首页 文章 精选 留言 我的

精选列表

搜索[Vite构建],共10000篇文章
优秀的个人博客,低调大师

构建基于Spark的推荐引擎(Python)

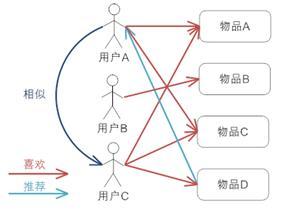
在学习Spark机器学习时,书上用scala完成,自己不熟悉遂用pyshark完成,更深入的理解了spark对协同过滤的实现 在这里我们的推荐模型选用协同过滤这种类型,使用Spark的MLlib中推荐模型库中基于矩阵分解(matrix factorization)的实现。 协同过滤(Collaborative Filtering) 协同过滤简单来说是利用某兴趣相投、拥有共同经验之群体的喜好来推荐用户感兴趣的信息,个人通过合作的机制给予信息相当程度的回应(如评分)并记录下来以达到过滤的目的进而帮助别人筛选信息,回应不一定局限于特别感兴趣的,特别不感兴趣信息的纪录也相当重要。 很简单的例子来介绍就是日常我们生活中经常找电影会通过向和自己品味类似的朋友要求推荐,这就是协同过滤的思想 基于用户的协同过滤推荐机制的基本原理 基于用户或物品的方法的得分取决于若干用户或是物品之间依据相似度所构成的集合(即邻居),故它们也常被称为最邻近模型。 矩阵分解 这里我们要处理的数据是用户提供的自身偏好数据,即用户对物品的打分数据。 这些数据可以被转换成用户为行,物品为列的二维矩阵,即评分矩阵A(m*n)表示m个用户对n个物品的打分情况 UI i1 i2 i3 u1 3.0 3.0 ? u2 ? 2.0 4.0 u3 ? 5.0 ? 这个矩阵A很多元素都是空的,我们称其为缺失值(missing value) 协同过滤提出了一种支持不完整评分矩阵的矩阵分解方法,不用对评分矩阵进行估值填充。 在推荐系统中,我们希望得到用户对所有物品的打分情况,如果用户没有对一个物品打分,那么就需要预测用户是否会对该物品打分,以及会打多少分。这就是所谓的矩阵补全(矩阵分解) 对于这个矩阵分解的方式就是找出两个低维度的矩阵,使得他们的乘积是原始的矩阵。 因此这也是一种降维技术。要找到和‘用户-物品’矩阵近似的k维矩阵,最终要求得出表示用户的m x k维矩阵,和一个表示物品的k x n维矩阵。 这两个矩阵也称作因子矩阵。 对于k的理解为对于每个产品,这里已电影为例,可以从k个角度进行评价,即k个特征值 由于是对‘用户-物品’矩阵直接建模,用这些模型进行预测也相对直接,要计算给定用户对某个物品的预计评级,就从用户因子矩阵和物品因子矩阵分别选取对应的行与列,然后计算两者的点积。 假设对于用户A,该用户对一部电影的综合评分和电影的特征值存在一定的线性关系, 即电影的综合评分=(a1d1+a2d2+a3d3+a4d4) 其中a1-4为用户A的特征值,d1-4为之前所说的电影的特征值 最小二乘法实现协同 最小二乘法(Alternating Least Squares, ALS)是一种求解矩阵分解问题的最优化方法。它功能强大、效果理想而且被证明相对容易并行化。这使得它很适合如Spark这样的平台。 使用用户特征矩阵U(m∗k) 中的第i个用户的特征向量ui 和产品特征矩阵V(n∗k)第j个物品的特征向量vi来预测打分矩阵A(m∗n)中的aij, 得出矩阵分解模型的损失函数如下: C=∑(i,j)∈R[(aij−uivTj)2+λ(u2i+v2j)] 通常的优化方法分为两种:交叉最小二乘法(alternative least squares)和随机梯度下降法(stochastic gradient descent)。Spark使用的是交叉最小二乘法(ALS)来最优化损失函数。 算法的思想就是:我们先随机生成然后固定它求解,再固定求解,这样交替进行下去,直到取得最优解min(C) 使用PySpark实现 我们这里的数据集是Movielens 100k数据集,包含了多个用户对多部电影的10万次评级数据 读取评级数据集,该数据包括用户ID,影片ID,星级和时间戳等字段,使用/t分隔 通过sc.textFile()读取数据为RDD,通过分隔符取前3个属性分别为用户ID,影片ID,星级 rawData=sc.textFile('/home/null/hadoop/data/ml-100k/u.data') rawData.first() type(rawData) pyspark.rdd.RDD rawRatings=rawData.map(lambdaline:line.split("\t")[:3]) rawRatings.first() ['196','242','3'] #导入spark中的mllib的推荐库 importpyspark.mllib.recommendationasrd 生成Rating类的RDD数据 #由于ALS模型需要由Rating记录构成的RDD作为参数,因此这里用rd.Rating方法封装数据 ratings=rawRatings.map(lambdaline:rd.Rating(int(line[0]),int(line[1]),float(line[2]))) ratings.first() Rating(user=196,product=242,rating=3.0) 训练ALS模型 rank: 对应ALS模型中的因子个数,即矩阵分解出的两个矩阵的新的行/列数,即A≈UVT,k<<m,nm,n中的k iterations: 对应运行时的最大迭代次数 lambda: 控制模型的正则化过程,从而控制模型的过拟合情况。 #训练ALS模型 model=rd.ALS.train(ratings,50,10,0.01) model #对用户789预测其对电影123的评级 predictedRating=model.predict(789,123) predictedRating 3.1740832151065774 #获取对用户789的前10推荐 topKRecs=model.recommendProducts(789,10) topKRecs [Rating(user=789,product=429,rating=6.302989890089658), Rating(user=789,product=496,rating=5.782039583864358), Rating(user=789,product=651,rating=5.665266358968961), Rating(user=789,product=250,rating=5.551256887914674), Rating(user=789,product=64,rating=5.5336980239740186), Rating(user=789,product=603,rating=5.468600343790217), Rating(user=789,product=317,rating=5.442052952711695), Rating(user=789,product=480,rating=5.414042111530209), Rating(user=789,product=180,rating=5.413309515550101), Rating(user=789,product=443,rating=5.400024900653429)] 检查推荐内容 这里首先将电影的数据读入,讲数据处理为电影ID到标题的映射 然后获取某个用户评级前10的影片同推荐这个用户的前10影片进行比较 #检查推荐内容 movies=sc.textFile('/home/null/hadoop/data/ml-100k/u.item') movies.first() '1|ToyStory(1995)|01-Jan-1995||http://us.imdb.com/M/title-exact?Toy%20Story%20(1995)|0|0|0|1|1|1|0|0|0|0|0|0|0|0|0|0|0|0|0' titles_data=movies.map(lambdaline:line.split("|")[:2]).collect() titles=dict(titles_data) titles moviesForUser=ratings.keyBy(lambdarating:rating.user).lookup(789) type(moviesForUser) list moviesForUser=sorted(moviesForUser,key=lambdar:r.rating,reverse=True)[0:10] moviesForUser [Rating(user=789,product=127,rating=5.0), Rating(user=789,product=475,rating=5.0), Rating(user=789,product=9,rating=5.0), Rating(user=789,product=50,rating=5.0), Rating(user=789,product=150,rating=5.0), Rating(user=789,product=276,rating=5.0), Rating(user=789,product=129,rating=5.0), Rating(user=789,product=100,rating=5.0), Rating(user=789,product=741,rating=5.0), Rating(user=789,product=1012,rating=4.0)] [(titles[str(r.product)],r.rating)forrinmoviesForUser] [('Godfather,The(1972)',5.0), ('Trainspotting(1996)',5.0), ('DeadManWalking(1995)',5.0), ('StarWars(1977)',5.0), ('Swingers(1996)',5.0), ('LeavingLasVegas(1995)',5.0), ('Bound(1996)',5.0), ('Fargo(1996)',5.0), ('LastSupper,The(1995)',5.0), ('PrivateParts(1997)',4.0)] [(titles[str(r.product)],r.rating)forrintopKRecs] [('DaytheEarthStoodStill,The(1951)',6.302989890089658), ("It'saWonderfulLife(1946)",5.782039583864358), ('Glory(1989)',5.665266358968961), ('FifthElement,The(1997)',5.551256887914674), ('ShawshankRedemption,The(1994)',5.5336980239740186), ('RearWindow(1954)',5.468600343790217), ('IntheNameoftheFather(1993)',5.442052952711695), ('NorthbyNorthwest(1959)',5.414042111530209), ('ApocalypseNow(1979)',5.413309515550101), ('Birds,The(1963)',5.400024900653429)] 推荐模型效果的评估 均方差(Mean Squared Error,MSE) 定义为各平方误差的和与总数目的商,其中平方误差是指预测到的评级与真实评级的差值平方 直接度量模型的预测目标变量的好坏 均方根误差(Root Mean Squared Error,RMSE) 对MSE取其平方根,即预计评级和实际评级的差值的标准差 #evaluationmetric usersProducts=ratings.map(lambdar:(r.user,r.product)) predictions=model.predictAll(usersProducts).map(lambdar:((r.user,r.product),r.rating)) predictions.first() ((316,1084),4.006135662882842) ratingsAndPredictions=ratings.map(lambdar:((r.user,r.product),r.rating)).join(predictions) ratingsAndPredictions.first() ((186,302),(3.0,2.7544572973050236)) #使用MLlib内置的评估函数计算MSE,RMSE frompyspark.mllib.evaluationimportRegressionMetrics predictionsAndTrue=ratingsAndPredictions.map(lambdaline:(line[1][0],line[1][3])) predictionsAndTrue.first() (3.0,2.7544572973050236) #MSE regressionMetrics=RegressionMetrics(predictionsAndTrue) regressionMetrics.meanSquaredError 0.08509832708963357 #RMSE regressionMetrics.rootMeanSquaredError 0.2917161755707653 本文地址https://segmentfault.com/a/1190000012494851 推荐内容《大数据全栈高手速成--Spark2.0精讲(全场景项目实战) 》http://www.roncoo.com/course/view/c4e0130ea2354c71a2cb9ba24348746c


优秀的个人博客,低调大师

如何构建一个flink sql平台

我们都知道,离线计算有Hive,使用过的知道,需要先定义一个schema,比如针对HDFS这种存储对标mysql定义一个schema,schema的本质是什么?主要描述下面这些信息 1)当前存储的物理位置的描述 2)数据格式的组成形式 然后Hive可以让用户定义一段sql,针对上面定义的schema进行,sql的本质是什么,是业务逻辑的描述。然后Hive内部会将这段sql进行编译转化为原生的底层MapReduce操作,通过这种方式,屏蔽底层技术原理,让业务开发人员集中精力在schema和sql业务逻辑上,flink sql平台也正是做同样的事情。 一开始经过跟上海同事的讨论,选择Uber的Athenax作为技术选型,通过翻阅源码,发现还是有很多不完善的地方,比如配置文件采用yaml,如果做多集群调度,平台代码优化,多存储扩展机制,都没有考虑得很清楚,所以代码拿过来之后基本上可以说按照对yarn和flink的理解重新写了一遍。 大致的工作流程如图所示: 简单解释一下: 1)业务定义job 2)提交到web服务器,存到mysql中 3)------------------- 4)-------------------- 5)flink平台进程定时扫描mysql,探测到job定义,并从yarn集群获取当前运行状态的job的report 比较时间戳,决定哪些任务要杀死,启动 6)flink提交到yarn集群的任务,yarn会从hdfs拉取job描述里的jar包,启动这个flink job 然后步骤3,4,5,6 重复执行 下面是平台代码的思路 1)通过springboot提供HTTP API,提供多集群定义,存储在mysql里 一个集群需要定义的信息点如下: 2)提供HTTP API让业务进行Job定义 这里的Job定义包含3个方面:job的输出输出的schema定义,job的业务逻辑定义(sql),job需要的yarn资源定义,具体来说如下所示: Job定义 文中的sql定义 SELECT SUM(nested.number) as nestedNumber, hundredFunction(SUM(CAST(`value` AS DOUBLE))) as `sum`, COUNT(`value`) as `count`, AVG(CAST(`value` AS DOUBLE)) as `avg`, MAX(CAST(`value` AS DOUBLE)) as `max`, MIN(CAST(`value` AS DOUBLE)) as `min`, TUMBLE_END(`time`, INTERVAL '3' SECOND) as `time` FROM input.`ymm-appmetric-dev-self1` WHERE metric IS NOT NULL AND `value` IS NOT NULL and `time` IS NOT NULL GROUP BY metric,TUMBLE(`time`, INTERVAL '3' SECOND) 输入/输出schema定义,以kafka为例,输入和输出格式差不多 { "brokerAddress":"略", "topic":"dev-metric", "schemas":[ {"key":"sum","type":"double"}, {"key":"count","type":"int"}, {"key":"avg","type":"double"}, {"key":"max","type":"double"}, {"key":"min","type":"double"}, {"key":"time","type":"timestamp"}, {"key":"nestedNumber","type":"int"} ] } 对于业务来说,“打开IDE->了解flink语法写java代码->打包成jar->提交到yarn集群”这一环节省去了,直接打开界面,点击按钮定义sql,写一段业务逻辑sql,提交此业务到mysql,关闭浏览器即可.由平台进行调度(秒级),永远不用担心这个任务某一天挂了怎么办,平台会自动发现自动拉起.提交一次永远不需要再人工干预,除非逻辑发生变化,在逻辑发生变化时也简单,打开任务修改再提交,关闭浏览器,结束,平台会发现job变化杀死老任务拉起新任务. 下面讲一下平台内部是如何实现的 3)集群自动发现 如果平台维护方想增加一个集群,通过界面直接定义一个存在mysql即可,后台线程会自动发现,为每个集群创建一个线程,多节点情况下,整个环境中某个特定集群的多个线程通过ZK进行抢占决定哪个线程当前为这个集群服务. 增加JVM关闭钩子,在JVM退出时,主动关闭ZK客户端,释放ZK上的临时节点. 4)UDF的支持&自动发现 错误做法: 平台支持平台级UDF的定义,由平台人员进行维护,平台人员编写脚本,通过base64编码存在mysql里,归属到某个集群,这个集群的扫描线程发现有必要进行编译时,实时编译成class常驻内存,同时,打包成jar包上传到远程HDFS,后面会将此路径放入到具体job的classpath路径下. job就可以正确发现UDF. 当UDF没有发生变化时,线程不会编译,而是复用上一次的编译结果. 正确做法: 后来发现这种做法是愚蠢的,算是踩了坑吧,后来改成jar包上传的方式了!!! 5)程序可以任意部署,不依赖大数据环境 程序本身不依赖大数据环境的配置,具体是指不需要依赖当前宿主机.../etc/hadoop/*.xml文件 通过读取cluster的配置,动态生成XML配置,再生成HDFS/YARN的客户端client,这样,平台代码可以任意部署到物理机/容器中,只要环境可以通过TCP连接到对应域名/ip即可. 6)如何做任务调度-任务的自动发现 这里的任务调度是指:哪些任务需要下线,哪些任务需要第一次上线,哪些任务需要重新上线, 这里的业务逻辑就是比较mysql里job的时间戳和yarn集群里任务的时间戳 yarn集群里任务的时间戳是通过提交时打上Tag标记,就是为了下一次比较用。 这里有一个细节,就是Athenax的做法是先算出所有要杀死的任务,杀死,再拉起所有要拉起的任务,个人认为这里不妥,优化之后的做法是:按照任务级别,算出(killaction,startaction),对于单个job来说,二者至少存在1个action,然后以任务为级别进行调度,不再是之前的大一统提交方式,这样就算单个任务调度异常,也不影响其它任务,做到了任务之间做隔离. 通过时间戳的方式,就不难理解业务一旦修改任务,平台发现时间戳有变化,就可以自动杀死老任务,拉起新任务,不需要人工操作. 7)拉起任务中的编译工作 一个job需要拉起时,会实时结合(输入schema,SQL业务逻辑,输出schema)进行编译, 正如hive会翻译成原生的mapreduce操作,flink sql编译工作会翻译成原生的flink jobgraph 这部分是抽取了athenax里的编译工作做2开 代码如下: privateJobCompilerResultcompile(Mapinputs,StringoriginSql, ExternalCatalogoutput,ResourceDTOresourceDTO, ClusterDTOathenaxCluster, ConfigurationflinkConf)throwsException{ //解析sql LoggerUtil.info("tobecompiledsql:[{}]",originSql); SqlNodeListstmts=(SqlNodeList)newCalciteSqlParser().parse(originSql); Validatorvalidator=newValidator(); validator.validateQuery(stmts); HashMapudfMap=validator.getUserDefinedFunctions(); StringselectSql=validator.getStatement().toString(); ListadditionalResources=validator.getAdditionalResources(); LoggerUtil.info("succeedtoparsesql,resultis:[{}]",stmts); LoggerUtil.info("udf{}",udfMap); LoggerUtil.info("statement{}",selectSql); LoggerUtil.info("additionalResources{}",additionalResources); //准备编译,输出Flink的JobGraph LoggerUtil.info("begintocreateexecutionenvironment"); StreamExecutionEnvironmentlocalExecEnv=StreamExecutionEnvironment .createLocalEnvironment(); //非常重要 setFeature(localExecEnv, resourceDTO.getTaskManagerCount()*resourceDTO.getSlotPerTaskManager(),flinkConf); StreamTableEnvironmenttableEnv=StreamTableEnvironment.getTableEnvironment(localExecEnv); LoggerUtil.info("tableEnv:{}",tableEnv); //注册UDF,收归到平台了,也就是说,只支持平台开发人员预定义,暂时不支持业务自定义 for(Map.Entrye:udfMap.entrySet()){ finalStringname=e.getKey(); StringclazzName=e.getValue(); LoggerUtil.info("usedudfspecifiedbybusiness:{}",name); } registerSDF(athenaxCluster,tableEnv); LoggerUtil.info("alludfregisterd,bingo"); //开始注册所有的input相关的schema for(Map.Entrye:inputs.entrySet()){ LoggerUtil.info("Registeringinputcatalog{}",e.getKey()); tableEnv.registerExternalCatalog(e.getKey(),e.getValue()); } LoggerUtil.info("allinputcatalogregisterd,bingo"); Tabletable=tableEnv.sqlQuery(selectSql); LoggerUtil.info("succeedtoexecutetableEnv.sqlQuery(...)"); LoggerUtil.info("table{}",table); LoggerUtil.info("bingo!inputworkdonecompletely,letushandleoutputworknow!!!"); //开始注册output ListoutputTables=output.listTables(); for(Stringt:outputTables){ table.writeToSink(getOutputTable(output.getTable(t))); } LoggerUtil.info("handleoutputok"); //生成JobGraph StreamGraphstreamGraph=localExecEnv.getStreamGraph(); JobGraphjobGraph=streamGraph.getJobGraph(); //thisisrequiredbecausetheslotsareallocatedlazily //如果为true就会报错,然后flink内部就是一直重启,所以设置为false jobGraph.setAllowQueuedScheduling(false); LoggerUtil.info("createflinkjobok{}",jobGraph); JobGraphTool.analyze(jobGraph); //生成返回结果 JobCompilerResultjobCompilerResult=newJobCompilerResult(); jobCompilerResult.setJobGraph(jobGraph); ArrayListpaths=newArrayList(); Collectionvalues=udfMap.values(); for(Stringvalue:values){ paths.add(value); } jobCompilerResult.setAdditionalJars(paths); returnjobCompilerResult; } 这部分工作要理解,需要对Calcite有基础 8)多存储的支持 平台在一开始编写的时候,就考虑到了多存储支持,虽然很多任务是从kafka->计算->Kafka 但是平台并不只满足于这一点,因为写到kafka之后,可能还需要业务再去维护一段代码取读取kafka的消息进行消费,如果有的业务希望直接能把结果写到mysql,这个时候就是需要对多存储进行扩展 通过设计和扩展机制,平台开发人员只需要定义储存相关的类,针对schema定义的解析工作已经再父类中完成,所有存储类共用,这样可以灵活支持多存储,平台开发人员只需要把重点放在特定存储性质的支撑即可. PS:编写此类存储类需要对fink job内部的运行机制,否则会造成资源泄露和浪费. 平台内部已经针对每种类型进行了定义 //存储类型 //排名不分先后 publicstaticintSTORAGE_REDIS=1<<0;//1 publicstaticintSTORAGE_MYSQL=1<<1;//2 publicstaticintSTORAGE_ROCKETMQ=1<<2;//4 publicstaticintSTORAGE_KAFKA=1<<3;//8 publicstaticintSTORAGE_PULSAR=1<<4;//16 publicstaticintSTORAGE_OTHER0=1<<5;//32 publicstaticintSTORAGE_OTHER1=1<<6;//64 publicstaticintSTORAGE_OTHER2=1<<7;//128 publicstaticintSTORAGE_RABBITMQ=1<<8;//256 publicstaticintSTORAGE_HBASE=1<<9;//512 publicstaticintSTORAGE_ES=1<<10;//1024 publicstaticintSTORAGE_HDFS=1<<11;//2048 目前支持的情况如下: 输入:Kafka 输出:Kafka/Mysql PS:输出mysql是基于flink官方的提供类实现的第一版,经过分析源码,mysql sink官方这部分代码写得太随意,差评. 后续当业务有需求时,需要结合zebra做2次开发.毕竟运维不会提供生产环境的ip和端口等信息,只会提供一个数据源字符串标识.这样更贴合公司内部的运行环境 9)任务提交 一旦生成flink原生的job,就可以准备提交工作 这部分需要对yarn的运行机制比较清楚,比如任务提交到RM上经过哪些状态变化,ApplicationMaster如何申请资源启动TaskManager, 具体的job是如何提交给JobManager的,平台开发人员需要对此有基本的原理掌握,当初也是0基础开始学习,通过快速翻阅源代码掌握一些运行机制,方可安心进行平台开发. 10)其它优化 针对yarn client的参数优化,保证可在一定时间内返回,否则可能一直卡死 针对flink job的平台级优化,比如禁止缓存,让信息立刻传输到下一个环节(默认100毫秒延迟) 定义flink job的重启次数,当发生异常时可自行恢复等 11)压测结果 输入:本地启动7个线程,发送速度 每秒发送到kafka 十几万条 接收topic描述 ymm-appmetric-dev-self1 开发环境 partitions 6 replication 1 flink任务描述 2个TaskManager进程 每个进程800M内存 每个进程3个线程, 并行度 2*3=6 flink计算任务所用sql SELECT SUM(nested.number) as nestedNumber, hundredFunction(SUM(CAST(`value` AS DOUBLE))) as `sum`, COUNT(`value`) as `count`, AVG(CAST(`value` AS DOUBLE)) as `avg`, MAX(CAST(`value` AS DOUBLE)) as `max`, MIN(CAST(`value` AS DOUBLE)) as `min`, TUMBLE_END(`time`, INTERVAL '3' SECOND) as `time` FROM input.`ymm-appmetric-dev-self1` WHERE metric IS NOT NULL AND `value` IS NOT NULL and `time` IS NOT NULL GROUP BY metric, TUMBLE(`time`, INTERVAL '3' SECOND) 输出topic ymm-appmetric-dev-result partitions 3 观察flink consumer端的消费速度 每个线程的消费速度在24000上下浮动,并发度6,每秒可消费kafka消息14万+,应该说目前不会碰到性能瓶颈. 其它 本次测试发送数据条数:4.3 亿条 耗时:56分钟 对于业务开发人员来说,我觉得好处就是 1)不需要懂flink语法(你真的想知道flink的玩法?好吧我承认你很好学) 2)不需要打开IDE写java代码(你真的想写Java代码?好吧我承认你对Java是真爱) 3)提交一次,不再需要人工介入(你真的想在假期/晚上/过节/过年 担心任务挂掉?好吧我承认你很敬业) 只需要 1)界面点击操作,定义你的schema 2)写一段你所擅长的sql 3)点击提交按钮 4)关闭浏览器 5)关闭电脑 其它的就交给平台吧! 后续:针对平台来说,后续的主要工作是根据业务需求扩展多存储 如果再长远,那就是要深度阅读flink源码对平台进行二次优化

优秀的个人博客,低调大师

centos7之Java开发环境构建

CensOS7环境 我个人的博客环境如下: 希望这个教程可以帮助到linux新手朋友们或者其他在安装软件时遇到问题的朋友们 当然了,百度上也有很多类似这样的教程,我个人贴出来,一来为分享,二来以后自己用到时,上手就有,不必担心为此耗费比较长的时间。 该教程是我个人使用xmind写的,只是通过导出工具导出为html,才会显示如下,不过导出的显示信息,不会影响正常阅读。 本人亲自实践过,有任何问题可以留言 Java开发基本环境 1.jdk的安装 rpm安装 获取rpm安装包 wget --no-check-certificate --no-cookies --header "Cookie: oraclelicense=accept-securebackup-cookie" http://download.oracle.com/otn-pub/java/jdk/8u131-b11/d54c1d3a095b4ff2b6607d096fa80163/jdk-8u131-linux-x64.rpm jdk官网:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 安装rpm rpm -ivh jdk-8u131-linux-x64.rpm java -version 显示对应的Java版本信息 2.tomcat安装 首先在浏览器输入tomcat,进入tomcat官网 https://tomcat.apache.org/ 选择对应的版本,将链接复制下来,然后再Linux上执行wget命令进行下载 wget http://mirrors.hust.edu.cn/apache/tomcat/tomcat-8/v8.0.52/bin/apache-tomcat-8.0.52.tar.gz 解压tomcat tar -xzvf apache-tomcat-8.0.52.tar.gz 3.mysql安装 获得tar包 wget http://dev.mysql.com/get/Downloads/MySQL-5.7/mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 解压tar包 tar -xvf mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 安装(存在依赖关系,依次安装) rpm -ivh mysql-community-common-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-libs-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-client-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-server-5.7.16-1.el7.x86_64.rpm 在安装这个的时候可能会报错,通过这个方法可以解决 获取相关依赖包并安装 下载 wget http://mirror.centos.org/centos/6/os/x86_64/Packages/libaio-0.3.107-10.el6.x86_64.rpm 安装 rpm -ivh libaio-0.3.107-10.el6.x86_64.rpm yum安装相关包 yum install net-tools 数据库初始化 mysqld --initialize --user=mysql 获得随机密码 cat /var/log/mysqld.log 启动数据库 systemctl start mysqld.service 进入mysql mysql -uroot -p 修改密码 ALTER USER 'root'@'localhost' IDENTIFIED BY 'new_password'; 4. maven安装 安装命令 yum install maven 安装成功 mvn -v 显示对应的版本信息 5.git安装 安装命令 yum install git 6.nginx安装 准备相关的依赖库 yum install gcc gcc-c++ autoconf automake yun -y install zlib zlib-devel openssl openssl-devel pcre pcre-devel wget http://downloads.sourceforge.net/project/pcre/pcre/8.35/pcre-8.35.tar.gz 解压 tar-xzvf pcre-8.35.tar.gz ./configure make && make install 编译安装 获取安装包 wget http://nginx.org/download/nginx-1.6.2.tar.gz 解压该包 tar xzvf nginx-1.6.2.tar.gz /configure --prefix=/usr/local/nginx --with-http_stub_status_module --with-http_ssl_module --with-pcre=/home/yc/pcre-8.35

优秀的个人博客,低调大师

Docker 构建自己的容器(学习笔记二)

Dockerfile --------------------------------------------------------------------------------------------------------------------- 首先需要的包和dockerfile放在一起 [root@localhost docker-file]# ls Dockerfile nginx-1.9.3.tar.gz pcre-8.37.tar.gz [root@localhost docker-file]# pwd /opt/docker-file [root@localhost docker-file]# --------------------------------------------------------------------------------------------------------------------- 创建dockerfile [root@localhost docker-file]# vim Dockerfile #base images,name or id 可以是镜像名字或者镜像ID FROM 3bee3060bfc8 #maintainer 作者 MAINTAINER wangzz #add 把包添加到容器的指定目录,如果是tar包会自动解压 ADD pcre-8.37.tar.gz /usr/local/src ADD nginx-1.9.3.tar.gz /usr/local/src #run 在容器里运行命令安装nginx需要软件 RUN yum install -y wget gcc gcc-c++ make openssl-devel #run 在容器里运行命令创建用户 RUN useradd -s /sbin/nologin -M www #workdir 相当于cd到这个目录 WORKDIR /usr/local/src/nginx-1.9.3 #run 在容器里运行命令进行编译安装 RUN ./configure --prefix=/usr/local/nginx --user=www --group=www --with-http_ssl_module --with-http_stub_status_module --with-pcre=/usr/local/src/pcre-8.37 && make && make install #run 在容器里运行命令更改nginx配置文件,使其前台运行 RUN echo "daemon off;" >> /usr/local/nginx/conf/nginx.conf #env 将nginx启动命令加到环境变量里 ENV PATH /usr/local/nginx/sbin:$PATH #映射80端口 EXPOSE 80 执行nginx命令 CMD ["nginx"] --------------------------------------------------------------------------------------------------------------------- 执行dockerfile [root@localhost docker-file]# docker build -t my-nginx-1:v1 /opt/docker-file/ 当成功后会出现这个,说明执行成功 Successfully built 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看镜像 [root@localhost docker-file]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE my-nginx-1 v1 21273b8e163a 14 minutes ago 429.1 MB --------------------------------------------------------------------------------------------------------------------- 使用创建好的镜像启动容器 [root@localhost docker-file]# docker run -dit --name mynginx 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看运行的容器 [root@localhost docker-file]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES aa30accbfc06 21273b8e163a "nginx" 3 seconds ago Up 2 seconds 80/tcp mynginx --------------------------------------------------------------------------------------------------------------------- 访问这个容器的80端口,看nginx是否安装启动成功 [root@localhost docker-file]# curl 172.17.0.3 Welcome to nginx! body { width: 35em; margin: 0 auto; font-family: Tahoma, Verdana, Arial, sans-serif; } Welcome to nginx! If you see this page, the nginx web server is successfully installed and working. Further configuration is required. For online documentation and support please refer to nginx.org. Commercial support is available at nginx.com. Thank you for using nginx.

优秀的个人博客,低调大师

docker私有仓库构建,上传,下载 push,pull

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80415332 1、下载私有仓库镜像 docker pull registry docker registry 启动 docker run -d -p 5001:5000 registry 默认端口5000我虚拟机占用5000所以改5001 上传 docker push localhost:5001/test/es:v1 另一台机器下载 docker pulldocker pull 47.106.154.105:5001/test/e:v1 ip为机器1公网ip 后面仓库位置要一样 docker pull 报错:Get https://registry:5000/v1/_ping: http: server gave HTTP response to HTTPS client 下载成功

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册