首页 文章 精选 留言 我的

精选列表

搜索[零点击],共10000篇文章
优秀的个人博客,低调大师

(Python)零起步数学+神经网络入门

在这篇文章中,我们将在Python中从头开始了解用于构建具有各种层神经网络(完全连接,卷积等)的小型库中的机器学习和代码。最终,我们将能够写出如下内容: 假设你对神经网络已经有一定的了解,这篇文章的目的不是解释为什么构建这些模型,而是要说明如何正确实现。 逐层 我们这里需要牢记整个框架: 1. 将数据输入神经网络 2. 在得出输出之前,数据从一层流向下一层 3. 一旦得到输出,就可以计算出一个标量误差。 4. 最后,可以通过相对于参数本身减去误差的导数来调整给定参数(权重或偏差)。 5. 遍历整个过程。 最重要的一步是第四步。我们希望能够拥有任意数量的层,以及任何类型的层。但是如果修改/添加/删除网络中的一个层,网络的输出将会改变,误差也将改变,误差相对于参数的导数也将改变。无论网络架构如何、激活函数如何、损

优秀的个人博客,低调大师

Java零基础入门学习1:初探Java世界

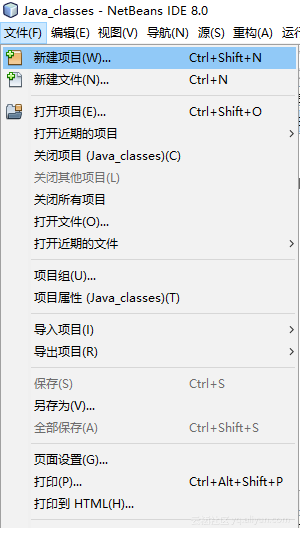
在我们的编程世界中,Java可以说是不可或缺的一部分,它可以实现C++中很多不能实现的地方,使用也与C++有一定差别。学过C或C++的,Java上手很快。如果你之前没学过C或C++,也没关系。我呢将用通俗的语言,生活中的栗子,来帮助大家理解、学习好Java编程。 有一句经典的话:计算机编程极其困难,它要求你获得计算机科学专业的学位,需要投入几千美元来购买计算机硬件和软件,需要极强的分析能力,需要有耐心,而且对含咖啡因的饮料有强烈的爱好。 而这句话除了最后一个,全是错的。我喜欢喝可乐,并发现百事比可口好喝,这是我当程序员来最大的收获之一,尽管不是很健康。 其实,编程不难,只要有兴趣,熟练掌握没问题。当你面对计算机时,你想告诉他,I love programming! 那么,你就可以用程序来坐到它。 首先,我们需要一个编程环境,也就是IDE,集成开发环境。一个友好的IDE能使人心情舒畅,愉悦,对做题有很大的帮助。 我们在这里一律采用Netbeans,可在这里下载。 首先,新建一个项目。 然后,选择类型Java。 之后给它命名为你喜欢的名字。这里以Java_class为例。 建好之后,我们按Ctrl+n键,新建文件。 文件名命名为My_first_java_program; 打出下面的源码: 代码1.1-我的第一个Java代码-I love programming! public class My_first_java_program{ public static void main(String args[]){ System.out.println("I love programming!"); } } 我们来讲解一下这段代码: public class My_first_java_program表示声明一个类。这里的类是什么意思呢?其实,每一个Java程序都是一个类,且只有一个主类。这个My_first_java_program是类名,而类名必须和文件名相符。否则就会出现CE(编译错误的情况)。 那我们所说的编译又是什么呢?编译就是将我们所编写的代码转化为程序的工作。因为代码本身无法进行任何运算,编程就是编写程序,而不仅仅是编写代码。 在Netbeans中,F6键是编译运行,按下F6,在下边就会出现程序运行框: 这就算完成了这个程序的编辑。 那让我们回到源代码上。 public static void main是指主函数。我们的类My_first_java_program中的主函数main,它是我们程序执行的重要来源。没有main,就没有我们的程序。 目前,在我们了解public,static,void为何物之前,你只要记住,一般主函数main都要这么写。当我们学习了数据类型,类的类型之后呢,我们在对它做一定调整。 我们输出I love programming的核心语句就是:System.out.println();这是输出语句。System是系统类,out是输出流。我们要记住,输入和输出都是以流出现的。println则是输出在换行。我们在深度学习之前,也只要记住这是输出就好了。记住,你想输出的话要用 “ ” 括起来。 那么,这就是Java最初始的一个程序。今天只是让大家浅浅地了解Java,并学会编写第一个程序。下一节课我们将讲解变量与变量类型,我们下次见

优秀的个人博客,低调大师

技术| Python的从零开始系列连载(三十一)

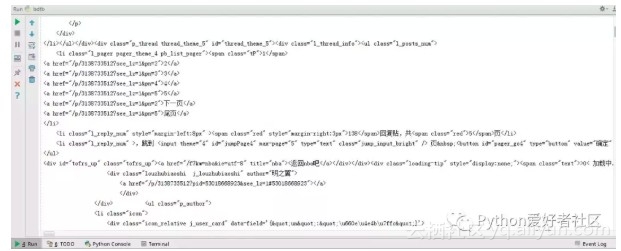
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子。与上一篇不同的是,这次我们需要用到文件的相关操作。 本篇目标 1.对百度贴吧的任意帖子进行抓取 2.指定是否只抓取楼主发帖内容 3.将抓取到的内容分析并保存到文件 1.URL格式的确定 首先,我们先观察一下百度贴吧的任意一个帖子。 比如:http://tieba.baidu.com/p/3138733512?see_lz=1&pn=1,这是一个关于NBA50大的盘点,分析一下这个地址。 http:// 代表资源传输使用http协议 tieba.baidu.com 是百度的二级域名,指向百度贴吧的服务器。 /p/3138733512 是服务器某个资源,即这个帖子的地址定位符 see_lz和pn是该URL的两个参数,分别代表了只看楼主和帖子页码,等于1表示该条件为真 所以我们可以把URL分为两部分,一部分为基础部分,一部分为参数部分。 例如,上面的URL我们划分基础部分是 http://tieba.baidu.com/p/3138733512,参数部分是 ?see_lz=1&pn=1 2.页面的抓取 熟悉了URL的格式,那就让我们用urllib2库来试着抓取页面内容吧。上一篇糗事百科我们最后改成了面向对象的编码方式,这次我们直接尝试一下,定义一个类名叫BDTB(百度贴吧),一个初始化方法,一个获取页面的方法。 其中,有些帖子我们想指定给程序是否要只看楼主,所以我们把只看楼主的参数初始化放在类的初始化上,即init方法。另外,获取页面的方法我们需要知道一个参数就是帖子页码,所以这个参数的指定我们放在该方法中。 综上,我们初步构建出基础代码如下: __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ): self.baseURL = baseUrl self.seeLZ = '?see_lz='+str(seeLZ) #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) print response.read() return response except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None baseURL = 'http://tieba.baidu.com/p/3138733512' bdtb = BDTB(baseURL,1) bdtb.getPage(1) 运行代码,我们可以看到屏幕上打印出了这个帖子第一页楼主发言的所有内容,形式为HTML代码。 3.提取相关信息 1)提取帖子标题 首先,让我们提取帖子的标题。 在浏览器中审查元素,或者按F12,查看页面源代码,我们找到标题所在的代码段,可以发现这个标题的HTML代码是 <h1 class="core_title_txt " title="纯原创我心中的NBA2014-2015赛季现役50大" style="width: 396px">纯原创我心中的NBA2014-2015赛季现役50大</h1> 所以我们想提取<h1>标签中的内容,同时还要指定这个class确定唯一,因为h1标签实在太多啦。 正则表达式如下 <h1 class="core_title_txt.*?>(.*?)</h1>所以,我们增加一个获取页面标题的方法 #获取帖子标题 def getTitle(self): page = self.getPage(1) pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None 2)提取帖子页数 同样地,帖子总页数我们也可以通过分析页面中的共?页来获取。所以我们的获取总页数的方法如下 #获取帖子一共有多少页 def getPageNum(self): page = self.getPage(1) pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None 3)提取正文内容 审查元素,我们可以看到百度贴吧每一层楼的主要内容都在<div id=”post_content_xxxx”></div>标签里面,所以我们可以写如下的正则表达式 <div id="post_content_.*?>(.*?)</div>相应地,获取页面所有楼层数据的方法可以写成如下方法 #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) for item in items: print item好,我们运行一下结果看一下 真是醉了,还有一大片换行符和图片符,好口怕!既然这样,我们就要对这些文本进行处理,把各种各样复杂的标签给它剔除掉,还原精华内容,把文本处理写成一个方法也可以,不过为了实现更好的代码架构和代码重用,我们可以考虑把标签等的处理写作一个类。 那我们就叫它Tool(工具类吧),里面定义了一个方法,叫replace,是替换各种标签的。在类中定义了几个正则表达式,主要利用了re.sub方法对文本进行匹配后然后替换。具体的思路已经写到注释中,大家可以看一下这个类 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() 在使用时,我们只需要初始化一下这个类,然后调用replace方法即可。 现在整体代码是如下这样子的,现在我的代码是写到这样子的 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ): self.baseURL = baseUrl self.seeLZ = '?see_lz='+str(seeLZ) self.tool = Tool() #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) return response.read().decode('utf-8') except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None #获取帖子标题 def getTitle(self): page = self.getPage(1) pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None #获取帖子一共有多少页 def getPageNum(self): page = self.getPage(1) pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) #for item in items: # print item print self.tool.replace(items[1]) baseURL = 'http://tieba.baidu.com/p/3138733512' bdtb = BDTB(baseURL,1) bdtb.getContent(bdtb.getPage(1))我们尝试一下,重新再看一下效果,这下经过处理之后应该就没问题了,是不是感觉好酸爽! 4)替换楼层 至于这个问题,我感觉直接提取楼层没什么必要呀,因为只看楼主的话,有些楼层的编号是间隔的,所以我们得到的楼层序号是不连续的,这样我们保存下来也没什么用。 所以可以尝试下面的方法: 1.每打印输出一段楼层,写入一行横线来间隔,或者换行符也好。 2.试着重新编一个楼层,按照顺序,设置一个变量,每打印出一个结果变量加一,打印出这个变量当做楼层。 这里我们尝试一下吧,看看效果怎样 把getContent方法修改如下 #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) floor = 1 for item in items: print floor,u"楼------------------------------------------------------------------------------------------------------------------------------------\n" print self.tool.replace(item) floor += 1运行一下看看效果 嘿嘿,效果还不错吧,感觉真酸爽!接下来我们完善一下,然后写入文件 4.写入文件 最后便是写入文件的过程,过程很简单,就几句话的代码而已,主要是利用了以下两句 file = open(“tb.txt”,”w”) file.writelines(obj) 这里不再赘述,稍后直接贴上完善之后的代码。 5.完善代码 现在我们对代码进行优化,重构,在一些地方添加必要的打印信息,整理如下 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ,floorTag): #base链接地址 self.baseURL = baseUrl #是否只看楼主 self.seeLZ = '?see_lz='+str(seeLZ) #HTML标签剔除工具类对象 self.tool = Tool() #全局file变量,文件写入操作对象 self.file = None #楼层标号,初始为1 self.floor = 1 #默认的标题,如果没有成功获取到标题的话则会用这个标题 self.defaultTitle = u"百度贴吧" #是否写入楼分隔符的标记 self.floorTag = floorTag #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: #构建URL url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) #返回UTF-8格式编码内容 return response.read().decode('utf-8') #无法连接,报错 except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None #获取帖子标题 def getTitle(self,page): #得到标题的正则表达式 pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #如果存在,则返回标题 return result.group(1).strip() else: return None #获取帖子一共有多少页 def getPageNum(self,page): #获取帖子页数的正则表达式 pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: return result.group(1).strip() else: return None #获取每一层楼的内容,传入页面内容 def getContent(self,page): #匹配所有楼层的内容 pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) contents = [] for item in items: #将文本进行去除标签处理,同时在前后加入换行符 content = "\n"+self.tool.replace(item)+"\n" contents.append(content.encode('utf-8')) return contents def setFileTitle(self,title): #如果标题不是为None,即成功获取到标题 if title is not None: self.file = open(title + ".txt","w+") else: self.file = open(self.defaultTitle + ".txt","w+") def writeData(self,contents): #向文件写入每一楼的信息 for item in contents: if self.floorTag == '1': #楼之间的分隔符 floorLine = "\n" + str(self.floor) + u"-----------------------------------------------------------------------------------------\n" self.file.write(floorLine) self.file.write(item) self.floor += 1 def start(self): indexPage = self.getPage(1) pageNum = self.getPageNum(indexPage) title = self.getTitle(indexPage) self.setFileTitle(title) if pageNum == None: print "URL已失效,请重试" return try: print "该帖子共有" + str(pageNum) + "页" for i in range(1,int(pageNum)+1): print "正在写入第" + str(i) + "页数据" page = self.getPage(i) contents = self.getContent(page) self.writeData(contents) #出现写入异常 except IOError,e: print "写入异常,原因" + e.message finally: print "写入任务完成" print u"请输入帖子代号" baseURL = 'http://tieba.baidu.com/p/' + str(raw_input(u'http://tieba.baidu.com/p/')) seeLZ = raw_input("是否只获取楼主发言,是输入1,否输入0\n") floorTag = raw_input("是否写入楼层信息,是输入1,否输入0\n") bdtb = BDTB(baseURL,seeLZ,floorTag) bdtb.start()现在程序演示如下 完成之后,可以查看一下当前目录下多了一个以该帖子命名的txt文件,内容便是帖子的所有数据。 抓贴吧,就是这么简单和任性! 原文发布时间为:2018-11-30 本文作者:灯塔大数据 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“DTbigdata”微信公众号

优秀的个人博客,低调大师

搭建Hadoop处理环境,零基础学习大数据

由于Hadoop需要运行在Linux环境中,而且是分布式的,因此个人学习只能装虚拟机,本文都以VMware Workstation为准,安装CentOS7,具体的安装此处不作过多介绍,只作需要用到的知识介绍。 VMware的安装,装好一个虚拟机后利用复制虚拟机的方式创建后面几个虚拟机,省时省力,需要注意的是需要修改每个虚拟机的IP与主机名。 所有虚拟机采用NAT模式上网,而且要保证与物理主机的IP互相能访问。 需要注意的几个问题。nat如果上网首先需要查看物理机(pc机)这个服务器已经启动。上网的原理:流量是走的物理网卡,但是它的ip,却是和物理机没有关系的。也就是说,无论你怎么更换网络环境,你的虚拟机都不需要做改变。这就是它的优点。 首先在安装VMware 之后,我们会看到多了两个网卡 这个如果经过网络配置的折磨,应该能找到着两个网卡:vmnet1和vmnet8,这里讲的是vmnet8。 重点看右侧第三图你会看到ip地址,这个ip地址,因个人而异,也就是说不同网络,不同环境,这个ip变化的概率是很大的。可能是192.168.0.1等等。这里也相当于我们编程的一个变量,这里是需要你根据你的环境来赋值的,建议vmnet1到vmnet8分别设置192.168.10.1到192.168.80.1,好作区分。 上面我们通过看到的虚拟机网卡的ip,为了避免混肴,上面的虚拟网卡和本地网络适配器处于同一界面。如下图: 而下面则是在打开虚拟机之后,通过菜单弹出 弹出之后,我们在看一下虚拟机的(交换机)vmnet8. 可以看到vmnet8子网ip和虚拟机网卡是出于同一个网段的。 同时在右侧net设置界面,我们可以看到网关为:192.168.106.2,改成192.168.80.2 虚拟机的设置会用到。 Linux基础知识 Linux的学习也是一个过程,因为可能你连最简单的开机和关机命令都不会,更不要谈配置网络。这里面给大家提供刚开始学习所查阅的资料和经验总结。 首先我们需要使用一些命令,进行网络配置,但是在网络配置中,这里面又必须懂得虚拟机的一些知识,所以前面的虚拟机知识需要掌握扎实一些。 在此注意CentOS7与CentOS6的命令有些不同,会一些常用命令是必备,每次开机或启动解压安装授权都是最基本的知识,其它的可以暂时不用学。 CentOS中安装java环境 下载对应32或64位jdk,设置好JDK环境变量PATH,具体的配置可自行Google。 环境准备 修改机器名,每个系统中都要修改成这样。 打开终端,切换到root用户下修改机器名称。 $ sudo su$ vim /etc/sysconfig/network在其中添加“HOSTNAME=H32” 添加每个服务器IP对应的机器名 三个ip地址都添加到各自的/etc/hosts文件中 每个系统中都要修改成这样 #编辑hostsvim /etc/hosts 关闭SELinux #编辑 SELinux 配置文件vim /etc/selinux/config#改状态SELINUX=disabled SSH设置 进入H30,查看ssh是否安装,如果有,继续,没有安装下。 rpm -qa|grep ssh 时间服务器安装 这里需要安装时间服务器,其他的服务器通过这个来进行多机器时间的同步,分布式部署时机器时间不一致会导致数据错误或组件内通讯错误。 安装httpd服务 httpd是Apache超文本传输协议(HTTP)服务器的主程序。被设计为一个独立运行的后台进程,它会建立一个处理请求的子进程或线程的池。 安装yum-utils yum install yum-utils 用于在线yum安装 它是基於RPM包管理,能够从指定的服务器自动下载RPM包并且安装,可以自动处理依赖性关系,并且一次安装所有依赖的软体包,无须繁琐地一次次下载、安装。yum提供了查找、安装、删除某一个、一组甚至全部软件包的命令,而且命令简洁而又好记。(需要机器能访问外网) 准备资源和环境 下载Centos 7.2 的iso安装镜像,jdk1.8 for Linux压缩包,hadoop2.7.3压缩包(本来用hadoop3,发现后面不兼容hive的最新版本) Java基础知识 由于Hadoop框架源码都是以Java来写,因此最好都以Java作为开发的最佳语言,虽然说有些用C#做了封装,但性能已大打折扣。(这就是为什么说Java的学大数据有很大的优势,其它语言的还需要重新学习Java) Eclipse IDE使用 Linux和Windows下源码编译技术 还有最重要的是你的网速要好,因为安装过程中会下载依赖包,网不好会卡到你怀疑人生。 最后还需要有耐心,每台机子的环境都不一样,而且每个人下载的包的版本也有可能不一样 会导致各种问题,此时就需要耐心的去看日志,不停的尝试和仔细的对比安装步骤,可能就是少了个变量 或大小写错误或是要重启。 本文链接:http://bigdata.evget.com/post/2331.html

优秀的个人博客,低调大师

技术 | Python从零开始系列连载(二十九)

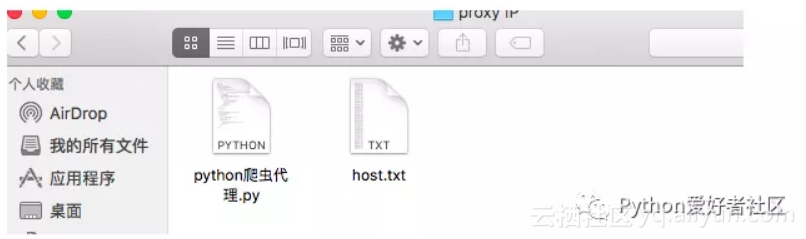
写爬虫防止被封的关键有以下几点: ●伪装请求报头(request header) ●减轻访问频率,速度 ●使用代理IP 一般第一点都能做到,第二点减轻访问频率就会大大增加任务时间,而使用代理就能在不增加任务时长避免被封的关键(实际情况却是任务时间因为代理的使用而增加的,但这里不细说,知道就好)。 下面我们从国内高匿代理IP获得代理IP数据。 import osimport timeimport requestsfrom bs4 import BeautifulSoup#num获取num页 国内高匿ip的网页中代理数据def fetch_proxy(num): #修改当前工作文件夹 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') api = 'http://www.xicidaili.com/nn/{}' header = { 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_3) AppleWebKit/' '537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'} fp = open('host.txt', 'a+', encoding=('utf-8')) for i in range(num+1): api = api.format(1) respones = requests.get(url=api, headers=header) soup = BeautifulSoup(respones.text, 'lxml') container = soup.find_all(name='tr',attrs={'class':'odd'}) for tag in container: try: con_soup = BeautifulSoup(str(tag),'lxml') td_list = con_soup.find_all('td') ip = str(td_list[1])[4:-5] port = str(td_list[2])[4:-5] IPport = ip + '\t' + port + '\n' fp.write(IPport) except Exception as e: print('No IP!') time.sleep(1) fp.close() 我们准备抓国内高匿代理IP网的十个页面的代理 fetch_proxy(10) 当前工作目录下的文件,你看!!有host.txt 打开host.txt,收集到了很多代理IP 但是有代理IP还不行,因为我们不知道这代理能不能用,是否有效。 下面我们用百度网进行检验(大公司不怕咱们短时间内高频率访问),上代码: import osimport timeimport requestsfrom bs4 import BeautifulSoupdef test_proxy(): N = 1 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') url = 'https://www.baidu.com' fp = open('host.txt', 'r') ips = fp.readlines() proxys = list() for p in ips: ip = p.strip('\n').split('\t') proxy = 'http:\\' + ip[0] + ':' + ip[1] proxies = {'proxy': proxy} proxys.append(proxies) for pro in proxys: try: s = requests.get(url, proxies=pro) print('第{}个ip:{} 状态{}'.format(N,pro,s.status_code)) except Exception as e: print(e) N+=1 运行该代码,效果如下 代理Ip池生成函数 #生成代理池子,num为代理池容量def proxypool(num): n = 1 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') fp = open('host.txt', 'r') proxys = list() ips = fp.readlines() while n<num: for p in ips: ip = p.strip('\n').split('\t') proxy = 'http:\\' + ip[0] + ':' + ip[1] proxies = {'proxy': proxy} proxys.append(proxies) n+=1 return proxys 下面开始爬豆瓣电影的电影数据,我们要获取 电影名、演员、评分。 电影标签页https://movie.douban.com/tag/ 烂片详情页https://movie.douban.com/tag/烂片 烂片详情页 我们就只爬烂片标签页的部分数据吧,网页链接规律如下 第一页https://movie.douban.com/tag/烂片?start=0 第二页https://movie.douban.com/tag/烂片?start=20 第三页https://movie.douban.com/tag/烂片?start=40 开始上代码 def fetch_movies(tag, pages, proxys): os.chdir(r'/Users/apple888/PycharmProjects/proxy IP/豆瓣电影') url = 'https://movie.douban.com/tag/爱情?start={}' headers = { 'User-Agent': 'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/' '537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Mobile Safari/537.36'} #用csv文件保存数据 csvFile = open("{}.csv".format(tag), 'a+', newline='', encoding='utf-8') writer = csv.writer(csvFile) writer.writerow(('name', 'score', 'peoples', 'date', 'nation', 'actor')) for page in range(0, pages*(20+1), 20): url = url.format(tag, page) try: respones = requests.get(url, headers=headers, proxies=random.choice(proxys)) while respones.status_code!=200: respones = requests.get(url, headers=headers, proxies=random.choice(proxys)) soup = BeautifulSoup(respones.text, 'lxml') movies = soup.find_all(name='div', attrs={'class': 'pl2'}) for movie in movies: movie = BeautifulSoup(str(movie), 'lxml') movname = movie.find(name='a') # 影片名 movname = movname.contents[0].replace(' ', '').strip('\n').strip('/').strip('\n') movInfo = movie.find(name='p').contents[0].split('/') # 上映日期 date = movInfo[0][0:10] # 国家 nation = movInfo[0][11:-2] actor_list = [act.strip(' ').replace('...', '') for act in movInfo[1:-1]] # 演员 actors = '\t'.join(actor_list) # 评分 score = movie.find('span', {'class': 'rating_nums'}).string # 评论人数 peopleNum = movie.find('span', {'class': 'pl'}).string[1:-4] writer.writerow((movname, score, peopleNum, date, nation, actors)) except: continue print('共有{}页,已爬{}页'.format(pages, int((page/20)))) 执行上述写好的代码 import timestart = time.time() proxyPool= proxypool(50) fetch_movies('烂片', 111, proxyPool)end = time.time() lastT = int(end-start) print('耗时{}s'.format(lastT)) Perfect 原文发布时间为:2018-11-16 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“灯塔大数据”。

优秀的个人博客,低调大师

技术 | Python从零开始系列连载(二十七)

我们接着上一期的Python,继续跟大家分享有关Python中常用的数值计算和正则表达式。 运算符 1)数值运算 +、-、*、/ % (求余数) // (注意Python中的整除是floor除,即向下除法) ** 2)比较运算 >、>=、<、<=、 == (判断两个对象是否相等) != (判断两个对象是否不相等) 3)逻辑运算 or (或) and (且) not (非) 数值函数 1)Python自带的数值函数 abs # 绝对值 divmod # 返回除法的整数和余数 round # 四舍五入 pow # 幂指数运算 2)math模块 math.pi math.e math.cell(x) # 向上取整 math.floor(x) # 向下取整 math.modf(expression) # 商的小数部分与整数部分 math.log2(x) # 以2为底的对数 math.log10(x) # 以10为底的对数 math.log(x) # 以e为底的对数 math.log(x, base) # 以base为底的对数 math.exp() # 指数 math.sqrt() # 算术平方根 math.factorial() # 阶乘 math.fmod() # 返回浮点型余数 字符串处理 1)字符串索引与切片(与上一期中列表、元组类似) 2)字符串拼接(字符串的加法与join方法) 3)字符串重复(字符串的乘法) 字符串中的正则表达式 1)正则表达式含义 . # 点可代表一切字符 \ # 起转义作用 [...] # 指代方括号中的任意字符 \d # 指代数字0-9 \D # 指代非数字 \s # 指代一切空格,包括tab制表符、空格、换行等 \S # 指代非空格 \w # 指代大小写字母、数字和下划线 \W # 指代非大小写字母、数字和下划线 * # 匹配前面字符 >=0 次 + # 匹配前面字符1次及以上 ? # 匹配前面字符0次或1次 {m} # 匹配m次 {m,n} # 匹配m到n次 {m,} # 至少匹配m次 2)结合re模块完成字符串的匹配 找 re.findall(pattern, string, flags=0) pattern-->正则表达式 string-->需要处理的字符串 flags-->说明匹配模式,如是否大小写re.I 切 re.split(pattern, string, maxsplit=0, flags=0) pattern-->正则表达式 string-->需要处理的字符串 maxsplit-->最大匹配次数。0表示匹配所有次 替 sub(pattern, repl, string, count=0, flags=0) pattern-->正则表达式 repl-->新的替换内容 string-->需要处理的字符串 count-->替换次数。0表示匹配替换所有次 flags-->匹配模式 原文发布时间为:2018-09-28本文来自云栖社区合作伙伴“ 灯塔大数据”,了解相关信息可以关注“ 灯塔大数据”。

优秀的个人博客,低调大师

技术 | Python从零开始系列连载(二十三)

跟奥巴马一起学编程 美国总统奥巴马不仅呼吁所有人都学习编程,甚至以身作则编写代码,成为美国历史上首位编写计算机代码的总统。2014年底,为庆祝“计算机科学教育周”正式启动,奥巴马编写了很简单的计算机代码:在屏幕上画一个正方形。现在你也跟他一起画吧! 输入格式: 输入在一行中给出正方形边长N(3=N=20)和组成正方形边的某种字符C,间隔一个空格。 输出格式: 输出由给定字符C画出的正方形。但是注意到行间距比列间距大,所以为了让结果看上去更像正方形,我们输出的行数实际上是列数的50%(四舍五入取整)。 输入样例: 10 a 输出样例: aaaaaaaaaa a a a a a a aaaaaaaaaa 上代码: 注意点: 1.input()可以一次接受多个值,用空格隔开,使用split()即可分开,用对应个数变量接收这些值即可 2. int类型的 // 含义? 3.代码是否可以优化,或者换种写法? show me the code ! 原文发布时间为:2018-08-17 本文作者:Python爱好者社区 本文来自云栖社区合作伙伴“ 灯塔大数据”,了解相关信息可以关注“ 灯塔大数据”。

优秀的个人博客,低调大师

技术 | Python从零开始系列连载(二十二)

挖掘机技术哪家强 为了用事实说明挖掘机技术到底哪家强,PAT组织了一场挖掘机技能大赛。现请你根据比赛结果统计出技术最强的那个学校。 输入格式: 输入在第1行给出不超过105的正整数N,即参赛人数。随后N行,每行给出一位参赛者的信息和成绩,包括其所代表的学校的编号(从1开始连续编号)、及其比赛成绩(百分制),中间以空格分隔。 输出格式: 在一行中给出总得分最高的学校的编号、及其总分,中间以空格分隔。题目保证答案唯一,没有并列。 输入样例:63 652 801 1002 703 403 0 输出样例:2 150 上代码: 注意点: input()可以一次接受多个值,用空格隔开,使用split()即可分开,用对应个数变量接收这些值即可 在c中可以用数组,在Python中我不想import库就用字典实现了,方法应该还有很多,大家可以试试探索。 光看不练,眼高手低可不好哦,动手敲代码吧~ 好啦,这期的分享先到这里,大家可以按照上面的详细步骤进行练习。加油。 原文发布时间为:2018-06-29本文作者:小柳本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“灯塔大数据”

优秀的个人博客,低调大师

零基础学python之文本和编码问题

字符串是个相当简单的概念:一个字符串是一个字符序列。问题出在”字符”的定义上。 在2015 年,”字符”的最佳定义是Unicode字符。因此,从Python 3 的str对象中获取 的元素是Unicode字符 Unicode 标准把字符的标识和具体的字节表述进行了如下的明确区分。 字符的标识,即码位,是0~1 114 111的数字(十进制),在Unicode标准中以4~6个十六进制数字表示,而且加前缀U+。例如,字母A的码位是U+0041,欧元符号的码位是U+20AC,高音谱号的码位是U+1D11E. 在Unicode 6.3标准中,约10% 的有效码位有对应的字符。 字符的具体表述取决于所用的编码。编码是在码位和字节序列之间转换时使用的算法。在UTF-8编码中,A(U+0041)的码位编码成单个字节\x41,而在UTF-16LE编码中编码成两个字节\x41\x00。再举个例子,欧元符号(U+20AC)在UTF-8编码中是三个字节——\xe2\x82\xac,而在UTF-16LE中编码成两个字节:\xac\x20. 把码位转换成字节序列的过程是编码,使用encode;把字节序列转换成码位的过程是解码,使用decode. 非英语用户常常会搞反所谓的编码解码,可以这样理解: 把Unicode字符串想成“人类可读”的文本.那么, 把字节序列变成人类可读的文本字符串就是解码 而把字符串变成用于存储或传输的字节序列就是编码 所以,我们在做爬虫的时候,遇到乱码的情况,可以先去看看编码格式是否正确!

优秀的个人博客,低调大师

用Python从零开始创建区块链1

作者认为最快的学习区块链的方式是自己创建一个,本文就跟随作者用Python来创建一个区块链。 对数字货币的崛起感到新奇的我们,并且想知道其背后的技术——区块链是怎样实现的。 但是完全搞懂区块链并非易事,我喜欢在实践中学习,通过写代码来学习技术会掌握得更牢固。通过构建一个区块链可以加深对区块链的理解。 准备工作 本文要求读者对Python有基本的理解,能读写基本的Python,并且需要对HTTP请求有基本的了解。 我们知道区块链是由区块的记录构成的不可变、有序的链结构,记录可以是交易、文件或任何你想要的数据,重要的是它们是通过哈希值(hashes)链接起来的。 如果你还不是很了解哈希,可以查看这篇文章 环境准备 环境准备,确保已经安装Python3.6+, pip , Flask, requests 安装方法: 1 pip install Flask=

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册