首页 文章 精选 留言 我的

精选列表

搜索[最大转化投放],共10000篇文章
优秀的个人博客,低调大师

图解自监督学习,人工智能蛋糕中最大的一块

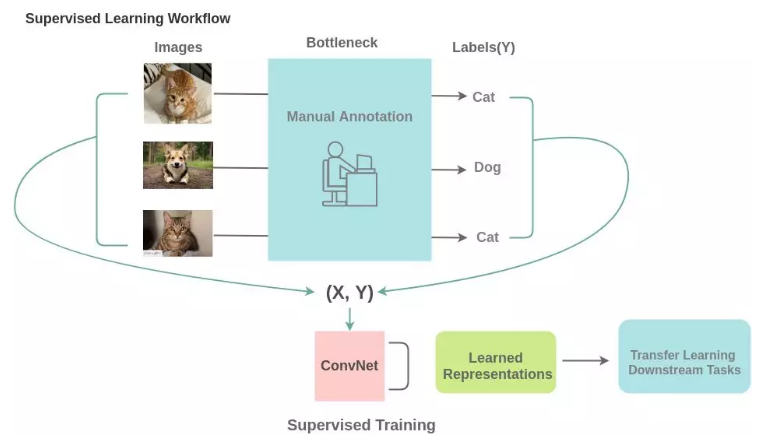
云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! Yann Lecun在他的演讲中引入了“蛋糕类比”来说明自监督学习的重要性。虽然这个类比是有争论的,但我们也已经看到了自监督学习的影响,在自然语言处理领域最新发展(Word2Vec,Glove, ELMO, BERT)中,已经接受了自监督,并取得了最佳的成果。 “如果人工智能是一块蛋糕,那么蛋糕的大部分是自监督学习,蛋糕上的糖衣是监督学习,蛋糕上的樱桃是强化学习(RL)。” 出于对自监督学习在计算机视觉领域的应用的好奇,我通过Jing等人的一篇近期调研论文查阅了已有的关于自我监督学习在计算机视觉领域应用的文献。 这篇文章是我对自监督学习中问题模式的直观总结。 关键的思想 为了使用监督学习,我们需要足够的标记数据。为了获得这些信息,人工标注器需要手工标记数据(图像/文本),这是一个既耗时又昂贵的过程。还有一些领域,比如医疗领域,获取足够的数据本身就是一个挑战。 这就是自监督学习发挥作用的地方。它提出了以下问题来解决这个问题: 我们能否以这样一种方式来设计这个任务,即我们可以从现有的图像生成几乎无限数量的标签,并使用这些标签来学习图像的表现形式? 我们通过创造性地利用数据的某些属性来代替人工标注块来建立监督任务。例如,在这里,我们可以将图像旋转0/90/180/270度,而不是将其标记为猫/狗,并训练一个模型来预测旋转。我们可以从数百万张免费提供的图像中生成几乎无限数量的训练数据。 已存在的创造性方法 下面是各种研究人员提出的利用图像和视频的属性并以自监督的方式学习表示的方法。 从图像中学习 1. 图像的着色 形式: 使用数以百万计的图像灰度化来准备成对(灰度,彩色)图像。 我们可以使用一个基于全卷积神经网络的编译码器结构来计算预测和实际彩色图像之间的L2损失。 为了解决这个问题,模型必须了解图像中出现的不同物体和相关部分,这样它才能用相同的颜色绘制这些部分。因此,表示学习对下游任务很有用。 2. 图像超分辨率 形式: 使用图像下采样的方式准备训练对(小的,缩放的)。 基于GAN的模型如SRGAN在此任务中很受欢迎。生成器获取低分辨率图像并使用全卷积网络输出高分辨率图像。使用均方误差和内容损失来模拟类人质量比较,对实际生成的图像和生成的图像进行比较。二进制分类鉴别器获取图像并对其进行分类,判断它是实际的高分辨率图像(1)还是假生成的超分辨率图像(0)。这两个模型之间的相互作用导致生成器学习生成具有精细细节的图像。 生成器和判别器都学到了可以用于下游任务的语义特征。 3. 图像修复 形式: 我们可以通过随机去掉图像中的某个部分来生成成对的训练图像(损坏的,复原的)。 与超分辨率类似,我们可以利用基于GAN的架构,在此架构中,生成器可以学习如何重构图像,而discriminator则可以将真实图像和生成的图像分开。 对于下游任务,Pathak等人表明,在PASCAL VOC 2012语义分割的比赛上,生成器学到的语义特征相比随机初始化有10.2%的提升,对于分类和物体检测有<4%的提升。 4. 图像拼图 形式: 通过随机交换图像块生成训练对 即使只有9个小块,也是个有362880个可能的谜题。为了克服这个问题,只使用了可能排列的一个子集,例如具有最高汉明距离的64个排列。 假设我们使用如下所示的重排来更改图像。我们用64个排列中的第64个排列。 现在,为了恢复原始的小块,Noroozi等人提出了一个称为上下文无关网络(CFN)的神经网络,如下图所示。在这里,各个小块通过相同的共享权值的siamese卷积层传递。然后,将这些特征组合在一个全连接的层中。在输出中,模型必须预测在64个可能的排列类别中使用了哪个排列。如果我们知道排列的方式,我们就能解决这个难题。 为了解决拼图问题,模型需要学习识别零件是如何在一个物体中组装的,物体不同部分的相对位置和物体的形状。因此,这些表示对于下游的分类和检测任务是有用的。 5. 上下文预测 形式: 我们随机选取一个图像块以及其附近的一个图像块来组成训练图像对。 为了解决这个文本前的任务,Doersch等人使用了类似于拼图游戏的架构。我们通过两个siamese卷积神经网络传递图像块来提取特征,连接特征并对8个类进行分类,表示8个可能的邻居位置。 6. 几何变换识别 形式: 我们通过随机的旋转图像来生成有标注的图像(旋转图像,旋转角度)。 为了解决这个文本前的任务,Gidaris et al.提出了一种架构,其中旋转后的图像通过一个卷积神经网络,网络需要把它分成4类(0/90/270/360度)。 虽然这是一个非常简单的想法,但模型必须理解图像中物体的位置、类型和姿态才能完成这项任务,因此,学习到的表示方法对后续任务非常有用。 7. 图像聚类 形式: 把聚类的结果作为图像的标签生成训练图像样本和标注。 为了解决这个预备任务,Caron et al.提出了一种称为深度聚类的架构。在这里,首先对图像进行聚类,把聚类出的类别用作分类的类别。卷积神经网络的任务是预测输入图像的聚类标签。 8. 图像合成 形式: 通过使用游戏引擎生成合成图像并将其调整为真实图像来准备训练对(图像,属性)。 为了解决这个预备任务,任等人提出一个架构,使用共享权值的卷积网络在合成和真实图像上进行训练,然后鉴别器学会分类合成图像是否是一个真正的图像。由于对抗性,真实图像和合成图像之间的共享表示变得更好。 从视频中学习 1. 视频帧顺序识别 形式: 通过打乱视频中的视频帧来生成训练对(视频帧,正确的顺序)。 为了解决这个预备任务,Misra等人提出了一个架构,其中视频帧通过共享权重的ConvNets传递,模型必须确定帧的顺序是否正确。在此过程中,该模型不仅学习了空间特征,还考虑了时间特征。 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-03-03本文作者:ronghuaiyang本文来自:“AI公园公众号”,了解相关信息可以关注“AI公园”

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册