首页 文章 精选 留言 我的

精选列表

搜索[官方产品],共10000篇文章
优秀的个人博客,低调大师

android 官方文档中的一些错误收集

1,Intents and Intent Filters 中<data> 的 说明 原文: For example, in the following URI, content://com.example.project:200/folder/subfolder/etc the scheme is "content", the host is "com.example.project", the port is "200", and the path is "folder/subfolder/etc". The host and port together constitute the URIauthority; if a host is not specified, the port is ignored. 这里的错误的地方在于path=”folder/subfolder/etc” 而实际上path=”/folder/subfolder/etc” 在首位应该还有一个分隔符,少了这个分隔符,将无法匹配<data> 由android 2.2 测试实际方法得出: ps:有同样的错误的文章 Content Providers 中 Content URI Summary C 项的解释 本文转自 liam2199 博客,原文链接:http://blog.51cto.com/youxilua/773123如需转载请自行联系原作者

优秀的个人博客,低调大师

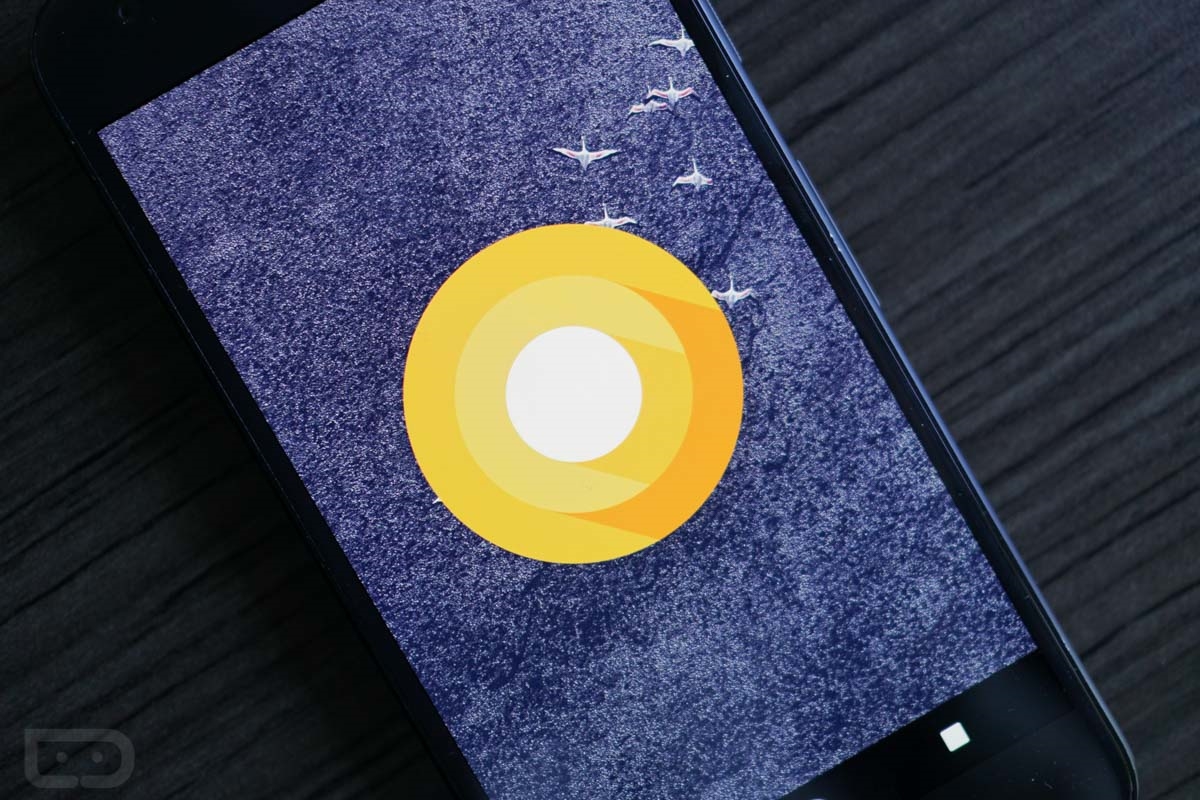
谷歌官方确认:Android O 的版本号为 8.0

今天,谷歌为参与 Android Beta 的用户推送了全新的 Android O 系统,也就是第三个开发者预览版。 系统标签是 OPP3.170518.006,支持 Nexus 5X, Nexus 6P, Pixel, Pixel XL, Pixel C 以及 Nexus Player 等在内的设备,目前,工厂镜像也已经可以下载。 同时,毫无悬念的,已经升级的设备中,系统版本号也正式确定为 Android 8.0(此前 IDE 工具曾暗示其版本号可能是 7+)。虽然 Android O 的版本号已确定,但正式名称依然没有公布(奥利奥?)。 按照谷歌目前公布的特性,安卓 8.0 的 APP 启动速度快了 2 倍,同时对后台管理进行了深度优化,续航长效提升。 那么问题来了,有多少人已经用上 7.0 了呢? 本文来自开源中国社区 [http://www.oschina.net]

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 定义 Storm 的非 JVM 语言 DSL

实现非 JVM 语言 DSL(Domain Specific Language,领域专用语言)应该从storm-core/src/storm.thrift文件开始。由于 Storm 拓扑是 Thrift 结构,而且 Nimbus 是一个 Thrift 后台进程,你可以以任意语言创建并提交拓扑。 当你创建 Thrift 结构的 spouts 与 bolts 时,spout 或者 bolt 的代码是以 ComponentObject 结构体的形式定义的: union ComponentObject { 1: binary serialized_java; 2: ShellComponent shell; 3: JavaObject java_object; } 对于非 JVM 语言 DSL(这里以 Python DSL 为例),你需要使用其中的 “2” 与 “3”。ShellComponent 负责指定运行该组件(例如你的 python 代码)的脚本,而 JavaObject 则负责指定该组件的本地(native)Java spouts 与 bolts(而且 Storm 也会使用反射来创建 spout 或者 bolt)。 “storm shell” 命令可以用于提交拓扑。下面是一个示例: storm shell resources/ python topology.py arg1 arg2 Storm shell 随后会将resources/打包到一个 jar 文件中,将该文件上传到 Nimbus,然后像这样调用你的 topology.py 脚本: python topology.py arg1 arg2 {nimbus-host} {nimbus-port} {uploaded-jar-location} 接着你就可以使用 Thrift API 连接到 Nimbus 来提交拓扑,并将上传的 jar 文件地址作为参数传入 submitTopology 方法中。作为参考,下面给出了 submitTopology 的定义: void submitTopology(1: string name, 2: string uploadedJarLocation, 3: string jsonConf, 4: StormTopology topology) throws (1: AlreadyAliveException e, 2: InvalidTopologyException ite); 最后,对于非 JVM DSL 还有一件非常重要的事就是要确保可以在一个文件中方便地定义出完整的拓扑(bolts,spouts,以及拓扑的其他部分定义)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(二)

编程方式定义Schema Scala Java Python 如果不能事先通过case class定义schema(例如,记录的字段结构是保存在一个字符串,或者其他文本数据集中,需要先解析,又或者字段对不同用户有所不同),那么你可能需要按以下三个步骤,以编程方式的创建一个DataFrame: 从已有的RDD创建一个包含Row对象的RDD 用StructType创建一个schema,和步骤1中创建的RDD的结构相匹配 把得到的schema应用于包含Row对象的RDD,调用这个方法来实现这一步:SQLContext.createDataFrame For example: 例如: // sc 是已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 创建一个RDD val people = sc.textFile("examples/src/main/resources/people.txt") // 数据的schema被编码与一个字符串中 val schemaString = "name age" // Import Row. import org.apache.spark.sql.Row; // Import Spark SQL 各个数据类型 import org.apache.spark.sql.types.{StructType,StructField,StringType}; // 基于前面的字符串生成schema val schema = StructType( schemaString.split(" ").map(fieldName => StructField(fieldName, StringType, true))) // 将RDD[people]的各个记录转换为Rows,即:得到一个包含Row对象的RDD val rowRDD = people.map(_.split(",")).map(p => Row(p(0), p(1).trim)) // 将schema应用到包含Row对象的RDD上,得到一个DataFrame val peopleDataFrame = sqlContext.createDataFrame(rowRDD, schema) // 将DataFrame注册为table peopleDataFrame.registerTempTable("people") // 执行SQL语句 val results = sqlContext.sql("SELECT name FROM people") // SQL查询的结果是DataFrame,且能够支持所有常见的RDD算子 // 并且其字段可以以索引访问,也可以用字段名访问 results.map(t => "Name: " + t(0)).collect().foreach(println) 数据源 Spark SQL支持基于DataFrame操作一系列不同的数据源。DataFrame既可以当成一个普通RDD来操作,也可以将其注册成一个临时表来查询。把DataFrame注册为table之后,你就可以基于这个table执行SQL语句了。本节将描述加载和保存数据的一些通用方法,包含了不同的Spark数据源,然后深入介绍一下内建数据源可用选项。 通用加载/保存函数 在最简单的情况下,所有操作都会以默认类型数据源来加载数据(默认是Parquet,除非修改了spark.sql.sources.default 配置)。 Scala Java Python R val df = sqlContext.read.load("examples/src/main/resources/users.parquet") df.select("name", "favorite_color").write.save("namesAndFavColors.parquet") 手动指定选项 你也可以手动指定数据源,并设置一些额外的选项参数。数据源可由其全名指定(如,org.apache.spark.sql.parquet),而对于内建支持的数据源,可以使用简写名(json, parquet, jdbc)。任意类型数据源创建的DataFrame都可以用下面这种语法转成其他类型数据格式。 Scala Java Python R val df = sqlContext.read.format("json").load("examples/src/main/resources/people.json") df.select("name", "age").write.format("parquet").save("namesAndAges.parquet") 直接对文件使用SQL Spark SQL还支持直接对文件使用SQL查询,不需要用read方法把文件加载进来。 Scala Java Python R val df = sqlContext.sql("SELECT * FROM parquet.`examples/src/main/resources/users.parquet`") 保存模式 Save操作有一个可选参数SaveMode,用这个参数可以指定如何处理数据已经存在的情况。很重要的一点是,这些保存模式都没有加锁,所以其操作也不是原子性的。另外,如果使用Overwrite模式,实际操作是,先删除数据,再写新数据。 仅Scala/Java 所有支持的语言 含义 SaveMode.ErrorIfExists(default) "error"(default) (默认模式)从DataFrame向数据源保存数据时,如果数据已经存在,则抛异常。 SaveMode.Append "append" 如果数据或表已经存在,则将DataFrame的数据追加到已有数据的尾部。 SaveMode.Overwrite "overwrite" 如果数据或表已经存在,则用DataFrame数据覆盖之。 SaveMode.Ignore "ignore" 如果数据已经存在,那就放弃保存DataFrame数据。这和SQL里CREATE TABLE IF NOT EXISTS有点类似。 保存到持久化表 在使用HiveContext的时候,DataFrame可以用saveAsTable方法,将数据保存成持久化的表。与registerTempTable不同,saveAsTable会将DataFrame的实际数据内容保存下来,并且在HiveMetastore中创建一个游标指针。持久化的表会一直保留,即使Spark程序重启也没有影响,只要你连接到同一个metastore就可以读取其数据。读取持久化表时,只需要用用表名作为参数,调用SQLContext.table方法即可得到对应DataFrame。 默认情况下,saveAsTable会创建一个”managed table“,也就是说这个表数据的位置是由metastore控制的。同样,如果删除表,其数据也会同步删除。 Parquet文件 Parquet是一种流行的列式存储格式。Spark SQL提供对Parquet文件的读写支持,而且Parquet文件能够自动保存原始数据的schema。写Parquet文件的时候,所有的字段都会自动转成nullable,以便向后兼容。 编程方式加载数据 仍然使用上面例子中的数据: Scala Java Python R Sql // 我们继续沿用之前例子中的sqlContext对象 // 为了支持RDD隐式转成DataFrame import sqlContext.implicits._ val people: RDD[Person] = ... // 和上面例子中相同,一个包含case class对象的RDD // 该RDD将隐式转成DataFrame,然后保存为parquet文件 people.write.parquet("people.parquet") // 读取上面保存的Parquet文件(多个文件 - Parquet保存完其实是很多个文件)。Parquet文件是自描述的,文件中保存了schema信息 // 加载Parquet文件,并返回DataFrame结果 val parquetFile = sqlContext.read.parquet("people.parquet") // Parquet文件(多个)可以注册为临时表,然后在SQL语句中直接查询 parquetFile.registerTempTable("parquetFile") val teenagers = sqlContext.sql("SELECT name FROM parquetFile WHERE age >= 13 AND age <= 19") teenagers.map(t => "Name: " + t(0)).collect().foreach(println) 分区发现 像Hive这样的系统,一个很常用的优化手段就是表分区。在一个支持分区的表中,数据是保存在不同的目录中的,并且将分区键以编码方式保存在各个分区目录路径中。Parquet数据源现在也支持自动发现和推导分区信息。例如,我们可以把之前用的人口数据存到一个分区表中,其目录结构如下所示,其中有2个额外的字段,gender和country,作为分区键: path └── to └── table ├── gender=male │ ├── ... │ │ │ ├── country=US │ │ └── data.parquet │ ├── country=CN │ │ └── data.parquet │ └── ... └── gender=female ├── ... │ ├── country=US │ └── data.parquet ├── country=CN │ └── data.parquet └── ... 在这个例子中,如果需要读取Parquet文件数据,我们只需要把 path/to/table 作为参数传给 SQLContext.read.parquet 或者 SQLContext.read.load。Spark SQL能够自动的从路径中提取出分区信息,随后返回的DataFrame的schema如下: root |-- name: string (nullable = true) |-- age: long (nullable = true) |-- gender: string (nullable = true) |-- country: string (nullable = true) 注意,分区键的数据类型将是自动推导出来的。目前,只支持数值类型和字符串类型数据作为分区键。 有的用户可能不想要自动推导出来的分区键数据类型。这种情况下,你可以通过 spark.sql.sources.partitionColumnTypeInference.enabled (默认是true)来禁用分区键类型推导。禁用之后,分区键总是被当成字符串类型。 从Spark-1.6.0开始,分区发现默认只在指定目录的子目录中进行。以上面的例子来说,如果用户把 path/to/table/gender=male 作为参数传给 SQLContext.read.parquet 或者 SQLContext.read.load,那么gender就不会被作为分区键。如果用户想要指定分区发现的基础目录,可以通过basePath选项指定。例如,如果把 path/to/table/gender=male作为数据目录,并且将basePath设为 path/to/table,那么gender仍然会最为分区键。 Schema合并 像ProtoBuffer、Avro和Thrift一样,Parquet也支持schema演变。用户从一个简单的schema开始,逐渐增加所需的新字段。这样的话,用户最终会得到多个schema不同但互相兼容的Parquet文件。目前,Parquet数据源已经支持自动检测这种情况,并合并所有文件的schema。 因为schema合并相对代价比较大,并且在多数情况下不是必要的,所以从Spark-1.5.0之后,默认是被禁用的。你可以这样启用这一功能: 读取Parquet文件时,将选项mergeSchema设为true(见下面的示例代码) 或者,将全局选项spark.sql.parquet.mergeSchema设为true Scala Python R // 继续沿用之前的sqlContext对象 // 为了支持RDD隐式转换为DataFrame import sqlContext.implicits._ // 创建一个简单的DataFrame,存到一个分区目录中 val df1 = sc.makeRDD(1 to 5).map(i => (i, i * 2)).toDF("single", "double") df1.write.parquet("data/test_table/key=1") // 创建另一个DataFrame放到新的分区目录中, // 并增加一个新字段,丢弃一个老字段 val df2 = sc.makeRDD(6 to 10).map(i => (i, i * 3)).toDF("single", "triple") df2.write.parquet("data/test_table/key=2") // 读取分区表 val df3 = sqlContext.read.option("mergeSchema", "true").parquet("data/test_table") df3.printSchema() // 最终的schema将由3个字段组成(single,double,triple) // 并且分区键出现在目录路径中 // root // |-- single: int (nullable = true) // |-- double: int (nullable = true) // |-- triple: int (nullable = true) // |-- key : int (nullable = true) Hive metastore Parquet table转换 在读写Hive metastore Parquet 表时,Spark SQL用的是内部的Parquet支持库,而不是Hive SerDe,因为这样性能更好。这一行为是由spark.sql.hive.convertMetastoreParquet 配置项来控制的,而且默认是启用的。 Hive/Parquet schema调和 Hive和Parquet在表结构处理上主要有2个不同点: Hive大小写敏感,而Parquet不是 Hive所有字段都是nullable的,而Parquet需要显示设置 由于以上原因,我们必须在Hive metastore Parquet table转Spark SQL Parquet table的时候,对Hive metastore schema做调整,调整规则如下: 两种schema中字段名和字段类型必须一致(不考虑nullable)。调和后的字段类型必须在Parquet格式中有相对应的数据类型,所以nullable是也是需要考虑的。 调和后Spark SQL Parquet table schema将包含以下字段: 只出现在Parquet schema中的字段将被丢弃 只出现在Hive metastore schema中的字段将被添加进来,并显式地设为nullable。 刷新元数据 Spark SQL会缓存Parquet元数据以提高性能。如果Hive metastore Parquet table转换被启用的话,那么转换过来的schema也会被缓存。这时候,如果这些表由Hive或其他外部工具更新了,你必须手动刷新元数据。 Scala Java Python Sql // 注意,这里sqlContext是一个HiveContext sqlContext.refreshTable("my_table") 配置 Parquet配置可以通过 SQLContext.setConf 或者 SQL语句中 SET key=value来指定。 属性名 默认值 含义 spark.sql.parquet.binaryAsString false 有些老系统,如:特定版本的Impala,Hive,或者老版本的Spark SQL,不区分二进制数据和字符串类型数据。这个标志的意思是,让Spark SQL把二进制数据当字符串处理,以兼容老系统。 spark.sql.parquet.int96AsTimestamp true 有些老系统,如:特定版本的Impala,Hive,把时间戳存成INT96。这个配置的作用是,让Spark SQL把这些INT96解释为timestamp,以兼容老系统。 spark.sql.parquet.cacheMetadata true 缓存Parquet schema元数据。可以提升查询静态数据的速度。 spark.sql.parquet.compression.codec gzip 设置Parquet文件的压缩编码格式。可接受的值有:uncompressed, snappy, gzip(默认), lzo spark.sql.parquet.filterPushdown true 启用过滤器下推优化,可以讲过滤条件尽量推导最下层,已取得性能提升 spark.sql.hive.convertMetastoreParquet true 如果禁用,Spark SQL将使用Hive SerDe,而不是内建的对Parquet tables的支持 spark.sql.parquet.output.committer.class org.apache.parquet.hadoop. ParquetOutputCommitter Parquet使用的数据输出类。这个类必须是 org.apache.hadoop.mapreduce.OutputCommitter的子类。一般来说,它也应该是 org.apache.parquet.hadoop.ParquetOutputCommitter的子类。注意:1. 如果启用spark.speculation, 这个选项将被自动忽略 2. 这个选项必须用hadoop configuration设置,而不是Spark SQLConf 3. 这个选项会覆盖 spark.sql.sources.outputCommitterClass Spark SQL有一个内建的org.apache.spark.sql.parquet.DirectParquetOutputCommitter, 这个类的在输出到S3的时候比默认的ParquetOutputCommitter类效率高。 spark.sql.parquet.mergeSchema false 如果设为true,那么Parquet数据源将会merge 所有数据文件的schema,否则,schema是从summary file获取的(如果summary file没有设置,则随机选一个) 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(三)

JSON数据集 Scala Java Python R Sql Spark SQL在加载JSON数据的时候,可以自动推导其schema并返回DataFrame。用SQLContext.read.json读取一个包含String的RDD或者JSON文件,即可实现这一转换。 注意,通常所说的json文件只是包含一些json数据的文件,而不是我们所需要的JSON格式文件。JSON格式文件必须每一行是一个独立、完整的的JSON对象。因此,一个常规的多行json文件经常会加载失败。 // sc是已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 数据集是由路径指定的 // 路径既可以是单个文件,也可以还是存储文本文件的目录 val path = "examples/src/main/resources/people.json" val people = sqlContext.read.json(path) // 推导出来的schema,可由printSchema打印出来 people.printSchema() // root // |-- age: integer (nullable = true) // |-- name: string (nullable = true) // 将DataFrame注册为table people.registerTempTable("people") // 跑SQL语句吧! val teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") // 另一种方法是,用一个包含JSON字符串的RDD来创建DataFrame val anotherPeopleRDD = sc.parallelize( """{"name":"Yin","address":{"city":"Columbus","state":"Ohio"}}""" :: Nil) val anotherPeople = sqlContext.read.json(anotherPeopleRDD) Hive表 Spark SQL支持从Apache Hive读写数据。然而,Hive依赖项太多,所以没有把Hive包含在默认的Spark发布包里。要支持Hive,需要在编译spark的时候增加-Phive和-Phive-thriftserver标志。这样编译打包的时候将会把Hive也包含进来。注意,hive的jar包也必须出现在所有的worker节点上,访问Hive数据时候会用到(如:使用hive的序列化和反序列化SerDes时)。 Hive配置在conf/目录下hive-site.xml,core-site.xml(安全配置),hdfs-site.xml(HDFS配置)文件中。请注意,如果在YARN cluster(yarn-cluster mode)模式下执行一个查询的话,lib_mananged/jar/下面的datanucleus 的jar包,和conf/下的hive-site.xml必须在驱动器(driver)和所有执行器(executor)都可用。一种简便的方法是,通过spark-submit命令的–jars和–file选项来提交这些文件。 Scala Java Python R 如果使用Hive,则必须构建一个HiveContext,HiveContext是派生于SQLContext的,添加了在Hive Metastore里查询表的支持,以及对HiveQL的支持。用户没有现有的Hive部署,也可以创建一个HiveContext。如果没有在hive-site.xml里配置,那么HiveContext将会自动在当前目录下创建一个metastore_db目录,再根据HiveConf设置创建一个warehouse目录(默认/user/hive/warehourse)。所以请注意,你必须把/user/hive/warehouse的写权限赋予启动spark应用程序的用户。 // sc是一个已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.hive.HiveContext(sc) sqlContext.sql("CREATE TABLE IF NOT EXISTS src (key INT, value STRING)") sqlContext.sql("LOAD DATA LOCAL INPATH 'examples/src/main/resources/kv1.txt' INTO TABLE src") // 这里用的是HiveQL sqlContext.sql("FROM src SELECT key, value").collect().foreach(println) 和不同版本的Hive Metastore交互 Spark SQL对Hive最重要的支持之一就是和Hive metastore进行交互,这使得Spark SQL可以访问Hive表的元数据。从Spark-1.4.0开始,Spark SQL有专门单独的二进制build版本,可以用来访问不同版本的Hive metastore,其配置表如下。注意,不管所访问的hive是什么版本,Spark SQL内部都是以Hive 1.2.1编译的,而且内部使用的Hive类也是基于这个版本(serdes,UDFs,UDAFs等) 以下选项可用来配置Hive版本以便访问其元数据: 属性名 默认值 含义 spark.sql.hive.metastore.version 1.2.1 Hive metastore版本,可选的值为0.12.0 到 1.2.1 spark.sql.hive.metastore.jars builtin 初始化HiveMetastoreClient的jar包。这个属性可以是以下三者之一: builtin 目前内建为使用Hive-1.2.1,编译的时候启用-Phive,则会和spark一起打包。如果没有-Phive,那么spark.sql.hive.metastore.version要么是1.2.1,要就是未定义 maven 使用maven仓库下载的jar包版本。这个选项建议不要再生产环境中使用 JVM格式的classpath。这个classpath必须包含所有Hive及其依赖的jar包,且包含正确版本的hadoop。这些jar包必须部署在driver节点上,如果你使用yarn-cluster模式,那么必须确保这些jar包也随你的应用程序一起打包 spark.sql.hive.metastore.sharedPrefixes com.mysql.jdbc, org.postgresql, com.microsoft.sqlserver, oracle.jdbc 一个逗号分隔的类名前缀列表,这些类使用classloader加载,且可以在Spark SQL和特定版本的Hive间共享。例如,用来访问hive metastore 的JDBC的driver就需要这种共享。其他需要共享的类,是与某些已经共享的类有交互的类。例如,自定义的log4j appender spark.sql.hive.metastore.barrierPrefixes (empty) 一个逗号分隔的类名前缀列表,这些类在每个Spark SQL所访问的Hive版本中都会被显式的reload。例如,某些在共享前缀列表(spark.sql.hive.metastore.sharedPrefixes)中声明为共享的Hive UD函数 用JDBC连接其他数据库 Spark SQL也可以用JDBC访问其他数据库。这一功能应该优先于使用JdbcRDD。因为它返回一个DataFrame,而DataFrame在Spark SQL中操作更简单,且更容易和来自其他数据源的数据进行交互关联。JDBC数据源在java和python中用起来也很简单,不需要用户提供额外的ClassTag。(注意,这与Spark SQL JDBC server不同,Spark SQLJDBC server允许其他应用执行Spark SQL查询) 首先,你需要在spark classpath中包含对应数据库的JDBC driver,下面这行包括了用于访问postgres的数据库driver SPARK_CLASSPATH=postgresql-9.3-1102-jdbc41.jar bin/spark-shell 远程数据库的表可以通过Data Sources API,用DataFrame或者SparkSQL 临时表来装载。以下是选项列表: 属性名 含义 url 需要连接的JDBC URL dbtable 需要读取的JDBC表。注意,任何可以填在SQL的where子句中的东西,都可以填在这里。(既可以填完整的表名,也可填括号括起来的子查询语句) driver JDBC driver的类名。这个类必须在master和worker节点上都可用,这样各个节点才能将driver注册到JDBC的子系统中。 partitionColumn, lowerBound, upperBound, numPartitions 这几个选项,如果指定其中一个,则必须全部指定。他们描述了多个worker如何并行的读入数据,并将表分区。partitionColumn必须是所查询的表中的一个数值字段。注意,lowerBound和upperBound只是用于决定分区跨度的,而不是过滤表中的行。因此,表中所有的行都会被分区然后返回。 fetchSize JDBC fetch size,决定每次获取多少行数据。在JDBC驱动上设成较小的值有利于性能优化(如,Oracle上设为10) Scala Java Python R Sql val jdbcDF = sqlContext.read.format("jdbc").options( Map("url" -> "jdbc:postgresql:dbserver", "dbtable" -> "schema.tablename")).load() 疑难解答 JDBC driver class必须在所有client session或者executor上,对java的原生classloader可见。这是因为Java的DriverManager在打开一个连接之前,会做安全检查,并忽略所有对原声classloader不可见的driver。最简单的一种方法,就是在所有worker节点上修改compute_classpath.sh,并包含你所需的driver jar包。 一些数据库,如H2,会把所有的名字转大写。对于这些数据库,在Spark SQL中必须也使用大写。 性能调整 对于有一定计算量的Spark作业来说,可能的性能改进的方式,不是把数据缓存在内存里,就是调整一些开销较大的选项参数。 内存缓存 Spark SQL可以通过调用SQLContext.cacheTable(“tableName”)或者DataFrame.cache()把tables以列存储格式缓存到内存中。随后,Spark SQL将会扫描必要的列,并自动调整压缩比例,以减少内存占用和GC压力。你也可以用SQLContext.uncacheTable(“tableName”)来删除内存中的table。 你还可以使用SQLContext.setConf 或在SQL语句中运行SET key=value命令,来配置内存中的缓存。 属性名 默认值 含义 spark.sql.inMemoryColumnarStorage.compressed true 如果设置为true,Spark SQL将会根据数据统计信息,自动为每一列选择单独的压缩编码方式。 spark.sql.inMemoryColumnarStorage.batchSize 10000 控制列式缓存批量的大小。增大批量大小可以提高内存利用率和压缩率,但同时也会带来OOM(Out Of Memory)的风险。 其他配置选项 以下选项同样也可以用来给查询任务调性能。不过这些选项在未来可能被放弃,因为spark将支持越来越多的自动优化。 属性名 默认值 含义 spark.sql.autoBroadcastJoinThreshold 10485760 (10 MB) 配置join操作时,能够作为广播变量的最大table的大小。设置为-1,表示禁用广播。注意,目前的元数据统计仅支持Hive metastore中的表,并且需要运行这个命令:ANALYSE TABLE <tableName> COMPUTE STATISTICS noscan spark.sql.tungsten.enabled true 设为true,则启用优化的Tungsten物理执行后端。Tungsten会显式的管理内存,并动态生成表达式求值的字节码 spark.sql.shuffle.partitions 200 配置数据混洗(shuffle)时(join或者聚合操作),使用的分区数。 分布式SQL引擎 Spark SQL可以作为JDBC/ODBC或者命令行工具的分布式查询引擎。在这种模式下,终端用户或应用程序,无需写任何代码,就可以直接在Spark SQL中运行SQL查询。 运行Thrift JDBC/ODBC server 这里实现的Thrift JDBC/ODBC server和Hive-1.2.1中的HiveServer2是相同的。你可以使用beeline脚本来测试Spark或者Hive-1.2.1的JDBC server。 在Spark目录下运行下面这个命令,启动一个JDBC/ODBC server ./sbin/start-thriftserver.sh 这个脚本能接受所有 bin/spark-submit 命令支持的选项参数,外加一个 –hiveconf 选项,来指定Hive属性。运行./sbin/start-thriftserver.sh –help可以查看完整的选项列表。默认情况下,启动的server将会在localhost:10000端口上监听。要改变监听主机名或端口,可以用以下环境变量: export HIVE_SERVER2_THRIFT_PORT=<listening-port> export HIVE_SERVER2_THRIFT_BIND_HOST=<listening-host> ./sbin/start-thriftserver.sh \ --master <master-uri> \ ... 或者Hive系统属性 来指定 ./sbin/start-thriftserver.sh \ --hiveconf hive.server2.thrift.port=<listening-port> \ --hiveconf hive.server2.thrift.bind.host=<listening-host> \ --master <master-uri> ... 接下来,你就可以开始在beeline中测试这个Thrift JDBC/ODBC server: ./bin/beeline 下面的指令,可以连接到一个JDBC/ODBC server beeline> !connect jdbc:hive2://localhost:10000 可能需要输入用户名和密码。在非安全模式下,只要输入你本机的用户名和一个空密码即可。对于安全模式,请参考beeline documentation. Hive的配置是在conf/目录下的hive-site.xml,core-site.xml,hdfs-site.xml中指定的。 你也可以在beeline的脚本中指定。 Thrift JDBC server也支持通过HTTP传输Thrift RPC消息。以下配置(在conf/hive-site.xml中)将启用HTTP模式: hive.server2.transport.mode - Set this to value: http hive.server2.thrift.http.port - HTTP port number fo listen on; default is 10001 hive.server2.http.endpoint - HTTP endpoint; default is cliservice 同样,在beeline中也可以用HTTP模式连接JDBC/ODBC server: beeline> !connect jdbc:hive2://<host>:<port>/<database>?hive.server2.transport.mode=http;hive.server2.thrift.http.path=<http_endpoint> 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(一)

Spark SQL, DataFrames 以及 Datasets 编程指南 概要 Spark SQL是Spark中处理结构化数据的模块。与基础的Spark RDD API不同,Spark SQL的接口提供了更多关于数据的结构信息和计算任务的运行时信息。在Spark内部,Spark SQL会能够用于做优化的信息比RDD API更多一些。Spark SQL如今有了三种不同的API:SQL语句、DataFrame API和最新的Dataset API。不过真正运行计算的时候,无论你使用哪种API或语言,Spark SQL使用的执行引擎都是同一个。这种底层的统一,使开发者可以在不同的API之间来回切换,你可以选择一种最自然的方式,来表达你的需求。 本文中所有的示例都使用Spark发布版本中自带的示例数据,并且可以在spark-shell、pyspark shell以及sparkR shell中运行。 SQL Spark SQL的一种用法是直接执行SQL查询语句,你可使用最基本的SQL语法,也可以选择HiveQL语法。Spark SQL可以从已有的Hive中读取数据。更详细的请参考Hive Tables这一节。如果用其他编程语言运行SQL,Spark SQL将以DataFrame返回结果。你还可以通过命令行command-line或者JDBC/ODBC使用Spark SQL。 DataFrames DataFrame是一种分布式数据集合,每一条数据都由几个命名字段组成。概念上来说,她和关系型数据库的表 或者 R和Python中的data frame等价,只不过在底层,DataFrame采用了更多优化。DataFrame可以从很多数据源(sources)加载数据并构造得到,如:结构化数据文件,Hive中的表,外部数据库,或者已有的RDD。 DataFrame API支持Scala,Java,Python, andR。 Datasets Dataset是Spark-1.6新增的一种API,目前还是实验性的。Dataset想要把RDD的优势(强类型,可以使用lambda表达式函数)和Spark SQL的优化执行引擎的优势结合到一起。Dataset可以由JVM对象构建(constructed)得到,而后Dataset上可以使用各种transformation算子(map,flatMap,filter 等)。 Dataset API 对Scala和Java的支持接口是一致的,但目前还不支持Python,不过Python自身就有语言动态特性优势(例如,你可以使用字段名来访问数据,row.columnName)。对Python的完整支持在未来的版本会增加进来。 入门 入口:SQLContext Scala Java Python R Spark SQL所有的功能入口都是SQLContext类,及其子类。不过要创建一个SQLContext对象,首先需要有一个SparkContext对象。 val sc: SparkContext // 假设已经有一个 SparkContext 对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 用于包含RDD到DataFrame隐式转换操作 import sqlContext.implicits._ 除了SQLContext之外,你也可以创建HiveContext,HiveContext是SQLContext 的超集。 除了SQLContext的功能之外,HiveContext还提供了完整的HiveQL语法,UDF使用,以及对Hive表中数据的访问。要使用HiveContext,你并不需要安装Hive,而且SQLContext能用的数据源,HiveContext也一样能用。HiveContext是单独打包的,从而避免了在默认的Spark发布版本中包含所有的Hive依赖。如果这些依赖对你来说不是问题(不会造成依赖冲突等),建议你在Spark-1.3之前使用HiveContext。而后续的Spark版本,将会逐渐把SQLContext升级到和HiveContext功能差不多的状态。 spark.sql.dialect选项可以指定不同的SQL变种(或者叫SQL方言)。这个参数可以在SparkContext.setConf里指定,也可以通过 SQL语句的SET key=value命令指定。对于SQLContext,该配置目前唯一的可选值就是”sql”,这个变种使用一个Spark SQL自带的简易SQL解析器。而对于HiveContext,spark.sql.dialect默认值为”hiveql”,当然你也可以将其值设回”sql”。仅就目前而言,HiveSQL解析器支持更加完整的SQL语法,所以大部分情况下,推荐使用HiveContext。 创建DataFrame Spark应用可以用SparkContext创建DataFrame,所需的数据来源可以是已有的RDD(existingRDD),或者Hive表,或者其他数据源(data sources.) 以下是一个从JSON文件创建DataFrame的小栗子: Scala Java Python R val sc: SparkContext // 已有的 SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) val df = sqlContext.read.json("examples/src/main/resources/people.json") // 将DataFrame内容打印到stdout df.show() DataFrame操作 DataFrame提供了结构化数据的领域专用语言支持,包括Scala,Java,PythonandR. 这里我们给出一个结构化数据处理的基本示例: Scala Java Python R val sc: SparkContext // 已有的 SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 创建一个 DataFrame val df = sqlContext.read.json("examples/src/main/resources/people.json") // 展示 DataFrame 的内容 df.show() // age name // null Michael // 30 Andy // 19 Justin // 打印数据树形结构 df.printSchema() // root // |-- age: long (nullable = true) // |-- name: string (nullable = true) // select "name" 字段 df.select("name").show() // name // Michael // Andy // Justin // 展示所有人,但所有人的 age 都加1 df.select(df("name"), df("age") + 1).show() // name (age + 1) // Michael null // Andy 31 // Justin 20 // 筛选出年龄大于21的人 df.filter(df("age") > 21).show() // age name // 30 Andy // 计算各个年龄的人数 df.groupBy("age").count().show() // age count // null 1 // 19 1 // 30 1 DataFrame的完整API列表请参考这里:API Documentation 除了简单的字段引用和表达式支持之外,DataFrame还提供了丰富的工具函数库,包括字符串组装,日期处理,常见的数学函数等。完整列表见这里:DataFrame Function Reference. 编程方式执行SQL查询 SQLContext.sql可以执行一个SQL查询,并返回DataFrame结果。 Scala Java Python R val sqlContext = ... // 已有一个 SQLContext 对象 val df = sqlContext.sql("SELECT * FROM table") 创建Dataset Dataset API和RDD类似,不过Dataset不使用Java序列化或者Kryo,而是使用专用的编码器(Encoder)来序列化对象和跨网络传输通信。如果这个编码器和标准序列化都能把对象转字节,那么编码器就可以根据代码动态生成,并使用一种特殊数据格式,这种格式下的对象不需要反序列化回来,就能允许Spark进行操作,如过滤、排序、哈希等。 Scala Java // 对普通类型数据的Encoder是由 importing sqlContext.implicits._ 自动提供的 val ds = Seq(1, 2, 3).toDS() ds.map(_ + 1).collect() // 返回: Array(2, 3, 4) // 以下这行不仅定义了case class,同时也自动为其创建了Encoder case class Person(name: String, age: Long) val ds = Seq(Person("Andy", 32)).toDS() // DataFrame 只需提供一个和数据schema对应的class即可转换为 Dataset。Spark会根据字段名进行映射。 val path = "examples/src/main/resources/people.json" val people = sqlContext.read.json(path).as[Person] 和RDD互操作 Spark SQL有两种方法将RDD转为DataFrame。 1. 使用反射机制,推导包含指定类型对象RDD的schema。这种基于反射机制的方法使代码更简洁,而且如果你事先知道数据schema,推荐使用这种方式; 2. 编程方式构建一个schema,然后应用到指定RDD上。这种方式更啰嗦,但如果你事先不知道数据有哪些字段,或者数据schema是运行时读取进来的,那么你很可能需要用这种方式。 利用反射推导schema Scala Java Python Spark SQL的Scala接口支持自动将包含case class对象的RDD转为DataFrame。对应的case class定义了表的schema。case class的参数名通过反射,映射为表的字段名。case class还可以嵌套一些复杂类型,如Seq和Array。RDD隐式转换成DataFrame后,可以进一步注册成表。随后,你就可以对表中数据使用SQL语句查询了。 // sc 是已有的 SparkContext 对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 为了支持RDD到DataFrame的隐式转换 import sqlContext.implicits._ // 定义一个case class. // 注意:Scala 2.10的case class最多支持22个字段,要绕过这一限制, // 你可以使用自定义class,并实现Product接口。当然,你也可以改用编程方式定义schema case class Person(name: String, age: Int) // 创建一个包含Person对象的RDD,并将其注册成table val people = sc.textFile("examples/src/main/resources/people.txt").map(_.split(",")).map(p => Person(p(0), p(1).trim.toInt)).toDF() people.registerTempTable("people") // sqlContext.sql方法可以直接执行SQL语句 val teenagers = sqlContext.sql("SELECT name, age FROM people WHERE age >= 13 AND age <= 19") // SQL查询的返回结果是一个DataFrame,且能够支持所有常见的RDD算子 // 查询结果中每行的字段可以按字段索引访问: teenagers.map(t => "Name: " + t(0)).collect().foreach(println) // 或者按字段名访问: teenagers.map(t => "Name: " + t.getAs[String]("name")).collect().foreach(println) // row.getValuesMap[T] 会一次性返回多列,并以Map[String, T]为返回结果类型 teenagers.map(_.getValuesMap[Any](List("name", "age"))).collect().foreach(println) // 返回结果: Map("name" -> "Justin", "age" -> 19) 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(四)

使用Spark SQL命令行工具 Spark SQL CLI是一个很方便的工具,它可以用local mode运行hive metastore service,并且在命令行中执行输入的查询。注意Spark SQL CLI目前还不支持和Thrift JDBC server通信。 用如下命令,在spark目录下启动一个Spark SQL CLI ./bin/spark-sql Hive配置在conf目录下hive-site.xml,core-site.xml,hdfs-site.xml中设置。你可以用这个命令查看完整的选项列表:./bin/spark-sql –help 升级指南 1.5升级到1.6 从Spark-1.6.0起,默认Thrift server 将运行于多会话并存模式下(multi-session)。这意味着,每个JDBC/ODBC连接有其独立的SQL配置和临时函数注册表。table的缓存仍然是公用的。如果你更喜欢老的单会话模式,只需设置spark.sql.hive.thriftServer.singleSession为true即可。当然,你也可在spark-defaults.conf中设置,或者将其值传给start-thriftserver.sh –conf(如下): ./sbin/start-thriftserver.sh \ --conf spark.sql.hive.thriftServer.singleSession=true \ ... 1.4升级到1.5 Tungsten引擎现在默认是启用的,Tungsten是通过手动管理内存优化执行计划,同时也优化了表达式求值的代码生成。这两个特性都可以通过把spark.sql.tungsten.enabled设为false来禁用。 Parquet schema merging默认不启用。需要启用的话,设置spark.sql.parquet.mergeSchema为true即可 Python接口支持用点(.)来访问字段内嵌值,例如df[‘table.column.nestedField’]。但这也意味着,如果你的字段名包含点号(.)的话,你就必须用重音符来转义,如:table.`column.with.dots`.nested。 列式存储内存分区剪枝默认是启用的。要禁用,设置spark.sql.inMemoryColumarStorage.partitionPruning为false即可 不再支持无精度限制的decimal。Spark SQL现在强制最大精度为38位。对于BigDecimal对象,类型推导将会使用(38,18)精度的decimal类型。如果DDL中没有指明精度,默认使用的精度是(10,0) 时间戳精确到1us(微秒),而不是1ns(纳秒) 在“sql”这个SQL变种设置中,浮点数将被解析为decimal。HiveQL解析保持不变。 标准SQL/DataFrame函数均为小写,例如:sum vs SUM。 当推测任务被启用是,使用DirectOutputCommitter是不安全的,因此,DirectOutputCommitter在推测任务启用时,将被自动禁用,且忽略相关配置。 JSON数据源不再自动加载其他程序产生的新文件(例如,不是Spark SQL插入到dataset中的文件)。对于一个JSON的持久化表(如:Hive metastore中保存的表),用户可以使用REFRESH TABLE这个SQL命令或者HiveContext.refreshTable来把新文件包括进来。 1.3升级到1.4 DataFrame数据读写接口 根据用户的反馈,我们提供了一个新的,更加流畅的API,用于数据读(SQLContext.read)写(DataFrame.write),同时老的API(如:SQLCOntext.parquetFile, SQLContext.jsonFile)将被废弃。 有关SQLContext.read和DataFrame.write的更详细信息,请参考API文档。 DataFrame.groupBy保留分组字段 根据用户的反馈,我们改变了DataFrame.groupBy().agg()的默认行为,在返回的DataFrame结果中保留了分组字段。如果你想保持1.3中的行为,设置spark.sql.retainGroupColumns为false即可。 Scala Java Python // 在1.3.x中,如果要保留分组字段"department", 你必须显式的在agg聚合时包含这个字段 df.groupBy("department").agg($"department", max("age"), sum("expense")) // 而在1.4+,分组字段"department"默认就会包含在返回的DataFrame中 df.groupBy("department").agg(max("age"), sum("expense")) // 要回滚到1.3的行为(不包含分组字段),按如下设置即可: sqlContext.setConf("spark.sql.retainGroupColumns", "false") 1.2升级到1.3 在Spark 1.3中,我们去掉了Spark SQL的”Alpha“标签,并清理了可用的API。从Spark 1.3起,Spark SQL将对1.x系列二进制兼容。这个兼容性保证不包括显式的标注为”unstable(如:DeveloperAPI或Experimental)“的API。 SchemaRDD重命名为DataFrame 对于用户来说,Spark SQL 1.3最大的改动就是SchemaRDD改名为DataFrame。主要原因是,DataFrame不再直接由RDD派生,而是通过自己的实现提供RDD的功能。DataFrame只需要调用其rdd方法就能转成RDD。 在Scala中仍然有SchemaRDD,只不过这是DataFrame的一个别名,以便兼容一些现有代码。但仍然建议用户改用DataFrame。Java和Python用户就没这个福利了,他们必须改代码。 统一Java和Scala API 在Spark 1.3之前,有单独的java兼容类(JavaSQLContext和JavaSchemaRDD)及其在Scala API中的镜像。Spark 1.3中将Java API和Scala API统一。两种语言的用户都应该使用SQLContext和DataFrame。一般这些类中都会使用两种语言中都有的类型(如:Array取代各语言独有的集合)。有些情况下,没有通用的类型(例如:闭包或者maps),将会使用函数重载来解决这个问题。 另外,java特有的类型API被删除了。Scala和java用户都应该用org.apache.spark.sql.types来编程描述一个schema。 隐式转换隔离,DSL包移除 – 仅针对scala Spark 1.3之前的很多示例代码,都在开头用 import sqlContext._,这行将会导致所有的sqlContext的函数都被引入进来。因此,在Spark 1.3我们把RDDs到DataFrames的隐式转换隔离出来,单独放到SQLContext.implicits对象中。用户现在应该这样写:import sqlContext.implicits._ 另外,隐式转换也支持由Product(如:case classes或tuples)组成的RDD,但需要调用一个toDF方法,而不是自动转换。 如果需要使用DSL(被DataFrame取代的API)中的方法,用户之前需要导入DSL(import org.apache.spark.sql.catalyst.dsl), 而现在应该要导入 DataFrame API(import org.apache.spark.sql.functions._) 移除org.apache.spark.sql中DataType别名 –仅针对scala Spark 1.3删除了sql包中的DataType类型别名。现在,用户应该使用 org.apache.spark.sql.types中的类。 UDF注册挪到sqlContext.udf中 – 针对java和scala 注册UDF的函数,不管是DataFrame,DSL或者SQL中用到的,都被挪到SQLContext.udf中。 Scala Java sqlContext.udf.register("strLen", (s: String) => s.length()) Python UDF注册保持不变。 Python DataTypes不再是单例 在python中使用DataTypes,你需要先构造一个对象(如:StringType()),而不是引用一个单例。 Shark用户迁移指南 调度 用户可以通过如下命令,为JDBC客户端session设定一个Fair Schedulerpool。 SET spark.sql.thriftserver.scheduler.pool=accounting; Reducer个数 在Shark中,默认的reducer个数是1,并且由mapred.reduce.tasks设定。Spark SQL废弃了这个属性,改为 spark.sql.shuffle.partitions, 并且默认200,用户可通过如下SET命令来自定义: SET spark.sql.shuffle.partitions=10; SELECT page, count(*) c FROM logs_last_month_cached GROUP BY page ORDER BY c DESC LIMIT 10; 你也可以把这个属性放到hive-site.xml中来覆盖默认值。 目前,mapred.reduce.tasks属性仍然能被识别,并且自动转成spark.sql.shuffle.partitions 缓存 shark.cache表属性已经不存在了,并且以”_cached”结尾命名的表也不再会自动缓存。取而代之的是,CACHE TABLE和UNCACHE TABLE语句,用以显式的控制表的缓存: CACHE TABLE logs_last_month; UNCACHE TABLE logs_last_month; 注意:CACHE TABLE tbl 现在默认是饥饿模式,而非懒惰模式。再也不需要手动调用其他action来触发cache了! 从Spark-1.2.0开始,Spark SQL新提供了一个语句,让用户自己控制表缓存是否是懒惰模式 CACHE [LAZY] TABLE [AS SELECT] ... 以下几个缓存相关的特性不再支持: 用户定义分区级别的缓存逐出策略 RDD 重加载 内存缓存直接写入策略 兼容Apache Hive Spark SQL设计时考虑了和Hive metastore,SerDes以及UDF的兼容性。目前这些兼容性斗是基于Hive-1.2.1版本,并且Spark SQL可以连到不同版本的Hive metastore(从0.12.0到1.2.1,参考:http://spark.apache.org/docs/latest/sql-programming-guide.html#interacting-with-different-versions-of-hive-metastore) 部署在已有的Hive仓库之上 Spark SQL Thrift JDBC server采用了”out of the box”(开箱即用)的设计,使用很方便,并兼容已有的Hive安装版本。你不需要修改已有的Hive metastore或者改变数据的位置,或者表分区。 支持的Hive功能 Spark SQL 支持绝大部分Hive功能,如: Hive查询语句: SELECT GROUP BY ORDER BY CLUSTER BY SORT BY 所有的Hive操作符: Relational operators (=,⇔,==,<>,<,>,>=,<=, etc) Arithmetic operators (+,-,*,/,%, etc) Logical operators (AND,&&,OR,||, etc) Complex type constructors Mathematical functions (sign,ln,cos, etc) String functions (instr,length,printf, etc) 用户定义函数(UDF) 用户定义聚合函数(UDAF) 用户定义序列化、反序列化(SerDes) 窗口函数(Window functions) Joins JOIN {LEFT|RIGHT|FULL} OUTER JOIN LEFT SEMI JOIN CROSS JOIN Unions 查询子句 SELECT col FROM ( SELECT a + b AS col from t1) t2 采样 执行计划详细(Explain) 分区表,包括动态分区插入 视图 所有Hive DDL(data definition language): CREATE TABLE CREATE TABLE AS SELECT ALTER TABLE 绝大部分Hive数据类型: TINYINT SMALLINT INT BIGINT BOOLEAN FLOAT DOUBLE STRING BINARY TIMESTAMP DATE ARRAY<> MAP<> STRUCT<> 不支持的Hive功能 以下是目前不支持的Hive特性的列表。多数是不常用的。 不支持的Hive常见功能 bucket表:butcket是Hive表的一个哈希分区 不支持的Hive高级功能 UNION类操作 去重join 字段统计信息收集:Spark SQL不支持同步的字段统计收集 Hive输入、输出格式 CLI文件格式:对于需要回显到CLI中的结果,Spark SQL仅支持TextOutputFormat。 Hadoop archive —Hadoop归档 Hive优化 一些比较棘手的Hive优化目前还没有在Spark中提供。有一些(如索引)对应Spark SQL这种内存计算模型来说并不重要。另外一些,在Spark SQL未来的版本中会支持。 块级别位图索引和虚拟字段(用来建索引) 自动计算reducer个数(join和groupBy算子):目前在Spark SQL中你需要这样控制混洗后(post-shuffle)并发程度:”SET spark.sql.shuffle.partitions=[num_tasks];” 元数据查询:只查询元数据的请求,Spark SQL仍需要启动任务来计算结果 数据倾斜标志:Spark SQL不会理会Hive中的数据倾斜标志 STREAMTABLEjoin提示:Spark SQL里没有这玩艺儿 返回结果时合并小文件:如果返回的结果有很多小文件,Hive有个选项设置,来合并小文件,以避免超过HDFS的文件数额度限制。Spark SQL不支持这个。 参考 数据类型 Spark SQL和DataFrames支持如下数据类型: Numeric types(数值类型) ByteType: 1字节长的有符号整型,范围:-128到127. ShortType: 2字节长有符号整型,范围:-32768到32767. IntegerType: 4字节有符号整型,范围:-2147483648到2147483647. LongType: 8字节有符号整型,范围:-9223372036854775808to9223372036854775807. FloatType: 4字节单精度浮点数。 DoubleType: 8字节双精度浮点数 DecimalType:任意精度有符号带小数的数值。内部使用java.math.BigDecimal, BigDecimal包含任意精度的不缩放整型,和一个32位的缩放整型 String type(字符串类型) StringType: 字符串 Binary type(二进制类型) BinaryType: 字节序列 Boolean type(布尔类型) BooleanType: 布尔类型 Datetime type(日期类型) TimestampType: 表示包含年月日、时分秒等字段的日期 DateType: 表示包含年月日字段的日期 Complex types(复杂类型) ArrayType(elementType, containsNull):数组类型,表达一系列的elementType类型的元素组成的序列,containsNull表示数组能否包含null值 MapType(keyType, valueType, valueContainsNull):映射集合类型,表示一个键值对的集合。键的类型是keyType,值的类型则由valueType指定。对应MapType来说,键是不能为null的,而值能否为null则取决于valueContainsNull。 StructType(fields):表示包含StructField序列的结构体。 StructField(name, datatype, nullable): 表示StructType中的一个字段,name是字段名,datatype是数据类型,nullable表示该字段是否可以为空 Scala Java Python R 所有Spark SQL支持的数据类型都在这个包里:org.apache.spark.sql.types,你可以这样导入之: import org.apache.spark.sql.types._ Data type Value type in Scala API to access or create a data type ByteType Byte ByteType ShortType Short ShortType IntegerType Int IntegerType LongType Long LongType FloatType Float FloatType DoubleType Double DoubleType DecimalType java.math.BigDecimal DecimalType StringType String StringType BinaryType Array[Byte] BinaryType BooleanType Boolean BooleanType TimestampType java.sql.Timestamp TimestampType DateType java.sql.Date DateType ArrayType scala.collection.Seq ArrayType(elementType, [containsNull])注意:默认containsNull为true MapType scala.collection.Map MapType(keyType,valueType, [valueContainsNull])注意:默认valueContainsNull为true StructType org.apache.spark.sql.Row StructType(fields)注意:fields是一个StructFields的序列,并且同名的字段是不允许的。 StructField 定义字段的数据对应的Scala类型(例如,如果StructField的dataType为IntegerType,则其数据对应的scala类型为Int) StructField(name,dataType,nullable) NaN语义 这是Not-a-Number的缩写,某些float或double类型不符合标准浮点数语义,需要对其特殊处理: NaN == NaN,即:NaN和NaN总是相等 在聚合函数中,所有NaN分到同一组 NaN在join操作中可以当做一个普通的join key NaN在升序排序中排到最后,比任何其他数值都大 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》在Amazon EC2上运行Spark

在Amazon EC2上运行Spark Spark的ec2目录下有一个spark-ec2脚本,可以帮助你在Amazon EC2上启动、管理、关闭Spark集群。该脚本能在EC2集群上自动设置好Spark和HDFS。本文将会详细描述如何利用spark-ec2脚本来启动和关闭集群,以及如何在集群提交作业。当然,首先你必须在Amazon Web Services site上注册一个EC2的账户。 spark-ec2可以管理多个命名集群。你可以用它来启动一个新集群(需要提供集群大小和集群名称),关闭一个已有的集群,或者登陆到一个集群。每一个集群的机器将会被划分到不同的EC2安全组(EC2 security groups)当中,而这些安全组的名字是由集群的名称派生而来。例如,对于一个命名为test的集群,其主节点(master)将被分到一个叫test-master的安全组,而其他从节点(slave)将被分配到test-slaves安全组。spark-ec2脚本会自动根据你提供的集群名称,来创建安全组。你可以在EC2的控制台(Amazon EC2 Console)中使用这些名字。 准备工作 首先,你需要创建Amazon EC2 key pair。这需要登陆Amazon Web Services账号,在AWS控制台(AWS console)上点击侧边栏上的Key Pairs来创建,并下载。同时,你要确保给这私匙文件附上600权限(即:可读可写)以便使用ssh登陆。 使用spark-ec2的时候,一定要设置好这两个环境变量,AWS_ACCESS_KEY_ID和AWS_SECRET_ACCESS_KEY,并使其指向你的Amazon EC2 access key ID和secret access key。这些都可以在AWS主页(AWS homepage)上,点击 Account > Security Credentials > Access Credentials获得。 启动集群 切换到你下载的spark的ec2目录下 运行命令./spark-ec2 -k <keypair> -i <key-file> -s <num-slaves> launch <cluster-name>,其中<keypair>是你的Amazon EC2 key pair的名字(你创建Amazon EC2 key pair的时候所指定的名字),<key-file>是Amazon EC2 key pair的私钥(private key)文件,<num-slaves>是slave节点个数(至少是1),<cluster-name>是你指定的集群名称。 例如: bash exportAWS_SECRET_ACCESS_KEY=AaBbCcDdEeFGgHhIiJjKkLlMmNnOoPpQqRrSsTtU \ export AWS_ACCESS_KEY_ID=ABCDEFG1234567890123 ./spark-ec2 --key-pair=awskey \ --identity-file=awskey.pem \ --region=us-west-1 \ --zone=us-west-1a \ launch my-spark-cluster 集群启动完成后,检查一下集群调度器是否启动,同时,你可以在Web UI上查看是否所有的slave节点都正确的展示出来了,Web UI的链接在脚本执行完以后会打印在屏幕上(通常这个链接是 http://<master-hostname>:8080) 你可以运行./spark-ec2 –help 来查看更多的选项。以下是比较重要的一些选项: –instance-type=<instance-type> 可以指定EC2机器的实例类型。目前,该脚本只支持64-bit的实例类型。 –region=<ec2-region>可以指定EC2集群部署于哪个地域,默认地域是 us-east-1。 –zone=<ec2-zone>可以指定EC2集群实例部署在哪些地区(EC2的可用地区)。指定这个参数时注意,有时候因为在某些地区可能出现容量不够,因此你可能需要在其他地区启动EC2集群。 –ebs-vol-size=<GB>可以在每个节点上附加一个EBS(弹性可持续存储)卷,并指定其总容量,这些存储时可持久化的,即使集群重启也不会丢失。 –spot-price=<price> 将启动竞价型实例(Spot Instances)工作节点,这些节点可以按需分配,可竞价,并且可以设定竞价最高价格(以美元计)。 –spark-version=<version> 可以在集群中预先加载指定版本的spark。<version>可以是一个版本号(如:0.7.3)或者是一个git hash值。默认会使用最新版本的spark。 –spark-git-repo=<repository url> 可以指定一个自定义的git库,从而下载并部署该git库中特定的spark构建版本。默认使用Apache Github mirror。如果同时指定了spark版本,那么–spark-version参数值不能使用版本号,而必须是一个git提交对应的git commit hash(如:317e114)。 如果启动过程中由于某些原因失败了(如:没有给private key文件设定正确的文件权限),你可以用–resume选项来重启并继续已有集群的部署过程。 在VPC(Amazon Virtual Private Cloud)上启动集群 运行 ./spark-ec2 -k <keypair> -i <key-file> -s <num-slaves> –vpc-id=<vpc-id> -subnet-id=<subnet-id> launch <cluster-name>,其中,<keypair>是你的EC2 key pair(之前已经创建的),<key-file>是key pair中的私钥文件,<num-slaves>是从节点个数(如果你是第一次用,可以先设成1),<vpc-id>是VPC的名称,<subnet-id> 是你的子网名称,最后<cluster-name>是你的集群名称。 例如: bash export AWS_SECRET_ACCESS_KEY=AaBbCcDdEeFGgHhIiJjKkLlMmNnOoPpQqRrSsTtU \ export AWS_ACCESS_KEY_ID=ABCDEFG1234567890123 ./spark-ec2 --key-pair=awskey \ --identity-file=awskey.pem \ --region=us-west-1 \ --zone=us-west-1a \ --vpc-id=vpc-a28d24c7 \ --subnet-id=subnet-4eb27b39 \ --spark-version=1.1.0 \ launch my-spark-cluster 运行应用 转到你下载的spark的ec2目录下 执行./spark-ec2 -k <keypair> -i <key-file> login <cluster-name>远程登录到你的EC2集群,其中,<keypair>和<key-file>的说明见本文上面(这里只是为了方便说明,你也可以使用EC2的控制台) 如果需要把代码或数据部署到EC2集群中,你可以在登录后,使用脚本 ~/spark-ec2/copy-dir,并指定一个需要RSYNC同步到所有从节点(slave)上的目录。 如果你的应用需要访问一个很大的数据集,最快的方式就是从Amazon S3或者Amazon EBS设备上加载这些数据,然后放到你集群中的HDFS上。spark-ec2脚本已经为你设置好了一个HDFS,其安装目录为/root/ephemeral-hdfs,并且可以使用该目录下的bin/hadoop脚本访问。需要特别注意的是,这个HDFS上的数据,在集群停止或重启后,会被自动删掉。 集群中也有可以持久的HDFS,其安装路径为/root/persistent-hdfs,这个HDFS保存的数据即使集群重启也不会丢失。但一般情况下,这个HDFS在每个节点上可使用的空间较少(约为3GB),你可以用spark-ec2的选项–ebs-vol-size来指定每个节点上持久化HDFS所使用的空间大小。 最后,如果你的应用出错,你可以看看改应用在slave节点的日志,日志位于调度器工作目录下(/root/spark/work)。当然,你也可以通过web UI(http://<master-hostname>:8080)查看一下集群状态。 配置 你可以编辑每个节点上的/root/spark/conf/spark-env.sh文件来设置Spark配置选项(如:JVM选项参数)。这个文件一旦更改,你必须将其复制到集群中所有节点上。最简单的方式仍然是使用 copy-dir 这个脚本。首先,编辑主节点(master)上的spark-env.sh文件,然后,运行 ~/spark-ec2/copy-dir /root/spark/conf 将conf目录RSYNC到所有工作节点上。 configuration guide这一边文档说明了有哪些可用的选项配置。 终止集群 请注意,如果EC2节点被关闭后,是没有办法恢复其数据的!所以,请务必确保在关闭节点之前,将所有重要的数据复制出来,备份好。 切换到spark下的ec2目录 运行命令 ./spark-ec2 destroy <cluster-name> 暂停和重启集群 spark-ec2脚本同样支持暂停集群。这种情况下,集群实例所使用的虚拟机都是被停止,但不会销毁,所以虚拟机上临时盘数据都会丢失,但root分区以及持久HDFS(persistent-hdfs)上的数据不会丢失。停止机器实例不会多花EC2周期(意味着不用为机器实例付费),但会持续EBS存储的计费。 要停止一个集群,你需要切到ec2目录下,运行 ./spark-ec2 –region=<ec2-region> stop <cluster-name> 如果过后又要重启,请运行 ./spark-ec2 -i <key-file> –region=<ec2-region> start <cluster-name> 如果需要最终销毁这个集群,并且不再占用EBS存储空间,需要运行 ./spark-ec2 –region=<ec2-region> destroy <cluster-name>(如前一小节所述) 限制 对“集群计算”的支持有个限制 – 无法指定一个局部群组。不过,你可以在<cluster-name>-slaves群组中手工启动一些slave节点,然后用 spark-ec2 launch –resume 这个命令将手工启动的节点组成一个集群。 如果你发现一些新的限制或者有什么建议,欢迎贡献(contribute)到社区。 访问S3上的数据 Spark文件接口允许你通过相同的URI格式访问所有在Amazon S3上的数据,当然这些数据格式必须是Hadoop所支持的。你可以通过这种URI格式指定S3路径 s3n://<bucket>/path。在启动Spark集群的时候,可以使用选项–copy-aws-credentials来指定访问S3的AWS证书。更完整的访问S3所需的Hadoop库可以在这里查看Hadoop S3 page. 另外,访问S3的时候,你不仅可以将单个文件路径作为输入,同时也可以将整个目录路径作为输入。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册