首页 文章 精选 留言 我的

精选列表

搜索[国产算力],共10000篇文章
优秀的个人博客,低调大师

华虹半导体发力国际MCU市场

华虹半导体宣布,2016年上半年微控制器芯片出货量达12亿颗,较去年同期增长50%,创历史新高。凭借其全面的嵌入式非易失性存储器(eNVM)技术解决方案及支持包括汽车级闪存在内的8位至32位MCU产品,华虹半导体大力拓展物联网(IoT)市场,积极加强与世界级一流客户的合作,不断扩大在MCU产品代工领域的业务版图。 在迅速发展的MCU市场趋势下,华虹半导体为客户提供全面、灵活及具成本效益的解决方案,可与物联网、可穿戴设备、智能电网、嵌入式智能连接设备、医疗电子设备以及智能照明、工业及汽车电子设备等诸多节能智能产品完美结合。华虹半导体通过eFlash/eEEPROM工艺平台提供定制化的Flash IP/EEPROM IP——读速度可达60MHz的高速IP与IP静态电流低于0.1μA的低功耗。此平台在保持良好性能的同时兼备高可靠性,长达100年的数据保存时间和高达10万次的擦写次数,可以帮助客户发展高规格的MCU产品,满足各种多元化应用。 本文转自d1net(转载)

优秀的个人博客,低调大师

商用市场发力,Chromebook 销量超 Mac

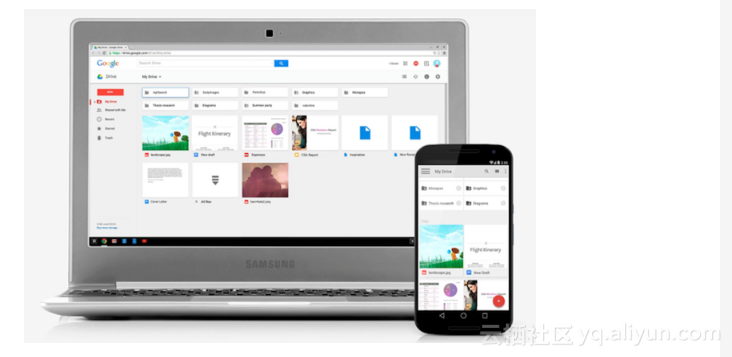
IDC最近的市场调查显示,2016第一季度美国市场Chromebook笔记本电脑的销量接近200万台,首次超过苹果Mac电脑,后者同期的销量只有176万台。 IDC认为Chromebook今天的业绩主要归功于K12教育市场份额的提升,谷歌公司在教育市场的大力推广收到了成效。 但是教育市场并不是Chromebook增长动力的全部,去年市场调查公司NPD发布的数据显示,Chromebook在企业级技术市场取得了重大突破,虽然很多企业依然依赖Windows电脑,但是搭载ChromeOS和Android的商用设备在2015年上半年增长了29%,增长速度远超Windows和苹果公司的产品。 Chromebook的市场表现说明,Chromebook作为上网、处理邮件和行业应用的低成本的计算工具,可以很好满足学生和上班族的需要,而且ChromeOS最近也增强了其离线功能,进一步提高了Chromebook的实用性和适用性。 文章转载自 开源中国社区[http://www.oschina.net]

优秀的个人博客,低调大师

2个国产AI记忆层开源项目PK

**Cortrix vs PowerMem 的设计取舍与选型指导, 两款产品之前都发文讲解过, 今天来个 PK.** **Cortrix 是刚刚新鲜发布的: **Cortrix 一手解说 PowerMem 则是 OceanBase AI 战略开源产品之一: PowerMem 未来可能成为 OB 的杀手锏 > 5 万行 Python 撞上 6.4 万行 C++,两种 RAG 基础设施哲学正面交锋 ## **写在前面** 最近翻了两个项目,巧合的是都跟「Agent 记忆」沾边。 一个是 **cortrix**——6.4 万行 C++17,AGPL-3.0 协议,刚放出 v1.0.0-rc.1。我上一篇已经拆过它了,把它定位成「带向量索引的数据库」。 另一个是 **powermem**——5 万行 Python 加上周边工具链,Apache-2.0 协议,OceanBase 团队出品,已经在 PyPI 上跑了好几个版本。它把自己定位成「持久化、自演化的记忆引擎」。 把它们放一起对比,是因为这两个项目**代表了两条完全相反的路径**:一条是把现有数据库的能力边界往死里推,另一条是把所有能用的数据库适配成统一接口。今天这篇把这两条路子的差异拆到源码级。 文章结构按四维展开:**产品设计**、**技术栈**、**生态**、**场景**。每个维度都给出双项目的对照,最后给一个可执行的选型建议。 ## **一、产品设计:底座 vs 中间件** 打开两个项目的 README,第一句话就把分歧讲清楚了: - **cortrix**:*「本地优先的语义存储服务」*——全栈自管,从存储到索引到 HTTP 一条龙 - **powermem**:*「持久化、自演化的记忆引擎」*——下沉到已有数据库上,只做记忆层 这两个定位的差异不是修辞,是技术债的分界。 cortrix 的设计压力来自「**我要替换现有向量库**」。它把 SQLite 的能力边界推到极致(多库架构、WAL 调优、自研 PHnsw),目的是让你不再需要 milvus / qdrant / weaviate 那一套独立部署。所有能力只能跑在它自己的 SQLite 上——这是它的封闭性,也是它的简化能力。 powermem 的设计压力来自「**我已经有一堆数据库了**」。它的 StorageAdapter 在 OceanBase、PostgreSQL、SQLite、seekdb 之间归一化 insert/search/get/update/delete,再加 json 元数据过滤和 snowflake ID。代价是:换存储时有些语义差异要靠 adapter 兜底;好处是:你可以把记忆层直接叠到现有基础设施上。 **一句话总结**:cortrix 是底座(替换你的向量库),powermem 是中间件(叠在已有数据库上)。 ## **二、技术栈:C++17 vs Python 3.11+** |维度|cortrix|powermem| | --- | --- | --- | |主语言|C++17|Python 3.11+| |代码量|6.4 万行|5 万行 + 周边| |协议|AGPL-3.0|Apache-2.0| |状态|v1.0.0-rc.1|已发布多版本| |编译/启动|自编译 C++|pip install| **AGPL-3.0 vs Apache-2.0** 是商业集成的分水岭。AGPL 是「传染型」开源——只要你的服务通过网络对外提供 AGPL 组件的能力,就得开源整个服务栈。Apache-2.0 允许闭源商用,只要保留版权和许可声明。对于企业级集成,powermem 显然更友好。 **C++17 vs Python 3.11+** 决定了演进路径: - cortrix 在 C++ 里自研了 hnswlib 的持久化封装、SQLite 多库拆分、BGE-M3 和 bge-reranker 的本地推理。代价是 C++ 编译地狱、依赖管理复杂、招人难 - powermem 走 Python 生态,全面接入 OpenAI、Anthropic、Qwen、DeepSeek、SiliconFlow、Ollama 等十几家 LLM 供应商。代价是单进程性能,powermem 自己文档就写明:embedded SQLite 模式下强制 workers=1,多进程起不来 **取舍的本质**:选 cortrix 是为**性能/可控性**自己扛;选 powermem 是为**生态/可改性**接受 Python 开销。 ## **三、接入路径:四条 vs 四条** 两个项目都给了四种客户端入口,但**成熟度分布完全不一样**: |路径|cortrix|powermem| | --- | --- | --- | |HTTP / OpenAPI|主力(自建服务)|FastAPI(成熟)| |MCP|标 Verification required|13 工具(7 记忆 + 6 用户画像)| |Python SDK|标 Verification required|主力,最成熟| |第四个|内置 Agent(Roadmap)|CLI(pmem)(成熟)| |IDE 插件|无|Claude Code / Cursor / VSCode 等多端| cortrix 多了一条「**内嵌 Agent**」——一个本地固定流程的 RAG 聊天服务,定位是给非开发者直接体验。Roadmap 标的是「高级自主执行器,如 tool-use 和 plan-execute 模式」。 powermem 多了一条「**CLI**」(`pmem` / `powermem-cli`),更偏运维和调试。它还通过 apps/ 目录提供了 Claude Code、Cursor、VSCode、OpenClaw 等十几种 IDE/Agent 的插件适配——这是「**生态广度**」的最直接体现。 **成熟度对照**:cortrix 的 MCP、SDK 都在补完中;powermem 的 4 条都已发布,且 13 个 MCP 工具有现成测试覆盖。 ## **四、存储:SQLite 多库 vs 多后端适配** 这是两个项目**分歧最大**的地方。 ### **cortrix · 一库打天下** 每个命名空间一份 `cortrix.db`,全局一份 `catalog.db`,稀疏向量的倒排索引再单独一份。所有 PRAGMA 参数都调过:WAL + `synchronous=NORMAL` + 256MB mmap + `auto_vacuum=INCREMENTAL` + `FULLMUTEX`。 向量索引是自研的 **PHnsw**(Persistent HNSW):vendor 进 hnswlib,但外面套了一整套 `WAL → fdatasync → 内存图 apply → 后台 snapshot` 流程。写入侧还有 group-commit 协调器。说白了,是把一个纯内存的图索引硬改成了崩溃可恢复的。 ### **powermem · Adapter 模式** `StorageAdapter` 把 insert/search/get/update/delete 在 OceanBase / PostgreSQL / SQLite / seekdb 之间归一化。filter 分两类:`_SYSTEM_FILTER_KEYS = {user_id, agent_id, run_id}` 和 `_PAYLOAD_FILTER_KEYS`,跨后端通过 `_metadata_filter_key_for_store()` 适配语义差异(SQLite / PG 的嵌套结构 vs OceanBase 的扁平结构)。 **隐藏强项**:OceanBase 后端原生支持 **vector + full-text + graph** 三合一,powermem 直接利用。代价是:换存储时有些**过滤路径差异**要靠 adapter 兜底(powermem 在 adapter 里有显式的注释说明这一点)。 **取舍**:cortrix 的存储是**最优解但唯一**(只能用它的 SQLite);powermem 的存储是**良好解但有妥协**(用哪个数据库都行,但要吃 adapter 层的抽象成本)。 ## **五、检索:都选了 RRF,但融合路数不同** 巧合的是,两个项目都把 **RRF(Reciprocal Rank Fusion,k=60)** 当默认融合策略。但走的路数完全不一样: |维度|cortrix|powermem| | --- | --- | --- | |主融合路数|2(向量 + FTS5)|4+(向量 + 全文 + 稀疏 + 图 + 时间)| |RRF 默认参数|k=60|k=60| |备选融合|仅 5 路 SPLADE 分支|weighted 加权融合| |FTS5 处理|主动改写为 OR 模式|用数据库原生全文索引| |过采样|3× 后过滤再截断|由后端实现,差异较大| **两个项目对 FTS5 的态度很能说明问题**: - cortrix 发现 SQLite FTS5 默认对多个查询词是隐式 AND 的,但自然语言查询往往词很多,隐式 AND 命中率极低,所以**主动改写为 OR 连接的词袋 BM25**,并对操作符做了注入清洗 - powermem 走的是数据库原生全文索引(OceanBase / SQLite FTS5 / PG tsvector),不在应用层改查询语法 **额外路径差异**: - cortrix 还有一个 5 路融合(dense / contextualized / sparse / fts5 / hype_question)专门给 SPLADE 稀疏分支用,是真的把融合当成了工程问题在做 - powermem 在 OceanBase 后端实现了完整 4 路 RRF,vector_w / fts_w 权重可调,weighted 加权融合作为备选 **结论**:两个项目 RRF 一样,但 cortrix 是在「**怎么让 RRF 跑得对**」上花了更多心思(SQL 路由只在意图分类器命中时触发,3× 过采样后再截断),powermem 是在「**让 RRF 适配多个后端**」上花了更多心思。 ## **六、记忆模型:矛盾判定 vs 经验蒸馏** 这一层是两个项目**最本质的差异**——它们对「记忆」的理解不一样。 ### **cortrix · 记忆会自己打架** 三层模型: ``` memory_sessions 会话元信息 └── interaction_log 每一轮 user/assistant 对话 └── blocks 抽出的事实(block_type=memory) ``` 第三层落的是**普通的 `blocks` 行**,只是类型标记不同——为了让 memory 检索直接复用 QueryPipeline(继承向量 + BM25 + RRF),不用另写召回。 **核心创新:矛盾判定**。新事实写入前会**再调一次 LLM** 判断它和已有事实有没有冲突。命中冲突就把旧事实标成 `invalidated`,并记录 `invalidated_by_block_id`——是哪条新事实把它作废的,有据可查。同时还支持手动作废和**撤销作废**。 这意味着记忆不是只写不改的日志,而是一个**会自我修正的状态机**。 ### **powermem · 两层蒸馏** 不只抽事实,还抽**程序性技能**: ``` class SkillManager: def distill(messages, today) -> List[{title, description, tags, procedure: {"prerequisites": [...], "steps": [...], "pitfalls": [...]}}]: ``` `distill()` 抽可复用的 SOP(prerequisites / steps / pitfalls 三段式),`merge()` 用 LLM 判定两个 skill 是否合并。**这是 cortrix 完全没有的能力**。 记忆还按重要性分三档:working(1h)、short_term(7h)、long_term(60h),由 `importance_score` 自动归类。 ### **决定的差异** - cortrix 是**会自我修正的状态机**(处理事实冲突) - powermem 是**会自己蒸馏出 SOP**(从对话里学到可复用工作流) 后者更激进,但要求 LLM 更靠谱。如果你做的是「**事实性**」agent(不能犯错),cortrix 的矛盾判定更合适;如果你做的是「**任务执行**」agent(越用越聪明),powermem 的 Skill 蒸馏更合适。 ## **七、生命周期:类型免疫 vs 艾宾浩斯** 记忆的「什么时候该忘」是核心设计取舍。 |维度|cortrix|powermem| | --- | --- | --- | |衰减模型|按类型免疫|艾宾浩斯曲线 R=e^(-t/S)| |触发器|纯时间|时间 + 访问强化| |衰减下限|event 类有下限|由 access_count 提升| |复习机制|无|按 review_schedule 主动复习| ### **cortrix** - `fact` 和 `preference`**永久免疫**,不衰减 - `event` 按 `exp(-λ·age_days)` 指数衰减,**但设了下限**,不会衰减到零 - 衰减是**纯时间**驱动,没有「复习强化」概念 ### **powermem** 经典 Ebbinghaus 公式 `R = e^(-t/S)`: - `decay_rate` 默认 1.5 - `decay_rate_multipliers` 按档位分 `{working: 1, short_term: 7, long_term: 60}` - `review_intervals` 默认 `[1, 6, 24, 72, 168]` 小时 - 每次访问会**强化 S**(stability),access_count 提升 retention - 工作流会按 schedule 主动复习 **行为差异**:powermem 的记忆会被**主动按 schedule 复习**(像人脑),cortrix 的记忆一旦写入就只受时间影响(像带 TTL 的 KV)。powermem 更像「人脑」,cortrix 更像「带 TTL 的 KV」。 ## **八、可观测:错误契约 vs Plugin 钩子** 两个项目都重视「让 Agent 用得稳」,但走的路不一样。 ### **cortrix · 对 LLM 友好的输出契约** **`agent_friendly::error`:全项目所有错误必须**带五个字段——`code` / `message` / `retryable` / `category`(auth / quota / transient / permanent / timeout) / `retry_after_ms`。意图明确:让 LLM 拿到错误能自己判断该重试、该换参数、还是该认输。 **`agent_trace`:能反查证据链(这次回复的依据是哪些 block),snippet 做了头 400 字节 + 尾 100 字节**的截断。权限做得很克制:跨用户读 trace 直接 unauthorized,而且**不泄露 session 是否存在**,避免被枚举探测。 ### **powermem · 对开发者友好的扩展点** **`IntelligentMemoryPlugin**` 抽象接口 + `EbbinghausIntelligencePlugin` 默认实现,提供 `on_add` / `on_get` / `on_search` 钩子。要加新行为,写个 plugin 就行,不用 fork 核心。 **`AuditLogger`:默认开启,所有写操作记到 `./logs/audit.log`,用于合规追溯。`TelemetryManager**` 默认 opt-in 开启遥测。 ### **设计取向差异** - cortrix 走的是**对 LLM 友好的输出契约**(错误 + 证据链)——面向 Agent 消费 - powermem 走的是**对开发者友好的扩展点**(plugin + 审计)——面向人类调试 前者把「LLM 能不能用得好」当一等公民;后者把「开发者能不能改得动」当一等公民。 ## **九、基准:BEIR 全量语料 vs LOCOMO 87.79%** 两个项目都跑了基准,但维度完全不同——**对比时要小心**。 |维度|cortrix|powermem| | --- | --- | --- | |基准|BEIR 三数据集(SciFact / FiQA / NFCorpus)|LOCOMO + AppWorld| |测什么|文档检索质量(Recall / nDCG)|端到端 Agent 任务| |指标|全量语料上的硬指标|87.79% 准确率 / 39% pass| |基线|无基线(绝对指标)|有显式基线对比| |声明|「不代表回答质量,不代表生产性能」|「+65.9% / +62.5% 提升」| ### **基准差异的根源** - cortrix 想证明的是**检索质量**(数据库角度) - powermem 想证明的是**记忆系统能不能让 Agent 真的多答对题**(产品角度) 这反映了两个项目的目标客户不一样:cortrix 服务的是「要替换向量库的工程师」,powermem 服务的是「要给产品加记忆层的应用开发者」。 你跑 BEIR 找不到 powermem,跑 LOCOMO 也找不到 cortrix。这是**测的东西根本不同**,不是谁更优。 ## **十、选型:给你三条具体建议** 如果让我基于源码看完给建议,会是这样: ### **选 cortrix 的场景** - 你需要**本地优先**部署(数据不出本机) - 你**能接受 AGPL-3.0** 协议(或用商业许可) - 你愿意**自己编译 C++** 二进制并集成到现有栈 - 你对**检索质量有硬指标要求**(BEIR 风格) - 你**不急着上生产**(v1.0.0-rc.1,鉴权/多租户还 Blocked) ### **选 powermem 的场景** - 你已有 **OceanBase / PostgreSQL / SQLite** 集群,要给现有应用加记忆层 - 你需要**商业可集成**(Apache-2.0) - 你想要 **Skills / 经验蒸馏**,让 Agent 越用越聪明 - 你**已准备好接 LLM**(默认 Qwen,也支持 OpenAI/Anthropic) - 你需要 CLI 调试或多 IDE 插件 ### **都不选的场景** 你需要的是**鉴权 / 多租户 / 生产 SLA**。 两个项目都还在这块补课: - cortrix 的 `RBAC 与租户隔离` 标 `Blocked`,README 自己写「在当前关闭鉴权的本地运行时中根本无法证明」 - powermem 的多智能体隔离在 `src/powermem/agent/abstract/` 抽象层,ManagerType 有 `multi_agent / multi_user / hybrid` 三种,但生产化程度不深 ## **最后** 把两个项目放一起看,最大的收获不是「选哪个」,而是看到**同一类问题有两种完全不同的解法**。 cortrix 押注「**底座**」——把一个能力极致的存储做透,让所有上层应用都建在它上面。代价是封闭、AGPL、自己编译。 powermem 押注「**中间件**」——把所有能用的数据库适配成统一接口,让记忆层可以被任何应用叠加。代价是抽象成本、多后端语义差异。 两条路都对。区别在于你的起点:你是「没有数据库想找一个」,还是「有数据库想加一层记忆」。 如果这篇对比让你对 Agent 记忆基础设施的工程取舍有更具体的理解,欢迎在评论区说说你选哪个、为什么。 --- **项目地址**: - cortrix: https://github.com/cortrix/cortrix(AGPL-3.0-only,v1.0.0-rc.1) - powermem: https://github.com/oceanbase/powermem(Apache-2.0) > 本文基于对 cortrix `src/` 6.4 万行 C++ 源码与 powermem `src/powermem/` 5 万行 Python 源码的实际探查写成。对比维度涵盖定位、技术栈、接入路径、存储、检索、记忆模型、生命周期、可观测、基准、选型。两个项目都还在快速演进,所述状态以写稿时(2026-07)的最新发布版本为准。

优秀的个人博客,低调大师

纯本地化国产落地 AI 产品 - GodoAI

GodoAI是一款集前沿AI技术与高效办公功能于一体的创新型办公产品,通过深度整合模型下载、模型对话、知识库管理、图片生成、语音转文字、文字转语音、以及全面的图像处理能力,GodoAI实现了办公场景的全覆盖,让每一位用户都能享受到智能化带来的便捷与高效。 💝良心产品,匠心独运,核心功能全面实现本地化部署,仅需8G内存,即可轻松驾驭。 💝 亮点 内置丰富的AI模型库,用户可根据需求一键下载所需模型 零配置,无需注册,下载即用 纯golang开发后端,低资源消耗和高性能 跨平台,Windows、Linux、MacOS都可以安装,无需docker部署 💖 开源地址 Gitee 🚀 演示视频 模型下载与创作 知识库与绘图 ⚡ 功能说明和预览 一、模型 内置丰富的AI模型库,用户可根据需求一键下载所需模型 几乎涵盖了市面上所有的基础大模型,包含聊天模型、文字转图片、图片转文字、图片转图片、文字转语音、语音转文字、Embeddings等模型 二、知识库 支持绝大多数类型文件上传,可抓取远程网页 支持本地向量数据库 三、创作 功能全面,包括从标题设定到内容编辑、保存、导出的全过程管理 支持关联知识库,可以不限制长度任意创作,发挥无限空间 支持段落生成、选中生成和全部生成 创作完成后可直接导出为word 支持查看创作列表、配置prompt高级设置等 四、绘图 无需GPU显卡也能生成图片 利用StableDiffusion,快速生成高质量图片,满足设计、广告、营销等多种场景需求。 支持SD中的所有模型,支持自定义SD中的参数 支持标签式生成prompt提示 生成的图片会自动保存到本地,支持实时查看后端的生成日志 五、聊天 支持多模态模型对话 支持保存聊天内容 支持自定义聊天参数 支持关联知识库 六、翻译 借助大模型可翻译多国语言 支持自定义翻译参数 七、语聊 声音转文字中建议选择telespeech模型,支持多地方言识别。不同的模型语音识别语言不同。 支持语音转文字、文字转语音功能,无需打字即可快速和大模型沟通。 八、听录 支持语音转文字功能,会议记录、访谈笔记轻松搞定。 支持保存会议记录,方便后续管理和查看。

优秀的个人博客,低调大师

故乡的云·国产大模型普惠计划

百度智能云千帆推出大模型普惠计划,0成本切换至国内调用量第一的大模型平台。场景更丰富、模型更全面、工具链更完整易用、更安全可靠! 即日起为新注册企业用户提供: 0元调用: 文心旗舰模型首次免费,赠送ERNIE3.5旗舰模型5000万Tokens包,主力模型ERNIE Speed/ERNIE Lite和轻量模型ERNIE Tiny持续免费 针对OpenAI迁移用户额外赠送与OpenAI使用规模对等的ERNIE3.5旗舰模型Tokens包 0元训练:免费模型精调训练服务 0元迁移:零成本SDK迁移工具 0元服务:专家服务(迁移&使用指导) 立即体验百度智能云千帆大模型平台 (以上优惠活动均在2024年7月25日24点前适用,最终解释权归百度智能云所有)

优秀的个人博客,低调大师

国产 Java ORM:sqltoy-orm 5.2.91 发版

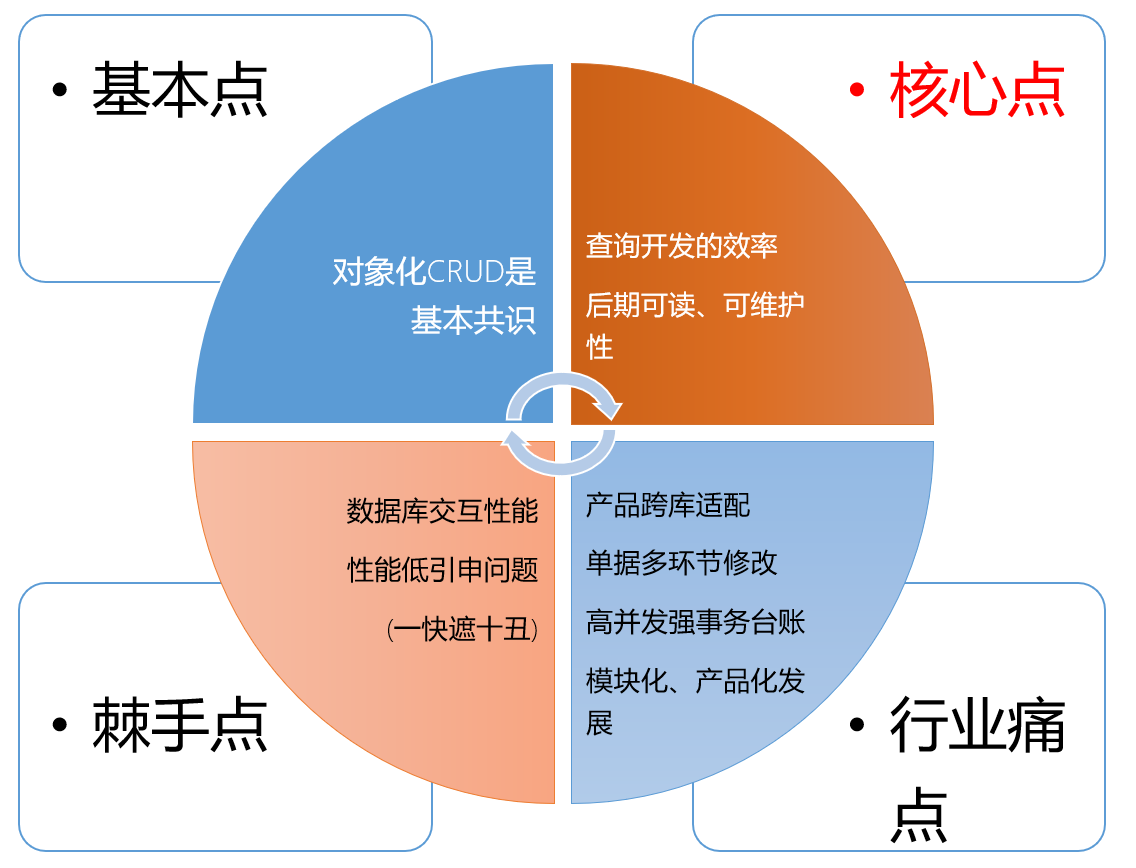
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、修复updateByQuery中UnifyFieldsHandler未判null引发的空指针异常 sqltoy-orm 是 JPA 和超强查询的融合体 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

国产 Java ORM:sqltoy-orm 5.2.90 发版

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、增强loop中LocalDateTime和LocalTime的输出精度 sqltoy-orm 是 JPA 和超强查询的融合体 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

可替代 Spring,国产 Solon v2.6.3 发布

Solon 是什么框架? Java 新的"生态级"应用开发框架。从零开始构建,有自己的标准规范与开放生态(历时六年,具备全球第二级别的生态规模)。 相对于 Spring,有什么特点? 启动快 5 ~ 10 倍。(更快) qps 高 2~ 3 倍。(更高) 低流量内存节省 1/3 ~ 1/2。(更少) 打包可以缩小到 1/2 ~ 1/10;比如,300Mb 的变成了 23Mb。(更小) 同时支持 jdk8, jdk11, jdk17, jdk21,graalvm native image 入门探索视频(用户录制): 最近更新了什么? 发布 Solon FaaS 修复 solon.luffy 插件 JtFunctionLoaderClasspath 可能会出现 null 异常的问题 修复 solon.luffy 插件 XFun.callFile 的执行兼容性(添加 file_id 赋值) 修复 Solon.cfg().stopSafe() 自动配置失效的问题 修复 war 部署时 contextPath 自动识别失效的问题 调整 contextPath 配置,支持 '!' 开头(表示强制模式,即不再支持旧的地址请求) 调整 solon.net 把 socketd 包改为 provided 调整 Utils::mime 添加默认处理 添加 ConvertUtil 对 Byte 类型的默认解析 smart-http 升为 1.3.6 luffy 升为 1.7.2 folkmq 升为 1.0.22 socket.d 升为 2.1.14 sqltoy 升为 5.2.86 beetl 升为 3.15.12.RELEASE beetlsql 升为 3.27.3-RELEASE netty 升为 4.1.101.Final 项目仓库地址? gitee:https://gitee.com/noear/solon github:https://github.com/noear/solon

优秀的个人博客,低调大师

Java 国产生态,Solon v2.4.3 发布

Solon 是什么? Java 生态型应用开发框架。它从零开始构建,有自己的标准规范与开放生态(历时五年,已有全球第二级别的生态规模)。与其他框架相比,它解决了两个重要的痛点:启动慢,费内存。2023年6月,Maven 单月下载量突破200万。 解决痛点? 由于SolonBean容器的独特设计,不会因为扩展依赖变多而启动很慢(开发调试时,省时、爽快)!以知名开源项目“小诺”为例: “snowy-spring 版”启动 15-50秒 “snowy-solon 版”启动3-5秒,内存节省1/3(有兴趣的,欢迎拉取代码体验) 相对于 Spring Boot 和 Spring Cloud 的项目,有什么特点? 启动快 5 ~ 10 倍。(更快) qps 高 2~ 3 倍。(更高) 运行时内存节省 1/3 ~ 1/2。(更少) 打包可以缩小到 1/2 ~ 1/10;比如,300Mb 的变成了 23Mb。(更小) 同时支持 jdk8, jdk11, jdk17, jdk20,graalvm native image 入门探索视频(用户录制): 更新了什么? 增加 solon.cloud.metrics 对 MeterBinder 的自动装配处理 增加 HandlerLoaderFactory,以实现所有@Mapping注解解析的重写支持 增加 rocketmq-solon-cloud-plugin 插件,对 ak/sk 的支持 增加 sa-token 插件,对 SaTokenDaoOfRedisson 实现 增加 solon.data.dynamicds 支持各源不同的连接池类型 调整 solon.serialization.fastjson 插件,默认增加字段排序特性 调整 solon-test 依赖,改成 solon-test-junit4 和 solon-test-junit5 的集合 调整 ConvertUtil 内的 LocalDateTime 处理,先通过 Date 中转,统一时间格式 调整 FiledWrap 反射权限改为用时再设置 调整 RouterInterceptorLimiter 标为弃用,由 RouterInterceptor::pathPatterns 替代 调整 ChainManager::getFilterNodes、getInterceptorNodes 输出类型 调整 solon-admin 的 server 和 client 通信为有状态格式 调整 solon 模块结构 调整 solon-admin-server 界面细节 修复 solon.docs.openapi2 插件 ApiImplicitParam::paramType 未生效的问题 修复 solon.docs.openapi2 插件 ApiParam::hidden 未生效的问题 sa-token 升为 1.35.0.RC mybatis-flex 升为 1.5.7 redisx 升为 1.4.9 项目仓库地址? gitee:https://gitee.com/noear/solon github:https://github.com/noear/solon

优秀的个人博客,低调大师

Snack3 3.1.10 发布,国产 JSON, Jsonpath 框架

一个微型JSON框架 基于jdk8,70kb。有序列化反序列化、解析和转换、支持 Json path 查询。 <dependency> <groupId>org.noear</groupId> <artifactId>snack3</artifactId> <version>3.1.10</version> </dependency> 更新说明: 增加特性:Feature.StringJsonToNode 支持处理节点值为jsonstring的情况 增加接口:ONode::fillObj(),ONode::fillStr() 支持快速填充Java bean或Json string数据 增加接口能力:ONode::set(key, obj),ONode::add(obj),ONode::val(obj) obj支持:Object,Map<String,Object>,List<Object>;Object 为基础类型

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册