首页 文章 精选 留言 我的

精选列表

搜索[jvm],共6833篇文章
优秀的个人博客,低调大师

java面试-深入理解JVM(五)——HotSpot垃圾收集器详解

HotSpot虚拟机提供了多种垃圾收集器,每种收集器都有各自的特点,没有最好的垃圾收集器,只有最适合的垃圾收集器。我们可以根据自己实际的应用需求选择最适合的垃圾收集器。 根据新生代和老年代各自的特点,我们应该分别为它们选择不同的收集器,以提升垃圾回收效率。 新生代垃圾收集器 1. Serial垃圾收集器 单线程只开启一条GC线程进行垃圾回收,并且在垃圾回收过程中停止一切用户线程,从而用户的请求或图形化界面会出现卡顿。 适合客户端应用一般客户端应用所需内存较小,不会创建太多的对象,而且堆内存不大,因此垃圾回收时间比较短,即使在这段时间停止一切用户线程,用户也不会感受到明显的停顿,因此本垃圾收集器适合客户端应用。 简单高效由于Serial收集器只有一条GC线程,因此避免了线程切换的开销,从而简单高效。 采用“复制”算法 2. ParNew垃圾收集器 ParNew是Serial的多线程版本。1. 多线程并行执行ParNew由多条GC线程并行地进行垃圾清理。但清理过程仍然需要停止一切用户线程。但由于有多条GC线程同时清理,清理速度比Serial有一定的提升。 适合多CPU的服务器环境由于使用了多线程,因此适合CPU较多的服务器环境。 与Serial性能对比ParNew和Serial唯一的区别就是使用了多线程进行垃圾回收,在多CPU的环境下性能比Serial会有一定程度的提升;但线程切换需要额外的开销,因此在单CPU环境中表现不如Serial。 采用“复制”算法 追求“降低停顿时间”和Serial相比,ParNew使用多线程的目的就是缩短垃圾收集时间,从而减少用户线程被停顿的时间。 3. Parallel Scavenge垃圾收集器 Parallel Scavenge和ParNew一样都是多线程、新生代收集器,都使用“复制”算法进行垃圾回收。但它们有个巨大的不同点:ParNew收集器追求降低用户线程的停顿时间,因此适合交互式应用;而Parallel Scavenge追求CPU吞吐量,能够在较短的时间内完成指定任务,因此适合没有交互的后台计算。 什么是“吞吐量”?吞吐量是指用户线程运行时间占CPU总时间的比例。CPU总时间包括:用户线程运行时间 和 GC线程运行的时间。因此,吞吐量越高表示用户线程运行时间越长,从而用户线程能够被快速处理完。 降低停顿时间的两种方式1.在多CPU环境中使用多条GC线程,从而垃圾回收的时间减少,从而用户线程停顿的时间也减少;2.实现GC线程与用户线程并发执行。所谓并发,就是用户线程与GC线程交替执行,从而每次停顿的时间会减少,用户感受到的停顿感降低,但线程之间不断切换意味着需要额外的开销,从而垃圾回收和用户线程的总时间将会延长。 Parallel Scavenge提供的参数 设置“吞吐量”通过参数-XX:GCTimeRadio设置垃圾回收时间占总CPU时间的百分比。 设置“停顿时间”通过参数-XX:MaxGCPauseMillis设置垃圾处理过程最久停顿时间。Parallel Scavenge会根据这个值的大小确定新生代的大小。如果这个值越小,新生代就会越小,从而收集器就能以较短的时间进行一次回收。但新生代变小后,回收的频率就会提高,因此要合理控制这个值。 启用自适应调节策略通过命令-XX:+UseAdaptiveSizePolicy就能开启自适应策略。我们只要设置好堆的大小和MaxGCPauseMillis或GCTimeRadio,收集器会自动调整新生代的大小、Eden和Survior的比例、对象进入老年代的年龄,以最大程度上接近我们设置的MaxGCPauseMillis或GCTimeRadio。 老年代垃圾收集器 1. Serial Old垃圾收集器 Serial Old收集器是Serial的老年代版本,它们都是单线程收集器,也就是垃圾收集时只启动一条GC线程,因此都适合客户端应用。 它们唯一的区别就是Serial Old工作在老年代,使用“标记-整理”算法;而Serial工作在新生代,使用“复制”算法。 2. Parallel Old垃圾收集器 Parallel Old收集器是Parallel Scavenge的老年代版本,一般它们搭配使用,追求CPU吞吐量。它们在垃圾收集时都是由多条GC线程并行执行,并停止一切用户线程。因此,由于在垃圾清理过程中没有使垃圾收集和用户线程并行执行,因此它们是追求吞吐量的垃圾收集器。 3. CMS垃圾收集器 CMS收集器是一款追求停顿时间的老年代收集器,它在垃圾收集时使得用户线程和GC线程并行执行,因此在垃圾收集过程中用户也不会感受到明显的卡顿。但用户线程和GC线程之间不停地切换会有额外的开销,因此垃圾回收总时间就会被延长。 垃圾回收过程 初始标记停止一切用户线程,仅使用一条初始标记线程对所有与GC ROOTS直接关联的对象进行标记。速度很快。 并发标记使用多条并发标记线程并行执行,并与用户线程并发执行。此过程进行可达性分析,标记出所有废弃的对象。速度很慢。 重新标记停止一切用户线程,并使用多条重新标记线程并行执行,将刚才并发标记过程中新出现的废弃对象标记出来。这个过程的运行时间介于初始标记和并发标记之间。 并发清除只使用一条并发清除线程,和用户线程们并发执行,清除刚才标记的对象。这个过程非常耗时。 CMS的缺点 吞吐量低由于CMS在垃圾收集过程使用用户线程和GC线程并行执行,从而线程切换会有额外开销,因此CPU吞吐量就不如在垃圾收集过程中停止一切用户线程的方式来的高。 无法处理浮动垃圾,导致频繁Full GC由于垃圾清除过程中,用户线程和GC线程并发执行,也就是用户线程仍在执行,那么在执行过程中会产生垃圾,这些垃圾称为“浮动垃圾”。如果CMS在垃圾清理过程中,用户线程需要在老年代中分配内存时发现空间不足时,就需要再次发起Full GC,而此时CMS正在进行清除工作,因此此时只能由Serial Old临时对老年代进行一次Full GC。 使用“标记-清除”算法产生碎片空间由于CMS使用了“标记-清除”算法, 因此清除之后会产生大量的碎片空间,不利于空间利用率。不过CMS提供了应对策略: 开启-XX:+UseCMSCompactAtFullCollection开启该参数后,每次FullGC完成后都会进行一次内存压缩整理,将零散在各处的对象整理到一块儿。但每次都整理效率不高,因此提供了以下参数。 设置参数-XX:CMSFullGCsBeforeCompaction本参数告诉CMS,经过了N次Full GC过后再进行一次内存整理。 通用垃圾收集器——G1垃圾收集器 G1是目前最牛逼的垃圾收集器。 G1的特点 追求停顿时间 多线程GC 面向服务端应用 标记-整理和复制算法合并不会产生碎片内存。 可对整个堆进行垃圾回收 可预测停顿时间 G1的内存模型 G1垃圾收集器没有新生代和老年代的概念了,而是将堆划分为一块块独立的Region。当要进行垃圾收集时,首先估计每个Region中的垃圾数量,每次都从垃圾回收价值最大的Region开始回收,因此可以获得最大的回收效率。 Remembered Set 一个对象和它内部所引用的对象可能不在同一个Region中,那么当垃圾回收时,是否需要扫描整个堆内存才能完整地进行一次可达性分析? 当然不是,每个Region都有一个Remembered Set,用于记录本区域中所有对象引用的对象所在的区域,从而在进行可达性分析时,只要在GC ROOTs中再加上Remembered Set即可防止对所有堆内存的遍历。 G1垃圾收集过程 初始标记标记与GC ROOTS直接关联的对象,停止所有用户线程,只启动一条初始标记线程,这个过程很快。 并发标记进行全面的可达性分析,开启一条并发标记线程与用户线程并行执行。这个过程比较长。 最终标记标记出并发标记过程中用户线程新产生的垃圾。停止所有用户线程,并使用多条最终标记线程并行执行。 筛选回收回收废弃的对象。此时也需要停止一切用户线程,并使用多条筛选回收线程并行执行。

优秀的个人博客,低调大师

JVM垃圾回收机制是怎样的,何时触发YoungGC或FullGC操作?

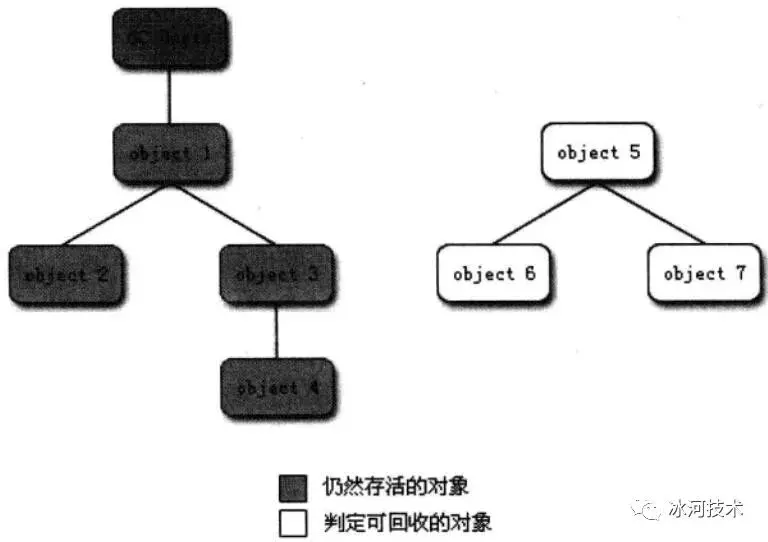
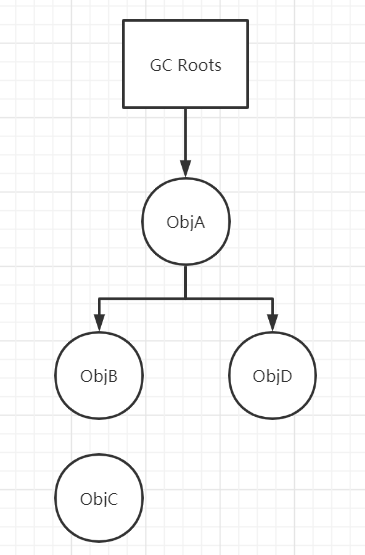
听说微信搜索《Java鱼仔》会变更强哦! 本文收录于JavaStarter ,里面有我完整的Java系列文章,学习或面试都可以看看哦 (一)关于垃圾回收 JAVA的垃圾回收需要完成三件事情: 1、哪些内存需要回收 2、什么时候回收 3、如何回收 下面就从这三个问题出发去了解Java的垃圾回收机制。 (二)哪些垃圾需要回收 在垃圾回收之前,首要的问题是确定哪些垃圾需要被回收,现在Java通过根搜索算法(GC Roots Tracing)来判断一个对象是否存活,这个算法的思路就是通过一系列名为“GC Roots”的对象作为起始点,从这些节点向下搜索,当GC Roots到达不了这个某个对象时(或者说某个对象没有被任何其他对象所引用),就证明这个对象是不可用的,这些对象会被判定为需要回收的对象。 如图,ObjC是不可达的,这个对象就是需要被回收的对象。 在Java语言中,可作为GC Roots的对象包括下面这些: 1、虚拟机栈(栈帧中的本地变量表)中引用的对象 2、方法区中的类静态属性引用的对象 3、方法区中的常量引用的对象 4、本地方法栈(Native方法)引用的对象 (三)什么时候回收 关于如何回收的问题,我参考了《深入理解Java虚拟机》,根搜索算法中不可达的对象,并不是立刻就会被回收,而是会经过一次标记: 如果对象没有覆盖finalize()方法,或者finalize()方法已经被调用,虚拟机会判定这个对象没必要执行finalize(),在这一次标记中该对象不会被回收。 如果这个对象被标记为有必要执行finalize()方法时,它会被放置在一个名为F-Queue的队列中,稍后由虚拟机进行垃圾回收。 但是这个对象还有最后一次逃脱的机会,当在F-Queue时,虚拟机会对F-Queue中的对象作小规模的标记,如果发现此时某个对象又可达了,就会逃过GC的命运。 (四)如何回收 如何回收垃圾的问题归根结底就是垃圾回收算法如何回收垃圾的问题。这里主要介绍三种垃圾回收算法的执行思路: 4.1 标记-清除算法(Mark-Sweep) 这种算法分为标记和清除两个阶段,首先标记出所有需要回收的对象,在标记完成后统一回收掉被标记的对象。 看图就可以明白了,这个算法的问题在于,清除之后会产生大量不连续的空间碎片。 4.2 复制算法(Copying) 复制算法将内存分为两块,每次使用其中一块,垃圾回收时,将正在使用的那块内存中存活的内存放入另一块内存中,然后清空原内存块,图示图下: 复制算法被广泛应用于新生代的垃圾回收,由于新生代的对象有百分之98左右都是要被回收的,因此新生代的内存会被分为一块Eden空间和两块Survivor空间,比例为8:1:1。 第一次YGC只回收eden区域,回收后大多数(百分之九十八左右)的对象会被回收,活着的对象通过复制算法进入Survivor0(后续用S0和S1代替)。再次YGC后,eden+S0中活着的对象进入S1。再次YGC,eden+S1中活着的对象进入到S0。依次循环 4.3 标记-整理(Mark-Compact) 标记-整理算法分为标记、整理、清除三步,第一步也是标记出可回收的对象,然后让存活的对象移到一边,然后直接清理掉边界外的垃圾。 标记整理算法被广泛应用于老年代的垃圾回收。 (五)何时触发YoungGC或FullGC YoungGC的触发时常在发生,当新生代的Eden区满了之后就会触发YoungGC。 FullGC在多个情况下都会被触发: 1、发生Young GC之前进行检查,如果“老年代可用的连续内存空间” < “新生代历次Young GC后升入老年代的对象总和的平均大小”,说明本次Young GC后可能升入老年代的对象大小,可能超过了老年代当前可用内存空间,此时会触发FullGC 2、当老年代没有足够空间存放对象时,会触发一次FullGC 3、如果元空间区域的内存达到了所设定的阈值-XX:MetaspaceSize=,也会触发FullGC。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码