首页 文章 精选 留言 我的

精选列表

搜索[并发编程],共10000篇文章
优秀的个人博客,低调大师

并发容器与框架——Fork/Join框架

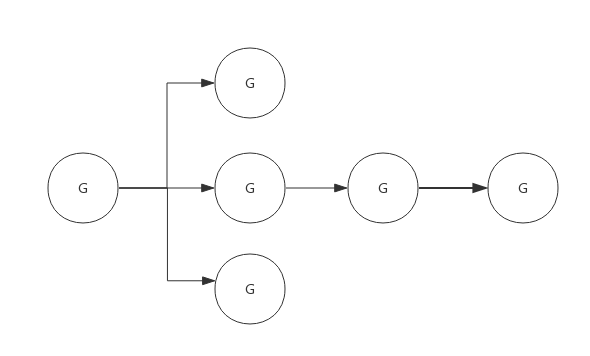
1. Fork/Join框架概念 Fork/Join框架是Java提供的一个用于并行执行任务的框架,它会将一个大任务分成多个小任务,并且将每个小任务的最终结果汇总得到大任务结果的框架。比如对1+2+3+····+100求和,可以分成十个子任务分别对10个数求和,最后再汇总这十个子任务的结果。 2.工作窃取算法 工作窃取算法是指某个线程从其他任务队列里窃取任务来执行。 假如我们可以将一个总任务分割成多个互不相干的子任务,为了减少线程的竞争,我们会将这些子任务放在不同的队列中,并为每个队列都建造一个线程执行该队列的任务,线程和队列一一对应。但是有些线程可能会很早的执行完自己队列中的所有任务,而其他线程还会处理自己拥有的队列中的任务,此时已处理完任务的线程与其等待其他线程执行任务,不如帮助其他线程一起执行剩余任务。这时他们会从其他线程的队列里窃取一个线程执行任务,所以为了避免因为工作窃取引起的两个线程之间的竞争,通常任务队列会使用双端队列。任务队列线程从头部取任务,窃取线程从尾部取任务。 优点是充分利用线程进行并行运算,并减少了竞争,缺点就是还是存在竞争情况,比如队列中任务数为1时,还会因为创建多个线程和队列造成更多的资源消耗。 3. Fork/Join框架设计实现类 通过前面的介绍我们可以了解到Fork/Join框架主要实现两个步骤:分割任务以及执行任务并汇总结果。 分割任务:我们需要一个Fork类来分割任务,并且要将大任务分割的足够小。 执行任务并汇总结果:分割的子任务分别放在双端队列里,然后几个启动线程分 别从双端队列里获取任务执行。子任务执行完的结果都统一放在一个队列里,启动一个线程 从队列里拿数据,然后合并这些数据。 Fork/Join框架设计了两个类来完成以上两个步骤的功能。 ForkJoinTask:这是一个抽象类,主要使用该类来创建一个ForkJoin任务,它提供在任务中执行fork()和join()操作的机制。但Fork/Join框架提供了ForkJoinTask的两个抽象子类,RecursiveAction(用于没有返回结果的任务);RecursiveTask(用于有返回结果的任务)。通过继承这两个子类来创建一个ForkJoin任务。 ②ForkJoinPool:ForkJoinTask需要通过ForkJoinPool来执行。任务分割出的子任务会添加到当前工作线程所维护的双端队列中,进入队列的头部。当 一个工作线程的队列里暂时没有任务时,它会随机从其他工作线程的队列的尾部获取一个任务。 4.简单使用Fork/Join框架 用Fork/Join框架来计算一个1+2+3+····+n的结果。注意,我们必须先想好如何分割任务,分割计算1+2+3+····+n时,必须至少分割为两个数字一组才能计算,但如果n过大两个数字一组会造成极大资源消耗,所以应考虑好任务分割的程度。此处仅以1+2+3+4为例。 public class TestFork_JoinFrame extends RecursiveTask<Integer>{ private static final int THRESHOLD=2;//设置阀值,也就是任务最小分割程度为2个数字相加 private int start; private int end; public TestFork_JoinFrame(int s,int e) { start=s; end=e; } public static void main(String[] args) { ForkJoinPool pool=new ForkJoinPool(); TestFork_JoinFrame task=new TestFork_JoinFrame(1, 4); //执行任务 Future<Integer> f=pool.submit(task); try { System.out.println("最终结果:"+f.get()); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } catch (ExecutionException e) { // TODO Auto-generated catch block e.printStackTrace(); } } @Override protected Integer compute() { int sum=0; boolean canCompute=(end-start)<=THRESHOLD;//如果已经是最小分割值,则进行运算,否则继续分割 if(canCompute){ for(int i=start;i<=end;i++){ sum+=i; } }else{ //分隔成两个子任务 int middle=(start+end)/2; TestFork_JoinFrame leftTask=new TestFork_JoinFrame(start, middle); TestFork_JoinFrame rightTask=new TestFork_JoinFrame(middle+1, end); //执行子任务 leftTask.fork(); rightTask.fork(); //等待子任务完成并获取结果汇总 sum=leftTask.join()+rightTask.join(); } return sum; } } 5.异常处理 ForkJoinTask在执行过程中可能会抛出异常,但是与普通线程任务一样,我们无法在主线程中对其进行捕获,所以以ForkJoinTask提供了isCompletedAbnormally()方法来检查任务是否已经抛出异常或已经被 取消了,并且可以通过ForkJoinTask的getException方法获取异常。getException方法返回Throwable对象,如果任务被取消了则返回CancellationException。如 果任务没有完成或者没有抛出异常则返回null。 public class TestFork_JoinFrame extends RecursiveTask<Integer>{ private static final int THRESHOLD=2;//设置阀值,也就是任务最小分割程度为2个数字相加 private int start; private int end; public TestFork_JoinFrame(int s,int e) { start=s; end=e; } public static void main(String[] args) { ForkJoinPool pool=new ForkJoinPool(); TestFork_JoinFrame task=new TestFork_JoinFrame(1, 4); //执行任务 Future<Integer> f=pool.submit(task); try { if(task.isCompletedAbnormally()){ System.out.println(task.getException()); }else{ System.out.println("最终结果:"+f.get()); } } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } catch (ExecutionException e) { // TODO Auto-generated catch block e.printStackTrace(); } } @Override protected Integer compute() { int sum=0; boolean canCompute=(end-start)<=THRESHOLD;//如果已经是最小分割值,则进行运算,否则继续分割 if(canCompute){ for(int i=start;i<=end;i++){ sum+=i; } }else{ //分隔成两个子任务 int middle=(start+end)/2; TestFork_JoinFrame leftTask=new TestFork_JoinFrame(start, middle); TestFork_JoinFrame rightTask=new TestFork_JoinFrame(middle+1, end); //执行子任务 leftTask.fork(); rightTask.fork(); //等待子任务完成并获取结果汇总 sum=leftTask.join()+rightTask.join(); } return sum; } } } 6.框架实现原理 ForkJoinPool由ForkJoinTask数组和ForkJoinWorkerThread数组组成,ForkJoinTask数组负责将存放程序提交给ForkJoinPool的任务,而ForkJoinWorkerThread数组负责执行这些任务。 1.ForkJoinTask的fork()方法原理:调用ForkJoinTask的fork方法时,程序会调用ForkJoinWorkerThread的pushTask方法异步地执行这个任务,然后立即返回结果。源码如下 public final ForkJoinTask<V> fork() { Thread t; if ((t = Thread.currentThread()) instanceof ForkJoinWorkerThread) ((ForkJoinWorkerThread)t).workQueue.push(this); else ForkJoinPool.common.externalPush(this); return this; } pushTask方法把当前任务存放在ForkJoinTask数组队列里。然后再调用ForkJoinPool的 signalWork()方法唤醒或创建一个工作线程来执行任务。源码码如下。 final void push(ForkJoinTask<?> task) { ForkJoinTask<?>[] a; ForkJoinPool p; int b = base, s = top, n; if ((a = array) != null) { // ignore if queue removed int m = a.length - 1; // fenced write for task visibility U.putOrderedObject(a, ((m & s) << ASHIFT) + ABASE, task); U.putOrderedInt(this, QTOP, s + 1); if ((n = s - b) <= 1) { if ((p = pool) != null) p.signalWork(p.workQueues, this); } else if (n >= m) growArray(); } } 2.ForkJoinTask的join方法实现原理:Join方法的主要作用是阻塞当前线程并等待获取结果。源码如下 public final V join() { int s; if ((s = doJoin() & DONE_MASK) != NORMAL) reportException(s); return getRawResult(); } private int doJoin() { int s; Thread t; ForkJoinWorkerThread wt; ForkJoinPool.WorkQueue w; return (s = status) < 0 ? s : ((t = Thread.currentThread()) instanceof ForkJoinWorkerThread) ? (w = (wt = (ForkJoinWorkerThread)t).workQueue). tryUnpush(this) && (s = doExec()) < 0 ? s : wt.pool.awaitJoin(w, this, 0L) : externalAwaitDone(); } 首先,它调用了doJoin()方法,通过doJoin()方法得到当前任务的状态来判断返回什么结 果,任务状态有4种:已完成(NORMAL)、被取消(CANCELLED)、信号(SIGNAL)和出现异常 (EXCEPTIONAL)。如果任务状态是已完成,则直接返回任务结果。如果任务状态是被取消,则直接抛出CancellationException。如果任务状态是抛出异常,则直接抛出对应的异常。 doJoin()方法里,首先通过查看任务的状态,看任务是否已经执行完成,如果执行完成, 则直接返回任务状态;如果没有执行完,则从任务数组里取出任务并执行。如果任务顺利执行完成,则设置任务状态为NORMAL,如果出现异常,则记录异常,并将任务状态设置为 EXCEPTIONAL。
优秀的个人博客,低调大师

java并发面试常识之copyonwrite

今天在网上看到一个问题,问除了加锁之外有没有其他方法来保证线程安全。楼下很多回答copyonwrite机制。这个问题回答有很多,但是copyonwrite的回答有点误导人。 copyonwrite机制 和单词描述的一样,他的实现就是写时复制, 在往集合中添加数据的时候,先拷贝存储的数组,然后添加元素到拷贝好的数组中,然后用现在的数组去替换成员变量的数组(就是get等读取操作读取的数组)。这个机制和读写锁是一样的,但是比读写锁有改进的地方,那就是读取的时候可以写入的 ,这样省去了读写之间的竞争,看了这个过程,你也发现了问题,同时写入的时候怎么办呢,当然果断还是加锁。 java中的copyonwrite java中提供了两个利用这个机制实现的线程安全集合。copyonwritearraylist,copyonwritearrayset。看名字就大概猜到他们之间的关系,copyonwritearrayset的底层实现是copyonwritearraylist。我们接下来看看java的实现。 public E get(int index) { return get(getArray(), index); } get的方法就是普通集合的get没有什么特殊的地方,但是成员变量的声明还是有讲究的,是个用volatile声明的数组,这样就保证了读取的那一刻读取的是最新的数据。 private transient volatile Object[] array; 接下来重点就是add方法了。下面的代码可以明显看出是明显需要reentrantlock加锁的,接下来就是复制数据和添加数据的过程,在setArray的过程中,把新的数组赋值给成员变量array(这里是引用的指向,java保证赋值的过程是一个原子操作)。 public void add(int index, E element) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; if (index > len || index < 0) throw new IndexOutOfBoundsException("Index: "+index+ ", Size: "+len); Object[] newElements; int numMoved = len - index; if (numMoved == 0) newElements = Arrays.copyOf(elements, len + 1); else { newElements = new Object[len + 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index, newElements, index + 1, numMoved); } newElements[index] = element; setArray(newElements); } finally { lock.unlock(); } } 关于迭代,他采取的是获取传递给迭代器的数组值进行迭代,中间就算加入新的值也迭代不到。在构造函数中就直接赋值给final的成员变量。 private final Object[] snapshot; private COWIterator(Object[] elements, int initialCursor) { cursor = initialCursor; snapshot = elements; } 适用场景 copyonwrite的机制虽然是线程安全的,但是在add操作的时候不停的拷贝是一件很费时的操作,所以使用到这个集合的时候尽量不要出现频繁的添加操作,而且在迭代的时候数据也是不及时的,数据量少还好说,数据太多的时候,实时性可能就差距很大了。在多读取,少添加的时候,他的效果还是不错的(数据量大无所谓,只要你不添加,他都是好用的)。

优秀的个人博客,低调大师

java并发面试常识之LinkedBlockingQueue

谈到ArrayBlockingQueue的特色就是循环队列,然后一把锁,2个条件,完成了功能。本来以为LinkedBlockingQueue也是这样的,结果和预期不一样,LinkedBlockingQueue利用了链表的特点,使用了两把锁,两个条件来控制。是一个锁分离的应用,下面就说说,他的实现,以及为什么ArrayBlockingQueue就不适合锁分离。 主要成员变量 private final ReentrantLock takeLock = new ReentrantLock(); private final Condition notEmpty = takeLock.newCondition(); private final ReentrantLock putLock = new ReentrantLock(); private final Condition notFull = putLock.newCondition(); private final AtomicInteger count = new AtomicInteger(); 除了两个锁,两个条件外,我这里专门列举了计数器。这个计数器很重要,重要到锁分离要依赖他才能正常运行。 锁分离 使用双锁分离就得注意一点,那就是防止线程夯死。生产线程要唤醒生产线程,消费线程也要唤醒生产线程,消费线程唤醒消费线程,消费线程也要唤醒生产线程。 public void put(E e) throws InterruptedException { if (e == null) throw new NullPointerException(); //唤醒标记 int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { while (count.get() == capacity) { //阻塞生产线程 notFull.await(); } enqueue(node); c = count.getAndIncrement(); if (c + 1 < capacity) //唤醒生产线程 notFull.signal(); } finally { putLock.unlock(); } //唤醒消费线程 if (c == 0) signalNotEmpty(); } 生产线程唤醒消费线程 基于上面的介绍,我们来看代码,唤醒标记就是为了生产唤醒消费的,因为可能出现消费线程全部都已经等待了,此时生产线程运作,但是消费线程并不能自己唤醒自己,于是就有了signalNotEmpty()的操作。这里的c是getAndIncrement的值,就是获取计数之前的值。c==0的满足条件就有1个元素,在这种情况下才去唤醒消费线程。 生产线程唤醒生产线程 在获取锁后,如果发现容量达到上限,就阻塞了,等待被唤醒,如果可以加入,就执行enqueue方法,是个很简单的链表添加节点的方法。就是在原来last节点后加节点,然后更新last节点。 private void enqueue(Node<E> node) { last = last.next = node; } 在计数器自增后,判断唤醒标记,如果还能继续生产,就去唤醒生产线程。 消费的方案思想和生产类似,这里就不说代码了。 删除 public boolean remove(Object o) { if (o == null) return false; fullyLock(); try { for (Node<E> trail = head, p = trail.next; p != null; trail = p, p = p.next) { if (o.equals(p.item)) { unlink(p, trail); return true; } } return false; } finally { fullyUnlock(); } } 删除代码相对比较简单,主要是要获取两把锁,才能进行删除操作就是fullyLock()和fullyUnlock(),删除掉元素后,还要唤醒生产线程。 void unlink(Node<E> p, Node<E> trail) { p.item = null; trail.next = p.next; if (last == p) last = trail; if (count.getAndDecrement() == capacity) notFull.signal(); } ArrayBlockingQueue为何不适合锁分离 这个主要是循环队列的原因,主要是数组和链表不同,链表队列的添加和头部的删除,都是只和一个节点相关,添加只往后加就可以,删除只从头部去掉就好。为了防止head和tail相互影响出现问题,这里就需要原子性的计数器,头部要移除,首先得看计数器是否大于0,每个添加操作,都是先加入队列,然后计数器加1,这样保证了,队列在移除的时候,长度是大于等于计数器的,通过原子性的计数器,双锁才能互不干扰。数组的一个问题就是位置的选择没有办法原子化,因为位置会循环,走到最后一个位置后就返回到第一个位置,这样的操作无法原子化,所以只能是加锁来解决。 适用场景 LinkedBlockingQueue的优点是锁分离,那就很适合生产和消费频率差不多的场景,这样生产和消费互不干涉的执行,能达到不错的效率,尽量不使用remove操作,获取两把锁的效率更低,可以使用size方法(就是计数器直接返回),这个还是比较重要的,有些集合不适合使用size,例如ConcurrentLinkedQueue,正确应该使用isEmpty()。

优秀的个人博客,低调大师

java并发面试常识之ArrayBlockingQueue

ArrayBlockingQueue是常用的线程集合,在线程池中也常常被当做任务队列来使用。使用频率特别高。他是维护的是一个循环队列(基于数组实现),循环结构在数据结构中比较常见,但是在源码实现中还是比较少见的。 线程安全的实现 线程安全队列,基本是离不开锁的。ArrayBlockingQueue使用的是ReentrantLock,配合两种Condition,实现了集合的线程安全操作。这里稍微说一个好习惯,下面是成员变量的声明。 private static final long serialVersionUID = -817911632652898426L; final Object[] items; int takeIndex; int putIndex; int count; final ReentrantLock lock; private final Condition notEmpty; private final Condition notFull; transient Itrs itrs = null; 赋值的操作基本都是在构造函数里做的。这样有个好处,代码执行可控。成员变量的初始化也是会合并在构造方法里执行的,但是在执行顺序上需要好好斟酌,如果写在构造方法里初始化,则没有相关问题。 阻塞队列的常用场所就是生产者消费者。一般都是生产者放入,消费者从头取数据。下面重点说这两个操作。 这两个操作都是依靠锁来保证线程安全的。 生产操作 public void put(E e) throws InterruptedException { checkNotNull(e); final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == items.length) notFull.await(); enqueue(e); } finally { lock.unlock(); } } put等放入操作,首先是获取锁,如果发现数据满了,就通过notFull的condition,来阻塞线程。这里的条件判定一定是用while而不是if,多线程情况下,可以被唤醒后发现又满了。 private void enqueue(E x) { final Object[] items = this.items; items[putIndex] = x; if (++putIndex == items.length) putIndex = 0; count++; notEmpty.signal(); } 这个是入队列的操作。首先获取维护的数组。putindex就是放入操作的标志。这个操作会一直加。达到预定的长度后就变成0从头开始计数。这样插入的操作就是一个循环的操作了,count就是用来做计数的,作为能否插入数据的一个标准,插入数据后就通过notEmpty的condition发出一个信号唤醒消费线程。 消费操作 public E take() throws InterruptedException { final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == 0) notEmpty.await(); return dequeue(); } finally { lock.unlock(); } } 消费的方法也是这样。先获取锁,然后进行条件判断,如果没有数据,则阻塞线程。注意点和put一样。 private E dequeue() { final Object[] items = this.items; @SuppressWarnings("unchecked") E x = (E) items[takeIndex]; items[takeIndex] = null; if (++takeIndex == items.length) takeIndex = 0; count--; if (itrs != null) itrs.elementDequeued(); notFull.signal(); return x; } 取数据的时候,也依靠takeIndex,这是一个标志,这个数值也会一直增加,表示取的第一个数据的位置。如果这个标志走到最后,然后变成0,从头再来。这样保证取出的数据都是fifo的顺序。删除的时候如果发现迭代中,则会修改迭代器的遍历。然后通过notFull的condition来唤醒生产线程。 移除操作 public boolean remove(Object o) { if (o == null) return false; final Object[] items = this.items; final ReentrantLock lock = this.lock; lock.lock(); try { if (count > 0) { final int putIndex = this.putIndex; int i = takeIndex; do { if (o.equals(items[i])) { removeAt(i); return true; } if (++i == items.length) i = 0; } while (i != putIndex); } return false; } finally { lock.unlock(); } } 对于remove操作就比较麻烦了,首先获取锁之后,把两个标志位本地化,然后找到要删除的元素的位置。调用removeAt,这里删除需要对标志位做改变。 void removeAt(final int removeIndex) { final Object[] items = this.items; if (removeIndex == takeIndex) { items[takeIndex] = null; if (++takeIndex == items.length) takeIndex = 0; count--; if (itrs != null) itrs.elementDequeued(); } else { final int putIndex = this.putIndex; for (int i = removeIndex;;) { int next = i + 1; if (next == items.length) next = 0; if (next != putIndex) { items[i] = items[next]; i = next; } else { items[i] = null; this.putIndex = i; break; } } count--; if (itrs != null) itrs.removedAt(removeIndex); } notFull.signal(); } 如果删除的元素是位置和takeindex一样。那就可以直接删除,然后让删除标志位向后移动。如果不是,则从删除的位置开始,进行后面向前面的数据覆盖的操作。直到遇到putindex的前一个位置。然后把那个位置的数据设置为null。并且把putindex的位置往前移动一格,正在迭代的时候要删除数据并且唤醒生产线程。

优秀的个人博客,低调大师

并发包中ThreadLocalRandom类原理浅尝

一、 前言 ThreadLocalRandom类是JDK7在JUC包下新增的随机数生成器,它解决了Random类在多线程下多个线程竞争唯一的原子性种子变量的更新操作而导致大量线程自旋重试的不足。本节首先讲解下Random类的实现原理以及它在多线程下使用的局限性,然后引出ThreadLocalRandom类,通过讲解ThreadLocalRandom的实现原理来说明ThreadLocalRandom是如何解决的Random类的不足。 二、 Random类原理及其局限性 在JDK7之前包括现在java.util.Random应该是使用比较广泛的随机数生成工具类,另外java.lang.Math中的随机数生成内部也是使用的java.util.Random的实例。下面先通过简单的代码看看java.util.Random是如何使用的: public

优秀的个人博客,低调大师

Java并发机制底层实现原理-synchronized

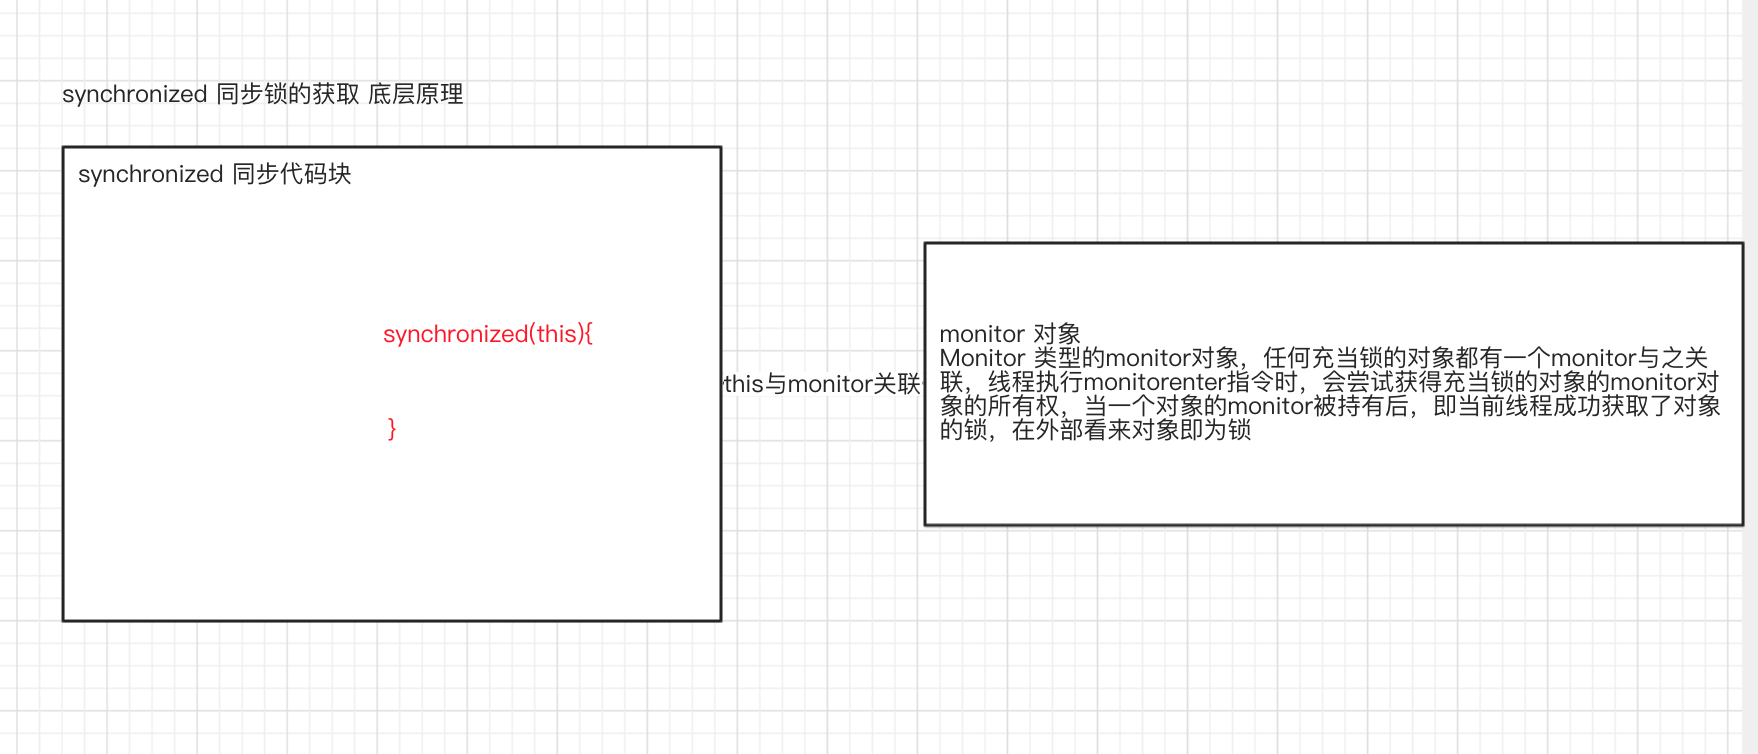
章节目录 synchronized的实现原理与应用 synchronized 重量级锁 1.6版本之前 synchronized 被称之为 重量级锁 1.6版本对 synchronized 进行了优化,主要优化的点在于 减少 获得锁和释放锁带 来的性能消耗,为实现这个目的引入了偏向锁、与轻量级锁。 synchronized 实现同步的基础 Java中每一个对象都可以作为锁。 普通同步方法,锁是当前实例对象。 静态同步方法块,锁是当前类的Class对象。 对于同步方法块,锁是synchronized括号里配置的对象。 synchronized 同步锁的获取 底层原理 如下图所示: synchronized 同步锁的获取 底层原理.png synchronized锁的存储位置 synchronized 用的锁是存在java对象头里的。 对象头中的Mark-word 默认存储对象的hashcode、分代年龄、和锁标志位。 Mark-word 中存储的数据会随着锁标志位的变化而变化 轻量级锁-00 重量级锁-10 GC标记-11 偏向锁-01 锁的升级与对比 Java SE 1.6 当中锁一共有4种状态,级别从低到高一次为:无锁状态、偏向锁状态、轻量级锁状态、重量级锁状态。锁可以升级但不能降级,这种锁升级但不能降级的策略,目的是为了提高获得锁与释放锁的效率。 1.偏向锁原理 偏向锁的优点及初始化过程: 加锁解锁不需要额外的资源消耗,只需要对比当前线程id在对象头中是否存储指向当前线程的偏向锁。如果存在,表示当前线程已经获得锁。如果测试失败,则查询当前mark word中的偏向锁标志是否设置成为1,如果没有设置,则使用CAS竞争锁(非偏向锁状态),如果设置了偏向锁标志,则尝试使用CAS将对象头的偏向锁指向当前线程。 偏向锁的撤销: 偏向锁使用了一种等到竞争出现才释放锁的机制,当其他线程尝试竞争偏向锁的时候,持有偏向锁的线程才会释放锁。偏向锁的撤销,需要等待全局安全点,这个时间点上没有正在执行的字节码。它首先会暂停拥有偏向锁的线程,然后检查持有偏向锁的线程活着,如果线程不处于活动状态,则将对象头设置为无锁状态。如果线程仍活着,拥有偏向锁的栈会被执行完。 2.轻量级锁原理 轻量级锁加锁: 线程在执行同步块之前,JVM会先在当前线程的栈桢中创建存储锁记录的空间,并将对象头中的mark word 复制到锁记录当中,然后线程尝试使用CAS将对象头中的 mark word 替换为指向锁记录的指针。如果成功,当前线程获得锁,如果失败,表示其他线程竞争锁,当前线程便尝试使用自旋锁来获取锁。 轻量级锁解锁 轻量级解锁时,会使用原子的CAS将锁记录(Displaced Mark Word)替换回到 对象头,如果成功,则表示没有发生竞争。如果失败,表示当前锁存在竞争,锁就会膨胀为重量级锁。 总结 锁 优点 缺点 适用场景 偏向锁 加锁和解锁都不需要额外的消耗,和执行非同步的方法相比只存在纳秒级差距 如果线程间存在锁竞争,会带来额外的锁撤销的消耗 适用于只有一个线程访问同步块的场景 轻量级锁 竞争的线程不会阻塞,提高了应用的相应速率 如果始终得不到竞争的线程,适用自旋会消耗cpu,造成cpu空转 追求响应时间,同步块执行速度非常快 重量级锁 线程竞争不使用自旋,不会消耗cpu 线程阻塞,响应时间缓慢 追求吞吐量,同步块执行速度较长 不同锁的优缺点 锁 优点 缺点 适用场景 偏向锁 加锁和解锁都不需要额外的消耗,和执行非同步的方法相比只存在纳秒级差距 如果线程间存在锁竞争,会带来额外的锁撤销的消耗 适用于只有一个线程访问同步块的场景 轻量级锁 竞争的线程不会阻塞,提高了应用的相应速率 如果始终得不到竞争的线程,适用自旋会消耗cpu,造成cpu空转 追求响应时间,同步块执行速度非常快 重量级锁 线程竞争不使用自旋,不会消耗cpu 线程阻塞,响应时间缓慢 追求吞吐量,同步块执行速度较长

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册