首页 文章 精选 留言 我的

精选列表

搜索[低空时代],共10000篇文章
优秀的个人博客,低调大师

大数据时代:要么去改变,要么被改变

ZDNet至顶网服务器频道 07月02日 :2015浙商大会迎来了一位重量级嘉宾:国际大数据最顶尖的专家之一、在科技和互联网领域极有影响力的《数据新常态:如何赢得指数级增长的先机》一书作者克里斯托弗·苏达克(Christopher Surdak)来了。站在互联网+的风口,苏达克用大数据给浙商做了一次头脑风暴。 告诉消费者“我懂你”,但“太懂你”会引起不适 过去15年中,我们不停地问这些问题:客户是谁,他们需要什么产品,需要什么样的价格?但是现在事情相反了,我们不仅要知道是什么,更重要的是要知道为什么。我们要关心客户为什么买,为什么在那个时间买。我们对客户的了解越多,对客户的需求把握也会更加精准。 大数据分析最重要的一点就是,当我们有不同的原始数据的时候,首先要保持及时性;其次是预测,下一步怎么做,我们要做有预测性的分析。最后一点也很重要,当有分析结果出来的时候,企业要行动,这个行动要在第一时间内告诉消费者“我懂你”。 一个案例就是亚马逊,他们会做一个预测性分析,把货物通过最短距离运送到客户家里。当你根本还没有做出采购选择时,他就预测到了你未来可能会做哪些采购。亚马逊对客户的掌握非常好,不仅能预测到你要购买这个东西,而且知道如果运输过去后,你一定会很开心。这个过程中,需要强大的数据支撑,用于了解客户心理、客户想法,当你把货运到他们家时,他会觉得你懂他。 亲密感虽然是客户所希望的,他们希望你能“懂我”,但如果他们觉得你过多地进入了自己的生活,“你太懂我了,我会有恐慌感。”这就是与“亲密感”所对应的“不舒适感”。 所以我们要做的事情是:我们懂消费者,但是不能让消费者感到害怕。一家聪明的公司,他们知道消费者知道什么,但是还是和他保持相对的距离,让他感觉亲密,不会让他感觉到不适。当你跨过了这条分界线,让他感觉不舒适,他会离开,觉得你不是一个很好的平台。 打通数据的桥梁,就能颠覆行业 现在所有人都在讨论一家叫Uber的公司。以前出租车公司想的是,能够把乘客送到想要去的目的地即可,但这么做还远远不够。消费者更关注是否能够最快速度地搭上车。Uber这么做了,所以成为了世界最大的出租车公司,但事实上没有一辆车是属于他们的。他们可以做到一年410亿美金的营收,而传统出租车公司现在的生存环境就有危机了。这样的商业模式冲击,我们在不同领域都可以看到。 大面积颠覆会发生在以下情况:第一,现有数据和新数据相互匹配提供新的见解;第二,数据分析涉及到移动数据、社交数据、云数据、游戏数据,并深刻理解客户,理解供应商。也就是说,假如你把数据的桥梁打通了,就能把行业给颠覆了。 我们看看这些应用案例: 一、脸识别系统。从进门那一刻,人脸就被快速抓拍,通过人脸识别技术可以很明确地知道:这个人是谁,他将要去哪里。 二、上海街道上的一个监控系统。当行人走过来的时候,摄像机会抓取人脸,识别这个人是否在警方搜索通缉范围内。假设走过来的是嫌疑犯,他在通缉的名单里,系统会快速地把他定位。 三、伦敦地铁的一个系统。每个人走过时,系统会记载他走路的步频是多少,身体状态好不好。这个案例已经落地了5年。 现在有非常智能的牙刷,每天记录你在什么时候刷牙、刷牙是否到位。如果不到位,它会把信息直接传给你的牙医,所以物联网很多应用产生的数据都会影响到你的消费需求。 对很多大公司来说,他们认为自己某种程度上受到政府和法律法规的保护,觉得自己不可战胜。他们说的最多的一句话就是“不,我不想改变”。但是对小的公司来说,任何一个机遇或者创新点对他们来说都是:“是的,我可以改变”,所以机会也许在他们身上。 这个世界是一定要被改变的。你要问自己的是,是改变这个世界,还是让这世界的一部分人来改变你。德国一家非常大的ERP公司预测说,未来很多曾经位列世界500强的企业会消失,全球有40%像泰坦尼克号一样的顶级企业会掉下来。新兴的企业会出来,这个趋势不会停止,大公司会以越来越快的速度消亡,新公司会以越来越快的速度前进。 原文发布时间为:2015年07月02日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

容器时代,难道这就是我们想要的未来?

以下完整的对话记录,U 为提问者,P为Paul Biggar(Founder of CircleCI)。 U:Hi,我老板让我采访你,我听说你是个Web专家? P:是啊,我现在专攻分布式系统。我刚从ContainerCamp和Gluecon回来,打算下周参加DockerCon。真的很兴奋,整个行业正朝着 - 让一切更简单,更可靠的方式前进。这就是未来! U:Cool,我现在构建一个简单的Web应用程序 —— 一个使用Rails的普通CRUD应用程序,将会部署到Heroku的。给我提些建议? P:Oh,不。这是老方式。Heroku已死 —— 没有人会再使用它了。你现在需要使用Docker。这才是未来。 U:Oh,好的。Docker是什么? P:Docker是一种新的容器化的方式。就像LXC,但Docker也是一种打包形式、分发平台和工具,它可以让分布式系统的构建变得非常容易。 U:容器化 —— 那是什么?什么是LXE? P:是LXC。你可以把它想成chroot的升级版。 U:什么是 cher-oot? P:好,看看。Docker。集装箱。这就是未来。这就像虚拟化,但速度更快、更廉价。 U:Oh,就像Vagrant。 P:不,Vagrant已死。一切都将会被容器化,这就是未来。 U:好了,所以我不需要知道虚拟化什么吗? P:不,你仍然需要虚拟化,因为容器目前没有提供充分的安全保证。所以,如果你想在多租户环境中运行应用,你仍然需要沙箱。 U:好吧,我开始有点糊涂了。让我们一起回顾下。现在有一个像虚拟化一样的东西,被称为容器。我可以在Heroku上使用它吗? P:嗯,Heroku提供了对Docker的支持,但我告诉你:Heroku已经死了。你需要在CoreOS上运行你的容器。 U:擦,那CoreOS是什么? P:它是一个可以运行Docker的Host OS。该死的,你甚至都不需要Docker,可以直接使用rkt。 U:Rocket? P:不,rkt。 U:没错,那就是Rocket。 P:不,现在已经叫rkt了。与Docker完全不同。这是另一种集装箱格式,不像Docker把东西都绑定在一起,所以它更可以随意组合。 U:那样很好? P:当然这是很好的。组合是未来的趋势。 U:好,你如何使用它? P:我不知道。估计还没人能玩转它。 U:好吧。那你接着刚才继续说下CoreOS? P:它是一个可以使用Docker的Host OS。 U:什么是Host OS? P:一个运行容器的主机操作系统。 U:运行我的容器? P:是啊,你总得有运行东西的容器。就像你设置一个EC2实例,你把CoreOS放上去就可以了,随后运行Docker的守护进程,然后你就可以将Docker镜像部署上去。 U:其中哪一部分是容器? P:所有。你可以把应用程序写为一个Dockerfile,然后在本地把它变成一个镜像,这样,镜像就可以被部署到任何Docker主机了。 U:啊,就像Heroku? P:不,不是Heroku。我告诉过你了。Heroku死了。你现在使用的是Docker。 U:什么? P:是啊,这真的很简单。查一查#gifee。 U:Gify? P:“谷歌的基础设施”。你可以基于一些现有的工具,并通过使用容器,就可以拥有和谷歌相同的基础设施了。 U:我为什么不只使用谷歌的东西呢? P:你认为这将是大约6个月可以完成的? U:OK,没有云服务商提供类似的服务吗?我真的不想自己搞一套 P:嗯,亚马逊有ECS,但你得写烦人的XML。 U:OpenStack又是什么东西? P:Ew。 U:Ew? P:Ew。 U:我真的不想自建。 P:不,它真的很容易。您只需设置一个Kubernetes集群。 U:我需要一个集群? P:Kubernetes集群。它会管理所有服务的部署。 U:我只有一个服务。 P:什么意思?你确实有一个应用程序,所以你必须至少有8-12个服务? U:什么?没有,我只是一个应用程序。为什么有那么多服务? P:不,看看微服务。这是未来。这就是现在我们所做的一切。你把你的整体应用程序分解成12个服务。每一个服务只做一件事情。 U:这似乎代价过高。 P:这是确保应用可靠的唯一途径。你可以想象下如果你的验证服务宕机了... U:认证服务?我之前用的是Gem。 P:对的。使用gem。把它转变为一个项目,再封装一个RESTful API就可以了。当你的其它服务使用这个API的时候,它就会变得非常容器。最后你可以把这个项目放在容器中。 U:好了,现在我已经得到了几十个难以管理的服务,现在该怎么办? P:Yeah,我提到的Kubernetes。它可以让你协调所有的服务。 U:交给Kubernetes进行调度? P:是啊,你的这些服务并不是每时每刻都是可靠的,所以你需要有多个『副本』。Kubernetes就是让这些服务分布在你的集群的多台主机上,以保证服务的可靠性。 U:我需要一个集群呢? P:是啊,为了可靠性。Kubernetes会帮你管理。Kubernetes是谷歌的一个开源项目,它有使用到etcd。 U:什么是etcd? P:它是Raft的实现。 U:好了,什么是Raft? P:它就像Paxos。 U:好,什么是Paxos? P:Paxos就是没有人理解或使用的上世纪70年代老的分布式共识协议。 U:太好了,谢谢你告诉我。Raft是什么? P:由于没有人理解Paxos,所以Diego.... U:哦,你认识他吗? P:不,他在CoreOS工作。换句话说,因为Paxos太难了,Diego就在他的博士论文中发布了Raft。聪明的家伙。之后他写了etcd作为实现,Aphyr说,这不是狗屎。 U:什么是Aphyr? P:Aphyr是那家伙昵称,“就叫我这个名字吧。” 你要知道,关于分布式系统和BDSM的人? U:什么?你说BDSM? P:是啊,BDSM。那在旧金山。每个人都向往分布式系统和BDSM。 U:嗯,OK。他写过Katy Perry的歌曲? P:不,他写了一组博客文章有关如何在每个数据库发生故障时CAP。 U:什么是CAP? P:CAP定理。CAP 理论说在一个系统中对某个数据不存在一个算法同时满足一致性,可用性和分区容忍性。 U:OK,所有数据库发生故障时CAP?这是什么意思? P:就像Mongo。 U:我以为Mongo was web scale?(此处有梗http://www.mongodb-is-web-scale.com/是个Mongo网站) P:没有其他人会这么做。 U:好了,那 etcd? P:是啊, etcd是一个分布式key-value存储。 U:哦,就像Redis。 P:不,一点都不像Redis。etcd是分布式的。 U:好的,这是一个分布式 key-value存储。 P:Kubernetes设置一个使用etcd作为消息总线标准的5个节点集群。它结合了Kubernetes自己的服务,并提供一个非常弹性的业务流程体系。 U:5个节点?我有一个应用程序。我做这些该需要多少台机器啊? P: 嗯,你将有大约12个服务,当然,你需要冗余副本,几个负载均衡的集群etcd,你的数据库和kubernetes集群。因此,需要运行50个容器。 U:擦! P:没什么大不了!容器是非常高效的,所以你应该能够分发这些跨越在8台服务器上!是不是很神奇呢? U:这就是把它的一种方式。而完成这一切,我就可以简单地部署我的应用程序? P:当然。我的意思是,存储仍然是Docker和Kubernetes一个未解决的问题,并且网络也会有不少问题,但你基本上还没到那步! U:我明白。好吧,我想我会努力得到他。 P:非常好! U:感谢解释它。 P:没问题。 U:请允许让我再说复述一遍,看看是否我的理解是否正确的。 P:当然可以。 U:我只需要将我简单的CRUD应用程序分割成12个微服务,每个都有自己的API,每个微服务调用其中其他的API,而且弹性处理失败,并把它们放到Docker容器中。Docker容器又运行于CoreOS之上,并分布在集群的8台机器上,同时使用运行etcd的Kubernetes集群来调度他们,再解决『网络和存储』难题,然后我不断地提供每个微服务的多个冗余副本到我的集群。是不是这样? P:是!是不是很炫酷? U:我要用回Heroku。 本文作者:周峰 来源:51CTO

优秀的个人博客,低调大师

前端在人工智能时代能做些什么?

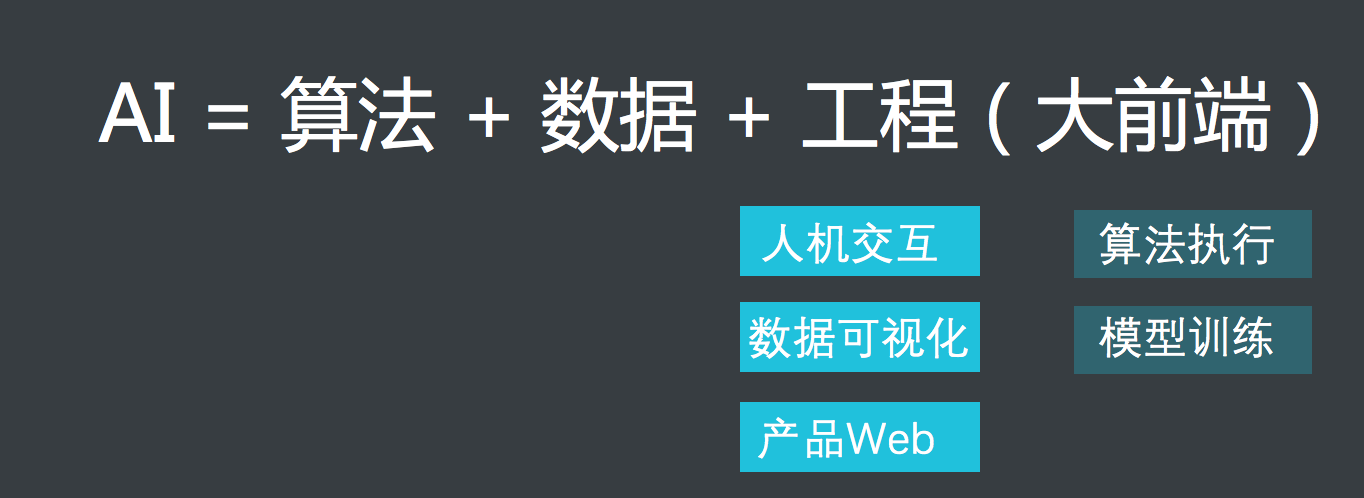
之前很长的一段时间内,一直在做阿里云人工智能产品 ET, 做为了一名前端工程师,参与了当中的一些工程工作,分享出来,希望对大家有所帮助。 前端工程在人工智能的团队到底能做什么,体现怎么的价值?对此,可以先下图的一个总结,然后我会逐条分析 从我们的实践看,要完成一个完整的人工智能项目,三种东西是不可或缺的:算法,数据和工程。 而前端在这三个方向种,最容易参与进去,同时也最容易做出彩的地方就是在工程方面,我们把这块内容叫做大前端。 具体的大致可以分为五块内容:人机交互,数据可视化,产品Web, 计算,模型训练和算法执行。 对于前三点偏重交互的领域,毋庸置疑用前端做起来驾轻就熟, 而后面偏重计算的领域,前端是否合适做,或者说前端该怎么去做是有可以探讨的。 一.人机机互: 这个应该前端这几年重点发力,而且取得不错进展的地方。 特别是随着HTML5技

优秀的个人博客,低调大师

大数据时代,OLAP解析与发展方向

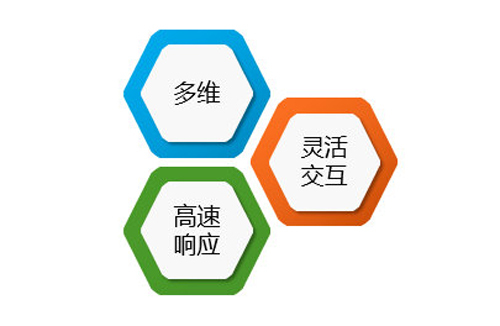
数据分析领域自2010前后一直占据了全球信息技术的核心地位,OLAP的需求并未随着Hadoop的流行而消亡,而是被越来越理智的认可——“数据再多也需要分析、分析的主要需求还是交互查询”。本文概括了OLAP的本质原则、曾经的困境和当前的技术派系,希望能引起从业者的思考,共同促进行业进步与发展! 1. 剖析OLAP本质 OLAP(Online Analytical Processing)是一种数据处理技术,专门设计用于支持复杂的分析操作,侧重对决策人员和高层管理人员的决策支持,可以根据分析人员的要求快速、灵活地进行大数据量的复杂查询处理,并且以一种直观而易懂的形式将查询结果提供给决策人员,以便他们准确掌握企业(公司)的经营状况 二十几年前E.F. Codd提出OLAP时,也参照关系数据库提出了12条规则,但后期没有得到发展,其中有些规则在现在看来都已经不再完全适用,或者不是OLAP的特殊规则。因此我们从OLAP的本质定位上,重新确定三条原则,用以解析OLAP的历史发展: 1) 提供多维的业务视图(“维”是OLAP存在和核心概念) 2) 满足灵活的交互分析(面向决策分析需要及时响应查询需求的变更) 3) 提供高速的检索性能(没有人希望查询数据等待太长时间) 无论从E.F. Codd提出的12条规则中,还是本文提炼的三大原则中,都可以明确出OLAP是满足应用需求而研发的新技术,而且是以“维度”为核心概念的所有技术的统称。 2. OLAP vs Reporting 从事BI/DW的专业人士们,对这张架构图应该非常熟悉,其中同时出现了OLAP和Reporting两个面向用户的应用功能(数据挖掘暂且忽略)。 两者核心的区别在于OLAP可以让终端用户可随意更改格式,以及进行维度钻取,甚至自定义成员,而Reporting的终端用户只能按照开发人员的预置做有限交互(比如刷新参数等)。同时从后台原理上,OLAP通过预计算(空间换时间的思想)做到高速响应,Reporting一般通过对关系型数据库的模型和优化保证既定SQL的高速查询。 为什么提到Reporting,因为它是OLAP出现之前的唯一数据应用,也正是因为Reporting解决不了大规模数据的交互分析,才诞生了OLAP。 3. OLAP遇到的困难 OLAP核心三原则的“多维”通过星型/雪花模型得以保证(已经有OLTP能参考的经验)、“灵活交互”和“高速响应”通过基于“预计算”数据的交互查询而实现。这就顺理成章的让我们联想起多维表达式——MDX(MultiDimensional eXpressions),此技术在E.F.Codd提出OLAP四年后就被微软定义并使用。 Multidimensional Expressions (MDX) is a query language for OLAP databases. Much like SQL, it is a query language for relational databases. MDX是类似SQL的查询语言,只不过查询的是OLAP数据库。 当微软发明MDX后,众多厂商都相继跟进并应用了这个非公开标准的技术,比如Oracle、SAS、Teradata、Cognos、Business Objects等等,从而使得MDX成为了OLAP领域的必备技术。 熟悉OLAP的朋友都知道MOLAP、ROLAP、HOLAP,它们都是时间与空间平衡关系的产物,比如MOLAP牺牲了空间和时效性,过度满足了查询性能,ROLAP保证了空间和时效性,却又容易丧失前端查询的高性能,最后发展出混合型的HOLAP。无论后端如何变化,前端的MDX却从来没有改变过(2008年我曾参加的面试题,里面就全部都是MDX语法)。 言归正传,为什么说OLAP的发展遇到了苦难呢,有这么几点: 1、 OLAP产品的封闭性 虽然前端查询的默认标准是MDX,但由于MDX的不够普及和易用,实际得以商业应用的软件中很多都自成一体(所谓成熟的商业软件),比如IBM Cognos等,造成前端功能的受限和不易集成。只有Microsoft SSAS、Oracle Essbase、Mondrian等少数几个可以把服务端以XML for Analysis标准开放出来,提供比较好的开发和集成能力。 2、 OLAP的预建模瓶颈 传统的OLAP软件,无论MOLAP/ROLAP/HOLAP,都会为用户的使用提前设计一个星型模型,它的好处是便于用户在一个存在相关关系的数据范围内操作,避免出现查询结果的错误。但带来的问题就是,当业务需求变化快或者业务关联更新时,模型就需要重构,而且必须由IT人员负责重构,较低的变更效率影响了使用感受。 3、 xOLAP都满足不了大数据的分析 凡事都存在量变到质变,数据量一旦大到TB、PB的程度,无论是基于文件的MOLAP,还是基于数据库的ROLAP,就都不能满足第三原则(高速响应)了。尤其很多客户已经采用Hadoop的数据架构,传统的OLAP技术就很难融入其中了! 4、 OLAP可视化能力弱 熟悉OLAP产品前端操作的用户都清楚,拖拽、下钻、切片这些动作都是基于表格的,基本不能在图形上完成同样的操作,这就给OLAP带来一个基因上的缺陷,就是可视化能力不够。还不要提现在时髦的玫瑰图、网络图、桑基图等等可视化图形! 5、 MDX不如SQL普及 MDX在很多统计分析功能上得天独厚,又比如协方差等计算函数,但80%的真正需求还是定位在简单的分级汇总和钻取切片排序上。无论在学习资源还是普及程度上,SQL还是拥有最多人群的数据查询技术。SQL的接受程度从在Hadoop生态的回归就能知道! 技术从来就不能阻挡需求,这些问题存在了若干年后,最近OLAP出现了很多新的技术实现,从多个方向带来了新的选择。 4. OLAP的技术派系 OLAP作为一大类市场需求始终是存在的,需要发展的只是实现它的技术(OLTP所基于的RDBMS非常稳定)。现在OLAP技术发展了20多年,正处于群雄逐鹿阶段,无论未来有没有一统江湖的完美技术,至少从现在来看,我们有必要从OLAP本质三原则梳理技术派系,以便市场参考和个人选择: 1. 传统OLAP 尊重传统是技术领域最缺少的品德,传统OLAP中尤其是Mondrian和SSAS还是有不少用户群的(前者是开源软件),反而选用Cognos、MSTR等的越来越少。 2. 可视化OLAP 十几年前,最火爆的BI产品是BO(2007年以68亿美元被SAP收购)。BO里最早的核心技术叫做“动态微立方”,就是把基于语义模型查询的结果集数据以MOLAP的方式存储在内存中,以加快后期交互分析的效率。现在同样也有各种基于内存计算的软件,但它们是以可视化为主,比如Tableau和Qlikview等。单纯定位在可视化上的OLAP只有商业软件,没有开源也没有免费的选择,这是因为可视化是个短期需求吧。 3. 大数据OLAP Hadoop的生态系统诞生于互联网公司,从一开始就有开放的基因,这个OLAP派系最有意思的是Kylin,而且是咱中国人在Apache上的定级项目。“Apache Kylin™是一个开源的分布式分析引擎,提供Hadoop之上的SQL查询接口及多维分析(OLAP)能力以支持超大规模数据,最初由eBay Inc. 开发并贡献至开源社区。”它与前2者最大不同点在于2个:使用SQL进行查询和支持Hadoop(SQL、SQL、SQL,重要的事情说三遍J)!准确的说,Kylin只是一个OLAP server,它的前端可以选用Smartbi等免费或者商业的软件,也可以选择自己开发。 4. 办公OLAP 最后一个派系也不可小视,那就是微软Excel(WPS等电子表格软件还难以匹敌)。虽然它也是自有的封闭技术,但它的友好性和兼容性足够强大,几乎人人电脑上都能使用,而且也确实是每个数据分析人员都略会一二的工具软件。而且它更重要的价值在于在Excel里面可以维护和处理数据,这是其它3类OLAP都无法提供的。具体介绍网上有很多,大家可以关注中国电子表格应用大会、Excelhome等网络资源。 最后还是强调OLAP是除了报表Reporting和数据挖掘Mining以外的一大类数据分析需求,在遵从“多维”、“灵活交互”和“高速响应”三个本质原则情况下,无论你是办公一族还是软件工程师、大数据专家,都有适合你的OLAP软件工具! 数据的联机分析处理,不会随着时间淡出,只会随着数据化运营的管理观念普及而加强! 本文作者:徐晶 来源:51CTO

优秀的个人博客,低调大师

新时代,大数据战略和DevOps更配

从大数据中获得有价值的洞察是每个企业的愿望,但是无奈理想很丰满,现实很骨感,再加上大数据软件开发人员和IT操作缺乏企业的协调,这也使得从大数据中获得洞察变得更加困难。还有的企业在其支持的其它项目中可能采用了良好的DevOps策略,但是大数据项目往往因为各种原因没有采用。 接下来,本文将来探讨一下DevOps是什么、为什么大数据项目团队不使用DevOps方法、使用DevOps的好处以及将大数据迁移到DevOps模型时可能会面临的挑战。 图片来源于informationweek 什么是DevOps? 首先我们先来了解一下DevOps是什么?为什么它会如此受欢迎?DevOps的主要目的是消除软件开发人员和IT基础架构管理员之间的孤岛,以确保每个人都可以专注于单一的目标。中间有一些交叉的训练可以会包含所有人都能理解的使用过程很多术语,但是一旦训练完成,双方又可以各自以清晰的方向继续改进。然后两个团队一起测试环境、调整生产基础架构组件以满足新的软件需求,并最终更快速地为终端用户提供软件修复和功能。 为什么大数据项目不喜欢采用DevOps IT领导者放弃DevOps的主要原因是大数据科学(特别是大数据的分析科学部分)的复杂性。数据科学是一个比较新的领域,大部分的专家都是外国人,国内的数据专家很少,所以这也导致了分析师无法和大数据开发商协同合作。 为什么大数据需要DevOps 由于分析师和大数据开发商的分离,DevOps在解决其他效率低下的项目中遇到的瓶颈照样会出现在大数据项目中。由于某些大数据项目会比预期的难度更大,所以IT领导者迫于压力会越来越想要早点得到结果,同时这也迫使分析科学家不断改进他们的算法。而分析模型发生的变化往往会和最初的基础设施和资源需求有很大的出入,在这个改变的过程中,运营团队一直被排除在外,所以当基础设施更改需求给到开发人员的时候,你就会发现通信和资源的分配滞后会减缓进度,而且这种放缓会影响大数据分析的潜在竞争优势。这也就是为什么大数据需要DevOps的原因。 集成大数据和DevOps时的挑战 如果你决定把大数据项目迁移到DevOps模型,就一定要了解你将面临的哪些挑战。 例如,如何快速打造探索分析和深度分析的大数据平台。 另外,大多数的专业分析人士都认为自己是社会工程师,而不是数据工程师,所以会有自己要学习的事情。如果在你的DevOps计划中速度是很关键的部分,那么资源协调是至关重要的。还有,大数据DevOps的高效运行还需要额外的人力资源,因为DevOps的价值并不是员工的减少,而是发掘应用程序的潜能。 大数据和DevOps集成的收益远远超过任何其他集成。效率和利益的协调有助于简化流程,加快实时分析变更的能力,从而更有效地利用所挖掘的数据。 本文作者:佚名 来源:51CTO

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。


用户登录
用户注册