首页 文章 精选 留言 我的

精选列表

搜索[springboot],共4370篇文章
优秀的个人博客,低调大师

SpringBoot2 整合ElasticJob框架,定制化管理流程

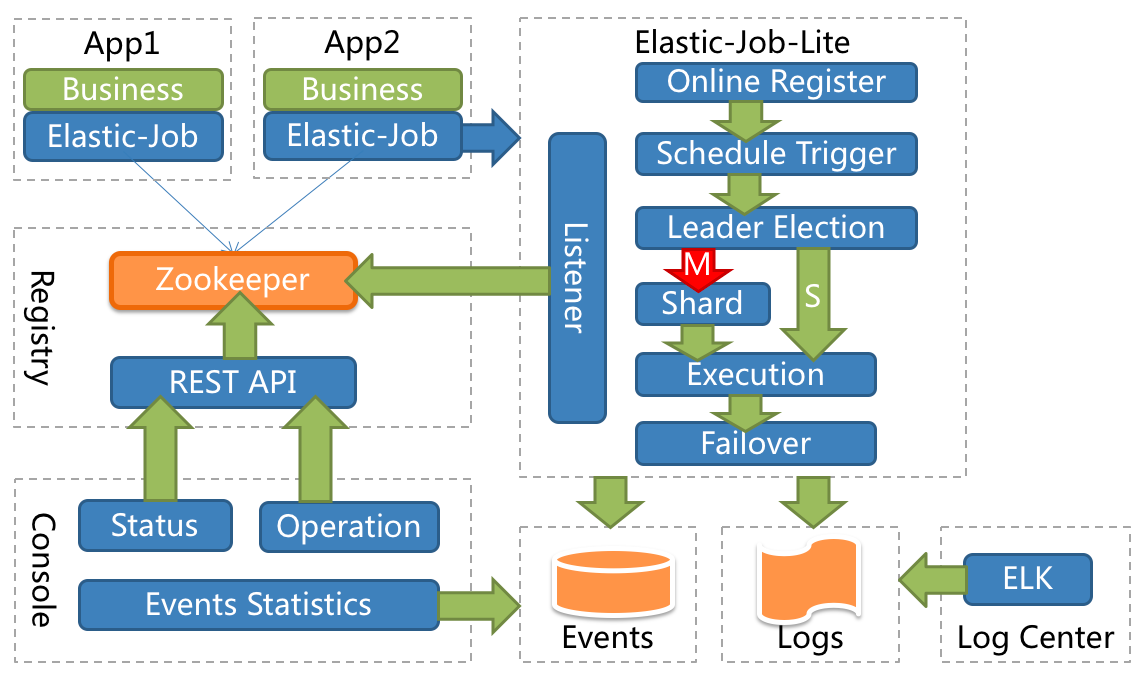
一、ElasticJob简介 1、定时任务 在前面的文章中,说过QuartJob这个定时任务,被广泛应用的定时任务标准。但Quartz核心点在于执行定时任务并不是在于关注的业务模式和场景,缺少高度自定义的功能。Quartz能够基于数据库实现任务的高可用,但是不具备分布式并行调度的功能。 2、ElasticJob说明 基础简介 Elastic-Job 是一个开源的分布式调度中间件,由两个相互独立的子项目 Elastic-Job-Lite 和 Elastic-Job-Cloud 组成。Elastic-Job-Lite 为轻量级无中心化解决方案,使用 jar 包提供分布式任务的调度和治理。 Elastic-Job-Cloud 是一个 Mesos Framework,依托于Mesos额外提供资源治理、应用分发以及进程隔离等服务。 功能特点 分布式调度协调 弹性扩容缩容 失效转移 错过执行作业重触发 作业分片一致性,保证同一分片在分布式环境中仅一个执行实例 补刀:人家官网这样描述的,这里赘述一下,充实一下文章。 基础框架结构 该图片来自ElasticJob官网。 由图可知如下内容: 需要Zookeeper组件支持,作为分布式的调度任务,有良好的监听机制,和控制台,下面的案例也就冲这个图解来。 3、分片管理 这个概念在ElasticJob中是最具有特点的,实用性极好。 分片概念 任务的分布式执行,需要将一个任务拆分为多个独立的任务项,然后由分布式的服务器分别执行某一个或几个分片项。 场景描述:假设有服务3台,分3片管理,要处理数据表100条,那就可以100%3,按照余数0,1,2分散到三台服务上执行,看到这里分库分表的基本逻辑涌上心头,这就是为何很多大牛讲说,编程思维很重要。 个性化参数 个性化参数即shardingItemParameter,可以和分片项匹配对应关系,用于将分片项的数字转换为更加可读的业务代码。 场景描述:这里猛一读好像很飘逸,其实就是这个意思,如果分3片,取名[0,1,2]不好看,或者不好标识,可以分别给个别名标识一下,[0=A,1=B,2=C]。 二、定时任务加载 1、核心依赖包 这里使用2.0+的版本。 <dependency> <groupId>com.dangdang</groupId> <artifactId>elastic-job-lite-core</artifactId> <version>2.1.5</version> </dependency> <dependency> <groupId>com.dangdang</groupId> <artifactId>elastic-job-lite-spring</artifactId> <version>2.1.5</version> </dependency> 2、核心配置文件 这里主要配置一下Zookeeper中间件,分片和分片参数。 zookeeper: server: 127.0.0.1:2181 namespace: es-job job-config: cron: 0/10 * * * * ? shardCount: 1 shardItem: 0=A,1=B,2=C,3=D 3、自定义注解 看了官方的案例,没看到好用的注解,这里只能自己编写一个,基于案例的加载过程和核心API作为参考。 核心配置类: com.dangdang.ddframe.job.lite.config.LiteJobConfiguration 根据自己想如何使用注解的思路,比如我只想注解定时任务名称和Cron表达式这两个功能,其他参数直接统一配置(这里可能是受QuartJob影响太深,可能根本就是想省事...) @Inherited @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) public @interface TaskJobSign { @AliasFor("cron") String value() default ""; @AliasFor("value") String cron() default ""; String jobName() default ""; } 4、作业案例 这里打印一些基本参数,对照配置和注解,一目了然。 @Component @TaskJobSign(cron = "0/5 * * * * ?",jobName = "Hello-Job") public class HelloJob implements SimpleJob { private static final Logger LOG = LoggerFactory.getLogger(HelloJob.class.getName()) ; @Override public void execute(ShardingContext shardingContext) { LOG.info("当前线程: "+Thread.currentThread().getId()); LOG.info("任务分片:"+shardingContext.getShardingTotalCount()); LOG.info("当前分片:"+shardingContext.getShardingItem()); LOG.info("分片参数:"+shardingContext.getShardingParameter()); LOG.info("任务参数:"+shardingContext.getJobParameter()); } } 5、加载定时任务 既然自定义注解,那加载过程自然也要自定义一下,读取自定义的注解,配置化,加入容器,然后初始化,等着任务执行就好。 @Configuration public class ElasticJobConfig { @Resource private ApplicationContext applicationContext ; @Resource private ZookeeperRegistryCenter zookeeperRegistryCenter; @Value("${job-config.cron}") private String cron ; @Value("${job-config.shardCount}") private int shardCount ; @Value("${job-config.shardItem}") private String shardItem ; /** * 配置任务监听器 */ @Bean public ElasticJobListener elasticJobListener() { return new TaskJobListener(); } /** * 初始化配置任务 */ @PostConstruct public void initTaskJob() { Map<String, SimpleJob> jobMap = this.applicationContext.getBeansOfType(SimpleJob.class); Iterator iterator = jobMap.entrySet().iterator(); while (iterator.hasNext()) { // 自定义注解管理 Map.Entry<String, SimpleJob> entry = (Map.Entry)iterator.next(); SimpleJob simpleJob = entry.getValue(); TaskJobSign taskJobSign = simpleJob.getClass().getAnnotation(TaskJobSign.class); if (taskJobSign != null){ String cron = taskJobSign.cron() ; String jobName = taskJobSign.jobName() ; // 生成配置 SimpleJobConfiguration simpleJobConfiguration = new SimpleJobConfiguration( JobCoreConfiguration.newBuilder(jobName, cron, shardCount) .shardingItemParameters(shardItem).jobParameter(jobName).build(), simpleJob.getClass().getCanonicalName()); LiteJobConfiguration liteJobConfiguration = LiteJobConfiguration.newBuilder( simpleJobConfiguration).overwrite(true).build(); TaskJobListener taskJobListener = new TaskJobListener(); // 初始化任务 SpringJobScheduler jobScheduler = new SpringJobScheduler( simpleJob, zookeeperRegistryCenter, liteJobConfiguration, taskJobListener); jobScheduler.init(); } } } } 絮叨一句:不要疑问这些API是怎么知道,看下官方文档的案例,他们怎么使用这些核心API,这里就是照着写过来,就是多一步自定义注解类的加载过程。当然官方文档大致读一遍还是很有必要的。 补刀一句:如何快速学习一些组件的用法,首先找到官方文档,或者开源库Wiki,再不济ReadMe文档(如果都没有,酌情放弃,另寻其他),熟悉基本功能是否符合自己的需求,如果符合,就看下基本用法案例,熟悉API,最后就是研究自己需要的功能模块,个人经验来看,该过程是弯路最少,坑最少的。 6、任务监听 用法非常简单,实现ElasticJobListener接口。 @Component public class TaskJobListener implements ElasticJobListener { private static final Logger LOG = LoggerFactory.getLogger(TaskJobListener.class); private long beginTime = 0; @Override public void beforeJobExecuted(ShardingContexts shardingContexts) { beginTime = System.currentTimeMillis(); LOG.info(shardingContexts.getJobName()+"===>开始..."); } @Override public void afterJobExecuted(ShardingContexts shardingContexts) { long endTime = System.currentTimeMillis(); LOG.info(shardingContexts.getJobName()+ "===>结束...[耗时:"+(endTime - beginTime)+"]"); } } 絮叨一句:before和after执行前后,中间执行目标方法,标准的AOP切面思想,所以底层水平决定了对上层框架的理解速度,那本《Java编程思想》上的灰尘是不是该擦擦? 三、动态添加 1、作业任务 有部分场景需要动态添加和管理定时任务,基于上面的加载流程,在自定义一些步骤就可以。 @Component public class GetTimeJob implements SimpleJob { private static final Logger LOG = LoggerFactory.getLogger(GetTimeJob.class.getName()) ; private static final SimpleDateFormat format = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss") ; @Override public void execute(ShardingContext shardingContext) { LOG.info("Job Name:"+shardingContext.getJobName()); LOG.info("Local Time:"+format.format(new Date())); } } 2、添加任务服务 这里就动态添加上面的任务。 @Service public class TaskJobService { @Resource private ZookeeperRegistryCenter zookeeperRegistryCenter; public void addTaskJob(final String jobName,final SimpleJob simpleJob, final String cron,final int shardCount,final String shardItem) { // 配置过程 JobCoreConfiguration jobCoreConfiguration = JobCoreConfiguration.newBuilder( jobName, cron, shardCount) .shardingItemParameters(shardItem).build(); JobTypeConfiguration jobTypeConfiguration = new SimpleJobConfiguration(jobCoreConfiguration, simpleJob.getClass().getCanonicalName()); LiteJobConfiguration liteJobConfiguration = LiteJobConfiguration.newBuilder( jobTypeConfiguration).overwrite(true).build(); TaskJobListener taskJobListener = new TaskJobListener(); // 加载执行 SpringJobScheduler jobScheduler = new SpringJobScheduler( simpleJob, zookeeperRegistryCenter, liteJobConfiguration, taskJobListener); jobScheduler.init(); } } 补刀一句:这里添加之后,任务就会定时执行,如何停止任务又是一个问题,可以在任务名上做一些配置,比如在数据库生成一条记录[1,job1,state],如果调度到state为停止状态的任务,直接截胡即可。 3、测试接口 @RestController public class TaskJobController { @Resource private TaskJobService taskJobService ; @RequestMapping("/addJob") public String addJob(@RequestParam("cron") String cron,@RequestParam("jobName") String jobName, @RequestParam("shardCount") Integer shardCount, @RequestParam("shardItem") String shardItem) { taskJobService.addTaskJob(jobName, new GetTimeJob(), cron, shardCount, shardItem); return "success"; } } 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/middle-ware-parent GitEE·地址 https://gitee.com/cicadasmile/middle-ware-parent

优秀的个人博客,低调大师

SpringBoot MQ 系列】RabbitMq 核心知识点小结

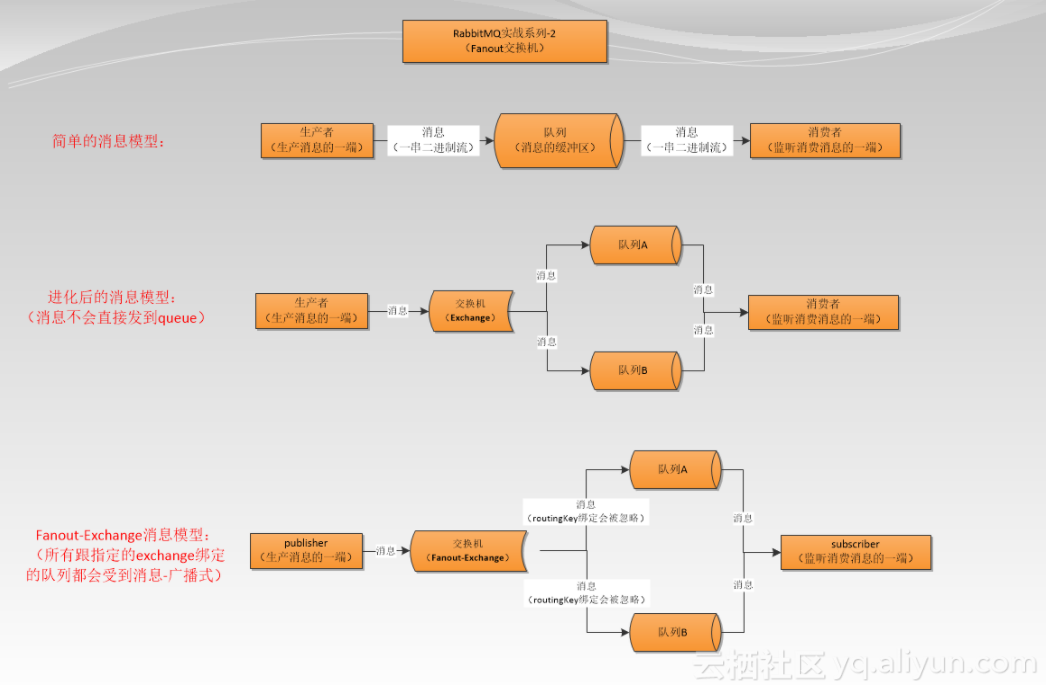
【MQ 系列】RabbitMq 核心知识点小结 以下内容,部分取材于官方教程,部分来源网络博主的分享,如有兴趣了解更多详细的知识点,可以在本文最后的文章列表中获取原地址 RabbitMQ 是一个基于 AMQP 协议实现的企业级消息系统,想要顺畅的玩耍的前提是得先了解它,本文将主要介绍 rabbitmq 的一些基本知识点 特点 基本概念 消息投递消费的几种姿势 事务 集群 <!-- more --> I. 基本知识点 它是采用 Erlang 语言实现的 AMQP(Advanced Message Queued Protocol)的消息中间件,最初起源于金融系统,用在分布式系统存储转发消息,目前广泛应用于各类系统用于解耦、削峰 1.特点 首先得了解一下 rabbitmq 的特点,看看是否满足我们的系统需求(毕竟学习一个框架也是要不少时间的) 以下内容来自: MQ 和 RabbitMQ 作用特点 主要特点,大致可以归纳为以下几个 可靠性:通过支持消息持久化,支持事务,支持消费和传输的 ack 等来确保可靠性 路由机制:支持主流的订阅消费模式,如广播,订阅,headers 匹配等 扩展性:多个 RabbitMQ 节点可以组成一个集群,也可以根据实际业务情况动态地扩展集群中节点。 高可用性:队列可以在集群中的机器上设置镜像,使得在部分节点出现问题的情况下队仍然可用。 多种协议:RabbitMQ 除了原生支持 AMQP 协议,还支持 STOMP,MQTT 等多种消息中间件协议。 多语言客户端:RabbitMQ 几乎支持所有常用语言,比如 Jav a、Python、Ruby、PHP、C#、JavaScript 等。 管理界面:RabbitMQ 提供了一个易用的用户界面,使得用户可以监控和管理消息、集群中的节点等。 插件机制:RabbitMQ 提供了许多插件,以实现从多方面进行扩展,当然也可以编写自己的插件。 2. 基本概念 下图为 rabbitmq 的内部结构图 从上图也可以发现几个基本概念(Message, Publisher, Exchange, Binding, Queue, Channel, Consuer, Virtual host) 下面逐一进行说明 a. Message 具体的消息,包含消息头(即附属的配置信息)和消息体(即消息的实体内容) 由发布者,将消息推送到 Exchange,由消费者从 Queue 中获取 b. Publisher 消息生产者,负责将消息发布到交换器(Exchange) c. Exchange 交换器,用来接收生产者发送的消息并将这些消息路由给服务器中的队列 d. Binding 绑定,用于给 Exchange 和 Queue 建立关系,从而决定将这个交换器中的哪些消息,发送到对应的 Queue e. Queue 消息队列,用来保存消息直到发送给消费者 它是消息的容器,也是消息的终点 一个消息可投入一个或多个队列 消息一直在队列里面,等待消费者连接到这个队列将其取走 f. Connection 连接,内部持有一些 channel,用于和 queue 打交道 g. Channel 信道(通道),MQ 与外部打交道都是通过 Channel 来的,发布消息、订阅队列还是接收消息,这些动作都是通过 Channel 完成; 简单来说就是消息通过 Channel 塞进队列或者流出队列 h. Consumer 消费者,从消息队列中获取消息的主体 i. Virtual Host 虚拟主机,表示一批交换器、消息队列和相关对象。 虚拟主机是共享相同的身份认证和加密环境的独立服务器域。 每个 vhost 本质上就是一个 mini 版的 RabbitMQ 服务器,拥有自己的队列、交换器、绑定和权限机制。 vhost 是 AMQP 概念的基础,必须在连接时指定,RabbitMQ 默认的 vhost 是 / 可以理解为 db 中的数据库的概念,用于逻辑拆分 j. Broker 消息队列服务器实体 3. 消息投递消费 从前面的内部结构图可以知晓,消息由生产者发布到 Exchange,然后通过路由规则,分发到绑定 queue 上,供消费者获取消息 接下来我们看一下 Exchange 支持的四种策略 a. Direct 策略 消息中的路由键(routing key)如果和 Binding 中的 binding key 一致, 交换器就将消息发到对应的队列中 简单来讲,就是rounting key与binding key完全匹配 如果一个队列绑定到交换机要求路由键为dog 只转发routing key 标记为dog的消息, 不会转发dog.puppy,也不会转发“dog.guard”等等 它是完全匹配、单播的模式 举例说明 Exchange 和两个队列绑定在一起: Q1 的 bindingkey 是 orange Q2 的 binding key 是 black 和 green. 当 Producer 发布一个消息,其routing key是orange时, exchange 会把它放到 Q1 上, 如果是black或green就会到 Q2 上, 其余的 Message 被丢弃 注意 当有多个队列绑定到同一个 Exchange,且 binding key 相同时,这时消息会分发给所有满足条件的队列 b. Topic 策略 这个策略可以看成是 Direct 策略的升级版,通过routing key与 bingding key的模式匹配方式来分发消息 简单来讲,直接策略是完全精确匹配,而 topic 则支持正则匹配,满足某类指定规则的(如以 xxx 开头的路由键),可以将消息分发过去 # 匹配 0 个或多个单词 * 匹配不多不少一个单词 一个更直观的实例如下 Producer 发送消息时需要设置 routing_key, Q1 的 binding key 是*.orange.* Q2 是 *.*.rabbit 和 lazy.#: 发布一个routing key为test.orange.mm 消息,则会路由到 Q1; 注意: 如果是routng key是 test.orange则无法路由到 Q1, 因为 Q1 的规则是三个单词,中间一个为 orange,不满足这个规则的都无效 发布一个routing key为test.qq.rabbit或者lazy.qq的消息 都可以分发到 Q2;即路由 key 为三个单词,最后一个为 rabbit 或者不限制单词个数,主要第一个是 lazy 的消息,都可以分发过来 如果发布的是一个test.orange.rabbit消息,则 Q1 和 Q2 都可以满足 注意: 这时两个队列都会接受到这个消息 c. Fanout 策略 广播策略,忽略routing key 和 binding key,将消息分发给所有绑定在这个 exchange 上的 queue d. Headers 策略 这个实际上用得不多,它是根据 Message 的一些头部信息来分发过滤 Message,忽略 routing key 的属性,如果 Header 信息和 message 消息的头信息相匹配 II. 消息一致性问题 在进入 rabbitmq 如何保证一致性之前,我们先得理解,什么是消息一致性? 1. 一致性问题 数据的一致性是什么 按照我个人的粗浅理解,我认为的消息一致性,应该包含下面几个 生产者,确保消息发布成功 消息不会丢 顺序不会乱 消息不会重复(如重传,导致发布一次,却出现多个消息) 消费者,确保消息消费成功 有序消费 不重复消费 发送端 为了确保发布者推送的消息不会丢失,我们需要消息持久化 broker 持久化消息 为了确定消息正确接收 publisher 需要知道消息投递并成功持久化 2. 持久化 这里的持久化,主要是指将内存中的消息保存到磁盘,避免 mq 宕机导致的内存中消息丢失;然而单纯的持久化,只是保证一致性的其中一个要素,比如 publisher 将消息发送到 exchange,在 broker 持久化的工程中,宕机了导致持久化失败,而 publisher 并不知道持久化失败,这个时候就会出现数据丢失,为了解决这个问题,rabbitmq 提供了事务机制 3. 事务机制 事务机制能够解决生产者与 broker 之间消息确认的问题,只有消息成功被 broker 接受,事务才能提交成功,否则就进行事务回滚操作并进行消息重发。但是使用事务机制会降低 RabbitMQ 的消息吞吐量,不适用于需要发布大量消息的业务场景。 注意,事务是同步的 4. 消息确认机制 RabbitMQ 学习(六)——消息确认机制(Confirm 模式) 消息确认机制,可以区分为生产端和消费端 生产端 生产者将信道设置成 Confirm 模式,一旦信道进入 Confirm 模式,所有在该信道上面发布的消息都会被指派一个唯一的 ID(以 confirm.select 为基础从 1 开始计数), 一旦消息被投递到所有匹配的队列之后,Broker 就会发送一个确认给生产者(包含消息的唯一 ID),这就使得生产者知道消息已经正确到达目的队列了, 如果消息和队列是可持久化的,那么确认消息会将消息写入磁盘之后发出, Broker 回传给生产者的确认消息中 deliver-tag 域包含了确认消息的序列号(此外 Broker 也可以设置 basic.ack 的 multiple 域,表示到这个序列号之前的所有消息都已经得到了处理) Confirm 模式属性异步,publisher 发布一条消息之后,在等信道返回确认的同时,依然可以继续发送下一条消息,所以小概率会出现投递的消息顺序和 broker 中持久化消息顺序不一致的问题 一般从编程角度出发,Confirm 模式有三种姿势 普通 Confirm 模式:发送一条消息之后,等到服务器 confirm,然后再发布下一条消息(串行发布) 批量 Confirm 模式:发送一批消息之后,等到服务器 confirm,然后再发布下一批消息(如果失败,这一批消息全部重复,所以会有重复问题) 异步 Confirm 模式:提供一个回调方法,服务器 confirm 之后,触发回调方法,因此不会阻塞下一条消息的发送 消费端 ACK 机制是消费者从 RabbitMQ 收到消息并处理完成后,反馈给 RabbitMQ,RabbitMQ 收到反馈后才将此消息从队列中删除。 如果一个消费者在处理消息出现了网络不稳定、服务器异常等现象,那么就不会有 ACK 反馈,RabbitMQ 会认为这个消息没有正常消费,会将消息重新放入队列中 如果在集群的情况下,RabbitMQ 会立即将这个消息推送给这个在线的其他消费者。这种机制保证了在消费者服务端故障的时候,不丢失任何消息和任务 消息永远不会从 RabbitMQ 中删除,只有当消费者正确发送 ACK 反馈,RabbitMQ 确认收到后,消息才会从 RabbitMQ 服务器的数据中删除 III. 集群 按照目前的发展趋势,一个不支持集群的中间件基本上是不会有市场的;rabbitmq 也是支持集群的,下面简单的介绍一下常见的 4 种集群架构模式 以下内容来自网上博文,详情请点击右边:RabbitMQ 的 4 种集群架构 1. 主备模式 这个属于常见的集群模式了,但又不太一样 主节点提供读写,备用节点不提供读写。如果主节点挂了,就切换到备用节点,原来的备用节点升级为主节点提供读写服务,当原来的主节点恢复运行后,原来的主节点就变成备用节点 2. 远程模式 远程模式可以实现双活的一种模式,简称 shovel 模式,所谓的 shovel 就是把消息进行不同数据中心的复制工作,可以跨地域的让两个 MQ 集群互联,远距离通信和复制。 Shovel 就是我们可以把消息进行数据中心的复制工作,我们可以跨地域的让两个 MQ 集群互联。 如上图,有两个异地的 MQ 集群(可以是更多的集群),当用户在地区 1 这里下单了,系统发消息到 1 区的 MQ 服务器,发现 MQ 服务已超过设定的阈值,负载过高,这条消息就会被转到 地区 2 的 MQ 服务器上,由 2 区的去执行后面的业务逻辑,相当于分摊我们的服务压力。 3. 镜像模式 非常经典的 mirror 镜像模式,保证 100% 数据不丢失。在实际工作中也是用得最多的,并且实现非常的简单,一般互联网大厂都会构建这种镜像集群模式。 如上图,用 KeepAlived 做了 HA-Proxy 的高可用,然后有 3 个节点的 MQ 服务,消息发送到主节点上,主节点通过 mirror 队列把数据同步到其他的 MQ 节点,这样来实现其高可靠 4. 多活模式 也是实现异地数据复制的主流模式,因为 shovel 模式配置比较复杂,所以一般来说,实现异地集群的都是采用这种双活 或者 多活模型来实现的。这种模式需要依赖 rabbitMQ 的 federation 插件,可以实现持续的,可靠的 AMQP 数据通信,多活模式在实际配置与应用非常的简单 rabbitMQ 部署架构采用双中心模式(多中心),那么在两套(或多套)数据中心各部署一套 rabbitMQ 集群,各中心的 rabbitMQ 服务除了需要为业务提供正常的消息服务外,中心之间还需要实现部分队列消息共享。 federation 插件是一个不需要构建 cluster ,而在 brokers 之间传输消息的高性能插件,federation 插件可以在 brokers 或者 cluster 之间传输消息,连接的双方可以使用不同的 users 和 virtual hosts,双方也可以使用不同版本的 rabbitMQ 和 erlang。federation 插件使用 AMQP 协议通信,可以接受不连续的传输。federation 不是建立在集群上的,而是建立在单个节点上的,如图上黄色的 rabbit node 3 可以与绿色的 node1、node2、node3 中的任意一个利用 federation 插件进行数据同步。 IV. 其他 0. 项目 工程:https://github.com/liuyueyi/spring-boot-demo 1. 相关博文 RabbitMQ Tutorials MQ 和 RabbitMQ 作用特点 RabbitMq 基础教程之基本概念 RabbitMQ 学习(六)——消息确认机制(Confirm 模式) RabbitMQ 的 4 种集群架构 Rabbitmq 是如何来保证事务的 rabbitmq 消息一致性问题 2. 一灰灰 Blog 尽信书则不如,以上内容,纯属一家之言,因个人能力有限,难免有疏漏和错误之处,如发现 bug 或者有更好的建议,欢迎批评指正,不吝感激 下面一灰灰的个人博客,记录所有学习和工作中的博文,欢迎大家前去逛逛 一灰灰 Blog 个人博客 https://blog.hhui.top 一灰灰 Blog-Spring 专题博客 http://spring.hhui.top

优秀的个人博客,低调大师

SpringBoot2.0 整合 RocketMQ ,实现请求异步处理

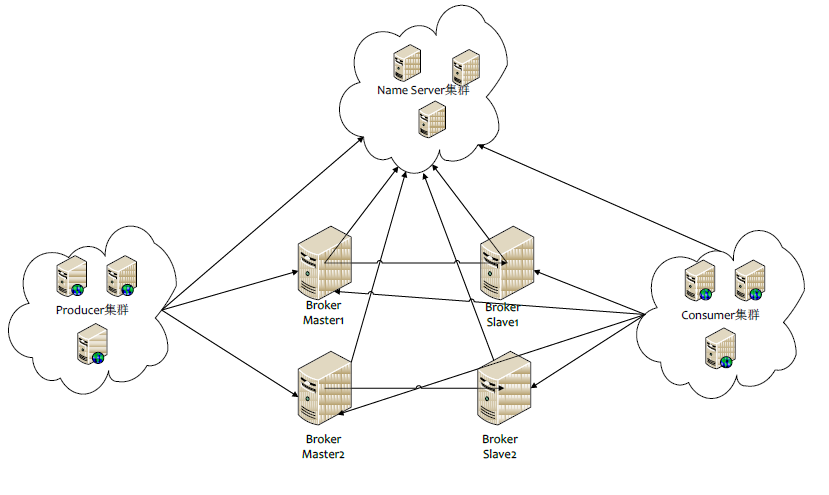
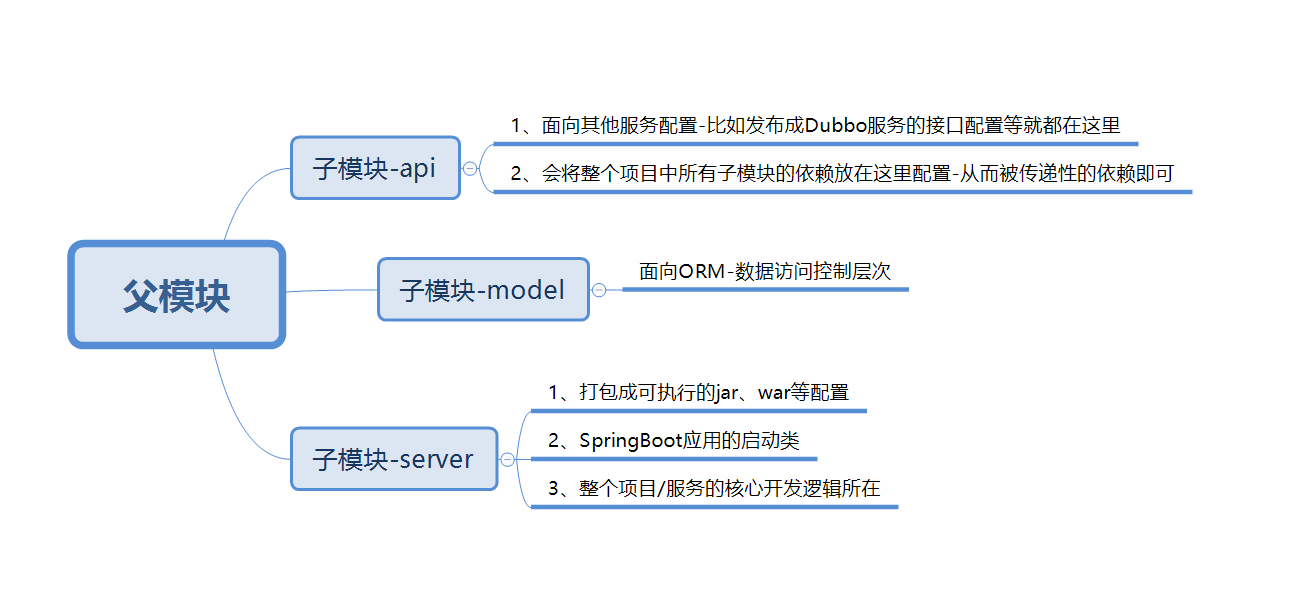
本文源码:GitHub·点这里 || GitEE·点这里 一、RocketMQ简介 1、架构图片 2、角色分类 (1)、Broker RocketMQ 的核心,接收 Producer 发过来的消息、处理 Consumer 的消费消息请求、消息的持 久化存储、服务端过滤功能等 。 (2)、NameServer 消息队列中的状态服务器,集群的各个组件通过它来了解全局的信息 。类似微服务中注册中心的服务注册,发现,下线,上线的概念。 热备份:NamServer可以部署多个,相互之间独立,其他角色同时向多个NameServer 机器上报状态信息。 心跳机制:NameServer 中的 Broker、 Topic等状态信息不会持久存储,都是由各个角色定时上报并存储到内存中,超时不上报的话, NameServer会认为某个机器出故障不可用。 (3)、Producer 消息的生成者,最常用的producer类就是DefaultMQProducer。 (4)、Consumer 消息的消费者,常用Consumer类DefaultMQPushConsumer收到消息后自动调用传入的处理方法来处理,实时性高DefaultMQPullConsumer用户自主控制 ,灵活性更高。 3、通信机制 (1)、Broker启动后需要完成一次将自己注册至NameServer的操作;随后每隔30s时间定时向NameServer更新Topic路由信息。 (2)、Producer发送消息时候,需要根据消息的Topic从本地缓存的获取路由信息。如果没有则更新路由信息会从NameServer重新拉取,同时Producer会默认每隔30s向NameServer拉取一次路由信息。 (3)、Consumer消费消息时候,从NameServer获取的路由信息,并再完成客户端的负载均衡后,监听指定消息队列获取消息并进行消费。 二、代码实现案例 1、项目结构图 版本描述 <spring-boot.version>2.1.3.RELEASE</spring-boot.version> <rocketmq.version>4.3.0</rocketmq.version> 2、配置文件 rocketmq: # 生产者配置 producer: isOnOff: on # 发送同一类消息的设置为同一个group,保证唯一 groupName: CicadaGroup # 服务地址 namesrvAddr: 127.0.0.1:9876 # 消息最大长度 默认1024*4(4M) maxMessageSize: 4096 # 发送消息超时时间,默认3000 sendMsgTimeout: 3000 # 发送消息失败重试次数,默认2 retryTimesWhenSendFailed: 2 # 消费者配置 consumer: isOnOff: on # 官方建议:确保同一组中的每个消费者订阅相同的主题。 groupName: CicadaGroup # 服务地址 namesrvAddr: 127.0.0.1:9876 # 接收该 Topic 下所有 Tag topics: CicadaTopic~*; consumeThreadMin: 20 consumeThreadMax: 64 # 设置一次消费消息的条数,默认为1条 consumeMessageBatchMaxSize: 1 # 配置 Group Topic Tag rocket: group: rocketGroup topic: rocketTopic tag: rocketTag 3、生产者配置 /** * RocketMQ 生产者配置 */ @Configuration public class ProducerConfig { private static final Logger LOG = LoggerFactory.getLogger(ProducerConfig.class) ; @Value("${rocketmq.producer.groupName}") private String groupName; @Value("${rocketmq.producer.namesrvAddr}") private String namesrvAddr; @Value("${rocketmq.producer.maxMessageSize}") private Integer maxMessageSize ; @Value("${rocketmq.producer.sendMsgTimeout}") private Integer sendMsgTimeout; @Value("${rocketmq.producer.retryTimesWhenSendFailed}") private Integer retryTimesWhenSendFailed; @Bean public DefaultMQProducer getRocketMQProducer() { DefaultMQProducer producer; producer = new DefaultMQProducer(this.groupName); producer.setNamesrvAddr(this.namesrvAddr); //如果需要同一个jvm中不同的producer往不同的mq集群发送消息,需要设置不同的instanceName if(this.maxMessageSize!=null){ producer.setMaxMessageSize(this.maxMessageSize); } if(this.sendMsgTimeout!=null){ producer.setSendMsgTimeout(this.sendMsgTimeout); } //如果发送消息失败,设置重试次数,默认为2次 if(this.retryTimesWhenSendFailed!=null){ producer.setRetryTimesWhenSendFailed(this.retryTimesWhenSendFailed); } try { producer.start(); } catch (MQClientException e) { e.printStackTrace(); } return producer; } } 4、消费者配置 /** * RocketMQ 消费者配置 */ @Configuration public class ConsumerConfig { private static final Logger LOG = LoggerFactory.getLogger(ConsumerConfig.class) ; @Value("${rocketmq.consumer.namesrvAddr}") private String namesrvAddr; @Value("${rocketmq.consumer.groupName}") private String groupName; @Value("${rocketmq.consumer.consumeThreadMin}") private int consumeThreadMin; @Value("${rocketmq.consumer.consumeThreadMax}") private int consumeThreadMax; @Value("${rocketmq.consumer.topics}") private String topics; @Value("${rocketmq.consumer.consumeMessageBatchMaxSize}") private int consumeMessageBatchMaxSize; @Resource private RocketMsgListener msgListener; @Bean public DefaultMQPushConsumer getRocketMQConsumer(){ DefaultMQPushConsumer consumer = new DefaultMQPushConsumer(groupName); consumer.setNamesrvAddr(namesrvAddr); consumer.setConsumeThreadMin(consumeThreadMin); consumer.setConsumeThreadMax(consumeThreadMax); consumer.registerMessageListener(msgListener); consumer.setConsumeFromWhere(ConsumeFromWhere.CONSUME_FROM_LAST_OFFSET); consumer.setConsumeMessageBatchMaxSize(consumeMessageBatchMaxSize); try { String[] topicTagsArr = topics.split(";"); for (String topicTags : topicTagsArr) { String[] topicTag = topicTags.split("~"); consumer.subscribe(topicTag[0],topicTag[1]); } consumer.start(); }catch (MQClientException e){ e.printStackTrace(); } return consumer; } } 5、消息监听配置 /** * 消息消费监听 */ @Component public class RocketMsgListener implements MessageListenerConcurrently { private static final Logger LOG = LoggerFactory.getLogger(RocketMsgListener.class) ; @Resource private ParamConfigService paramConfigService ; @Override public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> list, ConsumeConcurrentlyContext context) { if (CollectionUtils.isEmpty(list)){ return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } MessageExt messageExt = list.get(0); LOG.info("接受到的消息为:"+new String(messageExt.getBody())); int reConsume = messageExt.getReconsumeTimes(); // 消息已经重试了3次,如果不需要再次消费,则返回成功 if(reConsume ==3){ return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } if(messageExt.getTopic().equals(paramConfigService.rocketTopic)){ String tags = messageExt.getTags() ; switch (tags){ case "rocketTag": LOG.info("开户 tag == >>"+tags); break ; default: LOG.info("未匹配到Tag == >>"+tags); break; } } // 消息消费成功 return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } } 6、配置参数绑定 @Service public class ParamConfigService { @Value("${rocket.group}") public String rocketGroup ; @Value("${rocket.topic}") public String rocketTopic ; @Value("${rocket.tag}") public String rocketTag ; } 7、消息发送测试 @Service public class RocketMqServiceImpl implements RocketMqService { @Resource private DefaultMQProducer defaultMQProducer; @Resource private ParamConfigService paramConfigService ; @Override public SendResult openAccountMsg(String msgInfo) { // 可以不使用Config中的Group defaultMQProducer.setProducerGroup(paramConfigService.rocketGroup); SendResult sendResult = null; try { Message sendMsg = new Message(paramConfigService.rocketTopic, paramConfigService.rocketTag, "open_account_key", msgInfo.getBytes()); sendResult = defaultMQProducer.send(sendMsg); } catch (Exception e) { e.printStackTrace(); } return sendResult ; } } 三、项目源码 GitHub·地址 https://github.com/cicadasmile/middle-ware-parent GitEE·地址 https://gitee.com/cicadasmile/middle-ware-parent

优秀的个人博客,低调大师

springboot+redis分布式锁-模拟抢单

本篇内容主要讲解的是redis分布式锁,这个在各大厂面试几乎都是必备的,下面结合模拟抢单的场景来使用她;本篇不涉及到的redis环境搭建,快速搭建个人测试环境,这里建议使用docker;本篇内容节点如下:1.jedis的nx生成锁2.如何删除锁3.模拟抢单动作(10w个人开抢) jedis的nx生成锁对于java中想操作redis,好的方式是使用jedis,首先pom中引入依赖: 1 <dependency>2 <groupId>redis.clients</groupId>3 <artifactId>jedis</artifactId>4 </dependency> 对于分布式锁的生成通常需要注意如下几个方面:1、创建锁的策略:redis的普通key一般都允许覆盖,A用户set某个key后,B在set相同的key时同样能成功,如果是锁场景,那就无法知道到底是哪个用户set成功的;这里jedis的setnx方式为我们解决了这个问题,简单原理是:当A用户先set成功了,那B用户set的时候就返回失败,满足了某个时间点只允许一个用户拿到锁。 2、锁过期时间:某个抢购场景时候,如果没有过期的概念,当A用户生成了锁,但是后面的流程被阻塞了一直无法释放锁,那其他用户此时获取锁就会一直失败,无法完成抢购的活动;当然正常情况一般都不会阻塞,A用户流程会正常释放锁;过期时间只是为了更有保障。 下面来上段setnx操作的代码: 1 public boolean setnx(String key, String val) { 2 Jedis jedis = null; 3 try { 4 jedis = jedisPool.getResource(); 5 if (jedis == null) { 6 return false; 7 } 8 return jedis.set(key, val, "NX", "PX", 1000 * 60). 9 equalsIgnoreCase("ok");10 } catch (Exception ex) {11 } finally {12 if (jedis != null) {13 jedis.close();14 }15 }16 return false;17 } 这里注意点在于jedis的set方法,其参数的说明如:1、NX:是否存在key,存在就不set成功2、PX:key过期时间单位设置为毫秒(EX:单位秒) setnx如果失败直接封装返回false即可,下面我们通过一个get方式的api来调用下这个setnx方法: 1 @GetMapping("/setnx/{key}/{val}")2 public boolean setnx(@PathVariable String key, @PathVariable String val) {3 return jedisCom.setnx(key, val);4 } 访问如下测试url,正常来说第一次返回了true,第二次返回了false,由于第二次请求的时候redis的key已存在,所以无法set成功 由上图能够看到只有一次set成功,并key具有一个有效时间,此时已到达了分布式锁的条件。 如何删除锁 上面是创建锁,同样的具有有效时间,但是我们不能完全依赖这个有效时间,场景如:有效时间设置1分钟,本身用户A获取锁后,没遇到什么特殊情况正常生成了抢购订单后,此时其他用户应该能正常下单了才对,但是由于有个1分钟后锁才能自动释放,那其他用户在这1分钟无法正常下单(因为锁还是A用户的),因此我们需要A用户操作完后,主动去解锁: 1 public int delnx(String key, String val) { 2 Jedis jedis = null; 3 try { 4 jedis = jedisPool.getResource(); 5 if (jedis == null) { 6 return 0; 7 } 8 9 //if redis.call('get','orderkey')=='1111' then return redis.call('del','orderkey') else return 0 end10 StringBuilder sbScript = new StringBuilder();11 sbScript.append("if redis.call('get','").append(key).append("')").append("=='").append(val).append("'").12 append(" then ").13 append(" return redis.call('del','").append(key).append("')").14 append(" else ").15 append(" return 0").16 append(" end");17 18 return Integer.valueOf(jedis.eval(sbScript.toString()).toString());19 } catch (Exception ex) {20 } finally {21 if (jedis != null) {22 jedis.close();23 }24 }25 return 0;26 } 这里也使用了jedis方式,直接执行lua脚本:根据val判断其是否存在,如果存在就del;其实个人认为通过jedis的get方式获取val后,然后再比较value是否是当前持有锁的用户,如果是那最后再删除,效果其实相当;只不过直接通过eval执行脚本,这样避免多一次操作了redis而已,缩短了原子操作的间隔。(如有不同见解请留言探讨);同样这里创建个get方式的api来测试: 1 @GetMapping("/delnx/{key}/{val}")2 public int delnx(@PathVariable String key, @PathVariable String val) {3 return jedisCom.delnx(key, val);4 } 注意的是delnx时,需要传递创建锁时的value,因为通过et的value与delnx的value来判断是否是持有锁的操作请求,只有value一样才允许del; 模拟抢单动作(10w个人开抢)有了上面对分布式锁的粗略基础,我们模拟下10w人抢单的场景,其实就是一个并发操作请求而已,由于环境有限,只能如此测试;如下初始化10w个用户,并初始化库存,商品等信息,如下代码: 1 //总库存 2 private long nKuCuen = 0; 3 //商品key名字 4 private String shangpingKey = "computer_key"; 5 //获取锁的超时时间 秒 6 private int timeout = 30 * 1000; 7 8 @GetMapping("/qiangdan") 9 public List<String> qiangdan() {10 11 //抢到商品的用户12 List<String> shopUsers = new ArrayList<>();13 14 //构造很多用户15 List<String> users = new ArrayList<>();16 IntStream.range(0, 100000).parallel().forEach(b -> {17 users.add("神牛-" + b);18 });19 20 //初始化库存21 nKuCuen = 10;22 23 //模拟开抢24 users.parallelStream().forEach(b -> {25 String shopUser = qiang(b);26 if (!StringUtils.isEmpty(shopUser)) {27 shopUsers.add(shopUser);28 }29 });30 31 return shopUsers;32 } 有了上面10w个不同用户,我们设定商品只有10个库存,然后通过并行流的方式来模拟抢购,如下抢购的实现: 1 /** 2 * 模拟抢单动作 3 * 4 * @param b 5 * @return 6 */ 7 private String qiang(String b) { 8 //用户开抢时间 9 long startTime = System.currentTimeMillis();10 11 //未抢到的情况下,30秒内继续获取锁12 while ((startTime + timeout) >= System.currentTimeMillis()) {13 //商品是否剩余14 if (nKuCuen <= 0) {15 break;16 }17 if (jedisCom.setnx(shangpingKey, b)) {18 //用户b拿到锁19 logger.info("用户{}拿到锁...", b);20 try {21 //商品是否剩余22 if (nKuCuen <= 0) {23 break;24 }25 26 //模拟生成订单耗时操作,方便查看:神牛-50 多次获取锁记录27 try {28 TimeUnit.SECONDS.sleep(1);29 } catch (InterruptedException e) {30 e.printStackTrace();31 }32 33 //抢购成功,商品递减,记录用户34 nKuCuen -= 1;35 36 //抢单成功跳出37 logger.info("用户{}抢单成功跳出...所剩库存:{}", b, nKuCuen);38 39 return b + "抢单成功,所剩库存:" + nKuCuen;40 } finally {41 logger.info("用户{}释放锁...", b);42 //释放锁43 jedisCom.delnx(shangpingKey, b);44 }45 } else {46 //用户b没拿到锁,在超时范围内继续请求锁,不需要处理47 // if (b.equals("神牛-50") || b.equals("神牛-69")) {48 // logger.info("用户{}等待获取锁...", b);49 // }50 }51 }52 return "";53 } 这里实现的逻辑是:1、parallelStream():并行流模拟多用户抢购2、(startTime + timeout) >= System.currentTimeMillis():判断未抢成功的用户,timeout秒内继续获取锁3、获取锁前和后都判断库存是否还足够4、jedisCom.setnx(shangpingKey, b):用户获取抢购锁5、获取锁后并下单成功,最后释放锁:jedisCom.delnx(shangpingKey, b) 再来看下记录的日志结果: 最终返回抢购成功的用户: git地址:https://github.com/shenniubuxing3

优秀的个人博客,低调大师

补习系列(16)-springboot mongodb 数据库应用技巧

一、关于 MongoDB MongoDB 目前非常流行,在最近的DB-Engine排名中居第5位,仅次于传统的关系型数据库如 Oracle、Mysql。 然而在非关系型数据库领域,MongoDB已经持续成为佼佼者一段时间了,这与 MongoDB的一些优势存在一定关系: 无模式(Schema),便于快速开发; 面向文档化的数据,基于BSON格式(类JSON),灵活性强 高性能,得益于其内存计算能力; 副本集、自动分片特性,提供了高可用及水平扩展能力 MongoDB 的主要对象包括数据库(database)、集合(collection)、文档对象(document),与关系型数据库的对应关系如下: MySql MongoDB schema database table collection record document column field 与关系型数据库一样,M

优秀的个人博客,低调大师

SpringBoot整合RabbitMQ之典型应用场景实战三

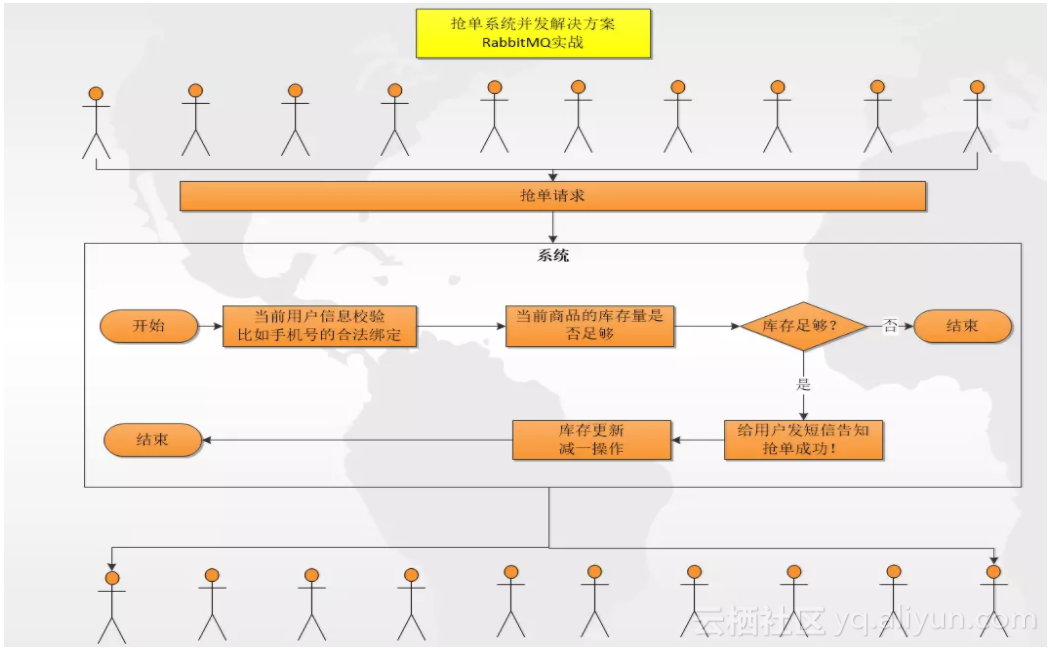
实战前言 RabbitMQ 作为目前应用相当广泛的消息中间件,在企业级应用、微服务应用中充当着重要的角色。特别是在一些典型的应用场景以及业务模块中具有重要的作用,比如业务服务模块解耦、异步通信、高并发限流、超时业务、数据延迟处理等。前两篇博文我介绍分享了RabbitMQ在业务服务模块异步解耦以及通信的实战业务场景,感兴趣童鞋可以前往观看:1.https://www.roncoo.com/article/detail/134309 2.https://www.roncoo.com/article/detail/134312 这篇博文我们继续介绍分享RabbitMQ死信队列实战以及在支付系统中支付过程超时则自动失效其下单记录 这样的业务场景! RabbitMQ 实战:死信队列认识与场景实战 死信队列认识 死信队列,又可以称之为“延迟/延时队列”,也是队列的一种,只不过与普通的队列最大的不同之处在于创建时的组成成分不同,创建死信队列的“成分”将不仅仅只是:名称、持久化、自动删除等基本属性,还包含了死信交换机、死信路由甚至还有TTL(Time-To-Live)即队列中消息可生存的时间。 死信队列其实最大的作用是可以实现消息或者数据延迟/延时处理,而且还可以动态的设定延迟的时间,即动态设定 TTL。典型的业务场景很多,在这里就不一一列举了,总之,凡是业务中需要延迟一定时间再处理的数据均可以将其压入死信队列中,等待一定的时间后再执行真正的处理逻辑! 下面是死信队列在创建、绑定、生产消息、消费消息过程的结构流程图,在这里其实已经很明确的指出死信队列的创建跟绑定逻辑 以及 真正监听消费处理消息的队列的绑定逻辑。图中问题的答案为:当入死信队列的消息TTL一到,它自然而然的将被路由到 死信交换机绑定的队列 中被真正消费处理!!! 死信队列场景实战 有了上面的流程图做指导,接下来,我们将用死信队列实战这样的一个业务场景:用户在商城下单成功并点击去支付后在指定时间未支付时自动失效!于是乎,我们需要创建两个消息模型,在 RabbitmqConfig 实施: 死信队列:用于设定指定的待支付的交易订单号在指定的 TTL(单位为 ms)后何去何从! 真正队列:用于监听消费处理指定的交易订单号,即判断该交易订单号是否已完成,如果否,则失效之! 接下来是我们的生产端的逻辑:用户商城下单的处理! 接下来是等待固定的 TTL:在这里设定的是 10s,当消息入死信队列 10s 后,将自然而然的将消息路由到下一个中转站,即真正的消费监听处理队列进行处理:判断该笔交易订单号是否已经付款,如果否,则失效之! 可以将该服务跑起来,然后发起 controller 的用户下单请求,会发现消息入死信队列后不会立马被消费,等待 10s 会,消息会被路由到真正的消费队列中进行处理,这一现象可以在 MQ 的后端控制台应用中看到! 总结:到此我们的死信队列已经实战完毕,回顾我们所介绍的历程,其实核心重点在于上面的那张 “死信队列的结构流程图”,理解了这个结构流程图中的相关组件及其流程,则在实战各种需要延时处理的业务场景将得心应手,包括如何创建死信队列,如何面向生产端绑定死信队列,如何面向消费端绑定真正的队列等等!而对于死信队列的实战场景,前面也介绍过了:凡是需要等待一定时间或者需要缓一缓特定时间的业务、数据均可以通过死信队列来实现! 可以将该服务跑起来,然后发起 controller 的用户下单请求,会发现消息入死信队列后不会立马被消费,等待 10s 会,消息会被路由到真正的消费队列中进行处理,这一现象可以在 MQ 的后端控制台应用中看到! 回顾与总结 RabbitMQ 的认识与实际业务场景的实战到此我都已经介绍完毕,总体而言,RabbitMQ 作为目前应用相当广泛的消息中间件,在我们实际系统的业务模块中具有重要的作用,特别是刚开始介绍的几种消息模型以及死信队列模型在微服务系统、分布式系统中均可充当重要的角色,其中我们实战的业务场景包括业务服务模块解耦异步通信(异步发送日志、异步发送邮件);另外,我们还介绍了消息确认机制,这是一种 MQ 确保消息能被消费者消费的机制,对于一些业务模块也是有广泛的应用;除此之外,我们还模拟实战了秒杀系统、抢单系统这样的业务场景下 RabbitMQ 的作用:限流、排队缓压、减少数据库读写锁的发生等等! 彩蛋:本博文介绍了RabbitMQ死信队列及其业务场景的实战,此业务场景其实适用于任何需要“延迟一定时间处理”的业务,包括本博文介绍的 “支付系统-用户下单点击去支付后超时仍未支付成功时则需要暂时失效其下单记录”!另外,博主已将RabbitMQ相关技术以及场景实战的相关要点录制成了视频教程,感兴趣小伙伴可以前往学习观看:https://www.roncoo.com/course/view/95ffac8bd3aa4f2d8a0d83c32f46c69d

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册