首页 文章 精选 留言 我的

精选列表

搜索[Flowable流程审批],共10000篇文章
优秀的个人博客,低调大师

python中上双互斥锁的线程执行流程

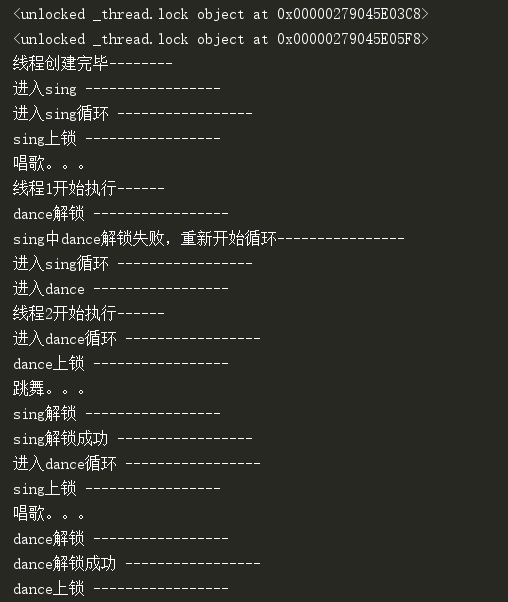
import threading def sing(): print('进入sing -----------------') for i in range(3): print('进入sing循环 -----------------') l1.acquire() print('sing上锁 -----------------') print('唱歌。。。') try: print('dance解锁 -----------------') l2.release() print('dance解锁成功 -----------------') except Exception: print('sing中dance解锁失败,重新开始循环----------------') pass def dance(): print('进入dance -----------------') for i in range(3): print('进入dance循环 -----------------') l2.acquire() print('dance上锁 -----------------') print('跳舞。。。') try: print('sing解锁 -----------------') l1.release() print('sing解锁成功 -----------------') except Exception: print('dance中sing解锁失败,重新开始循环----------------') pass if __name__ == '__main__': # sing() # dance() l1 = threading.Lock() print(l1) l2 = threading.Lock() print(l2) t1 = threading.Thread(target=sing) t2 = threading.Thread(target=dance) print('线程创建完毕--------') t1.start() print('线程1开始执行------') t2.start() print('线程2开始执行------') t1.join() print('线程1守护主线程-----') t2.join() print('线程2守护主线程-----') 这里我们暂且先不提全局解释器锁,从这个代码例子里我们可以看出,一个锁在上锁以后,如果在没有释放它的情况下再要对它上锁,他就会阻塞住,一直到它的锁被释放了以后才能够再次被上锁,这样就实现了两个线程的交替执行。 -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

Hadoop MapReduce工作详细流程(Partitioner/SortComparator/GroupingComparator)

转自:http://blog.sina.com.cn/s/blog_7581a4c30102veem.html map阶段 1. 使用job.setInputFormatClass(TextInputFormat)做为输入格式。注意输出应该符合自定义Map中定义的输出。 2. 进入Mapper的map()方法,生成一个List。 3. 在map阶段的最后,会先调用job.setPartitionerClass()对这个List进行分区,每个分区映射到一个reducer。 4. 每个分区内又调用job.setSortComparatorClass()设置的key比较函数类排序(如果没有通过job.setSortComparatorClass()设置key比较函数类,则使用key的实现的compareTo方法)。可以看到,这是一个二次排序。 5. 如果设置了Combiner(job.setCombinerClass)对output进行一次合并,从而减少对reduce的输出流量和预处理reduce的input数据。但不一定会执行,对于Combiner执行时机参考Reference[4]。 【说明】以上步骤省略了collect阶段、cache阶段等细节,更详细步骤参考Reference[3] reduce阶段 1. shuffle阶段 reducer开始fetch所有映射到这个reducer的map输出。 2.1 sort阶段 再次调用job.setSortComparatorClass()设置的key比较函数类对所有数据对排序(因为一个reducer接受多个mappers,需要重新排序)。 2.2 secondary sort阶段 然后开始构造一个key对应的value迭代器。这时就要用到分组,使用jobjob.setGroupingComparatorClass()设置的分组函数类。只要这个比较器比较的两个key相同,他们就属于同一个组,它们的value放在一个value迭代器,而这个迭代器的key使用属于同一个组的所有key的第一个key。 3.reduce阶段 最后就是进入Reducer的reduce()方法,reduce()方法的输入是所有的(key和它的value迭代器)。同样注意输入与输出的类型必须与自定义的Reducer中声明的一致。 【注意】reducers的输出是无序的。

优秀的个人博客,低调大师

Docker Hub工作流程-Docker for Web Developers(6)

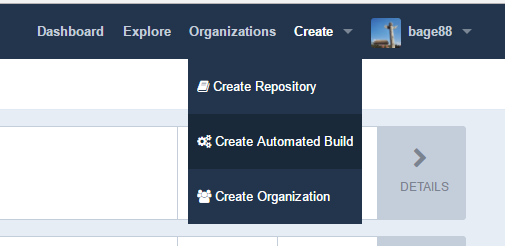
在Github上创建项目仓库 和创建其他Github项目一样,在Github创建一个仓库,然后在仓库里面增加一个dockerfile,然后提交并推送到Github上。 我已经创建的仓库地址:https://github.com/liminjun/simple-dockerfile Dockerfile内容如下: #FROM - Image to start building on. FROM ubuntu:14.04 #MAINTAINER - Identifies the maintainer of the dockerfile. MAINTAINER liminjun2007@gmail.com #RUN - Runs a command in the container RUN echo "Hello World" > /root/hello_world.txt #CMD - Identifies the command that should be used by default when running the image as a container. CMD ["cat", "/root/hello_world.txt"] 在Docker Hub上构建工作流 步骤1:注册Dockerhub并登录。 步骤2:基于Github仓库创建自动化构建 选择Github 步骤3:查看Build Settings 步骤4:查看Build Details 构建和迭代我们的项目 本地修改Dockerfile文件,提交并推动到Github上。 验证上述发生的变化。 获取镜像,并运行,查看内容是否变化。 docker pull bage88/simple-dockerfile 运行Docker镜像 docker run 因为Docker Hub访问速度问题,而且企业内部开发的代码都需要打包成私有的镜像。所以Docker Hub适合开源的小型项目。 对于企业内部来说,可以使用国内云计算厂商提供的镜像服务,也可以在企业内部搭建。 本文转自快乐八哥博客园博客,原文链接http://www.cnblogs.com/liminjun88/p/docker-hub-workflows.html如需转载请自行联系原作者 快乐八哥

优秀的个人博客,低调大师

mac或linux下安装hadoop-2.8流程

mac上安装hadoop 1,mac下的java ll /usr/bin |grep'java' 默认: /System/Library/Frameworks/JavaVM.framework/Versions/Current/Commands/java 具体的安装路径: /Library/Java/JavaVirtualMachines/下面, JAVA_HOME是/Library/Java/JavaVirtualMachines/jdk1.7.0_75/Contents/Home。 2,mac下的ssh 首先测试ssh localhost, 若不成功,看是否启动允许remotelogin,再尝试如果失败则继续下面的 ssh-keygen -t dsa-P '' -f ~/.ssh/id_dsa ssh-keygen表示生成秘钥; -t表示秘钥类型;-P用于提供密语;-f指定生成的秘钥文件。 这个命令在”~/.ssh/“文件夹下创建两个文件id_dsa和id_dsa.pub,是ssh的一对儿私钥和公钥。 接下来,将公钥追加到授权的key中去,输入: cat~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 再次尝试 ssh localhost 若无法打开,解决方法如下: 进入Mac的系统偏好设置 –> 共享–> 勾选remote login,并设置allow access for all users。 3,下载镜像,mirror,选择某一个tar.gz http://mirror.bit.edu.cn/apache/hadoop/common/ 4,设置环境变量 vi ~/.bash_profile 或者/etc/profile中 exportJAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.7.0_75/Contents/Home exportJRE_HOME=$JAVA_HOME/jre exportHADOOP_HOME=/Users/xiaolong.zhao/ittools/hadoop #是防止出现:Warning:$HADOOP_HOME is deprecated的警告错误。 exportHADOOP_HOME_WARN_SUPPRESS=1 exportPATH=$JAVA_HOME/bin:$JRE_HOME/bin: $ HADOOP_HOME /sbin:$HADOOP_HOME/bin:$PATH 注意:linux与mac的安装,唯一区别就是mac下会有默认的jdk路径的,以及ssh配置的 5,配置hadoop-env.sh 在/Users/xiaolong.zhao/ittools/hadoop/etc/hadoop目录下,找到hadoop-env.sh,打开编辑进行如下设置: export JAVA_HOME=${JAVA_HOME}(去掉注释) export HADOOP_HEAPSIZE=2000(去掉注释) export HADOOP_OPTS=”-Djava.security.krb5.realm=OX.AC.UK-Djava.security.krb5.kdc=kdc0.ox.ac.uk:kdc1.ox.ac.uk”(去掉注释) 6, 4个核心文件配置 6.1.配置core-site.xml——(defaultFS)指定了NameNode的主机名与端口 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <? xmlversion = "1.0" encoding = "UTF-8" ?> < configuration > <!--fs.defaultFS-这是一个描述集群中NameNode结点的URI(包括协议、主机名称、端口号),集群里面的每一台机器都需要知道NameNode的地址。 DataNode结点会先在NameNode上注册,这样它们的数据才可以被使用。独立的客户端程序通过这个URI跟DataNode交互,以取得文件的块列表。--> < property > < name >fs.defaultFS</ name > < value >hdfs://localhost:8000</ value > </ property > <!--hadoop.tmp.dir是hadoop文件系统依赖的基础配置,很多路径都依赖它。 如果hdfs-site.xml中不配置namenode和datanode的存放位置,默认就放在这个路径中--> < property > < name >hadoop.tmp.dir</ name > < value >/Users/time/Documents/hadoop-2.7.3/tmp</ value > < description >Abaseforothertemporarydirectories.</ description > </ property > </ configuration > 6.2. 配置hdfs-site.xml——指定了HDFS的默认参数副本数 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 <? xmlversion = "1.0" encoding = "UTF-8" ?> < configuration > <!--dfs.replication-它决定着系统里面的文件块的数据备份个数。对于一个实际的应用,它应该被设为3。 少于三个的备份,可能会影响到数据的可靠性--> < property > < name >dfs.replication</ name > < value >1</ value > </ property > <!--datanaode和namenode的物理存储,如果不设置,它的值hadoop.tmp.dir--> < property > < name >dfs.namenode.name.dir</ name > < value >file:/home/hdfs/name</ value > </ property > <!--可以不设置,namenode的Web监控端口,默认是0.0.0.0:50070--> < property > < name >dfs.namenode.http-address</ name > < value >localhost:57000</ value > </ property > < property > < name >dfs.datanode.data.dir</ name > < value >file:/home/hdfs/data</ value > </ property > </ configuration > 注意这里的file 如果配置为: file:/path/a/c,则具体的路径就是: /path/a/c 如果配置为:file://path/a/c,则具体的路径就是: /a/c 6.3 mapred-site.xml配置 1 2 3 4 < property > < name >mapreduce.framework.name</ name > < value >yarn</ value > </ property > 6.4 Yarn-site.xml 配置 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 <? xmlversion = "1.0" ?> < configuration > <!--resourcemanager--> <!--clientvisitaddress--> < property > < name >yarn.resourcemanager.address</ name > < value >localhost:18040</ value > </ property > <!--ApplicationMastervisitaddress--> < property > < name >yarn.resourcemanager.scheduler.address</ name > < value >localhost:18030</ value > </ property > <!--NodeManagervisitaddress--> < property > < name >yarn.resourcemanager.resource-tracker.address</ name > < value >localhost:18025</ value > </ property > <!--webvisitaddress--> < property > < name >yarn.resourcemanager.webapp.address</ name > < value >localhost:18088</ value > </ property > <!--NodeManagersupportmapreduceservice--> < property > < name >yarn.nodemanager.aux-services</ name > < value >mapreduce_shuffle</ value > </ property > </ configuration > 7, 格式化namenode hdfs namenode-format 8, 启动hadoop 8.1sbin/start-all.sh 8.2 web测试 8.2.1 namenode-web http://localhost:50070 8.2.2resourcemanager-web http://localhost:18088 8.2.3 nodemanager-web http://localhost:8042 本文转自 zhao_xiao_long 51CTO博客,原文链接:http://blog.51cto.com/computerdragon/1939523

优秀的个人博客,低调大师

hive执行流程(1)-hive入口CliDriver类分析

在运行hive cli命令时,调用hadoop jar hive-cli-0.13.1.jar org.apache.hadoop.hive.cli.CliDriver xxxx 命令,而org.apache.hadoop.util.RunJar方法其实是封装了反射调用,最终是调用org.apache.hadoop.hive.cli.CliDriver类的main方法. CliDriver类是hive的入口类。 首先CliDriver类会通过OptionsProcessor类来parse输入的命令。比如解析-e,-s,-h等参数,然后把对应的值存放到对应的CliSessionState类的属性中,最后应用于CliDriver类中。 比如在executeDriver方法中,根据CliSessionState的属性对命令进行处理 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 CliDrivercli= new CliDriver(); cli.setHiveVariables(oproc.getHiveVariables()); //有变量相关的设置时 //usethespecifieddatabaseifspecified cli.processSelectDatabase(ss); //Execute-iinitfiles(alwaysinsilentmode) cli.processInitFiles(ss); //指定了-i和加载.hiverc文件 if (ss.execString!= null ){ //指定了-e时 int cmdProcessStatus=cli.processLine(ss.execString); return cmdProcessStatus; } try { //指定了-f时 if (ss.fileName!= null ){ return cli.processFile(ss.fileName); } } catch (FileNotFoundExceptione){ System.err.println( "Couldnotopeninputfileforreading.(" +e.getMessage()+ ")" ); return 3 ; } 在CliDriver类方法的调用顺序主要有下面几种 1)add xxx/set/compile/reset等命令 1 main-->run--->executeDriver---->processLine--->processCmd--->processLocalCmd--对应processor类的run方法 2)sql命令 1 main-->run--->executeDriver---->processLine--->processCmd--->processLocalCmd---->Driver类run方法 3)shell命令 1 main-->run--->executeDriver---->processLine--->processCmd 其中CliDriver类中最重要的方法是processCmd,其定义了不同的命令不同的执行方式: 具体实现: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 public int processCmd(Stringcmd){ CliSessionStatess=(CliSessionState)SessionState.get(); ss.setLastCommand(cmd); //Flushtheprintstream,soitdoesn'tincludeoutputfromthelastcommand ss.err.flush(); Stringcmd_trimmed=cmd.trim(); String[]tokens=tokenizeCmd(cmd_trimmed); int ret= 0 ; if (cmd_trimmed.toLowerCase().equals( "quit" )||cmd_trimmed.toLowerCase().equals( "exit" )){ //如果是quit或者是exit,则直接退出jvm ss.close(); System.exit( 0 ); } else if (tokens[ 0 ].equalsIgnoreCase( "source" )){ //如果是sourcexxx的情况,则按文件处理(调用processFile方法) Stringcmd_1=getFirstCmd(cmd_trimmed,tokens[ 0 ].length()); FilesourceFile= new File(cmd_1); if (!sourceFile.isFile()){ console.printError( "File:" +cmd_1+ "isnotafile." ); ret= 1 ; } else { try { this .processFile(cmd_1); } catch (IOExceptione){ console.printError( "Failedprocessingfile" +cmd_1+ "" +e.getLocalizedMessage(), stringifyException(e)); ret= 1 ; } } } else if (cmd_trimmed.startsWith( "!" )){ //以!开头的,做为shell命令执行,最终调用Runtime.getRuntime().exec(shell_cmd) Stringshell_cmd=cmd_trimmed.substring( 1 ); shell_cmd= new VariableSubstitution().substitute(ss.getConf(),shell_cmd); //这里也会进行变量替换 //shell_cmd="/bin/bash-c\'"+shell_cmd+"\'"; try { Processexecutor=Runtime.getRuntime().exec(shell_cmd); StreamPrinteroutPrinter= new StreamPrinter(executor.getInputStream(), null ,ss.out); StreamPrintererrPrinter= new StreamPrinter(executor.getErrorStream(), null ,ss.err); outPrinter.start(); errPrinter.start(); ret=executor.waitFor(); if (ret!= 0 ){ console.printError( "Commandfailedwithexitcode=" +ret); } } catch (Exceptione){ console.printError( "ExceptionraisedfromShellcommand" +e.getLocalizedMessage(), stringifyException(e)); ret= 1 ; } } else if (tokens[ 0 ].toLowerCase().equals( "list" )){ //list命令时,调用SessionState的list_resource方法 SessionState.ResourceTypet; if (tokens.length< 2 ||(t=SessionState.find_resource_type(tokens[ 1 ]))== null ){ console.printError( "Usage:list[" +StringUtils.join(SessionState.ResourceType.values(), "|" )+ "][<value>[<value>]*]" ); ret= 1 ; } else { List<String>filter= null ; if (tokens.length>= 3 ){ System.arraycopy(tokens, 2 ,tokens, 0 ,tokens.length- 2 ); filter=Arrays.asList(tokens); } Set<String>s=ss.list_resource(t,filter); if (s!= null &&!s.isEmpty()){ ss.out.println(StringUtils.join(s, "\n" )); } } } else if (ss.isRemoteMode()){ //remotemode--connectingtoremotehiveserver//如果是远程模式,即hiveserver,调用HiveClient类的execute方法 HiveClientclient=ss.getClient(); PrintStreamout=ss.out; PrintStreamerr=ss.err; try { client.execute(cmd_trimmed); List<String>results; do { results=client.fetchN(LINES_TO_FETCH); for (Stringline:results){ out.println(line); } } while (results.size()==LINES_TO_FETCH); } catch (HiveServerExceptione){ ret=e.getErrorCode(); if (ret!= 0 ){ //OKifret==0--reachedtheEOF StringerrMsg=e.getMessage(); if (errMsg== null ){ errMsg=e.toString(); } ret=e.getErrorCode(); err.println( "[HiveError]:" +errMsg); } } catch (TExceptione){ StringerrMsg=e.getMessage(); if (errMsg== null ){ errMsg=e.toString(); } ret=- 10002 ; err.println( "[ThriftError]:" +errMsg); } finally { try { client.clean(); } catch (TExceptione){ StringerrMsg=e.getMessage(); if (errMsg== null ){ errMsg=e.toString(); } err.println( "[ThriftError]:Hiveserverisnotcleanedduetothriftexception:" +errMsg); } } } else { //localmode//剩下的情况都作为local模式,比如addxxx,setxxxx,select/insertxxx/showtables/createtable,databse/usexxx等命令。 try { CommandProcessorproc=CommandProcessorFactory.get(tokens,(HiveConf)conf); //会先根据命令获取对应的CommandProcessor实现类 ret=processLocalCmd(cmd,proc,ss); //并调用processLocalCmd方法 } catch (SQLExceptione){ console.printError( "Failedprocessingcommand" +tokens[ 0 ]+ "" +e.getLocalizedMessage(), org.apache.hadoop.util.StringUtils.stringifyException(e)); ret= 1 ; } } return ret; } 而processLocalCmd方法会将CommandProcessor的实例作为参数传入,并根据不同的CommandProcessor实现类,来调用不同的类的run方法。 1 int processLocalCmd(Stringcmd,CommandProcessorproc,CliSessionStatess) 本文转自菜菜光 51CTO博客,原文链接:http://blog.51cto.com/caiguangguang/1542275,如需转载请自行联系原作者

优秀的个人博客,低调大师

spark入门知识和job任务提交流程

spark是Apache开源社区的一个分布式计算引擎,基于内存计算,所以速度要快于hadoop. 下载 地址spark.apache.org 安装 复制一台单独的虚拟机,名c 修改其ip,192.168.56.200 修改其hostname为c,hostnamectl set-hostname c 修改/etc/hosts加入对本机的解析 重启网络服务 systemctl restart network 上传spark安装文件到root目录 解压spark到/usr/local下,将其名字修改为spark 本地运行模式 使用spark-submit提交job cd /usr/local/spark ./bin/spark-submit --class org.apache.spark.examples.SparkPi ./examples/jars/spark-examples_2.11-2.1.0.jar 10000 使用spark-shell进行交互式提交 创建root下的文本文件hello.txt ./bin/spark-shell 再次连接一个terminal,用jps观察进程,会看到spark-submit进程 sc sc.textFile("/root/hello.txt") val lineRDD = sc.textFile("/root/hello.txt") lineRDD.foreach(println) 观察网页端情况 val wordRDD = lineRDD.flatMap(line => line.split(" ")) wordRDD.collect val wordCountRDD = wordRDD.map(word => (word,1)) wordCountRDD.collect val resultRDD = wordCountRDD.reduceByKey((x,y)=>x+y) resultRDD.collect val orderedRDD = resultRDD.sortByKey(false) orderedRDD.collect orderedRDD.saveAsTextFile("/root/result") 观察结果 简便写法:sc.textFile("/root/hello.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).sortByKey().collect 使用local模式访问hdfs数据 start-dfs.sh spark-shell执行:sc.textFile("hdfs://192.168.56.100:9000/hello.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).sortByKey().collect (可以把ip换成master,修改/etc/hosts) sc.textFile("hdfs://192.168.56.100:9000/hello.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).sortByKey().saveAsTextFile("hdfs://192.168.56.100:9000/output1") spark standalone模式 在master和所有slave上解压spark 修改master上conf/slaves文件,加入slave 修改conf/spark-env.sh,export SPARK_MASTER_HOST=master 复制spark-env.sh到每一台slave cd /usr/local/spark ./sbin/start-all.sh 在c上执行:./bin/spark-shell --master spark://192.168.56.100:7077 (也可以使用配置文件) 观察http://master:8080 spark on yarn模式 本文转自 ChinaUnicom110 51CTO博客,原文链接:http://blog.51cto.com/xingyue2011/1968175

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册