首页 文章 精选 留言 我的

精选列表

搜索[天玑9500],共10000篇文章
优秀的个人博客,低调大师

海狸咬断光缆造成加拿大社区断网一天半

据外媒报道,几周前,加拿大西部不列颠哥伦比亚省的一只海狸几个地方咬断了光缆,导致900多名居民家中互联网服务中断,60多户居民的有线电视信号也被迫中断,运营商Telus的工程团队后来在小溪边地下约1米处找到了被损毁的光缆,尽管光缆外被十几厘米后的管道包裹,依然难以逃脱毒口。 Telus表示,有迹象显示保护光纤电缆的措施似乎未能成功防止河狸靠近。河狸凭著与生俱来的本能,绕过了保护措施。工作人员找到附近一个河狸筑成的水坝,发现河狸沿著溪床往下挖洞,去到了电缆埋设位置。电缆埋在地底3尺深,有4.5寸厚的导管保护。 Telus International成立于2005年,总部位于加拿大温哥华,主要为用户提供创新数字服务,用户涉及技术、游戏、通讯、媒体、电子商务、金融科技、旅游、医疗保健等领域的600多家企业。

优秀的个人博客,低调大师

5 亿微博数据疑泄露,Python 爬虫如何避免踩天坑?

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 编者按:本文来自微信公众号“CSDN”(ID:CSDNnews),作者:马超,36氪经授权发布。 3月19日,默安科技CTO魏兴国发微博称,微博数据泄露了不少用户的手机号,当中涉及不少微博认证的明星和企业家。 亦有网友在他的微博评论区表示:“有超过5.38亿条微博用户信息在暗网出售,其中1.72亿条有账户基本信息,售价0.177比特币。涉及到的账号信息包括用户ID、账号发布的微博数、粉丝数、关注数、性别、地理位置等。” 目前,这条微博已经删除。 针对此事,微博方面回应称,数据泄露属实,目前微博已经及时强化安全策略,微博一直有提供根据通讯录手机号查询微博好友昵称的服务,用户授权后可以使用该服务。 但微博不提供用户性别和身份证号等信息,也没有“根据用户昵称查手机号”的服务。因此这起数据泄露不涉及身份证、密码,对微博服务没有影响。 据此我们可以判断出这次微博个人信息泄漏的安全事件,其原因应该是通讯录好友匹配攻击导致的。很多社交App都有通过通讯录匹配好友的功能。攻击者可以伪造本地通讯录来获得手机号到微博用户账号的关联。比如通过伪造的手机号匹配好友,并不断列举,就能关联出所有用户帐号到微博ID到手机号的关系。 本次事件纠其本质其实是利用合法API的不合理使用来套取、收集信息的过程,简单来讲就是一个爬虫引发的血案。 有关爬虫的是是非非实在太多了,据笔者观察2019年几乎所有的大数据即爬虫公司全部被查,包括新颜科技与魔蝎科技的CEO被查、公信宝被封、聚信立也宣布将暂停爬虫服务、国内大数据风控平台龙头同盾科技也被曝解散爬虫部门。 这其中最惹人关注的事件,还是那位来自巧达科技的程序员,因为写了一段爬虫程序,非法从某招聘网站上下载简历信息而被起诉,引发了全网关于程序员面向“监狱”编程的大讨论。 而站在笔者角度来看,有关爬虫的争议和信息泄漏防护需要从数据持有方和数据爬取方两个角度来审视。 数据持有方的盾:DLP数据泄露防护系统 这次信息泄漏事件发生后,我们可以看到微博第一时间就回应不涉及身份证、密码等敏感信息的外流,我相信这背后的底气还是来自于微博对其数据泄漏防护(Data leakage prevention, DLP)的信心。 远程办公大背景下,先要做好内部预防:据国家计算机信息安全测评中心数据显示,重要资料被黑客窃取和被内部员工泄露的比例为1:99.也就是说有互联网出口的企业,其内部重要机密通过网络泄密而造成重大损失的事件中,只有1%是被黑客窃取造成的,而都是由于内部员工有意或者无意之间泄露而造成的。尤其是在目前远程办公的背景下,这种由员工引发的信息泄漏情况其实风险更高,企业在数据边界建立一套安全防护体系十分重要。 员工终端出口防控:部分大厂都有一套数据沙盒运行或者加密机制,用来阻止数据由使用的客户端流出,并且一般在DLP的整体解决方案中,还会使用图像处理技术还会将员工屏幕图像的频域中加入特定指纹,以追踪员工泄漏截屏信息。记得在2017年阿里脚本秒杀月饼的事件中,就有人因泄漏截图信息而被处理,这背后其实就是频域指纹的技术。再有就是对内网中包括U盘、移动硬盘、红外、WIFI、蓝牙等输出端口实施监控,对拷贝到移动存储设备的文档进行强制加密。 互联网出口防控:而针对互联网出口DLP技术几乎和AI图像处理与NLP技术同步发展,一般都会使用最新的分类模型,监控异常流量,防止数据外泄,这里还是再次强调一下系统上云的重要性。 数据爬取方之道:避免面向监狱编程 根据最新的流量分析,互联网40%左右的流量都是机器人也就是爬虫发起的,站在数据爬取方的角度,必须关注爬虫技术的法律边界,“技术无罪”的号往往不能保护广大程序员。 而有关爬虫的法律问题,笔者特意咨询了法务同事,根据我国的《刑法》、《网络安全法》的规定,爬虫可能涉及到的犯罪行为有如下情况: 1.首先侵入国家事务、国防建设、尖端科学技术领域的计算机信息系统的,不论情节严重与否,构成非法侵入计算机信息系统罪。 2.违反国家有关规定,向他人出售或者提供公民个人信息,构成“侵犯公民个人信息罪”。也就是说通过出售个人信息获利或者侵入含有国家机密的系统均会构成犯罪,但这两种情况均不会是无心之过,但是以下规定需要格外注意。 3.违反国家规定,对计算机信息系统功能进行删除、修改、增加、干扰,造成计算机信息系统不能正常运行,后果严重的,构成犯罪。也就是如果使用爬虫的抓取力度过大,造成被攫取的网站无法正常运行的情况,并造成严重后果的也会构成犯罪。我们前文所述巧达科技的程序员也是因为爬虫流量太大,造成目标网络接近瘫痪,而涉嫌触犯此条被捕。 也就是说避免面向监狱编程的三原则是 1. 不要触碰国家事务、国防建设的系统 2. 不要触碰个人信息,更不能贩卖个人信息 3. 合理设置爬取流量,避免DDOS攻击式的爬虫 另外为避免其它民事纠纷,要尽量遵守Robots 协议。Robots 协议是一种存放于网站根目录下的 ASCII 编码的文本文件,它通常告诉网络搜索引擎的漫游器也就是爬虫,此网站中的哪些内容是不应被爬虫获取的,哪些是可以被爬虫获取的。严格按照 Robots 协议 爬取网站相关信息一般不会出现太大问题。 因为司法实践中一般也会考虑行业的通行规范,因此一般遵守Robots 协议得到的信息不会被认为是商业机密或者个人隐私数据。或者说遵守协议所得的信息即使涉密其泄密责任一般也不会由爬取方承担。 实际遭遇信息泄漏时应该做什么 在所有的信息泄漏中最麻烦的就是密码或者身份证信息泄漏,对此笔者有如下建议: 1. 检查自己的征信记录:如果征信记录中有异常,尤其是遭遇不明原因的贷款时,那么大概率是遇到严重的信息泄漏情况了。此时如果联系不上贷款平台,可以尽早报案,以保护自己的合法权益。 2. 解除三方平台的绑定关系:一般来说银行对于客户银行卡的保护力度还是比三方支付公司要大的,所以如遇信息泄漏,可以先解除与三方支付平台的绑定关系及关闭定时自动扣款服务,必要时再更换银行卡。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-03-23本文作者:马超本文来自:“36Kr”,了解相关信息可以关注“36Kr”

优秀的个人博客,低调大师

打通前后端逻辑,客户端Flutter代码一天上线

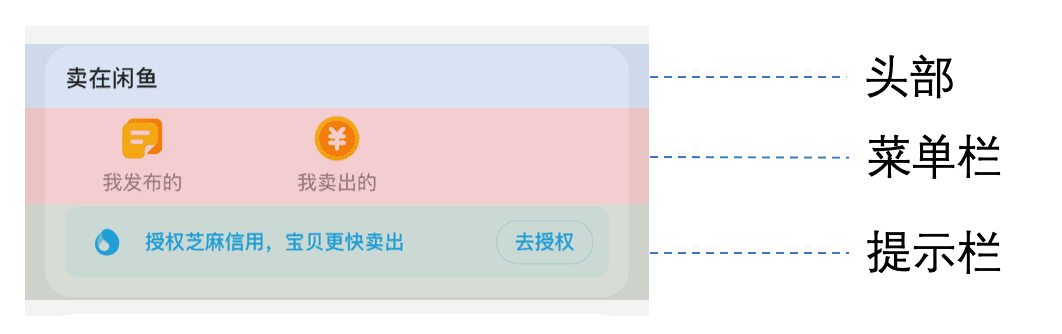
一、前沿 ​ 随着闲鱼的业务快速增长,运营类的需求也越来越多,其中不乏有很多界面修改或运营坑位的需求。闲鱼的版本现在是每2周一个版本,如何快速迭代产品,跳过窗口期来满足这些需求?另外,闲鱼客户端的包体也变的很大,企业包的大小,iOS已经到了94.3M,Android也到了53.5M。Android的包体大小,相比2016年,已经增长了近1倍,怎么能将包体大小降下来?首先想到的是如何动态化的解决此类问题。 ​ 对于原生的能力的动态化,Android平台各公司都有很完善的动态化方案,甚至Google还提供了Android App Bundles让开发者们更好地支持动态化。由于Apple官方担忧动态化的风险,因此并不太支持动态化。因此动态化能力就会考虑跟Web结合,从一开始基于 WebView 的 Hybrid 方案 PhoneGap、Titanium,到现在与原生相结合的 React Native 、Weex。 ​ 但Native和JavaScript Context之间的通讯,频繁的交互就成了程序的性能瓶颈。于此同时随着闲鱼Flutter技术的推广,已经有10多个页面用Flutter实现,上面提到的几种方式都不适合Flutter场景,如何解决这个问题Flutter的动态化的问题? 二、动态方案 我们最初调研了Google的动态化方案CodePush。 2.1 CodePush ​ CodePush是谷歌官方推出的动态化方案,目前只有在Android上面实现了。Dart VM在执行的时候,加载isolate_snapshot_data和isolate_snapshot_instr2个文件,通过动态更改这些文件,就达到动态更新的目的。官方的Flutter源码当中,已经有相关的提交来做动态更新的内容,具体内容可以参考ResourceExtractor.java。 ​ 根据官方给出的Guide,我们这边也做了相关的测试,patch的包体大小会很大(939kb)。为了降低包体大小,还可以通过增量的修改snapshot文件的方式来更新。通过bsdiff生成的snapshot的差异文件,2个文件分别可以缩小到48kb和870kb。 ​ 目前看来,CodePush还不能做到很好的工程化。而且如何管理patch文件,需要制定baseline和patch文件的规则。 2.2 动态模板 ​ 动态模板,就是通过定义一套DSL,在端侧解析动态的创建View来实现动态化,比如LuaViewSDK、Tangram-iOS和Tangram-Android。这些方案都是创建的Native的View,如果想在Flutter里面实现,需要创建Texture来桥接;Native端渲染完成之后,再将纹理贴在Flutter的容器里面,实现成本很高,性能也有待商榷,不适合闲鱼的场景。 ​ 所以我们提出了闲鱼自己的Flutter动态化方案,前面已经有同事介绍过方案的原理:《做了2个多月的设计和编码,我梳理了Flutter动态化的方案对比及最佳实现》,下面看下具体的实现细节。 三、模板编译 自定义一套DSL,维护成本较高,怎么能不自定义DSL来实现模板下发?闲鱼的方案就是直接将Dart文件转化成模板,这样模板文件也可以快速沉淀到端侧。 3.1 模板规范 ​ 先来看下一个完整的模板文件,以新版我的页面为例,这个是一个列表结构,每个区块都是一个独立的Widget,现在我们期望将“卖在闲鱼”这个区块动态渲染,对这个区块拆分之后,需要3个子控件:头部、菜单栏、提示栏;因为这3部分界面有些逻辑处理,所以先把他们的逻辑内置。 内置的子控件分别是MenuTitleWidget、MenuItemWidget和HintItemWidget,编写的模板如下: @override Widget build(BuildContext context) { return new Container( child: new Column( children: <Widget>[ new MenuTitleWidget(data), // 头部 new Column( // 菜单栏 children: <Widget>[ new Row( children: <Widget>[ new MenuItemWidget(data.menus[0]), new MenuItemWidget(data.menus[1]), new MenuItemWidget(data.menus[2]), ], ) ], ), new Container( // 提示栏 child: new HintItemWidget(data.hints[0])), ], ), ); } 中间省略了样式描述,可以看到写模板文件就跟普通的widget写法一样,但是有几点要注意: 每个Widget都需要用new或const来修饰 数据访问以data开头,数组形式以[]访问,字典形式以.访问 ​ 模板写好之后,就要考虑怎么在端上渲染,早期版本是直接在端侧解析文件,但是考虑到性能和稳定性,还是放在前期先编译好,然后下发到端侧。 3.2 编译流程 ​ 编译模板就要用到Dart的Analyzer库,通过parseCompilationUnit函数直接将Dart源码解析成为以CompilationUnit为Root节点的AST树中,它包含了Dart源文件的语法和语义信息。接下来的目标就是将CompilationUnit转换成为一个JSON格式。 ​ 上面的模板解析出来build函数孩子节点是ReturnStatementImpl,它又包含了一个子节点InstanceCreationExpressionImpl,对应模板里面的new Container(…),它的孩子节点中,我们最关心的就是ConstructorNameImpl和ArgumentListImpl节点。ConstructorNameImpl标识创建节点的名称,ArgumentListImpl标识创建参数,参数包含了参数列表和变量参数。 定义如下结构体,来存储这些信息: class ConstructorNode { // 创建节点的名称 String constructorName; // 参数列表 List<dynamic> argumentsList = <dynamic>[]; // 变量参数 Map<String, dynamic> arguments = <String, dynamic>{}; } 递归遍历整棵树,就可以得到一个ConstructorNode树,以下代码是解析单个Node的参数: ArgumentList argumentList = astNode; for (Expression exp in argumentList.arguments) { if (exp is NamedExpression) { NamedExpression namedExp = exp; final String name = ASTUtils.getNodeString(namedExp.name); if (name == 'children') { continue; } /// 是函数 if (namedExp.expression is FunctionExpression) { currentNode.arguments[name] = FunctionExpressionParser.parse(namedExp.expression); } else { /// 不是函数 currentNode.arguments[name] = ASTUtils.getNodeString(namedExp.expression); } } else if (exp is PropertyAccess) { PropertyAccess propertyAccess = exp; final String name = ASTUtils.getNodeString(propertyAccess); currentNode.argumentsList.add(name); } else if (exp is StringInterpolation) { StringInterpolation stringInterpolation = exp; final String name = ASTUtils.getNodeString(stringInterpolation); currentNode.argumentsList.add(name); } else if (exp is IntegerLiteral) { final IntegerLiteral integerLiteral = exp; currentNode.argumentsList.add(integerLiteral.value); } else { final String name = ASTUtils.getNodeString(exp); currentNode.argumentsList.add(name); } } 端侧拿到这个ConstructorNode节点树之后,就可以根据Widget的名称和参数,来生成一棵Widget树。 四、渲染引擎 端侧拿到编译好的模板JSON后,就是解析模板并创建Widget。先看下,整个工程的框架和工作流: 工作流程: 开发人员编写dart文件,编译上传到CDN 端侧拿到模板列表,并在端侧存库 业务方直接下发对应的模板id和模板数据 Flutter侧再通过桥接获取到模板,并创建Widget树 对于Native测,主要负责模板的管理,通过桥接输出到Flutter侧。 4.1 模板获取 模板获取分为2部分,Native部分和Flutter部分;Native主要负责模板的管理,包括下载、降级、缓存等。 程序启动的时候,会先获取模板列表,业务方需要自己实现,Native层获取到模板列表会先存储在本地数据库中。Flutter侧业务代码用到模板的时候,再通过桥接获取模板信息,就是我们前面提到的JSON格式的信息,Flutter也会有缓存,已减少Flutter和Native的交互。 4.2 Widget创建 Flutter侧当拿到JSON格式的,先解析出ConstructorNode树,然后递归创建Widget。 创建每个Widget的过程,就是解析节点中的argumentsList和arguments并做数据绑定。例如,创建HintItemWidget需要传入提示的数据内容,new HintItemWidget(data.hints[0]),在解析argumentsList时,会通过key-path的方式从原始数据中解析出特定的值。 解析出来的值都会存储在WidgetCreateParam里面,当递归遍历每个创建节点,每个widget都可以从WidgetCreateParam里面解析出需要的参数。 /// 构建widget用的参数 class WidgetCreateParam { String constructorName; /// 构建的名称 dynamic context; /// 构建的上下文 Map<String, dynamic> arguments = <String, dynamic>{}; /// 字典参数 List<dynamic> argumentsList = <dynamic>[]; /// 列表参数 dynamic data; /// 原始数据 } ​ 通过以上的逻辑,就可以将ConstructorNode树转换为一棵Widget树,再交给Flutter Framework去渲染。 至此,我们已经能将模板解析出来,并渲染到界面上,交互事件应该怎么处理? 4.3 事件处理 在写交互的时候,一般都会通过GestureDector、InkWell等来处理点击事件。交互事件怎么做动态化? ​ 以InkWell组件为例,定义它的onTap函数为openURL(data.hints[0].href, data.hints[0].params)。在创建InkWell时,会以OpenURL作为事件ID,查找对应的处理函数,当用户点击的时候,会解析出对应的参数列表并传递过去,代码如下: ... final List<dynamic> tList = <dynamic>[]; // 解析出参数列表 exp.argumentsList.forEach((dynamic arg) { if (arg is String) { final dynamic value = valueFromPath(arg, param.data); if (value != null) { tList.add(value); } else { tList.add(arg); } } else { tList.add(arg); } }); // 找到对应的处理函数 final dynamic handler = TeslaEventManager.sharedInstance().eventHandler(exp.actionName); if (handler != null) { handler(tList); } ... 五、 效果 新版我的页面添加了动态化渲染能力之后,如果有需求新添加一种组件类型,就可以直接编译发布模板,服务端下发新的数据内容,就可以渲染出来了;动态化能力有了,大家会关心渲染性能怎么样。 5.1 帧率 在加了动态加载逻辑之后,已经开放了2个动态卡片,下图是新版本我的页面近半个月的的帧率数据: 从上图可以看到,帧率并没有降低,基本保持在55-60帧左右,后续可以多添加动态的卡片,观察下效果。 注:因为我的页面会有本地的一些业务判断,从其他页面回到我的tab,都会刷新界面,所以帧率会有损耗。 ​ 从实现上分析,因为每个卡片,都需要遍历ConstructorNode树来创建,而且每个构建都需要解析出里面的参数,这块可以做一些优化,比如缓存相同的Widget,只需要映射出数据内容并做数据绑定。 5.2 失败率 现在监控了渲染的逻辑,如果本地没有对应的Widget创建函数,会主动抛Error。监控数据显示,渲染的流程中,还没有异常的情况,后续还需要对桥接层和native层加错误埋点。 六、展望 ​ 基于Flutter动态模板,之前需要走发版的Flutter需求,都可以来动态化更改。而且以上逻辑都是基于Flutter原生的体系,学习和维护成本都很低,动态的代码也可以快速的沉淀到端侧。 ​ 另外,闲鱼正在研究UI2Code的黑科技,不了解的老铁,可以参考闲鱼大神的这篇文章《重磅系列文章!UI2CODE智能生成Flutter代码——整体设计篇》。可以设想下,如果有个需求,需要动态的显示一个组件,UED出了视觉稿,通过UI2Code转换成Dart文件,再通过这个系统转换成动态模板,下发到端侧就可以直接渲染出来,程序员都不需要写代码了,做到自动化运营,看来以后程序员失业也不是没有可能了。 ​ 基于Flutter的Widget,还可以拓展更多个性化的组件,比如内置动画组件,就可以动态化下发动画了,更多好玩的东西等待大家来一起探索。 参考文献 https://github.com/flutter/flutter/issues/14330 https://www.dartlang.org/ https://mp.weixin.qq.com/s/4s6MaiuW4VoHr_7f0S_vuQ https://github.com/flutter/engine 作者:闲鱼技术-景松 原文链接 ​本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

如何学好 Linux、C++,并搞定 BAT 面试 作者/分享人:天千

学好Linux运维需要做到以下几点 1、多做实验 实验环境完全可以通过VMware来模拟,模拟私有网络,模拟多台机器,要搞懂VMware提供的集中网络模式的工作原理(桥接网络、宿主机网络、NAT等),这对整个Linux后续的学习帮助都非常之大,还可以通过虚拟机模拟Grub损坏并进行修复、模拟忘记密码并通过单用户模式修改密码等等。 2、LNMP、DHCP、DNS、MySQL等等这些网络服务需要完全基于源码来编译 这样更加有体感,对于编译的参数要理解,因为通过yum安装的软件包都是上一个稳定版本,并不是最新稳定版本,还有另外一点就是编译安装可以通过编译参数对软件进行一定的优化。 3、Linux基础要扎实 底层原理要理解,典型的文件系统的组成、inode和数据存放的位置、Linux进程是如何调度的、调度算法有哪些、磁盘调度算法有哪些、TCP/IP的三次握手和四次挥手的过程是如何的,网络中的数据是如何流向的(参考《构建高性能web站点》),iptables的三表五链、Nginx的网络IO模型(这个很重要,你要能讲清楚为什么Nginx要比Apache好),马哥Linux对于这个部分的内容讲解是我最喜欢的,我强力推荐大家都去听一听马哥的视频。 4、英文文档的阅读能力 阅读各类开源软件的官方文档是必经之路,这个也是了解一个开源软件最快的捷径,如果你没有一定的英文阅读能力,那么你只能等到有人把这些文章翻译成中文后你才能学习到。 5、写博客 很多时候,看了视频和书后,如果你不能讲这些知识用你的语言表达出来,那么很大可能,你并没有真正的理解这些知识,通过写博客的方式会逼迫你回忆知识,然后总结出来,博客被大量人访问也会在一定程度上激励你,让你有一定的成就感,促使你把博客写的更好。 6、Shell脚本的要熟悉 运维这条路上脚本会帮我们省掉不少体力活,此外必须要学习一门编程语言Python、Golang等 C语言要学好必须理解三个概念 1、什么是指针? 指针和数组的关系。 2、程序分为哪几个段 能说清楚全局变量,局部变量,静态变量等分别属于哪个段,各个段的特点是什么? 3、C语言的编译和链的接过程 真心不推荐在Windows上来学习C语言,因为它屏蔽了太多的细节,而这些细节却又是C程序员不可或缺的一部分。C语言这个阶段过去后,我开始学习LinuxC系统编程这个部分,最开始接触的一本书就是《Unix/Linux编程实践教程》强力推荐给大家,这本书会给你介绍如何通过man手册来帮助编程,如何去实现who、cat、ls、ps等系统命令。通过这本书的学习会让你对Linux上很多的原理有一个深刻的认识。 这本书学完后我就开始看UNP和APUE,其中APUE我并不推荐给大家,我推荐给大家的是《Linux/UNIX系统编程手册》这本书的内容更全面,更新。建议大家在看这些书的时候可以做详细的笔记和代码练习,在我的博客上就有我总结的文章。系统编程ok后,就要重点看UNP了,看这本书的时候要找重点看,里面有的章节已经过时了,还有一些章节对于我们目前来说用途并不大,比如STCP的部分。 对于这本书《Linux/UNIX系统编程手册》,重点有三个部分 1、各个socketAPI的对应到OS,做了哪些事情 比如connect后,做了哪些事情?,accept呢?,什么是RST报文?,什么是SIGPIPE,如何触发的? 2、网络IO模型,同步和异步,阻塞和非阻塞的概念 Linux上各种网络IO模型的优缺点对比,epoll、select、信号驱动IO等 3、服务器的网络编程模型,多线程、多进程、线程池等,各自优缺点 在我的博客上也有一篇文章介绍了相关的内容,学完这个后,剩下的就靠多实践和多读一些开源的项目来积累自己的经验了,这里推荐cjson、webbench、Tinyhttpd等,代码量都不大,很容易读懂,在读懂的基础上可以进行适当的改造和重写。 C语言和Linux系统编程这个部分结束后,就要开始踏入C++的世界了,自从C++11出来后,我觉得C++易学了,但是苦于现存的老的C++代码还是有很多,所以我们不得不去学习C++98相关的知识,这里我推荐《C++primer》一书,注意是C++primer,不是《C++primerplus》 我看书的方法都比较老套,第一遍力求看懂,第二遍开始抄代码,练习,第三遍开始总结写博客。所以这本书我前前后后看了大半年,后面又看了C++编程思想上册,EffectiveC++、深度理解C++对象模型、ExceptionalC++、深入理解C++11等经典书籍,看书的模式基本上都是二到三遍,通过抄书上的代码和写博客来加深记忆。看完这些书说真的,我觉得我的C++还只是一个小白,我真正蜕变要从读《LinuxC++服务端编程》陈硕的这本书开始,通过这本书我觉得我的C++水平有了一个质的飞跃。 C++有以下几个要点(只是部分): 1、RAII 这个很重要,是C++的核心,很多学习了C++的人都不知道RAII 2、值语义和对象语义 这个决定了你如何写好一个C++类 3、对象的生命周期,类的生命周期要清晰 4、智能指针 现代C++编程几乎不太可能出现delete语句,内存泄漏的问题真的很少会出现 5、各种STL和C++的一些坑 比如迭代器遍历过程中如何删除元素、std::list的size接口的复杂度居然是O(N)(C++11已经修正)等等 6、善用std::bind和std::function 7、基于对象编程和面向对象编程的区别 8、移动语义很重要 9、Lambda的捕获表达式 10、搞清楚C++的三五法则 11、std::string的实现方式,是否是线程安全的 12、std::map和std::set的底层数据结构等 《EffectiveModernC++》,这本书我重点推荐给大家,在我的博客上也有全部的总结,这本书讲了很多C++11种的一些实现细节、坑以及建议。最后推荐一些linux内核相关的书籍和学习方法 《深入理解Linux内核架构》《Linux环境编程从应用到内核》 重点找自己感兴趣的模块来看,比如我就对文件系统,通过内核模块来探索,不能只看代码不练习 网络上有很多从头开始编写一个内存文件系统的文章,在我的博客上也有一个系列讲解Linux内核模块编程入门的文章,通过编写Linux内核模块可以做很多有趣的事情,比如系统调用拦截、网络拦截、做安全审计等等,通过编写内核模块可以提高对Linux内核学习的兴趣。 在整个求职过程中,我做了以下几件事 1、刷leetcode的题目 从牛客网和google上搜集面试题,分门别类的进行整理,每天都回顾一下 2、拓宽自己的知识面,学习一些新的知识 比如当时流行的docker,更侧重学习其原理 3、加深自己对一些底层的OS知识的理解 比如epoll的原理、docker的cgroup机制和namespace机制的实现、文件系统VFS的实现、Linux信号、管道等的实现。 整理面试题和学习一些底层的OS知识对我整个面试过程中帮助很大,正常情况下如果你只学习Java或者C++是很难拿到阿里巴巴的Offer,阿里巴巴对应届生的知识面、知识的理解程度要求还是比较高的,在我的整个C++面试过程中,问的最多的就是IO复用、智能指针、内存泄漏的问题如何解决、如何排查Load高的问题、Linux内核相关的知识等,而这些问题对我来说早已得心应手,在搜集面试题的时候很多问题都是反复被提及到的,我只需要好好总结即可。 另外一点就是大家在准备面试题的时候不能只记一个结论,多问问为什么,举个例子,TCP/IP的三次握手和四次挥手的过程是什么样的,我们不光光要知道这个问题的结论,还要知道为什么是三次握手,四次挥手,为什么不是二次?当被问及到epoll、select的区别时,你应该从使用方法、可移植性、性能、优缺点、内核实现等多个方面分析和总结。而不是简简单单的就提及一个优缺点就完事了。你擅长的地方你应该多多引导你的面试官去问。 工作心得 在公司实习了大约1年,今年七月份正式入职,在这整个过程中我也零散的做了很多小需求,对C++的理解更加深刻,尤其是对软件工程有了一个新的理解,在此我想分享给大家。 1、要有造轮子的能力,但是不要轻易的去造轮子 2、单元测试的重要性 通过单元测试也可以提高程序员的信心,为了更好的写单测,会逼迫我们将模块之间的耦合降到最低,这样可以方便单测。 3、写易读的、可维护的代码 4、Google的C++编程规范,每一条都值得细细品味 5、Chromium开源项目有很多值得我们借鉴的地方 6、画UML图是程序员的基本素质,要有好的设计,设计要做评审 7、CodeReview一定要有的 8、类名和变量名的易读性 可能对于很多人来说编码规范、CodeReview、UML、单测好像都是说说而已,我起初也是这么认为,感触并不是很深刻,直到我的同事开始带我的时候,我自己亲身去体验的时候才发现这其中奥妙无穷,我们团队使用Chromium的base库作为自己的基础库,编码规范、全都followChromium,至于为什么不用boost,我的理由则是,boost是一个我无法驾驭的怪兽,而chromium的base库是我可以驾驭的,可以打组合拳,代码的稳定性已经经过上亿人的考验,值得我们信赖。推荐大家看看chromium的base库,源代码很易读。通过阅读它的代码可以学习到很多知识。推荐一本书给大家《C++API设计》,讲解了很多软件工程、设计层面的知识。 总结 上面说了很多,更侧重分享了我的学习经历,和一些感悟,可能我说的比较简单,实际上理解上面这些东西,是存在一个过程的,是一个从量变到质变的过程,在整个过程中我理解到,学习要坚持,不是一蹴而就的,要经历量变到质变的过程。

优秀的个人博客,低调大师

平价有机蔬菜亮相天猫双11,阿里云IoT成助攻神器

6块8一份的有机青菜、蒿子秆,8块8一份的胡萝卜,原来价格高昂的有机蔬菜,在盒马却卖出了平价。而让人更意想不到的是,这背后是阿里云IoT的科技暖男的守护,将农民在有机蔬菜种植的经验转化为云上的数据,从源头上降低了成本。 双11期间,盒马与阿里云IoT携手发布了IoT有机蔬菜安全溯源项目,借助物联网技术,对蔬菜的种植、加工、运输、卖场四个环节的供应链进行了全面升级,全链路数据监测,确保蔬菜的品质最优、运输最快、消耗最小。 种植环节,确保最佳环境成长。通过搭建LoRa物联网及传感器,24小时进行基地环境监测,随时同步蔬菜种植的温度、光照、紫外线、相对湿度、PM2.5、PH值等等13项数据,蔬菜基地的人亲切的称之为“智能稻草人”。 盒马上海生鲜采销总监陈华表示,兢兢业业的“智能稻草人”大幅降低了种植成本,这也是有机蔬菜走向平价的重要原因之一,

优秀的个人博客,低调大师

我的网站搭建: (第十天) Ueditor后台编辑器

之前说过,我的网站编辑器一开始是tinymce,然后才用的ckeditor。可是最近我发现,ckeditor的小图标不是很美观,看久了有点low的样子。我是不是应该换一个编辑器呢,一想到这里,马上打开谷歌搜索有没有更加美观的富文本编辑器。翻了几页发现,才发现百度Ueditor编辑器就很不错,其实之前我就了解过,但是并没有学习去怎么使用,这回好了,换个富文本编辑器顺便把Ueditor给学会了 安装及使用 1.Ueditor其实对python2和python3有一定的区别,在写程序时想通过Django的form表单顺便把评论框也改成Ueditor,但是没有将其实现却发现了错误提示为: fromwidgetsimportUEditorWidget,AdminUEditorWidget ImportError:Nomodulenamed‘widgets’ 经查发现,DjangoUeditor是基于Python 2.7的,对Python3的支持有问题。导致widgets.py文件出错,不能import,解决方法可以修改widgets.py或者采用网上修改好的版本DjangoUeditor3,github就有很多Ueditor的代码,有些不能直接使用,可能太久没更新了吧,然后才找到了:https://github.com/twz915/DjangoUeditor3 2.使用git下载后,输入如下命令将源码安装到Python路径中 python3setup.pyinstall 3.将DjangooUeditor添加到Django的INSTALLED_APPS中 4.在blog下的models.py文件导入 fromDjangoUeditor.modelsimportUEditorField #将之前ckeditor body=RichTextUploadingField() #改为 body=UEditorField(u'内容',width=1100,height=300,toolbars="full",imagePath="images/",filePath="files/",upload_settings={"imageMaxSize":1204000},) 5.进入admin后台管理页面,可以看到这时编辑器已经换了个装 6.去掉百度编辑器 ueditor 元素路径、字数统计等 在百度编辑器 ueditor 根目录下: ueditor.config.js 文件中 搜索并将参数elementPathEnabled设置成false即可 常用功能开关如下: ,elementPathEnabled : false //是否启用元素路径,默认是true显示 ,wordCount:false //是否开启字数统计 ,autoHeightEnabled:false // 编辑器内容,是否自动长高,默认true ,fullscreen : false //是否开启初始化时即全屏,默认关闭 7.图标对比 ckeditor是这样的 ueditor是这样的 代码高亮 1.为了这个代码高亮可是浪费了我不少时间,一开始是发现在DjangoUeditor/staticueditor/thirdd-party/SyntaxHighlighter文件夹中有shCoreDefault.css和shCore.js这两个文件的,网上也有很多文章说了可以在详情页添加下面三个标签 运行完后,发现的确有些效果,可是伴随着还有另外三个问题 一个是代码之间的行距和字体太小,不便于代码的阅读,通过对网页元素进行分析,我找到了shCoreDefault.css文件中的两个属性,通过文件搜索找出来将它们注释就可以解决了 line-height:1.1em!important; font-size:13px!important; 如果说上面的问题还能接收,第二个问题就完全不适应了,那就是行号与代码不匹配,经常在代码的两头空出多行是没有注明行号的,看着很不习惯 还有第三个问题,代码过长的情况下,不能自动换行,就导致代码块容易超出父容器宽度。网上的解决办法都是在shCoreDefault.css文件中通过ctrl+F查找:.syntaxhighlighter{,然后在括弧中加入样式:word-break:break-all,这个有效果,已经测试过了,但是第二个问题实在能力有限,无法解决,被迫放弃使用DjangoUeditor中的css样式 2.放弃DjangoUeditor的自带样式后,又找到了第二条路,那就是使用Hlightjs,我想要的是类似github上的那种白色背景的代码高亮显示,幸运的是Hlightjs插件提供了太多太多的代码样式。我参考的文章地址:https://blog.csdn.net/msllws/article/details/81048390 3.在官网https://highlightjs.org/download/下载好Hlightjs插件后,与之前使用SyntaxHighlighter类似,添加下面三个标签 <!--foundation.css文件就是我选择的代码样式--> <linkrel="stylesheet"type="text/css"href="{%static'blog/css/foundation.css'%}"> <scripttype="text/javascript"src="{%static'blog/js/highlight.pack.js'%}"></script> <script>hljs.initHighlightingOnLoad();</script> 这个时候,还无法正常显示,因为代码高亮遵循的格式是:<pre><code>代码</code></pre>而百度编辑器默认的代码块显示格式为:<pre>代码</pre>,所以还需要再写上一个script,添加在body下面 <scripttype="text/javascript"> varallpre=document.getElementsByTagName("pre"); for(i=0;i<allpre.length;i++) { varonepre=document.getElementsByTagName("pre")[i]; varmycode=document.getElementsByTagName("pre")[i].innerHTML; onepre.innerHTML='<codeid="mycode">'+mycode+'</code>'; } </script> 这个时候已经能看出代码样式发生改变了,但是没有行号,所以还要给代码加上行号,先创建一个code.css文件,里面包含了code代码块行号的样式效果 pre{ position:relative; padding:0; /*margin-bottom:24px;*/ border-radius:3px; border:1pxsolid#C3CCD0; background:#FFF; overflow:hidden; font-size:14px; } code{ display:block; padding:18px24px; overflow-y:auto; font-weight:300; font-family:Menlo,monospace; font-size:14px; } code.has-numbering{ margin-left:30px; } .pre-numbering{ position:absolute; top:0; left:0; width:30px; padding:8px5px5px0; border-right:1pxsolid#C3CCD0; border-radius:3px003px; background-color:#f5f5f5; text-align:right; font-family:Menlo,monospace; font-size:14px; color:#8c8c8c; } 将上面的行号样式通过javascript绑定到每个li元素上 <scripttype="text/javascript"> $(function(){ $('precode').each(function(){ varlines=$(this).text().split('\n').length-1; var$numbering=$('<ul/>').addClass('pre-numbering'); $(this) .addClass('has-numbering') .parent() .append($numbering); for(i=1;i<=lines+100;i++){ $numbering.append($('<li/>').text(i)); } }); }); </script> 完成后,就已经实现Ueditor+Hightjs的代码高亮了 4.代码高亮对比 Ckeditor是这样的 Ueditor是这样的 其他常见问题 1.此时可能还会出现编辑框内图片无法正常缩放,是因为页面上引入了Bootstrap,而Bootstrap默认将box-sizing样式统一设成border-box了,在ueditor.min.css中加入如下代码,就算是填坑成功 .edui-container*{-webkit-box-sizing:content-box;-moz-box-sizing:content-box;box-sizing:content-box;} .edui-container*:before,.edui-container*:after{-webkit-box-sizing:content-box;-moz-box-sizing:content-box;box-sizing:content-box;} 2.在css中可能出现长串字母或者数字不会自动换行的问题,在对应css中加: word-break:break-all; 3.因为在编辑文章的时候,上传图片的宽度是用px来表示的,这就有可能导致图片宽度超出父容器宽度,所以需要重新对img元素进行宽度重定义 #post-bodyimg{ max-width:100%; } 4.在编辑超链接内容时可以发现,在移动端或者宽度很窄的显示屏上,a标签元素也常常超出容器宽度之外,这是因为ueditor对长字母或者长数字不会自动换行导致的,所以需要设置自动换行 #post-bodya{ word-break:break-all; } 5.用过ueditor的人都知道,还有一个常见问题就是在编辑器下使用的表格可以被预览,但是内容发布之后,在网页显示中是看不见边框的。网上很多人大都提议取修改ueditor.all.js或者ueditor.all.min.js,但是我按照那个方法行不通,不知道是哪里还出了错,所以我就直接用最粗暴的方式,在详情页中的样式加上 #post-bodytable,#post-bodytr,#post-bodytd{ border:1pxsolid#000; max-width:100%; } 最后,实在没想到换个富文本编辑器会弄出这么多问题,学习之路,最难也是最让人愉悦的,也只有学习才是生活

优秀的个人博客,低调大师

108天南京银行完成不可能完成的新金融DevOps转型

扫码或点我直达 免费领 在2018云栖大会南京峰会企业研发云专场,由南京银行研发管理负责人吴攀带来了“云效助力新金融DevOps转型——南京银行实践之路”的主题分享。首先对南京银行的研发规模与成长做了介绍,对“鑫云+”的诞生和其架构应用做了详细的讲解。 以下为精彩视频内容整理: 南京银行研发规模概况 简单给大家介绍一下南京银行现在的规模,南京银行的科技现在有运维中心、研发中心和科技管理部,我是在科技管理部负责配置管理和研发过程管理。我们现在正式的员工有200多人,外包合作场商有600多人,在线运营的运营系统有300多个。 有人说银行不就是有柜面、网银、手机银行吗?在这里想和大家解释一下,举个例子。一个贷款的产品,除了要涉及到本身的核心柜面,贷款本身的系统以外,可能还涉及到风控,涉及到大数据,然后总账,还有账户管理,还有监管。那么银行的这种

优秀的个人博客,低调大师

苹果5天跌掉一个百度,库克醒醒吧

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 在中国,苹果手机几乎不邀请文体明星做广告或代言。但今年,它破例了。王菲的女儿、生于1997年的歌手窦靖童受邀为苹果手机拍摄了户外广告海报。对于神一般的苹果而言,自2018年开始至今,“破例”的并非只有这一项。 苹果公司将在美东时间5月1日发布季度财报,而全球智能手机市场增长放缓的历史性态势也伤害到苹果手机,这让外界更加关注苹果的新财报。截至4月25日的五个交易日内,苹果股价下跌了9%,市值蒸发高达800亿美元。截至美东时间4月25日,百度市值为803.91亿美元。这意味着,苹果在五个交易日内相当于跌掉了一个百度的市值。 苹果手机遭遇的历史性困境,在整个产业链产生了连锁反应。4月23日,欧洲芯片制造商AMS发出“警告”称,由于来自其一家主要客户的订单疲软,该公司的业绩将出现下滑。AMS并未透露该客户的姓名,但分析师估计,AMS有一半收入来自于苹果。 据路透社报道,4月24日,市场研究公司GBH Insights分析师丹尼尔·艾夫斯(Daniel Ives)在一份客户报告中称,他预计2018财年苹果iPhone的出货量将为2.12亿部,低于此前估计的2.21亿部。Wedbush证券公司高级交易员乔尔·库利纳(Joel Kulina)在谈到iPhone出货量将下降时表示,现有的预期可能还不够低,“目前仍没有可见性,这将使大量投资资金留在场外”。 加拿大投资银行Canaccord Genuity分析师迈克·沃克利(Michael Walkley)指出,iPhone X不是一款失败产品,但相对于iPhone先前的升级周期来说,“它令人感到略微有些失望”。 中国台湾的全球***芯片代工厂台积电也是苹果手机的供应商。彭博社报道称,台积电2018第二季营业利润率和营收的展望双双不如预期。虽然台积电受惠于新客户订单的增长,例如数字货币挖矿客户需要功能强大的芯片,但仍面临智能手机厂商需求放缓的窘境。这家总部位于新竹的公司现在更进一步争取客户,重点放在高性能运算处理器、汽车和物联网的订单上。 台积电 同样是来自于彭博社的报道还透露,苹果最贵的手机iPhone X 难以吸引新兴市场客户,而竞争对手华为和小米来势汹汹,纷纷推出性价比更高的手机,主宰中国市场——这是苹果***的海外市场。鸿海、和硕等苹果公司的五家***组装厂2017年年底营收达到高峰后,急剧放缓,可见高价手机iPhone X才推出一季后,需求可能退潮。从过去历史经验来看,这是苹果走下坡的前兆。 谁都知道苹果公司(Apple Inc.)在发生变化,唯独苹果自己没有感觉。 关于重大技术趋势以及这些趋势对苹果的影响,苹果公司的高管们一直闪烁其词。至少从当前看来,智能手机市场的增长已经消失,这是一个***的趋势。最有可能的消费者现在至少都拥有一部智能手机,用户换新机的时间间隔也越来越长。在许多国家,消费者要么是iPhone党,要么是安卓(Android)党,“变节”的人不多。 其结果就是,新型智能手机的销售在全球范围内陷入停滞,苹果公司也无法幸免。投资者清楚这一点。按照分析师的平均预期,苹果2018财年的智能手机销量较2017财年将增长3%,2019财年销量将增长1%。如此缓慢的增长对苹果业务不利,不过得益于涨价和新产品发布,苹果2018年的收入增长还是有望提速。在苹果5月1日发布第二财季财报前,分析师们一再下调销量增速预期。他们在苹果2017年12月业绩公布前也***先见之明地进行了类似的下调。 失去动力 苹果的iPhone销量预计将连续四年下滑或增长缓慢。 图表左上角的英文意为iPhone销量(单位:百万台) 注:苹果的财政年度在9月结束。据野村极讯,2018和2019财年数据为分析师的平均预期 来源:彭博社和野村极讯(Nomura Instinet)(2018和2019财年预期) 苹果也该收起客套,动点真格的了。从现实情况看,作为苹果的主要收入来源,iPhone的轻松增长时代已经结束。若想重振雄风,苹果可以通过涨价、推出更多产品来拓宽收入渠道,以音乐和新闻订阅、应用程序下载等方式进一步打开苹果用户口袋。但是,这样改变商业模式基础存在风险和不确定性(当然不是不可能)。既然苹果的股票价格还是维持在历史高位,那么其股价很可能无法反映出可能存在的缺点。 这些看法虽然悲观,却胜在真实。相比之下,苹果公司的高管们对智能手机市场广泛变化的事实置若罔闻,也不思考苹果公司该如何改变才能应对上述新现实。 增速趋缓 2017年智能手机销量下降,预计未来几年增速相对缓慢。 全球智能手机销量(单位:十亿美元) 来源:国际数据公司(IDC) 在2017年8月与股票分析师的电话会议中,苹果的一位高管问***执行官蒂姆•库克(Tim Cook):如今智能手机市场不景气,苹果还能否在未来几年销售更多的iPhone?库克表示,在他看来,已经拥有iPhone或是拥有iPhone竞争对手产品的消费者,以及从来没买过智能手机的消费者,都大有潜力可挖,可以向他们销售更多手机。这个答案直到2015年都没问题,因为当时库克说的每件事都是事实。但现在情况不一样,华尔街对iPhone的销售预期表明投资者对库克的话不买账。 IDC预计2017年智能手机销量下滑0.5%,未来五年复合年增长率2.8%。智能手机销量停滞的一个原因是,许多国家的消费者要花更长时间才换掉旧手机。苹果公司并没有预见到市场的这种变化。 下调预期 股票分析师一直在下调苹果2018财年收入预期。2018年不同时点华尔街的平均预期如下(单位:十亿美元): 注:苹果的财政年度至9月结束 来源:彭博社 库克在2018年2月与分析师的电话会议中表示,部分国家的消费者手机换新的时间间隔变长了。但他也说,消费者更新换代的速度不是“我们要过分关注的内容”。这个答案非常惊人,因为苹果大部分新款iPhone都是iPhone老用户在买,消费者手机换代的频率对于苹果的销售至关重要。 私底下,苹果肯定已经意识到智能手机的风口已经过去。这也是为什么苹果一直在强调“设备激活量”(全球苹果设备的使用量)的原因。苹果2月称自己的设备激活量是13亿。通过强调这一数字,苹果能引导投资者暂时忘掉iPhone单位销量的增长乏力,并勾勒出让投资者欣喜不已的前景:只要说服现有苹果设备用户购买更多应用程序、订购已有和未来的苹果产品、HomePod智能音箱等附加设备,那么财务图景该多么可观! 价格 苹果2018年的iPhone销量预计不会有大幅提高,但售价上调可能推高iPhone收入。以下是iPhone收入和单位销量的同比变化: 图表左上角的两处英文自左至右分别意为“iPhone收入”、“iPhone单位销量” (注:苹果的财政年度至9月结束。据野村极讯,2018财年数据为分析师的平均预期) 来源:彭博社和野村极讯(2018财年预期) 倘若苹果能解释为什么设备激活量很重要、公司打算怎样进一步打开用户腰包,以及如果减少了对iPhone销售的依赖,其财务状况将发生怎样的变化,那么无疑算得上明智。 也许企业高管并没有义务将惊人的真实情况(比如“我们正努力弥补***市场陷入自然停滞的不利影响”等)坦露给我们知道,但这么做确实会让人耳目一新,还能为苹果进驻下一个大型产品领域(不管是电动车还是其他)争取更多时间。苹果目前的做法是聪明的:通过增加辅助产品、设法上调智能手机价格等方式来扩大iPhone业务。这个策略如此精明,反而让苹果的默不作声显得愈发奇怪了。

优秀的个人博客,低调大师

一天我们能做什么? ——中小金融企业持续交付之路

导读:平时工作中,研发、测试、运维同学在持续交付和DevOps上会碰到一些难题:比如持续交付搭一个系统很简单,但是想要管理代码之外的一些资源有点难;公司里的系统多、模块多,开发人员只是做了一小部分,但最终需要集成测试通过才能交付;开发和测试人员之间界限不明确,常常会出现一些互相扯皮的事情。面对这些难题该如何解决?国泰产险首席架构师许磊明首次披露国泰产险持续交付之路,分享解决思路。 前言 对于一家公司或者企业来说,最重要的还是要看结果。持续交付,DevOps只是手段,那怎么衡量这个结果呢?我们需要知道发布的吞吐量是什么,修复时间是多少,质量怎么样?接下来我会跟大家分享国泰产险在持续交付上的一些实践。 保险行业面临的困境 保险业是一个强监管的行业。当时我们主要业务是做车险,车险是一个红海市场,中小保险公司操作十分困难,外部面临的是市场竞争惨烈

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册