首页 文章 精选 留言 我的

精选列表

搜索[分区技术],共10000篇文章
优秀的个人博客,低调大师

ZooKeeper 技术内幕初探(二)

前面介绍了ZooKeeper的一些基本特性,ZooKeeper入门,也安装运行了一个简单的ZooKeeper的例子。这此主要介绍ZooKeeper内部的一些工作方式理论部分。 与文无关 主要涉及以下: ZooKeeper服务的架构 ZooKeeper的数据模型 ZooKeeper的节点特性 ZooKeeper的访问控制 Watcher(监听器) ZooKeeper服务概览 ZooKeeper是一个复制式的分布式应用,有点像DNS服务或一些中心化的服务。 ZooKeeper服务架构 这是官网给的ZooKeeper服务图,所有组成ZooKeeper服务的服务器都相互知晓,它们维护了一个内存状态的镜像,也包含事务日志,持久存储的快照等。只要半数以上的的服务器是可用的,ZooKeeper服务就是可用的。 顺便提一下ZooKeeper的设计目标(Design Goals) 简单 复制式的 所有节点相互复制状态 有序的,所有的事务都有时间戳 快速 在读大于写的时候... ZooKeeper读写图 ZooKeeper在读数据的时候可以直接从当前节点读取数据,在写数据的时候需要将写请求转发到Leader节点上。 ZooKeeper数据模型 ZooKeeper的各个服务器节点共同维护一个可以注册数据的层级结构,类似于Unix的文件系统。数据注册的位置也称为znode。 Znode图 注意: 数据节点一般以字节形式存储,节点存储的数据大小最大不超过1MB。协作的数据一般不会太大。最好让数据远小于1MB会好些。 ZooKeeper无法识别相对路径。 znode的路径必须是绝对路径 每个Znode除了存储数据以外,还有维护一些状态信息。 Znode 特性 Znode类型 ZooKeeper主要有两种节点类型,也可以说是三种。持久节点,临时节点。第三个是顺序节点,顺序节点也可以说是刚才那两种节点。 持久节点和顺序节点都可以是顺序节点。 注意节点的类型是在创建的时候就设置好的。 持久节点。ZooKeeper中最常见的一种节点类型,创建之后一直存在服务器上,知道有删除操作来主动清楚这个节点 临时节点,与客户端会话绑定在一起。 客户端会话失效,节点自动清理。(网络突然坏掉不算会话失效) 顺序节点,在节点创建的时候,ZooKeeper自动给节点名分配一个序列号。例如/path/to/znode-0000000001,一般是10位数字,序号之外的位以0填充。 节点状态 每一个Znode都有对应的stat结构,和文件系统类似。stat状态主要包含下面的信息: cZxid. 节点被创建时候的事务ID mZxid 节点最后一次被修改时候的事务ID pZxid 该节点的子节点最后一次被修改时的事务ID。子节点删除或添加才会影响pZxid ctime 节点被创建的时间 mtime 节点被修改的世界 dataVersion 这个节点数据改变的次数 cversion 子节点被改变的次数 aclVersion 节点的ACL(访问控制列表被改变的次数) ephemeralOwner 创建该临时节点的 session ID。如果是持久节点,设置为0 dataLength 数据内容长度 numChildren 当前节点子节点的个数 可以使用ls2和stat命令查看ZooKeeper节点下的信息。 命令演示 ZooKeeper的访问控制(ACL) ZooKeeper的数据模型提供了ACL来控制znode节点的访问。如果一个客户端符合ACL控制,那么就可以对其进行访问,否则将无法操作。 Zookeeper支持可配置的认证机制。它利用一个三元组来定义客户端的访问权限: (scheme:expression, perms) 。其中: Schema 代表权限控制模式,分别为 World 任何人 Auth 不需要ID Digest 用户名和密码方式的认证 IP Address IP地址方式的认证 perms(权限),ZooKeeper支持如下权限 CREATE: 创建子节点 READ: 获取子节点与自身节点的数据信息 WRITE:在Znode节点上写数据 DELETE:删除子节点 ADMIN:设置ACL权限 贴上如下图,在下次使用ZooKeeper的时候更明白,这次我们主要说明一些ZooKeeper理论方面的知识,具体编程的实现下次再说。 ACL图 权限模式和授权对象的关系: IP: 通常是IP地址或是IP端,例如"192.168.1.2"或"192.168.1.1/24" Degist: 自定义,通常是"username:BASE64(SHA-1(username:password))" World:只有一个ID,“anyone” Super: 与Degist模式一致 注意: Znode的Acl只是针对某个节点,不会作用到它的子节点上 任何连接到ZooKeeper的客户端都可以使用exist操作,exist是不需要权限的。 ZooKeeper的Watcher ZooKeeper中引入了Watcher机制来实现分布式通知功能,ZooKeeper允许客户端像服务端注册一个Watcher监听,当服务端的一些指定事件触发了这个Watcher,那么就会向指定客户端发送一个事件通知来实现分布式的通知功能。 有如下的Watcher事件类型可能出现: NodeChildrenChanged: zNode的子节点创建或删除的时候 NodeCreated: 新的Znode节点被创建的时候 NodeDataChanged: Znode节点的数据改变了的时候 NodeDeleted: Znode节点被删除的时候。 关于Watcher内部实现机制,下次可以通过分析其源码进行更详细的说明 最后 这次主要介绍了一些ZooKeeper内部的基本概念,理论部分较多,若无理论的基础实施接下来的操作也不太方便。 接下来我会写下: ZooKeeper 客户端编程 ZooKeeper Watcher监听器原理分析 参考 《从Paxos到ZooKeeper-分布式一致性原理与实践》 《Apache ZooKeeper Essential》 ZooKeeper Overview

优秀的个人博客,低调大师

大数据的技术生态

大数据本身是个很宽泛的概念,Hadoop生态圈(或者泛生态圈)基本上都是为了处理超过单机尺度的数据处理而诞生的。你可以把它比作一个厨房所以需要的各种工具。锅碗瓢盆,各有各的用处,互相之间又有重合。你可以用汤锅直接当碗吃饭喝汤,你可以用小刀或者刨子去皮。但是每个工具有自己的特性,虽然奇怪的组合也能工作,但是未必是最佳选择。 大数据,首先你要能存的下大数据。 传统的文件系统是单机的,不能横跨不同的机器。HDFS(Hadoo上。你作为用户,不需要知道这些,就好比在单机上你不关心文件分散在什么磁道什么扇区一样。HDFS为你管理这些数据。p Distributed FileSystem)的设计本质上是为了大量的数据能横跨成百上千台机器,但是你看到的是一个文件系统而不是很多文件系统。比如你说我要获取/hdfs/tmp/file1的数据,你引用的是一个文件路径,但是实际的数据存放在很多不同的机器 存的下数据之后,你就开始考虑怎么处理数据。虽然HDFS可以为你整体管理不同机器上的数据,但是这些数据太大了。一台机器读取成T上P的数据(很大的数据哦,比如整个东京热有史以来所有高清电影的大小甚至更大),一台机器慢慢跑也许需要好几天甚至好几周。对于很多公司来说,单机处理是不可忍受的,比如微博要更新24小时热博,它必须在24小时之内跑完这些处理。那么我如果要用很多台机器处理,我就面临了如何分配工作,如果一台机器挂了如何重新启动相应的任务,机器之间如何互相通信交换数据以完成复杂的计算等等。这就是MapReduce / Tez / Spark的功能。MapReduce是第一代计算引擎,Tez和Spark是第二代。MapReduce的设计,采用了很简化的计算模型,只有Map和Reduce两个计算过程(中间用Shuffle串联),用这个模型,已经可以处理大数据领域很大一部分问题了。 那什么是Map什么是Reduce? 考虑如果你要统计一个巨大的文本文件存储在类似HDFS上,你想要知道这个文本里各个词的出现频率。你启动了一个MapReduce程序。Map阶段,几百台机器同时读取这个文件的各个部分,分别把各自读到的部分分别统计出词频,产生类似(hello, 12100次),(world,15214次)等等这样的Pair(我这里把Map和Combine放在一起说以便简化);这几百台机器各自都产生了如上的集合,然后又有几百台机器启动Reduce处理。Reducer机器A将从Mapper机器收到所有以A开头的统计结果,机器B将收到B开头的词汇统计结果(当然实际上不会真的以字母开头做依据,而是用函数产生Hash值以避免数据串化。因为类似X开头的词肯定比其他要少得多,而你不希望数据处理各个机器的工作量相差悬殊)。然后这些Reducer将再次汇总,(hello,12100)+(hello,12311)+(hello,345881)= (hello,370292)。每个Reducer都如上处理,你就得到了整个文件的词频结果。 这看似是个很简单的模型,但很多算法都可以用这个模型描述了。 Map+Reduce的简单模型很黄很暴力,虽然好用,但是很笨重。第二代的Tez和Spark除了内存Cache之类的新feature,本质上来说,是让Map/Reduce模型更通用,让Map和Reduce之间的界限更模糊,数据交换更灵活,更少的磁盘读写,以便更方便地描述复杂算法,取得更高的吞吐量。 有了MapReduce,Tez和Spark之后,程序员发现,MapReduce的程序写起来真麻烦。他们希望简化这个过程。这就好比你有了汇编语言,虽然你几乎什么都能干了,但是你还是觉得繁琐。你希望有个更高层更抽象的语言层来描述算法和数据处理流程。于是就有了Pig和Hive。Pig是接近脚本方式去描述MapReduce,Hive则用的是SQL。它们把脚本和SQL语言翻译成MapReduce程序,丢给计算引擎去计算,而你就从繁琐的MapReduce程序中解脱出来,用更简单更直观的语言去写程序了。 有了Hive之后,人们发现SQL对比Java有巨大的优势。一个是它太容易写了。刚才词频的东西,用SQL描述就只有一两行,MapReduce写起来大约要几十上百行。而更重要的是,非计算机背景的用户终于感受到了爱:我也会写SQL!于是数据分析人员终于从乞求工程师帮忙的窘境解脱出来,工程师也从写奇怪的一次性的处理程序中解脱出来。大家都开心了。Hive逐渐成长成了大数据仓库的核心组件。甚至很多公司的流水线作业集完全是用SQL描述,因为易写易改,一看就懂,容易维护。 自从数据分析人员开始用Hive分析数据之后,它们发现,Hive在MapReduce上跑,真鸡巴慢!流水线作业集也许没啥关系,比如24小时更新的推荐,反正24小时内跑完就算了。但是数据分析,人们总是希望能跑更快一些。比如我希望看过去一个小时内多少人在充气娃娃页面驻足,分别停留了多久,对于一个巨型网站海量数据下,这个处理过程也许要花几十分钟甚至很多小时。而这个分析也许只是你万里长征的第一步,你还要看多少人浏览了跳蛋多少人看了拉赫曼尼诺夫的CD,以便跟老板汇报,我们的用户是猥琐男闷骚女更多还是文艺青年/少女更多。你无法忍受等待的折磨,只能跟帅帅的工程师蝈蝈说,快,快,再快一点! 于是Impala,Presto,Drill诞生了(当然还有无数非著名的交互SQL引擎,就不一一列举了)。三个系统的核心理念是,MapReduce引擎太慢,因为它太通用,太强壮,太保守,我们SQL需要更轻量,更激进地获取资源,更专门地对SQL做优化,而且不需要那么多容错性保证(因为系统出错了大不了重新启动任务,如果整个处理时间更短的话,比如几分钟之内)。这些系统让用户更快速地处理SQL任务,牺牲了通用性稳定性等特性。如果说MapReduce是大砍刀,砍啥都不怕,那上面三个就是剔骨刀,灵巧锋利,但是不能搞太大太硬的东西。 这些系统,说实话,一直没有达到人们期望的流行度。因为这时候又两个异类被造出来了。他们是Hive on Tez / Spark和SparkSQL。它们的设计理念是,MapReduce慢,但是如果我用新一代通用计算引擎Tez或者Spark来跑SQL,那我就能跑的更快。而且用户不需要维护两套系统。这就好比如果你厨房小,人又懒,对吃的精细程度要求有限,那你可以买个电饭煲,能蒸能煲能烧,省了好多厨具。 上面的介绍,基本就是一个数据仓库的构架了。底层HDFS,上面跑MapReduce/Tez/Spark,在上面跑Hive,Pig。或者HDFS上直接跑Impala,Drill,Presto。这解决了中低速数据处理的要求。 那如果我要更高速的处理呢? 如果我是一个类似微博的公司,我希望显示不是24小时热博,我想看一个不断变化的热播榜,更新延迟在一分钟之内,上面的手段都将无法胜任。于是又一种计算模型被开发出来,这就是Streaming(流)计算。Storm是最流行的流计算平台。流计算的思路是,如果要达到更实时的更新,我何不在数据流进来的时候就处理了?比如还是词频统计的例子,我的数据流是一个一个的词,我就让他们一边流过我就一边开始统计了。流计算很牛逼,基本无延迟,但是它的短处是,不灵活,你想要统计的东西必须预先知道,毕竟数据流过就没了,你没算的东西就无法补算了。因此它是个很好的东西,但是无法替代上面数据仓库和批处理系统。 还有一个有些独立的模块是KV Store,比如Cassandra,HBase,MongoDB以及很多很多很多很多其他的(多到无法想象)。所以KV Store就是说,我有一堆键值,我能很快速滴获取与这个Key绑定的数据。比如我用身份证号,能取到你的身份数据。这个动作用MapReduce也能完成,但是很可能要扫描整个数据集。而KV Store专用来处理这个操作,所有存和取都专门为此优化了。从几个P的数据中查找一个身份证号,也许只要零点几秒。这让大数据公司的一些专门操作被大大优化了。比如我网页上有个根据订单号查找订单内容的页面,而整个网站的订单数量无法单机数据库存储,我就会考虑用KV Store来存。KV Store的理念是,基本无法处理复杂的计算,大多没法JOIN,也许没法聚合,没有强一致性保证(不同数据分布在不同机器上,你每次读取也许会读到不同的结果,也无法处理类似银行转账那样的强一致性要求的操作)。但是丫就是快。极快。 每个不同的KV Store设计都有不同取舍,有些更快,有些容量更高,有些可以支持更复杂的操作。必有一款适合你。 除此之外,还有一些更特制的系统/组件,比如Mahout是分布式机器学习库,Protobuf是数据交换的编码和库,ZooKeeper是高一致性的分布存取协同系统,等等。 有了这么多乱七八糟的工具,都在同一个集群上运转,大家需要互相尊重有序工作。所以另外一个重要组件是,调度系统。现在最流行的是Yarn。你可以把他看作中央管理,好比你妈在厨房监工,哎,你妹妹切菜切完了,你可以把刀拿去杀鸡了。只要大家都服从你妈分配,那大家都能愉快滴烧菜。 你可以认为,大数据生态圈就是一个厨房工具生态圈。为了做不同的菜,中国菜,日本菜,法国菜,你需要各种不同的工具。而且客人的需求正在复杂化,你的厨具不断被发明,也没有一个万用的厨具可以处理所有情况,因此它会变的越来越复杂。

优秀的个人博客,低调大师

Elastic 技术栈之 Filebeat

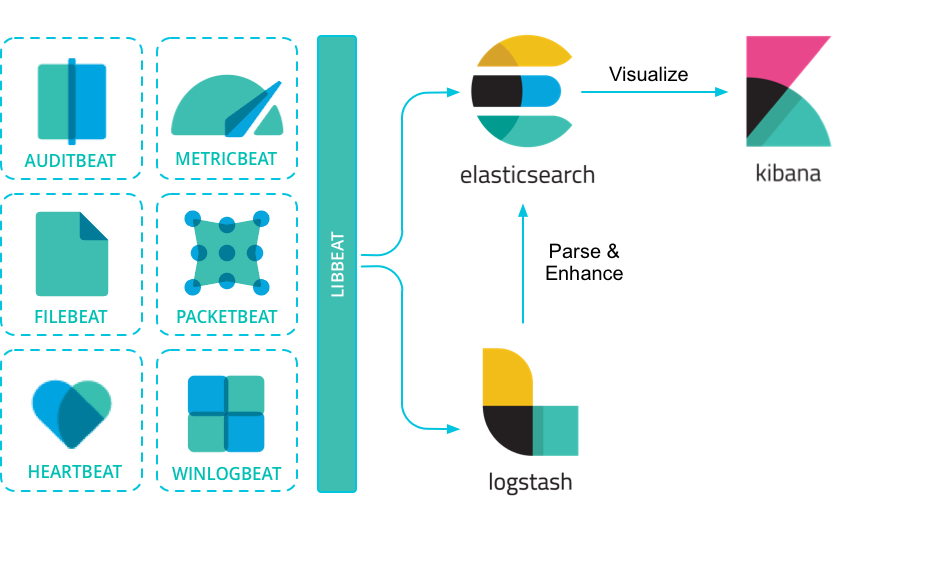
简介 Beats 是安装在服务器上的数据中转代理。 Beats 可以将数据直接传输到 Elasticsearch 或传输到 Logstash 。 Beats 有多种类型,可以根据实际应用需要选择合适的类型。 常用的类型有: Packetbeat:网络数据包分析器,提供有关您的应用程序服务器之间交换的事务的信息。 Filebeat:从您的服务器发送日志文件。 Metricbeat:是一个服务器监视代理程序,它定期从服务器上运行的操作系统和服务收集指标。 Winlogbeat:提供Windows事件日志。 参考 更多 Beats 类型可以参考:community-beats 说明 由于本人工作中只应用了 FileBeat,所以后面内容仅介绍 FileBeat 。 FileBeat 的作用 相比 Logstash,FileBeat 更加轻量化。 在任何环境下,应用程序都有停机的可能性。 Filebeat 读取并转发日志行,如果中断,则会记住所有事件恢复联机状态时所在位置。 Filebeat带有内部模块(auditd,Apache,Nginx,System和MySQL),可通过一个指定命令来简化通用日志格式的收集,解析和可视化。 FileBeat 不会让你的管道超负荷。FileBeat 如果是向 Logstash 传输数据,当 Logstash 忙于处理数据,会通知 FileBeat 放慢读取速度。一旦拥塞得到解决,FileBeat 将恢复到原来的速度并继续传播。 安装 Unix / Linux 系统建议使用下面方式安装,因为比较通用。 wget https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.1.1-linux-x86_64.tar.gz tar -zxf filebeat-6.1.1-linux-x86_64.tar.gz 参考 更多内容可以参考:filebeat-installation 配置 配置文件 首先,需要知道的是:filebeat.yml是 filebeat 的配置文件。配置文件的路径会因为你安装方式的不同而变化。 Beat 所有系列产品的配置文件都基于YAML格式,FileBeat 当然也不例外。 filebeat.yml 部分配置示例: filebeat: prospectors: - type: log paths: - /var/log/*.log multiline: pattern: '^[' match: after 参考 更多 filebeat 配置内容可以参考:配置 filebeat 更多 filebeat.yml 文件格式内容可以参考:filebeat.yml 文件格式 重要配置项 filebeat.prospectors (文件监视器)用于指定需要关注的文件。 示例 filebeat.prospectors: - type: log enabled: true paths: - /var/log/*.log output.elasticsearch 如果你希望使用 filebeat 直接向 elasticsearch 输出数据,需要配置 output.elasticsearch 。 示例 output.elasticsearch: hosts: ["192.168.1.42:9200"] output.logstash 如果你希望使用 filebeat 向 logstash输出数据,然后由 logstash 再向elasticsearch 输出数据,需要配置 output.logstash。 注意 相比于向 elasticsearch 输出数据,个人更推荐向 logstash 输出数据。 因为 logstash 和 filebeat 一起工作时,如果 logstash 忙于处理数据,会通知 FileBeat 放慢读取速度。一旦拥塞得到解决,FileBeat 将恢复到原来的速度并继续传播。这样,可以减少管道超负荷的情况。 示例 output.logstash: hosts: ["127.0.0.1:5044"] 此外,还需要在 logstash 的配置文件(如 logstash.conf)中指定 beats input 插件: input { beats { port => 5044 # 此端口需要与 filebeat.yml 中的端口相同 } } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { elasticsearch { hosts => "localhost:9200" manage_template => false index => "%{[@metadata][beat]}-%{[@metadata][version]}-%{+YYYY.MM.dd}" document_type => "%{[@metadata][type]}" } } setup.kibana 如果打算使用 Filebeat 提供的 Kibana 仪表板,需要配置 setup.kibana 。 示例 setup.kibana: host: "localhost:5601" setup.template.settings 在 Elasticsearch 中,索引模板用于定义设置和映射,以确定如何分析字段。 在 Filebeat 中,setup.template.settings 用于配置索引模板。 Filebeat 推荐的索引模板文件由 Filebeat 软件包安装。如果您接受 filebeat.yml 配置文件中的默认配置,Filebeat在成功连接到 Elasticsearch 后自动加载模板。 您可以通过在 Filebeat 配置文件中配置模板加载选项来禁用自动模板加载,或加载自己的模板。您还可以设置选项来更改索引和索引模板的名称。 参考 更多内容可以参考:filebeat-template 说明 如无必要,使用 Filebeat 配置文件中的默认索引模板即可。 setup.dashboards Filebeat 附带了示例 Kibana 仪表板。在使用仪表板之前,您需要创建索引模式filebeat- *,并将仪表板加载到Kibana 中。为此,您可以运行setup命令或在filebeat.yml配置文件中配置仪表板加载。 为了在 Kibana 中加载 Filebeat 的仪表盘,需要在filebeat.yml配置中启动开关: setup.dashboards.enabled: true 参考 更多内容可以参考:configuration-dashboards 命令 filebeat 提供了一系列命令来完成各种功能。 执行命令方式: ./filebeat COMMAND 参考 更多内容可以参考:command-line-options 说明 个人认为命令行没有必要一一掌握,因为绝大部分功能都可以通过配置来完成。且通过命令行指定功能这种方式要求每次输入同样参数,不利于固化启动方式。 最重要的当然是启动命令 run 了。 示例指定配置文件启动 ./filebeat run -e -c filebeat.yml -d "publish" ./filebeat -e -c filebeat.yml -d "publish" # run 可以省略 模块 Filebeat 提供了一套预构建的模块,让您可以快速实施和部署日志监视解决方案,并附带示例仪表板和数据可视化。这些模块支持常见的日志格式,例如Nginx,Apache2和MySQL 等。 运行模块的步骤 配置 elasticsearch 和 kibana output.elasticsearch: hosts: ["myEShost:9200"] username: "elastic" password: "elastic" setup.kibana: host: "mykibanahost:5601" username: "elastic" password: "elastic username 和 password 是可选的,如果不需要认证则不填。 初始化环境 执行下面命令,filebeat 会加载推荐索引模板。 ./filebeat setup -e 指定模块 执行下面命令,指定希望加载的模块。 ./filebeat -e --modules system,nginx,mysql 参考 更多内容可以参考:配置 filebeat 模块|filebeat 支持模块 原理 Filebeat 有两个主要组件: harvester:负责读取一个文件的内容。它会逐行读取文件内容,并将内容发送到输出目的地。 prospector:负责管理 harvester 并找到所有需要读取的文件源。比如类型是日志,prospector 就会遍历制定路径下的所有匹配要求的文件。 filebeat.prospectors: - type: log paths: - /var/log/*.log - /var/path2/*.log Filebeat保持每个文件的状态,并经常刷新注册表文件中的磁盘状态。状态用于记住 harvester 正在读取的最后偏移量,并确保发送所有日志行。 Filebeat 将每个事件的传递状态存储在注册表文件中。所以它能保证事件至少传递一次到配置的输出,没有数据丢失。 本文转自静默虚空博客园博客,原文链接:http://www.cnblogs.com/jingmoxukong/p/8185321.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册