首页 文章 精选 留言 我的

精选列表

搜索[tdd],共406篇文章
优秀的个人博客,低调大师

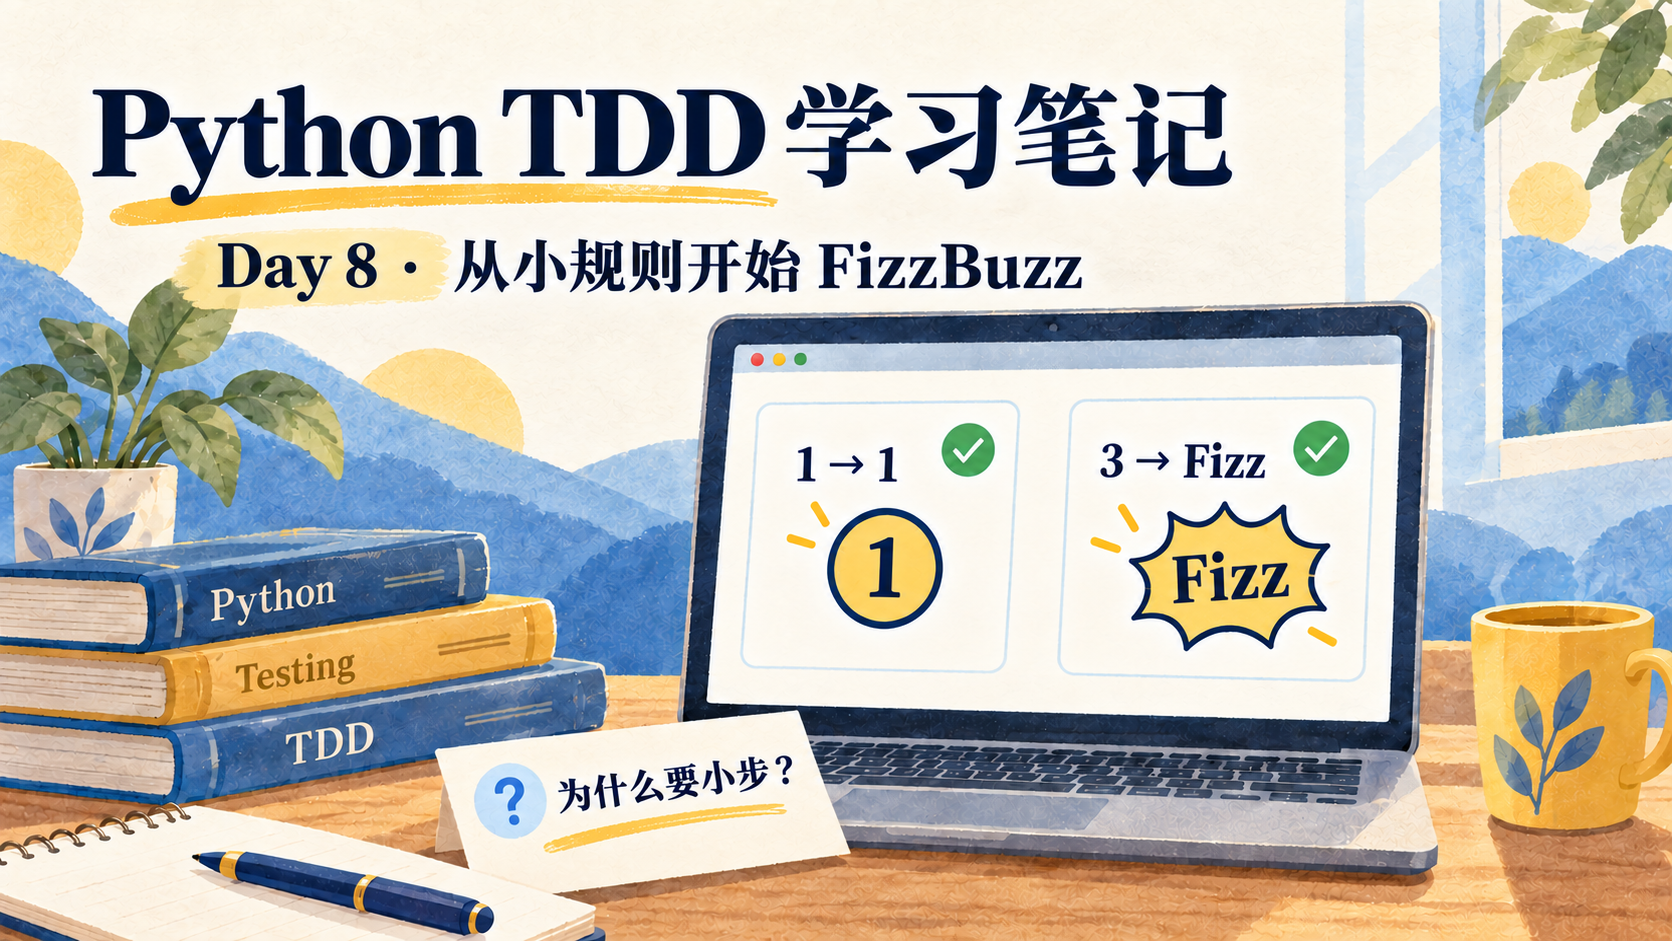
Python TDD 学习笔记 Day 08:FizzBuzz,以及为什么要小步推进

今天开始 FizzBuzz。代码很短,真正让我停下来思考的,是练习背后的做法:先写一个普通数字的测试,实现它,再加入特殊规则,究竟有什么用?直接写完不是更快吗? ## 今天先实现两条规则 FizzBuzz 是练习条件判断的题目,不是真实业务。完整规则包括:3 的倍数返回 `"Fizz"`,5 的倍数返回 `"Buzz"`,同时为两者倍数时返回 `"FizzBuzz"`,其他数字返回自己的字符串。 按照课程安排,今天只处理正整数,完成普通数字转换与 Fizz;Buzz 和组合规则留到 Day 09。函数返回文字,不负责打印,也不生成整段数列。 ## 从普通数字开始 第一个案例没有特殊条件:输入整数 1,期望字符串 `"1"`。 ```python def test_ordinary_number_returns_its_string(): assert fizzbuzz(1) == "1" ``` 函数最初返回空字符串,测试失败。随后用 Python 自带的转换实现它: ```python def fizzbuzz(number): return str(number) ``` `str(1)` 返回字符串 `"1"`,并不是把 1 打印到终端。返回值可以继续比较、拼接或交给其他代码使用。 这次没有先写死 `"1"`。规则已经清楚,直接使用简单的通用转换即可,不必为了展示流程刻意绕路。 ## 再加入 Fizz 第二条规则用输入 3 来表达: ```python def test_multiple_of_three_returns_fizz(): assert fizzbuzz(3) == "Fizz" ``` 当前实现返回 `"3"`,新测试失败,而普通数字测试继续通过。实现需要判断输入能否被 3 整除: ```python 3 % 3 # 0 6 % 3 # 0 7 % 3 # 1 ``` `%` 取得余数,所以 `number % 3 == 0` 表示输入是 3 的倍数。加入判断后,本节实现为: ```python def fizzbuzz(number): if number % 3 == 0: return "Fizz" return str(number) ``` 先判断特殊情况,再处理普通情况。`return` 给出结果后立即结束当前调用,因此返回 `"Fizz"` 后不会继续执行下面的转换。 ## 用多组案例检查同一规则 只测试 3,还不足以区分“只处理数字 3”和“处理 3 的倍数”。因此补充 6、9;普通数字则保留 1,并增加 2、4。 ```python import pytest from fizzbuzz import fizzbuzz @pytest.mark.parametrize("number, expected", [(1, "1"), (2, "2"), (4, "4")]) def test_ordinary_number_returns_its_string(number, expected): assert fizzbuzz(number) == expected @pytest.mark.parametrize("number", [3, 6, 9]) def test_multiple_of_three_returns_fizz(number): assert fizzbuzz(number) == "Fizz" ``` 两组测试分别表达普通转换与特殊规则。期望值直接来自约定,没有在测试里再写一遍实现算法。当前函数已经简单清楚,没有继续增加类或复杂抽象。 ## 我的疑问:为什么不直接写完整函数 讲完后,我的感受是:没有看到分步与一次写完有什么区别,也不明白这样做的用意。 这个疑问并没有因为测试全绿而消失。对于 FizzBuzz 这种只有几行、规则又已经给出的例子,直接写完确实更快。前面的演示拆得很细,展示了操作,却没有充分说明这种做法解决了什么问题。 课堂随后用运费场景补充解释:如果原规则是“满 100 元包邮”,后来增加“偏远地区收取 20 元”,就需要先确认:满 100 元的偏远地区订单,究竟是否包邮? 先写这个场景的测试,会促使我们先确定预期结果。实现之后运行旧测试,又能检查普通地区的包邮行为有没有被破坏。规则发生交互时,小步的价值才更容易看见。 | 做法 | 主要作用 | | --- | --- | | 先写测试 | 在实现之前明确什么结果才算正确 | | 每次推进一条规则 | 减少同时考虑的内容,失败时更容易定位 | | 保留已有测试 | 修改后反复检查原有行为 | 这些作用不是每个例子都同样明显。测试通过也只说明已有案例符合预期,不能替代对业务规则本身的确认。 ## 小步不是每改一行就停一次 实际使用时,可以把一条有意义的业务规则作为一步,连贯地看测试、实现和结果。简单明确的逻辑不必刻意拆成许多机械动作;规则有疑问或交互时,再放慢节奏。 后续课程也会采用这个粒度,先解释需要解决的问题,再通过完整一点的例子展示做法。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day08 -v uv run pytest -v ``` 本节 6 个测试通过,全项目 45 个测试通过。Day 08 完成普通数字与 Fizz;完整 FizzBuzz 尚未实现,下一节继续。 ## 今日收获 今天我仍没明显看出,分步写 FizzBuzz 比直接写完好在哪里。这个例子太简单,频繁停下来反而让我不清楚目的。课堂补充了规则变化时的用途:先用测试明确预期,再通过旧测试检查原有行为。对我来说,目前更直观的是把规则写成可重复执行的检查;小步推进的价值,还需要在更贴近实际的场景里继续体会。

优秀的个人博客,低调大师

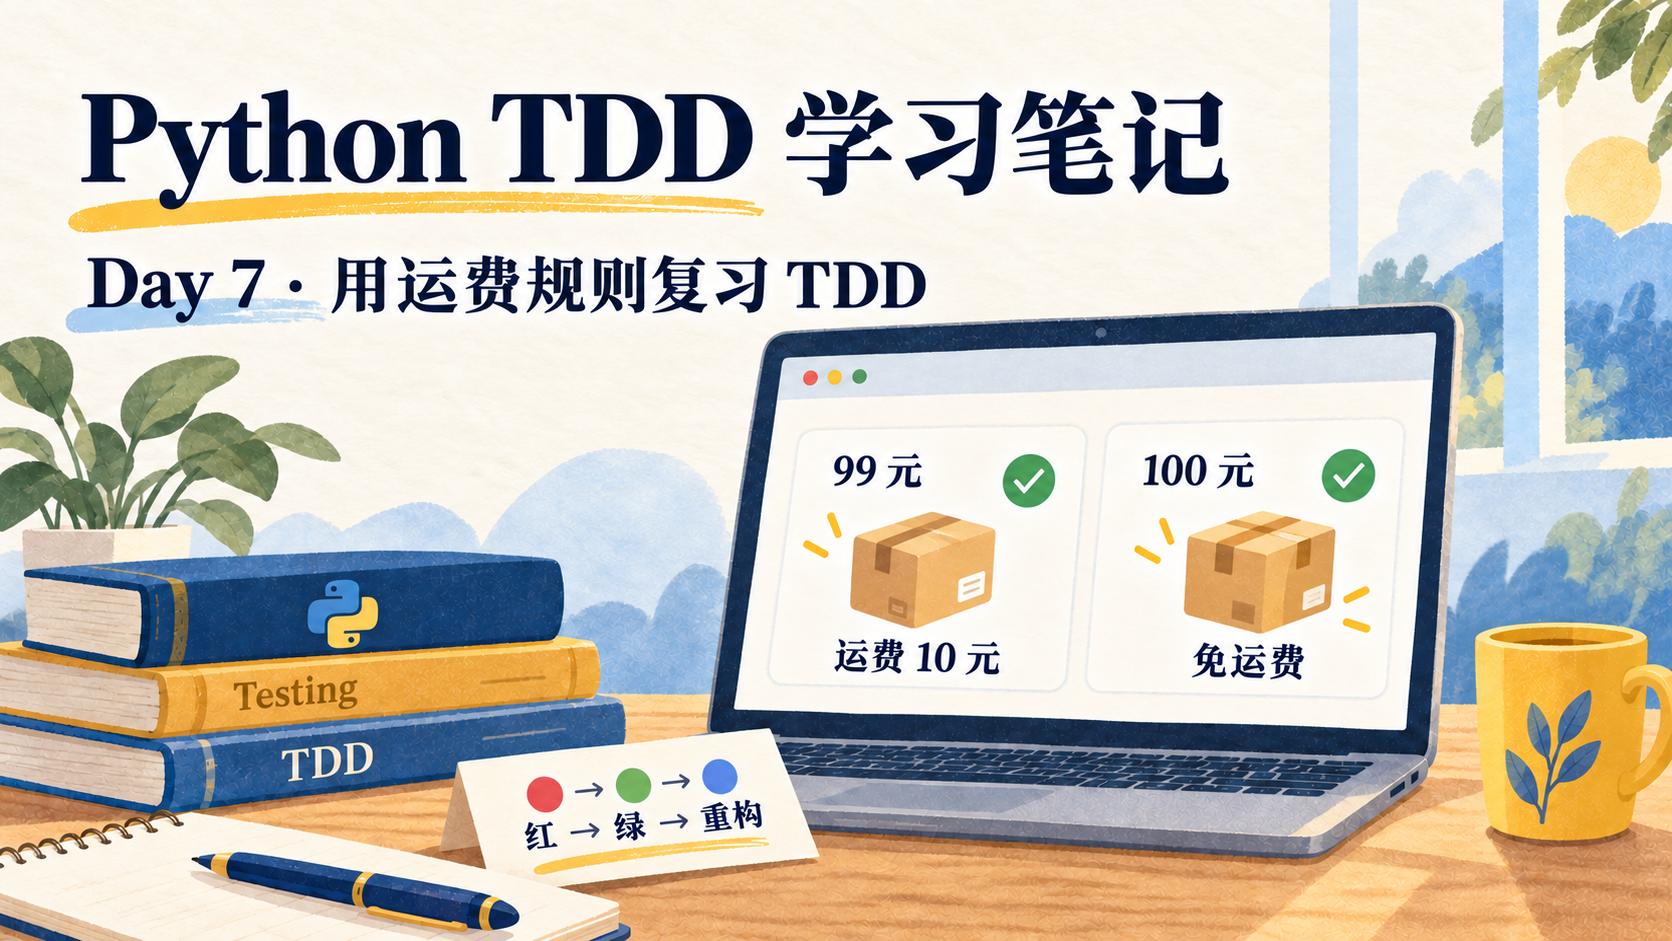
Python TDD 学习笔记 Day 07:用运费规则复习红、绿、重构

今天是第一阶段复习,没有增加新工具,而是用一个贴近实际的运费函数,把断言、异常、边界、参数化和重构串起来。 这次例子让我觉得比较好理解:每条测试都能对应到实际订单中的一种情况。我们仍然采用分步讲解、同步修改代码的方式。所以本篇记录的是引导练习过程,不代表我已经能够独立完成全部步骤。 ## 先把收费规则说清楚 本节只处理整数金额,单位为元: | 订单金额 | 运费规则 | | --- | --- | | 非负且小于 100 元 | 收取 10 元 | | 达到或超过 100 元 | 免运费 | | 负数 | 抛出 `ValueError`,说明金额不能为负 | “达到 100 元”包含恰好 100 元,所以后面的判断应该使用 `>=`。地区、重量、小数和其他输入类型先不扩展,避免一个复习例子承担过多需求。 ## 红灯:先描述一个普通订单 先选 50 元订单,要求运费为 10 元: ```python def test_shipping_fee_below_free_shipping_threshold(): assert shipping_fee(50) == 10 ``` 函数最初暂时返回 0,运行后得到 `assert 0 == 10`。这次失败说明测试确实执行了,而且找到了当前实现与规则之间的差异。 随后让函数返回 10,第一个测试通过。这是教学中的过渡实现,还没有满足完整需求。 实际项目中,规则清楚、判断简单时,可以直接写对应条件,不必机械地先返回一个常量。这里分步,是为了看清测试怎样推动代码变化。 ## 新规则出现,旧测试继续保留 第二个测试选择恰好 100 元: ```python def test_shipping_is_free_at_threshold(): assert shipping_fee(100) == 0 ``` 此时函数始终返回 10,所以新测试失败。加入免运费判断后: ```python def shipping_fee(total): if total >= 100: return 0 return 10 ``` 50 元和 100 元两个案例都通过。旧测试继续保留,是为了确认新增免运费规则没有破坏普通订单的收费行为。修改后重新运行已有测试,就是回归测试。 ## 非法输入用异常表达 负数不能直接当作“小于 100 元”来收取运费,需要单独拒绝: ```python def test_shipping_rejects_negative_total(): with pytest.raises(ValueError, match="^total must not be negative$"): shipping_fee(-1) ``` 测试最初失败,提示 `DID NOT RAISE ValueError`,意思是没有抛出约定的异常。随后在函数开头检查负数: ```python if total = FREE_SHIPPING_THRESHOLD: return 0 return STANDARD_SHIPPING_FEE ``` 名字让读代码的人直接知道 100 是免运费门槛,10 是普通运费。这一步没有新增功能,只改变了代码的表达方式。 测试中的预期仍然使用需求中的具体数字,不从实现常量推导。否则实现常量误改时,预期也可能跟着变化,失去检查作用。 重构也不是必须做出某种改动。如果一个小函数已经足够清楚,保留原状同样合理。 ## 测试帮了什么忙,又有哪些局限 课堂补充的解释是:测试把口头规则变成了可以反复执行的检查。以后改代码,不用凭记忆重新尝试每种金额,就能检查普通收费、免运费和非法输入是否仍符合约定。 但测试通过,只能说明实现满足了已写出的案例,不能保证需求和期望值本身正确。如果把“满额免运费”理解反了,即使测试全绿,业务仍然可能出错。因此先确认规则,与写测试同样重要。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day07 -v uv run pytest -v ``` 第一条执行本节五个正常金额案例和一个负数异常案例;第二条检查全部课程。整理时,本节 6 个测试、全项目 39 个测试均通过。 ## 今日收获 今天的运费例子比较贴近实际,让我更容易理解测试案例与业务规则的对应关系:未满 100 元收取运费,达到 100 元免运费,负数金额则被拒绝。相比单独讲概念,这种围绕实际场景逐步补充测试的方式更直观。对于红—绿—重构这套循环,目前还没有更多特别的感受,需要在后续练习中继续体会。

优秀的个人博客,低调大师

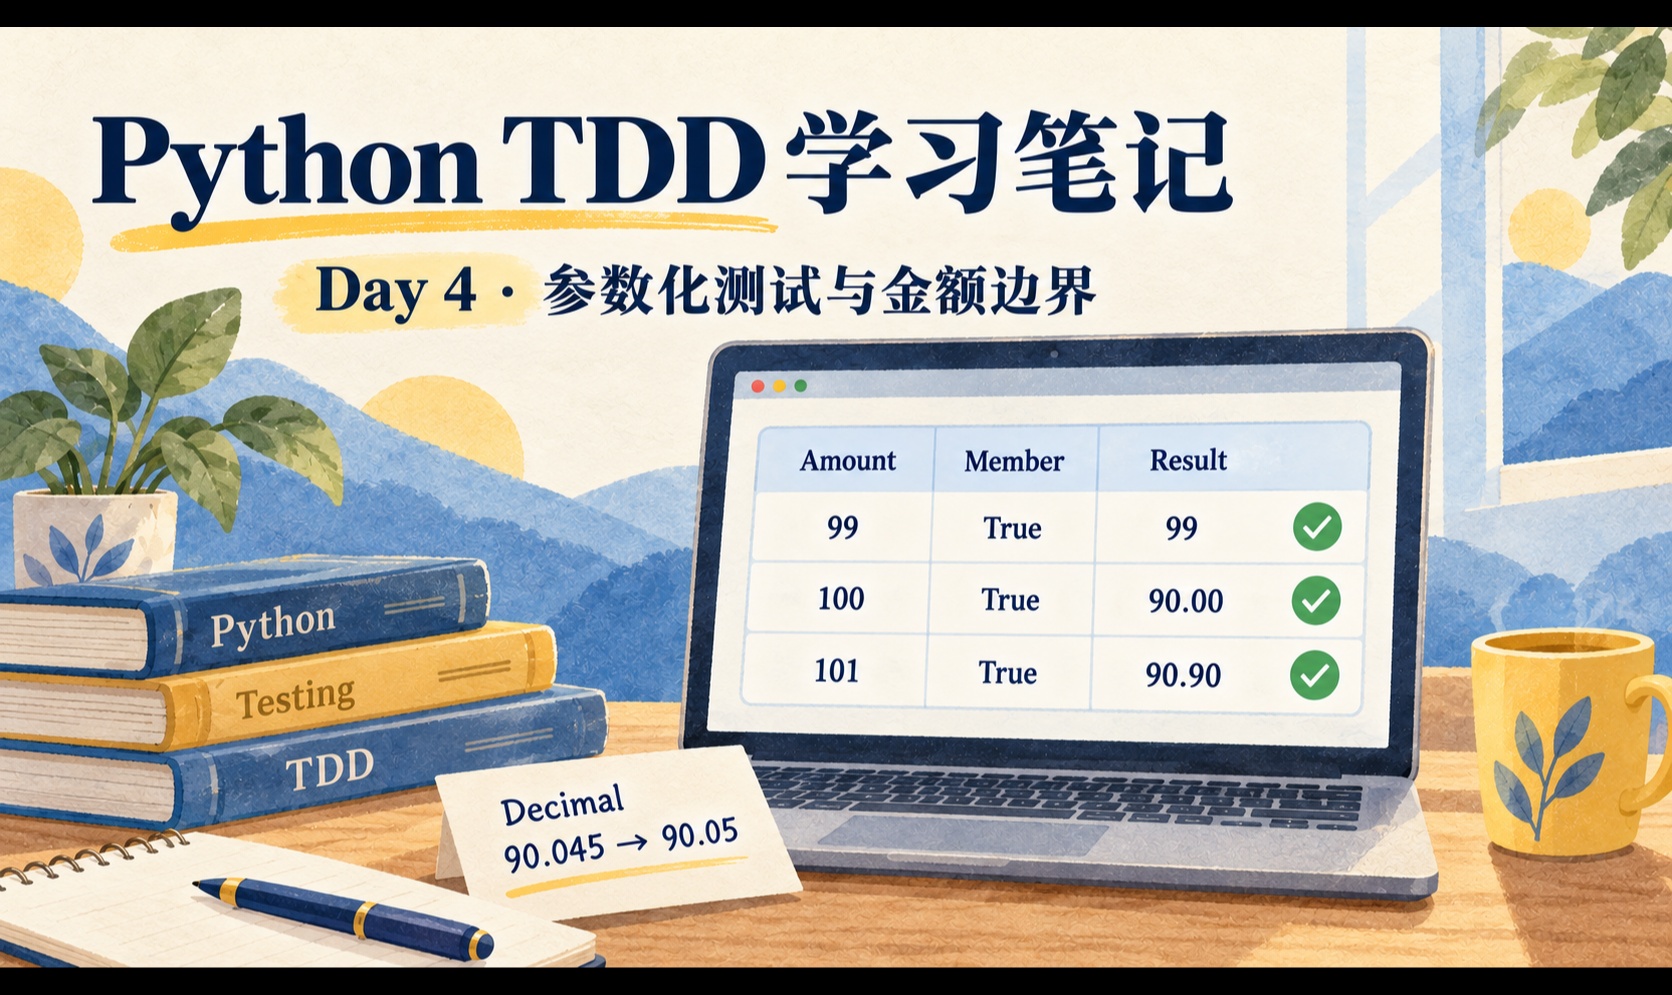
Python TDD 学习笔记 Day 04:参数化测试、边界与金额规则

今天用“会员订单满 100 元打九折”这条规则,练习怎样让测试既精简,又能覆盖真正容易出错的地方。 ## 一张参数表,多条业务规则 折扣函数有三个输入信息:订单金额、是否会员、预期价格。把它们放进 `pytest.param`,一个测试函数就能执行多组独立案例: ```python DISCOUNT_CASES = [ pytest.param(Decimal("99"), True, Decimal("99"), id="member-just-below-100"), pytest.param(Decimal("100"), True, Decimal("90.00"), id="member-at-100"), pytest.param(Decimal("101"), True, Decimal("90.90"), id="member-just-above-100"), pytest.param(Decimal("100.01"), True, Decimal("90.01"), id="member-decimal-amount"), pytest.param(Decimal("100"), False, Decimal("100"), id="non-member-at-100"), ] @pytest.mark.parametrize("total, is_member, expected", DISCOUNT_CASES) def test_final_price(total, is_member, expected): assert final_price(total, is_member) == expected ``` 参数化测试的价值不只是少写几个测试函数。每一行都对应一条可读的业务规则;`id` 会显示在 pytest 报告中,所以失败时能直接定位到,例如 `member-at-100`。 ## 边界案例验证规则在哪里切换 “满 100 元”意味着规则在 100 这个点发生变化,因此重点测试 99、100、101: | 条件 | 预期 | | --- | --- | | 会员,99 元 | 原价 99 | | 会员,100 元 | 九折,90.00 | | 会员,101 元 | 九折,90.90 | | 非会员,100 元 | 原价 100 | 这不是单纯给输入分类。边界测试要验证分类交界处的行为是否正确:如果条件误写成 `total > 100`,恰好 100 元的测试就会失败;如果漏掉会员判断,非会员 100 元的测试就会失败。 一开始还加入了 90、120 等案例。之后发现,在当前没有更多金额分段的规则下,它们和 99、101 分别属于相同行为区间,并没有增加新的保障,因此保留四个能区分规则的核心案例。测试应覆盖不同的行为,不是累积相似的数据。 ## 金额不能只依赖 float 和 round 带小数金额 `100.01` 打九折的数学结果是 `90.009`,而价格要精确到分,因此预期结果是 `90.01`。这首先说明需要明确“金额保留两位小数”的业务规则。 进一步检查发现,Python 的 `round()` 对中点采用银行家舍入: ```python round(2.5) # 2 round(3.5) # 4 ``` 这种行为适合部分数值场景,但金额怎样舍入必须由业务规则决定。本练习约定传统四舍五入,并用 `Decimal` 表示金额: ```python from decimal import Decimal, ROUND_HALF_UP DISCOUNT_THRESHOLD = Decimal("100") DISCOUNT_RATE = Decimal("0.9") CENT = Decimal("0.01") def final_price(total, is_member): total = Decimal(str(total)) if is_member and total >= DISCOUNT_THRESHOLD: return (total * DISCOUNT_RATE).quantize(CENT, rounding=ROUND_HALF_UP) return total ``` `Decimal` 精确表示十进制数值;`quantize(Decimal("0.01"), rounding=ROUND_HALF_UP)` 则明确规定结果以分为单位、按传统四舍五入处理。比如 `100.05` 的九折为 `90.045`,最终金额为 `90.05`。 ## 验证 在项目根目录执行: ```bash uv run pytest lessons/day04 -v uv run pytest -v ``` 整理时,Day 04 的 7 个测试和项目全部 19 个测试均已通过。 ## 今日收获 我理解参数化测试能更方便地编写多个案例;进一步看,它还能把每一条业务规则集中成清晰的数据表。边界案例不只是分类输入,更要检查规则在临界点前后是否正确切换。`Decimal` 解决的是金额场景中十进制表示与舍入规则的确定性问题;它比浮点数更适合需要精确到分的计算。本次练习也让我认识到,金额是否四舍五入、如何舍入,都应先写成测试中的明确规则。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 03:异常类型、异常消息与边界测试

前两次练习分别检查了返回结果和预期异常。今天继续学习:异常类型符合要求,还能不能进一步检查程序给出的原因?我们用一个密码长度验证函数,把异常消息、边界案例和参数化测试连接起来。 ## 先约定行为,再编写测试 这次练习只检查字符串长度:少于 8 个字符时抛出 `ValueError`,消息为 `password is too short`;至少 8 个字符时返回 `True`。暂时不增加数字、大写字母和纯空格限制,也不把这个教学函数当作完整的密码安全方案。 项目延续简单结构: ```text lessons/day03/ ├── README.md ├── password_validator.py └── test_password_validator.py ``` ## 从没有异常的红灯开始 最初的占位函数直接返回 `True`。短密码测试要求抛出异常: ```python with pytest.raises(ValueError, match="password is too short"): validate_password("abc") ``` 当时实际运行得到: ```text Failed: DID NOT RAISE ValueError ``` 这不是异常类型或消息错误,而是根本没有抛出预期异常。确认失败原因后,函数改为: ```python def validate_password(password): if len(password) < 8: raise ValueError("password is too short") return True ``` `len` 取得字符串长度,`if` 决定是否拒绝输入。`raise` 主动抛出异常并停止本次函数执行;只有满足长度要求,才会走到 `return True`。 条件用 `< 8`,而不是 `<= 8`,因为“至少 8 个”包含恰好 8 个字符。 ## 异常类型解决什么问题 异常类型用于分类错误,让调用方选择处理方式。例如,`ValueError` 表示输入值不符合要求,`FileNotFoundError` 表示文件不存在,`TimeoutError` 表示操作超时。调用方可以根据类别提示修改输入、选择其他文件或考虑重试,而不用解析消息里的文字。 同一类型可以表示多种具体原因: ```python ValueError("password is too short") ValueError("password contains only spaces") ``` 它们都属于值不符合要求,但拒绝原因不同。第二条只是用于说明概念,并不是本次新增的规则。 ## 异常消息说明具体原因 在 `ValueError("password is too short")` 中,类型告诉我们错误类别,消息说明这一次是“密码太短”。当消息也是需求的一部分,测试可以同时检查两项: ```python with pytest.raises(ValueError, match="password is too short"): validate_password("abc") ``` 这里要求抛出 `ValueError` 或其子类,而且异常消息匹配规定的表达式。若抛出 `ValueError("invalid password")`,类型符合要求,消息不匹配,测试仍然失败。 ## 包含一句话,与完整消息匹配 `match` 使用正则表达式搜索。没有起止锚点时,它检查的是能否找到匹配片段: ```python match="password is too short" ``` 这会匹配 `password is too short`,也会匹配 `password is too short: minimum 8`。 本次约定了固定消息,因此把测试改成: ```python match="^password is too short$" ``` `^` 表示开始,`$` 表示结束。对于当前不含换行的消息,额外添加 `: minimum 8` 就不能匹配。 | 异常消息 | 无锚点的模式 | 带起止锚点的模式 | |---|---|---| | `password is too short` | 匹配 | 匹配 | | `password is too short: minimum 8` | 匹配 | 不匹配 | 是否锁定完整消息取决于需求。若只约定异常类别,没有约定具体措辞,就不必让测试与每个字绑定。 ## 为什么选择 7、8、9 至少 8 个字符是规则的分界,所以选择 7、8、9 来检查边界两侧: | 长度 | 预期行为 | |---:|---| | 7 | 抛出规定的异常和消息 | | 8 | 返回 `True` | | 9 | 返回 `True` | 如果条件被误写为 `<= 8`,长度为 8 的正常案例就能发现错误。 边界测试与异常检查不是同一个概念。边界决定选择哪些输入;异常类型、消息或返回值决定对输出行为检查什么。长度为 3 的密码离边界较远,也可以检查它的异常类型和消息。 ## 参数化测试:数据怎样进入函数 下面是项目目前的完整测试文件: ```python import pytest from password_validator import validate_password @pytest.mark.parametrize( "password", ["", "abc", "abcdefg"], ids=["empty", "length-3", "length-7"], ) def test_password_below_minimum_length(password): with pytest.raises(ValueError, match="^password is too short$"): validate_password(password) @pytest.mark.parametrize( "password", ["abcdefgh", "abcdefghi"], ids=["length-8", "length-9"], ) def test_password_at_or_above_minimum_length(password): assert validate_password(password) is True ``` `"password"` 指定参数名,与测试函数的形参对应。数据列表为它提供取值;`ids` 列表按同样的顺序给测试项命名,只影响报告显示,不改变数据和判断。 第一张参数表有三组数据,生成三个独立测试项,统一检查拒绝行为。第二张表有两组数据,生成两个独立测试项,统一检查正常返回。两个函数合计生成五个测试项。 `assert validate_password(password) is True` 要求返回值就是布尔值 `True`,不只是一个被当作真值的对象。 ## 当前代码与本地验证 练习代码已加入空字符串、3、7、8、9 个字符的五组案例。空字符串长度为 0,因此已有的 `< 8` 条件就能处理,不需要新增业务分支。 在项目根目录运行: ```bash uv run pytest lessons/day03 -v ``` 预期结果为 `5 passed`。截至本篇整理时,对话里尚未收到这份最终运行结果,因此这里记录的是预期,不把它写成已经验证通过。 8 个空格的长度也是 8,按照当前只检查长度的规则会被接受。若要拒绝纯空格,应先明确新需求,再增加测试和实现。`None`、数字等非字符串输入的处理也尚未约定。 ## 今日收获 今天我最初觉得异常类型和异常消息都在解决边界问题,进一步了解后发现:边界决定选择哪些输入,异常类型用于分类错误,异常消息说明具体原因。边界与异常检查互相补充,但测试并非每次都必须检查消息,要看需求是否约定了具体说明。这次密码长度练习同时约定了类型和消息,因此都需要验证。 ## 参考 [pytest 官方文档:匹配异常消息](https://docs.pytest.org/en/stable/how-to/assert.html#matching-exception-messages)

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 13:覆盖率高,为什么还会有 Bug?

今天沿用运费场景,学习修改已有代码时怎样留下测试保护:先记录已经确认的行为,再复现 Bug、修复并保留案例,最后整理代码结构。 最让我明确的一点是:覆盖率高,不代表边界情况都考虑到了。 ## 三个测试通过,仍然漏掉了 100 元 规则还是“未满 100 元收取 10 元运费,达到 100 元免运费,负数金额被拒绝”。今天另建了一份故意带错误的教学旧代码,原来的 Day 07 实现没有被改坏。 旧代码的关键条件是: ```python if total > 100: fee = 0 else: fee = 10 ``` 先为已确认的行为补上测试: | 输入 | 预期 | | --- | --- | | 50 元 | 运费 10 元 | | 150 元 | 免运费 | | -1 元 | 抛出 ValueError | 三个案例全部通过,却没有发现恰好 100 元会收费。这说明全绿只代表已写出的案例符合预期。 给旧代码补测试,也不意味着把现有结果一律当成正确答案。本次只保护已确认符合需求的行为;发现与规则冲突的行为,需要另外留下缺陷测试。 ## 先复现,再修复 新增边界测试: ```python def test_order_at_free_shipping_threshold_has_no_fee(): assert calculate_shipping(100) == 0 ``` 旧代码实际返回 10,测试失败,留下了明确的 Bug 证据。随后只将 `> 100` 改为 `>= 100`,四个测试全部通过。 先看到失败的意义是:确认这条测试确实能发现本次问题。如果以后有人误改回原来的条件,保留下来的测试就会再次失败。这就是缺陷回归测试的用途。 ## 修复与重构分开做 修复把错误行为改正确;重构则是在保持行为的前提下改善结构。 边界修好后,测试保持原样,再移除多余的 else 和临时变量,得到: ```python def calculate_shipping(total): if total = 100: return 0 return 10 ``` 负数抛出异常后不会继续执行,免运费分支可以直接返回结果。整理后读起来更直观,四个测试仍然通过。 这为已覆盖案例的行为没有变化提供了证据,但不能保证所有未测输入都正确。重构时也不能只为让测试通过,就跟着修改原有预期。 ## 覆盖率记录执行,不替代场景选择 最初的 50、150、-1 三个案例,可以让教学旧代码的所有语句执行到,也能经过金额判断的真、假两侧,却仍然没有验证恰好 100 元。 因此,覆盖率帮助我们寻找没有执行过的代码,不能证明业务规则都正确。本节只通过代码路径解释这一局限,没有安装插件或生成实测覆盖率报告。 我在总结时说:“感觉覆盖率高,但是可能一些边界情况你没有考虑进去。”这正是本次例子要说明的问题。 实际项目里,除了关注覆盖率,还要根据需求选择普通、边界和异常场景,并检查真正重要的结果。 ## 小数比较:允许误差时用 approx 今天另做了一个耗时求和的教学实验: ```python duration = sum([0.1, 0.2]) assert duration == 0.3 ``` 它实际得到 `0.30000000000000004`,直接比较失败。这是浮点表示误差,不是运费函数中的新 Bug。 如果计算允许一个明确的误差范围,可以写: ```python import pytest assert duration == pytest.approx(0.3, abs=1e-9, rel=0) ``` 这里允许最多 `0.000000001` 的绝对误差,`rel=0` 关闭相对容差。本例只是演示,实际误差范围应由计算或测量要求决定,不能随意放宽以掩盖错误。 `approx` 改变的是比较方式,不会提高计算精度。耗时、测量值等近似结果可以使用它;精确金额与明确舍入规则,继续使用之前学过的 Decimal。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day13 -v ``` 本节包含四个运费案例和一个小数比较实验,五个测试均已通过。本篇整理时重新运行了完整回归,全项目 77 个测试通过。 ## 今日收获 今天我理解了,覆盖率高并不代表没有 Bug,边界情况仍可能被遗漏。测试除了执行代码,还要选择关键场景并检查正确结果。发现 Bug 后,先用测试复现,再修复并保留这个案例,可以帮助后续修改及时发现同类问题。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 11:Stub 检查结果处理,Mock 检查外部动作

今天学习外部依赖与测试替身,用订单通知练习:怎样不真的发送消息,也能检查通知逻辑? 让我真正分清 Stub 和 Mock 的,是两句话: - Stub:外部返回这个结果,我的程序怎么处理? - Mock:我的程序有没有正确执行这个动作? ## 为什么测试时替换发送服务 真实发送服务依赖网络和账号,可能慢、可能失败,还会真的打扰收件人。但我们首先要检查的是自己的逻辑:是否生成正确消息,以及怎样处理发送结果。 因此把发送对象作为参数传入: ```python def notify_order(order_id, recipient, sender): message = f"订单 {order_id} 已确认" sent = sender.send(recipient, message) if sent: return "通知成功" return "通知失败" ``` `sender` 是函数所依赖的发送能力。由外部提供它,而不是在函数内部创建真实服务对象,就是一种简单的依赖注入,不需要框架。 本例约定 `send` 返回 True 或 False。这是教学接口;实际平台可能通过返回对象或异常表达状态。 ## Stub:让外部结果可控 成功替身只提供同样的调用方式,固定返回 True: ```python class SuccessfulSenderStub: def send(self, recipient, message): return True ``` 它不发送消息,也不连接网络。测试把这个对象传进去: ```python def test_notification_reports_success_when_sender_succeeds(): sender = SuccessfulSenderStub() result = notify_order("A001", "buyer@example.com", sender) assert result == "通知成功" ``` 函数最初固定返回“通知失败”,这条测试失败;补上调用与结果判断后通过。再换成固定返回 False 的替身,就能检查失败提示: ```python class FailedSenderStub: def send(self, recipient, message): return False def test_notification_reports_failure_when_sender_fails(): sender = FailedSenderStub() result = notify_order("A001", "buyer@example.com", sender) assert result == "通知失败" ``` 这里不需要断网,也不需要等待真实故障。Stub 的重点是提供预设结果,让外部条件稳定可控。返回 False 与抛出超时异常不同,本节没有展开所有服务故障。 ## Mock:记录动作,再检查调用 两个 Stub 都不会检查收件人和正文。即使程序发给错误的人,它们仍可能固定返回 True 或 False,结果测试照样通过。 因此增加一个调用验证: ```python from unittest.mock import Mock def test_notification_sends_expected_message_to_recipient_once(): sender = Mock(spec=["send"]) sender.send.return_value = True notify_order("A001", "buyer@example.com", sender) sender.send.assert_called_once_with( "buyer@example.com", "订单 A001 已确认", ) ``` `Mock` 来自 Python 标准库,不需要另装依赖。这里的 `spec` 限制可用属性名;`return_value` 规定返回值;`assert_called_once_with` 检查发送方法恰好调用一次,且参数符合约定。 我把它比作“日志记录仪”。这个比喻比较贴切,但还要补充:记录本身不自动判断对错,是后面的断言在检查收件人、正文和调用次数。 ## 共性与区别,取决于关注点 | 关注点 | Stub | Mock | | --- | --- | --- | | 主要用途 | 提供预设结果 | 记录并验证调用 | | 通知例子 | 返回失败,检查程序如何处理 | 检查是否向正确收件人提交正确正文 | 两者共同点:都代替真实依赖,让测试无需连接外部服务。 它们不是完全互斥的工具分类。上面的 Mock 也设置了 `return_value = True`,同时承担了提供预设结果的作用。理解测试要回答什么问题,比只记住对象名称更有用。 ## 测试通过,不代表真实消息送达 本节测试确认的是:程序正确处理了约定的返回结果,并向发送接口提交了正确请求。整个过程没有真实发送消息,不能证明真实平台可用或收件人已收到通知。 实际项目中,还可以用少量集成测试验证真实接入,通常选择测试环境或沙箱。 另一个常见经验是,不必把每个内部函数都换成 Mock。计算逻辑直接检查返回值;通知这类外部动作确有必要时,再检查调用,避免内部重构也导致大量测试失效。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day11 -v uv run pytest -v ``` 本节包含发送成功、发送失败、收件人及正文调用验证三条测试。本篇整理时,本节 3 个测试、全项目 68 个测试均通过。 ## 今日收获 今天我理解了,Stub 主要用预设返回值,检查程序如何处理外部结果;Mock 主要记录调用,检查程序有没有正确执行外部动作。比如前者模拟发送失败,后者检查消息是否提交给了正确的收件人。这两句话比单独记住术语更容易帮助我区分它们。

优秀的个人博客,低调大师

TDD两小时实现自定义表达式模板解析器

为什么要重新造一个车轮? 很多情况下,用户需要按其自定义模板动态生成邮件、PDF。开源组件中,有两类较贴合需求的产品系列: 模板渲染引擎,如FreeMarker, Velocity虽然强大异常,但是过于灵活,不利于按需裁减出自己想要的少量语法; 纯字符串模板引擎,要么取数据不够动态(需要提前预知有哪些变量),或者是语法冗长(函数调用来实现动态扩展)不利于非IT人事编写。 那么有没有一款产品,既简洁可控,又易于扩展呢? 其实自己实现一个够用的模板解析器,也是很简单的事情,下面分享一款我两小时在融创地产HR项目中实现的模板解析器。 本实现没有任何外部依赖,很容易移植到其它语言,比如用javascript实现甚至更简单。 用户场景 用户的原始需求: 亲爱的XXX先生/女士 你好!欢迎加入XXX公司,你的部门是XXX,岗位职级XXX … 人事部 HR XXX先生/女士 模板设计: 亲爱的${uid|userInfo|prop:name}${uid|userInfo|prop:gender|genderName} 你好!欢迎加入 一天一个小目标 公司,你的部门是${uid|department|prop:name},岗位职级${uid|position|prop:name} … 人事部 HR ${my|prop:name}${my|prop:gender|genderName} 语法(静态语法) "${}":需要值替换的表达式,包含在"${"与"}"之间; "|": 顺序串联单个表达式的多个函数调用,前一调用的值会作为后一调用的第一参数; ":": 若调用有额外参数,则追加在":"之后; ",": 若额外参数不止一个,参以","分隔。 函数说明(可扩展及控制部分) uid: 获取当前调用的目标用户id userInfo: 根据用户id获取用户信息 prop:name: 获取对象的"name"属性 prop:gender: 获取对象的"gender"属性 genderName: 获取性别的中文名 department: 根据用户id获取所在部门信息 position: 根据用户id获取其岗位信息 my: 获取session中当前登录的用户信息 Tips: 此处是为了可读性使用了相对完整的单词。实际为了简洁,我们采用了单个到两个字母表示每个函数(如:"P:name"="prop:name","GN"="genderName"),然后在前端文本编辑器下方给用户一张函数表去定制模板,实践证明在语法、函数不多的情况下,对非IT人士整个模板的简洁比部分内容的可读性更重要 实现过程 代码库 https://gitee.com/chentao106/SimpleExpressionInterpreter 通过提交记录完整展示了实现过程,整体只需要五步,即可实现一个面向非IT人士的自定义表达式模板解析器: 第一步 创建代码框架及测试用例 先创建我们的解析器类,及其最重要的方法eval,即模板求值: //SimpleExpressionInterpreter.java public class SimpleExpressionInterpreter { public String eval(String template) { return null; } } 测试驱动开发,当然要先编写测试用例: //SimpleExpressionInterpreterTester.java import org.junit.Assert; import org.junit.Test; public class SimpleExpressionInterpreterTester { static final String template = "亲爱的${uid|userInfo|prop:name}${uid|userInfo|prop:gender|genderName}\n" + " 你好!欢迎加入不存在公司,你的部门是${uid|department|prop:name},岗位职级${uid|position|prop:name}…\n" + " 人事部 HR ${my|prop:name}${my|prop:gender|genderName}\n"; static final String value = "亲爱的李四女士\n" + " 你好!欢迎加入不存在公司,你的部门是互联网行销部,岗位职级产品经理T1…\n" + " 人事部 HR 张三先生\n"; private SimpleExpressionInterpreter testObj = new SimpleExpressionInterpreter(); @Test public void testEval() { Assert.assertEquals(value, testObj.eval(template)); } } 此时,测试用例当然是执行不通过的,我们想办法让测试先通过,才好进行下一步,同时定义一下我们的语法关键字: //SimpleExpressionInterpreter.java public class SimpleExpressionInterpreter { protected String expressionStart = "${"; protected String expressionEnd = "}"; protected String invocationSplit = "|"; protected String methodNameSplit = ":"; protected String parameterSplit = ","; protected char escape = '\\'; public String eval(String template) { return "亲爱的李四女士\n" + " 你好!欢迎加入不存在公司,你的部门是互联网行销部,岗位职级产品经理T1…\n" + " 人事部 HR 张三先生\n"; } } 运行测试用例,保证通过 第二步 提取字符器模板中的表达式 修改SimpleExpressionInterpreter.java文件,在其中增加 //SimpleExpressionInterpreter.java List<String> findExpressions(String template) { return null; } 增加测试用例 //SimpleExpressionInterpreterTester.java @Test public void testFindExpressions() { Assert.assertEquals(Collections.EMPTY_LIST, testObj.findExpressions("{a}")); Assert.assertEquals(Collections.singletonList("${a}"), testObj.findExpressions("${a}")); Assert.assertEquals(Collections.singletonList("${a}"), testObj.findExpressions("\\$${a}")); Assert.assertEquals(Arrays.asList("${a}", "${b}"), testObj.findExpressions("${a}${b}")); Assert.assertEquals(Arrays.asList("${a}", "${b}"), testObj.findExpressions("Hello ${a}, world${b}")); Assert.assertEquals(Collections.singletonList("${a\\}${b}"), testObj.findExpressions("${a\\}${b}")); Assert.assertEquals(Collections.EMPTY_LIST, testObj.findExpressions("${a\\}${b")); Assert.assertEquals(Arrays.asList("${uid|userInfo|prop:name}", "${uid|userInfo|prop:gender|genderName}", "${uid|department|prop:name}", "${uid|position|prop:name}", "${my|prop:name}", "${my|prop:gender|genderName}"), testObj.findExpressions(template)); } 为确保测试通过,修改SimpleExpressionInterpreter.java: //SimpleExpressionInterpreter.java int nextDivider(String template, String divider, int fromIndex) { int pos; int from = fromIndex; do { pos = template.indexOf(divider, from); if (pos == 0) return pos; if (pos > 0 && template.charAt(pos - 1) != escape) return pos; from = pos + 1; } while (pos >= 0); return -1; } List<String> findExpressions(String template) { List<String> expressions = new LinkedList<>(); int fromIndex = 0; String expression; do { int beginIndex = nextDivider(template, expressionStart, fromIndex); if (beginIndex < 0) break; int endIndex = nextDivider(template, expressionEnd, beginIndex + expressionStart.length()); if (endIndex < 0) break; expression = template.substring(beginIndex, endIndex + expressionEnd.length()); expressions.add(expression); fromIndex = endIndex + expressionEnd.length(); } while (true); return expressions; } 为了重用表达式前缀和后缀的查找代码,我们提取了公共函数nextDivider,我们也可以给它增加测试用例: //SimpleExpressionInterpreterTester.java @Test public void testNextDivider() { Assert.assertEquals(-1, testObj.nextDivider("{a}", testObj.expressionStart, 0)); Assert.assertEquals(0, testObj.nextDivider("${a}", testObj.expressionStart, 0)); Assert.assertEquals(2, testObj.nextDivider("\\$${a}", testObj.expressionStart, 0)); Assert.assertEquals(4, testObj.nextDivider("${a}${b}", testObj.expressionStart, 1)); Assert.assertEquals(3, testObj.nextDivider("${a}${b}", testObj.expressionEnd, 1)); Assert.assertEquals(8, testObj.nextDivider("${a\\}${b}", testObj.expressionEnd, 1)); Assert.assertEquals(-1, testObj.nextDivider("${a\\}${b", testObj.expressionEnd, 1)); } 运行测试用例,保证通过 第三步 解析表达式调用链 调用必须先用一个实体来表示: //Invocation.java import java.util.Arrays; public class Invocation { private String method; private String[] extraParams; public Invocation(String method, String... extraParams) { this.method = method; this.extraParams = extraParams; } public Invocation(String method) { this(method, null); } public String getMethod() { return method; } public String[] getExtraParams() { return extraParams; } @Override public int hashCode() { return method.hashCode() + (extraParams == null ? 0 : Arrays.hashCode(extraParams)); } @Override public boolean equals(Object obj) { if (obj == null) return false; if (!this.getClass().isInstance(obj)) return false; if (this.hashCode() != obj.hashCode()) return false; Invocation another = (Invocation) obj; return this.method.equals(another.method) && Arrays.equals(this.extraParams, another.extraParams); } @Override public String toString() { return extraParams == null || extraParams.length == 0 ? method : String.format("%s:%s", method, String.join(",", extraParams)); } } 增加解析调用链的函数声明: //SimpleExpressionInterpreter.java List<Invocation> parseInvocations(String expression) { return null; } 增加测试用例: //SimpleExpressionInterpreterTester.java @Test public void testParseInvocations() { Assert.assertEquals(Collections.EMPTY_LIST, testObj.parseInvocations("")); Assert.assertEquals(Collections.singletonList(new Invocation("a")), testObj.parseInvocations("${a}")); Assert.assertEquals(Arrays.asList(new Invocation("a"), new Invocation("b"), new Invocation("c")), testObj.parseInvocations("${a|b|c}")); Assert.assertEquals(Arrays.asList(new Invocation("uid"), new Invocation("userInfo"), new Invocation("prop", "name")), testObj.parseInvocations("${uid|userInfo|prop:name}")); } 为了通过测试,修改SimpleExpressionInterpreter.java: //SimpleExpressionInterpreter.java List<Invocation> parseInvocations(String expression) { if (expression == null || expression.length() < expressionStart.length() + expressionEnd.length()) return Collections.emptyList(); String statement = expression.substring(expressionStart.length(), expression.length() - expressionEnd.length()); String[] phrases = split(statement, invocationSplit); List<Invocation> invocations = new ArrayList<>(phrases.length); for (String phrase : phrases) { invocations.add(parseInvocation(phrase)); } return invocations; } private Invocation parseInvocation(String phrase) { int methodNameEndIndex = phrase.indexOf(methodNameSplit); if (methodNameEndIndex > 0) { String method = phrase.substring(0, methodNameEndIndex); String parameterStr = phrase.substring(methodNameEndIndex + methodNameSplit.length()); String[] parameters = parameterStr.split(parameterSplit); return new Invocation(method, parameters); } else { return new Invocation(phrase); } } String[] split(String text, String delimiter) { if (text == null) return null; if (delimiter == null || delimiter.length() == 0) return new String[]{text}; List<String> data = new ArrayList<>(); int pos = 0; for (int from = 0; from >= 0; from = pos + delimiter.length()) { pos = text.indexOf(delimiter, from); if (pos >= 0) { data.add(text.substring(from, pos)); } else { data.add(text.substring(from)); break; } } return data.toArray(new String[0]); } 为了支持使用"|"串连表达式,我们重写了String的split函数(split使用正则表达式拆分,而"|"是正则表达式的关键字,不考虑语法可替换、可跨语言移植的情况下,可以直接转义"\|"+String.split),我们也为它加上测试用例: //SimpleExpressionInterpreterTester.java @Test public void testSplit() { Assert.assertNull(testObj.split(null, "|")); Assert.assertArrayEquals(new String[]{"a|b"}, testObj.split("a|b", null)); Assert.assertArrayEquals(new String[]{"a|b"}, testObj.split("a|b", "")); Assert.assertArrayEquals(new String[]{"a", "b"}, testObj.split("a|b", "|")); Assert.assertArrayEquals(new String[]{"ab", "cd:ef,gh"}, testObj.split("ab|cd:ef,gh", "|")); Assert.assertArrayEquals(new String[]{"ab", "cd", "ef", "gh"}, testObj.split("ab,cd,ef,gh", ",")); } 运行测试用例,保证通过 第四步 实现表达式求值 到了最关键的表达式求值步骤,照旧我们还是先定义函数 //SimpleExpressionInterpreter.java String evalExpression(String expression) { return null; } 编写测试 //SimpleExpressionInterpreterTester.java @Test public void testEvalExpression() { Assert.assertEquals("李四", testObj.evalExpression("${uid|userInfo|prop:name}")); Assert.assertEquals("女士", testObj.evalExpression("${uid|userInfo|prop:gender|genderName}")); Assert.assertEquals("先生", testObj.evalExpression("${my|prop:gender|genderName}")); Assert.assertEquals("", testObj.evalExpression("${my1|prop:gender|genderName}")); } 如何实现表达式求值呢?首先我想到了javascript可以通过函数名来调用对象的方法,如果是java就要用到反射了。也就是说,我们可以把函数调用全部委托给另一个对象,我称作methodProvider,那么开始动手吧: //SimpleExpressionInterpreter.java //增加成员变量,并通过注入一个methodProvider private final Object methodProvider; public SimpleExpressionInterpreter(Object methodProvider) { this.methodProvider = methodProvider; } //实现回调逻辑 private Method findMethod(Class<?> clazz, String methodName) { for (Method m : clazz.getMethods()) { if (m.getName().equals(methodName)) { return m; } } return null; } private Object evalInvocations(List<Invocation> invocations) { boolean firstCall = true; Object result = null; try { for (Invocation invocation : invocations) { Method m = findMethod(methodProvider.getClass(), invocation.getMethod()); if (m == null) return null; Object[] args; if (invocation.getExtraParams() != null) { args = new Object[invocation.getExtraParams().length + (firstCall ? 0 : 1)]; if (!firstCall) args[0] = result; System.arraycopy(invocation.getExtraParams(), 0, args, firstCall ? 0 : 1, invocation.getExtraParams().length); } else { args = firstCall ? new Object[0] : new Object[]{result}; } result = m.invoke(methodProvider, args); firstCall = false; } } catch (IllegalAccessException | InvocationTargetException e) { return null; } return result; } String evalExpression(String expression) { List<Invocation> invocations = parseInvocations(expression); Object result = evalInvocations(invocations); return result == null ? "" : result.toString(); } 为了测试,我们要实现一个DemoMethodProvider,实际应用时,MethodProvider类就决定了你想向用户提供哪些可用函数: //DemoMethodProvider.java import java.util.Collections; import java.util.HashMap; import java.util.Map; public class DemoMethodProvider { private Map<String, Object> callParameters;//模拟实时传入的参数 private Map<String, Map<String, ?>> demoDB;//模拟数据库中的数据 public DemoMethodProvider() { callParameters = new HashMap<>(); Map<String, Object> my = new HashMap<>(); my.put("id", 0); my.put("name", "张三"); my.put("gender", 1); callParameters.put("my", my); callParameters.put("uid", 1); demoDB = new HashMap<>(); Map<String, Object> you = new HashMap<>(); you.put("id", 1); you.put("name", "李四"); you.put("gender", 2); demoDB.put(String.format("user:%d", 1), you); Map<String, Object> yourDepartment = Collections.singletonMap("name", "互联网行销部"); demoDB.put(String.format("user:%d:department", 1), yourDepartment); Map<String, Object> yourPosition = Collections.singletonMap("name", "产品经理T1"); demoDB.put(String.format("user:%d:position", 1), yourPosition); } public Object uid() { return callParameters.get("uid"); } public Object my() { return callParameters.get("my"); } public Map<String, ?> userInfo(int uid) { return demoDB.get(String.format("user:%d", uid)); } public Map<String, ?> department(int uid) { return demoDB.get(String.format("user:%d:department", uid)); } public Map<String, ?> position(int uid) { return demoDB.get(String.format("user:%d:position", uid)); } public Object prop(Map<String, ?> map, String propName) { return map.get(propName); } public String genderName(int gender) { switch (gender) { case 1: return "先生"; case 2: return "女士"; default: return ""; } } } 测试用例中创建SimpleExpressionInterpreter时注入DemoMethodProvider //SimpleExpressionInterpreterTester.java private SimpleExpressionInterpreter testObj = new SimpleExpressionInterpreter(new DemoFunctionProvider()); 运行测试用例,保证通过 第五步 组装代码实现模板求值 第一步我们通过写死返回值,已经“实现”了固定模板的解析,当然这个“实现”是静态的,我们首先修改测试用例,暴露代码问题(当然更建议的是增加更多完整 的模板->结果测试用例): //SimpleExpressionInterpreterTester.java @Test public void testEval() { Assert.assertEquals(value, testObj.eval(template)); Assert.assertEquals(value + "...", testObj.eval(template + "...")); Assert.assertEquals("", testObj.eval("")); Assert.assertNull(testObj.eval(null)); } 修改实现以保证测试通过: //SimpleExpressionInterpreter.java public String eval(String template) { if (template == null || template.length() == 0) return template; String result = template; List<String> expressions = findExpressions(template); for (String expression : expressions) { String value = evalExpression(expression); result = result.replace(expression, value); } return result; } 上面的自定义表达式模板解析器虽然还有改进空间,但是在大部分情况下都已经够用了,这不就是测试驱动的高效之处吗? 到此,我们可以非常自信地说,我们快速实现了一个高质量、简洁够用的自定义表达式模板解析器,可以放心的使用到业务代码中去。 后续工作 作为一款组件,上面的自定义表达式模板解析器,还有一定的改良空间: 模板求值采用replace会涉及内存分配,可以在解析表达式的同时,把模板片段也解析出来,在求值后整体进行一次拼字符串操作; 解析器的创建可以引入Builder生成器,从而语法关键字可以实现运行时的动态指定; 对转义字符的支持——上面的实现实际已经支持了表达式之外的转义,即用户内容中有${关键字,但是没有处理表达式内的转义,即表达式包含},但是基于这个表达式的初衷,大家自行决断吧!!
优秀的个人博客,低调大师

每日一博 | TDD 两小时实现自定义表达式模板解析器

为什么要重新造一个车轮? 很多情况下,用户需要按其自定义模板动态生成邮件、PDF。开源组件中,有两类较贴合需求的产品系列: 模板渲染引擎,如FreeMarker, Velocity虽然强大异常,但是过于灵活,不利于按需裁减出自己想要的少量语法; 纯字符串模板引擎,要么取数据不够动态(需要提前预知有哪些变量),或者是语法冗长(函数调用来实现动态扩展)不利于非IT人事编写。 那么有没有一款产品,既简洁可控,又易于扩展呢? 其实自己实现一个够用的模板解析器,也是很简单的事情,下面分享一款我两小时在融创地产HR项目中实现的模板解析器。 本实现没有任何外部依赖,很容易移植到其它语言,比如用javascript实现甚至更简单。 用户场景 用户的原始需求: 亲爱的XXX先生/女士 你好!欢迎加入XXX公司,你的部门是XXX,岗位职级XXX … 人事部 HR XXX先生/女士 模板设计: 亲爱的${uid|userInfo|prop:name}${uid|userInfo|prop:gender|genderName} 你好!欢迎加入 一天一个小目标 公司,你的部门是${uid|department|prop:name},岗位职级${uid|position|prop:name} … 人事部 HR ${my|prop:name}${my|prop:gender|genderName} 语法(静态语法) "${}":需要值替换的表达式,包含在"${"与"}"之间; "|": 顺序串联单个表达式的多个函数调用,前一调用的值会作为后一调用的第一参数; ":": 若调用有额外参数,则追加在":"之后; ",": 若额外参数不止一个,参以","分隔。 函数说明(可扩展及控制部分) uid: 获取当前调用的目标用户id userInfo: 根据用户id获取用户信息 prop:name: 获取对象的"name"属性 prop:gender: 获取对象的"gender"属性 genderName: 获取性别的中文名 department: 根据用户id获取所在部门信息 position: 根据用户id获取其岗位信息 my: 获取session中当前登录的用户信息 Tips: 此处是为了可读性使用了相对完整的单词。实际为了简洁,我们采用了单个到两个字母表示每个函数(如:"P:name"="prop:name","GN"="genderName"),然后在前端文本编辑器下方给用户一张函数表去定制模板,实践证明在语法、函数不多的情况下,对非IT人士整个模板的简洁比部分内容的可读性更重要 实现过程 代码库 https://gitee.com/chentao106/SimpleExpressionInterpreter 通过提交记录完整展示了实现过程,整体只需要五步,即可实现一个面向非IT人士的自定义表达式模板解析器: 第一步 创建代码框架及测试用例 先创建我们的解析器类,及其最重要的方法eval,即模板求值: //SimpleExpressionInterpreter.java public class SimpleExpressionInterpreter { public String eval(String template) { return null; } } 测试驱动开发,当然要先编写测试用例: //SimpleExpressionInterpreterTester.java import org.junit.Assert; import org.junit.Test; public class SimpleExpressionInterpreterTester { static final String template = "亲爱的${uid|userInfo|prop:name}${uid|userInfo|prop:gender|genderName}\n" + " 你好!欢迎加入不存在公司,你的部门是${uid|department|prop:name},岗位职级${uid|position|prop:name}…\n" + " 人事部 HR ${my|prop:name}${my|prop:gender|genderName}\n"; static final String value = "亲爱的李四女士\n" + " 你好!欢迎加入不存在公司,你的部门是互联网行销部,岗位职级产品经理T1…\n" + " 人事部 HR 张三先生\n"; private SimpleExpressionInterpreter testObj = new SimpleExpressionInterpreter(); @Test public void testEval() { Assert.assertEquals(value, testObj.eval(template)); } } 此时,测试用例当然是执行不通过的,我们想办法让测试先通过,才好进行下一步,同时定义一下我们的语法关键字: //SimpleExpressionInterpreter.java public class SimpleExpressionInterpreter { protected String expressionStart = "${"; protected String expressionEnd = "}"; protected String invocationSplit = "|"; protected String methodNameSplit = ":"; protected String parameterSplit = ","; protected char escape = '\\'; public String eval(String template) { return "亲爱的李四女士\n" + " 你好!欢迎加入不存在公司,你的部门是互联网行销部,岗位职级产品经理T1…\n" + " 人事部 HR 张三先生\n"; } } 运行测试用例,保证通过 第二步 提取字符器模板中的表达式 修改SimpleExpressionInterpreter.java文件,在其中增加 //SimpleExpressionInterpreter.java List<String> findExpressions(String template) { return null; } 增加测试用例 //SimpleExpressionInterpreterTester.java @Test public void testFindExpressions() { Assert.assertEquals(Collections.EMPTY_LIST, testObj.findExpressions("{a}")); Assert.assertEquals(Collections.singletonList("${a}"), testObj.findExpressions("${a}")); Assert.assertEquals(Collections.singletonList("${a}"), testObj.findExpressions("\\$${a}")); Assert.assertEquals(Arrays.asList("${a}", "${b}"), testObj.findExpressions("${a}${b}")); Assert.assertEquals(Arrays.asList("${a}", "${b}"), testObj.findExpressions("Hello ${a}, world${b}")); Assert.assertEquals(Collections.singletonList("${a\\}${b}"), testObj.findExpressions("${a\\}${b}")); Assert.assertEquals(Collections.EMPTY_LIST, testObj.findExpressions("${a\\}${b")); Assert.assertEquals(Arrays.asList("${uid|userInfo|prop:name}", "${uid|userInfo|prop:gender|genderName}", "${uid|department|prop:name}", "${uid|position|prop:name}", "${my|prop:name}", "${my|prop:gender|genderName}"), testObj.findExpressions(template)); } 为确保测试通过,修改SimpleExpressionInterpreter.java: //SimpleExpressionInterpreter.java int nextDivider(String template, String divider, int fromIndex) { int pos; int from = fromIndex; do { pos = template.indexOf(divider, from); if (pos == 0) return pos; if (pos > 0 && template.charAt(pos - 1) != escape) return pos; from = pos + 1; } while (pos >= 0); return -1; } List<String> findExpressions(String template) { List<String> expressions = new LinkedList<>(); int fromIndex = 0; String expression; do { int beginIndex = nextDivider(template, expressionStart, fromIndex); if (beginIndex < 0) break; int endIndex = nextDivider(template, expressionEnd, beginIndex + expressionStart.length()); if (endIndex < 0) break; expression = template.substring(beginIndex, endIndex + expressionEnd.length()); expressions.add(expression); fromIndex = endIndex + expressionEnd.length(); } while (true); return expressions; } 为了重用表达式前缀和后缀的查找代码,我们提取了公共函数nextDivider,我们也可以给它增加测试用例: //SimpleExpressionInterpreterTester.java @Test public void testNextDivider() { Assert.assertEquals(-1, testObj.nextDivider("{a}", testObj.expressionStart, 0)); Assert.assertEquals(0, testObj.nextDivider("${a}", testObj.expressionStart, 0)); Assert.assertEquals(2, testObj.nextDivider("\\$${a}", testObj.expressionStart, 0)); Assert.assertEquals(4, testObj.nextDivider("${a}${b}", testObj.expressionStart, 1)); Assert.assertEquals(3, testObj.nextDivider("${a}${b}", testObj.expressionEnd, 1)); Assert.assertEquals(8, testObj.nextDivider("${a\\}${b}", testObj.expressionEnd, 1)); Assert.assertEquals(-1, testObj.nextDivider("${a\\}${b", testObj.expressionEnd, 1)); } 运行测试用例,保证通过 第三步 解析表达式调用链 调用必须先用一个实体来表示: //Invocation.java import java.util.Arrays; public class Invocation { private String method; private String[] extraParams; public Invocation(String method, String... extraParams) { this.method = method; this.extraParams = extraParams; } public Invocation(String method) { this(method, null); } public String getMethod() { return method; } public String[] getExtraParams() { return extraParams; } @Override public int hashCode() { return method.hashCode() + (extraParams == null ? 0 : Arrays.hashCode(extraParams)); } @Override public boolean equals(Object obj) { if (obj == null) return false; if (!this.getClass().isInstance(obj)) return false; if (this.hashCode() != obj.hashCode()) return false; Invocation another = (Invocation) obj; return this.method.equals(another.method) && Arrays.equals(this.extraParams, another.extraParams); } @Override public String toString() { return extraParams == null || extraParams.length == 0 ? method : String.format("%s:%s", method, String.join(",", extraParams)); } } 增加解析调用链的函数声明: //SimpleExpressionInterpreter.java List<Invocation> parseInvocations(String expression) { return null; } 增加测试用例: //SimpleExpressionInterpreterTester.java @Test public void testParseInvocations() { Assert.assertEquals(Collections.EMPTY_LIST, testObj.parseInvocations("")); Assert.assertEquals(Collections.singletonList(new Invocation("a")), testObj.parseInvocations("${a}")); Assert.assertEquals(Arrays.asList(new Invocation("a"), new Invocation("b"), new Invocation("c")), testObj.parseInvocations("${a|b|c}")); Assert.assertEquals(Arrays.asList(new Invocation("uid"), new Invocation("userInfo"), new Invocation("prop", "name")), testObj.parseInvocations("${uid|userInfo|prop:name}")); } 为了通过测试,修改SimpleExpressionInterpreter.java: //SimpleExpressionInterpreter.java List<Invocation> parseInvocations(String expression) { if (expression == null || expression.length() < expressionStart.length() + expressionEnd.length()) return Collections.emptyList(); String statement = expression.substring(expressionStart.length(), expression.length() - expressionEnd.length()); String[] phrases = split(statement, invocationSplit); List<Invocation> invocations = new ArrayList<>(phrases.length); for (String phrase : phrases) { invocations.add(parseInvocation(phrase)); } return invocations; } private Invocation parseInvocation(String phrase) { int methodNameEndIndex = phrase.indexOf(methodNameSplit); if (methodNameEndIndex > 0) { String method = phrase.substring(0, methodNameEndIndex); String parameterStr = phrase.substring(methodNameEndIndex + methodNameSplit.length()); String[] parameters = parameterStr.split(parameterSplit); return new Invocation(method, parameters); } else { return new Invocation(phrase); } } String[] split(String text, String delimiter) { if (text == null) return null; if (delimiter == null || delimiter.length() == 0) return new String[]{text}; List<String> data = new ArrayList<>(); int pos = 0; for (int from = 0; from >= 0; from = pos + delimiter.length()) { pos = text.indexOf(delimiter, from); if (pos >= 0) { data.add(text.substring(from, pos)); } else { data.add(text.substring(from)); break; } } return data.toArray(new String[0]); } 为了支持使用"|"串连表达式,我们重写了String的split函数(split使用正则表达式拆分,而"|"是正则表达式的关键字,不考虑语法可替换、可跨语言移植的情况下,可以直接转义"\|"+String.split),我们也为它加上测试用例: //SimpleExpressionInterpreterTester.java @Test public void testSplit() { Assert.assertNull(testObj.split(null, "|")); Assert.assertArrayEquals(new String[]{"a|b"}, testObj.split("a|b", null)); Assert.assertArrayEquals(new String[]{"a|b"}, testObj.split("a|b", "")); Assert.assertArrayEquals(new String[]{"a", "b"}, testObj.split("a|b", "|")); Assert.assertArrayEquals(new String[]{"ab", "cd:ef,gh"}, testObj.split("ab|cd:ef,gh", "|")); Assert.assertArrayEquals(new String[]{"ab", "cd", "ef", "gh"}, testObj.split("ab,cd,ef,gh", ",")); } 运行测试用例,保证通过 第四步 实现表达式求值 到了最关键的表达式求值步骤,照旧我们还是先定义函数 //SimpleExpressionInterpreter.java String evalExpression(String expression) { return null; } 编写测试 //SimpleExpressionInterpreterTester.java @Test public void testEvalExpression() { Assert.assertEquals("李四", testObj.evalExpression("${uid|userInfo|prop:name}")); Assert.assertEquals("女士", testObj.evalExpression("${uid|userInfo|prop:gender|genderName}")); Assert.assertEquals("先生", testObj.evalExpression("${my|prop:gender|genderName}")); Assert.assertEquals("", testObj.evalExpression("${my1|prop:gender|genderName}")); } 如何实现表达式求值呢?首先我想到了javascript可以通过函数名来调用对象的方法,如果是java就要用到反射了。也就是说,我们可以把函数调用全部委托给另一个对象,我称作methodProvider,那么开始动手吧: //SimpleExpressionInterpreter.java //增加成员变量,并通过注入一个methodProvider private final Object methodProvider; public SimpleExpressionInterpreter(Object methodProvider) { this.methodProvider = methodProvider; } //实现回调逻辑 private Method findMethod(Class<?> clazz, String methodName) { for (Method m : clazz.getMethods()) { if (m.getName().equals(methodName)) { return m; } } return null; } private Object evalInvocations(List<Invocation> invocations) { boolean firstCall = true; Object result = null; try { for (Invocation invocation : invocations) { Method m = findMethod(methodProvider.getClass(), invocation.getMethod()); if (m == null) return null; Object[] args; if (invocation.getExtraParams() != null) { args = new Object[invocation.getExtraParams().length + (firstCall ? 0 : 1)]; if (!firstCall) args[0] = result; System.arraycopy(invocation.getExtraParams(), 0, args, firstCall ? 0 : 1, invocation.getExtraParams().length); } else { args = firstCall ? new Object[0] : new Object[]{result}; } result = m.invoke(methodProvider, args); firstCall = false; } } catch (IllegalAccessException | InvocationTargetException e) { return null; } return result; } String evalExpression(String expression) { List<Invocation> invocations = parseInvocations(expression); Object result = evalInvocations(invocations); return result == null ? "" : result.toString(); } 为了测试,我们要实现一个DemoMethodProvider,实际应用时,MethodProvider类就决定了你想向用户提供哪些可用函数: //DemoMethodProvider.java import java.util.Collections; import java.util.HashMap; import java.util.Map; public class DemoMethodProvider { private Map<String, Object> callParameters;//模拟实时传入的参数 private Map<String, Map<String, ?>> demoDB;//模拟数据库中的数据 public DemoMethodProvider() { callParameters = new HashMap<>(); Map<String, Object> my = new HashMap<>(); my.put("id", 0); my.put("name", "张三"); my.put("gender", 1); callParameters.put("my", my); callParameters.put("uid", 1); demoDB = new HashMap<>(); Map<String, Object> you = new HashMap<>(); you.put("id", 1); you.put("name", "李四"); you.put("gender", 2); demoDB.put(String.format("user:%d", 1), you); Map<String, Object> yourDepartment = Collections.singletonMap("name", "互联网行销部"); demoDB.put(String.format("user:%d:department", 1), yourDepartment); Map<String, Object> yourPosition = Collections.singletonMap("name", "产品经理T1"); demoDB.put(String.format("user:%d:position", 1), yourPosition); } public Object uid() { return callParameters.get("uid"); } public Object my() { return callParameters.get("my"); } public Map<String, ?> userInfo(int uid) { return demoDB.get(String.format("user:%d", uid)); } public Map<String, ?> department(int uid) { return demoDB.get(String.format("user:%d:department", uid)); } public Map<String, ?> position(int uid) { return demoDB.get(String.format("user:%d:position", uid)); } public Object prop(Map<String, ?> map, String propName) { return map.get(propName); } public String genderName(int gender) { switch (gender) { case 1: return "先生"; case 2: return "女士"; default: return ""; } } } 测试用例中创建SimpleExpressionInterpreter时注入DemoMethodProvider //SimpleExpressionInterpreterTester.java private SimpleExpressionInterpreter testObj = new SimpleExpressionInterpreter(new DemoMethodProvider()); 运行测试用例,保证通过 第五步 组装代码实现模板求值 第一步我们通过写死返回值,已经“实现”了固定模板的解析,当然这个“实现”是静态的,我们首先修改测试用例,暴露代码问题(当然更建议的是增加更多完整 的模板->结果测试用例): //SimpleExpressionInterpreterTester.java @Test public void testEval() { Assert.assertEquals(value, testObj.eval(template)); Assert.assertEquals(value + "...", testObj.eval(template + "...")); Assert.assertEquals("", testObj.eval("")); Assert.assertNull(testObj.eval(null)); } 修改实现以保证测试通过: //SimpleExpressionInterpreter.java public String eval(String template) { if (template == null || template.length() == 0) return template; String result = template; List<String> expressions = findExpressions(template); for (String expression : expressions) { String value = evalExpression(expression); result = result.replace(expression, value); } return result; } 上面的自定义表达式模板解析器虽然还有改进空间,但是在大部分情况下都已经够用了,这不就是测试驱动的高效之处吗? 到此,我们可以非常自信地说,我们快速实现了一个高质量、简洁够用的自定义表达式模板解析器,可以放心的使用到业务代码中去。 后续工作 作为一款组件,上面的自定义表达式模板解析器,还有一定的改良空间: 模板求值采用replace会涉及内存分配,可以在解析表达式的同时,把模板片段也解析出来,在求值后整体进行一次拼字符串操作; 解析器的创建可以引入Builder生成器,从而语法关键字可以实现运行时的动态指定; 对转义字符的支持——上面的实现实际已经支持了表达式之外的转义,即用户内容中有${关键字,但是没有处理表达式内的转义,即表达式包含},但是基于这个表达式的初衷,大家自行决断吧!!
优秀的个人博客,低调大师

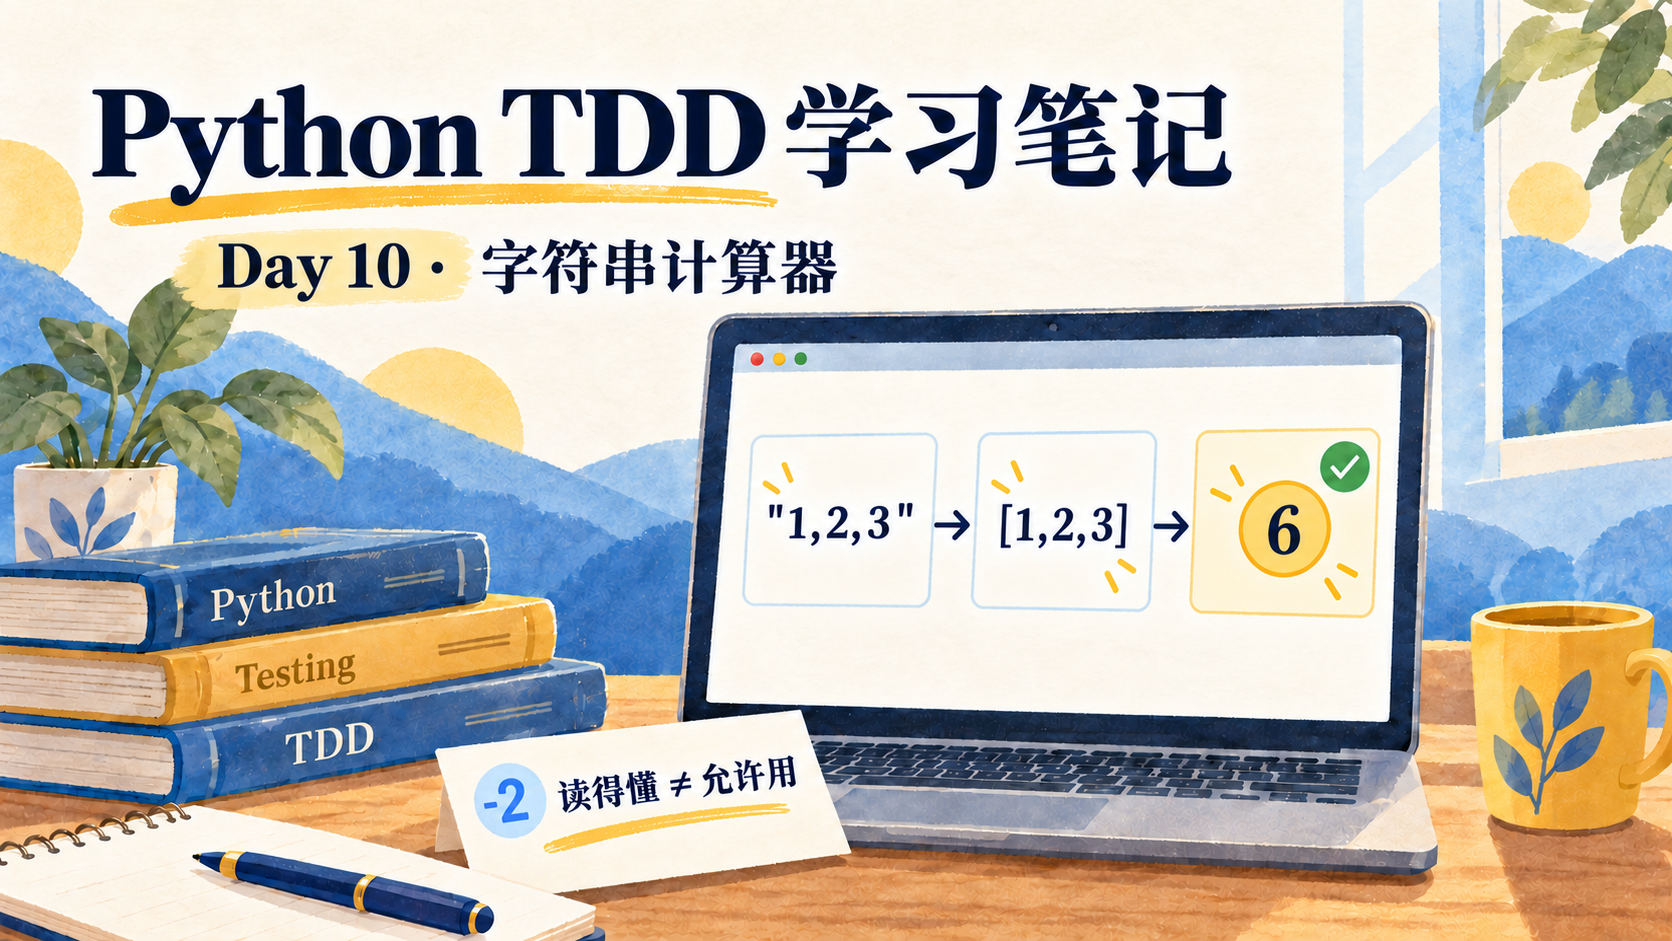
Python TDD 学习笔记 Day 10:字符串计算器,读得懂不等于允许用

今天练习字符串计算器:把 `"1,2,3"` 变成数字并求和。代码不长,主要涉及拆分、转换、验证和计算。 学到最后,我对“能转换成数字”和“业务允许这个数字”的区别还不够清楚,于是用购买数量的例子来区分。这篇也把这一区别放在重点位置。 ## 先约定输入与结果 本节函数叫 `add_numbers(text)`,接收字符串、返回整数,不负责打印。 | 输入 | 预期 | | --- | --- | | `""` | 0 | | `"7"` | 7 | | `"1,2,3"` | 6 | | `"-2"` 或 `"5,-2,3"` | 抛出 `ValueError`,消息为 `negative numbers are not allowed` | 今天只覆盖空输入、逗号分隔的整数和负数规则,不扩展换行、自定义分隔符或小数。 ## 字符串不是数字 文字看起来像数字,不代表它能直接参与数字运算: ```python "1" + "2" # "12",拼接文字 1 + 2 # 3,数字相加 ``` `int("7")` 才会把字符串转换为整数 7。先加入空输入和单个数字测试,确认函数始终返回 0 时,输入 `"7"` 的测试失败,再补上转换: ```python def add_numbers(text): if text == "": return 0 return int(text) ``` 空字符串不能直接传给 `int()`,因此按照本次需求单独返回 0。 ## 多个数字:拆分、转换、求和 加入 `add_numbers("1,2,3") == 6` 的测试后,原实现抛出 `ValueError`。因为 `"1,2,3"` 整体不是一个整数,不能一次转换。 需要依次处理: ```python parts = text.split(",") numbers = [int(part) for part in parts] return sum(numbers) ``` | 步骤 | 结果 | | --- | --- | | 按逗号拆分 | `["1", "2", "3"]` | | 每项转成整数 | `[1, 2, 3]` | | 求和 | 6 | `[int(part) for part in parts]` 是列表推导式,表示逐个取出字符串、转换成整数,再组成新列表。 单个数字也能使用这条路径:`"7"` 拆分成 `["7"]`,转换成 `[7]`,求和仍是 7,不需要保留单独的转换分支。 ## 读得懂,不等于允许用 接着增加负数测试: ```python @pytest.mark.parametrize("text", ["-2", "5,-2,3"]) def test_negative_numbers_are_rejected(text): with pytest.raises(ValueError, match="^negative numbers are not allowed$"): add_numbers(text) ``` 两个测试最初都失败,提示没有抛出约定异常。旧实现可以把负数字符串转换成整数,然后正常求和,但这不符合本次规则。 我当时仍不太清楚,转换成功与业务允许到底有什么不同。购买数量的例子把它们分成了两道检查: | 输入文字 | 能读成整数吗? | 能作为购买数量吗? | | --- | --- | --- | | `"3"` | 能,得到 3 | 能 | | `"-2"` | 能,得到 -2 | 不能购买负两件 | | `"苹果"` | 不能 | 尚未得到数字,无法继续判断 | `int()` 只负责理解文字表示哪个整数,并不知道这个数字将被用在哪里。同一个 -2,用于气温可以合理,用于购买数量就不允许。 因此,解析解决“读不读得懂”,业务验证解决“允不允许”。负数本来就能参与数学计算,今天拒绝它,是本练习明确约定的规则。 ## 检查每个数字,不能只检查总和 最终函数是: ```python def add_numbers(text): if text == "": return 0 parts = text.split(",") numbers = [int(part) for part in parts] if any(number < 0 for number in numbers): raise ValueError("negative numbers are not allowed") return sum(numbers) ``` `any(...)` 表示只要其中一个条件成立,整体就为真。对 `[5, -2, 3]`,检查结果依次为 False、True、False,因此拒绝输入。 不能改成只判断总和是否小于 0:这组数字的总和是 6,但其中存在负数,仍然违反规则。验证应检查需求约束的对象,而不是用最终结果替代输入检查。 ## 用代表性案例保护行为 收尾时,正常输入整理为六组参数: ```python @pytest.mark.parametrize( "text, expected", [ pytest.param("", 0, id="empty"), pytest.param("0", 0, id="zero"), pytest.param("7", 7, id="single-number"), pytest.param("10,20", 30, id="two-multi-digit-numbers"), pytest.param("1,2,3", 6, id="three-numbers"), pytest.param("0,4,0", 4, id="numbers-with-zero"), ], ) def test_valid_input_returns_sum(text, expected): assert add_numbers(text) == expected ``` 这些案例保留了原来的空输入、单数字和多数字测试,又增加零、两位数及含零场景。负数检查的预期是异常,继续单独测试。现有函数顺序清楚,无需额外增加类或复杂结构。 格式错误也可能被 `int()` 拒绝,但本节没有约定统一的格式错误消息,也未验证各种格式错误,不把这个练习当成完整输入校验器。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day10 -v uv run pytest -v ``` 第一条执行本节六个正常案例和两个负数异常案例,第二条执行全部课程。本篇整理时,本节 8 个测试、全项目 65 个测试均通过。 ## 今日收获 今天我对“能转换成数字”和“业务允许这个数字”的区别还不够清楚,因此改用购买数量的例子来说明:`int()` 能读懂 -2,不代表购买数量允许 -2;同样的数字,用途不同,限制也可能不同。这个例子给了我一个更具体的对照,后续还需要在实际练习中继续区分解析、验证和计算。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册