首页 文章 精选 留言 我的

精选列表

搜索[tdd],共406篇文章
优秀的个人博客,低调大师

Python TDD 学习笔记 Day 05:用 fixture 准备测试

前几天测试加法、除法和折扣函数,只要传入数据,就能检查返回值。今天换成购物车:它会记住加入的商品。如果多个测试共用同一辆车,前一个测试留下的商品,会不会影响后一个测试? 这次从这个问题开始,学习 pytest 的 fixture,以及测试中对象应该独立还是共享。 ## 测试之前,先准备好购物车 一个测试通常要完成三件事:准备对象、执行动作、检查结果。比如测试加入一件商品: ```python cart = ShoppingCart() # 准备 cart.add_item(20) # 执行 assert cart.total() == 20 # 检查 ``` 如果多个测试都需要购物车,就会重复创建对象。fixture 可以把这些准备工作集中起来: ```python import pytest from shopping_cart import ShoppingCart @pytest.fixture(scope="function") def cart(): return ShoppingCart() def test_empty_cart_total_is_zero(cart): assert cart.total() == 0 ``` pytest 看到测试函数的参数名 `cart`,会寻找同名 fixture,执行它,并把返回的购物车对象传给测试。测试中的 `cart` 是对象,不需要手动调用 fixture。 这是 pytest 提供的运行机制;普通 Python 函数不会因为参数与另一个函数同名,就自动获得返回值。 ## 从缺少方法的红灯,到保存商品的绿灯 最初的购物车只会返回总价 0。加入新测试后: ```python def test_cart_total_after_adding_one_item(cart): cart.add_item(20) assert cart.total() == 20 ``` 实际失败信息是: ```text AttributeError: 'ShoppingCart' object has no attribute 'add_item' ``` 这时还没执行到断言,程序在加入商品时就停下来了。随后补上实现: ```python class ShoppingCart: def __init__(self): self.prices = [] def add_item(self, price): self.prices.append(price) def total(self): return sum(self.prices) ``` 创建对象时,`__init__` 为这辆购物车准备空列表;`append` 保存商品价格;`sum` 计算总价,空列表求和为 0。空车与单件商品两个测试都通过了。 ## function 为什么能避免互相干扰 我在学习中追问了:`scope="function"` 为什么要加? 它控制 fixture 返回值的复用范围。`function` 表示每个测试函数各自准备一份购物车,也是省略 `scope` 时的默认行为。显式写出来,是为了看清测试的独立性从哪里来。 我们还调整了执行顺序:先加入一件商品,再测试两件商品,最后检查空购物车。三个测试的总价仍分别是 20、50、0。 原因是每个测试都创建了新车,之前的商品没有被带到下一个测试中。这里独立的是测试获得的购物车对象,并不是说测试函数本身变成了某种实例。 ## fixture 也可以依赖 fixture 有些测试需要从“已经有商品”的状态开始,可以在空车 fixture 上继续准备: ```python @pytest.fixture(scope="function") def filled_cart(cart): cart.add_item(20) cart.add_item(30) return cart def test_cart_total_after_adding_another_item(filled_cart): filled_cart.add_item(10) assert filled_cart.total() == 60 ``` 准备好的 50 元是初始状态,再加入 10 元才是这个测试执行的动作。 还有一个需要区分的细节:同一测试内请求同一个 fixture,pytest 会复用它的返回值。因此下面的实验也会通过: ```python def test_fixtures_share_cart_within_one_test(cart, filled_cart): assert cart is filled_cart assert cart.total() == 50 ``` `is` 检查两者是否为同一个对象。`filled_cart` 使用并修改的,就是本次测试里的 `cart`。默认情况下,同一个测试内复用;不同测试之间重新准备。 ## module 什么时候适合共享 接着,我又问到了 `scope="module"`。 这里的 module 指一个 Python 文件。同一文件内,使用该 fixture 的测试共同使用一份返回值。例如商店支持的币种: ```python @pytest.fixture(scope="module") def supported_currencies(): return ("CNY", "USD") def test_shop_supports_cny(supported_currencies): assert "CNY" in supported_currencies def test_shop_supports_usd(supported_currencies): assert "USD" in supported_currencies ``` 这个示例中的元组只包含字符串,测试只读取它,因此适合共享。购物车会被加入商品,如果共享,就可能留下其他测试修改过的状态。 | 范围 | 复用方式 | 本次例子 | | --- | --- | --- | | function | 每个测试函数各自准备 | 可修改的购物车 | | module | 同一测试文件内共同使用 | 只读币种配置 | `scope` 本身不保证数据只读,也不会自动清空共享对象,选择时要考虑数据是否会被修改。 ## 参数化提供数据,fixture 提供初始状态 最后,把前一天的参数化与今天的 fixture 放到一起: ```python @pytest.mark.parametrize("price", [10, 20, 35]) def test_cart_total_after_adding_one_item(cart, price): cart.add_item(price) assert cart.total() == price ``` `price` 来自参数表,`cart` 来自 fixture。三组价格形成三个独立测试项,每项都获得新的空购物车,所以总价分别为 10、20、35,不会持续累加。 ## 实际验证 项目仍由 uv 管理。在项目根目录运行: ```bash uv run pytest lessons/day05 -v --setup-show uv run pytest -v ``` 第一条检查本节练习,并展示 fixture 的准备与结束过程。`SETUP F cart` 中的 F 表示 function;币种配置的 `SETUP M supported_currencies` 中,M 表示 module。 本次验证结果:Day 05 共 9 个测试通过,全项目共 28 个测试通过。 ## 今日收获 我最初感觉 fixture 是把所有参数组织得更有条理,进一步理解后发现,它主要组织的是测试对象和初始数据的准备工作,参数化则负责提供不同输入。使用 function 范围时,每个测试获得独立的购物车,避免商品数据互相干扰;使用 module 范围时,同一文件中的测试共享一份配置。选择范围时,要考虑这些数据是否适合共享,以及测试会不会修改它们。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 09:规则组合与回归测试

昨天实现了普通数字转换与 Fizz,今天继续加入 Buzz 和 FizzBuzz。重点是一个常见问题:分别检查过两条规则,为什么还要检查它们同时成立的情况? ## 两条规则都通过,组合仍可能出错 加入“5 的倍数返回 Buzz”后,代码可以这样写: ```python if number % 3 == 0: return "Fizz" if number % 5 == 0: return "Buzz" ``` 输入 3 返回 Fizz,输入 5 返回 Buzz,看起来都正确。但输入 15 时,它先满足第一个条件,返回 Fizz 后调用立即结束,不会继续检查 5 的倍数。 完整需求却规定,3 与 5 的公倍数应该返回 FizzBuzz。问题出在规则交集:输入 15 同时满足两条条件,程序必须知道该采用什么结果。 ## 用测试把交集写清楚 今天先保留昨天六个案例,再加入 5、10、20。新案例在旧实现下失败,增加 Buzz 分支后,九个测试通过。 然后补上组合规则: ```python @pytest.mark.parametrize("number", [15, 30, 45]) def test_common_multiple_returns_fizzbuzz(number): assert fizzbuzz(number) == "FizzBuzz" ``` 这三个案例实际返回 Fizz,测试失败。它们揭示了前九个案例没有覆盖的问题:单独条件都符合预期,不代表交集也正确。 最终实现把组合情况放在前面: ```python def fizzbuzz(number): if number % 3 == 0 and number % 5 == 0: return "FizzBuzz" if number % 3 == 0: return "Fizz" if number % 5 == 0: return "Buzz" return str(number) ``` `and` 表示两边条件同时满足。先处理组合,再处理单独情况,最后才是普通转换。这符合本题约定,并不是所有程序都必须把条件最多的判断放在最前面。 ## 运费例子让我更容易理解 为了联系实际,课堂又用运费说明同一个问题。假设约定:普通订单满 100 元包邮,偏远地区无论金额多少都收 20 元。 如果先判断金额: ```python if total >= 100: return 0 if is_remote: return 20 ``` 偏远地区的 150 元订单就会错误地免运费。因为金额条件先命中,后面的地区条件没有机会执行。 按照这次约定,应先检查偏远地区: ```python def shipping_fee(total, is_remote): if is_remote: return 20 if total >= 100: return 0 return 10 ``` 最关键的案例就是: ```python assert shipping_fee(150, True) == 20 ``` 这是课堂说明规则优先级的简化片段,没有扩展修改 Day 07 的运费练习,也省略了原例中的输入校验。通过这个例子,我对“为什么要测试规则交集”理解得更清楚了。 ## 项目中先确认优先级,再排列代码 优惠叠加、权限组合、运费例外,都可能出现相同的问题。先单独测试每条规则,再选择有意义的交集场景。 例如,满额包邮遇到偏远地区,究竟谁优先,是业务约定,不能让代码碰巧写出的顺序替我们决定。 | 类别 | 本节测试输入 | 预期 | | --- | --- | --- | | 普通数字 | 1、2、4 | 数字字符串 | | 仅为 3 的倍数 | 3、6、9 | Fizz | | 仅为 5 的倍数 | 5、10、20 | Buzz | | 同时为两者倍数 | 15、30、45 | FizzBuzz | 调整组合判断后,原有案例仍然保留并重新运行,确认普通转换、Fizz、Buzz 没有被破坏。这就是本节的回归检查。 ## 本次验证 Day 09 的扩展代码保存在 `lessons/day09/`,Day 08 保留当时的学习版本。在项目根目录运行: ```bash uv run pytest lessons/day09 -v uv run pytest -v ``` 本篇整理时,Day 09 的 12 个测试和全项目 57 个测试均已通过。FizzBuzz 练习到这里结束,下一节按精简计划学习字符串计算器。 ## 今日收获 运费例子让我更清楚地理解了为什么要测试规则交集。满额包邮与偏远地区收费,单独检查都可能正确,但同时满足时,还需要明确哪条规则优先。由于 `return` 会结束函数,判断顺序也必须符合这个约定。以后遇到多条规则,我会留意它们同时成立的场景。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 06:让代码更容易测试

前几天主要学习怎样写测试。今天换个角度:代码怎样组织,才能让测试更简单、结果更稳定? 我们用“判断订单是否过期”练习,把获取时间、业务判断和打印结果分开。不过,学到最后,我的实际感受是:把打印的内容捕获下来,方便了文字对比,但对这么小的例子,拆开函数的好处并不明显。这也是今天需要说清楚的一点。 ## 先明确过期规则 本次约定:当前时间达到或超过截止时间,订单就算过期。 | 截止时间 | 当前时间 | 预期 | | --- | --- | --- | | 10:00 | 09:59 | 未过期 | | 10:00 | 10:00 | 已过期 | | 10:00 | 10:01 | 已过期 | 如果函数内部直接读系统时间,测试结果就会随运行时间改变。我们也不希望为了测试过期逻辑,真的等待一分钟,或修改电脑时间。 简单的办法是把“当前时间”作为输入: ```python def is_order_expired(expires_at, now): return now >= expires_at ``` 函数只根据传入的时间判断。`>=` 的结果本身就是布尔值,可以直接返回。 ## 用固定时间测试,不必等待 第一个测试检查超过截止时间的情况: ```python from datetime import datetime from order_expiry import is_order_expired def test_order_is_expired_after_deadline(): expires_at = datetime(2026, 10, 17, 10, 0) now = datetime(2026, 10, 17, 10, 1) assert is_order_expired(expires_at, now) is True ``` `datetime(年, 月, 日, 时, 分)` 创建一个具体时间。本节所有时间按同一时区理解,先不展开时区处理。 函数最初暂时返回 `False`,测试如预期失败;改成时间比较后通过。随后补上 09:59 和恰好 10:00 两个案例。 恰好到期的测试能防止以后有人把 `>=` 误改成 `>`;未到期的测试则防止“一直返回 True”这种实现蒙混过关。相同输入始终得到相同结果,测试不再依赖运行时的真实时间。 ## 实际程序从哪里取得时间 测试使用固定时间,实际运行依然使用真实时间,只是把获取动作放到调用处: ```python expires_at = datetime(2026, 10, 17, 10, 0) now = datetime.now() expired = is_order_expired(expires_at, now) ``` 业务规则保持一份,输入来源可以不同。这是今天最实用的经验:把会随环境变化的数据从外部传入,让判断函数只处理规则。 ## 返回结果与打印文字怎么分别测试 判断得到的是 `True` 或 `False`,向用户展示的则是“订单状态:已过期”等文字。练习中把显示写成一个函数: ```python def print_order_status(expired): status = "已过期" if expired else "未过期" print(f"订单状态:{status}") ``` `"已过期" if expired else "未过期"` 表示根据布尔值选择文字。实际程序先判断,再显示: ```python expired = is_order_expired(expires_at, now) print_order_status(expired) ``` 判断结果可以直接断言,但打印文字需要先捕获,才能自动对比。 ## capsys 接住打印内容 `capsys` 是 pytest 自带的 fixture,在测试参数中写上名字就能使用,不需要自己定义: ```python def test_print_expired_order_status(capsys): print_order_status(True) captured = capsys.readouterr() assert captured.out == "订单状态:已过期\n" ``` 执行显示函数后,`readouterr()` 读取捕获的内容;`captured.out` 是标准输出中的文字。末尾的 `\n` 来自 `print()` 默认添加的换行。 显示函数最初只有 `pass`,没有输出,测试因此失败。加入打印实现后通过,再补充传入 `False` 时应显示“未过期”的测试。 这解决了我提出的问题:“capsys 有什么作用,在什么地方用?”它常用于检查命令行程序的成功提示、状态文字或使用说明。若需求只关心计算结果,直接检查返回值即可,不必检查打印文字。 注意,`print()` 自身返回 `None`。不能用 `assert print("你好") == "你好"` 来检查它打印了什么。 ## 小程序一定要拆成多个函数吗 我在总结时说,感觉主要是方便文本对比,整体上没觉得有什么好处。 对当前例子,这个感受有道理:判断只有一行,打印也很简单,拆分反而增加了函数和文件。今天这样安排主要是为了分别演示返回值测试和输出测试,不能据此认为每句打印都必须抽成函数。 当同一条过期规则需要同时用于终端提示、网页显示和支付判断时,单独返回布尔值的函数更容易复用。修改显示文字时,也不必触动时间判断。简单脚本把打印保留在 `main()` 中同样合理。 实际项目中,先把业务规则与外部数据获取分清楚,再根据复用和维护需要决定拆分程度。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day06 -v uv run python lessons/day06/demo.py ``` 第一条执行三个时间判断测试和两个输出测试;第二条读取本机真实时间并展示订单状态。演示脚本使用固定截止日期,状态随运行时间变化是正常的。 本篇整理时,Day 06 的 5 个测试和全项目 33 个测试均已通过。 ## 今日收获 今天我理解了,`capsys` 可以捕获程序打印的内容,方便与预期文字对比。对当前的小例子,拆分判断与打印的收益并不明显;当判断结果需要用于终端、网页或其他业务操作时,分开才更方便复用。把当前时间作为参数传入,也让测试可以直接检查固定场景。实际写代码时,应根据需要拆分,避免为了测试而把简单程序变复杂。


优秀的个人博客,低调大师

Python TDD 学习笔记 Day 15:把测试用进日常项目

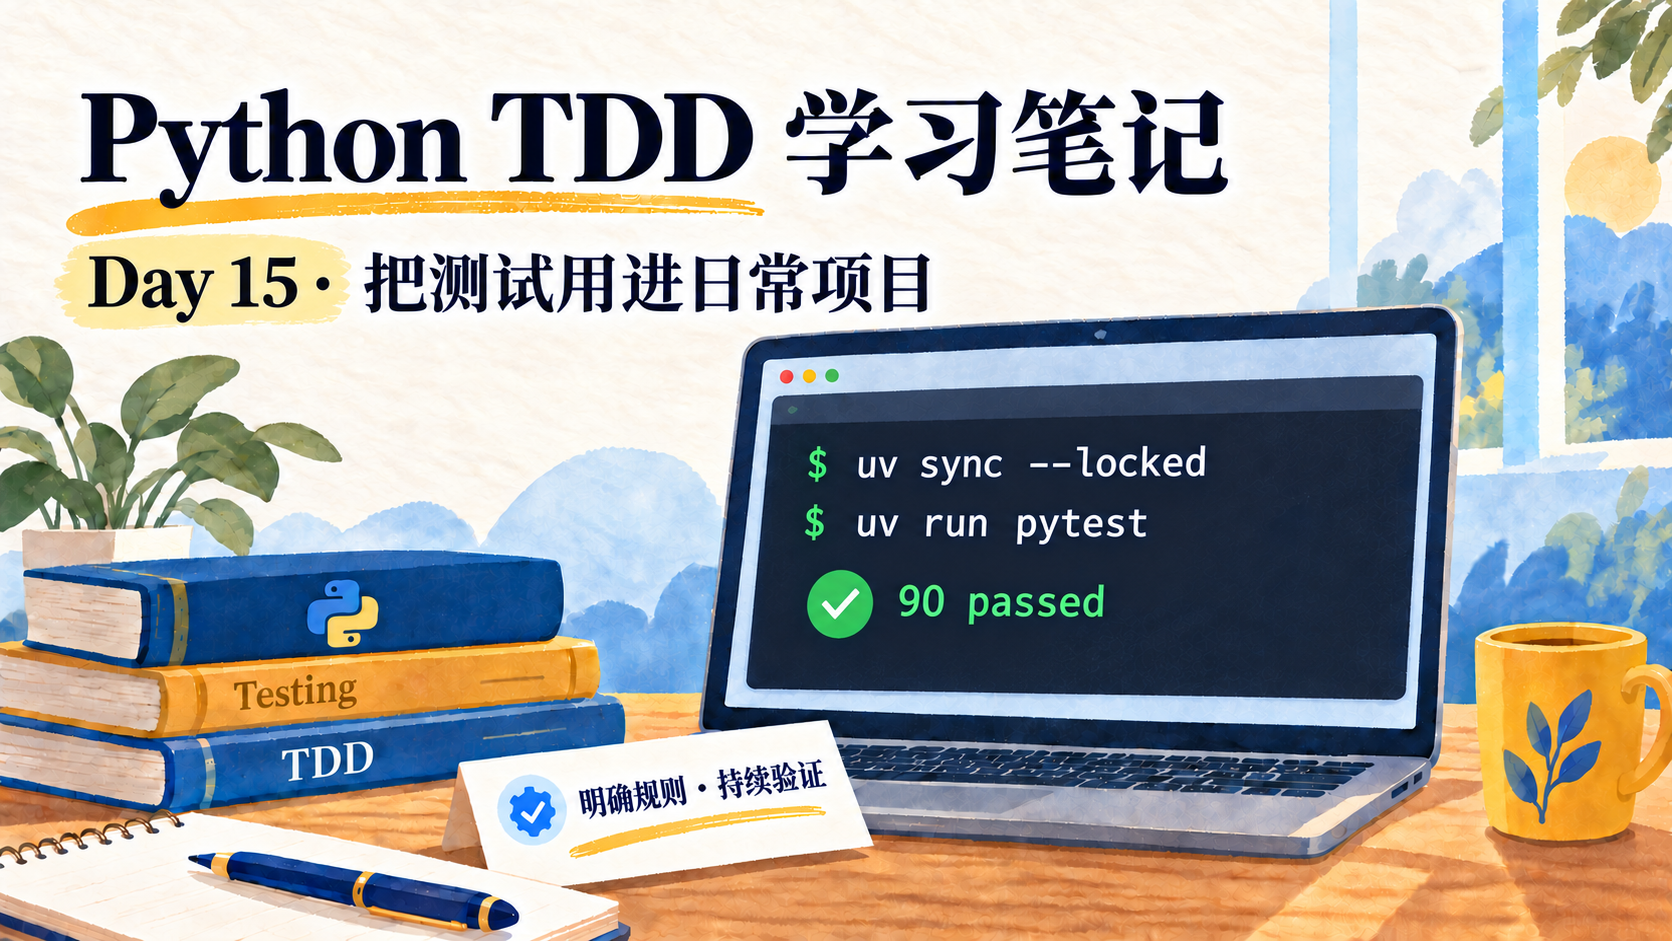
今天是这个系列的收尾。没有新建大项目,而是在已有运费接口上增加一个字段,练习明确需求、检查 AI 生成的案例,以及运行完整回归。 最后让我觉得最有实际帮助的,是三个常用命令:同步环境、运行当前测试、运行全部测试。这套操作比抽象概念更容易直接带到今后的项目里。 ## 一次小改动,先说清预期 接口原来返回运费,现在增加 free_shipping,告诉页面是否免运费: ```json {"fee": 0, "free_shipping": true} ``` 业务继续沿用原约定:非负整数金额未满 100 元收费 10 元,达到 100 元必须免运费,没有地区例外。新字段表示运费是否为零。 写代码前,先列出案例: | Given:已知条件 | When:动作 | Then:预期 | | --- | --- | --- | | 订单 99 元 | 查询运费 | fee 为 10,free_shipping 为 false | | 订单 100 元 | 查询运费 | fee 为 0,free_shipping 为 true | | 订单 101 元 | 查询运费 | fee 为 0,free_shipping 为 true | Given–When–Then 只是把前提、动作、结果说清楚,不需要安装另一个测试框架。 测试先确认旧响应缺少字段时失败,再增加实现: ```python fee = calculator(total) return {"fee": fee, "free_shipping": fee == 0} ``` 这里复用已有运费计算,保留 Day 14 的学习版本,在 Day 15 的独立应用中展示新响应。随后检查缺少金额、非数字和负数仍然返回 422,最终保留六项测试。 ## AI 在哪里,人又做什么 课堂一开始拿特殊报价说明测试审查。我连续追问了三个问题:AI 在这里起了什么作用?人需要做什么?150 元订单收取 20 元,符合正常规则吗? 第三个问题暴露了案例中的矛盾:原规则明确满额包邮,没有允许特殊收费的业务前提,助手却为了展示依赖替换,引入了“150 元收费 20 元”的替身结果。 因此撤掉了两条冲突报价测试,更新了讲义,继续使用原规则。依赖替换的用法已在 Day 14 演示,不需要为了制造差异再引入业务例外。 这个过程比假设 AI 可能犯错更具体:人实际检查了案例,指出它不符合既有需求。不能因为代码和测试都能通过,就跳过这一步。 ## 怎样审查 AI 生成的测试 更合适的候选错误是:AI 把“100 元订单收费 10 元”写成预期。 这时应先指出,“满 100”包括恰好 100,预期必须是免运费。如果实现也误写为 `> 100`,错误测试可能与错误代码互相吻合,仍然全绿。 人的主要工作是确认业务规则、审查预期,并判断验证是否足够。AI 可以辅助列出候选场景、提出遗漏、编写代码和执行测试,但不能把它生成的答案自动当作需求。 一个实用的提问方式是: > 先列出输入、预期结果与理由,指出不明确的规则,暂时不要实现。 先看案例表,比一开始就审查一大段实现更容易发现矛盾。确认后,再让 AI 编写测试、观察失败、实现并运行回归。 这次没有另外运行一套独立 AI 评测实验。记录的是当前助手参与编写代码,以及学习者审查并纠正案例的真实过程,不据此声称已经验证 AI 的可靠性。 ## 三个命令,形成日常验证习惯 ### 1. 按锁文件同步环境 ```bash uv sync --locked ``` 根据 uv.lock 同步项目环境。如果项目声明与锁文件不一致,会失败,而不是自动更新锁文件。项目 Python 版本由 .python-version 固定。 它能减少依赖版本随意变化的问题,但不是每次都删除虚拟环境重新安装,也不等于已经验证新电脑上的全部安装过程。恢复环境时仍可能需要下载 Python 或依赖。 ### 2. 先检查当前改动 ```bash uv run pytest lessons/day15 -v ``` 使用项目环境,只运行当前相关测试,快速确认本次改动。实际项目应把目录替换成对应的测试文件或目录。 ### 3. 再检查全部回归 ```bash uv run pytest -v ``` 运行项目全部测试,检查其他已验证行为是否被破坏。测试全绿依然不能替代需求确认,也不能证明替身背后的真实服务已经接通。 这次已执行锁定同步和完整回归:Day 15 六项测试、全项目 90 项测试通过。 ## 回看十五个单元 课程从断言与异常开始,逐步接触边界、参数化、fixture、可测试的代码,再到回归修复、文件、依赖替身、接口与异步并发。 内容不同,常用过程是一致的:明确规则,选择关键案例,用测试检查,修改实现,再运行回归。修复错误与整理结构尽量分开,不为了流程而强行增加抽象。 十五个单元完成的是引导练习,并不等于已经独立掌握所有内容。后续遇到实际任务,再用这些例子对照,按需要补充更深入的知识。 ## 今日收获 今天对我最有帮助的是三个常用命令:uv sync --locked 按锁文件同步环境,运行当前单元的测试检查本次改动,再运行全部测试确认旧功能没有被破坏。相比抽象概念,这套操作更容易直接用到今后的项目中。其中,测试目录需要根据实际项目调整。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 14:API 依赖替换与异步测试

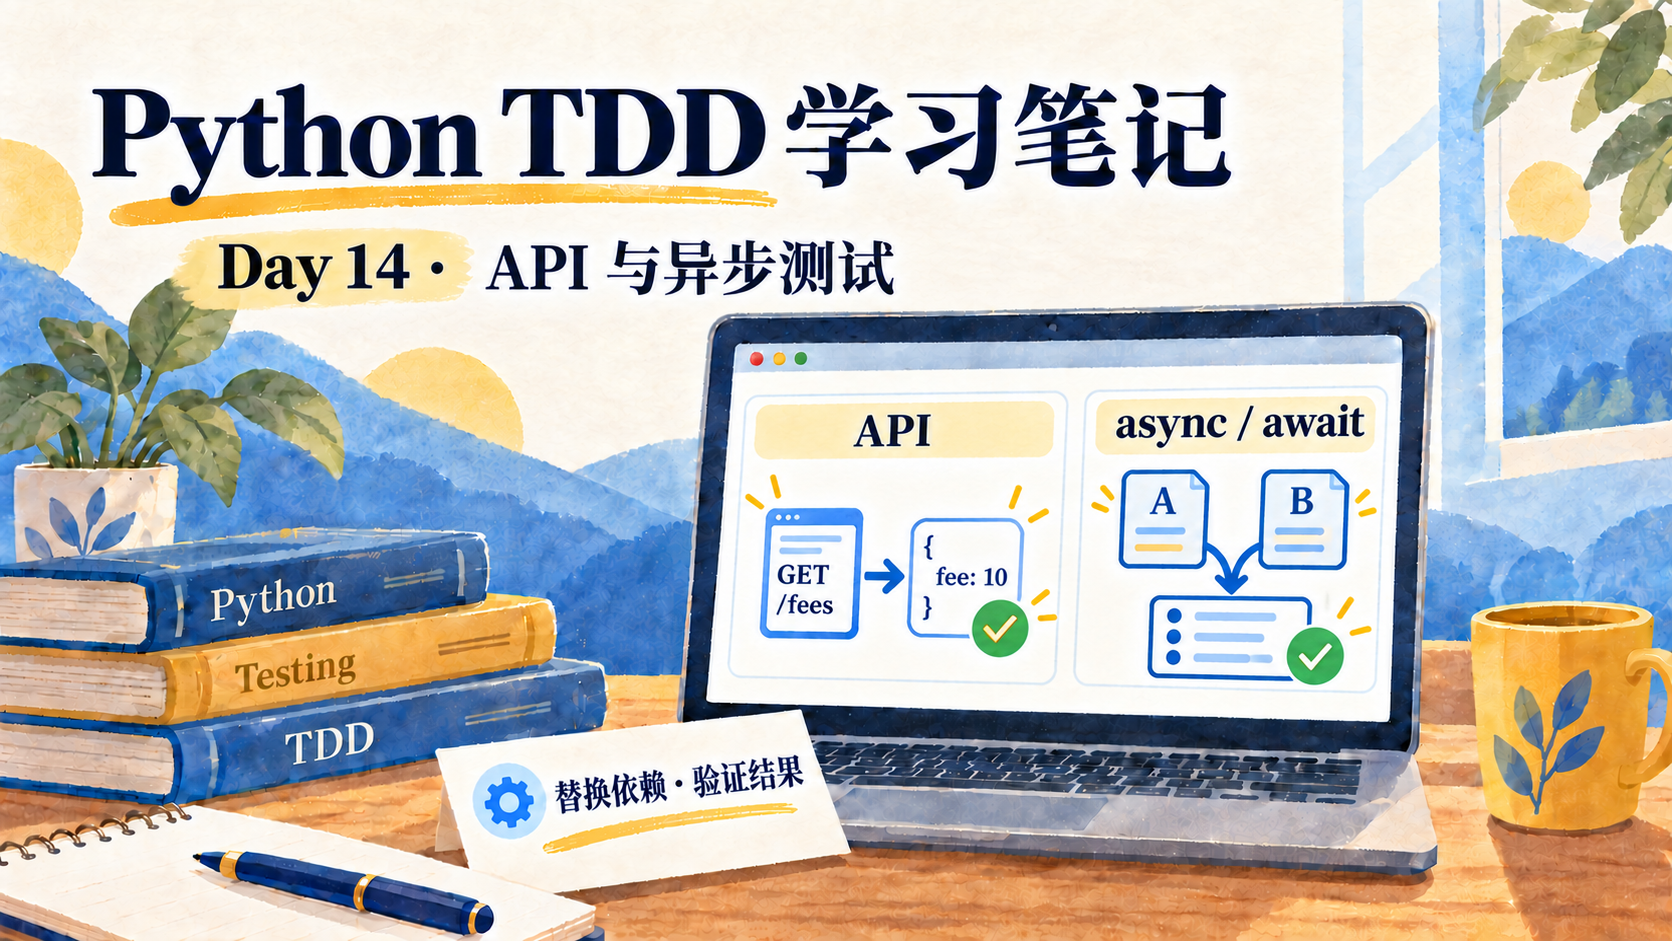
今天把熟悉的运费函数接到 HTTP 接口,学习怎样测试请求与响应,再补充异步和并发入门。 我总结了两点:接口测试时可以替换外部依赖,以及异步代码的测试方法。第一点还需要把术语说准确:本次用手写 Stub 提供固定结果,没有使用 Mock 对象。 ## 从函数调用到接口请求 以前直接调用运费函数,现在把它提供给其他程序: ```text GET /shipping?total=50 ↓ 解析金额,调用运费函数 ↓ 状态码 200,响应内容 {"fee": 10} ``` 函数测试检查运费规则,接口测试还检查地址、参数解析、状态码与响应格式是否连接正确。 使用 FastAPI 的 TestClient,可以在进程内模拟请求,不必启动网络服务器: ```python def test_shipping_endpoint_returns_fee(): with TestClient(app) as client: response = client.get("/shipping", params={"total": 50}) assert response.status_code == 200 assert response.json() == {"fee": 10} ``` 最初没有注册接口,测试得到 404;连接运费函数后通过。相关依赖仍通过 uv 管理,本环境的新版 Starlette 使用 httpx2 作为测试客户端依赖。 ## 错误输入也需要约定响应 接着增加三个参数化案例:未提供金额、金额为 hello、金额为负数。它们都应返回 422,表示输入不符合接口要求。 ```python total: Annotated[int, Query(ge=0)] ``` 这表示金额必须提供、可以解析成整数,且大于或等于 0。与 Day 10 相同:hello 无法解析,-1 可以解析,但不符合业务约束。 原来负数进入业务函数后抛出未处理异常;加入入口约束后,接口返回约定的错误响应。测试同时检查错误指向查询参数 total,不锁定框架生成的全部措辞。 `params` 只是测试中的变量名,不是 pytest 特殊关键字。参数表可以分别传入 `{}`、`{"total": "hello"}`、`{"total": -1}`,复用同一套检查。 ## 依赖替换:让接口拿到不同的计算工具 为了控制测试条件,接口不再固定调用计算函数,而是由依赖提供函数返回它: ```python def get_shipping_calculator(): return calculate_shipping @app.get("/shipping") def get_shipping( total: Annotated[int, Query(ge=0)], calculator=Depends(get_shipping_calculator), ): return {"fee": calculator(total)} ``` `return calculate_shipping` 返回函数本身,不是立即计算。FastAPI 先调用提供函数,再把得到的计算工具放入 calculator,供接口执行。 测试准备一个固定返回 20 的替身: ```python def fixed_fee(total): return 20 def override_calculator(): return fixed_fee app.dependency_overrides[get_shipping_calculator] = override_calculator ``` 同样请求 total=50,正常依赖返回 10,替换后返回 20。接口没改,请求没改,改变的是拿到的计算工具。测试在 finally 中撤销替换,避免影响其他测试。 这次是手写 Stub 控制结果,没有使用 `unittest.mock.Mock`。它演示外部服务的隔离方法,但实际上没有接入物流平台。简单本地计算通常不必增加这一层;数据库、物流报价或登录服务等依赖更能体现价值。 ## 调用异步函数,不会直接得到结果 随后学习了模拟查询两家物流报价: ```python async def fetch_quote(provider): await asyncio.sleep(0) fees = {"A": 10, "B": 12} return {"provider": provider, "fee": fees[provider]} async def compare_quotes(): return await asyncio.gather(fetch_quote("A"), fetch_quote("B")) ``` `async def` 定义异步函数;await 等待结果,操作未完成时可以让出执行机会。此处 sleep(0) 只是主动让出执行机会,没有真实网络请求,也不代表真实耗时。 我追问了两个调用方式的区别: ```python quotes = compare_quotes() quotes = asyncio.run(compare_quotes()) ``` 第一种得到待执行的协程对象,不是报价列表。第二种启动异步运行环境,执行并等待协程,拿到最终结果。在已经运行的异步函数内,应使用 `await compare_quotes()`,而不是再次调用 asyncio.run。 ## 并发执行与结果测试 依次写两个 await,仍然是等待 A 完成后才开始 B。gather 则安排任务并发执行,让等待过程有机会重叠,并按传入顺序返回结果。 普通同步 pytest 测试中可以这样检查: ```python def test_compare_quotes_returns_both_provider_results(): quotes = asyncio.run(compare_quotes()) assert quotes == [ {"provider": "A", "fee": 10}, {"provider": "B", "fee": 12}, ] ``` 本节不需要额外异步测试插件。这条测试验证报价结果,不直接证明调度过程或性能;异步也不意味着多个 CPU 同时计算,或必然更快。 ## 共享数据可能丢失更新 另一个实验让两个任务各加一次计数。故意在读取和写回之间 await,两个任务就可能都读到 0,再分别写回 1,最终只得到 1。 测试确实观察到 `1 != 2`。随后让两个任务共用一把锁,保护整个更新过程: ```python async with lock: previous = count await asyncio.sleep(0) count = previous + 1 ``` A 完成后,B 才进入这段操作,于是读到 1,最终结果为 2。async with 在退出时释放锁;nonlocal 用于修改外层函数中的计数变量。 这个错误来自读写之间存在让出执行机会的操作,并不是所有异步加法都会冲突。asyncio.Lock 也只用于同一事件循环内的任务,不直接解决数据库或跨进程并发。能让任务各自返回结果时,优先避免共享可变数据。 ## 本次验证 ```bash uv run pytest lessons/day14 -v uv run pytest -v ``` 本节五个接口案例、一个异步报价案例、一个共享计数案例,共七项测试通过。全项目 84 个测试通过。 替身测试不能证明真实服务已接通,结果测试不能证明并发更快。先明确测试要验证什么,才能正确理解通过的含义。 ## 今日收获 今天我学到了接口依赖替换和异步代码测试。测试 API 时,可以临时用替身提供固定结果,不必调用真实外部服务;本次使用的是手写 Stub。测试异步代码时,可以用 asyncio.run 执行协程,再检查结果。多个任务并发执行时,还要留意共享数据是否互相干扰。

优秀的个人博客,低调大师

Python TDD 学习笔记 Day 12:文件测试,以及 fixture 与 with 的分工

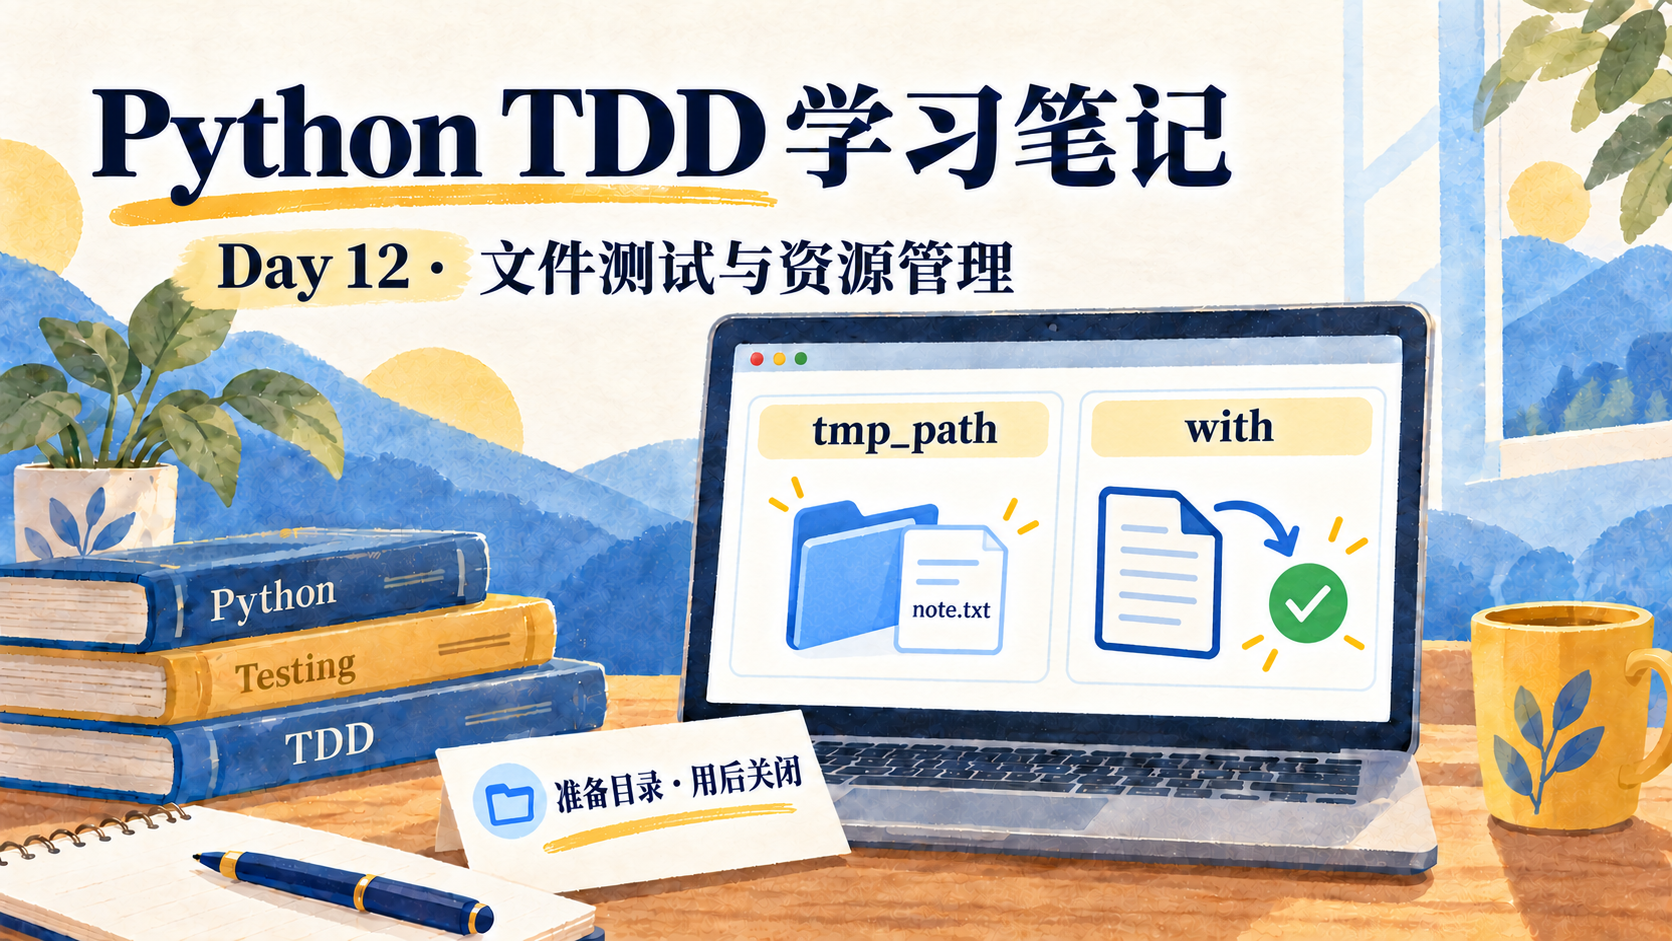
今天学习文件读写测试。最开始,我先问了一个问题:这样做是为了解决什么场景?后来又发现 fixture 与 `with` 都能参与资源准备和清理,感觉有些相似。 这次用“保存一条学习笔记”练习,重点就是把用途和分工讲清楚。 ## 为什么需要测试文件 假设我们开发一个笔记工具,用户点击保存后,需要确认文件真的生成了,内容没有遗漏,中文也能正常读出来。 如果测试直接写真实的笔记文件,反复运行可能覆盖自己的内容,已有文件也可能影响测试结果。因此,测试仍然读写真实文件,但把位置换成测试专用临时目录。 这同样适用于保存配置、生成文本、导出报表等场景。与上一节的通知服务不同,简单文件操作容易在本机隔离,直接检查实际文件通常比模拟 `write()` 更有价值。 ## 保存与读取的实现 本节只写两个函数: ```python def save_note(path, content): with open(path, "w", encoding="utf-8") as file: file.write(content) def load_note(path): with open(path, "r", encoding="utf-8") as file: return file.read() ``` `"w"` 表示写入,不存在则创建,存在则覆盖;`"r"` 表示读取已有文件。统一指定 UTF-8 编码,避免中文读写依赖环境默认设置。 `with` 在退出代码块时关闭文件。即使读取时在块内执行 `return`,也会先关闭文件,再把内容交给调用方。关闭文件是释放资源,不是删除磁盘上的文件。 ## tmp_path 为测试准备独立目录 保存测试使用 pytest 自带的 `tmp_path` fixture: ```python def test_save_note_writes_text_to_file(tmp_path): path = tmp_path / "note.txt" save_note(path, "今天学习文件测试") assert path.read_text(encoding="utf-8") == "今天学习文件测试" ``` `tmp_path` 是一个临时目录的路径对象;这里的 `/` 用来拼接文件名,不是除法。每个测试获得独立目录,避免覆盖真实笔记,也避免测试之间共用文件。 保存函数最初只有 `pass`,测试读取文件时抛出 `FileNotFoundError`。补上写入实现后,文件存在且内容正确,测试通过。 临时目录由 pytest 管理,可能保留最近几次运行的数据供排查,不保证每个测试结束就立即删除。 ## 读取测试独立准备文件 读取功能的测试先用 Python 自带方法准备内容: ```python def test_load_note_reads_existing_text(tmp_path): path = tmp_path / "note.txt" path.write_text("这是已有的学习笔记", encoding="utf-8") assert load_note(path) == "这是已有的学习笔记" ``` 这里没有调用被测试的 `save_note()` 来准备文件。这样读取失败时,更容易定位到读取功能;保存测试也通过自带的 `read_text()` 独立核对实际内容。需要时,可以另外增加保存后读回的组合测试。 ## 两个常见场景 第一个是覆盖旧笔记。测试先写入较长的旧内容,再保存较短的新内容,确认不是追加,也没有残留文字: ```python path.write_text("这是比较长的旧笔记内容", encoding="utf-8") save_note(path, "新笔记") assert path.read_text(encoding="utf-8") == "新笔记" ``` 第二个是读取不存在的文件: ```python with pytest.raises(FileNotFoundError): load_note(tmp_path / "missing.txt") ``` 不存在与内容为空是两种状态,不能直接返回空字符串掩盖路径错误。这里仅检查异常类型,不锁定包含具体路径、系统措辞的完整消息。 当前写入模式与读取行为已经满足这两项要求,因此补充测试后,无需额外修改实现。 ## fixture 和 with 为什么感觉相似 我在学习中追问:它们的作用是什么,怎么感觉有些相似? 相似之处是都可以参与资源准备和清理,但它们管理的范围不同: | 概念 | 负责什么 | 本节用途 | | --- | --- | --- | | fixture | 组织测试所需的准备与收尾 | pytest 提供 `tmp_path` | | tmp_path | 为每个测试准备独立目录 | 存放测试笔记 | | with | 让具体资源在代码块结束时可靠释放 | 读写完后关闭文件 | 因此,本节的执行顺序是:fixture 提供目录,测试调用保存函数,函数用 `with` 打开、写入并关闭文件,测试最后重新读取内容进行检查。 fixture 并不一定需要清理动作。创建购物车时没有文件需要关闭;如果 fixture 提供的是测试期间持续使用的文件或连接,才需要安排资源收尾。 这里再补充 `yield` 的用法:fixture 可以执行到 `yield`,把资源交给测试,测试结束后继续收尾。先知道这个用途即可,本节保存与读取函数自己已经用 `with` 关闭文件,不必额外引入这种 fixture。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day12 -v uv run pytest -v ``` 四个案例覆盖保存中文、读取已有文字、覆盖旧内容、读取缺失文件。本篇整理时,本节 4 个测试、全项目 72 个测试均通过。 ## 今日收获 今天我了解了如何在临时目录中测试真实文件读写。学习时,我觉得 fixture 和 with 有些相似,其实分工就能分清:fixture 为测试准备条件,with 保证文件使用后关闭。实际例子里,tmp_path 提供独立目录,保存和读取函数用 with 管理文件资源。后续可以继续用这段代码对照,区分测试准备与资源释放。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册