首页 文章 精选 留言 我的

精选列表

搜索[architecture],共2242篇文章
优秀的个人博客,低调大师

Stack based vs Register based Virtual Machine Architecture

进程虚拟机简介 一个虚拟机是对原生操作系统的一个高层次的抽象,目的是为了模拟物理机器,本文所谈论的是基于进程的虚拟机,而不是基于系统的虚拟机,基于系统的虚拟机可以用来在同一个平台下去运行多个不同的硬件架构的操作系统,常见的有kvm,xen,vmware等,而基于进程的虚拟机常见的有JVM,PVM(python虚拟机)等,java和python的解释器将java和python的代码编译成JVM和PVM可以识别的字节码.然后JVM和PVM取出字节码依次执行.就好比是汇编语言被编译成了机器码,通过指令寄存器取出每一个机器码开始执行.道理都是相同的. 那么作为一个进程虚拟机需要实现哪些功能呢?,因为虚拟机其实就是模拟物理机器的,而进程虚拟机其实就是去模拟CPU的一些操作,比如取指令,解析指令,执行指令,存储数据等.所以通常来说实现一个进程虚

优秀的个人博客,低调大师

Basic Architecture(基础架构)

1. Daemons(守护进程) 新老架构 老的: Apache Hadoop 1.x (MRv1) 新的: Apache Hadoop 2.x (YARN)-Yet Another Resource Negotiator 1-1) Apache Hadoop 1.x (MRv1) 包含如下后台进程: • Namenode (名称节点) • Secondary namenode (第二名称节点) • Jobtracker (工作跟踪器) • Datanode (数据节点) • Tasktracker (任务跟踪器) a) 所有的后台进程是运行在自己的JVM虚拟机中的Java服务。 b) 主从模式 namenode 和 jobtracker 是 master daemons datanode 和 tasktracker 是 slave daemons 2.NameNode(名称节点) 2-1) 名称节点是master daemon, 它负责存储HDFS文件系统上所有文件的位置信息。 名称节点从不存储实际数据,换句话说,它存储所有的元数据(metadata)。 (备注:元数据(Metadata),又称中介数据、中继数据,为描述数据的数据(data about data), 主要是描述数据属性(property)的信息,用来支持如指示存储位置、历史数据、资源查找、文件记录等功能。) 2-2) 名称节点在内存(RAM)中维护所有的元数据,这样客户端可以快速得到请求它的响应。 因此,需要在有较多内存分配的服务器上运行名称节点。(非常重要!!) HDFS中的文件数量越多,名称节点所消耗的内存也越高。 2-3) 由于在内存中存储元数据信息,因此名称节点后台进程也同时在硬盘上存储了一个用来持久化元数据的检查点文件,该文件名叫fsimage。 每当集群中的文件发生 新增/删除/更新 操作的时候,动作信息会被更新到一个叫做edits log的日志文件中。 更新完日志后,内存中的元数据信息也会相应地更新。 需要注意的是: fsimage文件不会针对每次写操作进行更新。 有人要问,如果名称节点的后台进程重启了怎么办,信息不都在内存中吗?丢失了呀! 答案是不会,下列操作会发生: 1. 从磁盘上读取fsimage文件的信息并把它加载到内存。 2. 从edits log读取所有的操作信息,并把它还原到内存中。 3. 最后把修改后的内存中的信息再写入磁盘上的fsimage文件。 2-4) Hadoop 1.x名称节点的弱点以及Hadoop 2.x的改进 a. Hadoop 1.x里的名称节点是单节点的,因此,如果该服务器宕机了的话,整个HDFS文件系统将不可使用了。 为了解决这种情况,以前管理员需要配置下,把fsimage同时写到本地磁盘和网络上的远程磁盘。 那台新备份的机器其实相当于冷备份,在名称节点宕机的时候可以临时启动。 b.Hadoop 2.x支持高可用(High Availability - HA) 部署2台名称节点的服务器, 分别是active和passive, 如果active的那台服务器宕机了, passive的那台服务器会接管 控制权,相当于双机热备份。 3. Secondary namenode(第二名称节点)

优秀的个人博客,低调大师

论文笔记系列-Efficient Neural Architecture Search via Parameter Sharing

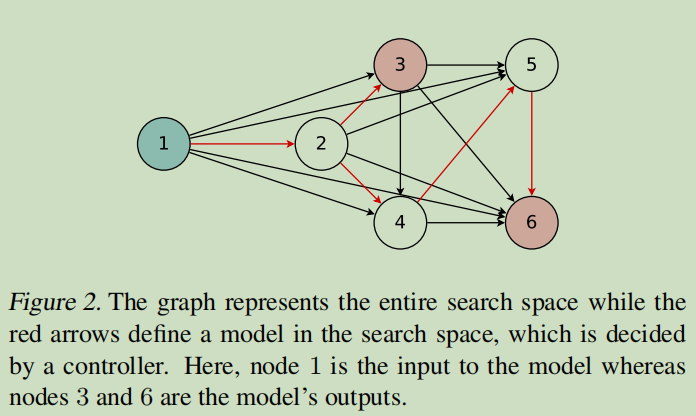
Summary 本文提出超越神经架构搜索(NAS)的高效神经架构搜索(ENAS),这是一种经济的自动化模型设计方法,通过强制所有子模型共享权重从而提升了NAS的效率,克服了NAS算力成本巨大且耗时的缺陷,GPU运算时间缩短了1000倍以上。在Penn Treebank数据集上,ENAS实现了55.8的测试困惑度;在CIFAR-10数据集上,其测试误差达到了2.89%,与NASNet不相上下(2.65%的测试误差) Research Objective 作者的研究目标 设计一种快速有效且耗费资源低的用于自动化网络模型设计的方法。主要贡献是基于NAS方法提升计算效率,使得各个子网络模型共享权重,从而避免低效率的从头训练。 Problem Statement 问题陈述,要解决什么问题? 本文提出的方法是对NAS的改进。NAS存在的问题是它的计算瓶颈,因为NAS是每次将一个子网络训练到收敛,之后得到相应的reward,再将这个reward反馈给RNN controller。但是在下一轮训练子网络时,是从头开始训练,而上一轮的子网络的训练结果并没有利用起来。 另外NAS虽然在每个节点上的operation设计灵活度较高,但是固定了网络的拓扑结构为二叉树。所以ENAS对于网络拓扑结构的设计做了改进,有了更高的灵活性。 Method(s) 解决问题的方法/算法 ENAS算法核心 回顾NAS,可以知道其本质是在一个大的搜索图中找到合适的子图作为模型,也可以理解为使用单个有向无环图(single directed acyclic graph, DAG)来表示NAS的搜索空间。 基于此,ENAS的DAG其实就是NAS搜索空间中所有可能的子模型的叠加。 下图给出了一个通用的DAG示例 如图示,各个节点表示本地运算,边表示信息的流动方向。图中的6个节点包含有多种单向DAG,而红色线标出的DAG则是所选择的的子图。 以该子图为例,节点1表示输入,而节点3和节点6因为是端节点,所以作为输出,一般是将而二者合并求均值后输出。 在讨论ENAS的搜索空间之前,需要介绍的是ENAS的测试数据集分别是CIFAR-10和Penn Treebank,前者需要通过ENAS生成CNN网络,后者则需要生成RNN网络。 所以下面会从生成RNN和生成CNN两个方面来介绍ENAS算法。 1.Design Recurrent Cells 本小节介绍如何从特定的DAG和controller中设计一个递归神经网络的cell(Section 2.1)? 首先假设共有\(N\)个节点,ENAS的controller其实就是一个RNN结构,它用于决定 哪条边需要激活 DAG中每个节点需要执行什么样的计算 下图以\(N=4\)为例子展示了如何生成RNN。 假设\(x[t]\)为输入,\(h[t-1]\)表示上一个时刻的输出状态。 节点1:由图可知,controller在节点1上选择的操作是tanh运算,所以有\(h_1=tanh(X_t·W^{(X)}+h_{t-1}·W_1^{(h)})\) 节点2:同理有\(h_2 = ReLU(h_1·W_{2,1}^{(h)})\) 节点3:\(h_3 = ReLU(h_2·W_{3,2}^{(h)})\) 节点4:\(h_4 = ReLU(h_1·W_{4,1}^{(h)})\) 节点3和节点4因为不是其他节点的输入,所以二者的平均值作为输出,即\(h_t=\frac{h_3+h_4}{2}\) 由上面的例子可以看到对于每一组节点\((node_i,node_j),i<j\),都会有对应的权重矩阵\(W_{j,i}^{(h)}\)。因此在ENAS中,所有的recurrent cells其实是在搜索空间中共享这样一组权重的。 但是我们可以很容易知道ENAS的搜索空间是非常庞大的,例如假设共有4中激活参数(tanh,identity,sigmoid,ReLU)可以选择,节点数为N,那么搜索空间大小则为\(4^N * N!\),如果N=12,那么就将近有\(10^{15}\)种模型参数。 2.1 Design Convolutional Networks 本小节解释如何设计卷积结构的搜索空间 回顾上面的Recurrent Cell的设计,我们知道controller RNN在每一个节点会做如下两个决定:a)该节点需要连接前面哪一个节点 b)使用何种激活函数。 而在卷积模型的搜索空间中,controller RNN也会做如下两个觉得:a)该节点需要连接前面哪一个节点 b)使用何种计算操作。 在卷积模型中,(a)决定 (连接哪一个节点) 其实就是skip connections。(b)决定一共有6种选择,分别是3*3和5*5大小的卷积核、3*3和5*5大小的深度可分离卷积核,3*3大小的最大池化和平均池化。 下图展示了卷积网络的生成示意图。 2.2 Design Convolutional Cell 本文并没有采用直接设计完整的卷积网络的方法,而是先设计小型的模块然后将模块连接以构建完整的网络(Zoph et al., 2018)。 下图展示了这种设计的例子,其中设计了卷积单元和 reduction cell。 接下来将讨论如何利用 ENAS 搜索由这些单元组成的架构。 假设下图的DAG共有\(B\)个节点,其中节点1和节点2是输入,所以controller只需要对剩下的\(B-2\)个节点都要做如下两个决定:a)当前节点需要与那两个节点相连 b)所选择的两个节点需要采用什么样的操作。(可选择的操作有5种:identity(id,相等),大小为3*3或者5*5的separate conv(sep),大小为3*3的最大池化。) 可以看到对于节点3而言,controller采样的需要连接的两个节点都是节点2,两个节点预测的操作分别是sep 5*5和identity。 3.Training ENAS and Deriving Architectures 本小节介绍如何训练ENAS以及如何从ENAS的controller中生成框架结构。(Section 2.2) controller网络是含有100个隐藏节点的LSTM。LSTM通过softmax分类器做出选择。另外在第一步时controller会接收一个空的embedding作为输入。 在ENAS中共有两组可学习的参数: 子网络模型的共享参数,用\(w\)表示。 controller网络(即LSTM网络参数),用\(θ\)表示。 而训练ENAS的步骤主要包含两个交叉阶段:第一部训练子网络的共享参数\(w\);第二个阶段是训练controller的参数\(θ\)。这两个阶段在ENAS的训练过程中交替进行,具体介绍如下: 子网络模型共享参数\(w\)的训练 在这个步骤中,首先固定controller的policy network,即\(π(m;θ)\)。之后对\(w\)使用SGD算法来最小化期望损失函数\(E_{m~π}[L(m;w)]\)。 其中\(L(m;w)\)是标准的交叉熵损失函数:\(m\)表示根据policy network \(π(m;θ)\)生成的模型,然后用这个模型在一组训练数据集上计算得到的损失值。 根据Monte Carlo估计计算梯度公式如下: \[\nabla_w E_{m-~π}(m;θ)[L(m;w)] ≈ \frac{1}{M} \sum_i^M \nabla_wL(m_i;w) \] 其中上式中的\(m_i\)表示由\(π(m;θ)\)生成的M个模型中的某一个模型。 虽然上式给出了梯度的无偏估计,但是方差比使用SGD得到的梯度的方差大。但是当\(M=1\)时,上式效果还可以。 训练controller参数θ 在这个步骤中,首先固定\(w\),之后通过求解最大化期望奖励\(E_{m~π}[R(m;w)]\)来更新\(θ\)。其中在语言模型实验中\(R(m;w)=\frac{c}{valid\_ppl}\),perplexity是基于小批量验证集计算得到的;在分类模型试验中,\(R(m;w)\)等于基于小批量验证集的准确率。 导出模型架构 首先使用\(π(m,θ)\)生成若干模型。 之后对于每一个采样得到的模型,直接计算其在验证集上得到的奖励。 最后选择奖励最高的模型再次从头训练。 当然如果像NAS那样把所有采样得到的子模型都先从头训练一边,也许会对实验结果有所提升。但是ENAS之所以Efficient,就是因为它不用这么做,原理继续看下文。 Evaluation 评估方法 1.在 Penn Treebank 数据集上训练的语言模型 2.在 CIFAR-10 数据集上的图像分类实验 由上表可以看出,ENAS的最终结果不如NAS,这是因为ENAS没有像NAS那样从训练后的controller中采样多个模型架构,然后从中选出在验证集上表现最好的一个。但是即便效果不如NAS,但是ENAS效果并不差太多,而且训练效率大幅提升。 下图是生成的宏观搜索空间。 ENAS 用了 11.5 个小时来发现合适的卷积单元和 reduction 单元,如下图所示。 Conclusion ENAS能在Penn Treebank和CIFAR-10两个数据集上得到和NAS差不多的效果,而且训练时间大幅缩短,效率大大提升。 MARSGGBO原创 2018-8-7


优秀的个人博客,低调大师

理解 OpenStack Swift (2):架构、原理及功能 [Architecture, Implementation and Feat...

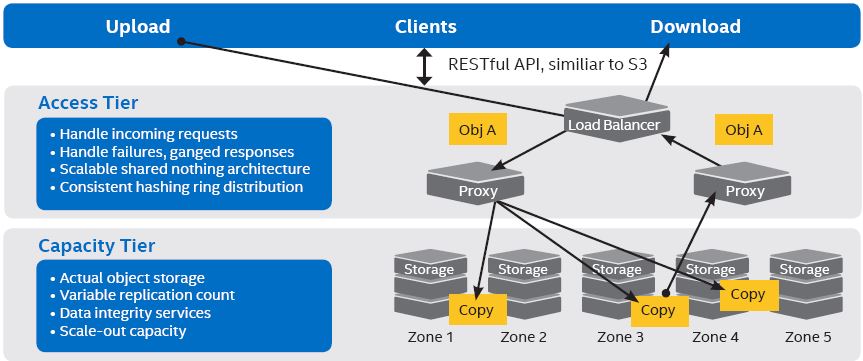
本系列文章着重学习和研究OpenStack Swift,包括环境搭建、原理、架构、监控和性能等。 (1)OpenStack + 三节点Swift 集群+ HAProxy + UCARP 安装和配置 (2)原理、架构和性能 (3)监控 1. 架构 1.1 总体架构 Swift 的总体架构非常的清晰和独立: # 分层(Tier) 组件(Service) 功能(Function) 特性 部署考量 1 访问层(Access Tier) Load Balancer 硬件(比如F5)或者软件(比如HAProxy)负载均衡器,将客户端的请求按照配置的策略分配到无状态的 proxy service。 按照实际需求选择硬件还是软件LB 2 Proxy Server 提供 REST API 给客户端 无状态的 WSGI 服务,由多个 Proxy Server 组成一个集群 将客户端请求转给某个存储节点上的 Account,Container 或者 Object 服务 是CPU 和网络带宽敏感的 分配更多的CPU和网络带宽,比如 10GbE 网络 使用 Memcached 来做 token、account 和 container 数据缓存 和存储服务分开部署 使用负载均衡器 往往每五个存储节点使用两个 proxy server 节点,然后再按比例扩展 将 public network (用于客户端访问)和 backend network (用于访问存储服务)分开 需要考虑安全性,可以将 SSL Termination 放在 Proxy Server 上 3 存储层 (Capactity Tier) AccountServer 提供 Account 操作 REST API 是磁盘性能和网络带敏感的 对 Account 和 Container 服务使用更好的磁盘,比如 SAS 或者 SSD,来提高性能; 使用 1GbE 或者 10GbE 网络 需要的话,可以将 replicaiton network 独立出来 需要的话,可以将 Account 和 Container 服务部署到独立的服务器上 4 Container Server 提供 Container 操作 REST API 5 Object Server 提供 Object 操作 REST API 6 Consistency Servers 包括Replicators, Updaters 和 Auditors 等后台服务,用于保证 object 的一致性 这是一张比较经典的 Swift 物理部署图: 1.2 网络架构 以一个对外提供对象存储服务的集群为例,其网络架构可以为: 外部流量被放在一个单独的(上图中紫色)VLAN 中,终点为 LB 控制(管理)网络连接所有节点 Swift 前端(front end / public)网络连接 LB 和 所有 Proxy server 节点 Swift 后端 (backend / private) 网络连接所有 Proxy server 节点和 存储节点 需要的话,还可以从后端网络中分离出复制(replication)网络 在网络带宽选择上, 考虑到复制数据的容量较大(往往是几个TB起步),后端网络往往是用 10GbE 网络 根据前端负载,前端网络可以使用 1GbE 网络,或者有条件时使用 10GbE 网络 管理/IPMI网络往往是用 1GbE 网络 这是 SwiftStack 的一个例子: 2. 数据存放 2.1 Swift 的数据存放 2.1.1 Swift 的数据模型 Swift 的数据模型使用了以下三个概念来(见下图1): Account: 账户/租户。Swift 是天生支持多租户的。如果使用 OpenStack Keystone 做用户校验的话,account 与 OpenStack project/tenant 的概念相同。Swift 租户的隔离性体现在metadata上,而不是体现在 object data 上。数据包括自身元数据 和 container 列表,被保存在 SQLite 数据库中。 Container: 容器,类似于文件系统中的目录,由用户自定义,它包含自身的元数据和容器内的对象列表。数据保存在 SQLite 数据库中。在新版中,Swift 支持在容器内添加文件夹。 Object: 对象,包括数据和数据的元数据,以文件形式保存在文件系统上。 (图1) (图2) Containers 是用户创建的,用来 hold objects。 objects 可以是 0 bytes 长度,或者包含数据。 container 中的 object 最大大小为 5GB;超过的话,会做特殊处理 每个 object 使用它的 name 来被 referenced;Swift 没有目录概念 在 object name 中可以使用任意的可以被 ‘URL-encoded’ 的字符,最大长度为 URL - coded 之后 1034 个字符 object name 中可以带 '/' 字符,它会带来目录结构的幻觉(illusion),比如dir/dir2/name。即使看起来象个目录,但是它仍然只是一个 object name。此时,不需要 dir 或者 dir/dir2 container 的存在。 如果一个 container 所有 objects 的大小为0,那么它将看起来象一个目录。 客户端使用 HTTP 或者 HTTPS 访问 Swift,包括读、写、删除 objects。也支持 COPY 操作,它会创建一个新的 object,使用一个新的 object name,包含老 object 的 data。没有 rename 操作,它会首先 copy 出一个新的,然后再将老的删除。 2.1.2 选择数据存放位置 Swift 保存每个对象为多分拷贝,它按照物理位置的特点,尽量将这些拷贝放在不同的物理位置上,来保证数据的地理位置上的可靠性。它主要考虑以下几种位置属性: Region:地理位置上的区域,比如不同城市甚至不同国家的机房,这主要是从灾备方面考虑的。 Zone:一个数据中心根据物理网络、供电、空调等基础设施分开的独立的域,往往将一个机架(Rack)内的服务器分在一个 Zone 内。 Node (节点):物理服务器 Disk (磁盘):物理服务器上的磁盘 Swift 在确定对象的放置位置时,会尽量将对象及其拷贝放在不会同时损失的物理位置上。见上图2. 2.1.3 保证数据一致性 对象及其拷贝放置在某个磁盘上后,Swift 会使用Replicators, Updaters 和 Auditors 等后台服务来保证其数据的最终一致性。 Replicator – 拷贝对象,确保系统的最终一致性(Replicate objects and make a system in a consistent state);恢复磁盘和网络错误(Recover disk failure, network outages situation) Updater – 更新元数据(Update metadata),从容器和账户元数据高负载导致的问题上恢复(Recover failure caused by container, account metadata high load) Auditor – 删除问题账户,容器和对象,然后从别的服务器上拷贝过来(Delete problematic account, container or objects and replicate from other server);恢复数据库和文件数据错误(Recover dbs or files which have bit rot problem. 其中,Replicator 服务以可配置的间隔来周期性启动,默认是 30s,它以 replication 为最小单位,以 node 为范围,周期性地执行数据拷贝。详细过程请参考文末的参考文档。考虑到Swift 实现的是最终一致性而非强一致性,它不合适于需要数据强一致性的应用,比如银行存款和订票系统等。需要做 replication 的情形包括但不限于: Proxy server 在写入第三份时失败,它依然会向客户端返回成功,后台服务会写第三份拷贝 后台进程发现某个replication 数据出现损坏,它会在新的位置重新写入 在跨 Region 的情况下,Proxy server 只会向它所在 Region 的存储上写入,远处 region 上的数据由后台进程复杂写入 在更换磁盘或者添加磁盘的情况下,数据需要重新平衡时 2.2 Swift 是如何实现这些需求的:使用 Ring + 哈希算法 Swift 根据由管理员配置的 Ring 使用相对简单直接的算法来确定对象的存放位置。对象会以文件的形式保存在本地文件系统中,使用文件的扩展属性来保存对象的元数据,因此,Swift 需要支持扩展属性的文件系统,目前官方推荐是 XFS。 2.2.1 Ring 的内容和算法 简单来说,Swift 的 Proxy Server 根据account,container 和 object 各自的 Ring 来确定各自数据的存放位置,其中 account 和 container 数据库文件也是被当作对象来处理的。 因此,Swift 需要 Ring 的配置文件分布在所有 Proxy节点上。同时,Consistency Servers 需要它来确定后台对象拷贝的位置,因此也需要部署在所有存储节点上。Ring 以文件的形式保存: object.ring.gz container.ring.gz account.ring.gz 在分析 Ring 是如何工作的之前,先来看看 Ring 的几个关键配置: Region,zone 和 disk:前面说过了,略过 partition:Swift 再将每个磁盘分成若干 partition (分区)。这是后端一致性检查服务处理拷贝(replication)的基本单位。 Replica:对象和拷贝的总份数,常规推荐值是 3。 管理员使用 Swift 提供的 ring 生成工具(swift-ring-builder,位于源码的bin目录下,是swift最基本的命令,它与swift/common/ring/下的文件一起实现ring文件创建,添加,平衡,等操作),加上各种配置参数,得出该ring的内容。以 Object ring 为例, root@swift1:/etc/swift# swift-ring-builder object.builder object.builder, build version 6 1024 partitions, 3.000000 replicas, 1 regions, 3 zones, 6 devices, 0.00 balance, 0.00 dispersion The minimum number of hours before a partition can be reassigned is 1 The overload factor is 0.00% (0.000000) Devices: id region zone ip address port replication ip replication port name weight partitions balance meta 0 1 1 9.115.251.235 6000 9.115.251.235 6000 sdb1 100.00 512 0.00 1 1 1 9.115.251.235 6000 9.115.251.235 6000 sdc1 100.00 512 0.00 2 1 2 9.115.251.234 6000 9.115.251.234 6000 sdb1 100.00 512 0.00 3 1 2 9.115.251.234 6000 9.115.251.234 6000 sdc1 100.00 512 0.00 4 1 3 9.115.251.233 6000 9.115.251.233 6000 sdb1 100.00 512 0.00 5 1 3 9.115.251.233 6000 9.115.251.233 6000 sdc1 100.00 512 0.00 该 Ring 的配置为:1 个 region,3 个 zone,3 个 node,6 个磁盘,每个磁盘上 512 个分区。 内部实现上,Swift 将该 Ring 的配置保存在其_replica2part2dev数据结构中: 其读法是: 行:将集群所有的分区都顺序编号,每个分区有唯一的一个ID 列:包含 Ring 中的 id,该 id 唯一确定了一个 disk;和 replica 的编号。 因此,Swift 通过该数据结构可以方便地查到某个 replica 应该通过哪些节点上的存储服务放在哪个 disk 上。 除了生成 Ring 外,对 Ring 的另一个重要操作是 rebalance(再平衡)。在你修改builder文件后(例如增减设备),该操作会重新生成ring文件,使系统中的partition分布平衡。当然,在 rebalance 后,需要重新启动系统的各个服务。 详情可以参考OpenStack Swift源码分析(二)ring文件的生成。 2.2.2 数据放置和读取过程 当收到一个需要保存的 object 的 PUT 请求时,Proxy server 会: 根据其完整的对象路径(/account[/container[/object]])计算其哈希值,哈希值的长度取决于集群中分区的总数。 将哈希值的开头 N 个字符映射为数目同 replica 值的若干 partition ID。 根据 partition ID 确定某个数据服务的 IP 和 port。 依次尝试连接这些服务的端口。如果有一半的服务无法连接,则拒绝该请求。 尝试创建对象,存储服务会将对象以文件形式保存到某个磁盘上。(Object server 在完成文件存储后会异步地调用 container service 去更新container数据库) 在3份拷贝中有两份被成功写入后, Proxy Server 就会向客户端返回成功。 当 Proxy server 收到一个获取对象的 GET 请求时,它: (1)(2)(3)(4)同前面的 PUT 请求,确定存放所有 replica 的 所有磁盘 (5)排序这些 nodes,尝试连接第一个,如果成功,则将二进制数据返回客户端;如果不成功,则尝试下一个。直到成功或者都失败。 应该说该过程蛮简单直接,这也符合Swift的总体设计风格。至于具体的哈希算法实现,有兴趣可以看相关论文。大致来说,它实现的是 “unique-as-possible” 即 “尽量唯一” 的算法,按照 Zone,Node 和 Disk 的顺序。对于一个 replica,Swift 首先会去选择一个没有该对象 replica 的 zone,如果没有这样的 zone,选择一个已使用 zone 中的没用过的 node,如果没有这样的 node,就选择已使用的 node 上的一个没使用过的 disk。 2.2.3 Hash 计算和对象位置查找 (1)存放的目录取决于哈希值 这里也表明,对象的存放目录和其名称是直接关联的。因此,在Swift中的,对对象重命名,意味着对象位置的修改,该过程会产生数据拷贝,而且在很多时候是需要跨节点的远程拷贝。在某些应用中,比如 Hadoop 大数据应用,如果采用 Swift 作为存储,在其mapreduce 过程中,是会产生文件 rename 操作的,这在 Swift 中会带来严重的性能下降。 (2)获取某对象的存放路径 root@swift1:~/s1# swift-get-nodes /etc/swift/object.ring.gz AUTH_dea8b51d28bf41599e63464828102759/container1/1 Account AUTH_dea8b51d28bf41599e63464828102759 Container container1 Object 1 Partition 277 Hash 456a95e2e66aad55d72756c6b0cd3b75 Server:Port Device 9.115.251.235:6000 sdb1 Server:Port Device 9.115.251.234:6000 sdc1 Server:Port Device 9.115.251.233:6000 sdc1 curl -I -XHEAD "http://9.115.251.235:6000/sdb1/277/AUTH_dea8b51d28bf41599e63464828102759/container1/1" curl -I -XHEAD "http://9.115.251.234:6000/sdc1/277/AUTH_dea8b51d28bf41599e63464828102759/container1/1" curl -I -XHEAD "http://9.115.251.233:6000/sdc1/277/AUTH_dea8b51d28bf41599e63464828102759/container1/1" (3)远程登录后者 ssh 后可以看到保存对象的文件 root@swift1:~/s1# ls /srv/node/sdb1/objects/277/b75/456a95e2e66aad55d72756c6b0cd3b75 -l total 8 -rw------- 1 swift swift 12 Nov 8 17:17 1447003035.84393.dataroot@swift1:~/s1# cat /srv/node/sdb1/objects/277/b75/456a95e2e66aad55d72756c6b0cd3b75/1447003035.84393.data 222222222222 2.2.4 对象分段 Swift 对于小的文件,是不分段直接存放的;对于大的文件(大小阈值可以配置,默认是 5G),系统会自动将其分段存放。用户也可以指定分段的大小来存放文件。比如对于 590M 的文件,设置分段大小为 100M,则会被分为 6 段被并行的(in parallel)上传到集群之中: root@controller:~/s1# swift upload container1 -S 100000000 tmpubuntu tmpubuntu segment 5 tmpubuntu segment 2 tmpubuntu segment 4 tmpubuntu segment 1 tmpubuntu segment 3 tmpubuntu segment 0 tmpubuntu root@controller:~/s1# swift list container1 1 admin-openrc.sh cirros-0.3.4-x86_64-disk.raw tmpubuntu 从 stat 中可以看出它使用一个 manifest 文件来保存分段信息: root@controller:~/s1# swift stat container1 tmpubuntu Account: AUTH_dea8b51d28bf41599e63464828102759 Container: container1 Object: tmpubuntu Content Type: application/octet-stream Content Length: 591396864 Last Modified: Fri, 13 Nov 2015 18:31:53 GMT ETag: "fa561512dcd31b21841fbc9dbace118f" Manifest: container1_segments/tmpubuntu/1446907333.484258/591396864/100000000/ Meta Mtime: 1446907333.484258 Accept-Ranges: bytes Connection: keep-alive X-Timestamp: 1447439512.09744 X-Trans-Id: txae548b4b35184c71aa396-0056462d72 但是 list 的时候依然只看到一个文件,原因是因为 manifest 文件被保存到一个独立的 container (container1_segments)中。这里可以看到 6 个对象: root@controller:~/s1# swift list container1_segments tmpubuntu/1446907333.484258/591396864/100000000/00000000 tmpubuntu/1446907333.484258/591396864/100000000/00000001 tmpubuntu/1446907333.484258/591396864/100000000/00000002 tmpubuntu/1446907333.484258/591396864/100000000/00000003 tmpubuntu/1446907333.484258/591396864/100000000/00000004 tmpubuntu/1446907333.484258/591396864/100000000/00000005 每个对象大小是100M(考虑到存储效率,不建议每个对象大小小于100M): root@controller:~/s1# swift stat container1_segments tmpubuntu/1446907333.484258/591396864/100000000/00000000 Account: AUTH_dea8b51d28bf41599e63464828102759 Container: container1_segments Object: tmpubuntu/1446907333.484258/591396864/100000000/00000000 Content Type: application/octet-stream Content Length: 100000000 而且用户可以单独操作比如修改某一段。Swift 只会负责将所有段连接为用户所见的大的对象。 关于大文件支持的更多细节,可以参考官方文档和Rackspace 的文档。从上面的描述可以看出,Swift 对文件分段的支持是比较初级的(固定,不灵活),因此,已经有人提出 Object stripping (对象条带化)方案,比如下面的方案,不知道是否已经支持还是将要支持。 2.3 Region 通过将对象存放在不同物理位置上的 Region 内,可以进一步增强数据的可用性。其基本原则是:对于 N 份 replica 和 M 个 region,每个 region 中的 replica 数目为 N/M 的整数,剩余的 replica 在 M 个region 中随机选择。以 N = 3, M = 2 为例,一个 region 中有 1 个 replica,另一个 region 中有两个 replica,如下图所示: 对于一个 PUT 操作来说,Proxy server 只会将 replica 写入它所在的 region 中的 node,远端 region 中的 replica 由 replicator 写入。因此,Swift 的算法应该尽量保证 proxy server 所在的 region 中的 replica 份数相对多一些,这也称为 replica 的 proxy server 亲和性。 显然,跨 region 的数据复制加重了对网络带宽的要求。 两种形式的 Region: (1)远端 region 实时写入 replica (2)远端 region 的 replica 异步写入 2.4 Storage Polices (存储策略) 上面的描述中,一个Swift 集群只支持一套 Ring 配置,这意味着整个机器的配置是唯一的。类似 Ceph 中 pool 的定义,Swift 在 2.0 版本(包含在 OpenStack Juno 版本中)中,添加了一个非常大的功能:Storage policy。在新的实现中,一个 Swift 可以由多套 Ring 配置,每套 Ring 的配置可以不相同。比如,Ring 1 保存 3 份对象拷贝,Ring 2 保存 2 份对象拷贝。几个特点: Policy 被实现在 container 级别 创建 container 时可以指定 policy。一旦被指定,不可以修改。 一个 policy 可以被多个 container 共享使用 通过应用该新的功能,Swift 用户可以制定不同的存储策略,来适应不同应用的存储需求。比如对关键应用的数据,制定一个存储策略使得数据被保存到 SSD 上;对于一般关键性的数据,指定存储策略使得数据只保存2份来节约磁盘空间。比如说: 详细信息,请参考 OpenStack官方文档和SwiftStack 官方文档。 3. 版本及主要功能 3.1 Juno以及之前主要版本和功能 (1)Large object support Swift limitation:Single object: 5GB Split object & manage large object Manage segmented objects by manifest file Ref:http://docs.openstack.org/developer/swift/overview_large_objects.html (2)Static web hosting Upload static web file and make web site;Upload web site file with index and error files Use statiscweb middleware Ref:http://docs.openstack.org/developer/swift/middleware.html#staticweb (3)S3 compatible API Support S3 APISupport limited API less than 40%Use swift3 middleware Ref:https://github.com/stackforge/swift3 (4)Object expiration Schedule deletion of objects Use X-Delete-At and X-Delete-After header while using an object PUT or POST X-Delete-At: Delete object at specified time X-Delete-After: Delete object after specified time Ref:http://docs.openstack.org/developer/swift/overview_expiring_objects.html (5)Temp url Provide url to access in limited time Need temp_url_expires time in header Use temporary URL middleware Ref:http://docs.openstack.org/developer/swift/api/temporary_url_middleware.html (6)Global cluster Make a single cluster in distant regionRead/Write affinity Deferred replication Ref:http://docs.openstack.org/developer/swift/admin_guide.html,https://swiftstack.com/blog/2012/09/16/globally-distributed-openstack-swift-cluster/ (7)Storage policy Support various policy in sing storage cluster Use multiple ring file Ref:http://docs.openstack.org/developer/swift/admin_guide.html 3.2 Kilo 版本中的更新 新功能 纠删码(beta) Swift现在支持纠删码(EC)存储策略类型。这样部署人员、以极少的RAW容量达到极高的可用性,如同在副本存储中一样。然而,EC需要更多的CPU和网络资源,所以并不适合所有应用场景。EC非常适合在一个独立的区域内极少访问的、大容量数据。 Swift纠删码的实现对于用户是透明的。对于副本存储和纠删码存储的类型,在API上没有任何区别。 为了支持纠删码,Swift现在需要依赖PyECLib和liberasurecode。liberasurecode是一个可插件式的库,允许在你选择的库中实现EC算法。 更详细文档请参阅http://swift.openstack.org/overview_erasure_code.html 复合型令牌(Composite tokens) 复合型令牌允许其他OpenStack服务以客户端名义将数据存储于Swift中,所以无论是客户端还是服务在更新数据时,都不需要双方彼此的授权。 一个典型的例子就是一个用户请求Nova存放一个VM的快照。Nova将请求传递给Glance,Glance将镜像写入Swift容器中的一组对象中。在这种场景下,用户没有来自服务的合法令牌时,无法直接修改快照数据。同样,服务自身也无法在没有用户合法令牌的情况下更新数据。但是数据的确存在于用户的Swift账户中,这样使得账户管理更简单。 更详细的文档请参阅http://swift.openstack.org/overview_backing_store.html 更小规模、不平衡集群的数据位置更新 Swift数据的存放位置现在根据硬件权重决定。当前,允许运维人员逐渐的添加新的区域(zones)和地域(regions),而不需要立即触发大规模数据迁移。同时,如果一个集群是非平衡的(例如,在一个区域(zones)的集群中,其中一个的容量是另外一的两倍),Swift会更有效的使用现有空间并且当副本在集群空间不足时发出警告。 全局性集群复制优化 区域(regions)之间复制时,每次复制只迁移一个副本。这样远程的区域(region)可以在内部复制,避免更多的数据在广域网(WAN)拷贝。 已知问题 作为beta更新,纠删码(EC)的功能接近完成,但是对于某些功能仍然不完整(像多范围(multi-range)读取),并且没有一个完整的性能测算。这个功能为了持久性依赖于ssync。部署人员督促我们做更大规模的测试,并且不要在生产环境部署中使用纠删码存储策略。 升级提示 像往常一样,你能在不影响最终用户体验的前提下,升级到这个版本的Swift。 为了支持纠删码,Swift需要一个新的依赖PyECLib(和liberasurecode等)。并且eventlet的最低版本要求也升高了。 3.3 Liberty 版本中的更新 L版本中Swift 没有加入大的新功能,详细情况可以参考官方文档。 3.4 优势 其它参考文档: http://www.florentflament.com/blog/openstack-swift-ring-made-understandable.html https://www.mirantis.com/blog/configuring-multi-region-cluster-openstack-swift/ OpenStack Swift源码分析 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4955241.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

开发转测试七年,我从测试策略到测试架构(Test architecture)

程序员之间流传着这样一句顺口溜:有人喜欢创造世界,他们做了开发者;有的人喜欢开发者,他们做了测试员。什么是软件测试?软件测试就是一场本该在用户面前发生的灾难提前在自己面前发生了,这会让他们生出一种救世主的感觉,拯救了用户,也就拯救者这个软件,避免了他们被卸载的命运。 今年是我做软件测试的第7个年头了,当年我从软件开发转做软件测试的时候,没有想过我能在这个领域做这么久。在这7年里面,我在软件测试领域摸爬滚打,从自动测试起步,逐步接触到软件测试的各个领域:各种测试方法(等价类,全配对等)、测试技术(单元测试,功能测试,性能测试,探索性测试等)、自动化测试工具(JUnit,Selenium,Gatling,ZAP等)、测试流程(传统测试流程,敏捷测试流程等)以及测试策略(测试象限和测试金字塔等)。 其中“测试策略”在测试业界是讨论的比较少的,因为大多数人的工作重点是设计测试用例,执行测试或者开发和维护自动化测试,而只有少部分人才会涉及到测试策略的工作,从而导致很多测试人员其实并没有系统的了解测试策略。 所以我准备将我这几年对于测试策略的经验、总结以及思考以系列文章的形式写出来,希望能稍微帮助一下大家去理解测试策略,从而做到更好的测试,减少缺陷,提高质量。 测试策略 测试策略(Test Strategy)的第一目标就是“减少缺陷的出现和发布”。其中“减少缺陷的出现”可以通过测试前移等方法来解决,在进行软件需求分析和架构设计的时候发现缺陷;而“减少缺陷发布”可以使用各种测试方法、技术来验证和测试编码完成的功能(这两点在今后的文章里面会通过不同的例子进行更详细的阐述)。 由此可见,“测试策略”并不是只由测试人员定制的,它是由一个团队的各个角色一起来制定和建立的,目的是保证软件的质量,减少缺陷。 而“测试计划”是用于实施测试策略的。只有充分理解测试策略目的和实施方式,才能充分理解测试策略,为什么要做测试策略,什么样的测试策略才更有意义、更好,怎样实施才能更有效等问题。 测试计划 制定测试计划是保证测试策略能被有效执行的一种方式。它告诉了团队在什么阶段,什么样的角色应该执行测试策略中什么样测试技术和测试方法。它主要由测试人员编写,但是应该由整个团队进行评审,因为开发人员、产品经理、业务分析人员甚至用户都可能参与到测试计划的执行中。 测试计划是可以根据项目的实际进展情况进行调整的,所以它并不是一成不变的。 测试架构 在上个世纪六七十年代软件系统还处于小规模的时候,软件开发并没有谈什么架构,软件测试也不存在什么策略可言。但是随着软件规模的极速增大,复杂性也成指数级增加,专业的软件架构应运而生。 为了有效的在规定时间内完成复杂软件系统的测试,必须有一个指导性的策略来帮助团队理解、选择和组织大量的测试,因此软件测试策略就出现了。而测试策略往往是高层次的指导,对于一些中小型项目也许已经足够了,但是却不足以应付现代越来越复杂的软件系统。 因为随着微服务、移动互联网、物联网、大数据分析系统、AI系统等的出现,要测试一个包含各种技术,外部依赖,或者独立子系统的复杂系统,并不是简单的根据测试策略在不同层面上做不同的测试就可以了,而是要理清各种测试之间的相互联系和制约,然后思考怎么有效的将各个维度上的测试联系起来,以软件系统架构的思维去思考整个测试体系。 请注意这里不是说要去设计一套全自动化的测试系统来完成整个系统的所有测试,而是通个各种有效的方式(无论手动还是自动)把各种测试合理且有效的联系起来,形成一个拥有完整架构的测试体系,这样才能使整个系统的各种测试更加可视化和更易于理解,使整个系统的各种测试更加有效,避免重复测试,节约成本。 举例来说,一个前后端分离的Web业务系统不仅有前端UI和大量的JavaScirpt代码,还有后端的API和第三方依赖系统以及数据库系统,如何将各层测试有效的联系起来就是测试架构需要解决的问题。 首先,前端、后端API、第三方依赖系统和数据库系统有各自的单元测试、集成测试等,然后可以使用契约测试来测试统一前端和后端API,再使用Stub加入对于第三方依赖系统的契约测试或者监控测试,还需要使用测试数据生成系统参数,将各种测试数据存入数据库系统用于支持契约测试等。 如果对软件测试、接口测试、自动化测试、性能测试、LR脚本开发、面试经验交流。感兴趣可以175317069,群内会有不定期的发放免费的资料链接,这些资料都是从各个技术网站搜集、整理出来的,如果你有好的学习资料可以私聊发我,我会注明出处之后分享给大家。 对于不同软件系统,其架构一般都是根据业务需求、技术能力等各种条件来设计的。与软件架构一样,测试策略和测试架构在不同的项目里面,需要根据其软件系统的架构、技术栈、业务需求、人员的技能等因素来定制和设计。 再谈测试策略 现在业界流行的测试金字塔和测试象限只是两种高度抽象和简化的测试策略模型,不具备实际可操作性,只具备高层次的指导性和参考性。直接根据这两个模型来工作是低效的,甚至可能带来负面效果。所以对于测试金字塔和测试象限不能盲目的使用,而是需要根据项目的实际情况来生成适合自己项目的测试策略和测试架构(项目不需要测试架构),并在此基础上执行真实的测试工作。

优秀的个人博客,低调大师

System Architecture Modeling (SAM) - 知识体系与能力框架可视化建模提示词

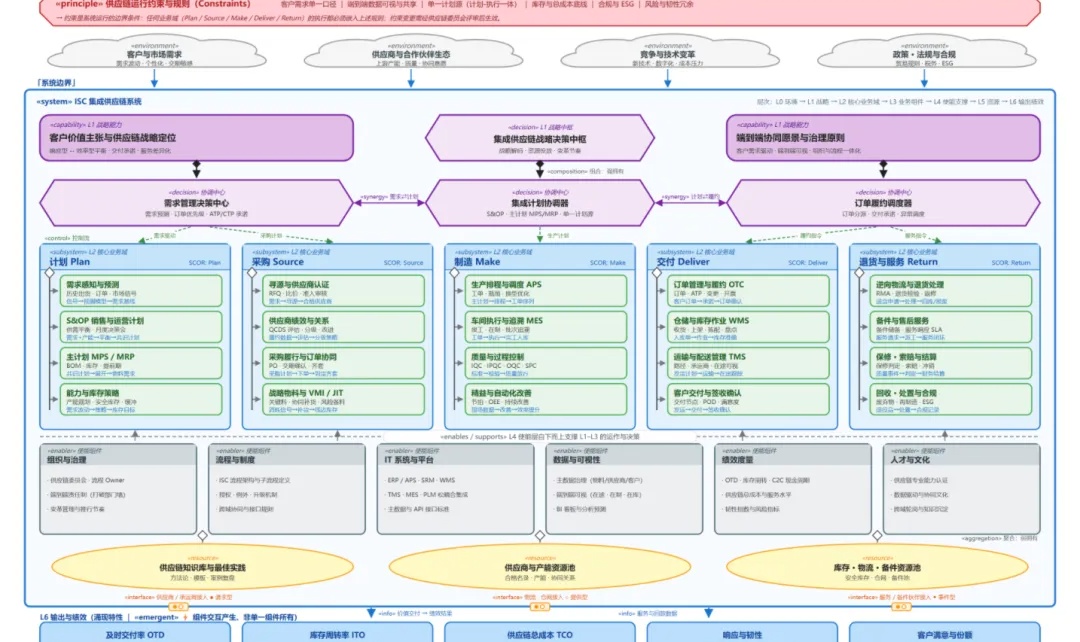
**大家好,我是人月聊IT。** 今天继续分享我原来整理的基于系统工程学思想的可视化建模提示词和标准规范。实际在今年1月份的时候就出了该规范,但是当时大模型的绘图能力有限,也没有引起我足够重视。 今天重新在使用该规范,即使使用DeepSeek V4.1 Flash模型,也可以得到很好的模型输出和可视化效果。该提示词和参考案例已经开源,大家可以下载和试用。具体地址在: https://github.com/sharptoolbox/visual-model 提示词:基于《SystemArchitectureModeling.md》提示词的要求。对ISC集成供应链框架体系进行可视化建模,输出一个完整的svg可视化模型图给我。 ![](https://developer.qcloudimg.com/http-save/audit-8165035/1b4d2400129bcba73916af3e46cf8d62.webp) 基于提示词,输出生产制造企业的IPDF可视化模型图。 ![](https://developer.qcloudimg.com/http-save/audit-8165035/db2f0582373e63d1434188a3dfb2ccae.webp) 基于我9.18日本体论的文章的核心内容,整理为一个知识体系和能力框架,还是按前面的建模提示词和方法论,输出一个新的svg文件给我。 ![](https://developer.qcloudimg.com/http-save/audit-8165035/6a74bcaa5922e7ae4dcb2862552ec052.webp) ## **一、核心建模理念** ### **1.1 系统工程思想基础** 本建模规范基于**系统工程**(Systems Engineering)的核心思想,将任何复杂事物(知识体系、能力框架、组织架构、概念模型等)视为一个**系统**,通过可视化模型来揭示其**内在机制**和**外在表现**之间的因果关系。 > **核心假设**:任何复杂事物都可以被分解为相互关联的组件,组件间的关系和交互决定了系统的整体涌现行为。 ### **1.2 五维建模框架(SCBRD)** 为了完整理解和表达一个系统,必须同时把握五个核心维度: |**维度**|**英文**|**核心问题**|**建模目标**| | --- | --- | --- | --- | |**结构**|Structure|系统由哪些组件构成?|识别核心要素与层次| |**能力**|Capability|各组件能做什么?|定义功能与职责| |**行为**|Behavior|组件如何运作?|描述动态过程与状态| |**关系**|Relation|组件间如何关联?|建立依赖与交互模式| |**依赖**|Dependency|什么驱动什么?|追溯因果与约束链| ### **1.3 建模核心原则** - **层次化分解**:从整体到局部,从抽象到具体 - **关注点分离**:不同视图表达不同的系统关注点 - **可追溯性**:概念→能力→行为→实现之间的清晰追溯 - **一致性**:确保不同视图之间的信息一致 - **涌现性**:揭示组件交互产生的整体特性 ## **二、系统建模元素规范** ### **2.1 核心组件(Component)表示法** #### **形状语义约定** 不同形状代表不同类型的系统组件,具有明确的语义: |**形状**|**语义**|**适用场景**|**填充色**| | --- | --- | --- | --- | |**矩形**|基础模块/子系统|功能模块、知识模块|#E3F2FD(浅蓝)| |**圆角矩形**|有状态组件|能力、技能、记忆模块|#E8F5E9(浅绿)| |**六边形**|决策/协调中心|控制器、调度器、核心引擎|#F3E5F5(浅紫)| |**椭圆/圆形**|资源池/知识库|知识库、经验池、数据存储|#FFF9C4(浅黄)| |**菱形**|判断/条件节点|决策点、分支条件|#FFE0B2(浅橙)| |**云形**|外部环境/边界|外部系统、环境输入|#F5F5F5(浅灰)| |**八边形**|约束/规则|原则、规范、限制条件|#FFCDD2(浅红)| #### **组件标注要素** 每个组件必须包含以下标注: ```markdown ┌─────────────────────────────────────┐│ «构造型» ││ ────────────────── ││ 组件名称 ││ ────────────────── ││ 核心属性:属性1, 属性2 ││ ────────────────── ││ 输入→处理→输出 ││ ●○────────○● │(端口)└─────────────────────────────────────┘ ``` **构造型列表**: - `«knowledge»` - 知识模块 - `«capability»` - 能力组件 - `«process»` - 过程/行为 - `«resource»` - 资源/存储 - `«principle»` - 原则/约束 - `«interface»` - 接口/连接点 - `«system»` - 系统/子系统 ### **2.2 能力与功能(Capability)表示法** #### **能力层次结构** ```markdown L1 - 战略能力(Strategic Capability) │ └→ 系统的核心价值主张 │L2 - 核心能力(Core Capability) │ └→ 关键功能模块 │L3 - 基础能力(Basic Capability) └→ 可复用的基础技能 ``` #### **能力描述模板** ```javascript 【能力名称】:[填写能力名称]【能力层级】:L1/L2/L3【触发条件】:何时激活此能力?【输入要素】:需要什么输入?【处理过程】:如何处理?(核心机制)【输出结果】:产生什么输出?【依赖关系】:依赖哪些其他能力?【约束条件】:有什么限制? ``` ### **2.3 行为与动态(Behavior)表示法** #### **行为类型** |**行为类型**|**符号**|**描述**| | --- | --- | --- | |**线性过程**|①→②→③|顺序执行的步骤| |**并行过程**|①⫿②③|同时进行的活动| |**循环过程**|①→②→③↺|迭代反馈的流程| |**条件分支**|①→⟨?⟩→②/③|根据条件选择路径| |**状态转换**|○→●→◎|状态变化序列| #### **状态机表示** ```markdown ┌──────────┐ 触发事件 ┌──────────┐│ 状态A │ ──────────→ │ 状态B ││ [entry] │ [条件]/动作 │ [entry] ││ [do] │ │ [do] ││ [exit] │ │ [exit] │└──────────┘ └──────────┘ ``` ### **2.4 关系与依赖(Relation & Dependency)表示法** #### **关系类型约定** |**关系类型**|**符号**|**线型**|**语义**|**颜色**| | --- | --- | --- | --- | --- | |**信息流**|→|实线箭头|数据/知识传递|#1976D2(蓝)| |**控制流**|⇢|虚线箭头|触发/调用关系|#388E3C(绿)| |**组合**|◆─|实线+实心菱形|强拥有关系|#212121(黑)| |**聚合**|◇─|实线+空心菱形|弱拥有关系|#424242(灰)| |**泛化**|▷─|实线+空心三角|继承/特化|#1976D2(蓝)| |**依赖**|··→|点线箭头|使用/依赖|#757575(灰)| |**反馈**|⇠··|反向点线|反馈/监控|#F57C00(橙)| |**双向**|⟷|双向箭头|双向交互|#7B1FA2(紫)| |**关键路径**|═▶|粗线箭头|主流程|#D32F2F(红)| #### **关系标注要素** 每条关系连接必须标注: 1. **流动内容**:传递的是什么?(如"知识请求"、"决策结果") 1. **流动类型**:信息/能量/物质/控制 1. **多重性**:1..1、1..*、*..* 等 1. **条件**(可选):触发条件 1. **顺序**(可选):执行顺序号 --- ### **2.5 层次与边界(Hierarchical Boundary)表示法** #### **洋葱模型层次** ```markdown ┌─────────────────────────────────────────────┐│ L0: 环境层 (Environment) ││ ┌─────────────────────────────────────────┐ ││ │ L1: 系统层 (System) │ ││ │ ┌─────────────────────────────────────┐│ ││ │ │ L2: 子系统层 (Subsystem) ││ ││ │ │ ┌─────────────────────────────────┐││ ││ │ │ │ L3: 组件层 (Component) │││ ││ │ │ │ ┌─────────────────────────────┐│││││ │ │ │ │ L4: 元素层 (Element) ││││││ │ │ │ └─────────────────────────────┘│││││ │ │ └─────────────────────────────────┘││││ │ └─────────────────────────────────────┘│││ └─────────────────────────────────────────┘│└─────────────────────────────────────────────┘ ``` #### **边界表示** - **外边界**:3px solid,深色,表示系统边界 - **内边界**:2px dashed,浅色,表示子系统边界 - **接口点**:边界上的端口,表示对外接口 ## **三、核心视图类型** ### **3.1 结构视图(Structure View)** **用途**:展示系统的静态结构,回答"由什么组成"的问题 ```javascript 请绘制一个系统结构视图的SVG,要求:**图表标题**:[系统名称]结构模型图**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px**层次结构**:- L1 系统层:顶部居中,大矩形框 * 填充色:#E3F2FD,边框:3px solid #1976D2 * 构造型:«system»- L2 子系统层:第二行,中等矩形框 * 填充色:#E8F5E9,边框:2px solid #4CAF50 * 构造型:«subsystem» * 使用组合关系(实心菱形)连接到系统层- L3 组件层:第三行,小矩形框 * 填充色:#FFF3E0,边框:2px solid #FF9800 * 构造型:«component» * 使用聚合关系(空心菱形)连接到子系统层**结构关系**:- 组合关系:实线+实心菱形,表示强拥有- 聚合关系:实线+空心菱形,表示弱拥有- 关联关系:实线,表示一般关联- 泛化关系:实线+空心三角箭头,表示继承**标注规范**:- 组件名称:16px, 粗体, #212121- 属性列表:14px, 常规, #424242- 构造型:12px, 斜体, #666666**布局原则**:- 从抽象到具体:从上到下- 从整体到部分:从中心向外- 相关组件邻近布置- 避免连接线交叉 ``` ### **3.2 能力视图(Capability View)** **用途**:展示系统的功能能力,回答"能做什么"的问题 ```markdown 请绘制一个系统能力视图的SVG,要求:**图表标题**:[系统名称]能力模型图**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px**能力层次**:- 战略能力层(L1): * 形状:大圆角矩形,填充色#E1BEE7,边框:3px solid #7B1FA2 * 位置:顶部中央 * 内容:核心价值主张、战略目标- 核心能力层(L2): * 形状:中等圆角矩形,填充色#C5CAE9,边框:2px solid #3F51B5 * 位置:第二层,水平排列 * 内容:关键功能描述- 基础能力层(L3): * 形状:小圆角矩形,填充色#B2DFDB,边框:2px solid #009688 * 位置:底层,按组分布 * 内容:基础技能/知识点**能力关系**:- 支撑关系:从下往上的虚线箭头,标注«supports»- 依赖关系:水平虚线箭头,标注«depends»- 协同关系:双向箭头,标注«synergy»- 派生关系:实线箭头,标注«derives»**能力属性**:每个能力块显示:- 能力名称(粗体)- 成熟度等级(1-5星或百分比)- 关键输入/输出- 依赖数量**布局原则**:- 战略能力居中突出- 核心能力环绕分布- 基础能力按功能分组- 用颜色深浅表示重要程度 ``` ### **3.3 行为视图(Behavior View)** **用途**:展示系统的动态行为,回答"如何运作"的问题 ```markdown 请绘制一个系统行为视图的SVG,要求:**图表标题**:[系统名称]行为模型图**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px**过程表示**:活动节点:- 形状:圆角矩形- 填充色:#E8F5E9,边框:2px solid #4CAF50- 内容:活动名称 + 简要描述决策节点:- 形状:菱形- 填充色:#FFF3E0,边框:2px solid #FF9800- 内容:判断条件并行分叉/汇合:- 形状:粗黑线(水平或垂直)- 宽度:3px控制节点:- 初始:实心圆,填充#4CAF50- 结束:双圆环,外圈#F44336- 连接点:小圆圈,填充#757575**流程控制**:- 控制流:实线箭头,stroke-width: 2px, #212121- 数据流:实线箭头+数据标签,#1976D2- 异常流:虚线箭头,#F44336**泳道表示**(可选):- 垂直分隔线划分责任区域- 每个泳道顶部标注责任主体- 跨泳道的活动用特殊标记**时序标注**:- 活动节点内标注执行顺序号:①②③- 关键路径用粗线标注- 时间约束用标签说明**布局原则**:- 主流程从左到右或从上到下- 分支在主流程两侧展开- 异常处理流程在下方或右侧- 反馈回路清晰可见 ``` ### **3.4 关系视图(Relation View)** **用途**:展示组件间的交互关系,回答"如何关联"的问题 ```markdown 请绘制一个系统关系视图的SVG,要求:**图表标题**:[系统名称]关系模型图**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px**组件表示**:- 所有参与交互的组件用统一形状- 形状:圆角矩形- 大小:根据重要程度调整- 颜色:根据类型区分**关系分类**:结构关系:- 组合:实线+实心菱形,#212121- 聚合:实线+空心菱形,#424242- 关联:实线,#616161- 泛化:实线+空心三角,#1976D2交互关系:- 信息流:蓝色实线箭头,标注数据类型- 控制流:绿色虚线箭头,标注触发条件- 反馈流:橙色点线箭头,标注反馈内容依赖关系:- 使用依赖:虚线箭头+«use»- 实现依赖:虚线箭头+«realize»- 细化依赖:虚线箭头+«refine»**交互矩阵**(可选):在图的一角显示N×N交互矩阵,标注组件间是否有直接交互**关系属性**:每条关系线标注:- 关系名称/类型- 流动内容- 多重性(如 1..*, 0..1)- 方向性**布局原则**:- 高耦合组件靠近放置- 核心组件居中- 外围组件按功能分组- 尽量减少连接线交叉- 使用曲线避免遮挡 ``` ### **3.5 集成视图(Integration View)** **用途**:展示系统的整体架构机制,回答"如何集成"的问题 ```markdown 请绘制一个系统集成视图的SVG,要求:**图表标题**:[系统名称]集成架构图**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px**分层架构**:环境层(最外层):- 外边框:3px dashed #9E9E9E- 包含:外部系统、用户、环境因素- 使用云形表示系统边界:- 边框:3px solid #1976D2- 标题:系统名称 + «system»处理层(中间层):- 包含:核心处理组件- 按功能横向分组- 填充色:#E3F2FD支撑层(底层):- 包含:基础设施、资源池- 横向排列- 填充色:#ECEFF1**接口定义**:- 对外接口:边界上的端口,填充色#FFF3E0- 对内接口:组件间的连接点- 接口类型:请求型●、提供型○、事件型◆**集成模式**:- 数据集成:共享数据存储- 接口集成:点对点连接- 事件集成:发布-订阅模式- 流程集成:工作流编排**关键路径**:- 主数据流:粗蓝色箭头- 主控制流:粗绿色箭头- 关键依赖:粗红色虚线**布局原则**:- 从外到内:环境→系统→子系统→组件- 从上到下:输入→处理→输出- 从左到右:数据流方向- 突出核心组件和关键路径 ``` ## **四、知识体系专项建模** ### **4.1 知识体系结构模型** ```markdown 请绘制一个知识体系结构模型的SVG,要求:**系统信息**:- 系统名称:[知识体系名称]- 建模目标:构建完整的知识架构,理解知识间的关联**画布规格**:- 尺寸:1600px × 1200px- 背景:白色(#FFFFFF)- 边距:80px**知识层次结构**:元知识层(Meta Knowledge):- 位置:顶部- 形状:六边形- 内容:认知方法论、思维模式、学习方法- 填充色:#E1BEE7,边框:3px solid #7B1FA2领域知识层(Domain Knowledge):- 位置:第二层- 形状:大矩形,内部分区- 内容:专业领域的核心知识体系- 填充色:#C5CAE9,边框:2px solid #3F51B5应用知识层(Applied Knowledge):- 位置:第三层- 形状:圆角矩形- 内容:实践方法、工具技能、案例经验- 填充色:#B2DFDB,边框:2px solid #009688隐性知识层(Tacit Knowledge):- 位置:底层- 形状:云形/模糊边界- 内容:经验直觉、默会知识、个人洞察- 填充色:#FFECB3,边框:2px dashed #FFA000**知识关系**:- 抽象化:从下往上,«abstract»- 实例化:从上往下,«instance»- 关联:水平连接,«related»- 依赖:虚线箭头,«depends»- 冲突:红色虚线,«conflict»**知识属性标注**:- 成熟度:⭐⭐⭐(1-5星)- 应用频率:高/中/低- 更新周期:天/周/月/年- 来源类型:书籍/实践/思考**特殊元素**:- 知识空白:虚线框,标注"待补充"- 核心概念:加粗边框+星号标记- 争议观点:问号标记**布局要求**:- 按知识层次垂直分布- 同层知识水平排列- 相关知识邻近放置- 使用分区线组织知识群 ``` ### **4.2 能力框架模型** ```markdown 请绘制一个能力框架模型的SVG,要求:**系统信息**:- 系统名称:[能力框架名称]- 建模目标:构建完整的能力地图,理解能力的依赖和发展路径**画布规格**:- 尺寸:1600px × 1200px- 背景:白色(#FFFFFF)- 边距:80px**能力架构**:核心能力环(Core):- 位置:中央- 形状:圆形/椭圆- 内容:最核心的1-3个能力- 填充色:#FFCDD2,边框:4px solid #D32F2F支撑能力层(Supporting):- 位置:围绕核心- 形状:扇形分区- 内容:支撑核心能力的关键能力- 填充色:#F3E5F5,边框:2px solid #7B1FA2扩展能力层(Extended):- 位置:外围- 形状:矩形模块- 内容:可选的增强能力- 填充色:#E3F2FD,边框:2px solid #2196F3基础能力层(Foundation):- 位置:最外围/底部- 形状:横向条带- 内容:通用基础能力- 填充色:#E8F5E9,边框:2px solid #4CAF50**能力成熟度**:用颜色深浅或进度条表示:- 入门级(L1):25%填充- 熟练级(L2):50%填充- 精通级(L3):75%填充- 专家级(L4):100%填充**能力关系**:- 依赖关系:A→B 表示A依赖B- 协同关系:A⟷B 表示互相增强- 发展路径:虚线箭头,标注发展顺序- 替代关系:双向虚线,标注可替代**能力属性**:每个能力块显示:- 能力名称- 当前水平(进度条)- 目标水平- 发展优先级(P1/P2/P3)**布局原则**:- 核心能力居中突出- 相关能力邻近- 依赖关系清晰可见- 发展路径从基础到高级 ``` ### **4.3 框架机制模型** ```markdown 请绘制一个框架机制模型的SVG,要求:**系统信息**:- 系统名称:[框架名称]- 建模目标:理解框架的内在运作机制**画布规格**:- 尺寸:1600px × 1200px- 背景:白色(#FFFFFF)- 边距:80px**框架结构**:输入层(Input):- 位置:左侧/顶部- 形状:带箭头的矩形- 内容:输入要素列表- 填充色:#C8E6C9核心处理(Core Processing):- 位置:中央- 形状:大矩形,内含多个子组件- 内容:框架的核心处理逻辑- 填充色:#E3F2FD,边框:3px solid #1976D2子组件需分别表示:- 处理单元:圆角矩形- 决策点:菱形- 缓存/存储:圆柱形- 协调器:六边形输出层(Output):- 位置:右侧/底部- 形状:带箭头的矩形- 内容:输出结果列表- 填充色:#BBDEFB约束/规则层(Constraints):- 位置:顶部横跨- 形状:八边形/横条- 内容:框架运行的规则和约束- 填充色:#FFECB3反馈环路:- 从输出到输入的虚线箭头- 从处理到决策的反馈- 标注反馈内容和触发条件**机制表示**:处理流程:① 输入接收 → ② 预处理 → ③ 核心处理 → ④ 后处理 → ⑤ 输出内部循环:用闭合箭头路径表示迭代过程状态变化:用状态机符号表示关键状态转换**关键路径**:- 正常路径:粗蓝色实线- 异常路径:红色虚线- 优化路径:绿色实线**标注要求**:- 每个处理步骤标注:输入→处理→输出- 决策点标注:条件和分支- 接口标注:数据格式和协议- 性能指标:关键节点标注延迟/吞吐量 ``` ## **五、高级建模技巧** ### **5.1 多视图关联** 当系统需要多个视图表达时,确保视图间的关联: **视图关联矩阵**: |**源视图**|**目标视图**|**关联类型**|**一致性要求**| | --- | --- | --- | --- | |结构视图|能力视图|组件→能力|每个组件至少提供一个能力| |能力视图|行为视图|能力→实现|每个能力有对应的行为| |行为视图|关系视图|活动→交互|活动间交互在关系视图中体现| |关系视图|集成视图|接口→集成|所有接口在集成视图中定义| ### **5.2 追溯性建模** 建立从概念到实现的完整追溯链: ```markdown 概念层 功能层 实现层 验证层┌────────┐ ┌────────┐ ┌────────┐ ┌────────┐│ 需求/ │ → │ 能力/ │ → │ 组件/ │ → │ 测试/ ││ 目标 │ │ 功能 │ │ 行为 │ │ 验证 │└────────┘ └────────┘ └────────┘ └────────┘ │ │ │ │ └──────────────┴──────────────┴──────────────┘ 追溯链 ``` ### **5.3 涌现性表达** 表达组件交互产生的涌现特性: - **涌现属性**:用特殊标记(⚡)标注 - **涌现条件**:标注产生涌现的交互模式 - **涌现度量**:量化涌现程度 ## **六、SVG绘制提示语模板** ### **6.1 通用建模提示语** ```markdown 请绘制一个基于系统工程思想的[视图类型]SVG图,要求:**系统信息**:- 系统名称:[系统名称]- 建模目标:[描述建模目的,如"理解XX的内在机制"]- 视图类型:[结构视图/能力视图/行为视图/关系视图/集成视图]- 抽象层次:[系统级/子系统级/组件级]**画布规格**:- 尺寸:1400px × 1000px- 背景:白色(#FFFFFF)- 边距:60px- 网格:可选,浅灰色辅助线**组件列表**:1. [组件1名称] - 构造型:«XXX» - 形状:[形状类型] - 属性:[属性1], [属性2] - 功能:[输入]→[处理]→[输出] 2. [组件2名称] - 构造型:«XXX» - 形状:[形状类型] - 属性:[属性1], [属性2] - 功能:[输入]→[处理]→[输出]【继续列出所有组件...】**关系定义**:- [组件1] → [组件2]: * 关系类型:[信息流/控制流/依赖/...] * 流动内容:[描述传递的内容] * 触发条件:[可选]- [组件2] ⟷ [组件3]: * 关系类型:[双向交互] * 交互内容:[描述]【继续定义所有关系...】**层次结构**:描述组件间的层次包含关系:- L1: [顶层系统] - L2: [子系统1], [子系统2] - L3: [组件1], [组件2]**关键流程**:描述一个完整的业务/处理场景:① [步骤1] → ② [步骤2] → ③ [步骤3] → ...**视觉规范**:- 组件颜色:根据类型使用规定颜色- 关系线型:根据类型使用规定样式- 字体: * 标题:20px, Arial, 粗体 * 组件名称:16px, Arial, 粗体 * 属性:14px, Arial, 常规 * 标签:12px, Arial, 斜体**布局要求**:- [描述期望的布局方式]- [描述主要流向]- [特殊布局要求]**质量检查**:- [ ] 所有组件都有明确的构造型- [ ] 所有关系都有明确的类型和标注- [ ] 层次结构清晰- [ ] 布局整洁,无交叉- [ ] 关键路径突出显示**图例说明**:- 右下角:组件类型图例- 左下角:关系类型图例- 包含颜色编码说明请确保生成的SVG图符合系统工程建模规范,能够清晰表达系统的内在机制。 ``` ### **6.2 知识体系快速建模提示语** ```markdown 请为【知识体系名称】绘制一个知识架构SVG图:**知识体系描述**:[一段话描述这个知识体系的核心内容和目的]**核心知识点**:1. [知识点1] - [简要说明]2. [知识点2] - [简要说明]3. [知识点3] - [简要说明]...**知识间关系**:- [A] → [B]:[关系说明,如"A是B的理论基础"]- [C] ← [D]:[关系说明]- [E] ⟷ [F]:[关系说明,如"互相支撑"]**层次要求**:按照 元知识→领域知识→应用知识→隐性知识 的层次组织**期望布局**:[描述期望的布局,如"树形结构"、"环形结构"、"矩阵结构"]请生成一个1400×1000的SVG图,使用规定的颜色方案和形状约定。 ``` ### **6.3 能力框架快速建模提示语** ```markdown 请为【能力框架名称】绘制一个能力地图SVG图:**能力框架目标**:[描述这个能力框架要达成的目标]**核心能力列表**:[按层次列出所有能力]- 核心层: * [能力1](当前水平:X/10,目标:Y/10)- 支撑层: * [能力2](当前水平:X/10) * [能力3](当前水平:X/10)- 基础层: * [能力4] * [能力5]**能力依赖关系**:[描述能力间的依赖]**发展路径**:[描述能力发展的推荐顺序]请生成一个体现能力层次和依赖关系的SVG图。 ``` ## **七、质量检查清单** ### **7.1 结构完整性** - [ ] 所有关键组件都已识别 - [ ] 组件的构造型标识正确 - [ ] 层次结构清晰合理 - [ ] 边界定义明确 ### **7.2 能力明确性** - [ ] 每个组件的能力/功能已描述 - [ ] 输入/输出定义清晰 - [ ] 能力层次划分合理 - [ ] 依赖关系完整 ### **7.3 行为正确性** - [ ] 关键流程已建模 - [ ] 状态转换逻辑正确 - [ ] 触发条件明确 - [ ] 异常处理考虑 ### **7.4 关系清晰性** - [ ] 所有交互路径已绘制 - [ ] 关系类型使用正确 - [ ] 流动内容已标注 - [ ] 方向性明确 ### **7.5 集成合理性** - [ ] 接口定义一致 - [ ] 依赖链完整 - [ ] 关键路径突出 - [ ] 整体架构合理 ### **7.6 可读性** - [ ] 非专业人员能理解70%以上 - [ ] 布局整洁不拥挤 - [ ] 颜色使用一致 - [ ] 图例说明完整 ## **八、应用场景** 本建模规范适用于以下场景: - **个人知识体系**:构建个人的知识框架和学习地图 - **能力发展规划**:制定能力提升计划和发展路径 - **思维模型建设**:可视化思维模式和决策框架 - **组织架构设计**:设计团队结构和协作机制 - **业务流程优化**:分析和优化业务流程 - **系统架构设计**:设计软件或技术系统架构 - **概念模型构建**:将抽象概念具体化、可视化 - **问题分析框架**:构建分析复杂问题的框架 ## **九、结语** 本建模规范融合了MBSE(基于模型的系统工程)的严谨性和SBR(结构-行为-关系)建模法的直观性,提供了一套完整的系统架构可视化建模方法。 通过五维建模框架(结构、能力、行为、关系、依赖),可以全面把握任何复杂系统的内在机制。无论是构建个人知识体系、规划能力发展路径,还是设计组织架构、分析业务流程,都可以运用本规范进行系统化建模。 > **核心理念**:任何复杂事物都是一个系统,系统的特性由其组件结构、组件能力、组件行为、组件关系和组件依赖共同决定。理解了这五个维度,就理解了事物的本质。 今天分享就到这里。希望对大家有所启发。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册