首页 文章 精选 留言 我的

精选列表

搜索[architecture],共2242篇文章
优秀的个人博客,低调大师

Architecture -- Lifecycle

1). 简介 生命周期感知组件执行操作以响应另一个组件(例如活动和片段)的生命周期状态的更改。 这些组件可帮助您生成更易于组织且通常更轻量级的代码,这些代码更易于维护。 一种常见的模式是在活动和片段的生命周期方法中实现依赖组件的操作。 但是,这种模式导致代码组织不良以及错误的增加。 通过使用生命周期感知组件,您可以将依赖组件的代码移出生命周期方法并移入组件本身。 2). 依赖 // ViewModel and LiveData implementation "android.arch.lifecycle:extensions:$lifecycle_version" // alternatively - just ViewModel implementation "android.arch.lifecycle:viewmodel:$lifecycle_version" // use -ktx for Kotlin // alternatively - just LiveData implementation "android.arch.lifecycle:livedata:$lifecycle_version" // alternatively - Lifecycles only (no ViewModel or LiveData). // Support library depends on this lightweight import implementation "android.arch.lifecycle:runtime:$lifecycle_version" annotationProcessor "android.arch.lifecycle:compiler:$lifecycle_version" // use kapt for Kotlin // alternately - if using Java8, use the following instead of compiler implementation "android.arch.lifecycle:common-java8:$lifecycle_version" // optional - ReactiveStreams support for LiveData implementation "android.arch.lifecycle:reactivestreams:$lifecycle_version" // optional - Test helpers for LiveData testImplementation "android.arch.core:core-testing:$lifecycle_version" 3). 解决问题 主要解决MVP模式时Activity和Fragment声明周期问题 4). 原MVP写法 Presenter接口 interface IPresenter { fun onCreate() fun onStart() fun onResume() fun onPause() fun onStop() fun onDestroy() } Presenter实现 class CustomPresenter : IPresenter { companion object { private val TAG = CustomPresenter::class.java.simpleName } override fun onCreate() { Log.e(TAG, "-- onCreate") } override fun onStart() { Log.e(TAG, "-- onStart") } override fun onResume() { Log.e(TAG, "-- onResume") } override fun onPause() { Log.e(TAG,"-- onPause") } override fun onStop() { Log.e(TAG, "-- onStop") } override fun onDestroy() { Log.e(TAG, "-- onDestroy") } } Activity代码 class CustomLifeCycleActivity : AppCompatActivity() { private lateinit var presenter: IPresenter companion object { private val TAG = CustomLifeCycleActivity::class.java.simpleName } override fun onCreate(savedInstanceState: Bundle?) { super.onCreate(savedInstanceState) setContentView(R.layout.activity_custom_life_cyclle) presenter = CustomPresenter() Log.e(TAG, "-- onCreate") presenter.onCreate() } override fun onStart() { super.onStart() Log.e(TAG, "-- onStart") presenter.onStart() } override fun onResume() { super.onResume() Log.e(TAG, "-- onResume") presenter.onResume() } override fun onPause() { super.onPause() Log.e(TAG, "-- onPause") presenter.onPause() } override fun onStop() { super.onStop() Log.e(TAG, "-- onStop") presenter.onStop() } override fun onDestroy() { super.onDestroy() Log.e(TAG, "-- onDestroy") presenter.onDestroy() } } 打印结果: 图1.png 5). Lifecycle写法 Presenter接口 interface IPresenter : LifecycleObserver { @OnLifecycleEvent(Lifecycle.Event.ON_CREATE) fun onCreate(@NotNull owner: LifecycleOwner) @OnLifecycleEvent(Lifecycle.Event.ON_DESTROY) fun onDestroy(@NotNull owner: LifecycleOwner) @OnLifecycleEvent(Lifecycle.Event.ON_ANY) fun onLifecycleChanged(@NotNull owner: LifecycleOwner) } Presenter实现 class SpecialPresenter : IPresenter { companion object { private val TAG = SpecialPresenter::class.java.simpleName } override fun onCreate(owner: LifecycleOwner) { Log.e(TAG, "onCreate") } override fun onDestroy(owner: LifecycleOwner) { Log.e(TAG, "onDestroy") } override fun onLifecycleChanged(owner: LifecycleOwner) { Log.e(TAG, "onLifecycleChanged") } } Activity代码 class SpecialLifeCycleActivity : AppCompatActivity() { override fun onCreate(savedInstanceState: Bundle?) { super.onCreate(savedInstanceState) setContentView(R.layout.activity_special_life_cycle) val presenter = SpecialPresenter() // 添加观察者 lifecycle.addObserver(presenter) } } 打印结果: 图2.png 6). 组件原理 原理图.png 7). 时序图 时序图.png 8). Event枚举 public enum Event { /** * Constant for onCreate event of the {@link LifecycleOwner}. */ ON_CREATE, /** * Constant for onStart event of the {@link LifecycleOwner}. */ ON_START, /** * Constant for onResume event of the {@link LifecycleOwner}. */ ON_RESUME, /** * Constant for onPause event of the {@link LifecycleOwner}. */ ON_PAUSE, /** * Constant for onStop event of the {@link LifecycleOwner}. */ ON_STOP, /** * Constant for onDestroy event of the {@link LifecycleOwner}. */ ON_DESTROY, /** * An {@link Event Event} constant that can be used to match all events. */ ON_ANY } 9). 原文链接 10). 代码下载

优秀的个人博客,低调大师

Architecture -- Room

1). 简介 Room persistence库为SQLite提供了一个抽象层,以便在利用SQLite的全部功能的同时实现更强大的数据库访问。 该库可帮助您在运行应用程序的设备上创建应用程序数据的缓存。 此缓存作为应用程序的唯一事实来源,允许用户在应用程序中查看关键信息的一致副本,无论用户是否具有Internet连接。 2). 依赖 buildscript { ext.room_version = "1.1.0" } dependencies { // Room 使用 implementation "android.arch.persistence.room:runtime:$room_version" annotationProcessor "android.arch.persistence.room:compiler:$room_version" // optional - RxJava support for Room implementation "android.arch.persistence.room:rxjava2:$room_version" // optional - Guava support for Room, including Optional and ListenableFuture implementation "android.arch.persistence.room:guava:$room_version" // Test helpers testImplementation "android.arch.persistence.room:testing:$room_version" // Kotlin kapt "android.arch.persistence.room:compiler:$room_version" } 3). 数据实体类 * 实体类 * Created by mazaiting on 2018/7/25. */ @Entity data class User( @PrimaryKey val uid: Int, @ColumnInfo(name = "first_name") var firstName: String, @ColumnInfo(name = "last_name") var lastName: String ) 4). 用户DAO类 /** * 用户DAO类 * Created by mazaiting on 2018/7/25. */ @Dao interface UserDao { @Query("SELECT * FROM user") fun getAll(): List<User> @Query("SELECT * FROM user WHERE uid IN (:userIds)") fun loadAllByIds(userIds: IntArray): List<User> @Query("SELECT * FROM user WHERE first_name LIKE :first AND last_name LIKE :last LIMIT 1") fun findByName(first: String, last: String): User @Insert fun insertAll(users: List<User>) // 可变参数 // fun insertAll(vararg users: User) @Delete fun delete(user: User) @Update fun update(user: User) } 5). 数据库类 /** * 数据库类 * Created by mazaiting on 2018/7/25. */ @Database(entities = arrayOf(User::class), version = 1) abstract class AppDatabase : RoomDatabase() { // 获取DAO abstract fun userDao(): UserDao } 6). 创建数据库 btn_create_db.setOnClickListener { val db = Room.databaseBuilder(applicationContext, AppDatabase::class.java, "TEST").build() userDao = db.userDao() } 7). 新增数据 对数据的操作必须在子线程中 btn_insert.setOnClickListener { Thread(Runnable { val users = (0..10).map { User(it, "first$it", "last$it") } userDao.insertAll(users) }).start() } 8). 查询数据 btn_find_all.setOnClickListener { Thread(Runnable { userDao.getAll().forEach { L.e(it.toString()) } }).start() } btn_find_id.setOnClickListener { Thread(Runnable { userDao.loadAllByIds(intArrayOf(0, 1, 2, 3, 4)).forEach { L.e(it.toString()) } }).start() } btn_find_name.setOnClickListener { Thread(Runnable { L.e(userDao.findByName("first1", "last1").toString()) }).start() } 9). 更新数据 btn_update.setOnClickListener { Thread(Runnable { val user = userDao.findByName("first1", "last1") user.firstName = "ma" user.lastName = "zaiting" userDao.update(user) userDao.loadAllByIds(intArrayOf(1)).forEach { L.e(it.toString()) } }).start() } 10). 删除数据 btn_delete.setOnClickListener { Thread(Runnable { userDao.delete(userDao.loadAllByIds(intArrayOf(0))[0]) }).start() } 11). 原文地址 12). 代码下载

优秀的个人博客,低调大师

Architecture -- LiveData

1). 简介 LiveData是一个可观察的数据持有者类。 与常规observable不同,LiveData是生命周期感知的,这意味着它尊重其他应用程序组件的生命周期,例如活动,片段或服务。 此感知确保LiveData仅更新处于活动生命周期状态的应用程序组件观察者。 2). 依赖 官方依赖 dependencies { def lifecycle_version = "1.1.1" // ViewModel and LiveData implementation "android.arch.lifecycle:extensions:$lifecycle_version" // alternatively - just ViewModel implementation "android.arch.lifecycle:viewmodel:$lifecycle_version" // use -ktx for Kotlin // alternatively - just LiveData implementation "android.arch.lifecycle:livedata:$lifecycle_version" // alternatively - Lifecycles only (no ViewModel or LiveData). // Support library depends on this lightweight import implementation "android.arch.lifecycle:runtime:$lifecycle_version" annotationProcessor "android.arch.lifecycle:compiler:$lifecycle_version" // use kapt for Kotlin // alternately - if using Java8, use the following instead of compiler implementation "android.arch.lifecycle:common-java8:$lifecycle_version" // optional - ReactiveStreams support for LiveData implementation "android.arch.lifecycle:reactivestreams:$lifecycle_version" // optional - Test helpers for LiveData testImplementation "android.arch.core:core-testing:$lifecycle_version" } 此处在使用时,我没有添加依赖,Android Studio3.0 项目中已经默认依赖 3). 优点 确保UI符合数据状态 没有内存泄漏 活动停止不会崩溃 不需要手动处理声明周期 始终保持最新数据 适当的配置更改 共享资源 4). 创建LiveData NameViewModel class NameViewModel : ViewModel() { // Create LiveData Objects var currentName : MutableLiveData<String>? = null get() { if (null == field) { currentName = MutableLiveData() } return field } } LiveDataActivity // 初始化ViewModel model = ViewModelProvider.AndroidViewModelFactory.getInstance(application).create(NameViewModel::class.java) // 创建观察者更新UI val nameObserver = Observer<String> { name: String? -> tv_show.text = name } // 观察LiveData model.currentName?.observe(this, nameObserver) 5). 修改 // 修改文本 btn_change.setOnClickListener { val name = "John" // 修改数据 model.currentName?.value = name } 6). 转换LiveData LiveData<User> userLiveData = ...; LiveData<String> userName = Transformations.map(userLiveData, user -> { user.name + " " + user.lastName }); 7). 原文地址 8). 代码下载

优秀的个人博客,低调大师

Architecture -- ViewModel

1). 简介 ViewModel类旨在以生命周期意识的方式存储和管理UI相关数据。 ViewModel类允许数据在配置更改(例如屏幕旋转)后继续存在。 Android框架管理UI控制器的生命周期,例如活动和片段。 框架可以决定销毁或重新创建UI控制器以响应完全不受您控制的某些用户动作或设备事件。 2). 依赖 官方依赖 dependencies { def lifecycle_version = "1.1.1" // ViewModel and LiveData implementation "android.arch.lifecycle:extensions:$lifecycle_version" // alternatively - just ViewModel implementation "android.arch.lifecycle:viewmodel:$lifecycle_version" // use -ktx for Kotlin // alternatively - just LiveData implementation "android.arch.lifecycle:livedata:$lifecycle_version" // alternatively - Lifecycles only (no ViewModel or LiveData). // Support library depends on this lightweight import implementation "android.arch.lifecycle:runtime:$lifecycle_version" annotationProcessor "android.arch.lifecycle:compiler:$lifecycle_version" // use kapt for Kotlin // alternately - if using Java8, use the following instead of compiler implementation "android.arch.lifecycle:common-java8:$lifecycle_version" // optional - ReactiveStreams support for LiveData implementation "android.arch.lifecycle:reactivestreams:$lifecycle_version" // optional - Test helpers for LiveData testImplementation "android.arch.core:core-testing:$lifecycle_version" } 但在此处我在Android Studio中未添加任何依赖,lifecyle包在Android Studio3.0之后就默认依赖了 3). 实现 /** * 自定义ViewModel * Created by mazaiting on 2018/7/25. */ class MyViewModel : ViewModel() { var users: MutableLiveData<List<User>>? = null get() { if (null == field) { users = MutableLiveData() loadUsers() } return field } /** * 加载数据 */ private fun loadUsers() { val userList = arrayListOf<User>() (0..10).map { userList.add(User("first$it", "last$it")) } users?.value = userList } } 4). 使用 btn_model_get_data.setOnClickListener { val model: MyViewModel = ViewModelProvider.AndroidViewModelFactory.getInstance(application).create(MyViewModel::class.java) model.users?.observe(this, Observer { users -> users?.forEach { L.e(it.toString()) } }) } 5). 解决的问题 解决Activity横竖屏切换时数据丢失的问题 简化Fragment之间数据传递,数据冗余的问题 6). 原文地址 7). 代码下载

优秀的个人博客,低调大师

Architecture -- WorkManager

1. WorkManager 1). 简介 其实就是"管理一些要在后台工作的任务, -- 即使你的应用没启动也能保证任务能被执行",WorkManager在底层, 会根据你的设备情况, 选用JobScheduler, Firebase的JobDispatcher, 或是AlarmManager。WorkManager并不是为了那种在应用内的后台线程而设计出来的. 这种需求你应该使用ThreadPool。 2). 引入 kolin # Android Studio 3.0, 3.0以下版本请使用complie ext.work_version = "1.0.0-alpha02" // WorkManager implementation "android.arch.work:work-runtime:$work_version" // use -ktx for Kotlin // optional - Firebase JobDispatcher support implementation "android.arch.work:work-firebase:$work_version" // optional - Test helpers androidTestImplementation "android.arch.work:work-testing:$work_version" java # 必须加入 implementation "android.arch.work:work-runtime:1.0.0-alpha01" 2. 用法 1). 执行一次的任务 PullWorker.kt /** * Pull 任务 * 创建步骤: * 1. 继承Worker类 * 2. 重写doWork()方法 * Created by mazaiting on 2018/6/6. */ class PullWorker : Worker() { override fun doWork(): WorkerResult { // 模拟设置页面中的"是否接受推送"是否被勾选 val isOkay = this.inputData.getBoolean("key_accept_bg_work", false) // 判断是否推送 if (isOkay) { // 模拟长时间工作 Thread.sleep(5000) // 获取数据 val pulledResult = startPull() // 设置输出数据 val output = Data.Builder().putString("key_pulled_result", pulledResult).build() // 存放数据 outputData = output // 返回成功 return WorkerResult.SUCCESS } else { // 返回失败 return WorkerResult.FAILURE } } /** * 开始推送 */ private fun startPull(): String { return "[worker] pull messages from backend." } } PullEngine.kt /** * Pull 引擎 * Created by mazaiting on 2018/6/6. */ class PullEngine { fun scheduleOneTimeWork(context: Context) { // 设置任务,执行一次 val pullRequest = OneTimeWorkRequestBuilder<PullWorker>() .setInputData( Data.Builder() .putBoolean("key_accept_bg_work", true) .build() ) .build() WorkManager.getInstance().enqueue(pullRequest) // 将请求入列 WorkManager.getInstance().enqueue(pullRequest) // 获取请求ID val pullRequestId = pullRequest.id // 存在SharedPreference中 PreferenceManager .getDefaultSharedPreferences(context) .edit() .putString("pullId", pullRequestId.toString()) .apply() } } MainApplication.kt(注意在AndroidManifest.xml文件中配置) class MainApplication : Application() { override fun onCreate() { super.onCreate() // 任务执行一次 PullEngine().scheduleOneTimeWork(this.applicationContext) } } MainActivity.kt class MainActivity : AppCompatActivity() { override fun onCreate(savedInstanceState: Bundle?) { super.onCreate(savedInstanceState) setContentView(R.layout.activity_main) // UUID实现了Serializable接口,能由toString(),fromString()与String互转 val uuid = UUID.fromString( PreferenceManager.getDefaultSharedPreferences(this.applicationContext) .getString("pullId", "") ) WorkManager.getInstance() // 获取状态ID .getStatusById(uuid) // 观察数据 .observe(this, Observer<WorkStatus>{ status -> if (null != status && status.state.isFinished) { val pulledResult = status.outputData.getString("key_pulled_result","") Log.e("MainActivity", pulledResult) } }) } } 打印结果 图1.png 2). 任务设置约束 fun scheduleOneTimeWork(context: Context) { val constraints = Constraints.Builder() // 负荷 .setRequiresCharging(true) .build() // 设置任务,执行一次 val pullRequest = OneTimeWorkRequestBuilder<PullWorker>() // 设置约束 .setConstraints(constraints) // 输入数据 .setInputData( Data.Builder() .putBoolean("key_accept_bg_work", true) .build() ) .build() // 将请求入列 WorkManager.getInstance().enqueue(pullRequest) // 获取请求ID val pullRequestId = pullRequest.id // 存在SharedPreference中 PreferenceManager .getDefaultSharedPreferences(context) .edit() .putString("pullId", pullRequestId.toString()) .apply() } 3). 取消任务 // 获取请求ID val pullRequestId = pullRequest.id // 取消任务 WorkManager.getInstance().cancelWorkById(pullRequestId) 4). 任务链 WorkManager.getInstance() .beginWith(workA) // Note: WorkManager.beginWith() returns a // WorkContinuation object; the following calls are // to WorkContinuation methods .then(workB) // FYI, then() returns a new WorkContinuation instance .then(workC) .enqueue() 或 WorkManager.getInstance() // First, run all the A tasks (in parallel): .beginWith(workA1, workA2, workA3) // ...when all A tasks are finished, run the single B task: .then(workB) // ...then run the C tasks (in any order): .then(workC1, workC2) .enqueue() 再或 val chain1 = WorkManager.getInstance() .beginWith(workA) .then(workB) val chain2 = WorkManager.getInstance() .beginWith(workC) .then(workD) val chain3 = WorkContinuation .combine(chain1, chain2) .then(workE) chain3.enqueue() 5). 定时任务 /** * 执行任务 */ fun schedulePeriodicWork(context: Context) { val constraints = Constraints.Builder() // 负荷 .setRequiresCharging(true) .build() // 设置任务执行时长,并设置输入参数 // 长期任务,循环 val pullRequest = PeriodicWorkRequestBuilder<PullWorker>(30, TimeUnit.SECONDS) .setConstraints(constraints) .setInputData( Data.Builder() .putBoolean("key_accept_bg_work", true) .build() ) .build() // 将请求入列 WorkManager.getInstance().enqueue(pullRequest) // 获取请求ID val pullRequestId = pullRequest.id // 存在SharedPreference中 PreferenceManager .getDefaultSharedPreferences(context) .edit() .putString("pullId", pullRequestId.toString()) .apply() } 6). 原文地址 7). 代码下载

优秀的个人博客,低调大师

Application Architecture Guide 2.0

最近比较有时间了,想翻译点有意义的东西和大家分享下同时也提高下自己的英语水平。 有什么不对的地方就请大家拍砖赐教了! 应用程序架构指导2 引言 -J.D. Meier, Alex Homer, David Hill,Jason Taylor,Prashant Bansode, Lonnie Wall, Rob Boucher Jr, Akshay Bogawat 前言 应用程序架构指导的目的是为了改善你在微软平台上开发的效率。主要的读者包括解决方案架构师和团队开发领导。本文为在.Net平台上建立的应用程序提供架构和设计上的指导。本文主要集中在一般类型的应用程序上,把应用程序的功能分割为几层,组件和服务,并介绍它们的共通的设计特点。 这个指导是给予任务的,并且会按照架构和设计的主要特点分别介绍。本文既可以作为参考,也可以的从开始学习到最后。这个指导被分为一下四部分: l第一部分:“基础”提供架构和设计方面的基础知识,一边理解架构设计的技巧和策略。 l第二部分:“设计”提供设计主要的可以用于任何类型的应用程序或者程序中的某一层的原则和实践,包括如何设计联系和服务。 l第三部分:“分层”体统架构和设计方式,以及每一层的实践,包括展示、业务、服务和数据访问。 l第四部分:为每一种应用程序原型提供模式和设计框架,包括服务应用、Web应用、富客户端应用、RIA应用 我们为什么写这个指南 我们写作这个指南是为了完成一下目标: •帮助你在.NET平台下设计更有效率的架构 •帮助你选择正确的技术 •帮助你采取更有效的工程决策 •帮助你选择适合的策略和模式 •帮助你选择相关度模式和实践解决方案。 范围 这个原则提供了在.NET平台下应用程序架构方面的原则、模式和实践。 这是个原则为基础的方式。这个指南的范围请参看(图1) (图1) 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/archive/2008/12/22/1359696.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

HDFS-Architecture剖析

1.概述 从HDFS的应用层面来看,我们可以非常容易的使用其API来操作HDFS,实现目录的创建、删除,文件的上传下载、删除、追加 (Hadoop2.x版本以后开始支持)等功能。然而仅仅局限与代码层面是不够的,了解其实现的具体细节和过程是很有必要的,本文笔者给大家从以下几个方 面进行剖析: Create Delete Read Write Heartbeat 下面开始今天的内容分享。 2.Create 在HDFS上实现文件的创建,该过程并不复杂,Client到NameNode的相关操作,如:修改文件名,创建文件目录或是子目录等,而这些操作只涉及Client和NameNode的交互,过程如下图所示: 我们很熟悉,在我们使用Java 的API去操作HDFS时,我们会在Client端通过调用HDFS的FileSystem实例,去完成相应的功能,这里我们不讨论FileSystem 和DistributedFileSystem和关系,留在以后在阅读这部分源码的时候在去细说。而我们知道,在使用API实现创建这一功能时是非常方便 的,代码如下所示: public static void mkdir(String remotePath) throws IOException { FileSystem fs = FileSystem.get(conf); Path path = new Path(remotePath); fs.create(path); fs.close(); } 在代码层面上,我们只需要获取操作HDFS的实例即可,调用其创建方法去实现目录的创建。但是,其中的实现细节和相关步骤,我们是需要清楚的。 在我们使用HDFS的FileSystem实例时,DistributedFileSystem对象会通过IPC协议调用NameNode上的 mkdir()方法,让NameNode执行具体的创建操作,在其指定的位置上创建新的目录,同时记录该操作并持久化操作记录到日志当中,待方法执行成功 后,mkdir()会返回true表示创建成功来结束创建过程。在此期间,Client和NameNode不需要和DataNode进行数据交互。 3.Delete 在执行创建的过程当中不涉及DataNode的数据交互,而在执行一些较为复杂的操作时,如删除,读、写操作时,需要DataNode来配合完成对应的工作。下面以删除HDFS的文件为突破口,来给大家展开介绍。删除流程图如下所示: 在使用API操作删除功能时,我使用以下代码,输入要删除的目录地址,然后就发现HDFS上我们所指定的删除目录就被删除了,而然其中的删除细节和过程却并不一定清楚,删除代码如下所示: public static void rmr(String remotePath) throws IOException { FileSystem fs = FileSystem.get(conf); Path path = new Path(remotePath); boolean status = fs.delete(path, true); LOG.info("Del status is [" + status + "]"); fs.close(); } 通过阅读这部分删除的API实现代码,代码很简单,调用删除的方法即可完成删除功能。但它是如何完成删除的,下面就为大家这剖析一下这部分内容。 在NameNode执行delete()方法时,它只是标记即将要删除的Block(操作删除的相关记录是被记录并持久化到日志当中的,后续的 相关HDFS操作都会有此记录,便不再提醒),NameNode是被动服务的,它不会主动去联系保存这些数据的Block的DataNode来立即执行删 除。而我们可以从上图中发现,在DataNode向NameNode发送心跳时,在心跳的响应中,NameNode会通过DataNodeCommand 来命令DataNode执行删除操作,去删除对应的Block。而在删除时,需要注意,整个过程当中,NameNode不会主动去向DataNode发送 IPC调用,DataNode需要完成数据删除,都是通过DataNode发送心跳得到NameNode的响应,获取DataNodeCommand的执 行命令。 4.Read 在读取HDFS上的文件时,Client、NameNode以及DataNode都会相互关联。按照一定的顺序来实现读取这一过程,读取过程如下图所示: 通过上图,读取HDFS上的文件的流程可以清晰的知道,Client通过实例打开文件,找到HDFS集群的具体信息(我们需要操作的是 ClusterA,还是ClusterB,需要让Client端知道),这里会创建一个输入流,这个输入流是连接DataNode的桥梁,相关数据的读取 Client都是使用这个输入流来完成的,而在输入流创建时,其构造函数中会通过一个方法来获取NameNode中DataNode的ID和Block的 位置信息。Client在拿到DataNode的ID和Block位置信息后,通过输入流去读取数据,读取规则按照“就近原则”,即:和最近的 DataNode建立联系,Client反复调用read方法,并将读取的数据返回到Client端,在达到Block的末端时,输入流会关闭和该 DataNode的连接,通过向NameNode获取下一个DataNode的ID和Block的位置信息(若对象中为缓存Block的位置信息,会触发 此步骤,否则略过)。然后拿到DataNode的ID和Block的位置信息后,在此连接最佳的DataNode,通过此DataNode的读数据接口, 来获取数据。 另外,每次通过向NameNode回去Block信息并非一次性获取所有的Block信息,需得多次通过输入流向NameNode请求,来获取 下一组Block得位置信息。然而这一过程对于Client端来说是透明的,它并不关系是一次获取还是多次获取Block的位置信息,Client端在完 成数据的读取任务后,会通过输入流的close()方法来关闭输入流。 在读取的过程当中,有可能发生异常,如:节点掉电、网络异常等。出现这种情况,Client会尝试读取下一个Block的位置,同时,会标记该 异常的DataNode节点,放弃对该异常节点的读取。另外,在读取数据的时候会校验数据的完整性,若出现校验错误,说明该数据的Block已损坏,已损 坏的信息会上报给NameNode,同时,会从其他的DataNode节点读取相应的副本内容来完成数据的读取。Client端直接联系 NameNode,由NameNode分配DataNode的读取ID和Block信息位置,NameNode不提供数据,它只处理Block的定位请 求。这样,防止由于Client的并发数据量的迅速增加,导致NameNode成为系统“瓶颈”(磁盘IO问题)。 5.Write HDFS的写文件过程较于创建、删除、读取等,它是比较复杂的一个过程。下面,笔者通过一个流程图来为大家剖析其中的细节,如下图所示: Client端通过实例的create方法创建文件,同时实例创建输出流对象,并通过远程调用,通知NameNode执行创建命令,创建一个新 文件,执行此命令需要进行各种校验,如NameNode是否处理Active状态,被创建的文件是否存在,Client创建目录的权限等,待这些校验都通 过后,NameNode会创建一个新文件,完成整个此过程后,会通过实例将输出流返回给Client。 这里,我们需要明白,在向DataNode写数据的时候,Client需要知道它需要知道自身的数据要写往何处,在茫茫Cluster 中,DataNode成百上千,写到DataNode的那个Block块下,是Client需要清楚的。在通过create创建一个空文件时,输出流会向 NameNode申请Block的位置信息,在拿到新的Block位置信息和版本号后,输出流就可以联系DataNode节点,通过写数据流建立数据流管 道,输出流中的数据被分成一个个文件包,并最终打包成数据包发往数据流管道,流经管道上的各个DataNode节点,并持久化。 Client在写数据的文件副本默认是3份,换言之,在HDFS集群上,共有3个DataNode节点会保存这份数据的3个副本,客户端在发送 数据时,不是同时发往3个DataNode节点上写数据,而是将数据先发送到第一个DateNode节点,然后,第一个DataNode节点在本地保存数 据,同时推送数据到第二个DataNode节点,依此类推,直到管道的最后一个DataNode节点,数据确认包由最后一个DataNode产生,并逆向 回送给Client端,在沿途的DataNode节点在确认本地写入成功后,才会往自己的上游传递应答信息包。这样做的好处总结如下: 分摊写数据的流量:由每个DataNode节点分摊写数据过程的网络流量。 降低功耗:减小Client同时发送多份数据到DataNode节点造成的网络冲击。 另外,在写完一个Block后,DataNode节点会通过心跳上报自己的Block信息,并提交Block信息到NameNode保存。当 Client端完成数据的写入之后,会调用close()方法关闭输出流,在关闭之后,Client端不会在往流中写数据,因而,在输出流都收到应答包 后,就可以通知NameNode节点关闭文件,完成一次正常的写入流程。 在写数据的过程当中,也是有可能出现节点异常。然而这些异常信息对于Client端来说是透明的,Client端不会关心写数据失败后 DataNode会采取哪些措施,但是,我们需要清楚它的处理细节。首先,在发生写数据异常后,数据流管道会被关闭,在已经发送到管道中的数据,但是还没 有收到确认应答包文件,该部分数据被重新添加到数据流,这样保证了无论数据流管道的哪个节点发生异常,都不会造成数据丢失。而当前正常工作的 DateNode节点会被赋予新的版本号,并通知NameNode。即使,在故障节点恢复后,上面只有部分数据的Block会因为Blcok的版本号与 NameNode保存的版本号不一致而被删除。之后,在重新建立新的管道,并继续写数据到正常工作的DataNode节点,在文件关闭 后,NameNode节点会检测Block的副本数是否达标,在未达标的情况下,会选择一个新的DataNode节点并复制其中的Block,创建新的副 本。这里需要注意的是,DataNode节点出现异常,只会影响一个Block的写操作,后续的Block写入不会收到影响。 6.Heartbeat 前面说过,NameNode和DataNode之间数据交互,是通过DataNode节点向NameNode节点发送心跳来获取NameNode的操作指令。心跳发送之前,DataNode需要完成一些步骤之后,才能发送心跳,流程图如下所示: 从上图来看,首先需要向NameNode节点发送校验请求,检测是否NameNode节点和DataNode节点的HDFS版本是否一致(有可 能NameNode的版本为2.6,DataNode的版本为2.7,所以第一步需要校验版本)。在版本校验结束后,需要向NameNode节点注册,这 部分的作用是检测该DataNode节点是否属于NameNode节点管理的成员之一,换言之,ClusterA的DataNode节点不能直接注册到 ClusterB的NameNode节点上,这样保证了整个系统的数据一致性。在完成注册后,DataNode节点会上报自己所管理的所有的Block信 息到NameNode节点,帮助NameNode节点建立HDFS文件Block到DataNode节点映射关系(即保存Meta),在完成此流程之后, 才会进入到心跳上报流程。 另外,如果NameNode节点长时间接收不到DataNode节点到心跳,它会认为该DataNode节点的状态处理Dead状态。如果 NameNode有些命令需要DataNode配置操作(如:前面的删除指令),则会通过心跳后的DataNodeCommand这个返回值,让 DataNode去执行相关指令。 7.总结 简而言之,关于HDFS的创建、删除、读取以及写入等流程,可以一言以蔽之,内容如下: Create:Client直接与NameNode交互,不涉及DataNode Delete:Client将删除指令存于NameNode,DataNode通过心跳获取NameNode的操作指令 Read:Client通过NameNode获取读取数据的位置,找到DataNode节点对应的Block位置读取数据 Write:Client通过NameNode后区写数据的位置,找到DataNode节点对应的Block位置进行写入 8.结束语 这篇博客就和大家分享到这里,如果大家在研究学习的过程当中有什么问题,可以加群进行讨论或发送邮件给我,我会尽我所能为您解答,与君共勉!

优秀的个人博客,低调大师

Android Architecture Componets BasicSample学习

1.创建工程 所有模块依赖于Google,jencenter,maven仓库 allprojects { repositories { jcenter() maven { url 'https://maven.google.com' } mavenCentral() } } gradle版本:gradle-4.1-milestone-1-all gradle 的Android插件版本在3.0.0-beta7 distributionUrl=https\://services.gradle.org/distributions/gradle-4.1-milestone-1-all.zip classpath 'com.android.tools.build:gradle:3.0.0-alpha7' 工程根目录的gradle设置一些变量,表示模块依赖的框架的版本号,方便以后改动,例如 ext { buildToolsVersion = "26.0.1" supportLibVersion = "26.0.2" runnerVersion = "1.0.1" rulesVersion = "1.0.1" espressoVersion = "3.0.1" archLifecycleVersion = "1.0.0-alpha9" archRoomVersion = "1.0.0-alpha9" constrantLayoutVersion="1.0.2" } Module的gradle里 compile 'com.android.support:design:' + rootProject.supportLibVersion compile 'com.android.support:cardview-v7:' + rootProject.supportLibVersion compile 'com.android.support:recyclerview-v7:' + rootProject.supportLibVersion compile 'com.android.support.constraint:constraint-layout:' + rootProject.constrantLayoutVersion 需求分析,效果展示 这个应用就两个界面,打开应用进入首页,刚开始会加载产品数据,数据是从本地数据库查询而来,然后点击任意一项可以进入产品的详情页,详情页包含对产品的评论 效果展示 主目录 src主目录 db db目录 converter 里面放着一个日期转换器,用了TypeConverter注解 /** * 时间转换 * @param timestamp * @return Date */ @TypeConverter public static Date toDate(Long timestamp){ return timestamp==null?null:new Date(timestamp); } /** * 时间转换 * @param date * @return long */ @TypeConverter public static Long toTimestamp(Date date) { return date == null ? null : date.getTime(); } model 模型,里面都是接口,包含的都是获取数据实体成员的方法,它们都是抽象的。 例:一个Comment的,一个Product的 public interface Comment { int getId();//获取ID int getProductId();//获取产品ID String getText();//获取评论内容 Date getPostedAt();//获取发布时间 } public interface Product { int getId(); String getName(); String getDescription(); int getPrice(); } entity 这个数据库就两张表,一个使产品表,一个使评论表,所以分别对应着各自的实体类 例如一个产品的实体类,它是实现了model里的抽象方法 //Entity注解,设置表名为products @Entity(tableName = "products") public class ProductEntity implements Product{//实现了模型的抽象方法 @PrimaryKey private int id;//id 为主键 private String name;//产品名 private String description;//产品描述 private int price;//产品价格 @Override public String getDescription() { return description; } public void setDescription(String description) { this.description = description; } @Override public int getId() { return id; } public void setId(int id) { this.id = id; } @Override public String getName() { return name; } public void setName(String name) { this.name = name; } @Override public int getPrice() { return price; } public void setPrice(int price) { this.price = price; } public ProductEntity() { } public ProductEntity(Product product){ this.id=product.getId(); this.name=product.getName(); this.description=product.getDescription(); this.price=product.getPrice(); } } @Entity(tableName = "comments" ,foreignKeys = { @ForeignKey(entity = ProductEntity.class, parentColumns = "id", childColumns = "productId", onDelete = ForeignKey.CASCADE) },indices = { @Index(value = "productId") }) public class CommentEntity implements Comment{ @PrimaryKey(autoGenerate = true) private int id; private int productId; private String text; private Date postedAt; @Override public int getId() { return id; } public void setId(int id) { this.id = id; } @Override public int getProductId() { return productId; } public void setProductId(int productId) { this.productId = productId; } @Override public String getText() { return text; } public void setText(String text) { this.text = text; } @Override public Date getPostedAt() { return postedAt; } public void setPostedAt(Date postedAt) { this.postedAt = postedAt; } public CommentEntity() { } public CommentEntity(Comment comment) { this.id = comment.getId(); this.productId = comment.getProductId(); this.text = comment.getText(); this.postedAt = comment.getPostedAt(); } } dao 里面是各个表的操作接口,都是抽象的,很像Retrofit那个带注解的接口,只不过这里是操作数据库 @Dao public interface CommentDao { @Query("SELECT * FROM comments where productId = :productId") LiveData<List<CommentEntity>> loadComments(int productId); @Query("SELECT * FROM comments where productId = :productId") List<CommentEntity> loadCommentsSync(int productId); @Insert(onConflict = OnConflictStrategy.REPLACE) void insertAll(List<CommentEntity> products); } @Dao public interface ProductDao { @Query("SELECT * FROM products") LiveData<List<ProductEntity>> loadAllProducts(); @Insert(onConflict = OnConflictStrategy.REPLACE) void insertAll(List<ProductEntity> products); @Query("SELECT * FROM products WHERE id=:productId") LiveData<ProductEntity> loadProduct(int productId); @Query("SELECT * FROM products WHERE id =:productId") ProductEntity loadProductSync(int productId); } AppDatabase.java AppDatabase继承RoomDatabase,这个类的作用就是数据库类,通过这个对象可以获取各个表的Dao和数据库设置,@Database注解设置了实体类和数据库版本,@TypeConverters指定了类型转换,就是上面的日期转换,因为数据库没有Data这种类型,但可以用long表示 @Database(entities = {ProductEntity.class, CommentEntity.class},version = 1) @TypeConverters(DateConverter.class) public abstract class AppDataBase extends RoomDatabase { public static final String DATABASENAME="basesample-db";//数据库名 public abstract ProductDao productDao();//获取Dao public abstract CommentDao commentDao();//获取Dao } DatabaseCreator.java 这个是一个辅助类,也是一个单例,用于获取AppDatabase实例,因为很多地方都要用AppDatabase实例嘛,而且数据库还没创建啊,这个类设计到一些知识 实现单例 这里应该用的是双重检查锁,保证创建实例是也是在一个线程里创建 // For Singleton instantiation private static DatabaseCreator sInstance; private static final Object LOCK = new Object(); public synchronized static DatabaseCreator getInstance(Context context) { if (sInstance == null) { synchronized (LOCK) { if (sInstance == null) { sInstance = new DatabaseCreator(); } } } return sInstance; } 原子操作 这里用到了AtomicBoolean,原来看到这里我都很懵逼,后来查查资料,才知道这个叫原子操作,就是compareAndSet(boolean expect, boolean update)。 比较AtomicBoolean和expect的值,如果一致,执行方法内的语句。其实就是一个if语句 把AtomicBoolean的值设成update 这连个操作一气呵成,中间没有人能够阻止,这样的话可以进行多线程控制,比如这里的创建数据库,因为后期可能多个地方会用到creatDb方法,所以要保证数据库只能创建一次且只能在一个线程中创建,当然这里没用SharePreferences,所以这里的"数据库只能创建一次"是指在应用不被杀死的情况下。 private final MutableLiveData<Boolean> mIsDatabaseCreated = new MutableLiveData<>(); private AppDataBase mDb; private final AtomicBoolean mInitializing = new AtomicBoolean(true); public void createDb(Context context) { Log.d("DatabaseCreator", "Creating DB from " + Thread.currentThread().getName()); if (mInitializing.compareAndSet(false, true)) { return; // Already initializing 已经创建了数据库 } mIsDatabaseCreated.setValue(false);//开始创建数据库,观察这个数据可以显示loading new AsyncTask<Context,Void,Void>(){ @Override protected Void doInBackground(Context... contexts) { Log.d("DatabaseCreator", "Starting bg job " + Thread.currentThread().getName()); Context context = contexts[0].getApplicationContext(); // Reset the database to have new data on every run. context.deleteDatabase(DATABASENAME); AppDataBase db= Room.databaseBuilder(context.getApplicationContext(),AppDataBase.class, DATABASENAME).build(); addDelay(); // Add a delay to simulate a long-running operation模拟耗时操作 // Add some data to the database 加一些数据进去 DatabaseInitUtil.initializeDb(db); Log.d("DatabaseCreator", "DB was populated in thread " + Thread.currentThread().getName()); mDb=db; return null; } @Override protected void onPostExecute(Void aVoid) { mIsDatabaseCreated.setValue(true);//创建数据库完毕 Log.d(TAG, "onPostExecute:"); } }.execute(context.getApplicationContext()); } viewmodel viewmodel目录 viewmodel就是提供一个连接model和view的桥梁,只不过提供的是可被观察的数据对象,而且是liveData,可以判断观察者的状态进行通知.如下面的ProductListViewModel,mObservableProducts是一个LiveData,viewmodel获取它是通过database得到,但如果database未初始化的情况也要考虑,所以用了一个Transformations.switchMap(),就是在databaseCreator.isDatabaseCreated()这个liveData为FALSE时返回值为空的liveData,为True时返回database查询到的liveData,这里可能有点绕,但是慢慢想又觉得很妙,因为这个观察模式在一定的生命周期内一直生效,完全是响应式的。 public class ProductListViewModel extends AndroidViewModel{ private static final String TAG = "ProductListViewModel>>>"; private static final MutableLiveData ABSENT=new MutableLiveData(); { ABSENT.setValue(null); } private final LiveData<List<ProductEntity>> mObservableProducts; public ProductListViewModel(@Nullable Application application) { super(application); final DatabaseCreator databaseCreator=DatabaseCreator.getInstance(application); mObservableProducts= Transformations.switchMap(databaseCreator.isDatabaseCreated(), new Function<Boolean, LiveData<List<ProductEntity>>>() { @Override public LiveData<List<ProductEntity>> apply(Boolean input) { if (!Boolean.TRUE.equals(input)){ Log.d(TAG, "apply: 空数据!"); return ABSENT; }else { return databaseCreator.getDatabase().productDao().loadAllProducts(); } } }); databaseCreator.createDb(this.getApplication()); } public LiveData<List<ProductEntity>> getmObservableProducts() { return mObservableProducts; } }

优秀的个人博客,低调大师

Application Architecture Guide 2.0 chapter 1

第一章程序架构基础 目标 程序架构基础 标准关键程序建构术语和原则 促使现代架构形成的关键因素 概要 定义程序架构就是定义结构化的解决方案的过程,这个解决方案可以满足所有的技术和操作的需求,以及最佳化的一般质量特性,如性能,安全和可管理性。 这包括广泛因素的一系列的决策,每个决策都考虑到了对质量,性能,可维护性和程序的成功。下面我们就展开对这一过程的描述,并使用其中包含的信息,你可以构建一个包含所有要点的架构。并可以使这个架构部署在你选择的基础之上,并且符合所有的原始的目标和需求。本章是实践性的程序架构的基础。首先从高层介绍架构和设计,之后详细介绍具体的架构和设计。提示符和以上采用同样方式。最后,本章会给出关键术语和原则。理解这些会帮助你从本指南中获得最大的收益,并成为一个更好的架构师。通过学习本章,你会从整体角度理解结束和架构及设计,主要的你必须考虑的因素和你在设计架构是可以使用的主要方法。 这会帮助你理解一些架构和程序风格,质量特性和交叉相关的概念以及分析和展示架构。 什么是软件架构? 软件架构一般被定义为一个系统的机构和各种结构的集合。 一些我们熟知的工业专家在架构相关决策的基础上扩展了这个定义。 Kruchten, Booch, Bittner,和Reitman对架构的定义 根据工作的经验Philippe Kruchten, Grady Booch, Kurt Bittner和Rich Reitman继承并提炼了架构的定义。他们的定义是:“软件架构包括了一些列的显著的软件系统组织的决策,包括: ü选择结构元素和他们组成系统的接口。 ü明确这些元素之间的协同行为 ü把这些结构的和行为的元素组成一个更大的子系统 ü指导这种组织的架构风格 软件架构同时包括功能性、可用性、可靠性、性能、复用性、广泛性以及经济和技术约束、权衡和美观等相关问题。” Fowler给出的架构定义 在《企业应用架构模式》一书中Martin Fowler在解释架构的时候,指出了一些重复发生的主题: •从最高层分解系统。 •决策很难修改。 •一个系统中存在多个架构。 •架构会影响一个系统的生命期。 •最后,架构按照系统的各个总要部分分解。 Bass, Clements, Kazman对架构的定义 在《软件架构实践(第二版)》中Bass, Clements,和Kazman这样定义软件架构: “一个软件或者是一个计算系统的架构就是这个系统的结构或者结构的集合,包括软件的各种元素,这些元素的外部可见的属性和他们之间的关系。架构主要是关于公共接口的,这些元素的内部细节—需要在内部实现的细节与架构无关。” 我们为什么需要架构设计? 想其他的复杂结构一样,软件必须建立在一个稳定的基础之上。没有考虑到关键的用例,没有处理好常见的问题,或者没有对长期的关键决策做好评估,会导致一个应用的失败。先待工具和平台会帮助你简化创建应用的难度,但是他们不会在需求之上建立你的应用程序。不好的架构导致的风险包括不稳定,不支持业务需求,甚至软件部署到工作环境时无法工作。考虑软件架构时,从高层考虑一下问题: •软件如何部署到生产环境? •用户会如何使用软件? •质量需求有哪些,比如安全,性能,并发,国际化以及配置? 架构和设计 当前或者在你部署了你的软件后,会影响到你的架构的趋势是什么?Martin Fowler说道:“专家一级的开发人员对于项目有个共同的理解。这个共同的理解叫做‘架构’。这个理解包括如何把系统分块以及这些不同的模块如何通过接口相互作用。这些模块通常又由更小的模块组成,但是架构只包括这些可以呗所有开发人员理解的模块以及他们之间的接口。”。所以结构主要集中在如何分解出模块和他们之间的接口。选择数据机构和算法实现已经不是架构了。不要用硬性快速的法则去区分架构和设计的区别,把他们两者结合起来才更有意义。在某些场合下,决策本质上来说更接近与架构。在其他情况下,决策又更接近于设计,并帮助你实现架构。 用户,业务和系统目标 系统架构的建立需要考虑到用户,系统和业务目标。每个领域都需要列出关键场景,重要的质量属性(比如,可维护性),关键客户要求实现的功能。如果可以,开发时,考虑每个领域中的成功的度量标准。 图1 在每个领域中都会有权衡,并且平衡点也必须找到。比如,反应时间可能是一个用户体验方面的要求但是系统管理者却不愿意投资到硬件上。而平衡点可能只是满足用户80%反应时间要求。 架构的目标 通过理解用例,软件架构可以建立业务需求和技术需求之间的桥梁,并在软件中实现用例。架构的目的就是为了辨别出对软件的结构有重大影响的需求。好的架构可以有效的降低业务的变化对解决方案的影响。一个好的设计可以非常灵活的适应由于时间引起的硬件和软件技术的变化,以及用户场景和需求的变化。一个架构师必须考虑设计决策,质量属性(比如:性能和安全)固有平衡,用户、系统和业务需求等对整体的影响。 架构应该包括的一下的内容: •找出系统的结构但是隐藏实现的细节。 •实现全部的场景用例。 •列出所有的利益相关者关注的问题。 • 实现架构的方法 功能和质量需求全都处理。任意的架构,实现架构的方式,都必须列出全部的关键决策。至少你必须确定你要建立的架构的类型,建立架构的风格并且处理这些问题的交叉部分。通过这个指南,我们会通过基本的架构来列出在你的架构中需要考虑的各个方面。基本架构在下图中。 图2 此外,对于基本架构来说,你可以用下列的方式来帮助你定义你自己的架构。第一步是你的要建立的应用的类型。接着,你必须理解你的软件如何部署。一旦你明白了你应用的类型以及该软件如何部署,你就可以开始用你认为合适的风格和技术来建立你的软件。最终,你需要把考虑质量属性和交叉点容纳到你的设计中。 应用类型 作为设计和组织软件架构过程的一部分,选择正确的应用类型极为关键。这取决于需求和基础结构的限制。本指南包括了一下的应用类型: l移动设备的移动应用 l主要运行在客户机上的富客户端应用 l部署在Internet上的支持丰富的UI和媒体的RIA应用 部署策略 当你设计架构时,你必须考虑到共同的方针和处理过程,以及你要部署你软件的基础。目标环境是灵活的还是不变的,你的软件必须考虑到在目标环境中存在的限制。你的应用程序必须同时考虑到质量属性比如安全和性能以及可维护性。有时你必须因为网络技术和协议做出必要的权衡。尽早在设计阶段分辨出需求和基础结构的限制和需求。这会帮助你选择一个正确的部署技术,帮助你尽早解决软件和基础架构之间的冲突。 架构风格 一种架构风格就是一些列的组成该风格的原则。每种风格都定义了一系列的规则,这些规则指明了你可以用于组成系统的组件,在软件组件之间关系,各个组件组织到一起的约束,以及他们组织到一起的方式。架构风格的例子是客户机/服务器,基于组件的,分层架构,消息总线,MVC,三层/N层,面向对象,以及面向服务的架构(SOA)。很多的因素会影响你对架构风格的选择。这些因素包括你所在开发单位的设计和实现的能力,开发人员的经验和能力,以及可以获得的架构约束和部署场景。 合适的技术 当为您的软件选择技术的时候,要考虑的关键因素是你所要开发的软件的类型,和软件部署技术以及架构风格。技术的选择也会受到代发单位策略,基础架构限制,技术资源等的影响。你必须比较在你的需求的基础上考虑你选择的技术,并且在做出任何的决定之前考虑其他的因素。 质量属性 质量属性可以把你的思考集中在几个设计中必须解决的关键的问题上。在你的需求的基础之上,你可能要考虑在本指南中列出的全部的质量属性,或者这些质量属性的一个子集。比如,每个软件都必须考虑安全和性能,但不是每个设计都需要考虑互操作性或者可升级性。首先理解你的需求和部署场景,这样哪些质量属性对你的设计很重要。记住质量属性会出现冲突。比如,安全性需要对性能和可用性做出权衡。在做安全性方面的设计时,分析并理解关键的权衡,就会避免边缘作用对软件产生显著的影响。在质量属性设计中可以考虑一下的指导: l质量是系统级属性,是和功能分离的。 l从技术的角度讲,质量属性的实现与否或实现如何可以区分一个软件的好坏。 l有两种质量属性:一种是在运行是度量的,一种只能通过审查来度量。 l分析质量属性之间的权衡。 当你考虑质量属性时,有几个问题你需要考虑: 什么是你软件要求的关键的质量属性?在设计的过程中找出他们。 什么是你软件要求的关键的质量属性?在设计的过程中找出他们。 客户的接手标准是什么,这表明了你是否符合需求。 关注交叉点 交叉点代表了软设计中与某一层无关的关键域。比如,你可能想在展示层和数据访问层缓存数据。你也需要设计一个在每一层都工作的异常处理框架。另外,你还设计每一层都可以使用的日志系统以及设计一个在不同层之间通讯的功能。权限管理也存在于不同的层次之间,所以你必须决定如何在系统中传递一个认证并使持有这个认证的用户可以访问特定的系统资源。一下列表描述了架构中必须考虑的交叉点: 身份认证:决定如何验证用户并在不同层之间传递认证的身份。 权限:在每一层和信任授权之间的授权正确。 缓存:确定什么是需要缓存的,缓存位置以改善软件的性能和响应时间。设计缓 存时一定要考虑到网页和网络应用的问题。 通讯:选择和是网络技术,减少网络调用并防止敏感数据在网络中传输。 异常管理:在边界捕获异常。不再终端用户钱显示敏感信息。 规范应用程序和日志:规范全部的业务和系统关键事件,并详细记录日志以便重建事件。不要记录敏感信息。 敏捷架构 敏捷架构假设软件的设计会随着时间的改变儿改变,并且你不知道为整个系统设计架构需要知道的所有信息。你的设计,总的来说,会在实施阶段获得了更多的信息后,或是在实际环境中测试过后加以改进。由于在设计的开始阶段无法全面的了解需求,而不断在头脑中改进架构。用敏捷的方法设计架构时,需要考虑一下问题: 在架构中,如果你出错了给整个系统带来最大风险的基本模块有那些。 架构中的那些部分是最容易改变的,或者说那部分的设计退后之后对系统的影响最小? 你的关键假设是什么,如何测试他们? 何种情况会使你重新考虑你的设计? 不要过分设计,不要做无法验证的假设。相反的,保持对未来的变化开放的想法,而不是把自己逼到墙角。有些方面,如果重新设计会给你带来很高成本的话,是你在设计的初期就必须确定好的,尽快确认这些域,并认真分析他们。 敏捷架构设计的关键原则 敏捷架构包括一些关键的原则: 建模适应改变:任何地点只要可能,设计你的软件,以使之可以适应新的需求和 挑战。 建模分析、减低风险:给风险建模以理解风险和易出问题的地方。 建模和试图只是沟通和协调的工具:设计原则行业设计变更的沟通是敏捷设计的 关键所在。用户建模和其他的可视化手段可以使得沟通更加有效并可以使得 团队针对设计的变更做出迅速的应对。 确认关键建模决策:用本指导的框架来理解工程决策,区分出经常容易出错的地方。最后可以第一时间找出这些关键决策,以使设计更加灵活和更容易适应变化。 增量和迭代架构方式 敏捷架构通过增量和迭代的方式达到改进的目的。就是不要在第一次就把搜有的事情都作对。尽可能的设计,之后在需求和假设的基础上验证你的设计。迭代的在你的设计中添加细节,以使你在第一次就在重要问题上做出正确的决策,之后关注细节。一个常犯的错误就是过早的进入到了细节问题,并在错误的假设上做出错误的决策,或者无法评价架构是否有效。保证架构的基本方面是正确的,并测试这个架构,同时考虑一下问题: •在这个架构中我做了什么样的假设? •这个架构能满足什么样的显式或隐性的需求? •这样架构设计方式会有什么样的风险? •通过何种方法应对关键的危机? •以何种方式改进架构的基本设计或最近一个版本的架构? 基本架构和待测架构 一个基本架构就是对现存系统的描述—也就是你系统当前的结构。如果是一个全新的架构,那么你的基本架构就是这个架构设计的最高层描述,待测架构也将从这里产生。一个待测架构包括应用类型,部署架构,架构风格,技术选择,质量属性和交叉点。 Architectural Spikes An architectural spike是一个软件的每个小块的端到端的测试。目的就是减低风险并测试潜在路径。只要你评价你的架构,你就会用这些spike来发现不同的场景,但这不会对软件现有的设计产生任何影响。An architectural spike可以得出一个待测架构,这个待测架构可以在基础架构的基础上进行测试。如果一个待测架构是一个改进,那么它就可以作为下一个待测架构的基础架构。这样的迭代和增量方式使你可以在第一时间摆脱较大的风险。用迭代的方式得出架构,并用架构测试证明每个基本架构都是一个改进。考虑下面的问题,以帮助你测试一个新的待测架构: •这个架构会导致新的风险吗? •这个架构会降低已知的风险吗? •这个架构满足其他的新增的需求吗? •这个架构支持架构级的用例吗? •这个架构列出了质量属性了吗? •这个架构列出了增加的交叉点了吗? 架构级的用例 架构级用例的符合以下标准: •他们对成功和客户对软件部署的接受至关重要。 •他们可以从多方面考验设计,这对架构的评估至关重要。 当你确定好架构的架构级用例之后,你可以用他们来评估待测框架的成功与否。如果待测框架需要更多的用例,或者更加有效的评估架构,那么这个待测架构是上个基本架构的改进版本了。 分析和评估架构 用架构评价来确定你的基本架构和待测架构的灵活性。架构评价是成功的架构迭代中的关键部分。在架构评价中考虑以下几个技术: •架构级用例:用用例来测试设计对你软件的成功非常重要。这也是你设计中的重要一环。 •基于场景的评估:用场景来分析你的设计。并且要考虑到质量属性。基于场景的评估有: ü架构权衡分析方法。 ü软件架构分析方法。 ü和中间设计审查。 展示和沟通架构 把你的架构拿出来沟通在架构审查中非常重要,在架构的实施过程中尤其如此。最后,只要你的沟通质量好,那架构的质量就有了保障。你必须和不同的角色讨论你的架构,包括系统设计者、开发人员、系统管理员等。一个可以清晰展现架构图景的方法是决策图。决策图不是某个专业的东西而是一个可以帮助你和其他人沟通的抽象。 架构图景 理解当前让我们做出架构决策,和将来让我们做出改变的关键因素。这些关键因素受客户要求的影响,同时也受到业务要求的影响,比如更快的得到结果,更好的支持工作风格和工作流程的改变,以及更容易修改的设计。考虑一下关键趋势: •用户授权:一个支持用户授权的设计是比较灵活的,这样的设计是可配置的,并考虑到了用户使用体验。设计时考虑到用户的个性和可能的选择。允许用户选择软件如何对操作做出回应,而不是培训他们。理解关键的使用场景,并使软件尽量的简单易用,容易找到信息和使用。 •市场成熟:在现有平台和技术选择的基础上烤炉事成成熟度。在高层建立应用框架才有意义,这样唯一的确定什么在你的软件中是有价值的,而不是建立一些已经存在并可以复用的。评价模式可以提供很多的已经证明了的普遍问题的解决方案。 •灵活性和适应性:一个灵活的,适应性强的设计重点在与松耦合以支持复用。考虑插件式开发以支持扩展。考虑服务优先的技术比如SOA以支持互操作。 •未来趋势:当你构建你的软件的时候,理解未来可能在部署后对你的设计产生影响的趋势。比如,考虑富客户端和媒体,符合模块比如混搭应用,增加的网络贷款和可用性,移动终端的增加,硬件性能的持续改进,社区和个人出版的增加,云计算的和远程操作的增加等。 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/archive/2009/01/17/1377377.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Learn Influxdb the hard way (1) - Overview of the architecture

前言 Influxdb是目前最流行的时序性数据库之一,由Go语言编写,无需特殊的环境依赖,简单方便,非常适合作为监控系统的后端存储。在容器相关领域的场景中,经常和telegraf、grafana、prometheus等开源系统相集成。从这篇文章开始,我们会从源码深入探讨Influxdb的设计思路。本系列文章基于Influxdbv1.5的源码,需要读者具备influxdb的基本使用经验。 Influxdb架构总览 首先我们先从上帝视角鸟瞰一下Influxdb的整体结构,在后续的文章中我们会深入到每一个组件进行解析。从整体的架构分层上来讲可以分为数据持久层、内部组件层、对外服务层,我们先从最下层向上层进行分析。在存储上,Influxdb分为两种储存,一种是META存储,一种是数据存储,首先我们先从磁盘上的目录结构进行查看。 ├── data

优秀的个人博客,低调大师

Service-oriented architecture (SOA)

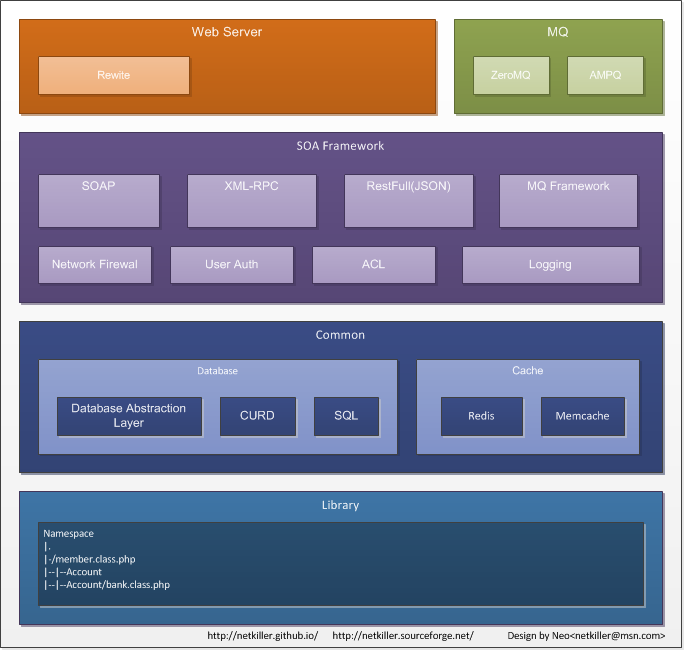
SOA 与 REST很多相同之处,目前SOA主要是基于SOAP实现,也有基于MQ的实现。而REST只限于HTTP POST/GET/PUT/DELETE等等。 我个人比较喜欢机遇TCP的SOA实现,不喜欢SOAP大量XML传输。 15.4.1.SOAP实现 这里提供一个简单的机遇SOAP实现的SOA框架 index.php入口文件 <?php define ('CONFIG_DIR', '../config/'); define ('LIBRARY_DIR', '../library/'); define ('DEBUG', false); //define ('DEBUG', ture); require_once(CONFIG_DIR. 'default.php'); $remote_addr = $_SERVER['REMOTE_ADDR']; if(!in_array($remote_addr, $firewall)) { printf("Permission denied: %s", $remote_addr); exit(0); } $request_uri = $_SERVER['REQUEST_URI']; $classspath = LIBRARY_DIR.strtolower($request_uri) . '.class.php'; if( is_file($classspath) ){ require_once($classspath); }else{ die("Cannot loading interface!"); } $class = ucfirst(substr($request_uri, strrpos($request_uri, '/')+1)); if( DEBUG ){ printf("%s<br>",$class); } if (class_exists($class)) { $server = new SoapServer(null, array('uri' => "http://webservice.example.com")); $server->setClass($class); $server->handle(); }else{ die('Object isnot exist.'); } 接口文件 <?php require_once('common.class.php'); class Members extends Common{ private $dbh = null; public function __construct() { parent::__construct(); $this->dbh = new Database('slave'); } public function getAllByUsernameAndMobile($username,$mobile){ $result = array(); if(empty($username) or empty($mobile)){ return($result); } $sql = "SELECT username, chinese_name, sex FROM members m, members_digest md WHERE m.id = md.id and m.username= :username and md.mobile = md5( :mobile );"; $stmt = $this->dbh->prepare($sql); $stmt->bindValue(':username', $username); $stmt->bindValue(':mobile', $mobile); $stmt->execute(); $result = $stmt->fetch(PDO::FETCH_ASSOC); return($result); } public function getAllByLimit($limit,$offset) { $sql = "SELECT username FROM members limit ".$limit.",".$offset; $stmt = $this->dbh->query($sql); while ($row = $stmt->fetch()) { //printf("%s\r\n", $row['username']); $result[] = $row['username']; } return $result; } function __destruct() { $this->dbh = null; } } 客户端调用实例 <?php $options = array('uri' => "http://webservice.example.com", 'location'=>'http://webservice.example.com/members', 'compression' => 'SOAP_COMPRESSION_ACCEPT | SOAP_COMPRESSION_GZIP', 'login'=>'neo', 'password'=>'chen', 'trace'=>true ); $client = new SoapClient(null, $options); try { print_r($client->getAllByUsernameAndMobile('280600086','13113668890')); print_r($client->getAllByLimit(20,20)); } catch (Exception $e) { echo 'Caught exception: ', $e->getMessage(), "\n"; } Nginx 虚拟主机配置文件 /etc/nginx/conf.d/webservice.example.com.conf server { listen 80; server_name webservice.example.com; charset utf-8; access_log /var/log/nginx/webservice.example.com.access.log main; auth_basic "Login"; auth_basic_user_file htpasswd; location / { root /www/example.com/webservice.example.com/htdocs; index index.html index.php; if ($request_filename !~ (js|css|images|robots/.txt|.*\.html|index/.php) ) { rewrite ^/(.*)$ /index.php/$1 last; break; } } error_page 500 502 503 504 /50x.html; location = /50x.html { root /usr/share/nginx/html; } location ~ /index.php/ { root /www/example.com/webservice.example.com/htdocs; fastcgi_pass 127.0.0.1:9000; fastcgi_index index.php; fastcgi_param SCRIPT_FILENAME /www/example.com/webservice.example.com/htdocs$fastcgi_script_name; include fastcgi_params; } } 每增加一个功能需求,在library中创建一个 Class 文件即可。 index.php 有IP过滤功能,禁止非法IP访问 客户端采用压缩传输,节省xml传输开销 Nginx 设置了HTTP认证,防止他人探测,另外提示你还可以采用双向SSL认证。 15.4.2.MQ 实现 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

优秀的个人博客,低调大师

第 3 章 Systems architecture(系统架构)

3.1.集群(Cluster) 集群有很多实现方法,分为硬件和软件,集群可以在不同网络层面上实现 实现IP轮循(Bind DNS) 硬件四层交换(硬件负载均衡设备 F5 BIG IP) 软件四层交换(linux virtual server) 应用层上实现(tomcat) 越是低层性能越好,越是上层功能更强 集群的分类 高可用性集群 负载均衡集群 超级计算集群 网站一般用到两种集群分别是高可用性集群和负载均衡集群 3.1.1.负载均衡 3.1.1.1.DNS负载均衡 这是早期出现的负载均衡技术,直到现在,很多网站仍然使用DNS负载均衡。 你可通过ping命令观看它是如何工作的,例如你可反复ping个网域名。 C:\>ping www.163.com Pinging www.cache.split.netease.com [220.181.28.52] with 32 bytes of data: Reply from 220.181.28.52: bytes=32 time=226ms TTL=53 Reply from 220.181.28.52: bytes=32 time=225ms TTL=53 Reply from 220.181.28.52: bytes=32 time=226ms TTL=53 Reply from 220.181.28.52: bytes=32 time=226ms TTL=53 Ping statistics for 220.181.28.52: Packets: Sent = 4, Received = 4, Lost = 0 (0% loss), Approximate round trip times in milli-seconds: Minimum = 225ms, Maximum = 226ms, Average = 225ms C:\>ping www.163.com Pinging www.cache.split.netease.com [220.181.28.53] with 32 bytes of data: Reply from 220.181.28.53: bytes=32 time=52ms TTL=52 Reply from 220.181.28.53: bytes=32 time=53ms TTL=52 Reply from 220.181.28.53: bytes=32 time=52ms TTL=52 Reply from 220.181.28.53: bytes=32 time=52ms TTL=52 Ping statistics for 220.181.28.53: Packets: Sent = 4, Received = 4, Lost = 0 (0% loss), Approximate round trip times in milli-seconds: Minimum = 52ms, Maximum = 53ms, Average = 52ms C:\>ping www.163.com Pinging www.cache.split.netease.com [220.181.28.50] with 32 bytes of data: Reply from 220.181.28.50: bytes=32 time=51ms TTL=53 Reply from 220.181.28.50: bytes=32 time=52ms TTL=53 Reply from 220.181.28.50: bytes=32 time=52ms TTL=53 Reply from 220.181.28.50: bytes=32 time=51ms TTL=53 Ping statistics for 220.181.28.50: Packets: Sent = 4, Received = 4, Lost = 0 (0% loss), Approximate round trip times in milli-seconds: Minimum = 51ms, Maximum = 52ms, Average = 51ms C:\> DNS负载均衡主要优点 技术简单,容易实现,灵活,方便,成本低 Web服务器可以位于互联网的任意位置上,无地理限制。 DNS的主从结构非常稳定 可以有效的分散DDOS攻击。 你甚至可以在DNS服务商那里实现,自己不需要添加设备。而且没有带宽开销。 DNS负载均衡主要缺点 DNS负载均衡采用的是简单的轮循负载算法,不能够按照服务器节点的处理能力分配负载。 不支持故障转移(failover)和自动恢复failback ,如果某台服务器拓机,DNS仍会将用户解析到这台故障服务器上,导致不能响应客户端。 如果添加节点或撤出节点,不能即时更新到省市级DNS,可导致部分地区不能访问。 占用大量静态IP。 3.1.1.2.软件四层交换负载均衡 软件四层交换负载均衡为我们解决了几个问题 能够按照服务器节点的处理能力分配负载。 支持故障转移(failover)和自动恢复failback ,如果某节点拓机,调度器自动将它剔除,不响应客户端访问,当节点故障排除调度器立即恢复节点。 可以随时添加节点或撤出节点,即时生效,方便网站扩容。 软件四层交换负载均衡优点 仅仅需要一个静态IP。 节点位于私有网络上与WAN隔离,用户面对的只是调度器。 可以随时添加节点或撤出节点。 通过端口可以组建多个集群。 3.1.1.3.应用层负载均衡 Tomcat balancer mod_proxy_balancer.so ,tomcat mod_jk.so MySQL proxy / MySQL-LB 3.1.2.高可用性集群 俗称:双机热备份 关键词:心跳线 两部服务器,或多部服务器,形成一个集群,当主服务器崩溃是,立即切换到其它节点上。 两部服务器要做到,内容实时同步,保持数据一直。 一般用 heartbeat + DRBD 实现。heartbeat负责切换服务器,DRBD用于同步数据。 3.1.3.负载均衡设备 负载均衡成熟产品 F5 Big IP Array 这些设备可提供3,4,7层负载均衡HA,硬件已经压缩,HTTP头改写,URL改写... 其中3层交换部分多采用硬件实现。 3.1.4.会话保持 3.1.5.健康状态检查 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册