首页 文章 精选 留言 我的

精选列表

搜索[AI现代化],共10000篇文章
优秀的个人博客,低调大师

现代化的领域驱动设计的货物跟踪系统

DDDSample: 现代领域驱动设计的货物跟踪系统 项目概述 DDDSample 是一个基于现代领域驱动设计(DDD)理念开发的货物跟踪系统,旨在展示如何运用 DDD 原则构建高效、可维护和可扩展的企业级应用。该系统采用了分层架构、事件驱动架构、CQRS 等设计模式,并集成了 Spring Boot、JPA、JMS 等技术,为开发高质量的软件系统提供了良好的范例。 技术栈 Spring Boot 3:作为基础框架,利用其自动配置和依赖注入功能,简化项目开发和部署。 JPA (Spring Data JPA):用于数据库操作,提供简洁的方式访问和管理数据。 JMS (Spring ActiveMQ):实现消息队列,支持异步通信和事件驱动架构。 功能特性 策略设计模式 为处理报告提供了策略设计模式,支持线程池(ThreadPool)、消息队列(MessageQueue)和直接处理(Directly)三种方式。通过配置 CargoTrackerApplicationProperties 中的 HandlingReportProcessStrategy 可以灵活选择处理策略,提高了系统的灵活性和可配置性。 java @Data @ConfigurationProperties(prefix = "cargotracker.application") public class CargoTrackerApplicationProperties { private final HandlingReport handingReport = new HandlingReport(); public enum HandlingReportProcessStrategy { MESSAGE, THREAD, DIRECT } @Data public static class HandlingReport { private HandlingReportProcessStrategy processStrategy = HandlingReportProcessStrategy.DIRECT; } } BDD 测试 在应用层采用行为驱动开发(BDD)测试,提高了测试的可读性和可维护性。通过编写测试用例来验证系统的行为是否符合预期。 无删除设计 各层采用无删除设计,例如可以安全地删除接口层的文件夹,而不会影响系统的其他部分。 领域层分离 将领域层分离为单独的 JAR 文件,避免意外使用领域层外的类,保护领域模型的完整性。 CQRS 分离 利用命令查询职责分离(CQRS)模式,将写操作和读操作分离处理,提高系统的性能和可扩展性。 架构设计 分层架构与模块化 采用清晰的分层架构,将不同职责的代码分离,如领域层、应用层、接口层等。领域层专注于核心业务逻辑,应用层协调业务流程,接口层负责对外提供服务。这种分层设计使得代码结构清晰,易于维护和扩展。 事件驱动架构 使用事件来解耦不同模块之间的依赖,当货物状态发生变化时,发布相应的事件,如 CargoCreatedEvent、 CargoRoutedEvent 等。通过消息队列和事件监听器,实现了异步处理和系统的可扩展性。 领域建模 清晰的领域模型 定义了丰富的领域实体和值对象,如 Cargo、 Itinerary、 Leg、 Location 等,准确地反映了业务领域的概念和关系。 值对象和实体的区分 明确区分了值对象和实体,如 TrackingId 是值对象,用于唯一标识货物; Cargo 是实体,具有唯一标识和生命周期。

优秀的个人博客,低调大师

Remix 2.0 正式发布,现代化全栈 Web 框架!

9 月 16 日,全栈 Web 框架 Remix 正式发布了 2.0 版本,Remix 团队在发布 1.0 版本后经过近 2 年的持续努力,发布了 19 个次要版本、100 多个补丁版本,并解决了数千个问题和拉取请求,终于迎来了第二个主要版本! Remix 具有以下特性: 追求速度、用户体验(UX),支持任何 SSR/SSG 等 基于 Web 基础技术,如 HTML/CSS 与 HTTP 以及 Web Fecth API,在绝大部分情况可以不依赖于 JavaScript 运行,所以可以运行在任何环境下,如 Web Browser、Cloudflare Workers、Serverless 或者 Node.js 等 客户端与服务端一致的开发体验,客户端代码与服务端代码写在一个文件里,无缝进行数据交互,同时基于 TypeScript,类型定义可以跨客户端与服务端共用 内置文件即路由、动态路由、嵌套路由、资源路由等 去掉 Loading、骨架屏等任何加载状态,页面中所有资源都可以预加载(Prefetch),页面几乎可以立即加载 告别以往瀑布式(Waterfall)的数据获取方式,数据获取在服务端并行(Parallel)获取,生成完整 HTML 文档,类似 React 的并发特性 提供开发网页需要所有状态,开箱即用;提供所有需要使用的组件,包括 <Links> 、<Link>、 <Meta> 、<Form> 、<Script/> ,用于处理元信息、脚本、CSS、路由和表单相关的内容 内置错误处理,针对非预期错误处理的 <ErrorBoundary> 和开发者抛出错误处理的 <CatchBoundary> Remix 是一个由 React Router 开发团队所开发的基于 React 和 TypeScript 的全栈框架。2021 年 11 月,Remix 正式开源,至今已在 Github 上获得了 24.6k star。Remix 正式开源时,引发了前端圈不小的关注,其被普遍认为是 Next.js 的强劲对手,那时隔两年,它和 Next.js 之间的“竞争”怎么样了呢? 目前,Next.js 拥有 112k star,是 Remix 的近 5 倍。Next.js 周下载量 279 万,而 Remix 仅有 1.4 万,Next.js 是 Remix 的近 200 倍。可见,Remix 并没有像大家预料的那样,成为 Next.js 的有力竞争对手,在开发者社区中只有较小的市场份额。尽管如此,Remix 仍然吸引了一些开发者,并且在特定领域或项目中有其优势和适用性。 下面就来看看 Remix 2.0 都有哪些更新! v1.0 以来的更新 v1.8和v1.10中,将 Remix与React Router v6进行了对齐。当开始开发Remix时,承诺它将使React Router变得更好。这个版本真正实现了这一承诺,并将两个库都对齐到使用相同的底层依赖。 在v1.11中,发布了"promises over the wire",即延迟加载模块。现在,如果真的想在Remix应用中添加 loading 图标,可以这么做了! 在v1.11中,添加了"flat"路由,简化了使用嵌套布局而不需要嵌套目录的操作,这成为v2版本的默认设置。 在v1.13和v1.16中,改进了Remix对各种CSS策略的支持,包括PostCSS、CSS模块、Vanilla Extract 和CSS副作用(全局)导入。 在v1.14和v1.18中,发布了一个新的开发服务器,支持热更新(HMR)和热数据重载(HDR)。这个新的开发服务器成为v2版本的默认设置。 在v2版本中,最重要的亮点之一是全新的create-remix命令行工具体验。 v2.0 的更新内容 重大变化 升级的依赖要求 Remix v2已经升级了对React和Node的最低版本支持,并正式支持以下版本: React 18 Node 18 或更高版本 移除未来标志 以下未来标志已被移除,并且它们的行为现在是默认的,现在可以从remix.config.js文件中删除这些设置。 v2_dev,新的开发服务器,具有HMR + HDR,如果在future.v2_dev中有配置而不仅仅是布尔值(例如,future.v2_dev.port),可以将它们提升到remix.config.js中的根dev对象中。 v2_errorBoundary,移除了CatchBoundary,改为使用单个ErrorBoundary v2_headers,修改了嵌套路由场景中的头部逻辑 v2_meta,修改了meta()的返回格式 v2_normalizeFormMethod,将formMethod规范化为大写 v2_routeConvention,现在默认情况下,路由使用扁平化路由约定 重大变更/API 删除 下面列出了 Remix v1 中具有弃用警告的其他重大更改/API 删除。如果使用的是最新1.19.3版本且没有任何控制台警告,那么可能可以继续执行所有这些操作! (1)有破坏性更改/API移除 remix.config.js 将browserBuildDirectory重命名为assetsBuildDirectory 删除devServerBroadcastDelay 将devServerPort重命名为dev.port 如果在1.x版本中选择此选项,则配置标记将是future.v2_dev.port,但在稳定的2.x版本中,它将是dev.port 将默认的serverModuleFormat从cjs更改为esm 删除serverBuildTarget 将serverBuildDirectory更改为serverBuildPath 默认情况下不再在服务器上对Node内置模块进行polyfill,必须通过serverNodeBuiltinsPolyfill选择加入polyfill @remix-run/react 删除useTransition 删除fetcher.type并压缩fetcher.submission <fetcher.Form method="get">现在更准确地被归类为state:“loading”,而不是state:“submitting”,以更好地与底层的GET请求保持一致 要求camelCased版本的imagesrcset/imagesizes (2)没有弃用警告 此版本没能在每个破坏性更改或API移除上都收到废弃警告。以下是可能需要查看的剩余变更列表,以升级到v2: remix.config.js Node内置模块不再默认在浏览器中进行polyfill,可以通过browserNodeBuiltinsPolyfill选项选择加入polyfill 如果存在配置文件,则PostCSS/Tailwind将默认启用,可以通过postcss和tailwind标志禁用此功能 @remix-run/cloudflare 删除createCloudflareKVSessionStorage方法 不再支持@cloudflare/workers-types v2和v3 @remix-run/dev 删除REMIX_DEV_HTTP_ORIGIN,增加REMIX_DEV_ORIGIN 删除REMIX_DEV_SERVER_WS_PORT,增加dev.port或--port 删除--no-restart/restart标志,增加--manual/manual 删除--scheme/scheme和--host/host,增加REMIX_DEV_ORIGIN 删除codemod命令 @remix-run/eslint-config 删除@remix-run/eslint-config/jest配置 删除魔法imports的ESLint警告 @remix-run/netlify @remix-run/netlify适配器已被删除,推荐使用Netlify官方适配器 @remix-run/node 默认不再对fetch进行polyfill,应用需要调用installGlobals()来安装polyfills 不再从@remix-run/node导出fetch和相关 API,应用应使用全局命名空间中的版本 应用需要调用sourceMapSupport.install()来设置源映射支持 @remix-run/react 删除unstable_shouldReload,增加shouldRevalidate @remix-run/serve 如果3000端口被占用且未指定PORT,则remix-serve将选择一个可用的端口 集成手动模式 删除未记录的createApp Node API 在remix-serve中保留动态imports以供外部bundle使用 @remix-run/vercel @remix-run/vercel适配器已被删除,推荐使用Vercel官方提供的功能 create-remix 停止传递isTypeScript给remix.init脚本 remix 删除魔法 exports (3)破坏类型变化 从 future.v2_meta 类型中删除了 V2_ 前缀,因为它们现在是默认行为。 V2_MetaArgs -> MetaArgs V2_MetaDescriptor -> MetaDescriptor V2_MetaFunction -> MetaFunction V2_MetaMatch -> MetaMatch V2_MetaMatches -> MetaMatches V2_ServerRuntimeMetaArgs -> ServerRuntimeMetaArgs V2_ServerRuntimeMetaDescriptor -> ServerRuntimeMetaDescriptor V2_ServerRuntimeMetaFunction -> ServerRuntimeMetaFunction V2_ServerRuntimeMetaMatch -> ServerRuntimeMetaMatch V2_ServerRuntimeMetaMatches -> ServerRuntimeMetaMatches 以下类型已进行调整,更偏向于使用unknown而不是any,并与底层的React Router类型保持一致: 将useMatches()的返回类型从RouteMatch改名为UIMatch 将LoaderArgs/ActionArgs改名为LoaderFunctionArgs/ActionFunctionArgs 将AppData的类型从any改为unknown 将Location["state"](useLocation.state)的类型从any改为unknown 将UIMatch["data"](useMatches()[i].data)的类型从any改为unknown 将UIMatch["handle"](useMatches()[i].handle)的类型从{ [k: string]: any }改为unknown 将Fetcher["data"](useFetcher().data)的类型从any改为unknown MetaMatch.handle(在meta()函数中使用)的类型从any改为unknown AppData/RouteHandle不再导出,因为它们只是unknown的别名 新增功能 新的create-remix命令行界面工具 最显著的改变是,不再使用下拉菜单选择模板/堆栈,而是使用--template参数和不断增长的可用模板列表。 新增--overwrite参数 支持bun包管理器 通过build.mode检测构建模式 支持通过serverNodeBuiltinsPolyfill.globals/browserNodeBuiltinsPolyfill.globals来对Node全局对象进行polyfill 新的redirectDocument实用工具,通过重新加载文档实现重定向 在meta参数中添加error,以便可以渲染错误标题等 unstable_createRemixStub现在支持在stubbed Remix路由上添加meta/links函数 unstable_createRemixStub不再支持在路由上使用element/errorElement属性。必须使用Component/ErrorBoundary与从Remix路由模块导出的内容匹配。 其他更新 Remix现在在内部使用React Router的route.lazy方法在导航时加载路由模块。 删除了@remix-run/node中的atob/btoa polyfills,改用内置版本。 将@remix-run/dev包与@remix-run/css-bundle包的内容解耦。 现在,@remix-run/css-bundle包的内容完全由Remix编译器管理。尽管仍然建议Remix依赖项共享相同的版本,但这个变化确保在升级@remix-run/dev而不升级@remix-run/css-bundle时没有运行时错误。 remix-serve现在将选择一个空闲的端口(如果3000端口被占用)。 如果设置了PORT环境变量,remix-serve将使用该端口。 否则,remix-serve将选择一个空闲的端口(除非3000端口已被占用)。 更新的依赖项: react-router-dom@6.16.0 @remix-run/router@1.9.0 @remix-run/web-fetch@4.4.0 @remix-run/web-file@3.1.0 @remix-run/web-stream@1.1.0 React Server Components? Remix 对于 React Server Components(RSC)的支持计划是积极的。他们希望在Remix v3中添加对RSC的支持,并希望能够展示这项技术在多个框架中的能力。 RSC是一个有趣且强大的功能,但是 Remix v2 是基于当前稳定的React特性构建的,因此 RSC 在 Remix v2 中尚未包含。一旦RSC稳定下来,Remix 将会支持它。 然而,与之前支持的其他React特性相比,“支持RSC”需要更深入的集成。RSC的异步组件与Remix的加载器和组件结合得非常相似,并且Remix在v3中决定摒弃使用第三方库useLoaderData,因此在数据加载方面可能会有所不同。他们希望开发者只需要将现有的加载器代码迁移到新的异步组件中,但需要注意数据依赖的瀑布效应。 Remix团队在今年早些时候的Remix Conf上与React核心团队的成员举办了一个讨论会,讨论了RSC以及如何共同推进这项技术的稳定发布。他们以各种方式帮助准备RSC,并希望能够成功地集成它到Remix中。

优秀的个人博客,低调大师

每日一博 | 应用现代化中的弹性伸缩

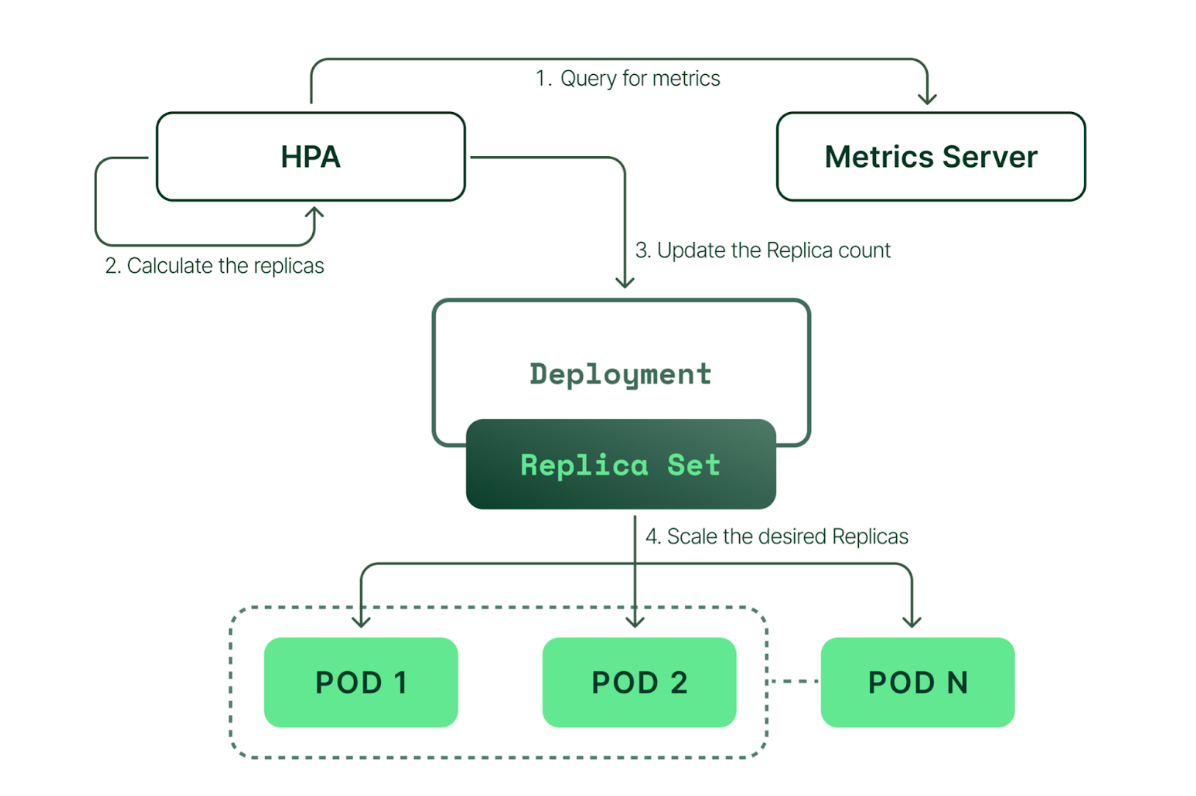
作者:马伟,青云科技容器顾问,云原生爱好者,目前专注于云原生技术,云原生领域技术栈涉及 Kubernetes、KubeSphere、KubeKey 等。 2019 年,我在给很多企业部署虚拟化,介绍虚拟网络和虚拟存储。 2023 年,这些企业都已经上了云原生了。对于高流量的 Web 应用程序,实时数据分析,大规模数据处理、移动应用程序等业务,容器比虚拟机更适合,因为它轻量级,快速响应,可轻松移植,并具有很强的弹性伸缩能力。 为什么需要弹性伸缩呢? 峰值负载应对:促销活动、节假日购物季或突发事件根据需求快速扩展资源,保证应用可用性和性能。 提高资源利用率:根据实际资源负载动态调整资源规模,避免基础设施资源浪费,降低 TCO。 应对故障和容错:多实例部署和快速替换,提高业务连续性和可用性。 跟随需求变化:匹配前端的业务需求及压力,快速调整规模,提高事件应对能力,满足需求和期望。 Horizontal Pod Autoscaling Kubernetes 自身提供一种弹性伸缩的机制,包括 Vertical Pod Autoscaler (VPA)和 Horizontal Pod Autoscaler (HPA)。HPA 根据 CPU 、内存利用率增加或减少副本控制器的 pod 数量,它是一个扩缩资源规模的功能特性。 HPA 依赖 Metrics-Server 捕获 CPU、内存数据来提供资源使用测量数据,也可以根据自定义指标(如 Prometheus)进行扩缩。 由上图看出,HPA 持续监控 Metrics-Server 的指标情况,然后计算所需的副本数动态调整资源副本,实现设置目标资源值的水平伸缩。 但也有一定局限性: 无外部指标支持。如不同的事件源,不同的中间件/应用程序等,业务端的应用程序变化及依赖是多样的,不只是基于 CPU 和内存扩展。 无法 1->0。应用程序总有 0 负载的时候,此时不能不运行工作负载吗? 所以就有了Kubernetes-based Event-Driven Autoscaling(KEDA)! KEDA KEDA 基于事件驱动进行自动伸缩。什么是事件驱动?我理解是对系统上的各种事件做出反应并采取相应行动(伸缩)。那么 KEDA 就是一个 HPA+多种触发器。只要触发器收到某个事件被触发,KEDA 就可以使用 HPA 进行自动伸缩了,并且,KEDA 可以 1-0,0-1! 架构 KEDA 自身有几个组件: Agent: KEDA 激活和停止 Kubernetes 工作负载(keda-operator 主要功能) Metrics: KEDA 作为一个 Kubernetes 指标服务器,向 Horizontal Pod Autoscaler 提供丰富的事件数据,从源头上消费事件。(keda-operator-metrics-apiserver 主要作用)。 Admission Webhooks: 自动验证资源变化,以防止错误配置。 Event sources: KEDA 更改 pod 数量的外部事件/触发源。如 Prometheus、Kafka。 Scalers: 监视事件源,获取指标并根据事件触发伸缩。 Metrics adapter:从 Scalers 获取指标并发送给 HPA。 Controller: 根据 Adapter 提供的指标进行操作,调谐到 ScaledObject 中指定的资源状态。Scaler 根据 ScaledObject 中设置的事件源持续监视事件,发生任何触发事件时将指标传递给 Metrics Adapter。Metrics Adapter 调整指标并提供给 Controller 组件,Controller 根据 ScaledObject 中设置的缩放规则扩大或缩小 Deployment。 总的来说,KEDA 设置一个 ScaledObject,定义一个事件触发器,可以是来自消息队列的消息、主题订阅的消息、存储队列的消息、事件网关的事件或自定义的触发器。基于这些事件来自动调整应用程序的副本数量或处理程序的资源配置,以根据实际负载情况实现弹性伸缩。 CRD ScaledObjects:代表事件源(如 Rabbit MQ)和 Kubernetes。 Deployment、StatefulSet 或任何定义 / 规模子资源的自定义资源之间的所需映射。 ScaledJobs:事件源和 Kubernetes Jobs 之间的映射。根据事件触发调整 Job 规模。 TriggerAuthentications:触发器的认证参数。 ClusterTriggerAuthentications:集群维度认证。 部署 KEDA helm repo add kedacore https://kedacore.github.io/charts helm repo update kubectl create namespace keda helm install keda kedacore/keda --namespace keda kubectl apply -f https://github.com/kedacore/keda/releases/download/v2.10.1/keda-2.10.1.yaml root@node-1:/# kubectl get all -n keda NAME READY STATUS RESTARTS AGE pod/keda-metrics-apiserver-7d89dbcb54-v22nl 1/1 Running 0 44s pod/keda-operator-5bb9b49d7c-kh6wt 0/1 Running 0 44s NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/keda-metrics-apiserver ClusterIP 10.233.44.19 <none> 443/TCP,80/TCP 45s NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/keda-metrics-apiserver 1/1 1 1 45s deployment.apps/keda-operator 0/1 1 0 45s NAME DESIRED CURRENT READY AGE replicaset.apps/keda-metrics-apiserver-7d89dbcb54 1 1 1 45s replicaset.apps/keda-operator-5bb9b49d7c 1 1 0 45s root@node-1:/# kubectl get all -n keda NAME READY STATUS RESTARTS AGE pod/keda-metrics-apiserver-7d89dbcb54-v22nl 1/1 Running 0 4m8s pod/keda-operator-5bb9b49d7c-kh6wt 1/1 Running 0 4m8s NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/keda-metrics-apiserver ClusterIP 10.233.44.19 <none> 443/TCP,80/TCP 4m9s NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/keda-metrics-apiserver 1/1 1 1 4m9s deployment.apps/keda-operator 1/1 1 1 4m9s NAME DESIRED CURRENT READY AGE replicaset.apps/keda-metrics-apiserver-7d89dbcb54 1 1 1 4m9s replicaset.apps/keda-operator-5bb9b49d7c # kubectl get crd | grep keda clustertriggerauthentications.keda.sh 2023-05-11T09:26:06Z scaledjobs.keda.sh 2023-05-11T09:26:07Z scaledobjects.keda.sh 2023-05-11T09:26:07Z triggerauthentications.keda.sh 2023-05-11T09:26:07Z KubeSphere 部署 KEDA kubectl edit cc -n kubesphere-system (kubesphere 3.4+) spec: ··· autoscaling: enabled: true ··· 扩展工作负载 CRD ScaledObject 资源定义,详情参数请看 :https://keda.sh/docs/2.10/concepts/scaling-deployments/。 apiVersion: keda.sh/v1alpha1 kind: ScaledObject metadata: name: {scaled-object-name} spec: scaleTargetRef: apiVersion: {api-version-of-target-resource} # Optional. Default: apps/v1 kind: {kind-of-target-resource} # Optional. Default: Deployment name: {name-of-target-resource} # Mandatory. Must be in the same namespace as the ScaledObject envSourceContainerName: {container-name} # Optional. Default: .spec.template.spec.containers[0] pollingInterval: 30 # Optional. Default: 30 seconds cooldownPeriod: 300 # Optional. Default: 300 seconds idleReplicaCount: 0 # Optional. Default: ignored, must be less than minReplicaCount minReplicaCount: 1 # Optional. Default: 0 maxReplicaCount: 100 # Optional. Default: 100 fallback: # Optional. Section to specify fallback options failureThreshold: 3 # Mandatory if fallback section is included replicas: 6 # Mandatory if fallback section is included advanced: # Optional. Section to specify advanced options restoreToOriginalReplicaCount: true/false # Optional. Default: false horizontalPodAutoscalerConfig: # Optional. Section to specify HPA related options name: {name-of-hpa-resource} # Optional. Default: keda-hpa-{scaled-object-name} behavior: # Optional. Use to modify HPA's scaling behavior scaleDown: stabilizationWindowSeconds: 300 policies: - type: Percent value: 100 periodSeconds: 15 triggers: # {list of triggers to activate scaling of the target resource} 查看 KEDA Mterics Server 暴露的指标 kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1" Demo KEDA 目前支持 53 种 Scalers,如 Kafka,Elasticsearch,MySQL,RabbitMQ,Prometheus 等等。 此处演示一个 Prometheus 和 Kafka 的例子。 Prometheus & KEDA 部署一个 Web 应用,使用 Prometheus 监控 Web 应用 http 请求指标。 为寻求演示效果,此处部署了一个有点击,互动的 Demo APP,地址如下:https://github.com/livewyer-ops/keda-demo/blob/v1.0.0/examples/keda/。 部署成功后通过 NodePort 访问: 进入 KubeSphere 项目,新建一个自定义伸缩: 设置最小副本数为 1,最大副本数为 10,轮询间隔 5 秒,等待时间为 1 分钟: KubeSphere 支持 Cron、Prometheus,和自定义触发器: 触发器设置 Prometheus,设置请求为 30s 内的增长率总和,当阈值大于 3 时事件驱动触发缩放: 设置一些其他设置,如资源删除后是否恢复指本来的副本数,以及扩缩策略设置: 现在并发访问 Web App: 可以在自定义监控看到监控指标的变化: Web App 的副本数开始横向扩展: 最终扩展到 ScaledObject 中定义的 10 个副本: 在访问停止后,可以看到监控指标的数值在慢慢变小: Deployment 开始缩容: Kafka & KEDA KEDA 使用 Kafka 事件源演示的整体拓扑如下: Kafka 使用 Demo 代码:https://github.com/ChamilaLiyanage/kafka-keda-example.git。 部署 Kafka 打开 KubeSphere 应用商店,查看 DMP 数据库中心: 选择 Kafka,进行安装: 安装好 Kafka 后,创建一个测试的 Kafka Topic,Topic 分区设置为 5,副本设置为 1: 创建 Kafka Producer 服务: 向主题发送订单: 创建 Consumer 服务: 发送新订单看 Consumer 服务是否消费: 现在可以来做自动伸缩了,创建一个 ScaledObject,设置最小副本数为 0,最大为 10,轮询间隔为 5s,Kafka LagThreshold 为 10: apiVersion: keda.k8s.io/v1alpha1 kind: ScaledObject metadata: name: kafka-scaledobject namespace: default labels: deploymentName: kafka-consumer-deployment # Required Name of the deployment we want to scale. spec: scaleTargetRef: deploymentName: kafka-consumer-deployment # Required Name of the deployment we want to scale. pollingInterval: 5 minReplicaCount: 0 #Optional Default 0 maxReplicaCount: 10 #Optional Default 100 triggers: - type: kafka metadata: # Required BootstrapeServers: radondb-kafka-kafka-external-bootstrap.demo:9092 # Kafka bootstrap server host and port consumerGroup: order-shipper # Make sure that this consumer group name is the same one as the one that is consuming topics topic: test lagThreshold: "10" # Optional. How much the stream is lagging on the current consumer group 创建自定义伸缩: 现在,让我们向队列提交大约 100,000 条订单消息,看看自动缩放的实际效果。你会看到随着队列中多余消息的增长,将会产生更多的 kafka-consumer pod。 NAMESPACE NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE demo keda-hpa-kafka-consumer Deployment/kafka-consumer 5/10 (avg) 1 10 1 2m35s 此处我们看到最大到 5 个副本,没有到 10 个副本,因为默认最大副本数不会超过 Kafka 主题分区数量,上面设置了分区为 5,可以激活 allowIdleConsumers: true 来禁用这个默认行为。 重新编辑自定义伸缩后,最大副本变化成 10: 在无消息消费时,副本变化为 0: 结尾 到这里本篇就结束了,对此有需求或感兴趣的小伙伴可以操练起来了。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

4步上手Meson:让PostgreSQL 16 构建更现代化!

导 读 从PostgreSQL 16开始,除了传统的./configure和Makefile,我们将可以选择使用现代构建系统Meson来构建PostgreSQL。 几周前,当我在为PostgreSQL开发社区补丁时,我开始练习meson,我被告知除了通常的Makefile之外,还需要更新meson.build文件。这也意味着,如果您正在做开发社区功能的工作时,你需要考虑meson。今天,我将分享如何在Ubuntu 18.04上使用meson构建PostgreSQL的方法,希望对您有所帮助。 01Meson vs Makefile Makefile 广泛使用、成熟和稳定。 Makefile语法是复杂的,编辑和维护起来很繁琐。对于非常大或复杂的项目,它可能变得难以管理。 Meson 语法简洁,易于理解和编写。 提供快速高效的编译过程,同时保持易用性和灵活性。 🔗Meson:https://mesonbuild.com/ 02安装 我们需要安装Meson和Ninja才能开始使用它。版本非常重要,使用过旧或过新的版本可能会导致在构建过程中出现错误。以下版本已经过确认可以正常工作(由我测试): lmeson v0.57.2 (minimum meson version recommended by PostgreSQL), github downloadlink-1 lninja v1.10.1, github downladlink-2 link-1: https://github.com/mesonbuild/meson/releases/download/0.57.2/meson-0.57.2.tar.gz link-2: https://www.highgo.ca/2023/07/14/building-postgresql-in-a-modern-way-with-meson/ 下载好它们后,您需要将它们添加到PATH环境变量中,并将ninja放在/usr/bin/ninja中,以便构建脚本可以找到它们。 我也尝试过将Meson v0.57.2与更新版本的Ninja一起使用,但在构建过程中遇到了错误,因此我不能保证不同版本组合的构建是否会正常工作。::>_<:: 03构建 Meson构建在PostgreSQL 16中可用,这个版本尚未正式发布,因此我们需要在主PG16开发分支上使用此功能。您可以在这里克隆官方的PostgreSQL源代码。 如果您之前已经运行过./configure和构建了PostgreSQL,则需要通过以下方式来撤销之前的操作。 $makemaintainer-clean 如果您想从头开始,可以执行以下步骤: $gitclonehttps://github.com/postgres/postgres.git 现在,我们准备进行Meson构建。我们首先设置一个文件夹(在postgres文件夹内部),用于存储所有构建输出、日志、测试输出、配置等。 我们还可以在设置阶段传递特殊的构建参数。这些生成参数类似于传递给经典./configure脚本的参数。例如: $cdpostgres $mesonsetupbuild--prefix=$PWD/highgo-Dcassert=true'-DPG_TEST_EXTRA=kerberosldap'-Dbuildtype=debug --prefix命令配置安装前缀,就像./configure一样。其余的可选构建参数通过-D参数名(无空格)传递给meson。 我们可以使用以下命令查看可能的参数列表及其描述: $mesonconfigure WARNING:Thesourcedirectoryinsteadofthebuilddirectorywasspecified. WARNING:Onlythedefaultvaluesfortheprojectareprinted,andallcommandlineparametersareignored. Coreproperties: Sourcedir/home/caryh/postgres Mainprojectoptions: CoreoptionsDefaultValuePossibleValuesDescription --------------------------------------------------- ... buildtypedebugoptimized[plain,debug,debugoptimized,release,minsize,custom]Buildtypetouse ... cassertfalse[true,false]Enableassertionchecks(fordebugging) ... PG_TEST_EXTRAEnableselectedextratests ... ...andmanymore 由于我们在构建文件夹外运行meson configure,因此它会向您发出警告,指出它仅打印构建的默认值和可能值。要查看当前值,我们需要在创建的文件夹中重新运行相同的命令。 $cdbuild $mesonconfigure Coreproperties: Sourcedir/home/caryh/postgres Builddir/home/caryh/postgres/build Mainprojectoptions: CoreoptionsCurrentValuePossibleValuesDescription --------------------------------------------------- ... buildtypedebug[plain,debug,debugoptimized,release,minsize,custom]Buildtypetouse ... casserttrue[true,false]Enableassertionchecks(fordebugging) ... PG_TEST_EXTRAkerberosldapEnableselectedextratests ....andmanymore 如果您需要更改任何构建参数,你也可以在构建文件夹内部进行更改,而不是像以前那样再次运行。 $mesonconfigure-Dcassert=false 当我们确定了构建参数后,我们可以通过在构建文件夹中运行以下命令来构建和安装: $ninja $sudoninjainstall 就是这样!😁 04运行测试套件 我们知道PostgreSQL源代码仓库中包含了许多测试用例,以确保软件正常工作。通常,我们会分别运行make check或make check-world来执行核心进程、扩展和前端工具的测试套件。在Meson中,所有这些都可以一次性运行。只需在构建文件夹内运行以下命令: $mesontest 1/257postgresql:setup/tmp_installOK8.48s 2/257postgresql:setup/install_test_filesOK0.06s 3/257postgresql:pg_upgrade/pg_upgrade/001_basicOK0.18s8subtestspassed 4/257postgresql:recovery/recovery/002_archivingOK3.61s8subtestspassed 5/257postgresql:recovery/recovery/003_recovery_targetsOK6.73s9subtestspassed 6/257postgresql:recovery/recovery/004_timeline_switchOK6.99s3subtestspassed 7/257postgresql:recovery/recovery/005_replay_delayOK7.58s3subtestspassed 8/257postgresql:recovery/recovery/006_logical_decodingOK4.78s20subtestspassed 9/257postgresql:recovery/recovery/001_stream_repOK10.34s59subtestspassed 10/257postgresql:recovery/recovery/007_sync_repOK6.20s11subtestspassed 11/257postgresql:recovery/recovery/010_logical_decoding_timelinesOK4.59s13subtestspassed 12/257postgresql:recovery/recovery/013_crash_restartOK3.55s18subtestspassed 13/257postgresql:recovery/recovery/014_unlogged_reinitOK3.72s23subtestspassed 14/257postgresql:recovery/recovery/012_subtransactionsOK6.63s12subtestspassed 15/257postgresql:recovery/recovery/009_twophaseOK11.63s24subtestspassed 16/257postgresql:recovery/recovery/016_min_consistencyOK4.34s1subtestspassed 17/257postgresql:recovery/recovery/015_promotion_pagesOK4.74s1subtestspassed 18/257postgresql:recovery/recovery/008_fsm_truncationOK14.55s1subtestspassed 19/257postgresql:recovery/recovery/017_shmOK5.23s4subtestspassed ... 36/257postgresql:kerberos/kerberos/001_authERROR0.21s(exitstatus255orsignal127SIGinvalid) ... 236/257postgresql:ldap_password_func/ldap_password_func/001_mutated_bindpasswdERROR0.19s(exitstatus255orsignal127SIGinvalid) ... 249/257postgresql:ldap/ldap/001_authERROR0.17s(exitstatus255orsignal127SIGinvalid) 250/257postgresql:ldap/ldap/002_bindpasswdERROR0.18s(exitstatus255orsignal127SIGinvalid) ... Ok:251 ExpectedFail:0 Fail:4 UnexpectedPass:0 Skipped:2 Timeout:0 我有 4个与 ldap 和 kerberos 相关的测试用例,因为我没有设置这些服务,所以失败是在预料之内的。我想更多地强调这些额外的测试用例,除非我们在$PG_TEST_EXTRA环境变量中指定它们,否则这些用例通常不会在传统设置中运行。在传统方式中,要运行额外的测试,如 ldap 和 kerberos,我们需要执行以下操作: $cdsrc/test/ldap $makecheckPG_TEST_EXTRA=ldap or $cdsrc/test/kerberos $makecheckPG_TEST_EXTRA=kerberos 默认情况下不会运行这些测试,因为它们需要设置单独的服务或者运行不安全的服务。使用Meson,如果您需要运行这些额外的测试,除非你在构建选项中明确定义-DPG_TEST_EXTRA为构建选项之一,不然的话以下命令将不起作用。 $exportPG_TEST_EXTRA="ldapkerberos" $mesontest ===>willskipldapandkerberostestsifyoudidnotdo'-DPG_TEST_EXTRA=kerberosldap'duringmesonsetup 05结论 🏆总体而言,Meson提供了一种现代,直观和高效的方法来构建软件项目。虽然 Makefile 仍然是一个广泛使用且功能强大的构建系统,但Meson为现代的开发工作流程提供了更简洁和用户友好的体验。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册