首页 文章 精选 留言 我的

精选列表

搜索[龙虾全家桶],共2465篇文章
优秀的个人博客,低调大师

手把手教你用 NebulaGraph AI 全家桶跑图算法

前段时间 NebulaGraph 3.5.0 发布,@**whitewum** 吴老师建议我把前段时间 NebulaGraph 社区里开启的新项目 ng_ai 公开给大家。 所以,就有了这个系列文章,本文是该系列的开篇之作。 ng_ai 是什么 ng_ai 的全名是:Nebulagraph AI Suite,顾名思义,它是在 NebulaGraph 之上跑算法的 Python 套件,希望能给 NebulaGraph 的用户一个自然、简洁的高级 API。简单来说,用很少的代码量就可以执行图上的算法相关的任务。 ng_ai 这个开源项目的目标是,快速迭代、公开讨论、持续演进,一句话概述便是: Simplifying things in surprising ways. 这个 ng_ai 的专属 url:https://github.com/wey-gu/nebulagraph-ai 可以帮你了解更全面的它。 ng_ai 的特点 为了让 NebulaGraph 社区的小伙伴拥有顺滑的算法体验,ng_ai 有以下特点: 与 NebulaGraph 紧密结合,方便从其中读、写图数据 支持多引擎、后端,目前支持 Spark(NebulaGraph Algorithm)、NetworkX,之后会支持 DGL、PyG 友好、符合直觉的 API 设计 与 NebulaGraph 的 UDF 无缝结合,支持从 Query 中调用 ng_ai 任务 友好的自定义算法接口,方便用户自己实现算法(尚未完成) 一键试玩环境(基于 Docker Extensions) 你可以这么用 ng_ai 跑分布式 PageRank 算法 可以在一个大图上,基于 nebula-algorithm 分布式地跑 PageRank 算法,像是这样: from ng_ai import NebulaReader # scan 模式,通过 Spark 引擎读取数据 reader = NebulaReader(engine="spark") reader.scan(edge="follow", props="degree") df = reader.read() # 运行 PageRank 算法 pr_result = df.algo.pagerank(reset_prob=0.15, max_iter=10) 写回算法结果到 NebulaGraph 假设我们要跑一个 Label Propagation 算法,然后把结果写回 NebulaGraph,我们可以这么做: 先确保结果中要写回图数据库的数据 Schema 已经创建好了,像是下面的示例,便是写到 label_propagation.cluster_id 字段里: CREATE TAG IF NOT EXISTS label_propagation ( cluster_id string NOT NULL ); 下面,我们来看下具体流程。执行算法: df_result = df.algo.label_propagation() 再看一下结果的 Schema: df_result.printSchema() root |-- _id: string (nullable = false) |-- lpa: string (nullable = false) 参考下面的代码,把 lpa 的结果写回 NebulaGraph 中的 cluster_id 字段里({"lpa": "cluster_id"}): from ng_ai import NebulaWriter from ng_ai.config import NebulaGraphConfig config = NebulaGraphConfig() writer = NebulaWriter( data=df_result, sink="nebulagraph_vertex", config=config, engine="spark" ) # 将 lpa 同 cluster_id 进行映射 properties = {"lpa": "cluster_id"} writer.set_options( tag="label_propagation", vid_field="_id", properties=properties, batch_size=256, write_mode="insert", ) # 将数据写回到 NebulaGraph writer.write() 最后,验证一下: USE basketballplayer; MATCH (v:label_propagation) RETURN id(v), v.label_propagation.cluster_id LIMIT 3; 结果: +-------------+--------------------------------+ | id(v) | v.label_propagation.cluster_id | +-------------+--------------------------------+ | "player103" | "player101" | | "player113" | "player129" | | "player121" | "player129" | +-------------+--------------------------------+ 更详细的例子参考:ng_ai/examples 通过 nGQL 调用算法 自 NebulaGraph v3.5.0 开始,用户可从 nGQL 中调用自己实现的函数。而 ng_ai 也用这个能力来实现了一个自己的 ng_ai 函数,让它从 nGQL 中调用 ng_ai 的算法,例如: -- 准备将要写入数据的 Schema USE basketballplayer; CREATE TAG IF NOT EXISTS pagerank(pagerank string); :sleep 20; -- 回调 ng_ai() RETURN ng_ai("pagerank", ["follow"], ["degree"], "spark", {space: "basketballplayer", max_iter: 10}, {write_mode: "insert"}) 更详细的例子参考:ng_ai/examples 单机运行算法 在单机、本地的环境,ng_ai 支持基于 NetworkX 运行算法。 举个例子,读取图为 ng_ai graph 对象: from ng_ai import NebulaReader from ng_ai.config import NebulaGraphConfig # query 模式,通过 NebulaGraph 或是 NetworkX 引擎读取数据 config_dict = { "graphd_hosts": "graphd:9669", "user": "root", "password": "nebula", "space": "basketballplayer", } config = NebulaGraphConfig(**config_dict) reader = NebulaReader(engine="nebula", config=config) reader.query(edges=["follow", "serve"], props=[["degree"], []]) g = reader.read() 查看、画图: g.show(10) g.draw() 运行算法: pr_result = g.algo.pagerank(reset_prob=0.15, max_iter=10) 写回 NebulaGraph: from ng_ai import NebulaWriter writer = NebulaWriter( data=pr_result, sink="nebulagraph_vertex", config=config, engine="nebula", ) # 待写入的属性 properties = ["pagerank"] writer.set_options( tag="pagerank", properties=properties, batch_size=256, write_mode="insert", ) # 将数据写回到 NebulaGraph writer.write() 其他算法: # 获取所有算法 g.algo.get_all_algo() # 获取相关算法的帮助信息 help(g.algo.node2vec) # 调用算法 g.algo.node2vec() 更详细的例子参考:ng_ai/examples 可视化图算法结果 这里演示一个 NetworkX 引擎情况下,计算 Louvain、PageRank 并可视化的例子: 先执行两个图算法: pr_result = g.algo.pagerank(reset_prob=0.15, max_iter=10) louvain_result = g.algo.louvain() 再手写一个画图好看的函数: from matplotlib.colors import ListedColormap def draw_graph_louvain_pr(G, pr_result, louvain_result, colors=["#1984c5", "#22a7f0", "#63bff0", "#a7d5ed", "#e2e2e2", "#e1a692", "#de6e56", "#e14b31", "#c23728"]): # 设定节点的位置 pos = nx.spring_layout(G) # 新建一个图形并设置坐标轴 fig, ax = plt.subplots(figsize=(35, 15)) ax.set_xlim(-1, 1) ax.set_ylim(-1, 1) # 从颜色列表中创建一个 colormap cmap = ListedColormap(colors) # 将图中的节点和边进行绘图 node_colors = [louvain_result[node] for node in G.nodes()] node_sizes = [70000 * pr_result[node] for node in G.nodes()] nx.draw_networkx_nodes(G, pos=pos, ax=ax, node_color=node_colors, node_size=node_sizes, cmap=cmap, vmin=0, vmax=max(louvain_result.values())) nx.draw_networkx_edges(G, pos=pos, ax=ax, edge_color='gray', width=1, connectionstyle='arc3, rad=0.2', arrowstyle='-|>', arrows=True) # 提取边数据中的 label 数据作为字典 edge_labels = nx.get_edge_attributes(G, 'label') # 在图中加入边的 label 数据 for edge, label in edge_labels.items(): ax.text((pos[edge[0]][0] + pos[edge[1]][0])/2, (pos[edge[0]][1] + pos[edge[1]][1])/2, label, fontsize=12, color='black', ha='center', va='center') # 在图中加入点的 label 数据 node_labels = {n: G.nodes[n]['label'] if 'label' in G.nodes[n] else n for n in G.nodes()} nx.draw_networkx_labels(G, pos=pos, ax=ax, labels=node_labels, font_size=12, font_color='black') # 为同社区数据添加相同颜色 sm = plt.cm.ScalarMappable(cmap=cmap, norm=plt.Normalize(vmin=0, vmax=max(louvain_result.values()))) sm.set_array([]) cbar = plt.colorbar(sm, ax=ax, ticks=range(max(louvain_result.values()) + 1), shrink=0.5) cbar.ax.set_yticklabels([f'Community {i}' for i in range(max(louvain_result.values()) + 1)]) # 数据展示 plt.show() draw_graph_louvain_pr(G, pr_result=pr_result, louvain_result=louvain_result) 效果如下所示: 更详细的例子参考:ng_ai/examples 更方便的 Notebook 操作 NebulaGraph 结合 NebulaGraph 的 Jupyter Notebook 插件: https://github.com/wey-gu/ipython-ngql,我们还可以更便捷地操作 NebulaGraph: 可通过 ng_ai 的 extras 在 Jupyter Notbook 中安装插件: %pip install ng_ai[jupyter] %load_ext ngql 当然,也可以单独安装插件: %pip install ipython-ngql %load_ext ngql 安装完成后,就可以在 Notebook 里直接使用 %ngql 命令来执行 nGQL 语句: %ngql --address 127.0.0.1 --port 9669 --user root --password nebula %ngql USE basketballplayer; %ngql MATCH (v:player{name:"Tim Duncan"})-->(v2:player) RETURN v2.player.name AS Name; 注,多行的 Query 用两个百分号就好了 %%ngql 最后,我们还能在 Jupyter Notebook 里直接可视化渲染结果!只需要 %ng_draw 就可以啦! %ngql match p=(:player)-[]->() return p LIMIT 5 %ng_draw 效果如下: 未来工作 现在 ng_ai 还在开发中,我们还有很多工作要做: [ ] 完善 Reader 模式,现在 NebulaGraph / NetworkX 的读取数据只支持 Query-Mode,还需要支持 Scan-Mode [ ] 实现基于 dgl(GNN)的链路预测、节点分类等算法,例如: model = g.algo.gnn_link_prediction() result = model.train() # query src, dst to be predicted model.predict(src_vertex, dst_vertices) [ ] UDA,自定义算法 [ ] 快速部署工具 ng_ai 完全 build in public,欢迎社区的大家们来参与,一起来完善 ng_ai,让 NebulaGraph 上的 AI 算法更加简单、易用! 试玩 ng_ai 我们已经准备好了一键部署的 NebulaGraph + NebulaGraph Studio + ng_ai in Jupyter 的环境,只需要大家从 Docker Desktop 的 Extension(扩展)中搜索 NebulaGraph,就可以试玩了。 安装 NebulaGraph Docker 插件 在 Docker Desktop 的插件市场搜索 NebulaGraph,点击安装: 安装 ng_ai Playground 进入 NebulaGraph 插件,点击 Install NX Mode,安装 ng_ai 的 NetworkX Playground,通常要等几分钟等待安装完成。 进入 NetworkX Playground 点击 Jupyter NB NetworkX,进入 NetworkX Playground。 ng_ai 的架构 ng_ai 的架构如下,它的核心模块有: Reader:负责从 NebulaGraph 读取数据 Writer:负责将数据写入 NebulaGraph Engine:负责适配不同运行时,例如 Spark、DGL、NetowrkX 等 Algo:算法模块,例如 PageRank、Louvain、GNN_Link_Predict 等 此外,为了支持 nGQL 中的调用,还有两个模块: ng_ai-udf:负责将 UDF 注册到 NebulaGraph,接受 ng_ai 的 Query 调用,访问 ng_ai API ng_ai-api:ng_ai 的 API 服务,接受 UDF 的调用,访问 ng_ai 核心模块 ┌───────────────────────────────────────────────────┐ │ Spark Cluster │ │ .─────. .─────. .─────. .─────. │ │ ; : ; : ; : ; : │ ┌─▶│ : ; : ; : ; : ; │ │ │ ╲ ╱ ╲ ╱ ╲ ╱ ╲ ╱ │ │ │ `───' `───' `───' `───' │ Algo Spark │ Engine└───────────────────────────────────────────────────┘ │ ┌────────────────────────────────────────────────────┬──────────┐ └──┤ │ │ │ NebulaGraph AI Suite(ngai) │ ngai-api │◀─┐ │ │ │ │ │ └──────────┤ │ │ ┌────────┐ ┌──────┐ ┌────────┐ ┌─────┐ │ │ │ │ Reader │ │ Algo │ │ Writer │ │ GNN │ │ │ ┌───────▶│ └────────┘ └──────┘ └────────┘ └─────┘ │ │ │ │ │ │ │ │ │ │ │ │ ├────────────┴───┬────────┴─────┐ └──────┐ │ │ │ │ ▼ ▼ ▼ ▼ │ │ │ │ ┌─────────────┐ ┌──────────────┐ ┌──────────┐ ┌──────────┐ │ │ │ ┌──┤ │ SparkEngine │ │ NebulaEngine │ │ NetworkX │ │ DGLEngine│ │ │ │ │ │ └─────────────┘ └──────────────┘ └──────────┘ └──────────┘ │ │ │ │ └──────────┬────────────────────────────────────────────────────┘ │ │ │ │ Spark │ │ │ └────────Reader ────────────┐ │ │ Spark Query Mode │ │ │ Reader │ │ │Scan Mode ▼ ┌─────────┐ │ │ ┌───────────────────────────────────────────────────┬─────────┤ ngai-udf│◀─────────────┐ │ │ │ │ └─────────┤ │ │ │ │ NebulaGraph Graph Engine Nebula-GraphD │ ngai-GraphD │ │ │ │ ├──────────────────────────────┬────────────────────┼───────────────────┘ │ │ │ │ │ │ │ │ │ │ NebulaGraph Storage Engine │ │ │ │ │ │ │ │ │ │ └─▶│ Nebula-StorageD │ Nebula-Metad │ │ │ │ │ │ │ │ └──────────────────────────────┴────────────────────┘ │ │ │ │ ┌───────────────────────────────────────────────────────────────────────────────────────┐ │ │ │ RETURN ng_ai("pagerank", ["follow"], ["degree"], "spark", {space:"basketballplayer"}) │──┘ │ └───────────────────────────────────────────────────────────────────────────────────────┘ │ ┌─────────────────────────────────────────────────────────────┐ │ │ from ng_ai import NebulaReader │ │ │ │ │ │ # read data with spark engine, scan mode │ │ │ reader = NebulaReader(engine="spark") │ │ │ reader.scan(edge="follow", props="degree") │ └──│ df = reader.read() │ │ │ │ # run pagerank algorithm │ │ pr_result = df.algo.pagerank(reset_prob=0.15, max_iter=10) │ │ │ └─────────────────────────────────────────────────────────────┘ 谢谢你读完本文 (///▽///) 欢迎前往 GitHub 来阅读 NebulaGraph 源码,或是尝试用它解决你的业务问题 yo~ GitHub 地址:https://github.com/vesoft-inc/nebula
优秀的个人博客,低调大师

React全家桶实战:Redux+Antd+Hooks构建企业级前端应用

在2026年的前端生态中,React依然占据着核心地位。但“会用”和“精通”之间,往往隔着对状态管理、UI组件库和Hooks组合能力的深度理解。本文不搞“Hello World”式教学,直接从一个真实的企业级后台管理场景出发,带你走通 React 18 + Redux Toolkit + Ant Design 5 + React Hooks 的全链路实战,重点解决:状态分层设计、异步数据流治理、组件逻辑复用与性能优化。读完本文,你将获得一套可直接投入生产的架构模板。

优秀的个人博客,低调大师

阿里发布 Qwen2.5 “全家桶” —— 历史上最大的开源发布

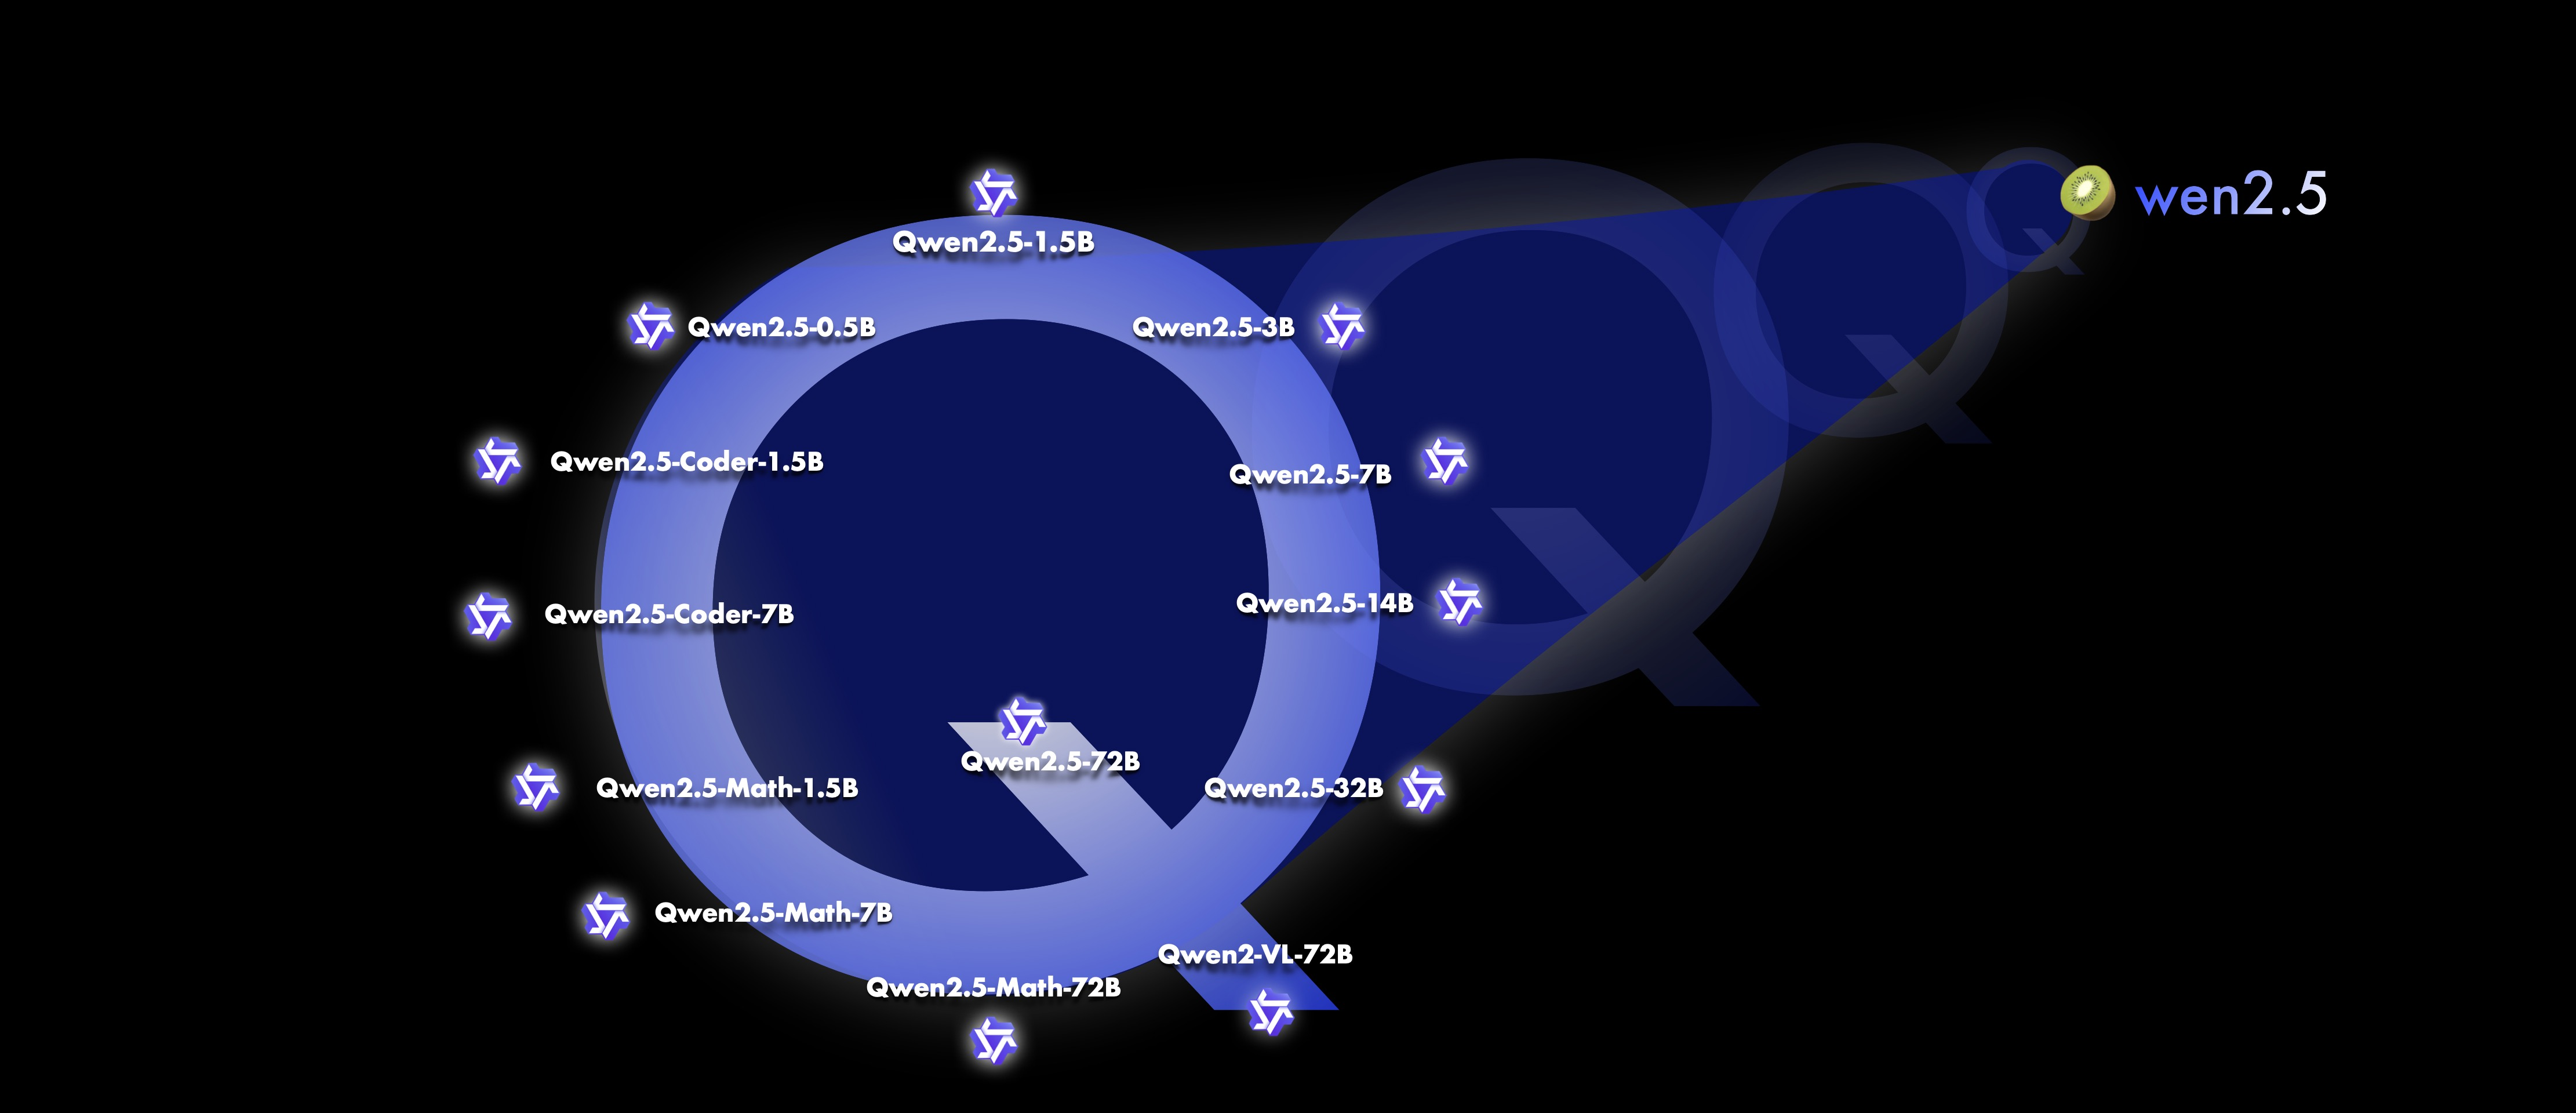
阿里今天发布了 Qwen 家族的最新成员:Qwen2.5,包括语言模型Qwen2.5,以及专门针对编程的Qwen2.5-Coder和数学的Qwen2.5-Math模型。 所有开放权重的模型都是稠密的、decoder-only 的语言模型,提供多种不同规模的版本,包括: Qwen2.5: 0.5B, 1.5B, 3B, 7B, 14B, 32B, 以及72B; Qwen2.5-Coder: 1.5B, 7B, 以及即将推出的32B; Qwen2.5-Math: 1.5B, 7B, 以及72B。 除了 3B 和 72B 的版本外,所有的开源模型都采用了 Apache 2.0 License。 Qwen2.5 主要升级内容 Qwen2.5 获得了显著更多的知识,在编程能力和数学能力有大幅提升。 在指令执行、生成长文本、理解结构化数据以及生成结构化输出方面有显著改进。 对各种 system prompt 更具适应性,增强了角色扮演实现和聊天机器人的条件设置功能。 Qwen2.5-Coder 使即使较小的编程专用模型也能在编程评估基准测试中表现出媲美大型语言模型的竞争力。 Qwen2.5-Math 支持 中文 和 英文,并整合了多种推理方法,包括 CoT、PoT 和 TIR。 Qwen2.5-Coder &Qwen2.5-Math 性能表现 据介绍,Qwen2.5语言模型在阿里最新的大规模数据集上进行了预训练,该数据集包含多达18Ttokens。 相较于 Qwen2,Qwen2.5 获得了显著更多的知识(MMLU:85+),并在编程能力(HumanEval 85+)和数学能力(MATH 80+)方面有了大幅提升。 此外,新模型在指令执行、生成长文本(超过 8K 标记)、理解结构化数据(例如表格)以及生成结构化输出特别是 JSON 方面取得了显著改进。 Qwen2.5 模型总体上对各种 system prompt 更具适应性,增强了角色扮演实现和聊天机器人的条件设置功能。 与 Qwen2 类似,Qwen2.5 语言模型支持高达128Ktokens,并能生成最多8Ktokens的内容。它们同样保持了对包括中文、英文、法文、西班牙文、葡萄牙文、德文、意大利文、俄文、日文、韩文、越南文、泰文、阿拉伯文等 29 种以上语言的支持。 专业领域的专家语言模型,即用于编程的Qwen2.5-Coder和用于数学的Qwen2.5-Math,相比其前身 CodeQwen1.5 和 Qwen2-Math 有了实质性的改进。 具体来说,Qwen2.5-Coder 在包含5.5Ttokens 编程相关数据上进行了训练,使即使较小的编程专用模型也能在编程评估基准测试中表现出媲美大型语言模型的竞争力。 同时,Qwen2.5-Math 支持中文和英文,并整合了多种推理方法,包括 CoT(Chain of Thought)、PoT(Program of Thought)和 TIR(Tool-Integrated Reasoning)。 详情查看发布公告。

优秀的个人博客,低调大师

开发者实战丨如何利用 OpenVINO™ 部署 Phi-3.5 全家桶

点击蓝字 关注我们,让开发变得更有趣 作者 | 杨亦诚 英特尔 AI 软件工程师 卢建晖 微软高级云技术布道师 排版| 吴紫琴 OpenVINO™ 近期微软发布其最新的 Phi-3.5 系列 SLM 模型, Phi-3.5-mini, Phi-3.5-vision, 以及 Phi-3.5-MoE,其中 Phi-3.5-mini 增加了多语种以及128k上下文长度的支持,提升中文输入的使用体验;Phi-3.5-vision 全面支持多图片理解任务,拓宽了其在视频理解任务类中的应用场景。 英特尔 AI PC 可以帮助用户利用人工智能技术提高工作效率、创意、游戏、娱乐和安全等性能。它搭载 CPU、GPU 和 NPU,可在本地更高效地处理 AI 任务。其中我们可以依靠 CPU 来运行较小的工作负载并实现低延迟,而 GPU 则非常适合需要并行吞吐量的大型工作负载,例如大语言模型推理任务,NPU 能够以低功耗处理持续运行 AI 工作负载,提高效率。开发者可以利用英特尔 OpenVINO™ 工具套件充分激活这些AI处理单元,更高效地部署深度学习模型,其中 Phi-3. 5 就是一个非常适合运行在 AI PC 上的模型任务。本文将分享如何利用 OpenVINO™ 在你的 AI PC 上部署最新 Phi-3.5-mini 及 Phi-3.5-vision 模型。 项目示例地址: https://github.com/openvino-dev-samples/Phi-3-workshop phi-3cookbook : https://aka.ms/phi-3cookbook OpenVINO™ Phi-3.5-mini 1. 模型转换与量化 由于 Phi-3.5 的预训练模型是基于 PyTorch 框架的,因此我们可以利用 Optimum-intel 的命令型工具快速从 Hugging Face 上导出 Phi-3.5-mini 的预训练模型,并通过内置的 NNCF 工具对模型进行权重量化压缩,以此提升推理性能,降低资源占用。 optimum-cliexport openvino--model microsoft/Phi-3.5-mini-instruct --task text-generation-with-past--weight-format int4--group-size 128--ratio 0.6--sym--trust-remote-code phi-3.5-mini-instruct-ov 开发者可以根据模型的输出结果,调整其中的量化参数,包括: weight-format:量化精度,可以选择 fp32,fp16,int8,int4,int4_sym_g128,int4_asym_g128,int4_sym_g64,int4_asym_g64。 group-size:权重里共享量化参数的通道数量。 ratio:int4/int8 权重比例,默认为1.0,0.6表示60%的权重以 int4 表,40%以 int8 表示。 sym:是否开启对称量化。 更多参数选项可以通过:optimum-cli export openvino -h 命令查询。 2.Optimum-intel部署 为了方便 Transformers 库用户体验 OpenVINO™,开发者可以利用 Optimum-intel 所提供的类 Transformers API 进行模型任务的部署。在不改变原本代码逻辑的前提下,只需要将 AutoModelForCausalLM 对象切换为 OVModelForCausalLM,便可以轻松实现对于推理后端的迁移,利用 OpenVINO™ 来加速 Phi-3.5-mini 原有的 Pipeline。 from optimum.intel.openvino import OVModelForCausalLMfrom transformers import AutoConfig, AutoTokenizerov_model = OVModelForCausalLM.from_pretrained( llm_model_path, device='GPU', config=AutoConfig.from_pretrained(llm_model_path, trust_remote_code=True), trust_remote_code=True,)tok = AutoTokenizer.from_pretrained(llm_model_path, trust_remote_code=True)prompt = "<|user|>\n你了解 .NET 吗?\n<|end|><|assistant|>\n"input_tokens = tok(prompt, return_tensors="pt", **tokenizer_kwargs)answer = ov_model.generate(**input_tokens, max_new_tokens=1024)tok.batch_decode(answer, skip_special_tokens=True)[0] 除此以外,你也可以通过 device 来指定模型部署的硬件平台为英特尔 CPU 或是 GPU。 3.GenAI API部署 当然考虑到 Transformers 中大量的第三方依赖,如果开发者想实现轻量化部署的目的,也可以利用 OpenVINO™ 原生的 GenAI API 来构建推理任务,由于 GenAI API 底层的 pipeline 是基于 C++ 构建,同时优化了 chat 模式下 kvcache 的缓存逻辑,因此相较 Optimum-intel,GenAI API 的资源占用和性能都是更优的。 import openvino_genai as ov_genaipipe=ov_genai.LLMPipeline(llm_model_path,"GPU") 可以看到在使用 GenAI API 的情况下,我们仅用3行代码就构建起了一个完整的文本生成任务 Pipeline。 OpenVINO™ Phi-3.5-vision 1. 模型转换与量化 目前 Phi-3.5-vision 的推理任务还没有被完全集成进 Optimum 工具中,因此我们需要手动完成模型的转换和量化,其中包含语言模型 lang_model,图像编码模型 image_embed,token 编码模型 embed_token 模型以及图像特征映射模型 img_projection。 为了简化转化步骤,我们提前对这些转化任务行进行了封装,开发者只需要调用示例中提供的函数便可完成这些模型的转换,并对其中负载最大的语言模型进行量化。 from ov_phi3_vision import convert_phi3_modelmodel_id = "microsoft/Phi-3.5-vision-instruct"out_dir = Path("../model/phi-3.5-vision-instruct-ov")compression_configuration = { "mode": nncf.CompressWeightsMode.INT4_SYM, "group_size": 64, "ratio": 0.6,}if not out_dir.exists():convert_phi3_model(model_id,out_dir,compression_configuration) 2. 图片内容理解 此外在该示例中,我们也对模型的推理任务进行封装,通过以下代码便可快速部署图像理解任务。 from transformers import AutoProcessor, TextStreamermessages = [ {"role": "user", "content": "<|image_1|>\nPlease create Python code for image, and use plt to save the new picture under imgs/ and name it phi-3-vision.jpg."},]processor = AutoProcessor.from_pretrained(out_dir, trust_remote_code=True)prompt = processor.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)inputs = processor(prompt, [image], return_tensors="pt")generation_args = {"max_new_tokens": 3072, "do_sample": False, "streamer": TextStreamer(processor.tokenizer, skip_prompt=True, skip_special_tokens=True)}print("Coding:")generate_ids=model.generate(**inputs,eos_token_id=processor.tokenizer.eos_token_id,**generation_args) 图:Phi-3.5-vision输出示例 可以看到在理解拼图内容后,Phi-3-vision 为我们生成了一段 Python 脚本来复现拼图数据。 3. 视频内容理解 由于 Phi-3.5-vision 可以同时支持对多个图像输入,因此可以基于这一特性实现视频内容理解,实现方法也特别简单,仅需对视频文件抽帧后保存为图片,并将这些图片基于 Phi-3.5-vision 提供的预处理脚本合并后,转化为 Prompt 模板,送入模型流水线进行推理。 images = [] placeholder = "" for i in range(1,4): with open("../examples/output/keyframe_"+str(i)+".jpg", "rb") as f: images.append(Image.open("../examples/output/keyframe_"+str(i)+".jpg")) placeholder += f"<|image_{i}|>\n"from transformers import AutoProcessor, TextStreamermessages = [ {"role": "user", "content": placeholder+"Summarize the video."},]processor = AutoProcessor.from_pretrained(out_dir, trust_remote_code=True)prompt = processor.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)inputs = processor(prompt, images, return_tensors="pt")generation_args = {"max_new_tokens": 500, "do_sample": False, "streamer": TextStreamer(processor.tokenizer, skip_prompt=True, skip_special_tokens=True)}print("Summary:")generate_ids = model.generate(**inputs, eos_token_id=processor.tokenizer.eos_token_id, **generation_args) OpenVINO™ 总结 通过 OpenVINO™ 封装后的 API 函数,开发者可以非常便捷地对预训练模型进行转化压缩,并实现本地化的推理任务部署。同时基于 Phi-3.5 在小语言模型场景下强大的文本与图像理解能力,我们仅在轻薄本上便可以构建起一个完整的语言模型应用,在保护用户数据隐私的同时,降低硬件门槛。 参考资料 Optimum-intel: https://docs.openvino.ai/2024/learn-openvino/llm_inference_guide/llm-inference-hf.html OpenVINO Gen API: https://docs.openvino.ai/2024/learn-openvino/llm_inference_guide/genai-guide.html OpenVINO™ --------------------------------------- *OpenVINO and the OpenVINO logo are trademarks of Intel Corporation or its subsidiaries. ----------------------------- OpenVINO 中文社区 微信号 : openvinodev B站:OpenVINO中文社区 “开放、开源、共创” 致力于通过定期举办线上与线下的沙龙、动手实践及开发者交流大会等活动,促进人工智能开发者之间的交流学习。 ○点击“在看”,让更多人看见 本文分享自微信公众号 - OpenVINO 中文社区(openvinodev)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

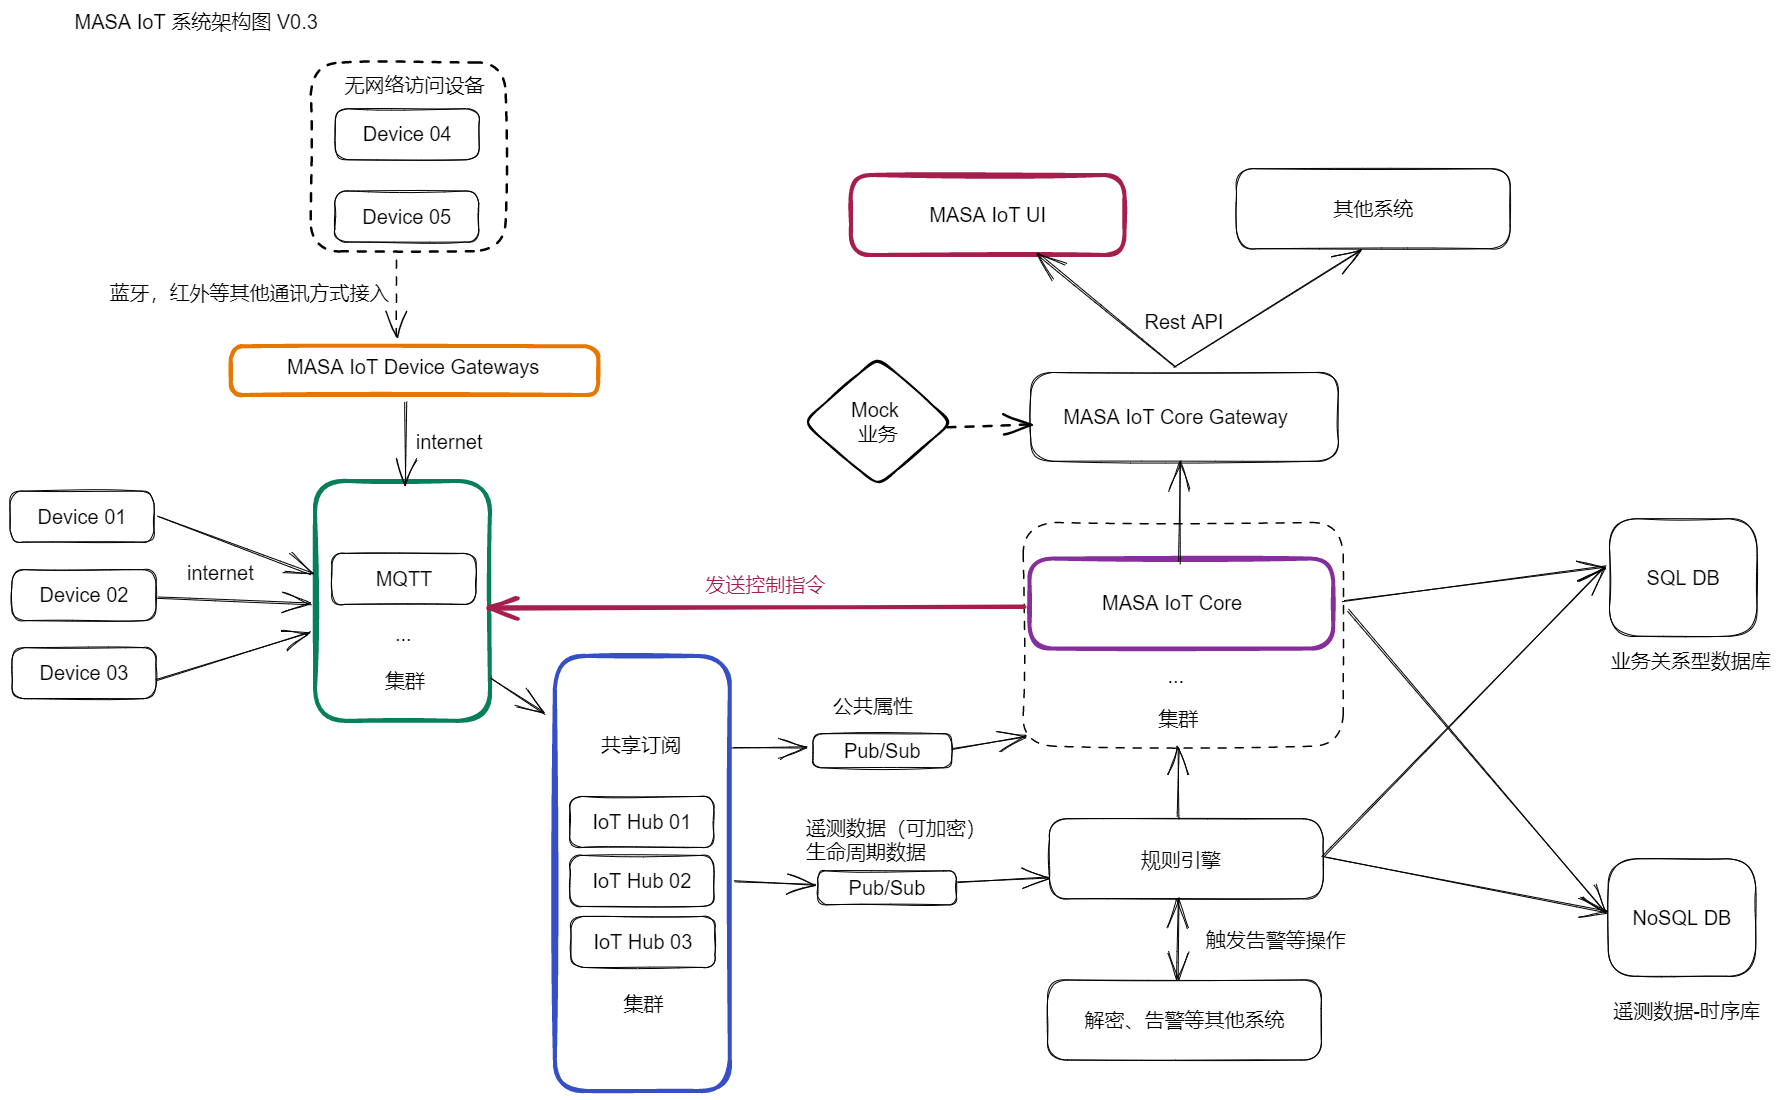
使用MASA全家桶从零开始搭建IoT平台(二)设备注册

前言 我们不希望任何设备都可以接入我们的IoT平台,所以一个设备正常的接入流程是这样的, 1、上位机软件通过串口或其他方式读取设备的唯一标识码UUID。 2、上位机调用IoT后台接口,发送UUID和ProductID。 3、后台接口判断设备是否注册过,如果没有注册过,就根据ProductID并按照一定规律生成DeviceName和Password通过接口返回给上位机软件。 4、上位机软件通过串口将接口返回的数据写入设备。 一、设备注册流程 这里主要涉及四个概念 1、UUID(设备唯一ID,一般为设备主控板编号) 2、ProductID(设备所属产品ID,在IoT后台定义) 3、DeviceName(设备在IoT平台或MQTT的名称,该名称大多与产品相关) 4、Password(设备连接MQTT的密码) 二、MQTT注册 1.在EMQX中添加认证方式 选择Built-in Database方式,内置数据库进行密码认证 账号类型选择username,加密方式和加盐方式可以保持默认。 点击创建后可以在认证菜单中看到新建的认证方式,状态为:已连接。 我们点击用户管理->添加 可以手动创建用户 这里的场景我们是通过上位机调用IoT后端,IoT接口内部调用EMQX接口来实现自动创建用户的 2.创建Api Key 调用接口需要认证,这里我们使用Api key的方式,我们在系统设置->API密钥中创建一个API密钥 Secret Key 只有创建的时候才会显示明文,我们需要记录下API Key 和 Secret Key 3.调用接口创建用户 我们在浏览器打开EMQX 的RestAPI swagger http://localhost:18083/api-docs/index.html 我们可以通过这个接口来创建用户,这里的Authenticator ID 就是我们上面创建的内置数据库 Password Based的ID, 这个ID的获取通过下面的authentication方法获取 我们在认证中直接使用API Key 和 Secret Key,接口返回Id:password_based:built_in_database 调用authentication的Post接口,在 id字段输入:password_based:built_in_database,Request body中输入设备的user_id和password即可成功创建用户。 我们在Deshboard的界面中也可以看到刚刚创建的用户 三、测试设备连接 我们使用MQTTX来模拟客户端设备通过mqtt协议连接到EMQX,新建连接,填写地址、端口、和刚刚通过Api创建用户名密码。 点击连接、发现设备已经可以正常连接mqtt了。 在Dashboard中也可以看到当前连接的客户端ID等信息。 四、编写代码 在MASA.IoT.WebApi项目种添加DeviceController控制器并添加DeviceRegAsync方法用于设备注册, 设备如果没有注册过(UUID 数据库不存在),那么会根据ProductCode按照规律生成设备名称,名称以该产品供应商编号开头,后跟时间和序号。然后向EMQX添加设备,并同时存储到数据库中。 如果设备已经注册过,那么直接从数据库取出设备注册信息返回。 代码编写相对简单,不过多赘述。 //DeviceController namespace MASA.IoT.WebApi.Controllers { [Route("api/[controller]")] [ApiController] public class DeviceController : ControllerBase { private readonly IDeviceHandler _deviceHandler; public DeviceController(IDeviceHandler deviceHandler) { _deviceHandler = deviceHandler; } [HttpPost] public async Task<DeviceRegResponse> DeviceRegAsync(DeviceRegRequest request) { return await _deviceHandler.DeviceRegAsync(request); } } } //DeviceHandler using MASA.IoT.WebApi.Contract; using MASA.IoT.WebApi.IHandler; using MASA.IoT.WebApi.Models.Models; using Microsoft.EntityFrameworkCore; namespace MASA.IoT.WebApi.Handler { public class DeviceHandler : IDeviceHandler { private readonly MASAIoTContext _ioTDbContext; private readonly IMqttHandler _mqttHandler; public DeviceHandler(MASAIoTContext ioTDbContext, IMqttHandler mqttHandler) { _ioTDbContext = ioTDbContext; _mqttHandler = mqttHandler; } /// <summary> /// 注册设备 /// </summary> /// <param name="request"></param> /// <returns> /// 设备注册信息 /// </returns> public async Task<DeviceRegResponse> DeviceRegAsync(DeviceRegRequest request) { var productInfo = await _ioTDbContext.IoTProductInfo.FirstOrDefaultAsync(o => o.ProductCode == request.ProductCode); if (productInfo == null) { return new DeviceRegResponse { Succeed = false, ErrMsg = "ProductCode not found" }; } var deviceRegInfo = await GetDeviceRegInfoAsync(request); if (deviceRegInfo != null) //已经注册过 { return deviceRegInfo; } else //没有注册过 { var deviceName = await GenerateDeviceNameAsync(productInfo.SupplyNo, request.ProductCode, request.UUID); var password = Guid.NewGuid().ToString("N"); var addDeviceResponse = await _mqttHandler.DeviceRegAsync(deviceName, password); if (addDeviceResponse.user_id == deviceName) //注册成功 { deviceRegInfo = new DeviceRegResponse { DeviceName = deviceName, Password = password, Succeed = true, ErrMsg = string.Empty }; await _ioTDbContext.IoTDeviceInfo.AddAsync(new IoTDeviceInfo { Id = Guid.NewGuid(), DeviceName = deviceName, Password = password, ProductInfoId = productInfo.Id, }); await _ioTDbContext.SaveChangesAsync(); return deviceRegInfo; } return new DeviceRegResponse { Succeed = false, ErrMsg = addDeviceResponse.message }; } } /// <summary> /// 获取设备注册信息 /// </summary> /// <param name="request"></param> /// <returns> /// 设备已经注册返回设备注册信息,没有注册过返回null /// </returns> private async Task<DeviceRegResponse?> GetDeviceRegInfoAsync(DeviceRegRequest request) { var deviceware = await _ioTDbContext.IoTDevicewares.FirstOrDefaultAsync(o => o.ProductCode == request.ProductCode && o.UUID == request.UUID); if (deviceware == null) { return null; } else { var deviceInfo = await _ioTDbContext.IoTDeviceInfo.FirstAsync(o => o.DeviceName == deviceware.DeviceName); return new DeviceRegResponse { DeviceName = deviceInfo.DeviceName, Password = deviceInfo.Password, Succeed = true, ErrMsg = string.Empty }; } } /// <summary> /// 生成设备名称 /// </summary> /// <param name="supplyNo"></param> /// <param name="productCode"></param> /// <param name="uuid"></param> /// <returns> /// 设备Mqtt名称 /// </returns> private async Task<string> GenerateDeviceNameAsync(string supplyNo, string productCode, string uuid) { var lastDeviceware = await _ioTDbContext.IoTDevicewares.Where(o => o.ProductCode == productCode).OrderByDescending(o => o.CreationTime).FirstOrDefaultAsync(); var newDeviceware = new IoTDevicewares { Id = Guid.NewGuid(), UUID = uuid, ProductCode = productCode, CreationTime = DateTime.Now }; if (lastDeviceware != null && lastDeviceware.DeviceName.StartsWith(supplyNo + DateTime.Today.ToString("yyyyMMdd"))) { newDeviceware.DeviceName = (long.Parse(lastDeviceware.DeviceName) + 1).ToString(); } else { newDeviceware.DeviceName = supplyNo + DateTime.Today.ToString("yyyyMMdd") + "0001"; } await _ioTDbContext.IoTDevicewares.AddAsync(newDeviceware); await _ioTDbContext.SaveChangesAsync(); return newDeviceware.DeviceName; } } } 这里生成设备名称用了一个简单的算法 // MqttHandler using Flurl.Http; using MASA.IoT.WebApi.Contract.Mqtt; using MASA.IoT.WebApi.IHandler; using Microsoft.Extensions.Options; using System.Net; namespace MASA.IoT.WebApi.Handler { public class MqttHandler : IMqttHandler { private readonly AppSettings _appSettings; public MqttHandler(IOptions<AppSettings> settings) { _appSettings = settings.Value; } public async Task<AddDeviceResponse> DeviceRegAsync(string deviceName,string password) { var url = $"{_appSettings.MqttSetting.Url}/api/v5/authentication/password_based:built_in_database/users"; var response = await url.WithBasicAuth(_appSettings.MqttSetting.ApiKey, _appSettings.MqttSetting.SecretKey).AllowAnyHttpStatus().PostJsonAsync(new AddDeviceRequest { user_id = deviceName, password = password, } ); if (response.StatusCode is (int)HttpStatusCode.Created or (int)HttpStatusCode.BadRequest or (int)HttpStatusCode.NotFound) { return await response.GetJsonAsync<AddDeviceResponse>(); } else { throw new UserFriendlyException(await response.GetStringAsync()); } } } } 总结 以上就是本文要讲的内容,本文介绍了通过账号密码的方式通过接口在EMQX中创建用户,并连接EMQX的过程,EMQX支持的认账方式还有很多,例如JWT认证方式可以授权一次性密码认证,可以控制认证的有效期,我们在后面的章节具体应用中会进行说明。 完整代码在这里:https://github.com/sunday866/MASA.IoT-Training-Demos 如果你对我们的 MASA 感兴趣,无论是代码贡献、使用、提 Issue,欢迎联系我们 WeChat:MasaStackTechOps QQ:7424099

优秀的个人博客,低调大师

腾讯云 AI 存储“全家桶”,重构智能体时代数据存储新范式

2026年7月10日,2026科学智能计算应用大会于郑州国际文化交流中心举办。其中 “存力协同创新,共筑 AI 数据底座” 存储论坛上,腾讯云存储高级产品经理王致铭发表《AI 时代存储新范式》主题演讲,现场完整拆解腾讯云面向智能体场景打造的 Agent Bucket、Vector Bucket、MetaInsight 三大 AI 原生存储产品,结合内部规模化落地案例,详解 AI 浪潮下存储架构革新思路与实践价值。

优秀的个人博客,低调大师

React全家桶实战:Redux+Ant Design+Hooks构建企业级前端应用

在当今前端工程化浪潮中,React 凭借其声明式视图和灵活生态稳居主流框架前列。然而,真实企业级项目不仅需要“能跑”,更要可维护、可扩展、高性能。本文基于实际项目经验,深度整合 Redux Toolkit(状态管理)、Ant Design 4.x(企业级 UI 库)与 React Hooks(逻辑复用),从零搭建一个具备登录认证、数据看板、动态表单等典型场景的脚手架。全文代码均经过生产环境验证,拒绝“玩具示例”,直击工程痛点。

优秀的个人博客,低调大师

《极限竞速:地平线6》激情狂飙,技嘉全家桶解锁高帧竞速体验

近日,竞速大作《极限竞速:地平线6》全球上线,超真实画面与丰富的超跑赛车DIY玩法多样,为PC玩家带来前所未有的飙车快感。趁618大促装机,选择技嘉B850M+RTX 50系显卡即可解锁卓越的画质与帧数体验,性价比超高。 入门级玩家推荐9600X处理器与技嘉B850M AORUS PRO WIFI7电竞雕主板组合,搭配RTX 5060 Ti魔鹰显卡,1080P最高画质下轻松突破百帧,竞速画面丝滑不掉帧。主板采用12+2+2相80A供电稳带旗舰U,双PCIe 5.0 M.2接口加Wi-Fi 7网络,主流预算一步到位。追求顶级光追特效建议升级RTX 5080超级雕,核心频率高达2805MHz,搭载16GB GDDR7显存,配有霸气LCD屏幕,支持DLSS 4.5 开启6倍帧生成,4K全高画质感受“完美风景模拟器”的魅力,2K高刷畅跑230 FPS以上毫无压力。 此外,竞速游戏对显示器的要求很高,玩家还可以选择技嘉GO27Q24G显示器,支持27英寸2K 240Hz WOLED纯黑镜面屏、0.03ms疾速响应,为《地平线6》玩家呈现通透锐利的高帧竞速画面。618装机锁定技嘉京东自营旗舰店,现在入手优惠多多,大品牌值得信赖。 产品链接: B850M AORUS PRO WIFI7电竞雕 https://item.jd.com/100189098672.html RTX 5060 Ti 8G 魔鹰 https://item.jd.com/100211023968.html GO27Q24G显示器 https://item.jd.com/100241383865.html

优秀的个人博客,低调大师

使用MASA全家桶从零开始搭建IoT平台(三)管理设备的连接状态

前言 获取一个设备的在线和离线状态,是一个很关键的功能。我们对设备下发的控制指令,设备处于在线状态才能及时给我们反馈。这里的在线和离线,我们可以简单的理解为设备与MQTT的连接状态。 分析 我们打电话的时候经常能听到:"您拨打的用户已关机“和”用户不在服务区或暂时无法接通“,这两种的区别是什么? 1、当用户开机时,会自动向最近的移动基站注册,基站标记该用户为"attach"(在线)状态。 2、当用户关机时,手机会发起datach流程,告知基站自己关机了,基站标记该用户为"detach"(离线)状态。这样再次拨打就可以节省寻呼资源,直接提示用户关机。 3、当用户忽然进入无网络的环境,或者手机故障,导致来不及发起datach流程,基站还认为用户"在线",当有人拨打用户号码时,基站测会对用户进行寻呼,但是超时得不到回应后,就会提示"不在服务区"或者"暂时无法接通" 的语音。 其实这个方案在IoT上也是可行的,我们可以让设备在线和离线的过程中向特定Topic发送状态消息,但是存在问题,我们需要一个单独的Broker去订阅这个Topic,但是这个单独的Broker很容易成为单点故障点。而且如果设备数量很大,这种意外离线的设备也很难及时发现,需要下发指令后等待设备响应超时才能发现。 方案1:遗嘱消息 MQTT 遗嘱消息可以在客户端意外断线时将“遗嘱”优雅地发送给第三方订阅者,以实现离线通知、设备状态更新等业务。其中意外断线指客户端断开前未向服务器发送 DISCONNECT 消息,比如: 因网络故障或网络波动,设备在保持连接周期内未能通讯,连接被服务端关闭 设备意外掉电 设备尝试进行不被允许的操作而被服务端关闭连接,例如订阅自身权限以外的主题等 遗嘱消息在 MQTT 客户端向服务器端 CONNECT 请求时设置,可选属性包括是否发送遗嘱消息 (Will Message)标志,和遗嘱消息主题 (Topic) 与内容(Payload) 以及 Properties。 值得一提的,遗嘱消息发布的时间可能会有延迟:通常意外断线时,服务器无法立即检测到断线行为,需要通过连接保活心跳机制并经过一定周期后才会触发;MQTT 5.0 提供的遗嘱延迟间隔(Will Delay Interval)属性也会影响发布时间。 演示遗嘱消息的使用 我们使用A、B两台电脑使用MQTT X来演示。 我们在A电脑的 MQTT X 中新建一个名为 Test 的连接,Host 修改为 修改为我们的MQTT地址(192.120.5.204),并输入账号密码,在 Advanced 部分选择 MQTT Version 为 5.0,并且将 Session Expiry Interval 设置为 10,确保会话不会在遗嘱消息发布前过期。 然后在 Lass Will and Testament 部分将 Last-Will Topic 设置为 offline,Last-Will Payload 设置为 I'm offline,Will Delay Interval (s) 设置为 5。 完成以上设置后,我们点击右上角的 Connect 按钮以建立连接。 我们在B电脑的MQTTX中新建一个连接Sub,mqtt地址同样指向我们的mqtt服务器(192.120.5.204) 并订阅offline主题 我们用任务管理器直接结束A电脑的MQTTX进程,这是连接会被直接断开,模拟了设备断电的场景,在5s之后,在B电脑的MQTTX订阅中收到了一条内容为 I‘m offline 的遗嘱消息。 实施流程 1、设备遗嘱消息内容设置为offline,该遗嘱主题与一个普通发送状态的主题设定成同一个 {设备名称}/status。例如 284202304230001/status 2、当设备连接时,向主题 {设备名称}/status 发送内容为 online 的Retained消息,其它客户端订阅主题 {设备名称}/status 的时候,将获取到 Retained 消息为 online。 保留消息(Retain ) MQTT 服务端收到 Retain 标志为 1 的 PUBLISH 报文时,会将该报文视为保留消息,除了被正常转发以外, 保留消息会被存储在服务端,每个主题下只能存在一份保留消息,因此如果已经存在相同主题的保留消息,则该保留消息被替换。 当客户端建立订阅时,如果服务端存在主题匹配的保留消息,则这些保留消息将被立即发送给该客户端。 借助保留消息,新的订阅者能够立即获取最近的状态,而不需要等待无法预期的时间,这在很多场景下是非常重要的。 EMQX 默认开启保留消息的能力和服务,可以在 etc/emqx.conf 中修改 mqtt.retain_available 为 false 来关闭保留消息的能力, 这样客户端将被禁止发送 Retain 标志为 1 的 PUBLISH 报文,否则,客户端将会收到原因码为 0x9A(不支持保留消息)的 DISCONNECT 报文。 保留消息的服务会存储和管理客户端发送的保留消息,并发送给相应的订阅者。 3、当客户端异常断开时,系统自动向主题 {设备名称}/status 发送内容为 offline 的消息,其它订阅了此主题的客户端会马上收到 offline 消息;如果遗嘱消息设置了 Will Retain,那么此时如果有新的订阅 A/status 主题的客户端上线,也将获取到内容为 offline 的遗嘱消息。 方案2:使用WebHook 方案1需要设备主动设置遗嘱消息才能实现,那么有没有更简单的方式,直接通过设备与Mqtt的连接事件来获取连接状态呢。 EMQX 设计了一套WebHook系统,可以通过这个自带的WebHook系统获取内部的事件并进行处理。WebHook的原理很简单,当设备与mqtt建立连接或者断开连接时,EMQX会把事件的信息通过我们的配置调用特定的URL上的接口,实现通知。 使用WebHook还可以有限避免单点故障。所以本项目会采用WebHook的方式来实现对设备在线和离线的管理。 开启WebHook 在数据集成 -> 数据桥接 中创建一个Webhook 名称设置为ConnectedEvent,URL 中填写我们的Webhook地址,也就是触发事件之后的调用接口地址,这里我们填: http://192.120.5.204:5000/api/Device/ConnectedEvent 请求方式为Post,其他内容保持默认不变 这里注意URL可以通过${field}的方式拼接,请求体也可以自己指定,如果留空会原样转发消息,我们这里请求体留空 设备在线和离线的事件转发的消息格式如下 { "username": "284202304230001", "timestamp": 1682652598840, "sockname": "172.17.0.5:1883", "receive_maximum": 32, "proto_ver": 5, "proto_name": "MQTT", "peername": "172.17.0.1:48524", "node": "emqx@172.17.0.5", "mountpoint": "undefined", "metadata": { "rule_id": "rule_3hsx" }, "keepalive": 60, "is_bridge": false, "expiry_interval": 10, "event": "client.connected", "connected_at": 1682652598840, "conn_props": { "User-Property": {}, "Session-Expiry-Interval": 10 }, "clientid": "mqttx_c4491df0", "clean_start": false } 我们点击 创建 ,并继续点击 创建规则 我们在创建规则中指定新的规则名称 rule_client_connected,并在SQL编辑器复制以下内容 SELECT * FROM "$events/client_connected", "$events/client_disconnected" 在右侧的事件中,我们可以看到所有可用的事件,我们选择了连接和断开两个事件,在这两个事件触发时会通过Webhook调用我们配置的接口,这样我们就能获取到设备的在线、离线状态了。 我们点击 创建按钮 完成规则的创建 我们可以看见我们创建好的规则 点击规则ID,还可以看到统计数据 在FLows中还可以看到整个工作流程 演示Webhook 我们使用MQTTX模拟一次设备连接和断开动作,可以在规则统计界面看到我们的操作已经被记录。 编写代码 我们这里采用方案2。 我们需要实现之前配置的ConnectedEvent接口 /// <summary> /// 连接事件请求 /// </summary> public class ConnectedEventRequest { /// <summary> /// 设备名称 /// </summary> public string Username { get; set; } /// <summary> /// 时间戳 /// </summary> public long Timestamp { get; set; } /// <summary> /// 事件(连接/断开) /// </summary> public string Event { get; set; } /// <summary> /// 连接时间(断开事件中为0) /// </summary> public long Connected_at { get; set; } /// <summary> /// Client ID /// </summary> public string Clientid { get; set; } } /// <summary> /// 更新设备在线状态 /// </summary> /// <param name="deviceName"></param> /// <param name="onlineStatus"></param> /// <returns></returns> public async Task UpdateDeviceOnlineStatusAsync(string deviceName, OnLineStates onlineStatus) { var device = await _ioTDbContext.IoTDeviceInfo.Include(o => o.IoTDeviceExtend).AsNoTracking() .FirstOrDefaultAsync(o => o.DeviceName == deviceName); if (device == null) { return; } else { if (device.IoTDeviceExtend == null) //扩展表为空 { device.IoTDeviceExtend = new IoTDeviceExtend { DeviceInfoId = device.Id, OnLineStates = (int)onlineStatus, }; _ioTDbContext.Attach(device.IoTDeviceExtend); _ioTDbContext.Entry(device.IoTDeviceExtend).State = EntityState.Added; _ioTDbContext.Entry(device.IoTDeviceExtend).Property(o => o.OnLineStates).IsModified = true; await _ioTDbContext.SaveChangesAsync(); } if (device.IoTDeviceExtend.OnLineStates != (int)onlineStatus) //在线状态不一致 { device.IoTDeviceExtend.OnLineStates = (int)onlineStatus; _ioTDbContext.Attach(device.IoTDeviceExtend); //防止更新其他字段 _ioTDbContext.Entry(device.IoTDeviceExtend).State = EntityState.Unchanged; _ioTDbContext.Entry(device.IoTDeviceExtend).Property(o => o.OnLineStates).IsModified = true; await _ioTDbContext.SaveChangesAsync(); } } } 我们根据Event中的内容来判断是 连接(client.connected)/断开(client.disconnected) 的事件 /// <summary> /// 连接、断开事件 /// </summary> /// <param name="request"></param> /// <returns></returns> [HttpPost] public async Task ConnectedEventAsync([FromBody] ConnectedEventRequest request) { var onlineStatus = request.Event switch { "client.connected" => OnLineStates.OnLine, _ => OnLineStates.OffLine }; await _deviceHandler.UpdateDeviceOnlineStatusAsync(request.Username, onlineStatus); } #总结 以上就是本文要讲的内容,我们可以通过MQTTX来测试我们的代码有效性。 该方案还存在部分缺点,例如: 1、每次设备上下线会导致频繁的请求接口,在大量设备接入的场景中需要考虑接口性能。 2、由于网络等问题,Web调用顺序可能不能完全保证,也许离线会比在线事件更早处理,从而导致状态不一致。我们后面会尝试用其他方案来替代WebHook,尝试解决上述问题,在此之前我们都会继续使用WebHook进行功能演示。 完整代码在这里:https://github.com/sunday866/MASA.IoT-Training-Demos 如果你对我们的 MASA 感兴趣,无论是代码贡献、使用、提 Issue,欢迎联系我们 WeChat:MasaStackTechOps QQ:7424099

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册