首页 文章 精选 留言 我的

精选列表

搜索[问题报告],共10014篇文章
优秀的个人博客,低调大师

CentOS7编译安装Gcc9.2.0,解决mysql等软件编译问题

编译环境准备 注:(已经安装就无需重复操作)针对CentOS其他请百度 sh 复制代码 yum -y install bzip2 make gcc gcc-c++ 编译安装 1.下载源码 [gcc-9.2.0.tar.gz] 下载地址:https://mirrors.cnnic.cn/gnu/gcc 2.解压到目录 如:/data0/cmake/gcc-9.2.0 3.切换到解压目录 sh 复制代码 cd /data0/cmake/gcc-9.2.0 4.下载必要配置信息 sh 复制代码 ./contrib/download_prerequisites 5.创建编译文件夹并预编译 sh 复制代码 mkdir build && cd build && ../configure --prefix=/data0/gcc -enable-checking=release -enable-languages=c,c++,objc,obj-c++ -disable-multilib --enable-bootstrap --enable-threads=posix 6.编译并安装 sh 复制代码 make -j4 && make install 注:这里的4指的是你的电脑处理器核心有几个,并且此处编译时间很长我用了近2个小时,以下是编译完成的状态 7.重启 sh 复制代码 reboot 8.备份原来的gcc sh 复制代码 mkdir -p /data0/gcc/bak && mv /usr/bin/gcc /data0/gcc/bak/gcc mv /usr/bin/g++ /data0/gcc/bak/g++ mv /usr/bin/c++ /data0/gcc/bak/c++ mv /usr/bin/cc /data0/gcc/bak/cc mv /usr/lib64/libstdc++.so.6 /data0/gcc/bak/libstdc++.so.6 9.新建gcc链接 sh 复制代码 ln -s /data0/gcc/bin/gcc /usr/bin/gcc ln -s /data0/gcc/bin/g++ /usr/bin/g++ ln -s /data0/gcc/bin/c++ /usr/bin/c++ ln -s /data0/gcc/bin/gcc /usr/bin/cc cp /data0/gcc/lib64/libstdc++.so.6.0.27 /usr/lib64 cd /usr/lib64 ln -s libstdc++.so.6.0.27 libstdc++.so.6 10.重新运行以下命令检查动态库 sh 复制代码 strings /usr/lib64/libstdc++.so.6 | grep GLIBC 11.查看gcc版本号 sh 复制代码 gcc -v
优秀的个人博客,低调大师

复盘一次线上漏测:问题不在『测试没覆盖到』,而在『需求根本没提』——一份漏测归因报告怎么改写了评审清单

每次线上漏测,会议室里的第一反应几乎都一样:「这个测试怎么没测到?」于是动作也高度一致——补一条用例,塞进回归集,下次不再漏。可如果把这半年漏掉的缺陷一条条拉出来做归因,会看到一个反常的分布:相当一部分根本不属于「测试漏了」,而是「需求里就没写」。

优秀的个人博客,低调大师

disruptor调研报告

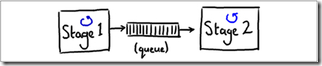
票池暂定使用disruptor来做消息队列,把最近对disruptor的调研结果整理一下。大部分文字都是把disruptor和其它网站上看到的资料翻译一下。 原文:http://www.oraclejavamagazine-digital.com/javamagazine/20120304/?pg=56&pm=1&u1=friend#pg56 Disruptor是什么? Disruptor是一个线程间通信的框架,即在多线程间共享数据。它是由LMAX公司开发的可信消息传递架构的一部分,以便用非常快速的方法来在多组件之间传递数据。它的一个核心思想是理解并适应硬件工作方式来达到最优的效果。 在很多(并行)架构里,普遍使用队列来共享数据(例如传递消息)。图1就是使用队列来传递消息的一个示意图(里面蓝色的小圈圈表示一个线程)。这种架构允许生产线程(图1里的stage1)在消费线程(图1里的stage2)处理不过来的情况下,还可以继续后面的工作,队列在其中用来做为消息的缓冲区。 图1 在最简单的情况下,disruptor可以用来替代图1架构里的队列,也就是线程间通过disruptor来传递数据。在disruptor里保存消息的数据结构是环状缓冲区(RingBuffer - 后面都用RingBuffer这个术语)。生产线程stage1将消息放到RingBuffer里,然后消费线程stage2从RingBuffer里读取消息,如图2。 图2 从图2里可以看到,RingBuffer里的每一个元素都有一个序列号(sequence number)来索引,RingBuffer维护当前最新放置的元素的序列号,这个序列号一直递增,(通过求余来得到元素在RingBuffer下面的数组下标)。 Disruptor的关键特性是无锁编程,这个是通过单一写线程的方式实现的 - 即一块数据永远只有一个线程写入。通过遵循这个编程原则来避免使用昂贵的同步锁或CAS操作,这就是为什么Disruptor这么快的原因。 因为RingBuffer规避了锁,而且每个EventProcessor维护自己的序列号。 向Disruptor发布消息 往RingBuffer里写入消息使用两步提交的方式。首先,生产线程Stage1需要确定RingBuffer里下一个空闲槽,如图3。 图3 RingBuffer维护了最后一次写入的序列号(图3里的18号),因此就可以推知下一个空闲的槽号。RingBuffer通过检查所有从RingBuffer读取消息的EventProcessor的序列号,以判别下一个槽号是否空闲。 图4演示了索取下一个空闲槽序列号的过程。 图4 当生产线程拿到了下一个序利号之后,它从RingBuffer里拿到槽里保存的对象并执行任何操作。这个过程中,因为RingBuffer的最新序列号依然是18,因此其它线程无法读取19号槽里面的事件 - 生产线程还在处理它。 图5 图5演示了RingBuffer在提交变更后的情况。当生产线程处理完第19号槽的数据后,它告诉RingBuffer将其公布出来。这个时候,RingBuffer才会更新它维护的序列号,任何等待读取第19号槽里的数据的线程才能读取它。 从RingBuffer里读取信息 Disruptor框架里提供了一个叫做BatchEventProcessor来从RingBuffer里读取数据。当生产线程向RingBuffer要求下一个可写入的空闲槽的序列号时,同时一个EventProcessor(类似消费者,但其并消费RingBuffer里的元素 - 即不从RingBuffer里移除任何元素)也会维护其最后所处理的数据的序列号,并要求下一个可处理的数据的序列号。 图6演示了EventProcessor等待处理下一个可读取数据序利号的过程。 图6 EventProcessor不是直接从RingBuffer里获取下一个可读取数据的序列号,而是通过一个SequenceBarrier对象来做的,稍后我们谈这个细节。 图6里,EventProcessor(即消费者线程Stage2)最后看到的是第16号槽的数据,它希望处理下一个(第17号)槽的数据,因此它执行SequenceBarrier的waitFor(17)函数调用。线程Stage2可以一直等待下一个可读序列号,因为如果尚没有数据生产出来的话,它什么也不需要做。但跟图6所示的一样,RingBuffer里最新可用数据已经到18号槽了,因此waitFor返回18,即告诉EventProcessor可以一直读到第18号的所有数据。如图7。 图7 这种模式提供了很好的批处理行为,可以使用这种批处理代码来实现EventHandler,在Disruptor里性能测试FizzBuzzEventHandler就是一个很好的例子。 处理系统组件之间的依赖关系 Disruptor处理系统内部多组件的依赖关系,而不引入任何线程竞争的做法很有意思。Disruptor遵循的是单线程写入,多线程读取的做法。Disruptor的原始设计是支持几步具有特定顺序的串行流水线操作 - 这种操作在企业级的系统里很常见。图8演了一个标准的三步流水线操作: 图8 首先,所有事件都会写入硬盘(日志“Journaling”操作),以便容灾恢复。第二所有事件会备份(Replication操作)到第二台服务器上,只有这些步骤都完成之后系统才能处理实际的业务操作(Business Logic)。 串行做这三步操作是一个合理的做法,但不是最有效率的。日志和备份操作可以并行,因为它们相互独立。但业务操作不行,因为它依赖前两者,图9演示了这个依赖关系。 图9 如果使用Disruptor,前两步(日志和备份)可以直接读RingBuffer。跟图7示意的,它们都使用一个屏障(Sequence Barrier)来得到RingBuffer下一个可读取的序列号。它们各自维护自己的序列号,这样方便它们自己知道已经读到哪了,并使用BatchEventProcessor来处理事件(日志和备份)。 业务线程也会从同一个RingBuffer里读取事件,不过只能处理前两个线程处理完的事件。这个限制通过第二个SequenceBarrier来实现,它被配置来读取日志线程和备份线程的序列号,返回它们的最小值,以告诉业务线程安全读取的范围。 只有每一个EventProcessor都使用序列号屏障(Sequence Barrier)来确定可以安全处理的事件范围,才能从RingBuffer里读取数据。如图10。 图10 虽然有很多线程读取不同的序利号,但由于都是简单递增自己内部的序利号,所以线程间没有竞争。 多个生产线程 Disruptor也支持,但是本文没有说如何支持,放在后面写。 结论 虽然disruptor的原理已经比较熟悉了,但是其API还不是很了解,我写了一个实验性的代码,来完善我的理解 - 不过随着理解的深入,代码会不断更新: https://github.com/shiyimin/12306ngpm/blob/8be9178d318618f905aaed45fa6025df09371c31/trunk/tpms/src/test/java/org/ng12306/tpms/DisruptorConceptProofTest.java 本文转自 donjuan 博客园博客,原文链接: http://www.cnblogs.com/killmyday/archive/2012/12/02/2798218.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

隐私窃贼病毒分析报告

1.概述 近日我们在恒安嘉新态势感知平台上监测到一款仿冒韩国音乐应用的病毒样本。经过安全研究人员分析,发现该应用在用户不知情的情况下,窃取用户设备短信、联系人、设备信息等敏感数据,之后便隐藏图标保持后台长时间运行。 图1-1 态势感知平台监测到的样本信息 2.详细分析 2.1请求敏感权限 (1)该应用整体运行过程并不复杂,应用启动后便通过第三方SDK(yanzhenjie)来请求敏感权限。 图1-2 利用第三方接口请求敏感权限 (2)yanzhenjie是第三方开源库,主要用于实现动态请求权限。 图1-3 第三方SDK包信息 2.2Binder机制处理消息 (1)启动主服务,通过binder机制发送消息: 图1-4 发送消息 图1-5 处理消息 (2)循环处理消息,依次执行获取并上传用户设备联系人、短信、设备等信息任务。 图1-6 循环处理任务 2.3服务器通信 (1)连接服务器:上传用户手机号、imei、设备类型等信息。 图1-7 上传用户设备信息 图1-8 抓包数据 (2)在与服务器通信之前恶意软件会先检测网络状态: 图1-9 监测网络连接状态 (3)若用户手机设备没有连网,获取设备APN类型(网络接入点)。 图1-10 硬编码的APN类型 图1-11 获取APN类型 (4)根据手机APN类型设置代理进行通信: 图1-12 设置代理进行通信 (5)若用户设备已连网则通过http协议进行通信: 图1-13连网通信 图1-14 向服务器发送请求 2.4窃取隐私信息 (1)注册短信接收广播,获取用户短信息。 图1-15 获取用户接收的短信息 将获取的短信信转换为json格式发送至服务器: 图1-16 发送的短信数据包 (2)通过binder消息机制,执行获取联系人信息任务并发送至服务器: 图1-17 获取用户联系人信息 图1-18 发送联系人数据包 (3)通过数据库查找获取用户设备短信箱信息并发送至服务器: 图1-19 获取用户短信箱信息 (4)获取用户设备照片信息并发送至服务器,但代码内并未调用: 图1-20 获取照片信息并发送至服务器 恶意软件打印的日志信息包含了大量用户敏感信息: 图1-21 恶意软件日志信息 2.5服务器列表 (1)该服务器地址最新注册与2020-06-09。 图2-1 域名最新注册时间 (2)IP指向美国洛杉机。 图2-2 IP指向美国 (3)对服务器地址进行扩展分析发现该应用的下载地址:http://api090501.ca***ac.xyz/1.apk,通过修改apk文件名称为其它数字能下载不同的应用。其中能下载文件名序号为1-3的apk文件,这三个apk文件代码行为完全相同,只是图标及应用名称不同。 图2-3 同类恶意软件家族 3.总结 从该应用的应用名称以及分发网站来看,该病毒软件主要针对韩国用户,且威胁行为者利用不同的仿冒韩国应用的恶意软件进行传播感染用户设备,以达到窃取用户隐私数据的目的。 暗影安全实验室将会持续监控移动恶意软件状态,及时为移动端用户提供最新风险舆情。

优秀的个人博客,低调大师

Apache Beam研究报告

概述 本文不是一篇Beam的入门文档,不会介绍Beam的基本概念;而会主要探讨Beam的表达力,Beam的性能,以及Beam目前在业内的使用情况。面向的读者是那些想使用Beam作为自己公司操作大数据的统一API,但是还有所顾虑的人们。 表达力 离线 Beam里面有两个核心原语: ParDo: 来处理通用的基于单条数据的计算: 每条需要处理的数据会被喂给用户提供的指定的一个函数(Beam里面的@ProcessElement), 然后输出0个或者多个输出。 我们平常熟悉的Filter, AppendColumn等等都可以通过ParDo来实现。 ParDo的语义涵盖了Hadoop中Map-Shuffle-Reduce的Map,Reduce GroupByKey: 用来做Grouping的操作。 我们平常熟悉的Count, Sum, Min等等都可以通过G

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册