首页 文章 精选 留言 我的

精选列表

搜索[程序设计],共1340篇文章
优秀的个人博客,低调大师

JavaScript高级程序设计学习(一)之介绍

作为一名web开发人员,日常用的最多的就是js,也就是大名鼎鼎的ECMAScript,又称javascript。再次声明js与java除了语法上相似,没有半毛钱关系。据说之所以叫javascript,是因为过去网景公司花了十天时间开发历史上的第一版js,但当时没有名气,故借用java之名在该script前缀上加上一个java,以提升其知名度。具体的历史或老皇历,百度或者相关官网一大堆,这里不再赘述。 作为一名前后台都攻的软件工程师,虽说平时js足以解决常见的问题和共性问题,但发现总会有这样那样的小错误,有的时候,就是那么一个小错误,调试了3~4小时,浪费了很多时间,最后解决了,却发觉分分钟可以解决的问题,我居然花了这么长时间,觉得太对不起有限的光阴。所以决定好好系统学习下javascript。在我看来,为该书做序的人,说的一句话,挺对的,js上手是非常容易的,要么跟着w3scholl一遍遍敲,记得当初我学习js的时候就是这样,又或者参考廖雪峰的js教程,他们的教程很容易让你熟悉并了解js。 下面是网站: w3school:http://www.w3school.com.cn/js/index.asp 廖雪峰教程:https://www.liaoxuefeng.com/wiki/001434446689867b27157e896e74d51a89c25cc8b43bdb3000 不过如果是小白建议还是从w3school入手吧,当然在此也可以看看廖雪峰。我个人是从w3school一遍遍敲,一遍遍运行,一遍遍找博客了解和熟悉。但是博客毕竟是零散的,不够系统。视频了,我个人学习视频一大堆,有好哥们分享的,也有朋友给的。说到视频,如果你是完全的小白,建议可以先看视频再实战,因为视频可以让你了解熟悉,等到有了基本的熟悉,去除了一些陌生感,就是实战吧! 或许有人问,我为什么不看视频学习呢? 第一,我个人有相关经验,可以看懂js和使用js解决项目问题; 第二,作为一名工程师,平时忙于工作,没有很多时间去看视频,视频的时间太长了; 第三,在我看来视频适合小白,完全不懂的,但是作为有相关实战经验的人,没多大必要,当然有些进阶相关的视频还是不错的; 第四,书相对于视频,系统全面,而且,上下班地铁差不多的两个小时,我可以通过手机阅读,至少可以读完一章,这样时间也就充分的利用了; 说到js,至今我仍觉得它是一个非常神秘又好用的玩意,它可以做出酷炫的效果,也可以让我前后端分离开发,同时作为一名Java程序员,它的语法对我而言太容易懂了。当然,还是那句话,入手容易,深入难。如今我要打破这个瓶颈。 下面进行系统的讲解: 1.JavaScript由三部分组成 (1)核心(ECMASCRIPT),又称ECMA262,是js的核心; ECMA由以下部分组成: a.语法 b.类型 c.关键字 d.语句 e.保留字 f.操作符 g.对象 (2)浏览器对象模型; 常用的window,location,screen等, 我用的比较多的,还是window和location window常用的方法 alert()警示框 常用于提示信息 confirm()确认框 通常用于是否删除这样的或是否启用等 propt()输入框 这个用的不多 setInterval()每隔多长时间加载 ,可以调用多次, ajax轮询可以使用它,不过太消耗服务器资源,应用的通常是数据定时更新 setTimeout()每隔多长时间加载 ,一般只加载一次 location.href用的比较多 前后端分离时,不过通过form提交的形式,直接通过window.location.href进入另外一个界面 location.reload用的也比较多 当然浏览器对象除了上述说的,还有navicator,不过这个我也没用过,开发一段时间,从未用过,看字面意思,似乎有导航的作用 (3)文档对象模型; 文档对象,简单的说对节点进行增,删,改,查。 增加的话,比如遍历数据后,将html元素,通过append方法追加到某个ID选择器或者类选择器中 删除的话,节点删除,比如,上级公司下级部门这样的 修改的话,replace方法替换 查的话,find或push之类的方法 这是我个人开发用的比较多的 2.html页面如何写js html写js有三种方式: (1)外部js 通过<script src="test.js"></script>引入html中,从而可调用该js文件中所有函数,我个人建议,非常强烈建议开发,不论是初学者还是半路出家的,多写外部js少写内部js或者直接在<body></body>中嵌入js,因为这种写法一点都不好,至少我这么认为,写外部js可以将公共部分js抽取复用,而且方便管理修改规范; 运行示例: test.html <html> <head> <script src="test.js"></script> </head> <body> </body> </html> test.js alert("hello js") (2)内部js 在<head></head>中嵌入<script></script> <html> <head> <script> alert("hello js") </script> </head> <body> </body> </html> (3)<body></body>内嵌入js <html> <head> </head> <body> <script> alert("hello js") </script> </body> </html> (1)还是那句话,建议使用,(2)的话,慎用,因为到时对web进行优化时,<head></head>内嵌入大量的js将会导致浏览器加载网页速度变慢,不利于web性能优化 另外js文件放头部和尾部的效果是不一样的,因为头部优先加载,头部通常放置css外部文件,尾部放置js,因为浏览器优先加载头部,由头到尾,由于css优先加载,这样渲染效果也会很快,如果是js文件放置头部的话,会导致css渲染效果变慢从而导致影响用户体验

优秀的个人博客,低调大师

JavaScript面向对象程序设计(7): 闭包

闭包这个概念看上去很深奥,这个词在离散数学里面的意思确实比较难于理解。在这里,我们先可以把闭包理解成是一种匿名函数或者匿名类。 1. 什么是闭包? 什么是闭包?一种正式的解释是:所谓闭包,指的是一种拥有很多变量并且绑定了这些变量的环境的表达式(通常是一个函数),因而这些变量也是这个表达式的一部分。 相信很多人都不会理解这个定义,因为他的学术味道太浓了——或许你喜欢从字面的语法上进行分析:首先,它是一个表达式,这个表达式绑定了很多变量以及这些变量的环境。不过这并没有什么意义,这依然不会告诉我们什么是闭包。 那么,来看一个例子: functionadd(a) { return function(b) { returna + b; }; } varfunc = add(10); alert(func(20)); 我想经过了前面有关函数的描述,这个例子应该很清楚的理解。JavaScript里面的函数就是对象,他可以做对象能做的一切事情——我们首先定义了一个函数add,它接受一个参数,这个函数返回一个匿名函数,这个匿名函数也接受一个参数,并且会返回这个参数同外部函数的那个参数的和。因此在我们使用的时候,我们将add返回的匿名函数赋值给func,然后调用func,就返回了这两个数的和。 当我们创建一个这样的函数,这个函数内部的一个变量能够在函数外面被引用时,我们就称创建了一个闭包。仔细的品味一下:这就是那个闭包的定义。 看看我们的代码:首先,它有一个内部变量,就是那个匿名函数;其次,这个函数将匿名函数返回了出去,以便外面的变量可以引用到内部定义的变量。 2. 闭包的作用 闭包有什么用呢?或许现在还看不出来,那么看看这段代码: functioninc(a) { vari = 0; return function() { returni; }; } varnum = inc(); alert(num()); 本来,这个变量 i 在函数外面是访问不到的,因为它是 var 定义的,一旦跳出作用域,这个变量就被垃圾回收了,但是,由于我们使用了闭包,在外面是能够访问到这个变量的,因此它并不被垃圾回收! 如果还是不明白闭包的作用,那么看一段应该很熟悉的代码: functionPerson() { varid; this.getId = function() { returnid; } this.setId = function(newId) { id = newId; } } varp = newPerson(); p.setId(1000); alert(p.getId()); // 1000 alert(p.id); // undefined 我们定义一个类Person,它有一个id属性。现在这个属性的行为很像是私有变量——只能通过 setter 和 getter 函数访问到。没错,这就是闭包的一个用途:制造类的私有变量! 闭包还有一个作用:在内存中维护一个变量,不让垃圾回收器回收这个变量。这里的例子就不再举出了。 这里我们只是简单的说了JavaScript的闭包的概念,并没有涉及闭包的内存模型等等之类。这是一个相当重要的概念,Java社区中的部分成员一直对闭包梦寐以求,C#也已经在最新版本中添加了闭包的概念,只不过在那里称为lambda表达式。 本文转自 FinderCheng 51CTO博客,原文链接: http://blog.51cto.com/devbean/174927

优秀的个人博客,低调大师

《Android程序设计》一2.4 Java编程惯例

2.4 Java编程惯例 对于一门语言,介于编程语言语义规范和好的面向模式的设计之间的是对语言的良好使用。一名喜欢遵循惯例的程序员会使用一致的代码来表达类似的思想,而且通过使用这种方式,程序会更易于理解,且能够在充分利用运行时环境的同时避免语言中存在的“陷阱”。 2.4.1 Java的类型安全性 Java的一个主要设计目标是编程安全。其中存在的很多冗余和不灵活机制都是为了帮助编译器预防在运行时出现各种错误,而这些措施在其他语言,如Ruby、Python和Objective-C中是不存在的。Java的静态类型(static typing)是已经被证明的特性,其优越性已不再局限于Java自己的编译器中。机器能够自动解析并识别Java代码的语义是开发强大的工具,如FindBugs和IDE重构工具的主要驱动力。很多开发人员对这些限制表示认同,尤

优秀的个人博客,低调大师

《Android程序设计》一1.4 保持版本最新

1.4 保持版本最新 JDK、Eclipse和Android SDK源于不同的供应商。用于开发Android软件的工具可能变化非常快。这是在本书(尤其是本章)中,建议你通过查看Android开发者网站来获取工具的最新兼容版本的相关信息的原因。即使在学会了开发Android软件之后,保持软件工具的及时更新和可兼容性也很有可能是一件必要的任务。Windows、Mac OS X和Linux等系统自身都带有自动更新机制,能够使你的软件版本保持最新。但是Android SDK的这种整合方式所带来的一个后果是,各个软件的更新的保持需要采用不同的机制。 1.4.1 保持Android SDK版本最新 Android SDK不是桌面操作系统的一部分,也不是Eclipse插件的一部分,因此操作系统和Eclipse都不会自动更新SDK文件夹中的内容。SDK

优秀的个人博客,低调大师

《Android程序设计》一1.3 SDK的组件

1.3 SDK的组件 Android SDK的主体是通用组件,辅以一些专用组件。在很多情况下,配置、插件和扩展是这些组件在Android中的实现形式。Android SDK的开发是一个对现代化和完整的SDK进行高效开发的研究。Google为了能够快速地把Android推向市场采用了这种方式。在探索Android SDK的过程中,你会感受到这一点。Eclipse、Java语言、QEMU及其他已有的平台、工具和技术一起组成了Android SDK最重要的组成部分。在创建简单的应用来确认SDK安装的过程中,已经用过了SDK的很多组件。这里将找出并具体介绍在创建程序中所涉及的SDK组件及一些其他将要使用的组件。 1.3.1 Android Debug Bridge Android Debug Bridge(adb)是一个程序,通过它你既可以控制

优秀的个人博客,低调大师

《Android程序设计》一1.6 关于代码阅读

1.6 关于代码阅读 好的编码者会阅读很多代码。本书提供的示例代码旨在既能够提供良好的Java编码示例,也能够说明如何使用Android平台。本书提供的一些例子不具备要创建最佳的可扩展和可维护的商业软件所需要的一些必要条件。很多示例应用选择在单个Java类中创建实例,这样更便于读者理解。但在很多情况下,Android应用超出了示例代码的范畴,导致这些代码不可读并难以维护,但是这并不意味着你不需要阅读那些比大型应用代码更方便的示例代码。下一章将讨论Java语言,主要是帮助你形成良好的工程和设计实践思想,从而能够评估示例代码。希望你能够理解这些示例,写出更好的代码,并把示例中的思想应用到工程编码实践中以创建出高品质的产品。

优秀的个人博客,低调大师

《Android程序设计》一2.2 Java类型系统

2.2 Java类型系统 Java语言基础数据类型有两种:对象和基本类型(primitives)。Java通过强制使用静态类型来确保类型安全,要求每个变量在使用之前必须先声明。举个例子,变量i的类型声明是int(原始32位整数),代码如下:int i;这种机制和非静态类型的语言有很大差别,非静态语言不要求对变量进行声明。虽然显式类型声明看起来较烦琐,但其有助于编译器对很多编程错误的预防,例如,由于变量名拼写错误导致创建了没有用的变量,调用了不存在的方法等,显式声明可以彻底防止这些错误被生成到运行代码中。关于Java类型系统的详细说明可以在Java语言规范(Java Language Specification)中找到。 2.2.1 基本类型 Java的基本类型不是对象,它们不支持本章稍后将会描述的对象相关的操作。基本数据类型只能通过一些

优秀的个人博客,低调大师

《Android程序设计》一3.3 其他Android组件

3.3 其他Android组件 Android应用还有一些其他组件,具体包括:Service(服务)、Content Provider(内容提供者)和Broadcast Receiver(广播接收器)。类Service负责为后台功能提供支持,类ContentProvider是多个应用使用数据存储的访问方式,Broadcast Receiver支持多方接收应用所广播的意图信息。你可能会发现,和组件相比,应用本身是一个相对不重要的单元。设计良好的应用会和Android环境“融为一体”,这些应用可以启动其他应用的活动,使用它们的功能,通过Android支持组件来提供或增强自身的功能。可以把Android的内容提供者和意图理解成辅助性API,应该学会使用它们,以便能够充分利用Android强大的特性并实现和Android平台的无缝集成。 3.

优秀的个人博客,低调大师

C++程序设计基础(5)sizeof的使用

1.知识点 (1)sizeof是一个单目运算发,而不是一个函数,其用于获取操作数所占内存空间的字节数。 (2)sizeof的操作数可以使类型名,也可以是表达式,如果是类型名则直接获得该类型所占字节数,如果是表达式,则先分析表达式结果的类型,再根据类型确定所占字节数,并不对表达式进行实际计算。 1 int a = 1; 2 double b = 1.5; 3 sizeof(int);//结果为4 4 sizeof(a); //结果为4 5 sizeof(b); //结果为8 (3)sizeof很少单独使用,而是和内存分配或者计算法数组长度等需求进行配合使用。 1 //与内存空间分配配合使用 2 int *ptr = (int *)malloc(sizeof(int) * 20); 3 //与计算数组长度配合使用 4 int count = sizeof(darray) / sizeof(double); (4)数组名作为操作数时,将获得整个数组所占空间,当数组名作为实参传递给子函数时,此时数组名已经成为了指针,其计算结果将是指针的所占空间。 void subfunc(double darray[]) { cout << sizeof(darray) / sizeof(double) << endl; //输出4/8=0 } int main(int argc, char *argv[]) { double darray[20]; cout << sizeof(darray) / sizeof(double) << endl; //输出16/8=20 subfunc(darray); getchar(); return 0; } (5)在计算字符串长度时要用strlen。sizeof是一个运算符,用于获取类型或表达式的所占内存大小;strlen是一个函数,用于计算字符串中字符的个数,其中字符串结尾符\0不会被计算在内。 2.面试题 2.1不能使用sizeof计算的表达式 1 struct baby 2 { 3 unsigned int gender : 1; 4 unsigned int weight : 5; 5 unsigned int week : 7; 6 unsigned int blood : 3; 7 unsigned int height : 8; 8 }; 9 int triple(int number) { 10 return 3 * number; 11 } 12 int main(int argc, char *argv[]) { 13 sizeof(baby); //A 14 sizeof(baby.gender);//B 15 sizeof(triple);//C 16 sizeof(triple(3));//D 17 sizeof(show());//E 18 19 getchar(); 20 return 0; 21 } 答案:正确:A,D;错误:B,C,E. (1)sizeof计算结构体是结果是结构体的所占内存空间,结构体中使用了位域定义成员,要求一个位域成员不能横跨两个字节,故可以算出该结构体的字节数为4,A正确。 (2)sizeof计算的结果是字节数,但是不允许计算结构体中某个位域成员的所占空间,当然如果不是位域定义的是可以计算的。故B错。 (3)不允许计算函数名的所占字节数大小,有点莫名其妙,C错。 (4)允许计算表达函数表达式,其结果是函数返回值的类型的字节数,即该题的int大小,D正确。 (5)函数返回值类型不确定使,不允许通过sizeof计算,故E错误。 2.2sizeof计算结构体是的内存对其问题 写出下面两个结构体的sizeof计算结果 struct s1{ char a;//1 short b;//4 int c;//8 double d;//16,16刚好是double大小的整数倍 }; struct s2 { char a;//1 short b;//4 double c;//16(从9开始排) int d;//20(该结果不是double的整数倍,故需要加到24) }; 数据对其总结:(1)每个成员在内存中的起始位置都必须是自身大小的整数倍。 (2)最终结构体计算结果必须是占字节数最大的成员的整数倍。 答案:16,24。 2.3结构体嵌套时的sizeof计算 1 struct s1 { 2 int a; 3 }; 4 struct s2 { 5 char a[4]; 6 }; 7 struct s3{ 8 char a[4]; 9 char b; 10 }; 11 struct s4 { 12 s1 a; 13 char b; 14 }; 15 struct s5{ 16 s2 a; 17 char b; 18 }; 含复杂结构体的数据对其总结:在数据对其时,要以结构体中最深层的基本数据类型为准。例如:如果结构体成员是一个数组,应以数组的元素的类型作为数据对其的标准,如果结构体成员是其他结构体,应以内层结构体中的基本元素类型成员作为外层结构体数据对齐的标准。故答案如下 1 sizeof(struct s1)=4; 2 sizeof(struct s2)=4; 3 sizeof(struct s3)=5; 4 sizeof(struct s4)=8; 5 sizeof(struct s5)=5;

优秀的个人博客,低调大师

Python程序设计思维练习---体育竞技分析

体育竞技分析:模拟N场比赛 计算思维:抽象 + 自动化 模拟:抽象比赛过程,自动模拟N场比赛,当N越大时,比赛结果分析越科学。 本次比赛规则:回合制,15分一局,先由一方发球,如胜利,则得1分并继续发球,如失败,则双方分数不改变并交换球权。球员AB的能力为0-1之间的一个数值 思维方式:自顶向下即将一个复杂问题分解成几个问题,再细分成一个个具体的小问题,从而来解决复杂问题。自底向上为自顶向下的逆过程,即解决复杂问题的方法,逐步解决一个个小问题,来达成目的。 1.将体育竞技分析分解为以下几个小步骤 1.1打印程序的介绍性信息式 1.2获得程序运行参数:probA(A的能力值),probB(B的能力值),n(比赛场次) 1.3利用球员AB的能力值,模拟n场比赛 1.4输出球员AB获胜的场次及概率 2.将各个步骤定义成函数来实现 分解 定义函数 3.完整代码 from random import random def printInfo(): # 打印程序介绍信息 print('这个程序模拟两个选手A和B的某种竞技比赛') print('程序运行需要A和B的能力值(以0到1之间的小数表示)') def getInputs(): # 获得程序运行参数 a = eval(input('请输入选手A的能力值(0-1):')) b = eval(input('请输入选手B的能力值(0-1):')) n = eval(input('模拟比赛场次:')) return a, b, n def simOneGame(probA, probB): # 进行一场比赛 scoreA, scoreB = 0, 0 # 初始化AB的得分 serving = 'A' # 首先由A发球 while not gameOver(scoreA, scoreB): #用while循环来执行比赛 if serving == 'A': if random() < probA: # random() 方法返回随机生成的一个实数,它在[0,1)范围内。 scoreA += 1 # 用随机数来和能力值比较从而分出胜负 else: serving = 'B' else: if random() < probB: scoreB += 1 else: serving = 'A' return scoreA, scoreB def simNGames(n, probA, probB): #进行N场比赛 winsA, winsB = 0, 0 # 初始化AB的胜场数 for i in range(n): scoreA, scoreB = simOneGame(probA, probB) if scoreA > scoreB: winsA += 1 else: winsB += 1 return winsA, winsB def gameOver(c, d): #比赛结束 return c==15 or d==15 def printSummary(n ,winA, winB): #打印比赛结果 print('竞技分析开始,共模拟{}场比赛'.format(n)) print('选手A获胜{}场比赛,占比{:.2f}%'.format(winA, winA/n*100)) print('选手B获胜{}场比赛,占比{:.2f}%'.format(winB, winB / n * 100)) def main(): printInfo() probA, probB, n =getInputs() winsA, winsB = simNGames(n, probA, probB) printSummary(n, winsA, winsB) main() 4.运行结果分析 菜鸟互啄 中阶对抗 皇城PK 分析以上数据得知:对于两位能力相差相同的选手(都为0.05),能力越大的选手竞技时,胜负概率越接近。 本练习来自中国大学MOOC

优秀的个人博客,低调大师

JavaScript高级程序设计学习(六)之设计模式

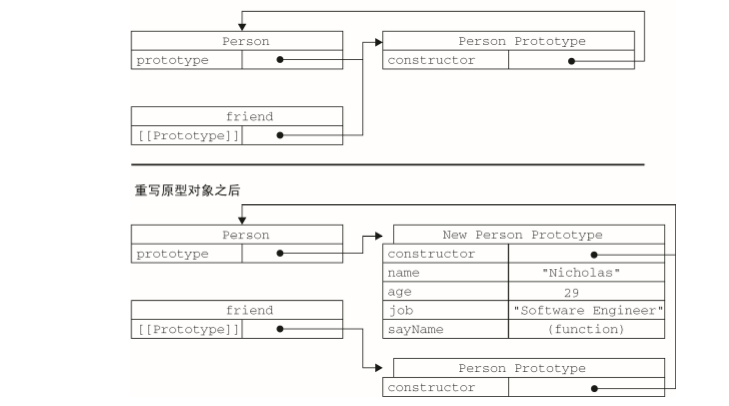
每种编程语言都有其自己的设计模式。不禁让人疑惑设计模式是用来做什么?有什么用? 简单的说,设计模式是为了让代码更简洁,更优雅,更完美。 同时设计模式也会让软件的性能更好,同时也会让程序员们更轻松。设计模式可谓是编程界的“葵花宝典”或“辟邪剑法”。如果一旦练成,必可在编程界中来去自如,游刃有余。 下面进入正题 (1)工厂模式 工厂模式是软件工程领域一种广为人知的设计模式,这种模式抽象了创建具体对象的过程(本书后 面还将讨论其他设计模式及其在 JavaScript中的实现)。考虑到在 ECMAScript中无法创建类,开发人员 就发明了一种函数,用函数来封装以特定接口创建对象的细节。 <html> <meta charset="utf-8"> <head> <script> function createPerson(name,age,job){ var o = new Object(); o.name=name; o.age=age; o.job=job; o.sayName=function(){ alert(this.name); }; return o; } var person1 = createPerson("a",20,"java"); var person2 = createPerson("b",20,"c++"); alert(person1.name); alert(person2.name); </script> </head> <body> </body> </html> 工厂模式,和Java的工厂模式差异不大,就是为了批量生产对象,上述函数我只需写一遍,我就能通过调用函数源源不断的进行复用传参。 简单的说工厂模式就是为了提高函数复用率,写一遍的东西我不要写好几遍就可以调用。 函数 createPerson()能够根据接受的参数来构建一个包含所有必要信息的 Person 对象。可以无 数次地调用这个函数,而每次它都会返回一个包含三个属性一个方法的对象。工厂模式虽然解决了创建 多个相似对象的问题,但却没有解决对象识别的问题(即怎样知道一个对象的类型)。 任何模式都有其局限性,所以诞生了一个构造函数模式。 (2)构造函数模式 构造函数与其他函数的唯一区别,就在于调用它们的方式不同。不过,构造函数毕竟也是函数,不存在定义构造函数的特殊语法。任何函数,只要通过 new 操作符来调用,那它就可以作为构造函数;而任何函数,如果不通过 new 操作符来调用,那它跟普通函数也不会有什么两样。例如,前面例子中定义 的 Person()函数可以通过下列任何一种方式来调用。 <html> <meta charset="utf-8"> <head> <script> function createPerson(name,age,job){ var o = new Object(); o.name=name; o.age=age; o.job=job; o.sayName=function(){ alert(this.name); }; return o; } var person = new Person("zs",20,"java"); person.sayName(); Person("ls",20,"c++"); window.sayName(); </script> </head> <body> </body> </html> 构造函数模式虽然好用,但也并非没有缺点。使用构造函数的主要问题,就是每个方法都要在每个 实例上重新创建一遍。在前面的例子中,person1 和 person2 都有一个名为 sayName()的方法,但那 两个方法不是同一个 Function 的实例。不要忘了——ECMAScript中的函数是对象,因此每定义一个 函数,也就是实例化了一个对象 (3)原型模式 我们创建的每个函数都有一个 prototype(原型)属性,这个属性是一个指针,指向一个对象, 而这个对象的用途是包含可以由特定类型的所有实例共享的属性和方法。如果按照字面意思来理解,那 么 prototype 就是通过调用构造函数而创建的那个对象实例的原型对象。使用原型对象的好处是可以 让所有对象实例共享它所包含的属性和方法。换句话说,不必在构造函数中定义对象实例的信息,而是 可以将这些信息直接添加到原型对象中。 a.理解原型模型 无论什么时候,只要创建了一个新函数,就会根据一组特定的规则为该函数创建一个 prototype 属性,这个属性指向函数的原型对象。在默认情况下,所有原型对象都会自动获得一个 constructor (构造函数)属性,这个属性包含一个指向 prototype 属性所在函数的指针。就拿前面的例子来说, Person.prototype. constructor 指向 Person。而通过这个构造函数,我们还可继续为原型对象 添加其他属性和方法。 创建了自定义的构造函数之后,其原型对象默认只会取得 constructor 属性;至于其他方法,则 都是从 Object 继承而来的。当调用构造函数创建一个新实例后,该实例的内部将包含一个指针(内部 属性),指向构造函数的原型对象。ECMA-262第 5版中管这个指针叫[[Prototype]]。虽然在脚本中 没有标准的方式访问[[Prototype]],但 Firefox、Safari 和 Chrome 在每个对象上都支持一个属性 __proto__;而在其他实现中,这个属性对脚本则是完全不可见的。不过,要明确的真正重要的一点就 是,这个连接存在于实例与构造函数的原型对象之间,而不是存在于实例与构造函数之间。 b.原型与 in 操作符 有两种方式使用 in 操作符:单独使用和在 for-in 循环中使用。在单独使用时,in 操作符会在通 过对象能够访问给定属性时返回 true,无论该属性存在于实例中还是原型中。 <html> <meta charset="utf-8"> <head> <script> function Person(){ } Person.prototype.name = "Nicholas"; Person.prototype.age = 29; Person.prototype.job = "Software Engineer"; Person.prototype.sayName = function(){ alert(this.name); }; var person1 = new Person(); var person2 = new Person(); alert(person1.hasOwnProperty("name")); //false alert("name" in person1); //true person1.name = "Greg"; alert(person1.name); //"Greg" ——来自实例 alert(person1.hasOwnProperty("name")); //true alert("name" in person1); //true alert(person2.name); //"Nicholas" ——来自原型 alert(person2.hasOwnProperty("name")); //false alert("name" in person2); //true delete person1.name; alert(person1.name); //"Nicholas" ——来自原型 alert(person1.hasOwnProperty("name")); //false alert("name" in person1); //true </script> </head> <body> </body> </html> 在以上代码执行的整个过程中,name 属性要么是直接在对象上访问到的,要么是通过原型访问到 的。因此,调用"name" in person1 始终都返回 true,无论该属性存在于实例中还是存在于原型中。 同时使用 hasOwnProperty()方法和 in 操作符,就可以确定该属性到底是存在于对象中,还是存在于原型中。 由于 in 操作符只要通过对象能够访问到属性就返回 true,hasOwnProperty()只在属性存在于 实例中时才返回 true,因此只要 in 操作符返回 true 而 hasOwnProperty()返回 false,就可以确 定属性是原型中的属性。 c.更简单的原型语法 <html> <meta charset="utf-8"> <head> <script> function Person(){ } Person.prototype = { name : "Nicholas", age : 29, job: "Software Engineer", sayName : function () { alert(this.name); } }; </script> </head> <body> </body> </html> d.原型的动态性 由于在原型中查找值的过程是一次搜索,因此我们对原型对象所做的任何修改都能够立即从实例上 反映出来——即使是先创建了实例后修改原型也照样如此。 var friend = new Person(); Person.prototype.sayHi = function(){ alert("hi"); }; friend.sayHi(); //"hi"(没有问题!) 以上代码先创建了 Person 的一个实例,并将其保存在 person 中。然后,下一条语句在 Person. prototype 中添加了一个方法 sayHi()。即使 person 实例是在添加新方法之前创建的,但它仍然可 以访问这个新方法。其原因可以归结为实例与原型之间的松散连接关系。当我们调用 person.sayHi() 时,首先会在实例中搜索名为 sayHi 的属性,在没找到的情况下,会继续搜索原型。因为实例与原型 之间的连接只不过是一个指针,而非一个副本,因此就可以在原型中找到新的 sayHi 属性并返回保存 在那里的函数。 尽管可以随时为原型添加属性和方法,并且修改能够立即在所有对象实例中反映出来,但如果是重 写整个原型对象,那么情况就不一样了。我们知道,调用构造函数时会为实例添加一个指向初原型的 [[Prototype]]指针,而把原型修改为另外一个对象就等于切断了构造函数与初原型之间的联系。 请记住:实例中的指针仅指向原型,而不指向构造函数。 例如: function Person(){ } var friend = new Person(); Person.prototype = { constructor: Person, name : "Nicholas", age : 29, job : "Software Engineer", sayName : function () { alert(this.name); } }; friend.sayName(); //error 看图: e.原型对象问题 原型模式也不是没有缺点。首先,它省略了为构造函数传递初始化参数这一环节,结果所有实例在 默认情况下都将取得相同的属性值。虽然这会在某种程度上带来一些不方便,但还不是原型的大问题。 原型模式的大问题是由其共享的本性所导致的。 原型中所有属性是被很多实例共享的,这种共享对于函数非常合适。对于那些包含基本值的属性倒 也说得过去,毕竟(如前面的例子所示),通过在实例上添加一个同名属性,可以隐藏原型中的对应属 性。然而,对于包含引用类型值的属性来说,问题就比较突出了. <html> <meta charset="utf-8"> <head> <script> function Person(){ } Person.prototype = { constructor: Person, name : "Nicholas", age : 29, job : "Software Engineer", friends : ["Shelby", "Court"], sayName : function () { alert(this.name); } }; var person1 = new Person(); var person2 = new Person(); person1.friends.push("Van"); alert(person1.friends); //"Shelby,Court,Van" alert(person2.friends); //"Shelby,Court,Van" alert(person1.friends === person2.friends); //true </script> </head> <body> </body> </html> 在此,Person.prototype 对象有一个名为 friends 的属性,该属性包含一个字符串数组。然后, 创建了 Person 的两个实例。接着,修改了 person1.friends 引用的数组,向数组中添加了一个字符 串。由于 friends 数组存在于 Person.prototype 而非 person1 中,所以刚刚提到的修改也会通过 person2.friends(与 person1.friends 指向同一个数组)反映出来。假如我们的初衷就是像这样 在所有实例中共享一个数组,那么对这个结果我没有话可说。可是,实例一般都是要有属于自己的全部 属性的。而这个问题正是我们很少看到有人单独使用原型模式的原因所在。 (4)组合使用构造函数模式和原型模式 创建自定义类型的常见方式,就是组合使用构造函数模式与原型模式。构造函数模式用于定义实 例属性,而原型模式用于定义方法和共享的属性。结果,每个实例都会有自己的一份实例属性的副本, 但同时又共享着对方法的引用,大限度地节省了内存。另外,这种混成模式还支持向构造函数传递参 数;可谓是集两种模式之长。 <html> <meta charset="utf-8"> <head> <script> function Person(name, age, job){ this.name = name; this.age = age; this.job = job; this.friends = ["Shelby", "Court"]; } Person.prototype = { constructor : Person, sayName : function(){ alert(this.name); } } var person1 = new Person("Nicholas", 29, "Software Engineer"); var person2 = new Person("Greg", 27, "Doctor"); person1.friends.push("Van"); alert(person1.friends); //"Shelby,Count,Van" alert(person2.friends); //"Shelby,Count" alert(person1.friends === person2.friends); //false alert(person1.sayName === person2.sayName); //true </script> </head> <body> </body> </html> 在这个例子中,实例属性都是在构造函数中定义的,而由所有实例共享的属性 constructor 和方 法 sayName()则是在原型中定义的。而修改了 person1.friends(向其中添加一个新字符串),并不 会影响到 person2.friends,因为它们分别引用了不同的数组。 这种构造函数与原型混成的模式,是目前在 ECMAScript中使用广泛、认同度高的一种创建自 定义类型的方法。可以说,这是用来定义引用类型的一种默认模式。 (5)动态原型模式 有其他 OO语言经验的开发人员在看到独立的构造函数和原型时,很可能会感到非常困惑。动态原 型模式正是致力于解决这个问题的一个方案,它把所有信息都封装在了构造函数中,而通过在构造函数 中初始化原型(仅在必要的情况下),又保持了同时使用构造函数和原型的优点。换句话说,可以通过 检查某个应该存在的方法是否有效,来决定是否需要初始化原型。 示例如下: <html> <meta charset="utf-8"> <head> <script> function Person(name, age, job){ //属性 this.name = name; this.age = age; this.job = job; //------ if (typeof this.sayName != "function"){ Person.prototype.sayName = function(){ alert(this.name); }; } } //------ var friend = new Person("Nicholas", 29, "Software Engineer"); friend.sayName(); </script> </head> <body> </body> </html> 注意构造函数代码中//------部分。这里只在 sayName()方法不存在的情况下,才会将它添加到原 型中。这段代码只会在初次调用构造函数时才会执行。此后,原型已经完成初始化,不需要再做什么修 改了。不过要记住,这里对原型所做的修改,能够立即在所有实例中得到反映。因此,这种方法确实可 以说非常完美。其中,if 语句检查的可以是初始化之后应该存在的任何属性或方法——不必用一大堆 if 语句检查每个属性和每个方法;只要检查其中一个即可。对于采用这种模式创建的对象,还可以使 用 instanceof 操作符确定它的类型。 (6)寄生构造函数模式 通常,在前述的几种模式都不适用的情况下,可以使用寄生(parasitic)构造函数模式。这种模式 的基本思想是创建一个函数,该函数的作用仅仅是封装创建对象的代码,然后再返回新创建的对象;但 从表面上看,这个函数又很像是典型的构造函数。 <html> <meta charset="utf-8"> <head> <script> function Person(name, age, job){ var o = new Object(); o.name = name; o.age = age; o.job = job; o.sayName = function(){ alert(this.name); }; return o; } var friend = new Person("Nicholas", 29, "Software Engineer"); friend.sayName(); //"Nicholas" </script> </head> <body> </body> </html> 在这个例子中,Person 函数创建了一个新对象,并以相应的属性和方法初始化该对象,然后又返 回了这个对象。除了使用 new 操作符并把使用的包装函数叫做构造函数之外,这个模式跟工厂模式其实 是一模一样的。构造函数在不返回值的情况下,默认会返回新对象实例。 而通过在构造函数的末尾添加一个 return 语句,可以重写调用构造函数时返回的值。 这个模式可以在特殊的情况下用来为对象创建构造函数。假设我们想创建一个具有额外方法的特殊 数组。由于不能直接修改 Array 构造函数,因此可以使用这个模式。 示例: <html> <meta charset="utf-8"> <head> <script> function SpecialArray(){ //创建数组 var values = new Array(); //添加值 values.push.apply(values, arguments); //添加方法 values.toPipedString = function(){ return this.join("|"); }; //返回数组 return values; } var colors = new SpecialArray("red", "blue", "green"); alert(colors.toPipedString()); //"red|blue|green" </script> </head> <body> </body> </html> 在这个例子中,我们创建了一个名叫 SpecialArray 的构造函数。在这个函数内部,首先创建了 一个数组,然后 push()方法(用构造函数接收到的所有参数)初始化了数组的值。随后,又给数组实 例添加了一个 toPipedString()方法,该方法返回以竖线分割的数组值。后,将数组以函数值的形 式返回。接着,我们调用了 SpecialArray 构造函数,向其中传入了用于初始化数组的值,此后又调 用了 toPipedString()方法。 关于寄生构造函数模式,有一点需要说明:首先,返回的对象与构造函数或者与构造函数的原型属 性之间没有关系;也就是说,构造函数返回的对象与在构造函数外部创建的对象没有什么不同。为此, 不能依赖 instanceof 操作符来确定对象类型。由于存在上述问题,我们建议在可以使用其他模式的情 况下,不要使用这种模式。 (7)稳妥构造函数模式 道格拉斯·克罗克福德(Douglas Crockford)发明了 JavaScript中的稳妥对象(durable objects)这 个概念。所谓稳妥对象,指的是没有公共属性,而且其方法也不引用 this 的对象。稳妥对象适合在 一些安全的环境中(这些环境中会禁止使用 this 和 new),或者在防止数据被其他应用程序(如 Mashup 程序)改动时使用。稳妥构造函数遵循与寄生构造函数类似的模式,但有两点不同:一是新创建对象的 实例方法不引用 this;二是不使用 new 操作符调用构造函数。按照稳妥构造函数的要求,可以将前面 的 Person 构造函数重写如下 <html> <meta charset="utf-8"> <head> <script> function Person(name, age, job){ //创建要返回的对象 var o = new Object(); //可以在这里定义私有变量和函数 //添加方法 o.sayName = function(){ alert(name); }; //返回对象 return o; } </script> </head> <body> </body> </html> 注意,在以这种模式创建的对象中,除了使用 sayName()方法之外,没有其他办法访问 name 的值。 可以像下面使用稳妥的 Person 构造函数。 var friend = Person("Nicholas", 29, "Software Engineer"); friend.sayName(); //"Nicholas" 这样,变量 friend 中保存的是一个稳妥对象,而除了调用 sayName()方法外,没有别的方式可 以访问其数据成员。即使有其他代码会给这个对象添加方法或数据成员,但也不可能有别的办法访问传 入到构造函数中的原始数据。稳妥构造函数模式提供的这种安全性,使得它非常适合在某些安全执行环 境——例如,ADsafe(www.adsafe.org)和 Caja(http://code.google.com/p/google-caja/)提供的环境—— 下使用。 注意: 与寄生构造函数模式类似,使用稳妥构造函数模式创建的对象与构造函数之间也 没有什么关系,因此 instanceof 操作符对这种对象也没有意义。 js的工厂模式,构造函数模式,原型模式,组合使用构造函数合原型模式,动态原型模式,寄生构造函数模式,稳妥构造函数模式等 大家有没有从中发现,js的设计模式基本围绕着构造和原型这两个主要点。 该篇只是对js的设计模式作出相应的讲解和知识普及,不熟悉该概念的可以参考此文,大家可以将上述例子,自己动手敲着看,哪怕有经验的Java开发或者js,一起敲敲吧,保证有不一样的体会。

优秀的个人博客,低调大师

《Android程序设计》一3.2 活动、意图和任务

3.2 活动、意图和任务 Android活动既是用户交互单元(通常填满Android移动设备的整个屏幕)也是执行单元。开发交互式的Android程序时,首先要继承Activity类。活动提供了在Android应用中可重用、可交换的UI组件流。那么,一个活动如何调用另一个活动,如何将信息传递给第二个活动呢?不同活动之间的基本通信单元是Intent类。Intent类是一个抽象的功能描述,用来定义一个活动要求另一个活动执行的功能,类似于是第二个活动提供的功能的一张照片。Intent类是构建松散耦合的系统的基础,它支持一个活动启动另一个活动。应用发布Intent时,可能已经有几个不同的已注册的活动都能实现这个功能。在本书第1章中为验证Android SDK是否正确安装而创建test应用的过程中,我们已经“编写”过了和活动相关的代码。下面再一

优秀的个人博客,低调大师

《Android程序设计》一3.7 组件生命周期

3.7 组件生命周期 我们在前面提到过组件的生命周期。例如,onCreate操作会启动一个应用。组件生命周期有两个用途:它有助于每个应用的内存或堆空间被有效利用,并且能够确保保存和恢复整个进程的状态,从而使得Android系统能够运行比实际内存容量更多的应用。活动生命周期最复杂的组件生命周期是活动的生命周期。这里我们将通过图表描述它,看看这些状态变化在代码层面是如何处理的。在图3-5中,可以看到活动生命周期的状态和状态转换。处理生命周期状态转换的核心因素在于选择需要实现的那一种生命周期回调,并了解什么时候执行这些回调。在第11章中,我们将进一步深入探讨这个话题。现在,我们来看看Activity类的两种方法。在运行时调用第一种方法通知应用保存其状态,调用第二种方法支持新的Activity实例恢复已经销毁的Activity生命周期的状态

优秀的个人博客,低调大师

JavaScript面向对象程序设计创建对象的方法分析

面向对象的语言具有一个共同的标志,那就是具有“类”的概念,但是在javascript中没有类的概念,在js中将对象定义为“无序属性的集合,其属性可以包含基本值,对象或者函数”,即其将对象看作是一组名值对的散列表。这样问题就来了,如何创建对象呢? 在最开始时使用object构造函数和对象字面量来创建单个对象,下面简要介绍这两种方法。 object构造函数:创建自定义对象的最简单方式就是创建一个object的实例,然后为这个实例添加属性和方法: var person=new object(); person.name="haha"; person.age=20; person.job="搞笑工作者"; person.sayName=function(){ alert(this.name); }; //前端全栈学习交流圈:866109386 //面向1-3经验年前端开发人员 //帮助突破技术瓶颈,提升思维能力 在上面的代码中,定义了一个person对象,并且添加了三个属性和一个方法,其中方法采用的时函数表达式的方式实现,这是用object构造函数的方式创建一个对象。 对象字面量: var person={ name:"haha", age:20, job:"搞笑工作者", sayName:function(){ alert(this.name); } } 以上代码中同样创建了一个person对象,这种方法类似于代码块的方式,实现了对一个person对象的创建。 以上这两种方法中,都需要大量重复定义,在我们需要创建对象时就需要重复以上代码,不够精炼,所以出现了工厂模式和构造函数模式类创建对象的方法。 工厂模式: 工程模式抽象了创建具体对象的过程(专业书籍中给出),其实说的比较明白点就是采用函数的形式,用函数来封装创建对象的过程,再创建对象时以调用函数的形式创建。例如: function createPerson(name,age,job){ var o=new object(); o.name="haha"; o.age=20; o.job="搞笑工作者"; o.sayName=function(){ alert(this.name); }; return o; } var person1=createPerson("hehe",22,"呵呵工作者"); var person2=createPerson("heihei",23,"嘿嘿工作者"); //前端全栈学习交流圈:866109386 //面向1-3经验年前端开发人员 //帮助突破技术瓶颈,提升思维能力 在这种工厂模式下,将以object构造函数创建对象的方法封装到了一个函数中,在以后的创建对象的过程中,直接调用此方法就可以创建出一个接着一个的对象。 构造函数模式: 构造函数模式相对于工厂模式的优势在于构造函数模式可以创建特定类型的对象。 function Person(name,age,job){ this.name=name; this.age=age; this.job=job; this.sayName=function(){ alert(this.name); }; } var person1=new Person("hehe",22,"呵呵工作者"); var person2=new Person("heihei",23,"嘿嘿工作者"); //前端全栈学习交流圈:866109386 //面向1-3经验年前端开发人员 //帮助突破技术瓶颈,提升思维能力 在以上代码中,定义一个Person()的方法,在Person()方法中,将其属性进行了实例化,这种方法类似于在面向对象语言中在实例化类时直接会调用的构造函数,利用这种方法,将此函数大致相当于面向对象语言中的类,可以在以后的代码中不断的实例化,用以不断创建出此类的对象。在Javascript中,这种构造函数也是一种函数,不过是专门用于创建对象而已。

优秀的个人博客,低调大师

C++程序设计基础(4)宏定义和内联

1.知识点 1.1宏定义 (1)不带参数的宏定义 1 #define ERROR_MESSAGE -100 2 #define SECONDS_PER_DAY 60*60*60 (2)带参数宏定义,这种形式称为宏函数,但其实并不是函数 #define OUTPUTINT(x) cout<<"INT:"<<x<<endl #define OUTPUTCHAR cout<<"CHAR:"<<x<<endl 1.2内联函数 宏定义是在预处理阶段进行宏展开的,但是经常会出现一些意想不到的错误,故出现内联函数,内联函数既发挥了宏定义的优势,又弥补了其缺点。 内联函数是在定义时在函数最前面加上inline,或者将函数声明的同时进行定义(这种方式不推荐)。 下面是一个内联函数的例子: 1 class Rectangle { 2 public: 3 Rectangle(int, int); 4 int getSquare(); 5 int getGirth() { return 2 * (length, width); } //直接在声明时定义函数,形成内联函数 6 private: 7 int length; 8 int width; 9 }; 10 11 Rectangle::Rectangle(int l,int w):length(l),width(w){} 12 inline int Rectangle::getSquare() { //在函数定义时使用inline形成内联函数 13 return length * width; 14 } 2.面试题 2.1简述内联函数和宏定义的区别 相同点:二者都能够节省频繁的函数调用过程中所产生的时间和空间消耗,提高执行的效率;二者都是哦谈过将函数调用替换成完整的函数体,二者的实现也类似。 区别:(1)二者的根本区别在于宏定义仅仅是字符串的替换,并不是函数,而内联函数是函数。 (2)二者的代码展开发生在不同阶段,宏定义是在预处理阶段展开的,而内联函数是在编译阶段展开的。 (3)内联函数作为类的成员函数时,可以访问类的所有成员,包括公有、私有、保护成员,隐式使用this指针,而宏定义无法实现这些功能。 (4)内联函数可以完全替代宏定义,故尽量少使用宏定义。 (5)另外在使用内联函数时要注意代码膨胀问题,内联函数应该尽量简短(另外现在编译器一般都有优化功能,当检测到内联函数代码很长时,不会进行内联,即使使用了内联函数)。 2.2宏定义的宏展开错误 指出下面程序中宏定义的错误并修改 1 #define MAX(a,b) a>b?a:b 2 #define MUL(a,b) a*b 3 int main(int argc, char *argv[]) { 4 int x = 4, y = 2; 5 int max = MAX(x, y); 6 int product = MUL(x, y); 7 cout << "the max is " << max << endl; 8 cout << "the product is " << product << endl; 9 getchar(); 10 return 0; 11 } 知识点:宏定义自身缺陷主要是宏展开之后,由于运算符的优先级等原因,使得宏定义展开后的语义和预想的发生偏差。 以下时两个宏展开出错的例子 1 int product=MUL(x,y+3) 2 int max=MAX(x,y)+2 3 4 //本意是 5 int product=x*(y+3) 6 int max=(x>y?x:y)+2 7 //实际宏展开变成了 8 int product=x*y+3 9 int max=x>y?x:y+2 解决办法包括以下两点: (1)给参数自身加上括号 (2)给整个宏定义加上括号 其修改结果如下: #define MAX(a,b) ((a)>(b)?(a):(b)) #define MUL(a,b) ((a)*(b)) 2.3内联函数的常识性问题 下列关于内联函数描述错误的是 (A)内联函数可以被重载; (B)构造函数可以被定义成内联函数; (C)内联函数能够减少函数调用的开销; (D)内联函数应该在函数声明时使用inline关键字 答案:D,一定要在定义时使用inline,在声明时使用不会起到任何作用。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册