社区项目ROSA-Tuning:验证RWKV-8 ROSA效果
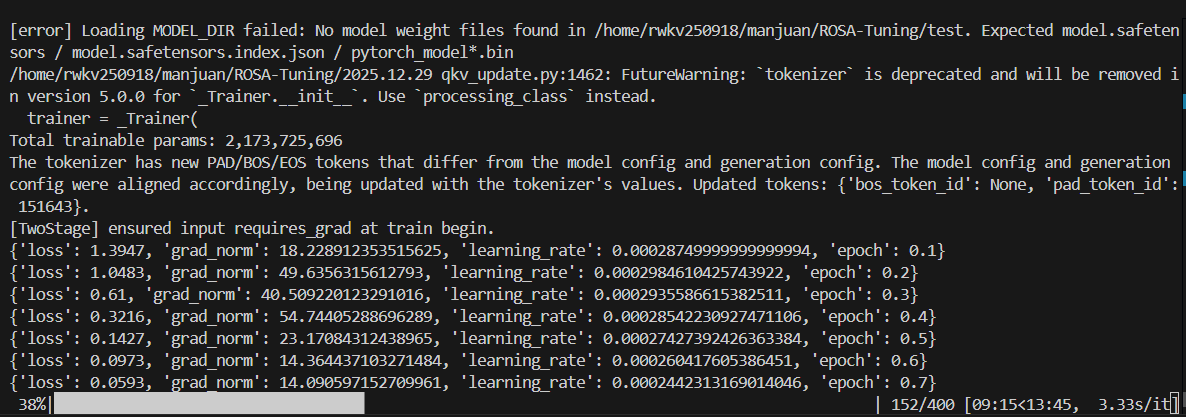
本项目来自 RWKV 社区开发者 zyaaa-ux ,项目链接:https://github.com/zyaaa-ux/ROSA-Tuning。 本项目为社区提出的一种 ROSA 实现,不代表 RWKV-8 ROSA 的实际性能,效果供参考。 本项目提出 ROSA-Tuning,一种通过检索回忆机制增强预训练模型长上下文建模能力的方法。该方法在传统注意力机制之外并行引入基于 CPU 的 ROSA(RWKV Online Suffix Automaton)检索模块,从长上下文中高效定位与当前查询相关的历史位置,并以可训练的方式将检索到的信息注入模型状态,故随后的加权融合可由状态受限的高效注意力完成。 为实现端到端训练,本文设计了二值离散化策略与反事实梯度算法,并通过 CPU–GPU 异步流水线进一步优化整体执行效率。 在 Qwen3-Base-1.7B 上的系统性评估结果表明,ROSA-Tuning 能够显著恢复窗口注意力模型的长上下文建模能力,在 LongBench 等基准上取得接近甚至匹配全局注意力的性能,同时保持与窗口注意力方法几乎相当的计算效率与显存占用,为高效长上下文处理提供了一条新的技术路径。 性能测试 困惑度 (PPL) 对比 在 PG-19 数据集上的测试显示,ROSA 适配器成功修复了窗口注意力的 PPL 劣化,甚至优于全局注意力。 Model PPL (越低越好) Global Attention 18.96 Windowed Attention 74.50 Windowed + ROSA 17.63 实验设置: 基础模型:具有全局注意力或窗口注意力的 Qwen3-Base-0.6B 训练:28,000 个样本,在 PG-19 训练集上训练 1 个轮次,原始模型冻结,仅训练 ROSA 适配器 评估:PG-19 测试集,序列长度 16k,窗口大小 1024 长文本能力 (LongBench) 在大海捞针 (NIAH) 测试,ROSA 实现了 100% 的召回率。综合评分恢复至全局注意力的 96.5%。 Task / Metric Global Attention Windowed (2048) Windowed + ROSA NIAH (大海捞针) 100.00 6.20 100.00 TriviaQA 86.20 61.56 84.34 Multi_news 23.23 10.43 23.76 Samsum 42.04 32.51 40.53 TREC 72.67 52.67 68.00 Gov_report 31.11 13.08 26.19 LongBench 平均分 59.21 29.41 57.14 实验设置: 基础模型:Qwen3-1.7B-Base,具有全局注意力或窗口化注意力(窗口大小2048) 训练数据:约 37B tokens,其中约 30B 来自 prolong,约 7B 来自其他上下文推理数据集,且不与测试集重叠 使用方法 项目作者进行了非常多的实验,本次介绍 2025 年 12 月 29 日更新的 2025.12.29 qkv_update.py 的使用方法。 注意在本地准备 Hugging Face datasets 库保存到磁盘的格式(Arrow 格式)的数据。 环境准备和代码获取 首先运行下列代码安装需要的库: pip install torch transformers datasets deepspeed numba numpy 可选安装 flash-attn 库,该库能够提升代码运行速度,但首次安装时需要编译。 然后运行下列命令,获取项目代码: git clone https://github.com/zyaaa-ux/ROSA-Tuning 准备 DeepSpeed 配置文件 项目使用了 DeepSpeed 进行加速,因此需要在本地创建一个 deepspeed_config.json 文件,示例如下: { "fp16": { "enabled": "auto", "loss_scale": 0, "loss_scale_window": 1000, "initial_scale_power": 16, "hysteresis": 2, "min_loss_scale": 1 }, "bf16": { "enabled": "auto" }, "zero_optimization": { "stage": 2, "allgather_partitions": true, "allgather_bucket_size": 200000000, "overlap_comm": true, "reduce_scatter": true, "reduce_bucket_size": 200000000, "contiguous_gradients": true, "offload_optimizer": { "device": "cpu", "pin_memory": true }, "offload_param": { "device": "none" } }, "gradient_accumulation_steps": "auto", "train_batch_size": "auto", "train_micro_batch_size_per_gpu": "auto", "gradient_clipping": "auto", "steps_per_print": 20, "wall_clock_breakdown": false } 如果显存足够,可以删除 offload_optimizer 中的 pin_memory 参数,并将 device 的值修改为 none,来获得更快的运行速度。 修改配置 2025.12.29 qkv_update.py 的 68~73 行定义了路径参数,需要修改路径参数为你本地的路径。 MODEL_LOCAL_DIR = "/path/to/base/model/" # 本地基础模型路径 MODEL_DIR = "/path/to/checkpoint/" # 模型检查点保存路径 DATASET_DIR = "/path/to/processed/dataset/" # 数据集路径 OUTPUT_DIR = "/path/to/output/" # 输出路径 DEEPSPEED_CONFIG_PATH = "/path/to/deepspeed/config.json" # DeepSpeed 配置文件路径 如果需要更加节省显存,可以修改代码第 119 行为 True,打开梯度累计: GRADIENT_CHECKPOINTING = True # 源代码是 False 如果本地无 flash-attn 库,可以修改第 78 行的代码,关闭 flash-attn 的使用: USE_FLASH_ATTN = False # 原来是 True 运行启动命令 由于使用了 DeepSpeed 和分布式训练逻辑(is_main_process 等检查),推荐 deepspeed 命令启动。 deepspeed --num_gpus=1 2025.12.29 qkv_update.py 启动成功后,会输出以下内容: 该图为使用 200 条长度为 128 的数据在单卡 4090 上进行流程测试的示例,实际训练 16k 长度数据时需要很大的显存。 🧠 原理概述 加入 RWKV 社区 欢迎大家加入 RWKV 社区,可以从 RWKV 中文官网了解 RWKV 模型,也可以加入 RWKV 论坛、QQ 频道和 QQ 群聊,一起探讨 RWKV 模型。 📖 RWKV 中文文档:https://www.rwkv.cn 💬 RWKV 论坛:https://community.rwkv.cn/ 🐧 QQ 频道:https://pd.qq.com/s/9n21eravc | QQ 交流群:224287095 📺 BiliBili 视频教程:https://space.bilibili.com/3546689096910933 欢迎大家基于 RWKV-7 进行创业、科研,我们也会为基于 RWKV 的项目提供技术支持。 如果您的团队正在基于 RWKV 创业或开展研究,请联系我们!(在“RWKV元始智能”微信公众号留言您的联系方式,或发送邮件到“contact@rwkvos.com”。)