首页 文章 精选 留言 我的

精选列表

搜索[一键安装包],共10000篇文章
优秀的个人博客,低调大师

PAI-Diffusion中文模型全面升级,海量高清艺术大图一键生成

作者:段忠杰(终劫)、刘冰雁(伍拾)、汪诚愚(熊兮)、黄俊(临在) 背景 以Stable Diffusion模型为代表,AI生成内容(AI Generated Content,AIGC)的模型和应用呈现出井喷式的增长趋势。在先前的工作中,阿里云机器学习PAI团队开源了PAI-Diffusion系列模型(看这里),包括一系列通用场景和特定场景的文图生成模型,例如古诗配图、二次元动漫、魔幻现实等。这些模型的Pipeline除了包括标准的Diffusion Model,还集成了PAI团队先前提出的中文CLIP跨模态对齐模型(看这里)使得模型可以生成符合中文文本描述的、各种场景下的高清大图。此外,由于Diffusion模型推理速度比较慢,而且需要耗费较多的硬件资源,我们结合由PAI自主研发的编译优化工具 PAI-Blade,支持对PAI-Diffusion模型的端到端的导出和推理加速,在A10机器下做到了1s内的中文大图生成(看这里)。在本次的工作中,我们对之前的PAI-Diffusion中文模型进行大幅升级,主要的功能扩展包括: 图像生成质量的大幅提升、风格多样化:通过大量对模型预训练数据的处理和过滤,以及训练过程的优化,PAI-Diffusion中文模型生成的图像无论在质量上,还是在风格上都大幅超越先前版本; 丰富的精细化模型微调功能:除了对模型的标准微调,PAI-Diffusion中文模型支持开源社区的各种微调功能,包括LoRA、Textual Inversion、DreamBooth、ControlNet等,支持各类图像生成和编辑的功能; 简单易用的场景化定制方案:除了训练各种通用场景下的中文模型,我们也在垂类场景下做了很多尝试和探索,通过场景化的定制,可以在各种产品中使用这些模型,包括Diffuser API、WebUI等。 在下文中,我们详细介绍PAI-Diffusion中文模型的新功能和新特性。 艺术画廊 在详细介绍PAI-Diffusion中文模型及其功能前,我们首先带大家参观我们的艺术画廊,下面的所有图片都采用PAI-Diffusion中文模型真实生成。 positive prompt: 人工智能,未来派,4k,科幻 negative prompt: 模糊 positive prompt: 魔法药瓶 negative prompt: positive prompt: 雄鹰展翅,风暴,动漫风格 negative prompt: positive prompt: 中国风景图 远山、清水、古楼、古船、飞鸟、云雾,光线灿烂,远距离透视,超广角,气势磅礴,色彩逼真 negative prompt: 丑陋,畸形,模糊,画面不连贯,污染,噪声 positive prompt: 带墨镜的猫,黑客,特工,西装 negative prompt: positive prompt: 海底世界,各种鱼类,海草 negative prompt: positive prompt: 白瓷的咖啡杯,质地细腻、透光性好,中国传统的瓷器。深蓝色主色调。 高贵、优雅、沉稳 negative prompt: 斑点 positive prompt: 柴犬小狗,机甲,机器人,未来科技 negative prompt: positive prompt: 白色小狐狸,扁平画风 negative prompt: 斑点,噪点 positive prompt: 参天大树,浮雕,画框 negative prompt: positive prompt: 东方美女,学妹,少女,精致面容,可爱,长发,古装,汉服,画面精致,完美造型,柔和的色彩,电影感 negative prompt: positive prompt: 奇妙几何形别墅,悬崖上 negative prompt: positive prompt: 粉红色羽毛的猫头鹰 negative prompt: positive prompt: 浮岛,天空,白云,城堡,幻想世界 negative prompt: 油画,模糊,雾蒙蒙 positive prompt: 一个抽烟的美丽女人的画像,梦幻般的色彩,精美细节 negative prompt: 丑陋,畸形,污染,噪声 positive prompt: 一个穿着连帽衫的酷女孩,日蚀背景,精美细节,赛博朋克 negative prompt: 噪声,污染 positive prompt: 火车,雪地,隧道,昏暗灯光,恐怖片 negative prompt: 多个铁轨 positive prompt: 金属盒子,宝箱,神秘,反光,骷髅,草地上 negative prompt: positive prompt: 镜中花,水中月,水彩画,大量笔墨 negative prompt: positive prompt: 阳光,彩虹,小白马 negative prompt: positive prompt: 中国剪纸画,雪山,白云,落日 negative prompt: positive prompt: 日落时分城市的鸟瞰图,日蚀行星建构主义风格 negative prompt: 噪点,扭曲 positive prompt: 山水画,流畅的线条,优美的山水图案 negative prompt: 斑点 positive prompt: 亭台楼阁,曲径通幽,水墨绘画,中国风 negative prompt: 油画,彩色 positive prompt: 洋葱头小精灵,可爱,童话 negative prompt: positive prompt: 一只小猪在夕阳下奔跑,童话绘本 negative prompt: positive prompt: 一个戴着眼镜的女孩 ,精致的五官,白皮肤,赛博朋克场景,全身照片 negative prompt: positive prompt: 一个在上学路上的女孩,宫崎骏的绘画风格,清晰 negative prompt: 摄影,写实,模糊 positive prompt: 向日葵花海,最高的质量,8K,超精细刻画 negative prompt: positive prompt: 落日风景油画,朦胧美 negative prompt: 画框,画笔 positive prompt: 生肖兔,武侠风,仙气,紫砂盔甲配剑,细节,特写 negative prompt: positive prompt: 盛世莲花,传说,荷塘,发光,柔和光线,CG感 negative prompt: 斑点 positive prompt: 陶瓷大花瓶,牡丹花 negative prompt: positive prompt: 童话绘本,蘑菇,树林,低饱和度氛围,可爱,萌萌哒 negative prompt: positive prompt: 未来战士,机械装甲,光剑,红眼,科幻 negative prompt: 景深,模糊 positive prompt: 蝴蝶,对称美感,数字艺术 negative prompt: PAI-Diffusion ModelZoo 我们利用海量中文图文对数据,训练了多个Diffusion中文模型,参数量均在10亿左右。本次我们开源了如下两个模型。概述如下所示: 模型名 使用场景 pai-diffusion-artist-large-zh 中文文图生成艺术模型,默认支持生成图像分辨率为512*512 pai-diffusion-artist-xlarge-zh 中文文图生成艺术模型(更大分辨率),默认支持生成图像分辨率为768*768 为了提升模型输出图像的质量,在最大限度内避免出现不合规或低质量内容,我们搜集海量开源的图文对数据集,包括大规模中文跨模态预训练数据集WuKong、大规模多语言多模态数据集LAION-5B等。我们针对图像和文本进行了多种清洗方式,筛选掉违规和低质量数据。具体的数据处理方式包括NSFW(Not Safe From Work)数据过滤、水印数据去除,以及使用CLIP分数和美观值分数评分,选出最合适的预训练数据子集进行训练。与英文开源社区的Diffusion模型不同,我们的CLIP Text Encoder采用EasyNLP自研的中文CLIP模型(https://github.com/alibaba/EasyNLP),并且在Diffusion训练过程中冻结其参数,使得模型对中文语义的建模更加精确。值得注意的是,上表的图像分辨率指训练过程中的图像分辨率,在模型推理阶段可以设置不同的分辨率。 PAI-Diffusion模型特性 为了更加便于广大用户使用PAI-Diffusion模型,我们从如下几个方面详细介绍PAI-Diffusion模型的特性。 丰富多样的模型微调方法 PAI-Diffusion模型和社区Stable Diffusion等模型的参数量一般在十亿左右。这些模型的全量参数微调往往需要消耗大量计算资源。除了标准的模型微调,PAI-Diffusion模型支持多种轻量化微调算法,支持用户在计算量尽可能少的情况下,实现模型的特定领域、特定场景的微调。以下,我们也给出两个轻量化微调的示例。 使用LoRA进行模型轻量化微调 PAI-Diffusion模型可以使用LoRA(Low-Rank Adaptation)算法进行轻量化微调,大幅降低计算量。调用开源脚本train_text_to_image_lora.py,我们同样可以实现PAI-Diffusion中文模型的轻量化微调。训练命令示例如下: export MODEL_NAME="model_name" export TRAIN_DIR="path_to_your_dataset" export OUTPUT_DIR="path_to_save_model" accelerate launch train_text_to_image_lora.py \ --pretrained_model_name_or_path=$MODEL_NAME \ --train_data_dir=$TRAIN_DIR \ --resolution=512 --center_crop --random_flip \ --train_batch_size=1 \ --gradient_accumulation_steps=4 \ --max_train_steps=15000 \ --learning_rate=1e-04 \ --max_grad_norm=1 \ --lr_scheduler="cosine" --lr_warmup_steps=0 \ --output_dir=$OUTPUT_DIR 其中,MODEL_NAME是用于微调的PAI-Diffusion模型名称或路径,TRAIN_DIR是训练集的本地路径,OUTPUT_DIR为模型保存的本地路径(只包含LoRA微调参数部分)。当模型LoRA轻量化微调完毕之后可以使用如下示例代码进行文图生成: from diffusers import StableDiffusionPipeline model_id = "model_name" lora_path = "model_path/checkpoint-xxx/pytorch_model.bin" pipe = StableDiffusionPipeline.from_pretrained(model_id) pipe.unet.load_attn_procs(torch.load(lora_path)) pipe.to("cuda") image = pipe("input text").images[0] image.save("result.png") 其中,model_path即为微调后的模型保存的本地路径(只包含LoRA微调参数部分),即前一步骤的OUTPUT_DIR;model_id为原始的没有经过LoRA微调的模型。 使用Textual Inversion进行模型定制化轻量微调 由于PAI-Diffusion模型一般用于生成各种通用场景下的图像,Textual Inversion是一种定制化轻量微调技术,使模型生成原来模型没有学会的、新的概念相关图像。PAI-Diffusion模型可以使用Textual Inversion算法进行轻量化微调。同样地,我们可以运行脚本textual_inversion.py,训练命令示例如下: export MODEL_NAME="model_name" export TRAIN_DIR="path_to_your_dataset" export OUTPUT_DIR="path_to_save_model" accelerate launch textual_inversion.py \ --pretrained_model_name_or_path=$MODEL_NAME \ --train_data_dir=$TRAIN_DIR \ --learnable_property="object" \ --placeholder_token="<小奶猫>" --initializer_token="猫" \ --resolution=512 \ --train_batch_size=1 \ --gradient_accumulation_steps=4 \ --max_train_steps=100 \ --learning_rate=5.0e-04 --scale_lr \ --lr_scheduler="constant" \ --lr_warmup_steps=0 \ --output_dir=$OUTPUT_DIR 其中,MODEL_NAME是用于微调的PAI-Diffusion模型名称,TRAIN_DIR是前述训练集的本地路径,OUTPUT_DIR为模型保存的本地路径。其中placeholder_token是与新的概念相关的文本,initializer_token是与新的概念密切相关的字(用于初始化新的概念对应的参数),这里我们以小奶猫为例。当模型轻量化微调完毕之后可以使用如下示例代码进行文图生成: from diffusers import StableDiffusionPipeline model_path = "path_to_save_model" pipe = StableDiffusionPipeline.from_pretrained(model_path).to("cuda") image = pipe("input text").images[0] image.save("result.png") 其中,model_path即为微调后的模型保存的本地路径,即前一步骤的OUTPUT_DIR。注意在使用微调后的模型生成包含新的概念的图像时,文本中新的概念用步骤二中的placeholder_token表示,例如: 输入文本:一只<小奶猫>在草地上 输入文本:一只<小奶猫>在沙发上 输出图像 输出图像 AIGC系列模型的潜在风险在于容易生成不可控的、带有违法信息的内容,影响了这些模型在下游业务场景中的应用。PAI-Diffusion中文模型支持多种可控的图像编辑功能,允许用户对生成的图像内容作出限制,从而使得结果更加可用。PAI-Diffusion中文模型对StableDiffusionImg2ImgPipeline做到完全兼容,这一文本引导的图像编辑Pipeline允许模型在给定输入文本和图像的基础上,生成相关的图像,示例脚本如下: from diffusers import StableDiffusionImg2ImgPipeline pipe = StableDiffusionImg2ImgPipeline.from_pretrained("model_name").to("cuda") image = pipe(prompt="input text", image=init_image, strength=0.75, guidance_scale=7.5).images[0] image.save("result.png") 以下给出一个输入输出的示例: 输入文本:雪地里的两只企鹅 输入图像 输出图像 场景定制化的功能支持 除了用于生成艺术大图,通过对PAI-Diffusion中文模型进行继续预训练,我们也可以得到高度场景化的中文模型。以下是PAI-Diffusion中文模型在美食数据上继续预训练后生成的结果,可以看出只要拥有高质量的业务数据,可以产出针对不同业务场景的Diffusion模型。这些模型可以进一步与LoRA、ControlNet等技术进行无缝结合,做到与业务更契合、更可控的图像编辑与生成。 菠萝炒饭 韭菜鸡蛋水饺 番茄炒蛋 韩式炸鸡 红烧狮子头 清汤娃娃菜 模型的使用和下载 在开源社区使用PAI-Diffusion中文模型 为了方便开源社区使用这些模型,我们将这两个模型接入了两个知名的开源模型分享社区HuggingFace和ModelScope。以HuggingFace为例,我们可以使用如下代码进行模型推理: from diffusers import StableDiffusionPipeline model_id = "alibaba-pai/pai-diffusion-artist-large-zh" pipe = StableDiffusionPipeline.from_pretrained(model_id) pipe = pipe.to("cuda") prompt = "雾蒙蒙的日出在湖面上" image = pipe(prompt).images[0] image.save("result.png") 在ModelScope的使用接口示例如下: from modelscope.pipelines import pipeline import cv2 p = pipeline('text-to-image-synthesis', 'PAI/pai-diffusion-artist-large-zh', model_revision='v1.0.0') result = p({'text': '雾蒙蒙的日出在湖面上'}) image = result["output_imgs"][0] cv2.imwrite("image.png", image) 此外,我们也在EasyNLP算法框架中开设了Diffusion算法专区(链接),提供各种PAI-Diffusio模型的使用脚本和教程。 在PAI-DSW使用PAI-Diffusion中文模型 PAI-DSW(Data Science Workshop)是阿里云机器学习平台PAI开发的云上IDE,面向不同水平的开发者,提供了交互式的编程环境(文档)。在DSW Gallery中,提供了各种Notebook示例,方便用户轻松上手DSW,搭建各种机器学习应用。我们也在DSW Gallery中上架了使用PAI-Diffusion中文模型的Sample Notebook,欢迎大家体验! 免费领取:阿里云机器学习平台PAI为开发者提供免费试用额度,包含DSW、DLC、EAS多款产品。https://free.aliyun.com/?pipCode=learn 未来展望 在这一期的工作中,我们对PAI-Diffusion中文模型的效果和功能进行了大幅扩展,使得图像生成质量的大幅提升、风格多样化。同时,我们支持包括LoRA、Textual Inversion等多种精细化模型微调和编辑功能。此外,我们也展示了多种场景化定制方案,方便用户在特定场景下训练和使用自己的Diffusion中文模型。在未来,我们计划进一步扩展各种场景的模型功能。 阿里灵杰回顾 阿里灵杰:阿里云机器学习PAI开源中文NLP算法框架EasyNLP,助力NLP大模型落地 阿里灵杰:预训练知识度量比赛夺冠!阿里云PAI发布知识预训练工具 阿里灵杰:EasyNLP带你玩转CLIP图文检索 阿里灵杰:EasyNLP中文文图生成模型带你秒变艺术家 阿里灵杰:EasyNLP集成K-BERT算法,借助知识图谱实现更优Finetune 阿里灵杰:中文稀疏GPT大模型落地 — 通往低成本&高性能多任务通用自然语言理解的关键里程碑 阿里灵杰:EasyNLP玩转文本摘要(新闻标题)生成 阿里灵杰:跨模态学习能力再升级,EasyNLP电商文图检索效果刷新SOTA 阿里灵杰:EasyNLP带你实现中英文机器阅读理解 阿里灵杰:EasyNLP发布融合语言学和事实知识的中文预训练模型CKBERT 阿里灵杰:当大火的文图生成模型遇见知识图谱,AI画像趋近于真实世界 阿里灵杰:PAI-Diffusion模型来了!阿里云机器学习团队带您徜徉中文艺术海洋 阿里灵杰:阿里云PAI-Diffusion功能再升级,全链路支持模型调优,平均推理速度提升75%以上

优秀的个人博客,低调大师

迫于压力 微软宣布恢复Windows 11一键切换默认浏览器选项

在 Windows 11 平台上,如果你想将默认浏览器从 Edge 切换到 Firefox/Chrome,那么整个操作现在变得更加复杂了。微软已经删除了只需点击一下就能设置默认浏览器的选项,用户需要对 HTM、HTML、HTTP、HTTPS、SHTML、WEBP、SVG 等文件类型均配置之后才能切换到 Firefox/Chrome。 在 Windows11 版本更迭中,微软对应用程序和功能页面进行了重新设计。该页面允许用户自行配置默认文件打开应用,包括浏览器和音乐播放器。对于浏览器,微软已经删除了一个一切使用第三方浏览器的选项。 现在,如果你试图将默认浏览器改为 Chrome 或 Firefox,你将需要为所有可能的网络相关格式手动改变文件类型。这包括 HTM、HTML、HTTP、HTTPS、SHTML、WEBP、SVG,甚至是 PDF。如果你忘记为所有必要的选项打勾,你将无法使用 Chrome 或 Firefox 作为默认浏览器。 这种复杂的变化让人感到厌烦,用户说微软在试图强迫自己的偏好。在用户发现这一变化后,微软也收到了来自 Google 和 Opera 等对手的反击。 Google 高级副总裁 Hiroshi Lockheimer 说,这种新的[默认浏览器]变化来自于“这家声称是最开放、有最多选择的公司”。这根本不是“选择”。Firefox 官员还批评微软强迫“采取额外和不必要的步骤来设置和保留默认浏览器设置”。 值得庆幸的是,微软终于决定通过一个新的预览更新来恢复 Windows 11 复杂的默认浏览器设置。在 Windows 11 Build 22509 中,微软悄悄启用了一个新的切换键,让你修改所有网络相关文件格式/连接的默认浏览器设置,包括 HTTP 和 HTTPs。

优秀的个人博客,低调大师

“预付费 ECS 实例”可一键添加“预付费云盘”啦~

功能说明 购买预付费实例后,之前您只能通过购买按量付费磁盘然后在升级页(对应OpenAPI为: ModifyDiskChargeType)转换为预付费的磁盘,操作比较繁琐,现支持直接为预付费的实例上添加预付费的磁盘,其生命周期跟实例保持一致。相较于按量付费的磁盘,预付费的磁盘更加便宜,可以享受预付费的一些折扣。 操作步骤(ECS 控制台) 登录 ECS 管理控制台。 选择需要添加 预付费云盘 的预付费 ECS 实例,在 操作 列,选择 更多 > 资源变配 > 添加预付费云盘。如图: 点击 添加预付费云盘 后进入购买云盘页面,如图: 点击 确认订单 > 创建订单 后会生成预付费的订单,您需要支付该订单,支付完成后云盘会自动挂载到所选 ECS 实例上,与所选 ECS 实例的到期时间一致。 其他 OpenAPI 操作,暂不支持,我们会

优秀的个人博客,低调大师

Docker一键部署OpenCloud:从零搭建企业级私有云盘全指南

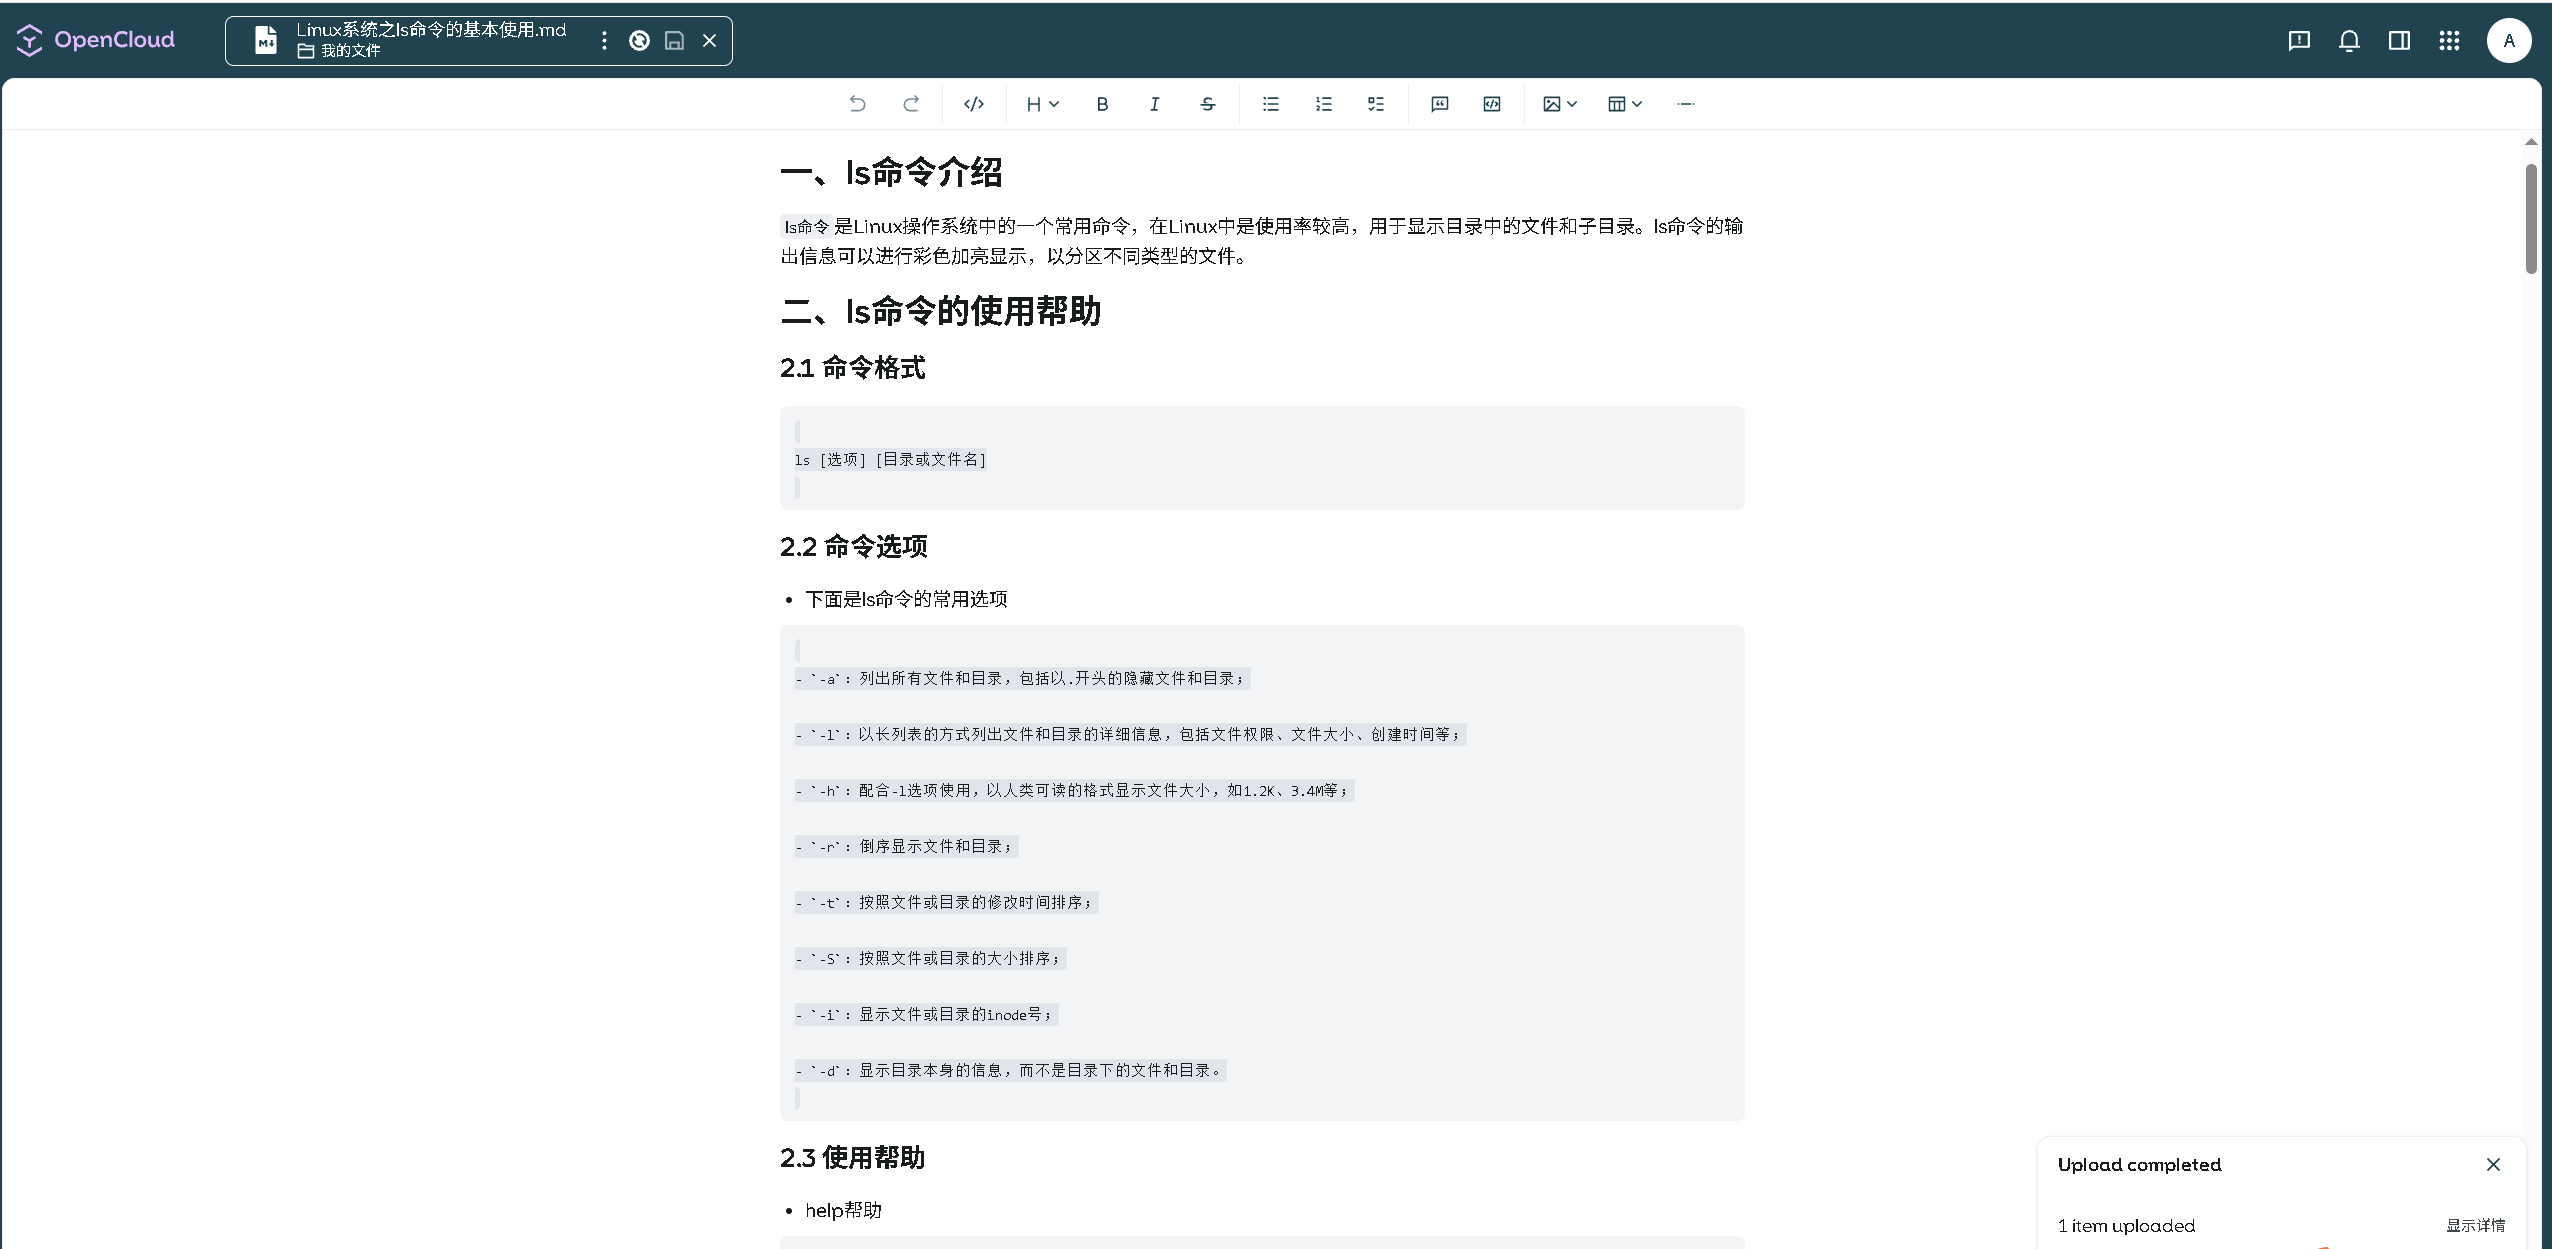
本文详细介绍了在 Docker 环境下部署 OpenCloud 文件管理工具的完整流程。从环境检查、镜像拉取,到使用 Docker Compose 编排服务并完成初始化配置,每一步都提供了具体的命令和操作截图。部署成功后,我们通过浏览器访问并验证了 OpenCloud 的核心功能,包括中文设置、文件夹管理、文件上传以及在线文档编辑。整个过程清晰明了,为个人或团队快速搭建一个私有化、功能全面的文件管理与协作平台提供了实用参考。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册