首页 文章 精选 留言 我的

精选列表

搜索[布隆过滤器],共6716篇文章
优秀的个人博客,低调大师

MXNet 0.11发布,加入动态图接口Gluon,还有两位CMU教授的亲笔教程

经过3个月的开发,MXNet 0.11版发布啦!0.11是MXNet正式加入Apache以后的第一个版本,官方网站搬到了Apache的服务器(注意:要在最上方Version处选择master才能看到包含Gluon的最新文档)。 这次最大的改进是加入了动态图接口Gluon。Gluon学习了Keras,Chainer,和Pytorch的优点,并加以改进。接口更简单,且支持动态图(Imperative)编程。相比TF,Caffe2等静态图(Symbolic)框架更加灵活易用。同时Gluon还继承了MXNet速度快,省显存,并行效率高的优点,并支持静、动态图混用,比Pytorch更快。 同时为了彻底解决MXNet文档不全的弱点,我们还特地邀请了前CMU知名教授Alex Smola和即将出任CMU教授的小网红Zachary Lipton联手为G

优秀的个人博客,低调大师

智慧计算战略再推进 浪潮新一代服务器M5发布在即

7月12日,浪潮将在北京发布新一代服务器M5,浪潮M5新一代服务器全面支持最新英特尔® 至强® 可扩展处理器(代号为"Skylake"),聚焦云计算、大数据、深度学习(简称CBD)应用场景,强调极致的场景化设计,涵盖关键业务服务器、通用服务器、融合架构服务器和应用优化服务器4大系列、超过35款产品,提供业界最丰富的场景应用产品阵列。 浪潮将于7月12日在京发布新一代服务器M5 面向智慧计算 随着人类社会从信息化到智能化的升级,智慧计算成为计算当中最主要的组成部分。智慧计算以云计算为基础平台,大数据为认知方法,深度学习为优化工具,是云计算、大数据和深度学习深度融合的计算形式。 数据中心的升级和变革是智慧计算发展的基础。根据Synergy Research Group的最新数据,截止2016年12月,全球超大型数据中心(可部署10000个以上的标准机架)已经超过300个,可容纳的服务器数量超过2016年全球服务器总出货量。在规模化、专业化程度不断提高,数据中心用户在整体成本的压力下,对服务器的部署密度、能效和统一管理等特性要求不断提高。另一方面,大数据、人工智能等新兴的智能应用形态需要单极强化的硬件平台,对存储、计算提出近乎无限的需求。 浪潮M5新一代服务器聚焦用户具体的应用场景和具象需求,从传统均衡设计到以应用场景为主追求极致和应用优化,在计算性能、可扩展性、配置弹性、智能管理等方面实现极致创新与突破。 场景化产品设计和布局 浪潮M5新一代服务器分别针对关键业务、企业应用、下一代数据中心、大数据和深度学习等四类应用场景,涉及关键业务服务器、通用服务器、融合架构服务器和应用优化服务器4大系列。 关键业务和通用系列服务器仍然追求极致的RASUM特性,计算性能与内存宽带提升50%,为企业应用提供最强大、最可靠的支撑计算平台。 应用优化服务器,面向大型专业数据中心部署需求以及云计算、大数据、深度学习等前沿应用场景,强调灵活优化,分别在计算密度、存储密度、I/O容量、能耗等方面追求极限设计和增强。 融合架构服务器支持ODCC、OCP和Open19三大开放计算标准,分别为天蝎整机柜,OCP整机柜,OCS整机柜,Open19整机柜等4大方案平台,14款扩展节点。 浪潮M5新一代服务器面向专业化部署场景和具体应用场景,从体系结构、硬件部件、资源管理,直至整机系统,进行了大量的定制优化工作。 聚焦计算+,落地智慧计算 目前浪潮已经形成以"计算+"为核心的生态体系,依托完善的软硬件产品线,形成了包括可重构的硬件、云数据中心操作系统、大数据处理平台、智能算法平台的软硬件产品布局。 站在智慧时代的潮头,浪潮要做智能化转型的赋能者和推动者。2017年,聚焦智慧计算业务,围绕智慧计算三要素,浪潮将为计算提供软硬件产品,为数据提供存储处理和分析平台,为算法提供面向应用、深度优化的集成工具。 IDC & Gartner最新数据显示,浪潮服务器销售额、销售量中国市场第一,互联网市场第一。同时在AI计算领域占据优势,其AI计算平台已广泛应用于语音识别、图像识别、无人驾驶领域,市场占有率超过60%。 原文发布时间为:2017年7月7日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

分布式调度中间件Elastic-Job 2.1.0发布:Cloud Native里程碑版本

Elastic-Job 是什么?Elastic-Job是一个开源的分布式调度中间件,由两个相互独立的子项目Elastic-Job-Lite和Elastic-Job-Cloud组成。 Elastic-Job-Lite为轻量级无中心化解决方案,使用jar包提供分布式任务的调度和治理。 Elastic-Job-Cloud是一个Mesos Framework,依托于Mesos额外提供资源治理、应用分发以及进程隔离等服务。 项目已开源接近2年,目前为止已更新发布16次。Elastic-Job已在分布式作业领域占有一席之地,明确采纳的公司已超过50家,未收录的采纳公司不计其数,更有多个开源产品衍生自Elastic-Job。 项目的开源地址: https://github.com/dangdangdotcom/elastic-job Elastic-Job-Lite和Elastic-Job-Cloud的定位是什么?Elastic-Job-Lite定位为纯粹的作业中间件,仅关注分布式调度、协调以及分片等核心功能,将作业部署、资源分配等功能交于Mesos或Kubernetes处理;而Elastic-Job-Cloud提供一体化私有云服务,将分布式调度、作业部署、资源分配、监控、日志处理等提供完善的解决方案。 从功能上看Elastic-Job-Cloud更加完善,但依托于Mesos,使用复杂度较高,不易整合进公司现有系统,因而更加轻量级的Elastic-Job-Lite在实际使用中更受青睐。 之前版本的Elastic-Job-Lite有什么缺失?主要缺失就是对Cloud Native的支持。原来的Elastic-Job-Lite是面向静态场景的,简单说就是每台作业服务器只能部署一个作业名称相同的作业实例,而当这个作业实例下线时,该作业服务器则显示为下线状态。这对于使用物理服务器的场景来说比较适合,而对于使用Docker的场景,则不太友好,原因是: 每次作业上线服务器IP可能产生变化,旧的服务器IP不会再使用,从而产生垃圾数据。Docker的治理系统可以在一台物理服务器上启动多实例,而仅支持单服务器单实例的Elastic-Job使用起来诸多不便,需要Docker的治理系统额外配置。Elastic-Job 2.1.0版本是如何做到Cloud Native的?新版本支持单服务器跑任意多的相同作业实例,原作业实例标识由IP地址替换为作业启动瞬时产生的UUID。在新的Cloud Native架构下,作业物理服务器概念大幅弱化。为了向前兼容,作业物理服务器仅包含控制服务器是否可以禁用这一功能。为了更加纯粹的实现作业核心,作业物理服务器统计和操作功能未来可能删除,可下放至容器治理部署系统。 使用新增加的运行实例概念全面替换原服务器概念,Elastic-Job-Lite与容器治理系统的对接由原来的服务器维度转变为运行实例维度,每个运行实例都是动态的,会随着作业下线而消失。 习惯根据服务器静态分配作业的使用者也不用太过担心新版本带来的变化,服务器信息以另外一个维度可选的存在于作业管理信息中,使用者仍然可以继续使用服务器静态部署的方式。 通过这次修改,Elastic-Job-Lite已经可以非常容易的对接Mesos + Marathon以及Kubernetes,相信使用者可以非常轻松的搭建一个深度定制版的作业私有云。 Elastic-Job 2.1.0版本还有哪些关键更新?Elastic-Job 2.1.0版本是仅针对Elastic-Job-Lite进行全面提升。它主要包含以下4方面的提升: 单服务器可运行任意多的相同作业实例。Cloud Native,这里不再细说。自修复能力使稳定性进一步提升。之前的Elastic-Job经过一年多的洗礼,稳定性已然不错,但是分布式场景由于环境复杂,很难完全通过正向的方式保证每个节点间的状态完全同步。而Elastic-Job原来的版本在网络不稳定的情况下,可能发生主节点选举卡死,或某个分片不运行的情况,可以通过重启应用修复。新版本的Elastic-Job-Lite使用异步线程,定期(可配置时间间隔)检测集群中不正确的状态,以反向检查的方式查找并自动修复分布式的不一致,为分布式稳定性的完善增加了最后一块拼图。作业操作梳理。新版本将操作分为作业、实例、分片以及服务器4个维度,去除了容易混淆的暂停操作,对禁用功能进一步的增强,可以从各个维度控制整体作业或独立分片。控制台界面提升。完全重写了控制台界面并且增加了事件追踪界面展示。新界面提供更加清新的用户体验,甚至包括主题皮肤切换,欢迎大家亲自体会。Elastic-Job 2.1.0版本与旧版本兼容么?新里程碑版本做了如此大的修改和提升,那么从旧版本升级至新版本有哪些地方需要修改?相信很多老用户有这样的疑问。答案是:不需要做任何改动。 Elastic-Job 2.1.0虽然对数据的存储结构进行了调整,但完全兼容原有数据结构,并且API和配置并未改变,使用者可以平滑升级。 Elastic-Job 下一步要做什么?当前的Elastic-Job已支持事件驱动,但并不完善。因此Elastic-Job下个功能将针对事件驱动进行提升,将其分布式“定时任务”中间件的定位彻底改变为分布式“任务”中间件。 另外还有很多功能需要继续完善,如作业依赖的支持等。 对于新手来说使用Elastic-Job 很难么?Elastic-Job-Cloud对于新手来说使用起来并不太容易,需要对Mesos技术栈有一定了解。 Elastic-Job-Lite则非常简单,只需在pom.xml中引入Elastic-Job的maven坐标,并且参照在github上的example编写几行代码即可,唯一的外部依赖是Zookeeper。 最后,请允许我再重复一次,项目的开源地址:https://github.com/dangdangdotcom/elastic-job 欢迎使用、吐槽和提出建议。 本文转自d1net(转载)

优秀的个人博客,低调大师

LiteFlow v2.11.1发布!一个高速迭代,社区活跃的新一代规则引擎

LiteFlow介绍 LiteFlow是一个开源编排式规则引擎,能够让你的系统逻辑任意编排,可选用脚本书写逻辑,支持多达6种脚本语言,支持丰富的第三方存储的支持,所有的逻辑和规则均可热变更。设计系统和重构系统的神器。 LiteFlow是Gitee的高star项目,过去一年来保持了非常快的增长趋势。 同时LiteFlow也是国内优秀的社区驱动型开源项目,开源将近3年,目前已经被各大公司应用在核心系统上。特性以及支持度都非常好。社区人数超过3500人。测试用例1500个,质量有保障。 如果你是第一次知道这个项目,可以去官网或相关的主页进行了解: 项目官网: https://liteflow.cc gitee托管仓库: https://gitee.com/dromara/liteFlow github托管仓库: https://github.com/dromara/liteflow 前言 上一个版本是9月1日发布的,经过了一个半月,LiteFlow新的v2.11.1和大家见面了。 这个版本总共带来了7个大特性,3个增强,2个修复。总计12个issue的更新。 其实这已经比上一个大版本已经有过之而无不及了。 这一切归功于LiteFlow的团队小伙伴们,他们贡献了这个版本中的诸多的特性,感谢他们。尤其这个版本又有2位新成员加入团队,目前团队成员一共有11位,接下来的迭代将会变的更加迅速。 我们在确保新特性推出的同时,项目质量也同样出色。LiteFlow截止到新版本,一共有1515个测试用例,每一个特性的提交,我们每一个成员都会全部通过测试用例,这也是我们每一次发版的底气,测试用例我们是认真的。并且我们的测试用例代码行覆盖率达到了非常高的90%覆盖率。 其实不吹不黑,在拥有1500个测试用例以上的开源项目中,90%的行覆盖率算得上是一个优秀的程度了。 SQL插件支持轮询自动更新模式 LiteFlow支持把规则和脚本存入任意的关系型数据库,由于关系型数据库不像注册中心会进行推送变更,所以一直以来,规则和脚本在数据库中发生改变,是需要开发者自己手动的去刷新的。并且需要每个应用实例都进行刷新。这对开发者来说,是繁琐了点。 所以我们在v2.11.1中推出了数据库自动轮询更新模式。这一切只需要在你原来的配置中加入: liteflow: rule-source-ext-data-map: ... #是否开启SQL数据轮询自动刷新机制 默认不开启 pollingEnabled: true ... 默认LiteFlow会每1分钟去进行SHA值的对比,由此来判断是否需要更新。 具体使用方式请参考规则文件->SQL数据库配置源。 WHEN增加must语法 之前WHEN推出过any语法,意思是任意一个完成即继续,而忽略其他。但是在社区里有小伙伴碰到真实的场景,需要异步并行中对指定的节点先完成就忽略其他。 为此这次新版本中推出了全新的must语法,提供在并行编排中更多的多样性。 <chain name="chain1"> THEN( a, WHEN(b, c, d).must(b, c), f ); </chain> 也可以指定一个或多个表达式: <chain name="chain1"> THEN( a, WHEN(b, THEN(c, d).id("t1"), e).must(b, "t1"), f ); </chain> 具体使用方式请参考EL规则的写法->并行编排->指定任意节点先执行完则忽略其他。 推出EL表达式的动态组装API 之前LiteFlow推出过动态构建chain的API,类似于这样: LiteFlowChainELBuilder.createChain().setChainName("chain1").setEL( "THEN(a, b, WHEN(c, d))" ).build(); 但是EL表达式还是需要你自己以字符串的方式填入,这并不能算真正意义上动态。 这次我们推出了全新的EL表达式的动态组装API,对于上面的EL,你可以如下进行动态构建: ThenELWrapper el = ELBus.then( "a","b",ELBus.when("c", "d") ); LiteFlowChainELBuilder.createChain().setChainName("chain1").setEL(el.toEL()).build(); 值得一说的是,用java语言构建EL表达式,几乎和EL的写法完全一致。如果你已经熟悉了LiteFlow的规则语法,应该是零成本上手的。 目前API支持了所有的EL语法。具体使用方式请参考用代码构造规则->构造EL。 链路继承 LiteFlow每一个chain独立,之前的版本不存在继承关系。但在这个新版本中,我们推出了链路继承这个特性。 如同类的继承一样,链路可以继承,那么对于拥有复杂链路的业务系统,可以对链路进行抽象,得到一个非常优雅的表现方式。 我们定义的继承也非常容易看懂: <chain id="base"> THEN(a, b, {0}, {1}); </chain> <chain id="implA" extends="base"> {0}=IF(c, d, e); {1}=SWITCH(f).to(j,k); </chain> 还可以多级继承: <chain id="base"> THEN(a, b, {0}, {1}); </chain> <chain id="base2" extends="base"> {0}=THEN(a,b,{3}); {1}=SWITCH(f).to({4},k); </chain> <chain id="implB" extends="base2"> {3}=THEN(a,b); {4}=j; </chain> 如果你有此方面的场景,不妨尝试下继承特性。 具体使用方式请参考高级特性->链路继承。 组件降级 LiteFlow之前的替补组件全面升级成组件降级特性。 组件降级允许你定义各个类型组件的降级组件。新版本提供了@FallbackCmp注解用于定义。 在EL规则中,如果你用node关键字包裹组件,便开启了降级特性: <chain id="chain1"> THEN(node("a"), b, c); </chain> 当a组件不存在时,便会走到用@FallbackCmp注解定义的降级组件中去。 具体用法请参考高级特定->组件降级。 支持绝对路径的模糊匹配 LiteFlow对项目内的规则文件的模糊匹配是早就支持的。但是之前的版本一直不支持绝对路径的模糊匹配。 这个版本,我们予以了支持。 你可以使用*或者**来模糊匹配多层级的任意名字的文件: liteflow.rule-source=/data/lf/**/*Rule.xml 如果开启了文件监听功能,还能对模糊路径匹配到的每一个文件进行监听。当文件改变的时候,实现自动刷新功能。是不是很酷。 具体用法请参考规则文件->本地规则文件配置和高级功能->本地文件监听。 WHEN线程池隔离 LiteFlow在v2.11.1版本中新推出了一个配置,在执行WHEN中的并行组件时,每一个when的线程池隔离,在运行复杂的嵌套WHEN链路时,这个特性非常有用。可以有效提高运行速度并且避免死锁问题。 你只需要开启这个配置即可,默认是关闭的。 liteflow.when-thread-pool-isolate=true 具体用法请参考EL规则的写法->并行编排->开启WHEN线程池隔离。 完整的更新列表 特性 #I7Y0Y1 SQL插件支持轮询模式 https://gitee.com/dromara/liteFlow/issues/I7Y0Y1 特性 #I7XAIB WHEN增加must语法 https://gitee.com/dromara/liteFlow/issues/I7XAIB 特性 #I878WV EL表达式动态组装 https://gitee.com/dromara/liteFlow/issues/I878WV 特性 #I7SVZF 支持chain的继承关系特性 https://gitee.com/dromara/liteFlow/issues/I7SVZF 特性 #I7YYLF 组件降级特性 https://gitee.com/dromara/liteFlow/issues/I7YYLF 特性 #I7ZJRH 支持绝对路径的模糊匹配 https://gitee.com/dromara/liteFlow/issues/I7ZJRH 特性 #I883LB when线程池隔离支持 https://gitee.com/dromara/liteFlow/issues/I883LB 增强 #I821F1 检测链路的循环依赖问题 https://gitee.com/dromara/liteFlow/issues/I821F1 增强 #I7G6BB 自定义异步线程池初始化存在并发问题 https://gitee.com/dromara/liteFlow/issues/I7G6BB 增强 #I855YM sql 插件重构 https://gitee.com/dromara/liteFlow/issues/I855YM 修复 #I82M4G 回滚组件无法获得tag的问题 https://gitee.com/dromara/liteFlow/issues/I82M4G 修复 #I7ZMVM 普通组件isContinueOnError和isEnd为true时,process直接抛异常会导致isEnd失效 https://gitee.com/dromara/liteFlow/issues/I7ZMVM 如何加群 LiteFlow的社区群已经有大约3000人以上了。你有任何问题,都可以在群里问。 关于加群的方式,请参考:https://liteflow.cc/pages/73c2c3/

优秀的个人博客,低调大师

LiteFlow v2.10.1发布!我们又发迭代版本了,国内超好用的编排规则引擎框架

LiteFlow介绍 LiteFlow是一个开源编排式规则引擎,能够让你的系统逻辑任意编排,可选用脚本书写逻辑,支持多达5种脚本语言,支持丰富的第三方存储的支持,所有的逻辑和规则均可热变更。设计系统和重构系统的神器。 LiteFlow是国内优秀的社区驱动型开源项目,开源2年多,目前已经被各大公司应用在核心系统上。特性以及支持度都非常好。 如果你是第一次知道这个项目,可以去官网或相关的主页进行了解: 项目官网: https://liteflow.yomahub.com gitee托管仓库: https://gitee.com/dromara/liteFlow github托管仓库: https://github.com/dromara/liteflow v2.10.1介绍 前段时间我们刚刚发布了LiteFlow的大版本2.10.0。在这个版本中增加了诸多特性和代码的优化。 我们现在又马不停蹄的推出了小版本升级:2.10.1。 其实2.10.0很稳定,最新的2.10.1版本主要为了增加一个新的脚本语言扩展Aviator和支持了循环表达式的嵌套循环增强。 支持Aviator脚本语言 首先介绍下Aviator。 Aviator是非常优秀的国产表达式引擎开源框架。文档详细,性能优秀,整个解析过程最多扫2次,保证了它的性能超越大部分解释型表达式引擎,整体非常轻量级,整个jar包大小哪怕发展到现在5.3这个版本,也才600k。 在社区中,我听到有人希望支持Aviator这个脚本语言。LiteFlow在脚本的支持度方面一直很全,既然Aviator很多人在用,那LiteFlow索性就一起支持了。 从2.10.1起,社区的小伙伴可以在LiteFlow里使用Aviator脚本了。具体如何依赖和注意事项,请看官方文档中的脚本这一章节。 循环表达式嵌套 LiteFlow之前的版本推出了循环表达式,循环表达式主要有FOR,WHILE以及迭代表达式ITERATOR,之前是不支持循环嵌套的。 新版本支持了循环表达式的嵌套增强。大家可以去试一试。 其余的更新 2.10.1版本中我们对所有的代码进行了统一插件格式化处理,修复了多脚本混用在SQL中不起效果的bug。优化了脚本这一块的核心代码。 完整更新列表 特性 #I6O380 支持aviator的脚本语言 https://gitee.com/dromara/liteFlow/issues/I6O380 增强 #I6P8F8 支持循环表达式的嵌套循环 https://gitee.com/dromara/liteFlow/issues/I6P8F8 增强 #I6O2YE 外置存储支持多脚本混合调用 https://gitee.com/dromara/liteFlow/issues/I6O2YE 增强 #I6OBZY 增加代码格式化插件,统一代码风格 https://gitee.com/dromara/liteFlow/issues/I6OBZY 支持和赞助LiteFlow 开源一个项目并坚持2年并不容易,所以我也需要一点赞助来给自己充能,如果各位对LiteFlow这个项目有信心并且愿意支持我的的话,可以在官网首先点击给LiteFlow发电按钮。 但不管你是否选择赞助,我仍然会在社区里尽可能的解决你们的问题。 如何加群 LiteFlow的社区群已经有大约2500人以上了。你有任何问题,都可以在群里问。 关于加群的方式,请参考:https://liteflow.yomahub.com/pages/73c2c3/

优秀的个人博客,低调大师

WPL/s v1.3.0发布 - 支持链接卡片 - 让你在 VS Code 中编写发布知乎专栏文章

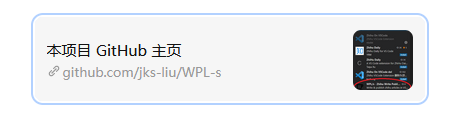
WPL/s 是一个 VS Code 插件,允许你在 VS Code 中用 Markdown 写知乎文章。最新版支持知乎链接卡片。 链接卡片格式如下 [![zhihu-link-card:本项目 GitHub 主页](./pics/vs-code-extension-search-zhihu.png)](https://github.com/jks-liu/WPL-s) 语法上和一个图片链接一样,但图片的文字需要以zhihu-link-card:开头。知乎链接卡片的外观如下:

优秀的个人博客,低调大师

阿里云PyODPS 0.7.18发布,针对聚合函数进行优化同时新增对Python 3.7支持

近日,阿里云发布PyODPS 0.7.18,主要是针对聚合函数进行优化同时新增对Python 3.7支持。 PyODPS是MaxCompute的Python版本的SDK,SDK的意思非常广泛,辅助开发某一类软件的相关文档、范例和工具的集合都可以叫做“SDK”。 PyODPS在这里的作用是提供了对MaxCompute对象的基本操作和DataFrame框架,可以轻松地在MaxCompute上进行数据分析。 PyODPS对于MaxCompute来说有多重要?首先MaxCompute是一种快速、完全托管的GB/TB/PB级数据仓库解决方案。MaxCompute可以为用户提供完善的数据导入方案以及多种经典的分布式计算模型,更快速的解决海量数据计算问题,有效降低企业成本,并保障数据安全。 在MaxCompute上,大家有很多种分析和机器学习的方式。

优秀的个人博客,低调大师

开源CMS Drupal 8发布更新修复多处高危漏洞补丁,提示您升级

据外媒报道, Drupal 研究人员于 8 月 16 日发布安全报告,宣称已修复 Drupal 8 多处漏洞并在线更新安全补丁。研究显示这些漏洞影响 Drupal 8 多个系统组件,包括实体访问系统、REST API 与部分视图组件。 CVE-2017-6925 研究人员发现 Drupal 8.3.7 中存在一处高危漏洞(CVE-2017-6925),影响实体访问系统,允许攻击者查看、创建、删除或更新实体。不过,该漏洞仅影响不具备 UUID 实体,以及对同一实体不同版本有多种访问限制的实体系统。 CVE-2017-6924 在 Drupal 8 中存在另一绕过访问权限的关键漏洞(CVE-2017-6924),即当无访问权限的任何用户驻留在 REST API 时,允许通过 REST 发布评论。目前,此漏洞已被评估为高危漏洞,因为它影响具有

优秀的个人博客,低调大师

阿里云AI产品全景图首次公开 机器学习平台PAI2.0发布 | 阿里云栖大会

吴恩达离职百度,腾讯任命张潼为AI Lab第一负责人,国内外关于人工智能的争夺正愈演愈烈,“AI”也不出所料成为了今年阿里云2017云栖大会的关键词。 3月29日,阿里云2017 云栖大会•深圳峰会主论坛召开,会上发布了ET医疗大脑和ET工业大脑,同期发布的还有用可视化的拖拽方式让开发者使用人工智能技术的机器学习平台PAI2.0,阿里云AI产品全景图首次公开。此外,阿里云在众智比赛上也有发力,与英特尔合作启动天池医疗AI大赛,挑战早期肺癌诊断。 阿里云首次公开发布了AI产品全景图 阿里云首次公开发布了AI产品全景图,从ET大脑、行业解决方案、ET应用场景、ET基础服务、分布式机器学习平台PAI2.0、飞天操作系统6个层次梳理了阿里云在AI的布局。 (大数据文摘后台回复“阿里云”获得高清版【阿里云AI产品全景图】) 阿里云正式发布机器学习平台

优秀的个人博客,低调大师

dify 1.16.0发布:原生Agent沙箱、MCP协议升级、GPT-5.6兼容适配,一文看懂全部更新

2026年7月19日,Dify 正式发布 v1.16.0 版本。这个版本不仅是常规迭代,更带来了一项颠覆性的能力——内置的 Dify Agent(Beta),并首次为 Agent 提供了完整的 Linux 沙箱运行环境。与此同时,Dify 在 AI 工作流生成、MCP 协议支持、性能优化、安全加固以及 OpenAI 新模型的兼容性方面都做了大量工作。本文将为你逐项拆解这 28 个新环境变量、9 项数据库迁移、超过 200 个变更背后的技术细节,帮助你平稳升级并充分利用新特性。

优秀的个人博客,低调大师

Python ORM Bee V1.9.0发布,支持多表关联查询,代码量少,AI 写也容易检查

用 AI 写代码,但太多代码,检查不过来;那就用 ORM Bee, 代码简单明了,不用写多余代码,轻松 Review! Pythone ORM Bee 让你使用 Python 开发数据库应用更简单!让你的 AI 开发真正的智能! Flask + Bee 开发 python web 系统更加快. 几行代码,就能让你完成数据库的查改增删: suid = Suid() #查询所有记录 orderList = suid.select(Orders()) # select all #插入一条记录 suid.insert(orders) #更新,删除记录 n1 = suid.update(orders) n2 = suid.delete(orders) 还支持 active record 风格编程: use BaseMode for active record type. e.g. class Orders(BaseMode): #__tablename__ = "orders" id:int = None name:str = None remark:str = None def __repr__(self): return str(self.__dict__) if __name__ == '__main__': orders = Orders() orderList=orders.select() 主要功能 V1.9.0 1.9.0(2026.07) 多表查询 (一对一关联) 更新cache以支持多表查询 主表对象和子表对象的值可转到where 多表查询支持Condition参数 多表查询支持分页 多表查询支持(一对多) 多表查询支持(多对一) 多表查询支持分页参数,指定查询字段参数 创建表支持在实体里有多表关联注解joins 往期回顾: V1.0 发布 V1.1 发布 V1.3 V1.5.4 V1.6.0 V1.6.2 快速开始: 安装依赖包 在命令行输入以下命令: pip install ormbee ORM Beepypi url: https://pypi.org/project/ormbee/ 1. 配置 db 连接信息 1. 配置db连接信息 1.1.can custom your db Module in bee.json or bee.properties set dbModuleName { "dbname": "SQLite", "database": "bee.db", //default support: pymysql,sqlite3,cx_Oracle,psycopg2 (no need set) "dbModuleName":"sqlite3" } #value is: MySql,SQLite,Oracle, #MySQL config #bee.db.dbname=MySQL #bee.db.host =localhost #bee.db.user =root #bee.db.password = #bee.db.database =bee #bee.db.port=3306 # SQLite bee.db.dbname=SQLite bee.db.database =bee.db 1.2.if do not want to use the default config file(bee.json or bee.properties), can set the db_config info yourself. # #mysql dict_config = { 'dbname':'MySQL', 'host': 'localhost', # 数据库主机 'user': 'root', # 替换为您的 MySQL 用户名 'password': '', # 替换为您的 MySQL 密码 'database': 'bee', # 替换为您的数据库名称 'port':3306 } honeyConfig= HoneyConfig() honeyConfig.set_db_config_dict(dict_config) 2. 使用 Bee 操作数据库 2. 使用Bee操作数据库 class Orders: id = None name = None remark = None # can ignore def __repr__(self): return str(self.__dict__) # also can use field type as :int class Orders8: __tablename__ = "orders" id:int = None name:str = None remark:str = None def __repr__(self): return str(self.__dict__) class Student2: id = None name = None age = None remark = None addr = None def __repr__(self): return str(self.__dict__) from bee.api import Suid, SuidRich from bee.config import PreConfig from bee.honeyfactory import BF from bee.osql.bee_enum import Op if __name__ == "__main__": # set bee.properties/bee.json config folder PreConfig.config_path="E:\\Bee-Project\\resources" # select record suid = Suid() orderList = suid.select(Orders()) # select all # insert orders = Orders() orders.id = 1 orders.name = "bee" orders.remark = "test" suid = Suid() suid.insert(orders) # update/delete orders = Orders() orders.name = "bee130" # For safety reasons # Fields that are not present in the entity will be ignored. orders.ext = "aaa" orders.id = 1 suid = Suid() n1 = suid.update(orders) n2 = suid.delete(orders) print(n1) print(n2) # batch insert student0 = Student2() student0.name = "bee" student1 = Student2() student1.name = "bee1" student1.addr = "" student1.age = 40 entity_list = [] entity_list.append(student0) entity_list.append(student1) suidRich = SuidRich() insertNum = suidRich.insert_batch(entity_list) print(insertNum) #how to use Condition for advanced query and update condition = BF.condition() condition.op("age", Op.ge, 22) condition.op("remark", Op.eq, None) stuList = suidRich.select(Student2(), condition) # select ... from student2 where age >= ? and remark is null for stu in stuList: print(stu) # all stu'age add 1 if id>5 condition = BF.condition() condition.setAdd("age", 1) condition.op("id", Op.ge, 5) updateNum = suidRich.updateBy(Student2(), condition) # update student2 set age = age + ? where id >= ? print("updateNum:", updateNum) #SuidRich: insert_batch,select_first,updateBy #复杂的where过滤条件、group,having,order by,Update Set等可使用Condition; 3. 多表关联查询 from bee.bee_enum import JoinType from bee.honeyfactory import BF from bee.anno import JoinTable import MyConfig # one to many, layer is 4. # 一对多,4层表 class Village: """ table village 's entity """ id: int = None name: str = None level: int = None remark: str = None town_id: int = None def __repr__(self): return str(self.__dict__) class Town: """ table town 's entity """ id: int = None name: str = None level: int = None remark: str = None city_id: int = None village_list = None __joins__ = { "village_list": JoinTable( sub_class = Village, joinType = JoinType.JOIN, main_fields = ["id"], sub_fields = ["town_id"], is_list = True ) } def __repr__(self): return str(self.__dict__) class City: """ table city 's entity """ id: int = None name: str = None level: int = None remark: str = None province_id: int = None town_list = None __joins__ = { "town_list": JoinTable( sub_class = Town, joinType = JoinType.JOIN, main_fields = ["id"], sub_fields = ["city_id"], is_list = True ) } def __repr__(self): return str(self.__dict__) class Province: """ table province 's entity """ id: int = None name: str = None level: int = None remark: str = None city_list = None __joins__ = { "city_list": JoinTable( sub_class = City, joinType = JoinType.JOIN, main_fields = ["id"], sub_fields = ["province_id"], is_list = True ) } def __repr__(self): return str(self.__dict__) if __name__ == '__main__': MyConfig.init() province = Province() moreTable = BF.moreTable() mylist = moreTable.select(province) # #查前两条记录 # condition = BF.condition() # condtion.start(0) # condtion.size(2) # teaList = moreTable.select(province, condition) # print(len(mylist)) if mylist: for one in mylist: print(one) 4. 其它功能 主要API在bee.api.py Suid: simple API for Select/Update/Insert/Delete SuidRich : select_paging, insert_batch, updateBy, select_first,select_by_id, delete_by_id,select_fun,count,exist,create_table,index_normal,unique MoreTable :Multi table join Select/Update/Insert/Delete PreparedSql: select, select_dict, modify, modify_dict 诚邀您的加入! 如果您还想添加什么功能,请到评论区告诉我们。 项目首页: https://gitee.com/automvc/BeePy/ https://github.com/automvc/BeePy/

优秀的个人博客,低调大师

腾讯混元世界模型1.5发布,首次开源业界最系统、最全面的实时世界模型框架

腾讯混元世界模型1.5(Tencent HY WorldPlay)已正式发布,公告写道: 它是易于创建的: 只需输入文字描述或者图片即可创建专属的互动世界。 它是沉浸式实时交互的: 通过键盘、鼠标或手柄,即可实时控制虚拟相机的移动和转向,让你可以像玩游戏一样自由探索AI生成的世界。 它也是直接可用的: 在腾讯混元3D官网可申请使用(https://3d.hunyuan.tencent.com/sceneTo3D?tab=worldplay)。 它还是开源的: 混元世界模型1.5(WorldPlay)首次开源了业界最系统、最全面的实时世界模型框架,涵盖数据、训练、流式推理部署等全链路、全环节,并提出了重构记忆力、长上下文蒸馏、基于3D的自回归扩散模型强化学习等算法模块。 混元世界模型1.5具备三大核心能力: 实时的交互生成:通过原创的Context Forcing蒸馏方案以及流式推理优化,模型可以按照24 FPS的速度生成720P的高清视频; 长范围的3D一致性:通过重构记忆机制(Reconstituted Memory),模型支持分钟级内容的几何一致性生成,可用于构建高质量的3D空间模拟器; 多样化的交互体验:混元世界模型可广泛适用于不同风格的游戏或者现实场景,以及第一和第三人称视角,也支持实时文本触发事件和视频续写等功能。 技术上,混元世界模型1.5首次开源了业界最系统、最全面的实时世界模型训练体系,涵盖数据、训练、推理部署等全链路、全环节。混元团队在技术报告中公开了模型预训练、持续训练、自回归视频模型强化学习、带记忆力的模型蒸馏的训练细节,并详述模型在控制(control space),记忆(reconstituted memory),蒸馏(context forcing),强化学习后训练几大模块上的思考与原创设计。 混元世界模型1.5的核心是一个叫做WorldPlay的自回归扩散模型,它采用Next-Frames-Prediction的视觉自回归任务进行训练,实现了长范围几何一致性的实时交互式世界建模,破解了业界满足实时性与几何一致性的难题。 该模型依托三大核心创新:双分支动作表征实现精准控制、上下文记忆重构机制保持几何一致性、上下文对齐蒸馏技术增强长视频生成的视觉质量和几何一致性。除此之外,该工作也构建了一套新颖的基于3D奖励的强化学习后训练框架来进一步增强生成视频的视觉质量和几何一致性。 数据方面,混元团队构建的自动化3D场景渲染流程,可以获得大量高质量的真实世界渲染数据,进一步激发核心算法的潜力。混元世界模型1.5可支持 24帧 / 秒的长时流式生成,一致性与泛化能力适用于多样化场景。 在线体验网站:https://3d.hunyuan.tencent.com/sceneTo3D?tab=worldplay Github链接:https://github.com/Tencent-Hunyuan/HY-WorldPlay Hugging Face链接:https://huggingface.co/tencent/HY-WorldPlay 项目主页:https://3d-models.hunyuan.tencent.com/world/

优秀的个人博客,低调大师

国产一站式数据库访问工具 CloudDM v2.1.1发布,支持 Redis 消息队列

CloudDM 是 ClouGence 公司推出的一款一站式多数据源开发管理工具,使用它可以方便地访问和管理 MySQL、Oracle、PostgreSQL、阿里云RDS、Greenplum、TiDB、Redis、StarRocks、Doris、SelectDB、SQL SERVER、ClickHouse、OceanBase 、PolarDB-X 、IBM Db2 等多种不同类型的数据库。通过 CloudDM 丰富的数据源支持可以避免在多个专业工具之间切换,从而提高工作效率 它是本地化的应用程序,没有后台进程。和DataGrip、Navicat一样在安装完成后,只需要双击应用程序图标,便可以方便的管理位于本地计算机或远程计算机上的数据库。已经支持Windows和MacOS两个操作系统。 更新内容 本次版本发布增加了对 Redis 命令组的支持和其它错误修复,更新内容如下: [新增] 完整支持 Redis 消息队列 PubSub 命令组 [修复] Oracle 快捷查询语句生成问题 [修复] 升级版本后出现的启动错误问题 [修复] 导出 Insert 语句错误问题 [优化] IP 和 Port 输入框的 UI 显示 本次亮点 本次更新的最大亮点则是带来了 Redis PubSub 命令组,如果您正在使用 Redis 提供的消息订阅机制,那么使用 CloudDM 可以帮助你更加方便的调试您的应用程序。 使用 CloudDM 模拟上游应用程序发布消息,通过 Redis-Cli 命令行工具模拟消息订阅消费 通过 Redis-Cli 命令行工具模拟上游应用程序发布消息,使用 CloudDM 监听上游发来的消息 (CloudDM 目前每次只能监听 6 秒内的消息,超过6秒后需要重新监听) 下载与反馈 产品官网:https://www.clougence.com/clouddm-personal 问题反馈:https://gitee.com/clougence/clouddm-issue/issue 微信交流群:访问产品首页,扫描入群二维码即可加入

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册