首页 文章 精选 留言 我的

精选列表

搜索[双足行走],共9142篇文章
优秀的个人博客,低调大师

一款双11养猫5亿用户的互动引擎

阿里巴巴历时2年自研开发的互动游戏引擎Eva.js正式开源,致力于让前端工程师更低成本的开发互动游戏,并已经在淘宝、天猫、支付宝、优酷、考拉、菜鸟、盒马等业务场景中使用。 官网:https://eva.js.org Github:https://github.com/eva-engine/eva.js 为什么要做Eva.js ▐背景 一个高速发展的APP,一定会去做拉新,留存,促活,转化。而游戏中的使命感、社交欲、拥有感、成就感等等正是令人上瘾的元素,将业务与游戏相结合,进行“游戏化”,可以实现产品的运营目的。所以,市场上出现了很多游戏化产品。比如淘宝、支付宝、京东、饿了么、拼多多、招商银行等等 APP 都有类似的游戏化互动项目。 ▐游戏引擎 团队在历年互动游戏探索中,使用过 Cocos/Egret/Laya 等游戏引擎开发互动游戏,他们有很多的优势,比如说他们都是大而全的引擎,能实现非常多的游戏能力,一体化比较好,从编辑器到发布一套流程搞定,跨平台能力不错,能够发布 Android/iOS/Web。 但随着我们对互动游戏的理解,发现前端互动类游戏大多数只是一些简单的交互和动画;对于前端来说,我们需要更低的学习成本去实现互动游戏,并且有很多非常优秀的东西不能被摒弃,例如使用 HTML/CSS 来实现UI更加方便,在 Canvas 里面实现动画性能更好。 ▐渲染引擎 后来我们就开始基于 PixiJS 探索,PixiJS 提供了非常强大的渲染能力、更小的体积、更好的性能。团队近几年来基于 PixiJS 做了非常多有利于前端开发互动游戏的工作。我们的Eva.js的底层也使用了 PixiJS 作为渲染引擎。 关于Eva.js ▐愿景和目标 Eva.js的愿景是让前端工程师更低成本的开发互动游戏,我们希望做到 高效开发:Eva.js 提供最基础的互动游戏组件,让前端工程师几行代码就能做出效果。 性能:提供高效的运行时以及渲染能力。 可扩展性:使用 ECS 架构,最小化ECS内核+渲染(目前 gzip 130K),通过插件机制可以扩展插件。 ▐我们做了什么 Evajs 实现了互动游戏常用的动画和渲染能力,也有游戏中常用的物理和音效插件。我们针对加载和运行时做了一些性能优化,后续会着重讲解。在用户体验方面实现了无障碍化。 Eva.js 现在还在成长阶段,未来将会有更多的功能加入进来。 我们使用了 ECS 的设计模式,在 Eva.js 里面呈现是 GameObject/Component/System。 GameObject:游戏中的物体,他只是无意义的空壳,只能用来存放 Component Component:描述物体的能力,存放数据。 System:实现能力 在简单的互动游戏开发过程中,我们只需要使用 GameObject 和 Component 即可。 const spriteAnimation = new GameObject('name') spriteAnimation.addComponent(new SpriteAnimation({ resource: 'resourceName' })) game.scene.addChild(spriteAnimation) 我们通过这个方法,就可以简单的在互动游戏里面显示出来一个帧动画。 技术解析 ▐加载方案 一般游戏都是在资源加载以后来创建游戏对象,游戏对象发现有需要某个资源以后再去解析资源,像骨骼动画这种资源解析时间比较长,在低性能手机上显示比较慢。在浏览器中,资源在加载的过程中不影响 CPU 的运行,所以我们做了一系列的优化。 游戏资源解析和资源加载并行(非同一资源) 创建对象和资源加载并行 渲染和资源加载并行 上图是某一资源加载使用的流程图,通过这种方式,在某一资源解析和渲染的时候,也不会影响其他资源加载。这个方法也会前置资源的解析,这样,在预加载的时候会解析资源,后续使用资源的时候无需解析,直接渲染。 例如在龙骨动画系统安装的时候,会注册龙骨的实例化方法,当资源加载成功后就自动解析资源。 resource.registerInstance(RESOURCE_TYPE.DRAGONBONE, ({data}) => { factory.parseDragonBonesData(data.ske); factory.parseTextureAtlasData(data.tex, Texture.from(data.image)); }); 在 Chrome 的 DevTool,的 performance 面板中,将 CPU 的性能调至 6 x slowdown,10个不同骨骼动画分别渲染10次,完整渲染时间,测试的数据: PixiJS:1200ms Eva.js:950ms ▐属性变化收集 ECS 架构中有个重要的优势,会把组件的属性按照顺序存放在 CPU 缓存当中,CPU 缓存中的数据传输速度是非常的快,C/C++ 等编程语言可以直接操作 CPU 缓存,所以,System 遍历检测 Component 属性变化是非常快的,但是在 JavaScript 中,我们没有办法直接操作 CPU 缓存。 其实很多属性不是每一帧都会改变的,例如图片组件的资源属性,所以针对哪些不经常变动的组件,我们通过监听的方式将会更加节省性能。 在 Eva.js 中,我们实现了组件监听器,系统将自己关注的组件以及属性添加至组件监听器,在游戏过程中,组件添加/删除/属性修改将会缓存,系统在每帧可以读取缓存的内容,进行相应的操作。 ▐无障碍化 在 Web 开发中,我们通过使用语意化的标签、HTML 结构,以及 WAI-ARIA 属性来实现无障碍化。但是在互动游戏开发中,我们使用 <canvas> 标签作为游戏的渲染画布,但 <canvas> 标签只是一个位图,它并不提供任何已经绘制在上面的对象的信息。所以 canvas 的内容不能像语义化的 HTML 一样暴露给屏幕阅读器。所以我们在Canvas上面增加了一层 A11yLayer,在A11yLayer上实现无障碍对象模型 AOM,目前 AOM 还在草案当中,我们临时使用 DOM 实现。A11y 系统就是使用了Eva.js提供的属性监听能力实现的。在真正的业务开发中,对于复杂的交互和动画,我们会为无障碍人群重新设计交互玩法,通过无障碍化的支持,可以让更多的用户也可以参与到我们的互动游戏中来。 ▐状态管理 在 react/vue 中,我们经常使用 redux/vuex 来进行状态管理,维护一套统一的数据,在 Eva.js 体系下,我们设计了一套状态管理系统,叫做 EvaX,通过 EvaX 我们可以维护一份共有数据,多个不同的对象上的组件可能会使用同一份数据进行逻辑运行。 比如游戏中的生命值,不仅在人的头顶上会显示,游戏中的人物也会根据生命值的多少来展示不同的形态,我们将 EvaX 组件绑定到游戏对象上,可对某个数据进行监听,如果数据发生变化,可以操作当前游戏对象上其他组件上的数据或者事件,有利于游戏对象或组件的解耦。 总结 据不完全统计,目前 Eva.js 覆盖了9个以上的 APP,30多个项目,甚至在天猫精灵上也会有 Eva.js 的身影,阿里巴巴内部的 NPM 包下载次数3w多次,覆盖用户数超5亿。 未来,Eva.js 会从性能,开发者体验,互动能力三个方向,让前端开发者更低成本的开发互动游戏。希望广大社区贡献者可以一起来维护 Eva.js 开源社区,希望未来 Eva.js 能够引领互动技术的发展,更多的技术是由 Eva.js 互动开发者们实现和定义出来的! 官网:https://eva.js.org Github: https://github.com/eva-engine/eva.js 作者 | 明非 编辑 | 橙子君 出品 | 阿里巴巴新零售淘系技术

优秀的个人博客,低调大师

Fluid 给数据弹性一双隐形的翅膀 -- 自定义弹性伸缩

作者 | 车漾 Fluid 社区 Commiter 谢远东 Fluid 社区 Commiter 来源 | 阿里巴巴云原生公众号 **导读:**弹性伸缩作为 Kubernetes 的核心能力之一,但它一直是围绕这无状态的应用负载展开。而 Fluid 提供了分布式缓存的弹性伸缩能力,可以灵活扩充和收缩数据缓存。它基于 Runtime 提供了缓存空间、现有缓存比例等性能指标, 结合自身对于 Runtime 资源的扩缩容能力,提供数据缓存按需伸缩能力。 背景 随着越来越多的大数据和 AI 等数据密集应用开始部署和运行在 Kubernetes 环境下,数据密集型应用计算框架的设计理念和云原生灵活的应用编排的分歧,导致了数据访问和计算瓶颈。云原生数据编排引擎 Fluid 通过数据集的抽象,利用分布式缓存技术,结合调度器,为应用提供了数据访问加速的能力。 弹性伸缩作为 Kubernetes 的核心能力之一,但它一直是围绕这无状态的应用负载展开。而 Fluid 提供了分布式缓存的弹性伸缩能力,可以灵活扩充和收缩数据缓存。它基于 Runtime 提供了缓存空间、现有缓存比例等性能指标, 结合自身对于 Runtime 资源的扩缩容能力,提供数据缓存按需伸缩能力。 这个能力对于互联网场景下大数据应用非常重要,由于多数的大数据应用都是通过端到端流水线来实现的。而这个流水线包含以下几个步骤: 数据提取:利用 Spark,MapReduce 等大数据技术对于原始数据进行预处理。 模型训练:利用第一阶段生成特征数据进行机器学习模型训练,并且生成相应的模型。 模型评估:通过测试集或者验证集对于第二阶段生成模型进行评估和测试。 模型推理:第三阶段验证后的模型最终推送到线上为业务提供推理服务。 可以看到端到端的流水线会包含多种不同类型的计算任务,针对每一个计算任务,实践中会有合适的专业系统来处理(TensorFlow,PyTorch,Spark, Presto);但是这些系统彼此独立,通常要借助外部文件系统来实现把数据从一个阶段传递到下一个阶段。但是频繁的使用文件系统实现数据交换,会带来大量的 I/O 开销,经常会成为整个工作流的瓶颈。 而 Fluid 对于这个场景非常适合,用户可以创建一个 Dataset 对象,这个对象有能力将数据分散缓存到 Kubernetes 计算节点中,作为数据交换的介质,这样避免了数据的远程写入和读取,提升了数据使用的效率。但是这里的问题是临时数据缓存的资源预估和预留。由于在数据生产消费之前,精确的数据量预估是比较难满足,过高的预估会导致资源预留浪费,过低的预估会导致数据写入失败可能性增高。还是按需扩缩容对于使用者更加友好。我们希望能够达成类似 page cache 的使用效果,对于最终用户来说这一层是透明的但是它带来的缓存加速效果是实实在在的。 我们通过自定义 HPA 机制,通过 Fluid 引入了缓存弹性伸缩能力。弹性伸缩的条件是当已有缓存数据量达到一定比例时,就会触发弹性扩容,扩容缓存空间。例如将触发条件设置为缓存空间占比超过 75%,此时总的缓存空间为 10G,当数据已经占满到 8G 缓存空间的时候,就会触发扩容机制。 下面我们通过一个例子帮助您体验 Fluid 的自动扩缩容能力。 前提条件 推荐使用 Kubernetes 1.18 以上,因为在 1.18 之前,HPA 是无法自定义扩缩容策略的,都是通过硬编码实现的。而在 1.18 后,用户可以自定义扩缩容策略的,比如可以定义一次扩容后的冷却时间。 具体步骤 1. 安装 jq 工具方便解析 json。 在本例子中我们使用操作系统是 centos,可以通过 yum 安装 jq。 yum install -y jq 2. 下载、安装Fluid 最新版。 git clone https://github.com/fluid-cloudnative/fluid.git cd fluid/charts kubectl create ns fluid-system helm install fluid fluid 3. 部署或配置 Prometheus。 这里通过 Prometheus 对于 AlluxioRuntime 的缓存引擎暴露的 Metrics 进行收集,如果集群内无 prometheus: $ cd fluid $ kubectl apply -f integration/prometheus/prometheus.yaml 如集群内有 prometheus,可将以下配置写到 prometheus 配置文件中: scrape_configs: - job_name: 'alluxio runtime' metrics_path: /metrics/prometheus kubernetes_sd_configs: - role: endpoints relabel_configs: - source_labels: [__meta_kubernetes_service_label_monitor] regex: alluxio_runtime_metrics action: keep - source_labels: [__meta_kubernetes_endpoint_port_name] regex: web action: keep - source_labels: [__meta_kubernetes_namespace] target_label: namespace replacement: $1 action: replace - source_labels: [__meta_kubernetes_service_label_release] target_label: fluid_runtime replacement: $1 action: replace - source_labels: [__meta_kubernetes_endpoint_address_target_name] target_label: pod replacement: $1 action: replace 4. 验证 Prometheus 安装成功。 $ kubectl get ep -n kube-system prometheus-svc NAME ENDPOINTS AGE prometheus-svc 10.76.0.2:9090 6m49s $ kubectl get svc -n kube-system prometheus-svc NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE prometheus-svc NodePort 172.16.135.24 <none> 9090:32114/TCP 2m7s 如果希望可视化监控指标,您可以安装 Grafana 验证监控数据,具体操作可以参考文档。 5. 部署 metrics server。 检查该集群是否包括 metrics-server,执行kubectl top node有正确输出可以显示内存和 CPU,则该集群 metrics server 配置正确。 kubectl top node NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% 192.168.1.204 93m 2% 1455Mi 10% 192.168.1.205 125m 3% 1925Mi 13% 192.168.1.206 96m 2% 1689Mi 11% 否则手动执行以下命令: kubectl create -f integration/metrics-server 6. 部署 custom-metrics-api 组件。 为了基于自定义指标进行扩展,你需要拥有两个组件: 第一个组件是从应用程序收集指标并将其存储到 Prometheus 时间序列数据库。 第二个组件使用收集的度量指标来扩展 Kubernetes 自定义 metrics API,即 k8s-prometheus-adapter。 第一个组件在第三步部署完成,下面部署第二个组件。 如果已经配置了custom-metrics-api,在 adapter 的 configmap 配置中增加与 dataset 相关的配置: apiVersion: v1 kind: ConfigMap metadata: name: adapter-config namespace: monitoring data: config.yaml: | rules: - seriesQuery: '{__name__=~"Cluster_(CapacityTotal|CapacityUsed)",fluid_runtime!="",instance!="",job="alluxio runtime",namespace!="",pod!=""}' seriesFilters: - is: ^Cluster_(CapacityTotal|CapacityUsed)$ resources: overrides: namespace: resource: namespace pod: resource: pods fluid_runtime: resource: datasets name: matches: "^(.*)" as: "capacity_used_rate" metricsQuery: ceil(Cluster_CapacityUsed{<<.LabelMatchers>>}*100/(Cluster_CapacityTotal{<<.LabelMatchers>>})) 否则手动执行以下命令: kubectl create -f integration/custom-metrics-api/namespace.yaml kubectl create -f integration/custom-metrics-api 注意:因为 custom-metrics-api 对接集群中的 Prometheous 的访问地址,请替换 prometheous url 为你真正使用的 Prometheous 地址。 检查自定义指标: $ kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1" | jq { "kind": "APIResourceList", "apiVersion": "v1", "groupVersion": "custom.metrics.k8s.io/v1beta1", "resources": [ { "name": "pods/capacity_used_rate", "singularName": "", "namespaced": true, "kind": "MetricValueList", "verbs": [ "get" ] }, { "name": "datasets.data.fluid.io/capacity_used_rate", "singularName": "", "namespaced": true, "kind": "MetricValueList", "verbs": [ "get" ] }, { "name": "namespaces/capacity_used_rate", "singularName": "", "namespaced": false, "kind": "MetricValueList", "verbs": [ "get" ] } ] } 7. 提交测试使用的 Dataset。 $ cat<<EOF >dataset.yaml apiVersion: data.fluid.io/v1alpha1 kind: Dataset metadata: name: spark spec: mounts: - mountPoint: https://mirrors.bit.edu.cn/apache/spark/ name: spark --- apiVersion: data.fluid.io/v1alpha1 kind: AlluxioRuntime metadata: name: spark spec: replicas: 1 tieredstore: levels: - mediumtype: MEM path: /dev/shm quota: 1Gi high: "0.99" low: "0.7" properties: alluxio.user.streaming.data.timeout: 300sec EOF $ kubectl create -f dataset.yaml dataset.data.fluid.io/spark created alluxioruntime.data.fluid.io/spark created 8. 查看这个 Dataset 是否处于可用状态。 可以看到该数据集的数据总量为 2.71GiB, 目前 Fluid 提供的缓存节点数为 1,可以提供的最大缓存能力为 1GiB。此时数据量是无法满足全量数据缓存的需求。 $ kubectl get dataset NAME UFS TOTAL SIZE CACHED CACHE CAPACITY CACHED PERCENTAGE PHASE AGE spark 2.71GiB 0.00B 1.00GiB 0.0% Bound 7m38s 9. 当该 Dataset 处于可用状态后,查看是否已经可以从 custom-metrics-api 获得监控指标。 kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/default/datasets.data.fluid.io/*/capacity_used_rate" | jq { "kind": "MetricValueList", "apiVersion": "custom.metrics.k8s.io/v1beta1", "metadata": { "selfLink": "/apis/custom.metrics.k8s.io/v1beta1/namespaces/default/datasets.data.fluid.io/%2A/capacity_used_rate" }, "items": [ { "describedObject": { "kind": "Dataset", "namespace": "default", "name": "spark", "apiVersion": "data.fluid.io/v1alpha1" }, "metricName": "capacity_used_rate", "timestamp": "2021-04-04T07:24:52Z", "value": "0" } ] } 10. 创建 HPA 任务。 $ cat<<EOF > hpa.yaml apiVersion: autoscaling/v2beta2 kind: HorizontalPodAutoscaler metadata: name: spark spec: scaleTargetRef: apiVersion: data.fluid.io/v1alpha1 kind: AlluxioRuntime name: spark minReplicas: 1 maxReplicas: 4 metrics: - type: Object object: metric: name: capacity_used_rate describedObject: apiVersion: data.fluid.io/v1alpha1 kind: Dataset name: spark target: type: Value value: "90" behavior: scaleUp: policies: - type: Pods value: 2 periodSeconds: 600 scaleDown: selectPolicy: Disabled EOF 首先,我们解读一下从样例配置,这里主要有两部分一个是扩缩容的规则,另一个是扩缩容的灵敏度: 规则:触发扩容行为的条件为 Dataset 对象的缓存数据量占总缓存能力的 90%;扩容对象为AlluxioRuntime,最小副本数为 1,最大副本数为 4;而 Dataset 和 AlluxioRuntime 的对象需要在同一个 namespace。 策略:可以 K8s 1.18 以上的版本,可以分别针对扩容和缩容场景设置稳定时间和一次扩缩容步长比例。比如在本例子, 一次扩容周期为 10 分钟(periodSeconds),扩容时新增 2 个副本数,当然这也不可以超过 maxReplicas 的限制;而完成一次扩容后,冷却时间(stabilizationWindowSeconds)为 20 分钟;而缩容策略可以选择直接关闭。 11. 查看 HPA 配置, 当前缓存空间的数据占比为 0。远远低于触发扩容的条件。 $ kubectl get hpa NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE spark AlluxioRuntime/spark 0/90 1 4 1 33s $ kubectl describe hpa Name: spark Namespace: default Labels: <none> Annotations: <none> CreationTimestamp: Wed, 07 Apr 2021 17:36:39 +0800 Reference: AlluxioRuntime/spark Metrics: ( current / target ) "capacity_used_rate" on Dataset/spark (target value): 0 / 90 Min replicas: 1 Max replicas: 4 Behavior: Scale Up: Stabilization Window: 0 seconds Select Policy: Max Policies: - Type: Pods Value: 2 Period: 600 seconds Scale Down: Select Policy: Disabled Policies: - Type: Percent Value: 100 Period: 15 seconds AlluxioRuntime pods: 1 current / 1 desired Conditions: Type Status Reason Message ---- ------ ------ ------- AbleToScale True ScaleDownStabilized recent recommendations were higher than current one, applying the highest recent recommendation ScalingActive True ValidMetricFound the HPA was able to successfully calculate a replica count from Dataset metric capacity_used_rate ScalingLimited False DesiredWithinRange the desired count is within the acceptable range Events: <none> 12. 创建数据预热任务。 $ cat<<EOF > dataload.yaml apiVersion: data.fluid.io/v1alpha1 kind: DataLoad metadata: name: spark spec: dataset: name: spark namespace: default EOF $ kubectl create -f dataload.yaml $ kubectl get dataload NAME DATASET PHASE AGE DURATION spark spark Executing 15s Unfinished 13. 此时可以发现缓存的数据量接近了 Fluid 可以提供的缓存能力(1GiB)同时触发了弹性伸缩的条件。 $ kubectl get dataset NAME UFS TOTAL SIZE CACHED CACHE CAPACITY CACHED PERCENTAGE PHASE AGE spark 2.71GiB 1020.92MiB 1.00GiB 36.8% Bound 5m15s 从 HPA 的监控,可以看到 Alluxio Runtime 的扩容已经开始, 可以发现扩容的步长为 2。 $ kubectl get hpa NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE spark AlluxioRuntime/spark 100/90 1 4 2 4m20s $ kubectl describe hpa Name: spark Namespace: default Labels: <none> Annotations: <none> CreationTimestamp: Wed, 07 Apr 2021 17:56:31 +0800 Reference: AlluxioRuntime/spark Metrics: ( current / target ) "capacity_used_rate" on Dataset/spark (target value): 100 / 90 Min replicas: 1 Max replicas: 4 Behavior: Scale Up: Stabilization Window: 0 seconds Select Policy: Max Policies: - Type: Pods Value: 2 Period: 600 seconds Scale Down: Select Policy: Disabled Policies: - Type: Percent Value: 100 Period: 15 seconds AlluxioRuntime pods: 2 current / 3 desired Conditions: Type Status Reason Message ---- ------ ------ ------- AbleToScale True SucceededRescale the HPA controller was able to update the target scale to 3 ScalingActive True ValidMetricFound the HPA was able to successfully calculate a replica count from Dataset metric capacity_used_rate ScalingLimited False DesiredWithinRange the desired count is within the acceptable range Events: Type Reason Age From Message ---- ------ ---- ---- ------- Normal SuccessfulRescale 21s horizontal-pod-autoscaler New size: 2; reason: Dataset metric capacity_used_rate above target Normal SuccessfulRescale 6s horizontal-pod-autoscaler New size: 3; reason: Dataset metric capacity_used_rate above target 14. 在等待一段时间之后发现数据集的缓存空间由 1GiB 提升到了 3GiB,数据缓存已经接近完成。 $ kubectl get dataset NAME UFS TOTAL SIZE CACHED CACHE CAPACITY CACHED PERCENTAGE PHASE AGE spark 2.71GiB 2.59GiB 3.00GiB 95.6% Bound 12m 同时观察 HPA 的状态,可以发现此时 Dataset 对应的 runtime 的 replicas 数量为 3, 已经使用的缓存空间比例 capacity_used_rate 为 85%,已经不会触发缓存扩容。 $ kubectl get hpa NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE spark AlluxioRuntime/spark 85/90 1 4 3 11m 15. 清理环境。 kubectl delete hpa spark kubectl delete dataset spark 总结 Fluid 提供了结合 Prometheous,Kubernetes HPA 和 Custom Metrics 能力,根据占用缓存空间的比例触发自动弹性伸缩的能力,实现缓存能力的按需使用。这样能够帮助用户更加灵活的使用通过分布式缓存提升数据访问加速能力,后续我们会提供定时扩缩的能力,为扩缩容提供更强的确定性。 Fluid 的代码仓库:https://github.com/fluid-cloudnative/fluid.git, 欢迎大家关注、贡献代码和 star。

优秀的个人博客,低调大师

故障分析 | 记一次 MySQL 主从双写导致的数据丢失问题

作者:戴骏贤 网易游戏 技术部资深数据库系统工程师。 本文来源:原创投稿 *爱可生开源社区出品,原创内容未经授权不得随意使用,转载请联系小编并注明来源。 一、问题起源 不久前用户反馈部门的 MySQL 数据库发生了数据更新丢失。为了解决这个问题,当时对用户使用的场景进行了分析。发现可能是因为用户在两台互为主从的机器上都进行了写入导致的数据丢失。 如图所示,是正常和异常情况下应用写入数据库的示例。随后在更加深入调查问题的过程中,DBA 发现了故障引起数据丢失的原因: 如图 1-2 所示为故障具体过程的还原。从图中可以看出在第 3 步 DP 上的写入操作,在恢复 DA 到 DP 的同步之后,覆盖了第 4 步 DA 上的写入。因此导致了最终两台机器数据不一致,并且有一部分数据更新丢失。 在这里相信读者都会有一个疑问, 在第 4 步之后数据变成了(id : 1 ,name : name4),那么第 3 步操作的时候写入的语句是update t20200709 set name = 'name3' where id =1 and name='name2',在第 5 步恢复同步的时候这条语句在 DA 上重放应该不会被成功执行,毕竟 Where 条件都不匹配了。而且在 DP 产生的 Binlog 中,确实也记录了 SQL 语句的 Where 条件,无论从哪个角度上来看第 3 步的 SQL 语句都不应该被重放成功。 ### UPDATE `test`.`t20200709`### WHERE### @1=1 /* INT meta=0 nullable=0 is_null=0 */### @2='name2' /* VARSTRING(255) meta=255 nullable=1 is_null=0 */### SET### @1=1 /* INT meta=0 nullable=0 is_null=0 */### @2='name3' /* VARSTRING(255) meta=255 nullable=1 is_null=0 */# at 684315240 那么这个问题难道是 MySQL 自身的 Bug,抑或是 MySQL 在某些特殊参数或者条件下的正常表现?对于这个问题,本文将可能的给出这个问题的详细解释和分析。 二、Row 格式下 RelayLog 的重放 2.1 BEFOR IMAGE && AFTER IMAGE && binlog_row_image 参数 在最后解释本文最初提出的问题前,需要先来看下 RelayLog 是怎么被重放的。一般情况下,当有 DML 语句变更数据库中的数据的时候,Binlog 会记录下事件描述信息、BEFORE IMAGE 和 AFTER IMAGE 等信息。在这里有一个概念 BEFORE IMAGE 和 AFTER IMAGE 需要先介绍下: 1. BEFORE IMAGE : 前镜像,既数据修改前的样子。 2. AFTER IMAGE : 后镜像,既数据修改后的样子。 为了方便理解,这里贴一个 Binlog 的例子。假设当前有表 t20200709,然后表中数据如下: mysql> select * from t20200709 ;+----+-------+| id | name |+----+-------+| 1 | name4 |+----+-------+1 rows in set (0.00 sec) 之后执行 SQL 语句update t20200709 set name =1 where id = 1; mysql> update t20200709 set name =1 where id = 1;Query OK, 1 row affected (0.00 sec)Rows matched: 1 Changed: 1 Warnings: 0 然后来看下 Binlog 中的记录: #200715 17:28:28 server id 15218 end_log_pos 400 CRC32 0xe4dedec0 Update_rows: table id 4034114356 flags: STMT_END_F### UPDATE `test`.`t20200709`### WHERE### @1=1 /* INT meta=0 nullable=0 is_null=0 */### @2='name4' /* VARSTRING(255) meta=255 nullable=1 is_null=0 */### SET### @1=1 /* INT meta=0 nullable=0 is_null=0 */### @2='1' /* VARSTRING(255) meta=255 nullable=1 is_null=0 */# at 400 可以见得,在修改之前 name 字段的值是 name4,在 Binlog 中用 Where 条件@2='name4'来指明,而修改后的 name 的值是 '1',在 Binlog 中就是@2='1'来指明。因此 BEFORE IMAGE 就是 Binlog 中 WHERE 到 SET 的部分。而 AFTER IMAGE 就是 SET 之后的部分。 那么 DELETE,UPDATE 和 INSERT 语句被记录在 Binlog 中的时候,是否都有 BEFORE IMAGE 和 AFTER IMAGE?其实不是所有的 DML 事件类型都拥有两个 IMAGE 的,参见图 2-2 可知只有 UPDATE 语句,会同时拥有 BEFORE IMAGE 和 AFTER IMAGE。 BEFOR IMAGE 和 AFTER IMAGE 默认会记录所有的列的变更,因此会导致 Binlog 的内容变得很大。那么有没有参数可以控制 IMAGE(对于 BEFOR IMAGE 和 AFTER IMAGE 以下合并简称为 IMAGE)的行为?MySQL 5.7 之后引入了一个新的参数binlog_row_image 。 参数说明: binlog_row_image:https://dev.mysql.com/doc/refman/5.7/en/replication-options-binary-log.html#sysvar_binlog_row_image 用于控制 IMAGE 的行为。 binlog_row_image 参数的值有三个: 1. full:Log all columns in both the before image and the after image. 既所有的列的值的变更,都会在 IMAGE 中记录。系统默认是 full。 2. minimal:Log only those columns in the before image that are required to identify the row to be changed; log only those columns in the after image where a value was specified by the SQL statement, or generated by auto-increment. BEFOR IMAGE 只记录哪些能够唯一标识数据的列,比如主键,唯一键等。AFTER IMAGE 只记录了变更的列。可以看出,minimal 会有效的减少 Binlog 的大小。 3. noblob:Log all columns (same as full), except for BLOBand TEXTcolumns that are not required to identify rows, or that have not changed. 对于其他列的行为都和 full 参数一样。但是对于 BLOB 和 TEXT,在不是可以标识数据行或者有变更的情况下不做记录。 参数说明: BLOB:https://dev.mysql.com/doc/refman/5.7/en/blob.htmlTEXT:https://dev.mysql.com/doc/refman/5.7/en/blob.html 可以看出 binlog_row_image 可以有效控制Binlog的大小,但是如果要保证数据的一致性,最好的值就是设置为 full。 2.2slave_rows_search_algorithms 参数 前文提到了 IMAGE 与 binlog_row_image 相关的内容。本节开始将主要介绍 Relay Log 的重放的时候,对于被重放的记录的查找逻辑。对于 DELETE 和 UPDATE 操作,需要先对数据库中的记录进行检索以确定需要执行 Binlog 重放的数据。如果从库的表上没有主键或唯一键时,则需要根据每一个行记录 BEFOR IMAGE 在所有数据中进行一次全表扫描。在大多数情况下这种开销非常巨大,会导致从库和主库的巨大延迟。从 MySQL 5.6 开始提供了参数slave_rows_search_algorithms 参数说明:slave_rows_search_algorithms:https://dev.mysql.com/doc/refman/5.7/en/replication-options-replica.html#sysvar_slave_rows_search_algorithms 用于控制在 Relay Log 执行重放的时候对于记录的检索行为。其基本的思路是收集每条记录的 BEFOR IMAGE 信息,然后根据 BEFOR IMAGE 的信息在被重放的表中检索对应的记录。根据 MySQL 的文档,检索数据的方式有如下的几种: 1.INDEX_SCAN 2.TABLE_SCAN 3.HASH_SCAN 如上三个方式可以两两组合并赋值给slave_rows_search_algorithms参数。MySQL 文档也给出了如下的说明: The default value isINDEX_SCAN,TABLE_SCAN, which means that all searches that can use indexes do use them, and searches without any indexes use table scans. To use hashing for any searches that do not use a primary or unique key, setINDEX_SCAN,HASH_SCAN. SpecifyingINDEX_SCAN,HASH_SCANhas the same effect as specifyingINDEX_SCAN,TABLE_SCAN,HASH_SCAN, which is allowed. Do not use the combinationTABLE_SCAN,HASH_SCAN. This setting forces hashing for all searches. It has no advantage overINDEX_SCAN,HASH_SCAN, and it can lead to “record not found” errors or duplicate key errors in the case of a single event containing multiple updates to the same row, or updates that are order-dependent. 1. INDEX_SCAN,TABLE_SCAN: 可以看出在默认的情况下,既INDEX_SCAN,TABLE_SCAN如果有主键或者唯一键,则通过主键或者唯一键来查询数据并重放 AFTER IMAGE。如果没有主键或者唯一键,则通过二级索引完成这个工作。如果什么都没有,则使用全表扫描的方式。 2. INDEX_SCAN,HASH_SCAN : 在表有主键或者唯一键的情况下, INDEX_SCAN,HASH_SCAN 配置也是使用的主键或者唯一键去定位数据。在表有二级索引或者完全没有索引的情况下会使用 HASH_SCAN 的方法。 可以见得 Slave 检索需要重放的数据的时候,三个检索方式的优先级是 Index Scan > Hash Scan > Table Scan 相信读者在这里会有 2 个疑问: 1. Hash Scan 的原理是什么?它和 Table Scan 以及 Index Scan 有什么区别?文档中还提到了 Hash scan over index 这个和 Index 有什么关系? 2. 前文提到在表没有主键或者唯一键的时候,会通过二级索引来定位数据。假设表中有 N 个二级索引(包括单列索引和联合索引),哪个二级索引会被选中? 2.3 Hash Scan && Table Scan && Index Scan 实现 分析 MySQL 源码可知最后决定使用哪个检索方式是在函数 Rows_log_event::decide_row_lookup_algorithm_and_key 里面实现的。 9745 void9746 Rows_log_event::decide_row_lookup_algorithm_and_key()9747 {9748... ...9781 /* PK or UK => use LOOKUP_INDEX_SCAN */9782 this->m_key_index= search_key_in_table(table, cols, (PRI_KEY_FLAG | UNIQUE_KEY_FLAG));9783 if (this->m_key_index != MAX_KEY)9784 {9785 DBUG_PRINT("info", ("decide_row_lookup_algorithm_and_key: decided - INDEX_SCAN"));9786 this->m_rows_lookup_algorithm= ROW_LOOKUP_INDEX_SCAN;9787 goto end;9788 }... ...9790 TABLE_OR_INDEX_HASH_SCAN:... ...9808 TABLE_OR_INDEX_FULL_SCAN:... ...9827 end:... ... 在 9782 行会先检索表中是否有主键和唯一键。之后在 TABLE_OR_INDEX_HASH_SCAN 和 TABLE_OR_INDEX_FULL_SCAN 决定最后使用哪种检索方式。在 do_apply_event 函数中,会根据 decide_row_lookup_algorithm_and_key 的结果去调用函数: 11286 switch (m_rows_lookup_algorithm)11287 {11288 case ROW_LOOKUP_HASH_SCAN:11289 do_apply_row_ptr= &Rows_log_event::do_hash_scan_and_update;11290 break;1129111292 case ROW_LOOKUP_INDEX_SCAN:11293 do_apply_row_ptr= &Rows_log_event::do_index_scan_and_update;11294 break;1129511296 case ROW_LOOKUP_TABLE_SCAN:11297 do_apply_row_ptr= &Rows_log_event::do_table_scan_and_update;11298 break;1129911300 case ROW_LOOKUP_NOT_NEEDED:11301 DBUG_ASSERT(get_general_type_code() == binary_log::WRITE_ROWS_EVENT);1130211303 /* No need to scan for rows, just apply it */11304 do_apply_row_ptr= &Rows_log_event::do_apply_row;11305 break;1130611307 default:11308 DBUG_ASSERT(0);11309 error= 1;11310 goto AFTER_MAIN_EXEC_ROW_LOOP;11311 break;11312 } 可以见得: 1. do_hash_scan_and_update: 对应 hash_scan 方式。 2. do_index_scan_and_update: 对应 index_scan 方式。 3. do_table_scan_and_update:对应 table_scan 方式。 接下来分别介绍下这三个函数所完成的内容。 2.3.1 do_hash_scan_and_update do_hash_scan_and_update 函数主要实现了 Hash Scan 检索数据的功能。在实现方式上又可以分为 H --> Hash Scan 和 Hi --> Hash over Index 两种方式。首先来看下 Hash Scan 的实现方法,图 2-5 给出 Hash Scan 的实现逻辑。 可以见得 Binlog 中的 BI 在 Slave 上会被处理到一个 Hash 表中。因为没有合适的索引可以使用,所以使用全表扫描的方式每获取一条记录就根据记录的值计算一个 hash 值,然后在 BI 的 Hash 表中匹配。如果匹配到了 BI,则重放并删除 Hash 表中的记录。 如果 test06 表中 id 列上有索引,那么在 Slave 重放的使用会使用 Hi --> Hash over index 的方式。如图 2-6 所示给出了 Hash over Index 方式(以下均简称 Hi)的实现逻辑。 可以见得如果通过 Hi 方式进行重放,则会对使用的二级索引生成一个 m_distinct_keys 结构,这个结构存放着这个 BI 中这个索引所有的去重值。然后对于 Slave 上的 test06 表通过 m_distinct_keys 中的每一个值在二级索引上进行遍历,遍历获取的记录与 m_hash 中的结果对比并执行重放逻辑。 ps : 对于 Hash Scan 方式还要一个比较迷惑的特性,读者可以参考下这篇文章[技术分享 | HASH_SCAN BUG 之迷惑行为大赏] 2.3.2 do_index_scan_and_update Index Scan 方式会通过索引检索 Slave 上需要重放的数据。通过索引检索数据的方式又可以分为: 1. 通过主键/唯一键索引检索数据。 2. 通过二级索引检索数据。 在通过主键或者唯一键索引检索数据的时候会调用 do_index_scan_and_update 函数,在函数逻辑中直接通过主键/唯一键索引返回了记录然后重放 Binlog。 而在通过二级索引检索数据的时候,会对二级索引返回的数据与 BI 中每一条记录做比较,如果一致就会重放 Binlog。 至此可以发现 Index Scan 下对于主键/唯一键和二级索引的实现逻辑有一些不同。对于主键/唯一键,对于索引到的记录并不会和 BI 中的每一个列做比较,而二级索引获取到的数据会与 BI 中每一个列做比较,如果不一致而不会重放并报错。 2.3.3 do_table_scan_and_update Table Scan 的实现相对简单,如果没有任何的索引可以使用,只能通过全表扫描的方式获取每一行数据并和BI中的每一行做比较。因此如果 Slave 上的数据和 Master 上的数据不一致,也会如图 2-9 中所示一样报错。关于 Table Scan 更加具体的实现方式,读者可以参考 MySQL 源码 sql/log_event.cc 文件中的 do_table_scan_and_update 函数,在这里就不过多的展开。 2.3.4 小结 至此可以回答本文之前提出的这个问题了: Hash scan 方法的原理是什么?它和 Table scan 以及 Index scan 有什么区别?文档中还提到了 Hash scan over index 这个和 Index 又有什么关系? 可以见得,Hash Scan 的原理是将 BI 每一行的内容都放入一个 Hash 表中。如果可以使用二级索引(既 Hash scan over index 这个方式),则额外的对 BI 中二级索引的值生成一个 Hash 结构,并且将 BI 中二级索引列的去重值放入这个 Hash 结构中。之后不管是通过全表扫描还是索引的方式获取数据,都会通过 Hash 结构去定位 BI 中的数据。对于 Table Scan 和 Index Scan 在获取表中的每一行之后,都需要去和 BI 中的记录做一次查找和比较(有主键或者唯一键的时候不做比较),而 BI 的每一行并没有生成类似于 Hash 的结构,因此从算法的时间复杂度效率上来说是属于 O(n^2) 的。而 Hash Scan 在获取一条记录之后也需要根据 BI 生成的 Hash 结构中查找记录,但是对于 Hash 结构的查找来说效率是 O(1),因此可以忽略不计。由此可以看出,在没有主键的情况下 Hi 和 Ht 方式的效率是会比 Table Scan 和 Index Scan 来的高一些。 同时到这里,也可以回答本文开头的问题,为什么当前表中的记录有一列值已经和 BI 中的记录不一致了,Binlog 中的操作还会重放。原因就是因为在默认的 INDEX_SCAN,TABLE_SCAN 方式下,对于有主键/唯一键的表不会去比较 BI 中的记录是否和检索到的数据一致。 2.4 Hash Scan Over Index && Index Scan 中二级索引的选择 前文提到了在有二级索引的情况下,Hash Scan 和 Index Scan 都会选择二级索引进行扫描。如果表中存在多个二级索引,MySQL 会选择哪个?通过源码分析,最后惊讶的发现,在 binlog_row_image 参数是 Full 的情况下,如果表中存在多个二级索引,MySQL 会默认选择使用第一个索引进行重放。在 decide_row_lookup_algorithm_and_key 函数中,除了决定了使用哪种方式检索数据以外(例如使用 Hash Scan 还是 Table Scan),也决定了后续使用哪个索引。 如图 2-10 给出了选择二级索引的时候的逻辑。可以发现如果在遍历的过程中,找到了第一个所有的列都在 BI 中 key,则会使用这个 key。给出一个例子,test06 的表结构和表中数据如下: *************************** 1. row *************************** Table: test06Create Table: CREATE TABLE `test06` ( `id` int(11) NOT NULL, `name` varchar(255) DEFAULT NULL, `c1` int(11) DEFAULT NULL, KEY `k1` (`id`), KEY `k2` (`id`,`name`), KEY `k3` (`c1`,`name`)) ENGINE=InnoDB DEFAULT CHARSET=utf81 row in set (0.13 sec)mysql> select * from test06 ;+------+-------+------+| id | name | c1 |+------+-------+------+| 2582 | name3 | 1 || 2582 | name4 | 1 || 1 | name1 | 0 || 1 | name2 | 0 || 1 | name3 | 0 |+------+-------+------+5 rows in set (0.00 sec) 在 Master 上执行 SQL,同时 Master 上的执行计划如下: delete from test06 where id = 1 and name ='name3' and c1=0;mysql> explain delete from test06 where id = 1 and name ='name3' and c1=0;+----+-------------+--------+------------+-------+---------------+------+---------+-------------+------+----------+-------------+| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |+----+-------------+--------+------------+-------+---------------+------+---------+-------------+------+----------+-------------+| 1 | DELETE | test06 | NULL | range | k1,k2,k3 | k2 | 772 | const,const | 1 | 100.00 | Using where |+----+-------------+--------+------------+-------+---------------+------+---------+-------------+------+----------+-------------+1 row in set (0.00 sec) 可以见得,在 Master 上优化器选择了 k2 这个联合索引。通过 GDB 跟踪 Slave 的进程,在 log_event.cc 第 9733 行打断点: 9714 if (key_type & MULTIPLE_KEY_FLAG && table->s->keys) 9715 { 9716 DBUG_PRINT("debug", ("Searching for K.")); 9717 for (key=0,keyinfo= table->key_info ; 9718 (key < table->s->keys) && (res == MAX_KEY); 9719 key++,keyinfo++) 9720 { 9721 /* 9722 - Skip innactive keys 9723 - Skip unique keys without nullable parts 9724 - Skip indices that do not support ha_index_next() e.g. full-text 9725 - Skip primary keys 9726 */ 9727 if (!(table->s->keys_in_use.is_set(key)) || 9728 ((keyinfo->flags & (HA_NOSAME | HA_NULL_PART_KEY)) == HA_NOSAME) || 9729 !(table->file->index_flags(key, 0, true) & HA_READ_NEXT) || 9730 (key == table->s->primary_key)) 9731 continue; 9732 9733 res= are_all_columns_signaled_for_key(keyinfo, bi_cols) ? 9734 key : MAX_KEY; 9735 9736 if (res < MAX_KEY) 9737 DBUG_RETURN(res); 9738 } 9739 DBUG_PRINT("debug", ("Not all columns signaled for K.")); 9740 } 可以观察到这时候 m_key_index 的值是 0,并且观察 keyinfo 变量的值为: (gdb) print *keyinfo$4 = {key_length = 4, flags = 0, actual_flags = 0, user_defined_key_parts = 1, actual_key_parts = 1, unused_key_parts = 0, usable_key_parts = 1, block_size = 0, algorithm = HA_KEY_ALG_UNDEF, { parser = 0x0, parser_name = 0x0}, key_part = 0x7f2f4c015a00, name = 0x7f2f4c012bb1 "k1", rec_per_key = 0x7f2f4c012bc0, m_in_memory_estimate = -1, rec_per_key_float = 0x7f2f4c012bf8, handler = { bdb_return_if_eq = 0}, table = 0x7f2f4c92d1a0, comment = {str = 0x0, length = 0}} 接下来,删除 k1 这个索引,再来观察下 m_key_index 和 keyinfo 的值。 (gdb) print *keyinfo$7 = {key_length = 772, flags = 64, actual_flags = 64, user_defined_key_parts = 2, actual_key_parts = 2, unused_key_parts = 0, usable_key_parts = 2, block_size = 0, algorithm = HA_KEY_ALG_UNDEF, { parser = 0x0, parser_name = 0x0}, key_part = 0x7f2f4c92b680, name = 0x7f2f4c92e7d1 "k2", rec_per_key = 0x7f2f4c92e7d8, m_in_memory_estimate = -1, rec_per_key_float = 0x7f2f4c92e808, handler = { bdb_return_if_eq = 0}, table = 0x7f2f4ca9fd90, comment = {str = 0x0, length = 0}} 可以发现删除了 k1 之后,Slave 上就选择 k2 这个索引,和 Master上的执行计划选择的索引一致了。通过前面的源码分析和调试跟踪可以发现,MySQL 在 Slave 重放数据的时候(没有主键和唯一键的情况),选择的索引是第一个所有的列都在 BI 中存在的索引。因此可能存在 Slave 上选择的索引不是最优的导致 Slave 和 Master 有巨大延迟。 三、总结 至此前文提出的几个问题都基本清楚了,可以总结出如下的几点内容: 1. 在有主键或者唯一键的情况下,Slave 重放 Binlog 并不会去比较检索到的记录的每一列是否和BI相同,因此如果 Slave 和 Master 存在数据不一致,会直接覆盖 Slave 的数据而不会报错。 2. 在没有主键或者唯一键的情况下,Hash Scan / Hash Scan Over Index 的执行效率 在理论上分析高于 Table Scan 和Index Scan 。 3. 在没有主键或者唯一键的情况下,Slave 选择的二级索引是第一个所有的列都在 BI 中存在的索引,不一定是 Master 执行计划所选择的索引。 最后本文所有分析的源码都是基于 mysql-5.7.28 版本。限于作者的水平有限,如果文章中有错误之处,望大家不吝指正。 四、参考文献 [1]. MySQL 无主键延迟优化(slave_rows_search_algorithms). https://www.centos.bz/2018/01/mysql无主键延迟优化(slave_rows_search_algorithms) [2]. MySQL 5.7 贴心参数之 binlog_row_image. https://www.cnblogs.com/gomysql/p/6155160.html [3]. 技术分享 | delete大表slave回放巨慢的问题分析. https://mp.weixin.qq.com/s/aeZvPBhhbea058Kz1Pplpw [4]. Causes and Workarounds for Slave Performance Too Slow with Row-Based Events. https://www.percona.com/blog/2018/05/03/slave-performance-too-slow-with-row-based-events-causes-and-workarounds/ [5]. 技术分享 | 从库数据的查找和参数 slave_rows_search_algorithms. https://mp.weixin.qq.com/s/Jh1z6ir1YfI5BvmdBS1n8g [6]. 技术分享 | HASH_SCAN BUG 之迷惑行为大赏. https://mp.weixin.qq.com/s/7zOekpbHG4g5SQ-FyjKk0A 社区近期动态 点一下“阅读原文”了解更多资讯 本文分享自微信公众号 - 爱可生开源社区(ActiontechOSS)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
优秀的个人博客,低调大师

上云双引擎(下)- 用DTS从自建数据库迁移至RDS

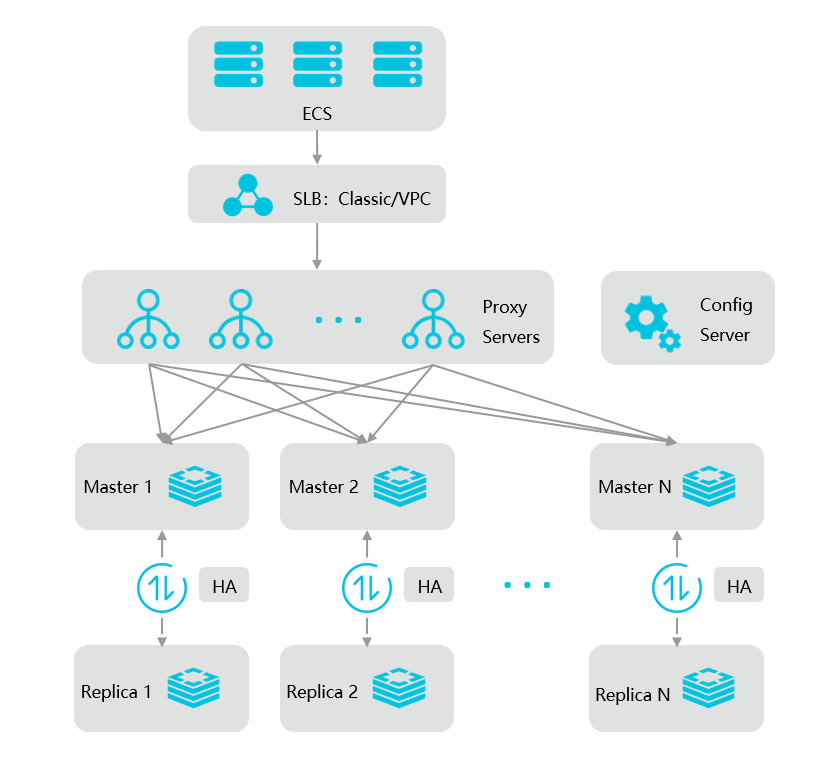
背景 传统的互联网业务,无论是APP应用还是web应用,很多中小型企业对于云服务还是处于一个“懵懂”时期,基本上所有的应用部署都依然延用的线下的那一套,例如数据库自建,中间件自建,存储自建;如果业务都是单点部署,不管是数据安全、还是业务的稳定性,都难以得到保障。 业务价值 对多台云服务器进行流量分发的多可用区高可用版的负载均衡,可以通过流量分发扩展应用系统对外的服务能力,通过消除单点故障提升应用系统的可用性,自动跨可用区部署更是加强了业务容灾能力。 通过自定义镜像,可以迅速复制出相同应用部署的ECS云服务器实例,同时添加到SLB后端服务器组中,实现业务高可用。 SLB可以同时配置四层和七层监听,及轮循、加权轮循、加权最小连接数三种算法,合理分配后端ECS计算资源。 使用云数据库RDS,针对高并发场景进行特殊优化,同时引入线程池、并行复制、隐含

优秀的个人博客,低调大师

2017双11技术揭秘—双十一海量数据下EagleEye的使命和挑战

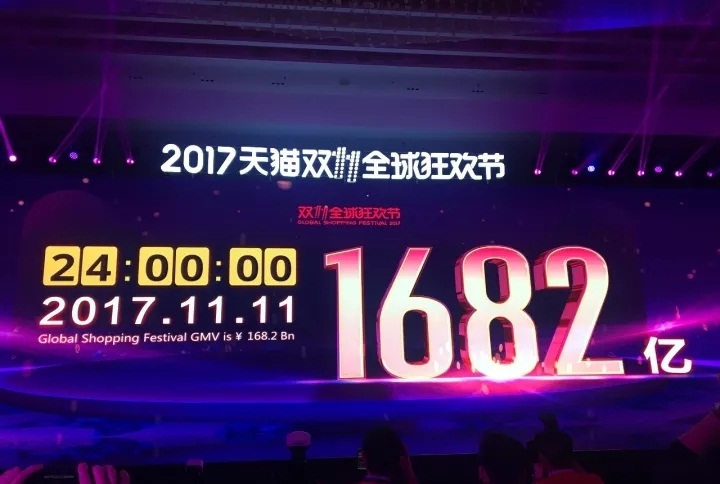
作者:王华锋(水彧) 背景 双十一一直是阿里巴巴集团每年要打的一场大战役。要打赢这场战役,技术上,不仅仅是几个应用、几个系统的事,也不是多少个开发+多少个测试就能完成的事,而是需要各大系统协同作战、每个应用各司其职、技术人员通力合作才能取得最终的胜利。 EagleEye作为阿里集团老牌的链路跟踪系统,其自身业务虽不在交易链路上,但却监控着全集团的链路状态,特别是在中间件的远程调用上,覆盖了集团绝大部分的场景,在问题排查和定位上发挥着巨大的作用,保障了各个系统的稳定性,为整个技术团队打赢这场战役保驾护航。 图1 EagleEye系统整体情况 近两年集团业务和规模始终保持着高速的增长,纵深上,交易量屡攀新高,双十一零点的交易峰值也再一次刷新了历史;横向上,集团涉及的行业和领域也不断的拓展,各行各业在不断加入阿里(高德、优酷、友盟及大麦等等),共

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册