首页 文章 精选 留言 我的

精选列表

搜索[全模态模型],共10000篇文章
优秀的个人博客,低调大师

Android UI优化全解析

点击上方蓝字关注我,每天一见,给你力量 前言 往期优化文章目录: 启动优化 今天继续优化方面的内容——UI(布局)优化。 UI优化知识点主要分为三部分: 第一部分,系统为我们做的优化。由于前端中UI展示的特殊性和重要性,Android团队也是在不断想办法提高UI方面的渲染速度,所以也是更新了很多系统优化方案,比如: 硬件加速、黄油计划、RenderThread。 第二部分,我们可以 具体实施的优化方案。主要包括: java代码布局、View重用、异步创建View、xml布局优化、异步布局框架Litho、屏幕适配、Flutter、Jetpack Compose 第三部分,工具使用,主要包括: Choreographer、monitor、Systrace 系统做的优化 硬件加速 之前我们说过,一个图形的绘制是CPU,GPU和屏幕三方合作的结果。 在Android3.0之前,还没有硬件加速,都是通过CPU进行数据计算,然后通过Skia库进行软件绘制,但是CPU对于图形处理并不高效。 于是从3.0开始,Android支持了硬件加速,到Android4.0默认开启硬件加速。 开启硬件加速后,就是由CPU进行图形缓存数据的绘制。这样CPU和GPU就能比较好的分工,各司其职了。CPU用于控制复杂绘制逻辑、构建或更新DisplayList(基础元素);GPU用于完成图形计算、渲染DisplayList(基础元素)。 这里也找了一张各种场景下,硬件加速前后的流程与加速效果(Android6.0背景): 但是硬件加速也是有缺点的: 启用硬件加速需要更多资源,因此应用会占用更多内存。 比较低的版本,由于有些 Canvas API还没有支持,所以使用硬件加速可能会有问题。那么我们就可以手动关闭某个view的硬件加速: myView.setLayerType(View.LAYER_TYPE_SOFTWARE,null) Project Butter 黄油计划,你有可能没怎么听说,但是其实之前两章内容都提到过,Android4.1之后,Google提出了黄油计划,主要包括两个内容: VSYNC Triple Buffering(三重缓存) 这些都熟悉了吧,上两节都说过的,这里再简单提一下: VSYNC 垂直同步信号,每当收到这个信号后,CPU就开始准备Buffer数据,并在16ms之内和GPU把屏幕需要的缓存数据准备好。 Triple Buffering(三重缓存) 在Android4.1之前,是双缓存机制,大部分是没问题的。但是当CPU/GPU绘制过程较长,超过一个vsync信号周期,一般是16ms,就会导致丢帧,CPU无法使用被GPU或者屏幕占用的缓存区。如果下一帧绘制如果又超时,那么又会丢帧。 所以再加上一个缓存区,这样,CPU、GPU、Display三者都有各自的缓存区,互不影响,就能保证时间的最大化利用,也就能减少上述的情况了。 RenderThread RenderThread是在Android5.0提出的,从这个名字就能知道,它是一个线程,一个专门执行GL命令的线程,也就是一部分的绘制工作。 有了它之后,当CPU处理数据给GPU后,就不需要等GPU渲染完毕了,而是将一些绘制任务交给RenderThread,这样就能减少主线程的工作,保证画面的流畅。同时还提供了RenderNode,用来做view的属性封装,渲染帧的信息等等。 优化方案 java代码布局 我们一般都是用XML文件进行布局,但是XML解析也是很耗时的,并在这个解析过程在主线程进行。 所以我们有的时候也许可以通过Java代码或者kotlin进行View的创建? 理论中,这样确实能减少布局加载的消耗时间,但是Java代码创建View太麻烦了,而且无法可视化。 当然,也有一些库可以帮助我们将xml代码转换成java代码,比如X2C(https://github.com/iReaderAndroid/X2C ),但是它并不支持所有的情况,比如merge标签,appCompat兼容控件等等。 所以我们需要在这之中找到平衡点,有的时候,UI简单并且要求高性能的前提下,我们可以试试用这样的方法,即用java代码代替XmL代码。 View重用 参照Recyclerview的做法,我们也可以将一些常用的view保存到缓存池中,这样在不同的界面中就能复用缓存池里面的view。 异步创建view 这是Google提出的一个方案——AsyncLayoutInflater。它可以异步加载布局文件,并且回调给主线程,从而减少主线程耗时。简单贴下主要代码: newAsyncLayoutInflater(MainActivity.this).inflate(R.layout.activity_main,null,newAsyncLayoutInflater.OnInflateFinishedListener(){@OverridepublicvoidonInflateFinished(@NonNullViewview,inti,@NullableViewGroupviewGroup){//回调给主线程setContentView(view);}}); xml布局优化 在写xml布局文件的时候,我们要做的也有很多,比如: 减少布局嵌套。多使用ViewStub、Merge、ConstraintLayout来代替。 优化开销。RelativeLayout和 使用weight的LinearLayout 开销比较大,建议使用ConstraintLayout,LinearLayout代替。 异步布局框架Litho Litho是Facebook开源的一款在Android上高效建立UI的声明式框架。 主要有以下特点: 1)声明式:它使用了声明式的API来定义UI组件。 2)异步布局:它把 measure 和 layout 都放到了后台线程,只留下了必须要在主线程完成的 draw,这大大降低了 UI 线程的负载 3)视图扁平化:由于 Litho 使用了自有的布局引擎(Yoga),在布局阶段就可以检测不必要的层级、减少 ViewGroups,来实现 UI 扁平化。 4)优化 RecyclerView:Litho 还优化了 RecyclerView 中 UI 组件的缓存和回收方法。 屏幕适配 关于屏幕适配问题,也是老生常谈了。主要有以下几种方案: dp适配方案。 这是系统自带的适配单位,dp是基于屏幕物理分辨率一个抽象的单位,用于说明与密度无关的尺寸和位置。所以它能在不同分辨率的手机上有相对大小的适配性。计算公式是:px=dp * (dpi/160)。但是dpi有可能会被人为调整(比如几部相同分辨率不同尺寸的手机的ppi可能分别是是430,440,450,那么在Android系统中,可能dpi会全部指定为480),所以还是有可能在一些设备上出现适配问题。 宽高限定符适配方案。 简单地说,这个方案就是穷举市面上所有的Android手机的宽高像素值。然后找到对应的文件夹使用下面的资源文件所对应的px值。 但是这方案有个缺陷,就是必须精确命中才行。比如1920x1080的手机就一定要找到1920x1080的限定符,否则就只能用统一的默认的dimens文件了。 所以容错性太低,不推荐。 smallestWidth适配方案。 这个方案就是通过手机的宽度值来找到对应限定符文件夹下的资源文件,可以看做宽高限定符屏幕适配方案的升级版。 假如我们的设计图宽为360dp,那么就创建values-sw360dp文件夹,并添加资源文件: <?xmlversion="1.0"encoding="UTF-8"?><resources><dimenname="dp_1">1dp</dimen><dimenname="dp_2">2dp</dimen><dimenname="dp_3">3dp</dimen>...<dimenname="dp_359">359dp</dimen><dimenname="dp_360">360dp</dimen></resources> 很简单,分为360份,然后我们实际写布局文件的时候,直接引用对应的dimen值即可。 然后新建其他设备宽度的文件夹,并在每个文件夹里添加对应的资源文件,这里以400dp为例: ├──src/main│├──res│├──├──values│├──├──values-sw320dp│├──├──values-sw400dp│├──├──...│├──├──values-sw640dp <?xmlversion="1.0"encoding="UTF-8"?><resources><dimenname="dp_1">1.1111dp</dimen><dimenname="dp_2">2.2222dp</dimen><dimenname="dp_3">3.3333dp</dimen><dimenname="dp_4">4.4444dp</dimen>...<dimenname="dp_359">398.8889dp</dimen><dimenname="dp_360">400.0000dp</dimen></resources> 也就是说,所有的设备都分为360份了,这样就能保证在不同宽度设备上都能有差不多的效果。 如果我们的设备宽度为400dp,那么就会调用values-sw400dp对应的资源文件,如果找不到,就会向下查找。比如我们宽度是402dp,找不到对应的,就会向上找到400dp对应的资源文件,所以也有比较好的容错性。也是一个比较好的适配方案。 当然这种重复性工作肯定不需要我们自己手动去实现,有专门的插件可以生成相应的文件和文件夹,这里也推荐一个:https://github.com/ladingwu/dimens_sw 今日头条适配方案。 这个大家应该都很熟悉了,主要是通过动态修改density值来保证所有设备的屏幕宽度都是固定的dp值。用到的公式就是px = density * dp。 比如设计图宽为360dp,我们只要保证所有设备的宽度都是360dp就能适配了。而宽度的px值我们是已知的,所以就是要修改这个 density 值来完成我们的适配目的。具体代码我就不贴了,网上很多。 这种方案侵入性低,使用方便,是个不错的适配方案。 Flutter Flutter是 Google 推出并开源的移动应用开发框架,开发者可以通过 Dart 语言开发 App,一套代码同时运行在 iOS 和 Android 平台。 Flutter框架现在也是特别火,实际运用到很多的大厂项目,比如闲鱼今日头条。它相对于Android其实是另外一套APP架构了,它没有基于系统本身的渲染引擎,而是app中自带Skia引擎,虚拟机也是使用的Dart虚拟机。 主要有以下几个特点: 跨平台:现在flutter至少可以跨5种平台,常见的平台:MacOS,Windows ,Linux ,Android ,iOS ,到目前为止,Flutter算是支持平台最多的框架了。良好的跨平台性,大大减少了开发成本。 丝滑般的体验:使用Flutter内置的Material Design(android风格)和Cupertino(ios风格)风格组件,以及丰富的motion API,平滑而自然的滑动效果和平台感知,为用户带来全新的体验。 响应式框架:使用一系列基础组件和响应式框架,可以轻松构建用户界面。使用功能强大且灵活的API可以实现复杂的界面效果。 支持插件:使用插件可以访问平台本地API,如相机,蓝牙,WIFI等等。借助现有的Java,swift ,object c , c++代码实现对原生系统的调用。 60fps超高性能:Flutter编写的应用可以达到60fps(每秒传输帧数)。Flutter采用GPU渲染技术,所以性能很好。完全可以胜任游戏开发。 Jetpack Compose Jetpack Compose 是用于构建原生 Android 界面的新工具包 原来我们的布局文件都是写在xml文件中的,现在提供了一种新的view构建方式,也就是Compose。 它是一种声明式UI,不再使用xml,而是使用kotlin进行UI布局。其实就跟我们之前提到的一点,用java代码去构建view一样的效果。这样就减少了xml解析的时间,提高了效率。 声明式UI。指的是只需要把界面声明出来,不需要手动更新。比如我们这里的Compose只需要写一遍,后续的UI改变会随着变量自动更新。而传统的xml布局方式就无法做到这一点,属于命令式UI,需要我们手动命令纸牌屋UI的修改。 官方也是宣称有以下几点优势: 更少更直观的代码,更强大的功能,能提高开发速度。 最后贴一段代码,感受下Compose的写法: classMainActivity:AppCompatActivity(){overridefunonCreate(savedInstanceState:Bundle?){super.onCreate(savedInstanceState)setContent{Greeting("Android")}}}@ComposablefunGreeting(name:String){Text(text="Hello$name!")} 工具篇 Choreographer 嘿嘿,没想到吧,上期我们说过的Choreographer其实也是一个监控应用帧率的工具。它主要有以下特性: 能获取整体的帧率。 能在线上使用。 获取的帧率几乎是实时的。 主要原理就是利用postFrameCallback计算两次绘制的间隔时间,简单贴下代码: privatelongmLastFrameTime;Choreographer.getInstance().postFrameCallback(newChoreographer.FrameCallback(){@OverridepublicvoiddoFrame(longframeTimeNanos){if(mLastFrameTime==0){mLastFrameTime=frameTimeNanos;}floatdiff=(frameTimeNanos-mLastFrameTime)/1000000.0f;//得到毫秒,正常是16.66msif(diff>500){doublefps=(((double)(mFrameCount*1000L))/diff);mFrameCount=0;mLastFrameTime=0;Log.d("doFrame","doFrame:"+fps);}else{++mFrameCount;}Choreographer.getInstance().postFrameCallback(this);}}); 想细细研究的可以看看这个库(https://github.com/friendlyrobotnyc/TinyDancer ) LayoutInspector/Android Device Monitor LayoutInspector是AndroidStudio种的一个布局检查器,可以通过Tools > Layout Inspector找到,他可以检查应用中的某个界面的视图结构,但是无法查看非调式状态的应用。 如果要看其他应用的布局情况,可以使用Android Device Monitor,在Android Studio 3.1 以后,需要单独从文件夹打开了: android-sdk/tools/monitor Systrace Systrace是分析Android性能问题的神器,获取Systrace文件的方式有两种: 一是 AndroidSDK/tools目录下,通过 monitor.bat用 Android Device Monitor可视化工具得到。 二是通过 python脚本获取。 具体怎么分析这里就不细说了,下次可以专门一篇文章讲Systrace性能分析。 参考 https://www.jianshu.com/p/a4b8e4c5d9b0 https://time.geekbang.org/column/article/81049 https://juejin.cn/post/6844904047355363341 https://juejin.cn/post/6844904048068395015 https://blog.csdn.net/u013425527/article/details/97046401 感谢大家的阅读,有一起学习的小伙伴可以关注下公众号—码上积木❤️ 每日三问知识点/面试题,积少成多。 点在看你最好看 本文分享自微信公众号 - 码上积木(Lzjimu)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Python 系统编程 (全)

进程 1.进程 简单的说就是实现唱歌跳舞同时进行,那么就需要一个新的方法,叫做:多任务 2.多任务的概念 ①简单地说,就是操作系统可以同时运行多个任务 ②并行执行多任务只能在多核CPU上实现,但是,由于任务数量远远多于CPU的核心数量,所以,操作系统也会自动把很多任务轮流调度到每个核心上执行 ③就是说当cpu核心数量大于任务数量就是并行,反过来,就是并发 ④依照的规则有时间片轮转,优先级调度 3.进程的创建-fork ①程序:编写完毕的代码,在没有运行的时候,称之为程序 ②进程:正在运行着的代码,还有需要运行的环境等 ③fork( ): Python的os模块封装了常见的系统调用,其中就包括fork importos #注意,fork函数,只在Unix/Linux/Mac上运行,windows不可以 pid=os.fork() ifpid==0: print('哈哈1') else: print('哈哈2') #程序执行到os.fork()时,操作系统会创建一个新的进程(子进程),然后复制父进程的所有信息到子进程中 #然后父进程和子进程都会从fork()函数中得到一个返回值,在子进程中这个值一定是0,而父进程中是子进程的id号 #普通的函数调用,调用一次,返回一次,但是fork()调用一次,返回两次,因为操作系统自动把当前进程(称为父进程)复制了一份(称为子进程),然后,分别在父进程和子进程内返回 #getpid()是获取当前进程(主进程或子进程)的id、getppid()获取父进程的id 4.多进程修改全局变量 多进程中,每个进程中所有数据(包括全局变量)都各有拥有一份,互不影响,所以在修改全局变量的时候,两个变量相互独立 5.多次fork问题 下次遇到多进程就画图,再如: os.fork() os.fork() os.fork()#就变成了8个进程 在while True中,如果有os.fork(),程序一定崩,这就相当于fork炸弹,死循环创建进程 6.multiprocessing模块 ①multiprocessing模块提供了一个Process类来代表一个进程对象 ②跨平台的操作,fork只在linux下才有效,所以平时应该使用process,它是一个类 程序如下: frommultiprocessingimportProcess importtime deftest(): whileTrue: print("---test---") time.sleep(1) P=Process(target=test) P.start()#让这个进程开始执行test函数里的代码 whileTrue: print("---main---") time.sleep(1) 说明: #创建子进程时,只需要传入一个执行函数和函数的参数,创建一个Process实例,用start()方法启动 #这样创建进程比fork()还要简单 #join()方法可以等待子进程结束后再继续往下运行,通常用于进程间的同步,这就与fork不同,需要等子进程结束,主进程才可以结束 7.Process语法结构 Process([group[,target[,name[,args[,kwargs]]]]]) ①target:表示这个进程实例所调用对象; ②args:表示调用对象的位置参数元组; ③kwargs:表示调用对象的关键字参数字典; ④name:为当前进程实例的别名; ⑤group:大多数情况下用不到; 8.Process类常用方法 ①is_alive():判断进程实例是否还在执行; ②join([timeout]):是否等待进程实例执行结束,或等待多少秒; ③start():启动进程实例(创建子进程); ④run():如果没有给定target参数,对这个对象调用start()方法时,就将执行对象中 的run()方法; ⑤terminate():不管任务是否完成,立即终止; 9.Process类常用属性 ①name:当前进程实例别名,默认为Process-N,N为从1开始递增的整数; ②pid:当前进程实例的PID值 ③进程的创建-Process子类: 创建新的进程还能够使用类的方式,可以自定义一个类,继承Process类,每次实例化这个类的时候,就等同于实例化一个进程对象 如果想知道程序的运行时间,可以用开始和结束的time.time()两个时间差,就代表运行时间 10.进程池pool ①当需要创建的子进程数量不多时,可以直接利用multiprocessing中的Process动态成生多个进程 ②但如果是上百甚至上千个目标,手动的去创建进程的工作量巨大,此时就可以用到multiprocessing模块提供的Pool方法 P0=Pool(3)#定义一个进程池,最大进程数3 foriinrange(0,10): #Pool.apply_async(要调用的目标,(传递给目标的参数元组,))(非堵塞式) #Pool.apply(worker,(i,))(堵塞式),主进程卡在这里,需要等子进程完成才能添加 #每次循环将会用空闲出来的子进程去调用目标 P0.apply_async(worker,(i,))#work是一个函数 P0.close()#关闭进程池,关闭后po不再接收新的请求 P0.join()#等待po中所有子进程执行完成,必须放在close语句之后 11.多种创建进程的方式比较 os.fork()中,子进程和父进程可以都执行,而且父进程可以不必等待子进程结束 p=process(target=xxx) p.start() #子进程和父进程都可执行 pool=Pool(3) pool.apply_async(xxx) #主进程一般用来等待,真正的任务都在子进程中执行 12.进程间通信-Queue ①Process之间有时需要通信,操作系统提供了很多机制来实现进程间的通信。 ②Queue的使用: 可以使用multiprocessing模块的Queue实现多进程之间的数据传递,Queue本身是一个消息列队程序 队列:先进先出 栈:先进后出 初始化Queue()对象时(例如:q=Queue()),若括号中没有指定最大可接收的消息数量,或数量为负值,那么就代表可接受的消息数量没有上限(直到内存的尽头) frommultiprocessingimportQueue q=Queue(3)#初始化一个Queue对象,最多可接收三条put消息 try: q.put_nowait("消息4") except: print("消息列队已满,现有消息数量:%s"%q.qsize()) Queue.qsize():返回当前队列包含的消息数量; Queue.empty():如果队列为空,返回True,反之False; Queue.full():如果队列满了,返回True,反之False; Queue.get([block[, timeout]]):获取队列中的一条消息,然后将其从列队中移除,block默认值为True Queue.get_nowait():相当Queue.get(False);应该把它放在try里面 Queue.put(item,[block[, timeout]]):将item消息写入队列,block默认值为True ③进程池中的Queue: 如果要使用Pool创建进程,就需要使用multiprocessing.Manager()中的Queue(),而不是multiprocessing.Queue() 13.孤儿进程和僵尸进程 ①孤儿进程:是指父进程结束,但子进程还未结束,通常的情况下父进程可以清除子进程 的垃圾,表示子进程没人收尸了 ②僵尸进程:是指子进程结束了,父进程还未结束 ③一般在操作系统中,0号进程负责切换任务,1号进程负责生子进程,并负责打理孤儿进程 线程 1.多线程threading python的thread模块是比较底层的模块,python的threading模块是对thread做了一些包装的,可以更加方便的被使用 2.进程和线程的关系 ①线程是进程里面一种真正执行代码的东西,类似进程里面的箭头 ②进程是资源分配的单位,线程是cpu调度的单位 ③进程,能够完成多任务,比如 在一台电脑上能够同时运行多个QQ ④线程,能够完成多任务,比如 一个QQ中的多个聊天窗口 ⑤定义的不同: 进程是系统进行资源分配和调度的一个独立单位. 线程是进程的一个实体,是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位 线程自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈), 但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源 ⑥区别: 一个程序至少有一个进程,一个进程至少有一个线程 线程的划分尺度小于进程(资源比进程少),使得多线程程序的并发性高 进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率 线程不能够独立执行,必须依存在进程中 ⑦优缺点: 线程和进程在使用上各有优缺点:线程执行开销小,但不利于资源的管理和保护;而进程正相反 3.多线程执行 importthreading importtime defsaySorry(): print("Python才是最好的语言") time.sleep(1) if__name__=="__main__": foriinrange(5): t=threading.Thread(target=saySorry) t.start()#启动线程,即让线程开始执行 说明: #可以明显看出使用了多线程并发的操作,花费时间要短很多 #创建好的线程,需要调用start()方法来启动 #主线程会等待所有的子线程结束后才结束 4.线程执行代码的封装 ①通过使用threading模块能完成多任务的程序开发,为了让每个线程的封装性更完美,所以使用threading模块时,往往会定义一个新的子类class,只要继承threading.Thread就可以了,然后重写 run方法 ②python的threading.Thread类有一个run方法,用于定义线程的功能函数,可以在自己的线程类中覆盖该方法。而创建自己的线程实例后,通过Thread类的start方法,可以启动该线程,交给python 虚拟机进行调度,当该线程获得执行的机会时,就会调用run方法执行线程 ③多线程程序的执行顺序与多进程类似,都是不确定的 5.总结 ①每个线程一定会有一个名字,尽管上面的例子中没有指定线程对象的name,但是python会自动为线程指定一个名字。 ②当线程的run()方法结束时该线程完成。 ③无法控制线程调度程序,但可以通过别的方式来影响线程调度的方式 6.多线程-共享全局变量 ①在一个进程内的所有线程共享全局变量,能够在不适用其他方式的前提下完成多线程之间的数据共享(这点要比多进程要好) ②缺点就是,线程是对全局变量随意遂改可能造成多线程之间对全局变量的混乱(即线程非安全),在线程中,不能同时对全局变量进行修改,解决办法是轮流让线程进行修改 7.同步 ①多线程开发可能遇到的问题 ②假设两个线程t1和t2都要对num=0进行增1运算,t1和t2都各对num修改10次, num的最终的结果应该为20。但是由于是多线程访问,答案可能不一样,所以在修改时, 就要让其修改完再轮到下一个线程来修改 ③什么是同步: 同步就是协同步调,按预定的先后次序进行运行。如:你说完,我再说,"同"字从字面上 容易理解为一起动作其实不是,"同"字应是指协同、协助、互相配合 ④解决问题的思路: 系统调用t1,然后获取到num的值为0,此时上一把锁,即不允许其他现在操作num 对num的值进行+1解锁,此时num的值为1,其他的线程就可以使用num了,而且是 num的值不是0而是1 同理其他线程在对num进行修改时,都要先上锁,处理完后再解锁,在上锁的整个过程 中不允许其他线程访问,就保证了数据的正确性 8.互斥锁 ①当多个线程几乎同时修改某一个共享数据的时候,需要进行同步控制 ②某个线程要更改共享数据时,先将其锁定,此时资源的状态为锁定,其他线程不能更改;直到该线程释放资源,将资源的状态变成非锁定,其他的线程才能再次锁定该资源。互斥锁保证了每次 只有一个线程进行写入操作,从而保证了多线程情况下数据的正确性 ③threading模块中定义了Lock类,可以方便的处理锁定: #创建锁 mutex=threading.Lock() #锁定 mutex.acquire([blocking]) #释放 mutex.release() ④如果设定blocking为True,则当前线程会堵塞,直到获取到这个锁为止(如果没有指定,那么默认为True)如果设定blocking为False,则当前线程不会堵塞 ⑤上锁解锁过程: 每次只有一个线程可以获得锁。如果此时另一个线程试图获得这个锁,该线程就会变为 &ldquo;blocked&rdquo; 状态,称为&ldquo;阻塞&rdquo;,直到拥有锁的线程调用锁的release()方法释放锁之后,锁进 入 &ldquo;unlocked&rdquo;状态。 线程调度程序从处于同步阻塞状态的线程中选择一个来获得锁,并使得该线程进入运行( running)状态。 ⑥总结: 锁的好处: 确保了某段关键代码只能由一个线程从头到尾完整地执行 锁的坏处: 阻止了多线程并发执行,包含锁的某段代码实际上只能以单线程模式执行,效率就大大地下降了 由于可以存在多个锁,不同的线程持有不同的锁,并试图获取对方持有的锁时, 可能会造成死锁 9.多线程-非共享数据 ①对于全局变量,在多线程中要格外小心,否则容易造成数据错乱的情况发生 ②在多线程开发中,全局变量是多个线程都共享的数据,而局部变量等是各自线程的,是非共享的 10.死锁 ①举个例子:就好比是现实社会中,男女双方都在等待对方先道歉 ②在线程间共享多个资源的时候,如果两个线程分别占有一部分资源并且同时等待对方的资源,就会造成死锁 ③避免死锁: #程序设计时要尽量避免(银行家算法) #添加超时时间等 ifmutex.acquire(2): 11.同步应用 可以使用互斥锁完成多个任务,有序的进程工作,这就是线程的同步 12.生产者与消费者模式 ①Python的Queue模块中提供了同步的、线程安全的队列类,包括FIFO(先入先出)队列 Queue,LIFO(后入先出)队列LifoQueue,和优先级队列PriorityQueue ②这些队列都实现了锁原语(可以理解为原子操作,即要么不做,要么就做完),能够在多线程中直接使用 ③可以使用队列来实现线程间的同步 ④Queue的说明: 对于Queue,在多线程通信之间扮演重要的角色 添加数据到队列中,使用put()方法 从队列中取数据,使用get()方法 判断队列中是否还有数据,使用qsize()方法 队列就是用来给生产者和消费者解耦的 13.ThreadLocal 在多线程环境下,每个线程都有自己的数据。一个线程使用自己的局部变量比使用全局变量好,因为局部变量只有线程自己能看见,不会影响其他线程,而全局变量的修改必须加锁一个thread.local()变量虽然是全局变量,但每个线程都只能读写自己线程的独立副本,互不干扰。thread.local()解决了参数在一个线程中各个函数之间互相传递的问题 14.异步 ①同步调用就是你喊你朋友吃饭,你朋友在忙,你就一直在那等,等你朋友忙完了,你们一起去 ②异步调用就是你喊你朋友吃饭,你朋友说知道了,待会忙完去找你 ,你就去做别的了 pool.apply_async(func=test,callback=test2)#callback是回调 进程整理代码 1. getpid()、getppid() importos rpid=os.fork() ifrpid<0: print("fork调用失败") elifrpid==0: print("我是子进程(%s),我的父进程是(%s)"%(os.getpid(),os.getppid())) x+=1 else: print("我是父进程(%s),我的子进程是(%s)"%(os.getpid(),rpid)) print("父子进程都可以执行这里的代码") 2.多进程修改全局变量 importos importtime num=0 #注意,fork函数,只在Unix/Linux/Mac上运行,windows不可以 pid=os.fork() ifpid==0: num+=1 print('哈哈1---num=%d'%num) else: time.sleep(1) num+=1 print('哈哈2---num=%d'%num) 3.进程的创建-Process子类 frommultiprocessingimportProcess importtime importos #继承Process类 classProcess_Class(Process): #因为Process类本身也有__init__方法,这个子类相当于重写了这个方法, #但这样就会带来一个问题,我们并没有完全的初始化一个Process类,所以就不能使用从这个类继承的一些方法和属性, #最好的方法就是将继承类本身传递给Process.__init__方法,完成这些初始化操作 def__init__(self,interval): Process.__init__(self) self.interval=interval #重写了Process类的run()方法 defrun(self): print("子进程(%s)开始执行,父进程为(%s)"%(os.getpid(),os.getppid())) t_start=time.time() time.sleep(self.interval) t_stop=time.time() print("(%s)执行结束,耗时%0.2f秒"%(os.getpid(),t_stop-t_start)) if__name__=="__main__": t_start=time.time() print("当前程序进程(%s)"%os.getpid()) p1=Process_Class(2) #对一个不包含target属性的Process类执行start()方法,就会运行这个类中的run()方法,所以这里会执行p1.run() p1.start() p1.join() t_stop=time.time() print("(%s)执行结束,耗时%0.2f"%(os.getpid(),t_stop-t_start)) 4.进程池pool frommultiprocessingimportPool importos,time,random defworker(msg): t_start=time.time() print("%s开始执行,进程号为%d"%(msg,os.getpid())) #random.random()随机生成0~1之间的浮点数 time.sleep(random.random()*2) t_stop=time.time() print(msg,"执行完毕,耗时%0.2f"%(t_stop-t_start)) po=Pool(3)#定义一个进程池,最大进程数3 foriinrange(0,10): #Pool.apply_async(要调用的目标,(传递给目标的参数元祖,)) #每次循环将会用空闲出来的子进程去调用目标 po.apply_async(worker,(i,)) print("----start----") po.close()#关闭进程池,关闭后po不再接收新的请求 po.join()#等待po中所有子进程执行完成,必须放在close语句之后 print("-----end-----") 5.进程Queue的读写 frommultiprocessingimportProcess,Queue importos,time,random #写数据进程执行的代码: defwrite(q): forvaluein['A','B','C']: print'Put%stoqueue...'%value q.put(value) time.sleep(random.random()) #读数据进程执行的代码: defread(q): whileTrue: ifnotq.empty(): value=q.get(True) print'Get%sfromqueue.'%value time.sleep(random.random()) else: break if__name__=='__main__': #父进程创建Queue,并传给各个子进程: q=Queue() pw=Process(target=write,args=(q,)) pr=Process(target=read,args=(q,)) #启动子进程pw,写入: pw.start() #等待pw结束: pw.join() #启动子进程pr,读取: pr.start() pr.join() #pr进程里是死循环,无法等待其结束,只能强行终止: print''" print'所有数据都写入并且读完' 线程整理代码 1.多线程 importthreading fromtimeimportsleep,ctime defsing(): foriinrange(3): print("正在唱歌...%d"%i) sleep(1) defdance(): foriinrange(3): print("正在跳舞...%d"%i) sleep(1) if__name__=='__main__': print('---开始---:%s'%ctime()) t1=threading.Thread(target=sing) t2=threading.Thread(target=dance) t1.start() t2.start() #sleep(5)#屏蔽此行代码,试试看,程序是否会立马结束? print('---结束---:%s'%ctime()) 2.多线程-共享全局变量 fromthreadingimportThread importtime g_num=100 defwork1(): globalg_num foriinrange(3): g_num+=1 print("----inwork1,g_numis%d---"%g_num) defwork2(): globalg_num print("----inwork2,g_numis%d---"%g_num) print("---线程创建之前g_numis%d---"%g_num) t1=Thread(target=work1) t1.start() #延时一会,保证t1线程中的事情做完 time.sleep(1) t2=Thread(target=work2) t2.start() 3.死锁 importthreading importtime classMyThread1(threading.Thread): defrun(self): ifmutexA.acquire(): print(self.name+'----do1---up----') time.sleep(1) ifmutexB.acquire(): print(self.name+'----do1---down----') mutexB.release() mutexA.release() classMyThread2(threading.Thread): defrun(self): ifmutexB.acquire(): print(self.name+'----do2---up----') time.sleep(1) ifmutexA.acquire(): print(self.name+'----do2---down----') mutexA.release() mutexB.release() mutexA=threading.Lock() mutexB=threading.Lock() if__name__=='__main__': t1=MyThread1() t2=MyThread2() t1.start() t2.start() 4.生产者和消费者模式 importthreading importtime #python2中 fromQueueimportQueue #python3中 #fromqueueimportQueue classProducer(threading.Thread): defrun(self): globalqueue count=0 whileTrue: ifqueue.qsize()<1000: foriinrange(100): count=count+1 msg='生成产品'+str(count) queue.put(msg) print(msg) time.sleep(0.5) classConsumer(threading.Thread): defrun(self): globalqueue whileTrue: ifqueue.qsize()>100: foriinrange(3): msg=self.name+'消费了'+queue.get() print(msg) time.sleep(1) if__name__=='__main__': queue=Queue() foriinrange(500): queue.put('初始产品'+str(i))
优秀的个人博客,低调大师

传送网系列笔记【全】

【申明:本系列为读书笔记,仅供自我学习】 目录 传送网基础知识 刚性通道时代——PDH 刚性通道时代——SDH 刚性通道时代——保护 刚性通道时代——MSTP 刚性通道时代——架构 光通信高速干道——波分复用 光通信高速干道——OTN(上) 光通信高速干道——OTN(下) MPLS VS MSTP 分组传送网——PTN/IPRAN 分组传送网——LTE/QoS/保护/时钟同步 本文转自Grodd51CTO博客,原文链接:http://blog.51cto.com/juispan/1970711,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Fragment使用全解析

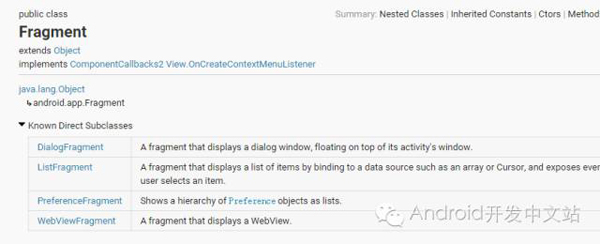
Fragment的使用可谓是老生常谈了~~~ 1、概述 自API 11引入Fragment之后,Fragment可谓风靡一时,现在大部分项目都或多或少的用到了Fragment,其更轻量级,更加适用屏幕,更加方便UI设计等优势。说了这么多什么是Fragment呢? Fragment:碎片,碎片是一个应用程序的用户界面和行为能够被放置在一个活动上。在其核心,它代表了一个特定的操作或界面,运行在一个更大的活动上。代表界面是因为可作为View在布局中进行使用,代表特定操作是因为包含生命周期可进行逻辑操作。简言之,Fragment就是一个带生命周期的组件。(若有问题恳请指正!) Fragment的特点: 生命周期必须依赖于Activity,当Activity被销毁,所有的碎片将被摧毁。(自己曾经踩坑) 轻量级,轻量切换。 方便处理平板、Phone的界面差异。 2、继承结构和生命周期 继承结构: Fragment直接继承Object,有四个直接子类,我个人对它的子类使用甚少。 生命周期: Fragment的生命周期在图上标注的很清楚了就不赘述了。该图是很久之前收藏的,已忘记原出处,在此感谢原作者! 3、基本使用 1).静态使用 静态使用就是Fragment相当于控件一样在布局中使用。 TestFragment.java 继承Fragment重写onCreateView方法 /** *Createdbymagicon2016年9月27日. */ publicclassTestFragmentextendsFragment{ @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer, BundlesavedInstanceState){ Viewview=inflater.inflate(R.layout.fragment_main,container); ImageViewimg=(ImageView)view.findViewById(R.id.img); img.setOnClickListener(newView.OnClickListener(){ @Override publicvoidonClick(Viewv){ Toast.makeText(getActivity(),"这是一个fragment",Toast.LENGTH_SHORT).show(); } }); returnview; } } fragment_main.xml <RelativeLayoutxmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent"> <ImageView android:id="@+id/img" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_centerInParent="true" android:src="@drawable/img"/> </RelativeLayout> MainActivity.java 里面其实什么也没干。 /** *Createdbymagicon2016年9月27日. */ publicclassMainActivityextendsActivity{ @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); } } activity_main.xml <RelativeLayoutxmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent"> <fragment android:id="@+id/id_fragment" android:layout_width="match_parent" android:layout_height="match_parent" class="com.magic.test_fragment.TestFragment"/> </RelativeLayout> 使用 fragment 标签添加碎片,通过class指定碎片的完整类名。 运行效果: 2).动态使用 动态使用就是向Fragment布局容器中动态添加、替换、移除、隐藏、显示Fragment。 CommonFragment.java /** *Createdbymagicon2016年9月27日.通用Fragment */ @SuppressLint("ValidFragment") publicclassCommonFragmentextendsFragment{ Stringdesc; publicCommonFragment(Stringdesc){ super(); this.desc=desc; } @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer, BundlesavedInstanceState){ Viewview=inflater.inflate(R.layout.fragment_common,container,false); TextViewtev=(TextView)view.findViewById(R.id.tev); System.out.println(desc); tev.setText(desc); returnview; } } 通过构造方法传递数据的形式向TextView上设置内容。 fragment_common.xml <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical"> <TextView android:id="@+id/tev" android:layout_width="match_parent" android:layout_height="match_parent" android:gravity="center" android:textColor="@color/mainOrange"/> </LinearLayout> MainActivity.java /** *Createdbymagicon2016年9月27日.底部tab+fragment */ publicclassMainActivityextendsActivityimplementsOnClickListener{ TextViewtev_tab1,tev_tab2,tev_tab3,tev_tab4; //fragment事务类 FragmentTransactionft; //fragment CommonFragmenttabFragment1,tabFragment2,tabFragment3,tabFragment4; @SuppressLint("CommitTransaction") @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main2); initView(); ft=getFragmentManager().beginTransaction(); tabFragment1=newCommonFragment("Tab1"); //替换 ft.replace(R.id.container,tabFragment1); //提交 ft.commit(); } //初始化控件 privatevoidinitView(){ tev_tab1=(TextView)findViewById(R.id.tev_tab1); tev_tab2=(TextView)findViewById(R.id.tev_tab2); tev_tab3=(TextView)findViewById(R.id.tev_tab3); tev_tab4=(TextView)findViewById(R.id.tev_tab4); tev_tab1.setOnClickListener(this); tev_tab2.setOnClickListener(this); tev_tab3.setOnClickListener(this); tev_tab4.setOnClickListener(this); } @Override publicvoidonClick(Viewv){ FragmentTransactionft=getFragmentManager().beginTransaction(); switch(v.getId()){ caseR.id.tev_tab1: ft.replace(R.id.container,tabFragment1); break; caseR.id.tev_tab2: if(tabFragment2==null){ tabFragment2=newCommonFragment("Tab2"); } ft.replace(R.id.container,tabFragment2); break; caseR.id.tev_tab3: if(tabFragment3==null){ tabFragment3=newCommonFragment("Tab3"); } ft.replace(R.id.container,tabFragment3); break; caseR.id.tev_tab4: if(tabFragment4==null){ tabFragment4=newCommonFragment("Tab4"); } ft.replace(R.id.container,tabFragment4); break; } //提交 ft.commit(); } } activity_main2.xml <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical"> <FrameLayout android:id="@+id/container" android:layout_width="match_parent" android:layout_height="0dp" android:layout_weight="1"/> <LinearLayout android:layout_width="match_parent" android:layout_height="50dp" android:background="@color/mainTextBlack" android:orientation="horizontal"> <TextView android:id="@+id/tev_tab1" android:layout_width="0dp" android:layout_height="match_parent" android:layout_weight="1" android:gravity="center" android:text="Tab1" android:textColor="@color/white"/> <TextView android:id="@+id/tev_tab2" android:layout_width="0dp" android:layout_height="match_parent" android:layout_weight="1" android:gravity="center" android:text="Tab2" android:textColor="@color/white"/> <TextView android:id="@+id/tev_tab3" android:layout_width="0dp" android:layout_height="match_parent" android:layout_weight="1" android:gravity="center" android:text="Tab3" android:textColor="@color/white"/> <TextView android:id="@+id/tev_tab4" android:layout_width="0dp" android:layout_height="match_parent" android:layout_weight="1" android:gravity="center" android:text="Tab4" android:textColor="@color/white"/> </LinearLayout> </LinearLayout> 通过 FrameLayout 标签创建Fragment的容器,底部四个Tab添加监听事件用于动态更换FrameLayout容器中的Fragment。 运行效果: 4、相关类及主要方法 FragmentManager碎片管理器,抽象类,具体实现在Android-support-v4.jar中的FragmentManagerImpl类中。 //获取FragmentManager对象 FragmentManagermanager=getFragmentManager(); FragmentTransaction碎片事务类,抽象类,具体实现在BackStackRecord类中。添加、删除、替换等操作其实最终的实现还是在FragmentManagerImpl类中。 //获取FragmentTransaction对象 FragmentTransactiontransaction=manager.beginTransaction(); //添加fragment transaction.add(); transaction.add(containerViewId,fragment,tag); //将被添加到容器的现有fragment替换 transaction.replace(); //删除一个现有的fragment transaction.remove(); //保存当前fragment数据,避免视图重绘 transaction.hide(); //显示以前隐藏的fragment transaction.show(); //这两个方法会触发fragment中的onHiddenChanged(booleanhidden)回调 //显示之前数据实例不会被销毁,但是视图层次依然会被销毁,即会调用onDestoryView和onCreateView transaction.addToBackStack(null); //事务提交 transaction.commit(); Fragment 碎片类 Fragmentfragment=newFragment(); //返回此fragment当前关联的Activity fragment.getActivity(); //设置数据 fragment.setArguments(newBundle()); //获取数据 fragment.getArguments(); //返回与该fragment作用的FragmentManager fragment.getFragmentManager(); //获取标签名 fragment.getTag(); //当隐藏状态改变的时候回调 //onHiddenChanged(true); 有兴趣大家可以去Read The Fucking Source,反正我看的比较头大……. 5、其它 未完待续…… 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

Docker 容器测试全探索

当我们构建好Docker镜像并利用多套容器共同组合成应用程序,建立起持续交付通道,了解了如何将新创建的镜像纳入到生产或者测试环境当中之后,新的问题来了——我们该如何测试自己的Docker容器? 测试的策略多种多样,反映了各种各样的测试性格:天真型,懒人省事型,超前理想主义型,完美主义处女座型……那么你是哪一型? 下面我们就对其各自的方案利弊进行逐一分析。 “天真”型方案 大多数人会将此作为默认方案。其利用CI服务器实现任务执行。在这项方案中,开发人员利用Docker作为软件包管理器,其实际效果优于jar/rpm/deb方案。CI服务器对应用程序代码进行编译,而后执行测试(包括单元、服务及功能等)。Docker中的build可复用以生成新的镜像,由此生成的镜像不仅包含应用程序的“二进制代码”,同时亦拥有运行时所必需的依赖性及配置。 不过为了实现应用程序的可移植性,我们需要放弃开发与测试的可移植能力。在这种情况下,我们无法在CI之外重新建立同样的开发与测试环境。为了创始这样一套新的测试环境,我们需要设置测试工具(正确版本与插件)、配置运行时与操作系统设定,同时获取相同版本的测试脚本与测试数据。 为了解决上述难题,我们需要考虑以下方案。 应用&测试容器方案 现在我们尝试创建单一捆绑包,其中应用程序“二进制代码”中包含全部必需的软件包、测试工具(包括对应版本)、测试工具插件、测试脚本以及其它各类测试环境元素。 这套方案的优势包括: 测试环境自身拥有可重复性——我们能够在CI、开发、分段或者生产环境当中使用完全相同的测试工具实现完全相同的测试效果。 我们能够立足特定时间点捕捉测试脚本,所以可将其复用于任意环境。 我们不需要对测试工具进行二次设置与配置——其已经成为镜像中的组成部分。 但这种方式也存在着显著弊端: 镜像体积直线增长——这是因为其中包含有测试工具、必要软件包、测试脚本甚至是测试数据。 特定测试配置可能对镜像运行时环境造成污染,甚至引入不必要的依赖性(集成测试中需要用到)。 我们还需要考虑如何处理测试结果与记录日志;如何将其导出以及向哪里导出。 通过以下经过简化的 Dockerfile,我们可以了解上述方案的整个流程。 FROM "<bases image>":"<version>" WORKDIR "<path>" # install packages required to run app and tests RUN apt-get update && apt-get install -y \ "<app runtime> and <dependencies>" \ # add app runtime and required packages "<test tools> and <dependencies>" \ # add testing tools and required packages && rm -rf /var/lib/apt/lists/* # copy app files COPY app app COPY run.sh run.sh # copy test scripts COPY tests tests # copy "main" test command COPY test.sh test.sh # ... EXPOSE, RUN, ADD ... for app and test environment # main app command CMD [run.sh, "<app arguments>"] # it's not possible to have multiple CMD commands, but this is the "main" test command # CMD [/test.sh, "<test arguments>"] 点此下载Dockerfile。 毫无疑问,应该有更好的容器内测试方案可供选择。 测试感知型容器方案 目前,Docker承诺以“Build -> Ship -> Run”这一简单操作完成镜像构建、发布至注册表并在其它位置运行等任务。不过恕我直言,其中还缺少了Test这一重要环节。正确且完整的流程应该是Build -> Test -> Ship -> Run。 ​ 下面让我们看看能够为Docker命令提供“测试友好”型语法与扩展的Dockerfile是如何建立而成的。当然,其中并不涉及真正的语法,只是我个人更偏好这样表述。我定义出了自己的“理想”版本(真的只是理想版本,仅供大家借鉴其中的思想,小数注),大家应该能够看出其中可用于实践的指导思路。 ONTEST [INSTRUCTION] 首先定义一条特殊的ONTEST指令,其与现有ONBUILD指令非常相似。ONTEST指令会向镜像添加一条触发指令,其在随后镜像接受测试时自动执行。任意build指令都可被注册为触发条件。 ONTEST指令可由一条新的docker test命令进行识别。 docker test [OPTIONS] IMAGE [COMMAND] [ARG...] 事实上,docker test命令的语法与docker run命令非常相似,二者只存在一项区别:前者会自动生成一套新的“可测试”镜像,甚至为其提供:-test 标签(向原始镜像标签中添加‘test’标签)。此可测试镜像将由初始应用镜像生成,执行全部build操作,于ONTEST命令后进行定义并执行ONTEST CMD(或者ONTEST ENTRYPOINT)。其中若测试发生错误,docker test命令应当返回一段非零代码。此测试结果应当被写入至自动生成且指向/var/tests/results文件夹的VOLUME。 下面我们来看看经过修改的Dockerfile——其中包含新的ONTEST指令。 FROM "<base image>":"<version>" WORKDIR "<path>" # install packages required to run app RUN apt-get update && apt-get install -y \ "<app runtime> and <dependencies>" \ # add app runtime and required packages && rm -rf /var/lib/apt/lists/* # install packages required to run tests ONTEST RUN apt-get update && apt-get install -y \ "<test tools> and <dependencies>" \ # add testing tools and required packages && rm -rf /var/lib/apt/lists/* # copy app files COPY app app COPY run.sh run.sh # copy test scripts ONTEST COPY tests tests # copy "main" test command ONTEST COPY test.sh test.sh # auto-generated volume for test results # ONTEST VOLUME "/var/tests/results" # ... EXPOSE, RUN, ADD ... for app and test environment # main app command CMD [run.sh, "<app arguments>"] # main test command ONTEST CMD [/test.sh, "<test arguments>"] 点此下载Dockerfile。 如何实现“测试感知容器” 我们相信,Docker应该会将docker-test作为容器管理生命周期中的组成部分。当下我们都需要更为简便的解决方案,因此我在这里提出一套接近于理想情况的实现办法。 如之前所提到,Docker拥有ONBUILD这样一条非常实用的指令。该指令允许我们在已经成功的build之上触发另一build指令。其基本思路是在运行docker-test命令的同时,使用ONBUILD指令。 以下为docker-test命令的执行流程: docker-test将在应用程序Dockerfile当中搜索ONBUILD指令,而后…… 利用初始Dockerfile生成一条临时的Dockerfile.test 执行docker build -f Dockerfile.test [OPTIONS] PATH,其中包含受docker build命令支持的其它选项:-test将自动被添加至tag选项当中。 如果构建成功,则执行 docker run -v ./tests/results:/var/tests/results [OPTIONS] IMAGE:TAG-test [COMMAND] [ARG...] 移除Dockerfile.test文件 那么,为什么不创建一个无需配合ONBUILD指令的Dockerfile.test文件? 这是因为,为了测试正确的镜像(及标签),我们需要保证FROM始终在测试目标的image:tag中得到更新。 不过前面提到的方案仍然存在局限——其不适用于“onbuild”镜像(即用于自动化构建应用的镜像),例如Maven:onbuild。 下面来看一条简单的docker-test命令实现流程。其中强调了一大重要概念:docker-test命令应当能够处理build与run命令选项,同时能够妥善处理错误状况。 #!/bin/bash image="app" tag="latest" echo "FROM ${image}:${tag}" > Dockerfile.test && docker build -t "${image}:${tag}-test" -f Dockerfile.test . && docker run -it --rm -v $(pwd)/tests/results:/var/tests/results "${image}:${tag}-test" && rm Dockerfile.test 让我们把注意力集中在最值得关注的重要部分。 集成测试型容器方案 假设我们的应用程序由数十甚至数百项微服务构建而成,同时假设我们已经拥有一套自动化CI/CD通道,其中每项微服务都由CI进行构建与测试,并在之后被部署到某种环境当中(例如测试、分段或者生产环境)。听起来不错,对吧?我们的CI会对各项微服务进行分别测试——运行单元与服务测试(或者API合同测试)。甚至有可能进行微集成测试——即将测试运行在特设的子系统之上(例如使用docker compose)。 但这又会带来一些新问题: • 实际集成测试或者长期运行测试该如何完成(例如性能与压力测试)? • 弹性测试该如何实现(例如‘混乱猴子’测试)? • 如何实现安全扫描? • 那些需要耗费较长时间且运行在完整操作系统之上的测试与扫描要如何完成? 应该有一种更好的办法来替代这种直接将新的微服务版本交付至生产环境的作法,我们也需要更为密切的监控手段。 应当存在一类特殊的集成测试容器。这些容器将仅包含测试工具与测试元素:测试脚本、测试数据、测试环境配置等等。为了简化此类容器的编排与自动化流程,我们应当定义并遵循某些约定并使用元数据标签(Dockerfile中的LABEL指令)。 集成测试标签 test.type – 测试类型,负责定义integration; 可属于 integration, performance, security, chaos 或者其它任意文本之一; 此标签代表其属于一套集成测试容器 test.results – 用于存放测试结果的VOLUME ; 默认位置为 /var/tests/results test.XXX -任何其它相关元数据,仅使用test.后缀名作为标签名称 集成测试容器 集成测试容器其实就是一种常规Docker容器,其中不包含任何应用程序逻辑及代码。它的惟一用途就是创建可重复且可移植的测试流程。以下为建议纳入集成测试容器的内容: 测试工具 - Phantom.js, Selenium, Chakram, Gatling, … 测试工具运行时 - Node.js, JVM, Python, Ruby, … 测试管理配置 – 环境变量, 配置文件, 引导脚本, … 测试 -作为经过编译的软件包或者脚本文件存在 测试数据 – 任何用于测试的数据文件类型: json, csv, txt, xml, … 测试启动脚本 -用于运行测试的部分“main”启动脚本,仅负责创建test.sh并借此启动该测试工具。 集成测试容器应当运行在全部微服务都已经部署到位的运营环境之下,包括测试、分段或者生产环境。这些容器可与其它服务采取完全一致的部署方式。其利用同样的网络层,因此能够访问多项其它服务;使用选定的服务发现方法(通常为DNS)。在实际集成测试当中,我们必须对多项服务进行访问——旨在模拟并验证自身系统是否能够在多种不同环境下正常运行。将集成测试纳入应用服务容器不仅会增加容器自身体积,同时亦会在各服务之间带来不必要的依赖性。因此,我们将所有依赖性都限制在集成测试容器当中。一旦测试(以及相关测试工具)被打包在该容器内,我们亦可在包括开发者设备在内的任意环境下重复运行同样的测试流程。大家还能够实现回滚,即根据需要运行任意集成测试容器版本。 原文发布时间为:2016-08-17 本文来自云栖社区合作伙伴“Linux中国”

优秀的个人博客,低调大师

hadoop 2.6全分布安装

环境:centos 6.6 + hadoop2.6 虚拟机:(vmware fusion 7.0.0) 虚拟机hostname / IP地址 master / 192.168.187.102 slave01 / 192.168.187.103 slave02 / 192.168.187.104 注:前三个步骤都是准备工作,如果已经完成,可直接进入步骤四 步骤一: 先在3台虚拟机上,设置hostname及修改hosts文件 1.1 先正确设置各虚拟机的hostname sudo vi /etc/sysconfig/network 将HOSTNAME=后的内容,改成想要的机器名 1.2 修改hosts文件 sudo vi /etc/hosts 192.168.187.102 master 192.168.187.103 slave01 192.168.187.104 slave02 这样,就不用记IP了 这一步完成后,最好重启一次系统,以便生效。然后可以用ping master(或slave01、slave02)试下,正常的话,应该能ping通 注:hostname不要命名为“xxx.01,xxx.02”之类以“.数字”结尾,否则到最后hadoop的NameNode服务将启动失败。 步骤二:在3台虚拟机上安装jdk yum install java 注:hadoop是java写的,jdk是必须的。上述命令,会安装openjdk最基本的运行时,没有源码和javac等其它工具。如果要安装javac等编译工具及源码 yum install java-1.7.0-openjdk-devel yum install java-1.7.0-openjdk-src 另外openjdk安装后,不会默许设置JAVA_HOME环境变量,要查看安装后的目录,可以用命令 sudo update-alternatives --config java 看到 默认jre目录为:/usr/lib/java/jvm/jre-1.7.0-openjdk.x86_64 如要设置环境变量,可用命令 sudo vi /etc/profile 在最后添加 export JAVA_HOME=/usr/lib/jvm/java-1.7.0-openjdk-1.7.0.75.x86_64 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/jre/lib/dt.jar:$JAVA_HOME/jre/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 注:如果不喜欢openjdk,想安装oracle官方的jdk,可按下面步骤操作 a) rpm -qa | grep java 即:查看当前已经安装的跟java相关的包,如果显示有openjdk在其中 b) yum -y remove java 一般这样就会卸载干净,执行完以后,再运行 a)中的rpm -qa | grep java看看,如果还有残留,可运行 rpm -e --nodeps tzdata-java-2015a-1.el6.noarch (最后的部分为要删除的包名,即刚才查出来的结果) 重新安装sun jdk,先从官网下载安装文件 a) 上传rpm安装文件到虚拟机,参考下面的命令 scp jdk-7u51-linux-x64.rpm root@master:/home/hadoop/ b) 到虚拟机上,执行安装 rpm -ivh jdk-7u51-linux-x64.rpm c) 然后修改环境变量 sudo vi /etc/profile,在最后加下面三行 export JAVA_HOME=/usr/java/jdk1.7.0_51 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 保存退出,然后输入 source /etc/profile 以便让新环境变量生效 注:如果机器上之前用 yum install hadoop之类的命令安装过低版本的hadoop,也必须先卸载干净 步骤三:在3台虚拟机上创建专门用户hadoop useradd hadoop (创建用户) passwd hadoop (设置密码,为简单起见,3台机器上的hadoop密码最好设置成一样,比如hadoop123) 为了方便,建议将hadoop加入root用户组,操作方法: 先以root身份登录,然后输入 usermod -g root hadoop ,执行完后hadoop即归属于root组了,可以再输入 id hadoop 查看输出验证一下,如果看到类似下面的输出: uid=502(hadoop) gid=0(root) 组=0(root) 就表示OK了 步骤四:配置ssh免密码登录 hadoop工作时,各节点要相互通讯,正常情况下linux之间通讯要提供用户名、密码(目的是保证通讯安全),如果需要人工干预输入密码,显然不方便,做这一步的目的,是让各节点能自动通过安全认证,不影响正常通讯。 4.1 先在master上,生成公钥、私钥对 以hadoop身份登录到系统 cd (进入个人主目录,默认为/home/hadoop) ssh-keygen -t rsa -P '' (注:最后是二个单引号) 即:以rsa算法,生成公钥、私钥对,-P ''表示空密码。该命令运行完后,会在个人主目录下生成.ssh目录,里面会有二个文件id_rsa(私钥) ,id_rsa.pub(公钥) 4.2 导入公钥 cat .ssh/id_rsa.pub >> .ssh/authorized_keys 执行完以后,可以在本机上测试下,用ssh连接自己,即:ssh localhost (或ssh master),如果不幸还是提示要输入密码,说明还没起作用,还有一个关键的操作 chmod 600 .ssh/authorized_keys (修改文件权限,否则不起作用) 然后再测试下 ssh localhost ,如果不需要输入密码,就连接成功,表示ok,一台机器已经搞定了。 4.3 在其它机器上生成公钥、密钥,并将公钥文件复制到master a) 以hadoop身份登录其它二台机器 slave01、slave02,执行 ssh-keygen -t rsa -P '' 生成公钥、密钥 b) 然后用scp命令,把公钥文件发放给master(即:刚才已经搞定的那台机器) slave01上: scp .ssh/id_rsa.pub hadoop@master:/home/hadoop/id_rsa_01.pub slave02上: scp .ssh/id_rsa.pub hadoop@master:/home/hadoop/id_rsa_02.pub 这二行执行完后,回到master中,查看下/home/hadoop目录,应该有二个新文件id_rsa_01.pub、id_rsa_02.pub,然后在master上,导入这二个公钥 cat id_rsa_01.pub >> .ssh/authorized_keys cat id_rsa_02.pub >> .ssh/authorized_keys 这样,master这台机器上,就有所有3台机器的公钥了。 4.4 将master上的“最全”公钥,复制到其它机器 a) 继续保持在master上, scp .ssh/authorized_keys hadoop@slave01:/home/hadoop/.ssh/authorized_keys scp .ssh/authorized_keys hadoop@slave02:/home/hadoop/.ssh/authorized_keys b) 修改其它机器上authorized_keys文件的权限 slave01以及slave02机器上,均执行命令 chmod 600 .ssh/authorized_keys 4.5 验证 在每个虚拟机上,均用 ssh 其它机器的hostname 验证下,如果能正常无密码连接成功,表示ok 小结:该步骤非常重要,主要思路是在各节点上生成公钥、私钥,然后将公钥发放其它所有节点。RSA算法是非对称加密算法,仅公布“公钥”,只要私钥不外泄,还是不能解密的,所以安全性依然有保障。 如果本步骤失败,根据我个人经验,多半是权限问题,请检查hadoop是否具有足够权限,建议将hadoop加入sudoers列表及root用户组。另外,这里也整理了一些SSH免密码设置失败的原因,请移步ssh 免密码设置失败原因总结 步骤五:上传并解压hadoop2.6 a)在本机上,用scp命令上传hadoop2.6到master scphadoop-2.6.0.tar.gz hadoop@master:/home/hadoop/ b) 以hadoop身份登录到master,运行以下命令解压 tar -zxvfhadoop-2.6.0.tar.gz 步骤六:修改配置 一共有7个文件要修改: $HADOOP_HOME/etc/hadoop/hadoop-env.sh $HADOOP_HOME/etc/hadoop/yarn-env.sh $HADOOP_HOME/etc/hadoop/core-site.xml $HADOOP_HOME/etc/hadoop/hdfs-site.xml $HADOOP_HOME/etc/hadoop/mapred-site.xml $HADOOP_HOME/etc/hadoop/yarn-site.xml $HADOOP_HOME/etc/hadoop/slaves 其中$HADOOP_HOME表示hadoop根目录,本文中默认为/home/hadoop/hadoop-2.6.0 a) hadoop-env.sh 、yarn-env.sh 这二个文件主要是修改JAVA_HOME后的目录,改成实际本机jdk所在目录位置 vi etc/hadoop/hadoop-env.sh (及 vi etc/hadoop/yarn-env.sh) 找到下面这行的位置,改成(jdk目录位置,大家根据实际情况修改) export JAVA_HOME=/usr/java/jdk1.7.0_51 另外 hadoop-env.sh中 , 建议加上这句: export HADOOP_PREFIX=/home/hadoop/hadoop-2.6.0 b) core-site.xml 参考下面的内容修改: 1 <?xml version="1.0" encoding="UTF-8"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>fs.defaultFS</name> 6 <value>hdfs://master:9000</value> 7 </property> 8 <property> 9 <name>hadoop.tmp.dir</name> 10 <value>/home/hadoop/tmp</value> 11 </property> 12 </configuration> 注:/home/hadoop/tmp 目录如不存在,则先mkdir手动创建 core-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-common/core-default.xml c) hdfs-site.xml 1 <?xml version="1.0" encoding="UTF-8"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>dfs.datanode.ipc.address</name> 6 <value>0.0.0.0:50020</value> 7 </property> 8 <property> 9 <name>dfs.datanode.http.address</name> 10 <value>0.0.0.0:50075</value> 11 </property> 12 <property> 13 <name>dfs.replication</name> 14 <value>2</value> 15 </property> 16 </configuration> 注:dfs.replication表示数据副本数,一般不大于datanode的节点数。 hdfs-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-hdfs/hdfs-default.xml d)mapred-site.xml 1 <?xml version="1.0"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>mapreduce.framework.name</name> 6 <value>yarn</value> 7 </property> 8 </configuration> mapred-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-mapreduce-client/hadoop-mapreduce-client-core/mapred-default.xml e)yarn-site.xml 1 <?xml version="1.0"?> 2 <configuration> 3 <property> 4 <name>yarn.nodemanager.aux-services</name> 5 <value>mapreduce_shuffle</value> 6 </property> 7 </configuration> yarn-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-yarn/hadoop-yarn-common/yarn-default.xml 另外,hadoop 1.x与2.x相比, 1.x中的很多参数已经被标识为过时,具体可参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-common/DeprecatedProperties.html 最后一个文件slaves暂时不管(可以先用mv slaves slaves.bak将它改名),上述配置弄好后,就可以在master上启用 NameNode测试了,方法: $HADOOP_HOME/bin/hdfs namenode –format 先格式化 15/02/12 21:29:53 INFO namenode.FSImage: Allocated new BlockPoolId: BP-85825581-192.168.187.102-1423747793784 15/02/12 21:29:53 INFO common.Storage: Storage directory /home/hadoop/tmp/dfs/name has been successfully formatted. 等看到这个时,表示格式化ok $HADOOP_HOME/sbin/start-dfs.sh 启动完成后,输入jps查看进程,如果看到以下二个进程: 5161 SecondaryNameNode 4989 NameNode 表示master节点基本ok了 再输入$HADOOP_HOME/sbin/start-yarn.sh ,完成后,再输入jps查看进程 5161 SecondaryNameNode 5320 ResourceManager 4989 NameNode 如果看到这3个进程,表示yarn也ok了 f) 修改slaves 如果刚才用mv slaves slaves.bak对该文件重命名过,先运行 mv slaves.bak slaves 把名字改回来,再 vi slaves 编辑该文件,输入 slave01 slave02 保存退出,最后运行 $HADOOP_HOME/sbin/stop-dfs.sh $HADOOP_HOME/sbin/stop-yarn.sh 停掉刚才启动的服务 步骤七:将master上的hadoop目录复制到slave01,slave02 仍然保持在master机器上 cd 先进入主目录 scp -r hadoop-2.6.0 hadoop@slave01:/home/hadoop/ scp -r hadoop-2.6.0 hadoop@slave02:/home/hadoop/ 注:slave01、slave02上的hadoop临时目录(tmp)及数据目录(data),仍然要先手动创建。 步骤八:验证 master节点上,重新启动 $HADOOP_HOME/sbin/start-dfs.sh $HADOOP_HOME/sbin/start-yarn.sh 顺利的话,master节点上有几下3个进程: 7482 ResourceManager 7335 SecondaryNameNode 7159 NameNode slave01、slave02上有几下2个进程: 2296 DataNode 2398 NodeManager 同时可浏览: http://master:50070/ http://master:8088/ 查看状态 另外也可以通过 bin/hdfs dfsadmin -report 查看hdfs的状态报告 其它注意事项: a) master(即:namenode节点)若要重新格式化,请先清空各datanode上的data目录(最好连tmp目录也一起清空),否则格式化完成后,启动dfs时,datanode会启动失败 b) 如果觉得master机器上只运行namenode比较浪费,想把master也当成一个datanode,直接在slaves文件里,添加一行master即可 c) 为了方便操作,可修改/etc/profile,把hadoop所需的lib目录,先加到CLASSPATH环境变量中,同时把hadoop/bin,hadoop/sbin目录也加入到PATH变量中,可参考下面的内容: export HADOOP_HOME=/home/hadoop/hadoop-2.6.0 export JAVA_HOME=/usr/java/jdk1.7.0_51 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.6.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.6.0.jar:$HADOOP_HOME/share/hadoop/common/lib/commons-cli-1.2.jar export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/sbin:$HADOOP_HOME/bin 参考文档:Hadoop MapReduce Next Generation - Cluster Setup

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册