首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

手把手教你监督学习(附python实战代码)

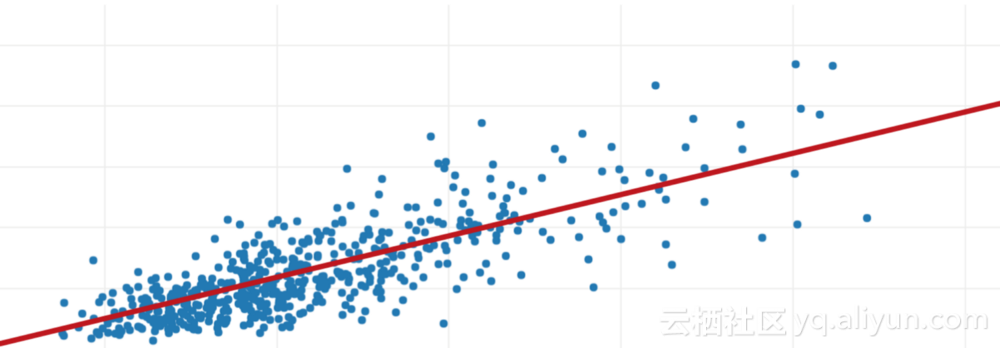
为什么选择人工智能和机器学习? 人类的未来是人工智能/机器学习。任何不了解的它们的人很快就会发现自己已经落后了。在这个充满创新的世界中醒来感觉科技越来越像魔术。有许多种方法和技术来执行人工智能和机器学习来解决实时问题,其中监督学习是最常用的方法之一。 什么是监督学习? 在监督学习中,我们从导入包含训练属性和目标属性的数据集开始。监督式学习算法将学习训练样本与其相关目标变量之间的关系,并应用该学习关系对全新输入(无目标)进行分类。 为了说明监督学习是如何工作的,让我们从一个根据他学习的小时数来预测学生分数的例子。 在数学上,Y = f(X)+ C 其中,f将是标记学生为考试准备的小时数之间的关系; X是INPUT(他准备的小时数); Y是输出(标记在考试中得分的学生); C将是随机错误。 监督学习算法的最终目标是以给定的新输入X,输出最大精度预测Y。算

优秀的个人博客,低调大师

Python-入门的第一个爬虫例子

前言: 此文为大家入门爬虫来做一次简单的例子,让大家更直观的来了解爬虫。 本次我们利用 Requests 和正则表达式来抓取豆瓣电影的相关内容。 一、本次目标: 我们要提取出豆瓣电影-正在上映电影名称、评分、图片的信息,提取的站点 URL 为:https://movie.douban.com/cinema/nowplaying/beijing/,提取的结果我们以文件形式保存下来。 二、准备工作 确保已经正确安装 Requests 库,无论是 Windows、Linux 还是 Mac,都可以通过 Pip 这个包管理工具来安装。 安装命令:pip3 install requests 正则表达式相关教程见:正则表达式总结版、正则表达式 三、抓取分析 抓取的目标站点为:https://movie.douban.com/cinema/nowplaying/beijing/,打开之后便可以查看到正在上映的电影信息,如图所示: 20180512142639_result.png 页面中显示的有效信息有影片名称、评分、图片等信息。这样我们获取该页面结果之后再用正则表达式提取出相关信息就可以得到所有正在上映的电影信息了。 四、抓取页面源代码 接下来我们用代码实现抓取页面源代码过程,首先实现一个 get_page() 方法,传入 url 参数,然后将抓取的页面结果返回,然后再实现一个 main() 方法调用一下,初步代码实现如下: def get_page(url): try: response = requests.get(url) if response.status_code == 200: return response.text return None except RequestException: return None def main(): url = "https://movie.douban.com/cinema/nowplaying/beijing/" html = get_page(url) 五、正则提取电影信息 接下来我们回到网页看一下页面的真实源码,在开发者工具中 Network 监听,然后查看一下源代码,如图所示: 20180512142636_result.png 注意这里不要在 Elements 选项卡直接查看源码,此处的源码可能经过 JavaScript 的操作而和原始请求的不同,我们需要从 Network 选项卡部分查看原始请求得到的源码。 查看其中的一个条目的源代码如图所示: 20180512143404_result.png 可以看到一部电影信息对应的源代码是一个 li 节点,我们用正则表达式来提取这里面的一些电影信息,首先我们需要提取它的电影名称信息,而它的电影名称信息是在 class 为 "list-item"的节点后,所以这里利用非贪婪匹配来提取data-title属性的信息,正则表达式写为: <li.*?list-item.*?data-title="(.*?)".*?> 使用相同判断方法来提取data-score属性的信息,正则表达式写为: <li.*?list-item.*?data-title="(.*?)".*?data-score="(.*?)".*?> 随后我们需要提取电影的图片,可以看到在a节点内部有img节点,该节点的src属性是图片的链接,所以在这里提取img节点的src属性,所以正则可以改写如下: <li.*?list-item.*?data-title="(.*?)".*?data-score="(.*?)".*?>.*?<img.*?src="(.*?)".*?/> 这样我们一个正则表达式可以匹配一个电影的结果,里面匹配了3个信息,接下来我们通过调用 findall() 方法提取出所有的内容,实现一个 parse_page() 方法如下: def parse_page(html): pattern = re.compile('<li.*?list-item.*?data-title="(.*?)".*?data-score="(.*?)".*?>.*?<img.*?src="(.*?)".*?/>', re.S) items = re.findall(pattern, html) for item in items: yield{ 'title': item[0], 'score': item[1], 'image': item[2], } 这样我们就可以成功提取出电影的图片、标题、评分内容了,并把它赋值为一个个的字典,形成结构化数据,运行结果如下: {'image': 'https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2517753454.jpg', 'title': '复仇者联盟3:无限战争', 'score': '8.6'} {'image': 'https://img1.doubanio.com/view/photo/s_ratio_poster/public/p2517769368.jpg', 'title': '小公主艾薇拉与神秘王国', 'score': '0'} {'image': 'https://img1.doubanio.com/view/photo/s_ratio_poster/public/p2519994468.jpg', 'title': '后来的我们', 'score': '5.8'} {'image': 'https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2520200484.jpg', 'title': '我是你妈', 'score': '5.1'} {'image': 'https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2520197352.jpg', 'title': '战犬瑞克斯', 'score': '7.0'} 到此为止我们就成功提取了此页的电影信息。 六、写入文件 随后我们将提取的结果写入文件,在这里直接写入到一个文本文件中,通过 json 库的 dumps() 方法实现字典的序列化,并指定 ensure_ascii 参数为 False,这样可以保证输出的结果是中文形式而不是 Unicode 编码,代码实现如下: def write_to_file(content): with open('xiaoxi.txt', 'a', encoding='utf-8')as f: print(type(json.dumps(content))) f.write(json.dumps(content,ensure_ascii=False)) 通过调用 write_to_json() 方法即可实现将字典写入到文本文件的过程,此处的 content 参数就是一部电影的提取结果,是一个字典。 七、整合代码 到此为止,我们 的爬虫就全部完成了,再稍微整理一下,完整的代码如下:源码见git # -*- coding: utf-8 -*- # @Time : 2018/5/12 上午11:37 # @Author : xiaoxi # @File : test.py import json import re import requests from requests import RequestException def get_page(url): try: response = requests.get(url) if response.status_code == 200: return response.text return None except RequestException: return None def parse_page(html): pattern = re.compile('<li.*?list-item.*?data-title="(.*?)".*?data-score="(.*?)".*?>.*?<img.*?src="(.*?)".*?/>', re.S) items = re.findall(pattern, html) for item in items: yield{ 'title': item[0], 'score': item[1], 'image': item[2], } def write_to_file(content): with open('xiaoxi.txt', 'a', encoding='utf-8')as f: # print(type(json.dumps(content))) f.write(json.dumps(content,ensure_ascii=False)) def main(): url = "https://movie.douban.com/cinema/nowplaying/beijing/" html = get_page(url) for item in parse_page(html): print(item) write_to_file(item) if __name__ == '__main__': main() 运行之后,可以看到电影信息也已全部保存到了文本文件中,大功告成! 八、运行结果 最后我们运行一下代码,类似的输出结果如下: {'image': 'https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2517753454.jpg', 'title': '复仇者联盟3:无限战争', 'score': '8.6'} {'image': 'https://img1.doubanio.com/view/photo/s_ratio_poster/public/p2517769368.jpg', 'title': '小公主艾薇拉与神秘王国', 'score': '0'} ... {'image': 'https://img1.doubanio.com/view/photo/s_ratio_poster/public/p2519994468.jpg', 'title': '后来的我们', 'score': '5.8'} 中间的部分输出结果已省略,可以看到这样就成功把电影信息爬取下来了。 这时我们再看下文本文件,结果如图所示: 20180512143407_result.png 以上~~你对爬虫有进一步的了解了么? 请继续关注我的爬虫系列~~~

优秀的个人博客,低调大师

深度学习精要之CapsuleNets理论与实践(附Python代码)

神经网络于上世纪50年代提出,直到最近十年里才得以发展迅速,正改变着我们世界的方方面面。从图像分类到自然语言处理,研究人员正在对不同领域建立深层神经网络模型并取得相关的突破性成果。但是随着深度学习的进一步发展,又面临着新的瓶颈——只对成熟网络模型进行加深加宽操作。直到最近,Hinton老爷子提出了新的概念——胶囊网络(Capsule Networks),它提高了传统方法的有效性和可理解性。 本文将讲解胶囊网络受欢迎的原因以及通过实际代码来加强和巩固对该概念的理解。 为什么胶囊网络受到这么多的关注? 对于每种网络结构而言,一般用MINST手写体数据集验证其性能。对于识别数字手写体问题,即给定一个简单的灰度图,用户需要预测它所显示的数字。这是一个非结构化的数字图像识别问题,使用深度学习算法能够获得最佳性能。本文将以这个数据集测试三个深度学习

优秀的个人博客,低调大师

带你入门Python数据挖掘与机器学习(附代码、实例)

一、数据挖掘与机器学习技术简介 什么是数据挖掘?数据挖掘指的是对现有的一些数据进行相应的处理和分析,最终得到数据与数据之间深层次关系的一种技术。例如在对超市货品进行摆放时,牛奶到底是和面包摆放在一起销量更高,还是和其他商品摆在一起销量更高。数据挖掘技术就可以用于解决这类问题。具体来说,超市的货品摆放问题可以划分为关联分析类场景。 在日常生活中,数据挖掘技术应用的非常广泛。例如对于商户而言,常常需要对其客户的等级(svip、vip、普通客户等)进行划分,这时候可以将一部分客户数据作为训练数据,另一部分客户数据作为测试数据。然后将训练数据输入到模型中进行训练,在训练完成后,输入另一部分数据进行测试,最终实现客户等级的自动划分。其他类似的应用例子还有验证码识别、水果品质自动筛选等。 那么机器学习技术又是什么呢?一言以蔽之,凡是让机器通过我们所

优秀的个人博客,低调大师

pip安装python包出错:Could not find a version that satisfies the requirement...

欢迎关注大数据和人工智能技术文章发布的微信公众号:清研学堂,在这里你可以学到夜白(作者笔名)精心整理的笔记,让我们每天进步一点点,让优秀成为一种习惯! 今天用pip安装skimage时报错: 这是因为网络的问题,需要使用国内的镜像源来加速,比如豆瓣源 命令改为: pip install scikit-image-i http://pypi.douban.com/simple/ --trusted-host pypi.douban.com 或者 pip3 install scikit-image-i http://pypi.douban.com/simple/ --trusted-host pypi.douban.com 最后成功安装:

优秀的个人博客,低调大师

Python对字典分别按键(key)和值(value)进行排序

方法一: # 使用 sorted 函数进行排序 ''' sorted(iterable,key,reverse) , sorted 一共有 iterable,key,reverse 这三个参数 ; 其中 iterable 表示可以迭代的对象,例如可以是 dict.items() 、 dict.keys() 等 key 是一个函数,用来选取参与比较的元素, reverse 则是用来指定排序是倒序还是顺序, reverse=true 则是倒序, reverse=false 时则是顺序,默认时 reverse=false 。 ''' # 初始化字典 dict_data={ 6 : 9 , 10 : 5 , 3 : 11 , 8 : 2 , 7 : 6 } 1、对字典按键(key)进行排序 # 对字典按键( key )进行排序(默认由小到大) test_data_0= sorted (dict_data. keys ()) # 输出结果 print (test_data_0) #[3, 6, 7, 8, 10] test_data_1= sorted (dict_data. items (), key = lambda x:x[ 0 ]) # 输出结果 print (test_data_1) #[(3, 11), (6, 9), (7, 6), (8, 2), (10, 5)] 2、对字典按值(value)进行排序 # 对字典按值( value )进行排序(默认由小到大) test_data_2= sorted (dict_data. items (), key = lambda x:x[ 1 ]) # 输出结果 print (test_data_2) #[('8', 2), ('10', 5), ('7', 6), ('6', 9), ('3', 11)] test_data_3= sorted (dict_data. items (), key = lambda x:x[ 1 ], reverse = True ) # 输出结果 print (test_data_3) #[('3', 11), ('6', 9), ('7', 6), ('10', 5), ('8', 2)] 方法二: import operator # 初始化字典 dict_data={ 6 : 9 , 10 : 5 , 3 : 11 , 8 : 2 , 7 : 6 } # 按键( key )进行排序 test_data_4= sorted (dict_data. items (), key =operator. itemgetter ( 0 )) test_data_5= sorted (dict_data. items (), key =operator. itemgetter ( 0 ), reverse = True ) print (test_data_4) #[(3, 11), (6, 9), (7, 6), (8, 2), (10, 5)] print (test_data_5) #[(10, 5), (8, 2), (7, 6), (6, 9), (3, 11)] # 按值( value )进行排序 test_data_6= sorted (dict_data. items (), key =operator. itemgetter ( 1 )) test_data_7= sorted (dict_data. items (), key =operator. itemgetter ( 1 ), reverse = True ) print (test_data_6) #[(8, 2), (10, 5), (7, 6), (6, 9), (3, 11)] print (test_data_7) #[(3, 11), (6, 9), (7, 6), (10, 5), (8, 2)]
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册