首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5672篇文章
优秀的个人博客,低调大师

机器视觉领域国产日益崛起 定制化成重要方向

近几十年来,我国机器视觉领域快速发展,视觉系统因其非接触、速度快、精度高、现场抗干扰能力强等突出优点,使机器视觉技术在农业、工业、医学等领域得到了广泛应用。长期以来,机器视觉原配件和软件算法被这些国外巨头企业垄断,我国主要依靠进口国外整套系统,价格昂贵。通过在某个细分市场推出定制化的系统产品,为细分领域客户解决需求,成为我国机器视觉企业发展的重要方向。 3D机器视觉系统.jpg 一个典型的机器视觉系统包括光源、镜头、高速相机、图像采集卡和视觉处理器5大部分。国外对机器视觉部件产品和软件的研发已经有数十年的历史。瞄准了机器视觉的广泛应用前景,许多国外厂商纷纷进入这一领域. 在硬件产品上,国内企业也多有突破。包括相机、软件包、镜头、光源等机器视觉的核心部件.产品体系日益完善,在某些方面可以与国外厂商媲美。 我国机器视觉行业虽然起步较晚,但发展速度极快,已成为继美国和日本之后的全球第三大机器视觉市场。我国机器视觉系统也主要应用在半导体及电子制造领域,较为突出的是在SMT贴片、AOI/AXI设备以及连接器检测上。市政交通、汽车、食品和包装机械等众多行业对于机器视觉的需求也在快速释放,推动着机器视觉行业迅猛发展。 随着机器视觉的成本逐渐降低,有更多的方案、更强大的硬件、更聪明的算法出现,再加上物联网连接所有装置,机器视觉将成为绝佳的数据收集工具。朗锐智科(www.lrist.com)认为在自动驾驶、医学诊断、保险索赔的破损评估、水位监测、农业生产等领域具有广泛的应用前景。

优秀的个人博客,低调大师

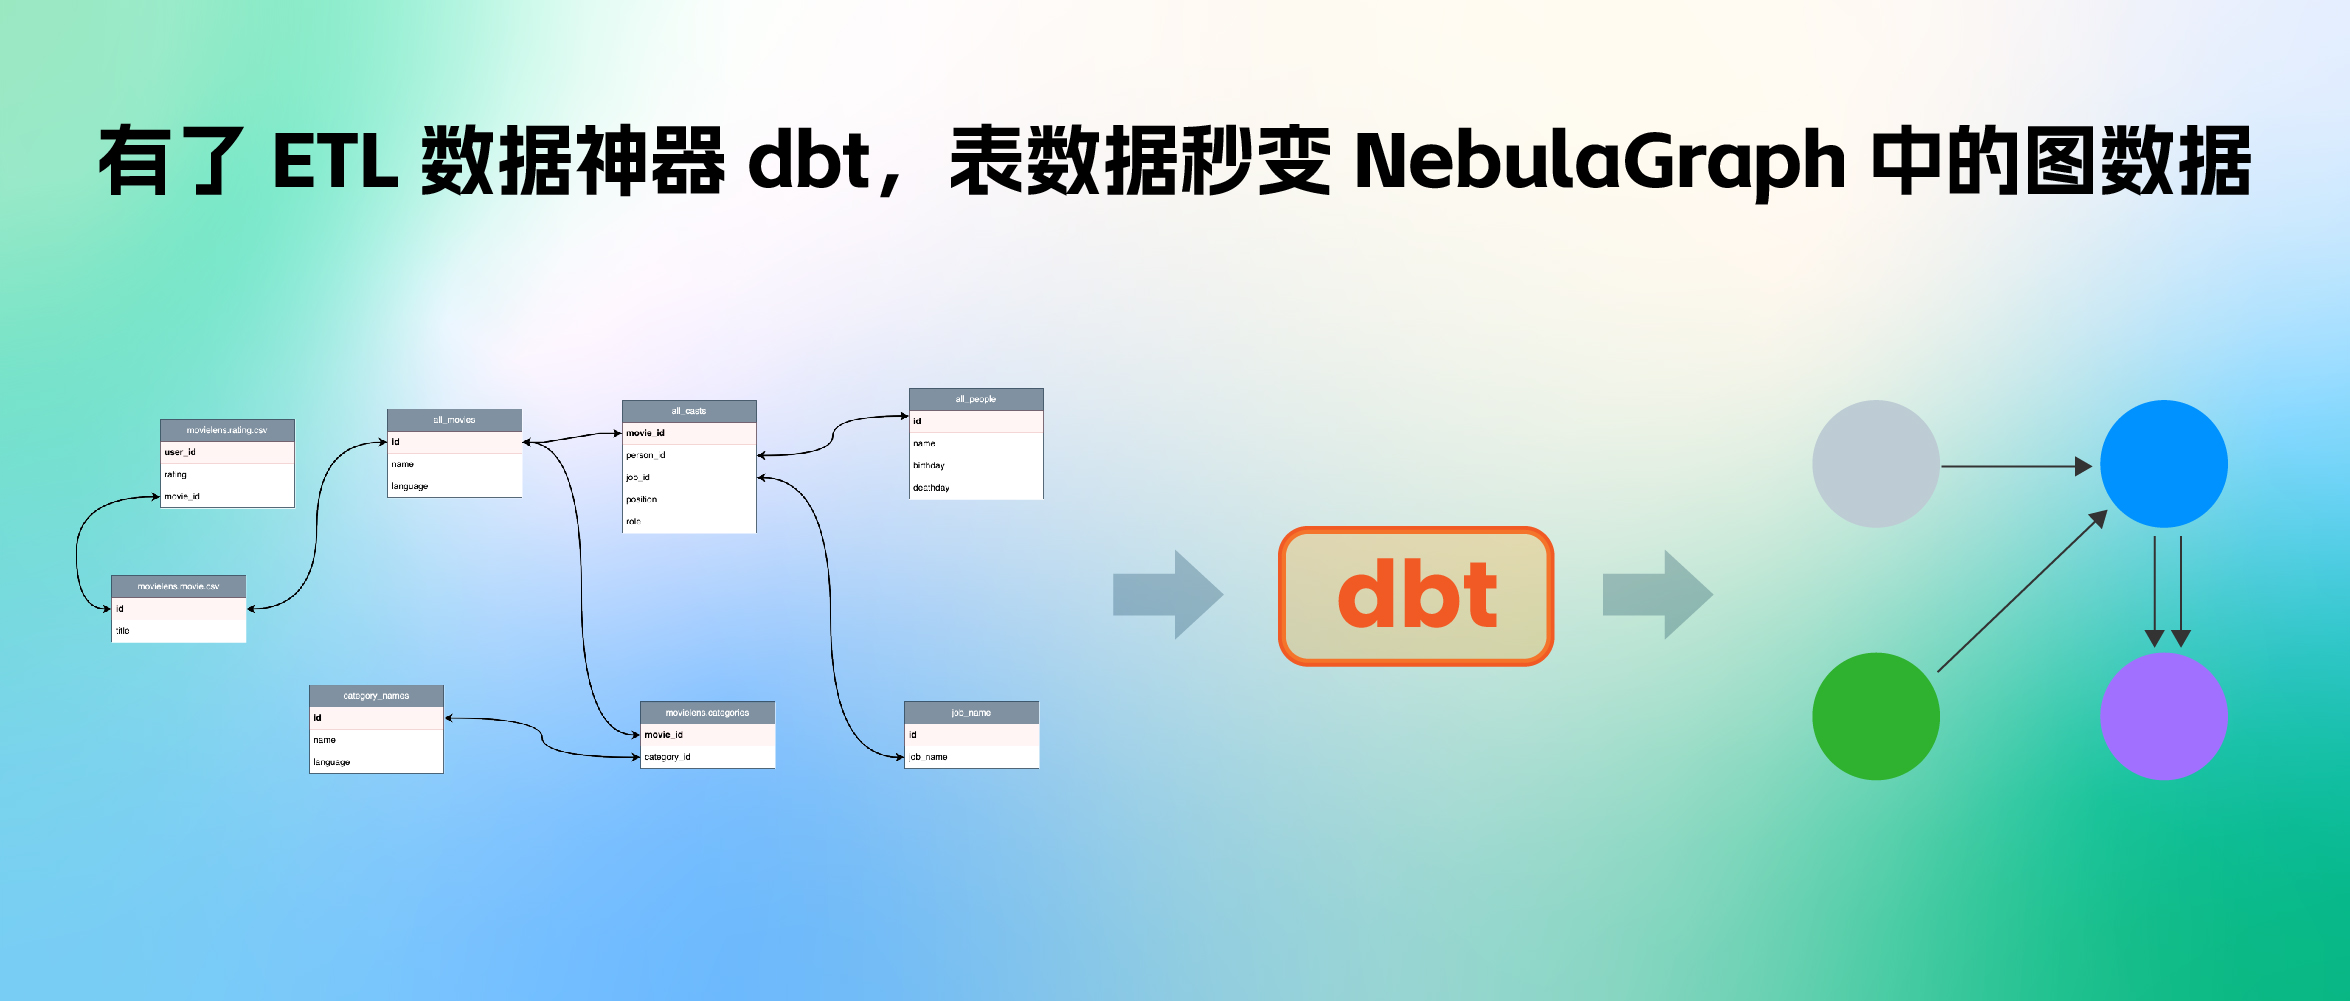
有了 ETL 数据神器 dbt,表数据秒变 NebulaGraph 中的图数据

本文搭配同主题分享视频阅读更佳,《多数据源的数据治理实践》 如果你装好某款数据库产品,比如:分布式图数据库 NebulaGrpah,跃跃欲试的第一步是不是就让它干活搞数据呢?好的,现在问题来了,如何把相对原始的数据处理、建模并导入 NebulaGraph 呢?本文是一个端到端的示例演示,从多数据源聚合数据,清理、利用 dbt 转换成 NebulaGraph 建模的属性图点边记录,最后导入成图谱的全流程。 构建知识图谱 现在假设你是一个类似于 Netflix、爱奇艺之类的视频服务提供商,我们需要利用图数据库搭建一个 用户-电影 的知识图谱,来辅助、支撑视频推荐、问答和推荐理由等常见由图谱支撑的场景。由于时间的关系,这里先用我们熟悉的老朋友——图数据库 NebulaGraph 来搞定知识图谱。 一般来说,知识图谱需要的数据会有不同的数据来源,比如一些公开的 API、数仓中的不同数据库、静态文件。这时候,我们如果要构建知识图谱,需要以下 3 个步骤: 分析可能获取的数据; 选取关心的关联关系,图建模; 抽取关联关系,导入图数据库。 数据源 这里我们会用到两个数据源 OMDB 和 MovieLens。 OMDB 是一个开放的电影数据库,将用来模拟公司内部的业务数据。我们可以获得的信息有: 电影 电影的分类 电影中的工作人员,包括:导演、动作指导、演员、后期制作等人员信息 电影封面、宣传片等电影信息 MovieLens 是一个开放的数据集,用来模拟公司内部的用户数据。我们可以获得的信息有: 用户 电影 用户对电影的评分交互 图建模 在之前的文章《基于图数据库的推荐系统》 里我们介绍了推荐系统的图数据库基本用法。在那篇文章中,内容过滤侧重关注 用户-->电影、电影-->分类、电影-->演员、电影-->导演 等关系,协同过滤则关注 用户-->电影 的关系,以及推荐理由服务关注以上所有的关系。 总结起来,我们需要的边有: watched(rate(double)) with_genre directed_by acted_by 结合已有信息,相对应地将顶点中可能需要被关注的信息作为属性,给出点 tag 的初始规划: user(user_id) movie(name) person(name, birthdate) genre(name) 表数据到知识图谱的映射 有了目标的图谱结构定义,我们来看看手上的数据如何映射到它。 OMDB 数据 首先是 OMDB 数据,它由很多表组成,比如 all_movies 这张表,存储了所有的电影、以及它们在不同语言下的名字: movie_id name language_iso_639_1 official_translation 1 Cowboy Bebop de 1 1 Cowboy Bebop en 1 2 Ariel - Abgebrannt in Helsinki de 0 3 Shadows in Paradise en 0 3 Im Schatten des Paradieses de 0 3 Schatten im Paradies de 1 而 all_casts 表格中保有所有电影相关的工作人员: movie_id person_id job_id role position 11 1 21 1 11 1 13 1 11 2 15 Luke Skywalker 1 11 3 15 Han Solo 3 11 4 15 Leia Organa 2 但是这里的每一个人的姓名等信息、以及他/她在电影中任职的职位,则分别在表 job_names 和 all_people 中: 这里讲解下 job_names 表,1 代表编剧、2 代表制作人。有意思的是,和上表的电影 id 与 name 字段一样,job_id 到 name 也是一对多的关系,因为 OMDB 中的数据都是多语言的。 job_id name language_iso_639_1 1 Autoren de 1 Writing Department en 1 Departamento de redacción es 1 Département écriture fr 1 Scenariusz pl 2 Produzenten de 2 Production Department en 下面这张表是 all_people: id name birthday deathday gender 1 George Lucas 1944-05-14 \N 0 2 Mark Hamill 1951-09-25 \N 0 3 Harrison Ford 1942-07-13 \N 0 4 Carrie Fisher 1956-10-21 2016-12-27 1 5 Peter Cushing 1913-05-26 1994-08-11 0 6 Anthony Daniels 1946-02-21 \N 0 这是在数据来源是表结构、RDBMS 中,是一个很典型的情况,所以对于 movie <-[directed_by]-(person) 这个关系,就涉及了 all_movies,all_casts,all_people,job_names 四个表格: directed_by 起点 person_id 在 all_casts 之中 终点 movie_id 在 all_casts 之中 条件是 job_id 为 job_names 之中的 “director” movie person_id 在 all_casts 之中 名字来自 all_movies 中按 id 查找,language 为 “en” person movie_id 在 all_casts 之中 name、birthday 在 all_people 之中 所有 OMDB 中我们关心的表的关联如图: MovieLens 数据集 上面我们讲述了单数据源的场景,只有单一数据源、数据表或者数仓的数据。但在真实场景中,我们还需要从其他源头收取数据,并聚合起来。在本例中,我们还需要从 MovieLens 的数据集中抽取需要的知识。 这里,涉及到 MovieLens 数据集,我们利用的只有:用户-->电影,这一条关系。 movies.csv 数据: movieId title genres 1 Toy Story (1995) Adventure 2 Jumanji (1995) Adventure 3 Grumpier Old Men (1995) Comedy 4 Waiting to Exhale (1995) Comedy ratings.csv 数据: userId movieId rating timestamp 1 1 4 964982703 1 3 4 964981247 1 6 4 964982224 从两个表的数据预览似乎可以得出: watched 起点来自于 ratings.csv 中的 userId 终点来自于 ratings.csv 中的 movieId 评分来自于 ratings.csv 中的 rating user 来自于 ratings.csv 中的 userId 然而,细心的你们一定发现 MovieLens 数据集中的 movieId 和来自于 OMDB 中的电影 id 完全是不同的两套体系。如果我们需要让它们关联起来,需要将 MovieLens 里的 movieId 转换成为 OMDB 中的电影 id,而它们之间的关联条件则是电影的标题。 但是,通观察我们知道: OMDB 电影中标题是多语言的 MovieLens 中的标题结尾带有(1995)这样的年份信息 所以我们最终的结论为 watched 起点来自于 ratings.csv 中的 userId 终点来自于 ratings.csv 中的 movieId,终点要从 movies.csv 中的 title ,在 OMDB 之中查找,得到 OMDB 的 movie_id。查找条件为去掉年份,从 OMDB 的英文标题中进行匹配 评分来自于 ratings.csv 中的 rating user 来自于 ratings.csv 中的 userId 现在,这个表格之间的关系如下 映射数据到图谱(属性图) 到这里小结下,我们需要对多个数据源中的不同表格(或者表格形式的 CSV 文件)进行聚合,这样的对应关系如图所示:蓝色虚线表示图中顶点的数据信息来源,粉色虚线表示边信息的来源。 此外,我们还要对不同表中个体的 id 进行格式化,比如 user_id,是自增的数字,我们要转换成全局唯一的 vertex_id。比较方便的方法是在现有 id 的基础上增加字符串前缀,比如 u_。 最终,以 user -[watched]-> movie 关系为例,我们可以处理得到这样的表结构数据: user_id rating title omdb_movie_id u_1 5 Seven (a.k.a. Se7en) 807 u_1 5 Star Wars: Episode IV - A New Hope 11 u_1 5 Star Wars: Episode IV - A New Hope 10 u_1 4 Mask, The 832 u_1 3 Mrs. Doubtfire 832 其中每一行记录中存在三个图上的结构信息: user 顶点 id movie 顶点 id watched 边的 rating 值 数据工具 好的,我们现在已经完成了数据的分析与建模设计,在进入”抽取关联关系,导入图数据库“环节之前,先介绍一下我们要用到的工具。 ”抽取关联关系“可以简单认为是 ETL 中的 Extract 和 Transform。本质上就是工程上执行数据映射与转换的工作,市面上有很多不同风格的工具、开源项目可以做 ETL 这件事。这里我们用到我个人比较喜欢的工具:dbt。 数据转换利器 dbt dbt 是一个开源的数据转换工具,它有非常成熟的社区和生态,可以在大多数主流数仓之中进行高效、可控、高质量的数据转换工作。无论是临时的转换工作(ad-hoc),还是在给定的定时 pipeline 中进行复杂编排,dbt 都可以很好胜任。它的一大特色就是使用 SQL LIKE 语言去描述数据转换的规则。此外,它还基于 GitOps 可以非常优雅地多人协作、维护超大规模数据团队里复杂的数据处理作业。而 dbt 内置的数据测试能力可以很好地控制数据质量,可复现、控制数据问题。 dbt 不仅有许多集成的子项目,还能和像是 Meltano、Airflow、Amundsen、Superset 之类的优秀开源项目有机地结合,形成一整套现代的数据基础设施体系。对具体实践感兴趣的同学可以阅读文末「参考资料中」的数据治理实践。 简单来说,dbt 是一个 Python 写的命令行工具。针对不同的项目,我们可以用 dbt 创建特定格式的项目文件夹,它会自带一个 .yaml 配置文件。我们要在配置文件里指定数据转换的来源信息在哪里,目标在哪里(处理之后的数据存储的地方,可能是 PostgreSQL、BigQuery、Spark 等)。在数据源中,我们用 yaml 文件和 .sql 文件一起描述了”从哪里取哪些数据,如何做变换,输出什么“的信息。 这个截图就是 dbt 官方文档中的示例项目中的文件和配置,可以看到 models/example 里的信息就是最核心的数据转换 transform 的规则,而所有的其他数据都是和这个数据转换相关的元数据,这些 dbt 项目文件非常适合用 git 来进行维护,进行现代、自动化的 DataOps。 NebulaGraph 数据导入 经过 dbt 对数据进行处理之后,我们可以得到直接映射到不同类型的顶点、边、及其属性的表结构的中间数据,它们可以是 CSV 的文件形式,也可以是数仓中的表,甚至可能是 Spark 中的 DataFrame。而将它们导入 NebulaGraph 有不同的选择,可以选数据导入工具 NebulaGraph Exchange、NebulaGraph Importer、NebulaGraph Spark Connector 的任意一款。 在这里,用最简单的 NebulaGraph Importer 作为例子。 NebulaGraph Importer 是一个用 Golang 写的开源数据工具。它可以编译成一个单文件的二进制,通过预配置的 yaml 格式的文件,读取指定 CSV 文件映射到 NebulaGraph 中点、边关系数据。 实操 现在,我们来实操下如何利用 dbt + NebulaGraph Importer 进行多数据源聚合、转换,再导入 NebulaGraph 的过程。整个项目的代码已经开源,仓库在 https://github.com/wey-gu/movie-recommendation-dataset 上,欢迎大家参考、共建。 整个实操过程如下: 将源数据简单清洗、导入数仓 PostgreSQL(EL) 用 dbt 对数据进行转换 Transform、导出为 CSV 文件 用 NebulaGraph Importer 将 CSV 导入 NebulaGraph(L) 准备 dbt 环境 dbt 是一个 Python 项目,我们在一个虚拟的 Python 3 环境里安装好 dbt 和 dbt-postgres。 python3 -m venv .venv source .venv/bin/activate pip install dbt-postgres 创建一个 dbt 项目,并进入到空的项目里: dbt init dbt_project cd dbt_project 看看里边的文件吧: $ tree . . |-- README.md # 项目说明 README |-- analyses |-- dbt_project.yml # 项目配置文件 |-- macros |-- models # transform 来源 | \-- example | |-- my_first_dbt_model.sql # 一个描述了如何从元数据中 SELECT 并处理的规则 | |-- my_second_dbt_model.sql | \-- schema.yml # 规则文件的元数据配置,描述了 sql 规则的属性 |-- seeds # 源数据如果是 CSV 文件,可以放到 seeds 里 |-- snapshots \-- tests 7 directories, 5 files 最后,咱们拉一个容器里的 Postgres 当做我们这个项目的数仓。如果你已经有各种其他数仓,就不需要这一步了,不过要把项目中的配置文件作相应的修改,并安装相应的 dbt 插件。 docker run --rm --name postgres \ -e POSTGRES_PASSWORD=nebula \ -e POSTGRES_USER=nebula \ -e POSTGRES_DB=warehouse -d \ -p 5432:5432 postgres 数据下载与预处理 我们把数据放到项目的 raw_data 下吧。 mkdir -p raw_data cd raw_data 注意,假设 raw_data 在 dbt_proeject 之下: tree .. .. |-- README.md |-- analyses |-- dbt_project.yml |-- macros |-- models | \-- example | |-- my_first_dbt_model.sql | |-- my_second_dbt_model.sql | \-- schema.yml |-- raw_data # 新建的目录 |-- seeds |-- snapshots \-- tests 8 directories, 5 files 我们把 OMDB 数据下载之后,再解压: wget www.omdb.org/data/all_people.csv.bz2 wget www.omdb.org/data/all_people_aliases.csv.bz2 wget www.omdb.org/data/people_links.csv.bz2 wget www.omdb.org/data/all_casts.csv.bz2 wget www.omdb.org/data/job_names.csv.bz2 wget www.omdb.org/data/all_characters.csv.bz2 wget www.omdb.org/data/movie_categories.csv.bz2 wget www.omdb.org/data/movie_keywords.csv.bz2 wget www.omdb.org/data/category_names.csv.bz2 wget www.omdb.org/data/all_categories.csv.bz2 wget www.omdb.org/data/all_movie_aliases_iso.csv.bz2 bunzip2 *.bz2 然后是 MovieLens 数据集的下载、解压: wget https://files.grouplens.org/datasets/movielens/ml-latest-small.zip unzip ml-latest-small.zip rm *.zip 在导入数仓进行转换 Transform 之前我们做一些数据的预处理,把它们放到 seeds 之下。 # 因为是实验项目,我们简单粗暴地去掉带有转义的引号的数据,因为它们会被认为是无效字符,处理之后的结果放到 seeds 下边。 grep -v '\\"' raw_data/all_movie_aliases_iso.csv > seeds/all_movie_aliases_iso.csv grep -v '\\"' raw_data/all_casts.csv > seeds/all_casts.csv grep -v '\\"' raw_data/all_characters.csv > seeds/all_characters.csv grep -v '\\"' raw_data/all_people.csv > seeds/all_people.csv grep -v '\\"' raw_data/category_names.csv > seeds/category_names.csv grep -v '\\"' raw_data/job_names.csv > seeds/job_names.csv # 下边的文件无需处理,直接放到 seeds 下边。 cp raw_data/movie_categories.csv seeds/movie_categories.csv cp raw_data/movie_keywords.csv seeds/movie_keywords.csv cp raw_data/all_categories.csv seeds/all_categories.csv cp raw_data/ml-latest-small/ratings.csv seeds/movielens_ratings.csv cp raw_data/ml-latest-small/movies.csv seeds/movielens_movies.csv 有了 seeds 下边的文件之后,可以用一个命令把他们导入到数仓里: dbt seed 执行过程因数仓而异,用本地的 Postgres 可能要等一会儿才能完成,执行结果大概是这样的: $ dbt seed 05:58:27 Running with dbt=1.3.0 05:58:27 Found 2 models, 4 tests, 0 snapshots, 0 analyses, 289 macros, 0 operations, 11 seed files, 0 sources, 0 exposures, 0 metrics 05:58:28 05:58:28 Concurrency: 8 threads (target='dev') 05:58:28 05:58:28 1 of 11 START seed file public.all_casts ....................................... [RUN] ... 07:10:11 1 of 11 OK loaded seed file public.all_casts ................................... [INSERT 1082228 in 4303.78s] 07:10:11 07:10:11 Finished running 11 seeds in 1 hours 11 minutes and 43.93 seconds (4303.93s). 07:10:11 07:10:11 Completed successfully 07:10:11 07:10:11 Done. PASS=11 WARN=0 ERROR=0 SKIP=0 TOTAL=11 撰写 Transform model 我们创建 model 如下: mkdir models/movie_recommedation touch models/movie_recommedation/user_watched_movies.sql touch models/movie_recommedation/schema.yml 这时候 models 中的文件结构大概是这样的: $ tree models models \-- movie_recommedation |-- user_watched_movies.sql \-- schema.yml 这个 model 下边目前只有一个规则,就是负责处理用户观看电影这条边上数据的 SQL 语句。 我们希望输出三列,所以 schema.yml 中的内容是: version: 2 models: - name: user_watched_movies description: "The edges between users and movies they have watched" columns: - name: user_id description: "user id" tests: - not_null - name: movie_id description: "movie id" tests: - not_null - name: rating description: "rating given by user to movie" tests: - not_null 注意,这里的 tests 的表达是对数据验证、测试的约束。有了它,我可以用 dbt 轻松地对数据质量进行测试、验收,比如:我们要求这里的三个字段都是 not_null。 然后,我们来写 SQL 吧,user_watched_movies.sql: {{ config(materialized='table') }} /* JOIN the movieielens_ratings table with the movieielens_movies table, and removing the movie title tailing the year of release */ WITH user_watched_movies AS( SELECT moveielens_ratings."userId", moveielens_ratings."movieId", moveielens_ratings.rating, REGEXP_REPLACE(moveielens_movies.title, ' \(\d{4}\)$', '') AS title, moveielens_movies.genres AS movielens_genres FROM moveielens_ratings JOIN moveielens_movies ON moveielens_movies."movieId" = moveielens_ratings."movieId" ) /* JOIN user_watched_movies table with all_movie_aliase_iso table where language is English the join condition is the movie title */ SELECT concat('u_',user_watched_movies."userId") AS user_id, user_watched_movies.rating, user_watched_movies.title, all_movie_aliases_iso."movie_id" AS OMDB_movie_id, user_watched_movies.movielens_genres FROM user_watched_movies JOIN all_movie_aliases_iso ON user_watched_movies.title LIKE CONCAT(all_movie_aliases_iso.name, '%') AND all_movie_aliases_iso.language_iso_639_1 = 'en' 而这个 SQL 做的事情就是绿色圆圈标注的部分: 从 movielens_ratings 中选 user id、movie id、rating、movie title(去掉年份),存成 user_watched_movies 的中间表格 movie title 从 movielens_movies 中 JOIN ,通过 movie_id 相同的匹配条件取得 从 user_watched_movies 中选 user id(增加前缀 u_)、rating、title、OMDB_movie_id OMDB_movie_id 从 all_movie_aliases_iso 中 JOIN,通过相似的电影姓名匹配 OMDB 电影中英文标题取得 最终的字段作为输出 当然,我们可以在 Postgres 的连接器中通过增加 LIMIT 快速调试自己的 SQL 语句。 现在我们来通过 dbt 执行、测试刚刚的规则: dbt run -m user_watched_movies 之后,我们应该就可以在 Postgres(数仓)中看到我们转换之后的一个表了。 类似的,如法炮制所有其他部分的 Transform 规则,我们就获得了这么多 model 了: $ tree models models \-- movie_recommedation |-- acted_by.sql |-- directed_by.sql |-- genres.sql |-- movies.sql |-- people.sql |-- schema.yml |-- user_watched_movies.sql \-- with_genre.sql 再对他们分别执行 transform: dbt run -m acted_by dbt run -m directed_by dbt run -m with_genre dbt run -m people dbt run -m genres dbt run -m movies 导出数据为 CSV 实际上,NebulaGraph Exchange 本身就支持把很多数据源(Postgres,ClickHouse,MySQL,Hive 等等)导入 NebulaGraph。只是在这个例子中,我们处理的数据量对于 NebulaGraph 来说非常非常小(只有百万级别的边而已),所以使用最轻量级的 NebulaGraph Importer 就足够了。而 NebulaGraph Importer 能消费的数据只有 CSV 文件,所以我们把刚才的表都输出为文件。 首先,我们进入 Postgres 的 Console,执行 COPY 命令 COPY acted_by TO '/tmp/acted_by.csv' WITH DELIMITER ',' CSV HEADER; COPY directed_by TO '/tmp/directed_by.csv' WITH DELIMITER ',' CSV HEADER; COPY with_genre TO '/tmp/with_genre.csv' WITH DELIMITER ',' CSV HEADER; COPY people TO '/tmp/people.csv' WITH DELIMITER ',' CSV HEADER; COPY movies TO '/tmp/movies.csv' WITH DELIMITER ',' CSV HEADER; COPY genres TO '/tmp/genres.csv' WITH DELIMITER ',' CSV HEADER; -- 对于 user_watched_movies 我们不输出表头,因为这个文件中记录了两种点、一种边,没法让 importer 通过约定好的表头自动导入,只能通过无表头的情况下指定第几列对应什么字段 COPY user_watched_movies TO '/tmp/user_watched_movies.csv' WITH DELIMITER ',' CSV; 再把 Postgres 容器里的文件导入到 to_nebulagraph 这个文件夹里: mkdir -p to_nebulagraph docker cp postgres:/tmp/. to_nebulagraph/ 导入 NebulaGraph 创建 NebulaGraph 集群 我们可以用 Nebula Up 一键拉起一个测试的 NebulaGraph 单机集群,导入所需数据: curl -fsSL nebula-up.siwei.io/install.sh | bash 创建 Schema 首先,我们创建一个叫做 moviegraph 的图空间。针对前面的建模,创建点边类型的结构 Schema: 先进入 NebulaGraph 的 Console: ~/.nebula-up/console.sh 再执行如下 DDL(Data Definiation Language): CREATE SPACE moviegraph(partition_num=10,replica_factor=1,vid_type=fixed_string(32)); :sleep 20 USE moviegraph; CREATE TAG person(name string, birthdate string); CREATE TAG movie(name string); CREATE TAG genre(name string); CREATE TAG user(user_id string); CREATE EDGE acted_by(); CREATE EDGE directed_by(); CREATE EDGE with_genre(); CREATE EDGE watched(rate float); exit 创建 NebulaGraph Importer 配置文件 这个文件是一个描述 CSV 文件和集群中点边数据对应关系的 YAML 文件。详细的格式可以参考文档:https://docs.nebula-graph.com.cn/master/nebula-importer/use-importer/,或者视频教程:https://www.bilibili.com/video/BV1ny4y1u7i4。 最终的配置文件我已经为大家写好了,在 https://github.com/wey-gu/movie-recommendation-dataset/blob/main/nebula-importer.yaml 可以下载得到。 这里,我们就直接下载我写好了的配置文件。注意,这个文件不应该是 dbt 项目文件的一部分,所以我们退出目录,向上一层,把它放到 dbt_proeject 外边: cd .. wget https://raw.githubusercontent.com/wey-gu/movie-recommendation-dataset/main/nebula-importer.yaml 开始导入 这一步,我们用容器化的 NebulaGraph Importer,避免了安装的步骤: docker run --rm -ti \ --network=nebula-net \ -v ${PWD}:/root/ \ -v ${PWD}/dbt_project/to_nebulagraph/:/data \ vesoft/nebula-importer:v3.2.0 \ --config /root/nebula-importer.yaml 很快,所有的数据就导入到 NebulaGraph 之中了。现在,我们可以通过 NebulaGraph Console,执行一些查询看看结果: 进入 Console: ~/.nebula-up/console.sh 进入图空间、执行 SHOW STATS: USE moviegraph; SHOW STATS; 结果: (root@nebula) [moviegraph]> SHOW STATS; +---------+---------------+---------+ | Type | Name | Count | +---------+---------------+---------+ | "Tag" | "genre" | 14397 | | "Tag" | "movie" | 20701 | | "Tag" | "person" | 263907 | | "Tag" | "user" | 610 | | "Edge" | "acted_by" | 673763 | | "Edge" | "directed_by" | 101949 | | "Edge" | "watched" | 31781 | | "Edge" | "with_genre" | 194009 | | "Space" | "vertices" | 299615 | | "Space" | "edges" | 1001502 | +---------+---------------+---------+ Got 10 rows (time spent 1693/15136 us) 通过 NebulaGraph Studio,我们也可以在可视化界面探索这个图谱。比如:在其中执行这个查询,看一下给用户 u_124 推荐电影 1891 的理由可能是什么? FIND NOLOOP PATH FROM "u_124" TO "1891" over * BIDIRECT UPTO 4 STEPS yield path as `p` | LIMIT 20 它的结果是:曾经喜欢的星战电影的大部分演职人员都也参与了这部同样是“奥斯卡获奖”且“经典”的电影。 总结 当我们打算把海量数据利用图数据库的能力进行知识转化、洞察分析的时候,往往第一步就是要做多数据源到图数据的转换、处理、建模。对于无从下手的新手们来说,一个可行的思路是从所有的相关信息出发,去设想最关注的关联关系,把边写出来,然后再罗列可以取得的点、以及需要的点、边上的属性。确定了初始的建模之后,就可以利用 ETL 工具把原始的数据清洗、ETL 成点、边类型的表结构,最后,利用导入工具导入 NebulaGraph。 借助于 dbt,我们可以版本控制、测试、迭代建模与数据转换,一点点进化、丰富构建的知识图谱。 参考资料 数据血缘治理:https://discuss.nebula-graph.com.cn/t/topic/11729 dbt 上手文档:https://docs.getdbt.com/docs/get-started/getting-started-dbt-core 如何选择 NebulaGraph 数据导入工具:www.siwei.io/sketches/nebula-data-import-options Postgres 文档:https://www.postgresql.org/docs/current/sql-copy.html 基于图数据库的推荐系统:https://discuss.nebula-graph.com.cn/t/topic/11491 谢谢你读完本文 (///▽///) 要来近距离快速体验一把图数据库吗?现在可以用用 NebulaGraph Cloud 来搭建自己的图数据系统哟,快来节省大量的部署安装时间来搞定业务吧~ NebulaGraph 阿里云计算巢现 30 天免费使用中,点击链接来用用图数据库吧~ 想看源码的小伙伴可以前往 GitHub 阅读、使用、(^з^)-☆ star 它 -> GitHub;和其他的 NebulaGraph 用户一起交流图数据库技术和应用技能,留下「你的名片」一起玩耍呢~

优秀的个人博客,低调大师

Fastcms v0.0.1 版本正式发布:潜心之作,即插即用的门户建站神器

Fastcms经过1年多时间的打磨,gitee上面200多次commit,v0.0.1第一个版本正式发布,后续会不断更新,持续维护。 Fastcms是真正意义上的插件化开源项目,支付,搜索,订单催付,附件水印,微信自动回复,微信扫码登录,等等都可以做成插件,即插即用,无需重启服务器。 Fastcms中的文章即是商品,可以付费下载,付费阅读,付费观看视频。 Fastcms不止是门户建站。。。 版本日志: 完成模板在线安装与卸载 完成插件在线安装与卸载 完成v0.0.1版本在线文档 完成api在线文档 完成插件以及模板的在线付费下载 版本更新日志 文档地址: fastcms在线文档

优秀的个人博客,低调大师

“节后综合征”疗愈神器,10分钟上手AI算法开发!

想要应用AI技术进行产业智能化升级,又担心缺乏计算机、数学等理论基础? AI算法训练完成,优化部署上线又是一个趟不过去的大坑? 别担心,今天就教大家应用一个开源项目——飞桨全流程开发工具PaddleX,快速开发AI算法并快速部署实现业务上线, 搭上人工智能的产业浪潮! 这个开源项目三次登录Github Daily全球趋势榜,2.7k 星标;不需要数学基础,不需要编程大牛,只要下载就可以快速开发AI算法模型并投产应用;还有工业制造、安防巡检、能源电力、卫星遥感、智能交通等行业海量的示例项目!所有代码全公开,让你可以一键利用云资源就可以运行,换数据就可以进行任务迁移,超低代码实现多环境、多硬件部署,实在是业界良心,“飘香四溢”啊~ 小编赶紧识趣的送上传送门: https://github.com/PaddlePaddle/PaddleX,建议小伙伴们Star收藏后再慢慢研究。 那这个项目到底有什么过人之处,又具体能做些什么呢?下面就展开来给大家详细介绍一下。 能做什么? 图像分类、目标检测、语义分割、实例分割任务全覆盖!还提供工业制造、安防巡检、能源电力、卫星遥感、智能交通等十多个行业的实际场景详细的示例工程! 工业制造:瑕疵检测、目标定位、智能抓取、自动分拣、产品计数 安防巡检:输电线路及基站本体异物检测,表计等设备检测及读数,异常喷洒、火情检测 智慧城市:车辆、行人、交通标志检测,卫星遥感图像识别,建筑物、农作物、道路等检测、分割及变化检测及面积计算 智慧零售:商品检测、商标检测及计数 智慧医疗领域:CT影像分割、肺炎筛查、眼底病变筛查 怎么用? PaddleX提供了从数据预处理、超参配置、模型训练与评估、模型多端部署等深度学习产业项目开发全流程全面覆盖。 数据准备 PaddleX适配产业标准数据标注格式,支持常用标注工具,如:Labelme、精灵标注、EasyData等。原生匹配数据格式转化方法。同时提供多种数据增强的策略,适配了imgaug图像增强库,支持上百种数据增强操作,有效缓解小样本训练难题。 模型训练 为了满足用户的多种需求,PaddleX提供多种开发方式。 本地API pip install一键安装, 3个API即可完成深度学习算法训练!与【图形化开发界面】开发流程相同,提供极简的API,功能更丰富、开发更灵活、开源易集成。 RESTful API 不论你将训练框架部署在哪里, 只需要启动RESTful API服务,即可在本地调起开发界面调动远程服务器的资源进行训练。 训练过程可视化分析 集成可视化分析工具VisualDL的能力,直观的将准确率、loss、PR曲线、数据样本分布情况等用图表的方式呈现,使你清晰了解算法训练过程,加速调参。 一键完成模型量化、裁剪 通过极简的方式即可快速进行算法的裁剪、量化,有效对算法进行体积、参数量的减小,速度、精度的提升。 模型部署 为了满足工业级别的部署,PaddleX更是提供了全方位的部署服务:支持Python、C++、C#等多语言部署;提供本地预测、服务化预测、边缘预测部署等多种解决方案;适配业界常用的CPU、GPU(包括NVIDIA Jetson)、树莓派等硬件。 多硬件、多环境快速部署上线 PaddleX Deploy模块:适配业界常用的CPU、GPU(包括NVIDIA Jetson)、树莓派等硬件;支持PaddleClas PaddleDetection PaddleSeg三个套件的模型的部署;支持用户采用OpenVINO或TensorRT进行推理加速;完备支持工业最常使用的Windows系统,且提供C#语言进行部署的方式! 独特的PaddleX Manufacture SDK 编译预测库太复杂?需要多个算法串联?PaddleX Manufacture SDK提供工业级多端多平台部署加速的预编译飞桨部署开发套件(SDK),通过修改业务逻辑配置文件,就可以快速完成推理部署。覆盖单个算法以及多个算法串联形式。极低代码,极高效率。再也不用在不同环境下分别打包! PaddleX图形化产品即将正式发布 PaddleX图形化产品将集成数据标注与模型部署功能,为用户提供高效便捷的可视化操作界面,完成本地化一站式模型开发。产品名称为飞桨EasyDL-桌面版,邀测链接如下:ai.baidu.com/easydl/paddle 应用教程 亲妈级示例工程及文档 针对产业落地每一细节,提供详细的完善的操作指南,以及基于产业真实场景的示例工程。覆盖从数据标注、数据预处理、单模型训练调优、多模型串联,到多端部署、推理加速、可视化结果呈现等全流程! 不论你是AI算法开发者、软件系统工程师、硬件工程师还是学生;不管你对什么视觉领域任务有需求,都可以应用PaddleX提供的深度学习算法快速进行模型开发,并在实际的硬件、系统上部署上线。 还不Star等什么?这么优秀的项目不值得支持一下嘛? 项目链接: https://github.com/PaddlePaddle/PaddleX 不仅如此!10.11-12日每晚 8:15-9:30,百度高工还会通过直播,为我们一步步揭秘智能视觉技术实现产业落地的机会与捷径,还不赶紧扫码上车!!! 扫描海报二维码报名,加入技术交流群 长按下方二维码立即 Star 更多信息: 飞桨官方QQ群:793866180 飞桨官网网址:www.paddlepaddle.org.cn/ 飞桨开源框架项目地址:GitHub:github.com/PaddlePaddle/PaddleGitee:gitee.com/paddlepaddle/Paddle 欢迎在飞桨论坛讨论交流~~http://discuss.paddlepaddle.org.cn 本文同步分享在 博客“飞桨PaddlePaddle”(CSDN)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

千万量级图片视频快速检索,轻松配置设计师的灵感挖掘神器

作者介绍: James Zhang,飞书深诺集团的算法工程师 ,毕业于芬兰坦佩雷大学,感兴趣的方向包括自然语言处理、计算机视觉等机器学习相关领域以及算法工程化。 飞书深诺集团是专注海外数字营销解决方案的综合服务集团,为中国出海企业提供可定制组合的全链路服务产品,满足游戏、APP、电商、品牌等典型出海场景需求。 Milvus 在电商场景中的千万量级素材搜索实践 项目背景 在服务电商客户的场景下,创意部门常常要为客户制作素材,如:广告图、宣传视频、宣传文案等。创意部门往往通过以图搜图、以视频搜视频、文本搜文本的方式发掘素材,为设计师们提供创意上的参考。同时,热度、效果值等其他条件也可以用来辅助搜索,帮助创意部门充分选择合适的素材。此项目的动机正是利用 Milvus 向量数据库在内的一系列技术,为创意部门提供一个素材的综合搜索系统。 技术选型 由于业务接口需要实时返回,并承受一定程度的并发负载,因此我们认为 Milvus 是比较合适的向量检索工具。它对 FAISS、ANN 等工具进行了封装,建立自己的存储文件结构,同时提供了方便的服务化接口,可以算得上“开箱即用”了。在保持检索速度快的同时,Milvus 可以通过参数设置,对向量检索的准确性、资源占用做一定的 Trade-off,比较适合在实际工程中使用。 我们在返回相似向量的同时,还需要图片/视频的一些对应信息,我们通过 KV(Key-Value)的形式将这些信息放在 Redis 缓存里,加快获取的速度。在 Web 接口封装方面,考虑到团队内大部分为 Python 程序员,因此我们选用了 Nginx + Flask + Gunicorn + supervisor 的 Web 经典套餐。 使用到的各工具和框架 Milvus(图片/视频/文本的向量相似检索) Redis(业务缓存) Nginx(负载均衡) Flask + Gunicorn (Web 框架 + 并发服务) Supervisor(服务的进程启动与异常自动重启) Docker(容器隔离部署) 项目实现 在我们的项目中,图片使用 EfficientNet 来提取特征向量;视频通过提取关键帧之后,再将每一帧图片进行向量提取之后叠加;文本采用 BERT 做特征提取。 架构示意如下图所示: 选择合适的索引: 在得到图片/视频/文本向量检索结果后,上层调用还要做一些业务操作,留给向量检索的接口的时间就不能太多,系统需要做到 1s 内返回。由于向量检索对速度的要求比较高,同时服务部署的机器内存又有一定的限制,我们选用了 IVF_PQ 作为向量索引。 IVF_PQ 是一种有损压缩的向量索引,它将所有向量分解成 m 段,每一小段分别进行聚类,每小段由所属的聚类中心来表示,称为索引值,用 Codebook (码表)来表示 。举例说明这种压缩方式:一个 D=128 维的原始向量被切分成了 M=8 个 D=16 维的短向量,同时每个 16 维短向量都对应一个量化的索引值,索引值即该短向量距离最近的聚类中心的编号,每一个原始向量就可以压缩成 8 个索引值构成的压缩向量,即每个向量都用这 8 个索引值来表示,相对于原始值有一定的误差。 在实际使用的时候,IVF_PQ 这种索引方法预先计算好的各个聚类中心间的距离,通过查找表得出两个向量索引值的距离,来近似替代两个向量的真实距离,这种方法加快了计算速度;在使用中可以通过参数 m 的设置,使得向量压缩成很小的比例,也大量减少了内存占用(约为向量原始空间大小的 5%~10%)。下图为 IVF_PQ 索引压缩示例: 根据 Milvus 官方提供的公式: 单个数据段计算量可估算为:目标向量数量 × (nlist+ (段内向量数 ÷nlist)× nprobe) 数据段的数量可估算为:集合数据总量 ÷ index_file_size 对集合查询所需的计算总量则为:单个数据段计算量 × 数据段数量 我们计算得出合适的索引参数是 nlist=1024,m=8。 使用分区提高速度: 目前素材中,图片总量接近 4kw,视频总量大约 1kw,文本总量大约 3kw,为了提高检索速度,分区变得十分必要。我们通过一些业务属性,根据属性值做笛卡尔积操作来建立分区: 例如,我们向量对应的 Item 有两个属性: 对于属性 A,取值 1,2,3,4 对于属性 B,取值 1,2,3 建立分区 A1_B1,A1_B2,A1_B3,A2_B1,A2_B2,A2_B3,...... ,A4_B3,一共 12 个。通过分区操作,我们将每个分区的向量规模控制在 500w 以下,进一步提高了检索速度。 需要注意的是,用来建立分区的属性应该是不会变动的基本属性。因为如果发生变动,重新建立分区、导入数据和建立索引将是非常漫长的过程,所以分区确定之后不要轻易改变。另外,分区及属性值不能太多,否则各个属性值相乘(笛卡儿积)会让数量变得非常庞大,使程序变得过于复杂。如果要实现更多的素材属性检索或筛选,我们在 Milvus 向量搜索的结果上另外封装一层业务接口来实现。 系统效果 向量检索服务以 REST 接口的形式对外提供,前端团队调用接口,将结果展示在界面上。(请自行脑补一下谷歌的以图搜图,百度的以影搜影等等……) 性能指标 目前我们的图片总量大约在 3kw+,视频总量大约在 1kw,向量维数为 2048 维,文本总量为 3kw 左右,向量维数为 768 维。图片检索耗时 0.2s 左右;视频检索耗时 0.1s 左右;文本向量检索耗时 <0.1s。 关于 Milvus 的一些经验与总结 Milvus 集成各种常见向量索引,能满足工程中大部分的需求,存储操作和检索速度都达到了工业级的水准,提供服务化的接口,基本上做到了开箱即用。不过 Milvus 目前还不支持其他类型(字符型、整型)的属性检索,官方表示新版本目前正在研发当中,期待早日上线。 总体来说,对于需要快速构建向量检索服务、又不想花太大成本构造的轻量级项目来说,Milvus 是一个很好的选择。 参考文献 [1] Product quantization for nearest neighbor search. Hervé Jégou, Matthijs Douze, Cordelia Schmid [2] https://Milvus.io/cn/docs/v1.1.1/tuning.md Arch Meetup 深圳站开始报名啦,点击查看活动议程! GitHub @Milvus-io|CSDN @Zilliz Planet|Bilibili @Zilliz-Planet Zilliz 以重新定义数据科学为愿景,致力于打造一家全球领先的开源技术创新公司,并通过开源和云原生解决方案为企业解锁非结构化数据的隐藏价值。 Zilliz 构建了 Milvus 向量数据库,以加快下一代数据平台的发展。Milvus 数据库是 LF AI & Data 基金会的毕业项目,能够管理大量非结构化数据集,在新药发现、推荐系统、聊天机器人等方面具有广泛的应用。

优秀的个人博客,低调大师

大家很喜欢用的可视化神器——Pyecharts|可视化系列07

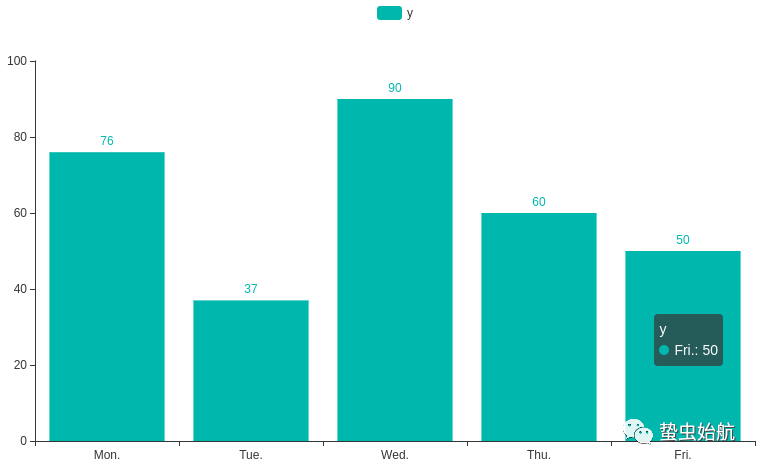
pyecharts简介 pyecharts是基于前端可视化框架echarts的Python可视化库。该库让我们在Python里也可以充分体验到快速出图和丰富交互的数据可视化体验。 echarts主要开发者御术曾说过,和d3相比,d3是面粉而echarts相当于面条。这是个很形象的比喻,和面粉相比,面条可以快速煮出各种美食,很贴合echarts的特点。echarts开箱即用,文档详细、可以配置的参数多,且有很多改改配置就能用的例子。pyecharts也具备这一优点。 代码框架与配置项 pyecharts的可视化基本代码框架如下。 import pyechartsbar=pyecharts.charts.Bar() #初始化一个柱状图bar.add_xaxis(['Mon.','Tue.','Wed.','Thu.','Fri.']) #设置x轴bar.add_yaxis("y", [76,37,90,60,50],color='#1eafae') #y轴bar.set_global_opts(title_opts=opts.TitleOpts(title="主标题",pos_left='center'))bar.render_notebook() #在jupyter notebook中出图#bar.render('bar_charts_01.html') #保存为文件 可以看到的是,pyecharts遵循了大部分Python可视化库的写法,初始化图对象,明确是什么类型的图,设置x,y轴数据及属性,设置图元属性,出图。 pyecharts绘制交互柱状图 pyecharts本质做的是把Python语句向echarts的JavaScript语句的映射,因此更强调配置,语句上使用add_、set_频率高。pyecharts囊括了30+常用的图表类型,而且对于表格展示、图像显示也有对应接口,除了输出html外,支持主流notebook环境的图表显示,还能很方便地和Flask、Django等Python前端框架集成。 在语句组织上,也可以用链式调用写法,思路和上面一致,初始化,设置X/Y,设置图元属性,出图。 bar = ( Bar().add_xaxis(x).add_yaxis("y",y))bar.render() 在图元属性上,图形颜色、文本标签通过向add_yaxis传参设置。也能通过set_colors设置全局配色。 标题、图例等设置通过set_global_opts设置,从语句名字可以看出其可以设置各种全局的属性。实例语句如下: from pyecharts import options as optsbar.set_global_opts(title_opts=opts.TitleOpts(title="主标题", subtitle="副标题",pos_left='center'), legend_opts=opts.LegendOpts(pos_left='5px')) set_global_opts设置的图元包括: •title_opts:标题设置,封装为pyecharts.options.TitleOpts(),属性有title,title_link,subtitle(副标题),pos_left,pos_top,title_textstyle_opts等实用配置。所以写法为:title_opts=opts.TitleOpts(title="主标题");•legend_opts:图例配置项,可以控制是否显示图例、图例相对位置、图例每项之间的间隔等属性,对应封装为LegendOpts();•tooltip_opts:提示框配置项,包括是否显示,触发条件等;•toolbox_opts:工具箱配置项;•brush_opts:区域选择组件配置项;•xaxis_opts:x坐标轴配置项,对应的封装是在AxisOpts()里,可以设置坐标轴类型(数值类型、离散类型,对数坐标轴、时间轴)、坐标轴名称、是否显示、值域、各种相对位置等属性;•yaxis_opts:y坐标轴配置项,对应封装也在AxisOpts();•visualmap_opts:视觉映射配置项;•datazoom_opts:区域缩放配置项; 等等,以上具体属性使用时可以随时查阅官方文档[1]。图形画布的宽度、背景色、使用主题等会在初始化图表时配置,称作InitOpts,也就是写在Bar()里,而不是传进set_global_opts。配置属性的时候需要注意的是type、min、max是Python的关键字,因此都用的type_、min_、max_这种形式。转为JavaScript会转回type,min,max。 bar=pyecharts.charts.Bar(init_opts=opts.InitOpts(width="400px",height="400px",page_title="pyecharts-demo")) 翻转XY轴 通过翻转柱状图的xy轴绘制条形图: bar.reversal_axis() #翻转柱状图的xy轴bar.render_notebook() 翻转xy轴得到条形图 数据进行统计后调整category_gap参数可以绘制出直方图 bar=pyecharts.charts.Bar()bar.add_xaxis(list(df['x']))bar.add_yaxis("y",list(df['y']),color='#1eafae',category_gap=0)bar.render_notebook() #直方图 绘制堆叠柱状图,只需要给bar对象添加两个.add_yaxis()再设置stack属性,实例如下: #堆叠柱df=pd.DataFrame({'x':['Mon.','Tue.','Wed.','Thu.','Fri.'], 'y':[76,37,90,60,50], 'z':[37,46,53,81,60]})bar=pyecharts.charts.Bar()bar.add_xaxis(list(df['x']))bar.add_yaxis("y",list(df['y']),color='#ba5c25',stack='s1',label_opts=opts.LabelOpts(position='inside'))bar.add_yaxis("z",list(df['z']),color='#1eafae',stack='s1',label_opts=opts.LabelOpts(position='inside'))bar.render_notebook() 堆叠柱状图效果 绘制折线图的多条折线也是用add_yaxis()。 #箱线图ybox=[59, 81, 80, 82, 50, 67, 66, 74, 75, 76, 91, 72]zbox=[59, 41, 80, 62, 70, 61, 46, 54, 45, 66, 85, 42]b=pyecharts.charts.Boxplot()b.add_xaxis(['boxplot-x-axis'])b.add_yaxis("y",[sorted(ybox)]) b.add_yaxis("z",[sorted(zbox)])b.render_notebook() 饼图 直角坐标系基本都是.add_xaxis(x).add_yaxis("y",y)配置X/Y轴的数据(包括箱线图),而饼图、雷达图等,是用add()配置数据。饼图的每块楔形对应的数为(标签,数值),因此传入add的数据不是[[x1,x2, …], [y1,y2, …]]这一的x的列表和y的列表,而是需要[(key1,val1),(k2,v2)]这样的组织形式。 c=pyecharts.charts.Pie() #pyecharts绘制饼图c.add("y",[[v['x'],v['y']] for i,v in df.iterrows()])#不是add_yaxis了;[(key1,val1),(k2,v2)]c.set_colors(['#1eafae','#69ffff', '#ba5c25', '#ffa069', '#a3ffff','#d7ce88'])c.render_notebook() c=pyecharts.charts.Radar() #雷达图sch=[opts.RadarIndicatorItem(name=i,max_=100) for i in list(df['x'])]c.add_schema(sch,shape='polygon') #shape可选 'polygon' 和 'circle',默认polygonc.add("y",[list(df['y'])],linestyle_opts=opts.LineStyleOpts(color="#1eafae")) c.add("z",[list(df['z'])],linestyle_opts=opts.LineStyleOpts(color="#ba5c25")) c.render_notebook() 雷达图的每条折线通过add()添加序列数据,基本上我们绘制雷达图各类别是分类变量(例如上图中的Mon.、Tue.等类别),配置进去需要用参数详解RadarIndicatorItem(name),雷达图绘制时最好显性声明每类的最大值,否则默认用的序列最大值。 关系图及数据特点 要绘制节点关系图等关系图,需要准备两份数据,一个节点表,一个边表。 节点表与边表 下面的例子更形象。节点表nodes说明有哪些节点,点的半径大小,每个节点是一个字典类型的数据,边表links说明谁连接谁,从节点A指向点B。必须要声明的是source和target,还可以有value、lineStyle等属性。 nodes = [ {"name": "A", "symbolSize": 10}, {"name": "B", "symbolSize": 40}, {"name": "C", "symbolSize": 20}, {"name": "D", "symbolSize": 10}]links=[ {"source":'A', "target":'B'}, {"source":'B', "target":'C','value': 10}, {"source":'C', "target":'D','lineStyle':{'normal':{'show':'true','width': 2}}}, {"source":'D', "target":'B'},]g=pyecharts.charts.Graph()g.add('',nodes,links,edge_length=100,repulsion=1500) #repulsion:节点之间的斥力因子; gravity:节点受到的引力因子;g.render_notebook() 桑吉图 Sankey图也是节点和边两个数据输入。 nodes = [ {"name": "A", "symbolSize": 10}, {"name": "B", "symbolSize": 40}, {"name": "C", "symbolSize": 20}, {"name": "D", "symbolSize": 10}]links=[ {"source":'A', "target":'C','value': 10}, {"source":'B', "target":'C','value': 15}, {"source":'C', "target":'D','value': 10}, {"source":'B', "target":'D','value': 10},]g=pyecharts.charts.Sankey()g.add('',nodes,links, label_opts=opts.LabelOpts(position="inside"), linestyle_opt=opts.LineStyleOpts(opacity=0.3, curve=0.2)) #默认颜色太难看了g.render_notebook() 复合图表 层叠不同类型的图、一行多图等排版对于pyecharts是基本操作。 通过b.overlap(a)将图a叠加到b类型的图上,且他们会共用一套坐标系。 #在同一坐标系里叠加多种图bar=pyecharts.charts.Bar()bar.add_xaxis(list(df['x']))bar.add_yaxis("y",list(df['y']),color='#1eafae')line = pyecharts.charts.Line().add_xaxis(list(df['x'])) \ .add_yaxis("z",list(df['z']),color='#ba5c25',z_level=2)bar.overlap(line)bar.render_notebook() 多个图进行排列而不是叠加到同一个坐标系里用grid和page,同一行多个图是grid,一页多图从上往下用的是page。通过选项卡点击切换多个图用tab,时间线轮播图用timeline。示例代码如下。综合以上的用法可以搭建仪表盘。 bar=pyecharts.charts.Bar()bar.add_xaxis(list('abcdef'))bar.add_yaxis('y',a,color='#1eafae')bar.set_global_opts(title_opts=opts.TitleOpts(title="帕累托图1", subtitle="双轴直角坐标图",pos_left='center'), legend_opts=opts.LegendOpts(pos_left='60px'))line=pyecharts.charts.Line()line.add_xaxis(list('abcdef'))line.add_yaxis('d',b,z_level=2)line.extend_axis( yaxis=opts.AxisOpts( name="累积比例", type_="value", min_=0, max_=1, position="right", axisline_opts=opts.AxisLineOpts( linestyle_opts=opts.LineStyleOpts(color="#ba5c25") ) ) )line.set_global_opts(yaxis_opts=opts.AxisOpts(position="right"),legend_opts=opts.LegendOpts(pos_left='120px'))grid=pyecharts.charts.Grid()grid.add(bar,grid_opts=opts.GridOpts(pos_right="18%"))grid.add(line,grid_opts=opts.GridOpts(pos_right="18%"))grid.render_notebook() tab = pyecharts.charts.Tab()bar1=pyecharts.charts.Bar()bar1.add_xaxis(list(df['x']))bar1.add_yaxis('y',list(df['y']),color='#1eafae')bar2=pyecharts.charts.Bar()bar2.add_xaxis(list(df['x']))bar2.add_yaxis('z',list(df['z']),color='#ba5c25') tab.add(bar1, "bar-example1")tab.add(bar2, "bar2")tab.render_notebook() pyecharts切换tab交互示例 总结 无论是从图表丰富性还是学习曲线角度看,pyecharts都是排名前列的可视化库。pyecharts上手很简单,文档很详细,有各种个性化需求时,通过查阅pyecharts的文档和echarts的文档基本都能得到解决,因此大家喜欢用也就不足为奇。pyecharts做的是从Python对象向JavaScript的转换,echarts支持的图表太丰富了,不一定需要一个个图表类型去看参数,有具体需求时边查文档边实现是更好的选择。 References [1]官方文档:https://pyecharts.org/#/zh-cn/global_options 本文分享自微信公众号 - 蛰虫始航(lyns_sailing)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册