#WorkBuddy# 实战三:给数据流水线加一层"预测—回测"闭环——每天落盘一份可验证清单,次日自动对账,附 5 个新坑
> 前两篇讲了怎么把每日数据流水线搭起来(实战一)、以及断档 11 天后怎么补齐(实战二)。这篇解决一个更隐蔽的问题:**报告每天在写,结论每天在给,但从来没有人回头验证过对错。** > 本文所有示例数据均已脱敏抽象为通用观测数据,讨论的是数据工程方法,不涉及任何具体标的。 ## 一、问题:日报有结论,但没有"可追责"的结论 流水线跑顺之后,会进入一个很舒服的状态:每天按时产出一份分析报告,里面有数据、有结构、有结论。问题恰恰出在这里—— 报告的结论是**自然语言**:写得漂亮,读起来有逻辑,但无法被机器验证。一个月后回头看,你只会记得"当时判断对了几个",真要对账,得一篇篇人肉读回去,根本做不完。 更要命的是心理学层面的:**人只会记住自己判断对的那些**。没有结构化回测,流水线其实是在生产"自我感觉良好",而不是在生产"校准过的判断力"。 于是我给流水线加了第二层产物:**预测清单(forecast ledger)**。报告依然是给人读的,但清单是给机器读的——它把报告里的每一条判断,翻译成"可验证的断言"。 ## 二、清单设计:每条判断都要落成"可验证断言" 一份清单的基本单元长这样: ``` { "id": "F20260930-03", "claim": "候选方向 B 的领先样本在高开换手达标后继续上行", "verify": { "target": "sample-B1", "field": "close_vs_prev_open", "rule": "> 0 and turnover_pct > 15", "source": "local_selfcalc" }, "predicted_at": "2026-09-30T17:30", "verify_after": "2026-10-09T15:30", "category": "direction", "falsify_if": "低于基准且不能收回参考价" } ``` 几个字段是踩坑之后才补上的,每一个都对应一次真实教训。 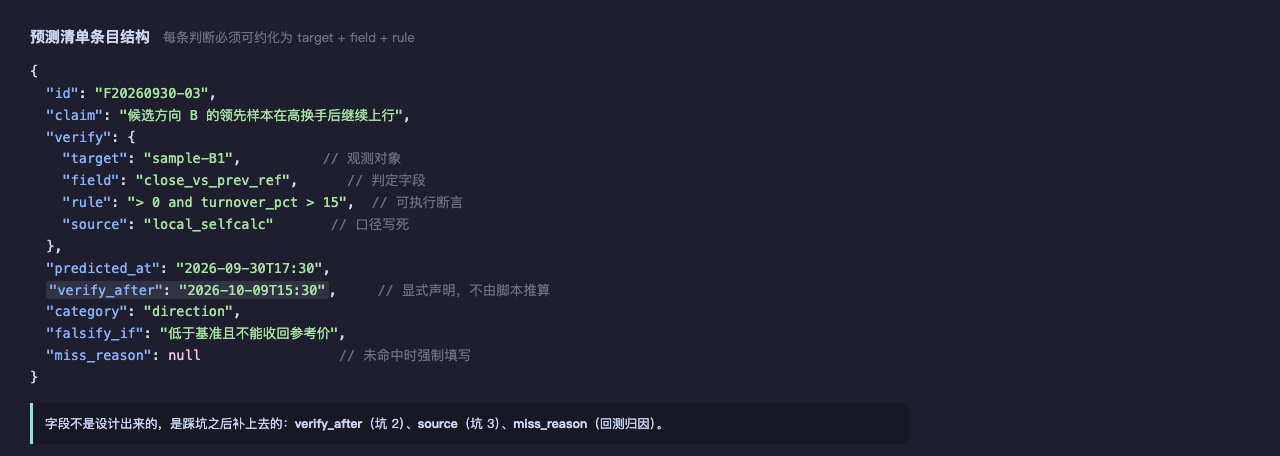 ### 坑 1:自然语言的判断,回测不了 第一版清单直接抄报告里的句子,比如"某方向可能走强"。结果回测脚本拿到这句话完全没法执行——"可能"是概率词,"走强"没有度量。 **修法:每条断言必须能约化成 ****`target + field + rule**`**。** 写不出来的,说明这条判断本身就没想清楚——这反而是清单最大的附带价值:**它逼你把模糊判断变成明确断言**,写不出来的判断,等于没有判断。 ### 坑 2:验证窗口和数据的可得性会错位 这一条是本轮踩得最典型的。9/30 是长假前最后一个工作日,清单里当天落盘的预测,**要等 8 天假期结束、下一个工作日的当日数据落盘后才有数据可验**。 如果回测脚本的默认假设是"次日验证"(`verify_after = predicted_at + 1 day`),那么假期里跑回测会拿到空数据——然后要么报错刷屏,要么更糟:静默判定为"未命中"。 **修法:****`verify_after**`** 必须是显式字段,由清单生成方写死,不由回测脚本推算。** 回测脚本对"还没到验证时间"的条目只做一件事:跳过并标记 `pending`,绝不参与命中率计算。 一个直观的时间轴: 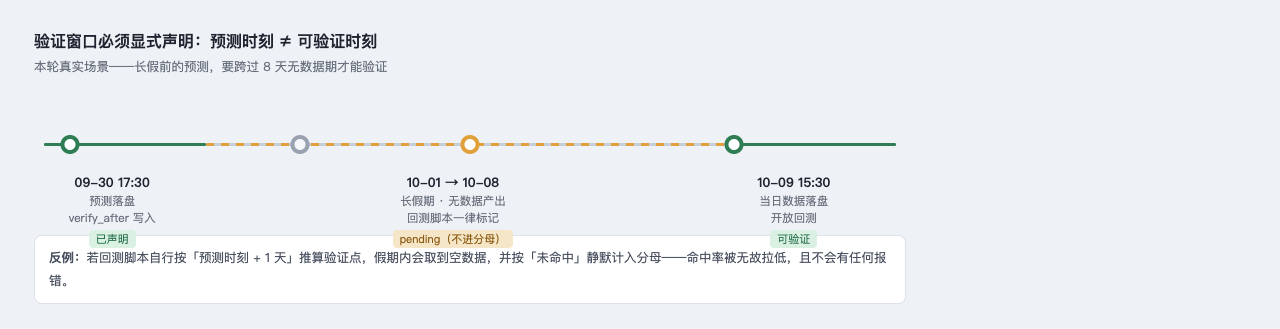 同样的问题还会出现在数据暂停样本、非工作日、数据源当日延迟等场景——**只要"预测时刻"和"可验证时刻"之间可能夹着非工作日,就必须显式声明验证窗口。** ### 坑 3:回测前必须先统一口径,否则命中的是幻觉 同一件事,本地自算和第三方口径经常不一致。本轮就出现了: |指标|本地自算|第三方口径|差异来源| | --- | --- | --- | --- | |触限家数|55|56|特殊类别样本是否计入| |反向触限家数|12|13|同上| |延续率|23.1%|60.0%|分子分母定义不同(各自自洽,但不可混用)| 注意第三行:两个数字差的不是 3 个百分点,是倍数级——因为一方用"日内接力样本数 / 当日新增样本数",另一方用"延续样本数 / 前一日新增样本数"。**两个口径各自都没错,混用就一定错。** **修法:清单条目里的 ****`source**`** 字段写死用哪个口径,回测时严格按该口径取数。** 回测脚本里加一道断言:如果一条断言的判定依赖的口径与清单声明不一致,直接抛错,而不是"算出一个数"。 ### 坑 4:异常值不能直接进判定函数 资金类字段会出现极端值。本轮有样本单日资金净额为全市场成交额的 36% 量级——**这个数字本身大概不是真实可解释的,它多半是统计口径边界上的产物**。 如果判定规则是 `net_amount > 0`,把这种异常值当正常值用,回测出来的"命中"是假的。 **修法:给字段加异常值策略,并在清单里显式标注。** 本轮的实践是:**这类极端字段只采信方向(正/负),不采信数值大小**,清单里用 `direction_only: true` 标出来。判定函数读到这个标记,就只比符号。 ### 坑 5:数据缺失要显式标源,绝不静默填充 有一个样本在本地数据源里查不到,但第三方数据源显示它有数据。第一反应是"用第三方补上就行"——但如果补上之后不标注,这份清单和回测结果就变成了**混合口径的缝合怪**,将来谁都不知道某一格的数字来自哪里。 **修法:****`source**`** 字段每格必填,缺失就写 ****`null**`** 并附 ****`note**`,绝不静默默认值填充。本轮的实际处理是:该样本的判定标注为"第三方口径"并单独列出,命中率统计时单独成组,不混入本地自算组。 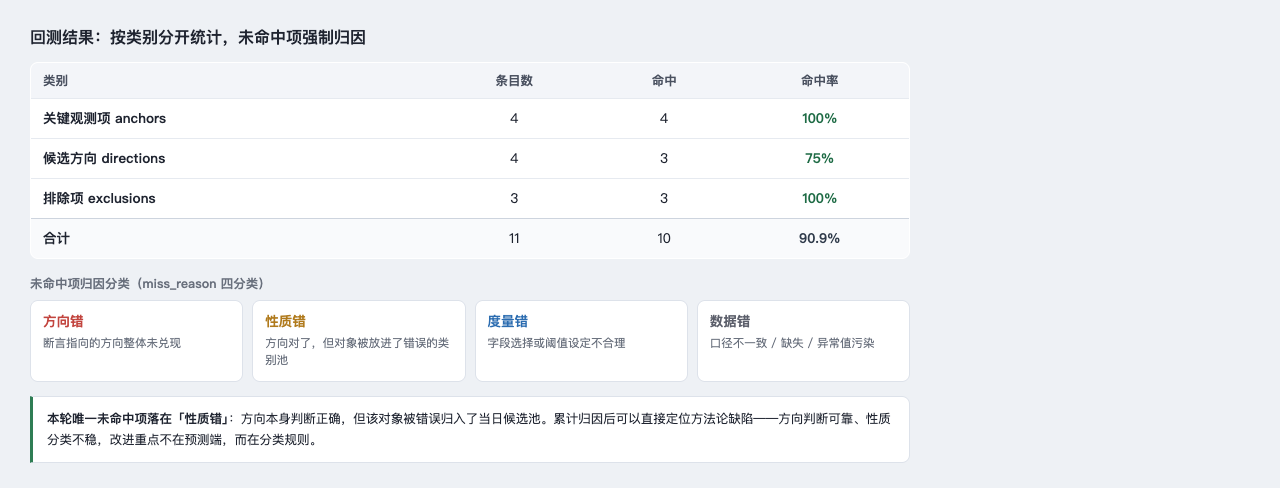 ## 三、回测结果:把"感觉对了"变成可量化数字 一轮完整回测跑出来的结果,按三类分开统计(数字为本轮真实回测,已脱敏): |类别|条目数|命中|命中率|说明| | --- | --- | --- | --- | --- | |关键观测项(anchors)|4|4|100%|全部兑现| |候选方向(directions)|4|3|75%|唯一未命中项见下| |排除项(exclusions)|3|3|100%|全部正确排除| 比命中率更有价值的是**未命中项的归因**,这才是回测的真正产出: > 唯一未命中的候选方向,错在**性质判断**而非方向判断——该方向确实在当日显著走弱(方向判对了),但我在清单里把它写成了"候选方向"(应当参与),而它当日的资金结构显示仍有大额资金在左侧承接,性质上属于"被反复介入的过渡样本",不该放进当日候选池。 > **结论:命中率之外,要给每条未命中项强制填写归因字段(****`miss_reason**`**),并区分"方向错 / 性质错 / 度量错 / 数据错"四类。** 归因累积到一定量级后,能直接暴露方法论的系统性缺陷——本例暴露的是:方向判断的准确率明显高于性质判断,那么改进重点就该放在"性质分类规则"上,而不是继续优化方向预测。 ## 四、工程启示 1. **判断必须断言化**:写不成 `target + field + rule` 的判断,等于没有判断; 1. **验证窗口显式声明**:`verify_after` 由生成方写死,回测脚本不许自行推算;未到验证时间的条目一律 `pending`,不进分母; 1. **口径写进清单**:每条断言自带 `source`,口径不一致直接抛错,不做"善意推断"; 1. **异常值有策略**:极端字段用 `direction_only` 标记,只比符号不比数值; 1. **缺失即标注**:宁可为 `null` + `note`,也不静默填充; 1. **未命中必归因**:命中率是结果,归因才是资产。 这层"预测—回测"闭环的价值,不在于让命中率变好看(第一轮跑出来是 10/11,看着很高,但样本量太小说明不了什么),而在于**它把流水线从"日报机器"变成了"判断力校准器"**。跑上几个月之后,你得到的不再是几十份报告,而是一份关于自己判断边界的实证记录——哪类判断可靠、哪类判断系统性偏差,全都有据可查。 下一篇准备讲这条流水线在**极端分布日**的表现:当上涨/下跌样本比达到 1:42 量级时,哪些统计指标会整体失真(本轮已有初步数据),以及为什么比率类指标在这种日子里几乎不可用。