首页 文章 精选 留言 我的

精选列表

搜索[首次公开募股],共10000篇文章
优秀的个人博客,低调大师

JetBrains 公开 2021 年开发者生态调查的原始数据

此前,本站报道了JetBrains 的第五次年度开发者生态系统调查结果,现在,JetBrains 公布了此次调查的原始数据。 官方表示,尽管此前的调查报告已经汇总了主要结果,但并没有包含所有有价值的结论和有趣的数据片段,大量未被发现的事实和趋势仍然隐藏在数据集中,比如不同国家/地区的开发人员之间的差异,又或者基于欧洲社会调查中 Schwartz’s Scale的关于人类价值观的问题。因此发布该原始数据集,以供感兴趣的用户自行分析。 据悉,该数据集总共包括 30,000 多个调查回复,并且数据已匿名化,不包含任何个人信息或地理位置详细信息。此外,为了防止识别任何单个受访者,已删除所有开放式字段,并将收集到的回复少于 15 个的选项合并到 "其他" 类别中。 感兴趣的用户可以自行挖掘数据以获得更多信息,并且可以在注明出处的情况下引用相关内容。

优秀的个人博客,低调大师

大量信息在网上公开贩卖

据消息,2021年1月中国交通银行遭遇黑客攻击,导致大量信息被泄露贩卖,总泄露数据16791320,贩卖价格为“8.8BTC”被挂在某网站,贩卖者并留下了联系方式。 如下图: 数据样本: 根据图中的信息可以看出,数据泄露包含有:姓名、电话、身份证号、地址、信用卡信息以及支行等信息。 由于银行机构提供个人金融服务,所以掌握着客户的账户信息、鉴别信息、金融交易信息、个人身份信息、财产信息、借贷信息等内容。这些都属于高敏感信息,一旦泄露可能严重威胁到客户的个人财产安全,更有甚者会影响到个人名誉及人身安全等。 在如今灰黑产横行的网络世界中,银行信息安全将面临严峻挑战。还望各企业重视网络安全问题,提高安全防御能力。 免责声明:本文消息来源于网络,我们在能知悉的范围内努力保证所有采写文章的真实性和正确性,但不对真实性和正确性做任何保证。 【责任编辑: 赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

EA 发布《命令与征服》重制版及公开游戏源代码

当地时间6月6日,游戏公司 EA 发布了《命令与征服:重制版》。 重制版带来 4K 图像效果、多人游戏、改进的用户界面、提供 Mod 支持、由 Frank Klepacki 完全重制的配乐,以及更多内容。 EA 游戏制作人 Jim Vessella 上个月在Reddit 上预告称,在发布《命令与征服》重制版的同时,会开源《命令与征服》系列游戏中泰伯利亚黎明和红警的部分源代码。 因此我们看到《命令与征服:重制版》发布之前,EA 在 GPLv3 许可证下开源了该系列中 TiberianDawn(泰伯利亚黎明) 和 RedAlert(红色警戒)的 DLL 源代码,代码托管在 GitHub 上。 开源的代码不涉及游戏引擎和游戏素材,只包括 TiberianDawn.dll 和 RedAlert.dll 的源代码,开源的 DLL 可帮助玩家设计地图、创建自定义单位、替换艺术作品,以及更改游戏逻辑和编辑数据。 Vessella 表示《命令与征服》应该是首个在 GPL 下开源的大型即时战略游戏,之所以采用 GPL 是为了确保它与CnCNet 和 Open RA 等开源项目相互兼容,希望以对社区真正有益的方式交付源代码。 游戏使用的开发语言是 C++,从泰伯利亚黎明游戏中的飞行器的源代码文件(AIRCRAFT.CPP)可以看到,此项目开始于1994年,当时属于机密文件,代码非常规范,注释也十分清晰。 传送门 >>>https://github.com/electronicarts/CnC_Remastered_Collection/

优秀的个人博客,低调大师

手机淘宝短视频业务「哇哦视频」迁移上 FaaS 笔记公开

作者 |刘子健(繁易) 阿里巴巴高级前端工程师 前言 2019 年,在阿里巴巴集团内部技术论坛上对于 Serverless 和 FaaS 的讨论非常火热。 在看了那么多“技术原理/顶层设计/平台建设”相关的文章之后,我相信你对 FaaS 肯定产生过跃跃欲试的感觉,但也肯定存在诸多疑惑,例如: FaaS 在业务中能落地吗? FaaS 能帮助前端同学实现能力升级吗? …… 而这些疑惑对于刚开始接触 FaaS 的我而言,只会多不会少。恰好,我所负责的“哇哦视频”业务是淘系第一个基于 Node FaaS 开发的线上业务,在线上已经稳稳当当的跑了 4 个月,这期间不仅接手了 Java 同学的工作,同时也顺利的承接了日常与双十一需求。 关于上面的这些疑惑,经过了这四个月的考验,我想我已经有了自己的答案。接下来我将会向大家分享我这四个月的历程,带大家一起看

优秀的个人博客,低调大师

首度公开!OceanBase存储系统架构的演进历程及工程实践

OB君:作为一款100%自研的分布式数据库,OceanBase历经了近十年的发展历程。近十年来,OceanBase的存储架构经历了多次演进,以解决业务越来越复杂苛刻的存储需求。本文整理自赵裕众(花名陈群)在2019 SACC中国系统架构师大会中的演讲。 随着用户数据量的不断增长,基于传统共享存储的纵向扩展能力渐渐变得力不从心,分布式存储成为应对用户海量数据的标配。作为一位架构师,在设计系统的分布式存储架构时,需要关注哪些方面呢?或者我们换句话说,对于客户来说,一个理想中的分布式存储产品应该具有哪些特性呢? 我们认为完善的分布式存储架构应该关注这五个方面: 扩展性:扩展性可谓是分布式存储有别于单机存储的重要特征,分布式存储的扩展性远远好于单机存储,但是不同分布式存储系统的扩展性之间仍然有着非常大的差异。某些分布式系统在几十个节点的量级上可

优秀的个人博客,低调大师

平头哥广发英雄帖,公开首款CPU“玄铁”仿真代码

“在自研芯片的路上,阿里走出了万里长征的第一步。” 7月25日,阿里云峰会上海站,压轴出场的平头哥,交出了时隔10月的首份答卷:玄铁910(XuanTie910),目前业界性能最强的RISC-V处理器。 在金庸小说中,玄铁是杨过手里的宝剑,“重剑无锋,大巧不工”;也是一种顶级的铸造材料,开锋後削铁如泥,极为稀有。 玄铁910是CPU的IP核,是芯片的关键内核驱动力所在。玄铁的寓意,与其在芯片产业中的作用恰好吻合。 玄铁910,业界性能最好的RISC-V处理器 万物互联的时代,人工智能、物联网以及云计算已经成为不可逆的趋势,AIoT 需要新的计算架构,重视安全、在线和智能等新特性,所有芯片面临升级,这必将在芯片行业将引起一波全新技术革命和产业浪潮。 新的机遇与挑战到来之际,平头哥立志成为 AIoT 时代芯片的基础设施提供者,降低企业设计芯片的门

优秀的个人博客,低调大师

闲鱼公开源代码实例

阿里妹导读:具有一定规模的 App 通常有一套成熟通用的基础库,尤其是阿里系 App,一般需要依赖很多体系内的基础库。那么使用 Flutter 重新从头开发 App 的成本和风险都较高。所以在 Native App 进行渐进式迁移是 Flutter 技术在现有 Native App 进行应用的稳健型方式。 今天我们来看看,闲鱼团队如何在这个实践过程中沉淀出一套独具特色的混合技术方案。 现状及思考 闲鱼目前采用的混合方案是共享同一个引擎的方案。这个方案基于这样一个事实:任何时候我们最多只能看到一个页面,当然有些特定的场景你可以看到多个 ViewController ,但是这些特殊场景我们这里不讨论。 我们可以这样简单去理解这个方案:我们把共享的 Flutter View 当成一个画布,然后用一个 Native 的容器作为逻辑的页面。每次在打开一个容器的时候我们通过通信机制通知 Flutter View 绘制成当前的逻辑页面,然后将 Flutter View 放到当前容器里面。 这个方案无法支持同时存在多个平级逻辑页面的情况,因为你在页面切换的时候必须从栈顶去操作,无法再保持状态的同时进行平级切换。举个例子:有两个页面A,B,当前B在栈顶。切换到A需要把B从栈顶 Pop 出去,此时B的状态丢失,如果想切回B,我们只能重新打开B之前页面的状态无法维持住。 如在 pop 的过程当中,可能会把 Flutter 官方的 Dialog 进行误杀。而且基于栈的操作我们依赖对 Flutter 框架的一个属性修改,这让这个方案具有了侵入性的特点。 新一代混合技术方案 FlutterBoost 重构计划 在闲鱼推进 Flutter 化过程当中,更加复杂的页面场景逐渐暴露了老方案的局限性和一些问题。所以我们启动了代号 FlutterBoost(向C++ Boost库致敬)的新混合技术方案。这次新的混合方案我们的主要目标有: 可复用通用型混合方案 支持更加复杂的混合模式,比如支持主页Tab这种情况 无侵入性方案:不再依赖修改 Flutter 的方案 支持通用页面生命周期 统一明确的设计概念 跟老方案类似,新的方案还是采用共享引擎的模式实现。主要思路是由 Native 容器 Container 通过消息驱动 Flutter 页面容器 Container,从而达到 Native Container与 Flutter Container 的同步目的。我们希望做到 Flutter 渲染的内容是由 Naitve 容器去驱动的。 简单的理解,我们想做到把 Flutter 容器做成浏览器的感觉。填写一个页面地址,然后由容器去管理页面的绘制。在 Native 侧我们只需要关心如果初始化容器,然后设置容器对应的页面标志即可。 主要概念 Native 层概念 Container:Native 容器,平台 Controller,Activity,ViewController Container Manager:容器的管理者 Adaptor:Flutter 是适配层 Messaging:基于 Channel 的消息通信 Dart 层概念 Container:Flutter 用来容纳 Widget 的容器,具体实现为 Navigator 的派生类 Container Manager:Flutter 容器的管理,提供 show,remove 等 Api Coordinator: 协调器,接受 Messaging 消息,负责调用 Container Manager 的状态管理。 Messaging:基于 Channel 的消息通信 关于页面的理解 在 Native 和 Flutter 表示页面的对象和概念是不一致的。在 Native,我们对于页面的概念一般是 ViewController,Activity 。而对于 Flutter 我们对于页面的概念是 Widget 。我们希望可统一页面的概念,或者说弱化抽象掉 Flutter 本身的 Widget 对应的页面概念。换句话说,当一个 Native 的页面容器存在的时候, FlutteBoost 保证一定会有一个 Widget 作为容器的内容。所以我们在理解和进行路由操作的时候都应该以 Native 的容器为准, Flutter Widget 依赖于 Native 页面容器的状态。 那么在 FlutterBoost 的概念里说到页面的时候,我们指的是 Native 容器和它所附属的 Widget 。所有页面路由操作,打开或者关闭页面,实际上都是对 Native 页面容器的直接操作。无论路由请求来自何方,最终都会转发给 Native 去实现路由操作。这也是接入 FlutterBoost 的时候需要实现 Platform 协议的原因。 另一方面,我们无法控制业务代码通过 Flutter 本身的 Navigator 去 push 新的 Widget 。对于业务不通过 FlutterBoost 而直接使用 Navigator 操作 Widget 的情况,包括 Dialog 这种非全屏 Widget,我们建议是业务自己负责管理其状态。这种类型 Widget 不属于 FlutterBoost 所定义的页面概念。 理解这里的页面概念,对于理解和使用 FlutterBoost 至关重要。 与老方案主要差别 前面我们提到老方案在 Dart 层维护单个 Navigator 栈结构用于 Widget 的切换。而新的方案则是在 Dart 侧引入了 Container 的概念,不再用栈的结构去维护现有的页面,而是通过扁平化 key-value 映射的形式去维护当前所有的页面,每个页面拥有一个唯一的 id 。这种结构很自然的支持了页面的查找和切换,不再受制于栈顶操作的问题,之前的一些由于 pop 导致的问题迎刃而解。也不需要依赖修改 Flutter 源码的形式去进行页面栈操作,去掉了实现的侵入性。 实际上我们引入的 Container 就是 Navigator 的,也就是说一个 Native 的容器对应了一个 Navigator 。那这是如何做到的呢? 多 Navigator 的实现 Flutter 在底层提供了让你自定义 Navigator 的接口,我们自己实现了一个管理多个 Navigator 的对象。当前最多只会有一个可见的 Flutter Navigator ,这个Navigator 所包含的页面也就是我们当前可见容器所对应的页面。 Native 容器与 Flutter 容器( Navigator )是一一对应的,生命周期也是同步的。当一个 Native 容器被创建的时候, Flutter 的一个容器也被创建,它们通过相同的 id 关联起来。当 Native 的容器被销毁的时候, Flutter 的容器也被销毁。 Flutter 容器的状态是跟随 Native 容器,这也就是我们说的 Native 驱动。由 Manager 统一管理切换当前在屏幕上展示的容器。 我们用一个简单的例子描述一个新页面创建的过程: 创建 Native 容器( iOS ViewController,Android Activity or Fragment )。 Native 容器通过消息机制通知 Flutter Coordinator 新的容器被创建。 Flutter Container Manager 进而得到通知,负责创建出对应的 Flutter 容器,并且在其中装载对应的 Widget 页面。 当 Native 容器展示到屏幕上时,容器发消息给 Flutter Coordinator 通知要展示页面的 id 。 Flutter Container Manager 找到对应 id 的 Flutter Container 并将其设置为前台可见容器。 这就是一个新页面创建的主要逻辑,销毁和进入后台等操作也类似有 Native 容器事件去进行驱动。 官方提出的混合方案 基本原理 Flutter 技术链主要由 C++实现的 Flutter Engine 和 Dart 实现的 Framework 组成(其配套的编译和构建工具我们这里不参与讨论)。Flutter Engine 负责线程管理,Dart VM 状态管理和 Dart 代码加载等工作。而 Dart 代码所实现的 Framework 则是业务接触到的主要 API,诸如 Widget 等概念就是在 Dart 层面 Framework 内容。 一个进程里面最多只会初始化一个 Dart VM。然而一个进程可以有多个 Flutter Engine,多个 Engine 实例共享同一个 Dart VM。 我们来看具体实现,在 iOS 上面每初始化一个 FlutterViewController 就会有一个引擎随之初始化,也就意味着会有新的线程(理论上线程可以复用)去跑 Dart 代码。Android 类似的 Activity 也会有类似的效果。如果你启动多个引擎实例,注意此时Dart VM 依然是共享的,只是不同 Engine 实例加载的代码跑在各自独立的 Isolate。 官方建议 引擎深度共享 在混合方案方面,我们跟 Google 讨论了可能的一些方案。Flutter 官方给出的建议是从长期来看,我们应该支持在同一个引擎支持多窗口绘制的能力,至少在逻辑上做到 FlutterViewController 是共享同一个引擎的资源的。换句话说,我们希望所有绘制窗口共享同一个主 Isolate。 但官方给出的长期建议目前来说没有很好的支持。 多引擎模式 我们在混合方案中解决的主要问题是如何去处理交替出现的 Flutter 和 Native 页面。Google 工程师给出了一个 Keep It Simple 的方案:对于连续的 Flutter 页面(Widget)只需要在当前 FlutterViewController 打开即可,对于间隔的 Flutter 页面我们初始化新的引擎。 例如,我们进行下面一组导航操作: 我们只需要在 Flutter Page1 和 Flutter Page3 创建不同的 Flutter 实例即可。 这个方案的好处就是简单易懂,逻辑清晰,但是也有潜在的问题。如果一个 Native页面一个 Flutter 页面一直交替进行的话,Flutter Engine 的数量会线性增加,而Flutter Engine 本身是一个比较重的对象。 多引擎模式的问题 冗余的资源问题:多引擎模式下每个引擎之间的 Isolate 是相互独立的。在逻辑上这并没有什么坏处,但是引擎底层其实是维护了图片缓存等比较消耗内存的对象。想象一下,每个引擎都维护自己一份图片缓存,内存压力将会非常大。 插件注册的问题:插件依赖 Messenger 去传递消息,而目前 Messenger 是由 FlutterViewController(Activity) 去实现的。如果你有多个 FlutterViewController ,插件的注册和通信将会变得混乱难以维护,消息的传递的源头和目标也变得不可控。 Flutter Widget 和 Native 的页面差异化问题: Flutter 的页面是 Widget, Native 的页面是 VC 。逻辑上来说我们希望消除 Flutter 页面与 Naitve 页面的差异,否则在进行页面埋点和其它一些统一操作的时候都会遇到额外的复杂度。 增加页面之间通信的复杂度:如果所有 Dart 代码都运行在同一个引擎实例,它们共享一个 Isolate ,可以用统一的编程框架进行 Widget 之间的通信,多引擎实例也让这件事情更加复杂。 因此,综合多方面考虑,我们没有采用多引擎混合方案。 总结 目前 FlutterBoost 已经在生产环境支撑着在闲鱼客户端中所有的基于 Flutter 开发业务,为更加负复杂的混合场景提供了支持,稳定为亿级用户提供服务。 我们在项目启动之初就希望 FlutterBoost 能够解决 Native App 混合模式接入 Flutter 这个通用问题。所以我们把它做成了一个可复用的 Flutter 插件,希望吸引更多感兴趣的朋友参与到 Flutter 社区的建设。在有限篇幅中,我们分享了闲鱼在 Flutter 混合技术方案中积累的经验和代码。欢迎兴趣的同学能够积极与我们一起交流学习。 扩展补充 性能相关 在两个 Flutter 页面进行切换的时候,因为我们只有一个 Flutter View 所以需要对上一个页面进行截图保存,如果 Flutter 页面多截图会占用大量内存。这里我们采用文件内存二级缓存策略,在内存中最多只保存2-3个截图,其余的写入文件按需加载。这样我们可以在保证用户体验的同时在内存方面也保持一个较为稳定的水平。 页面渲染性能方面, Flutter 的 AOT 优势展露无遗。在页面快速切换的时候, Flutter 能够很灵敏的相应页面的切换,在逻辑上创造出一种 Flutter 多个页面的感觉。 Release1.0的支持 项目开始的时候我们基于闲鱼目前使用的 Flutter 版本进行开发,而后进行了 Release 1.0 兼容升级测试目前没有发现问题。 接入 只要是集成了 Flutter 的项目都可以用官方依赖的方式非常方便的以插件形式引入 FlutterBoost ,只需要对工程进行少量代码接入即可完成接入。 详细接入文档,请参阅GitHub主页官方项目文档。 作者: 福居 原文链接​ 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

tensorflow object detection API训练公开数据集Oxford-IIIT Pets Dataset

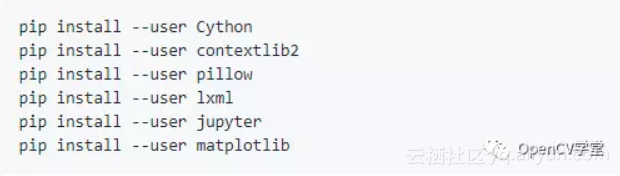
为了避免不必要的麻烦,先说一下我的系统版本 Python 3.6 tensorflow 1.10 windows 7 object detection API安装 object detection API 安装参见官方的github: https://github.com/tensorflow/models/tree/master/research/object_detection 这里需要特别强调一下,一定要检查一下,下面的python的包都安装了,方法很简单,全部执行一遍 coco API安装 windows下面不需要--user选项,Oxford-IIIT Pet 数据集使用coco metrix, 所以下面必须执行这个命令行: pip install git+https://github.com/philferriere/cocoapi.git#subdirectory=PythonAPI 在windows下面遇到utf-8编码错误 如下修正: C:\Program Files\Python\Python36\Lib\site-packages\pip\compat\_init_.py 79行改成gbk, utf-8替换为gbk, 不一定是是79行。再次执行即可成功安装 创建训练数据记录tfrecord 下载好Oxford-IIIT Pets Dataset数据集,解压缩到这里 然后执行下面的命令行: 训练数据成功创建在指定目录:先切换到指定目录,完整的命令行执行 D:\tensorflow\models\research>python objectdetection/datasettools/createpettfrecord.py --labelmappath=objectdetection/data/petlabelmap.pbtxt --datadir=D:/petdata --output-dir=D:\tensorflow\mytrain\data 还不会看这里: https://github.com/tensorflow/models/blob/master/research/objectdetection/g3doc/preparing_inputs.md 迁移学习 这步成功以后,就可以开始执行真正的训练啦,等等,别着急,我们是基于预训练模型的迁移学习,所以还有几件事情必须搞定, 下载预训练的tensorflow模型,我这里下载的是 http://download.tensorflow.org/models/objectdetection/ssdmobilenetv1coco201801_28.tar.gz 解压缩到指定目录,我的完整目录结构如下: 其实有+加号的表示目录文件夹, - 表示文件 labelmap file来自 D:\tensorflow\models\research\objectdetection\data\petlabelmap.pbtxt pipeline config file来自 D:\tensorflow\models\research\objectdetection\samples\configs\ssdmobilenetv1pets.config 直接copy过来,然后打开 开始修改,把所有【PATH_TO_BE_CONFIGURED】都改到正确路径上来: 保存好啦,然后直接执行训练的命令行: 各个参数选项解释如下: --pipelineconfigpath 训练时候配置目录,所有关于训练各种输入路径、参数模型、参数网络配置,都在这个里面。 --modeldir 训练时候会写文件的目录,训练完成输出的模型保存目录 --numtrainsteps 训练多少个steps --numeval_steps 多少个eval, 基本上两者要相差10倍以上 steps : eval --alsologtostderr 表示日志信息 如果遇到这个错误 TypeError: can't pickle dictvalues objects 这样修改,打开model_lib.py D:\tensorflow\models\research\objectdetection 继续训练就会很OK 启动tensorboard查看训练过程: CPU 太慢了,半天走一个step 原文发布时间为:2018-08-27 本文作者:gloomyfish 本文来自云栖社区合作伙伴“OpenCV学堂”,了解相关信息可以关注“OpenCV学堂”。

优秀的个人博客,低调大师

阿里云MaxCompute技术共享计划 首波技术公开课干货集锦

今夏伊始,阿里云大数据计算服务MaxCompute,为将计算红利惠及更多企业和更多开发者,隆重开启技术共享计划。为让更多开发者能够高效、便捷、循序渐进的了解大数据、了解MaxCompute以及阿里云相关的大数据产品,第一季的分享我们选择在“MaxCompute开发者交流”钉钉群进行每周为期半小时的直播分享。当然,除MaxCompute开发者交流钉钉群外,我们也一并邀请阿里云MVP、阿里云ACE以及DataWorks产品用户一起参与每周的直播学习和交流,大家对每周直播的形式和内容都表示,不仅参与简单,更能与大数据专家一对一交流并可在直播分享结束后通过视频多次回顾专家分享内容。第一季的内容聚焦“数据上云、数据转换、数仓性能优化、成本优化”四个主题。分别由阿里云数据技术专家及MaxCompute产品专家为企业和开发者朋友们做了开发实战的

优秀的个人博客,低调大师

Weex在苏宁移动办公开发中是如何实践的?

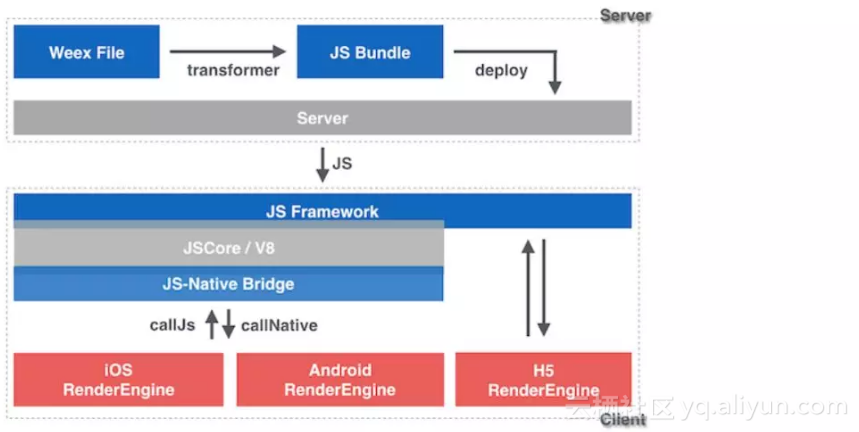
Weex 是什么? Weex 是一套简单易用的跨平台开发方案,能以 web 的开发体验构建高性能、可扩展的 native 应用,为了做到这些,Weex 与 Vue 合作,使用 Vue 作为上层框架,并遵循 W3C 标准实现了统一的 JSEngine 和 DOM API,打造三端一致的 native 应用。其架构如下所示: 将 weex 工程文件编译成 JS bundle,发布到云端,由客户端下载后,通过浏览器里的 JavaScript 引擎或 Weex SDK 运行起来的。 为了能掌握 weex 编程技术,开发人员需要熟悉以下几个概念(拷贝自官网 http://weex.apache.org) Weex 页面结构 界面展示、逻辑处理、设备能力使用、生命周期管理等部分。 Dom 模型 Weex 页面通过类似 HTML DOM 的方式管理界面,首先

优秀的个人博客,低调大师

SDCC 2017·上海站震撼来袭,首批讲师和议题大公开

时隔一年,2017年3月17-19日,SDCC 2017·上海站震撼来袭,特开设了三大主题会场,分别是互联网运维开发实战峰会、数据库核心技术与应用实战峰会和互联网应用架构实战峰会,为期三天,为软件开发者带去共24场的技术盛宴。 其中,百度、阿里、腾讯、苏宁等企业的顶级运维大牛带来360度无死角的运维盛宴,大规模分布式系统运维、自动化运维、云端运维、游戏运维、海量容器运维等等热点技术话题一网打尽。同时,集结业界前沿领域的数据库专家,业界巨匠,触手可及,围绕MySQL、PostgreSQL、Redis、Oracle等数据库,共同探讨性能调优、数据库自动运维、云端数据库、新一代数据平台等领域的前瞻性话题;深度剖析行业痛点,探秘数据库核心技术。SDCC也汇聚互联网应用架构实践的焦点议题,海量并发环境下的高可用/高并发/高性能系统架构设计、电商架构、消息队列、分布式架构、架构演讲、移动APP性能优化、分发系统的构建、微服务等。 日前,SDCC大会组委会也公布了首批的讲师和议题,接下来请看: 3月17日 互联网运维开发实战峰会 王津银 优维科技 优维科技CEO王津银 个人简介:王津银,07年进入腾讯公司接触运维,经历服务器从百到万的运维历程,先后在YY和UC参与不同业务形态的运维,期间带过前端运维、数据存储运维、YY语音、游戏运维、运维研发等多种运维团队,对运维有着全面的理解。极力倡导互联网价值运维理念,即面向用户的价值是由自动化平台交付传递,同时由数据化来提炼和衡量,“精益运维”理论提出者。 演讲主题:以资源管理的视角重新构建CMDB 演讲简介: CMDB从ITIL一出现就作为核心概念提出,CMDB的重要性不言而喻,但其中包含着太多的爱恨情仇。爱他,是它描绘的图景那么美好;恨他,是因为做起来大部分都是失败的下场。今天的CMDB建设需要转换一些方法论和思维模式,才能确保不失败。 传统CMDB的桎梏; 新形势下的CMDB应该如何改变; 资源管理到底有什么不同。 听众收益:什么是CMDB;CMDB建设失败的原因总结;资源管理究竟和CMDB有什么不同的视角;资源管理如何支撑上层的场景建设;资源管理针对不同的企业如何进行落地实施。 洪 楷 腾讯 腾讯游戏自研运维中心总监洪楷 个人简介:专注海量运维、高可用以及自动化运维等相关技术,致力于提升业务运维的自动化,建设运维岗位价值体系,通过运维服务整体提升团队价值和技术能力。负责运营商SP网关和BOSS系统开发工作,涉及计费平台、网络间通讯平台构建和持续集成。腾讯十年: 负责腾讯TBOSS平台的平台设计以及运维系统开发设计以及运维工作,见证TBOSS从1.0到3.0的成长,并在多次平台升级以及故障中得以锤炼。腾讯游戏代理、自研&引领云梯运维服务团队。 演讲主题:腾讯游戏“业务运维”贴近业务,技术实战迎接智能时代的到来 演讲简介:在面临高速发展的移动互联网游戏行业,对运维能力和素质的要求变得越来越高,特别是业务运维团队如何贴近业务,如何转型并且以技术凸显价值: 介绍腾讯游戏运维的转型,重点介绍业务运维如何切入业务和用户痛点,凸显运维的价值; 从游戏业务的场景出发,通过实战案例进行介绍docker在游戏中的应用,特别是在端游中的替换实战; 智能化时代的到来,腾讯游戏故障定位的新思路和技术难点。 听众收益: 业务运维在技术变迁下如何贴近业务创造业务运维岗位的价值,腾讯整个运维服务体系介绍; 腾讯游戏业务运维特别是端游在docker应用中的技术实战以及坑是如何填的; 智能化时代的到来,腾讯游戏故障定位的新思路和技术难点,如何更好迎接智能化时代的到来。 徐桂林 FIT2CLOUD FIT2CLOUD副总裁徐桂林 个人简介:徐桂林在FIT2CLOUD负责公司的技术布道和生态合作。在此之前先后供职于意法半导体、Autodesk和阿里云。徐桂林热衷于云计算(尤其是公有云IaaS平台),有过多年的公有云生产环境工作经历,是较早在国内分享AWS上实践经验的作者之一。 演讲主题:基于云平台构建业务运维管理平台 演讲简介:运维开发能力已经成为企业内部运维团队所必须具备的能力之一。区别与传统运维管理技能,运维开发人员除了需要有比较好的运维场景和需求理解能力,还必须具备构建企业运维管理平台的设计、编码和质量保障能力。而云平台的出现和快速普及则把对这种能力的要求推向了一个新的层次。目前,云平台已经成为初创公司和互联网公司的主流选择,而且传统企业也在上云,越来越多的业务正在逐步云化。基于传统数据建设的运维管理平台很多时候并不能很好适应云上业务的运维管理需求,这就需要运维开发人员能够重新思考云上运维管理平台的设计和开发。本演讲将就云平台带来的运维管理变与不变进行讨论,并展开介绍云平台上运维管理平台设计和研发的一些最佳实践及注意事项。 听众收益: 理解云平台带来的运维模式和理念的变化; 理解云平台为业务运维设计的工具和接口; 理解云上运维管理平台的功能边界; 理解云上运维管理平台的设计整体思路; 熟悉最常见的云上运维管理平台的最佳实践及实现方式。 3月18日 数据库核心技术与应用实战峰会 唐建法 MongoDB Inc. MongoDB大中华区首席架构师唐建法 个人简介: MongoDB大中华区首席架构师,MongDB中文社区mongoing.com发起人。 演讲主题:NoSQL之王:一分钟从关系型迁移到MongoDB 演讲简介:你可能从没听说过MongoDB你可能听说过但是没见过MongoDB你可能已经使用MongoDB开发了不少应用你也可能比TJ都更了解MongoDB。 听众收益:无论你是这里面的那一种人,今天TJ都不会让您失望。在这个讲座里,TJ会通过若干互动的演示,而不是干巴巴的宣讲的方式来为大家介绍MongoDB风靡全球,成为NoSQL王者的关键原因。如果您已经是Mongo老司机,不用担心,你也可以从TJ的文档模式设计精粹及一分钟关系型到MongoDB的迁移演示中获益匪浅。 程炎岭 饿了么 饿了么Data Arch负责人程炎岭 个人简介:近10年Oracle、MySQL、NoSQL数据库领域经验,金融、互联网背景。目前就职饿了么,负责数据库规划、治理、容量、架构、SQL优化方面工作。 演讲主题:饿厂 Redis Cluster集群化演进 演讲简介:介绍eleme Redis如何从单节点/twenproxy 演进到数百套Redis Cluster集群,1w+节点,近4T数据的规模. 以及我们做了什么,将来还要做什么。 听众收益: Redis Cluster 有哪些弊端; 大规模Redis Cluster下的治理工作; Redis Cluster的运维需要具备哪些条件; 聂 超 唯品会 唯品会运维工程部主任数据库工程师聂超 个人简介:聂超,唯品会运维工程部系统运维组主任数据库工程师。目前主要负责唯品会DBA工具开发团队以及唯品会上海DBA团队,在数据库自动化运维、NoSQL运维和应用实践上有一定的探索和实战经验。 演讲主题:唯品会数据库监控体系建设之路 演讲简介:监控是DBA团队的重中之重,好的监控系统不仅让故障告警和响应精准而迅速还能在问题诊断、容量评估、风险挖掘上带来事半功倍的效果。本话题主要介绍唯品会DBA团队在建设监控体系过程中走过的一些路和思考,期待能给大家在构建自己的监控体系的时候有一定的帮助。 听众收益:希望在如何构建一个监控体系给大家带来一定的启发。 3月19日 互联网应用架构实战峰会 者文明 京东 京东运营研发部系统架构部系统架构师者文明 个人简介:者文明,中科院硕士,清华大学精仪系学士,14年电子商务/企业应用领域研发、架构经验,涉及电商后端物流系统架构,实时大数据解决方案。2012年加入京东,主要负责仓储、配送、售后客服等系统架构。 演讲主题:京东物流系统高可用架构实践 演讲简介:大多电商物流系统均为OLTP系统,同时具有海量数据和高并发特性。如何在海量数据和高并发的应用场景中构建一个高可用的OLTP系统?本专题聚焦电商物流系统高可用架构设计与实践,旨在介绍京东物流系统在数据库和Web端的高可用架构设计思路、应用场景及案例分析。 听众收益: OLTP系统面对海量数据和高并发场景时如何提升系统的可用性; 电商物流系统高可用架构设计和实战经验; 李林锋 华为 华为软件API开放平台架构师李林锋 个人简介:李林锋,2008年进入华为公司从事电信软件的设计和开发工作,有多年Java NIO、平台中间件设计和开发经验,精通Netty、Mina、分布式服务框架、云计算等,目前从事云平台和开放API相关的架构和设计工作,著有《分布式服务框架原理与实践》、《Netty权威指南》。 演讲主题:微服务故障隔离技术 演讲简介:微服务分布式部署之后,涉及到序列化和反序列化、集群路由、网络读写等操作,故障在所难免。另外,在微服务中,可能会调用第三方服务,进行数据库操作、磁盘I/O操作等,这些对第三方服务的依赖,也会增加故障级联和扩散的风险。在实际项目中如何规避这些风险、如何更加有效的管理第三方依赖带来的可靠性奉献?本文将给出答案。 听众收益:学习到微服务故障隔离的关键技术: RPC通信层的故障隔离; 第三方依赖故障隔离; 基于线程池的微服务优先级调度; 熔断机制; 流量控制:静态、动态流控和并发控制; 优雅降级、异步回调机制; 陈清渠 携程 携程基础业务部高级研发经理陈清渠 个人简介:陈清渠,毕业于武汉大学,多年软件及互联网行业开发经验。14年加入携程,先后负责了订单查询服务重构,实时用户行为服务搭建等项目的架构和研发工作,目前负责携程订单中心团队。 演讲主题:实时用户行为服务系统架构 演讲简介:用户实时行为对接了携程近20条业务线用户访问日志,通过kafka+storm的组合,每天在处理20亿+埋点数据的基础上保证秒级落地可查,支撑了多个产品,目前日均服务8千万以上请求。本次分享主要介绍我们在海量数据和高并发双重挑战下,如何从架构上和实现上保证实时性,稳定性和性能。 听众收益: 了解实时计算的系统构成和架构; 打造高性能服务的经验分享; 从多个层面提高系统可用性经验分享; 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册