首页 文章 精选 留言 我的

精选列表

搜索[混元翻译],共10000篇文章
优秀的个人博客,低调大师

[Android]一个干净的架构(翻译)

以下内容为原创,欢迎转载,转载请注明 来自天天博客:http://www.cnblogs.com/tiantianbyconan/p/5276587.html 一个干净的架构 原文:https://blog.8thlight.com/uncle-bob/2012/08/13/the-clean-architecture.html 在过去几年中我们能看到的一系列关于系统架构的思想。它们包括: Hexagonal Architecture(也称为Ports and Adapters),作者是 Alistair Cockburn,并被 Steve Freeman 和 Nat Pryce 在他们很棒的Growing Object Oriented Software这本书中采用。 Onion Architecture,作者是 Jeffrey Palermo。 Screaming Architecture,来自我去年写的一篇博客。 DCI,来自 James Coplien 和 Trygve Reenskaug。 BCE,来自 Ivar Jacobson 的一本书Object Oriented Software Engineering: A Use-Case Driven Approach 尽管这些书在细节上有些不同之处,但是它们是非常相似的。从分离的观点上来讲它们都有着同样的目标。它们都是通过软件分层来实现分离的。每一个都至少有一层是用于业务规则,另外一层用于接口。 这些架构生产系统: 框架独立性。架构并不依赖于已经存在的某些库的有负载的特性。这允许你作为工具去使用框架,而不是把你的系统强塞到限制和约束中。 可测试性。业务规则可以脱离UI、数据库、web服务器和其它外部元素去进行测试。 UI的独立性。UI可以在不修改系统其它地方的情况下很容易地被改变。比如,一个Web UI可以使用console UI替换,而不改变任何业务规则。 数据库独立。你可以使用Mongo、BitTable、CouchDB或者其它来置换Oracle或SQL Server。你的业务规则不会被数据库束缚。 外部代理的独立性。事实上,你的业务规则根本不知道外面的世界。 这篇文章顶部的图表就是尝试所有这些结构到单个可操作的思想中去。 依赖准则 同心圆表示不同软件的区域。一般情况下,走得越远,软件水平也会变得越高。外面的圆是机制,而内部的圆是政策。 使得这个架构可行的最重要的规则是依赖准则。这个准则指代码的依赖只能向内。没有一个内部圆可以知道外部圆的任何东西。尤其是在内部圆声明的东西名字不能被内部圆中的代码提到。这里包括方法、类、变量、或者其它软件实体的名字。 同样的原因,外部圆中用到的数据格式不能被内部圆使用,尤其是这些格式是被外部圆中的框架生成的。我们不希望任何在外部圆中的东西影响到内部圆。 Entities 实体封装了企业级业务规则。一个实体可以是一个有方法的对象,或者有一系列的数据结构和函数。只要这个实体可以被很多不同企业中的应用使用就没关系。 如果你没有一个企业,并且只是编写单个的应用程序,那么这些实体就是应用程序中的业务对象。它封装了大部分一般的和高级别的规则。它们最不可能在外部改变的时候被改变。比如,由于安全你不希望这些对象被导航页面改变而影响。没有特别的可操作的改变可以影响实体层。 用例 软件在这一层包含应用程序指定的业务规则。它封装和实现了这个系统的所有用例。这些用例转化数据流到实体和从实体转化到数据流,然后这些实体直接使用它们企业范围的业务规则来达到用例的目的。 我们不期望改变这一层来影响到实体。我们也不希望这一层被外部的改变,比如数据库、UI、任何常见的框架等影响。在这一层在这的观点上是被孤立的。 然而,我们要做的是希望应用程序操作的改变会影响到软件的用例,所以应该是在这一层。如果用例的细节改变了,那么这一层的某些代码当然也会受到影响。 接口适配器 在软件的这一层是一系列的适配器,通过最方便的用例和实体转换数据格式,最方便的外部代理格式有数据库或者Web等。在这一层,举个例子,将会完整包含 GUI 的 MVC 架构。Presenters、Views、 Controllers 都属于这里。Models有可能仅仅是数据结构,它们从 contrllers 被传入到用例中,然后从用例到 presenters 和 views。 同样的,在这一层,数据会被转换,从最方便的方式如实体和用例,转换到使用的用于持久框架的最方便的方式,即数据库。 这个圆中没有代码可以向内知道任何关于数据库的东西。如果数据库是一个 SQL database,那么所有 SQL 应该在这一层被限制,特别是在这一层需要进行数据库操作的部分。 在这一层也有必要从一些外部形式去转换数据,比如一个外部服务,转化为内部用例和实体使用的形式。 框架和驱动 最外层通常是框架和工具,通常是数据库、Web 框架等的组合。通常你不需要在这一层编写太多的代码,除了一些用于向内圈进行通信的固定代码。 这一层是所有细节走向的地方。Web是一个细节。数据库是一个细节。我们把这些东西放置在外部,这样它们就难以造成伤害。 只有四个圆? 不,这些圆只是简图。你可能会需要多于这四个圆。这里并没有一个规则来让你必须要使用这四个圆。然而,依赖规则总是适用的。代码依赖总是指向内部。当你向内移动时,抽象级别增加。最外层的圆是最低级别的具体细节。当你向内移动,就会变得更加抽象和更高级别策略的封装。最内部的圆是最通用的。 跨越边界 右下方的图是一个我们怎么去跨越圆的边界的例子。它展示了 Controllers 和 Presenters 通过下一层使用用例进行通信。注意控制流。它在controller中开始,通过用例,然后再Presenter中执行。也要注意代码的依赖。它们每一个都是向内指向用例。 我们通常使用依赖反转准则来解决这个明显的矛盾。在像Java的语言中,举个例子,我们使用了interfaces和继承关系,这样代码依赖关系控制权被反转,达到跨越边界的目的。 举个例子,考虑到用例需要调用Presenter。然而,这些调用必须不能是直接的,因为它会违反_依赖准则_:内部圆不能提到外部圆中的任何名字。所以我们这种情况我们会调用在内部圆中的接口(就像这里展示的 Use Case Output Port)),然后在外部圆中的Presenter去实现它。 同样的技术在架构的所有跨越边界的地方被使用到。我们利用动态代理的优势去创建代码依赖来达到控制反转,所以我们可以确保无论什么方向的依赖准则控制流都能有效。 什么数据跨越边界。 典型的跨越边界的数据就是简单的数据结构。如果你喜欢你可以使用基本结构或者简单的数据传输对象。或者是方法调用时的简单的参数数据。或者你可以把它放进一个HashMap,或者构建它到一个对象中。重要的是分离的、简单的数据结构跨越过边界。我们不希望去欺骗并传递Entities或者数据库的行。我们不希望数据结构有任何的违反依赖准则的依赖。 举个例子,很多数据库框架通过一个查询返回一个方便的数据形式的响应。我们可能称它为一个RowStructure。我们不希望这个行结构向内跨越边界。这将违反依赖准则因为这将强制一个内部圆去知道外部圆的一些东西。 所以当我们跨越边界传递数据时,它对于内圆来说总是以最方便的形式的。 遵守这些简单的规则并不难,前进的道路上会解决很多头疼的事情。通过分离软件到不同层次,并遵守依赖准则,你将会创建一个本质上可测试的系统,这意味这所有的好处。当任何系统外置的部分变得过时,就像数据库,或者web框架,你可以在最小的改动下替换这些外置元素。 分类:本文转自天天_byconan博客园博客,原文链接:http://www.cnblogs.com/tiantianbyconan/p/5276587.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用 Docker 简化 TeamCity 安装 【已翻译100%】

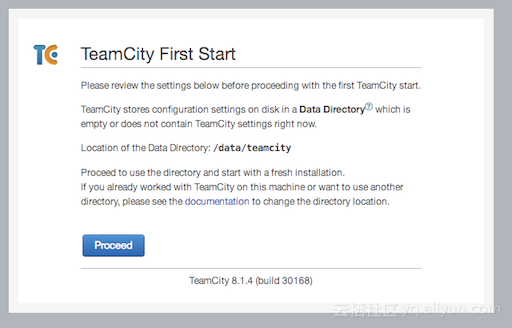
JetBrains出品的TeamCity是一款强大易用的持续集成(continuous integration)系统。它是一款商业产品,但对于小型项目和FOSS应用程序(免费和开源软件)有一项特殊的零费用许可证。尽管TeamCity的安装已经相对容易了,但通过使用Docker,安装过程会更简便。 像许多其它的最新式的持续集成系统一样,TeamCity采用了构建服务器和构建代理的概念。服务器负责管理和构建配置。实际的构建过程(编译、打包、部署等等)是由一个或多个代理执行的。通过个种方式,很容易实现代理的自动设置,整个设置过程中只需要很少的手动配置。 TeamCity服务器只需要Java。安装过程很简单。通过Docker,安装会更简单。为此,我准备了一个专门的容器 ariya/centos6-teamcity-server。此容器的基本系统是ariya/centos6-oracle-jre7,一个运行了Oracle官方Java 7的CentOS 6.5系统(更准确地说,到发稿为止是JRE 1.7.0_65-b17)。 假定你有一个已经安装了Docker的系统(VPS例如:Linode或DigitalOcean,Amazon EC2实例,一个虚拟机或一部真正的计算机),安装TeamCity服务器就简单到只需要运行下列命令。注意,如果你在使用OS X,如果你仅想试验本安装请使用boot2docker(参看我之前发表的博客 Docker on OS X 了解更多细节)。 docker run -dt -name teamcity_server -p 8111:8111 ariya/centos6-teamcity-server 几分钟后,打开机器地址的8111端口,开始TeamCity服务器的Web配置(更多细节请阅读官方TeamCity文档),如下图所示。如果你的系统使用了iptalbes,确保8111端口允许连接。注意,TeamCity数据将存储在特殊的位置/data/teamcity。这是一个标准的Docker卷,应当允许简单挂载、备份和未来升级。 服务器配置完成后,就应为此服务器指定构建代理(不然,什么也构建不了)。通过运行容器ariya/centos-teamcity-agent,我们再次用Docker产生一个构建代理。为了让代理工作,我们需要为它指定服务器。运行下列命令: docker run -e TEAMCITY_SERVER=http://buildserver:8111 \ -dt -p 9090:9090 ariya/centos6-teamcity-agent 如果你在运行着服务器容器的同一台主机上运行它,你需要将它们连接(link)起来。 docker run -e TEAMCITY_SERVER=http://teamcity_server:8111 \ --link teamcity_server:teamcity_server -dt ariya/centos6-teamcity-agent 环境变量中的TEAMCITY_SERVER是必须的,需要指向你上一步启动的TeamCity服务器的本地实例。一旦你运行了这个容器,它会连接到所指定的服务器,下载代理ZIP文件并安装。第一次连接服务器后,构建代理通常需要花几分钟时间更新。如果一切工作正常,在你的TeamCity服务器Web页面的Agent标签项中,你将看到一个新的代理。授权代理,现在它准备接受任何构建工作了! 如果启动代理出现问题,(docker ps)没有显示运行的容器,重新运行它,但这次使用 -it选项(interactive terminal交互终端)代替 -dt。这将转存一些额外的调试信息,有助于解决问题。 注意,此代理容器也是基于带Java 7的CentOS 6。通常这还不够,你可能需要其它的依赖项(不同的SDK,编译器,库等等)。理想情况下,那些依赖项能自动解决,或基于不同系统容器,或通过正确的自动设置。更多细节,参考我之前发表的博客 Build Agent: Template vs Provisioning。 还有借口不用持续集成?我可不这么想!

优秀的个人博客,低调大师

Docker 网络配置 【已翻译100%】(1/3)

摘要 当docker启动时,它会在宿主机器上创建一个名为docker0的虚拟网络接口。它会从RFC 1918定义的私有地址中随机选择一个主机不用的地址和子网掩码,并将它分配给docker0。例如当我启动docker几分钟后它选择了172.17.42.1/16-一个16位的子网掩码为主机和它的容器提供了65,534个ip地址。 注意: 本文讨论了Docker的高级网络配置和选项。通常你不会用到这些。如果你想查看一个较为简单的Docker网络介绍和容器概念介绍来着手,请参见Docker用户指南. 但docker0并不是正常的网络接口。它只是一个在绑定到这上面的其他网卡间自动转发数据包的虚拟以太网桥。它可以使容器与主机相互通信。每次Docker创建一个容器,它就会创建一对对等接口(peer interface),类似于一个管子的两端-在这边可以收到另一边发送的数据包。Docker会将对等接口中的一个做为eth0接口连接到容器上,并使用类似于vethAQI2QT这样的惟一名称来持有另一个,该名称取决于主机的命名空间。通过将所有veth*接口绑定到docker0桥接网卡上,Docker在主机和所有Docker容器间创建一个共享的虚拟子网。 本文其他部分将会讲解使用Docker选项的所有方式,并且-在高级模式下-使用纯linux网线配置命令来 调整,补充,或完全替代Docker的默认网络配置。 Docker选项快速指南 这里有一份关于Docker网络配置的命令行选项列表,省去您查找相关资料的麻烦。一些网络配置的命令行选项只能在服务器启动时提供给Docker服务器。并且一旦启动起来就无法改变。 一些网络配置命令选项只能在启动时提供给Docker服务器,并且在运行中不能改变: b BRIDGE或--bridge=BRIDGE— see 建立自己的网桥 -bip=CIDR— see 定制docker0 H SOCKET...或--host=SOCKET...— 它看起来像是在设置容器的网络,但实际却恰恰相反:它告诉Docker服务器要接收命令的通道,例如“run container"和"stop container"。 -icc=true|false— see 容器间通信 -ip=IP_ADDRESS— see 绑定容器端口 -ip-forward=true|false— see 容器间通信 -iptables=true|false— see 容器间通信 -mtu=BYTES— see 定制docker0 有两个网络配置选项可以在启动时或调用docker run时设置。当在启动时设置它会成为docker run的默认值: -dns=IP_ADDRESS...— see 配置DNS -dns-search=DOMAIN...— see 配置DNS 最后,一些网络配置选项只能在调用docker run时指出,因为它们要为每个容器做特定的配置: h HOSTNAME或--hostname=HOSTNAME— see 配置DNS 和 Docker与容器连接原理 -link=CONTAINER_NAME:ALIAS— see 配置DNS and 容器间通信 -net=bridge|none|container:NAME_or_ID|host— see Docker与容器连接原理 p SPECor--publish=SPEC— see 绑定容器端口 P或--publish-all=true|false— see 绑定容器端口 接下来的部分会对以上话题从易到难做出逐一解答。 配置DNS 怎样为Docker提供的每一个容器进行主机名和DNS配置,而不必建立自定义镜像并将主机名写到里面?它的诀窍是覆盖三个至关重要的在/etc下的容器内的虚拟文件,那几个文件可以写入新的信息。你可以在容器内部运行mount看到这个: $$ mount.../dev/disk/by-uuid/1fec...ebdf on /etc/hostname type ext4 .../dev/disk/by-uuid/1fec...ebdf on /etc/hosts type ext4 ...tmpfs on /etc/resolv.conf type tmpfs ...... 这样的配置允许Docker去做聪明的事情,类似于当主机接收到新的DHCP配置之后,保持resolv.conf的数据到所有的容器中。Docker怎样维护在容器内的这些文件从Docker的一个版本到下一个版本的具体细节,你应该抛开这些单独的文件本身并且使用下面的Docker选项代替。 有四种不同的选项会影响容器守护进程的服务名称。 -h HOSTNAME 或者 --hostname=HOSTNAME --设置容器的主机名,仅本机可见。这种方式是写到/etc/hostname ,以及/etc/hosts 文件中,作为容器主机IP的别名,并且将显示在容器的bash中。不过这种方式设置的主机名将不容易被容器之外可见。这将不会出现在 docker ps 或者 其他的容器的/etc/hosts 文件中。 --link=CONTAINER_NAME:ALIAS --使用这个选项去run一个容器将在此容器的/etc/hosts文件中增加一个主机名ALIAS,这个主机名是名为CONTAINER_NAME 的容器的IP地址的别名。这使得新容器的内部进程可以访问主机名为ALIAS的容器而不用知道它的IP。--link= 关于这个选项的详细讨论请看: Communication between containers. --dns=IP_ADDRESS --设置DNS服务器的IP地址,写入到容器的/etc/resolv.conf文件中。当容器中的进程尝试访问不在/etc/hosts文件中的主机A时,容器将以53端口连接到IP_ADDRESS这个DNS服务器去搜寻主机A的IP地址。 --dns-search=DOMAIN --设置DNS服务器的搜索域,以防容器尝试访问不完整的主机名时从中检索相应的IP。这是写入到容器的/etc/resolv.conf文件中的。当容器尝试访问主机 host,而DNS搜索域被设置为 example.com ,那么DNS将不仅去查寻host主机的IP,还去查询host.example.com的IP。 在docker中,如果启动容器时缺少以上最后两种选项设置时,将使得容器的/etc/resolv.conf文件看起来和宿主主机的/etc/resolv.conf文件一致。这些选项将修改默认的设置。 容器间通信 在操作系统层面上,决定两个容器间的通信能否得到控制,有以下三个因素。 网络拓扑逻辑是否连接上了容器的网络接口。默认情况下Docker将把所有容器绑定到一个 singledocker0bridge,并为两个容器间的包传输提供路径。参见本文档后续部分---其他可能的拓扑逻辑 主机是否要发送IP包?这由ip_forward系统参数控制。如果这个参数设为1,那么数据包只能在容器间传输。通常情况下,让Docker服务器使用它的默认设置 --ip-forward=true , Docker在启动的时候会把ip_forwardsh. 要检查设置或手动设置参数,可以这样做: # Usually not necessary: turning on forwarding,# on the host where your Docker server is running$ cat /proc/sys/net/ipv4/ip_forward0$ sudo echo 1 > /proc/sys/net/ipv4/ip_forward $ cat /proc/sys/net/ipv4/ip_forward1 iptables是否允许特殊连接?如果你把设置 --iptables=false,当守护进程启动时,Docker不会改变你的系统iptables规则。另外,如果你保留默认设置 --icc=true,Docker服务器或向FORWARD链添加一个带有全局ACCEPT策略的默认规则。如果不保留默认设置,系统会把策略设为DROP. 几乎所有人使用docker都希望ip_forward 是打开的,至少使容器间的通讯成为可能。但是否同意 --icc=true 或者更改为 --icc=false 使得iptables 可以保护容器以及宿主主机不被任意地端口扫描、避免被已经被渗透的容器所访问,这是一个策略问题。(在ubuntu,是编辑/etc/default/docker文件中的DOCKER_OPTS参数,然后重启docker服务) 如果你选择最安全的设置 --icc=false ,那么当你想让它们彼此提供服务的时候如何让它们相互通讯? 答案是:使用前文提到的 --link=CONTAINER_NAME:ALIAS 选项。如果docker守护进程正在以 --icc=false 和 --iptables=true 参数运行,当以选项 --link= 执行 docker run 命令时,docker服务将插入一部分 iptables ACCEPT 规则使得新容器可以连接其他容器所暴露出来的端口(此端口指前文在 Dockerfile 中提到的EXPOSE这一行)。更多详细文档介绍请看:linking Docker containers。 注意: --link 选项中的 CONTAINER_NAME 的值必须是 docker自动分配的容器名称,比如 stupefied_pare, 或者是在执行docker run 的时候用 --name= 指定的容器名称. 这不能使一个docker无法识别的主机名。 你可以在你的Docker主机上运行iptables命令,来观察FORWARD链是否有默认的ACCEPT或DROP策略 # When --icc=false, you should see a DROP rule:$ sudo iptables -L -n...Chain FORWARD (policy ACCEPT)target prot opt source destination DROP all -- 0.0.0.0/0 0.0.0.0/0...# When a --link= has been created under --icc=false,# you should see port-specific ACCEPT rules overriding# the subsequent DROP policy for all other packets:$ sudo iptables -L -n...Chain FORWARD (policy ACCEPT)target prot opt source destination ACCEPT tcp -- 172.17.0.2 172.17.0.3 tcp spt:80ACCEPT tcp -- 172.17.0.3 172.17.0.2 tcp dpt:80DROP all -- 0.0.0.0/0 0.0.0.0/0 注意: Docker的iptables规则完全显示了容器相互间的原始IP地址,所以一个容器到另一个容器的连接,需要显示地显示出第一个容器的原始IP地址。 为主机绑定容器端口默认情况下,Docker容器可以连接到外部区域,但外部区域不能连接到容器。在Docker启动时,由于它在主机上创建了一个iptables伪装规则,使得每一个输出连接看起来都是由主机IP地址建立起来的。 # You can see that the Docker server creates a# masquerade rule that let containers connect# to IP addresses in the outside world:$ sudo iptables -t nat -L -n...Chain POSTROUTING (policy ACCEPT)target prot opt source destination MASQUERADE all -- 172.17.0.0/16 !172.17.0.0/16... 当调用docker run的时候,如果你想让容器接受输入连接,你需要提供特殊选项。这些选项的详细说明在 Docker User Guide. 有两种方法可以实现。

优秀的个人博客,低调大师

Docker 网络配置 【已翻译100%】(2/3)

首先,你可以提供 -P 或者 --publish-all=true|false 选项参数来执行 docker run 命令,这将会识别所有在dockerfile中暴露的端口,并且随机映射到 49000-49900 之间的主机端口。这看起来是一个很大的不便,当你要启动一个新的容器时你需要知道那个主机端口已经被映射。 更方便的操作是使用 -p SPEC 或者 --publish=SPEC 选项,这两个选项让你明确的指定docker容器的端口映射到任意的主机端口中,不局限于49000-49900. 无论如何,你应该通过审查你的NAT表,去看看docker在你的网络占做了什么。 # What your NAT rules might look like when Docker # is finished setting up a -P forward: $ iptables -t nat -L -n ...Chain DOCKER (2 references) target prot opt source destination DNAT tcp -- 0.0.0.0/0 0.0.0.0/0 tcp dpt:49153 to:172.17.0.2:80 # What your NAT rules might look like when Docker # is finished setting up a -p 80:80 forward: Chain DOCKER (2 references) target prot opt source destination DNAT tcp -- 0.0.0.0/0 0.0.0.0/0 tcp dpt:80 to:172.17.0.2:80 可以看到,docker暴露了这些容器的端口到通配IP地址:0.0.0.0 ,这个通配IP地址可以匹配宿主主机上任意一个可以进入的端口。如果你希望更多的限制,并且只允许容器服务通过特殊的宿主主机的外部网络接口来相互联系,那么你有两种选择。当你执行 docker run 命令时,你可以使用 -p IP:host_port:container_port 或者 -p IP::port 来明确地绑定外部接口。 或者如果你希望dokcer永远转发到一个特殊的IP地址上,你可以编辑你的docker系统设置文件(ubuntu系统的设置方法为:编辑 /etc/default/docker文件,改写DOCKER_OPTS参数),增加选项 --ip=IP_ADDRESS 。修改完之后记得重启你的docker服务。 如果你希望更详细的指导,请参考: Docker User Guide . 定制 docker0 默认地,docker服务会在linux内核新建一个网络桥接docker0,使得物理主机和其他虚拟网络接口之间可以传递发送数据包,因此,这表现如一个独立的网络。 docker0有一个IP地址和子网掩码,使得物理主机可以从容器的桥接网络接收和发送数据包。并且给这个桥接网络一个MTU(最大传输单元)或者说网络接口允许的最大包长度-例如1,500 bytes 或者从docker的宿主主机上的网络接口拷贝的数值。在服务启动的时候两者都是可配置的: --bip=CIDR— 为docker0桥接网络提供一个特殊的IP地址和一个子网掩码, 使用标准的 CIDR 记法例如192.168.1.5/24. --mtu=BYTES— 从写docker0的最大数据包长度。 在ubuntu系统上,你可以增加以上的配置到 /etc/default/docker 文件中的DOCKER_OPTS参数中,然后重启docker服务。 当你有一个或多个正常运行的容器时,你可以通过在主机上运行brct1命令,观察interfaces列的输出,来确定Docker已经将这些容器正确地连接到docker0网桥。下面是一个连接了两个不同容器的主机: # Display bridge info$ sudo brctl show bridge name bridge id STP enabled interfaces docker0 8000.3a1d7362b4ee no veth65f9 vethdda6 如果你的Docker主机还没安装brct1命令,那么你可以在Ubuntu上运行sudo apt-get install bridge-utils来安装它。 最后,每次新建一个容器的时候都会用到docker0 桥接网络。每次在执行docker run命令新建一个容器的时候,docker从可利用的桥接网络中随机选择一个未被使用的IP地址,以及使用桥接网络的子网掩码,用来配置容器 eth0网络接口。docker宿主主机的IP地址被docker容器作为默认的网关。 # The network, as seen from a container$ sudo docker run -i -t --rm base /bin/bash $$ ip addr show eth024: eth0: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP group default qlen 1000 link/ether 32:6f:e0:35:57:91 brd ff:ff:ff:ff:ff:ff inet 172.17.0.3/16 scope global eth0 valid_lft forever preferred_lft forever inet6 fe80::306f:e0ff:fe35:5791/64 scope link valid_lft forever preferred_lft forever $$ ip routedefault via 172.17.42.1 dev eth0172.17.0.0/16 dev eth0 proto kernel scope link src 172.17.0.3$$ exit 记住docker的宿主主机无法转发docker容器的数据包到因特网上,除非它的ip_forward 系统设置为1,详情请看: Communication between containers 。 建立你自己的桥接网络如果你希望建立完整的自己的桥接网络,你可以在启动docker之前用 -b BRIDGE 或者 --bridge=BRIDGE选项参数高数docker使用你自己的桥接网络。如果你已经用docker0启动docker了,你需要停止docker服务然后移除docker0. # Stopping Docker and removing docker0$ sudo service docker stop $ sudo ip link set dev docker0 down $ sudo brctl delbr docker0 然后,在启动docker服务之前,新建你自己的桥接网络,写上你想要的配置。接下来我们新建一个简单的桥接网络,刚好用这些选项来定做docker0 ,这刚好足够说明这个技术。 # Create our own bridge$ sudo brctl addbr bridge0 $ sudo ip addr add 192.168.5.1/24 dev bridge0 $ sudo ip link set dev bridge0 up# Confirming that our bridge is up and running$ ip addr show bridge04: bridge0: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state UP group default link/ether 66:38:d0:0d:76:18 brd ff:ff:ff:ff:ff:ff inet 192.168.5.1/24 scope global bridge0 valid_lft forever preferred_lft forever# Tell Docker about it and restart (on Ubuntu)$ echo 'DOCKER_OPTS="-b=bridge0"' >> /etc/default/docker $ sudo service docker start 运行结构应该是docker服务成功启动,已经准备好绑定容器到桥接网络上。当核实好桥接网络的配置之后,尝试着新建一个容器,你将看到容器的IP地址是在你的新的桥接网络范围内的,这是docker自动检测的。 正如前文所述,可以用 brctl show 命令查看,新增或者移除网络接口,可以在docker容器中执行 ip addr 和 ip route 命令查看IP地址是否是从网桥IP段分配的,以及docker的宿主主机的IP是否被作为默认网关。**Docker 如何使容器连接到网络** docker是正在发展中的,并会持续提升网络配置的逻辑。当前命令行是很难满足docker新建容器时所需要的网络配置。 让我们回顾一些基础知识。 通讯的时候使用网际协议(IP),一个机器需要访问至少一个网络接口用来发送和接收包,路由表定义了通过接口可达IP地址范围。网络接口不一定非是物理设备。实际上,在每一个Linux机器(和每个Docker容器内部)的lo回环接口都是有效的而且完全是虚拟的——Linux内核简单地拷贝回环(数据)包,直接从发送者的内存放入接收者的内存。 Docker使用特殊的虚拟接口让容器在主机间通讯——成对的虚拟接口被叫做“peers”,它被链接到主机内核的内部,因此(数据)包能在他们之间传输。他们简单创建,待会儿我们将会看到。

优秀的个人博客,低调大师

如何进入 Docker 容器 【已翻译100%】

在前几篇文章[1,2,3]里,Lukas Pustina简单地介绍了使用Docker进行系统级虚拟化。在这篇文章里,我将讨论四种连接Docker容器并与其进行交互的方法。例子中所有的代码都可以在GitHub中找到,你可以亲自对它们进行测试。 nsenter 从util-linux版本2.23开始,nsenter工具就包含在其中。它用来访问另一个进程的名字空间。nsenter要正常工作需要有root权限。很不幸,Ubuntu 14.4仍然使用的是util-linux版本2.20。安装最新版本的util-linux(2.24)版,请按照以下步骤: cd /tmp curl https://www.kernel.org/pub/linux/utils/util-linux/v2.24/util-linux-2.24.tar.gz | tar -zxf-cd util-linux-2.24./configure --without-ncursesmake nsentercp nsenter /usr/local/bin 为了连接到容器,你还需要找到容器的第一个进程的PID。 docker inspect --format "{{ .State.Pid }}" <container-id> 通过这个PID,你就可以连接到这个容器: nsenter --target $PID --mount --uts --ipc --net --pid nsinit 从0.9版本开始,Docker自身就具有一个管理容器的库,名字为 libcontainer。libcontainer中的nsinit工具允许用户直接访问linux名字空间和cgroup内核。在安装nsinit之前,你首先需要安装Go运行时环境: apt-get install git golang-go mkdir -p $HOME/go-dev/binmkdir -p $HOME/go-dev/src echo "export GOPATH=\$HOME/go-dev" >> ~/.profileecho "PATH=\$PATH:\$GOPATH/bin" >> ~/.profile source ~/.profile 接下来才安装nsinit: mkdir -p $GOPATH/src/github.com/dotcloudcd $GOPATH/src/github.com/dotcloud git clone https://github.com/dotcloud/docker.gitcd $GOPATH/src/github.com/dotcloud/docker /usr/bin/go get -v github.com/dotcloud/docker/vendor/src/github.com/docker/libcontainer/nsinit nsinit读取的是位于/var/lib/docer/execdriver/native/容器目录下的配置数据。要运行nsinit,你需要切换到容器目录下。由于/var/lib/docker目录对于root用户是只读权限,因此你还需要root权限。通过docker的ps命令,你可以确定容器ID。一旦你进入/var/lib/docker目录,你就可以连接容器了: nsinit exec /bin/bash lxc(-attach) 直到Docker 0.8.1版本为止,LXC一直是管理容器的基本工具,Docker一直支持这个工具。但是从0.9.0版本开始,Docker默认使用libcontainer管理容器,不再依赖LXC了。因此默认情况下,你不能使用lxc-attach了。 如果你仍然希望使用lxc-attach,那么你需要使用-e lxc选项来重新启动Docker服务进程。使用这个选项,Docker的内部将再次使用LXC管理容器了。完成这个任务最简单的做法就是创建/etc/default/docker文件(如果这个文件仍然不存在),并添加以下内容: DOCKER_OPTS=" -e lxc" 现在你可以重新启动Docker服务了。要连接容器,你需要知道完整的容器ID: docker ps --no-trunc 接下来,你就可以连接这个容器了。要完成下面工作,你还需要root权限: lxc-attach -n <container-id> -- /bin/bash sshd 上面所有三种方法都要求具有主机系统的root权限。为了不采用root权限,通过ssh访问容器将是一个很好的选择。 要做到这一点,你需要构建一个支持SSH服务的基础映像。此时,我们可能遇到这样的问题:我们是不是用Docker CMD或者ENTRYPOINT运行一条命令就可以了?如果此时有sshd进程运行,那么我们就不要再运行其他进程了。接下来的工作是创建一个脚本或者使用像supervisord这样的进程管理工具来启动其它所有需要启动的进程。有关如何使用supervisord的 优秀的文档可以在Docker的web站点上找到。一旦你启动了具有sshd进程的容器,你就可以像以往一样通过ssh客户端了连接这个容器了。 结论 sshd方法可能是最简单的连接容器的方法,而且大多数用户习惯通过ssh连接虚拟机。另外,连接容器时你也不需要一定使用root权限。不过,对于是否一个容器是否应当管理不止一个进程仍然存在许多争议。这种方法最终使得每个容器了多了一个sshd进程,这从根本上来说不是进程虚拟化的所提倡的。 另外三种方法都需要root权限。到0.8.1版本为止,Docker都是使用LXC来管理容器的。正是由于这个原因,使用lxc-attach连接容器就非常容易。不过从版本0.9.0开始Docker服务就必须使用 -e lxc选项启动才能在内部支持LXC管理容器。不过,由于设置了这个选项,Docker将再次依赖LXC,而LXC可能随着发布或者安装的不同可能被剔除。 nsenter和nsinit总的来说是相同的。这两个工具的主要区别是nsinit在本身的容器了建立了一个新的进程,而nsenter只是访问了名字空间。Jerome Petazzoni在Docker博客文章里对这一点说的很透彻。

优秀的个人博客,低调大师

Swift 如何实现手势识别 【已翻译100%】

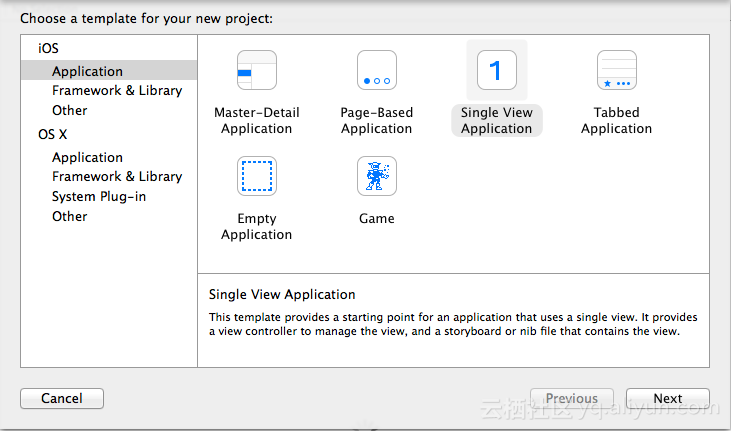
在这次IOS应用开发教程中,我们打算实现手势识别。正如你所知道的,IOS支持大量的手势操作,它们能提供了很好的应用控制和出色用户体验。 让我们开始吧! 首先需要在Xcode中创建一个新的Single View Application: 然后点击Next,弹出的窗口要求你填写项目设置。在第一栏 (“Product name”) 中填入项目名称后,点击Next. 确保语言选择的是 “Swift”. 设计界面点击 “Main.storyboard” 文件,拖出6个 UIViews放到视图中.把视图排列成如图所示的样子.当你排列UIViews时,在每个view下面添加一个UILabel并依图设定文本值。 我们开始写代码吧. 是时候编辑实现文件了 (在我们的案例 “ViewController.swift” ). 为了声明一些我们将会用到的变量,要在 “class ViewController: UIViewController “块中添加如下代码. class ViewController: UIViewController { @IBOutlet var tapView: UIView @IBOutlet var swipeView: UIView @IBOutlet var longPressView: UIView @IBOutlet var pinchView: UIView @IBOutlet var rotateView: UIView @IBOutlet var panView: UIView var lastRotation = CGFloat() let tapRec = UITapGestureRecognizer() let pinchRec = UIPinchGestureRecognizer() let swipeRec = UISwipeGestureRecognizer() let longPressRec = UILongPressGestureRecognizer() let rotateRec = UIRotationGestureRecognizer() let panRec = UIPanGestureRecognizer() } 在第2 – 7行,我们声明了在之前界面里排列过的 UIViews. 在第8行,我们声明了实现旋转手势要用到的变量(lastRotation). 在第 9 – 14行,我们为每个view声明了一个手势识别对象. 注意: 在 Swift中,我们用let关键字声明常量,这意味着它的值在程序运行时不可改变。关键字var则声明普通变量。 当声明完应用需要的主要变量后,在viewDidLoad 方法中添加如下代码. override func viewDidLoad() { super.viewDidLoad() tapRec.addTarget(self, action: "tappedView") pinchRec.addTarget(self, action: "pinchedView:") swipeRec.addTarget(self, action: "swipedView") longPressRec.addTarget(self, action: "longPressedView") rotateRec.addTarget(self, action: "rotatedView:") panRec.addTarget(self, action: "draggedView:") tapView.addGestureRecognizer(tapRec) swipeView.addGestureRecognizer(swipeRec) pinchView.addGestureRecognizer(pinchRec) longPressView.addGestureRecognizer(longPressRec) rotateView.addGestureRecognizer(rotateRec) panView.addGestureRecognizer(panRec) rotateView.userInteractionEnabled = true rotateView.multipleTouchEnabled = true pinchView.userInteractionEnabled = true pinchView.multipleTouchEnabled = true tapView.userInteractionEnabled = true swipeView.userInteractionEnabled = true longPressView.userInteractionEnabled = true panView.userInteractionEnabled = true } 第 3 – 8行,为每个视图设定手势识别的目标。所谓的目标,就是每个view中的手势完成后要调用的方法。 第 9 -14行,把手势识别添加到视图中. 第15 – 22行,把每个视图的 userInteractionEnabled 属性设为ture,并把拥有需要多点触控(rotateView and pinchView)的手势所在的视图的multipleTouchEnabled 属性设为true. 现在,我们编写每个手势识别器要调用的方法 (第3 – 8行设置的目标方法 ). 添加如下代码: func tappedView(){ let tapAlert = UIAlertController(title: "Tapped", message: "You just tapped the tap view", preferredStyle: UIAlertControllerStyle.Alert) tapAlert.addAction(UIAlertAction(title: "OK", style: .Destructive, handler: nil)) self.presentViewController(tapAlert, animated: true, completion: nil) } func swipedView(){ let tapAlert = UIAlertController(title: "Swiped", message: "You just swiped the swipe view", preferredStyle: UIAlertControllerStyle.Alert) tapAlert.addAction(UIAlertAction(title: "OK", style: .Destructive, handler: nil)) self.presentViewController(tapAlert, animated: true, completion: nil) } func longPressedView(){ let tapAlert = UIAlertController(title: "Long Pressed", message: "You just long pressed the long press view", preferredStyle: UIAlertControllerStyle.Alert) tapAlert.addAction(UIAlertAction(title: "OK", style: .Destructive, handler: nil)) self.presentViewController(tapAlert, animated: true, completion: nil) } 这三种方法都很好地完成同一件事.每次在手势在相应的视图中完成后,每种方法都弹出一个对话框. 所以 tappedView() 方法在用户滑动视图时弹出一个对话框,swipedView() 方法在用户触摸滑动 swipe视图时弹出对话框,而longPressedView() 方法则在用户长按long press view时弹出对话框. 另两种手势 (rotate and pinch ) 的代码稍微有点复杂. 为旋转手势添加如下代码: func rotatedView(sender:UIRotationGestureRecognizer){ var lastRotation = CGFloat() self.view.bringSubviewToFront(rotateView) if(sender.state == UIGestureRecognizerState.Ended){ lastRotation = 0.0; } rotation = 0.0 - (lastRotation - sender.rotation) var point = rotateRec.locationInView(rotateView) var currentTrans = sender.view.transform var newTrans = CGAffineTransformRotate(currentTrans, rotation) sender.view.transform = newTrans lastRotation = sender.rotation } 这个方法包含 sender:UIRotationGestureRecognizer 参数. sender 参数( UIRotationGestureRecognizer 类型) 含有这个方法(在这个案例中是rotateRec)调用的手势识别器的值. 第2行声明了 lastRotation. 第3行我们把 rotateView放到前面. 接下来,在 if语句中,我们检查手势是否完成,如果没有完成,我们就将视图旋转。 第 8 – 10行,我们计算rotate view的旋转程度,第10行,我们设置rotate view的旋转程度。 On line 12 we set the lastRotation 作为旋转手势识别器的当前旋转. 现在我们添加pinch 手势的代码: func pinchedView(sender:UIPinchGestureRecognizer){ self.view.bringSubviewToFront(pinchView) sender.view.transform = CGAffineTransformScale(sender.view.transform, sender.scale, sender.scale) sender.scale = 1.0 } 在之前方法的第1行中,我们把pinch视图放到了顶端。然后设置每个pinch视图的transform,并把pinchRec的scale设为1. 然后是实现 pan (drag) 手势. 添加如下代码: func draggedView(sender:UIPanGestureRecognizer){ self.view.bringSubviewToFront(sender.view) var translation = sender.translationInView(self.view) sender.view.center = CGPointMake(sender.view.center.x + translation.x, sender.view.center.y + translation.y) sender.setTranslation(CGPointZero, inView: self.view) } 第2行,我们把 drag视图放到顶端 (和前面的方法一样). 然后我们声明变量translation,并用 sender.translationInView(self.view)的值给它赋值。 完成后,把sender.view object (panRec) 的center属性设为计算出来的新center ( 通过CGPointMake(sender.view.center.x + translation.x, sender.view.center.y + translation.y) 计算) 并把translation 设为 sender (panRec). 现在,代码部分算是完成了! 回到界面设计. 现在我们回到 “Main.storyboard” 文件. 选择视图控制器并把声明的每个UIView连接到相应的视图,如下图所示. 完工 现在你可以在模拟器或你的设备上运行该应用并测试手势。 后记 我希望这篇教程对你有所帮助。你可以在下载完整源代码,另外如果有什么问题,可以通过 Twitter 联系我. 最后,请在psdapps.gr上试用我的IOS应用.


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册