首页 文章 精选 留言 我的

精选列表

搜索[Linux面板],共10000篇文章
优秀的个人博客,低调大师

Linux下Azkaban安装

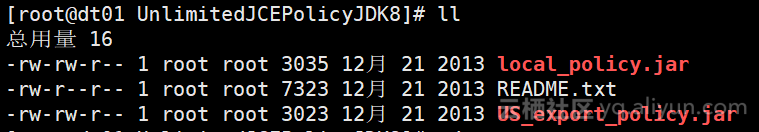
说明: CentOS 7JDK 1.8Azkaban版本:3.59.0官方文档:https://azkaban.readthedocs.io/en/latest/getStarted.html#building-from-source 安装步骤 Clone the repo: git clone https://github.com/azkaban/azkaban.git Build Azkaban and create an installation package: cd azkaban; ./gradlew build installDist 这个编译项目需要一定的时间,可能出现的问题如下: 1:连接maven超时,则需要检查超时的网址和端口是否正常 2:JCE报错 testV1_1 FAILED java.lang.RuntimeException: java.lang.RuntimeException: org.jasypt.exceptions.EncryptionOperationNotPossibleException: Encryption raised an exception. A possible cause is you are using strong encryption algorithms and you have not installed the Java Cryptography Extension (JCE) Unlimited Strength Jurisdiction Policy Files in this Java Virtual Machine at azkaban.crypto.Crypto.decrypt(Crypto.java:76) at azkaban.crypto.DecryptionTest.testV1_1(DecryptionTest.java:35) Caused by: java.lang.RuntimeException: org.jasypt.exceptions.EncryptionOperationNotPossibleException: Encryption raised an exception. A possible cause is you are using strong encryption algorithms and you have not installed the Java Cryptography Extension (JCE) Unlimited Strength Jurisdiction Policy Files in this Java Virtual Machine at azkaban.crypto.CryptoV1_1.decrypt(CryptoV1_1.java:57) at azkaban.crypto.Crypto.decrypt(Crypto.java:74) ... 1 more Caused by: org.jasypt.exceptions.EncryptionOperationNotPossibleException: Encryption raised an exception. A possible cause is you are using strong encryption algorithms and you have not installed the Java Cryptography Extension (JCE) Unlimited Strength Jurisdiction Policy Files in this Java Virtual Machine at org.jasypt.encryption.pbe.StandardPBEByteEncryptor.handleInvalidKeyException(StandardPBEByteEncryptor.java:1073) at org.jasypt.encryption.pbe.StandardPBEByteEncryptor.decrypt(StandardPBEByteEncryptor.java:1050) at org.jasypt.encryption.pbe.StandardPBEStringEncryptor.decrypt(StandardPBEStringEncryptor.java:725) at azkaban.crypto.CryptoV1_1.decrypt(CryptoV1_1.java:55) ... 2 more azkaban.crypto.EncryptionTest > testEncryption FAILED org.jasypt.exceptions.EncryptionOperationNotPossibleException: Encryption raised an exception. A possible cause is you are using strong encryption algorithms and you have not installed the Java Cryptography Extension (JCE) Unlimited Strength Jurisdiction Policy Files in this Java Virtual Machine at org.jasypt.encryption.pbe.StandardPBEByteEncryptor.handleInvalidKeyException(StandardPBEByteEncryptor.java:1073) at org.jasypt.encryption.pbe.StandardPBEByteEncryptor.encrypt(StandardPBEByteEncryptor.java:924) at org.jasypt.encryption.pbe.StandardPBEStringEncryptor.encrypt(StandardPBEStringEncryptor.java:642) at azkaban.crypto.CryptoV1_1.encrypt(CryptoV1_1.java:42) at azkaban.crypto.Crypto.encrypt(Crypto.java:58) at azkaban.crypto.EncryptionTest.testEncryption(EncryptionTest.java:28) 5 tests completed, 2 failed > Task :azkaban-common:compileJava 注: 某些输入文件使用或覆盖了已过时的 API。 注: 有关详细信息, 请使用 -Xlint:deprecation 重新编译。 注: 某些输入文件使用了未经检查或不安全的操作。 注: 有关详细信息, 请使用 -Xlint:unchecked 重新编译。 FAILURE: Build failed with an exception. * What went wrong: Execution failed for task ':az-crypto:test'. > There were failing tests. See the report at: file:///opt/azkaban/az-crypto/build/reports/tests/test/index.html * Try: Run with --stacktrace option to get the stack trace. Run with --info or --debug option to get more log output. Run with --scan to get full insights. * Get more help at https://help.gradle.org 解决方法:下载JCEhttps://www.oracle.com/technetwork/cn/java/javase/downloads/jce8-download-2133166-zhs.html我这边使用的JDK8,包含了JCE所需要的jre8解压搜下载好的文件,放置到以下目录:放置到jdk所在目录下的: cp UnlimitedJCEPolicyJDK8/* /usr/local/jdk1.8.0_74/jre/lib/security 对原有的文件进行覆盖 然后在进行重新编译 Start the solo server: 启动单机版的服务 cd azkaban-solo-server/build/install/azkaban-solo-server; bin/start-solo.sh Azkaban solo server should be all set, by listening to 8081 port at default to accept incoming network request. So, open a web browser and check out http://localhost:8081/ 打开页面 Stop server: bin/shutdown-solo.sh azkaban-solo-server 目录说明 目录名称 | 描述 | ------- | ------- | bin | 用于启动/停止Azkaban solo服务器的脚本conf | Azkaban solo服务器的配置文件lib | Azkaban的jar依赖项extlib | 添加到extlib的其他jar将添加到Azkaban的类路径中plugins | 可以安装插件的目录web | Azkaban Web服务器的Web(css,javascript,image)文件 数据库设置 为Azkaban创建数据库: #示例数据库创建命令,尽管db名称不需要是'azkaban' mysql> CREATE DATABASE azkaban; Query OK, 1 row affected (0.00 sec) 为Azkaban创建一个mysql用户。 例如,: # Example database creation command. The user name doesn't need to be 'azkaban' mysql> CREATE USER 'azka'@'%' IDENTIFIED BY '111111'; # give the user INSERT, SELECT, UPDATE, DELETE permission on all tables in the Azkaban db. mysql> GRANT SELECT,INSERT,UPDATE,DELETE ON azkaban.* to 'azka'@'%' WITH GRANT OPTION; 在/etc/my.cnf中配置Mysql Packet Size的大小 [mysqld] ... max_allowed_packet=1024M 重启mysql /sbin/service mysqld restart 创建Azkaban表 Installing Azkaban Executor Server 使用Gradle命令指令对源码进行编译注意:如果之前在安装solo模式的时候已经编译完成,则不需再进行编译 # Build Azkaban ./gradlew build # Clean the build ./gradlew clean # Build and install distributions ./gradlew installDist # Run tests ./gradlew test # Build without running tests ./gradlew build -x test 修改azkaban.properties中的mysql用户和密码,同时配置发送邮箱的配置信息 then run cd azkaban-exec-server/build/install/azkaban-exec-server ./bin/start-exec.sh 之后,请记住通过调用以下方法激活执行程序: cd azkaban-exec-server/build/install/azkaban-exec-server curl -G "localhost:$(<./executor.port)/executor?action=activate" && echo 激活成功 然后,一个执行器就可以使用了。用户可以通过分发和部署多个执行程序安装分发来设置多个执行程序。 安装Azkaban Web服务器 Azkaban Web Server处理项目管理,身份验证,调度和执行触发器。您可以从主分支构建最新版本 为了快速入门,我们可以直接使用gradle生成的安装目录azkaban / azkaban-web-server / build / install / azkaban-web-server。 更改账户名和密码 我们只需要在里面更改mysql用户名和密码azkaban.properties: Then run cd azkaban-web-server/build/install/azkaban-web-server ./bin/start-web.sh 默认的账户名和密码: azkaban azkaban 注意 如果修改azkaban.properties的配置信息,则需要重启进程才能生效 配置的文件都是修改install下的azkaban.properties文件 Could not find Linker 'g++' in system path 解决方法: sudo yum install g++ sudo yum install -y gcc-c++* 启动脚本是只能在bin目录外面提 solo是单机版使用的进程web和exec是和mql配置使用,分布式的服务模式 添加和修改配置的时候,修改的是如下位置的配置文件: /opt/azkaban/azkaban-web-server/build/install/azkaban-web-server/conf 然后重启web服务,配置生效 部署阿里云注意事项: 因为阿里云不能使用默认的25端口,所以需要事情ssl的465端口,但是3.59.0的版本是不支持ssl的,所以需要添加如下代码 import java.security.Security; final String SSL_FACTORY = "javax.net.ssl.SSLSocketFactory"; props.setProperty("mail.smtp.socketFactory.class", SSL_FACTORY); props.setProperty("mail.smtp.socketFactory.fallback", "false"); props.setProperty("mail.smtp.socketFactory.port", "465");
优秀的个人博客,低调大师

Linux安装python模块

# 依赖解决 # yum -y install epel-release python-devel gcc # 安装模块 # pip install psutil ------------------------------------------------------------- 作者: 罗穆瑞 出处: http://www.cnblogs.com/kazihuo/ 转载请保留此段声明,且在文章页面明显位置给出原文链接,谢谢! ------------------------------------------------------------------------------ 如果觉得这篇文章对你有小小的帮助的话,记得在右下角点个“推荐”哦,博主在此感谢! ------------------------------------------------------------------------------

优秀的个人博客,低调大师

Linux命令之curl

获取http请求头信息,-I 只打印response header, -i 打印response header和body curl -I "http://www.jouypub.com" curl -i "http://www.jouypub.com" 使用代理 curl -x 1.193.162.91:8000 http://www.jouypub.com curl -x 1.193.162.91:8000 --connect-timeout 3 --max-time 10 http://www.jouypub.com 上传文件curl -F "filename=@/home/test/file.tar.gz" http://localhost/action.php -F参数,curl就会以 multipart/form-data 的方式发送POST请求。-F参数以name=value的方式来指定参数内容,如果值是一个文件,则需要以name=@file的方式来指定。 选项 -d 以post方式请求 -H 请求时添加header,冒号前后不能有空格 curl -H "name=abc" http://www.jouypub.com -o 结果输出到指定文件 curl -o /dev/null http://www.jouypub.com -m/--max-time 指定最大允许时间,单位秒 curl -m 20 http://www.jouypub.com --connect-timeout 连接超时,单位秒 curl --connect-timeout 5 http://www.jouypub.com

优秀的个人博客,低调大师

linux 日常操作记录

1、搜索文件 locate php.ini 2、重启php服务 service php73-php-fpm restart 3、复制文件 cp [选项] 源文件或目录 目标文件或目录 参数说明: -a:是指archive的意思,也说是指复制所有的目录 -d:若源文件为连接文件(link file),则复制连接文件属性而非文件本身 -f:强制(force),若有重复或其它疑问时,不会询问用户,而强制复制 -i:若目标文件(destination)已存在,在覆盖时会先询问是否真的操作 -l:建立硬连接(hard link)的连接文件,而非复制文件本身 -p:与文件的属性一起复制,而非使用默认属性 -r:递归复制,用于目录的复制操作 -s:复制成符号连接文件(symbolic link),即“快捷方式”文件 -u:若目标文件比源文件旧,更新目标文件 如将/test1目录下的file1复制到/test3目录,并将文件名改为file2,可输入以下命令: cp /test1/file1 /test3/file2 4、查看最后几行 tail -n 20 filename 4、文件中搜索字符 cat -n 20000 laravel-2018-08-03.log |grep 'estimate_price' 5、查看监听 php72 artisan tinker 6、查看队列剩余剩余 Queue::size('high');

优秀的个人博客,低调大师

linux进程内存布局

一个程序本质上都是由 BSS 段、data段、text段三个组成的。这样的概念在当前的计算机程序设计中是很重要的一个基本概念,而且在嵌入式系统的设计中也非常重要,牵涉到嵌入式系统运行时的内存大小分配,存储单元占用空间大小的问题。 BSS段:在采用段式内存管理的架构中,BSS段(bss segment)通常是指用来存放程序中未初始化的全局变量的一块内存区域。BSS是英文Block Started by Symbol的简称。BSS段属于静态内存分配。 数据段:在采用段式内存管理的架构中,数据段(data segment)通常是指用来存放程序中已初始化的全局变量的一块内存区域。数据段属于静态内存分配。 代码段:在采用段式内存管理的架构中,代码段(text segment)通常是指用来存放程序执行代码的一块内存区域。这部分区域的大小在程序运行前就已经确定,并且内存区域属于只读。在代码段中,也有可能包含一些只读的常数变量,例如字符串常量等。 程序编译后生成的目标文件至少含有这三个段,这三个段的大致结构图如下所示: 其中.text即为代码段,为只读。.bss段包含程序中未初始化的全局变量和static变量。data段包含三个部分:heap(堆)、stack(栈)和静态数据区。 堆(heap):堆是用于存放进程运行中被动态分配的内存段,它的大小并不固定,可动态扩张或缩减。当进程调用malloc等函数分配内存时,新分配的内存就被动态添加到堆上(堆被扩张);当利用free等函数释放内存时,被释放的内存从堆中被剔除(堆被缩减) 栈 (stack):栈又称堆栈, 是用户存放程序临时创建的局部变量,也就是说我们函数括弧“{}”中定义的变量(但不包括static声明的变量,static意味着在数据段中存放变 量)。除此以外,在函数被调用时,其参数也会被压入发起调用的进程栈中,并且待到调用结束后,函数的返回值也会被存放回栈中。由于栈的先进先出特点,所以 栈特别方便用来保存/恢复调用现场。从这个意义上讲,我们可以把堆栈看成一个寄存、交换临时数据的内存区。 当程序在执行时动态分配空间(C中的malloc函数),所分配的空间就属于heap。其概念与数据结构中“堆”的概念不同。 stack段存放函数内部的变量、参数和返回地址,其在函数被调用时自动分配,访问方式就是标准栈中的LIFO方式。(因为函数的局部变量存放在此,因此其访问方式应该是栈指针加偏移的方式,否则若通过push、pop操作来访问相当麻烦) data段中的静态数据区存放的是程序中已初始化的全局变量、静态变量和常量。 在采用段式内存管理的架构中(比如intel的80x86系统),BSS 段(Block Started by Symbol segment)通常是指用来存放程序中未初始化的全局变量的一块内存区域,一般在初始化时 BSS 段部分将会清零。BSS 段属于静态内存分配,即程序一开始就将其清零了。 比如,在C语言之类的程序编译完成之后,已初始化的全局变量保存在.data 段中,未初始化的全局变量保存在.bss 段中。 text和data段都在可执行文件中(在嵌入式系统里一般是固化在镜像文件中),由系统从可执行文件中加载;而BSS段不在可执行文件中,由系统初始化。 图引自《C专家编程》 BSS段只保存没有值的变量,所以事实上它并不需要保存这些变量的映像。运行时所需要的BSS段大小记录在目标文件中,但BSS段并不占据目标文件的任何空间。 //main.c inta=0;//全局初始化区 char*p1;//全局未初始化区 main() { staticintc=0;//全局(静态)初始化区 intb;//栈 chars[]="abc";//栈 char*p2;//栈 char*p3="123456";//"123456\0"在常量区,p3在栈上。 p1=(char*)malloc(10); p2=(char*)malloc(20);//分配得来得10和20字节的区域就在堆区。 } (图出自:http://www.tenouk.com/Bufferoverflowc/Bufferoverflow1c.html) (图出自:APUE-2e,http://infohost.nmt.edu/~eweiss/222_book/222_book.html) The computer program memory is organized into the following: Code segment(text segment) Data Segment -- Data (rodata + rwdata) -- BSS -- Heap Stack Segment Data The data area contains global and staticvariables used by the program that are initialized. This segment can be furtherclassified into initialized read-only (rodata) area and initialized read-writearea (rwdata). BSS The BSS segment also known as uninitialized datastarts at the end of the data segment and contains all uninitialized globalvariables and static variables that are initialized to zero by default. Heap The heap area begins at the end of the BSSsegment and grows to larger addresses from there. The heap area is managed bymalloc/calloc/realloc/new and free/delete, which may use the brk and sbrk system calls to adjust its size. The heaparea is shared by all shared libraries and dynamically loaded modules in aprocess. Stack The stack is a LIFO structure, typically locatedin the higher parts of memory. It usually "grows down" with everyregister, immediate value or stack frame being added to it. A stack frameconsists at minimum of a return address 例子程序 //main.cpp int a = 0; // 全局初始化区(data) char *p1; // 全局未初始化区(bss) int main() { int b; // 栈区(stack) char s[] = "abc"; // 栈区(stack) char *p2; // 栈区(stack) char *p3 = "123456"; // p3 在栈区(stack); "123456\0" 在常量区(rodata) static int c =0; // 全局/静态 初始化区 (data) p1 = ( char *)malloc(10); p2 = ( char *)malloc(20); // 分配得来的 10 和 20 字节的区域就在堆区 (heap) strcpy(p1, "123456"); // "123456\0" 放在常量区(rodata). 编译器可能会将它与 p3 所指向的"123456\0"优化成一个地方。 return 0; } 堆和栈的区别 管理方式:对于栈来讲,是由编译器自动管理;对于堆来说,释放工作由程序员控制,容易产生 memory leak。 空间大小:一般来讲在 32 位系统下,堆内存可以达到接近 4G 的空间,从这个角度来看堆内存几乎是没有什么限制的。但是对于栈来讲,一般都是有一定的空间大小的,例如,在 VC6 下面,默认的栈空间大小大约是 1M。 碎片问题:对于堆来讲,频繁的new/delete 势必会造成内存空间的不连续,从而造成大量碎片,使程序效率降低;对于栈来讲,则不会存在这个问题,因为栈是先进后出的队列,永远都不可能有一个内存块从栈中间弹出。 生长方向:对于堆来讲,生长方向是向上的,也就是向着内存地址增加的方向;对于栈来讲,它的生长方向是向下的,是向着内存地址减小的方向增长。 分配方式:堆都是动态分配的,没有静态分配的堆;栈有 2 种分配方式:静态分配和动态分配。静态分配是编译器完成的,比如局部变量的分配,动态分配由 alloca 函数进行分配,但是栈的动态分配和堆是不同的,它的动态分配是由编译器进行释放,不需要我们手工实现。 分配效率:栈是机器系统提供的数据结构,计算机会在底层分配专门的寄存器存放栈的地址,压栈出栈都有专门的指令执行,这就决定了栈的效率比较高; 堆则是 C/C++函数库提供的,它的机制是很复杂的,例如为了分配一块内存,库函数会按照一定的算法(具体的算法可以参考数据结构/操作系统)在堆内存中搜索可用的足够大小的空间,如果没有足够大小的空间(可能是由于内存碎片太多),就有可能调用系统功能去增加程序数据段的内存空间,然后进行返回。显然,堆的效率比栈要低得多。 无论是堆还是栈,都要防止越界现象的发生。 关于 Global 和 Static 类型的一点讨论 1. static 全局变量与普通的全局变量有什么区别 ? 全局变量(外部变量)的定义之前再冠以 static 就构成了静态的全局变量。 全局变量本身就是静态存储方式, 静态全局变量当然也是静态存储方式。 这两者在存储方式上并无不同。 这两者的区别在于非静态全局变量的作用域是整个源程序, 当一个源程序由多个源文件组成时,非静态的全局变量在各个源文件中都是有效的。 而静态全局变量则限制了其作用域, 即只在定义该变量的源文件内有效, 在同一源程序的其它源文件中不能使用它。 由于静态全局变量的作用域局限于一个源文件内,只能为该源文件内的函数公用,因此可以避免在其它源文件中引起错误。 static 全局变量只初使化一次,防止在其他文件单元中被引用。 2. static 局部变量和普通局部变量有什么区别 ? 把局部变量改变为静态变量后是改变了它的存储方式即改变了它的生存期。把全局变量改变为静态变量后是改变了它的作用域,限制了它的使用范围。 static 局部变量只被初始化一次,下一次依据上一次结果值。 3. static 函数与普通函数有什么区别? static 函数与普通函数作用域不同,仅在本文件。只在当前源文件中使用的函数应该说明为内部函数(static),内部函数应该在当前源文件中说明和定义。对于可在当前源文件以外使用的函数,应该在一个头文件中说明,要使用这些函数的源文件要包含这个头文件.static 函数在内存中只有一份(.data),普通函数在每个被调用中维持一份拷贝。 谋胆并重

优秀的个人博客,低调大师

Linux动态监控进程

17.1 介绍 top与ps命令很相似。它们都用来显示正在执行的进程。top与ps最大的不同之处,在于top在执行一段时间可以更新正在运行的进程 17.2 语法 top [选项] 常用选项 交互操作 17.3 实例 (1)监视特定用户 top::输入此命令,按回车键,查看执行的进程。 u:然后输入u,回车,再输入用户名,即可。 (2)终止指定的进程 输入“k”回车,再输入要结束的进程ID号。 (3)指定系统状态更新的时间 top -d 10 17.4 查看系统网络情况 (1)基本语法 netstat [选项] (2)选项说明 -an 按一定顺序排列输出 -p 显示哪个进程在调用 (3)案例 查看系统所有的网络服务 查看服务名为sshd的服务的信息。

优秀的个人博客,低调大师

linux目录操作命令

目录的创建 比如我要在根目录下创建lives/human/man/programmer/目录,怎么创建? 阶梯式创建目录 ---mkdir 首先创建lives,其次创建human,进而创建man,然后创建programmer: [root@localhost /]# mkdir /lives [root@localhost /]# mkdir /lives/human [root@localhost /]# mkdir /lives/human/man [root@localhost /]# mkdir /lives/human/man/programmer 是不是有些繁琐?是!但是,这样创建目录,可以控制每一层目录的创建符合你的预期,错了,立马可以纠正。 跳跃式创建目录 ---mkdir -p 比如你想在/lives/human/下创建woman/consumer目录,问题是此时并没有woman目录,只有在woman的基础上才能创建onsumer, 如果强制创建,你将会看到: [root@localhost /]# mkdir /lives/human/woman/consumer mkdir: 无法创建目录"/lives/human/woman/consumer": 没有那个文件或目录 那么如何解决级联创建目录? [root@localhost /]# mkdir -p /lives/human/woman/consumer 此时的目录结构如下: [root@localhost /]# tree lives/ lives/ └── human ├── man │ ├── programmer │ └── scientist └── woman └── consumer 目录的切换 切换到父目录 切换到上一次目录 切换到当前用户主文件夹 切换到父目录:cd .. [root@localhost programmer]# pwd /lives/human/man/programmer [root@localhost programmer]# cd .. [root@localhost man]# pwd /lives/human/man 切换到上一次目录:cd - [root@localhost man]# pwd /lives/human/man [root@localhost man]# cd - /lives/human/man/programmer [root@localhost programmer]# 切换到当前用户主文件夹: cd ~或者 cd [root@localhost programmer]# pwd /lives/human/man/programmer [root@localhost programmer]# cd [root@localhost ~]# pwd /root 目录的删除 基本删除:删除的目录为空,被删除的目录下不能有目录或者文件 [root@localhost human]# pwd /lives/human [root@localhost human]# rmdir man rmdir: 删除 "man" 失败: 目录非空 [root@localhost man]# pwd /lives/human/man [root@localhost man]# rmdir scientist/ [root@localhost man]# ls -l 总用量 4 drwxr-xr-x. 2 root root 4096 5月 10 20:04 programmer 级联删除:无论目录是否为空,一概删除 [root@localhost human]# tree . ├── man │ └── programmer └── woman └── consumer 删除woman下的consumer, [root@localhost human]# rm -r woman/ rm:是否进入目录"woman"? 每删除一个非空目录都要提醒,很讨厌,希望不提醒,可以这样删: [root@localhost human]# tree . ├── man │ └── programmer └── woman └── consumer 4 directories, 0 files [root@localhost human]# rm -f -r woman/ [root@localhost human]# tree . └── man └── programmer 2 directories, 0 files

优秀的个人博客,低调大师

linux之awk命令

awk是一个非常棒的数据处理工具。相比于sed常常作用于一整行的处理,awk则比较倾向于将一行分成数个“字段”来处理。因此,awk 相当适合处理小型的数据处理。awk通常运行模式是这样的: [root@www ~]# awk '条件类型1{动作1} 条件类型2{动作2} 。。。' filename awk 后面接两个单引号并加上大括号来设置想要对数据进行的处理动作。awk 可以处理后续接的文件,也可以读取来自签个命令的standardoutput。但如前面所说的,awk主要是处理每一行的字段内的数据,而默认的字段的分隔符为空格键或[tab]键。举例来说,我们用 last 可以将登陆者的数据取出来,但我只想要取出账号与登录者的IP,且账号和IP之间以[tab]隔开 [root@www ~]# last -n 5 | awk '{print $1 "\t" $3}' <==可先用last -n 5 查看登录者数据,再进行操作 root 192.168.1.100 root 192.168.1.100 root 192.168.1.100 dmtsai 192.168.1.100 root Fri 上面是 awk 最常使用的动作。通过print 的功能将字段数据列出来!字段的分隔以空格或[tab] 隔开。第5行数据有点奇怪;这是因为数据格式的问题。所以使用awk的时候,请先确认一下你的数据,如果是连续性的数据,请不要有空格或[tab] 在内,否则就会像上面那样,发生误判。 另外,在每一行的每个字段都是有变量名称的,那就是$1,$2等变量名称。以上面的例子来说,root就是$1,因为它是第一列,至于192.168.1.100 是第三列,所以它就是 $3,后面以次类推。还有个变量$0,$0代表一整行数据的意思。 由此,上面5行当中,整个的awk处理流程是: 1.读入第一行,并将第一行数据填入$0,$1,$2等变量中; 2.依据条件类型的限制,判断是否需要进行后面的动作; 3.做完所有动作与条件类型; 4.若还有后续的“行”的数据,则重复上面1~3 的步骤,直到所有的数据都读完为止。 经过这样的步骤,你会晓得,awk 是以行为一次处理的单位,而以字段为最小的处理单位。那么awk 又怎么知道整个数据到底有几行和几列?这就需要 awk 的内置变量的帮忙了 NF: 每一行($0) 拥有的字段总数 NR: 目前awk 所处理的是 “第几行”数据 FS: 目前的分隔符,默认是空格

优秀的个人博客,低调大师

Linux关机&重启命令

基本介绍: shutdown -h now 立刻进行关机 shutdown -h 1 1分钟后关机 shutdown -r now 现在重启计算机 halt 关机,作用和上面一样 reboot 重启 sync 把内存的数据同步到磁盘 注意细节: 不管是重启系统还是关闭系统,首先要运行sync命令,把内存中的数据写到磁盘中 7.2 用户登录和注销 7.2.1 基本介绍: 1、登录时尽量少用root账户登录,因为它是系统管理员,最大的权限,避免操作失误。可以利用普通用户登录,登录后再用“su -用户名”命令来切换成系统管理员身份。 2、在提示符下输入logout即可注销用户 7.2.2 使用细节 1、logout注销指令在图形运行级别无效,在运行级别3下有效。

优秀的个人博客,低调大师

Linux 下netstat命令

netstat命令用于显示与IP、TCP、UDP和ICMP协议相关的统计数据,一般用于检验本机各端口的网络连接情况。netstat是在内核中访问网络及相关信息的程序,它能提供TCP连接,TCP和UDP监听,进程内存管理的相关报告。 如果你的计算机有时候接收到的数据报导致出错数据或故障,你不必感到奇怪,TCP/IP可以容许这些类型的错误,并能够自动重发数据报。但如果累计的出错情况数目占到所接收的IP数据报相当大的百分比,或者它的数目正迅速增加,那么你就应该使用netstat查一查为什么会出现这些情况了。 1 命令格式: netstat[-acCeFghilMnNoprstuvVwx][-A<网络类型>][--ip] 2 命令功能: netstat用于显示与IP、TCP、UDP和ICMP协议相关的统计数据,一般用于检验本机各端口的网络连接情况。 3 命令参数: -a或–all显示所有连线中的Socket。 -A<网络类型>或–<网络类型>列出该网络类型连线中的相关地址。 -c或–continuous持续列出网络状态。 -C或–cache显示路由器配置的快取信息。 -e或–extend显示网络其他相关信息。 -F或–fib显示FIB。 -g或–groups显示多重广播功能群组组员名单。 -h或–help在线帮助。 -i或–interfaces显示网络界面信息表单。 -l或–listening显示监控中的服务器的Socket。 -M或–masquerade显示伪装的网络连线。 -n或–numeric直接使用IP地址,而不通过域名服务器。 -N或–netlink或–symbolic显示网络硬件外围设备的符号连接名称。 -o或–timers显示计时器。 -p或–programs显示正在使用Socket的程序识别码和程序名称。 -r或–route显示RoutingTable。 -s或–statistice显示网络工作信息统计表。 -t或–tcp显示TCP传输协议的连线状况。 -u或–udp显示UDP传输协议的连线状况。 -v或–verbose显示指令执行过程。 -V或–version显示版本信息。 -w或–raw显示RAW传输协议的连线状况。 -x或–unix此参数的效果和指定”-Aunix”参数相同。 –ip或–inet此参数的效果和指定”-Ainet”参数相同。 4 使用实例: ★实例1:无参数使用 命令: netstat 输出: [root@localhost~]#netstat ActiveInternetconnections(w/oservers) ProtoRecv-QSend-QLocalAddressForeignAddressState tcp0268192.168.120.204:ssh10.2.0.68:62420ESTABLISHED udp00192.168.120.204:437110.58.119.119:domainESTABLISHED ActiveUNIXdomainsockets(w/oservers) ProtoRefCntFlagsTypeStateI-NodePath unix2[]DGRAM1491@/org/kernel/udev/udevd unix4[]DGRAM7337/dev/log unix2[]DGRAM708823 unix2[]DGRAM7539 unix3[]STREAMCONNECTED7287 unix3[]STREAMCONNECTED7286 [root@localhost~]# 说明: 从整体上看,netstat的输出结果可以分为两个部分: 一个是ActiveInternetconnections,称为有源TCP连接,其中"Recv-Q"和"Send-Q"指的是接收队列和发送队列。这些数字一般都应该是0。如果不是则表示软件包正在队列中堆积。这种情况只能在非常少的情况见到。 另一个是ActiveUNIXdomainsockets,称为有源Unix域套接口(和网络套接字一样,但是只能用于本机通信,性能可以提高一倍)。 Proto显示连接使用的协议,RefCnt表示连接到本套接口上的进程号,Types显示套接口的类型,State显示套接口当前的状态,Path表示连接到套接口的其它进程使用的路径名。 套接口类型: -t:TCP -u:UDP -raw:RAW类型 --unix:UNIX域类型 --ax25:AX25类型 --ipx:ipx类型 --netrom:netrom类型 状态说明: LISTEN:侦听来自远方的TCP端口的连接请求 SYN-SENT:再发送连接请求后等待匹配的连接请求(如果有大量这样的状态包,检查是否中招了) SYN-RECEIVED:再收到和发送一个连接请求后等待对方对连接请求的确认(如有大量此状态,估计被flood攻击了) ESTABLISHED:代表一个打开的连接 FIN-WAIT-1:等待远程TCP连接中断请求,或先前的连接中断请求的确认 FIN-WAIT-2:从远程TCP等待连接中断请求 CLOSE-WAIT:等待从本地用户发来的连接中断请求 CLOSING:等待远程TCP对连接中断的确认 LAST-ACK:等待原来的发向远程TCP的连接中断请求的确认(不是什么好东西,此项出现,检查是否被攻击) TIME-WAIT:等待足够的时间以确保远程TCP接收到连接中断请求的确认 CLOSED:没有任何连接状态 ★实例2:列出所有端口 命令: netstat-a 输出: 说明: 显示一个所有的有效连接信息列表,包括已建立的连接(ESTABLISHED),也包括监听连接请(LISTENING)的那些连接。 ★实例3:显示当前UDP连接状况 命令: netstat-nu 输出: ★实例4:显示UDP端口号的使用情况 命令: netstat-apu 输出: ★实例5:显示网卡列表 命令: netstat-i 输出: [root@andy~]#netstat-i KernelInterfacetable IfaceMTUMetRX-OKRX-ERRRX-DRPRX-OVRTX-OKTX-ERRTX-DRPTX-OVRFlg eth015000151818887000198928403000BMRU lo164360107235000107235000LRU [root@andy~]# ★实例6:显示组播组的关系 命令: netstat-g 输出: [root@andy~]#netstat-g IPv6/IPv4GroupMemberships InterfaceRefCntGroup ------------------------------------------ lo1all-systems.mcast.net eth01all-systems.mcast.net lo1ff02::1 eth01ff02::1:ffff:9b0c eth01ff02::1 [root@andy~]# ★实例7:显示网络统计信息 命令: netstat-s 输出: 说明: 按照各个协议分别显示其统计数据。如果我们的应用程序(如Web浏览器)运行速度比较慢,或者不能显示Web页之类的数据,那么我们就可以用本选项来查看一下所显示的信息。我们需要仔细查看统计数据的各行,找到出错的关键字,进而确定问题所在。 ★实例8:显示监听的套接口 命令: netstat-l 输出: [root@localhost~]#netstat-l ActiveInternetconnections(onlyservers) ProtoRecv-QSend-QLocalAddressForeignAddressState tcp00localhost:smux*:*LISTEN tcp00*:svn*:*LISTEN tcp00*:ssh*:*LISTEN udp00localhost:syslog*:* udp00*:snmp*:* ActiveUNIXdomainsockets(onlyservers) ProtoRefCntFlagsTypeStateI-NodePath unix2[ACC]STREAMLISTENING708833/tmp/ssh-yKnDB15725/agent.15725 unix2[ACC]STREAMLISTENING7296/var/run/audispd_events [root@localhost~]# ‍ ★实例9:显示所有已建立的有效连接 命令: netstat-n 输出: [root@localhost~]#netstat-n ActiveInternetconnections(w/oservers) ProtoRecv-QSend-QLocalAddressForeignAddressState tcp0268192.168.120.204:2210.2.0.68:62420ESTABLISHED ActiveUNIXdomainsockets(w/oservers) ProtoRefCntFlagsTypeStateI-NodePath unix2[]DGRAM1491@/org/kernel/udev/udevd unix4[]DGRAM7337/dev/log unix2[]DGRAM708823 unix2[]DGRAM7539 unix3[]STREAMCONNECTED7287 unix3[]STREAMCONNECTED7286 [root@localhost~]# ★实例10:显示关于以太网的统计数据 命令: netstat-e 输出: [root@localhost~]#netstat-e ActiveInternetconnections(w/oservers) ProtoRecv-QSend-QLocalAddressForeignAddressStateUserInode tcp0248192.168.120.204:ssh10.2.0.68:62420ESTABLISHEDroot708795 ActiveUNIXdomainsockets(w/oservers) ProtoRefCntFlagsTypeStateI-NodePath unix2[]DGRAM1491@/org/kernel/udev/udevd unix4[]DGRAM7337/dev/log unix2[]DGRAM708823 unix2[]DGRAM7539 unix3[]STREAMCONNECTED7287 unix3[]STREAMCONNECTED7286 [root@localhost~]# 说明: 用于显示关于以太网的统计数据。它列出的项目包括传送的数据报的总字节数、错误数、删除数、数据报的数量和广播的数量。这些统计数据既有发送的数据报数量,也有接收的数据报数量。这个选项可以用来统计一些基本的网络流量) ★实例11:显示关于路由表的信息 命令: netstat-r 输出: [root@localhost~]#netstat-r KernelIProutingtable DestinationGatewayGenmaskFlagsMSSWindowirttIface 192.168.120.0*255.255.255.0U000eth0 192.168.0.0192.168.120.1255.255.0.0UG000eth0 10.0.0.0192.168.120.1255.0.0.0UG000eth0 default192.168.120.2400.0.0.0UG000eth0 [root@localhost~]# ★实例12:列出所有tcp端口 命令: netstat-at 输出: ★实例13:统计机器中网络连接各个状态个数 命令: netstat-a|awk'/^tcp/{++S[$NF]}END{for(ainS)printa,S[a]}' 输出: [root@localhost~]#netstat-a|awk'/^tcp/{++S[$NF]}END{for(ainS)printa,S[a]}' ESTABLISHED1 LISTEN3 [root@localhost~]# ★实例14:把状态全都取出来后使用uniq-c统计后再进行排序 命令: netstat-nat|awk'{print$6}'|sort|uniq-c 输出: ★实例15:查看连接某服务端口最多的的IP地址 命令: netstat-nat|grep"192.168.120.20:16067"|awk'{print$5}'|awk-F:'{print$4}'|sort|uniq-c|sort-nr|head-20 输出: ★实例16:找出程序运行的端口 命令: netstat-ap|grepssh 输出: ★实例17:在netstat输出中显示PID和进程名称 命令: netstat-pt 输出: 说明: netstat-p可以与其它开关一起使用,就可以添加“PID/进程名称”到netstat输出中,这样debugging的时候可以很方便的发现特定端口运行的程序。 ★实例18:找出运行在指定端口的进程 命令: netstat-anpt|grep':16064' 输出: 说明: 运行在端口16064的进程id为24596,再通过ps命令就可以找到具体的应用程序了。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册