首页 文章 精选 留言 我的

精选列表

搜索[知识资产沉淀],共10000篇文章
优秀的个人博客,低调大师

Kubernetes集群部署关键知识总结

Kubernetes集群部署需要安装的组件东西很多,过程复杂,对服务器环境要求很苛刻,最好是能连外网的环境下安装,有些组件还需要连google服务器下载,这一点一般很难满足,因此最好是能提前下载好准备的就尽量下载好。 Kubernetes集群部署要求 服务器必须是Centos 7.2及以上 Kubernetes采用1.12版本 Docker-ce v17.03.2 Etcd 3.2.9 Flanneld v0.7.0-amd64 TLS 认证通信(所有组件,如etcd、kubernetes master 和node) RBAC 授权 kubedns、dashboard、heapster等插件 harbor,使用nfs后端存储 …… 部署方式 Minikube快速搭建单节点Kubenetes集群的工具,只能用作学习实践。 kubeadm是Kubernetes官方提供的用于快速安装Kubernetes集群的工具 使用Rancher部署K8S集群,布署在Docker环境中,方便快捷。 Ansible脚本安装K8S集群 如果对Rancher吃不透的话还是推荐使用Ansible脚本安装K8S集群,Ansible脚本将安装的流程都封装到了脚本里,只需更改安装主机服务器地址和环境就能实现一键布署。 推荐使用github上的kubeasz,能简化很多流程。 kubeasz致力于提供快速部署高可用k8s集群的工具, 并且也努力成为k8s实践、使用的参考书;基于二进制方式部署和利用ansible-playbook实现自动化:即提供一键安装脚本, 也可以分步执行安装各个组件, 同时讲解每一步主要参数配置和注意事项。 集群特性:TLS双向认证、RBAC授权、多Master高可用、支持Network Policy、备份恢复 布署关键点 为了初次安装顺利,关闭防火墙。 确保各节点时区设置一致、时间同步。 无法访问公网情况下,请下载离线docker镜像完成集群安装。 从国内下载docker官方仓库镜像非常缓慢,所以对于k8s集群来说配置镜像加速非常重要,配置/etc/docker/daemon.json,若访问不了外网就要配置局域网的镜像仓库地址。 docker要开启docker远程API修改docker配置文件docker.service 在ExecStart这一行后面加上 -H tcp://0.0.0.0:2375 -H unix:///var/run/docker.sock docker 从 1.13 版本开始,将iptables的filter表的FORWARD链的默认策略设置为DROP,从而导致 ping 其它 Node 上的 Pod IP 失败,因此必须在filter表的FORWARD链增加一条默认允许规则iptables -I FORWARD -s 0.0.0.0/0 -j ACCEPT 后续calico网络、kube-proxy等将大量使用 iptables规则,要维护好服务器本身的iptables规则。 网络组件 Kubernetes中网络是最复杂的,虽然从架构图上看是很清楚的,但实际操作起来还是到处报错,涉及到防火墙,iptables规则,服务器间的网络,网络组件的配置、容器与容器间的访问,容器与服务器的互相访问等等。 推荐flannel ,这里参考其它博文着重介绍下: Flannel的功能是让集群中的不同节点主机创建的Docker容器都具有全集群唯一的虚拟IP地址。 Flannel实质上是一种“覆盖网络(overlay network)”,也就是将TCP数据包装在另一种网络包里面进行路由转发和通信,Flannel的设计目的就是为集群中的所有节点重新规划IP地址的使用规则,从而使得不同节点上的容器能够获得“同属一个内网”且”不重复的”IP地址,并让属于不同节点上的容器能够直接通过内网IP通信。 默认的节点间数据通信方式是UDP转发,在Flannel的GitHub页面有如下的一张原理图: 1. 数据从源容器中发出后,经由所在主机的docker0虚拟网卡转发到flannel0虚拟网卡,这是个P2P的虚拟网卡,flanneld服务监听在网卡的另外一端。 Flannel也是通过修改Node的路由表实现这个效果的。 2. 源主机的flanneld服务将原本的数据内容UDP封装后根据自己的路由表投递给目的节点的flanneld服务,数据到达以后被解包,然后直接进入目的节点的flannel0虚拟网卡,然后被转发到目的主机的docker0虚拟网卡,最后就像本机容器通信一样由docker0路由到达目标容器。 3. 使每个结点上的容器分配的地址不冲突。Flannel通过Etcd分配了每个节点可用的IP地址段后,再修改Docker的启动参数。“--bip=X.X.X.X/X”这个参数,它限制了所在节点容器获得的IP范围。 flannel 使用 vxlan 技术为各节点创建一个可以互通的 Pod 网络,使用的端口为 UDP 8472,需要开放该端口。 kube-apiserver的高可用 keepalived+haproxy配置多个后端真实kube-apiserver的endpoints,并启用存活监测后端kube-apiserver,保证kube-apiserver的高可用。 dashboard dashboard 1.7 以后默认开启了自带的登陆验证机制,1.7 开始,dashboard 只允许通过 https 访问,如果使用 kube proxy 则必须监听 localhost 或 127.0.0.1,对于 NodePort 没有这个限制,但是仅建议在开发环境中使用。 对于不满足这些条件的登录访问,在登录成功后浏览器不跳转,始终停在登录界面。 参考:https://github.com/kubernetes/dashboard/wiki/Accessing-Dashboard---1.7.X-and-abovehttps://github.com/kubernetes/dashboard/issues/2540 kubernetes-dashboard 服务暴露了 NodePort,可以使用https://NodeIP:NodePort地址访问 dashboard; 通过 kube-apiserver 访问 dashboard; 通过 kubectl proxy 访问 dashboard: Ingress Ingress其实就是从kuberenets集群外部访问集群的一个入口,将外部的请求转发到集群内不同的Service 上,其实就相当于nginx、apache 等负载均衡代理服务器,再加上一个规则定义,路由信息的刷新需要靠Ingress controller来提供。 Ingress controller可以理解为一个监听器,通过不断地与kube-apiserver打交道,实时的感知后端service、pod 等的变化,当得到这些变化信息后,Ingress controller再结合Ingress的配置,更新反向代理负载均衡器,达到服务发现的作用。其实这点和服务发现工具consul的consul-template非常类似。 未配置ingress: 集群外部 -> NodePort -> K8S Service配置了ingress: 集群外部 -> Ingress -> K8S Service 注意:ingress 本身也需要部署Ingress controller时暴露NodePort让外部访问;如果你集群支持,可以方便地使用LoadBalancer地址暴露ingress服务。 Traefik 提供了一个简单好用 Ingress controller,是一款开源的反向代理与负载均衡工具。它最大的优点是能够与常见的微服务系统直接整合,可以实现自动化动态配置。 如果采用Rancher部署会有从k8s.gcr.io拉取镜像失败问题 新版本的Kubernetes在安装部署中,需要从k8s.grc.io仓库中拉取所需镜像文件,但由于国内网络防火墙问题导致无法正常拉取。 解决方案 docker.io仓库对google的容器做了镜像,可以通过下列命令下拉取相关镜像: docker pull mirrorgooglecontainers/kube-apiserver:v1.12.0 docker pull mirrorgooglecontainers/kube-controller-manager:v1.12.0 docker pull mirrorgooglecontainers/kube-scheduler:v1.12.0 docker pull mirrorgooglecontainers/kube-proxy:v1.12.0 docker pull mirrorgooglecontainers/pause:3.1 docker pull mirrorgooglecontainers/etcd:3.2.24 docker pull coredns/coredns:1.2.2 版本信息需要根据实际情况进行相应的修改。通过docker tag命令来修改镜像的标签: docker tag docker.io/mirrorgooglecontainers/kube-proxy:v1.12.0 k8s.gcr.io/kube-proxy:v1.12.0 docker tag docker.io/mirrorgooglecontainers/kube-scheduler:v1.12.0 k8s.gcr.io/kube-scheduler:v1.12.0 docker tag docker.io/mirrorgooglecontainers/kube-apiserver:v1.12.0 k8s.gcr.io/kube-apiserver:v1.12.0 docker tag docker.io/mirrorgooglecontainers/kube-controller-manager:v1.12.0 k8s.gcr.io/kube-controller-manager:v1.12.0 docker tag docker.io/mirrorgooglecontainers/etcd:3.2.24 k8s.gcr.io/etcd:3.2.24 docker tag docker.io/mirrorgooglecontainers/pause:3.1 k8s.gcr.io/pause:3.1 docker tag docker.io/coredns/coredns:1.2.2 k8s.gcr.io/coredns:1.2.2 使用docker rmi删除不用的镜像 dashboard无法显示监控图 dashboard 和heapster influxdb都部署完成后 dashboard依旧无法显示监控图 通过排查 heapster log有超时错误 $ kubectl logs -f pods/heapster-2882613285-58d9r -n kube-system E0630 17:23:47.339987 1 reflector.go:203] k8s.io/heapster/metrics/sources/kubelet/kubelet.go:342: Failed to list *api.Node: Get http://kubernetes.default/api/v1/nodes?resourceVersion=0: dial tcp: i/o timeout E0630 17:23:47.340274 1 reflector.go:203] k8s.io/heapster/metrics/heapster.go:319: Failed to list *api.Pod: Get http://kubernetes.default/api/v1/pods?resourceVersion=0: dial tcp: i/o timeout E0630 17:23:47.340498 1 reflector.go:203] k8s.io/heapster/metrics/processors/namespace_based_enricher.go:84: Failed to list *api.Namespace: Get http://kubernetes.default/api/v1/namespaces?resourceVersion=0: dial tcp: lookup kubernetes.default on 10.254.0.2:53: dial udp 10.254.0.2:53: i/o timeout E0630 17:23:47.340563 1 reflector.go:203] k8s.io/heapster/metrics/heapster.go:327: Failed to list *api.Node: Get http://kubernetes.default/api/v1/nodes?resourceVersion=0: dial tcp: lookup kubernetes.default on 10.254.0.2:53: dial udp 10.254.0.2:53: i/o timeout E0630 17:23:47.340623 1 reflector.go:203] k8s.io/heapster/metrics/processors/node_autoscaling_enricher.go Failed to list *api.Node: Get http://kubernetes.default/api/v1/nodes?resourceVersion=0: dial tcp: lookup kubernetes.default on 10.254.0.2:53: dial udp 10.254.0.2:53: i/o timeout E0630 17:23:55.014414 1 influxdb.go:150] Failed to create infuxdb: failed to ping InfluxDB server at "monitoring-influxdb:8086" - Get http://monitoring-influxdb:8086/ping: dial tcp: lookup monitoring-influxdb on 10.254.0.2:53: read udp 172.30.45.4:48955->10.254.0.2:53: i/o timeout` 我是docker的systemd Unit文件忘记添加 ExecStart=/root/local/bin/dockerd --log-level=error $DOCKER_NETWORK_OPTIONS 后边的$DOCKER_NETWORK_OPTIONS,导致docker0的网段跟flannel.1不一致。 kube-proxy报错kube-proxy[2241]: E0502 15:55:13.889842 2241 conntrack.go:42] conntrack returned error: error looking for path of conntrack: exec: “conntrack”: executable file not found in $PATH 导致现象:kubedns启动成功,运行正常,但是service 之间无法解析,kubernetes中的DNS解析异常 解决方法:CentOS中安装conntrack-tools包后重启kubernetes 集群即可。 Unable to access kubernetes services: no route to host 导致现象: 在POD 内访问集群的某个服务的时候出现no route to host $ curl my-nginx.nx.svc.cluster.local curl: (7) Failed connect to my-nginx.nx.svc.cluster.local:80; No route to host 解决方法:清除所有的防火墙规则,然后重启docker 服务 $ iptables --flush && iptables -tnat --flush $ systemctl restart docker 使用NodePort 类型的服务,只能在POD 所在节点进行访问 导致现象: 使用NodePort 类型的服务,只能在POD 所在节点进行访问,其他节点通过NodePort 不能正常访问 解决方法: kube-proxy 默认使用的是proxy_model就是iptables,正常情况下是所有节点都可以通过NodePort 进行访问的,我这里将阿里云的安全组限制全部去掉即可,然后根据需要进行添加安全限制。
优秀的个人博客,低调大师

js的基础知识笔记

目录 一、基本数据类型 二、函数 三、面向对象 一、基本数据类型 1、使用var声明变量、使用;结尾、使用{}表示代码块、使用驼峰式命名 2、变量是弱类型的,即并不严格要求声明变量的类型,一个变量可以在运行期间动态的指向不同类型的数据 3、变量声明后可以不定义(或叫赋值、初始化),此时它的值是undefined 4、符号$可以作为命名开头的特殊字母,jQuery使用它作为jquery函数的别名 5、数据分为两大类:原始数据和引用数据,所以一个变量中保存的值自然也有两类 原始数据:直接存放在栈中, 变量中保存着此数据的直接值 引用数据:存放在堆中,并把内存地址存放在栈中,即变量中存放着此对象的指针 6、原始类型:undefined、boolean、number、string、null 7、引用类型:即对象object,其他array、function等对象都是在object基础上进一步封装的对象 二、函数 1、函数也是一个对象,构造函数在功能上还类似于一个类 2、函数如果没有显式说明返回值,则默认return undefined 3、函数对输入参数的要求并不严格(数量、类型),可以使用arguments来获得一个函数的输入参数数组 4、函数也是一个对象意味着,函数可以被当做输入参数、也可以被return,这就意味着可以实现闭包 5、函数的toString()方法可以得到函数的源代码 6、闭包,保存了函数定义时上下文的执行环境,当函数执行时,可以获取到这些数据 闭包的支持意味着可以完成装饰器模式 7、函数声明和函数表达式在某些环境下有非常大的区别 函数声明: function show(){} 函数表达式: var show = function(){} 函数声明有很高的优先级,会被解释器提前解析并释放到执行环境中() console.log(show) // 可以正常的打印出show函数对象 function show(){} 以上两句语句可以正常执行而不报错,全局代码被扫描的时候通过词法分析会在当前函数的AO对象中设定show变量的值为对应函数 而函数表达式等价于一个赋值语句,只有在运行此句代码时才执行,一下语句会报错 console.log(show) var show = function(){} 8、词法分析,一个函数在被真正执行内部代码前,解释器会先扫描函数源代码并执行词法分析,目的是提前完成函数作用域的生成, 函数作用域通过一个AO对象来保存,后续在逐行执行函数代码时,所有的变量查询都通过AO对象,词法分析步骤: a、分析函数输入参数,若函数源代码出现输入参数,则发生此步骤。解释器在AO对象中添加此属性,值为undefined,若有接收实参,则覆盖原有的值 b、分析变量,若函数源代码中出现变量定义,则发生此步骤。解释器寻找AO对象中是否有此属性,若无则增加,值为undefined,若有,什么也不做 c、分析函数声明,若函数源代码中出现函数声明(函数表达式会被定义为步骤b),则发生此步骤。解释器寻找AO对象是否有此属性,若无则增加,若有,则覆盖 换句话说,如果在一个函数func1内部有另一个函数声明func2,此func1函数在真正被执行内部代码前就已经生成了AO对象并且func2函数已经在func1函数的作用域中 三、面向对象 1、js对象类似于Python中的字典,里面存放着无序的键值对 2、对象中的属性(数据属性、函数属性)权限均为公开的(和Python一样),使用_xxx_的方式约定俗成的表示成私有数据(Python中使用__xxx) 3、this指代当前对象,尤其在构造函数中使用时,指代当前被初始化的对象(类似Python的__init__中的self) 4、如何定义一个类(实际是构造函数) a、构造函数定义数据+原型定义函数(我个人比较常用此种方式,代码清晰) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; } Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } b、构造函数定义数据+函数(这种模型也可以用于处理单例模式) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; if(!Stu.__definedFlag){ //实际上此函数被当做单例模式 Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } var Stu.__definedFlag = true; } }

优秀的个人博客,低调大师

Java网络知识点总结

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80627294 通过IP地址和子网掩码与运算计算相关地址 http://blog.csdn.net/perddy/article/details/3137637 1、TCP/IP 1.1 TCP/IP四层模型 http://blog.csdn.net/hbtj_1216/article/details/76472747 1.2 IP、TCP、UDP首部详解 http://blog.csdn.net/hbtj_1216/article/details/76473088 1.3 IP是面向无连接的协议 IP是面向无连接的。在发包之前,不需要建立与对端目标地址之间的连接。上层如果有发送给IP的数据,该数据会立即被压缩成IP包发送出去。 可能存在的问题:丢包、错位、数据量翻倍等。 为什么IP要采用面向无连接的呢?主要有两点原因:(1)为了简化;(2)为了提速。面向连接比面向无连接处理相对复杂。甚至管理每个连接本身就是一个相当繁琐的事情。此外,每次通信之前都要事先建立连接,又会降低处理速度。需要有连接的时候,可以委托上一层的协议提供此项服务。因此,IP为了实现简单化与高速化采用了面向无连接的方式。并且,网络通信中如果能够进行有效的分层,就可以明确TCP与IP各自协议的最终目的,也有利于后续对这些协议进行扩展和性能上的优化。 1.4 TCP和UDP的区别 TCP与UDP区别总结: TCP面向连接。UDP是无连接的,即发送数据之前不需要建立连接。 TCP提供可靠的服务。也就是说,通过TCP连接传送的数据,无差错,不丢失,不重复,且按序到达;UDP尽最大努力交付,也就是说,不保证可靠交付。 TCP面向字节流,实际上是TCP把数据看成一连串无结构的字节流;UDP是面向报文的。UDP没有拥塞控制,因此网络出现拥塞不会使源主机的发送速率降低(对实时应用很有用,如IP电话,实时视频会议等)。 每一条TCP连接只能是点到点的;UDP支持一对一,一对多,多对一和多对多的交互通信。 TCP首部开销20字节;UDP的首部开销小,只有8个字节。 TCP的逻辑通信信道是全双工的可靠信道,UDP则是不可靠信道。http://blog.csdn.net/li_ning_/article/details/52117463 1.5 TCP三次握手和四次挥手 http://blog.csdn.net/hbtj_1216/article/details/76498441 1.5 TCP拥塞控制 http://www.jianshu.com/p/5f7fefed4d85 TCP参数 Netty中的ChannelOption常用参数详解http://blog.csdn.net/hbtj_1216/article/details/74199162 网络编程send,recv,read,write区别 http://blog.163.com/clevertanglei900@126/blog/static/111352259201122001933162/ 一篇文章完全搞清楚 scoket read/write 返回码、阻塞与非阻塞、异常处理 等让你头疼已久的问题 http://www.cnblogs.com/junneyang/p/6126635.html 2、HTTP 2.1 HTTP请求报文 http://blog.csdn.net/hbtj_1216/article/details/76525112 2.2 HTTP响应报文 http://blog.csdn.net/hbtj_1216/article/details/76528361 2.3 HTTP常见状态码 http://blog.csdn.net/hbtj_1216/article/details/76550362 HTTP状态码大全:http://www.runoob.com/http/http-status-codes.html 2.4 HTTP 长连接和短连接 http://blog.csdn.net/hbtj_1216/article/details/77529623 从用户浏览器输入 url 到用户看到页面结果的过程,发生了什么事情?(HTTP请求的过程) http://www.cnblogs.com/ddddemo/p/5624053.html HTTP、HTTPS 的区别 HTTPS协议和HTTP协议的区别: HTTPS协议需要到ca申请证书,一般免费证书很少,需要交费。 HTTP是超文本传输协议,信息是明文传输,HTTPS 则是具有安全性的SSL加密传输协议。 HTTP和HTTPS使用的是完全不同的连接方式用的端口也不一样,HTTP是80,HTTPS是443。 HTTP的连接很简单,是无状态的 。 HTTPS协议是由SSL+HTTP协议构建的可进行加密传输、身份认证的网络协议,要比HTTP协议安全。 http://www.jianshu.com/p/37654eb66b58 https加密完整过程 http://www.jianshu.com/p/2f6c93308370 HTTP1.0、HTTP2.0 的区别 http://blog.csdn.net/linsongbin1/article/details/54980801 GET、POST 的区别 http://blog.csdn.net/hbtj_1216/article/details/76552018 cookie 和 session 的区别 http://www.jianshu.com/p/aed2d6140c0a HTTP请求中 Session 实现原理 http://blog.csdn.net/zhq426/article/details/2992488 redirect与forward区别 http://blog.csdn.net/hbtj_1216/article/details/76607076 URI、URL、URN区别 URI全名为Uniform Resource Indentifier(统一资源标识),用来唯一的标识一个资源,是一个通用的概念,URI由两个主要的子集URL和URN组成 URL全名为Uniform Resource Locator(统一资源定位),通过描述资源的位置来标识资源 URN全名为Uniform Resource Name(统一资源命名),通过资源的名字来标识资源,与其所处的位置无关,这样即使资源的位置发生变动,其URN也不会变化 HTTP规范将更通用的概念URI作为其资源标识符,但是实际上,HTTP应用程序处理的只是URI的URL子集 DNS解析的过程 http://blog.csdn.net/charleslei/article/details/50116061 计算机各层网络协议 http://www.jianshu.com/p/d70d54879ca6 2、介绍一下Java NIO中的Buffer、Channel和Selector的概念和作用 http://blog.csdn.net/hbtj_1216/article/details/76446547Buffer和Channel详解:http://www.jianshu.com/p/052035037297 1、select、poll、epoll详解 http://blog.csdn.net/hbtj_1216/article/details/70568402 Level_triggered(水平触发):当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据一次性全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它还会通知你在上没读写完的文件描述符上继续读写,当然如果你一直不去读写,它会一直通知你!!!如果系统中有大量你不需要读写的就绪文件描述符,而它们每次都会返回,这样会大大降低处理程序检索自己关心的就绪文件描述符的效率!!! Edge_triggered(边缘触发):当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它不会通知你,也就是它只会通知你一次,直到该文件描述符上出现第二次可读写事件才会通知你!!!这种模式比水平触发效率高,系统不会充斥大量你不关心的就绪文件描述符!!! 阻塞IO:当你去读一个阻塞的文件描述符时,如果在该文件描述符上没有数据可读,那么它会一直阻塞(通俗一点就是一直卡在调用函数那里),直到有数据可读。当你去写一个阻塞的文件描述符时,如果在该文件描述符上没有空间(通常是缓冲区)可写,那么它会一直阻塞,直到有空间可写。以上的读和写我们统一指在某个文件描述符进行的操作,不单单指真正的读数据,写数据,还包括接收连接accept(),发起连接connect()等操作… 非阻塞IO:当你去读写一个非阻塞的文件描述符时,不管可不可以读写,它都会立即返回,返回成功说明读写操作完成了,返回失败会设置相应errno状态码,根据这个errno可以进一步执行其他处理。它不会像阻塞IO那样,卡在那里不动!!! 阻塞和非阻塞、同步和异步 http://blog.csdn.net/hbtj_1216/article/details/77866384

优秀的个人博客,低调大师

python学习-基础知识-1

1、计算机历史 计算机使用高低电压的两种状态来描述信息。计算机可以理解的只有二进制数据即010100011....,1个比特位可以表示的状态只有2种,n个比特位可以表示的状态有2的n次方种。 所以如果想要描述天气状态:天晴、下雨、刮风、下雪、霜冻,则需要使用3个比特位。 2、编程语言历史 计算机只能理解二进制数据,二进制数据中蕴含了很多指令、操作、数据,计算机通过cpu直接运行二进制代码执行不同的功能,二进制代码被称为机器语言。 但是机器语言(二进制代码)对于人类而言可读性太差、编写太困难,所以人类需要使用适合自身的语言来编程以操作计算机。 一开始,人类将机器语言中的代码进行分类、标记,把蕴含操作行为、蕴含数据的二进制代码使用英语单词标记,形成了汇编语言。汇编语言的模式是:操作行为+被操作数。 操作行为和被操作数都使用英语单词代替了一串010101的二进制代码,这样人类只需要编写汇编语言,再将汇编语言通过之前的映射关系转换成二进制即可。 通过汇编语言,人类即可以方便的编写代码,又可以通过转化得到对应的二进制代码让计算机运行。 但是,汇编语言依然可读性较差、编写也不是非常的方便,要实现一个简单的功能需要非常多的汇编代码,代码冗余性依然很高。 于是,人类模仿汇编和二进制的对应关系,将高级语言和汇编又对应起来,这时候人类就只需要编写高级语言,再通过编译器将高级语言转换成汇编语言或者直接转换成二进制代码。 高级语言的代码非常接近人类的英语,所以使用起来很方便。 因语法规则、语义的不同,高级语言分为很多种,如:python,java、c、c++、JavaScript,ruby等等。 3、编译型高级语言/解释性高级语言 高级语言接近人类英语,编写的代码可读性也很强,但是计算机是无法直接理解和执行源代码的,因为计算机只认识二进制代码,所以不论是哪一种高级语言,都需要将源代码转换成二进制代码后才能被计算机执行。 在转换过程中,有2种不同的情况: 1、编译型 编译型高级语言,在程序执行之前,需要提前将源代码通过编译器转换成目标文件(二进制代码),然后计算机直接执行目标文件。 优点:计算机执行效率高、速度快 缺点: 如果程序需要修改,必须修改源代码并再次编译,修改不方便 一旦编译完成,目标文件就只能在当前操作系统和cpu架构上运行,无法在其他平台使用,除非重新编译 举例:c、c++、c# 2、解释型 解释型高级语言,由解释器实时读取源代码并编译成二级制代码交由计算机执行。 优点: 程序的修改直接操作源文件即可,修改方便 只要计算机安装了对应平台的解释器,源代码就可以被执行,即一份源代码可以在不同平台运行,平台兼容性好 缺点: 因为需要实时编译,所以运行效率低、速度较慢 需要一个匹配版本和平台的解释器与源代码共同工作 举例:python、java、ruby 4、python版本 python有2个相互不兼容的大版本,版本2最高是2.7,版本3截止20180603最高是3.6.5。版本2官方宣布将会维护到2020年,建议现在选择版本3编码。 5、python解释器 解释器也是一种程序,功能是将python源代码翻译成机器语言。解释器可以使用多种语言编写,有如下几种: cpython,官方发布的解释器,使用c语言编写 ipython,在cpython基础上套了一个壳,提高用户交互性 pypy,据说使用jit技术动态实时编译使得代码运行速度更快,但是目前暂不成熟 jpython和icronpython,使用java和.net编写,一般不使用 6、python文件执行 两种方式执行python文件,一种是启动解释器并将python源文件作为参数,解释器读取文件中代码。一种是启动解释器,在交互环境编写代码执行。 7、变量 1、变量存在的原因 用于保存阶段性计算的结果,同时变量用于描述程序中的一些数据,良好的变量命名和使用会增加代码的可读性。 2、变量命名规范 变量名可以是数字、字母、下划线的任意组合,注意:不可使用除了下划线之外的特殊字符 变量名开头不能是数字 变量名不能和python预定义的关键字重名 注意:python竟然可以使用中文作为变量名! 3、变量定义语法 age = 26 定义一个变量,它的名字是age,此变量指向内存中的一个对象,此对象值是26 8、常量 常量的命名规范和变量一样,不过常量的命名约定俗成的是全大写。 常量用于保存基本不变的数据,python没有提供类似c语言的const关键字来强制规定常量的不可变性,所以python中的常量是约定俗成的不可变。 9、python安装 www.python.org官网下载最新版本3.6.5,根据电脑配置选择32或者64位,安装的时候选择add to path并自定义安装位置和其他高级选项,安装完成可以直接shell进入python解释器。 10、输入/输出 python中通过input函数提供shell输入,通过print函数提供shell打印。 input函数会阻塞程序执行直到获取shell输入值 11、注释 不论哪一种高级语言,我们在编码的时候都是将脑海中的思路、信息、步骤简化成实际的代码。将大脑中的信息转换成实际代码的时候,会有很大的信息量丢失,即代码所表达的信息量是很少的。 所以单独的代码无法还原编码时的全部信息量,此时我们就需要使用注释来弥补代码缺失的信息量。优秀的注释+代码可以提供很高的可读性,也方便后续代码使用和维护。 注释有几个需要遵守的规范: 1、注释的内容应该保持与代码的强一致性,注释应该精简、准确的表达代码的含义、编码背景等 2、可以使用中文或者英文 3、注意注释的使用量,在适当且必要的地方使用注释,如:重要流程节点、复杂代码块解释等 12、数据类型 计算机只认识二进制,对于计算机而言,数据没有类别,全部都是010101010... 但是对于人类而言,人类世界中的数据、信息是五花八门的,我们编码的过程其实就是在计算机世界中对现实世界进行建模的过程,所以我们需要对人类世界的数据划分类别。 基础的数据类型有:数字(整数+小数)、字符串、布尔值 我们使用int来表示整数类型、float表示小数类型 我们使用str表示字符串类型 我们使用bool表示布尔值类型 数字类型用于计算、字符串类型用于表示信息、布尔类型用于判断 13、字符串格式化输出 所谓格式化输出,其实就是在编码过程中定义展示模板,在模板中通过占位符代表后续有对应数据填充在此。 占位符: %d 整数类型 %f 小数类型 %s 字符串类型(%s是万能匹配,即任意数据类型都可以填充到%s占位符中) %r 原格式(将数据的原始格式存放到%r占位符中,如字符串的原格式就包含引号) 14、运算符 算数运算符 + - * / (注意,/ 除法运算符得到的商可以是小数,即5/2 = 2.5) // % (地板除得到的结果是商的整数部分,如5//2 = 2。取模得到的结果是未整除的结果,如5%2 = 1,对2取模可以判断奇偶。) ** (幂运算,5**2 = 25) 比较运算符 == > < >= <= != (==表示的是两边对象的值是否相等,python3中使用!=表示不等于,不再使用<>) 赋值运算符 = (赋值) += -= *= /= //= %= **= (在原有值的基础上做运算,并赋值给原有变量,如a = 5, a %= 2,此时a = 1) 逻辑运算符 and or no (逻辑判断会使用短路判断,所以:使用and的时候,概率小的放前面。使用or的时候,概率大的放前面。) 15、流程控制-分支 程序默认是自上而下没有分支的执行代码。很多时候我们需要通过判断程序运行中间的某一种状态、情况、值,来决策程序下一步该执行哪些代码。 通过分支提供多条执行路线,分支有双分支、多分支。 之所以可以划分多种分支是因为可能出现多种不同条件,而这些条件的概率和应该为1。 分支需要特别注意条件判断的逻辑性,多种条件只会执行其中一个条件,条件之间是相互对立的。 通过if elif elif else来提供多分支,通过条件的布尔值结果判断条件是否成立。 注意:条件判断应该把概率大的放在前面,概率小的放后面,对于无法明确具体判断条件的可以放在else统一匹配。另外,判断input的返回值的时候注意,input返回值一定是字符串。 16、流程控制-循环-while while关键字后面的语义是:判断条件是否成立?成立的话执行一次循环体然后再次判断条件是否成立。不成立的话跳过此循环体执行后续代码。 因为循环代码有导致死循环的风险,所以任何一个循环定义,都需要预先设计循环跳出条件。循环可以在循环体中通过break跳出,或者通过while条件判断不成立跳过。(当然,也可以在循环体中exit) 通过continue可以提前结束当前循环,直接开始下一次的循环while判断,注意:continue应用于跳过后续本应该执行的代码。 因为continue可以跳过后续本应该执行的代码,而后续执行代码中可能包含循环跳出的设置如:i += 1。所以continue的使用会有死循环风险,需要单独处理循环跳出问题。 17、while...else... 据说使用while后面的else,如果while正常执行完毕,则执行else。如果while没有正常执行完毕如被break打断,则不会执行else。可以使用else是否执行来判断循环是否正常执行完毕,我觉得这并不合理,考虑下述代码: 1 i = 11 2 while i < 10: 3 print('i is:', i) 4 i += 1 5 if i == 3: 6 break 7 else: 8 print('循环正常执行完毕') 9 10 # 循环没有正常执行完毕,实际上循环根本就没执行,else也被执行了。所以else被用于判断 11 # while是否正常执行我觉得并不合理。 18、while的使用 思考如下练习: # 使用while,完成以下图形的输出 # # * # * * # * * * # * * * * # * * * * * # * * * * # * * * # * * # * 1 star = 1 2 most_star = 5 3 while star <= most_star: 4 print(' *' * star) 5 if star == most_star: 6 while most_star > 0: 7 most_star -= 1 8 print(' *' * most_star) 9 break 10 star += 1 11 12 row = 1 13 most_row = 5 14 while row <= most_row: 15 print(' *' * row) 16 row += 1 17 row = most_row - 1 18 while row > 0: 19 print(' *' * row) 20 row -= 1 while循环只能打印一个方向,如果是两个相反的方向,需要两个while。两个while可以写成第二个while放在第一个while的末尾。

优秀的个人博客,低调大师

代码审计补充知识点

参考文献:https://hacksec.xyz/2018/03/23/php-trick/?nsukey=cWDNgiIxMsJayPNWtqM8Rc9amSOIgC0SI9Ko3jxxW2uV9mcoLNLdl4Q1U%2BrV9UhKIs3das0Cizzc8atumDKxG5nHSDPPthMpgeq5Xqa02MDie21AnddLn9BUUyOdXVEOsbvHRrlq1S61OS4%2BRpRffcBRIuwbJUdeL%2FEcZRNmvBtBzhuGQhuRU9fs%2BM9pyrRyVvKRlq5SmzZRSXFYcAjYcQ%3D%3D https://www.jianshu.com/p/9c8c9272e12e ①is_numeric函数 在判断是否是数字时会忽略字符串开头的’ ‘、’\t’、’\n’、’\r’、’\v’、’\f’。 ​ 而’.’可以出现在任意位置,E、e能出现在参数中间,仍可以被判断为数字。也就是说is_numeric(“\r\n\t 0.1e2”) >> TRUE intval()函数会忽略’’ ‘\n’、’\r’、’\t’、’\v’、’\0’ ,也就是说intval(“\r\n\t 12”) >> 12 ②PHP变量名不能带有点[.] 和空格,否则在会被转化为下划线[_] parse_str("na.me=admin&pass wd=123",$test); var_dump($test); 结果: ["na_me"]=> string(5) "admin" ["pass_wd"]=> string(3) "123" } ③htmlspecialchars()函数默认只转义双引号不转义单引号,如果都转义的话需要添加上参数ENT_QUOTES ④in_arrary()函数默认进行松散比较(进行类型转换) in_arrary(“1asd”,arrart(1,2,3,4)) => true in_arrary(“1asd”,arrart(1,2,3,4),TRUE) => false \\(需要设置strict参数为true才会进行严格比较,进行类型检测) ⑤sprintf()格式化漏洞(可以吃掉转义后的单引号) 当我们输入的特殊字符被放到引号中进行转义时,但是又使用了sprintf函数进行拼接时,例如%1$’%s’ 中的 ‘%被当成使用%进行padding,导致后一个’逃逸了 还有一种情况就是’被转义成了\’,例如输入%’ and 1=1#进入,存在SQL过滤,’被转成了\’,于是sql语句变成了 select * from user where username = ‘%\’ and 1=1#’;如果这个语句被使用sprintf函数进行了拼接,%后的\被吃掉了,导致了’逃逸 $sql = "select * from user where username = '%\' and 1=1#';"; $args = "admin"; echo sprintf( $sql, $args ) ; //result: select * from user where username = '' and 1=1#' ?> 不过这样容易遇到 PHP Warning: sprintf(): Too few arguments的报错,这个时候我们可以使用%1$来吃掉转义添加的\ <?php $sql = "select * from user where username = '%1$\' and 1=1#' and password='%s';"; $args = "admin"; echo sprintf( $sql, $args) ; //result: select * from user where username = '' and 1=1#' and password='admin'; ?> ⑥php中 = 赋值运算的优先级高于and $c = is_numeric($a) and is_numeric($b)程序本意是要a、b都为数字才会继续,但是当$a为数字时,会先赋值给$c,所以可能导致$b绕过检测 ⑦url标准的灵活性导致绕过filter_var与parse_url进行ssrf parse_url() 是专门用来解析 URL 而不是 URI 的。不过为遵从 PHP 向后兼容的需要有个例外,对 file:// 协议允许三个斜线(file:///...)。其它任何协议都不能这样. filter_var()函数对于http://evil.com;google.com 会返回false也就是认为url格式错误,但是对于0://evil.com:80;google.com:80/、0://evil.com:80,google.com:80/、0://evil.com:80\google.com:80/却返回true。 ⑧通过file_get_contents获取网页内容并返回到客户端有可能造成xss if(filter_var($argv[1], FILTER_VALIDATE_URL)) { // parse URL $r = parse_url($argv[1]); print_r($r); // check if host ends with google.com if(preg_match('/baidu\.com$/', $r['host'])) { // get page from URL $a = file_get_contents($argv[1]); echo($a); } else { echo "Error: Host not allowed"; } } else { echo "Error: Invalid URL"; } 虽然通过filter_var函数对url的格式进行检查,并且使用正则对url的host进行限定, 但是可以通过data://baidu.com/plain;base64,PHNjcmlwdD5hbGVydCgxKTwvc2NyaXB0Pgo== 页面会将<script>alert(1)</script>返回给客户端,就有可能造成xss ⑨parse_url与libcurl对与url的解析差异可能导致ssrf 当url中有多个@符号时,parse_url中获取的host是最后一个@符号后面的host,而libcurl则是获取的第一个@符号之后的。因此当代码对http://user@eval.com:80@baidu.com 进行解析时,PHP获取的host是baidu.com是允许访问的域名,而最后调用libcurl进行请求时则是请求的eval.com域名,可以造成ssrf绕过。此外对于https://evil@baidu.com这样的域名进行解析时,php获取的host是evil@baidu.com,但是libcurl获取的host却是evil.com ⑩md5碰撞 $Param1="\x4d\xc9\x68\xff\x0e\xe3\x5c\x20\x95\x72\xd4\x77\x7b\x72\x15\x87\xd3\x6f\xa7\xb2\x1b\xdc\x56\xb7\x4a\x3d\xc0\x78\x3e\x7b\x95\x18\xaf\xbf\xa2\x00\xa8\x28\x4b\xf3\x6e\x8e\x4b\x55\xb3\x5f\x42\x75\x93\xd8\x49\x67\x6d\xa0\xd1\x55\x5d\x83\x60\xfb\x5f\x07\xfe\xa2"; $Param2="\x4d\xc9\x68\xff\x0e\xe3\x5c\x20\x95\x72\xd4\x77\x7b\x72\x15\x87\xd3\x6f\xa7\xb2\x1b\xdc\x56\xb7\x4a\x3d\xc0\x78\x3e\x7b\x95\x18\xaf\xbf\xa2\x02\xa8\x28\x4b\xf3\x6e\x8e\x4b\x55\xb3\x5f\x42\x75\x93\xd8\x49\x67\x6d\xa0\xd1\xd5\x5d\x83\x60\xfb\x5f\x07\xfe\xa2"; #008ee33a9d58b51cfeb425b0959121c9 $data1="\xd1\x31\xdd\x02\xc5\xe6\xee\xc4\x69\x3d\x9a\x06\x98\xaf\xf9\x5c\x2f\xca\xb5\x07\x12\x46\x7e\xab\x40\x04\x58\x3e\xb8\xfb\x7f\x89\x55\xad\x34\x06\x09\xf4\xb3\x02\x83\xe4\x88\x83\x25\xf1\x41\x5a\x08\x51\x25\xe8\xf7\xcd\xc9\x9f\xd9\x1d\xbd\x72\x80\x37\x3c\x5b\xd8\x82\x3e\x31\x56\x34\x8f\x5b\xae\x6d\xac\xd4\x36\xc9\x19\xc6\xdd\x53\xe2\x34\x87\xda\x03\xfd\x02\x39\x63\x06\xd2\x48\xcd\xa0\xe9\x9f\x33\x42\x0f\x57\x7e\xe8\xce\x54\xb6\x70\x80\x28\x0d\x1e\xc6\x98\x21\xbc\xb6\xa8\x83\x93\x96\xf9\x65\xab\x6f\xf7\x2a\x70"; $data2="\xd1\x31\xdd\x02\xc5\xe6\xee\xc4\x69\x3d\x9a\x06\x98\xaf\xf9\x5c\x2f\xca\xb5\x87\x12\x46\x7e\xab\x40\x04\x58\x3e\xb8\xfb\x7f\x89\x55\xad\x34\x06\x09\xf4\xb3\x02\x83\xe4\x88\x83\x25\x71\x41\x5a\x08\x51\x25\xe8\xf7\xcd\xc9\x9f\xd9\x1d\xbd\xf2\x80\x37\x3c\x5b\xd8\x82\x3e\x31\x56\x34\x8f\x5b\xae\x6d\xac\xd4\x36\xc9\x19\xc6\xdd\x53\xe2\xb4\x87\xda\x03\xfd\x02\x39\x63\x06\xd2\x48\xcd\xa0\xe9\x9f\x33\x42\x0f\x57\x7e\xe8\xce\x54\xb6\x70\x80\xa8\x0d\x1e\xc6\x98\x21\xbc\xb6\xa8\x83\x93\x96\xf9\x65\x2b\x6f\xf7\x2a\x70"; #79054025255fb1a26e4bc422aef54eb4

优秀的个人博客,低调大师

JavaScript的常用基础知识

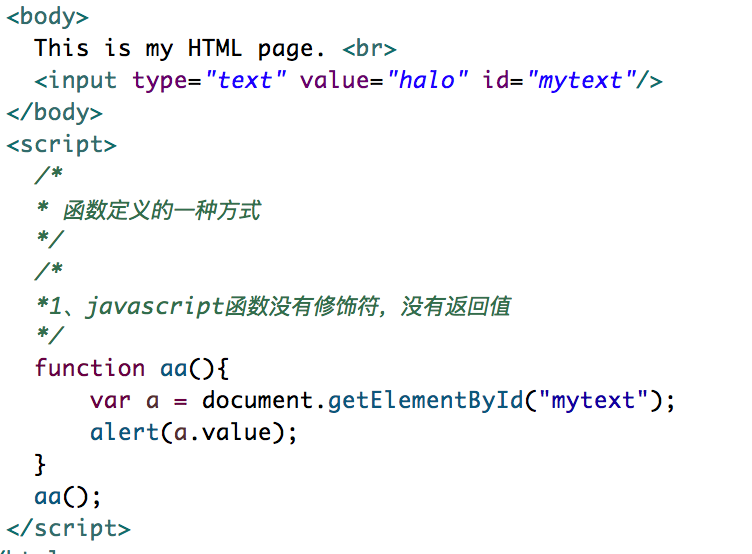
前言 稻光养晦,未雨绸缪 函数的定义 函数定义的第一种方式 屏幕快照 2018-01-26 17.39.05.png 说明 1 . 这是最正常的一种函数表达式 2 . 函数aa可以接受任意的参数 3 . 可以有返回值,可以用变量来接受其返回值 4 . 如果没有return,则返回undefined. 函数定义的第二种方式 屏幕快照 2018-01-26 17.41.48.png 说明 1 . 直接给变量赋值一个函数 2 . 在项目开发中是一种比较常见的形式 Dom对象 DOM是Document Object Model文档对象模型的缩写。根据W3C DOM规范,DOM是一种与浏览器,平台,语言无关的接口,使得你可以访问页面其他的标准组件。 D:文档 – html 文档 或 xml 文档 O:对象 – 把document里的所有节点都看成对象 M:模型(用于建立从文档到对象的模型) 结构如下: 屏幕快照 2018-01-27 00.02.59.png 对应的html页面: 屏幕快照 2018-01-27 00.03.11.png 从上述两个图中可以看出: 1 . 整个html称为dom树,而dom的引用为document,也称为一个节点。 2 . 每一个HTML标签都为一个元素节点 3 . 标签中的文字则是文本节点 4 . 标签中的属性则是属性节点 5 . dom中元素、文本、属性都是节点 6 . dom树是由节点构成的 7 . 每个节点都代表一个对象 常用的API getElementById() 说明: 1、 查询给定ID属性值的元素,返回该元素的元素节点。也称为元素对象。 2、 因为在一个html页面中id的值是唯一的,所以返回值也是唯一的。所以方法的名称为getElementById()而不是getElementsById()。 3、 该方法只能用于document对象,类似与java的static关键字。 例子 屏幕快照 2018-01-27 00.24.44.png getElementsByName() 说明: 1、查找给定name属性的所有元素,这个方法将返回一个节点集合,也可以称为对象集合。 2、这个集合可以作为数组来对待,length属性的值表示集合的个数。 3、因为在html页面中,name不能唯一确定一个元素,所以方法的名称为getElementsByName而不是getElementByName。 例子 屏幕快照 2018-01-27 00.25.53.png getElementsByTagName() 说明: 1、查询给定标签名的所有元素 2、因为在html页面中,标签名不是唯一的,所以返回值为节点的集合。 3、这个集合可以当做数组来处理,length属性为集合里所有元素的个数 例子 <!DOCTYPE html> <html> <head> <title>getElementsByTagName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <form name="form1" action="test.html" method="post"> <input type="text" name="halo" value="我是Halo1!!!" id="halo1"> <input type="text" name="halo" value="我是Halo2!!!" id="halo2"> <input type="text" name="halo" value="我是Halo3!!!" id="halo3"> <input type="text" name="halo" value="我是Halo4!!!" id="halo4"> <input type="button" name="ok" value="OK"> </form> <select name="sport" id="sport"> <option value="篮球">乔丹</option> <option value="足球" selected="selected">梅西</option> <option value="乒乓球">刘国梁</option> <option value="台球">丁俊晖</option> </select> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /*** *1、获取所有input元素的值 *2、输出所有input元素的值,不包括按钮,并且点击文本框,获取相应的值。 *3、输出所有下拉选 id=“edu” 的value值 *4、输出所有下拉选框的内容 *5、选择下拉列表框的内容,并且弹出所选择的内容 *6、针对每一个下拉列表框的内容,弹出所选中的内容 ***/ //1. /******************************************************************/ /* //1.获取所有input元素的值 var inputElements = document.getElementsByTagName("input"); //遍历inputElements数组元素的每一个对象 for(var i=0;i < inputElements.length;i++){ alert(inputElements.item(i).value); } */ //2. /******************************************************************/ //输出所有input元素的值,不包括按钮,并且点击文本框,获取相应的值。 //1、获取input元素的对象数组 var inputElements = document.getElementsByTagName("input"); //2、遍历数组 /* for(var i=0;i<inputElements.length;i++){ if(inputElements[i].type != "button"){ alert(inputElements[i].value); inputElements[i].onclick = function(){ alert(this.value); } } } */ //3. /******************************************************************/ //输出所有下拉选 id=“edu” 的value值 //eduElement.childNodes获取的是所有子节点及子子节点。 /* //1、获取id为edu的对象 var eduElement = document.getElementById("edu"); //2、获取id为edu的对象的子节点 var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].value); } */ //4. /******************************************************************/ //输出所有下拉选框的内容 /* var optionElements = document.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].value); } */ //5. /******************************************************************/ //选择下拉列表框的内容,并且弹出所选择的内容 //1.获取所有的select元素的对象 var selectElements = document.getElementsByTagName("select"); //2.遍历所有的select对象,并且赋值onchange方法 for(var i=0; i<selectElements.length;i++){ selectElements[i].onchange = function(){ //this代表选中的option对象 alert(this.value); } } //6. /******************************************************************/ //针对每一个下拉列表框的内容,弹出所选中的内容 var selectElement1 = document.getElementById("sport"); var selectElement2 = document.getElementById("edu"); selectElement1.onchange = function(){ alert(this.value); } selectElement2.onchange = function(){ alert(this.value); } </script> </html> hasChildNodes() 说明 1、该方法用来判断一个元素是否有子节点。 2、返回值为true或者false。 3、文本节点和属性节点不可能再包含子节点,所以对于这两类节点使用 hasChildNodes()方法返回值永远为false。 4、如果hasChildNodes()返回值为false,则childNodes,firstChild,lastChild将为空数组或者空字符串。 例子 <!DOCTYPE html> <html> <head> <title>hasChildNodes.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <form name="form1" action="test.html" method="post"> <input type="text" name="halo" value="我是Halo1!!!" id="halo1"> <input type="text" name="halo" value="我是Halo2!!!" id="halo2"> <input type="text" name="halo" value="我是Halo3!!!" id="halo3"> <input type="text" name="halo" value="我是Halo4!!!" id="halo4"> <input type="button" name="ok" value="OK"> </form> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分两种情况输出hasChildNodes()的值 * 1、有子节点 * 2、没有子节点 */ //输出有子节点的值 var eduElement = document.getElementById("edu"); //因为有子节点,所以返回值为true alert(eduElement.hasChildNodes()); //输出没有子节点的值 var halo1Element = document.getElementById("halo1"); alert(halo1Element.hasChildNodes()); </script> </html> nodeName属性 说明 1、文档中的每一个节点都有这个属性。 2、为给定节点的名称。 3、如果节点是元素节点,nodeName返回元素的名称;如果给定节点为属性节点,nodeName返回属性的名称;如果给定节点为文本节点,nodeName返回为#text的字符串; 例子 <!DOCTYPE html> <html> <head> <title>nodeName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> <option value="专科">专科学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeName * */ //1.获得edu对象 var eduElement = document.getElementById("edu"); //2.获得edu对象的nodeName alert(eduElement.nodeName); //这一步获得的是<select name="edu" id="edu">的name属性的值 //var nameElement = eduElement.name; //通过eduElement.getAttributeNode()可以获取属性的对象 var nameElement = eduElement.getAttributeNode("name"); alert(nameElement.nodeName); var idElement = eduElement.getAttributeNode("id"); alert(idElement.nodeName); var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].nodeName); var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeName); } </script> </html> nodeType属性 说明 1、该节点表明节点类型,返回值为一个整数 2、常用的节点类型有三种: (1)、 元素节点类型 值为1 (2)、属性节点类型 值为2 (3)、文本节点类型 值为3 例子 <!DOCTYPE html> <html> <head> <title>nodeName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeType *输出option元素的子节点文本元素的元素类型 */ //1.分别输出edu元素节点元素及属性name,id的nodeType var eduElement = document.getElementById("edu"); //alert(eduElement.nodeType); var nameElement = eduElement.getAttributeNode("name"); //alert(nameElement.nodeType); var idElement = eduElement.getAttributeNode("id"); //alert(idElement.nodeType); var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ //alert(optionElements[i].nodeType); var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeType); var textElement = optionElements[i].firstChild; alert(textElement.nodeType); } </script> </html> nodeType属性 说明 1、返回给定节点的当前值(字符串)。 2、如果给定节点是属性节点,返回值是这个属性的值;如果给定节点是文本节点,返回值是这个文本节点的内容;如果给定节点是元素节点,返回值是null。 3、nodeValue是一个读写属性。 例子 <!DOCTYPE html> <html> <head> <title>nodeValue.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeValue *输出option元素的子节点文本元素的元素类型 */ //1、获得edu的元素节点 var eduElement = document.getElementById("edu"); //2、获得eduElement的nodeValue的值 alert(eduElement.nodeValue); //获得edu属性name的元素节点值 var nameElement = eduElement.getAttributeNode("name"); alert(nameElement.nodeValue); //获得edu属性id的元素节点值 var idElement = eduElement.getAttributeNode("id"); alert(nameElement.nodeValue); //输出option元素的子节点文本元素的元素类型 var optionElements = eduElement.getElementsByTagName("option"); for(var i = 0; i < optionElements.length; i++){ var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeValue); var textElement = optionElements[i].firstChild; alert(textElement.nodeValue); } </script> </html> replaceChild() 说明 1、把一个给定父元素里的一个子节点替换为另外一个子节点; 2、var reference = element.replaceChild(newChild,oldChild); 3、返回值指向已经被替换掉的那个子节点的引用; 例子 <!DOCTYPE html> <html> <head> <title>replaceChild.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的城市:<br> <ul> <li id="wh" value="wuhan">武汉</li> <li id="km" value="kunming">昆明</li> <li id="sz" value="shenzhen">深圳</li> </ul> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value="daye">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /* *点击北京节点,将被给力节点替换 */ window.onload = function(){ //1、得到北京节点 var whElement = document.getElementById("wh"); //2、注册onclick事件 whElement.onclick = function(){ //3、找到wh节点的父节点 var ulElement = whElement.parentNode; //4、获得gl节点 var dyElement = document.getElementById("dy"); //5、替换 ulElement.replaceChild(dyElement,whElement); } } </script> </html> getAttribute() 说明 1、返回一个给定元素的给定属性的节点的值 2、var attributeValue = element.getAttribute(attributeName) 3、给定属性的名字必须以字符串的形式传递给该方法 4、给定属性的值将以字符串的形式返回 5、通过属性获取属性节点getAttributeNode(属性的名称) --返回属性节点 例子 <!DOCTYPE html> <html> <head> <title>getAttribute.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value="daye">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 获取<li id="six" value="sixsixsix">666</li>的属性id和value的值 **/ var sixElement = document.getElementById("six"); //第一种方法: alert(sixElement.getAttributeNode("id").nodeValue); alert(sixElement.getAttributeNode("value").nodeValue); //第二种方法: alert(sixElement.getAttribute("id")); alert(sixElement.getAttribute("value")); </script> </html> setAttribute() 说明 1、将给定元素添加一个新的属性或改变它现有属性的值; 2、element.setAttribute(attributeName,attributeValue); 3、属性的名字和值必须以字符串的形式传递; 4、如果这个属性已经存在,那么值将被attributeValue取代; 5、如果这个属性不存在,那么先创建它,再给他赋值; 例子 <!DOCTYPE html> <html> <head> <title>setAttribute.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value=daye"">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 给<li id="ly" value="laoye">老爷</li>增加一个name属性,并赋值,然后输出 **/ var lyElement = document.getElementById("ly"); lyElement.setAttribute("name", "halo"); alert(lyElement.getAttribute("name")); </script> </html> createElement() 说明 1、按照给定的标签名创建一个新的元素节点,方法的参数为被创建的元素的名称; 2、var reference = document.createElement(elementName); 3、方法的返回值指向新建节点的引用,返回值是一个元素节点,所以nodeType 为1; 4、新建的节点不会自动添加到文档里,只是存在于document里一个游离的对象; 例子 <!DOCTYPE html> <html> <head> <title>createElement.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value=daye"">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 为ul增加一个新的元素<li id="cs" value="cs">计算机</li> ** **/ //1.创建<li></li> var liElement = document.createElement("li"); //2.创建文本节点 传说 var textElement = document.createTextNode("计算机"); //3.<li id="cs" value="cs">计算机</li>的形成 liElement.appendChild(textElement); liElement.setAttribute("id", "cs"); liElement.setAttribute("value", "cs"); //4.获得ul对象 var ulElement = document.getElementsByTagName("ul")[0]; ulElement.appendChild(liElement); </script> </html> innerHTML属性 说明 用来读写某个元素中的HTML内容 例子 <!DOCTYPE html> <html> <head> <title>innerHTML.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <div id="mydiv"><h1 id="h">halo是我的简称!!</h1></div> </body> <script type="text/javascript"> /** *读取div中的html内容 **/ var divElement = document.getElementById("mydiv"); var h1Element = document.getElementById("h") alert(divElement.textContent); alert(h1Element.textContent); </script> </html> window.onload 说明 1、在页面上所有的数据加载完以后触发该方法; 2、这样做的好处是,有时候一些JS函数要用到页面上的一些数据,但是此时有些数据还没有加载进来。这个时候触发函数,就会报一些异常。所以用window.onload方法可以确保数据安全落地; 例子 <!DOCTYPE html> <html> <head> <title>window_load.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> this is my HTML page.<br> </body> <script type="text/javascript"> /** *把页面中的所有的数据加载完以后触发该方法 **/ window.onload = function(){ alert("ssssss"); } </script> </html>

优秀的个人博客,低调大师

swift:入门知识之简单值

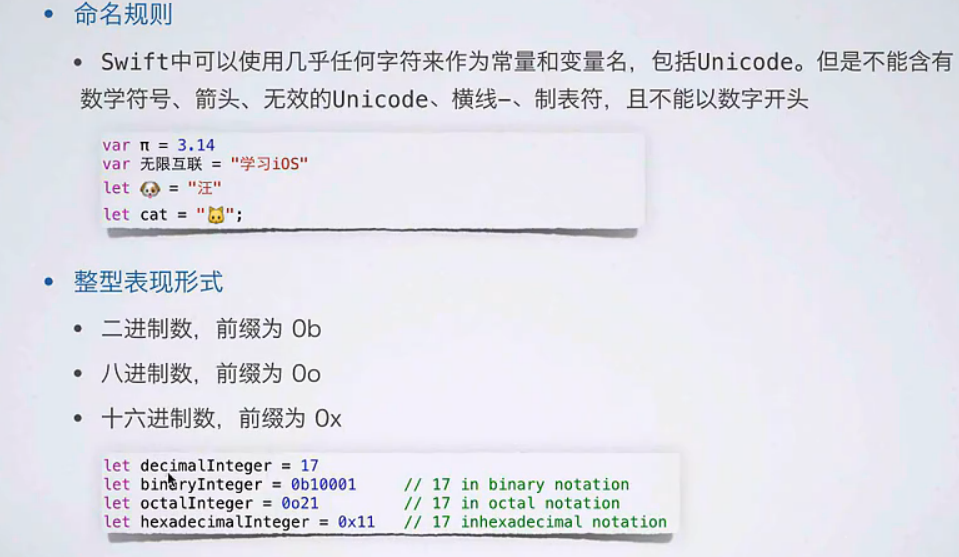
1、swift中用let关键字类定义常量,用var关键字来定义变量。 2、swift语句的结尾不需要再带逗号,系统在运行程序时自动会帮你添加上 3、一个变量或常量必须与赋值时拥有相同的类型。 4、如果初始化值没有提供足够的信息(或没有初始化值),可以在变量名后写类型,并用冒号分隔。 5、如果第一次赋初值变量的类型不确定,它可以根据再一次赋值时来确定当前变量的数据类型。 命名规范: 常用数据类型: 类型别名: 新类型元组 : 字符和字符串: 具体举例如下: 用var定义隐式变量,开始赋初值不能确定类型,等第二次赋值后,类型即可确定,此时再赋值类型需要一样 //定义变量用var //不用加类型 //语句后面不用加分号 var str = "Hello, playground" println(str) //"Hello,palyground" var myVariable = 40 myVariable = 55 myVariable = 56.7 //myVariable = "hello world" //error,类型不匹配 用let定义常量,赋初值后,不允许再赋值 //定义常量用let let myConstant = 40 //myConstant = 55 //error,常量不可再赋值 显示的定义变量或常量的类型,变量或常量的后面跟上": 类型" //显示声明变量或常量的类型 var num:Int = 30 let num2:Double = 30.5 其他类型转化为字符串类型,采用String(...)的方式强制转换为字符串 //其他类型转换为字符串 let label = "The width is " let width = 94 let widthLabel = label + String(width) //"The width is 94" 字符串可以直接用"+"号连接成一个新的字符串 //字符串的连接直接用加号var str = "hello" var str2 = "good morning" println(str+" "+str2) //"hello good morning" 在字符串中用" \(...) "这种方式可以用来格式化字符串 //格式化字符串var num = 2.0 let str3 = "good morning \(num)" //"good mornig 2.0" 字符串其他运算: 定义数组,用[ ]括号,通过索引获取数组中的值 //定义数组,用[] var arr = [1,2,3,4] arr[1] = 6 println("\(arr)") //"6" 数组其他运算方式: 添加元素 数组元素个数和容量 遍历元素: 删除元素: 设置数组多个元素: 定义一个字典,也用[ ]括号,没有显示指定字典类型时,键和值类型要保持一致,通过键key获取对应的值。如果没有找到,就会将其新添加进字典中 //定义一个字典,也用[],键和值类型需要保持一致 var dic = ["name":"Tom","age":"20"] dic["age"] = "22" println("\(dic)") //["name":"Tom","age":"22"]dic["sex"]= "M"println("\(dic)") //["name":"Tom","age":"22","sex":"M"] 字典其他运算方式: 遍历字典: 删除元素: 定义未知类型的空数组或空字典 //创建空数组 var arr3 = [] //创建空字典 var dic3 = [:] 定义指定类型的空数组或空字典 //创建空的字符串数组 var emptyArray = [String]() emptyArray = ["Tom"]//创建空的泛型字典 var emptyDictionary = Dictionary<String,Float>() emptyDictionary = ["tom":20,"jobs":23] 创建元组,可以同时存放任意类型的数据 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4902736.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

swift:入门知识之泛型

在尖括号里写一个名字来创建一个泛型函数或者类型 例如<T>、<Type> 可以创建泛型类、枚举和结构体 在类型后使用where来指定一个需求列表。例如,要限定实现一个协议的类型,需要限定两个类型要相同,或者限定一个类必须有一个特定的父类 先给一个具体举例如下: //泛型函数 func repeat<ItemType>(item:ItemType,times:Int)->[ItemType]{ var results:[ItemType] = [ItemType]() for i in 0..<times{ results.append(item) } return results } //第一个参数可以接收任意类型的数据 repeat("Tom", 4) //字符串 repeat(10, 5) //整数 repeat((1,2,3,4), 3) //元组 显示结果: swift泛型具体介绍: http://www.cocoachina.com/newbie/basic/2014/0612/8790.html 泛型代码可以让你写出根据自我需求定义、适用于任何类型的,灵活且可重用的函数和类型。它可以让你避免重复的代码,用一种清晰和抽象的方式来表达代码的意图。 泛型是 Swift 强大特征中的其中一个,许多 Swift 标准库是通过泛型代码构建出来的。事实上,泛型的使用贯穿了整本语言手册,只是你没有发现而已。例如,Swift 的数组和字典类型都是泛型集。你可以创建一个Int数组,也可创建一个String数组,或者甚至于可以是任何其他 Swift 的类型数据数组。同样的,你也可以创建存储任何指定类型的字典(dictionary),而且这些类型可以是没有限制的。 泛型所解决的问题 这里是一个标准的,非泛型函数swapTwoInts,用来交换两个Int值: funcswapTwoInts(inouta:Int,inoutb:Int) lettemporaryA=a a=b b=temporaryA } 这个函数使用写入读出(in-out)参数来交换a和b的值,请参考写入读出参数。 swapTwoInts函数可以交换b的原始值到a,也可以交换a的原始值到b,你可以调用这个函数交换两个Int变量值: varsomeInt=3 varanotherInt=107 swapTwoInts(&someInt,&anotherInt) println("someIntisnow\(someInt),andanotherIntisnow\(anotherInt)") //输出"someIntisnow107,andanotherIntisnow3" swapTwoInts函数是非常有用的,但是它只能交换Int值,如果你想要交换两个String或者Double,就不得不写更多的函数,如 swapTwoStrings和swapTwoDoublesfunctions,如同如下所示: funcswapTwoStrings(inouta:String,inoutb:String){ lettemporaryA=a a=b b=temporaryA } funcswapTwoDoubles(inouta:Double,inoutb:Double){ lettemporaryA=a a=b b=temporaryA } 你可能注意到 swapTwoInts、 swapTwoStrings和swapTwoDoubles函数功能都是相同的,唯一不同之处就在于传入的变量类型不同,分别是Int、String和Double。 但实际应用中通常需要一个用处更强大并且尽可能的考虑到更多的灵活性单个函数,可以用来交换两个任何类型值,很幸运的是,泛型代码帮你解决了这种问题。(一个这种泛型函数后面已经定义好了。) 注意: 在所有三个函数中,a和b的类型是一样的。如果a和b不是相同的类型,那它们俩就不能互换值。Swift 是类型安全的语言,所以它不允许一个String类型的变量和一个Double类型的变量互相交换值。如果一定要做,Swift 将报编译错误。 泛型函数 泛型函数可以工作于任何类型,这里是一个上面swapTwoInts函数的泛型版本,用于交换两个值: funcswapTwoValues<T>(inouta:T,inoutb:T){ lettemporaryA=a a=b b=temporaryA } swapTwoValues函数主体和swapTwoInts函数是一样的,它只在第一行稍微有那么一点点不同于swapTwoInts,如下所示: funcswapTwoInts(inouta:Int,inoutb:Int) funcswapTwoValues<T>(inouta:T,inoutb:T) 这个函数的泛型版本使用了占位类型名字(通常此情况下用字母T来表示)来代替实际类型名(如In、String或Doubl)。占位类型名没有提示T必须是什么类型,但是它提示了a和b必须是同一类型T,而不管T表示什么类型。只有swapTwoValues函数在每次调用时所传入的实际类型才能决定T所代表的类型。 另外一个不同之处在于这个泛型函数名后面跟着的展位类型名字(T)是用尖括号括起来的()。这个尖括号告诉 Swift 那个T是swapTwoValues函数所定义的一个类型。因为T是一个占位命名类型,Swift 不会去查找命名为T的实际类型。 swapTwoValues函数除了要求传入的两个任何类型值是同一类型外,也可以作为swapTwoInts函数被调用。每次swapTwoValues被调用,T所代表的类型值都会传给函数。 在下面的两个例子中,T分别代表Int和String: varsomeInt=3 varanotherInt=107 swapTwoValues(&someInt,&anotherInt) //someIntisnow107,andanotherIntisnow3 varsomeString="hello" varanotherString="world" swapTwoValues(&someString,&anotherString) //someStringisnow"world",andanotherStringisnow"hello" 注意:上面定义的函数swapTwoValues是受swap函数启发而实现的。swap函数存在于 Swift 标准库,并可以在其它类中任意使用。如果你在自己代码中需要类似swapTwoValues函数的功能,你可以使用已存在的交换函数swap函数。 类型参数 在上面的swapTwoValues例子中,占位类型T是一种类型参数的示例。类型参数指定并命名为一个占位类型,并且紧随在函数名后面,使用一对尖括号括起来(如)。 一旦一个类型参数被指定,那么其可以被使用来定义一个函数的参数类型(如swapTwoValues函数中的参数a和b),或作为一个函数返回类型,或用作函数主体中的注释类型。在这种情况下,被类型参数所代表的占位类型不管函数任何时候被调用,都会被实际类型所替换(在上面swapTwoValues例子中,当函数第一次被调用时,T被Int替换,第二次调用时,被String替换。)。 你可支持多个类型参数,命名在尖括号中,用逗号分开。 命名类型参数 在简单的情况下,泛型函数或泛型类型需要指定一个占位类型(如上面的swapTwoValues泛型函数,或一个存储单一类型的泛型集,如数组),通常用一单个字母T来命名类型参数。不过,你可以使用任何有效的标识符来作为类型参数名。 如果你使用多个参数定义更复杂的泛型函数或泛型类型,那么使用更多的描述类型参数是非常有用的。例如,Swift 字典(Dictionary)类型有两个类型参数,一个是键,另外一个是值。如果你自己写字典,你或许会定义这两个类型参数为KeyType和ValueType,用来记住它们在你的泛型代码中的作用。 注意:请始终使用大写字母开头的驼峰式命名法(例如T和KeyType)来给类型参数命名,以表明它们是类型的占位符,而非类型值。 泛型类型 通常在泛型函数中,Swift 允许你定义你自己的泛型类型。这些自定义类、结构体和枚举作用于任何类型,如同Array和Dictionary的用法。 这部分向你展示如何写一个泛型集类型--Stack(栈)。一个栈是一系列值域的集合,和Array(数组)类似,但其是一个比 Swift 的Array类型更多限制的集合。一个数组可以允许其里面任何位置的插入/删除操作,而栈,只允许在集合的末端添加新的项(如同push一个新值进栈)。同样的一个栈也只能从末端移除项(如同pop一个值出栈)。 注意:栈的概念已被UINavigationController类使用来模拟试图控制器的导航结构。你通过调用UINavigationController的pushViewController:animated:方法来为导航栈添加(add)新的试图控制器;而通过popViewControllerAnimated:的方法来从导航栈中移除(pop)某个试图控制器。每当你需要一个严格的后进先出方式来管理集合,堆栈都是最实用的模型。 下图展示了一个栈的压栈(push)/出栈(pop)的行为: 1、现在有三个值在栈中; 2、第四个值“pushed”到栈的顶部; 3、现在有四个值在栈中,最近的那个在顶部; 4、栈中最顶部的那个项被移除,或称之为“popped”; 5、移除掉一个值后,现在栈又重新只有三个值。 这里展示了如何写一个非泛型版本的栈,Int值型的栈: structIntStack{ varitems= [Int]() mutatingfuncpush(item:Int){ items.append(item) } mutatingfuncpop()->Int{ returnitems.removeLast() } } 这个结构体在栈中使用一个Array性质的items存储值。Stack提供两个方法:push和pop,从栈中压进一个值和移除一个值。这些方法标记为可变的,因为他们需要修改(或转换)结构体的items数组。 上面所展现的IntStack类型只能用于Int值,不过,其对于定义一个泛型Stack类(可以处理任何类型值的栈)是非常有用的。 这里是一个相同代码的泛型版本: structStack<T>{ varitems= [T]() mutatingfuncpush(item:T){ items.append(item) } mutatingfuncpop()->T{ returnitems.removeLast() } } 注意到Stack的泛型版本基本上和非泛型版本相同,但是泛型版本的占位类型参数为T代替了实际Int类型。这种类型参数包含在一对尖括号里(<T>),紧随在结构体名字后面。 T定义了一个名为“某种类型T”的节点提供给后来用。这种将来类型可以在结构体的定义里任何地方表示为“T”。在这种情况下,T在如下三个地方被用作节点: - 创建一个名为items的属性,使用空的T类型值数组对其进行初始化; - 指定一个包含一个参数名为item的push方法,该参数必须是T类型; - 指定一个pop方法的返回值,该返回值将是一个T类型值。 当创建一个新单例并初始化时, 通过用一对紧随在类型名后的尖括号里写出实际指定栈用到类型,创建一个Stack实例,同创建Array和Dictionary一样: varstackOfStrings=Stack<String>() stackOfStrings.push("uno") stackOfStrings.push("dos") stackOfStrings.push("tres") stackOfStrings.push("cuatro") //现在栈已经有4个string了 下图将展示stackOfStrings如何push这四个值进栈的过程: 从栈中pop并移除值"cuatro": letfromTheTop=stackOfStrings.pop() //fromTheTopisequalto"cuatro",andthestacknowcontains3strings 下图展示了如何从栈中pop一个值的过程: 由于Stack是泛型类型,所以在 Swift 中其可以用来创建任何有效类型的栈,这种方式如同Array和Dictionary。 类型约束 swapTwoValues函数和Stack类型可以作用于任何类型,不过,有的时候对使用在泛型函数和泛型类型上的类型强制约束为某种特定类型是非常有用的。类型约束指定了一个必须继承自指定类的类型参数,或者遵循一个特定的协议或协议构成。 例如,Swift 的Dictionary类型对作用于其键的类型做了些限制。在字典的描述中,字典的键类型必须是可哈希,也就是说,必须有一种方法可以使其是唯一的表示。Dictionary之所以需要其键是可哈希是为了以便于其检查其是否包含某个特定键的值。如无此需求,Dictionary即不会告诉是否插入或者替换了某个特定键的值,也不能查找到已经存储在字典里面的给定键值。 这个需求强制加上一个类型约束作用于Dictionary的键上,当然其键类型必须遵循Hashable协议(Swift 标准库中定义的一个特定协议)。所有的 Swift 基本类型(如String,Int, Double和 Bool)默认都是可哈希。 当你创建自定义泛型类型时,你可以定义你自己的类型约束,当然,这些约束要支持泛型编程的强力特征中的多数。抽象概念如可哈希具有的类型特征是根据他们概念特征来界定的,而不是他们的直接类型特征。 类型约束语法 你可以写一个在一个类型参数名后面的类型约束,通过冒号分割,来作为类型参数链的一部分。这种作用于泛型函数的类型约束的基础语法如下所示(和泛型类型的语法相同): funcsomeFunction<T:SomeClass,U:SomeProtocol>(someT:T,someU:U){ //functionbodygoeshere } 上面这个假定函数有两个类型参数。第一个类型参数T,有一个需要T必须是SomeClass子类的类型约束;第二个类型参数U,有一个需要U必须遵循SomeProtocol协议的类型约束。 类型约束行为 这里有个名为findStringIndex的非泛型函数,该函数功能是去查找包含一给定String值的数组。若查找到匹配的字符串,findStringIndex函数返回该字符串在数组中的索引值(Int),反之则返回nil: funcfindStringIndex(array: [String],valueToFind:String)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } findStringIndex函数可以作用于查找一字符串数组中的某个字符串: letstrings=["cat","dog","llama","parakeet","terrapin"] ifletfoundIndex=findStringIndex(strings,"llama"){ println("Theindexofllamais\(foundIndex)") } //输出"Theindexofllamais2" 如果只是针对字符串而言查找在数组中的某个值的索引,用处不是很大,不过,你可以写出相同功能的泛型函数findIndex,用某个类型T值替换掉提到的字符串。 这里展示如何写一个你或许期望的findStringIndex的泛型版本findIndex。请注意这个函数仍然返回Int,是不是有点迷惑呢,而不是泛型类型?那是因为函数返回的是一个可选的索引数,而不是从数组中得到的一个可选值。需要提醒的是,这个函数不会编译,原因在例子后面会说明: funcfindIndex<T>(array: [T],valueToFind:T)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } 上面所写的函数不会编译。这个问题的位置在等式的检查上,“if value == valueToFind”。不是所有的 Swift 中的类型都可以用等式符(==)进行比较。例如,如果你创建一个你自己的类或结构体来表示一个复杂的数据模型,那么 Swift 没法猜到对于这个类或结构体而言“等于”的意思。正因如此,这部分代码不能可能保证工作于每个可能的类型T,当你试图编译这部分代码时估计会出现相应的错误。 不过,所有的这些并不会让我们无从下手。Swift 标准库中定义了一个Equatable协议,该协议要求任何遵循的类型实现等式符(==)和不等符(!=)对任何两个该类型进行比较。所有的 Swift 标准类型自动支持Equatable协议。 任何Equatable类型都可以安全的使用在findIndex函数中,因为其保证支持等式操作。为了说明这个事实,当你定义一个函数时,你可以写一个Equatable类型约束作为类型参数定义的一部分: funcfindIndex<T:Equatable>(array: [T],valueToFind:T)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } findIndex中这个单个类型参数写做:T: Equatable,也就意味着“任何T类型都遵循Equatable协议”。 findIndex函数现在则可以成功的编译过,并且作用于任何遵循Equatable的类型,如Double或String: letdoubleIndex=findIndex([3.14159,0.1,0.25],9.3) //doubleIndexisanoptionalIntwithnovalue,because9.3isnotinthearray letstringIndex=findIndex(["Mike","Malcolm","Andrea"],"Andrea") //stringIndexisanoptionalIntcontainingavalueof2 关联类型 当定义一个协议时,有的时候声明一个或多个关联类型作为协议定义的一部分是非常有用的。一个关联类型给定作用于协议部分的类型一个节点名(或别名)。作用于关联类型上实际类型是不需要指定的,直到该协议接受。关联类型被指定为typealias关键字。 关联类型行为 这里是一个Container协议的例子,定义了一个ItemType关联类型: protocolContainer{ typealiasItemType mutatingfuncappend(item:ItemType) varcount:Int{get} subscript(i:Int)->ItemType{get} } Container协议定义了三个任何容器必须支持的兼容要求: 必须可能通过append方法添加一个新item到容器里; 必须可能通过使用count属性获取容器里items的数量,并返回一个Int值; 必须可能通过容器的Int索引值下标可以检索到每一个item。 这个协议没有指定容器里item是如何存储的或何种类型是允许的。这个协议只指定三个任何遵循Container类型所必须支持的功能点。一个遵循的类型也可以提供其他额外的功能,只要满足这三个条件。 任何遵循Container协议的类型必须指定存储在其里面的值类型,必须保证只有正确类型的items可以加进容器里,必须明确可以通过其下标返回item类型。 为了定义这三个条件,Container协议需要一个方法指定容器里的元素将会保留,而不需要知道特定容器的类型。Container协议需要指定任何通过append方法添加到容器里的值和容器里元素是相同类型,并且通过容器下标返回的容器元素类型的值的类型是相同类型。 为了达到此目的,Container协议声明了一个ItemType的关联类型,写作typealias ItemType。The protocol does not define what ItemType is an alias for—that information is left for any conforming type to provide(这个协议不会定义ItemType是遵循类型所提供的何种信息的别名)。尽管如此,ItemType别名支持一种方法识别在一个容器里的items类型,以及定义一种使用在append方法和下标中的类型,以便保证任何期望的Container的行为是强制性的。 这里是一个早前IntStack类型的非泛型版本,适用于遵循Container协议: structIntStack:Container{ //originalIntStackimplementation varitems= [Int]() mutatingfuncpush(item:Int){ items.append(item) } mutatingfuncpop()->Int{ returnitems.removeLast() } //conformancetotheContainerprotocol typealiasItemType=Int mutatingfuncappend(item:Int){ self.push(item) } varcount:Int{ returnitems.count } subscript(i:Int)->Int{ returnitems[i] } } IntStack类型实现了Container协议的所有三个要求,在IntStack类型的每个包含部分的功能都满足这些要求。 此外,IntStack指定了Container的实现,适用的ItemType被用作Int类型。对于这个Container协议实现而言,定义 typealias ItemType = Int,将抽象的ItemType类型转换为具体的Int类型。 感谢Swift类型参考,你不用在IntStack定义部分声明一个具体的Int的ItemType。由于IntStack遵循Container协议的所有要求,只要通过简单的查找append方法的item参数类型和下标返回的类型,Swift就可以推断出合适的ItemType来使用。确实,如果上面的代码中你删除了 typealias ItemType = Int这一行,一切仍旧可以工作,因为它清楚的知道ItemType使用的是何种类型。 你也可以生成遵循Container协议的泛型Stack类型: structStack<T>:Container{ //originalStack<T>implementation varitems= [T]() mutatingfuncpush(item:T){ items.append(item) } mutatingfuncpop()->T{ returnitems.removeLast() } //conformancetotheContainerprotocol mutatingfuncappend(item:T){ self.push(item) } varcount:Int{ returnitems.count } subscript(i:Int)->T{ returnitems[i] } } 这个时候,占位类型参数T被用作append方法的item参数和下标的返回类型。Swift 因此可以推断出被用作这个特定容器的ItemType的T的合适类型。 扩展一个存在的类型为一指定关联类型 在使用扩展来添加协议兼容性中有描述扩展一个存在的类型添加遵循一个协议。这个类型包含一个关联类型的协议。 Swift的Array已经提供append方法,一个count属性和通过下标来查找一个自己的元素。这三个功能都达到Container协议的要求。也就意味着你可以扩展Array去遵循Container协议,只要通过简单声明Array适用于该协议而已。如何实践这样一个空扩展,在使用扩展来声明协议的采纳中有描述这样一个实现一个空扩展的行为: extensionArray:Container{} 如同上面的泛型Stack类型一样,Array的append方法和下标保证Swift可以推断出ItemType所使用的适用的类型。定义了这个扩展后,你可以将任何Array当作Container来使用。 Where 语句 类型约束中描述的类型约束确保你定义关于类型参数的需求和一泛型函数或类型有关联。 对于关联类型的定义需求也是非常有用的。你可以通过这样去定义where语句作为一个类型参数队列的一部分。一个where语句使你能够要求一个关联类型遵循一个特定的协议,以及(或)那个特定的类型参数和关联类型可以是相同的。你可写一个where语句,通过紧随放置where关键字在类型参数队列后面,其后跟着一个或者多个针对关联类型的约束,以及(或)一个或多个类型和关联类型的等于关系。 下面的列子定义了一个名为allItemsMatch的泛型函数,用来检查是否两个Container单例包含具有相同顺序的相同元素。如果匹配到所有的元素,那么返回一个为true的Boolean值,反之,则相反。 这两个容器可以被检查出是否是相同类型的容器(虽然它们可以是),但他们确实拥有相同类型的元素。这个需求通过一个类型约束和where语句结合来表示: funcallItemsMatch< C1:Container,C2:Container whereC1.ItemType==C2.ItemType,C1.ItemType:Equatable> (someContainer:C1,anotherContainer:C2)->Bool{ //checkthatbothcontainerscontainthesamenumberofitems ifsomeContainer.count!=anotherContainer.count{ returnfalse } //checkeachpairofitemstoseeiftheyareequivalent foriin0..someContainer.count{ ifsomeContainer[i]!=anotherContainer[i]{ returnfalse } } //allitemsmatch,soreturntrue returntrue } 这个函数用了两个参数:someContainer和anotherContainer。someContainer参数是类型C1,anotherContainer参数是类型C2。C1和C2是容器的两个占位类型参数,决定了这个函数何时被调用。 这个函数的类型参数列紧随在两个类型参数需求的后面: C1必须遵循Container协议 (写作 C1: Container)。 C2必须遵循Container协议 (写作 C2: Container)。 C1的ItemType同样是C2的ItemType(写作 C1.ItemType == C2.ItemType)。 C1的ItemType必须遵循Equatable协议 (写作 C1.ItemType: Equatable)。 第三个和第四个要求被定义为一个where语句的一部分,写在关键字where后面,作为函数类型参数链的一部分。 这些要求意思是: someContainer是一个C1类型的容器。 anotherContainer是一个C2类型的容器。 someContainer和anotherContainer包含相同的元素类型。 someContainer中的元素可以通过不等于操作(!=)来检查它们是否彼此不同。 第三个和第四个要求结合起来的意思是anotherContainer中的元素也可以通过 != 操作来检查,因为他们在someContainer中元素确实是相同的类型。 这些要求能够使allItemsMatch函数比较两个容器,即便他们是不同的容器类型。 allItemsMatch首先检查两个容器是否拥有同样数目的items,如果他们的元素数目不同,没有办法进行匹配,函数就会false。 检查完之后,函数通过for-in循环和半闭区间操作(..)来迭代someContainer中的所有元素。对于每个元素,函数检查是否someContainer中的元素不等于对应的anotherContainer中的元素,如果这两个元素不等,则这两个容器不匹配,返回false。 如果循环体结束后未发现没有任何的不匹配,那表明两个容器匹配,函数返回true。 这里演示了allItemsMatch函数运算的过程: varstackOfStrings=Stack<String>() stackOfStrings.push("uno") stackOfStrings.push("dos") stackOfStrings.push("tres") vararrayOfStrings=["uno","dos","tres"] ifallItemsMatch(stackOfStrings,arrayOfStrings){ println("Allitemsmatch.") }else{ println("Notallitemsmatch.") } //输出"Allitemsmatch." 上面的例子创建一个Stack单例来存储String,然后压了三个字符串进栈。这个例子也创建了一个Array单例,并初始化包含三个同栈里一样的原始字符串。即便栈和数组否是不同的类型,但他们都遵循Container协议,而且他们都包含同样的类型值。你因此可以调用allItemsMatch函数,用这两个容器作为它的参数。在上面的例子中,allItemsMatch函数正确的显示了所有的这两个容器的items匹配。 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4905273.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

swift:入门知识之类和对象

1、swift中使用class创建一个类。一个类的声明则是在类里作为常量或变量声明的,除了是在类的上下文中。在方法和函数中也是这么写的。 2、swift中使用init(...)作为初始化构造函数 3、swift中使用构造函数初始化成员变量时,格式为 : self.name = name.构造器的声明跟函数一样,除了会创建类的实例。每一个属性都需要赋值,无论在声明里还是在构造器里。 4、swift中使用deinit来创建一个析构函数,由系统自动调用来撤销对象,进行内存的清理工作 5、swift中子类继承父类时,一冒号:隔开。在继承标准根类时无需声明,所以你可以忽略超类 6、swift中子类重写父类的方法时,必须使用关键词override重载超类中的实现,如果没有这个关键词,编译器会报错 7、swift中可以设置get和set方法,例如如下所示: var perimeter: Double { //getter方法 get{ return slideLength } //setter方法 set{ slideLength = newValue/2 } } 具体举例如下: 定义一个没有构造函数的类Shape //声明一个没有构造函数的类 class Shape{ //成员变量,边数 var numberOfSides = 0 //成员方法 func simpleDescripton()->String{ return "A shape with \(numberOfSides) sides." } } //创建对象 var shape = Shape() //{numberOfSides 0} //设置成员变量 shape.numberOfSides = 4 //调用成员方法 shape.simpleDescripton() //"A shape with 4 sides" 定义一个子类NameShape继承上面的父类Shape,子类带一个init构造函数和一个deinit析构函数 //声明带构造函数的类,继承父类Shape class NameShape : Shape{ //形状的名字 var name:String //初始化方法 init(name:String){ self.name = name } //虚构方法,不可以显示调用,系统会在程序执行结束后自动调用,清理内存 deinit{ println("deinit") } //成员方法,重写父类的方法必须要加上关键字 override override func simpleDescripton()->String{ return "A shape with name:\(name) have \(numberOfSides) sides." } } //创建对象,参数名不可以省略 var nameshape:NameShape = NameShape(name:"rect") //{{numberOfSides 0} name"rect"} //设置成员变量 nameshape.numberOfSides = 4 //{{numberOfSides 4} name "rect"} //调用成员方法 nameshape.simpleDescripton() //"A shape with name:rect have 4 sides" 定义一个正方形类Square继承上面的父类NameShape,其实它也继承了根父类Shape,Square继承它父类所有公有的属性和方法,在初始化时,子类可以借助父类的初始化方法给它们共有的属性赋初值 //继承父类NameShape class Square: NameShape { //边长 var slideLength:Double = 0.0 //子类自己的初始化方法 init(slideLength:Double,name:String) { self.slideLength = slideLength //调用父类的初始化方法 super.init(name: name) //直接用从父类继承的边数属性 numberOfSides = 4 } //设置对象的set和get方法 var perimeter: Double { //getter方法 get{ return slideLength } //setter方法 set{ slideLength = newValue/2 } } //定义求面积的方法 func area() -> Double{ return slideLength*slideLength } override func simpleDescripton() -> String { return "A shape with name:\(name) have \(numberOfSides) sides.its area is \(area())" } } //创建对象时的参数名不可以省略 var square:Square = Square(slideLength:2,name:"正方形") square.perimeter = 6 square.simpleDescripton() //"A shape with name:正方形 have 4 sides .its area is 9.0" square.slideLength //3 可以给参数的参数名再设置一个名字,函数内部使用参数的原始名,调用时使用设置参数名的名称,即外部名,前一章函数部分已经介绍过 class Counter{ var count:Int = 0 //给第二个参数times再设置一个名称numberOfTimes,不过函数内部使用的还是times func incrementBy(amount: Int, numberOfTimes times: Int){ count += amount * times } } var counter = Counter() //创建一个对象//调用函数时,用的第二个参数的名称为numberOfTimes counter.incrementBy(2, numberOfTimes: 7) //14 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4903057.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

HADOOP生态圈知识概述

一. hadoop生态概况 Hadoop是一个由Apache基金会所开发的分布式系统基础架构。用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。具有可靠、高效、可伸缩的特点。 Hadoop的核心是YARN,HDFS和Mapreduce 下图是hadoop生态系统,集成spark生态圈。在未来一段时间内,hadoop将于spark共存,hadoop与spark都能部署在yarn、mesos的资源管理系统之上。 1、HDFS(Hadoop分布式文件系统) 源自于Google的GFS论文,发表于2003年10月,HDFS是GFS克隆版。 HDFS是Hadoop体系中数据存储管理的基础。它是一个高度容错的系统,能检测和应对硬件故障,用于在低成本的通用硬件上运行。 HDFS简化了文件的一致性模型,通过流式数据访问,提供高吞吐量应用程序数据访问功能,适合带有大型数据集的应用程序。 它提供了一次写入多次读取的机制,数据以块的形式,同时分布在集群不同物理机器上。 2、Mapreduce(分布式计算框架) 源自于google的MapReduce论文,发表于2004年12月,HadoopMapReduce是google MapReduce克隆版。 MapReduce是一种分布式计算模型,用以进行大数据量的计算。它屏蔽了分布式计算框架细节,将计算抽象成map和reduce两部分, 其中Map对数据集上的独立元素进行指定的操作,生成键-值对形式中间结果。Reduce则对中间结果中相同“键”的所有“值”进行规约,以得到最终结果。 MapReduce非常适合在大量计算机组成的分布式并行环境里进行数据处理。 3. HBASE(分布式列存数据库) 源自Google的Bigtable论文,发表于2006年11月,HBase是GoogleBigtable克隆版。 HBase是一个建立在HDFS之上,面向列的针对结构化数据的可伸缩、高可靠、高性能、分布式和面向列的动态模式数据库。 HBase采用了BigTable的数据模型:增强的稀疏排序映射表(Key/Value),其中,键由行关键字、列关键字和时间戳构成。 HBase提供了对大规模数据的随机、实时读写访问,同时,HBase中保存的数据可以使用MapReduce来处理,它将数据存储和并行计算完美地结合在一起。 4. Zookeeper(分布式协作服务) 源自Google的Chubby论文,发表于2006年11月,Zookeeper是Chubby克隆版 解决分布式环境下的数据管理问题:统一命名,状态同步,集群管理,配置同步等 Hadoop的许多组件依赖于Zookeeper,它运行在计算机集群上面,用于管理Hadoop操作。 5. HIVE(数据仓库) 由facebook开源,最初用于解决海量结构化的日志数据统计问题。 Hive定义了一种类似SQL的查询语言(HQL),将SQL转化为MapReduce任务在Hadoop上执行。通常用于离线分析。 HQL用于运行存储在Hadoop上的查询语句,Hive让不熟悉MapReduce开发人员也能编写数据查询语句,然后这些语句被翻译为Hadoop上面的MapReduce任务。 6.Pig(ad-hoc脚本) 由yahoo!开源,设计动机是提供一种基于MapReduce的ad-hoc(计算在query时发生)数据分析工具 Pig定义了一种数据流语言—PigLatin,它是MapReduce编程的复杂性的抽象,Pig平台包括运行环境和用于分析Hadoop数据集的脚本语言(Pig Latin)。 其编译器将Pig Latin翻译成MapReduce程序序列将脚本转换为MapReduce任务在Hadoop上执行。通常用于进行离线分析。 7.Sqoop(数据ETL/同步工具) Sqoop是SQL-to-Hadoop的缩写,主要用于传统数据库和Hadoop之前传输数据。数据的导入和导出本质上是Mapreduce程序,充分利用了MR的并行化和容错性。 Sqoop利用数据库技术描述数据架构,用于在关系数据库、数据仓库和Hadoop之间转移数据。 8.Flume(日志收集工具) Cloudera开源的日志收集系统,具有分布式、高可靠、高容错、易于定制和扩展的特点。 它将数据从产生、传输、处理并最终写入目标的路径的过程抽象为数据流,在具体的数据流中,数据源支持在Flume中定制数据发送方,从而支持收集各种不同协议数据。 同时,Flume数据流提供对日志数据进行简单处理的能力,如过滤、格式转换等。此外,Flume还具有能够将日志写往各种数据目标(可定制)的能力。 总的来说,Flume是一个可扩展、适合复杂环境的海量日志收集系统。当然也可以用于收集其他类型数据 9. Oozie(工作流调度器) Oozie是一个可扩展的工作体系,集成于Hadoop的堆栈,用于协调多个MapReduce作业的执行。它能够管理一个复杂的系统,基于外部事件来执行,外部事件包括数据的定时和数据的出现。 Oozie工作流是放置在控制依赖DAG(有向无环图DirectAcyclic Graph)中的一组动作(例如,Hadoop的Map/Reduce作业、Pig作业等),其中指定了动作执行的顺序。 Oozie使用hPDL(一种XML流程定义语言)来描述这个图。 10. Yarn(分布式资源管理器) YARN是下一代MapReduce,即MRv2,是在第一代MapReduce基础上演变而来的,主要是为了解决原始Hadoop扩展性较差,不支持多计算框架而提出的。 yarn是下一代Hadoop计算平台,yarn是一个通用的运行时框架,用户可以编写自己的计算框架,在该运行环境中运行。 用于自己编写的框架作为客户端的一个lib,在运用提交作业时打包即可。该框架为提供了以下几个组件: 资源管理:包括应用程序管理和机器资源管理 资源双层调度 容错性:各个组件均有考虑容错性 扩展性:可扩展到上万个节点 内存DAG计算模型) Spark是一个Apache项目,它被标榜为“快如闪电的集群计算”。它拥有一个繁荣的开源社区,并且是目前最活跃的Apache项目。 最早Spark是UC BerkeleyAMP lab所开源的类Hadoop MapReduce的通用的并行计算框架。 Spark提供了一个更快、更通用的数据处理平台。和Hadoop相比,Spark可以让你的程序在内存中运行时速度提升100倍,或者在磁盘上运行时速度提升10倍 12. Kafka(分布式消息队列) Kafka是Linkedin于2010年12月份开源的消息系统,它主要用于处理活跃的流式数据。 活跃的流式数据在web网站应用中非常常见,这些数据包括网站的pv、用户访问了什么内容,搜索了什么内容等。 这些数据通常以日志的形式记录下来,然后每隔一段时间进行一次统计处理。 13.Ambari(安装部署配置管理工具) Apache Ambari的作用来说,就是创建、管理、监视Hadoop的集群,是为了让Hadoop以及相关的大数据软件更容易使用的一个web工具。 本文转自南非蚂蚁51CTO博客,原文链接:http://blog.51cto.com/ixdba/1794872,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux 小知识翻译 - 「架构」(arch)

这次,聊聊「架构」这个术语。 在PC相关的文档中,是不是经常看到「x86架构」这个短句。但是对于这句话,是不是总感到有种似懂非懂的感觉。 架构的英语是「architecture」。这里面有「建筑」,「建筑风格」,「构造」的意思。实际上架构这个词在很多领域中都有「构造」的意思。 其实,即使在电脑的世界里,「架构」也有被用在多种场合。软件设计中会使用「架构」这个术语,硬件中也会使用「架构」这个术语。 使用时会涉及到多个方面,很难用一句话来概括「架构」的意思,但基本含有之前提到的「构造」,「设计风格」的意思。 那么,「x86架构」指的又是什么呢?「x86」是被称为电脑的头脑的CPU的一种。 所以,说「x86架构」的时候,就是指以 x86 CPU为核心的各种硬件的组合。 总之,只有CPU的话电脑是无法运行的,根据CPU的不同,硬件(使用什么样主板好呢?使用什么样的内存好呢?等等)的构成也会变化。 把和CPU相关的硬件的全体被称为「架构」,这样来考虑可能比较好。 (硬件)架构这个术语产生的理由是因为软件会「根据硬件架构的不同而改变」。即,同样的软件,可能在某些架构上能运行,其他架构上则不能运行或者运行的不好。 为了防止这种事情,有必要掌握使用软件的电脑的架构是什么样的。 标签: linux 本文转自wang_yb博客园博客,原文链接:http://www.cnblogs.com/wang_yb/p/3796348.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

聊聊Docker理论知识(二)

一、什么是Dcoker 相信docker是什么大家都已经比较清楚了,网上有很详细的介绍,我这里只是大概描述一下。 Docker是一个开源的引擎,可以轻松的为任何应用创建一个轻量级的、可移植的、自给自足的容器。开发者在笔记本上编译测试通过的容器可以批量地在生产环境中部署,包括VMs(虚拟机)、bare metal、OpenStack 集群和其他的基础应用平台。 Docker通常用于如下场景: web应用的自动化打包和发布; 自动化测试和持续集成、发布; 在服务型环境中部署和调整数据库或其他的后台应用; 从头编译或者扩展现有的OpenShift或Cloud Foundry平台来搭建自己的PaaS环境。 二、Docker的三大核心概念 1、镜像(Image) Docker镜像(Image)类似与虚拟机的镜像,可以将他理解为一个面向Docker引擎的只读模板,包含了文件系统。 例如:一个镜像可以完全包含了Ubuntu操作系统环境,可以把它称作一个Ubuntu镜像。镜像也可以安装了Apache应用程序(或其他软件),可以把它称为一个Apache镜像。 镜像是创建Docker容器的基础,通过版本管理和增量的文件系统,Docker提供了一套十分简单的机制来创建和更新现有的镜像。 用户可以从网上下载一个已经做好的应用镜像,并通过命令直接使用。 总之,应用运行是需要环境的,而镜像就是来提供这种环境。 2、容器(Container) Docker容器(Container)类似于一个轻量级的沙箱子(因为Docker是基于Linux内核的虚拟技术,所以消耗资源十分少),Docker利用容器来运行和隔离应用。 容器是从镜像创建的应用运行实例,可以将其启动、开始、停止、删除,而这些容器都是相互隔离、互不可见的。 可以吧每个容器看作一个简易版的Linux系统环境(包括了root用户权限、进程空间、用户空间和网络空间),以及与运行在其中的应用程序打包而成的应用盒子。 镜像自身是只读的。容器从镜像启动的时候,Docker会在镜像的最上层创建一个可写层,镜像本身将保持不变。就像用ISO装系统之后,ISO并没有什么变化一样。 3、仓库(Repository) Docker仓库(Repository)类似与代码仓库,是Docker集中存放镜像文件的场所。 有时候会看到有资料将Docker仓库和注册服务器(Registry)混为一谈,并不严格区分。实际上,注册服务器是存放仓库的地方,其上往往存放着多个仓库。每个仓库集中存放某一类镜像,往往包括多个镜像文件,通过不同的标签(tag)来进行区分。例如存放Ubuntu操作系统镜像的仓库,称为Ubuntu仓库,其中可能包括14.04,12.04等不同版本的镜像。 根据存储的镜像公开分享与否,Docker仓库分为公开仓库(Public)和私有仓库(Private)两种形式。 目前,最大的公开仓库是Docker Hub,存放了数量庞大的镜像供用户下载。国内的公开仓库包括Docker Pool等,可以提供稳定的国内访问。山东理工大学开源社区什么时候搞个这个啊,可以提上进程。 如果用户不希望公开分享自己的镜像文件,Docker也支持用户在本地网络内创建一个只能自己访问的私有仓库。 当用户创建了自己的镜像之后就可以使用push明亮将它上传到指定的公有或则私有仓库。这样用户下次在另一台机器上使用该镜像时,只需将其从仓库pull下来就可以了。 Docker利用仓库管理镜像的设计理念甚至命令和git非常相似,也就意味着非常好上手。 三、Docker架构组成 Docker 采用的是 Client/Server 架构。客户端向服务器发送请求,服务器负责构建、运行和分发容器。客户端和服务器可以运行在同一个 Host 上,客户端也可以通过 socket 或 REST API 与远程的服务器通信。 https://docs.docker.com/engine/docker-overview/#union-file-systems 四、Docker的技术组件 Docker 可以运行于任何安装了现代 Linux 内核的 x64 主机上。推荐的内核版本是 3.8 或者更高。Docker 的开销比较低,可以用于服务器、台式机或者笔记本。它包括以下几个部分。 一个原生的 Linux 容器格式,Docker 中称为 libcontainer。 Linux 内核的命名空间(namespace),用于隔离文件系统、进程和网络。 文件系统隔离:每个容器都有自己的 root 文件系统。 进程隔离:每个容器都运行在自己的进程环境中。 网络隔离:容器间的虚拟网络接口和IP地址都是分开的。 资源隔离和分组:使用 cgroups(即control group,Linux 的内核特性之一)将 CPU 和内存之类的资源独立分配给每个 Docker 容器。 写时复制(Copy on write):文件系统都是通过写时复制创建的,这就意味着文件系统是分层的、快速的,而且占用磁盘空间更小。 日志:容器产生的STDOUT、STDERR和STDIN这些IO流都会被收集并计入日志。用来进行日志分割和故障排错。 交互式shell:用户可以创建一个伪 tty 终端,将其连接到STDIN,为容器提供一个交互式shell。 五、Docker的安装(Ubuntu) 1、环境选择 因为 Ubuntu 系统的内核版本比较高,而且官方也建议我们使用 Ubuntu,并且各大网站博客的教程很多都是基于 Ubuntu 系统,所以我们这里选择Ubuntu 16.04 进行安装Docker。 运行64位CPU的计算机 运行Linux 3.8或者更高的内核 内核需要支持Device Manager、AUFS、vfs、btrfs、ZFS中的一种 内核必须支持开启cgroup和命名空间namespace功能 https://docs.docker.com/engine/installation/linux/docker-ce/ubuntu/#install-using-the-repository 2、允许apt命令HTTPS访问Docker源 sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common 3、添加 Docker 官方的GPG key curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - 4、将Docker的源添加到 /etc/apt/sources.list sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" 5、安装 Docker sudo apt-get update sudo apt-get install docker-ce 6、运行第一个容器 docker run hello-world 五、配置加速器 由于众所周知的一些原因,我们访问 Docker Hub 速度非常慢,为此我们需要添加一个国内的镜像站来作为极速器。 1、阿里云加速器 登录地址https://dev.aliyun.com/search.html ,点击"创建我的容器镜像",找到"Docker Hub 镜像站点",如下图: sudo mkdir -p /etc/docker sudo tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://78ssvya7.mirror.aliyuncs.com"] } EOF sudo systemctl daemon-reload sudo systemctl restart docker 2、DaoCloud 加速器 注册 DaoCloud 账户(支持微信登录),然后访问:https://www.daocloud.io/mirror#accelerator-doc curl -sSL https://get.daocloud.io/daotools/set_mirror.sh | sh -s http://b149d2fd.m.daocloud.io 六、Docker开启远程管理 默认配置下,Docker daemon 只能响应来自本地 Host 的客户端请求。如果要允许远程客户端请求,需要在配置文件中打开 TCP 监听,步骤如下: 1、修改配置文件 编辑配置文件 /etc/systemd/system/multi-user.target.wants/docker.service,在环境变量 ExecStart 后面添加 -H tcp://0.0.0.0,允许来自任意 IP 的客户端连接。 2、重启Docker daemon systemctl daemon-reload systemctl restart docker 3、验证 本文转自 wzlinux 51CTO博客,原文链接:http://blog.51cto.com/wzlinux/2044363,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册