首页 文章 精选 留言 我的

精选列表

搜索[模型训练],共10000篇文章
优秀的个人博客,低调大师

EKS 训练营-vue 项目实战(16)

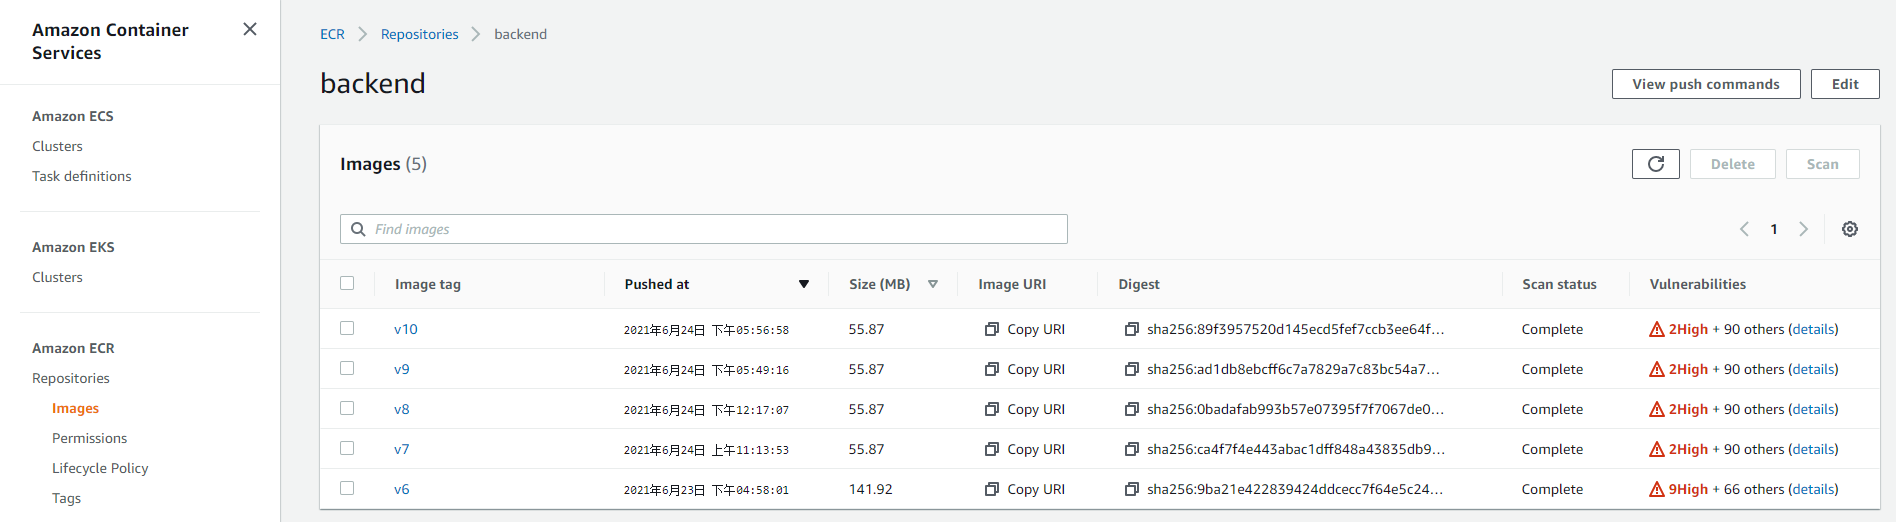
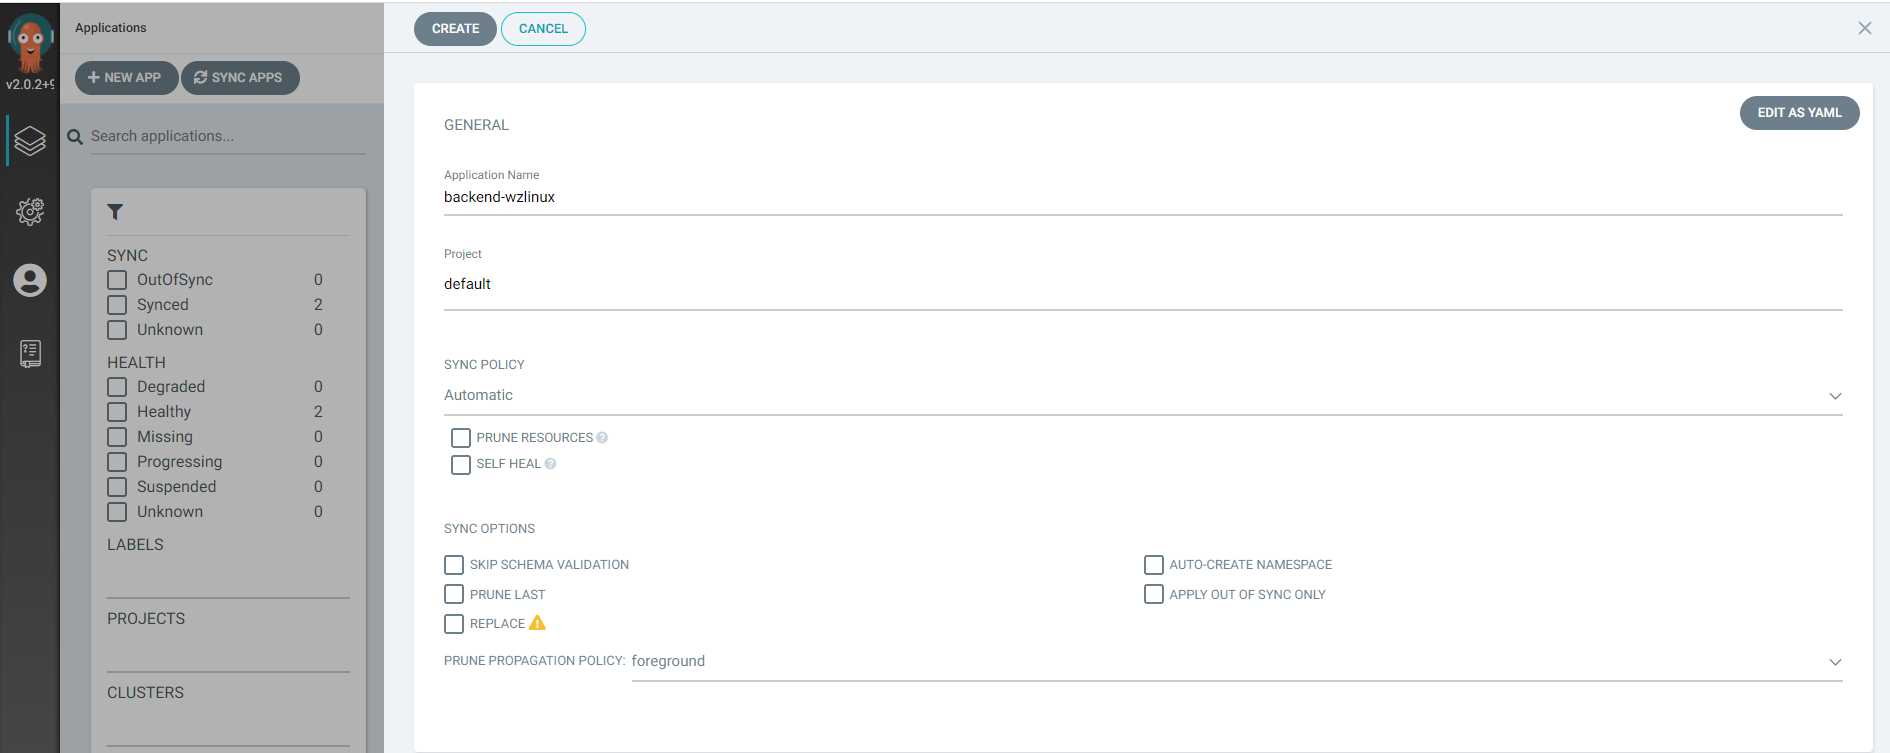
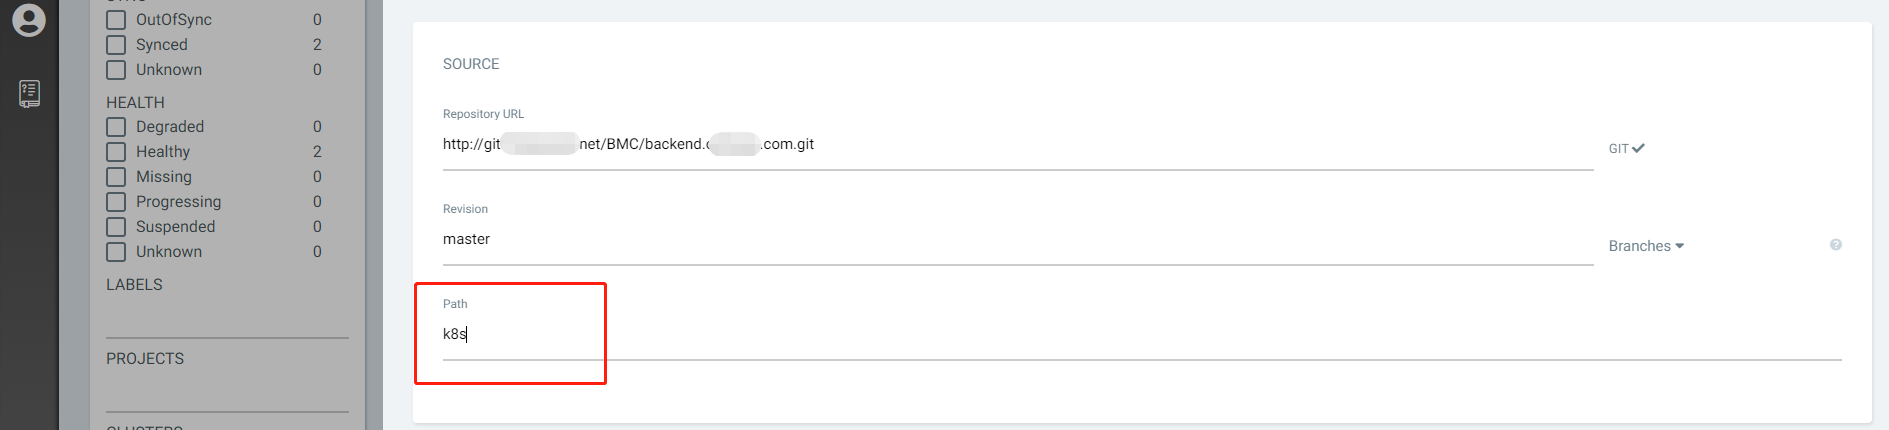
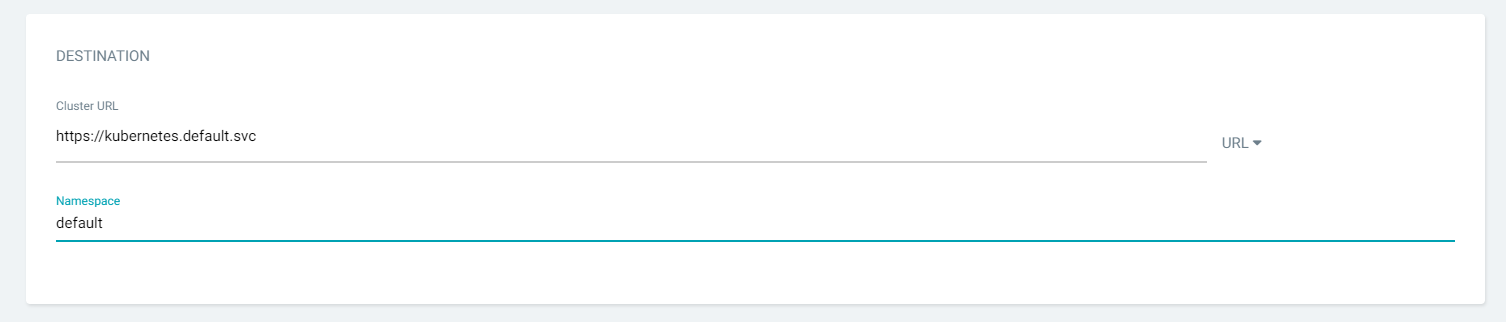
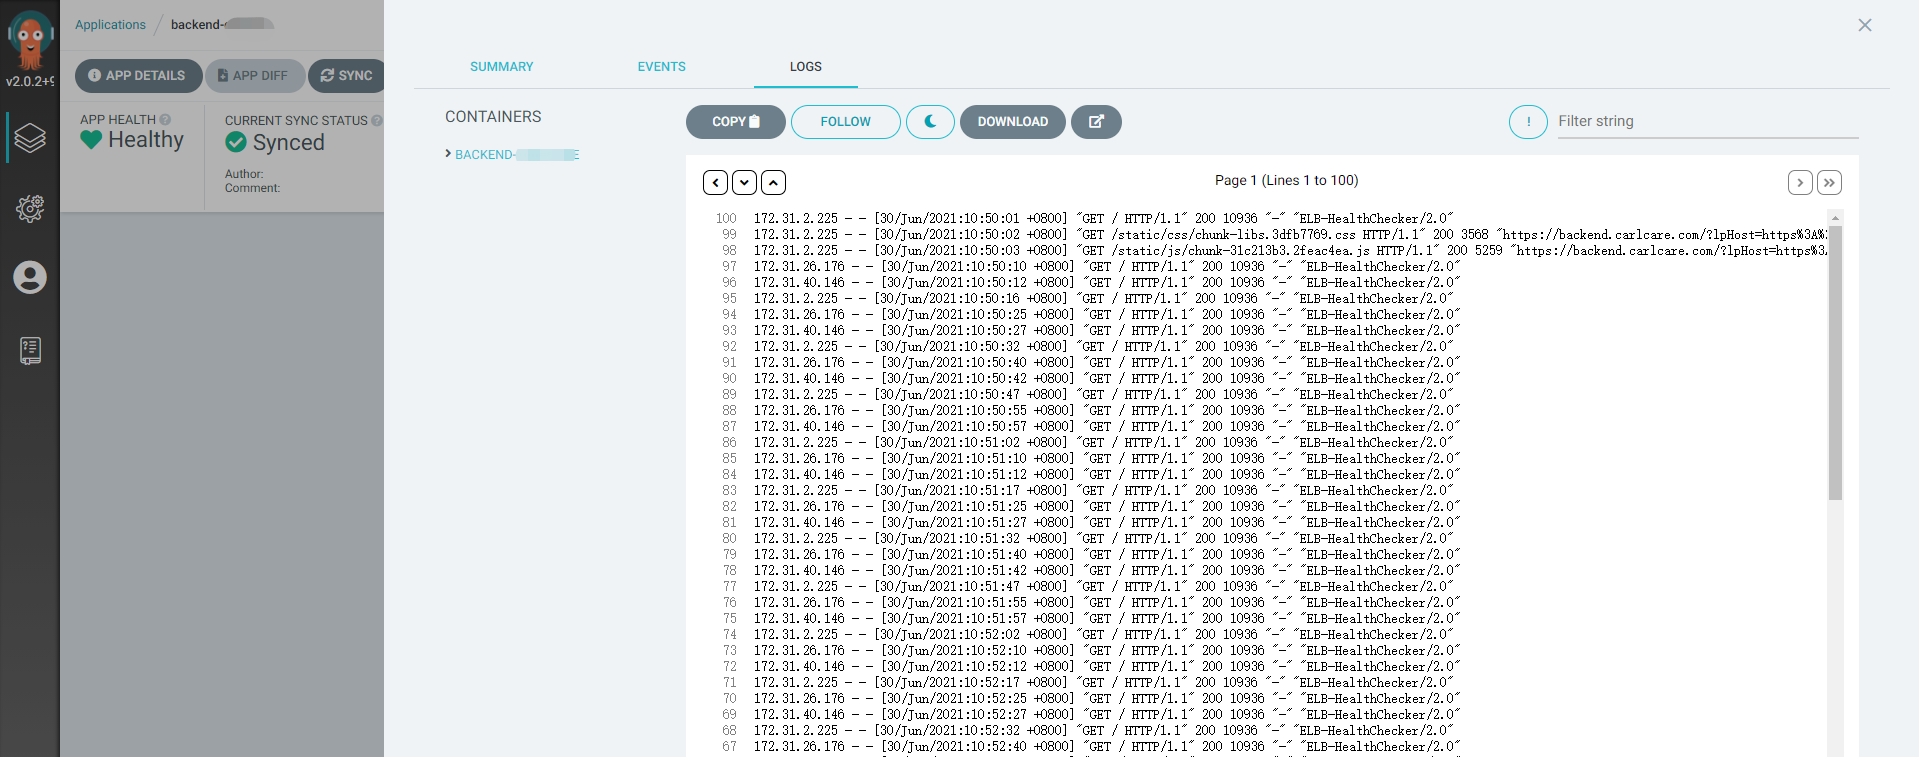
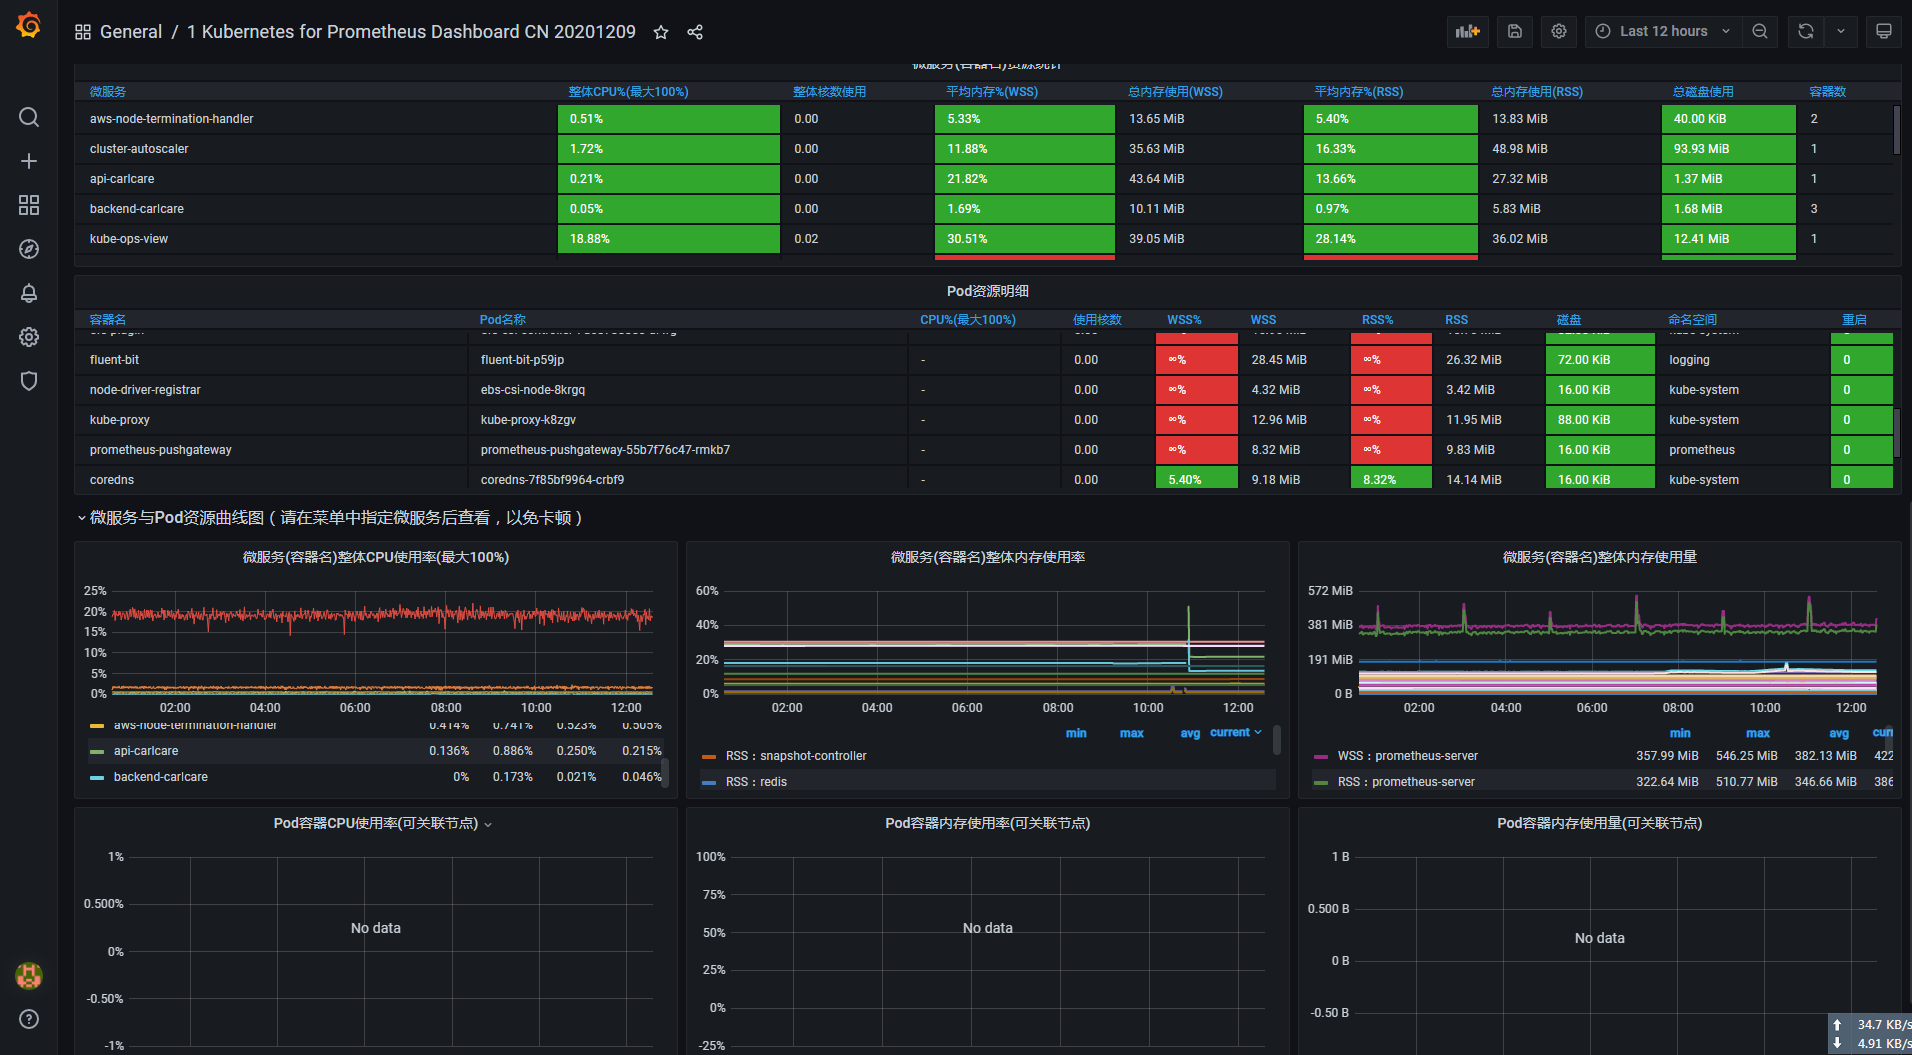
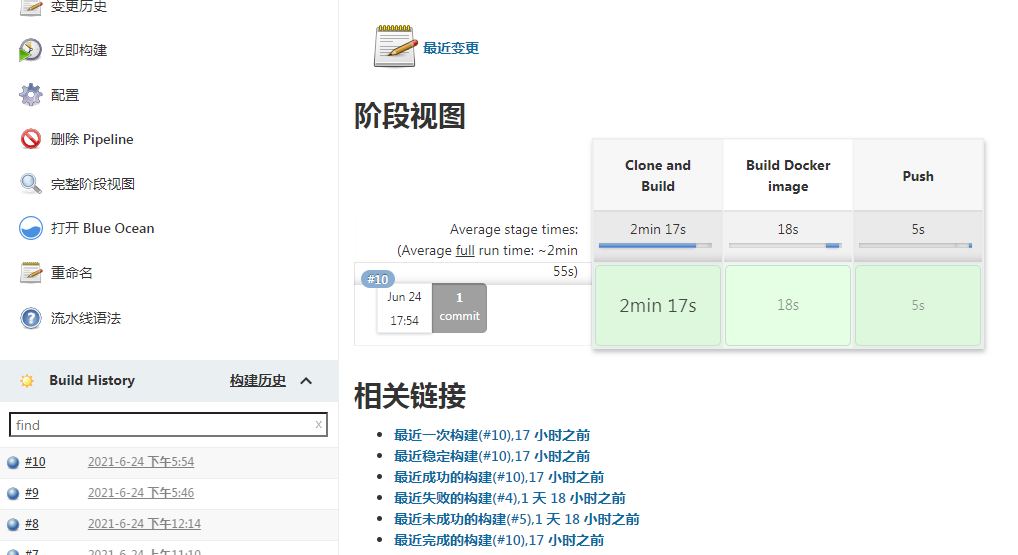
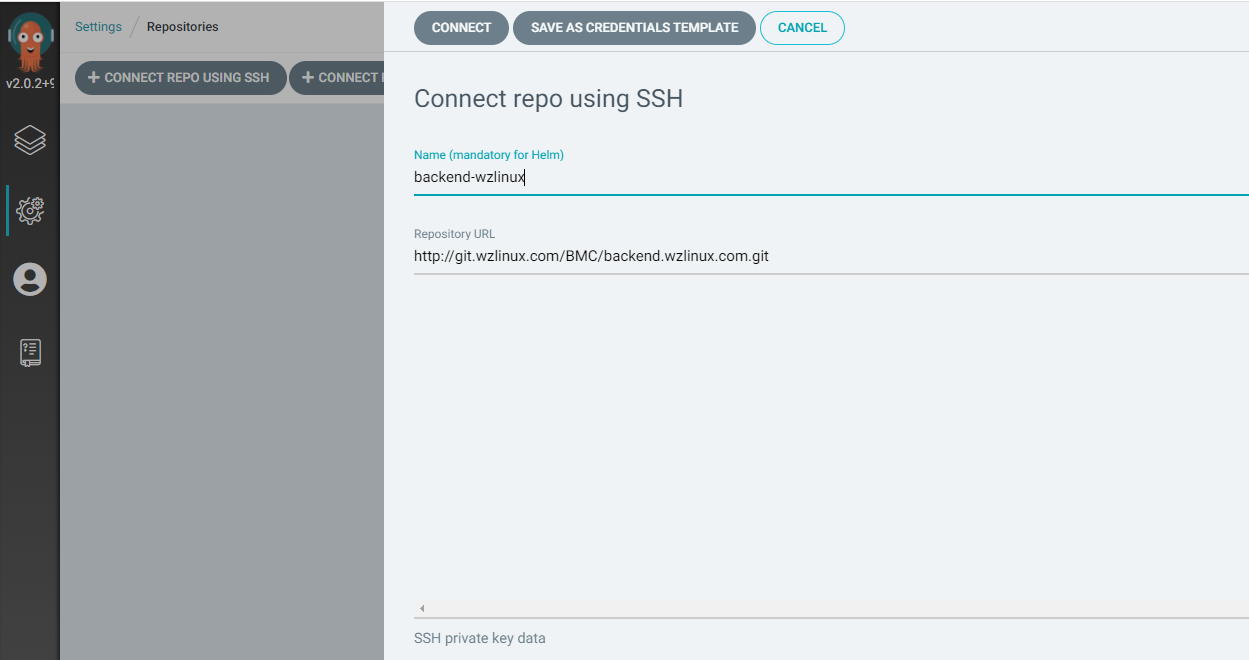
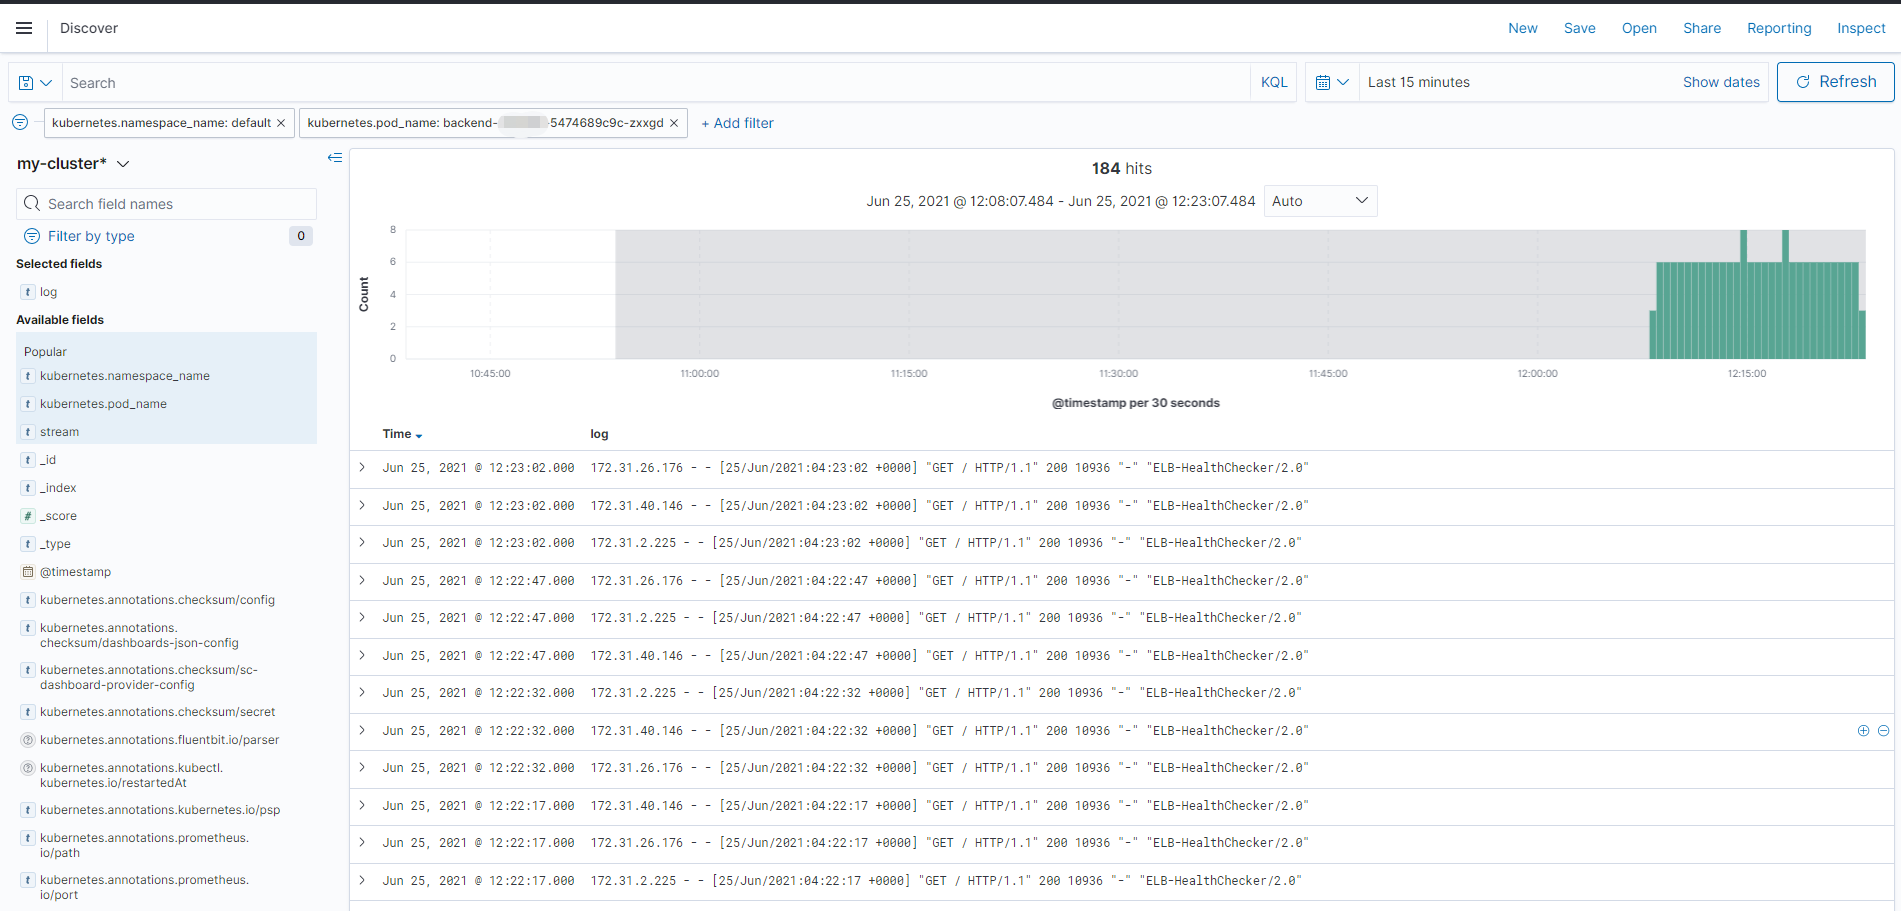
# 介绍 我演示的这个项目使用 vue-element-admin 模版编写,是一个前端项目,相对来说比较简单。 官方地址为:https://panjiachen.github.io/vue-element-admin-site/ ![image-20210625110920533](https://imgs.wzlinux.com/blog/202106/25/110921-711930.png) 代码不过多介绍,我们直接部署 CI/CD 流程。 # Continuous Integration ## 编写 Dockerfile 因为是前端项目,我们只需要 nginx 提供 web 服务即可,并且只需要把打包好的文件 dist 放入镜像就行,所以 Dockerfile 可以这样编写。 ```dockerfile # Version 0.0.1 FROM nginx MAINTAINER wzlinux "admin@wzlinux.com" COPY ["backend.wzlinux.com.conf","/etc/nginx/conf.d/default.conf"] COPY ["dist/","/usr/share/nginx/html/"] EXPOSE 80 ``` ## 编写 nginx conf 默认的 nginx 配置文件不满足我们的代码需要,我们需要定制自己的 conf 文件 `backend.wzlinux.com.conf` ```nginx server { listen 80 default_server; listen [::]:80 default_server; server_name _; index index.html index.htm index.php default.html default.htm default.php; root /usr/share/nginx/html; #关键解决vue路由丢失问题 location / { try_files $uri $uri/ /index.html; } location ~ .*\.(gif|jpg|jpeg|png|bmp|swf)$ { expires 30d; } location ~ .*\.(js|css)?$ { expires 12h; } location ~ /.well-known { allow all; } location ~ /\. { deny all; } #access_log /var/log/nginx/access.log; #error_log /var/log/nginx/error.log; access_log /dev/stdout; error_log /dev/stderr; } ``` 以上两个文件放在代码根目录即可。 ## 编写 Jenkins pipeline 我们的 jenkins 已经配置过 EKS,这里不再介绍,可以查看前面的文档,这里直接贴出 pipeline,其他项目都可以按照这个结构,更好自己需要的镜像或者命令即可。 ```json podTemplate( containers: [ containerTemplate(name: 'node', image: 'wangzan18/node:12-slim', ttyEnabled: true, command: 'cat'), containerTemplate(name: 'docker', image: 'docker:latest', ttyEnabled: true, command: 'cat'), containerTemplate(name: 'awscli', image: 'amazon/aws-cli:latest', ttyEnabled: true, command: 'cat') ], volumes: [ hostPathVolume(mountPath: '/var/run/docker.sock', hostPath: '/var/run/docker.sock'), hostPathVolume(mountPath: '/usr/bin/docker', hostPath: '/usr/bin/docker') ], serviceAccount: 'jenkins-agent' ) { node(POD_LABEL) { stage('Clone and Build') { git branch: 'master', credentialsId: 'd38f927d-9152-4083-9e48-c312a07d230e', url: 'http://git.wzlinux.net/BMC/backend.wzlinux.com.git' container('node') { sh 'npm install' sh 'npm run build:prod' } } stage('Build Docker image') { container('docker') { sh 'docker build -t backend:v${BUILD_NUMBER} .' sh 'docker tag backend:v${BUILD_NUMBER} 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v${BUILD_NUMBER}' } } stage('Push') { container('awscli') { sh 'aws sts get-caller-identity' sh 'aws ecr get-login-password --region eu-west-1 | docker login --username AWS --password-stdin 921283538843.dkr.ecr.eu-west-1.amazonaws.com' sh 'docker push 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v${BUILD_NUMBER}' } } } } ``` 在 podTemplate 里面定义整个过程需要的镜像,针对这个 vue,我们使用到 node 镜像,因为 vue 里面一些资源需要 git 命令下面,我自己在 node:12-slim 里面安装了 git,重新制作了一个公共镜像,大家可以使用。 在 node 里面的 stage 就是我们真正的构建过程,第一个 stage 主要是拉取代码,已经进行 build 打包,打包完成之后会生成一个 dist 目录,我们 Dockerfile 里面会把这个 dist 目录文件复制到 nginx 的文件目录。 第二个 stage 就是制作镜像,并且给镜像加一个 `BUILD_NUMBER` 的版本,然后改为我们 ECR 的标签,这里应该注意到我们里面有一个 `serviceAccount` 的参数,因为后面上传镜像到 ECR 需要权限,我们根据 EKS IRSA 的功能,为这个 `serviceAccount` 赋予了 ECR 上传代码的权限。 第三个 stage 就是上传镜像了,在上传镜像之前,首先需要登录 ECR,可以直接使用 awscli 提供的指令进行登录,然后使用 docker push 进行镜像上传。 然后就可以直接指向 Jenkins task,查看镜像上传。 ![image-20210625112818357](https://imgs.wzlinux.com/blog/202106/25/112818-315806.png) 查看我们上传的镜像。 ![image-20210625112948141](https://imgs.wzlinux.com/blog/202106/25/113026-257768.png) 到此为止,我们整个 CI 流程已经完成,后面我们进行 CD 的演示。 # Continuous Deployment ## 编写 k8s 清单文件 在 EKS 中,node 节点所赋予的 Role 默认有 ECR 镜像的拉取,这里我们不需要再单独授权。在代码的根目录,我们创建一个`k8s`文件夹,然后创建两个清单: **deployment.yaml** ```yaml apiVersion: apps/v1 kind: Deployment metadata: name: backend-wzlinux labels: k8s-app: backend-wzlinux namespace: default spec: replicas: 3 selector: matchLabels: k8s-app: backend-wzlinux strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: labels: k8s-app: backend-wzlinux annotations: fluentbit.io/parser: nginx spec: containers: - image: 921283538843.dkr.ecr.eu-west-1.amazonaws.com/backend:v10 imagePullPolicy: Always name: backend-wzlinux env: - name: TZ value: Asia/Shanghai resources: limits: cpu: 500m memory: 500Mi requests: cpu: 100m memory: 200Mi ports: - containerPort: 80 protocol: TCP ``` **service.yaml** ```yaml apiVersion: v1 kind: Service metadata: name: backend-wzlinux spec: selector: k8s-app: backend-wzlinux ports: - protocol: TCP port: 80 targetPort: 80 type: ClusterIP --- apiVersion: networking.k8s.io/v1 kind: Ingress metadata: namespace: default name: backend-ingress annotations: kubernetes.io/ingress.class: alb alb.ingress.kubernetes.io/listen-ports: '[{"HTTP": 80}, {"HTTPS": 443}]' alb.ingress.kubernetes.io/target-group-attributes: stickiness.enabled=true,stickiness.lb_cookie.duration_seconds=600 alb.ingress.kubernetes.io/scheme: internet-facing alb.ingress.kubernetes.io/conditions.backend-wzlinux: > [{"field":"host-header","hostHeaderConfig":{"values":["backend.wzlinux.com"]}}] alb.ingress.kubernetes.io/group.name: wzlinux alb.ingress.kubernetes.io/ssl-redirect: '443' alb.ingress.kubernetes.io/certificate-arn: arn:aws:acm:eu-west-1:921283538843:certificate/e55a72ae-d9b5-4f77-bf6d-242691105231 alb.ingress.kubernetes.io/target-type: ip spec: rules: - http: paths: - path: / pathType: Prefix backend: service: name: backend-wzlinux port: number: 80 ``` 在 service 里面,我使用了 Ingress,为了使用 ALB,并且添加证书,具体的 annotations 含义,请查看下面的文档:https://kubernetes-sigs.github.io/aws-load-balancer-controller/v2.2/guide/ingress/annotations/ 上面的 ingress 清单,可以使用 Headless Service,也可以写成下面这样: ```yaml apiVersion: v1 kind: Service metadata: name: backend-wzlinux spec: selector: k8s-app: backend-wzlinux ports: - protocol: TCP port: 80 targetPort: 80 type: ClusterIP clusterIP: None --- apiVersion: networking.k8s.io/v1 kind: Ingress metadata: namespace: default name: backends-ingress annotations: kubernetes.io/ingress.class: alb alb.ingress.kubernetes.io/listen-ports: '[{"HTTP": 80}, {"HTTPS": 443}]' alb.ingress.kubernetes.io/target-group-attributes: stickiness.enabled=true,stickiness.lb_cookie.duration_seconds=600 alb.ingress.kubernetes.io/scheme: internet-facing alb.ingress.kubernetes.io/group.name: wzlinux alb.ingress.kubernetes.io/ssl-redirect: '443' alb.ingress.kubernetes.io/certificate-arn: arn:aws:acm:eu-west-1:921283538843:certificate/e55a72ae-d9b5-4f77-bf6d-242691105231 alb.ingress.kubernetes.io/target-type: ip spec: rules: - host: backends.wzlinux.com http: paths: - pathType: ImplementationSpecific backend: service: name: backend-wzlinux port: number: 80 ``` ## 配置 argocd 首先为 argocd 配置 Repositories。 ![image-20210625121850828](https://imgs.wzlinux.com/blog/202106/25/121851-679605.png) 创建 app。 ![image-20210625121932020](https://imgs.wzlinux.com/blog/202106/25/121932-170841.png) ![image-20210625122007852](https://imgs.wzlinux.com/blog/202106/25/122008-53226.png) ![image-20210625122028572](https://imgs.wzlinux.com/blog/202106/25/122029-708478.png) 当然在 Argo CD 里面也可以查看日志,也是很方便的。 ![image-20210630105825514](https://imgs.wzlinux.com/blog/image-20210630105825514.png) 这样设置的话,当我们更新清单就会自动发布。 整个流程大概就是这样。 # 日志查看 登陆到我们的 Kibana,可以看到相关 Pod 的日志信息,因为我们把 nginx 访问日志和错误日志都输出到终端了。 ![image-20210625122738420](https://imgs.wzlinux.com/blog/202106/25/122739-127703.png) 目前还没有什么访问量,基本都是 ALB 健康检查的日志。 # 监控查看 ![image-20210625123608106](https://imgs.wzlinux.com/blog/202106/25/123608-640587.png) # 欢迎大家扫码关注,获取更多信息 ![](https://imgs.wzlinux.com/wechat/wechat-8.jpg)
优秀的个人博客,低调大师

EKS 训练营-日志收集 EFK(14)

# 介绍 应用程序和系统日志可以帮助我们了解集群内部的运行情况,日志对于我们调试问题和监视集群情况也是非常有用的。而且大部分的应用都会有日志记录,对于传统的应用大部分都会写入到本地的日志文件之中。对于容器化应用程序来说则更简单,只需要将日志信息写入到 stdout 和 stderr 即可,容器默认情况下就会把这些日志输出到宿主机上的一个 JSON 文件之中,同样我们也可以通过 docker logs 或者 kubectl logs 来查看到对应的日志信息。 但是,通常来说容器引擎或运行时提供的功能不足以记录完整的日志信息,比如,如果容器崩溃了、Pod 被驱逐了或者节点挂掉了,我们仍然也希望访问应用程序的日志。所以,日志应该独立于节点、Pod 或容器的生命周期,这种设计方式被称为 cluster-level-logging,即完全独立于 Kubernetes 系统,需要自己提供单独的日志后端存储、分析和查询工具。 ## 日志收集方案 Kubernetes 集群本身不提供日志收集的解决方案,一般来说有主要的 3 种方案来做日志收集: - 在节点上运行一个 agent 来收集日志 ![image-20210607203949035](https://imgs.wzlinux.com/blog/202106/07/203949-774535.png) - 在 Pod 中包含一个 sidecar 容器来收集应用日志 ![image-20210607204001951](https://imgs.wzlinux.com/blog/202106/07/204002-893326.png) - 直接在应用程序中将日志信息推送到采集后端 ![image-20210607204111275](https://imgs.wzlinux.com/blog/202106/07/204111-160445.png) Kubernetes 中比较流行的日志收集解决方案是 Elasticsearch、Fluentd 和 Kibana(EFK)技术栈,也是官方现在比较推荐的一种方案。 `Elasticsearch` 是一个实时的、分布式的可扩展的搜索引擎,允许进行全文、结构化搜索,它通常用于索引和搜索大量日志数据,也可用于搜索许多不同类型的文档。 Elasticsearch 通常与 `Kibana` 一起部署,Kibana 是 Elasticsearch 的一个功能强大的数据可视化 Dashboard,Kibana 允许你通过 web 界面来浏览 Elasticsearch 日志数据。 `Fluentd`是一个流行的开源数据收集器,我们将在 Kubernetes 集群节点上安装 Fluentd,通过获取容器日志文件、过滤和转换日志数据,然后将数据传递到 Elasticsearch 集群,在该集群中对其进行索引和存储。 `Fluentd` 是一个高效的日志聚合器,是用 Ruby 编写的,并且可以很好地扩展。对于大部分企业来说,Fluentd 足够高效并且消耗的资源相对较少,另外一个工具`Fluent-bit`更轻量级,占用资源更少,但是插件相对 Fluentd 来说不够丰富,所以整体来说,Fluentd 更加成熟,使用更加广泛,所以我们这里也同样使用 Fluentd 来作为日志收集工具。 我们先来配置启动一个可扩展的 Elasticsearch 集群,然后在 Kubernetes 集群中创建一个 Kibana 应用,最后通过 DaemonSet 来运行 Fluentd,以便它在每个 Kubernetes 工作节点上都可以运行一个 Pod。 # 创建 ES 集群 为了简便,我们这里使用 AWS 全托管的 ES 服务,服务将会开启精细访问服务,先设定几个环境变量: ```bash # name of our elasticsearch cluster export ES_DOMAIN_NAME="eks-logging" # Elasticsearch version export ES_VERSION="7.10" # kibana admin user export ES_DOMAIN_USER="admin" # kibana admin password export ES_DOMAIN_PASSWORD="Wangzan@18" ``` 创建 ES 集群 ```bash # Download and update the template using the variables created previously mkdir ~/environment/logging/ && cd ~/environment/logging/ curl -sS https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/es-domain.json \ | envsubst > ~/environment/logging/es_domain.json # Create the cluster aws es create-elasticsearch-domain \ --cli-input-json file://~/environment/logging/es_domain.json ``` ![image-20210607230206132](https://imgs.wzlinux.com/blog/202106/07/230206-837255.png) # 为 Fluent bit 配置 IRSA 我们为 ES 开启了精细访问控制,因为 fluent 需要向 ElasticSearch 通信,我们需要为这个 fluent 创建一个具有基本权限的 serviceAccount,这里即便给了很大的权限也是无法写入 ES 集群的,请自行替换 Resource 里面的参数。 ```bash cd ~/environment/logging/ cat < ~/environment/logging/fluent-bit-policy.json { "Version": "2012-10-17", "Statement": [ { "Action": [ "es:ESHttp*" ], "Resource": "arn:aws:es:eu-west-1:921283538843:domain/eks-logging", "Effect": "Allow" } ] } EoF aws iam create-policy \ --policy-name fluent-bit-policy \ --policy-document file://~/environment/logging/fluent-bit-policy.json ``` ## 创建 serviceAccount 为 fluent serviceAccount 创建 IAM 角色。 ```bash kubectl create namespace logging eksctl create iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --attach-policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" \ --approve \ --override-existing-serviceaccounts ``` 确认一下创建的 serviceAccount 已经 annotated 相应的角色。 ```bash kubectl -n logging describe sa fluent-bit ``` 输出如下: ```bash Name: fluent-bit Namespace: logging Labels: app.kubernetes.io/managed-by=eksctl Annotations: eks.amazonaws.com/role-arn: arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO Image pull secrets: Mountable secrets: fluent-bit-token-kjqnh Tokens: fluent-bit-token-kjqnh Events: ``` # 配置 ES 访问权限 角色映射是精细访问控制的最重要的方面。精细访问控制具有一些预定义的角色来帮助您入门,但除非您将角色映射到用户,否则,向集群发出的每个请求都会以权限错误结束。 *Backend roles*,提供了另一种将角色映射到用户的方法。您可以将同一角色映射到单个后端角色,然后确保所有用户都具有该后端角色,而不是将同一角色映射到几十个不同的用户。后端角色可以是 IAM 角色或任意字符串。 有上面的结果我们可以知道 fluent 的 serviceAccount 的 IAM 角色为: ```bash arn:aws:iam::921283538843:role/eksctl-my-cluster-addon-iamserviceaccount-lo-Role1-1628KE9D9FMEO ``` 因为 ES 已经创建好了,我们使用提前定义的账户和密码登陆进去,然后选择 `Open Distro for Elasticsearch` --> Security --> Roles --> all_access --> Mapped users --> Manage mapping 加上上面的角色。 ![image-20210607231953893](https://imgs.wzlinux.com/blog/202106/07/231954-920360.png) 也可以使用我们定义好的账户访问 ES 接口添加权限 ```bash # We need to retrieve the Fluent Bit Role ARN export FLUENTBIT_ROLE=$(eksctl get iamserviceaccount --cluster my-cluster --namespace logging -o json | jq '.[].status.roleARN' -r) # Get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") # Update the Elasticsearch internal database curl -sS -u "${ES_DOMAIN_USER}:${ES_DOMAIN_PASSWORD}" \ -X PATCH \ https://${ES_ENDPOINT}/_opendistro/_security/api/rolesmapping/all_access?pretty \ -H 'Content-Type: application/json' \ -d' [ { "op": "add", "path": "/backend_roles", "value": ["'${FLUENTBIT_ROLE}'"] } ] ' ``` 现在我们使用自己的 IAM user 打开 Console,可以看到会有下面的报错 ![image-20210607232313985](https://imgs.wzlinux.com/blog/202106/07/232314-521859.png) 虽然我们的 IAM user 具有最高权限,但是因为开启的精细访问,这里也会显示没有权限,按照上面的方式,我们可以把自己的 IAM user 也 Map user 里面的 user。 ![image-20210607232510859](https://imgs.wzlinux.com/blog/202106/07/232511-878719.png) # 部署 fluent bit 下载 fluent bit yaml 文件,修改其中一些参数 ```bash cd ~/environment/logging # get the Elasticsearch Endpoint export ES_ENDPOINT=$(aws es describe-elasticsearch-domain --domain-name ${ES_DOMAIN_NAME} --output text --query "DomainStatus.Endpoint") curl -Ss https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluentbit.yaml \ | envsubst > ~/environment/logging/fluentbit.yaml ``` 可以查看文件清单,确认一下要部署的资源,然后我们进行部署: ```bash kubectl apply -f ~/environment/logging/fluentbit.yaml ``` 部署的为 DaemonSet,每个 node 上面都会部署一个 fluent 来收取日志。 ```bash wangzan:~/environment/logging $ kubectl --namespace=logging get pods NAME READY STATUS RESTARTS AGE fluent-bit-cfqrn 1/1 Running 0 60s fluent-bit-cnfbl 1/1 Running 0 60s fluent-bit-n46wq 1/1 Running 0 60s fluent-bit-zhbxn 1/1 Running 0 60s ``` # Kibana 可视化 登陆到 Kibana 系统之后,我们选择 Kibana ---> Discover,选择创建 index。 ![image-20210607233724563](https://imgs.wzlinux.com/blog/202106/07/233725-533201.png) 输入 index pattern 的名字,然后点击下一步 ![image-20210607233820347](https://imgs.wzlinux.com/blog/202106/07/233821-999201.png) 我们选择 @timestamp ![image-20210607233921971](https://imgs.wzlinux.com/blog/202106/07/233922-296745.png) 然后再点击 Discover,就可以看到日志了。 ![image-20210607234035175](https://imgs.wzlinux.com/blog/202106/07/234035-230542.png) # 问题处理 我们在 ES 的界面中,可以看到大量的 fluent bit 的错误报告,内容如下: ```verilog [2021/06/17 01:46:35] [ warn] [engine] failed to flush chunk '1-1623894315.231527444.flb', retry in 359 seconds: task_id=1825, input=tail.0 > output=es.0 ``` 我们再去查看 fluent bit 的 Pod ,查看报错日志,会有一个 400 错误,尽量查看新创建的 Pod: ```json "index": { "_index": "fluent-bit", "_type": "_doc", "_id": "TUx4E3oB4v1-EVN7WM4m", "status": 400, "error": { "type": "mapper_parsing_exception", "reason": "Could not dynamically add mapping for field [app.kubernetes.io/name]. Existing mapping for [kubernetes.labels.app] must be of type object but found [text]." } } ``` 我们看到,当 fluent bit 去动态创建 mapping 的时候,无法创建,我们再去查看一下 ES 的 mapping。 ![image-20210617095246535](https://imgs.wzlinux.com/blog/202106/17/095247-151579.png) 这里的 app 类型为 text,无法被创建,为什么会出现这样的问题呢? 我们去查看一下部署的 Pod,发现其中有些 Pod 同时有如下的一些 lable: ```bash app.kubernetes.io/name: app.kubernetes.io/instance: app: ``` 一般来说,若您没有特别设定,当数据写入 ES 的时候,该 index 的 index mapping 便会自动被建立,并且随着数据格式的改变动态地调整 index mapping,因为有 app 这个 label,创建了如上的 mapping,当再创建含有”kubernetes.labels.app.kubernetes.io/name” 的栏位数据写入时, ES无法动态地将”kubernetes.labels.app” 由 text 转为 object,因此出现 http 400 mapper_parsing_exception 这样的错误信息。 ## 小测试 我们可以对 ES Dev Tools 进行一下测试,我们手动写入一份数据: ```json PUT fluent-bit-test-001/_doc/1 { "kubernetes": { "labels": { "app":"test" } } } ``` 然后查看一下 ES 自动创建的 Index mapping。 ```bash GET /fluent-bit-test-001/_mapping ``` ![image-20210617101342472](https://imgs.wzlinux.com/blog/202106/17/101343-316893.png) 若我再写一笔数据至fluent-bit-test-001。 ```json PUT fluent-bit-test-001/_doc/2 { "kubernetes": { "labels": { "app-test":"test" } } } ``` 此时该索引的mapping便随之更动如下: ```json { "fluent-bit-test-001" : { "mappings" : { "properties" : { "kubernetes" : { "properties" : { "labels" : { "properties" : { "app" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } }, "app-test" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } } } } } } } } } } ``` ![image-20210617101558456](https://imgs.wzlinux.com/blog/202106/17/101559-841545.png) 那么我们去重现一下上面的问题,写入如下数据 ```json PUT fluent-bit-test-001/_doc/3 { "kubernetes": { "labels": { "app": { "kubernetes": { "io/name":"test12345" } } } } } ``` 便会出现http 400 mapper_parsing_exception error. 又“kubernetes.labels.app” 无法同时为text及object 型态。 ![image-20210617101835707](https://imgs.wzlinux.com/blog/202106/17/101835-513511.png) ## 解决办法 调整 prod labels 的 key 值的 naming 规则,举例来说,若 labels 的 Key 已经有 app 这样的 key 值了,就不要有后续 app.kubernetes.io/name 这样的 Key 值。 我看了一下,同时有这两个 label 的 Pod 基本就是 ebs,efs,我们去修改他们的 deployment,删掉这些 app 这个标签。 **更改 ebs-csi-controller** ```bash kubectl delete deploy ebs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-controller.yaml -n kube-system ``` **ebs-csi-node** ```bash kubectl delete daemonset ebs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-csi-node.yaml -n kube-system ``` **ebs-snapshot-controller** ```bash kubectl delete statefulset ebs-snapshot-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/ebs-snapshot-controller.yaml -n kube-system ``` **efs-csi-controller** ```bash kubectl delete deploy efs-csi-controller -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-controller.yaml -n kube-system ``` **efs-csi-node** ```bash kubectl delete daemonset efs-csi-node -n kube-system kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/efs-csi-node.yaml -n kube-system ``` 然后查看命令,看看还有哪些 Pod 是带有 app 这个标签的。 ```bash kubectl get pod -n kube-system -l app --show-labels ``` 发现只有一个 cluster-autoscaler,我们修改最后一个 Pod。 **cluster-autoscaler** ```bash kubectl -n kube-system edit deployment.apps/cluster-autoscaler kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/cluster-autoscaler-autodiscover.yaml -n kube-system kubectl -n kube-system \ annotate deployment.apps/cluster-autoscaler \ cluster-autoscaler.kubernetes.io/safe-to-evict="false" deployment.apps/cluster-autoscaler annotated ``` 现在已经没有使用 app 标签的 Pod 了,我们下一步需要重建 ES 的 Index,我们适当的修改 fluent bit 的配置文件,在输出里面,添加一些参数,使得每天生成一个 Index,这样可以提升检索速度,记得把 yaml 下载下来,修改为自己的 ES 地址。 ```bash kubectl delete -f fluentbit.yaml kubectl apply -f https://raw.githubusercontent.com/wangzan18/jenkins-agent-k8s-cicd/master/logging/fluent-bit.yaml ``` **重新添加 Index pattern** ![image-20210617122645494](https://imgs.wzlinux.com/blog/202106/17/122646-295212.png) # 清理资源 ```bash cd ~/environment/ kubectl delete -f ~/environment/logging/fluentbit.yaml aws es delete-elasticsearch-domain \ --domain-name ${ES_DOMAIN_NAME} eksctl delete iamserviceaccount \ --name fluent-bit \ --namespace logging \ --cluster my-cluster \ --wait aws iam delete-policy \ --policy-arn "arn:aws:iam::921283538843:policy/fluent-bit-policy" kubectl delete namespace logging rm -rf ~/environment/logging unset ES_DOMAIN_NAME unset ES_VERSION unset ES_DOMAIN_USER unset ES_DOMAIN_PASSWORD unset FLUENTBIT_ROLE unset ES_ENDPOINT ``` # 欢迎大家扫码关注,获取更多信息 ![](https://imgs.wzlinux.com/wechat/wechat-8.jpg)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册