首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

深入理解 JUC:CountDownLatch

CountDownLatch 是一个同步辅助工具,用于阻塞当前一个或多个线程以等待其它线程中的操作完成。在构造 CountDownLatch 对象时,我们需要指定一个非负的 count 值,一般情况下,调用 CountDownLatch#await 方法的线程需要阻塞等待该 count 值变为 0 时才能够继续往下执行。具体示例可以参考 理清 CountDownLatch 与 CyclicBarrier 的区别。 CountDownLatch 实现内幕 CountDownLatch 在实现上同样依赖于 AQS 组件,在 CountDownLatch 的内部定义了一个 Sync 内部类,该类继承自 AbstractQueuedSynchronizer,并复用 AQS 的 state 字段以记录 count 值的变化。CountDownLatch 的核心方法均委托 Sync 进行处理,实现如下: public class CountDownLatch { private final Sync sync; public CountDownLatch(int count) { if (count < 0) { throw new IllegalArgumentException("count < 0"); } this.sync = new Sync(count); } public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } public boolean await(long timeout, TimeUnit unit) throws InterruptedException { return sync.tryAcquireSharedNanos(1, unit.toNanos(timeout)); } public void countDown() { sync.releaseShared(1); } public long getCount() { return sync.getCount(); } } 下面我们主要分析一下 CountDownLatch#await 和 CountDownLatch#countDown 方法的实现。 首先来看一下 CountDownLatch#await 方法,该方法用于阻塞当前线程,直到 count 值变为 0,或者被其它线程中断。具体实现上,CountDownLatch 直接将请求委托给 AQS 的 AbstractQueuedSynchronizer#acquireSharedInterruptibly 方法进行处理,所以我们下面主要来看一下 CountDownLatch 针对模板方法 AbstractQueuedSynchronizer#tryAcquireShared 的实现,如下: protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } 实现上非常简单,获取并判定状态值是否为 0,如果是则说明当前线程获取资源成功,能够继续往下执行,否则说明当前线程获取资源失败,需要被添加到同步队列阻塞等待。CountDownLatch 还为 CountDownLatch#await 方法定义了超时版本 CountDownLatch#await(long, TimeUnit)。 继续来看一下 CountDownLatch#countDown 方法,该方法用于将 count 值减 1,如果发现 count 值变为 0,则唤醒阻塞等待的线程。具体实现上,CountDownLatch 同样直接将请求委托给 AQS 的 AbstractQueuedSynchronizer#releaseShared 方法进行处理,所以我们下面主要来看一下 CountDownLatch 针对模板方法 AbstractQueuedSynchronizer#tryReleaseShared 的实现,如下: protected boolean tryReleaseShared(int releases) { // Decrement count; signal when transition to zero for (; ; ) { // 获取 state 状态值 int c = getState(); // 如果已经为 0 则说明没有资源可以释放,直接返回 false,避免 state 变为负值 if (c == 0) { return false; } // 资源数减 1 int nextc = c - 1; if (compareAndSetState(c, nextc)) { // 如果为 0,则说明资源全部释放完毕,此时需要唤醒等待的线程 return nextc == 0; } } } 具体实现如代码注释,比较简单。需要注意的一点就是上面步骤中的判 0 操作,刚开始看的时候可能觉得有点多余,但是这一步的主要作用在于保证 state 值不会变为负值。当前 count 值变为 0 时,上述方法会返回 true,接下去 AQS 会执行唤醒之前因为 count 值不为 0 而被打入同步队列的线程。 总结 CountDownLatch 的实现机制到此就分析完了,因为依赖于 AQS,所以 CountDownLatch 在实现上变得十分简单,但是功能却很强大。下一篇我们将要分析与 CountDownLatch 极为容易混淆的 CyclicBarrier 组件,从实现层面去理清二者的区别。 参考 JDK 1.8 源码 The java.util.concurrent Synchronizer Framework

优秀的个人博客,低调大师

TensorFlow On Flink 原理解析

作者:陈戊超(仲卓),阿里巴巴技术专家 深度学习技术在当代社会发挥的作用越来越大。目前深度学习被广泛应用于个性化推荐、商品搜索、人脸识别、机器翻译、自动驾驶等多个领域,此外还在向社会各个领域迅速渗透。 背景 当前,深度学习的应用越来越多样化,随之涌现出诸多优秀的计算框架。其中 TensorFlow,PyTorch,MXNeT 作为广泛使用的框架更是备受瞩目。在将深度学习应用于实际业务的过程中,往往需要结合数据处理相关的计算框架如:模型训练之前需要对训练数据进行加工生成训练样本,模型预测过程中需要对处理数据的一些指标进行监控等。在这样的情况下,数据处理和模型训练分别需要使用不同的计算引擎,增加了用户使用的难度。 本文将分享如何使用一套引擎搞定机器学习全流程的解决方案。先介绍一下典型的机器学习工作流程。如图所示,整个流程包含特征工程、模型训练、离线或者是在线预测等环节。 在此过程中,无论是特征工程、模型训练还是模型预测,中间都会产生日志。需要先用数据处理引擎比如 Flink 对这些日志进行分析,然后进入特征工程。再使用深度学习的计算引擎 TensorFlow 进行模型训练和模型预测。当模型训练好了以后再用 tensor serving 做在线的打分。 上述流程虽然可以跑通,但也存在一定的问题,比如: 同一个机器学习项目在做特征工程、模型训练、模型预测时需要用到 Flink 和 TensorFlow 两个计算引擎,部署相对而言更复杂。 TensorFlow 在分布式的支持上还不够友好,运行过程中需要指定机器的 IP 地址和端口号;而实际生产过程经常是运行在一个调度系统上比如 Yarn,需要动态分配 IP 地址和端口号。 TensorFlow 的分布式运行缺乏自动的 failover 机制。 针对以上问题,我们通过结合 Flink 和 TensorFlow,将 TensorFlow 的程序跑在 Flink 集群上的这种方式来解决,整体流程如下: 特征工程用 Flink 去执行,模型训练和模型的准实时预测目标使 TensorFlow 计算引擎可以跑在 Flink 集群上。这样就可以用 Flink 一套计算引擎去支持模型训练和模型的预测,部署上更简单的同时也节约了资源。 Flink 计算简介 Flink 是一款开源大数据分布式计算引擎,在 Flink 里所有的计算都抽象成 operator,如上图所示,数据读取的节点叫 source operator,输出数据的节点叫 sink operator。source 和 sink 中间有多种多样的 Flink operator 去处理,上图的计算拓扑包含了三个 source 和两个 sink。 机器学习分布式拓扑 机器学习分布式运行拓扑如下图所示: 在一个机器学习的集群当中,经常会对一组节点(node)进行分组,如上图所示,一组节点可以是 worker(运行算法),也可以是 ps(更新参数)。 如何将 Flink 的 operator 结构与 Machine Learning 的 node、Application Manager 角色结合起来?下面将详细讲解 flink-ai-extended 的抽象。 Flink-ai-extended 抽象 首先,对机器学习的 cluster 进行一层抽象,命名为 ML framework,同时机器学习也包含了 ML operator。通过这两个模块,可以把 Flink 和 Machine Learning Cluster 结合起来,并且可以支持不同的计算引擎,包括 TensorFlow。 如下图所示: 在 Flink 运行环境上,抽象了 ML Framework 和 ML Operator 模块,负责连接 Flink 和其他计算引擎。 ML Framework ML Framework 分为 2 个角色。 Application Manager(以下简称 am) 角色,负责管理所有 node 的节点的生命周期。 node 角色,负责执行机器学习的算法程序。 在上述过程中,还可以对 Application Manager 和 node 进行进一步的抽象,Application Manager 里面我们单独把 state machine 的状态机做成可扩展的,这样就可以支持不同类型的作业。 深度学习引擎,可以自己定义其状态机。从 node 的节点抽象 runner 接口,这样用户就可以根据不同的深度学习引擎去自定义运行算法程序。 ML Operator ML Operator 模块提供了两个接口: addAMRole,这个接口的作用是在 Flink 的作业里添加一个 Application Manager 的角色。Application Manager 角色如上图所示就是机器学习集群的管理节点。 addRole,增加的是机器学习的一组节点。 利用 ML Operator 提供的接口,可以实现 Flink Operator 中包含一个Application Manager 及 3 组 node 的角色,这三组 node 分别叫 role a、 role b,、role c,三个不同角色组成机器学习的一个 cluster。如上图代码所示。Flink 的 operator 与机器学习作业的 node 一一对应。 机器学习的 node 节点运行在 Flink 的 operator 里,需要进行数据交换,原理如下图所示: Flink operator 是 java 进程,机器学习的 node 节点一般是 python 进程,java 和 python 进程通过共享内存交换数据。 TensorFlow On Flink TensorFlow 分布式运行 TensorFlow 分布式训练一般分为 worker 和 ps 角色。worker 负责机器学习计算,ps 负责参数更新。下面将讲解 TensorFlow 如何运行在 Flink 集群中。 TensorFlow Batch 训练运行模式 Batch 模式下,样本数据可以是放在 HDFS 上的,对于 Flink 作业而言,它会起一个source 的 operator,然后 TensorFlow 的 work 角色就会启动。如上图所示,如果 worker 的角色有三个节点,那么 source 的并行度就会设为 3。同理下面 ps 角色有 2 个,所以 ps source 节点就会设为 2。而 Application Manager 和别的角色并没有数据交换,所以 Application Manager 是单独的一个节点,因此它的 source 节点并行度始终为 1。这样 Flink 作业上启动了三个 worker 和两个 ps 节点,worker 和 ps 之间的通讯是通过原始的 TensorFlow 的 GRPC 通讯来实现的,并不是走 Flink 的通信机制。 TensorFlow stream 训练运行模式 如上图所示,前面有两个 source operator,然后接 join operator,把两份数据合并为一份数据,再加自定义处理的节点,生成样本数据。在 stream 模式下,worker 的角色是通过 UDTF 或者 flatmap 来实现的。 同时,TensorFlow worker node 有3 个,所以 flatmap 和 UDTF 相对应的 operator 的并行度也为 3, 由于ps 角色并不去读取数据,所以是通过 flink source operator 来实现。 下面我们再讲一下,如果已经训练好的模型,如何去支持实时的预测。 使用 Python 进行预测 使用 Python 进行预测流程如图所示,如果 TensorFlow 的模型是分布式训练出来的模型,并且这个模型非常大,比如说单机放不下的情况,一般出现在推荐和搜索的场景下。那么实时预测和实时训练原理相同,唯一不同的地方是多了一个加载模型的过程。 在预测的情况下,通过读取模型,将所有的参数加载到 ps 里面去,然后上游的数据还是经过和训练时候一样的处理形式,数据流入到 worker 这样一个角色中去进行处理,将预测的分数再写回到 flink operator,并且发送到下游 operator。 使用 Java 进行预测 如图所示,模型单机进行预测时就没必要再去起 ps 节点,单个 worker 就可以装下整个模型进行预测,尤其是使用 TensorFlow 导出 save model。同时,因为 saved model 格式包含了整个深度学习预测的全部计算逻辑和输入输出,所以不需要运行 Python 的代码就可以进行预测。 此外,还有一种方式可以进行预测。前面 source、join、UDTF 都是对数据进行加工处理变成预测模型可以识别的数据格式,在这种情况下,可以直接在 Java 进程里面通过 TensorFlow Java API,将训练好的模型 load 到内存里,这时会发现并不需要 ps 角色, worker 角色也都是 Java 进程,并不是 Python 的进程,所以我们可以直接在 Java 进程内进行预测,并且可以将预测结果继续发给 Flink 的下游。 总结 在本文中,我们讲解了 flink-ai-extended 原理,以及Flink 结合 TensorFlow 如何进行模型训练和预测。希望通过本文大分享,大家能够使用 flink-ai-extended, 通过 Flink 作业去支持模型训练和模型的预测。

优秀的个人博客,低调大师

简单理解CAS以及compareAndSet

CAS:Compare and Swap, 比较并交换。 CAS的作用是将指定内存地址的内容与所给的某个值相比,如果相等,则将其内容替换为指令中提供的新值,如果不相等,则更新失败。这一比较并交换的操作是原子的,不可以被中断。CAS是通过硬件命令保证了原子性,且硬件级别的原子性比高级语言的软件级别的运行速度要快地多。虽然CAS也包含了多个操作,但其的运算是固定的(就是个比较),这样的锁定性能开销很小。 CAS有3个操作数,内存值V,旧的预期值A,要修改的新值B。当且仅当预期值A和内存值V相同时,将内存值V修改为B,否则什么都不做。 CAS有效地说明了“我认为位置V应该包含值A;如果包含该值,则将B放到这个位置;否则,不要更改该位置,只告诉我这个位置现在的值即可。 AtomicInteger类compareAndSet通过原子操作实现了CAS操作,最底层基于汇编语言实现。 public final boolean compareAndSet(V expect, V update) 工作原理如图:内存值跟期望值相同时,内存值跟期望值不同时,

优秀的个人博客,低调大师

ConcurrentHashMap 1.8原理解析

JDK 1.8中,Hash家族有这么一些存在,HashMap,HashTable,LinkedHashMap,ConcurrentHashMap。这里面支持线程安全的有HashTable以及ConcurrentHashMap。对Hash有一个基本了解可以参考本人的从Hash到一致性Hash原理(深度好文) 。 那既然说到ConcurrentHashMap,自然要讨论的就是它的线程安全性和效能。我们先来看一下HashTable的线程安全性以及效能的低下。 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 我们对比一下HashMap 1.7的这两个方法(因为1.8点HashMap会生成红黑树,我们暂时先不考虑红黑树的问题) public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); return null; } public V get(Object key) { if (key == null) return getForNullKey(); Entry<K,V> entry = getEntry(key); return null == entry ? null : entry.getValue(); } final int hash(Object k) { int h = 0; if (useAltHashing) { if (k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h = hashSeed; } h ^= k.hashCode(); // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). //一种算法,进行4次位移,得到相对比较分散的链表 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 在这里我们可以看到,他们除了key的hash算法不同,HashTable的比较简单,只是用key的哈希值与0x7FFFFFFF(十进制2147483647,二进制1111111111111111111111111111111)进行一次与运算,即为只要相同二进制位上不论0,1全部都变成1,再对table数组的长度取模。而HashMap 1.7则为key的哈希值进行各位无符号位移加异或运算,取得最终哈希值。然后是HashTable不接收null的key,而HashMap接受。他们最大的区别就在于synchronized显示器锁了。 synchronized的本质是所有对象的字节码中有一个monitor的对象头,任何线程拿到了这个monitor的对象头就可以对这个对象进行操作,而拿不到monitor对象头的线程就只能等待,直到拿到了monitor的线程放弃,其他线程才能争夺这个对象头来对对象进行操作。那么问题来了,当大量线程高并发的时候,只要有一个线程拿到了这个对象头,其他线程对这个对象是既不能读也不能写。而对于HashMap来说,如果多线程对其进行操作,那么任意线程都可以胡乱修改里面值的内容造成脏读,所以HashMap是线程不安全的。 那么我们今天的主角登场了ConcurrentHashMap。我们同样来看一下这两个方法。以下是1.8的源码,首先我们要清楚的是1.8跟1.7已经完全不同,1.7是使用segements(16个segement),每个segement都有一个table(Map.Entry数组),相当于16个HashMap,同步机制为分段锁,每个segment继承ReentrantLock;而1.8只有1个table(Map.Entry数组),同步机制为CAS + synchronized保证并发更新。如果不搞清楚这个问题,那么你看1.8的源码可能会很懵逼。 public V put(K key, V value) { return putVal(key, value, false); } final V putVal(K key, V value, boolean onlyIfAbsent) { //无论key还是value,不允许空 if (key == null || value == null) throw new NullPointerException(); //此处获取hash值的方法与HashTable类似 int hash = spread(key.hashCode()); int binCount = 0; //无限循环 for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; //如果节点数组为null,或者长度为0,初始化节点数组 if (tab == null || (n = tab.length) == 0) tab = initTable(); //如果节点数组的某个节点为null,则put的时候就会采用无锁竞争来获取该节点的头把交椅 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) break; // no lock when adding to empty bin } //需要扩容的时候先扩容,再写入 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { //如果hash冲突的时候,即多线程操作时,大家都有一样的hash值 V oldVal = null; synchronized (f) { //锁定节点数组的该节点 if (tabAt(tab, i) == f) { //如果当前该节点为链表形态 if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; //找链表中找到相同的key,把新value替代老value if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; //如果找不到key,就添加到链表到末尾 if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null); break; } } } //如果当前为红黑树形态,进行红黑树到查找和替代(存在相同的key),或者放入红黑树到新叶节点上(key不存在) else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { //如果链表长度超过了8,链表转红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } //统计节点个数,检查是否需要扩容 addCount(1L, binCount); return null; } public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 读取的时候,我们没有看见锁到存在,说明读不受多线程影响。 对比ConcurrentHashMap和HashTable,我们可以明显的看到,ConcurrentHashMap在写的时候,并没有锁住整个节点数组,在新节点上使用的是无锁竞争,在老节点上锁住的仅仅是一个节点,读的时候如果不是恰好读到写线程写入相同Hash值的位置,不受影响(可以认为我们的操作一般是读多写少,这种几率也比较低)。而HashTable是对整个节点数组进行锁定,读到时候不能写,写的时候不能读,这么一对比就可以明显感觉到性能差距是巨大的。 虽然ConcurrentHashMap的并发性能还算比较优异,但在亿级计算中,却依然会成为性能瓶颈,具体可以参考本人的Fork/Join框架原理和使用探秘 至于这里为什么会慢,我认为在这种超高并发下,节点数组的单节点的的写写竞争是互斥的,其次,由于红黑树具有读快写慢的特性,它要不断保持树的平衡而不断返转,所以才会使得高并发写的性能急剧下降。

优秀的个人博客,低调大师

理解并实现 ResNet(Keras)

本文为 AI 研习社编译的技术博客,原标题 : Understanding and Coding a ResNet in Keras 作者 |Priya Dwivedi @ Deep Learning Analytics 翻译 | linlh、通夜 编辑 | 邓普斯•杰弗、Pita 原文链接: https://towardsdatascience.com/understanding-and-coding-a-resnet-in-keras-446d7ff84d33 ResNet 是残差网络(Residual Network)的缩写,是一种作为许多计算机视觉任务主干的经典神经网络。这个模型是2015年ImageNet挑战赛的获胜者,ResNet最根本的突破在于它使得我们可以训练成功非常深的神经网路,如1

优秀的个人博客,低调大师

深入理解线程通信

前言 开发中不免会遇到需要所有子线程执行完毕通知主线程处理某些逻辑的场景。 或者是线程 A 在执行到某个条件通知线程 B 执行某个操作。 可以通过以下几种方式实现: 等待通知机制 等待通知模式是 Java 中比较经典的线程通信方式。 两个线程通过对同一对象调用等待 wait() 和通知 notify() 方法来进行通讯。 如两个线程交替打印奇偶数: publicclassTwoThreadWaitNotify{ privateintstart=1; privatebooleanflag=false; publicstaticvoidmain(String[]args){ TwoThreadWaitNotifytwoThread=newTwoThreadWaitNotify(); Threadt1=newThread(newOuNum(twoThread)); t1.setName("A"); Threadt2=newThread(newJiNum(twoThread)); t2.setName("B"); t1.start(); t2.start(); } /** *偶数线程 */ publicstaticclassOuNumimplementsRunnable{ privateTwoThreadWaitNotifynumber; publicOuNum(TwoThreadWaitNotifynumber){ this.number=number; } @Override publicvoidrun(){ while(number.start<=100){ synchronized(TwoThreadWaitNotify.class){ System.out.println("偶数线程抢到锁了"); if(number.flag){ System.out.println(Thread.currentThread().getName()+"+-+偶数"+number.start); number.start++; number.flag=false; TwoThreadWaitNotify.class.notify(); }else{ try{ TwoThreadWaitNotify.class.wait(); }catch(InterruptedExceptione){ e.printStackTrace(); } } } } } } /** *奇数线程 */ publicstaticclassJiNumimplementsRunnable{ privateTwoThreadWaitNotifynumber; publicJiNum(TwoThreadWaitNotifynumber){ this.number=number; } @Override publicvoidrun(){ while(number.start<=100){ synchronized(TwoThreadWaitNotify.class){ System.out.println("奇数线程抢到锁了"); if(!number.flag){ System.out.println(Thread.currentThread().getName()+"+-+奇数"+number.start); number.start++; number.flag=true; TwoThreadWaitNotify.class.notify(); }else{ try{ TwoThreadWaitNotify.class.wait(); }catch(InterruptedExceptione){ e.printStackTrace(); } } } } } } } 输出结果: t2+-+奇数93 t1+-+偶数94 t2+-+奇数95 t1+-+偶数96 t2+-+奇数97 t1+-+偶数98 t2+-+奇数99 t1+-+偶数100 这里的线程 A 和线程 B 都对同一个对象 TwoThreadWaitNotify.class 获取锁,A 线程调用了同步对象的 wait() 方法释放了锁并进入 WAITING 状态。 B 线程调用了 notify() 方法,这样 A 线程收到通知之后就可以从 wait() 方法中返回。 这里利用了 TwoThreadWaitNotify.class 对象完成了通信。 有一些需要注意: wait() 、nofify() 、nofityAll() 调用的前提都是获得了对象的锁(也可称为对象监视器)。 调用 wait() 方法后线程会释放锁,进入 WAITING 状态,该线程也会被移动到等待队列中。 调用 notify() 方法会将等待队列中的线程移动到同步队列中,线程状态也会更新为 BLOCKED 从 wait() 方法返回的前提是调用 notify() 方法的线程释放锁,wait() 方法的线程获得锁。 等待通知有着一个经典范式: 线程 A 作为消费者: 获取对象的锁。 进入 while(判断条件),并调用 wait() 方法。 当条件满足跳出循环执行具体处理逻辑。 线程 B 作为生产者: 获取对象锁。 更改与线程 A 共用的判断条件。 调用 notify() 方法。 伪代码如下: //ThreadA synchronized(Object){ while(条件){ Object.wait(); } //dosomething } //ThreadB synchronized(Object){ 条件=false;//改变条件 Object.notify(); } join() 方法 privatestaticvoidjoin()throwsInterruptedException{ Threadt1=newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("running"); try{ Thread.sleep(3000); }catch(InterruptedExceptione){ e.printStackTrace(); } } }); Threadt2=newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("running2"); try{ Thread.sleep(4000); }catch(InterruptedExceptione){ e.printStackTrace(); } } }); t1.start(); t2.start(); //等待线程1终止 t1.join(); //等待线程2终止 t2.join(); LOGGER.info("mainover"); } 输出结果: 2018-03-1620:21:30.967[Thread-1]INFOc.c.actual.ThreadCommunication-running2 2018-03-1620:21:30.967[Thread-0]INFOc.c.actual.ThreadCommunication-running 2018-03-1620:21:34.972[main]INFOc.c.actual.ThreadCommunication-mainover 在 t1.join() 时会一直阻塞到 t1 执行完毕,所以最终主线程会等待 t1 和 t2 线程执行完毕。 其实从源码可以看出,join() 也是利用的等待通知机制: 核心逻辑: while(isAlive()){ wait(0); } 在 join 线程完成后会调用 notifyAll() 方法,是在 JVM 实现中调用,所以这里看不出来。 volatile 共享内存 因为 Java 是采用共享内存的方式进行线程通信的,所以可以采用以下方式用主线程关闭 A 线程: publicclassVolatileimplementsRunnable{ privatestaticvolatilebooleanflag=true; @Override publicvoidrun(){ while(flag){ System.out.println(Thread.currentThread().getName()+"正在运行。。。"); } System.out.println(Thread.currentThread().getName()+"执行完毕"); } publicstaticvoidmain(String[]args)throwsInterruptedException{ VolatileaVolatile=newVolatile(); newThread(aVolatile,"threadA").start(); System.out.println("main线程正在运行"); TimeUnit.MILLISECONDS.sleep(100); aVolatile.stopThread(); } privatevoidstopThread(){ flag=false; } } 输出结果: threadA正在运行。。。 threadA正在运行。。。 threadA正在运行。。。 threadA正在运行。。。 threadA执行完毕 这里的 flag 存放于主内存中,所以主线程和线程 A 都可以看到。 flag 采用 volatile 修饰主要是为了内存可见性,更多内容可以查看这里。 CountDownLatch 并发工具 CountDownLatch 可以实现 join 相同的功能,但是更加的灵活。 privatestaticvoidcountDownLatch()throwsException{ intthread=3; longstart=System.currentTimeMillis(); finalCountDownLatchcountDown=newCountDownLatch(thread); for(inti=0;i<thread;i++){ newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("threadrun"); try{ Thread.sleep(2000); countDown.countDown(); LOGGER.info("threadend"); }catch(InterruptedExceptione){ e.printStackTrace(); } } }).start(); } countDown.await(); longstop=System.currentTimeMillis(); LOGGER.info("mainovertotaltime={}",stop-start); } 输出结果: 2018-03-1620:19:44.126[Thread-0]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1620:19:44.126[Thread-2]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1620:19:44.126[Thread-1]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1620:19:46.136[Thread-2]INFOc.c.actual.ThreadCommunication-threadend 2018-03-1620:19:46.136[Thread-1]INFOc.c.actual.ThreadCommunication-threadend 2018-03-1620:19:46.136[Thread-0]INFOc.c.actual.ThreadCommunication-threadend 2018-03-1620:19:46.136[main]INFOc.c.actual.ThreadCommunication-mainovertotaltime=2012 CountDownLatch 也是基于 AQS(AbstractQueuedSynchronizer) 实现的,更多实现参考 ReentrantLock 实现原理 初始化一个 CountDownLatch 时告诉并发的线程,然后在每个线程处理完毕之后调用 countDown() 方法。 该方法会将 AQS 内置的一个 state 状态 -1 。 最终在主线程调用 await() 方法,它会阻塞直到 state == 0 的时候返回。 CyclicBarrier 并发工具 privatestaticvoidcyclicBarrier()throwsException{ CyclicBarriercyclicBarrier=newCyclicBarrier(3); newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("threadrun"); try{ cyclicBarrier.await(); }catch(Exceptione){ e.printStackTrace(); } LOGGER.info("threadenddosomething"); } }).start(); newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("threadrun"); try{ cyclicBarrier.await(); }catch(Exceptione){ e.printStackTrace(); } LOGGER.info("threadenddosomething"); } }).start(); newThread(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("threadrun"); try{ Thread.sleep(5000); cyclicBarrier.await(); }catch(Exceptione){ e.printStackTrace(); } LOGGER.info("threadenddosomething"); } }).start(); LOGGER.info("mainthread"); } CyclicBarrier 中文名叫做屏障或者是栅栏,也可以用于线程间通信。 它可以等待 N 个线程都达到某个状态后继续运行的效果。 首先初始化线程参与者。 调用 await() 将会在所有参与者线程都调用之前等待。 直到所有参与者都调用了 await() 后,所有线程从 await() 返回继续后续逻辑。 运行结果: 2018-03-1822:40:00.731[Thread-0]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1822:40:00.731[Thread-1]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1822:40:00.731[Thread-2]INFOc.c.actual.ThreadCommunication-threadrun 2018-03-1822:40:00.731[main]INFOc.c.actual.ThreadCommunication-mainthread 2018-03-1822:40:05.741[Thread-0]INFOc.c.actual.ThreadCommunication-threadenddosomething 2018-03-1822:40:05.741[Thread-1]INFOc.c.actual.ThreadCommunication-threadenddosomething 2018-03-1822:40:05.741[Thread-2]INFOc.c.actual.ThreadCommunication-threadenddosomething 可以看出由于其中一个线程休眠了五秒,所有其余所有的线程都得等待这个线程调用 await() 。 该工具可以实现 CountDownLatch 同样的功能,但是要更加灵活。甚至可以调用 reset() 方法重置 CyclicBarrier (需要自行捕获 BrokenBarrierException 处理) 然后重新执行。 线程响应中断 publicclassStopThreadimplementsRunnable{ @Override publicvoidrun(){ while(!Thread.currentThread().isInterrupted()){ //线程执行具体逻辑 System.out.println(Thread.currentThread().getName()+"运行中。。"); } System.out.println(Thread.currentThread().getName()+"退出。。"); } publicstaticvoidmain(String[]args)throwsInterruptedException{ Threadthread=newThread(newStopThread(),"threadA"); thread.start(); System.out.println("main线程正在运行"); TimeUnit.MILLISECONDS.sleep(10); thread.interrupt(); } } 输出结果: threadA运行中。。 threadA运行中。。 threadA退出。。 可以采用中断线程的方式来通信,调用了 thread.interrupt() 方法其实就是将 thread 中的一个标志属性置为了 true。 并不是说调用了该方法就可以中断线程,如果不对这个标志进行响应其实是没有什么作用(这里对这个标志进行了判断)。 但是如果抛出了 InterruptedException 异常,该标志就会被 JVM 重置为 false。 线程池 awaitTermination() 方法 如果是用线程池来管理线程,可以使用以下方式来让主线程等待线程池中所有任务执行完毕: privatestaticvoidexecutorService()throwsException{ BlockingQueue<Runnable>queue=newLinkedBlockingQueue<>(10); ThreadPoolExecutorpoolExecutor=newThreadPoolExecutor(5,5,1,TimeUnit.MILLISECONDS,queue); poolExecutor.execute(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("running"); try{ Thread.sleep(3000); }catch(InterruptedExceptione){ e.printStackTrace(); } } }); poolExecutor.execute(newRunnable(){ @Override publicvoidrun(){ LOGGER.info("running2"); try{ Thread.sleep(2000); }catch(InterruptedExceptione){ e.printStackTrace(); } } }); poolExecutor.shutdown(); while(!poolExecutor.awaitTermination(1,TimeUnit.SECONDS)){ LOGGER.info("线程还在执行。。。"); } LOGGER.info("mainover"); } 输出结果: 2018-03-1620:18:01.273[pool-1-thread-2]INFOc.c.actual.ThreadCommunication-running2 2018-03-1620:18:01.273[pool-1-thread-1]INFOc.c.actual.ThreadCommunication-running 2018-03-1620:18:02.273[main]INFOc.c.actual.ThreadCommunication-线程还在执行。。。 2018-03-1620:18:03.278[main]INFOc.c.actual.ThreadCommunication-线程还在执行。。。 2018-03-1620:18:04.278[main]INFOc.c.actual.ThreadCommunication-mainover 使用这个 awaitTermination() 方法的前提需要关闭线程池,如调用了 shutdown() 方法。 调用了 shutdown() 之后线程池会停止接受新任务,并且会平滑的关闭线程池中现有的任务。 管道通信 publicstaticvoidpiped()throwsIOException{//面向于字符PipedInputStream面向于字节 PipedWriterwriter=newPipedWriter(); PipedReaderreader=newPipedReader();//输入输出流建立连接 writer.connect(reader); Threadt1=newThread(newRunnable(){@Override publicvoidrun(){ LOGGER.info("running");try{for(inti=0;i<10;i++){ writer.write(i+""); Thread.sleep(10); } }catch(Exceptione){ }finally{try{ writer.close(); }catch(IOExceptione){ e.printStackTrace(); } } } }); Threadt2=newThread(newRunnable(){@Override publicvoidrun(){ LOGGER.info("running2");intmsg=0;try{while((msg=reader.read())!=-1){ LOGGER.info("msg={}",(char)msg); } }catch(Exceptione){ } } }); t1.start(); t2.start(); } 输出结果: 2018-03-1619:56:43.014[Thread-0]INFOc.c.actual.ThreadCommunication-running 2018-03-1619:56:43.014[Thread-1]INFOc.c.actual.ThreadCommunication-running2 2018-03-1619:56:43.130[Thread-1]INFOc.c.actual.ThreadCommunication-msg=0 2018-03-1619:56:43.132[Thread-1]INFOc.c.actual.ThreadCommunication-msg=1 2018-03-1619:56:43.132[Thread-1]INFOc.c.actual.ThreadCommunication-msg=2 2018-03-1619:56:43.133[Thread-1]INFOc.c.actual.ThreadCommunication-msg=3 2018-03-1619:56:43.133[Thread-1]INFOc.c.actual.ThreadCommunication-msg=4 2018-03-1619:56:43.133[Thread-1]INFOc.c.actual.ThreadCommunication-msg=5 2018-03-1619:56:43.133[Thread-1]INFOc.c.actual.ThreadCommunication-msg=6 2018-03-1619:56:43.134[Thread-1]INFOc.c.actual.ThreadCommunication-msg=7 2018-03-1619:56:43.134[Thread-1]INFOc.c.actual.ThreadCommunication-msg=8 2018-03-1619:56:43.134[Thread-1]INFOc.c.actual.ThreadCommunication-msg=9 Java 虽说是基于内存通信的,但也可以使用管道通信。 需要注意的是,输入流和输出流需要首先建立连接。这样线程 B 就可以收到线程 A 发出的消息了。 实际开发中可以灵活根据需求选择最适合的线程通信方式。 号外 最近在总结一些 Java 相关的知识点,感兴趣的朋友可以一起维护。 地址: https://github.com/crossoverJie/Java-Interview java线程与并发相关内容推荐阅读:http://www.roncoo.com/course/list.html?courseName=java

优秀的个人博客,低调大师

8 张图理解 Java

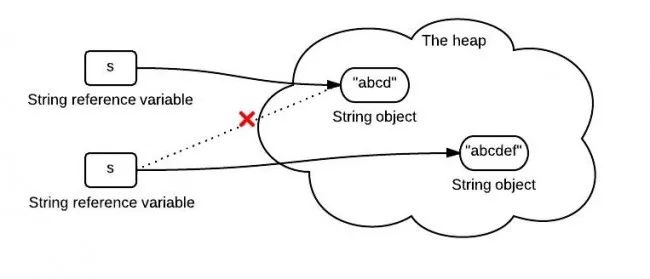
一图胜千言,如果图解没有阐明问题,那么你可以借助它的标题来一窥究竟。 1、字符串不变性 下面这张图展示了这段代码做了什么 String s = "abcd"; s = s.concat("ef"); 2、equals()方法、hashCode()方法的区别 HashCode被设计用来提高性能。equals()方法与hashCode()方法的区别在于: 如果两个对象相等(equal),那么他们一定有相同的哈希值。 如果两个对象的哈希值相同,但他们未必相等(equal)。 JAVA高级架构群:https://jq.qq.com/?_wv=1027&k=5gMDouY 3、Java异常类的层次结构 图中红色部分为受检查异常。它们必须被捕获,或者在函数中声明为抛出该异常。 4、集合类的层次结构 注意Collections和Collection的区别。(Collections包含有各种有关集合操作的静态多态方法) 5、Java同步 Java同步机制可通过类比建筑物来阐明。 6、别名 别名意味着有多个变量指向同一可被更新的内存块,这些别名分别是不同的对象类型。 7、堆和栈 图解表明了方法和对象在运行时内存中的位置。 8、Java虚拟机运行时数据区域 图解展示了整个虚拟机运行时数据区域的情况。

优秀的个人博客,低调大师

深入理解 java volatile

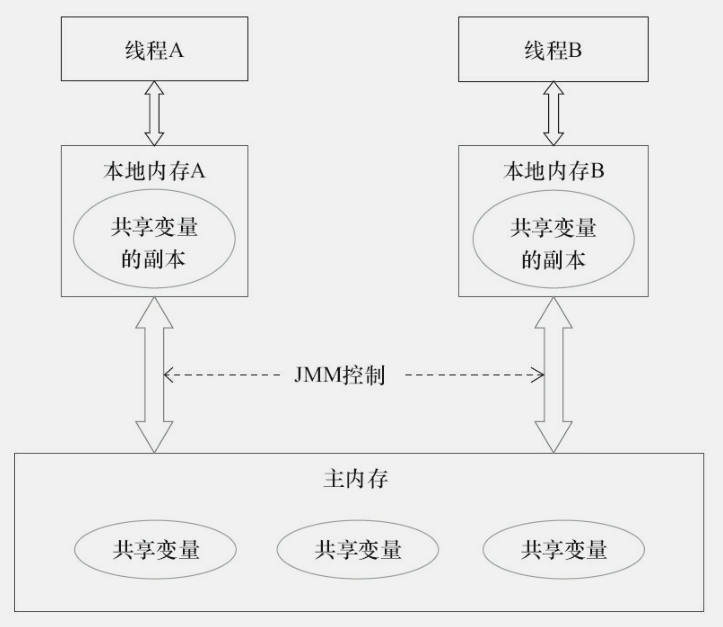
在开始讲volatile之前,我们需要对以下的内容有所了解. java 内存模型(JMM) 在java中,java堆内存是存在数据共享的,这些共享数据的通信就是通过java内存模型(JMM)来控制的. JMM决定一个线程对共享数据的写入何时对另一个线程可见. JMM是一个抽象的结构,它定义了线程和主内存的关系: 线程之间的共享变量存储在主内存(Main Memory)中 每一个线程都有一个私有的本地内存(Local Memory) 本地内存中储存了该线程可以读写变量的副本. JMM 只有存放在java堆和方法区中的数据,才会被线程共享,对于其他区是属于线程私有的数据,不受JMM的影响. 从JMM中可以看出,如果线程之间的数据,是不能直接进行数据传递的,一定要经过主内存进行传递. A线程更新数据 -> 刷新主内存数据 -> B线程读取主线程数据 为什么需要JMM? 为什么需要内存模型,直接读写内存不可以吗? 主要是因为下面两个原因. CPU缓存一致性 CPU与内存读写和运算速度不在一个量级,CPU效率会比内存高的多. 为了解决CPU和内存效率差异问题,引入了 高速缓存(Cache)和写缓冲区(Write Buffer)等,来作为cpu和内存的传输媒介,使用缓冲中读写可能造成数据不一致的问题. 处理器优化和指令重排 处理器优化:处理器为了优化 执行效率, 可能会将输入的代码进行乱序执行处理.指令重排:JIT编译过程也可能会对指令进行乱序处理 . 为了解决上次两个问题,需要引入JMM,而不是直接操作内存变量。 为了解决 <1>,引入主内存和线程的本地内存概念. 为了解决 <2>,通过 禁止处理器优化, 和 内存屏障来解决. 原子性,可见性,有序性 原子性 : 表示不可被中断的一个或一系列操作.一旦开始,就一直运行到结束,中间不会有任何线程切换(context switch)。 可见性 : 是指当多个线程访问同一个变量时,一个线程修改了这个变量的值,其他线程能够立即看得到修改的值. 有序性 : 由于指令的执行,会经过编译器和处理的重排序,有序性是指从指令上的执行结果上看,指令的执行顺序是有序的.根据as-if-serial语义,单线程中,程序的结果不能被改变.在多线程并发中, 提供 happens-before规则来支持有序性. volatile Java语言规范第三版中对volatile的定义如下: java编程语言允许线程访问共享变量,为了确保共享变量能被准确和一致的更新,线程应该确保通过排他锁单独获得这个变量。Java语言提供了volatile,在某些情况下比锁更加方便。如果一个字段被声明成volatile,java线程内存模型确保所有线程看到这个变量的值是一致的。 它被称为轻量级的 synchronized, 它比synchronized的使用和执行成本会更低,因为它不会引起线程上下文的切换和调度。 volatile的特性 可见性 : 对一个volatile的变量的读,总是能看到任意线程对这个变量最后的写入. 单个读或者写具有原子性 : 对于单个volatile变量的读或者写具有原子性,复合操作不具有.(如i++) 互斥性 : 同一时刻只允许一个线程对变量进行操作.(互斥锁的特点) volatile的内存语义 volatile的写和锁的释放具有相同的语义,当写一个volatile变量时,JMM会把该线程对应的本地内存中的共享变量值刷新到主内存. volatile的读和锁的获取有相同的语义,当读一个volatile变量时,JMM会把该线程对应的本地内存置为无效。线程接下来将从主内存中读取共享变量。 volatile内存语义的实现 为了实现volatile语义,JMM分为编译器重排序和处理器重排序进行了特殊的处理. 针对编译器重排序的处理,有如下规则 volatile重排序规则表 针对处理器的重排序,编译器在生成字节码时,会在指令序列中插入内存屏障来禁止特定类型的处理器重排序 在每个volatile写操作的前面插入一个StoreStore屏障 // 禁止上面的写重排序 在每个volatile写操作的后面插入一个StoreLoad屏障 // 禁止上面的写或下面的读/写重排序 在每个volatile读操作的后面插入一个LoadLoad屏障 // 禁止下面的读重排序 在每个volatile读操作的后面插入一个LoadStore屏障 // 禁止下面的下重排序 volatile的使用条件 对变量的写操作不依赖于当前值 或 能够确保只有单一线程能够修改变量的值 如 i++操作,变量的写操作依赖当前值,所以不能保证线程安全. 该变量没有包含在具有其他变量的不变式中 如 i<value,即使i变量声明为volatile,也不能保证线程安全,value可能在运行判断的时候发生变化. 正确使用volatile 下面提出几种使用 volatile的场景. 状态标志 作为一个布尔状态标志,用于指示发生了一个重要的一次性事件,例如完成初始化或任务结束. 状态标志并不依赖于程序内任何其他状态,且通常只有一种状态转换 volatile boolean shutdownRequested; ... public void shutdown() { shutdownRequested = true; } public void doWork() { while (!shutdownRequested) { // todo... } } 一次性安全发布(one-time safe publication) 在缺乏同步的情况下,可能会遇到某个对象引用的更新值(由另一个线程写入)和该对象状态的旧值同时存在。(这就是造成著名的双重检查锁定(double-checked-locking)问题的根源)。 //基于volatile的解决方案 public class SafeDoubleCheckSingleton { //通过volatile声明,实现线程安全的延迟初始化 private volatile static SafeDoubleCheckSingleton singleton; private SafeDoubleCheckSingleton(){ } public static SafeDoubleCheckSingleton getInstance(){ if (singleton == null){ synchronized (SafeDoubleCheckSingleton.class){ if (singleton == null){ //原理利用volatile在于 禁止 "初始化对象"(2) 和 "设置singleton指向内存空间"(3) 的重排序 singleton = new SafeDoubleCheckSingleton(); } } } return singleton; } } 由于对象的创建,可以拆分成以下指令: 对象创建顺序 在多线程环境中,如果没有对变量 声明为volatile,将可能出现以下情况,其他线程可能得到的是null而不是完成初始化的对象. 对象创建乱序 独立观察(independent observation) 将 volatile变量用于多个独立观察结果的发布,是"状态标志"的拓展,该值随时会发生变化,同时会被反复使用,前者一般就是用一次 ;只是简单的赋值操作,不会做复合操作. class CustomLinkedList{ public volatile Node lastNode; ..... public void add() { Node node = new Node(); ..... lastNode = node;//将新节点作为最后一个节点 } } 开销较低的读-写锁策略 当读远多于写,结合使用内部锁和 volatile 变量来减少同步的开销 利用volatile保证读取操作的可见性;利用synchronized保证复合操作的原子性 public class Counter { private volatile int value; //利用volatile保证读取操作的可见性, 读取时无需加锁 public int getValue() { return value; } // 使用 synchronized 加锁 public synchronized int increment() { return value++; } } 参考 memory barriers(内存屏障) 内存屏障的作用 : 阻止屏障两侧的指令重排序 强制刷新主内存数据,以及让缓存中相应的数据失效。 java的内存屏障有的四种,LoadLoad,StoreStore,LoadStore,StoreLoad 内存屏障类型表 as-if-serial as-if-serial的语义是, 不管怎么重排序,单线程中程序的执行结果不能被改变. 编译器,runtime,处理器都需要遵守该语义. happens-before 程序顺序原则:一个线程内保证语义的串行性.对于单线程来讲,必须保证重排后的结果与重排前一致。 volatile规则:volatile变量的写,先发生于后续对这个变量的读.这保证了volatile变量的可见性. 监视锁规则:对于一个锁的解锁,先发生于随后对这个锁的加锁. 否则随后的加锁将会失败. 传递性:A先于B,B等于C,那么A必然先于C. 线程启动规则:Thread对象的start()方法先发生于此线程的其他任意动作。 线程终止规则:线程的所有操作都先发生于对此线程的终止检测,可以通过Thread.join()方法结束、Thread.isAlive()的返回值等手段检测到线程已经终止执行。 线程中断规则:对线程interrupt()方法的调用先发生于被中断线程的代码检测到中断时事件的操作。 对象终结规则:一个对象的初始化完成(构造函数执行结束)先发生于它的finalize()方法的开始 引用 java并发编程的艺术 并发番@Java内存模型&Volatile一文通(1.7版) 正确使用 Volatile 变量

优秀的个人博客,低调大师

理解Activity的启动模式

Activity的启动模式有哪几种,分别用于什么场景? standard:标准模式 系统的默认模式。一种典型的多实例实现。每次启动一个Activity都会重新创建一个新的实例。被启动的Activity会被放入启动者的栈中,如果启动者是非Activity类型的Context(如ApplicationContext),并没有所谓的任务栈,就会报错,此时需为待启动的Activity指定FLAG_ACTIVITY_NEW_TASK标记位,创建一个新栈。没有特殊需求默认是这种模式。 singleTop:栈顶复用模式 如果一个Activity的实例已经在栈顶存在,启动这个Activity时,不会创建新的Activity,而会回调onNewIntent(),如果不是在栈顶存在,则会新建一个实例。 适合接收通知启动的内容显示页面。当收到多条新闻推送时,用于展示新闻的Activity设置成此模式,根据传来的intent数据显示不同的新闻信息,不会启动多个Activity。 singleTask:栈内复用模式 一个单实例模式。只要Activity的实例在一个栈中存在,再次启动Activity都不会重新创建实例只会回调onNewIntent(),并从栈中弹出实例上面所有的实例。 适合作为程序入口点,例如浏览器的主界面。不管从多少个不同应用启动浏览器,只会启动主界面一次,其余情况都会走onNewIntent,并且会清空主界面上面的其他页面。 singleInstance:单实例模式 具有singleTask的所有特性,设置此模式的Activity只能单独存在一个任务栈中。 清晰地描述下onNewIntent和onConfigurationChanged这两个生命周期方法的场景? onNewIntent 在singleTop、singleTask、singleInstance模式下,启动相同的Activity,期望只有一个实例存在,再次启动就会调用onNewIntent()。在onNewIntent中可以setIntent(intent)刷新intent数据。 onConfigurationChanged 当Android设备正在运行App时,如果设备的语言、屏幕方向、键盘的参数改变了,默认会销毁当前Activity并重新创建一次来加载新的配置信息。为了防止Actitvity被系统销毁,可以在AndroidManifest.xml文件中给<Activity>标签设置android:configChanges,可选值如下: 属性值 含义 mcc SIM卡唯一标识IMSI(国际移动用户标识码)中的国家代码,由三位数字组成(中国为460)。 这里表示mcc发生了改变 mnc SIM卡唯一标识IMSI(国际移动用户标识码)中的运营商代码,由两位数字组成,中国移动TD系统为00,中国联通为01,电信为03。这里表示mnc发生了改变 locale 设备的本地位置发生了改变,一般指的是切换了系统语言 touchscreen 触摸屏发生了改变 keyboard 键盘类型发生了改变,比如用户使用了外接键盘 keyboardHidden 键盘的可访问性发生了改变,比如用户调出了键盘 navigation 系统导航方式发生了改变 screenLayout 屏幕布局发生了改变,很可能是用户激活了另外一个显示设备 fontScale 系统字体缩放比例发生了改变,比如用户选择了个新的字号 uiMode 用户界面模式发生了改变,比如开启夜间模式-API8新添加 orientation 屏幕方向发生改变,比如旋转了手机屏幕 screenSize 当屏幕尺寸信息发生改变(当编译选项中的minSdkVersion和targeSdkVersion均低于13时不会导致Activity重启)—API13新添加 smallestScreenSize 设备的物理屏幕尺寸发生改变,这个和屏幕方向没关系,比如切换到外部显示设备—API13新添加 layoutDirection 当布局方向发生改变的时候,正常情况下无法修改布局的layoutDirection的属性—API17新添加 申明的配置发生改变时,将不会重启Activity,而是回调onConfigurationChanged。如果设置orientation,当屏幕方向发生旋转时,会阻止系统销毁Activity重建,而是保持运行,回调Activity的onConfigurationChanged(),我们需要在这个方法中自己处理旋转后的操作。onConfigurationChanged中会传入一个Configuration对象,通过读取对象中最新的配置信息,来自行适配新的UI界面。 从Android 3.2 (API13) 开始,当设备旋转时,screenSize也会改变,因此需要设置android:configChange="orientation|screenSize"。

优秀的个人博客,低调大师

理解synchronized关键字

Java多线程中的同步机制会对资源进行加锁,保证在同一时间只有一个线程可以操作对应资源,避免多程同时访问相同资源发生冲突。synchronized是Java中的关键字,它是一种同步锁,可以实现同步机制。 synchronized主要修饰的对象有以下三种: 修饰普通方法 一个对象中的加锁方法只允许一个线程访问。但要注意这种情况下锁的是访问该方法的实例对象, 如果多个线程不同对象访问该方法,则无法保证同步。 修饰静态方法 由于静态方法是类方法,所以这种情况下锁的是包含这个方法的类,也就是类对象;这样如果多个线程不同对象访问该静态方法,也是可以保证同步的。 修饰代码块 其中普通代码块如synchronized(obj),这里的obj可以为类中的一个属性,也可以是当前的对象,它的同步效果和修饰普通方法一样;synchronized(obj.class)静态代码块,它的同步效果和修饰静态方法类似。 synchronized方法控制范围较大,它会同步对象中所有synchronized方法的代码。 synchronized代码块控制范围较小,它只会同步代码块中的代码,而位于代码块之外的代码是可以被多个线程访问的。 简单来说,就是synchronized代码块更加灵活精确。 问题 有如下一个类 A class A { public synchronized void a() { } public synchronized void b() { } } 然后创建两个对象 A a1 = new A(); A a2 = new A(); 然后在两个线程中并发访问如下代码: Thread1Thread2 a1.a();a2.a(); 请问二者能否构成线程同步? 如果A的定义是下面这种呢? class A { public static synchronized void a() { } public static synchronized void b() { } } 答案 问题1 :不能同步 问题2:能同步

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册