首页 文章 精选 留言 我的

精选列表

搜索[TencentOS Server],共10000篇文章
优秀的个人博客,低调大师

SQL Server-聚焦UNIOL ALL/UNION查询

初探UNION和UNION ALL 首先我们过一遍二者的基本概念和使用方法,UNION和UNION ALL是将两个表或者多个表进行JOIN,当然表的数据类型必须相同,对于UNION而言它会去除重复值,而UNION ALL则会返回所有数据,这就是二者的区别和使用方法。下面我们来看一个简单的例子。 USETSQL2012 GO--USEUNIONALL SELECT1 UNIONALL SELECT2 UNIONALL SELECT2 UNIONALL SELECT3--USEUNION SELECT1 UNION SELECT2 UNION SELECT2 UNION SELECT3 上述我们稍微讲解了下二者的基本使用,接下来我们来看看二者的性能比较。 进一步探讨UNION 和 UNION ALL性能问题 我们首先创建两个测试表Table1和Table2 USETSQL2012 GO CREATETABLETable1 ( colVARCHAR(10) ) CREATETABLETable2 ( colVARCHAR(10) ) 在表Table1中插入如下测试数据 USETSQL2012 GO INSERTINTOTable1 SELECT'First'UNIONALL SELECT'Second'UNIONALL SELECT'Third'UNIONALL SELECT'Fourth'UNIONALL SELECT'Fifth' 在表Table2中插入如下测试数据 USETSQL2012 GO INSERTINTOTable2 SELECT'First'UNIONALL SELECT'Third'UNIONALL SELECT'Fifth' 我们查询下两个表插入的测试数据 USETSQL2012 GO SELECT*FROMTable1 SELECT*FROMTable2 接着分别利用UNION和UNION ALL来查询数据比较二者性能开销 USETSQL2012 GO--UNIONALL SELECT*FROMTable1 UNIONALL SELECT*FROMTable2--UNION SELECT*FROMTable1 UNION SELECT*FROMTable2 此时我们能够很明显的看到因为UNION要去除重复所以会进行DISTINCT Sort操作使得其性能要低于UNION ALL。到这里我们可以下个基本结论。 UNION VS UNION ALL性能分析结论:当使用UNION查询语句时类似会进行SELECT DISTINCT操作,除非我们非常明确要返回唯一不重复的值那就用UNION,否则使用UNION ALL会带来更好的性能,返回结果集更快。 是不是到此就完了呢,使用UNION和UNION ALL就这么简单么,那你就太天真了,我们继续往下看。 深入探讨UNION 和 UNION ALL(一) 我们声明一个表变量插入数据并利用UNION ALL来进行查询 USETSQL2012 GO DECLARE@tempTableTABLE(colTEXT) INSERTINTO@tempTable(col) SELECT'JeffckyWang'SELECTcolFROM@tempTableUNIONALLSELECT'TestUNIONALL' 此时对应返回合并结果集,恩,没毛病,我们接下来看看UNION USETSQL2012 GO DECLARE@tempTableTABLE(colTEXT) INSERTINTO@tempTable(col) SELECT'JeffckyWang'SELECTcolFROM@tempTableUNIONSELECT'TestUNIONALL' 此时毛病就出来了,说什么数据类型text不可比,不能将其用作UNIN、INTERSERCT或EXCEPT等运算符的操作数,这是什么意思,不太懂。在我们讲解UNION和UNION ALL的性能问题时,我们已经标出UNION的查询计划,UNION会进行DISTINCT Sort操作,这说明什么呢?实际上它内部会进行自动排序同时移除重复的数据,此时数据类型为TEXT所以无法对TEXT类型进行排序,换句话说UNION不支持TEXT类型。所以到这里我们可以给出一个结论。 当利用UNION进行查询时,如果查询列中有TEXT数据类型时,此时会发生错误,因为UNION内部会自动对数据进行排序,而TEXT是无法进行排序的,所以UNION不支持TEXT数据类型。 好了到了这里,我们才算是给出第一个需要注意的地方,下面我们再来看一个。 深入探讨UNION和UNION ALL(二) 当我们对两个表进行UNION ALL时,此时我们如果有这样一个需求,需要使用UNION ALL前后的表是进行排序的,那么此时我们应该如何做呢?下面我们创建测试表看看。 USETSQL2012 GO CREATETABLETable1(IDINT,Col1VARCHAR(100)); CREATETABLETable2(IDINT,Col1VARCHAR(100)); GO INSERTINTOTable1(ID,Col1) SELECT1,'Col1-t1'UNIONALL SELECT2,'Col2-t1'UNIONALL SELECT3,'Col3-t1'; INSERTINTOTable2(ID,Col1) SELECT3,'Col1-t2'UNIONALL SELECT2,'Col2-t2'UNIONALL SELECT1,'Col3-t2'; GO 此时我们查询上述Table1和Table2数据如下: 我们的需求是利用UNION ALL将Table1和Table2合并时,其顺序分别是1,2,3和1,2,3。对于UNION查询我们就不用讨论,内部会自行排序,如下则是利用UNION对数据进行排序的结果: 当我们进行UNION ALL时呢 USETSQL2012 GO SELECTID,Col1 FROMdbo.Table1 UNIONALL SELECTID,Col1 FROMdbo.Table2 GO 显然满足不了我们的需求,在Table2表中的数据我们需要的是1,2,3。那么我们对Table2中的ID进行ORDER BY结果会如何呢? USETSQL2012 GO SELECTID,Col1 FROMdbo.Table1 UNIONALL SELECTID,Col1 FROMdbo.Table2 ORDERBYID GO 使用UNION ALL通过对Table2表上的ID进行ORDER BY此时得到的结果和上述UNION查询的结果很类似,但是还是没有得到我们的结果。上述对于两个结果集进行合并后的排序也可以进行如下查询: USETSQL2012 GO SELECT*FROM (SELECTID,Col1FROMdbo.Table1 UNIONALL SELECTID,Col1FROMdbo.Table2)ast ORDERBYID 对于查询我们能够自定义常量列,我们接下来添加一个额外的常量列,先对其常量列进行排序,然后对ID进行ORDER BY呢,结果又会是怎样的呢? USETSQL2012 GO SELECTID,Col1,'addtionalcol1'ASaddtionalColFROMdbo.Table1 UNIONALL SELECTID,Col1,'addtionalCol2'ASaddtionalColFROMdbo.Table2 ORDERBYaddtionalCol,ID GO 到这里算是基本完成我们的需求,貌似需要额外添加一个列,虽然效果不是太好。 本文转自 sshpp 51CTO博客,原文链接:http://blog.51cto.com/12902932/1926499,如需转载请自行联系原作者

优秀的个人博客,低调大师

第 21 章 radiusd - Authentication, Authorization and Accounting server

目录 21.1. 安装 radiusd 21.2. 802.1 http://freeradius.org/ 21.1.安装 radiusd 过程21.1.安装步骤 yum 安装 yum install -y freeradius 设置启动文件 chkconfig radiusd on service radiusd start 配置 radiusd cp /etc/raddb/clients.conf{,.original} cp /etc/raddb/users{,.original} cp /etc/raddb/sites-enabled/default{,.original} cat >> /etc/raddb/clients.conf <<EOF client 192.168.0.0/16 { secret = testing123 shortname = freeradius.example.com } EOF /etc/raddb/users guest Cleartext-Password := "test" /etc/raddb/sites-enabled/default 测试 radiusd $ radtest guest test 192.168.2.1 1812 testing123 Sending Access-Request of id 223 to 192.168.2.1 port 1812 User-Name = "guest" User-Password = "test" NAS-IP-Address = 127.0.1.1 NAS-Port = 1812 Message-Authenticator = 0x00000000000000000000000000000000 rad_recv: Access-Accept packet from host 192.168.2.1 port 1812, id=223, length=20 Please enable JavaScript to view the &lt;a href="http://disqus.com/?ref_noscript"&gt;comments powered by Disqus.&lt;/a&gt;comments powered by Disqus 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

优秀的个人博客,低调大师

Windows server 2003 DNS 全攻略(一)

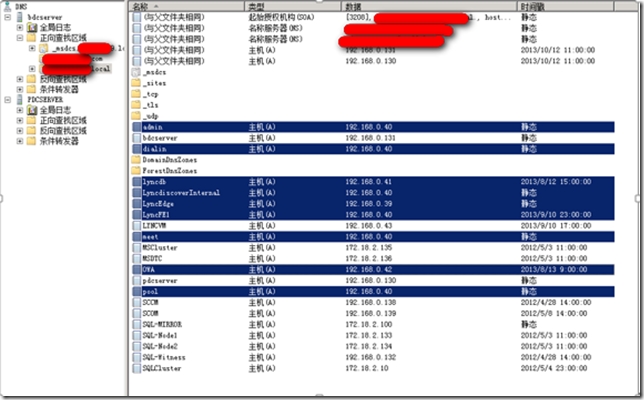
在目前应用中主要使用两种名称体系:DNS名称体系和NetBIOS名称体系。但DNS成为INTERNET上通用的命名规范。 1.NetBIOS名称体系 它是使用长度不超过16个字符的名称来惟一标识每个网络资源。名称中的前进15个字符可以由用户指定,每16个字符是一个00到FF的十六进制数,用于标识资源或服务类型。在实际应用中,通过WINDOWS操作系统中的“网络邻居”看到的计算机名、工作组名或域名就是NetBIOS名称。 2.DNS名称体系 DNS名称通常采用FQDN(Fully Qualified Domain Name,完全限定域名)的形式来表示由主机名和域名两部分组成。比如:[url]www.landon.com[/url]就是一个典型的FQDN,其中,www是主机名,表示域名限制范围中的一台主机;landon.com是域名,表示一个区域或一个范围。 DNS名称空间 DNS名称体系是有层次的,域是其层次结构的基本单位,任何一个域最多属于一个上级域,但可以有多个或没有下级域。在同一个域中不能有相同的下级域或主机名,但在不同的域中则可以有相同的下级域名或主机名。 1.根域:(Root Domain)根域只有一个,根域是默认的,一般不需要表示出来。DNS命名空间都是由位于美国的INTERNIC负责管理域进行授权管理的。在根域服务器中并没有保存全世界的所有的DNS名称,其中只保存着顶级域的DNS服务器名称与IP地址的对应关系。每一层的DNS服务器只负责管理其下一层域的DNS服务器名称与IP地址的对应关系。 2.顶级域(Top-Level Domain,TLD) 在根域之下的第一级域便是顶级域。顶级域位于最右边。顶级域有两种类型的划分方法:机构域和地理域。比如:.com是机构域 .cn是地理域。 3.各级子域(Subdomain) 除了根域和顶级域之外,其它域均称为子域。一个域可以有多个子域。 4.主机名(Host Name) 位于最左边的便是域主机名。 5.反向域(in-addr.arpa) 反向域使用一个IP地址的一个字节值来代表一个子域,这样反向域in-addr.arpa就被划分为256个子域,每个子域代表该字节的一个可能值0-255。。根据同样的方法,又可以将每一个子域进一步划分为256个子域。这样,可以对每个子域继续划分,直到将全部的地址空间都在反向域中表示出来。 DNS名称的解析方法 主要有两种:一是通过HOSTS文件解析,二是通过DNS服务器解析。 1.HOSTS文件 这是最初的一种查询方式,它是由人工进行输入、删除、修改所有DNS名称与IP地址对应数据。显然网络较大时是不适用的。在WIN2003中,HOSTS文件位于%SYSTEMROOT%\System32\Drivers\Etc目录中。是一个纯文本文件 2.DNS服务器:目前最常用的。 DNS服务器的类型 主要有四种类型:主DNS服务器,辅助DNS服务器、转发DNS服务器和惟缓存DNS服务器。 1、主DNS服务器 它是特定DNS域所有信息的权威性信息源,从域管理员构造本地数据库文件中加载域信息,主DNS服务器保存着自主生成的区域文件夹,该文件是可读可写的,当DNS域中的信息发生变化时,这些京华都会保存到主DNS服务器的区域文件中。 2、辅助DNS服务器 它可以从主DNS服务器中复制一整套域信息。区域文件是从主DNS服务器中复制生成的,并作为本地文件存储在辅助DNS服务器中。这种复制称为区域传输。这个副本是只读的。无法对其进行更改。要更改就是必须在主DNS服务器上进行。在实际应用中辅助DNS主要是为了均衡负载和容错。当主DNS出现故障,辅助的DNS可以转换为主DNS服务器。 3、转发DNS服务器 转发DNS服务器可以将其它DNS转发解析请求,当DNS服务器收到客户端的解析请求后。它首先会尝试从其本地数据库中查找,若没有找到,则需要向其它指定的DNS服务器转发解析请求;其它DNS服务器完成解析后会返回解析结果,转发DNS服务器将解析结果缓存在自己的DNS缓存中,并向客户端返回解析结果。在缓存期内,如果客户端请求解析相同的名称,则转发DNS服务器会立即回应客户端;否则将会再次发生转发解析的过程。目前网络中所有的DNS服务器均被配置为转发DNS服务器,向指定的其它DNS服务器或根域服务器转发自己无法解析的请求。 4、惟缓存DNS服务器 可以提供名称解析,但其没有任何本地数据库文件,惟缓存DNS服务器必须同时是转发DNS服务器,它将客户端的解析请示转发给指定的远程DNS服务器,并从远程DNS服务器取得每次解析的结果,并将该结果存储在DNS缓存中,以后收到相同的解析请求时就用DNS缓存中的结果。DNS服务器都按这种方式使用缓存中的信息,但惟缓存服务器则依赖于这一技术实现所有的名称解析,惟缓存服务器并不是权威性的服务器,因为它提供的所有信息都是间接信息。 提示:(1)所有的DNS服务器都可以使用DNS缓存机制响应解析请求,以提供解析效率。(2)一些域的主DNS服务器可以是另一些域的辅助DNS服务器。(3)一个域只能部署一个主DNS服务器,它是该域的权威性信息源,另处至少应部署一个辅助DNS服务器,将作为主服务器的备份。(4)配置缓存DNS服务器可以减轻主DNS服务器和辅助DNS服务器的负载,从而减少网络传输。 DNS名称解析的查询模式 1、递归查询:当收到客户端的递归查询请求后,当前DNS服务器只会向DNS客户端返回两种信息:要么是在该DNS服务器上查询到的结果,要么是查询失败,如果当前DNS服务器中无法解析名称,它并不会主动告知DNS客户端其它可能的DNS服务器,而是自行向其它DNS服务器查询并完成解析。如果其它DNS服务器解析失败,则DNS服务器将向DNS客户端返回查询失败的消息。递归即是有来有往。 2、迭代查询:迭代查询通常在一台DNS服务器向另一台DNS服务器发出解析请求时使用。如果当前DNS收到其它DNS服务器发来的迭代查询请求并且未能在本地查询到所需要的数据,则当前DNS服务器将告诉发起查询的DNS服务器另一台DNS服务器的IP地址。然后,再由发起查询的DNS服务器自行向另一台DNS服务器发起查询;依次类推,直到查询到所需数据为止。如果到最后一台DNS服务器仍没有查到所需数据,则通知最初发起查询的DNS服务器解析失败。迭代的意思就是若在某地查不到,该地就会告知查询者其它地方的地址。让查询转到其它地方去查。 DNS解析过程 1、DNS区域:DNS服务器是通过区域来管理,并不是通过域为单位管理的。一台DNS服务器可以管理一个或多个区域。而一个区域也可以由多台DNS服务器来管理。 2、主要区域、辅助区域和存根区域 (1)主要区域:一个区域的主要区域是建立在该区域的主DNS服务器上,主要区域的数据库文件是可读可写的,所有针对该区域的添加、修改和删除等写入操作都必须在主要区域中进行 (2)辅助区域:一个区域的辅助区域建立在该区域的辅助DNS服务器上。辅助区域数据库文件是主要区域数据库文件的副本,需要定期地通过区域传输从主要区域中复制以获得更新。辅助区域的主要作用是均衡DNS解析的负载以提高解析效率,同时提供容错能力。必要时可将辅助区域转换为主要区域。 (3)存根区域:将在后面介绍。。。 资源记录 每个区域数据库文件都是由资源记录构成的。主要有:SOA记录、NS记录、A记录、CNAME记录、MX记录和PTR记录。 标准的资源记录具有其基本格式: [name] [ttl] IN type rdata name:名称字段,此字段是资源记录引用的域对象名,可以是一台单独的主机也可以是整个域。字段值:"."是根域,@是默认域,即当前域, ttl:生存时间字段,它以秒为单位定义该资源记录中的信息存放在DNS缓存中的时间长度。通常此字段值为空,表示采用SOA记录中的最小TTL值。 IN:此字段用于将当前湖泊记录标识为一个INTERNET的DNS资源记录。 TYPE:类型字段,用于标识当前资源记录的类型。资源记录类型:A,即是A记录,也称为主机记录,是DNS名称到IP地址的映射,用于正向解析。CNAME:CNAME记录,也是别名记录,用于定义A记录的别名。MX:邮件交换器记录,用于告知邮件服务器进程将邮件发送到指定的另一台邮件服务器。(该服务器知道如何将邮件传送到最终目的地)。NS:NS记录,用于标识区域的DNS服务器,即是说负责此DNS区域的权威名称服务器,用哪一台DNS服务器来解析该区域。一个区域有可能有多条ns记录,例如zz.com有可能有一个主服务器和多个辅助服务器。PTR:是IP地址到DNS名称的映射,用于反向解析。SOA:用于一个区域的开始,SOA记录后的所有信息均是用于控制这个区域的,每个区域数据库文件都必须包谷一个SOA记录,并且必须是其中的第一个资源记录,用以标识DNS服务器管理的起始位置,SOA说明能解析这个区域的dns服务器中哪个是主服务器。 radata:数据字段用于指定与当前资源记录有关的数据,数据字段的内容取决于类型字段。 部署主DNS服务器 安装DNS服务 打开配置您的服务器向导 下一步 下一步 下一步 下一步,便开始安装。 创建正向主要区域 点新建区域 下一步 这里选主要区域 填写区域名称 这里有两个选择,在这里做创建新文件。 由于这里不是AD所以第一项不能选。选不允许动态更新。 点完成 建立好后,可看见已建立好两个记录:SOA记录和NS记录 这里点更改 可以更改区域类型,通常在某DNS区域的主DNS服务器出现故障且短时间内无法修复,就需要在辅助DNS服务器将辅助区域改为主要区域,使其成为主DNS服务器。此外,需要将存储于文本数据库文件夹的DNS区域存储到活动目录,也需要更改。 点老化便出现上框。 这个是SOA记录,可看到主服务器,即是本台服务器名。如果点浏览便出现下面。这里的序列号:是该区域文件的修订版本号,每次区域中的资源记录发生改变时,这个数字就会增加。每次区域改变时增加这个值非常重要,它使部分区域改动或完全修改的区域都可以在后续传送中复制到其它辅助DNS服务器上。负责人:管理区域负责人的电子邮件地址,在该电子邮件名称中使用英文钟点(.)代替@. 刷新间隔:是在查询区域的来源进行区域更新之前,辅助DNS服务器等待的时间,当刷新间隔到期时,辅助DNS服务器请求主DNS服务器的区域的当前SOA记录副本。然后,辅助DNS服务器将主DNS服务器的当前SOA记录的序列号与其本地SOA记录的序列号相比较,如果二者不同,则辅助DNS服务器从主DNS服务器请求区域传输,默认为900S。 TLL:这里是用于指定SOA资源记录的TTL。 这台服务器名为MING,记录类型可以选择。 如点负责人旁边的浏览,便出现上框。 点名称服务器,在这里只有一台服务器为其解析。 点添加,可以添加多个名称服务器 这里可以使用WINS帮助解析。 配置区域传输 点通知。 下面来 创建反向区域 点新建区域 出现向导 选主要区域 输入IP。 创建新文件 不允许动态更新 点完成 同样可看到创建好两个记录 同样可以更改类型 主服务器也是本台服务器 可以添加名称服务器 这里是反向查找 可允许区域复制。 本文转自yangming1052 51CTO博客,原文链接:http://blog.51cto.com/ming228/99365,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册