首页 文章 精选 留言 我的

精选列表

搜索[Q4_K_XL量化],共10000篇文章
优秀的个人博客,低调大师

【最佳实践】Filebeat实现MySQL日志轻量化发送至Elasticsearch

在今天的文章中,我们来详细地描述如果使用Filebeat把MySQL的日志信息传输到Elasticsearch中。 环境准备 1、准备centos7.4版本 ECS 环境,关闭 selinux、firewall。2、准备阿里云elasticsearch 6.7 版本环境,并使用创建的账号密码登录Kibana3、安装 Filebeat 版本为 6.7.04、安装 MySQL 版本为 5.6.48 安装 MySQL 我们需要通过以下命令,来对 MySQL 进行安装。 # yum install mysql-server # systemctl start mysqld # systemctl status mysqld ####通过mysqladmin设置root密码##### # mysqladmin -u root password "12
优秀的个人博客,低调大师

【Python金融量化】VaR系列(一):HS,WHS,RM方法估计VaR

最近参加了一个线上学习计划,一群人一起学《Elements of Financial Risk Management》这本书,主要偏向于金融时间序列和多因子模型的知识,结合python编程。现在已经看了三分之一左右,感觉写的还不错,有些收获,意外惊喜是教材的答案全是用excel公式做的,头一次发现excel还可以做极大似然估计这种东西,很神奇。 VaR的估计是书中一个重要部分,从最浅显的HS模型开始不断深入到蒙特卡洛,讨论了若干估计方法,边学习边总结吧。这次主要总结三种不需要考虑分布的方法,并分析每种方法的特点。 VaR定义 这里所说的VaR并非时间序列中的向量自回归模型(vector autoregression),而是在险价值(Value at Risk)。指的是一定概率下,一个金融资产在未来一段时间内的最大可能损失,是对金融资产风

优秀的个人博客,低调大师

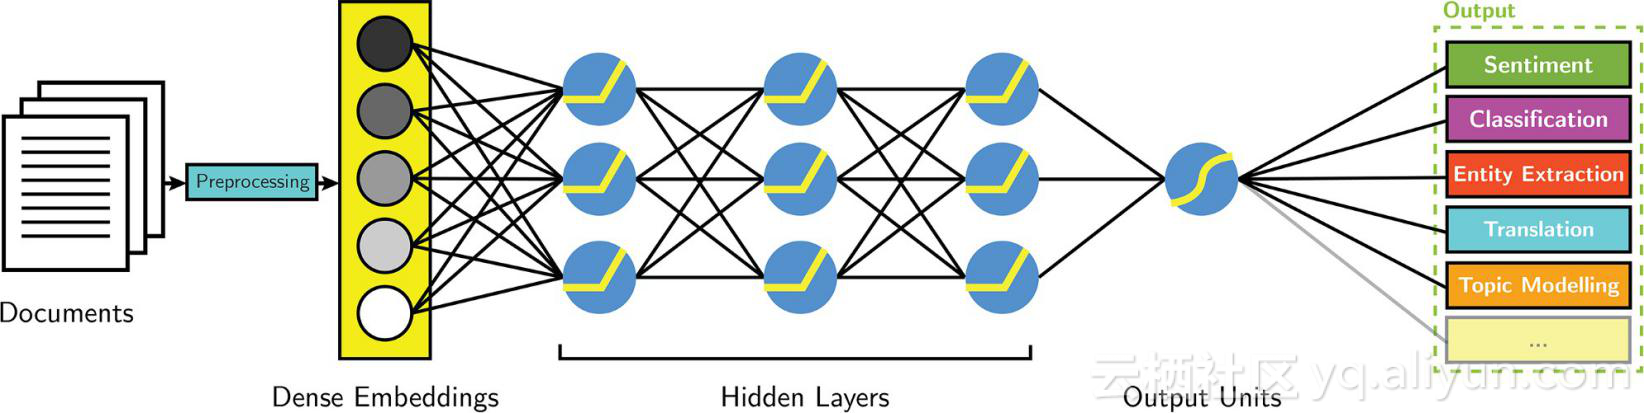
实体嵌入(向量化):用深度学习处理结构化数据

嵌入源自于 NLP ( word2vec )中的单词学习,上图来自 Aylien 本博文将涉及机器学习中两个重复出现的问题:第一个问题是深度学习在图像和文本中都有较好的表现,我们又如何将其用于表格数据?其次,在构建机器学习模型时,你必须始终问自己一个问题:将如何处理数据集中的分类变量?令人惊讶的是,我们可以用相同的答案回答这两个问题:实体嵌入。 现在,深度学习在许多方面都优于其他机器学习方法:图像识别,音频分类和自然语言处理只是众多应用中的一部分。这些研究领域都使用所谓的“非结构化数据”,即没有预定义结构的数据。一般来说,这些数据也可以按照一定的顺序(像素,用户行为,文本)排列。深度学习已成为处理非结构化数据的标准。现在的问题是深度学习是否也可以在结构化数据上有较好的表现。结构化数据是以表格格式组织的数据,其中列表示不同的特征,而行表示不同的数

优秀的个人博客,低调大师

AIGC内容工厂的技术架构设计与成本量化分析

内容生产的成本结构三年里被反复重写:从人力密集型,到外包制,再到AI管线自动化。本文从架构视角分析AIGC内容工厂的技术栈与成本模型。 ### 三种生产模式的成本对比 以月产300条多平台内容为基准: |维度|自聘3人团队|外包代运营|AIGC管线+1名运营| | --- | --- | --- | --- | |月成本量级|2.5万–4万元+管理成本|1万–3万元|数千元(API订阅)| |边际成本|随人力线性上升|增项需重新议价|新增条数趋近于零| |内容资产归属|代码与数据完全自有|依合同常有灰区|完全自有| |主要风险|人员流动导致能力断层|质量不稳定、断约归零|内容同质化与低质高产| **AIGC内容工厂的管线架构** 一条完整的AIGC内容管线至少包含: **1. 选题层** - 人工定义选题方向,输入热点监测数据(如新榜/5118 API) **2. 生成层** - 长文本:LLM API批量生成 - 短视频:脚本生成 → 数字人口播合成(如HeyGen/D-ID SDK) - 图文:Markdown自动生成 + 版式模板渲染 **3. 审核层** - 事实核查:与知识库RAG检索结果比对,拦截幻觉 - 合规审查:敏感词过滤、品牌风险扫描 - 质量评分:人工抽检 + 规则引擎 **4. 分发层** - 多平台API适配:微信公众号、抖音、小红书、知乎的格式自动转换 ### 数字人直播的技术边界 直播与口播视频是AI最先改写成本结构的内容形态。数字人把长尾时段的讲解成本压到很低——但技术边界清晰: |内容类型|AI适配度|原因| | --- | --- | --- | |参数讲解、流程演示|高|标准化程度高,可复用模板| |直播长尾时段填充|高|数字人承接标准化讲解,降低真人主播时段成本| |强观点、强人设内容|低|品牌温度、复杂互动与临场应变依赖真人| 成本最优解是**"AI管量、人管质"**:自动化管线负责产能,人工负责选题终审与强人设内容。

优秀的个人博客,低调大师

Docker一键部署 Crumbs,自建轻量化私有笔记服务

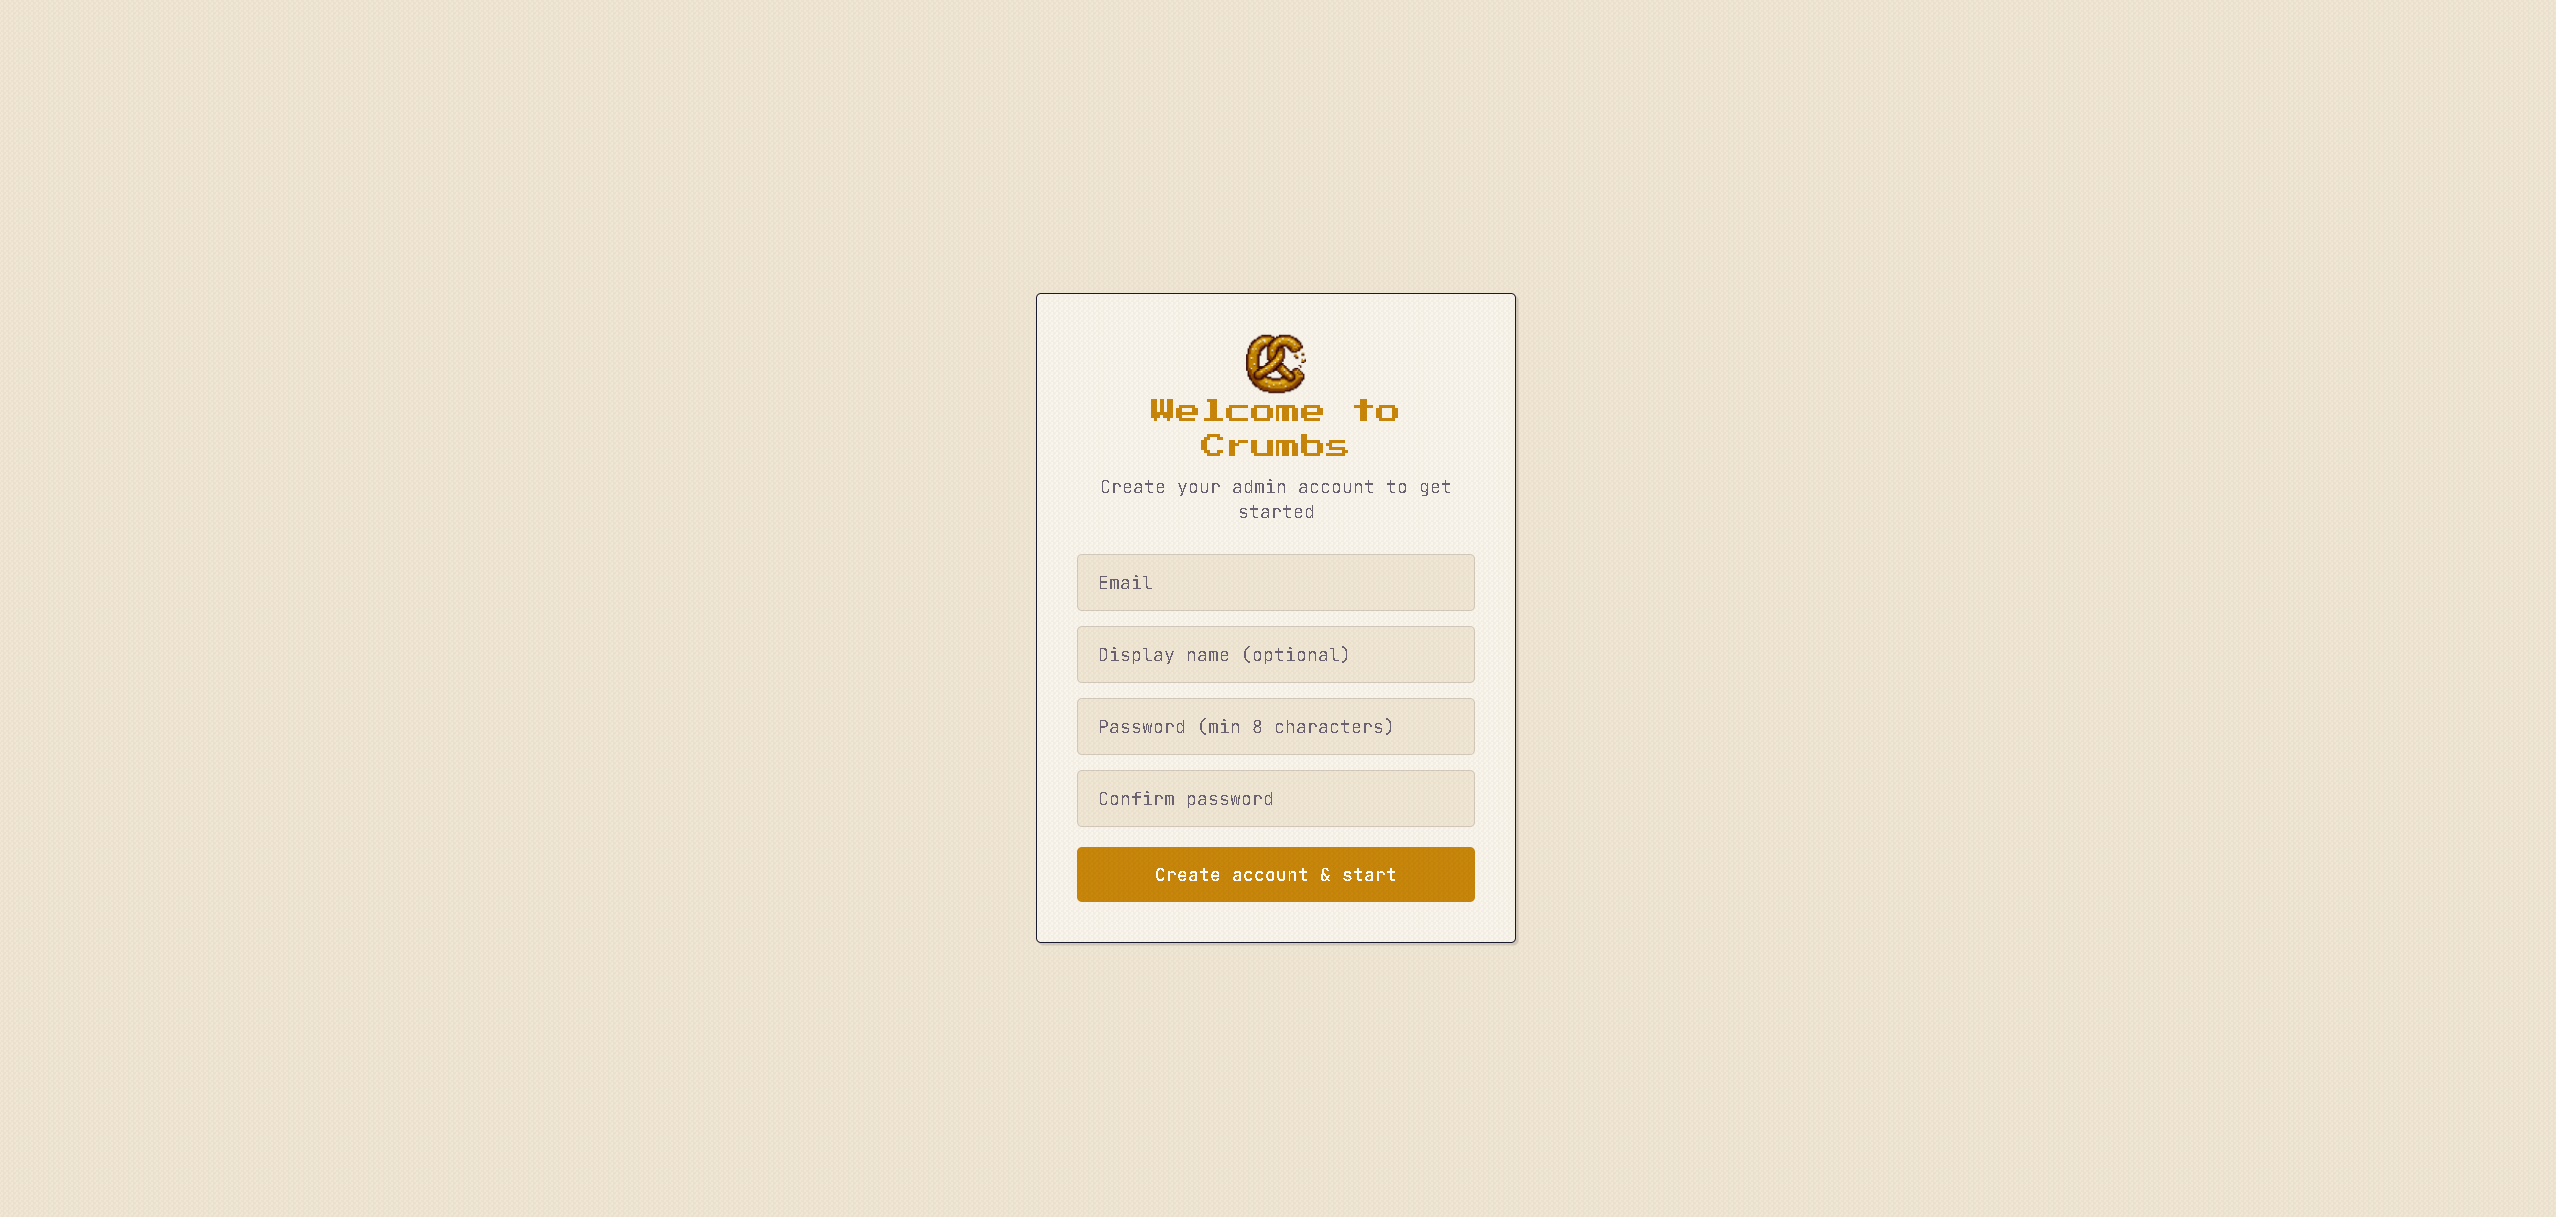
# 一、Crumbs介绍 ## 1.1 Crumbs项目简介 > Crumbs 是一款由 Bretzel 应用宇宙推出的、支持自托管且优先离线使用的笔记应用。它专为注重隐私安全的用户设计,无论是记录日常灵感还是管理个人知识库,都能让你在完全掌控自己数据的前提下,享受流畅、安全的笔记体验。 ## 1.2 Crumbs主要特点 - **丰富的笔记体验**:全面支持 Markdown 语法、待办清单与图片附件,并提供多达 12 种配色主题随心切换。 - **高效的组织管理**:支持通过 #标签 分类、置顶重要笔记,以及归档和回收站功能,让信息管理井井有条。 - **强大的全文检索**:内置全文搜索引擎,能够快速精准地在笔记标题、正文内容及标签中查找所需信息。 - **完善的版本控制**:自动记录笔记的版本历史,支持随时浏览并一键还原到之前的任意修改版本。 - **便捷的笔记共享**:支持在同一实例内与其他用户安全地分享笔记,轻松实现信息的协作与互通。 - **灵活的消息通知**:提供可选的 SMTP 邮件服务,及时推送笔记共享、安全警报及账户动态等重要通知。 - **出色的离线能力**:作为 PWA 应用支持一键安装,利用 IndexedDB 结合 LWW CRDT 技术实现完美的离线使用与同步。 - **强大的 AI 扩展**:内置 MCP 服务器,允许 Claude Code 等 AI 助手直接接入并智能化管理你的笔记内容。 - **安全的多用户认证**:采用 Argon2 算法保障账户安全,并支持 Google、GitHub 及 OIDC 等第三方 OAuth/SSO 登录。 - **极简的部署方式**:提供高度容器化的支持,仅需一条 Docker 命令即可快速完成私有化环境的搭建与运行。 # 二、本次实践规划 ## 2.1 本地环境规划 > 本次实践为个人测试环境,操作系统版本为 Ubuntu 24.04.2 LTS。 |hostname|IP地址 |操作系统版本 |Docker版本 |部署项目|备注| | --- | --- | --- | --- | --- | --- | |jeven|192.168.3.88 |Ubuntu 24.04.2 LTS|28.5.0 |Crumbs|——| ## 2.2 本次实践介绍 > 1.本次实践部署环境为个人测试环境,生产环境请谨慎; > 2.在Docker环境下部署Crumbs自托管笔记应用。 # 三、本地环境检查 ## 3.1 检查Docker服务状态 > 检查Docker服务是否正常运行,确保Docker正常运行。 ``` root@jeven:~# systemctl status docker ● docker.service - Docker Application Container Engine Loaded: loaded (/usr/lib/systemd/system/docker.service; enabled; preset: enabled) Active: active (running) since Thu 2026-02-05 00:27:40 CST; 1s ago TriggeredBy: ● docker.socket Docs: https://docs.docker.com Main PID: 841698 (dockerd) Tasks: 65 Memory: 73.5M (peak: 77.1M) CPU: 975ms CGroup: /system.slice/docker.service ``` ## 3.2 检查Docker版本 > 检查Docker版本 ``` root@jeven:~# docker -v Docker version 28.5.0, build 887030f ``` ## 3.3 检查docker compose 版本 > 检查Docker compose版本,确保2.0以上版本。 ``` root@jeven:~# docker compose version Docker Compose version v2.39.4 ``` # 四、拉取Crumbs镜像 > 下载Crumbs镜像,执行以下命令: ``` root@jeven:~# docker pull ghcr.io/bretzel-app/crumbs:0.28.3 0.28.3: Pulling from bretzel-app/crumbs ff86ea2e5edc: Already exists 82dd35b9bc5d: Pull complete d0513e5eafd9: Pull complete 539f12fec8ec: Pull complete bba7366a523c: Pull complete d80b5cf71a9f: Pull complete 1e3933667442: Pull complete ecd657a7617b: Pull complete eac099b9d35d: Pull complete 3154080fdf5b: Pull complete bfc6e36d6f25: Pull complete Digest: sha256:23cccfb2cbd018e2d671c7f1094becd6a3bcaf5de5fe1bb5460557bc2f1f459e Status: Downloaded newer image for ghcr.io/bretzel-app/crumbs:0.28.3 ghcr.io/bretzel-app/crumbs:0.28.3 ``` ![](https://developer.qcloudimg.com/http-save/4995888/0669e95836b8fba02481804a96d190a5.png) # 五、部署Crumbs服务 ## 5.1 创建部署目录 - 创建部署目录 ``` mkdir -p /data/crumbs/data && cd /data/crumbs ``` - 在测试环境中,为了方便操作,我们直接为挂载目录设置了完全权限。但在生产环境中,请务必根据实际安全需求,配置更精细、严格的权限控制方案。 ``` chmod -R 777 /data/crumbs ``` ## 5.2 docker-cli方式部署(可选) > 如果想要使用docker-cli方式部署,可参考以下命令部署。(可选) ``` docker run -d \ --name=crumbs \ --restart=unless-stopped \ -p 5660:3000 \ -v $(pwd)/data:/data \ ghcr.io/bretzel-app/crumbs:0.28.3 ``` ## 5.3 创建Crumbs容器 > 本次实践我们采用 Docker Compose 方式进行部署,这也是我推荐的方式。首先我们需要创建并编辑 `docker-compose.yaml` 文件,请注意宿主机映射端口可根据您的实际情况自行设置,务必避免端口冲突。 ``` vim docker-compose.yaml ``` ``` version: '3' services: crumbs: image: ghcr.io/bretzel-app/crumbs:0.28.3 container_name: crumbs restart: always ports: - "5660:3000" volumes: - /data/crumbs/data:/data ``` > 执行以下命令,创建Crumbs容器。 ``` docker compose up -d ``` ![](https://developer.qcloudimg.com/http-save/4995888/26fa7fbe60c5a6bb18575f50b0132070.png) ## 5.4 查看Crumbs容器状态 > 检查Crumbs容器运行状态,确保Crumbs容器正常启动。 ``` root@jeven:/data/crumbs# docker compose ps WARN[0000] /data/crumbs/docker-compose.yaml: the attribute `version` is obsolete, it will be ignored, please remove it to avoid potential confusion NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS crumbs ghcr.io/bretzel-app/crumbs:0.28.3 "docker-entrypoint.s…" crumbs 29 seconds ago Up 28 seconds (healthy) 0.0.0.0:5660->3000/tcp, [::]:5660->3000/tcp ``` ![](https://developer.qcloudimg.com/http-save/4995888/94b82dbc50f361cfdf2d2188424e8f2a.png) ## 5.5 检查Crumbs容器日志 > 检查容器运行日志,确保Crumbs服务正常运行。 ``` docker compose logs ``` ![](https://developer.qcloudimg.com/http-save/4995888/fde495afed0900570e5e767e98cf73f3.png) # 六、访问Crumbs服务 ## 6.1 访问Crumbs初始页 > 浏览器地址: `http://:5660`,访问Crumbs初始页。如果无法访问,请确保宿主机的防火墙已关闭或已放行相关端口,对于云服务器还需配置相应的安全组规则。 ![](https://developer.qcloudimg.com/http-save/4995888/786c5eda94698b09fa0cf39149627e34.png) ## 6.2 创建账号 > 自行填写账号信息,创建登录账号。 ![](https://developer.qcloudimg.com/http-save/4995888/f50bc303d7b8f805f075c09fb48adc70.png) ![](https://developer.qcloudimg.com/http-save/4995888/d1dd266348eb419a3614f669bb91ae22.png) ## 6.3 编辑笔记 > 编辑笔记内容后,效果如下所示: ![](https://developer.qcloudimg.com/http-save/4995888/e27f0dc02134360bae4dc3dcf046cac4.png) # 七、总结 > 本次实践成功使用 Docker 完成了 Crumbs 自托管笔记应用的部署,充分体验了其轻量级与隐私优先的特性。通过简单的容器化操作,我们不仅实现了数据的本地化存储,还有效保障了个人知识资产的安全与独立。Crumbs 简洁易用的界面配合灵活的 Docker 部署方式,使其成为构建个人专属知识库的理想选择。

优秀的个人博客,低调大师

用云函数跑量化日更任务,先分清“调度”和“计算”

最近在整理日更行情和因子计算任务时,我重新看了腾讯云云函数的定时触发器。它的优点很直观:不用长期维护一台服务器,用 Cron 到点触发,适合收盘后更新少量数据、生成简报或做健康检查。但它不是把所有回测代码原样上传就结束,先分清“调度”和“计算”更重要。 腾讯云文档说明,定时器按 Cron 触发事件函数,而且始终采用异步调用。也就是说,触发动作发生了,不代表业务结果已经成功生成。函数里至少要记录本次任务的交易日、触发时间、数据版本和结束状态;外部再检查结果文件或状态表,而不是只看控制台显示“已触发”。 幂等也不能省。定时任务可能因重试、网络抖动或人工补跑而重复执行。我的做法是用交易日和任务名组成唯一键,开始前先检查该日结果是否完整;未完成才继续,完成则直接退出。结果不要只留在临时运行目录,重要的行情快照、因子文件和日志可以写到 COS,并在上传成功后再写完成标记。 Cron 时间也要认真核对。官方事件中的 Time 字段使用零时区,表达式则按平台规则配置。涉及 A 股收盘后任务时,应明确北京时间与 UTC 的换算,并另外判断交易日,不能简单用周一到周五代替交易所日历。 SCF 更适合耗时可控、依赖不重、输入输出明确的任务。全市场多年回测、需要常驻连接的交易程序,通常仍适合放在 CVM、容器或专门调度系统里。一个实用的拆法是让云函数负责准时启动、校验参数和写状态,把重计算交给更稳定的计算环境。 判断架构是否合适,不看用了多少云产品,而看失败后能不能重跑、结果能不能追踪、重复触发会不会污染数据。把这些边界先想清楚,轻量的 Serverless 调度反而很好维护。

优秀的个人博客,低调大师

worker不是越多越好:主从延迟调优的量化方法

大家好,我是小耶,写功课只是为了我踩过的坑,你们别再踩了! 主从延迟是DBA绕不过去的坎,但延迟背后的原因,不同的人看到的完全不同。有人遇到延迟就翻慢查询日志,有人一上来就改并行复制参数,还有人选择“重启大法”。折腾一晚上,问题可能解决了,但下次来的时候你还是不知道怎么应对。 从库追不上主库,本质是两条线——主库拼命写,从库拼命回放,看谁跑得快。当从库回放速度跟不上主库的写入速度时,延迟就出现了。前几周我们走完了“发现问题”的路:大事务怎么查、二次放大怎么识别、根因怎么分析。今天走“解决问题”的路——把延迟从秒级压到毫秒级,让从库在主库写入高峰时也能稳稳跟上。 **一、回放慢的根源:瓶颈在SQL线程** 先走一遍主从复制的基本流程:主库写入 → binlog → 从库IO线程拉取 → relay log → 从库SQL线程重放 → 数据写入。 延迟的瓶颈通常卡在最后一步——**SQL线程重放**。 主库能同时处理几百上千个并发连接,但MySQL 5.6之前,从库只有一个SQL线程在一条一条地重放binlog。主库是10条流水线同时干活,从库只有1个人在一件一件地做。主库写得越快,从库落得越远。瓶颈就出在“干活的人太少”上。 并行复制就是解决这个问题的。不是所有延迟问题都靠并行复制能解决——并行复制解决“干活的人少”的问题,业务优化解决“活太大”的问题。两个都搞定,从库追不上主库的问题才基本能治好。 **二、并行复制的四代演进:选对模式比调对参数更重要** MySQL的并行复制经历了四代演进,每一代的设计思路完全不同。不搞清楚原理就上手调,跟闭眼开车差不多。很多人一开始以为并行复制就是改个`slave_parallel_workers`的事,结果改完延迟一点没降,还差点搞出数据不一致。 **第一代:基于Schema(MySQL 5.6)** 如果两个事务操作的是不同数据库,可以并行执行。 ```javascript slave_parallel_type = DATABASE slave_parallel_workers = 4 ``` 局限性很明显——现在的业务谁不是一个库搞到底?单库多表场景下基本等于没开。 **第二代:LOGICAL_CLOCK(MySQL 5.7.2+)** 核心思路变了:不再看“是不是同一个库”,而是看“在主库是不是一起提交的”。 MySQL会把多个事务的binlog攒在一起写盘(Group Commit),同一组的事务在主库是“同时”提交的,之间大概率不冲突。5.7在binlog里记录了每个事务的“逻辑时钟”,从库看到逻辑时钟相同的事务就可以并行重放。 ```javascript slave_parallel_type = LOGICAL_CLOCK slave_parallel_workers = 8 slave_preserve_commit_order = ON ``` 单库多表也能并行。但LOGICAL_CLOCK有个问题:逻辑时钟的并行度受限于主库的组提交效率。如果主库并发不高,组里的事务少,从库的并行度也上不去。 **第三代:WRITESET(MySQL 5.7.22+)** 这是真正的突破——基于**行级冲突检测**来决定哪些事务可以并行。原理是分析每个事务修改了哪些行,生成一个“写集合”。两个事务如果修改的行没有交集,就可以并行重放,不管它们在主库是不是同一组提交的。 ```javascript slave_parallel_type = WRITESET slave_parallel_workers = 8 ``` **第四代:WRITESET_SESSION(MySQL 8.0.27+)** 在WRITESET的基础上增加了一个限制:同一个session(会话)内的事务仍然按顺序重放。为什么需要这个限制?因为同一个session内的事务可能有业务逻辑上的先后依赖(比如先插入再更新)。WRITESET_SESSION在保证并行度的同时,避免了session内部的数据一致性问题。 ```javascript slave_parallel_type = WRITESET_SESSION slave_parallel_workers = 8 ``` **三、并行度调优:worker数不是越大越好** `slave_parallel_workers`设多少合适?很多人的第一反应是“越多越好”。但实际情况是:worker太多,线程切换和锁竞争的开销反而会拖慢回放速度。 **调优原则**: |CPU核心数|推荐worker数|说明| | --- | --- | --- | |4核|4-8|保守起步| |8核|8-16|通常最优区间| |16核|16-32|高配场景| |32核以上|不超过32|超过32收益递减| **调优步骤**: 1. 先设`slave_parallel_workers = 8`,观察一周 1. 看从库CPU使用率和延迟趋势: - CPU低于60%且延迟还在涨 → 加worker - CPU高于80%或锁争用明显 → 减worker `slave_preserve_commit_order`**要不要开?** 这个参数保证从库事务的提交顺序与主库一致。开启后会稍微降低并行度,但能避免数据不一致的风险。生产环境建议保持`ON`。 **四、精细化参数调优** 并行复制调好了,但延迟还是压不下去,问题可能出在binlog和刷盘参数上。 **1. binlog_format = ROW** 一定要用ROW格式。虽然STATEMENT格式省空间,但无法准确记录行级变化,容易导致主从数据不一致,而且对并行复制的支持不如ROW好。 **2. binlog_group_commit_sync_delay** 控制组提交的等待时间。适当调高这个值可以让更多事务被攒到一个组里一起提交,增加并行复制的粒度。 ```javascript binlog_group_commit_sync_delay = 1000 # 微秒 ``` 建议从0开始逐步调高,观察延迟变化。 **3. 从库硬件配置不低于主库** 从库硬件配置最好不低于主库,尤其是磁盘I/O。很多团队用淘汰下来的旧机器跑从库,延迟问题从第一天就埋下了。 **五、业务侧与架构侧配套优化** 并行复制和参数调优是“治标”,业务优化才是“治本”。 **1. 拆分大事务** 并行复制解决“干活的人少”的问题,业务优化解决“活太大”的问题。一个事务里更新了50万行,worker再多也得等它跑完。拆分大事务是最有效的预防手段。 **2. 读写分离路由做对** 不是所有查询都应该去从库。实时性要求高的查询(如订单详情、余额查询)走主库,容忍秒级延迟的查询(如报表、历史记录)走从库。 **3. 监控不要只看Seconds_Behind_Master** `Seconds_Behind_Master`的盲区我们前几周已经讲过了。建议补充监控: - 从库的binlog应用延迟(`Read_Master_Log_Pos`与`Exec_Master_Log_Pos`的差值) - 从库CPU使用率 - worker线程的活跃状态 **六、总结** 把从库延迟压到极限,需要做四件事: |层级|动作|目标| | --- | --- | --- | |**复制模式**|升级到WRITESET或WRITESET_SESSION|最大化并行度| |**并行度调优**|worker数=CPU核数的70%-100%,动态调整|不浪费CPU,不引入锁竞争| |**参数精细化**|ROW格式、调优group commit、从库硬件不低于主库|减少每一环节的额外开销| |**业务配套**|拆分大事务、读写分离路由、完善监控|从源头减少延迟压力| 主从延迟优化的终点不是“延迟降到0”,而是“延迟可控、可预测、可接受”。把上面四件事做到位,你的从库在主库写入高峰时也能稳稳跟上。 **小耶在手,SQL 不愁** 还有什么想了解的,欢迎留言!小耶一定知无不言言无不尽……我们下次见~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册