首页 文章 精选 留言 我的

精选列表

搜索[编译器工具集],共10000篇文章
优秀的个人博客,低调大师

云主机搭建Kubernetes 1.10集群

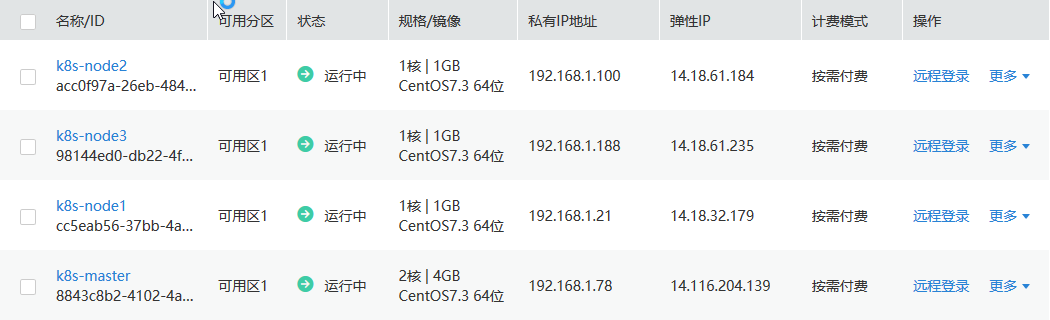
一、基础环境 云主机 下载软件包 将所有软件下载至/data目录 # 链接:https://pan.baidu.com/s/13DlR1akNBCjib5VFaIjGTQ 密码:1l69 # 链接:https://pan.baidu.com/s/1V6Uuj6a08mEq-mRLaI1xgw 密码:6gap master到node做免密认证 ssh-keygen ssh-copy-id root@192.168.1.237 ssh-copy-id root@192.168.1.100 ssh-copy-id root@192.168.1.188 设定主机名与host文件 # 分别设定node与master的主机名 hostnamectl set-hostname master exec bash # 同步所有主机的hosts文件 vim /etc/hosts 192.168.1.78 master localhost 192.168.1.237 node1 192.168.1.100 node2 192.168.1.188 node3 解决DNS解析localhost 此云主机的DNS解析localhost会解析到一个鬼地址,这是个大坑。kubeadm初始化是会用到localhost。如果你的主机能解析到自己的IP,那么这步可以跳过。如果不能则需要自己搭建一个DNS,将localhost解析到自己。 # 1.检测 [root@node2 ~]# nslookup localhost Server: 118.118.118.9 Address: 118.118.118.9#53 Non-authoritative answer: Name: localhost.openstacklocal Address: 183.136.168.91 # 2.搭建DNS yum -y install dnsmasq cp /etc/resolv.conf{,.bak} rm -rf /etc/resolv.conf echo -e "nameserver 127.0.0.1\nnameserver $(hostname -i)" >> /etc/resolv.conf chmod 444 /etc/resolv.conf chattr +i /etc/resolv.conf echo -e "server=8.8.8.8\nserver=8.8.4.4" > /etc/dnsmasq.conf echo -e "$(hostname -i)\tlocalhost.$(hostname -d)" >> /etc/hosts service dnsmasq restart # 3.再次检测 [root@master ~]# nslookup localhost Server: 127.0.0.1 Address: 127.0.0.1#53 Name: localhost Address: 192.168.1.78 同步系统时间 ntpdate 0.centos.pool.ntp.org 关闭防火墙 iptables -F systemctl stop firewalld systemctl disable firewalld 关闭SELinux & 关闭swap swapoff -a sed -i 's/.*swap.*/#&/' /etc/fstab setenforce 0 确认时区 timedatectl set-timezone Asia/Shanghai systemctl restart chronyd.service 修改系统参数 cat <<EOF > /etc/sysctl.d/k8s.conf net.bridge.bridge-nf-call-ip6tables = 1 net.bridge.bridge-nf-call-iptables = 1 EOF sysctl --system 安装docker tar -xvf docker-packages.tar cd docker-packages yum -y install local *.rpm systemctl start docker && systemctl enable docker 配置镜像加速器 vim /etc/docker/daemon.json { "registry-mirrors": ["https://lw9sjwma.mirror.aliyuncs.com"] } systemctl daemon-reload systemctl restart docker 配置k8s的yum源 vim /etc/yum.repos.d/k8s.repo [k8s] name=k8s baseurl=https://mirrors.aliyun.com/kubernetes/yum/repos/kubernetes-el7-x86_64/ gpgcheck=0 获取kube软件包 cd kube-packages-1.10.1 # 软件包在网盘中下载 tar -xvf kube-packages-1.10.1.tar cd kube-packages-1.10.1 yum -y install local *.rpm systemctl start kubelet && systemctl enable kubelet 统一k8s与docker的驱动 # 1.查看docker驱动 docker info | Cgroup Driver Cgroup Driver: cgroupfs # 修改k8s配置文件与docker保持一致 sed -i "s/cgroup-driver=systemd/cgroup-driver=cgroupfs/g" /etc/systemd/system/kubelet.service.d/10-kubeadm.conf 导入基础镜像 cd /data docker load -i k8s-images-1.10.tar.gz 二、初始化master节点 # 初始化master 指定的版本要与kubeadm版本一致 # kubeadm只给定了最少选项,集群名称等等都没有指定,kubeadm init [root@master ~]# kubeadm init --kubernetes-version=v1.10.1 --pod-network-cidr=10.244.0.0/16 # 初始化完成后得到如下信息 Your Kubernetes master has initialized successfully! To start using your cluster, you need to run the following as a regular user: mkdir -p $HOME/.kube sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config sudo chown $(id -u):$(id -g) $HOME/.kube/config You should now deploy a pod network to the cluster. Run "kubectl apply -f [podnetwork].yaml" with one of the options listed at: https://kubernetes.io/docs/concepts/cluster-administration/addons/ You can now join any number of machines by running the following on each node as root: kubeadm join 192.168.1.78:6443 --token qabol0.c2gq0uyfxvpqr8bu --discovery-token-ca-cert-hash sha256:2237ec7b8efd5a8f68adcb04900a0b17b9df2a78675a7d62b4aef644a7f62c05 # kubeadm join 是node节点加入集群的命令,注意token的有效期 若要通过普通用户使用群集,需要执行以下步骤 mkdir -p $HOME/.kube sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config sudo chown $(id -u):$(id -g) $HOME/.kube/config 基本命令 # 查看pods kubectl get pods # 查看系统pods [root@master ~]# kubectl get pods -n kube-system NAME READY STATUS RESTARTS AGE etcd-master 0/1 Pending 0 1s kube-apiserver-master 0/1 Pending 0 1s kube-controller-manager-master 0/1 Pending 0 1s kube-dns-86f4d74b45-d42zm 0/3 Pending 0 8h kube-proxy-884h6 1/1 NodeLost 0 8h kube-scheduler-master 0/1 Pending 0 1s # 查看集群各组件状态信息 [root@master ~]# kubectl get componentstatuses NAME STATUS MESSAGE ERROR scheduler Healthy ok controller-manager Healthy ok etcd-0 Healthy {"health": "true"} You have new mail in /var/spool/mail/root 三、node加入集群 # 确保node节点cgroup驱动保持一致 sed -i "s/cgroup-driver=systemd/cgroup-driver=cgroupfs/g" /etc/systemd/system/kubelet.service.d/10-kubeadm.conf # 命令来自集群初始化之后额显示中 kubeadm join 192.168.1.78:6443 --token v0866r.u7kvg5js1ah2u1bi --discovery-token-ca-cert-hash sha256:7b36794f4fa5121f6a5e309d0e312ded72997a88236a93ec7da3520e5aaccf0e # master节点查看nodes信息 [root@master data]# kubectl get nodes NAME STATUS ROLES AGE VERSION master NotReady master 57m v1.10.1 node1 NotReady <none> 27m v1.10.1 node2 NotReady <none> 11s v1.10.1 node3 NotReady <none> 4s v1.10.1 You have new mail in /var/spool/mail/root 四、部署网络 部署 flannel官网 flannel下载时不用科学上网,flannel的yml文件会自动去quay.io网站中下载镜像。 # 1.1使用软件包中的flannel,并指pod映射到哪个主机的网卡上面。 vim kube-flannel.yml command: [ "/opt/bin/flanneld", "--ip-masq", "--kube-subnet-mgr","-iface=eth0" ] # 以下要按顺序创建,先创建rbac,之前没有穿件rbac导致pod正常创建,但是pin不同 kubectl apply -f kube-flannel-rbac.yml kubectl apply -f kube-flannel.yml # 后,节点的状态会变为ready [root@master1 kubernetes1.10]# kubectl get node NAME STATUS ROLES AGE VERSION master Ready master 57m v1.10.1 node1 Ready <none> 27m v1.10.1 node2 Ready <none> 11s v1.10.1 node3 Ready <none> 4s v1.10.1 # 2.从官网下载最新的flannel,k8s1.7+ 直接执行以下命令即可 kubectl apply -f https://raw.githubusercontent.com/coreos/flannel/master/Documentation/kube-flannel.yml flannel配置文件修改 kube-flannel.yml中指定使用的网段 "Network": "10.244.0.0/16" 默认使用16位掩码,则在各node中都分配一个10.244.0.0/8的网络 五、部署dashboard kubectl apply -f kubernetes-dashboard-http.yam kubectl apply -f admin-role.yaml kubectl apply -f kubernetes-dashboard-admin.rbac.yaml 命令行常用命令 # 查看pod信息,默认显示default名称空间下的pod [root@master ~]# kubectl get pods No resources found. # 指定名称空间写pod [root@master ~]# kubectl get pods -n kube-system NAME READY STATUS RESTARTS AGE etcd-master 1/1 Running 0 3h kube-apiserver-master 1/1 Running 0 3h kube-controller-manager-master 1/1 Running 0 3h kube-dns-86f4d74b45-bzbvc 3/3 Running 0 3h kube-flannel-ds-5ghhj 1/1 Running 0 2h kube-flannel-ds-ht4xd 1/1 Running 0 3h kube-flannel-ds-kbm5g 1/1 Running 0 3h kube-flannel-ds-mlj4r 1/1 Running 0 2h kube-proxy-9xxnd 1/1 Running 0 3h kube-proxy-n9w5x 1/1 Running 0 3h kube-proxy-nkn8c 1/1 Running 0 2h kube-proxy-shd6l 1/1 Running 0 2h kube-scheduler-master 1/1 Running 0 3h kubernetes-dashboard-5c469b58b8-rjfx6 1/1 Running 0 1h # 显示更详细的pod信息,此时各pod中都运行了一个kube-proxy和flannel容器 -o wide 显示更详细的信息,报错node节点iP、主机名 [root@master ~]# kubectl get pods -n kube-system -o wide NAME READY STATUS RESTARTS AGE IP NODE etcd-master 1/1 Running 0 3h 192.168.1.78 master kube-apiserver-master 1/1 Running 0 3h 192.168.1.78 master kube-controller-manager-master 1/1 Running 0 3h 192.168.1.78 master kube-dns-86f4d74b45-bzbvc 3/3 Running 0 3h 10.244.0.2 master kube-flannel-ds-5ghhj 1/1 Running 0 2h 192.168.1.188 node3 kube-flannel-ds-ht4xd 1/1 Running 0 3h 192.168.1.78 master kube-flannel-ds-kbm5g 1/1 Running 0 3h 192.168.1.237 node1 kube-flannel-ds-mlj4r 1/1 Running 0 2h 192.168.1.100 node2 kube-proxy-9xxnd 1/1 Running 0 3h 192.168.1.237 node1 kube-proxy-n9w5x 1/1 Running 0 3h 192.168.1.78 master kube-proxy-nkn8c 1/1 Running 0 2h 192.168.1.100 node2 kube-proxy-shd6l 1/1 Running 0 2h 192.168.1.188 node3 kube-scheduler-master 1/1 Running 0 3h 192.168.1.78 master kubernetes-dashboard-5c469b58b8-rjfx6 1/1 Running 0 1h 10.244.0.3 master 六、kubeadm清空配置 # 清空kubectl kubeadm reset # 清空网络信息 ip link del cni0 ip link del flannel.1 七、踩过的那些坑 确保master与node的DNS解析localhost能解析到自己的IP node加入master确保token不过期 node确保kubelet正常启动并运行 flannel网络要先创建kube-flannel-rbac.ymal再创建 kube-flannel.yml 八、token过期的解决办法 # 1.查看已经存在的token kubeadm token list # 2.创建token kubeadm token create # 3.查看ca证书的sha256编码 openssl x509 -pubkey -in /etc/kubernetes/pki/ca.crt | openssl rsa -pubin -outform der 2>/dev/null | openssl dgst -sha256 -hex | sed 's/^.* //' # 4.node使用新的token加入集群 kubeadm join --token acb123 --discovery-token-ca-cert-hash sha256:efg456 172.16.6.79:6443 --skip-preflight-checks # abc123 新创建的Token # efg456 证书的sha256编码 # IP+Port Master的IP+Port 感谢 无痴迷,不成功 discsthnew

优秀的个人博客,低调大师

hadoop2集群搭建过程

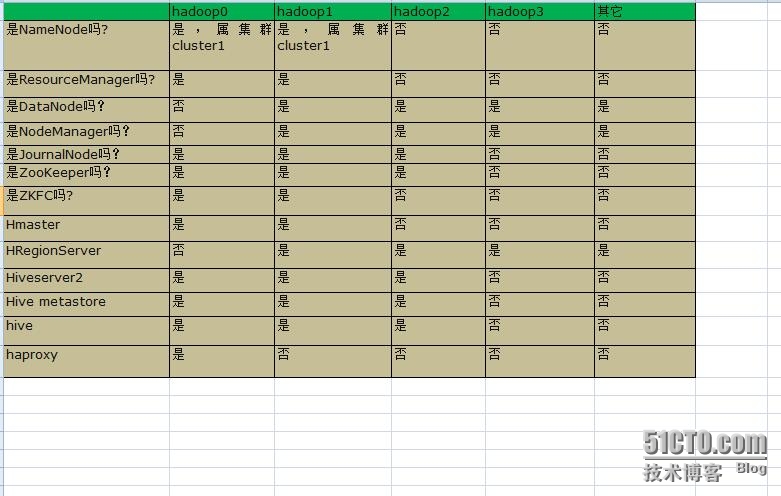
在这里我选用4台机器进行示范,各台机器的职责如下表格所示 (说明: 1. ZooKeepe使用其它节点的 2. Hadoop0节点安装所有的master, ha的matster全部是worker, 以达到较高的资源利用率,又对master的负载不会过高) Hadoop0 -> dchadoop206 Hadoop1 -> dchadoop207 Hadoop2 -> dchadoop208 Hadoop3 -> dchadoop209 1.搭建自动HA 1.1.复制编译后的hadoop项目到/usr/local目录下 1.2.修改位于etc/hadoop目录下的配置文件 1.1.1.hadoop-env.sh 1 export JAVA_HOME= /usr/local/jdk 1.1.1.core-site.xml 1 2 3 4 5 <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //cluster1 < /value > < /property > 【这里的值指的是默认的HDFS路径。当有多个HDFS集群同时工作时,用户如果不写集群名称,那么默认使用哪个哪?在这里指定!该值来自于hdfs-site.xml中的配置。在节点hadoop0和hadoop1中使用cluster1,在节点hadoop2和hadoop3中使用cluster2】 1 2 3 4 <property> <name>hadoop.tmp. dir < /name > <value> /data0/hadoop/tmp < /value > < /property > 【这里的路径默认是NameNode、DataNode、JournalNode等存放数据的公共目录。用户也可以自己单独指定这三类节点的目录。】 1 2 3 4 <property> <name>ha.zookeeper.quorum< /name > <value>hadoop0:2181,hadoop1:2181,hadoop2:2181< /value > < /property > 【这里是ZooKeeper集群的地址和端口。注意,数量一定是奇数,且不少于三个节点】 1 < /configuration > 1.1.1.hdfs-site.xml 该文件只配置在hadoop0和hadoop1上。 1 2 3 4 5 <configuration> <property> <name>dfs.replication< /name > <value>2< /value > < /property > 【指定DataNode存储block的副本数量。默认值是3个,我们现在有4个DataNode,该值不大于4即可。】 1 2 3 4 <property> <name>dfs.namenode.name. dir < /name > <value> file : ///data0/hadoop2/hdfs/name < /value > < /property > 【指定namenode元数据信息存储位置】 1 2 3 <property> <name>dfs.datanode.data. dir < /name ><value> file : ///data0/hadoop2/hdfs/data , file : ///data1/hadoop2/hdfs/data , file : ///data2/hadoop2/hdfs/data , file : ///data3/hadoop2/hdfs/data , file : ///data4/hadoop2/hdfs/data , file : ///data5/hadoop2/hdfs/data , file : ///data6/hadoop2/hdfs/data , file : ///data7/hadoop2/hdfs/data , file : ///data8/hadoop2/hdfs/data , file : ///data9/hadoop2/hdfs/data , file : ///data10/hadoop2/hdfs/data < /value > < /property > 【指定datanode元数据信息存储位置,设置成所有的磁盘】 1 2 3 4 <property> <name>dfs.nameservices< /name > <value>cluster1< /value > < /property > 【设置cluster1的namenode id。】 1 2 3 4 <property> <name>dfs.ha.namenodes.cluster1< /name > <value>hadoop0,hadoop1< /value > < /property > 【指定NameService是cluster1时的namenode有哪些,这里的值也是逻辑名称,名字随便起,相互不重复即可】 1 2 3 4 <property> <name>dfs.namenode.rpc-address.cluster1.hadoop0< /name > <value>hadoop0:9000< /value > < /property > 【指定hadoop0的RPC地址】 1 2 3 4 <property> <name>dfs.namenode.http-address.cluster1.hadoop0< /name > <value>hadoop0:50070< /value > < /property > 【指定hadoop0的http地址】 1 2 3 4 <property> <name>dfs.namenode.rpc-address.cluster1.hadoop1< /name > <value>hadoop1:9000< /value > < /property > 【指定hadoop1的RPC地址】 1 2 3 4 <property> <name>dfs.namenode.http-address.cluster1.hadoop1< /name > <value>hadoop1:50070< /value > < /property > 【指定hadoop1的http地址】 1 2 3 4 <property> <name>dfs.namenode.shared.edits. dir < /name > <value>qjournal: //hadoop0 :8485;hadoop1:8485;hadoop2:8485 /cluster1 < /value > < /property > 【指定cluster1的两个NameNode共享edits文件目录时,使用的JournalNode集群信息】 1 2 3 4 <property> <name>dfs.ha.automatic-failover.enabled.cluster1< /name > <value> true < /value > < /property > 【指定cluster1是否启动自动故障恢复,即当NameNode出故障时,是否自动切换到另一台NameNode】 1 2 3 4 <property> <name>dfs.client.failover.proxy.provider.cluster1< /name > <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider< /value > < /property > 【指定cluster1出故障时,哪个实现类负责执行故障切换】 1 2 3 4 <property> <name>dfs.journalnode.edits. dir < /name > <value> /data0/hadoop2/hdfs/journal < /value > < /property > 【指定JournalNode集群在对NameNode的目录进行共享时,自己存储数据的磁盘路径】 1 2 3 4 <property> <name>dfs.ha.fencing.methods< /name > <value>sshfence< /value > < /property > 【一旦需要NameNode切换,使用ssh方式进行操作】 1 2 3 4 <property> <name>dfs.ha.fencing. ssh .private-key-files< /name > <value> /root/ . ssh /id_rsa < /value > < /property > 【如果使用ssh进行故障切换,使用ssh通信时用的密钥存储的位置】 1 < /configuration > 1.2.4. slaves hadoop1 hadoop2 hadoop2 1.3.把以上配置的内容复制到hadoop1、hadoop2、hadoop3节点上 1.4.修改hadoop1、hadoop2、hadoop3上的配置文件内容 1.4.1.修改hadoop2上的core-site.xml内容 1 fs.defaultFS的值改为hdfs: //cluster2 1.4.1.修改hadoop2上的hdfs-site.xml内容 把cluster1中关于journalnode的配置项删除,增加如下内容 1 2 3 4 <property> <name>dfs.namenode.shared.edits. dir < /name > <value>qjournal: //hadoop0 :8485;hadoop1:8485;hadoop2:8485 /cluster2 < /value > < /property > 1.4.3.开始启动 1.4.3.1.启动journalnode 在hadoop0、hadoop1、hadoop2上执行 1 sbin /hadoop-daemon .shstartjournalnode 1.4.3.1.格式化ZooKeeper 在hadoop0、hadoop2上执行 bin/hdfszkfc -formatZK zkCli.sh-->ls->/Hadoop-ha/cluster1 1.4.3.3.对hadoop0节点进行格式化和启动 1 bin /hdfs namenode- format 1 sbin /hadoop-daemon .shstartnamenode 1.4.3.4.对hadoop1节点进行格式化和启动 1 bin /hdfs namenode-bootstrapStandby 1 sbin /hadoop-daemon .shstartnamenode 1.4.3.5.在hadoop0、hadoop1上启动zkfc 1 sbin /hadoop-daemon .shstartzkfc 我们的hadoop0、hadoop1有一个节点就会变为active状态。 1.4.3.6.对于cluster2执行类似操作 1.4.4.启动datanode 在hadoop0上执行命令 1 sbin /hadoop-daemons .shstartdatanode 1.5.配置Yarn 1.5.1.修改文件mapred-site.xml 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <property> <name>mapreduce.jobhistory.address< /name > <value>hadoop0:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>hadoop0:19888< /value > < /property > <property> <name>mapreduce.task.io. sort .factor< /name > <value>20< /value > <description>Thenumberofstreamstomergeatonce while sorting files.Thisdeterminesthenumberof open file handles.< /description > < /property > <property> <name>mapreduce.reduce.shuffle.parallelcopies< /name > <value>40< /value > <description>Thedefaultnumberofparalleltransfersrunbyreduce duringthecopy(shuffle)phase. < /description > < /property > <property> <name>mapreduce.job.reduce.slowstart.completedmaps< /name > <value>0.80< /value > <description>Fractionofthenumberofmaps in thejobwhichshouldbe completebeforereducesarescheduled for thejob. < /description > < /property > <property> <name>mapreduce.task.io. sort .mb< /name > <value>300< /value > <description>Thetotalamountofbuffermemorytousewhilesorting files, in megabytes.Bydefault,giveseachmergestream1MB, which shouldminimizeseeks.< /description > < /property > <property> <name>mapreduce.map.output.compress< /name > <value> true < /value > <description>Shouldtheoutputsofthemapsbecompressedbeforebeing sentacrossthenetwork.UsesSequenceFilecompression. < /description > < /property > <property> <name>mapreduce.client.submit. file .replication< /name > <value>5< /value > <description>默认10,Thereplicationlevel for submittedjobfiles.This shouldbearoundthesquarerootofthenumberofnodes. < /description > < /property > 1.5.2.修改文件yarn-site.xml 1 2 3 4 <property> <name>yarn.resourcemanager.ha.enabled< /name > <value> true < /value > < /property > 【打开resourcemanager ha模式】 1 2 3 4 <property> <name>yarn.resourcemanager.cluster- id < /name > <value>yarn-ha-cluster< /value > < /property > 【打开resourcemanager ha的集群名称,这个名称可以在zookeeper中查看】 1 2 3 4 <property> <name>yarn.resourcemanager.ha. rm -ids< /name > <value>rm1,rm2< /value > < /property > 【设置resourcemanager的id,可以与主机同名】 1 2 3 4 <property> <name>yarn.resourcemanager. hostname .rm1< /name > <value>hadoop0< /value > < /property > 【指定rm1对应哪一台主机】 1 2 3 4 <property> <name>yarn.resourcemanager. hostname .rm2< /name > <value>hadoop1< /value > < /property > 【指定rm1对应哪一台主机】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <property> <name>yarn.resourcemanager.zk-address< /name > <value>zk1:2181,zk2:2181,zk3:2181< /value > < /property > <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > <!---用什么方式进行数据传递-> <property> <name>yarn.log-aggregation- enable < /name > <value> true < /value > < /property > 【设置日志合并】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 <property> <name>yarn.application.classpath< /name > <value> /usr/local/hadoop-2 .5.0-cdh5.3.8 /etc/hadoop , /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/common/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/common/lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/hdfs/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/hdfs/lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/yarn/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/yarn/lib/ *, /usr/local/hbase-0 .98.6-cdh5.3.8 /lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /lib_dc/ *, /usr/local/hbase-0 .98.6-cdh5.3.8 /conf/ < /value > < /property > 【设置classpath,没有新增外部jar的话,不需要配这个】 1 2 3 4 5 6 7 8 9 10 <!--设置调度器类型为CapacityScheduler,默认是公平调度器--> <property> <name>yarn.resourcemanager.scheduler.class< /name ><value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler< /value > < /property > <!--设置nodemanager节点内存大小,CPU个数--> <property> <name>yarn.nodemanager.resource.memory-mb< /name > <value>28672< /value > < /property > 【设置nodemanager节点内存大小 28G】 1 2 3 4 <property> <name>yarn.nodemanager.resource.cpu-vcores< /name > <value>14< /value > < /property > 【设置nodemanager节点内存大小 14个core】 1 2 3 4 <property> <name>yarn.timeline-service.enabled< /name > <value> true < /value > < /property > 【打开timeline服务】 1.5.3 修改环境变量(可以不改,使用默认配置) 1.5.3.1修改 yarn-env.sh 1 YARN_LOG_DIR= /data0/hadoop2/logs 【修改yarn的日志目录,默认在$HADOOP_HOME/logs下】 1.5.3.2 修改hadoop-env.sh 1 export JAVA_HOME= /usr/java/jdk1 .7.0_25 【修改jdk】 1 export HADOOP_LOG_DIR= /data0/hadoop2/logs 【修改hadoop的日志目录,默认在$HADOOP_HOME/logs下】 1 export HADOOP_PID_DIR= /data0/hadoop2/pid 【修改hadoop pid目录】 1.5.5修改capacity-scheduler.xml这个文件(可选 ,设置调度器为CapacityScheduler时,可以通过这个配置文件修改作业队列) 1 2 3 4 5 6 7 8 9 10 11 12 <configuration> <!--comparememroyonly--> <property> <name>yarn.scheduler.capacity.resource-calculator< /name > <value>org.apache.hadoop.yarn.util.resource.DefaultResourceCalculator< /value > < /property > <!-- more chance for appmasterthatwilllaunchMRjobs--> <property> <name>yarn.scheduler.capacity.maximum-am-resource-percent< /name > <value>0.9< /value > < /property > 【appMaster可以使用集群多少资源】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <!--打开异步调度--> <property> <name>yarn.scheduler.capacity.schedule-asynchronously. enable < /name > <value> true < /value > < /property > <!--定义队列名称queues,dev--> <property> <name>yarn.scheduler.capacity.root.queues< /name > <value>default,dev< /value > < /property > <property> <name>yarn.scheduler.capacity.root.dev.capacity< /name > <value>50< /value > < /property > 【设置队列dev的能力大小占集群的50%】 1 2 3 4 <property> <name>yarn.scheduler.capacity.root.default.capacity< /name > <value>50< /value > < /property > 【设置队列default的能力大小占集群的50%】 1 < /configuration > 1.5.4 启动yarn 在hadoop0上执行 1 sbin /start-yarn .sh 本文转自 zouqingyun 51CTO博客,原文链接:http://blog.51cto.com/zouqingyun/1754041,如需转载请自行联系原作者

优秀的个人博客,低调大师

通过Springboot拆分服务构建微服务集

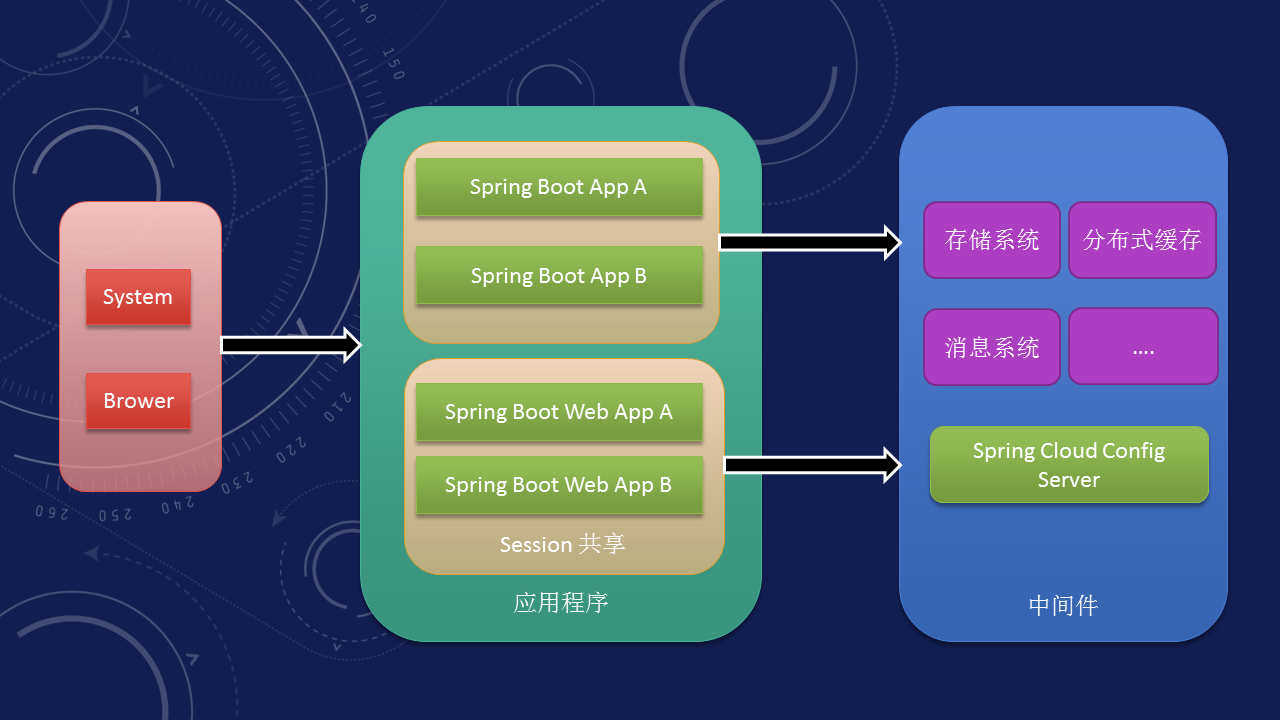
应用背景: 1.基于Spring Boot开发 2.依赖ActiveMQ,Kafka,Redis,Mongodb,MySQL等开源软件 3.内部服务图片服务器,分布式计算平台服务,检索服务,消息推送服务等 拆分原因: 1.(原有的)应用模块之间高度耦合,各个模块都担当了牵一发而动全身的“角色” 2.应用的配置信息分布到依赖个几个服务的配置中,配置信息冗余,对配置的修改改动地方过多 3.应用在依赖的基础服务的时候,没能遵循“依赖倒转原则”,导致基础服务升级,问题修复,功能增加时应用在面对变化,不够灵活 4.应用定制化开发分支与主线决裂,无法满足灵活定制化开发 拆分过程: 整个拆封过程中保持原有业务不变,逐步进行的。 1.先是把依赖基础服务的部分抽取出来,应用对依赖服务的操作全部通过抽象出来的接口进行。然后通过具体实现来完成基础服务的操作。比如:操作图片服务器的操作通过ImageServerClient进行,操作分布式计算平台服务通过PccServerClient进行。 2.梳理应用的配置信息,比如图片服务器配置,数据库配置等,搭建Spring Cloud Config服务(支持git,svn,Local File 读取配置文件)采用Local File的方式来管理配置文件;应用集成Spring Cloud Config Client ,配置信息统一才配置服务中读取。 3.进行应用拆分,将提供Http请求接口的拆分为WebApp,将提供RPC接口的拆分为App。然后这两类分别安装实现的业务功能进行拆分。 拆分的WebApp,App仍然采用Spring Boot框架。 拆分结果: 1.WebApp通过Spring Session + Redis来实现Session共享 2.WebApp,App通过请求配置服务(Spring Cloud Config Server)完成配置文件的读取,解决了拆封原因2的问题 3.拆分步骤1解决拆分原因3中的问题 4.各个独立的应用之间除了webApp要session共享外,其它的通信,数据流向都是通过中间件来完成 5.解决拆分原因4的问题就更加容易了,定制化开发仅需要添加定制的应用即可 访问应用: 1.应用是前后端分离,通过反向代理来完成Http请求到多个WebApp的转发 2.外部系统可以通过Http请求,TCP/IP的方式分别访问WebApp和App 拆分难点: 1.应用的模块划分,这个需要对应用业务流程,数据流向,依赖服务之间的调用关系以及通信协议清楚 2.避免为拆分而拆分 3.团队成员都能够理解拆分的原因,清楚操作的过程,能够想象到期望的结果 一个故事: 某一天女朋友包了两种饺子:大肉葱,韭菜鸡蛋。 我:一起煮 女朋友:说分开煮 我:不嫌麻烦 女朋友:我不吃大肉 我:那煮好,不捞大肉给你就好了 女朋友:那大肉葱煮烂了,咋办!锅里全是肉味 大而全的应用就像是一个锅煮各种饺子,小应用(微服务)就像是一锅煮一类饺子。 本文转自 secondriver 51CTO博客,原文链接:http://blog.51cto.com/aiilive/1845951,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 单元测试cmd 命令集

对app进行单元测试时,或使用robotium进行黑盒测试时,需要把测试apk安装到模拟器或者android真机上,然后用命令去驱动测试 1.运行测试程序命令-运行测试工程中所有test方法: >adb shell am instrument -w 测试程序packageName/android.test.InstrumentationTestRunner 例如: >adb shell am instrument -w com.example.action02.test/android.test.InstrumentationTestRunner 2.运行测试程序命令-运行测试工程中指定测试类方法: >abd shell am instrument -e class package.testClass(测试类) -w packageName/android.test.InstrumentationTestRunner 例如:adb shell am instrument -e class com.example.action02.test.testlogin -w com.example.action02.test/android.test.InstrumentationTestRunner 3.运行测试程序命令-运行单个测试方法 >adb shell am instrument -e class package.testClass#testmethod -w cpackageNameandroid.test.InstrumentationTestRunner 例如:adb shell am instrument -e class com.example.action02.test.testloginandquit#testlogin -w com.example.action02.test/android.test.InstrumentationTestRunner最新内容请见作者的GitHub页:http://qaseven.github.io/

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册