首页 文章 精选 留言 我的

精选列表

搜索[策略引擎],共10000篇文章
优秀的个人博客,低调大师

SAP ABAP Netweaver和Hybris Commerce的部署策略

我们都知道Netweaver经典的三层架构,既能部署在Linux/Unix上也能部署在Windows OS上.https://help.sap.com/doc/1080eced90cf4c7a94858c56e8203257/CURRENT_VERSION/en-US/SystemCopy_70X_win_aj.pdftcode SM51能看到一个逻辑的application server比如AG3后面的物理server instance: 这些物理server instance共享同一个DB.Hybris的部署方式有三种,单instance,多instance和多tenant。下图的cluster mode就对应上图的AG3这种部署方式,而Multi-tenant mode就对应C4C的部署方式,唯一区别就是Hybris里不同客户拥有自己的tenant,数据是通过database table prefix隔离的,而C4C里数据隔离是通过client做的。 对于成都开发团队来说,开发环境肯定采取的是最简单的单instance mode.开发环境里有一个嵌入的tomcat server: 我们直接执行tomcat里这个bat启动tomcat: 这个bat里会首先检测当前os类型,然后执行对应的执行文件: 在我的laptop上,执行这个x86的exe: 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

每日一博 | Gitee 存储库体积控制策略

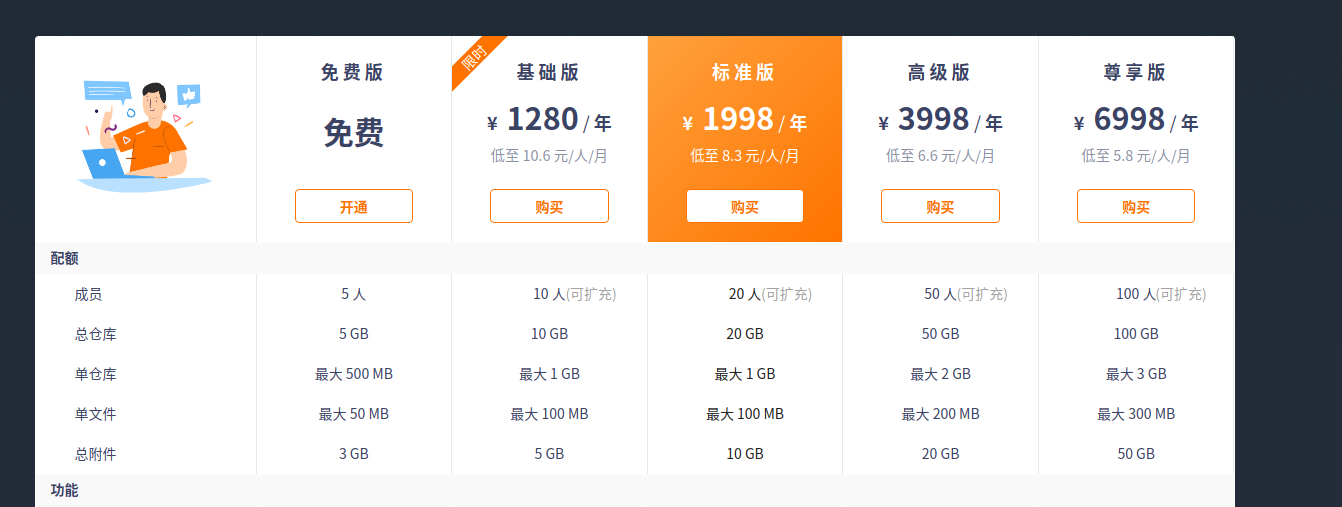
前言 作为全球第二大的代码托管平台,Gitee 拥有350W 用户和 600W 存储库,海量的存储库对 Gitee 的硬件设施提出了更高的要求,以 600W 存储库为例,如果按照平均 1GB 的大小磁盘体积,这些存储库将需要总共 5860 TB 的空间,按照 Gitee 每台存储磁盘 14TB,则需要 419 台存储设备。实际上在 Gitee 中,绝大多数存储库的体积都小于 100 M,超过 100 M 的存储库通常都是未合理使用 git。尽管如此,Gitee 仍然需要投入大量的存储设备来支撑用户的接入。为了能够让更多的人能够免费使用 Gitee,我们迫不得已只能限制大存储库的访问。近期,Gitee 存储库路由架构改造第一阶段已经到了收尾截断,在此期间,我们将陆续将服务端的钩子切换到 GNK (Gitee Native Hook),GNK 基于 C++ 编写,使用了 Git 环境隔离等高级特定,意味着大文件检测和存储库体积检测不会再有漏网之鱼。一些用户的存储库体积已经超过了 Gitee 配额限制,而之前的钩子检测存在缺陷,无法实时拦截大存储库和大文件,当切换到 GNK 后,这些用户修改他们的存储库却无法推送到 Gitee,这让他们产生了困扰,本文就这一困扰解答若干问题。当然如果用户有其他问题也可以在本文下留言。 Gitee 套餐信息 Gitee 分为普通用户,和企业用户,个人的套餐实际和企业免费版一致,最新的套餐信息 如下: 大存储库的产生 Git 是基于文件快照的,但并不是所有时候都存储快照,当对象被打包到 .pack 文件中时,则有可能存储对象的差异,即 OBJ_OFS_DELTA/OBJ_REF_DELTA。这种机制使得在文件大小不变的情况下,每次修改文件都会导致存储库体积按大于文件压缩后体积增长,以一个 Zip 压缩文件为例,每次修改后大小为 50 MB,提交 20次便能够超过 1000 MB。当用户将项目中的构建文件诸如 .exe,.pdb,.so,.jar 或者依赖文件/文件夹 node_modules,packages 以及资源文件 .psd,.raw,.avi,.jpg 添加到版本控制中后,很容易使得存储库体积超出限制。 大文件除了容易让存储库超出限制,而且也会降低用户拉取代码的体验,git 在处理二进制文件时需要花费更多的 CPU。 GNK 的拦截 随着存储服务器陆续切换到 GNK,超出配额的报告也可能会更多。GNK 的拦截是实时的,即用户将代码推送到服务器后,git-receive-pack 将调用 GNK 中的 pre-receive 钩子,这个钩子将统计存储库的 objects 目录,将所有文件和目录所占用的磁盘空间大小累加就获得了存储库的体积,这和 du -sh 机制一致,特别的,我们这里说的存储库体积包含其附带的 wiki 存储库的目录,这也是为了避免个别用户使用 wiki 存储大文件。 GNK 目前会给大存储库推送提供三次机会,如果三次读没有减小存储库体积,则便无法继续修改远程存储库,以 Linux 内核 1.4 G 为例,如下所示: 第三次时如果存储库体积依然超出限制,则会告知用户,已经耗尽所有机会,无法重试。 无法尝试时,输出如下: GNK 还会拦截用户推送的大文件,但已经存在于存储库的大文件,GNK 不会去检测。基于 Git 环境隔离机制实现的 GNK,拦截大文件不会像之前一样反复推送大文件失败导致存储库体积变大,环境隔离目录在 pre-receive 执行失败后会被删除。 存储库的精简方案 在开发的时候,我们可以使用包管理工具管理项目依赖,比如 dotnet core 使用 NuGet,Java 使用 Maven,完全没有必要将依赖二进制纳入版本控制。 如果不慎将大文件纳入了版本控制中,可以去访问 Gitee 帮助:仓库体积过大,如何减小?。在修改本地存储库后,通过 git push -f 的方式推送到 Gitee,然后在项目配置页面运行 Git GC 待 GC 运行后,通常能够发现存储库体积变小。 如果项目使用 PR 机制参与协作开发,强制推送后运行 git gc 可能不会减小存储库的体积(这是因为存储库需要使用内部引用保持 PR 相应的 commit 的可用性,不被 GC),这个时候用户可以升级套餐,获得更大的存储库容量,或者在 Gitee 上新建一个空存储库,将修改历史记录的存储库推送到新的存储库。使用新的存储库即可。 一些大文件无法用版本控制可以将其使用 Git LFS 管理,用户需要使用 Git LFS 可以查看 Gitee LFS。 对于一些用户由于疏忽已经用完重试次数则可以联系官方团队重置重试次数 最后 无论如何,给用户带来困扰,我们很抱歉,但 Gitee 也是需要不断改进,不断的完善。随着 GNK 迁移完成和前端切换,Gitee 的路由架构改造第一阶段也将完成,这使得用户改名,存储库改名,存储库忽略大小写,fork 能够更容易实现或者更加快速。

优秀的个人博客,低调大师

技术篇-HBase 最佳实践-读性能优化策略

Full GC 问题之前在一些文章里面已经讲过它的来龙去脉,主要的解决方案目前 主要有两方面需要注意,一方面需要查看 GC 日志确认是哪种 Full GC,根据 Full GC 类型对 JVM 参数进行调优,另一方面需要确认是否开启了 BucketCache 的 offheap 模式,建议使用 LRUBlockCache 的童鞋尽快转移到 BucketCache 来。当然我们还是很期待官方 2.0.0 版本发布的更多 offheap 模块。 RIT 问题,我相信更多是因为我们对其不了解,具体原理可以戳这里,解决方案目前有两个,优先是使用官方提供的 HBCK 进行修复(HBCK 本人一直想拿出来分享,但是目前案例还不多,等后面有更多案例的话再拿出来说),使用之后还 是解决不了的话就需要手动修复文件或者元数据表。 而对于写吞吐量太低以及读

优秀的个人博客,低调大师

深入理解JVM(三)——垃圾收集策略详解

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612610 Java虚拟机的内存模型分为五个部分,分别是:程序计数器、Java虚拟机栈、本地方法栈、堆、方法区。 这五个区域既然是存储空间,那么为了避免Java虚拟机在运行期间内存存满的情况,就必须得有一个垃圾收集者的角色,不定期地回收一些无效内存,以保障Java虚拟机能够健康地持续运行。 这个垃圾收集者就是平常我们所说的“垃圾收集器”,那么垃圾收集器在何时清扫内存?清扫哪些数据?这就是接下来我们要解决的问题。 程序计数器、Java虚拟机栈、本地方法栈都是线程私有的,也就是每条线程都拥有这三块区域,而且会随着线程的创建而创建,线程的结束而销毁。那么,垃圾收集器在何时清扫这三块区域的问题就解决了。 此外,Java虚拟机栈、本地方法栈中的栈帧会随着方法的开始而入栈,方法的结束而出栈,并且每个栈帧中的本地变量表都是在类被加载的时候就确定的。因此以上三个区域的垃圾收集工作具有确定性,垃圾收集器能够清楚地知道何时清扫这三块区域中的哪些数据。 然而,堆和方法区中的内存清理工作就没那么容易了。堆和方法区所有线程共享,并且都在JVM启动时创建,一直得运行到JVM停止时。因此它们没办法根据线程的创建而创建、线程的结束而释放。 堆中存放JVM运行期间的所有对象,虽然每个对象的内存大小在加载该对象所属类的时候就确定了,但究竟创建多少个对象只有在程序运行期间才能确定。方法区中存放类信息、静态成员变量、常量。类的加载是在程序运行过程中,当需要创建这个类的对象时才会加载这个类。因此,JVM究竟要加载多少个类也需要在程序运行期间确定。因此,堆和方法区的内存回收具有不确定性,因此垃圾收集器在回收堆和方法区内存的时候花了一些心思。 堆内存的回收 1. 如何判定哪些对象需要回收? 在对堆进行对象回收之前,首先要判断哪些是无效对象。我们知道,一个对象不被任何对象或变量引用,那么就是无效对象,需要被回收。一般有两种判别方式: 引用计数法每个对象都有一个计数器,当这个对象被一个变量或另一个对象引用一次,该计数器加一;若该引用失效则计数器减一。当计数器为0时,就认为该对象是无效对象。 可达性分析法所有和GC Roots直接或间接关联的对象都是有效对象,和GC Roots没有关联的对象就是无效对象。GC Roots是指: Java虚拟机栈所引用的对象(栈帧中局部变量表中引用类型的变量所引用的对象) 方法区中静态属性引用的对象 方法区中常量所引用的对象 本地方法栈所引用的对象PS:注意!GC Roots并不包括堆中对象所引用的对象!这样就不会出现循环引用。 两者对比:引用计数法虽然简单,但存在一个严重的问题,它无法解决循环引用的问题。因此,目前主流语言均使用可达性分析方法来判断对象是否有效。 2. 回收无效对象的过程 当JVM筛选出失效的对象之后,并不是立即清除,而是再给对象一次重生的机会,具体过程如下: 判断该对象是否覆盖了finalize()方法 若已覆盖该方法,并该对象的finalize()方法还没有被执行过,那么就会将finalize()扔到F-Queue队列中; 若未覆盖该方法,则直接释放对象内存。 执行F-Queue队列中的finalize()方法虚拟机会以较低的优先级执行这些finalize()方法们,也不会确保所有的finalize()方法都会执行结束。如果finalize()方法中出现耗时操作,虚拟机就直接停止执行,将该对象清除。 对象重生或死亡如果在执行finalize()方法时,将this赋给了某一个引用,那么该对象就重生了。如果没有,那么就会被垃圾收集器清除。 注意:强烈不建议使用finalize()函数进行任何操作!如果需要释放资源,请使用try-finally。因为finalize()不确定性大,开销大,无法保证顺利执行。 方法区的内存回收 我们知道,如果使用复制算法实现堆的内存回收,堆就会被分为新生代和老年代,新生代中的对象“朝生夕死”,每次垃圾回收都会清除掉大量的对象;而老年代中的对象生命较长,每次垃圾回收只有少量的对象被清除掉。 由于方法区中存放生命周期较长的类信息、常量、静态变量,因此方法区就像是堆的老年代,每次垃圾收集的只有少量的垃圾被清除掉。 方法区中主要清除两种垃圾:1. 废弃常量2. 废弃的类 1. 如何判定废弃常量? 清除废弃的常量和清除对象类似,只要常量池中的常量不被任何变量或对象引用,那么这些常量就会被清除掉。 2. 如何废弃废弃的类? 清除废弃类的条件较为苛刻:1. 该类的所有对象都已被清除2. 该类的java.lang.Class对象没有被任何对象或变量引用只要一个类被虚拟机加载进方法区,那么在堆中就会有一个代表该类的对象:java.lang.Class。这个对象在类被加载进方法区的时候创建,在方法区中该类被删除时清除。3. 加载该类的ClassLoader已经被回收 垃圾收集算法 现在我们知道了判定一个对象是无效对象、判定一个类是废弃类、判定一个常量是废弃常量的方法,也就是知道了垃圾收集器会清除哪些数据,那么接下来介绍如何清除这些数据。 1. 标记-清除算法 首先利用刚才介绍的方法判断需要清除哪些数据,并给它们做上标记;然后清除被标记的数据。 分析:这种算法标记和清除过程效率都很低,而且清除完后存在大量碎片空间,导致无法存储大对象,降低了空间利用率。 2. 复制算法 将内存分成两份,只将数据存储在其中一块上。当需要回收垃圾时,也是首先标记出废弃的数据,然后将有用的数据复制到另一块内存上,最后将第一块内存全部清除。 分析:这种算法避免了碎片空间,但内存被缩小了一半。而且每次都需要将有用的数据全部复制到另一片内存上去,效率不高。 解决空间利用率问题:在新生代中,由于大量的对象都是“朝生夕死”,也就是一次垃圾收集后只有少量对象存活,因此我们可以将内存划分成三块:Eden、Survior1、Survior2,内存大小分别是8:1:1。分配内存时,只使用Eden和一块Survior1。当发现Eden+Survior1的内存即将满时,JVM会发起一次MinorGC,清除掉废弃的对象,并将所有存活下来的对象复制到另一块Survior2中。那么,接下来就使用Survior2+Eden进行内存分配。 通过这种方式,只需要浪费10%的内存空间即可实现带有压缩功能的垃圾收集方法,避免了内存碎片的问题。 但是,当一个对象要申请内存空间时,发现Eden+Survior中剩下的空间无法放置该对象,此时需要进行Minor GC,如果MinorGC过后空闲出来的内存空间仍然无法放置该对象,那么此时就需要将对象转移到老年代中,这种方式叫做“分配担保”。 什么是分配担保?当JVM准备为一个对象分配内存空间时,发现此时Eden+Survior中空闲的区域无法装下该对象,那么就会触发MinorGC,对该区域的废弃对象进行回收。但如果MinorGC过后只有少量对象被回收,仍然无法装下新对象,那么此时需要将Eden+Survior中的所有对象都转移到老年代中,然后再将新对象存入Eden区。这个过程就是“分配担保”。 3. 标记-整理算法 在回收垃圾前,首先将所有废弃的对象做上标记,然后将所有未被标记的对象移到一边,最后清空另一边区域即可。 分析:它是一种老年代的垃圾收集算法。老年代中的对象一般寿命比较长,因此每次垃圾回收会有大量对象存活,因此如果选用“复制”算法,每次需要复制大量存活的对象,会导致效率很低。而且,在新生代中使用“复制”算法,当Eden+Survior中都装不下某个对象时,可以使用老年代的内存进行“分配担保”,而如果在老年代使用该算法,那么在老年代中如果出现Eden+Survior装不下某个对象时,没有其他区域给他作分配担保。因此,老年代中一般使用“标记-整理”算法。 4. 分代收集算法 将内存划分为老年代和新生代。老年代中存放寿命较长的对象,新生代中存放“朝生夕死”的对象。然后在不同的区域使用不同的垃圾收集算法。 Java中引用的种类 Java中根据生命周期的长短,将引用分为4类。 1. 强引用 我们平时所使用的引用就是强引用。A a = new A();也就是通过关键字new创建的对象所关联的引用就是强引用。只要强引用存在,该对象永远也不会被回收。 2. 软引用 只有当堆即将发生OOM异常时,JVM才会回收软引用所指向的对象。软引用通过SoftReference类实现。软引用的生命周期比强引用短一些。 3. 弱引用 只要垃圾收集器运行,软引用所指向的对象就会被回收。弱引用通过WeakReference类实现。弱引用的生命周期比软引用短。 4. 虚引用 虚引用也叫幽灵引用,它和没有引用没有区别,无法通过虚引用访问对象的任何属性或函数。一个对象关联虚引用唯一的作用就是在该对象被垃圾收集器回收之前会受到一条系统通知。虚引用通过PhantomReference类来实现。

优秀的个人博客,低调大师

【短视频SDK】短视频SDK License的策略

1.概述 短视频SDK的使用前提是需要开通License的,否则用户集成SDK将会不可用.目前需要用户提供一些基础信息发送到我们的服务邮箱来保证SDK可用.整体用户需要保证提供的信息的准确性.SDK需要保证服务的稳定性和可用性. 2.需要提供的参数 iOS: 应用bundleIDAndroid:包名和签名信息(MD5、格式小写无冒号) 2.1 bundleId如何获取? 你可以直接使用xCode查看,也可以通过代码获取: //代码段示例 [[NSBundle mainBundle] bundleIdentifier] 2.2 包名和签名信息如何获取? 注:获取签名有个点需要明确,绑定的keystore不一样,得到的MD5信息也不一样,如不指定keystore默认拿到的debug包是自己本地的debug.keystore. 如何指定keystore呢

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册