首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

灵魂 36 问,让你快速熟悉一个系统

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 阿里妹导读:面对一个完全陌生的系统,如何快速的熟悉并上手?本文将从三个方面进行总结,提供一个系统的方法,同时也可以用来 review 已有的系统,查漏补缺。 前言 开发人员经常会面临下面一些场景: 新人入职,需要学习已有系统,作为 landing 的一部分,如何学习? 被拉过去参与一个陌生系统的迭代开发或者系统维护(bugfix),如何快速上手? 同事离职或转岗,需要把系统交接给你,怎么去接?内心 os:这是一口锅吗? 这样的场景多了,就需要去梳理常见问题以及应对方法,方便后续遇到类似场景可以快速应对。本文总结熟悉系统主要分三部分:业务学习、技术学习、实战。每部分会梳理一些在学习过程中需要解答的问题,这些问题随着经验的积累需要逐步补充完善。 业务学习 业务学习就是从业务角度去学习系统,我们需要了解系统的客户是谁、使用人是谁、带来了什么价值,系统提供了哪些功能等。不清楚业务,就等于不知道系统在干什么。技术是为业务落地而服务,清楚了业务才知道怎样用技术更好地服务业务,所以业务学习是熟悉一个系统的首要任务。这块主要的学习方式有跟产品、运营、开发沟通,学习产品设计文档文档、PRD、自己使用系统,还有一些常见图,如产品功能架构图、业务流程图、功能树,用例图等。 常见问题: 系统所在行业的情况是怎样? 系统的目标用户是谁?比如是给公司高层做决策用?给运营或客服用?还是互联网用户用? 平均有多少人在使用?高峰期多有少人在用? 系统有什么业务价值?有哪些指标可以衡量系统业务价值? 系统有哪些功能模块? 系统有哪些领域概念?梳理下系统的领域模型。 系统的关键业务流程有哪些?关键业务流程是怎样? 系统的非功能性需求有哪些?如性能、质量、扩展性、安全性等。 系统未来的发展规划是怎样? 技术学习 技术学习主要学习系统的架构、如何实现、系统的运维等。描述一个系统的架构有五视图方法论,五视图分别是:逻辑架构、开发架构、运行架构、物理架构、数据架构。 逻辑架构 逻辑架构着重考虑功能需求,系统应当向用户提供什么样的服务,关注点主要是行为或职责的划分。常用表达图形,静态图有包图、类图、对象图,动态图有序列图、协作图、状态图、活动图。逻辑架构的核心设计任务是模块划分、接口定义、领域模型细化。 常见问题: 有哪些子系统或模块?系统之间是什么样的关系? 对外上下游接口有哪些?对接人是谁? 关键业务流程怎么实现的?用类图、序列图等方式表达出来。 开发架构 开发架构关主要关注系统源代码、第三方SDK、使用的框架、中间件、工具包。 常见问题: 代码在哪? 包怎么划分的?怎么分层?如 mvc、controller-service-dao。 用了什么框架?如 ssh、dubbo。 用了哪些工具包?如 apache commons、guava。 用了哪些中间件?如 metaq、tair、schedulerX、Diamond。 依赖哪些平台?如权限平台、流程引擎等。 运行架构 运行架构的着重考虑运行期质量属性,关注点是系统的并发、同步、通信等问题,这势必涉及到进程、线程、对象等运行时概念,以及相关的并发、同步、通信等。 常见问题: 系统能支撑多少 qps ?峰值 qps 多少? 与上下游系统怎么交互的?rpc?http?同步还是异步? 物理架构 物理架构的设计着重考虑安装和部署需求,关注点是目标程序及其依赖的运行库和系统软件最终如何安装或部署到物理机器,以及如何部署机器和网络来配合软件系统的可靠性、可伸缩性、持续可用性、性能和安全性等要求。 常见问题: 系统如何发布部署?有哪些部署环境? 系统有多少台机器? 系统部署怎么部署的?关注接入层,部署方式,如集群部署、分布式部署等。 有没有容器化? 有没有多机房部署? 数据架构 数据架构的设计着重考虑数据需求,关注点是持久化数据的存储方案,不仅包括实体及实体关系数据存储格式,还可能包括数据传递、数据复制、数据同步等策略。 常见问题: 数据存储在哪?用了什么数据库,如 oracle、mysql。 梳理 E-R 图。 数据量有多少?是否有分库分表? 用了哪些 nosql 库? 有哪些数据同步任务? 大数据框架的使用情况如何? 系统运维 系统运维重点关注什么时候会出问题,出了问题怎么解决。 常见问题: 什么时间容易出问题?比如电商双十一,对系统的压力很大,这时候很容易出问题。 对关键功能是否有监控?需要看系统有配置了哪些报警项,监控了哪些方面。 出了问题怎么解决?日志在哪?是否有全链路跟踪?是否有一些紧急操作,比如开关配置、降级、限流配置。 系统有哪些坑?找开发同学回顾历史问题,以免踩坑。通过同事总结的 case,或者与负责的产品、运营、技术与了解。系统总会有一些坑,需要把这些坑填上。历史代码经过多次迭代总会导致复杂度高(分支、嵌套、循环很多),存在设计漏洞,性能隐患等,很难维护,这些就需要我们去重构了。记住有一句话:填的坑越大,能力越大。 运营、客服反馈的常见问题有哪些? 实践 熟悉了系统的业务和技术后,就要实战了,通过实战进一步加深对系统的熟悉程度。实践可以通过做需求、修 bug、重构等方式,亲自动手编码、调试、测试、上线。 总结 已有系统通常经历了从 0 到 N 的建设过程,熟悉系统其实是一个逆向推导过程,也是一个学习架构、阅读源码的过程。在学习的过程中最好能带上思考,比如为什么要这么设计,为什么要用这个中间件?是否有更好的编码方式?哪些地方可以优化等,以此达到一个深入熟悉的过程。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-03本文作者:唐志龙(鲲龙)本文来自:“阿里技术公众号”,了解相关信息可以关注“阿里技术”

优秀的个人博客,低调大师

面试必问的时间复杂度到底怎么算

高级工程师title的我,最近琢磨着好好刷刷算法题更高级一些,然鹅,当我准备回忆大学和面试时候学的数据结构之时,我发现自己对这个算法复杂度的记忆只有OOOOOooo 文章收录在 GitHub JavaKeeper ,N线互联网开发必备技能兵器谱 算法(Algorithm)是指用来操作数据、解决程序问题的一组方法。对于同一个问题,使用不同的算法,也许最终得到的结果是一样的,但在过程中消耗的资源和时间却会有很大的区别。 那么我们应该如何去衡量不同算法之间的优劣呢? 主要还是从算法所占用的「时间」和「空间」两个维度去考量。 时间维度:是指执行当前算法所消耗的时间,我们通常用「时间复杂度」来描述。 空间维度:是指执行当前算法需要占用多少内存空间,我们通常用「空间复杂度」来描述。 因此,评价一个算法的效率主要是看它的时间复杂度和空间复杂度情况。然而,有的时候时间和空间却又是「鱼和熊掌」,不可兼得的,那么我们就需要从中去取一个平衡点。 时间复杂度 一个算法执行所耗费的时间,从理论上是不能算出来的,必须上机运行测试才能知道。但我们不可能也没有必要对每个算法都上机测试,只需知道哪个算法花费的时间多,哪个算法花费的时间少就可以了。并且一个算法花费的时间与算法中语句的执行次数成正比例,哪个算法中语句执行次数多,它花费时间就多。一个算法中的语句执行次数称为语句频度或「时间频度」。记为T(n)。 时间频度T(n)中,n称为问题的规模,当n不断变化时,时间频度T(n)也会不断变化。但有时我们想知道它变化时呈现什么规律,为此我们引入时间复杂度的概念。算法的时间复杂度也就是算法的时间度量,记作:T(n) = O(f(n))。它表示随问题规模n的增大,算法执行时间的增长率和f(n)的增长率相同,称作算法的渐进时间复杂度,简称「时间复杂度」。 这种表示方法我们称为「 大O符号表示法 」,又称为渐进符号,是用于描述函数渐进行为的数学符号 常见的时间复杂度量级有: 常数阶$O(1)$ 线性阶$O(n)$ 平方阶$O(n^2)$ 立方阶$O(n^3)$ 对数阶$O(logn)$ 线性对数阶$O(nlogn)$ 指数阶$O(2^n)$ 常数阶$O(1)$ $O(1)$,表示该算法的执行时间(或执行时占用空间)总是为一个常量,不论输入的数据集是大是小,只要是没有循环等复杂结构,那这个代码的时间复杂度就都是O(1),如: int i = 1; int j = 2; int k = i + j; 上述代码在执行的时候,它消耗的时候并不随着某个变量的增长而增长,那么无论这类代码有多长,即使有几万几十万行,都可以用$O(1)$来表示它的时间复杂度。 线性阶$O(n)$ $O(n)$,表示一个算法的性能会随着输入数据的大小变化而线性变化,如 for (int i = 0; i < n; i++) { j = i; j++; } 这段代码,for循环里面的代码会执行n遍,因此它消耗的时间是随着n的变化而变化的,因此这类代码都可以用$O(n)$来表示它的时间复杂度。 平方阶$O(n^2)$ $O(n²)$ 表示一个算法的性能将会随着输入数据的增长而呈现出二次增长。最常见的就是对输入数据进行嵌套循环。如果嵌套层级不断深入的话,算法的性能将会变为立方阶$O(n^3)$,$O(n^4)$,$O(n^k)$以此类推 for(x=1; i<=n; x++){ for(i=1; i<=n; i++){ j = i; j++; } } 指数阶$O(2^n)$ $O(2^n)$,表示一个算法的性能会随着输入数据的每次增加而增大两倍,典型的方法就是裴波那契数列的递归计算实现 int Fibonacci(int number) { if (number <= 1) return number; return Fibonacci(number - 2) + Fibonacci(number - 1); } 对数阶$O(logn)$ int i = 1; while(i<n) { i = i * 2; } 上面的代码,在while循环里面,每次都将 i 乘以 2,乘完之后,i 距离 n 就越来越近了,直到i不小于n退出。我们试着求解一下,假设循环次数为x,也就是说 2 的 x 次方等于 n,则由2^x=n得出x=log₂n。因此这个代码的时间复杂度为$O(logn)$ 线性对数阶$O(nlogn)$ 线性对数阶$O(nlogn) $,就是将时间复杂度为对数阶$O(logn)$的代码循环n遍的话,那么它的时间复杂度就是 n * O(logN),也就是了$O(nlogn)$,如下, for(m=1; m<n; m++) { i = 1; while(i<n) { i = i * 2; } } 除此之外,其实还有平均情况复杂度、最好时间复杂度、最坏时间复杂度。。。一般没有特殊说明的情况下,都是值最坏时间复杂度。 空间复杂度 空间复杂度(Space Complexity)是对一个算法在运行过程中临时占用存储空间大小的一个量度,同样反映的是一个趋势,一个算法所需的存储空间用f(n)表示。S(n)=O(f(n)),其中n为问题的规模,S(n)表示空间复杂度。 一个算法在计算机存储器上所占用的存储空间,包括存储算法本身所占用的存储空间,算法的输入输出数据所占用的存储空间和算法在运行过程中临时占用的存储空间这三个方面。 一般情况下,一个程序在机器上执行时,除了需要存储程序本身的指令、常数、变量和输入数据外,还需要存储对数据操作的存储单元。若输入数据所占空间只取决于问题本身,和算法无关,这样只需要分析该算法在实现时所需的辅助单元即可。若算法执行时所需的辅助空间相对于输入数据量而言是个常数,则称此算法为原地工作,空间复杂度为O(1)。当一个算法的空间复杂度与n成线性比例关系时,可表示为$0(n)$,类比时间复杂度。 空间复杂度比较常用的有:O(1)、O(n)、O(n²) 空间复杂度 $O(1)$ 如果算法执行所需要的临时空间不随着某个变量n的大小而变化,即此算法空间复杂度为一个常量,可表示为 O(1)举例: int i = 1; int j = 2; ++i; j++; int m = i + j; 代码中的 i、j、m 所分配的空间都不随着处理数据量变化,因此它的空间复杂度 S(n) = O(1) 空间复杂度 $O(n)$ int[] m = new int[n] for(i=1; i<=n; ++i) { j = i; j++; } 这段代码中,第一行new了一个数组出来,这个数据占用的大小为n,这段代码的2-6行,虽然有循环,但没有再分配新的空间,因此,这段代码的空间复杂度主要看第一行即可,即 S(n) = O(n) 复杂度速查表 来源:https://liam.page/2016/06/20/big-O-cheat-sheet/ 源地址:https://www.bigocheatsheet.com/ 图例 大-O 复杂度曲线 抽象数据结构的操作复杂度 数组排序 图操作 堆操作 参考 《大话数据结构》https://zhuanlan.zhihu.com/p/50479555

优秀的个人博客,低调大师

一文彻底搞懂面试中常问的各种“锁”

前言 锁,顾名思义就是锁住一些资源,当只有我们拿到钥匙的时候,才能操作锁住的资源。在我们的Java,数据库,还有一些分布式的环境中,总是充斥着各种各样的锁让人头疼,例如“公平锁”、“自旋锁”、“读写锁”、“分布式锁”等等。 其实真实的情况是,锁并没有那么多,很多概念只是从不同的功能特性,设计,以及锁的状态这些不同的侧重点来说明的,因此我们可以根据不同的分类来搞明白为什么会有这些“锁”?坐稳扶好了,准备开车。 正文 “公平锁”与“非公平锁” 公平锁:指线程在等待获取同一个锁的时候,是严格按照申请锁的时间顺序来进行的,这就意味着在程序正常运作的时候,不会有线程执行不到,而被“饿死”,但是也需要额外的机制来维护这种顺序,所以效率相对于非公平锁会差点。 非公平锁:概念跟“公平锁”恰恰相反,随机线程获取锁,相率相对高。 newReentrantLock();//默认非公平锁newReentrantLock(true);//公平锁 “重入锁(递归锁)”与“不可重入锁(自旋锁)” 这里要注意了,重入/递归,不可重入/自旋,虽然名字不同,但是确实是同一种锁,只是从锁的表现跟实现方式的角度来命名而已。 重入锁:当一个线程获取了A锁以后,若后续方法运行被A锁锁住的话,当前线程也是可以直接进入的。 publicclassDemo{ private Lock lockA; publicDemo(LockLock){this.lockA=lock; } publicvoidmethodA(){ lockA.lock(); methodB(); lockA.unlock(); } publicvoidmethodB(){ lockA.lock();//dosm lockA.unlock(); } } 当我们运行methodA()的时候,线程获取了lockA,然后调用methodB()的时候发现也需要lockA,由于这是一个可重入锁,所以当前线程也是可以直接进入的。在java中,synchronized跟ReetrantLock都是可重入锁。 不可重入锁:以上面的代码实例来说明,就是methodA进入methodB的时候不能直接获取锁,必须先调用unLock释放锁。才能执行下去,那实现不可重入锁有什么方式呢?那就是自旋,所以会有一个小名叫做自旋锁。​​​​​​​ public class SpinLock { private AtomicReference<Thread> sign =new AtomicReference<>(); public void lock(){ Thread current = Thread.currentThread(); while(!sign .compareAndSet(null, current)){ } } public void unlock (){ Thread current = Thread.currentThread(); sign .compareAndSet(current, null); }} “悲观锁”与“乐观锁” 这两种锁呢,其实是一个很宏观的分类,它不是一种具体的锁,而是泛指看待并发的程度。 悲观锁:有一个“悲观”的心态,既每次取数据的时候,都会认为该数据会被修改,所以必须加一把锁才安心。 乐观锁:乐观的孩子,认为同一个数据不会发生并发操作的行为,所以取的时候不会加锁,只有在更新的时候,会通过例如版本号之类的来判断是否数据被修改了。 Java中各种锁其实都是悲观锁的实现,既操作的数据的都会被获取锁的线程锁住,而乐观锁的话,一般是通过cas(compare and swap)的思想来实现,例如一些原子类AtomicInteger使用自旋来原子更新。 “共享锁”与“排他锁” 这两种锁的概念比较多的出现在数据库的事务当中。 共享锁:也称读锁或S锁。如果事务对数据A加上共享锁后,则其他事务只能对A再加共享锁,不能加排它锁。获准共享锁的事务只能读数据,不能修改数据。在java中的ReetrantReadWriteLock()也是如此。 排它锁:也称独占锁、写锁或X锁。如果事务对数据A加上排它锁后,则其他事务不能再对A加任何类型的锁。获得排它锁的事务即能读数据又能修改数据。 分布式锁 我们上面聊的这些锁,都是在单个程序上面的不同线程之间来实现的,那么当我们的不同程序需要去竞争同一块资源的时候,这就需要分布式锁了,我们可以通过redis、zookeeper等中间件来实现分布式锁。 对于锁来说,其实还有偏向锁,轻量级锁等,但是这里涉及到的内容就比较多,这里就不在展开篇幅介绍了,有兴趣的同学可自行研究,如果你能搞懂上面介绍的这些锁,那基本上在绝大部分的公司关于“锁”的问题都可以迎刃而解。 喜欢的话,麻烦大家点个赞~关注一下微信公众号《深夜里的程序猿》,每天分享最干的干货~

优秀的个人博客,低调大师

以后再也不怕别人问「单链表」的问题啦 。

写在之前 自打刷题以来 ,有不少于 10 个小伙伴问及链表问题 。因为 python 和 C不太一样 ,没有指针的概念 ,所以 python 中为模拟链表 ,今天分享的这篇文章系统的捋了一下 。 在程序设计里,我们经常需要将同为某个类型的一组数据元素作为一个整体来使用,需要创建这种元素组,用变量来记录它们或者传入函数等等等等,「线性表」就是这样一组元素的抽象,它是某类元素的集合并且记录着元素之间一种顺序关系,是最基本的数据结构之一,在实际程序中运用非常广泛,比如 Python 中的 list 和 tuple 都可以看作是线性表的实现。 基于各种实际操作等方面的综合考虑,我们提出了两种实现线性表的形式:「顺序表」和「链表」。 「顺序表」是将表中的元素顺序存放在一大块连续的存储区间里,所以在这里元素间的顺序是由它们的存储顺序来表示的。「链表」则是将表中元素存放在一系列的结点中(结点的存储位置可以是连续的,可以是不连续的,也就意味着它们可以存在任何内存未被占用的位置),这些结点通过连接构造起来,结点分为「数据域」和「指针域」。这次我们要学习的「单链表」就是「链表」的一种实现形式,「数据域」保存着作为表元素的数据项,「指针域」保存同一个表里的下一个结点的标识。 在正式说「单链表」之前,我先来说一下很多人在学习链表之初都傻傻分不清的两个东西:「头结点」和「头指针」。 「头结点」的设立是为了操作的统一和方便,是放在第一个元素的节点之前,它的数据域一般没有意义,并且它本身也不是链表必须要带的。那设立头节点的目的是什么呢?其实就是为了在某些时候可以更方便的对链表进行操作,有了头结点,我们在对第一个元素前插入或者删除结点的时候,它的操作与其它结点的操作就统一了。 「头指针」顾名思义,是指向链表第一个结点的指针,如果有头结点的话,那么就是指向头结点的指针。它是链表的必备元素且无论链表是否为空,头指针都不能为空,因为在访问链表的时候你总得知道它在什么位置,这样才能通过它的指针域找到下一个结点的位置,也就是说知道了头指针,整个链表的元素我们都是可以访问的,所以它必须要存在,这也就是我们常说的「标识」,这也就是为什么我们一般用头指针来表示链表。 单链表 n 个结点链接成一个链表,这也就是平时书上所说的「链式存储结构」,因为这个链表中的每个结点中只包含一个指针域,所以又叫「单链表」。单链表正是通过每个结点的指针域将线性表的数据元素按其逻辑次序链接在一起。单链表的第一个结点的存储位置叫做「头指针」,最后一个结点的指针为「空」,一般用 “^” 表示。 上图是不带头结点的单链表,下面我们来看一下带头结点的单链表: 还有一种是空链表: 通过上面 3 个图我们发现无论单链表是否为空,是否有头结点,头指针都是存在的,这就很好的印证了之前我们所说的「头指针是链表的必备元素且无论链表是否为空,头指针都不能为空」。 为了方便后续的操作,我们一般会先定义一个简单的结点类: classNode(object): def__init__(self,data): self.data = data self.next= None 单链表的基本操作 首先我们先来创建一个链表类: classLinkList(object): def__init__(self): self.head = Node(None) # 判断链表是否为空 defIsEmpty(self): p =self.head# 头指针 ifp.next==None: print("List is Empty") returnTrue returnFalse # 打印链表 defPrintList(self): ifself.IsEmpty(): returnFalse p =self.head whilep: print(p.data,end=' ') p = p.next 1.创建单链表 创建单链表的过程其实就是一个动态生成链表的过程,说简单点就是从一个「空链表」开始,依次建立各个元素的结点,并把它们逐个插入链表,时间复杂度为 O(n): defInitList(self,data): self.head = Node(data[0])# 头结点 p =self.head# 头指针 foriindata[1:]: node = Node(i) p.next= node p = p.next 下面我们来测试一下: #test lst = LinkList() data = [1, 4, 5, 8, 2, 3] lst.InitList(data) lst.PrintList() 输出结果如下: 1 4 5 8 2 3 2.计算单链表的长度 在使用链表的时候,经常需要求表的长度,为此我们可以创建一个球表长的函数,这个函数就是从左到右扫描,遍历表中的所有结点并完成计数,时间复杂度为 O(n): defLengthList(self): ifself.IsEmpty(): return0 p =self.head cnt =0 whilep: cnt +=1 p = p.next returncnt 下面我们来测试一下: #test lst = LinkList() data = [1, 4, 5, 8, 2, 3] lst.InitList(data) print(lst.LengthList()) 输出的结果如下: 6 3.单链表的插入 假设我们要将结点 s 插入到 结点 p 的后面,只需要将结点 s 插入到结点 p 和 结点 p.next 之间即可,说起来简单,那么到底如何插入呢?请看下图: 由上图我们可以看到,单链表结点的插入根本不需要惊动其它结点,只需要让 s.next 和 p.next 的指针稍作改变即可。让 p 的后继结点改为 s 的后继结点,再把 s 的后继结点变成 p 的后继结点。这里一定要切记,插入操作的顺序不能改变,至于为什么,你可以拿起纸笔手动的画一下,结果一下子就会出来(对于单链表的表头和表尾的特殊情况,操作是相同的)。 # 单链表的插入(在第 s 个结点后面插入 data) defInsertList(self,s,data): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Insert failed!") return p =self.head index =1 whileindex <s: p = p.next index +=1 node = Node(data) node.next= p.next p.next= node 下面我们来测试一下: #test lst = LinkList() data = [1, 4, 5, 8, 2, 3] lst.InitList(data) lst.InsertList(0,666) lst.PrintList() 输出的结果如下: 1 666 4 5 8 2 3 4.单链表删除 看完插入,我们现在再来看看单链表的删除。假设我们想要删除一个结点 q,其实就是将它的前继结点 p 的指针绕过 q,直接指向 q 的后继结点即可,具体操作如下图所示: 由上图可以看出,我们只需要一步就可以实现删除操作,那就是让 p.next 直接为 p 的 next 的 next,p 的 next 为 q,所以也就是 p.next = q.next,时间复杂度为 O(n)。 # 单链表的删除(删除第 s 个结点) defDeleteList(self, s): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Delete failed! ") return p =self.head index =1 whileindex <s: pre = p index +=1 p = p.next pre.next= p.next p = None 由 p = None 可以看出,在 Python 中,只需要简单的将指针赋值为 None,就抛弃了链表原有的结点,Python 解释器的存储管理系统会自动回收不用的存储。 下面我们来测试一下: #test lst = LinkList() data = [1, 4, 5, 8, 2, 3] lst.InitList(data) lst.DeleteList(3) lst.PrintList() 输出的结果如下: 1 4 8 2 3 5.单链表的读取 在顺序结构中,我们想要获取任意一个元素的存储位置是很容易的,但是在单链表中,第 i 个元素到底在哪我们一开始没办法知道,只能傻傻的从头开始找,所以在对于单链表获取第 i 个元素的操作,算法上相对麻烦一些。 # 单链表的读取(获取第 s 个结点的值) defGetList(self, s): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Read failed! ") return p =self.head index =1 whileindex <s: index +=1 p = p.next print("第 {} 个值为 {}".format(s, p.data)) 从上面的代码我们可以很清楚的看出,单链表获取第 i 个元素就是从头开始找,知道第 i 个元素为止,所以我们可以很容易的估算出它的时间复杂度是 O(n)。任何事物都不是完美的,有好的地方就有坏的地方,元素的读取就是单链表美中不足的地方之一。 写在之后 单链表的操作其实还有不少,我只是写了其中常用的几种,希望大家能自己动手尝试一下,把这几个搞懂搞透。碰到这样的问题从哪个方面去思考,如何去做才是最重要的,只有学会了这些,你在日后碰到相关问题的时候就知道如何去下手。 我在上面每个操作的讲解中大多数给出了图,通过图来看解法题目了然。算法这个东西其实就是这样,多动手实现以下,想不明白了就动手画一下,画着画着思路就出来了。 最后我们就来总结一下链表操作的时间复杂度,如果你还不会估算算法的时间复杂度,请看我的循序渐进带你学习时间复杂度和空间复杂度。 ●创建空表 O(1)。 ●创建单链表 O(n) ●插入元素:首端插入为 O(1);尾端插入为 O(n),因为还要找到表的最后结点;定位插入 为O(n)。 ●删除元素:首端删除为 O(1);尾端删除为 O(n),理由如上;定位删除为 O(n)。 以下是上述所有操作的代码汇总: # 结点类 classNode(object): def__init__(self,data): self.data = data self.next= None # 链表类 classLinkList(object): def__init__(self): self.head = Node(None) # 判断链表是否为空 defIsEmpty(self): p =self.head# 头指针 ifp.next==None: print("List is Empty") returnTrue returnFalse # 打印链表 defPrintList(self): ifself.IsEmpty(): returnFalse p =self.head whilep: print(p.data,end=' ') p = p.next # 创建单链表 defInitList(self,data): self.head = Node(data[0])# 头结点 p =self.head# 头指针 foriindata[1:]: node = Node(i) p.next= node p = p.next # 单链表的长度 defLengthList(self): ifself.IsEmpty(): return0 p =self.head cnt =0 whilep: cnt +=1 p = p.next returncnt # 单链表的插入(在第 s 个结点后面插入 data) defInsertList(self,s,data): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Insert failed!") return p =self.head index =1 whileindex <s: p = p.next index +=1 node = Node(data) node.next= p.next p.next= node # 单链表的删除(删除第 s 个结点) defDeleteList(self, s): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Delete failed! ") return p =self.head index =1 whileindex <s: pre = p index +=1 p = p.next pre.next= p.next p = None # 单链表的读取(获取第 s 个结点的值) defGetList(self, s): ifself.IsEmpty()ors <0ors >self.LengthList(): print("Read failed! ") return p =self.head index =1 whileindex <s: index +=1 p = p.next print("第 {} 个值为 {}".format(s, p.data)) 原文发布时间为:2018-11-2 本文作者:Rocky0429 本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”。

优秀的个人博客,低调大师

干货分享|Java异常经典14问,你都能答对吗?

1、什么是Java中的异常? 异常是在程序执行期间可能发生的错误事件,并且会中断它的正常流程。异常可能来自不同类型的情况,例如用户输入的错误数据,硬件故障,网络连接故障等。 每当执行java语句时发生任何错误,都会创建一个异常对象,然后JRE会尝试查找异常处理程序来处理异常。如果找到合适的异常处理程序,则将异常对象传递给处理程序代码以处理异常,称为捕获异常。如果未找到处理程序,则应用程序将异常抛出到运行时环境,JRE将终止该程序。 Java异常处理框架仅用于处理运行时错误,编译时错误不由异常处理框架处理。 2、Java中的异常处理关键字是什么? java异常处理中使用了四个关键字。 throw:有时我们明确要创建异常对象然后抛出它来停止程序的正常处理。throw关键字用于向运行时抛出异常来处理它。 throws:当我们在方法中抛出任何已检查的异常而不处理它时,我们需要在方法签名中使用throws关键字让调用者程序知道该方法可能抛出的异常。调用方法可以处理这些异常或使用throws关键字将其传播给它的调用方法。我们可以在throws子句中提供多个异常,也可以与main()方法一起使用。 try-catch:我们在代码中使用try-catch块进行异常处理。try是块的开始,catch是在try块的末尾处理异常。我们可以使用try有多个catch块,try-catch块也可以嵌套。catch块需要一个应该是Exception类型的参数。 finally:finally块是可选的,只能用于try-catch块。由于异常会暂停执行过程,因此我们可能会打开一些不会关闭的资源,因此我们可以使用finally块。finally块总是被执行,无论是否发生异常。 3、解释Java异常层次结构? Java异常是分层的,继承用于对不同类型的异常进行分类。Throwable是Java Exceptions Hierarchy的父类,它有两个子对象 - Error和Exception。异常进一步分为检查异常和运行时异常。 错误是超出应用程序范围的特殊情况,并且无法预测并从中恢复,例如硬件故障,JVM崩溃或内存不足错误。 Checked Exceptions是我们可以在程序中预期并尝试从中恢复的特殊情况,例如FileNotFoundException。我们应该捕获此异常并向用户提供有用的消息并正确记录以进行调试。Exception是所有Checked Exceptions的父类。 运行时异常是由错误的编程引起的,例如尝试从Array中检索元素。我们应该在尝试检索元素之前先检查数组的长度,否则它可能会ArrayIndexOutOfBoundException在运行时抛出。RuntimeException是所有运行时异常的父类。 4、Java异常类的重要方法是什么? 异常及其所有子类不提供任何特定方法,并且所有方法都在基类Throwable中定义。 String getMessage() - 此方法返回消息String of Throwable,并且可以在通过构造函数创建异常时提供消息。 String getLocalizedMessage() - 提供此方法,以便子类可以覆盖它以向调用程序提供特定于语言环境的消息。此方法getMessage()的可抛出类实现只是使用方法来返回异常消息。 synchronized Throwable getCause() - 此方法返回异常的原因或null id,原因未知。 String toString() - 此方法以String格式返回有关Throwable的信息,返回的String包含Throwable类和本地化消息的名称。 void printStackTrace() - 此方法将堆栈跟踪信息打印到标准错误流,此方法已重载,我们可以将PrintStream或PrintWriter作为参数传递,以将堆栈跟踪信息写入文件或流。 5、解释Java 7 ARM功能和multi-catch块? 如果你在一个try块中捕获了很多异常,你会发现catch块代码看起来非常难看,并且主要由冗余代码组成,以记录错误,记住Java 7的一个特性是multi-catch块。我们可以在一个catch块中捕获多个异常。具有此功能的catch块如下所示: catch(IOException | SQLException | Exception ex){ logger.error(ex); throw new MyException(ex.getMessage()); } 大多数情况下,我们使用finally块来关闭资源,有时我们忘记关闭它们并在资源耗尽时获得运行时异常。这些异常很难调试,我们可能需要查看我们使用该类资源的每个地方,以确保我们关闭它。所以java 7的改进之一是try-with-resources,我们可以在try语句中创建一个资源并在try-catch块中使用它。当执行来自try-catch块时,运行时环境会自动关闭这些资源。具有这种改进的try-catch块样本是: try (MyResource mr = new MyResource()) { System.out.println("MyResource created in try-with-resources"); } catch (Exception e) { e.printStackTrace(); } 6、Java中Checked和Unchecked Exception有什么区别? Checked Exceptions应该使用try-catch块在代码中处理,否则方法应该使用throws关键字让调用者知道可能从方法抛出的已检查异常。未经检查的异常不需要在程序中处理或在方法的throws子句中提及它们。 Exception是所有已检查异常RuntimeException的超类,而是所有未经检查的异常的超类。请注意,RuntimeException是Exception的子类。 已检查的异常是需要在代码中处理的错误方案,否则您将收到编译时错误。例如,如果您使用FileReader读取文件,它会抛出FileNotFoundException,我们必须在try-catch块中捕获它或将其再次抛给调用方法。 未经检查的异常主要是由编程不良引起的,例如在对象引用上调用方法时的NullPointerException,而不确保它不为null。例如,我可以编写一个方法来从字符串中删除所有元音。确保不传递空字符串是调用者的责任。我可能会改变方法来处理这些场景,但理想情况下,调用者应该处理这个问题。 7、Java中throw和throws关键字有什么区别? throws关键字与方法签名一起用于声明方法可能抛出的异常,而throw关键字用于破坏程序流并将异常对象移交给运行时来处理它。 8、如何在Java中编写自定义异常? 我们可以扩展Exception类或其任何子类来创建我们的自定义异常类。自定义异常类可以拥有自己的变量和方法,我们可以使用它们将错误代码或其他与异常相关的信息传递给异常处理程序。 自定义异常的一个简单示例如下所示。 package com.journaldev.exceptions; import java.io.IOException; public class MyException extends IOException { private static final long serialVersionUID = 4664456874499611218L; private String errorCode="Unknown_Exception"; public MyException(String message, String errorCode){ super(message); this.errorCode=errorCode; } public String getErrorCode(){ return this.errorCode; } } 9、Java中的OutOfMemoryError是什么? Java中的OutOfMemoryError是java.lang.VirtualMachineError的子类,当JVM用完堆内存时,它会抛出它。我们可以通过提供更多内存来通过java选项运行java应用程序来修复此错误。 $>java MyProgram -Xms1024m -Xmx1024m -XX:PermSize=64M -XX:MaxPermSize=256m 10、主线程中的异常”有哪些不同的情况? 一些常见的主线程异常情况是: 主线程java.lang.UnsupportedClassVersionError中的异常: 当您的java类是从另一个JDK版本编译并且您尝试从另一个Java版本运行它时,会出现此异常。 主线程java.lang.NoClassDefFoundError中的异常: 此异常有两种变体。第一个是您提供类全名和.class扩展名的地方。第二种情况是找不到Class。 主线程java.lang.NoSuchMethodError中的异常: main:当您尝试运行没有main方法的类时会出现此异常。 线程“main”中的异常java.lang.ArithmeticException: 每当从main方法抛出任何异常时,它都会打印异常是控制台。第一部分解释了从main方法抛出异常,第二部分打印异常类名,然后在冒号后打印异常消息。 11、Java中的final,finally和finalize有什么区别? final和finally是java中的关键字,而finalize是一种方法。 final关键字可以与类变量一起使用,以便它们不能被重新分配,类可以避免按类扩展,并且使用方法来避免子类覆盖。 finally关键字与try-catch块一起使用,以提供始终执行的语句即使出现一些异常,通常最终也会用来关闭资源。 finalize()方法由垃圾收集器在销毁对象之前执行,这是确保关闭所有全局资源的好方法。 在三者之中,最后只涉及到java异常处理。 12、当main方法抛出异常时会发生什么? 当main()方法抛出异常时,Java Runtime终止程序并在系统控制台中打印异常消息和堆栈跟踪。 13、我们可以有一个空的catch块吗? 我们可以有一个空的catch块,但它是最差编程的例子。我们永远不应该有空的catch块,因为如果异常被该块捕获,我们将没有关于异常的信息,并且它将成为调试它的噩梦。应该至少有一个日志记录语句来记录控制台或日志文件中的异常详细信息。 14、提供一些Java异常处理最佳实践? 与Java异常处理相关的一些最佳实践是: 使用特定异常以便于调试。 在程序中尽早抛出异常(Fail-Fast)。 在程序后期捕获异常,让调用者处理异常。 使用Java 7 ARM功能确保资源已关闭或使用finally块正确关闭它们。 始终记录异常消息以进行调试。 使用multi-catch块清洁关闭。 使用自定义异常从应用程序API中抛出单一类型的异常。 遵循命名约定,始终以Exception结束。 记录在javadoc中使用@throws的方法抛出的异常。 异常是昂贵的,所以只有在有意义的时候抛出它。否则,您可以捕获它们并提供空或空响应。 原文发布时间为:2018-10-21 本文作者: Java技术驿站 本文来自云栖社区合作伙伴“ Java技术驿站”,了解相关信息可以关注“ Java技术驿站”。

优秀的个人博客,低调大师

十问 | 关于Service Mesh 和Kubernets的最前沿思考

小蚂蚁说: 在7月6日ArchSummit全球架构师峰会2018深圳站上,蚂蚁金服平台数据技术部的杨冰、Service Mesh布道师敖小剑、蚂蚁金服技术专家毛小云和来自阿里大文娱UC基础部的曾彬,四位技术专家围绕着Service Mesh和Kubernets领域最前沿的问题展开了深度的讨论。本文是此次讨论实录。 嘉宾组成背景:蚂蚁金服中间件团队和阿里大文娱UC基础部,在云原生/K8S/Service Mesh等多个共同领域都有长期探索和深度积累,在双方的共同推动下,在基于Kubernetes的PaaS及周边基础设施、Service Mesh大规模落地实践、中间件和应用云原生探索方向上展开合作共建。 Q1:蚂蚁金服近期在对外发布的文章和线下活动中频频提到 Service Mesh的概念,能否介绍一下? 敖小剑:Service Mesh是

优秀的个人博客,低调大师

关于Java锁机制面试官会怎么问

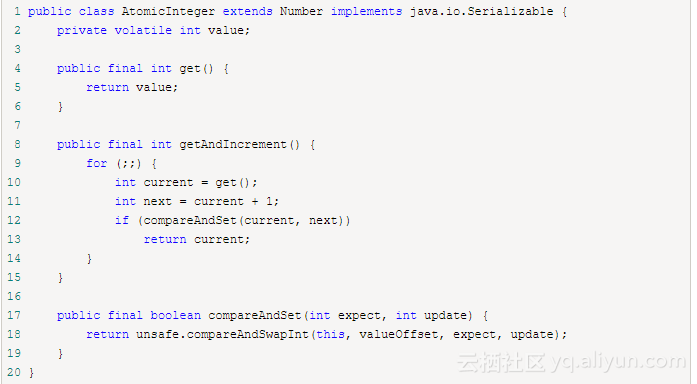
乐观锁与悲观锁 悲观锁:总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。再比如Java里面的同步原语synchronized关键字的实现也是悲观锁。 乐观锁:顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库提供的类似于write_condition机制,其实都是提供的乐观锁。在Java中java.util.concurrent.atomic包下面的原子变量类就是使用了乐观锁的一种实现方式CAS实现的。 乐观锁的一种实现方式-CAS(Compare and Swap 比较并交换): 锁存在的问题 Java在JDK1.5之前都是靠synchronized关键字保证同步的,这种通过使用一致的锁定协议来协调对共享状态的访问,可以确保无论哪个线程持有共享变量的锁,都采用独占的方式来访问这些变量。这就是一种独占锁,独占锁其实就是一种悲观锁,所以可以说 synchronized 是悲观锁。 悲观锁机制存在以下问题: 在多线程竞争下,加锁、释放锁会导致比较多的上下文切换和调度延时,引起性能问题。 一个线程持有锁会导致其它所有需要此锁的线程挂起。 如果一个优先级高的线程等待一个优先级低的线程释放锁会导致优先级倒置。 对比于悲观锁的这些问题,另一个更加有效的锁就是乐观锁。其实乐观锁就是:每次不加锁而是假设没有并发冲突而去完成某项操作,如果因为并发冲突失败就重试,直到成功为止。 乐观锁 乐观锁( Optimistic Locking)在上文已经说过了,其实就是一种思想。相对悲观锁而言,乐观锁假设认为数据一般情况下不会产生并发冲突,所以在数据进行提交更新的时候,才会正式对数据是否产生并发冲突进行检测,如果发现并发冲突了,则让返回用户错误的信息,让用户决定如何去做。 上面提到的乐观锁的概念中其实已经阐述了它的具体实现细节:主要就是两个步骤:冲突检测和数据更新。其实现方式有一种比较典型的就是 Compare and Swap ( CAS )。 CAS CAS是乐观锁技术,当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值,而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试。 CAS 操作中包含三个操作数 —— 需要读写的内存位置(V)、进行比较的预期原值(A)和拟写入的新值(B)。如果内存位置V的值与预期原值A相匹配,那么处理器会自动将该位置值更新为新值B。否则处理器不做任何操作。无论哪种情况,它都会在 CAS 指令之前返回该位置的值。(在 CAS 的一些特殊情况下将仅返回 CAS 是否成功,而不提取当前值。)CAS 有效地说明了“ 我认为位置 V 应该包含值 A;如果包含该值,则将 B 放到这个位置;否则,不要更改该位置,只告诉我这个位置现在的值即可。 ”这其实和乐观锁的冲突检查+数据更新的原理是一样的。 这里再强调一下,乐观锁是一种思想。CAS是这种思想的一种实现方式。 JAVA对CAS的支持:在JDK1.5 中新增 java.util.concurrent (J.U.C)就是建立在CAS之上的。相对于对于 synchronized 这种阻塞算法,CAS是非阻塞算法的一种常见实现。所以J.U.C在性能上有了很大的提升。 以 java.util.concurrent 中的 AtomicInteger 为例,看一下在不使用锁的情况下是如何保证线程安全的。主要理解 getAndIncrement 方法,该方法的作用相当于 ++i 操作。 在没有锁的机制下,字段value要借助volatile原语,保证线程间的数据是可见性。这样在获取变量的值的时候才能直接读取。然后来看看 ++i 是怎么做到的。getAndIncrement 采用了CAS操作,每次从内存中读取数据然后将此数据和 +1 后的结果进行CAS操作,如果成功就返回结果,否则重试直到成功为止。而 compareAndSet 利用JNI(Java Native Interface)来完成CPU指令的操作: 那么比较this == expect,替换this = update,compareAndSwapInt实现这两个步骤的原子性呢? 参考CAS的原理。 CAS原理:CAS通过调用JNI的代码实现的。而compareAndSwapInt就是借助C来调用CPU底层指令实现的。下面从分析比较常用的CPU(intel x86)来解释CAS的实现原理。下面是sun.misc.Unsafe类的compareAndSwapInt()方法的源代码: 如上面源代码所示,程序会根据当前处理器的类型来决定是否为cmpxchg指令添加lock前缀。如果程序是在多处理器上运行,就为cmpxchg指令加上lock前缀(lock cmpxchg)。反之,如果程序是在单处理器上运行,就省略lock前缀(单处理器自身会维护单处理器内的顺序一致性,不需要lock前缀提供的内存屏障效果)。 CAS缺点: ABA问题:比如说一个线程one从内存位置V中取出A,这时候另一个线程two也从内存中取出A,并且two进行了一些操作变成了B,然后two又将V位置的数据变成A,这时候线程one进行CAS操作发现内存中仍然是A,然后one操作成功。尽管线程one的CAS操作成功,但可能存在潜藏的问题。如下所示: 现有一个用单向链表实现的堆栈,栈顶为A,这时线程T1已经知道A.next为B,然后希望用CAS将栈顶替换为B:head.compareAndSet(A,B);在T1执行上面这条指令之前,线程T2介入,将A、B出栈,再pushD、C、A,此时堆栈结构如下图,而对象B此时处于游离状态: 此时轮到线程T1执行CAS操作,检测发现栈顶仍为A,所以CAS成功,栈顶变为B,但实际上B.next为null,所以此时的情况变为: 其中堆栈中只有B一个元素,C和D组成的链表不再存在于堆栈中,平白无故就把C、D丢掉了。从Java1.5开始JDK的atomic包里提供了一个类AtomicStampedReference来解决ABA问题。这个类的compareAndSet方法作用是首先检查当前引用是否等于预期引用,并且当前标志是否等于预期标志,如果全部相等,则以原子方式将该引用和该标志的值设置为给定的更新值。 循环时间长开销大: 自旋CAS(不成功,就一直循环执行,直到成功)如果长时间不成功,会给CPU带来非常大的执行开销。如果JVM能支持处理器提供的pause指令那么效率会有一定的提升,pause指令有两个作用,第一它可以延迟流水线执行指令(de-pipeline),使CPU不会消耗过多的执行资源,延迟的时间取决于具体实现的版本,在一些处理器上延迟时间是零。第二它可以避免在退出循环的时候因内存顺序冲突(memory order violation)而引起CPU流水线被清空(CPU pipeline flush),从而提高CPU的执行效率。 只能保证一个共享变量的原子操作: 当对一个共享变量执行操作时,我们可以使用循环CAS的方式来保证原子操作,但是对多个共享变量操作时,循环CAS就无法保证操作的原子性,这个时候就可以用锁,或者有一个取巧的办法,就是把多个共享变量合并成一个共享变量来操作。比如有两个共享变量i=2,j=a,合并一下ij=2a,然后用CAS来操作ij。从Java1.5开始JDK提供了AtomicReference类来保证引用对象之间的原子性,你可以把多个变量放在一个对象里来进行CAS操作。 CAS与Synchronized的使用情景 1、对于资源竞争较少(线程冲突较轻)的情况,使用synchronized同步锁进行线程阻塞和唤醒切换以及用户态内核态间的切换操作额外浪费消耗cpu资源;而CAS基于硬件实现,不需要进入内核,不需要切换线程,操作自旋几率较少,因此可以获得更高的性能。 2、对于资源竞争严重(线程冲突严重)的情况,CAS自旋的概率会比较大,从而浪费更多的CPU资源,效率低于synchronized。 补充:synchronized在jdk1.6之后,已经改进优化。synchronized的底层实现主要依靠Lock-Free的队列,基本思路是自旋后阻塞,竞争切换后继续竞争锁,稍微牺牲了公平性,但获得了高吞吐量。在线程冲突较少的情况下,可以获得和CAS类似的性能;而线程冲突严重的情况下,性能远高于CAS。 concurrent包的实现 由于java的CAS同时具有 volatile 读和volatile写的内存语义,因此Java线程之间的通信现在有了下面四种方式: A线程写volatile变量,随后B线程读这个volatile变量。 A线程写volatile变量,随后B线程用CAS更新这个volatile变量。 A线程用CAS更新一个volatile变量,随后B线程用CAS更新这个volatile变量。 A线程用CAS更新一个volatile变量,随后B线程读这个volatile变量。 Java的CAS会使用现代处理器上提供的高效机器级别原子指令,这些原子指令以原子方式对内存执行读-改-写操作,这是在多处理器中实现同步的关键(从本质上来说,能够支持原子性读-改-写指令的计算机器,是顺序计算图灵机的异步等价机器,因此任何现代的多处理器都会去支持某种能对内存执行原子性读-改-写操作的原子指令)。同时,volatile变量的读/写和CAS可以实现线程之间的通信。把这些特性整合在一起,就形成了整个concurrent包得以实现的基石。如果我们仔细分析concurrent包的源代码实现,会发现一个通用化的实现模式: 首先,声明共享变量为volatile; 然后,使用CAS的原子条件更新来实现线程之间的同步; 同时,配合以volatile的读/写和CAS所具有的volatile读和写的内存语义来实现线程之间的通信。 AQS,非阻塞数据结构和原子变量类(java.util.concurrent.atomic包中的类),这些concurrent包中的基础类都是使用这种模式来实现的,而concurrent包中的高层类又是依赖于这些基础类来实现的。从整体来看,concurrent包的实现示意图如下: JVM中的CAS(堆中对象的分配) Java调用new object()会创建一个对象,这个对象会被分配到JVM的堆中。那么这个对象到底是怎么在堆中保存的呢? 首先,new object()执行的时候,这个对象需要多大的空间,其实是已经确定的,因为java中的各种数据类型,占用多大的空间都是固定的(对其原理不清楚的请自行Google)。那么接下来的工作就是在堆中找出那么一块空间用于存放这个对象。 在单线程的情况下,一般有两种分配策略: 指针碰撞:这种一般适用于内存是绝对规整的(内存是否规整取决于内存回收策略),分配空间的工作只是将指针像空闲内存一侧移动对象大小的距离即可。 空闲列表:这种适用于内存非规整的情况,这种情况下JVM会维护一个内存列表,记录哪些内存区域是空闲的,大小是多少。给对象分配空间的时候去空闲列表里查询到合适的区域然后进行分配即可。 但是JVM不可能一直在单线程状态下运行,那样效率太差了。由于在给一个对象分配内存的时候不是原子性的操作,至少需要以下几步:查找空闲列表、分配内存、修改空闲列表等等,这是不安全的。解决并发时的安全问题也有两种策略: CAS:实际上虚拟机采用CAS配合上失败重试的方式保证更新操作的原子性,原理和上面讲的一样。 TLAB:如果使用CAS其实对性能还是会有影响的,所以JVM又提出了一种更高级的优化策略:每个线程在Java堆中预先分配一小块内存,称为本地线程分配缓冲区(TLAB),线程内部需要分配内存时直接在TLAB上分配就行,避免了线程冲突。只有当缓冲区的内存用光需要重新分配内存的时候才会进行CAS操作分配更大的内存空间。 虚拟机是否使用TLAB,可以通过-XX:+/-UseTLAB参数来进行配置(jdk5及以后的版本默认是启用TLAB的)。 原文发布时间为:2018-07-05本文来自云栖社区合作伙伴“Java架构沉思录”,了解相关信息可以关注“Java架构沉思录”。

优秀的个人博客,低调大师

公有云迁移前必问的三个问题

许多公司认为公有云是托管所有应用的最佳场所,但情况并非总是如此。在您享用云带来的低成本之前,请确保该举措的确会带来成本效益。 由于公有云的可扩展性、速度和即付即用模式,对许多企业来说,公有云是一个很有吸引力的选择。但是这些好处并不适用于所有的工作——实际上,一些应用可能在云中表现不佳或成本更高。 这意味着,在将应用迁移到公共基础设施即服务(IaaS)平台之前,您需要确保此举能提供业务价值。 首先,了解您要迁移到云上的动机。您想要更低的成本吗? 您需要更多的灵活性吗? 一些企业很快地就转移到云上,只因为他们认为应该这样做,这可能会导致将来发生问题。 在决定大规模将应用迁移到公有云之前,请先从以下三个问题开始: 如何选择要迁移的应用? 评估您的应用,并检查其需求——无论是性能还是合规性,以确定它是否是公有云的合适候选者。检查应用是否有任何特定的网络需求或依赖项。除非您还同时迁移应用所依赖的系统,包括数据库,否则延迟可能是一个问题。此外,在将应用迁移到云端之前,请查看应用的设计;例如,经常读取和写入存储系统的应用可能会导致更多的处理费用。一般来说,“突发”或频繁出现高峰需求的应用非常适合于公有云,而运行在更一致、可预测基础上的应用在本地可能会更好。 云供应商提供诸如Azure Cloud Migration Assessment和Amazon Web Services(AWS)Application Discovery Service等工具来简化评估过程。 AWS,Azure和Google还提供定价计算器来估算云成本。 另外,确定您选择的云供应商是否符合您对安全性和合规性的要求。看看他们的数据中心在哪里,特别是如果您有敏感数据需要遵守严格的合规性标准的时候。 应该采用哪种迁移方式?在确定要迁移的应用之后,就要确定迁移方法。两个常见的选项是rehost(重新托管),也称为lift-and-shift,以及refactor(重构),也称为rearchitect(重新架构)。 由于开发人员不必更改应用的架构或设计,因此lift-and-shift过程所需的时间比重构的时间要少,因为它们只是按原样移动。但是,尽管lift-and-shift是一种更简单的方法,但它也有缺点。例如,如果您将应用迁移到IaaS而无需任何修改,那么可能无法利用关键的云特性:自动缩放。其结果是,这些应用的运行方式仍然与本地部署的系统相同——在高峰期,企业将为实际使用的云存储和计算资源付出更多的代价。 因此,对于一些旧的应用来说,重新构建或重构是一个更好的选择——即使它更耗时且成本高昂。另一方面,lift-and-shift最适合云灾难的恢复。 不要太快地将应用迁移到云上——从最适配于云并且敏感数据最少的应用开始。在运行一个试点之后,测试应用,了解该过程,然后再转移到更关键的应用上。 有哪些云迁移工具可供选择?迁移是一个复杂的过程,伴随着风险和潜在的高成本。云供应商和第三方工具都可以帮助企业完成此过程。例如,Microsoft Assessment和Planning Toolkit可以帮助IT团队将应用迁移到Microsoft Azure,而像Cloudyn和CloudVelox这样的第三方工具也可以发挥作用。 如果企业需要将大量的数据迁移到云端,则还可以执行脱机数据迁移。这需要企业将其数据存储到物理磁盘上,然后将磁盘运送给云供应商。虽然这种方法可能看起来有些老套,但如果您有TB级的数据,那么它可能比通过网络的迁移更具成本效益。顶级云供应商的离线数据迁移服务包括AWS Snowball,AWS Snowmobile,Google Transfer Appliance和Azure Import / Export。本文转自d1net(转载)

优秀的个人博客,低调大师

7问7答谈容器 Mesosphere工程师专访

容器的出现彻底改变了现代软件开发和操作的方式。 日前, JAXenter就容器工具、技术以及其在DevOps环境中的用途,对JAX DevOps演讲者、Mesosphere分布式应用工程师Johannes Unterstein进行了相关采访。 JAXenter: Mesosphere首席执行官Florian Leibert曾在一篇博客文章中表示,“容器2.0是在同一组资源上运行(和编排)无状态和有状态服务的能力。”您怎么看? Johannes Unterstein:持久性是当今容器技术面临的挑战之一。 无状态容器很容易处理:例如,失败后它们可以在每个节点上重新启动。 然而有状态的容器就不是那么容易了。 想想看,在某些网络问题修复后,如果具有持久数据的容器在另一个实例已启动时恢复联机,会发生什么? 容器2.0解决了有状态容器和与“大数据”框架(如Spark,Cassandra,Kafka)的组合,理想的在与容器相同的集群上运行。 JAXenter:容器2.0已经来临? 它是什么样子 - 它的关键要素是什么? Johannes Unterstein:当然,在JAX DevOps会议上都是关于容器2.0的,数据中心所有部分之间的资源(CPU,内存,磁盘)共享以及DC / OS可以帮助您以最有效的方式使用集群。 在数据中心内进行静态分区时,需要根据峰值和故障单独优化每个部分。 如果您的基础架构能够在微服务,传统数据库以及大数据和快速数据应用程序之间共享,那么您可以在扩展,利用率和容错能力方面更灵活,并且还能够节省节点。 JAXenter:容器的下一步将会如何? Johannes Unterstein:容器领域最近增添了许多新颖趣味性。 在当前的讨论中,我特别感兴趣的是速度水平的变化。此外, 关注不同标准的发展也很有趣,如CNI网络。 JAXenter:你最喜欢的容器工具是什么? Johannes Unterstein:关于这点也许我有点偏见,因为我正在帮助构建DC / OS,但事实上我确实很喜欢使用DC / OS。 我喜欢DC / OS和底层Apache Mesos的灵活性,以运行Docker容器,AppC镜像容器或Apache Mesos本身隔离(也称为容器化)的常规程序。 除此之外,您还可以选择是否要使用Docker Daemon,或者直接在Mesos universal containerizer上运行Docker镜像。 JAXenter:为什么开发人员对容器技术那么感兴趣? Johannes Unterstein:因为它可以让你的生活更轻松。 容器使得在一个单独的归档中共享具有所有依赖性的应用程序变得非常容易,这在每个合适的容器运行时都是可执行的。例如Docker hub这样的基础设施可以使开发人员在需要多个shell命令启动一个特定应用程序时的时间更短。另一大优点就是使用容器可以使我们获得思考-容器的内部需求到底是什么。 JAXenter:容器是否可用于实现DevOps? Johannes Unterstein:当然。 当谈到记录依赖和轻松共享应用程序时,我们正在使建立自动化基础设施变得更加容易。 现在,您可以轻松共享和启动不依赖于主机的应用程序。DC / OS这样的工具可以支持运行你的容器格局,公开API来开发自动化。 JAXenter:参与者可以从JAX DevOps会议中学到什么? Johannes Unterstein:本次会议的主题是关于容器2.0以及如何保持它们在生产环境中运行的最佳实践。 当前容器技术使我们能够在整个数据中心内动态地启动容器,但是我们仍然在我们的应用程序中有一些持久的数据。我们希望保留我们的数据,即使容器发生故障,或者更糟糕的是如果整个节点发生故障。另一方面,运行大数据和快速数据应用程序需要大量的节点,通常具有与容器不同的调度策略。 最大限度地提高集群资源利用率并在扩展和容错方面更灵活,避免静态集群分区并在同一数据中心运行应用程序的部分是很好的。 通常,一旦POC成功部署,评估就会停止,但是在我的经验中,实际的挑战就是保持其运行,不论是升级还是出现上述故障情况。 这就是为什么我们将花一些时间讨论所谓的操作的最佳实践,包括监控,调试,升级和故障处理。 本文转自d1net(转载)

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册