首页 文章 精选 留言 我的

精选列表

搜索[基础软件],共10000篇文章
优秀的个人博客,低调大师

最全 MongoDB 基础教程

MongoDB 创建数据库 - 格式:use DATABASE_NAME - use ruochen - db 创建数据库需要插入一条数据才会在列表中显示 - db.ruochen.insert({'name': '若尘'}) - show dbs 删除数据库 格式:db.dropDatabase() use ruochen db.dropDatabase() show dbs 创建集合 - 格式:db.createCollection(name, options) - name: 要创建的集合名称 - options: 可选参数,指定有关内存大小及索引的选项 字段 类型 描述 capped 布尔 (可选)如果为 true,则创建固定集合。固定集合是指有着固定大小的集合,当达到最大值时,它会自动覆盖最早的文档。当该值为 true 时,必须指定 size 参数。 autoIndexId 布尔 (可选)如为 true,自动在 _id 字段创建索引。默认为 false。 size 数值 (可选)为固定集合指定一个最大值,以千字节计(KB)。如果 capped 为 true,也需要指定该字段。 max 数值 (可选)指定固定集合中包含文档的最大数量。 在插入文档时,MongoDB 首先检查固定集合的 size 字段,然后检查 max 字段 实例 # 在test数据库中创建ruochen 集合 use test db.createCollection('ruochen') # 查看已有集合 show collections db.createCollection('test', {capped: true, autoIndexId: true, size: 1024000, max: 10000}) # autoIndexId 已弃用,默认_id添加索引 # 插入文档时,MongoDB会自动创建集合 db.ruochen.insert({'name': 'ruochen'}) 删除集合 格式:db.collection.drop() use ruochen db.createCollection('ruochen') # 创建集合 show tables db.ruochen.drop() show tables 插入文档 格式:db.COLLECTION_NAME.insert(document) 方法1 db.ruochen.insert({title: 'MongoDB 教程', description: 'shu ju ku', by: 'ruochen', tags: ['mongodb', 'database', 'NoSQL'] }) db.ruochen.find() 方法2 document=({title: 'mongodb', description: 'shu ju ku', by: 'ruochen', tags: ['mongodb', 'database', 'NoSQL'] }) db.ruochen.insert(document) db.ruochen.find() db.collection.insertOne() # 向指定集合中插入一条文档数据 db.collection.insertMany() # 向指定集合中插入多条文档数据 var document = db.ruochen.insertOne({"e": 3}) document var res = db.ruochen.insertMany([{'a': 1}, {'b': 2}]) res 一次插入多条数据 先创建数组 将数据放在数据中 一次insert到集合中 案例 var arr = []; for(var i = 1; i < 5; i++){ arr.push({num:i});} db.num.insert(arr); 更新文档 格式 db.collection.update( <query>, <update>, { upsert: <boolean>, multi: <boolean>, writeConcern: <ducument> } ) query: update的查询条件,类似sql update查询内where后面的 update: update的对象和一些更新的操作符(如$,$inc...)等,也可以理解为sql update查询内set后面的 upsert: 可选,这个参数的意思是,如果不存在update的记录,是否插入objNew,true为插入,默认是false,不插入 multi: 可选,mongodb 默认是false,只更新找到的第一条记录,如果这个参数为true,就把按条件查出来多条记录全部更新 writeConcern: 可选,抛出异常的级别 案例 db.ruochen.insert({ title: 'mongodb', description: 'Nosql 数据库', by: 'ruochen', tags: ['mongodb', 'databases', 'NoSQL'] }) db.ruochen.update({'title': 'mongodb'}, {$set:{'title': 'MongoDB'}}) # 只会修改第一条发现的文档 db.ruochen.find().pretty() db.ruochen.update({'title': 'mongodb'}, {$set:{'title': 'MongoDB'}}, {multi:true}) # 修改多条相同的文档 save() 方法: 通过传入的文档来替换已有文档 格式 db.collection.save( <document>, { writeConcern: <document> } ) document: 文档数据 writeConcern: 可选,抛出异常的级别 案例 db.ruochen.save({ "_id" : ObjectId("5e631a14c17b253e9cef40cc"), "title" : "MongoDB", "description" : "MongoDB 是一个 Nosql 数据库", "by" : "Runoob", "url" : "http://www.runoob.com", "tags" : [ "mongodb", ] }) db.ruochen.find().pretty() 删除文档 语法: db.collection.remove( <query>, <justOne> ) 2.6版本以后语法格式 db.collection.remove( <query> { justOne: <boolean>, writeConcern: <document> } ) 参数说明 query: (可选) 删除的文档的条件 justOne: (可选) 如果设为 true 或 1,则只删除一个文档,如果不设置该参数,或使用默认值 false,则删除所有匹配条件的文档 writeConcern: (可选) 抛出异常的级别 db.ruochen.remove({'title': 'mongodb'}) # 只删除第一条找到的记录 db.COLLECTION_NAME.remove(DELETION_CRITHRIA, 1) # 删除所有数据 db.ruochen.remove({}) db.ruochen.find() # remove() 方法 并不会真正释放空间 # 需要执行db.repairDatabase() 来回收磁盘空间 db.repairDatabase() db.runCommand({repairDatabase: 1}) remove方法已经过时 # 删除集合下所有文档 db.ruochen.deleteMany({}) # 删除 num 等于1 的全部文档 db.ruochen.deleteMany({num: '1'}) # 删除 num 等于1 的一个文档 db.ruochen.deleteOne({num: '1'}) 查询文档 语法: db.collection.find(query, projection) 参数说明 query: 可选,使用查询操作符指定查询条件 projection: 可选,使用投影操作符指定返回的键。查询时返回文档中所有键值, 只需省略该参数即可(默认省略) # 以易读的方式读取数据 db.ruochen.find().pretty() 操作 格式 范例 RDBMS中的类似语句 等于 {key:value} db.ruochen.find({'by':'ruochen'}).pretty() where by = 'ruochen' 小于 {key:{$lt: value}} db.ruochen.find({'likes': {$lt:3}}).pretty() where likes < 3 小于或等于 {key:{$lte: value}} db.ruochen.find({'likes': {$lte:2}}).pretty() where likes <= 2 大于 {key:{$gt: value}} db.ruochen.find({'likes': {$gt:100}}).pretty() where likes > 100 大于等于 {key:{$gte: value}} db.ruochen.find({'likes': {$gte:200}}).pretty() where likes >= 200 不等于 {key:{$ne: value}} db.ruochen.find({'likes': {$ne:200}}).pretty() where likes != 200 AND条件 find() 方法可以传入多个键(key),每个键(key)以逗号隔开,即常规 SQL 的 AND 条件 格式: db.ruochen.find({key1: value1, key2: value2}).pretty() 案例 db.ruochen.find({'by': 'ruochen', 'likes': 200}).pretty() 类似于 where by='ruochen' and likes=200 or条件 格式 db.ruochen.find( { $or:[ {key1: value1}, {key2: value2} ] } ).pretty() 案例 db.ruochen.find({$or:[{'likes': 2}, {'likes':200}]}).pretty() AND和OR联合 db.ruochen.find({'likes': {$gt:100}, $or: [{'likes': 2}, {'likes': 200}]}).pretty() 条件操作符 db.ruochen.insert({ title: 'python', description: 'i love python', by: 'ruochen', url: 'xxx', tags: ['python'], likes: 200 }) db.ruochen.insert({ title: 'php', description: 'php是世界上最好的语言', by: 'ruochen', url: 'xxx', tags: ['php'], likes: 150 }) db.ruochen.insert({ title: 'MondoDB', description: 'NoSQL数据库', by: 'ruochen', url: 'xxx', tags: ['mongodb'], likes: 100 }) # 获取 'ruochen' 集合中 'likes' 大于100的数据 db.ruochen.find({likes: {$gt: 100}}).pretty() # 类似于SQL语句 Select * from ruochen where likes > 100; 获取 'ruochen' 集合中 'likes' 大于等于100的数据 db.ruochen.find({likes: {$gte: 100}}).pretty() # 类似于SQL语句 Select * from ruochen where likes >= 100; # 获取 'ruochen' 集合中 'likes' 小于150的数据 db.ruochen.find({likes: {$lt: 150}}).pretty() # 类似于SQL语句 Select * from ruochen where likes < 150; # 获取 'ruochen' 集合中 'likes' 小于等于150的数据 db.ruochen.find({likes: {$lte: 150}}).pretty() # 类似于SQL语句 Select * from ruochen where likes <= 150; MongoDB 使用 (<) 和 (>) 查询 - $lt 和 $gt 获取"ruochen"集合中 "likes" 大于100,小于 200 的数据 db.ruochen.find({likes: {$lt: 200, $gt: 100}}).pretty() 类似SQL语句 Select * from ruochen where likes > 100 and likes < 200; 模糊查询 查询title中包含 'py' 的文档 db.ruochen.find({title:/py/}).pretty() 查询title字段以 'p' 开头的文档 db.ruochen.find({title:/^p/}).pretty() 查询title 字段以 'p' 结尾的文档 db.ruochen.find({title:/p$/}).pretty() MongoDB $type 操作符 $type操作符是基于BSON类型来检索集合中匹配的数据类型,并返回结果 类型 数字 备注 Double 1 String 2 Object 3 Array 4 Binary data 5 Undedined 6 已废弃 Object id 7 Boolean 8 Date 9 Null 10 Regular Experssion 11 JavaScript 13 Symbol 14 JavaScript(with scope) 15 32-bit integer 16 Timestamp 17 64-bit integer 18 Min key 255 Query with -1 Max key 127 获取 "ruochen" 集合中 title 为 String 的数据 db.ruochen.find({'title': {$type: 2}}).pretty() db.ruochen.find({'title': {$type: String}}).pretty() Limit与Skip方法 Limit() 方法 在MongoDB中读取指定数量的数据记录, 使用MongoDB的Limit方法 limit()方法接受一个数字参数,该参数指定从MongoDB中读取的记录条数 语法 db.COLLECTION_NAME.find().limit(NUMBER) 案例 db.ruochen.find().limit(2) Skip() 方法 skip()方法跳过指定数量的数据 skip方法接受一个数字参数作为跳过的记录条数 语法 db.COLLECTION_NAME.find().limit(NUMBER).skip(NUMBER) 案例 db.ruochen.find().limit(1).skip(1) skip() 方法默认参数为0 MongoDB 排序 sort() 方法 sort() 方法可以通过参数指定排序的字段,并使用 1 和 -1 来指定排序的方式,其中 1 为升序排列,而 -1 是用于降序排列 语法 db.COLLECTION_NAME.find().sort({key: 1}) 案例 ruochen 集合中的数据按字段 likes 的降序排列 db.ruochen.find().sort({'likes': -1}).pretty() skip(), limilt(), sort()三个放在一起执行的时候,执行的顺序是先 sort(), 然后是 skip(),最后是显示的 limit()。 MongoDB 索引 creatIndex() 方法 MongoDB使用 createIndex() 方法来创建索引 语法 db.collection.createIndex(keys, options) Key 值为你要创建的索引字段, 1 为指定按升序创建索引, -1 为降序创建索引 案例 db.ruochen.createIndex({'title': 1}) db.ruochen.createIndex({'title': 1, 'description': -1}) # 设置多个字段创建索引 createIndex() 接收可选参数,可选参数列表如下 Parameter Type Description background Boolean 建索引过程会阻塞其它数据库操作,background可指定以后台方式创建索引,即增加 "background" 可选参数。 "background" 默认值为false unique Boolean 建立的索引是否唯一。指定为true创建唯一索引。默认值为false name string 索引的名称。如果未指定,MongoDB的通过连接索引的字段名和排序顺序生成一个索引名称 dropDups Boolean 3.0+版本已废弃。在建立唯一索引时是否删除重复记录,指定 true 创建唯一索引。默认值为 false sparse Boolean 对文档中不存在的字段数据不启用索引;这个参数需要特别注意,如果设置为true的话,在索引字段中不会查询出不包含对应字段的文档.。默认值为 false expireAfterSeconds integer 指定一个以秒为单位的数值,完成 TTL设定,设定集合的生存时间 v index version 索引的版本号。默认的索引版本取决于mongod创建索引时运行的版本 weights document 索引权重值,数值在 1 到 99,999 之间,表示该索引相对于其他索引字段的得分权重 default_language string 对于文本索引,该参数决定了停用词及词干和词器的规则的列表。 默认为英语 language_override string 对于文本索引,该参数指定了包含在文档中的字段名,语言覆盖默认的language,默认值为 language MongoDB聚合 MongoDB聚合(aggregate)主要用于处理数据(诸如统级平均值、求和等), 并返回计算后的数据结果。有点类似sql语句中的count(*) aggregate() 方法 语法 db.COLLECTION_NAME.aggregate(AGGREGATE_OPERATION) 实例 db.ruochen.aggregate([{$group: {_id: "$by", num_tutorial: {$sum: 1}}}]) 类似于mql语句 select by, count(*) from ruochen group by by 聚合表达式 表达式 描述 实例 $sum 计算总和 db.ruochen.aggregate([{$group: {_id: "$by", num_tutorial: {$sum: "$likes"}}}]) $avg 平均值 db.ruochen.aggregate([{$group: {_id: "$by", avg: {$avg: "$likes"}}}]) $min 获取集合中所有文档对应值的最小值 db.ruochen.aggregate([{$group: {_id: "$by", min: {$min: "$likes"}}}]) $max 获取集合中所有文档对应值的最大值 db.ruochen.aggregate([{$group: {_id: "$by", min: {$max: "$likes"}}}]) $push 在结果文档中插入值到一个数组中 db.ruochen.aggregate([{$group: {_id: "$by", url: {$push: "$url"}}}]) $addToSet 在结果文档中插入值到一个数组中,但不创建副本 db.ruochen.aggregate([{$group: {_id: "$by", url: {$addToSet: "$url"}}}]) $first 根据资源文档的排序获取第一个文档数据 db.ruochen.aggregate([{$group: {_id: "$by", url: {$first: "$url"}}}]) $last 根据资源文档的排序获取最后一个文档数据 db.ruochen.aggregate([{$group: {_id: "$by", url: {$last: "$url"}}}]) 管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的参数 MongoDB的聚合管道将MongoDB文档在一个管道处理完毕后将结果传递给下一个管道处理 管道操作是可以重复的 表达式:处理文档并输出 表达式是无状态的,只能用于计算当前聚合管道的文档,不能处理其它的文档 常用操作 $project:修改输入文档的结构。可以用来重命名、增加或删除域,也可以用于创建计算结果以及嵌套文档 $match:用于过滤数据,只输出符合条件的文档。$match使用MongoDB的标准查询操作 $limit:用来限制MongoDB聚合管道返回的文档数 $skip:在聚合管道中跳过指定数量的文档,并返回余下的文档 $unwind:将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 $group:将集合中的文档分组,可用于统计结果 $sort:将输入文档排序后输出 $geoNear:输出接近某一地理位置的有序文档 举例 $project db.ruochen.aggregate( { $project: { title: 1, by: 1, }} ); 只剩_id, title 和 by 三个字段,默认_id 字段被包含 db.ruochen.aggregate( { $project: { _id: 0 title: 2, by: 1, }} ); 如此即可不包含_id, 非0可表示显示字段,负数也可以表示显示该字段 $match 获取分数大于70或小于等于90的记录,然后把符合条件的记录送到下一阶段$group 管道操作符进行处理 db.ruochen.aggregate([ {$match: {score: {$gt: 70, $lte: 90}}}, {$group: {_id: null, count: {$sum: 1}}} ]) 当 match 条件和 group 同时存在时,顺序会影响检索结果,必须先写 match 在前面 $skip 过滤前5个文档 db.ruochen.aggregate( {$skip: 5});

优秀的个人博客,低调大师

JS基础知识整合

1、执行环境:有时也叫环境,是JavaScript中最为重要的一个概念,执行环境定义了变量或函数有权访问的其他数据。 2、变量对象:每一个执行环境都有一个与之关联的变量对象,环境中定义的所有的变量和函数都保存在这个的对象中。 3、作用域链:代码在环境中执行时,会创建变量对象的作用域链,保证对执行环境有权访问的所有变量和函数的有序访问。作用域链的前端,始终是当前执行代码所在环境的变量对象。 4、活动对象:如果当前执行环境是函数,则将活动对象作为变量对象。 5、可执行代码: 1)全局代码:例如加载外部的JS文件或者本地标签内的代码,全局代码不包括function体内的代码; 2)函数代码:function体内的代码; 3) eval代码:eval()函数计算某个字符串,并执行其中的JS代码,比如 eval("alert('helloworld')")。 6、执行上下文栈:在一个JS程序中,必定会产生多个执行上下文,JS引擎会以栈的方式来处理它们,也就是执行上下文栈。 7、作用域:JS是一种没有块级作用域的语言(包括if、for等语句的花括号代码块或者单独的花括号代码块都不能形成一个局部作用域),所以js的局部作用域的形成有且只有函数的花括号内定义的代码块形成的,既函数作用域。 8、作用域链:是作用域规则的实现,通过作用域链的实现,变量在它的作用域内可被访问,函数在它的作用域内可被调用。 作用域链是一个只能单向访问的链表,这个链表上的每个节点就是执行上下文的变量对象,单向链表的头部(可被第一个访问的节点)始终都是当前正在被调用执行的函数的变量对象(活动对象),尾部始终是全局活动对象。 9、闭包:函数对象可以通过作用域链相互关联起来,函数体内的数据(变量和函数声明)都可以保存在函数作用域内,这种特性在计算机科学文献中被称为“闭包”。 从技术角度来说,JS的函数都是闭包:函数都是对象,都关联到作用域链,函数内数据都被保存在函数作用域内。

优秀的个人博客,低调大师

线程最最基础的知识

Java 多线程系列文章第 5 篇。 什么是线程 试想一下没有线程的程序是怎么样的?百度网盘在上传文件时就无法下载文件了,得等文件上传完成后才能下载文件。这个我们现在看起来很反人性,因为我们习惯了一个程序同时可以进行运行多个功能,而这些都是线程的功劳。 之前的文章 进程知多少 中讲到,为了实现多个程序并行执行,引入了进程概念。现在引入线程是为了让一个程序能够并发执行。 线程的组成 线程ID:线程标识符。 当前指令指针(PC):指向要执行的指令。 寄存器集合:存储单元寄存器的集合。 堆栈:暂时存放数据和地址,一般用来保护断点和现场。 线程与进程区别 线程和进程之间的区别,我觉得可以用这个例子来看出两者的不同,进程就是一栋房子,房子住着 3 个人,线程就是住在房子里的人。进程是一个独立的个体,有自己的资源,线程是在进程里的,多个线程共享着进程的资源。 线程状态 我们看到 Java 源代码里面,线程状态的枚举有如下 6 个。 public enum State { //新建状态 NEW, //运行状态 RUNNABLE, //阻塞状态 BLOCKED, //等待状态 WAITING, //等待状态(区别在于这个有等待的时间) TIMED_WAITING, //终止状态 TERMINATED; } 下面给这 6 个状态一一做下解释。 NEW:新建状态。在创建完 Thread ,还没执行 start() 之前,线程的状态一直是 NEW。可以说这个时候还没有真正的一个线程映射着,只是一个对象。 RUNNABLE:运行状态。线程对象调用 start() 之后,就进入 RUNNABLE 状态,该状态说明在 JVM 中有一个真实的线程存在。 BLOCKED:阻塞状态。线程在等待锁的释放,也就是等待获取 monitor 锁。 WAITING:等待状态。线程在这个状态的时候,不会被分配 CPU,而且需要被显示地唤醒,否则会一直等待下去。 TIMED_WAITING:超时等待状态。这个状态的线程也一样不会被分配 CPU,但是它不会无限等待下去,有时间限制,时间一到就停止等待。 TERMINATED:终止状态。线程执行完成结束,但不代表这个对象已经没有了,对象可能还是存在的,只是线程不存在了。 线程既然有这么多个状态,那肯定就有状态机,也就是在什么情况下 A 状态会变成 B 状态。下面就来简单描述一下。 结合下图,我们 new 出线程类的时候,就是 NEW 状态,调用 start() 方法,就进入了 RUNNABLE 状态,这时如果触发等待,则进入了 WAITING 状态,如果触发超时等待,则进入 TIMED_WAITING 状态,当访问需要同步的资源时,则只有一个线程能访问,其他线程就进入 BLOCKED 状态,当线程执行完后,进入 TERMINATED 状态。 其实在 JVM 中,线程是有 9 个状态,如下所示,有兴趣的同学可以深入了解一下。 javaClasses.hpp enum ThreadStatus { NEW = 0, RUNNABLE = JVMTI_THREAD_STATE_ALIVE + // runnable / running JVMTI_THREAD_STATE_RUNNABLE, SLEEPING = JVMTI_THREAD_STATE_ALIVE + // Thread.sleep() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_SLEEPING, IN_OBJECT_WAIT = JVMTI_THREAD_STATE_ALIVE + // Object.wait() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_INDEFINITELY + JVMTI_THREAD_STATE_IN_OBJECT_WAIT, IN_OBJECT_WAIT_TIMED = JVMTI_THREAD_STATE_ALIVE + // Object.wait(long) JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_IN_OBJECT_WAIT, PARKED = JVMTI_THREAD_STATE_ALIVE + // LockSupport.park() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_INDEFINITELY + JVMTI_THREAD_STATE_PARKED, PARKED_TIMED = JVMTI_THREAD_STATE_ALIVE + // LockSupport.park(long) JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_PARKED, BLOCKED_ON_MONITOR_ENTER = JVMTI_THREAD_STATE_ALIVE + // (re-)entering a synchronization block JVMTI_THREAD_STATE_BLOCKED_ON_MONITOR_ENTER, TERMINATED = JVMTI_THREAD_STATE_TERMINATED }; Java 线程实现 下面讲一讲在 Java 中如何创建一个线程。众所周知,实现 Java 线程有 2 种方式:继承 Thread 类和实现 Runnable 接口。 继承 Thread 类 继承 Thread 类,重写 run() 方法。 class MyThread extends Thread { @Override public void run() { System.out.println("MyThread"); } } 实现 Runnable 接口 实现 Runnable 接口,实现 run() 方法。 class MyRunnable implements Runnable { public void run() { System.out.println("MyRunnable"); } } 这 2 种线程的启动方式也不一样。MyThread 是一个线程类,所以可以直接 new 出一个对象出来,接着调用 start() 方法来启动线程;而 MyRunnable 只是一个普通的类,需要 new 出线程基类 Thread 对象,将 MyRunnable 对象传进去。 下面是启动线程的方式。 public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); Thread myRunnable = new Thread(new MyRunnable()); System.out.println("main Thread begin"); myThread.start(); myRunnable.start(); System.out.println("main Thread end"); } } 打印结果如下: main Thread begin main Thread end MyThread MyRunnable 看这结果,不像咱们之前的串行执行依次打印,主线程不会等待子线程执行完。 敲重点:不能直接调用 run(),直接调用 run() 不会创建线程,而是主线程直接执行 run() 的内容,相当于执行普通函数。这时就是串行执行的。看下面代码。 public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); Thread myRunnable = new Thread(new MyRunnable()); System.out.println("main Thread begin"); myThread.run(); myRunnable.run(); System.out.println("main Thread end"); } } 打印结果: main Thread begin MyThread MyRunnable main Thread end 从结果看出只是串行的,但看不出没有线程,我们看下面例子来验证直接调用 run() 方法没有创建新的线程,使用 VisualVM 工具来观察线程情况。 我们对代码做一下修改,加上 Thread.sleep(1000000) 让它睡眠一段时间,这样方便用工具查看线程情况。 调用 run() 的代码: public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); myThread.setName("MyThread"); Thread myRunnable = new Thread(new MyRunnable()); myRunnable.setName("MyRunnable"); System.out.println("main Thread begin"); myThread.run(); myRunnable.run(); System.out.println("main Thread end"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } class MyThread extends Thread { @Override public void run() { System.out.println("MyThread"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } class MyRunnable implements Runnable { public void run() { System.out.println("MyRunnable"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果: main Thread begin MyThread 只打印出 2 句日志,观察线程时也只看到 main 线程,没有看到 MyThread 和 MyRunnable 线程,印证了上面咱们说的:直接调用 run() 方法,没有创建线程。 下面我们来看看有 调用 start() 的代码: public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); myThread.setName("MyThread"); Thread myRunnable = new Thread(new MyRunnable()); myRunnable.setName("MyRunnable"); System.out.println("main Thread begin"); myThread.start(); myRunnable.start(); System.out.println("main Thread end"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果: main Thread begin main Thread end MyThread MyRunnable 所有日志都打印出来了,并且通过 VisualVM 工具可以看到 MyThread 和 MyRunnable 线程。看到了这个结果,切记创建线程要调用 start() 方法。 今天就先讲到这,继续关注后面的内容。 推荐阅读 老板叫你别阻塞了 吃个快餐都能学到串行、并行、并发 泡一杯茶,学一学同异步 进程知多少? 设计模式看了又忘,忘了又看? 后台回复『设计模式』可以获取《一故事一设计模式》电子书 觉得文章有用帮忙转发&点赞,多谢朋友们!

优秀的个人博客,低调大师

Java基础之反射整理

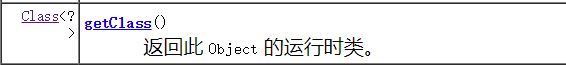
什么是反射? Java反射就是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性;并且能改变它的属性。而这也是Java被视为动态(或准动态,为啥要说是准动态,因为一般而言的动态语言定义是程序运行时,允许改变程序结构或变量类型,这种语言称为动态语言。从这个观点看,Perl,Python,Ruby是动态语言,C++,Java,C#不是动态语言。)语言的一个关键性质。 为什么需要反射 在运行时检测对象的类型; 动态构造某个类的对象; 检测类的属性和方法; 任意调用对象的方法; 修改构造函数、方法、属性的可见性; 以及其他。 得到Class类的三种方法 1.通过对象调用 getClass() 方法来获取 Li l1 = new Li(); Class c1 = l1.getClass(); 2.直接通过 类名.class 的方式得到,该方法最为安全可靠,程序性能更高 Class c2 = Li.class; 3.通过 Class 对象的 forName() 静态方法来获取,用的最多 Class c3 = Class.forName("com.qq.Li"); Class的方法整理 getName():获得类的完整名字。 getFields():获得类的public类型的属性。 getDeclaredFields():获得类的所有属性。包括private 声明的和继承类 getMethods():获得类的public类型的方法。 getDeclaredMethods():获得类的所有方法。包括private 声明的和继承类 getMethod(String name, Class[] parameterTypes):获得类的特定方法,name参数指定方法的名字,parameterTypes 参数指定方法的参数类型。 getConstructors():获得类的public类型的构造方法。 getConstructor(Class[] parameterTypes):获得类的特定构造方法,parameterTypes 参数指定构造方法的参数类型。 newInstance():通过类的不带参数的构造方法创建这个类的一个对象。

优秀的个人博客,低调大师

Matplotlib基础全攻略

本文来自云栖社区官方钉群“Python技术进阶”,了解相关信息可以关注“Python技术进阶”。 Matplotlib是Python中最流行的绘图库,它模仿MATLAB中的绘图风格,提供了一整套与MATLAB相似的绘图API,通过API,我们可以轻松地绘制出高质量的图形。 1、开场例子 我们以中国银行股票收盘价曲线作为例子来作为开场。首先我们通过pandas导入数据,并提取出收盘价一列: ChinaBank = pd.read_csv('data/ChinaBank.csv',index_col = 'Date') ChinaBank = ChinaBank.iloc[:,1:] ChinaBank.index = pd.to_datetime(ChinaBank.index) Close = ChinaBank.Close 我们来绘制2

优秀的个人博客,低调大师

Javascript基础之-原型(prototype)

首先呢,prototype是对象里的一个内置属性,并且呢,这个属性是对于其他对象的一个引用。所以呢,思考下面的例子: var obj = { a: 2 } var myObj = Object.create(obj); console.log(myObj.a); // 2 console.log(myObj === obj); // false console.log(Object.getPrototypeOf(myObj) === obj); // true Object.getPrototypeOf(myObj).a = 4 console.log(obj.a); // 4 这里可以看到,实际上Object.create()是新建了一个对象,并且这个对象的prototype是obj的一个引用,所以呢,如果咱们直接修改prototype里面的值,原对象也就跟着变了。 很简单吧,那么如果执行如下代码的话,会发生什么呢? myObj.a = 10; 是不是认为,还跟上面那个一样的,obj.a也变成10了呢?实际上不是的,他的运行机制要比咱们想的稍微复杂一点点。 实际上要分三种情况来看: 如果在prototype链上存在这个属性,并且没有标记为只读,那么就会在本对象上新建一个新的同名属性。 如果在prototype链上存在这个属性,并且标记为只读,那么将无法修改已有属性或在本对象上新建一个同名属性,如果是严格模式的话,还会报错。 如果在prototype链上只是存在此setter,那么一定会调用此setter,并不会添加属性到对象上,更不会重新定义这个setter 很枯燥是吧,来看例子,对照着上面的情况,好好的理解一下: var obj = { a: 2, set c(num) { console.log('exec it'); } } var myObj = Object.create(obj); myObj.a = 10; console.log(obj.a); // 2 console.log(myObj.a); // 10 Object.defineProperty(obj, 'b', { value: 3, writable: false }) myObj.b = 10; console.log(myObj.b); // 3 myObj.c = 20; // "exec it" console.log(myObj.c); // undefined 假如上面的已经理解了,那么可以思考下下面的运行结果: var obj = { a: 2 } var myObj = Object.create(obj); console.log(++myObj.a); // 3 console.log(obj.a); // 2 这个在咱们实际的编码中时有发生,看代码是想把a改成3,但是由于上面第一种情况的影响,实际上是新建了一个同名属性3,并且赋值给了myObj。 上面我们谈论的都是普通对象的prototype的一些特性,接下来,咱们就要讲关于new关键字相关的一些知识点了,思考下面的例子 function Foo() {} var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // true var b = new Foo(); Object.getPrototypeOf(b).saySomething = function () { console.log('say something'); } a.saySomething(); // "say something" 很明显,在new的过程中呢,生成了一个新对象,并且把Foo.prototype引用到了新对象的prototype。那么因为是引用,所以通过b改变其原型上的prototype的值,Foo.prototype里也会跟着改变。 那么new的过程,是不是一定引用的是函数的prototype呢?也不一定,比如说下面的例子。 function Foo() { return { a: 3 } } var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // false console.log(Object.getPrototypeOf(a) === Object.prototype); // true console.log(a.a); // 3 在这个例子中,由于new的时候,返回的是一个对象,所以最后实际上a最终引用的是Foo最后返回的那个小对象,所以其prototype就是Object.prototype,而不是Foo.prototype 甚至说,Foo.prototype也是可以被改变的,不过在这时候,new出来的对象,其prototype就是被改过的那个对象。 var protoObj = { b: 10 } function Foo() {} Foo.prototype = protoObj; var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // true console.log(Object.getPrototypeOf(a) === protoObj); // true console.log(a.b); // 10 你看,如果prototypeObj修改了默认的Foo.prototype,所以最后,实际上形成了这么一个引用链:a.prototype => foo.prototype => protoObj=>Object.prototype。 所以说结论吧,在new的时候,实际上执行会包含这么几步, 如果有return并且返回的是一个对象的话,则直接返回return后的那个对象。 反之,则新建一个对象。 并且吧函数的prototype引用到新建对象的prototype中。 所以说,原型,可以理解为我本来对象有一个prototype,引用着其他的对象,当我这个对象的prototype引用了另一个对象的prototype,一般情况会到Object.prototype为止,这样就组成了一个原型链,原型链也就是互相引用的引用链。而这个引用链是可以根据自己的需求去改。 好了,简短的一小节就完事了,如果有不明白的,或者有疏漏的地方,或者有什么地方想和我讨论的,可以留言给我哦。 本文转载自http://www.lht.ren/article/8/

优秀的个人博客,低调大师

Java重点基础:反射机制

一、什么是反射? Java反射说的是在运行状态中,对于任何一个类,我们都能够知道这个类有哪些方法和属性。对于任何一个对象,我们都能够对它的方法和属性进行调用。我们把这种动态获取对象信息和调用对象方法的功能称之为反射机制。 二、反射的三种方式 这里需要跟大家说一下,所谓反射其实是获取类的字节码文件,也就是.class文件,那么我们就可以通过Class这个对象进行获取。 1、第一种方式 这个方法其实是Object的一个方法,Class继承了Object,所以我们可以直接使用。 public class Test02 { public static void main(String\[\] args) { // 创建一个对象 Test02 t = new Test02(); // 获取该对象的Class对象 Class c = t.getClass(); // 获取类名称 System.out.println(c.getName()); // com.ms.Test02 } } 2、第二种方式 public class Test02 { public static void main(String\[\] args) { Class c = Test02.class; // 获取类名称 System.out.println(c.getName()); // com.ms.Test02 } } 3、第三种 这里需要注意,通过类的全路径名获取Class对象会抛出一个异常,如果根据类路径找不到这个类那么就会抛出这个异常。 public class Test02 { public static void main(String\[\] args) { try { // 根据类的全路径名获取 Class c = Class.forName("com.ms.Test02"); // 获取类名称 System.out.println(c.getName()); // com.ms.Test02 } catch (ClassNotFoundException e) { e.printStackTrace(); } } } 那么这3中方式我们一般选用哪种方式呢?第一种已经创建了对象,那么这个时候就不需要去进行反射了,显得有点多此一举。第二种需要导入类的包,依赖性太强。所以我们一般选中第三种方式。 三、通过反射获取类的构造方法、方法以及属性 1、获取构造方法 public class Test01 { public static void main(String\[\] args) throws ClassNotFoundException, NoSuchMethodException, IllegalAccessException, InstantiationException { // 加载Class对象 Class c = Class.forName("com.reflect.User"); System.out.println("===========================获取所有公用的构造方法=============================="); // 获取所有公用的构造方法 Constructor\[\] constructors = c.getConstructors(); for (Constructor constructor : constructors) { System.out.println(constructor); } System.out.println("=============================获取所有的构造方法============================"); // 获取所有的构造方法 Constructor\[\] declaredConstructors = c.getDeclaredConstructors(); for (Constructor declaredConstructor : declaredConstructors) { System.out.println(declaredConstructor); } System.out.println("=============================获取公有 & 无参的构造方法============================"); Constructor constructor = c.getConstructor(null); System.out.println(constructor); System.out.println("=============================获取公有 & 有参的构造方法============================"); Constructor constructor1 = c.getConstructor(new Class\[\]{String.class, Integer.class, String.class}); System.out.println(constructor1); System.out.println("=============================获取私有 & 有参 构造方法============================"); Constructor declaredConstructor1 = c.getDeclaredConstructor(new Class\[\]{String.class}); System.out.println(declaredConstructor1); } } 结果: 2、获取类属性 public class Test02 { public static void main(String\[\] args) throws ClassNotFoundException, NoSuchFieldException, IllegalAccessException, InstantiationException, NoSuchMethodException, InvocationTargetException { // 获取Class对象 Class<?> clazz = Class.forName("com.reflect.User"); System.out.println("=====获取所有的公共字段====="); Field\[\] fields = clazz.getFields(); for (Field field : fields) { System.out.println(field); } System.out.println("=====获取所有的字段(公开的、私有的)====="); Field\[\] declaredFields = clazz.getDeclaredFields(); for (Field declaredField : declaredFields) { System.out.println(declaredField); } System.out.println("=====获取公有字段并使用====="); // 获取指定公有字段 Field field = clazz.getField("name"); // 获取一个公有构造方法,然后实例化 Object obj = clazz.getConstructor().newInstance(); // 为属性设置值 field.set(obj, "张三"); // 测试,看设置的值是否成功 User user = (User) obj; System.out.println(user.getName()); System.out.println("=====获取私有字段并使用====="); Field field1 = clazz.getDeclaredField("sex"); // 获取构造函数,实例化对象 Object obj1 = clazz.getConstructor().newInstance(); // 暴力反射 field1.setAccessible(true); // 给属性设置值 field1.set(obj1, "男"); // 测试 User u = (User) obj1; System.out.println(u.getSex()); } } 结果 这里需要注意,在获取私有属性的时候如果没有进行暴力反射,那么会抛出下面这个异常。 3、获取类中的方法 先定义几个方法 public void method1(String str) { System.out.println("public 修饰的方法"); } private void method2() { System.out.println("private 修饰的方法"); } String method3(String name, Integer age, String sex) { System.out.println("默认修饰 " + name + " " + sex + " " + age + "岁"); return name + sex + age; } protected void method4() { System.out.println("protected 修饰的方法"); } 正题 public class Test03 { public static void main(String\[\] args) throws Exception { // 获取Class对象 Class<?> clazz = Class.forName("com.reflect.User"); System.err.println("======获取所有的public修饰的方法====="); Method\[\] methods = clazz.getMethods(); for (Method method : methods) { System.out.println(method); } Thread.sleep(1000); System.err.println("======获取所有的方法====="); Method\[\] declaredMethods = clazz.getDeclaredMethods(); for (Method declaredMethod : declaredMethods) { System.out.println(declaredMethod); } Thread.sleep(1000); System.err.println("======获取特定方法(带参)并使用====="); Method method1 = clazz.getMethod("method1", String.class); System.out.println(method1); Thread.sleep(1000); System.err.println("======获取特定方法(不带参)并使用====="); Method method2 = clazz.getDeclaredMethod("method2"); System.out.println(method2); System.err.println("======获取特定方法(多个参数)并使用====="); Method method3 = clazz.getDeclaredMethod("method3", String.class, Integer.class, String.class); // 获取构造方法,实例化一个对象 Object obj = clazz.getConstructor().newInstance(); // 给方法传值 Object invoke = method3.invoke(obj, "小涛", 24, "男"); // 测试 System.out.println(invoke); } } 结果 这里需要注意的就是当一个方法需要传入多个参数值的时候,一定要注意。踩了一点坑。 四、反射执行main方法 public class Main { public static void main(String\[\] args) { System.out.println("main方法执行了"); } } 反射调用 public class Test04Main { public static void main(String\[\] args) { try { // 获取Class对象 Class<?> clazz = Class.forName("com.reflect.Main"); // 获取Main方法 Method method = clazz.getMethod("main", java.lang.String\[\].class); // 调用 method.invoke(null, (Object) new String\[\]{"a"}); } catch (Exception e) { e.printStackTrace(); } } } 这里需要告诉大家,在导String包的时候千万要看清楚,我在这填了20多分钟的坑。 五、总结 看到这里你已经对反射有了一个简单的了解,可以使用反射获取一些属性方法,其实我们平时写代码很少用到反射技术,但是在我们使用的一些主流框架中反射技术应用是非常广泛的,所以学好反射也是非常有必要的。 今天就写到这里,下篇给大家分享一下利用反射做一些有应用型的例子。 感觉不错就给小涛一个赞吧!

优秀的个人博客,低调大师

Python基础(面向对象编程)

类的内置方法 补充: 其实比如str()这个内置函数,都是在内部调用__str__方法。 之所以提供str()这种方法大概是更简洁吧,有兴趣的可以去看一下源码。 str(123456)实际上是123456.__str__() 实例: a = 123456 b = str(123456) c = a.__str__ print(b) # 输出123456,看不出是字符串类型,你可以type()下 print(c) # 输出一个内存地址,也就是存放这个字符串的内存地址 print(c()) # 输出123456,用一个内存地址加上一个括号就是执行 print(repr(b)) # 利用repr方法输出 '123456',可以看出是字符串类型,同时你也可以type() print(repr(c())) # 同上,输出 '123456' __str__ class A: def __str__(self): return '我是__str__方法' a = A() print(a) 输出:我是__str__方法 你会觉得不可思议吧,但是确确实实是这样,当我们输出a的时候,实际上是输出a.__str__()方法,友谊之前我们没有写这个方法,所以就会调用object中的__str__方法,因为所有没有继承的类,默认是继承object类的,在子类中没有找到__str__方法就会去父类object中找。 列表实例化输出: list = [1,2,3,4,5] print(list) #那么这里为什么会直接输出一个列表,而不是一个内存地址,实际上就是重构了__str__方法。 注:返回值必须为字符串类型 __repr__ class Person: def __init__(self,name): self.name = name def __repr__(self): return self.name p = Person('张三') print(repr(p)) # 输出 张三 print('我的名字是%r'%p) # 输出 我的名字是张三 %r就是调用的__repr__()方法,同理%s?你应该懂吧。如果我们不写repr方法,它就会调用父类的方法,会输出一个内存地址。 注:当我们在类中写了repr方法,没有写str方法,我们再次输出str(Person)他不会输出内存地址,会输出repr中的内容,我们理解为他找不到str方法就会找repr方法,repr方法再没有就会输出内存地址,但是反过来不行。(莫名的备胎)这个repr方法也必须返回字符串。 __del__ class A: def __init__(self,name): self.name = name def __del__(self): print('执行__del__方法') a = A('张三') del a.name print(a.name) 输出: 'A' object has no attribute 'name' 执行__del__方法 报错了,说明删除了name这个属性,并且执行力__del__中的方法。和上面两个不一样。 注:放我们调用完这个一会执行__del__方法,但是没有删除变量。python这个方法内部有个引用计数机制, 当计数为0的时候,就会删除这个属性。来释放内存。 实例: class A: def __init__(self,name): self.name = name def __del__(self): print('执行__del__方法') a = A('张三') import time time.sleep(1) print(a.name) 输出: 张三 执行__del__方法 可以看到,我们并没有调用__del__方法,但是再调用完之后会自动调用这个方法。并且看一下执行顺序,也就是说,先输出,再调用__del__方法。也就是说先执行__del__中的方法,再进行删除,也就是说我们可以在__del__写一些收尾工作,比如f.close()。 __call__ class A: def __call__(self): print('执行了__call__方法') a = A() a() 输出:执行了__call__方法 也就是a()就是执行了__call__方法。 __getitem__ class A: def __init__(self,name,age): self.name = name self.age = age def __getitem__(self,item): return self.__dict__[item] a = A('张三',18) print(a['name']) 输出:张三 我们实例化之类后,a['name'],就是调用内置方法__getitem__中的内容。 __setitem__ class A: def __init__(self,name,age): self.name = name self.age = age def __setitem__(self,key,value): self.__dict__[key] = value a = A('张三',18) a['sex'] = '男' print(a.sex) 输出:男 也同样,当我们a['sex'] = '男'的时候,调用的是 __setitem__方法。 __delitem__ class A: def __init__(self,name,age): self.name = name self.age = age def __delitem__(self,key): del self.__dict__[key] a = A('张三',18) del a['name'] 这样就删除了,其实我会觉得像删除不是有方法吗,这种方法是以将对象以字典的形式查,那么对于字典和列表你可能又有了新的认识。在object中对应的是__delattr__方法。 __new__ 我们知道__init__是在实例化的时候就会执行,在他之前会执行__new__方法。 class A: def __init__(self,name,age): self.name = name self.age = age def __new__(cls,*args,**kwargs): return object.__new__(A,*args,**kwargs) __new__可以决定调用哪个类的_init_方法,如果有两个类,并且是继承关系,就可以选择调用父类的__init__方法,__init__的self就是__new__实例化的结果。有兴趣的可以去了解一下。 __eq__ class A: def __init__(self,name): self.name =name def __eq__(self,other): return self == other a = A('张三') b = A('张三') print(a==b) 返回False,==是调用了__eq__方法,修改成: def __eq__(self,other): return True 就会返回True,但是也不能这样写是吧,我们判断名字相等就让他返回True def __eq__(self,other): if self.name == other.name: return True else: return False 即可。 __hash__ 在hash()一个类的时候,就会执行__hash__方法。就不多说了。 原文发布时间为:2018-11-29 本文作者:小新python入门到放弃 本文来自云栖社区合作伙伴“Python爱好者社区”,了解相关信息可以关注“python_shequ”微信公众号

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册