首页 文章 精选 留言 我的

精选列表

搜索[单体架构],共10000篇文章
优秀的个人博客,低调大师

JAVA架构:Redis BigKey

一、什么是bigkey 在Redis中,一个字符串最大512MB,一个二级数据结构(例如hash、list、set、zset)可以存储大约40亿个(2^32-1)个元素,但实际上中如果下面两种情况,我就会认为它是bigkey。 字符串类型:它的big体现在单个value值很大,一般认为超过10KB就是bigkey。 非字符串类型:哈希、列表、集合、有序集合,它们的big体现在元素个数太多。 二、危害 bigkey可以说就是Redis的老鼠屎,具体表现在: 1.内存空间不均匀 这样会不利于集群对内存的统一管理,存在丢失数据的隐患。 2.超时阻塞 由于Redis单线程的特性,操作bigkey的通常比较耗时,也就意味着阻塞Redis可能性越大,这样会造成客户端阻塞或者引起故障切换,它们通常出现在慢查询中。 例如,在Redis发现了这样的key,你就等着DBA找你吧。 127.0.0.1:6379> hlen big:hash(integer) 2000000127.0.0.1:6379> hgetall big:hash 1) "a" 2) "1" 3.网络拥塞 bigkey也就意味着每次获取要产生的网络流量较大,假设一个bigkey为1MB,客户端每秒访问量为1000,那么每秒产生1000MB的流量,对于普通的千兆网卡(按照字节算是128MB/s)的服务器来说简直是灭顶之灾,而且一般服务器会采用单机多实例的方式来部署,也就是说一个bigkey可能会对其他实例造成影响,其后果不堪设想。 4.过期删除 有个bigkey,它安分守己(只执行简单的命令,例如hget、lpop、zscore等),但它设置了过期时间,当它过期后,会被删除,如果没有使用Redis 4.0的过期异步删除(lazyfree-lazy-expire yes),就会存在阻塞Redis的可能性,而且这个过期删除不会从主节点的慢查询发现(因为这个删除不是客户端产生的,是内部循环事件,可以从latency命令中获取或者从slave节点慢查询发现)。 5.迁移困难 当需要对bigkey进行迁移(例如Redis cluster的迁移slot),实际上是通过migrate命令来完成的,migrate实际上是通过dump + restore + del三个命令组合成原子命令完成,如果是bigkey,可能会使迁移失败,而且较慢的migrate会阻塞Redis。 三、怎么产生的? 一般来说,bigkey的产生都是由于程序设计不当,或者对于数据规模预料不清楚造成的,来看几个: (1)社交类:粉丝列表,如果某些明星或者大v不精心设计下,必是bigkey。 (2)统计类:例如按天存储某项功能或者网站的用户集合,除非没几个人用,否则必是bigkey。 (3)缓存类:将数据从数据库load出来序列化放到Redis里,这个方式非常常用,但有两个地方需要注意: 第一,是不是有必要把所有字段都缓存 第二,有没有相关关联的数据 例如遇到过一个例子,该同学将某明星一个专辑下所有视频信息都缓存一个巨大的json中,造成这个json达到6MB,后来这个明星发了一个官宣 四、如何发现 1. redis-cli --bigkeys redis-cli提供了--bigkeys来查找bigkey,例如下面就是一次执行结果: -------- summary ------- Biggest string found 'user:1' has 5 bytes Biggest list found 'taskflow:175448' has 97478 items Biggest set found 'redisServerSelect:set:11597' has 49 members Biggest hash found 'loginUser:t:20180905' has 863 fields Biggest zset found 'hotkey:scan:instance:zset' has 3431 members 40 strings with 200 bytes (00.00% of keys, avg size 5.00) 2747619 lists with 14680289 items (99.86% of keys, avg size 5.34) 2855 sets with 10305 members (00.10% of keys, avg size 3.61) 13 hashs with 2433 fields (00.00% of keys, avg size 187.15) 830 zsets with 14098 members (00.03% of keys, avg size 16.99) 可以看到--bigkeys给出了每种数据结构的top 1 bigkey,同时给出了每种数据类型的键值个数以及平均大小。 bigkeys对问题的排查非常方便,但是在使用它时候也有几点需要注意: 建议在从节点执行,因为--bigkeys也是通过scan完成的。 建议在节点本机执行,这样可以减少网络开销。 如果没有从节点,可以使用--i参数,例如(--i 0.1 代表100毫秒执行一次) --bigkeys只能计算每种数据结构的top1,如果有些数据结构非常多的bigkey,也搞不定,毕竟不是自己写的东西嘛 debug object 再来看一个场景: 你好,麻烦帮我查一下Redis里大于10KB的所有key 您好,帮忙查一下Redis中长度大于5000的hash key 是不是发现用--bigkeys不行了(当然如果改源码也不是太难),但有没有更快捷的方法,Redis提供了debug object ${key}命令获取键值的相关信息: 127.0.0.1:6379> hlen big:hash (integer) 5000000 127.0.0.1:6379> debug object big:hash Value at:0x7fda95b0cb20 refcount:1 encoding:hashtable serializedlength:87777785 lru:9625559 lru_seconds_idle:2 (1.08s) 其中serializedlength表示key对应的value序列化之后的字节数,当然如果是字符串类型,完全看可以执行strlen,例如: 127.0.0.1:6379> strlen key (integer) 947394 这样你就可以用scan + debug object的方式遍历Redis所有的键值,找到你需要阈值的数据了。 但是在使用debug object时候一定要注意以下几点: debug object bigkey本身可能就会比较慢,它本身就会存在阻塞Redis的可能 建议在从节点执行 建议在节点本地执行 如果不关系具体字节数,完全可以使用scan + strlen|hlen|llen|scard|zcard替代,他们都是o(1) 3. memory usage 上面的debug object可能会比较危险、而且不太准确(序列化后的长度),有没有更准确的呢?Redis 4.0开始提供memory usage命令可以计算每个键值的字节数(自身、以及相关指针开销,具体的细节可查阅相关文章),例如下面是一次执行结果: 127.0.0.1:6379> memory usage big:hash (integer) 318663444 下面我们来对比就可以看出来,当前系统就一个key,总内存消耗是400MB左右,memory usage相比debug object还是要精确一些的。 127.0.0.1:6379> dbsize (integer) 1 127.0.0.1:6379> hlen big:hash (integer) 5000000 #约300MB 127.0.0.1:6379> memory usage big:hash (integer) 318663444 #约85MB 127.0.0.1:6379> debug object big:hash Value at:0x7fda95b0cb20 refcount:1 encoding:hashtable serializedlength:87777785 lru:9625814 lru_seconds_idle:9 (1.06s) 127.0.0.1:6379> info memory # Memory used_memory_human:402.16M 如果你使用Redis 4.0+,你就可以用scan + memory usage(pipeline)了,而且很好的一点是,memory不会执行很慢,当然依然是建议从节点 + 本地 。 4. 客户端 上面三种方式都有一个问题,就是马后炮,如果想很实时的找到bigkey,一方面你可以试试修改Redis源码,还有一种方式就是可以修改客户端,以jedis为例,可以在关键的出入口加上对应的检测机制,例如以Jedis的获取结果为例子: protected Object readProtocolWithCheckingBroken() { Object o = null; try { o = Protocol.read(inputStream); return o; }catch(JedisConnectionException exc) { UsefulDataCollector.collectException(exc, getHostPort(), System.currentTimeMillis()); broken = true; throw exc; }finally { if(o != null) { if(o instanceof byte[]) { byte[] bytes = (byte[]) o; if (bytes.length > threshold) { // 做很多事情,例如用ELK完成收集和展示 } } } } } 5. 监控报警 bigkey的大操作,通常会引起客户端输入或者输出缓冲区的异常,Redis提供了info clients里面包含的客户端输入缓冲区的字节数以及输出缓冲区的队列长度,可以重点关注下: 如果想知道具体的客户端,可以使用client list命令来查找 redis-cli client list id=3 addr=127.0.0.1:58500 fd=8 name= age=3978 idle=25 flags=N db=0 sub=0 psub=0 multi=-1 qbuf=0 qbuf-free=0 obl=0 oll=0 omem=26263554 events=r cmd=hgetall 6. 改源码 这个其实也是能做的,但是各方面成本比较高,对于一般公司来说不适用。 建议的最佳实践: Redis端与客户端相结合:--bigkeys临时用、scan长期做排除隐患(尽可能本地化)、客户端实时监控。 监控报警要跟上 debug object尽量少用 所有数据平台化 要和开发同学强调bigkey的危害 五、如何删除 如果发现了bigkey,而且确认是垃圾是不是直接del就可以了,来看一组数据: 可以看到对于string类型,删除速度还是可以接受的。但对于二级数据结构,随着元素个数的增长以及每个元素字节数的增大,删除速度会越来越慢,存在阻塞Redis的隐患。所以在删除它们时候建议采用渐进式的方式来完成:hscan、ltrim、sscan、zscan。 如果你使用Redis 4.0+,一条异步删除unlink就解决,就可以忽略下面内容。 1. 字符串 一般来说,对于string类型使用del命令不会产生阻塞。 del bigkey 2. hash 使用hscan命令,每次获取部分(例如100个)field-value,在利用hdel删除每个field(为了快速可以使用pipeline)。 public void delBigHash(String bigKey) { Jedis jedis = new Jedis("127.0.0.1", 6379); // 游标 String cursor = "0"; while(true) { ScanResult<Map.Entry<String, String>> scanResult = jedis.hscan(bigKey, cursor, new ScanParams().count(100)); // 每次扫描后获取新的游标 cursor = scanResult.getStringCursor(); // 获取扫描结果 List<Entry<String, String>> list = scanResult.getResult(); if(list == null || list.size() == 0) { continue; } String[] fields = getFieldsFrom(list); // 删除多个field jedis.hdel(bigKey, fields); // 游标为0时停止 if(cursor.equals("0")) { break; } } // 最终删除key jedis.del(bigKey); } /** * 获取field数组 */ private String[] getFieldsFrom(List<Entry<String, String>> list) { List<String> fields = new ArrayList<String>(); for (Entry<String, String> entry : list) { fields.add(entry.getKey()); } return fields.toArray(new String[fields.size()]); } 3. list Redis并没有提供lscan这样的API来遍历列表类型,但是提供了ltrim这样的命令可以渐进式的删除列表元素,直到把列表删除。 public void delBigList(String bigKey) { Jedis jedis = new Jedis("127.0.0.1", 6379); long llen = jedis.llen(bigKey); int counter = 0; int left = 100; while(counter < llen) { // 每次从左侧截掉100个 jedis.ltrim(bigKey, left, llen); counter += left; } // 最终删除key jedis.del(bigKey); } 4. set 使用sscan命令,每次获取部分(例如100个)元素,在利用srem删除每个元素。 public void delBigSet(String bigKey) { Jedis jedis = new Jedis("127.0.0.1", 6379); // 游标 String cursor = "0"; while(true) { ScanResult<String> scanResult = jedis.sscan(bigKey, cursor, new ScanParams().count(100)); // 每次扫描后获取新的游标 cursor = scanResult.getStringCursor(); // 获取扫描结果 List<String> list = scanResult.getResult(); if(list == null || list.size() == 0) { continue; } jedis.srem(bigKey, list.toArray(new String[list.size()])); // 游标为0时停止 if(cursor.equals("0")) { break; } } // 最终删除key jedis.del(bigKey);} 5. sorted set 使用zscan命令,每次获取部分(例如100个)元素,在利用zremrangebyrank删除元素。 public void delBigSortedSet(String bigKey) { long startTime = System.currentTimeMillis(); Jedis jedis = new Jedis(HOST, PORT); // 游标 String cursor = "0"; while(true) { ScanResult<Tuple> scanResult = jedis.zscan(bigKey, cursor, new ScanParams().count(100)); // 每次扫描后获取新的游标 cursor = scanResult.getStringCursor(); // 获取扫描结果 List<Tuple> list = scanResult.getResult(); if(list == null || list.size() == 0) { continue; } String[] members = getMembers(list); jedis.zrem(bigKey, members); // 游标为0时停止 if(cursor.equals("0")) { break; } } // 最终删除key jedis.del(bigKey); } public void delBigSortedSet2(String bigKey) { Jedis jedis = new Jedis(HOST, PORT); long zcard = jedis.zcard(bigKey); int counter = 0; int incr = 100; while(counter < zcard) { jedis.zremrangeByRank(bigKey, 0, 100); // 每次从左侧截掉100个 counter += incr; } // 最终删除key jedis.del(bigKey); } 六、如何优化 1.拆分 big list: list1、list2、...listN big hash:可以做二次的hash,例如hash%100 日期类:key20190320、key20190321、key_20190322。 2.本地缓存 减少访问redis次数,降低危害,但是要注意这里有可能因此本地的一些开销(例如使用堆外内存会涉及序列化,bigkey对序列化的开销也不小) 7、总结: 由于开发人员对Redis的理解程度不同,在实际开发中出现bigkey在所难免,重要的能通过合理的检测机制及时找到它们,进行处理。作为开发人员应该在业务开发时不能将Redis简单暴力的使用,应该在数据结构的选择和设计上更加合理,例如出现了bigkey,要思考一下可不可以做一些优化(例如二级索引)尽量的让这些bigkey消失在业务中,如果bigkey不可避免,也要思考一下要不要每次把所有元素都取出来(例如有时候仅仅需要hmget,而不是hgetall),删除也是一样,尽量使用优雅的方式来处理。 由于篇幅限制,更多的Redis介绍小编放在下面的文档里了,需要获取完整文档用以学习的朋友们可以转发+关注,私信领取,还有更多java源码、笔记、资料哦!

优秀的个人博客,低调大师

Impala——2.架构

标签(空格分隔): Impala Impala Server的组件 Impala服务器是分布式,大规模并行处理(MPP)数据库引擎。它由不同的在群集中的特定主机上运行的守护程序进程组成。 Impala守护进程 核心Impala组件是一个守护进程,它通过impalad进程在集群的每个DataNode上运行。它读写数据文件;接受从impala-shell、Hue、JDBC或ODBC传输的查询命令;并行化查询并在整个集群中分配工作;传输中间查询结果返回中央协调节点。您可以向在任何DataNode上运行的Impala守护进程提交查询,并且该守护进程的实例用作该查询的协调节点。其他节点将部分结果发送回协调器,该协调器构造查询的最终结果集。通过impala-shell命令运行具有功能的实验时,为方便起见,您可能始终连接到相同的Impala守护进程。对

优秀的个人博客,低调大师

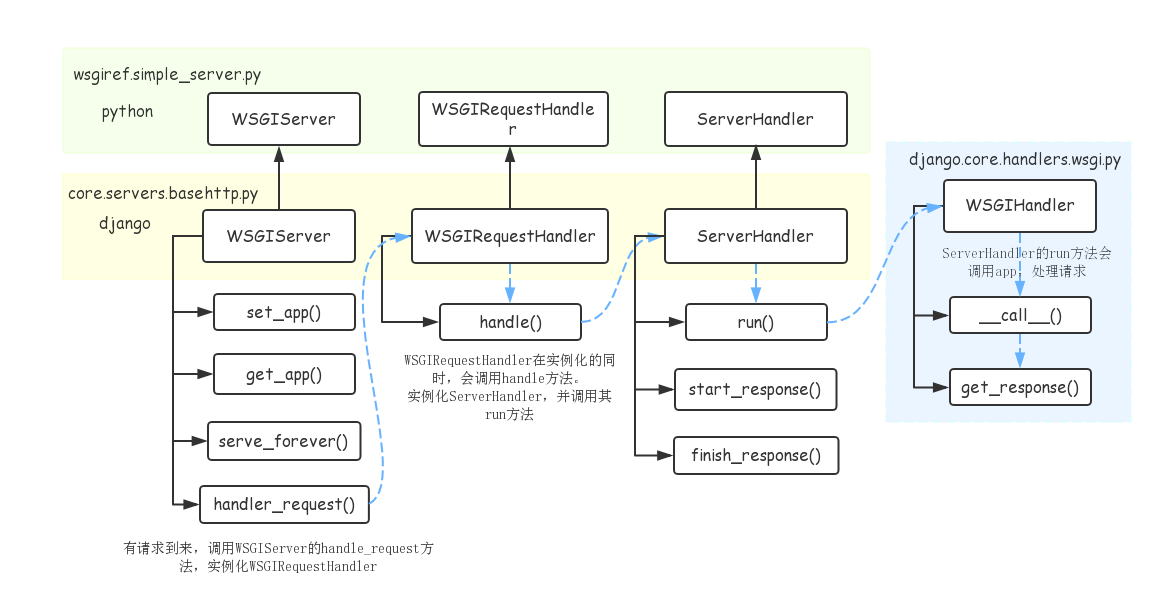
django框架--底层架构

目录 零、参考 一、对于web服务的理解 二、对于wsgi协议的理解 三、自定义一个简单的基于wsgi协议的web框架 四、django中的server实现 五、django中的application实现 六、django的底层调用链 七、总结 零、参考 https://www.jianshu.com/p/679dee0a4193https://www.letiantian.me/2015-09-10-understand-python-wsgi/ 一、对于web服务的理解 web服务应该至少包含两个模块:web服务器和web应用程序,两个模块在功能和代码上解耦。web服务器负责处理socket调用、http数据解析和封装等底层操作。web应用程序负责业务处理、数据增删改查、页面渲染/生成等高层操作。web服务器一旦接收到http请求,经过自身的解析后就会调用web应用程序来处理业务逻辑,并得到web应用程序的返回值,再经过自身的封装发送给客户端。 二、对于wsgi协议的理解 在web服务器和web应用程序之间需要定义一个接口规则,这也叫协议,用于明确两者之间以什么样的形式交互数据。即:web服务器应该以什么样的形式调用web应用程序,而web应用程序又应该定义成什么形式。 python下规定的web服务的接口规则叫做wsgi,wsgi协议对于server和application的接口定义如下: 对于server调用规则的定义: response = application(environ, start_response) 对于application接口编码的定义: def application(environ, start_response): status = '200 OK' response_headers = [('Content-Type', 'text/plain'),] start_response(status, response_headers) return [b'hello',] 只要是遵从如上形式进一步封装server和application的,均称为实现了wsgi协议的server/application。 python内置提供了一个wsigref模块用于提供server,但是只能用于开发测试,django框架就是使用此模块作为它的server部分,也就说,实际生产中的server部分,还需要使用其他模块来实现。 任何web框架,可能没有实现server部分或者只实现一个简单的server,但是,web框架肯定实现了application部分。application部分完成了对一次请求的全流程处理,其中各环节都可以提供丰富的功能,比如请求和响应对象的封装、model/template的实现、中间件的实现等,让我们可以更加细粒度的控制请求/响应的流程。 三、自定义一个简单的基于wsgi协议的web框架 django框架的server部分由python内置的wsgiref模块提供,我们只需要编写application应用程序部分。 from wsgiref.simple_server import make_server def app(environ, start_response): # wsgi协议规定的application部分的编码形式,可在此基础上扩展 status = '200 OK' respones_headers = [] start_response(status, response_headers) return [b'hello',] if __name__ == '__main__': httpd = make_server('127.0.0.1', 8080, app) httpd.serve_forever() 四、django中的server实现 django使用的底层server模块是基于python内置的wsgiref模块中的simple_server,每次django的启动都会执行如下run函数。run函数中会执行serve_forever,此步骤将会启动socket_server的无限循环,此时就可以循环提供请求服务,每次客户端请求到来,服务端就执行django提供的application模块。 django中server的启动----django.core.servers.basehttp.py """ HTTP server that implements the Python WSGI protocol (PEP 333, rev 1.21). Based on wsgiref.simple_server which is part of the standard library since 2.5. This is a simple server for use in testing or debugging Django apps. It hasn't been reviewed for security issues. DON'T USE IT FOR PRODUCTION USE! """ def run(addr, port, wsgi_handler, ipv6=False, threading=False, server_cls=WSGIServer): server_address = (addr, port) if threading: httpd_cls = type('WSGIServer', (socketserver.ThreadingMixIn, server_cls), {}) else: httpd_cls = server_cls httpd = httpd_cls(server_address, WSGIRequestHandler, ipv6=ipv6) if threading: # ThreadingMixIn.daemon_threads indicates how threads will behave on an # abrupt shutdown; like quitting the server by the user or restarting # by the auto-reloader. True means the server will not wait for thread # termination before it quits. This will make auto-reloader faster # and will prevent the need to kill the server manually if a thread # isn't terminating correctly. httpd.daemon_threads = True httpd.set_app(wsgi_handler) httpd.serve_forever() 底层无限循环将作为web服务的主要驱动----socektserver.py def serve_forever(self, poll_interval=0.5): """Handle one request at a time until shutdown. Polls for shutdown every poll_interval seconds. Ignores self.timeout. If you need to do periodic tasks, do them in another thread. """ self.__is_shut_down.clear() try: # XXX: Consider using another file descriptor or connecting to the # socket to wake this up instead of polling. Polling reduces our # responsiveness to a shutdown request and wastes cpu at all other # times. with _ServerSelector() as selector: selector.register(self, selectors.EVENT_READ) while not self.__shutdown_request: ready = selector.select(poll_interval) if ready: self._handle_request_noblock() self.service_actions() finally: self.__shutdown_request = False self.__is_shut_down.set() server对于application的调用----wsgiref.handlers.py def run(self, application): """Invoke the application""" # Note to self: don't move the close()! Asynchronous servers shouldn't # call close() from finish_response(), so if you close() anywhere but # the double-error branch here, you'll break asynchronous servers by # prematurely closing. Async servers must return from 'run()' without # closing if there might still be output to iterate over. try: self.setup_environ() self.result = application(self.environ, self.start_response) self.finish_response() except: try: self.handle_error() except: # If we get an error handling an error, just give up already! self.close() raise # ...and let the actual server figure it out. 五、django中的application实现 django的application模块是通过WSGIHandler的一个实例来提供的,此实例可以被call,然后根据wsgi的接口规则传入environ和start_response。所以本质上,django就是使用的内置python提供的wsgiref.simple_server再对application进行丰富的封装。大部分的django编码工作都在application部分。 application的编码定义部分----django.core.handlers.wsgi.py class WSGIHandler(base.BaseHandler): request_class = WSGIRequest def __init__(self, *args, **kwargs): super().__init__(*args, **kwargs) self.load_middleware() def __call__(self, environ, start_response): set_script_prefix(get_script_name(environ)) signals.request_started.send(sender=self.__class__, environ=environ) request = self.request_class(environ) response = self.get_response(request) response._handler_class = self.__class__ status = '%d %s' % (response.status_code, response.reason_phrase) response_headers = list(response.items()) for c in response.cookies.values(): response_headers.append(('Set-Cookie', c.output(header=''))) start_response(status, response_headers) if getattr(response, 'file_to_stream', None) is not None and environ.get('wsgi.file_wrapper'): response = environ['wsgi.file_wrapper'](response.file_to_stream) return response 六、django的底层调用链 七、总结 web服务是基于socket的高层服务,所以web服务必须含有web服务器这一模块。web服务需要动态渲染数据,需要中间件来丰富功能,需要封装和解析来处理数据,所以web服务必须含有web应用程序这一模块。web框架是一种工具集,封装了各种功能的底层代码,提供给我们方便开发的接口。但不论是哪一种框架,它们的底层原理基本都是一致的。 应该深入学习、研究一个web框架,精通一门框架的实现原理和设计理念。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册