首页 文章 精选 留言 我的

精选列表

搜索[socket编程],共10000篇文章
优秀的个人博客,低调大师

Python网络编程 —— 进程

个人独立博客:www.limiao.tech 微信公众号:TechBoard 进程 进程:通俗理解就是一个运行的程序或者软件,进程是操作系统资源分配的基本单位 一个程序至少有一个进程,一个进程至少有一个线程,多进程可以完成多任务 进程的状态 工作中,任务数往往大于cpu的核数,即一定有一些任务正在执行,而另外一些任务在等待cpu进行执行,因此导致了有了不同的状态 进程的使用 导入进程模块: import multiprocessing 用进程完成多任务 import multiprocessing import time def sing(): for i in range(10): print("唱歌中...") time.sleep(0.2) def dance(): for i in range(10): print("跳舞中...") time.sleep(0.2) if __name__ == "__main__": # 创建对应的子进程执行对应的任务 sing_process = multiprocessing.Process(target=sing) dance_process = multiprocessing.Process(target=dance) # 启动进程执行对应的任务 sing_process.start() dance_process.start() Process类参数介绍 import multiprocessing import os def show_info(name,age): print("show_info:", multiprocessing.current_process()) # 获取进程的编号 pritn("show_info pid:", multiprocessing.current_process().pid, os.getpid) print(name, age) if __name__ == "__main__": # 创建子进程 # group: 进程组,目前只能使用None # target: 执行的目标任务 # args: 以元组方式传参 # kwargs: 以字典方式传参 sub_prcess = multiprocessing.Process(group=None, target=show_info, arg=("杨幂", 18)) sub_prcess.start() 进程之间不共享全局变量 import multiprocessing import time # 全局变量 g_list = [] # 添加数据 def add_data(): for i in range(15): g_list.append(i) time.sleep(0.1) print("add_data:", g_list) # 读取数据 def read_data(): print("read_data:", g_list) if __name__ == "__main__": # 创建添加数据的子进程 add_process = multiprocessing.Process(target=add_data) # 创建读取数据的子进程 read_process = multiprocessing.Process(target=read_data) # 启动进程 add_process.start() # 主进程等待添加数据的子进程执行完成以后再执行读取进程的操作 add_process.join() # 代码执行到此说明添加数据的子进程把任务执行完成了 read_process.start() 创建子进程其实就是对主进程资源的拷贝 主进程会等待所有的子进程执行完成程序再退出 import multiprocessing import time # 工作任务 def work(): for i in range(10): print("工作中...") time.sleep(0.3) if __name__ == "__main__": # 创建子进程 sub_prcess = multiprocessing.Process(target=work) # 查看进程的守护状态 # print(sub_prcess.daemon) # 守护主进程,主进程退出子进程直接销毁,不再执行子进程里面的代码 # sub_prcess.daemon = True # 启动进程执行对应的任务 sub_process.start() # 主进程延时1s time.sleep(1) print("主进程执行完了") # 主进程退出之前把所有的子进程销毁 sub_prcess.terminate() exit() 总结: 主进程会等待所有的子进程执行完成程序再退出 获取进程pid # 获取进程pid import multiprocessing import time import os def work(): # 获取当前进程编号 print("work进程编号:", os.getpid()) # 获取父进程编号 print("work父进程编号:", os.getppid()) for i in range(10): print("工作中...") time.sleep(1) # 扩展:根据进程编号杀死对应的进程 # os.kill(os.getpid(), 9) if __name__ == '__main__': # 获取当前进程的编号: print("当前进程编号:", multiprocessing.current_process().pid) # 创建子进程 sub_process = multiprocessing.Process(target=work) # 启动进程 sub_process.start() # 主进程执行打印信息操作 for i in range(20): print("我在主进程中执行...") time.sleep(1) 运行结果: 当前进程编号: 624 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... work进程编号: 1312 work父进程编号: 624 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... ***Repl Closed*** 进程间通信——Queue 可以使用multiprocessing模块Queue实现多进程之间的数据传递,Queue本身是一个消息队列程序 import multiprocessing if __name__ == "__main__": # 创建消息队列 # 3:表示消息队列的最大个数 queue = multiprocessing.Queue(3) # 存放数据 queue.put(1) queue.put("hello") queue.put([1, 5, 8]) # 总结:队列可以放入任意类型的数据 # queue.put("xxx": "yyy") # 放入消息的时候不会进行等待,如果发现队列满了不能放入数据,那么会直接崩溃 # 建议: 放入数据统一使用 put 方法 # queue.put_nowait(("xxx": "yyy")) # 判断队列是否满了 result = queue.full() print(result) # 判断队列是否为空,不靠谱(加延时可解决) result = queue.empty() print("队列是否为空:", result) # 获取队列消息个数 size = queue.qsize() print("消息个数:", size) # 获取队列中的数据 res = queue.get() print(res) # 如果队列空了,那么使用get方法会等待队列有消息以后再取值 消息队列Queue完成进程间通信的演练 import multiprocessing import time # 添加数据 def add_data(queue): for i in range(5): # 判断队列是否满了 if queue.full(): # 如果满了跳出循环,不再添加数据 print("队列满了") break queue.put(i) print("add:", i) time.sleep(0.1) def read_data(queue): while True: if queue.qsize == 0: print("队列空了") break result = queue.get() print("read:", result) if __name__ == "__main__": # 创建消息队列 queue = multiprocessing.Queue(3) # 创建添加数据的子进程 add_process = multiprocessing.Process(target=add_data, args=(queue,)) # 创建读取数据的子进程 read_process = multiprocessing.Process(target=read_data, args=(queue,)) # 启动进程 add_process.start() # 主进程等待写入进程执行完成以后代码再继续往下执行 add_process.join() read_process.start() 进程池Pool 进程池的概念 池子里面放的是进程,进程池会根据任务执行情况自动创建进程,而且尽量少创建进程,合理利用进程池中的进程完成多任务 当需要创建的子进程数量不多时,可以直接利用multiprocess中的Process动态生成多个进程,但如果是上百甚至上千个目标,手动的去创建进程的工作量巨大,此时就可以用到multiprocess模块提供的Pool方法。 初始化Pool时,可以指定一个最大进程数,当有新的请求提到Pool中时,如果池还没有满,那么就会创建一个新的进程用来执行该请求,但如果池中的进程数已经达到指定的最大值,那么该请求就会等待,直到池中有进程结束,才会用之前的进程来执行新的任务。 进程池同步执行任务 进程池同步执行任务表示进程池中的进程在执行任务的时候一个执行完成另外一个才能执行,如果没有执行完会等待上一个进程执行 进程池同步实例代码 import multiprocessing import time # 拷贝任务 def work(): print("复制中...", multiprocessing.current_process().pid) time.sleep(1) if __name__ == '__main__': # 创建进程池 #3:进程池中进程的最大个数 pool = multiprocessing.Pool(3) # 模拟大批量的任务,让进程池去执行 for i in range(5): # 循环让进程池执行对应的work任务 # 同步执行任务,一个任务执行完成以后另外一个任务才能执行 pool.apply(work) 运行结果: 复制中... 6172 复制中... 972 复制中... 972 复制中... 1624 复制中... 1624 ***Repl Closed*** 进程池异步执行任务 进程池异步执行任务表示进程池中的进程同时执行任务,进程之间不会等待 进程池异步实例代码 import multiprocessing import time # 拷贝任务 def work(): print("复制中...", multiprocessing.current_process().pid) # 获取当前进程的守护状态 # 提示:使用进程池创建的进程时守护主进程的状态,默认自己通过Process创建的进程是不守护主进程的状态 # print(multiprocessing.current_process().daemon) time.sleep(1) if __name__ == '__main__': # 创建进程池 # 3:进程池中进程的最大个数 pool = multiprocessing.Pool(3) # 模拟大批量的任务,让进程池去执行 for i in range(5): # 循环让进程池执行对应的work任务 # 同步执行任务,一个任务执行完成以后另外一个任务才能执行 # pool.apply(work) # 异步执行,任务执行不会等待,多个任务一起执行 pool.apply_async(work) # 关闭进程池,意思告诉主进程以后不会有新的任务添加进来 pool.close() # 主进程等待进程池执行完成以后程序再退出 pool.join() 运行结果: 复制中... 1848 复制中... 12684 复制中... 12684 复制中... 6836 复制中... 6836 ***Repl Closed*** 个人独立博客:www.limiao.tech 微信公众号:TechBoard
优秀的个人博客,低调大师

Python网络编程 —— 线程

个人独立博客:www.limiao.tech 微信公众号:TechBoard 线程的概念 线程就是在程序运行过程中,执行程序代码的一个分支,每个运行的程序至少都有一个线程 单线程执行 import time def sing(): for i in range(3): print("唱歌...%d" % i) time.sleep(1) def dance(): for i in range(3): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing() dance() 运行结果: 唱歌...0 唱歌...1 唱歌...2 跳舞...0 跳舞...1 跳舞...2 ***Repl Closed*** 多线程执行 多线程的执行需要导入threading模块 参数说明: Thread([group[,target[,name[,args[,kwargs]]]]]) - group: 线程组,目前只能使用None - target: 执行的目标任务名 - args: 以元组的方式给执行任务传参 - kwargs: 以字典方式给执行任务传参 - name: 线程名,一般不用设置 多线程完成多任务 # 多线程执行 import time, threading def sing(): # 获取当前进程 print(threading.current_thread()) for i in range(3): print("唱歌...%d" % i) time.sleep(1) def dance(): print(threading.current_thread()) for i in range(3): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing_thread = threading.Thread(target=sing) dance_thread = threading.Thread(target=dance) sing_thread.start() dance_thread.start() 运行结果: <Thread(Thread-1, started 8520)> 唱歌...0 <Thread(Thread-2, started 4604)> 跳舞...0 唱歌...1 跳舞...1 唱歌...2 跳舞...2 ***Repl Closed*** 多线程执行带有参数的任务 import time, threading def sing(num): for i in range(num): print("唱歌...%d" % i) time.sleep(1) def dance(num): for i in range(num): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing_thread = threading.Thread(target=sing, args=(3,)) dance_thread = threading.Thread(target=dance, kwargs={"num": 3}) sing_thread.start() dance_thread.start() 运行结果: 唱歌...0 跳舞...0 跳舞...1 唱歌...1 跳舞...2 唱歌...2 ***Repl Closed*** 查看获取线程列表 import time, threading def sing(): for i in range(5): print("唱歌...%d" % i) time.sleep(1) def dance(): for i in range(5): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': # 获取当前程序活动线程的列表 thread_list = threading.enumerate() print("111:", thread_list, len(thread_list)) sing_thread = threading.Thread(target=sing) dance_thread = threading.Thread(target=dance) thread_list = threading.enumerate() print("222:", thread_list, len(thread_list)) # 启动线程 sing_thread.start() dance_thread.start() # 只有线程启动了,才能加入到活动线程列表中 thread_list = threading.enumerate() print("333:", thread_list, len(thread_list)) 运行结果: 111: [<_MainThread(MainThread, started 11864)>] 1 222: [<_MainThread(MainThread, started 11864)>] 1 唱歌...0 跳舞...0 333: [<_MainThread(MainThread, started 11864)>, <Thread(Thread-1, started 892)>, <Thread(Thread-2, started 6444)>] 3 跳舞...1 唱歌...1 跳舞...2 唱歌...2 唱歌...3 跳舞...3 唱歌...4 跳舞...4 ***Repl Closed*** 注意 线程之间执行是无序的 import time, threading def task(): time.sleep(1) print("当前线程:", threading.current_thread().name) if __name__ == '__main__': for _ in range(5): sub_thread = threading.Thread(target=task) sub_thread.start() 运行结果: 当前线程: Thread-5 当前线程: Thread-2 当前线程: Thread-3 当前线程: Thread-1 当前线程: Thread-4 ***Repl Closed*** 主线程会等待所有的子线程结束后才结束 # 主线程会等待所有的子线程结束后才会结束 import time, threading # 测试主线程是否会等待子线程执行完成以后程序再退出 def show_info(): for i in range(5): print("test:", i) time.sleep(1) if __name__ == '__main__': sub_thread = threading.Thread(target=show_info) sub_thread.start() # 主线程延时5秒 time.sleep(10) print("over") 运行结果: test: 0 test: 1 test: 2 test: 3 test: 4 over ***Repl Closed*** 守护主线程 import time, threading def show_info(): for i in range(5): print("test:", i) time.sleep(1) if __name__ == '__main__': # 设置成守护主线程,主线程退出后子线程直接销毁不再执行子线程的代码 sub_thread = threading.Thread(target=show_info, daemon=True) sub_thread.start() time.sleep(10) print("over") 运行结果: test: 0 test: 1 test: 2 test: 3 test: 4 over ***Repl Closed*** 自定义线程 import threading # 自定义线程类 class MyThread(threading.Thread): # 通过构造方法取接受任务的参数 def __init__(self, info1, info2): # 调用父类的构造方法 super().__init__() self.info1 = info1 self.info2 = info2 # 定义自定义线程相关的任务 def test1(self): print(self.info1) def test2(self): print(self.info2) # 通过run方法执行相关任务 def run(self): self.test1() self.test2() # 创建自定义线程 my_thread = MyThread("测试1", "测试2") # 启动 my_thread.start() 运行结果: 测试1 测试2 ***Repl Closed*** 总结: 自定义线程不能指定target,因为自定义线程里面的任务都统一在run方法里面执行 启动线程统一调用start方法,不要直接调用run方法,因为这样不是使用子线程去执行任务 多线程共享全局变量 import time, threading # 定义全局变量 my_list = list() # 写入数据任务 def write_data(): for i in range(5): my_list.append(i) time.sleep(1) print("write_data:", my_list) # 读取数据任务 def read_data(): print("read_data:", my_list) if __name__ == '__main__': # 创建写入数据的线程 write_thread = threading.Thread(target=write_data) # 创建读取数据的线程 read_thread = threading.Thread(target=read_data) write_thread.start() # 主线程等待写入线程执行完成以后代码再继续往下执行 write_thread.join() print("开始读取数据...") read_thread.start() 运行结果: write_data: [0, 1, 2, 3, 4] 开始读取数据... read_data: [0, 1, 2, 3, 4] ***Repl Closed*** 多线程同时对全局变量进行操作,导致数据可能出现错误 import threading # 定义全局变量 g_num = 0 # 循环一次给全局变量加1 def sum_num1(): for i in range(1000000): global g_num g_num += 1 print("sum1:", g_num) # 循环一次给全局变量加1 def sum_num2(): for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) if __name__ == '__main__': # 创建两个线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) first_thread.start() second_thread.start() 运行结果: sum1: 1491056 sum2: 1528560 ***Repl Closed*** 通过上面运行结果,得出:多线程同时对全局变量操作数据发生了错误 原因分析:两个线程first_thread和second_thread都要对全局变量g_num(默认是0)进行加1运算,但是由于是多线程同时操作,,有可能出现下面的情况: 1.在g_num=0时,first_thread取得g_num=0.此时系统把first_thread调度为"sleeping"状态,把second_thread转换为"running"状态,t2也获得g_num=0 2.然后second_thread对得到的值进行加1并赋给g_num,使得g_num=1 3.然后系统又把second_thread调度为"sleeping",把first_thread转为"running".线程t1又把之前得到的0加1后赋值给g_num. 4.这样导致虽然first_thread和second_thread都对g_num加1,但结果仍然是g_num=1。 全局变量数据错误的解决办法 线程同步:保证同一时刻只能有一个线程去操作全局变量同步,就是协同步调,按预定的先后次序进行运行 线程同步的方式: 1.线程等待(join) 2.互斥锁 线程等待实现方式: import threading # 定义全局变量 g_num = 0 # 循环一次给全局变量加1 def sum_num1(): for i in range(1000000): global g_num g_num += 1 print("sum1:", g_num) # 循环一次给全局变量加1 def sum_num2(): for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) if __name__ == '__main__': # 创建两个线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) first_thread.start() first_thread.join() second_thread.start() 运行结果: sum1: 1000000 sum2: 2000000 ***Repl Closed*** 结论:多个线程同时对同一个全局变量进行操作,会有可能出现资源竞争数据错误的问题 线程同步方式可以解决资源竞争数据错误问题,但是这样有多任务变成了单任务 互斥锁 对共享数据进行锁定,保证同一时刻只能有一个线程去操作 抢到锁的线程先执行,没有抢到锁的线程需要等待,等锁用完后需要释放,然后其它等待的线程再去抢这个锁,哪个线程抢到,那个线程再执行 具体哪个线程抢到这个锁,我们决定不了,是由CPU调度决定的 线程同步能够保证多个线程安全访问竞争资源,最简单的同步机制是引入互斥锁 互斥锁为资源引入的一个状态:锁定/非锁定 某个线程要更改共享数据时,先将其锁定,此时资源的状态为"锁定",其他线程不能更改;直到该线程释放资源,将资源的状态变成"非锁定",其他的线程才能再次锁定该资源。互斥锁保证了每次只有一个线程进行写入操作,从而保证了多线程情况下数据的正确性。 创建锁: a = threading.Lock() 锁定 a.acquire() 释放 a.release() 注意: 1.如果这个锁之前时没有上锁的,那么acquire不会堵塞 2.如果在调用acquire对这个锁上锁之前,它已经被其它线程上了锁,那么此时acquire会堵塞,直到这个锁被解锁为止 # 使用互斥锁完成2个线程对同一个全局变量各加100万次的操作 import threading # 定义全局变量 g_num = 0 # 创建全局互斥锁 lock = threading.Lock() # 循环一次给全局变量加1 def sum_num1(): # 上锁 lock.acquire() for i in range(1000000): global g_num g_num += 1 print("sun1:", g_num) # 释放锁 lock.release() # 循环一次给全局变量加1 def sum_num2(): # 上锁 lock.acquire() for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) # 释放锁 lock.release() if __name__ == '__main__': # 创建线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) # 启动线程 first_thread.start() second_thread.start() 运行结果: sun1: 1000000 sum2: 2000000 ***Repl Closed*** 注意 加上互斥锁,哪个线程抢到这个锁我们决定不了,哪个线程抢到锁哪个线程先执行,没有抢到的线程需要等待 加上互斥锁多任务瞬间变成单任务,性能会下降,也就是说同一时刻只能有一个线程去执行 使用互斥锁的目的 能够保证多个线程访问共享数据不会出现资源竞争及数据错误 上锁、解锁过程 当一个线程调用锁的acquire()方法获得锁时,锁就进去了"locked"状态。 每次只有一个而线程可以获得锁,如果此时另一个线程试图获得这个锁,该线程就会变为"blocked"状态,称为"阻塞",直到拥有锁的线程调用锁的release()方法释放锁之后,锁进入"unlocked"状态。 线程调度程序从处于同步阻塞状态的线程中选择一个来获得锁,并使得该线程进入运行"running"状态 死锁 一直等待对方释放锁的情景就是死锁 根据下标在列表中取值,但是要保证同一时刻只能有一个线程去取值 # 死锁示例: import time, threading # 创建互斥锁 lock = threading.Lock() def get_value(index): # 上锁 lock.acquire() print(threading.current_thread().name) my_list = [3, 6, 8, 1] # 判断下标释放越界 if index >= len(my_list): print("下标越界:", index) return value = my_list[index] print(value) time.sleep(1) # 释放锁 lock.release() if __name__ == '__main__': # 模拟大量线程去执行取值操作 for i in range(30): sub_thread = threading.Thread(target=get_value, args=(i,)) sub_thread.start() 避免死锁: # 死锁示例: import time, threading # 创建互斥锁 lock = threading.Lock() def get_value(index): # 上锁 lock.acquire() print(threading.current_thread().name) my_list = [3, 6, 8, 1] # 判断下标释放越界 if index >= len(my_list): print("下标越界:", index) lock.release() return value = my_list[index] print(value) time.sleep(1) # 释放锁 lock.release() if __name__ == '__main__': # 模拟大量线程去执行取值操作 for i in range(30): sub_thread = threading.Thread(target=get_value, args=(i,)) sub_thread.start() 小结:使用互斥锁的时候需要注意死锁的问题,要在合适的地方注意释放锁 死锁一旦发生就会造成应用的停止响应 个人独立博客:www.limiao.tech 微信公众号:TechBoard
优秀的个人博客,低调大师

Java网络编程-NIO

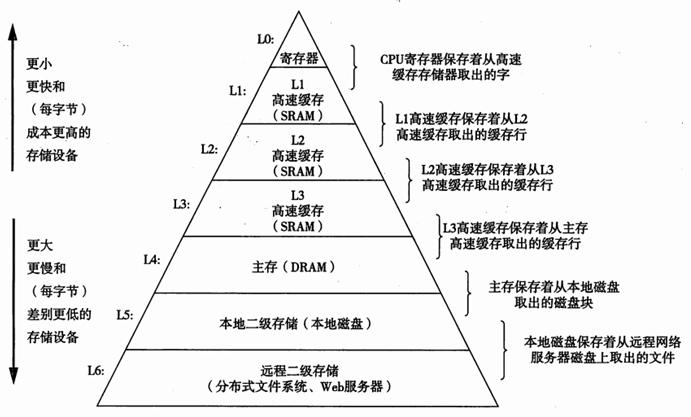
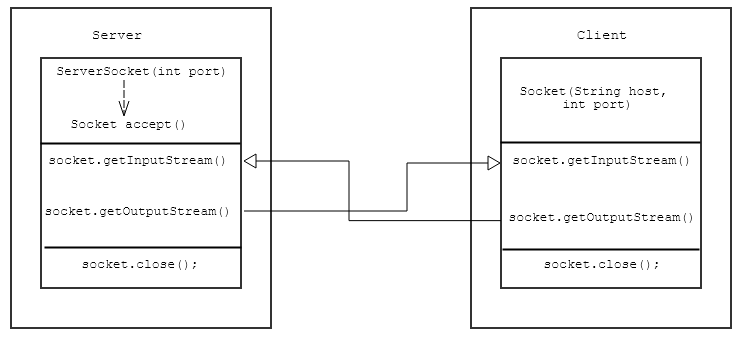
构造函数 首先放一个NIO的使用流程 1、创建ServerSocketChannel,配置为非阻塞模式 2、绑定监听,配置TCP参数,例如backlog大小; 3、创建一个独立的IO线程,用于轮询多路复用器Selector; 4、创建Selector,将之前创建的ServerSocketChannel注册到Selector上,监听SelectionKey.ACCEPT 5、启动IO线程,在循环体中之行Selector.select()方法,轮询就绪的Channel; 6、当轮训到了处于就绪状态的channel时,需要对其进行判断,如果是OP_ACCEPT状态,说明是新的客户端接入,则调用ServerSocketChannel.accept()方法接受新的客户端; 7、设置新借入的客户端链路SocketChannel为非阻塞模式,配置其他的一些TCP 8、将SocketChannel注册到Selector,监听OP_READ操作位; 9、如果轮训的Channel为OP_READ,则说明SocketChannel中,有心得就绪的数据包需要读取,则构造ByteBuffer对象,读取数据包; 10、如果轮训的Channel为OP_WRITE,说明还有数据没有发送完成,需要继续发送

优秀的个人博客,低调大师

Android--Https编程

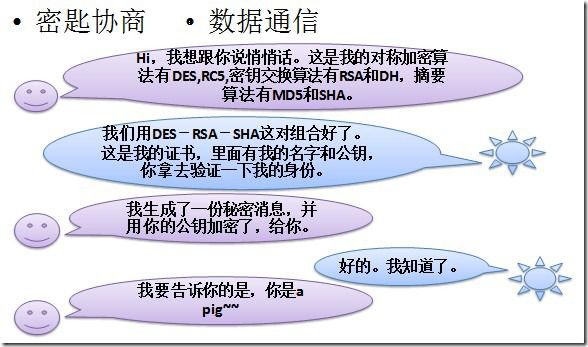
概述 SSL(Secure Sockets Layer安全套接层),为网景公司(Netscape)所研发,用以保障在Internet 上数据传输之安全,利用数据加密(Encryption)技术,可确保数据在网络上之传输过程中不会被截取及窃听。一般通用之规格为40 bit 之安全标准,美国则已推出128 bit 之更高安全标准,但限制出境。只要3.0 版本以上之I.E.或Netscape 浏览器即可支持SSL。 TLS(Transport Layer Security传输层安全),用于在两个通信应用程序之间提供保密性和数据完整性。TLS 是SSL 的标准化后的产物,有1.0 ,1.1 ,1.2 三个版本,默认使用1.0。TLS1.0 和SSL3.0 几乎没有区别,事实上我们现在用的都是TLS,但因为历史上习惯了SSL 这个称呼。 SSL 通信简单图示: SSL 通信详细图示: 当请求使用自签名证书的网站数据时,例如请求12306 的客运服务页面:https://kyfw.12306.cn/otn/,则会报下面的错误,原因是客户端的根认证机构不能识别该证书错误信息:unable to find valid certification path to requested target 解决方案1 一个证书可不可信,是由TrustManager 决定的,所以我们只需要自定义一个什么都不做的TrustManager即可,服务器出示的所有证书都不做校验,一律放行。 public static void main(String[] args) throws Exception { //协议传输层安全TLS(transport layer secure) SSLContext sslContext = SSLContext.getInstance("TLS"); //创建信任管理器(TrustManager 负责校验证书是否可信) TrustManager[] tm = new TrustManager[]{new EmptyX509TrustManager()}; //使用自定义的信任管理器初始化SSL 上下文对象 sslContext.init(null, tm, null); //设置全局的SSLSocketFactory 工厂(对所有ssl 链接都产生影响) HttpsURLConnection.setDefaultSSLSocketFactory(sslContext.getSocketFactory()); //URL url = new URL("https://www.baidu.com"); URL url = new URL("https://kyfw.12306.cn/otn/"); HttpsURLConnection conn = (HttpsURLConnection) url.openConnection(); InputStream in = conn.getInputStream(); System.out.println(Util.inputstream2String(in)); } /** * 自定义一个什么都不做的信任管理器,所有证书都不做校验,一律放行 */ private static class EmptyX509TrustManager implements X509TrustManager{ @Override public void checkClientTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public void checkServerTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public X509Certificate[] getAcceptedIssuers() { return null; } } 解决方案2 12306 服务器出示的证书是中铁集团SRCA 给他颁发的,所以SRCA 的证书是能够识别12306 的证书的,所以只需要把SRCA 证书导入系统的KeyStore 里,之后交给TrustManagerFactory 进行初始化,则可把SRCA 添加至根证书认证机构,之后校验的时候,SRCA 对12306 证书校验时就能通过认证。 这种解决方案有两种使用方式:一是直接使用SRCA.cer 文件,二是使用改文件的RFC 格式数据,将其写在代码里。 //12306 证书的RFC 格式(注意要记得手动添加两个换行符) private static final String CERT_12306_RFC = "-----BEGIN CERTIFICATE-----\n"+ "MIICmjCCAgOgAwIBAgIIbyZr5/jKH6QwDQYJKoZIhvcNAQEFBQAwRzELMAkGA1UEBhMCQ04xKTAn"+ "BgNVBAoTIFNpbm9yYWlsIENlcnRpZmljYXRpb24gQXV0aG9yaXR5MQ0wCwYDVQQDEwRTUkNBMB4X"+ "DTA5MDUyNTA2NTYwMFoXDTI5MDUyMDA2NTYwMFowRzELMAkGA1UEBhMCQ04xKTAnBgNVBAoTIFNp"+ "bm9yYWlsIENlcnRpZmljYXRpb24gQXV0aG9yaXR5MQ0wCwYDVQQDEwRTUkNBMIGfMA0GCSqGSIb3"+ "DQEBAQUAA4GNADCBiQKBgQDMpbNeb34p0GvLkZ6t72/OOba4mX2K/eZRWFfnuk8e5jKDH+9BgCb2"+ "9bSotqPqTbxXWPxIOz8EjyUO3bfR5pQ8ovNTOlks2rS5BdMhoi4sUjCKi5ELiqtyww/XgY5iFqv6"+ "D4Pw9QvOUcdRVSbPWo1DwMmH75It6pk/rARIFHEjWwIDAQABo4GOMIGLMB8GA1UdIwQYMBaAFHle"+ "tne34lKDQ+3HUYhMY4UsAENYMAwGA1UdEwQFMAMBAf8wLgYDVR0fBCcwJTAjoCGgH4YdaHR0cDov"+ "LzE5Mi4xNjguOS4xNDkvY3JsMS5jcmwwCwYDVR0PBAQDAgH+MB0GA1UdDgQWBBR5XrZ3t+JSg0Pt"+ "x1GITGOFLABDWDANBgkqhkiG9w0BAQUFAAOBgQDGrAm2U/of1LbOnG2bnnQtgcVaBXiVJF8LKPaV"+ "23XQ96HU8xfgSZMJS6U00WHAI7zp0q208RSUft9wDq9ee///VOhzR6Tebg9QfyPSohkBrhXQenvQ"+ "og555S+C3eJAAVeNCTeMS3N/M5hzBRJAoffn3qoYdAO1Q8bTguOi+2849A=="+ "-----END CERTIFICATE-----\n"; public static void main(String[] args) throws Exception { // 使用传输层安全协议TLS(transport layer secure) SSLContext sslContext = SSLContext.getInstance("TLS"); //使用SRCA.cer 文件的形式 //FileInputStream certInputStream = new FileInputStream(new File("srca.cer")); //也可以通过RFC 字符串的形式使用证书 ByteArrayInputStream certInputStream = new ByteArrayInputStream(CERT_12306_RFC.getBytes()); // 初始化keyStore,用来导入证书 KeyStore keyStore = KeyStore.getInstance(KeyStore.getDefaultType()); //参数null 表示使用系统默认keystore,也可使用其他keystore(需事先将srca.cer 证书导入 keystore 里) keyStore.load(null); //通过流创建一个证书 Certificate certificate = CertificateFactory.getInstance("X.509") .generateCertificate(certInputStream); // 把srca.cer 这个证书导入到KeyStore 里,别名叫做srca keyStore.setCertificateEntry("srca", certificate); // 设置使用keyStore 去进行证书校验 TrustManagerFactory trustManagerFactory = TrustManagerFactory .getInstance(TrustManagerFactory.getDefaultAlgorithm()); trustManagerFactory.init(keyStore); //用我们设定好的TrustManager 去做ssl 通信协议校验,即证书校验 sslContext.init(null, trustManagerFactory.getTrustManagers(), null); HttpsURLConnection.setDefaultSSLSocketFactory(sslContext .getSocketFactory()); URL url = new URL("https://kyfw.12306.cn/otn/"); HttpsURLConnection conn = (HttpsURLConnection) url.openConnection(); InputStream in = conn.getInputStream(); System.out.println(Util.inputstream2String(in)); } Android 里的https 请求: 把scra.cer 文件考到assets 或raw 目录下,或者直接使用证书的RFC 格式,接下来的做法和java工程代码一样 //ByteArrayInputStream in = new ByteArrayInputStream("rfc".getBytes()); CertificateFactory cf = CertificateFactory.getInstance("X.509"); InputStream caInput = new BufferedInputStream(new FileInputStream("load-der.crt")); Certificate ca; try { ca = cf.generateCertificate(caInput); System.out.println("ca=" + ((X509Certificate) ca).getSubjectDN()); } finally { caInput.close(); } String keyStoreType = KeyStore.getDefaultType(); KeyStore keyStore = KeyStore.getInstance(keyStoreType); keyStore.load(null, null); keyStore.setCertificateEntry("ca", ca); String tmfAlgorithm = TrustManagerFactory.getDefaultAlgorithm(); TrustManagerFactory tmf = TrustManagerFactory.getInstance(tmfAlgorithm); tmf.init(keyStore); SSLContext context = SSLContext.getInstance("TLS"); context.init(null, tmf.getTrustManagers(), null); URL url = new URL("https://certs.cac.washington.edu/CAtest/"); HttpsURLConnection urlConnection = (HttpsURLConnection)url.openConnection(); urlConnection.setSSLSocketFactory(context.getSocketFactory()); InputStream in = urlConnection.getInputStream(); copyInputStreamToOutputStream(in, System.out); 双向证书验证 CertificateFactory certificateFactory = CertificateFactory.getInstance("X.509"); KeyStore keyStore = KeyStore.getInstance(KeyStore.getDefaultType()); keyStore.load(null); SSLContext sslContext = SSLContext.getInstance("TLS"); TrustManagerFactory trustManagerFactory = TrustManagerFactory. getInstance(TrustManagerFactory.getDefaultAlgorithm()); trustManagerFactory.init(keyStore); //初始化keystore KeyStore clientKeyStore = KeyStore.getInstance(KeyStore.getDefaultType()); clientKeyStore.load(getAssets().open("client.bks"), "123456".toCharArray()); KeyManagerFactory keyManagerFactory = KeyManagerFactory.getInstance(KeyManagerFactory.getDefaultAlgorithm()); keyManagerFactory.init(clientKeyStore, "123456".toCharArray()); sslContext.init(keyManagerFactory.getKeyManagers(), trustManagerFactory.getTrustManagers(), new SecureRandom()); Nogotofail 网络流量安全测试工具,Google的开源项目:https://github.com/google/nogotofail Android安全加密专题总结 以上学习所有内容,对称加密、非对称加密、消息摘要、数字签名等知识都是为了理解数字证书工作原理而作为一个预备知识。数字证书是密码学里的终极武器,是人类几千年历史总结的智慧的结晶,只有在明白了数字证书工作原理后,才能理解Https 协议的安全通讯机制。最终才能在SSL 开发过程中得心应手。 另外,对称加密和消息摘要这两个知识点是可以单独拿来使用的。 数字证书使用到了以上学习的所有知识 对称加密与非对称加密结合使用实现了秘钥交换,之后通信双方使用该秘钥进行对称加密通信。 消息摘要与非对称加密实现了数字签名,根证书机构对目标证书进行签名,在校验的时候,根证书用公钥对其进行校验。若校验成功,则说明该证书是受信任的。 Keytool 工具可以创建证书,之后交给根证书机构认证后直接使用自签名证书,还可以输出证书的RFC格式信息等。 数字签名技术实现了身份认证与数据完整性保证。 加密技术保证了数据的保密性,消息摘要算法保证了数据的完整性,对称加密的高效保证了数据处理的可靠性,数字签名技术保证了操作的不可否认性。 通过以上内容的学习,我们要能掌握以下知识点: 基础知识:bit 位、字节、字符、字符编码、进制转换、io 知道怎样在实际开发里怎样使用对称加密解决问题 知道对称加密、非对称加密、消息摘要、数字签名、数字证书是为了解决什么问题而出现的 了解SSL 通讯流程 实际开发里怎样请求Https 的接口

优秀的个人博客,低调大师

Android编程设置LayoutParams

1 RelativeLayout.LayoutParams linearParams = (RelativeLayout.LayoutParams)viewHolder.headerWraper.getLayoutParams(); 2 RelativeLayout.LayoutParams textParams = (RelativeLayout.LayoutParams)viewHolder.textWrapper.getLayoutParams(); 3 4 linearParams.addRule(RelativeLayout.ALIGN_PARENT_RIGHT, 0); //清空alignParentRight参数 5 textParams.addRule(RelativeLayout.ALIGN_LEFT, 0); //清空toLeftOf参数 6 7 if (fromToType == Constants.FromToType.FromToTypeFromThisUser.getValue()) { //根据条件设置Layout参数 8 9 linearParams.addRule(RelativeLayout.ALIGN_PARENT_RIGHT); 10 textParams.addRule(RelativeLayout.LEFT_OF, R.id.header_wrapper); 11 12 viewHolder.headerWraper.setLayoutParams(linearParams); 13 viewHolder.textWrapper.setLayoutParams(textParams); 14 15 Logger.d(TAG, "from this user"); 16 } 17 else{ 18 Logger.d(TAG, "from otehr user"); 19 20 linearParams.addRule(RelativeLayout.ALIGN_PARENT_LEFT); 21 textParams.addRule(RelativeLayout.RIGHT_OF , R.id.header_wrapper); 22 23 viewHolder.headerWraper.setLayoutParams(linearParams); 24 viewHolder.textWrapper.setLayoutParams(textParams); 25 26 viewHolder.textWrapper.setBackgroundResource(R.drawable.chat_other); 27 } 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/p/3562518.html ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册