首页 文章 精选 留言 我的

精选列表

搜索[Agent团队],共10000篇文章
优秀的个人博客,低调大师

带你走进灵动岛 | 京东云技术团队

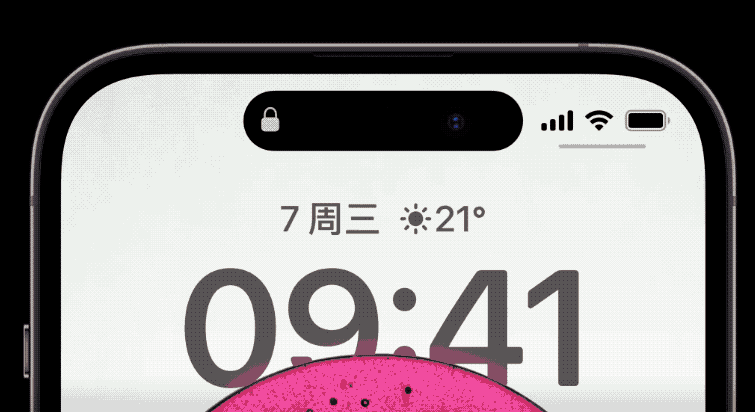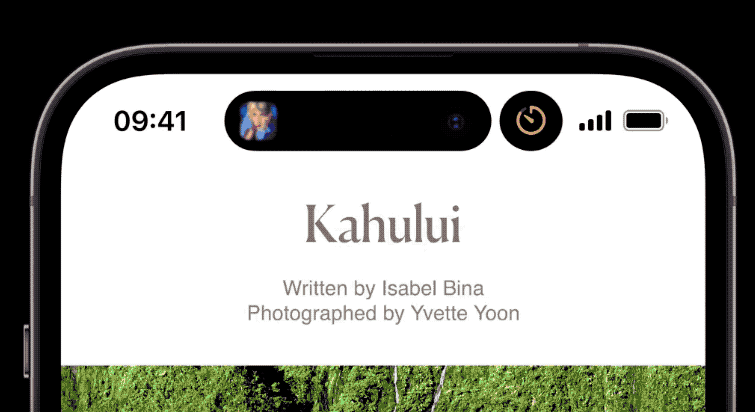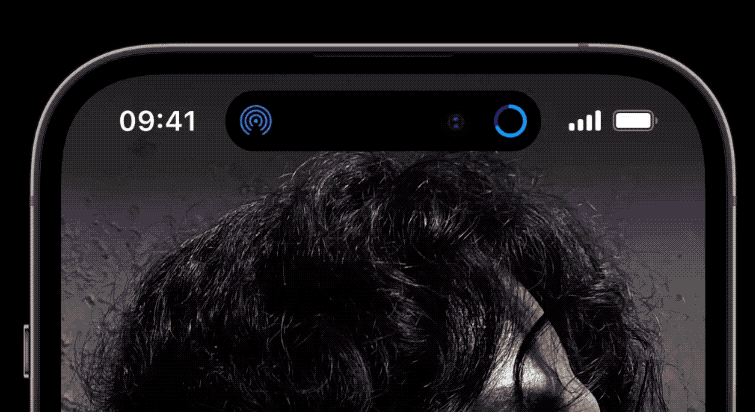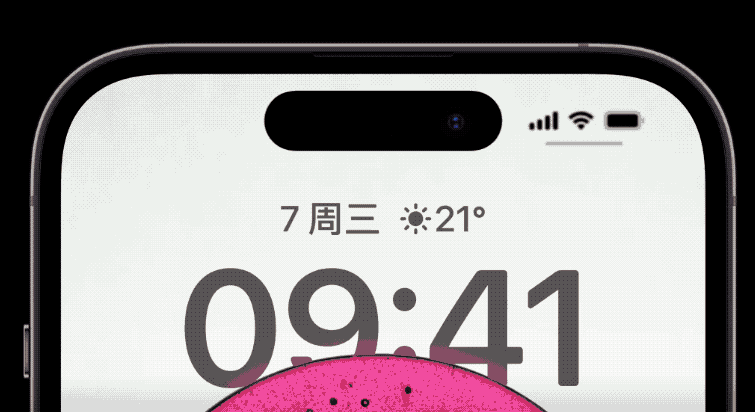
前言 iOS最近几年新特性 iOS14 视频画中画 AppLibrary 桌面小组件 照片隐私加强 应用限免 智能折叠 全新siri悬浮显示 iOS15 FaceTime支持屏幕共享 信息和新增拟我表情 推出专注模式 通知重新设计,图标变得更大 地图公共交通路线置顶,增加时间显示 识别图片上文字信息 支持照片信息和照片上的文字进行搜索 iOS16 iOS 16 锁定界面 锁定界面小组件 锁屏界面的实时活动 iPhone锁定全屏幕音乐播放器 电池百分比出来啦 视频实况文本 快速查询Wi-Fi密码 iOS17 设置您的待机屏幕 优先考虑交互式小部件 定制您的联系海报 创建您自己的贴纸 设置新的 Safari 配置文件 开启反追踪 分享您的 iCloud 钥匙串密码 一、简介 实时活动(Live Activity),是iOS16新增的扩展组件功能,可以在灵动岛和锁定屏幕上显示应用程序的实时数据。用于追踪事件和任务进度实时活动的开始和结束都是离散的,具体画面场景如下:苹果 苹果在 iPhone 14 Pro 及 iPhone 14 Pro MAX 上推出了灵动岛。灵动岛将 iPhone 前置镜头和软件通知结合在一起的全新设计,用出色的交互设计掩盖硬件的缺陷,是一次交互玩法的革新。灵动岛可以通过点按、长按、轻扫来进行交互,最多支持两个应用同时“登岛”。 灵动岛全称 Dynamic Island,作为 iOS 中实时活动(Live Activities)功能的一部分,用来展示需要实时更新的消息。例如外卖配送信息,地图实时导航信息等。灵动岛有 3 种展现形式。 1.1 展现形式 1.1.1 紧凑(Compact) 当系统只有 1 个实时活动的内容时,灵动岛默认使用紧凑模式。紧凑模式下UI由头部(Leading side)和尾部(Trailing side)组成,如图所示。用户可以点击灵动岛打开 App 查看实时活动的内容 1.1.2 最小化(Minimal) 当系统有多个实时活动的内容时,灵动岛自动切换使用最小化模式。最小化模式下由附着的头部(Leading(attached))和分割开的尾部(Trailing(detached))组成,如图所示。和紧凑模式一样,最小化模式也支持用户点击打开 App。 1.1.3扩展(Expanded) 当用户在紧凑或最小化模式轻扫或长按灵动岛时,灵动岛可以切换成扩展模式。用于向用户展示更多信息。扩展模式的 UI 设计尽量保持和紧凑模式一致,用户从紧凑模式切换到扩展模式会有一个平滑的体验。 当我们向 App Store 提交了适配灵动岛的 App 版本时,以上 3 种模式都需要适配。 二、场景限制 2.1样式限制 1、实时活动针对锁定屏幕和灵动岛提供了不同的视图。锁定屏幕可以出现在所有支持 iOS 16 的设备上。而灵动岛在支持设备上,使用以下视图显示实时活动:紧凑前视图、紧凑尾视图、最小视图和扩展视图。 2、当用户触摸灵动岛,且灵动岛中有紧凑或最小视图,同时实时活动更新时,会出现扩展视图。在不支持灵动岛的设备上,扩展视图显示为实时活动更新的横幅。 3、为确保系统可以在每个位置显示 App 的实时活动,开发者必须支持所有视图。 建议:同场景多卡片由于样式趋同且折叠,不建议同时创建多卡片 灵动岛页面需要实现的部分有4个: a、不支持灵动岛的机型 或 锁屏时的 显示 b、紧凑级展示(即左右贴合灵动岛的展示) c、多Live activity时的展示(即极小视图,左贴合,右分离) d、扩展视图(长按灵动岛时触发) 备注:还有一个App同时存在的实时活动面板最多只能创建5个,这也是一个场景约束条件。Error requesting delivery Live Activity The operation couldn’t be completed. Maximum number of activities for target already exists 2.2 时间限制 实时活动最多可以保持八小时的活动状态,除非其应用程序或人员在此限制之前结束活动。超过八小时限制后,系统自动结束直播活动,并立即将其移出动态岛。但是,实时活动会保留在锁定屏幕上,直到有人将其删除,或者在系统将其删除之前最多再保留四个小时(以先到者为准)。因此,实时活动在锁定屏幕上保留最多 12 小时。 官方表述:https://developer.apple.com/documentation/activitykit/displaying-live-data-with-live-activities A Live Activity can be active for up to eight hours unless your app or a person ends it before this limit. After the 8-hour limit, the system automatically ends it. When a Live Activity ends, the system immediately removes it from the Dynamic Island. However, the Live Activity remains on the Lock Screen until a person removes it or for up to four additional hours before the system removes it — whichever comes first. As a result, a Live Activity remains on the Lock Screen for a maximum of twelve hours. 2.3 数据更新 每个实时活动运行在自己的沙盒中,与小组件不同的是,它无法访问网络或接收位置更新。若要更新实时活动的动态数据,少量(不能超过4KB)数据可通过远程推送通知发送,或通过ActivityKit 框架后台活动刷新数据。 ActivityKit 更新和 ActivityKit 推送通知的更新动态数据大小不能超过 4 KB。 2.4 网络限制 a、卡片本身禁止定位以及网络请求,数据刷新依赖本地刷新,实施活动推送刷新,同2)所述; b、Live Activity内部禁用网络图片,传统的服务端传图片URL的方式无法满足实际使用,但是希望传入订单图片来个性化地表达并且区分不同订单。 iOS 16 beta版创建时可以通过将图片转为Data格式传入卡片,但是iOS16.1该方案仅限传入4KB左右的图片(API限制),因此暂时不考虑非本地图片方案,采用内置图片方式实现。 2.5 埋点限制 **场景情况:**由于默认情况点击是回主程序,而并不是固定页面,因此有必要自定义widgetUrl(如用于回到订单页面),也可以通过Link实现分区域的跳转,Link和widgetUrl共存时,点击Link区域会响应Link,因此两者同时使用即可。 无法在widget内部直接添加埋点,并且灵动岛收起时,仅支持添加同一个widgetUrl,对于收起状态添加Link并没有响应。 **埋点方式:**因为点击直接跳转到主App,因此考虑将埋点参数加入URL参数即可,主App解析时埋点。但是无法记录包括用户查看、用户关闭(关闭卡片 继续发送推送也没有报错 因此无法判断)等行为的埋点。 对于灵动岛的区分,实际测试发现,在展开模式下,可以加入Link并且可以正常响应,这与官方文档中的描述一致。 三、适配 3.1 UI适配 1、尺寸: 目前只有 iPhone 14 Pro 及 iPhone 14 Pro MAX 具有灵动岛功能。在两种机型上,灵动岛的圆角半径都为 44Points,这个数值和前置深感摄像头的半径是一样的。按照前述的 3 种模式,灵动岛的具体参数如下表格所示(表格涉及的数值表示Points)。 机型 屏幕尺寸 紧凑模式(头部) 紧凑模式(尾部) 最小化模式 展开模式 iPhone 14 Pro 393*852 52.33*36.67 52.33*36.67 36.67*36.67 371*(84-160) iPhone 14 Pro Max 430*932 62.33*36.67 62.33*36.67 36.67*36.67 408*(84-160) 2、颜色 开发者无法更改灵动岛的背景颜色,只能更改文字颜色、素材颜色、灵动岛边框颜色等。UI 适配需要考虑系统的深色模式,必要情况可以使用两套 UI。 3.2开发适配 3.2.1开发框架简介 苹果在 iOS 16.1 正式对外开放了灵动岛适配框架ActivityKit,第三方 App 可以使用这些ActivityKit完成灵动岛适配工作。注意ActivityKit的 API 目前仅适用于 iPhone。灵动岛使用WidgetKit和SwiftUI完成 UI 开发工作,ActivityKit在其中扮演创建Activity,请求数据,更新数据,结束Activity的角色。 3.2.2权限管理 灵动岛作为实时活动的一部分,需要实时活动权限才能正常展示。和通知权限,相机权限等类似,实时活动权限需要 App 3.2.3 生命周期 Request Update Observe avtivity state End import ActivityKit struct AdventureAttributes: ActivityAttributes { //不可变 let hero: EmojiRanger /// The associated type that describes the dynamic content of a Live Activity. /// /// The dynamic data of a Live Activity that's encoded by `ContentState` can't exceed 4KB. struct ContentState: Codable & Hashable { let currentHealthLevel: Double let eventDescription: String } } let adventure = AdventureAttributes(hero: hero) let initialState = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "Adventure has begun!" ) let content = ActivityContent(state: initialState, staleDate: nil, relevanceScore: 0.0) let activity = try Activity.request( attributes: adventure, content: content, pushType: nil ) let heroName = activity.attributes.hero.name let contentState = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "\(heroName) has taken a critical hit!" ) var alertConfig = AlertConfiguration( title: "\(heroName) has taken a critical hit!", body: "Open the app and use a potion to heal \(heroName)", sound: .default ) activity.update( ActivityContent<AdventureAttributes.ContentState>( state: contentState, staleDate: nil ), alertConfiguration: alertConfig ) // Observe activity state asynchronously func observeActivity(activity: Activity<AdventureAttributes>) { Task { for await activityState in activity.activityStateUpdates { if activityState == .dismissed { self.cleanUpDismissedActivity() } } } } // Observe activity state synchronously let activityState = activity.activityState if activityState == .dismissed { self.cleanUpDismissedActivity() } let hero = activity.attributes.hero let finalContent = AdventureAttributes.ContentState( currentHealthLevel: hero.healthLevel, eventDescription: "Adventure over! \(hero.name) has defeated the boss! Congrats!" ) let dismissalPolicy: ActivityUIDismissalPolicy = .default activity.end( ActivityContent(state: finalContent, staleDate: nil), dismissalPolicy: dismissalPolicy) } 3.2.4UI import WidgetKit import SwiftUI @main struct EmojiRangersWidgetBundle: WidgetBundle { var body: some Widget { EmojiRangerWidget() LeaderboardWidget() AdventureActivityConfiguration() } } struct AdventureActivityConfiguration: Widget { var body: some WidgetConfiguration { ActivityConfiguration(for: AdventureAttributes.self) { context in // ... // Create the view that appears on the Lock Screen and as a // banner on the Home Screen of devices that don't support the // Dynamic Island. } dynamicIsland: { context in // Create the views that appear in the Dynamic Island. DynamicIsland { // Create the expanded view. // Leading region // Expanded region // Bottom region } compactLeading: { // Create the compact leading view. // ... } compactTrailing: { // Create the compact trailing view. // ... } minimal: { // Create the minimal view. // ... } } } } 四、远程通知更新数据 实时活动也支持远程推送更新,根据文档以下9点要求实现(avtivity远程推送每小时有通知预算(数量未明确),超出后系统将关闭通知) 1、确保启动activity时[request(attributes:contentState:pushType:)传入pushType参数(.token); 2、获取启动后的activity的推送令牌pushToken,传给服务端用来推送更新activity;(实时活动的pushToken不是消息通知的token,这个是独立出来的) 3、服务端推送的更新内容字段需要和ActivityAttributes的ContentState中定义的动态数据字段对应; 4、设置推送的报头apns-push-type的值为liveactivity; 5、设置推送的报头apns-topic的值为.push-type.liveactivity; 6、正确的推送对应的内容和状态; 7、使用pushTokenUpdates监听pushToken变化,如有变化,就令牌失效,需要将新的令牌传给服务器; 8、当Activity结束时,服务器端的pushToken将失效; { "aps": { "timestamp": 1685952000, "event": "update", "content-state": { "currentHealthLevel": 0.0, "eventDescription": "Power Panda has been knocked down!" }, "alert": { "title": "Power Panda is knocked down!", "body": "Use a potion to heal Power Panda!", "sound": "default" } } } 注意: 1、不用为推送提供声音 , 如果推送延迟,在activity结束后收到时将被忽略,avtivity每小时有通知预算(数量未明确),超出后系统将关闭通知; 2、实时活动的pushToken不是消息通知的token,这个token上报到JDPush服务,需要单独管理和归类。 备注: 灵动岛的实时信息要有明确的开始和结束时间点 当一个实时信息持续超过 8 小时,系统会从灵动岛移除这个 App 的信息 当一个实时活动结束时,灵动岛上的展示信息也会立即被系统移除 避免在灵动岛上显示广告,毕竟引起用户反感可以被直接关闭 App 要能够响应灵动岛的点击信息,跳转到 App 中的正确子页面,而不是停留在 App 的首页 运用场景 1、需在屏幕驻留的文字、图像为主的信息:如地图导航、airdrop 传输情况等; 2、后台进行的音频类:如接电话、放音乐、录音、倒计时等; 3、即时交互反馈:如充电、静音、人脸识别等。超过这三类信息后,桌面可能会变得杂乱无章 参考文章 ActivityKit官方文档 https://developer.apple.com/videos/play/wwdc2023/10194 https://developer.apple.com/videos/play/wwdc2023/10184 https://www.jianshu.com/p/f410eba6c392 https://www.bilibili.com/read/cv18549307/ 作者:京东零售李艳敏 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅析Redis大Key | 京东云技术团队

一、背景 在京东到家购物车系统中,用户基于门店能够对商品进行加车操作。用户与门店商品使用Redis的Hash类型存储,如下代码块所示。不知细心的你有没有发现,如果单门店加车商品过多,或者门店过多时,此Key就会越来越大,从而影响线上业务。 userPin:{ storeId:{门店下加车的所有商品基本信息}, storeId:{门店下加车的所有商品基本信息}, ...... } 二、BigKey的界定和如何产生 2.1、BigKey的界定 BigKey称为大Key,通常以Key对应Value的存储大小,或者Key对应Value的数量来进行综合判断。对于大Key也没有严格的定义区分,针对String与非String结构,给出如下定义: String:String类型的 Key 对应的 Value 超过 10KB 非String结构(Hash,Set,ZSet,List):Value的数量达到10000个,或者Vaule的总大小为100KB 集群中Key的总数超过1亿 2.2、如何产生 1、数据结构设置不合理,例如集合中元素唯一时,应该使用Set替换List; 2、针对业务缺少预估性,没有预见Value动态增长; 3、Key没有设置过期时间,把缓存当成垃圾桶,一直再往里面扔,但是从不处理。 三、BigKey的危害 3.1、数据倾斜 redis数据倾斜分为数据访问倾斜和数据量倾斜,会导致该Key所在的数据分片节点CPU使用率、带宽使用率升高,从而影响该分片上所有Key的处理。 数据访问倾斜:某节点中key的QPS高于其他节点中的Key 数据量倾斜:某节点中key的大小高于其他节点中的Key,如下图,实例1中的Key1存储高于其他实例。 3.2、网络阻塞 Redis服务器是一个事件驱动程序,有文件事件和时间事件,文件事件和时间事件都是主线程完成。其中文件事件就是服务器对套接字操作的抽象,客户端与服务端的通信会产生相应的文件事件,服务器通过监听并处理这些事件来完成一系列网络通信操作。 Redis基于Reactor模式开发了自己的网络事件处理器,即文件事件处理器,该处理器内部使用I/O多路复用程序,可同时监听多个套接字,并根据套接字执行的任务来关联不同的事件处理器。文件事件处理器以单线程的方式运行,但是通过I/O多路复用程序来监听多个套接字,既实现了高性能网络通信模型,又保持了内部单线程设计的简单性。文件事件处理器构成如下图: 文件事件是对套接字操作的抽象,包括连接应答,写入,读取,关闭,因为一个服务器会连接多个套接字,所以文件事件可能并发出现,即使文件事件并发的出现,但是I/O多路复用程序会将套接字放入一个队列,通过队列有序的,同步的每次一个套接字的方式向文件事件分派器传送套接字,当让一个套接字产生的事件被处理完毕后,I/O多路复用程序才会继续向文件事件分派器传送下一个套接字,当有大key时,单次操作时间延长,导致网络阻塞。 3.3、慢查询 严重影响 QPS 、TP99 等指标,对大Key进行的慢操作会导致后续的命令被阻塞,从而导致一系列慢查询。 3.4、CPU压力 当单Key过大时,每一次访问此Key都可能会造成Redis阻塞,其他请求只能等待了。如果应用中设置了超时等,那么上层就会抛出异常信息。最后删除的时候也会造成redis阻塞,到时候内存中数据量过大,就会造成CPU负载过高。单个分片cpu占用率过高,其他分片无法拥有cpu资源,从而被影响。此外,大 key 对持久化也有些影响。fork 操作会拷贝父进程的页表项,如果过大,会占用更多页表,主线程阻塞拷贝需要一定的时间。 四、如何检测BigKey 4.1、redis-cli --bigkeys 首先我们从运行结果出发。首先通过脚本插入一些数据到redis中,然后执行redis-cli的--bigkeys选项 $ redis-cli --bigkeys # Scanning the entire keyspace to find biggest keys as well as # average sizes per key type. You can use -i 0.01 to sleep 0.01 sec # per SCAN command (not usually needed). -------- 第一部分start ------- [00.00%] Biggest string found so far 'key-419' with 3 bytes [05.14%] Biggest list found so far 'mylist' with 100004 items [35.77%] Biggest string found so far 'counter:__rand_int__' with 6 bytes [73.91%] Biggest hash found so far 'myobject' with 3 fields -------- 第一部分end ------- -------- summary ------- -------- 第二部分start ------- Sampled 506 keys in the keyspace! Total key length in bytes is 3452 (avg len 6.82) Biggest string found 'counter:__rand_int__' has 6 bytes Biggest list found 'mylist' has 100004 items Biggest hash found 'myobject' has 3 fields -------- 第二部分end ------- -------- 第三部分start ------- 504 strings with 1403 bytes (99.60% of keys, avg size 2.78) 1 lists with 100004 items (00.20% of keys, avg size 100004.00) 0 sets with 0 members (00.00% of keys, avg size 0.00) 1 hashs with 3 fields (00.20% of keys, avg size 3.00) 0 zsets with 0 members (00.00% of keys, avg size 0.00) -------- 第三部分end ------- 以下我们分三步对bigkeys选项源码原理进行解析,简要流程如下图: 4.1.1、第一部分是如何进行找key的呢? Redis找bigkey的函数是static void findBigKeys(int memkeys, unsigned memkeys_samples),因为--memkeys选项和--bigkeys选项是公用同一个函数,所以使用memkeys时会有额外两个参数memkeys、memkeys_sample,但这和--bigkeys选项没关系,所以不用理会。findBigKeys具体函数框架为: 1.申请6个变量用以统计6种数据类型的信息(每个变量记录该数据类型的key的总数量、bigkey是哪个等信息) typedef struct { char *name;//数据类型,如string char *sizecmd;//查询大小命令,如string会调用STRLEN char *sizeunit;//单位,string类型为bytes,而hash为field unsigned long long biggest;//最大key信息域,此数据类型最大key的大小,如string类型是多少bytes,hash为多少field unsigned long long count;//统计信息域,此数据类型的key的总数 unsigned long long totalsize;//统计信息域,此数据类型的key的总大小,如string类型是全部string总共多少bytes,hash为全部hash总共多少field sds biggest_key;//最大key信息域,此数据类型最大key的键名,之所以在数据结构末尾是考虑字节对齐 } typeinfo; dict *types_dict = dictCreate(&typeinfoDictType); typeinfo_add(types_dict, "string", &type_string); typeinfo_add(types_dict, "list", &type_list); typeinfo_add(types_dict, "set", &type_set); typeinfo_add(types_dict, "hash", &type_hash); typeinfo_add(types_dict, "zset", &type_zset); typeinfo_add(types_dict, "stream", &type_stream); 2.调用scan命令迭代地获取一批key(注意只是key的名称,类型和大小scan命令不返回) /* scan循环扫描 */ do { /* 计算完成的百分比情况 */ pct = 100 * (double)sampled/total_keys;//这里记录下扫描的进度 /* 获取一些键并指向键数组 */ reply = sendScan(&it);//这里发送SCAN命令,结果保存在reply中 keys = reply->element[1];//keys来保存这次scan获取的所有键名,注意只是键名,每个键的数据类型是不知道的。 ...... } while(it != 0); 3.对每个key获取它的数据类型(type)和key的大小(size) /* 检索类型,然后检索大小*/ getKeyTypes(types_dict, keys, types); getKeySizes(keys, types, sizes, memkeys, memkeys_samples); 4.如果key的大小大于已记录的最大值的key,则更新最大key的信息 /* Now update our stats */ for(i=0;i<keys->elements;i++) { ......//前面已解析 //如果遍历到比记录值更大的key时 if(type->biggest<sizes[i]) { /* Keep track of biggest key name for this type */ if (type->biggest_key) sdsfree(type->biggest_key); //更新最大key的键名 type->biggest_key = sdscatrepr(sdsempty(), keys->element[i]->str, keys->element[i]->len); if(!type->biggest_key) { fprintf(stderr, "Failed to allocate memory for key!\n"); exit(1); } //每当找到一个更大的key时则输出该key信息 printf( "[%05.2f%%] Biggest %-6s found so far '%s' with %llu %s\n", pct, type->name, type->biggest_key, sizes[i], !memkeys? type->sizeunit: "bytes"); /* Keep track of the biggest size for this type */ //更新最大key的大小 type->biggest = sizes[i]; } ......//前面已解析 } 5.对每个key更新对应数据类型的统计信息 /* 现在更新统计数据 */ for(i=0;i<keys->elements;i++) { typeinfo *type = types[i]; /* 跳过在SCAN和TYPE之间消失的键 */ if(!type) continue; //对每个key更新每种数据类型的统计信息 type->totalsize += sizes[i];//某数据类型(如string)的总大小增加 type->count++;//某数据类型的key数量增加 totlen += keys->element[i]->len;//totlen不针对某个具体数据类型,将所有key的键名的长度进行统计,注意只统计键名长度。 sampled++;//已经遍历的key数量 ......//后续解析 /* 更新整体进度 */ if(sampled % 1000000 == 0) { printf("[%05.2f%%] Sampled %llu keys so far\n", pct, sampled); } } 4.1.2、第二部分是如何执行的? 1.输出统计信息、最大key信息 /* We're done */ printf("\n-------- summary -------\n\n"); if (force_cancel_loop) printf("[%05.2f%%] ", pct); printf("Sampled %llu keys in the keyspace!\n", sampled); printf("Total key length in bytes is %llu (avg len %.2f)\n\n", totlen, totlen ? (double)totlen/sampled : 0); 2.首先输出总共扫描了多少个key、所有key的总长度是多少。 /* Output the biggest keys we found, for types we did find */ di = dictGetIterator(types_dict); while ((de = dictNext(di))) { typeinfo *type = dictGetVal(de); if(type->biggest_key) { printf("Biggest %6s found '%s' has %llu %s\n", type->name, type->biggest_key, type->biggest, !memkeys? type->sizeunit: "bytes"); } } dictReleaseIterator(di); 4.1.3、第三部分是如何执行的? di为字典迭代器,用以遍历types_dict里面的所有dictEntry。de = dictNext(di)则可以获取下一个dictEntry,de是指向dictEntry的指针。又因为typeinfo结构体保存在dictEntry的v域中,所以用dictGetVal获取。然后就是输出typeinfo结构体里面保存的最大key相关的数据,包括最大key的键名和大小。 di = dictGetIterator(types_dict); while ((de = dictNext(di))) { typeinfo *type = dictGetVal(de); printf("%llu %ss with %llu %s (%05.2f%% of keys, avg size %.2f)\n", type->count, type->name, type->totalsize, !memkeys? type->sizeunit: "bytes", sampled ? 100 * (double)type->count/sampled : 0, type->count ? (double)type->totalsize/type->count : 0); } dictReleaseIterator(di); 4.2、使用开源工具发现大Key 在不影响线上服务的同时得到精确的分析报告。使用redis-rdb-tools工具以定制化方式找出大Key,该工具能够对Redis的RDB文件进行定制化的分析,但由于分析RDB文件为离线工作,因此对线上服务不会有任何影响,这是它的最大优点但同时也是它的最大缺点:离线分析代表着分析结果的较差时效性。对于一个较大的RDB文件,它的分析可能会持续很久很久。 redis-rdb-tools的项目地址为:https://github.com/sripathikrishnan/redis-rdb-tools 五、如何解决Bigkey 5.1、提前预防 设置过期时间,尽量过期时间分散,防止同一时间过期; 存储为String类型的JSON,可以删除不使用的Filed; 例如对象为{"userName":"京东到家","ciyt":"北京"},如果只需要用到userName属性,那就定义新对象,只具有userName属性,精简缓存中数据 存储为String类型的JSON,利用@JsonProperty注解让FiledName字符集缩小,代码例子如下。但是存在缓存数据识别性低的缺点; import org.codehaus.jackson.annotate.JsonProperty; import org.codehaus.jackson.map.ObjectMapper; import java.io.IOException; public class JsonTest { @JsonProperty("u") private String userName; public String getUserName() { return userName; } public void setUserName(String userName) { this.userName = userName; } public static void main(String[] args) throws IOException { JsonTest output = new JsonTest(); output.setUserName("京东到家"); System.out.println(new ObjectMapper().writeValueAsString(output)); String json = "{\"u\":\"京东到家\"}"; JsonTest r1 = new ObjectMapper().readValue(json, JsonTest.class); System.out.println(r1.getUserName()); } } {"u":"京东到家"} 京东到家 采用压缩算法,利用时间换空间,进行序列化与反序列化。同时也存在缓存数据识别性低的缺点; 在业务上进行干预,设置阈值。比如用户购物车的商品数量,或者领券的数量,不能无限的增大; 5.2、如何优雅删除BigKey 5.2.1、DEL 此命令在Redis不同版本中删除的机制并不相同,以下分别进行分析: redis_version < 4.0 版本:在主线程中同步删除,删除大Key会阻塞主线程,见如下源码基于redis 3.0版本。那针对非String结构数据,可以先通过SCAN命令读取部分数据,然后逐步进行删除,避免一次性删除大key导致Redis阻塞。 // 从数据库中删除给定的键,键的值,以及键的过期时间。 // 删除成功返回 1,因为键不存在而导致删除失败时,返回 0 int dbDelete(redisDb *db, robj *key) { // 删除键的过期时间 if (dictSize(db->expires) > 0) dictDelete(db->expires,key->ptr); // 删除键值对 if (dictDelete(db->dict,key->ptr) == DICT_OK) { // 如果开启了集群模式,那么从槽中删除给定的键 if (server.cluster_enabled) slotToKeyDel(key); return 1; } else { // 键不存在 return 0; } } 4.0 版本 < redis_version < 6.0 版本:引入lazy-free,手动开启lazy-free时,有4个选项可以控制,分别对应不同场景下,是否开启异步释放内存机制: lazyfree-lazy-expire:key在过期删除时尝试异步释放内存 lazyfree-lazy-eviction:内存达到maxmemory并设置了淘汰策略时尝试异步释放内存 lazyfree-lazy-server-del:执行RENAME/MOVE等命令或需要覆盖一个key时,删除旧key尝试异步释放内存 replica-lazy-flush:主从全量同步,从库清空数据库时异步释放内存 开启lazy-free后,Redis在释放一个key的内存时,首先会评估代价,如果释放内存的代价很小,那么就直接在主线程中操作了,没必要放到异步线程中执行 redis_version >= 6.0 版本:引入lazyfree-lazy-user-del,只要开启了,del直接可以异步删除key,不会阻塞主线程。具体是为什么呢,现在先卖个关子,在下面进行解析。 5.2.2、SCAN SCAN命令可以帮助在不阻塞主线程的情况下逐步遍历大量的键,以及避免对数据库的阻塞。以下代码是利用scan来扫描集群中的Key。 public void scanRedis(String cursor,String endCursor) { ReloadableJimClientFactory factory = new ReloadableJimClientFactory(); String jimUrl = "jim://xxx/546"; factory.setJimUrl(jimUrl); Cluster client = factory.getClient(); ScanOptions.ScanOptionsBuilder scanOptions = ScanOptions.scanOptions(); scanOptions.count(100); Boolean end = false; int k = 0; while (!end) { KeyScanResult< String > result = client.scan(cursor, scanOptions.build()); for (String key :result.getResult()){ if (client.ttl(key) == -1){ logger.info("永久key为:{}" , key); } } k++; cursor = result.getCursor(); if (endCursor.equals(cursor)){ break; } } } 5.2.3、UNLINK Redis 4.0 提供了 lazy delete (unlink命令) ,下面基于源码(redis_version:7.2版本)分析下实现原理 del与unlink命令底层都调用了delGenericCommand()方法; void delCommand(client *c) { delGenericCommand(c,server.lazyfree_lazy_user_del); } void unlinkCommand(client *c) { delGenericCommand(c,1); } lazyfree-lazy-user-del支持yes或者no。默认是no; 如果设置为yes,那么del命令就等价于unlink,也是异步删除,这也同时解释了之前咱们的问题,为什么设置了lazyfree-lazy-user-del后,del命令就为异步删除。 void delGenericCommand(client *c, int lazy) { int numdel = 0, j; // 遍历所有输入键 for (j = 1; j < c->argc; j++) { // 先删除过期的键 expireIfNeeded(c->db,c->argv[j],0); int deleted = lazy ? dbAsyncDelete(c->db,c->argv[j]) : dbSyncDelete(c->db,c->argv[j]); // 尝试删除键 if (deleted) { // 删除键成功,发送通知 signalModifiedKey(c,c->db,c->argv[j]); notifyKeyspaceEvent(NOTIFY_GENERIC,"del",c->argv[j],c->db->id); server.dirty++; // 成功删除才增加 deleted 计数器的值 numdel++; } } // 返回被删除键的数量 addReplyLongLong(c,numdel); } 下面分析异步删除dbAsyncDelete()与同步删除dbSyncDelete(),底层同时也是调用dbGenericDelete()方法 int dbSyncDelete(redisDb *db, robj *key) { return dbGenericDelete(db, key, 0, DB_FLAG_KEY_DELETED); } int dbAsyncDelete(redisDb *db, robj *key) { return dbGenericDelete(db, key, 1, DB_FLAG_KEY_DELETED); } int dbGenericDelete(redisDb *db, robj *key, int async, int flags) { dictEntry **plink; int table; dictEntry *de = dictTwoPhaseUnlinkFind(db->dict,key->ptr,&plink,&table); if (de) { robj *val = dictGetVal(de); /* RM_StringDMA may call dbUnshareStringValue which may free val, so we need to incr to retain val */ incrRefCount(val); /* Tells the module that the key has been unlinked from the database. */ moduleNotifyKeyUnlink(key,val,db->id,flags); /* We want to try to unblock any module clients or clients using a blocking XREADGROUP */ signalDeletedKeyAsReady(db,key,val->type); // 在调用用freeObjAsync之前,我们应该先调用decrRefCount。否则,引用计数可能大于1,导致freeObjAsync无法正常工作。 decrRefCount(val); // 如果是异步删除,则会调用 freeObjAsync 异步释放 value 占用的内存。同时,将 key 对应的 value 设置为 NULL。 if (async) { /* Because of dbUnshareStringValue, the val in de may change. */ freeObjAsync(key, dictGetVal(de), db->id); dictSetVal(db->dict, de, NULL); } // 如果是集群模式,还会更新对应 slot 的相关信息 if (server.cluster_enabled) slotToKeyDelEntry(de, db); /* Deleting an entry from the expires dict will not free the sds of the key, because it is shared with the main dictionary. */ if (dictSize(db->expires) > 0) dictDelete(db->expires,key->ptr); // 释放内存 dictTwoPhaseUnlinkFree(db->dict,de,plink,table); return 1; } else { return 0; } } 如果为异步删除,调用freeObjAsync()方法,根据以下代码分析: #define LAZYFREE_THRESHOLD 64 /* Free an object, if the object is huge enough, free it in async way. */ void freeObjAsync(robj *key, robj *obj, int dbid) { size_t free_effort = lazyfreeGetFreeEffort(key,obj,dbid); if (free_effort > LAZYFREE_THRESHOLD && obj->refcount == 1) { atomicIncr(lazyfree_objects,1); bioCreateLazyFreeJob(lazyfreeFreeObject,1,obj); } else { decrRefCount(obj); } } size_t lazyfreeGetFreeEffort(robj *key, robj *obj, int dbid) { if (obj->type == OBJ_LIST && obj->encoding == OBJ_ENCODING_QUICKLIST) { quicklist *ql = obj->ptr; return ql->len; } else if (obj->type == OBJ_SET && obj->encoding == OBJ_ENCODING_HT) { dict *ht = obj->ptr; return dictSize(ht); } else if (obj->type == OBJ_ZSET && obj->encoding == OBJ_ENCODING_SKIPLIST){ zset *zs = obj->ptr; return zs->zsl->length; } else if (obj->type == OBJ_HASH && obj->encoding == OBJ_ENCODING_HT) { dict *ht = obj->ptr; return dictSize(ht); } else if (obj->type == OBJ_STREAM) { ... return effort; } else if (obj->type == OBJ_MODULE) { size_t effort = moduleGetFreeEffort(key, obj, dbid); /* If the module's free_effort returns 0, we will use asynchronous free * memory by default. */ return effort == 0 ? ULONG_MAX : effort; } else { return 1; /* Everything else is a single allocation. */ } } 分析后咱们可以得出如下结论: 当Hash/Set底层采用哈希表存储(非ziplist/int编码存储)时,并且元素数量超过64个 当ZSet底层采用跳表存储(非ziplist编码存储)时,并且元素数量超过64个 当List链表节点数量超过64个(注意,不是元素数量,而是链表节点的数量,List的实现是在每个节点包含了若干个元素的数据,这些元素采用ziplist存储) refcount == 1 就是在没有引用这个Key时 只有以上这些情况,在删除key释放内存时,才会真正放到异步线程中执行,其他情况一律还是在主线程操作。也就是说String(不管内存占用多大)、List(少量元素)、Set(int编码存储)、Hash/ZSet(ziplist编码存储)这些情况下的key在释放内存时,依旧在主线程中操作。 5.3、分而治之 采用经典算法“分治法”,将大而化小。针对String和集合类型的Key,可以采用如下方式: String类型的大Key:可以尝试将对象分拆成几个Key-Value, 使用MGET或者多个GET组成的pipeline获取值,分拆单次操作的压力,对于集群来说可以将操作压力平摊到多个分片上,降低对单个分片的影响。 集合类型的大Key,并且需要整存整取要在设计上严格禁止这种场景的出现,如无法拆分,有效的方法是将该大Key从JIMDB去除,单独放到其他存储介质上。 集合类型的大Key,每次只需操作部分元素:将集合类型中的元素分拆。以Hash类型为例,可以在客户端定义一个分拆Key的数量N,每次对HGET和HSET操作的field计算哈希值并取模N,确定该field落在哪个Key上。 如果线上服务强依赖Redis,需要考虑到如何做到“无感”,并保证数据一致性。咱们基本上可以采用三步走策略,如下图所示。分别是进行双写,双读校验,最后读新Key。在此基础上可以设置开关,做到上线后的平稳迁移。 六、总结 综上所述,针对文章开头咱们购物车大Key问题,相信你已经有了答案。咱们可以限制门店数,限制门店中的商品数。如果不作限制,咱们也能进行拆分,将大Key分散存储。例如。将Redis中Key类型改为List,key为用户与门店唯一键,Value为用户在此门店下的商品。 存储结构拆分成两种: 第一种: userPin:storeId的集合 第二种: userPin_storeId1:{门店下加车的所有商品基本信息}; userPin_storeId2:{门店下加车的所有商品基本信息} 以上介绍了大key的产生、识别、处理,以及如何使用合理策略和技术来应对。在使用Redis过程中,防范大于治理,在治理过程中也要做到业务无感。 七、参考 https://github.com/redis/redis.git http://redisbook.com/ https://github.com/huangz1990/redis-3.0-annotated.git https://blog.csdn.net/ldw201510803006/article/details/124790121 https://blog.csdn.net/kuangd_1992/article/details/130451679 http://sd.jd.com/article/4930?shareId=119428&isHideShareButton=1 https://www.liujiajia.me/2023/3/28/redis-bigkeys https://www.51cto.com/article/701990.html https://help.aliyun.com/document_detail/353223.html https://juejin.cn/post/7167015025154981895 https://www.jianshu.com/p/9e150d72ffc9 https://zhuanlan.zhihu.com/p/449648332 作者:京东零售高凯 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

IPSec VPN原理介绍 | 京东物流技术团队

背景: 什么是VPN?他是干什么用的?有什么优势?解决我们什么问题? 1 VPN的概念 VPN定义 Virtual Private Network,中文名虚拟专用网络,意思是在公用网络上仿真建立一条点到点的专用网络,进行加密通讯,解决远程访问(个人和分支机构到总部)的问题。 要理解VPN,我们需要先弄了解一个概念——隧道协议,其实质是用一种协议来传输另一种协议,其基本功能是封装和加密。我们给大家列举几个隧道协议:GRE、IPSec、SSL/TLS、VPN(WebVPN)、PPTP、L2TP。 VPN解决的问题 VPN是企业分支机构、末端网络以及个人通告公共网络访问内部私网的一个解决方案。公网上存在的问题既是VPN需要面对和解决的问题。 广域网存在的隐患: 网上传输的数据有被窃听的风险; 网上传输的数据有被篡改的风险; 通信双方可能被冒充; VPN如何保护网络实体间的通信: 通过加密技术防止数据被窃听——数据的私密性; 通过哈希技术防止数据被篡改——数据的完整性; 通过认证机制确认身份,防止数据被截获、重传——数据的源认知; 通过增加序列号机制,防止数据的重放攻击——防重放攻击; VPN的优势 VPN作为一项成熟的技术,广泛应用于组织总部和分支机构之间的组网互联,其利用组织已有的互联网出口,虚拟出一条“专线”,将组织的分支机构和总部连接起来,组成一个大的局域网。 相比于传统专线,vpn具有安全、成本低、可靠、构建灵活等特点。 VPN的框架 VPN的两种框架: site-to-site VPN,也叫LAN-to-LAN。 remote-access VPN,即拨号VPN,一般通过软件进行拨号。 2 IPSec VPN 2.1 引入IPSec IP Security,IP层安全。工作在网络层,针对IP包提供如下功能:私密性、完整性、源认证和防重放攻击。 IPSec是一个开放的标准,与具体的算法没有关联。很多个RFC共同定义IPSec。 2.2 IPSec私密性保护 IPSec通过加密技术实现数据的私密性,加密就是把数据的明文格式通过具体的算法变成无法理解的密文格式。 加密算法的发展: 古典加密算法(算法都是保密不公开的,古典加密算法就是在研究各种算法) 现代加密算法:现代加密学的所有算法都是公开的,但是现代加密算法加入了一个key,主要在研究key,现代加密算法都是通过异或运算与数据难题在设计 现代加密算法分类: 对称加密学:加密解密使用相同的key,典型的对称算法:DES,3DES,AES 非对称加密学:又叫公共密钥系统,每种算法存在2个key:public key和private key。两个key都可以用来加密数据,但是解密必须非对称,公钥加密私钥解密,私钥加密公钥解密。典型的公共密钥算法有RSA(DSA)和DH。 对称加密算法的缺陷: 密钥的分发问题; key的数量与参与者的数量呈正比,密钥管理困难 对称加密算法的优点: 算法快,不需要消耗很多资源; 明文密文几乎等长,不需要浪费网络带宽 非对称加密算法缺点: 算法需要很长时间进行加解密,不可能通告非对称算法实现传输数据的加密; 算法冗长,密文远远大于明文; 非对称加密算法的优点: 非常安全,不可能被破解,非对称算法都是基于现有的属性南通设计的; 可用来支撑数字签名; 现有安全模型的操作规范: 实体间交换公钥 发送方通过公钥加密对称算法的key,得出密文,这个密文只有私钥持有者可以解密 接收方通过私钥解密密文,得到对称算法的key 通过这个key运行对称算法 2.3 IPSec的数据完整性保护 数据完整性指发送方到接收方的整个过程数据没有发生任何变化。IPSec通过哈希技术实现完整性校验,哈希是数据的指纹算法。 哈希的特征: 不可逆(哈希的结果不可能反推明文) 等长(不同的哈希算法,对不同大小的数据,得到哈希结果总是相同的) 雪崩(微小的变化会引起完全不一样的结果) 开销少 介绍两种哈希算法: MD5:哈希结果128bit; SHA:哈希结果256bit; 2.4 IPSec的数据源认证 源认证是用来对数据发送方进行合法性校验的方法。IPSec提供两种方式实现源认证: HMAC:在MD5的算法中,加入一个变量key,只有key相同才能导致MD5结果相同,通过这种方式可实现数据的源认证。IGP的认证中,都是HMAC; 数字签名:指发送方通过自己的私钥对数据的指纹进行加密,得出加密后的哈希,这个东西就是数据签名,数字签名只能使用发送方的公钥进行解密,这样发送方无法抵赖(最严谨的源认证)。 注意:在整个安全模型中,如果使用到私钥在进行加密,肯定是出现了数字签名 2.5 IPSec框架 前面提到,IPSec不是一个特定协议,而是一组操作流程,有多个组件构成: 封装协议(AH,ESP) 加密算法(RSA,DH,DES,3DES,AES) 认证协议(MD5,SHA) ESP封装为数据提供了如下功能:私密性、完整性、源认证和防重放攻击。 概念介绍:SA:Security Association,安全关联是指一组用来保护信息的策略和密钥。安全关联的概念是IPSec的基础。所有AH和ESP的实现都必须支持安全关联。 安全关联的两种模式:transport mode和tunnel mode。通过两种设备的位置,可以判断当前网络模式应该使用哪种封装模式: 通讯点设备:真正的数据发起和接收设备。 加密点设备:IPSec实施设备,可以是路由器、防火墙等。 transport mode:通讯点即为加密点,可以试试传输模式,有两种场景会使用:GRE over IPSec、内网设备间部署IPSec tunnel mode:通讯点不等于加密点一定使用隧道模式。因为通讯点位于网络内部,发出的数据包是私网地址,不可全局路由,所以必须实施新的IP头封装,让数据包全局可路由。 3 IPSec工作流程步骤 3.1 整体工作流程 流量触发IPSec; IKE阶段1,在VPN设备间协商IKE的安全策略,建立一个安全的channel——控制层面; IKE阶段2,在VPN设备间通过安全的channel去协商IPSec的策略,用来保护数据;——数据层面; 通过对感兴趣流设施安全保护,来转发数据; 隧道终结。 VPN设备对感兴趣流量的匹配:设备接口下存在一个map,用来定义感兴趣流的,如果数据撞上map则需要应用IPSec保护,否则bypass 概念穿插: IKE:internet KEY Exchange,因特网密钥交换,目前使用IKEv1版本,包括如下内容: ISAKMP:因特网安全管理和密钥管理协议,端口号500; OAKLEY:用来定义IKE的密钥交换方式,当前的定义是使用DH实现。 SKEME:用来定义IKE职场的加密算法。 IKE的两种模式:main mode(主模式)和积极模式(用于拨号vpn) IKE主模式操作过程: IKE协商——构建控制层面; IPSec协商——协商数据层面; 两个阶段需要进行9个包交换,第一个阶段6个包,3次交换,第二个阶段3个包,两次交换。 3.2 IKE阶段1 主要功能介绍: 协商IKE策略(第1,2两个包)——第一次交换; 交换DH组(第3,4两个包)——第二次交换; 验证peer的合法性(第5,6两个包)——第三次交换。 第一次交换:VPN device把本地所有的IKE policy打包,发起ike的proposal IPSec设备会进行策略比较,总是从policy-id小的开始match,如果存在可以match的policy则提议被通过,如果所有的policy无法match,则IKE协商失败,进入第二次交换。 因为加密算法没统一,没有加密key,所以第一次交换过程肯定是明文交换。 第二次交换:交换的是DH组信息,在这个交换过程中,设备不可能把本地的psk进行发送(psk严格本地保留),只是用来交互几个DH的公开值。 因为key还没协商,所有依然是明文交换。 在第二次交换后,VPN设备通过cookie+psk可以推导出三个密钥: SKEIDa:用来通过1,2个包协商出来的加密算法保护5,6包 SKEIDe:用来通过1,2个包交换出来的哈希算法对5,6包进行认证 SKEIDd:这个密钥是在第二个阶段用来衍生IPSec的key,如果这个密钥被攻破,所有IPSec就没有意义 第三次交换:第三次交换的主要功能是用来做peer的身份验证。 第三次交换是在建立了安全的channel下交换的,第五第六个包是加密的,也是被认证的。 在psk的验证中,其实vpn设备只是通过5,6包的源IP地址进行校验。psk的关键作用只是参与DH算法,用来做key衍生,如果psk不同key不同,协商失败。 IKE第一阶段协商结果,即产生IKE SA,也叫isakmp sa 3.2 IKE阶段2 本阶段涉及3个包,两次交换,也叫做快速模式。 快速模式下的所有包都是通过SKEIDa进行加密,SKEIDe进行认证,所有读取报文都是加密的数据。 此过程交换并匹配IPSec的安全参数(转换集),VPN设备把本地的所有转换集打包发送,match的时候与IKE的1,2包交换是相同的,同时只要转换集匹配则通过DH的第三个key-SKEIDd进行IPSec加密算法密钥的推导。 IKE第二阶段协商结果是IPSec sa。 SA的三要素: SPI(安全参数索引),用来描述一个SA,用于IPSec快速匹配,告诉对端通过这个SPI对应的SA对该数据进行解密,让加解密更加高效,占用4byte;对于一个对应的感兴趣流,一端的outbound SPI肯定是对端的inbound SPI(因为数据保护使用的是对称算法,必须保证加解密key相同) 安全协议标识:标识该SA是AH安全关联或ESP安全关联。 IP目的地址:只允许使用单一地址,表示SA的目的地址。 4 扩展话题 SA的切换探讨: SA的主要内容就是对称密钥的key与哈希算法的key,当一个SA使用的越频繁,就代表key越需要更新,SA的切换必须做到不丢包。 IKE在可以超时前就会重新推算新的SA,防止切换瞬间带来的丢包。 所有的IPSec SA都是通过IKE的SKEIDd在推算,如果这个SKEIDd被曝光,会导致所有的IPSec SA全部可推算 PFS(完美向前保护): 因为默认的IPsec key间存在互相推导关系,导致不够安全,PFS强制每一次重新计算SA需要重新通过DH推导SKEIDd。 RRI(反向路由注入): 如果策略1能够成功的协商SA,则往本地路由表注入一条远端通讯点的静态路由 DPD(dead peer detection): 如果对端失效,本端无法检测,导致数据层面转发黑洞,解决方案是必须让本端可以检测到对端失效,同时删除与对端的SA,重新寻找peer去建立SA DMVPN和NHRP(可自行了解) 作者:京东物流 陈旭辉 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

浅谈幂等设计 | 京东云技术团队

1 幂等性 一句话,幂等就是一个执行操作,无论执行多少次,产生的效果和返回的结果都是一样的。 2 为什么要实现幂等性? 如今随着互联网技术快速发展,业务越来越复杂,系统的高并发和关键数据的场景越来越多。 在分布式系统中,机器宕机和消息丢失也是需要重点关注的问题,其中的一个典型就是幂等性问题。 想想看,一个对外暴露的接口会面领很多次请求,如果不能保证幂等性会带来什么样的后果? 微信进行一次扣款操作,应该只扣用户一次钱,当遇到网络故障或系统bug,如果没有实现幂等性扣多了你会不会直接“C语言”投诉? 当然,有些接口是天然保证幂等性的,比如查询操作、删除操作。有些对数据的修改是一个常量,无其他操作,也是具有幂等性的。修改操作可能幂等可能不幂等。 SELECT col1 FROM tab1 WHERE col2 = 2UPDATE tab1 SET col1 = 1 WHERE col2 = 2UPDATE tab1 SET col1 = col1 + 1 WHERE col2 = 2 这三个sql只有第三个不是幂等的。 POST请求天生就不是一个幂等操作,每次调用都会在系统中产生新的资源,想要幂等就必须在业务中实现。 需要避免的是,幂等性和并发安全不是一回事。当同一笔订单即使你不停的提交支付,如果扣了不止一次钱,就说明该操作不幂等。 而有多笔订单同时进行支付,最后扣除的金额不是这么多笔金额的总和,说明该操作有并发安全问题。这是两个维度的问题,应该分开讨论解决。 3 如何实现幂等性? (1)数据库防重 利用数据表唯一索引的特性,当并发时新增报错时,再查询一次,数据已经存在,就避免了脏数据的新增。但注意,不要将uuid作为索引字段,其大小和类型对于索引而言都会导致速度非常慢。 常见的场景,比如博客/微博系统点赞,一个用户对一个微博点赞,就把用户id与该博文id绑定,后续该用户再对该博文点赞就无法插入。再比如金融账户,可以通过在账户表中增加唯一索引来存储用户id,即使重复操作一个用户也只能拥有一个账户。 (2)token令牌机制 token机制是适用范围最广泛的一种幂等设计。虽然实现方式有很多种,但核心思想就是每次操作都生成一个唯一token凭证,服务器通过这个唯一凭证确保同样的操作不会被执行多次。 具体可以分为两个阶段,获取token和使用token。每次接口请求前先获取一个token,然后在下次请求时在请求的header体中加上这个token,后端进行校验,如果验证通过则删除token,下次请求再次判断token。如果在redis缓存的帮助下,流程图如下: (3)分布式锁 数据库防重表可以通过分布式锁代替,相比去重表,将放并发做到了缓存中,效率更高。局限性都是同一时间只能完成一次请求。 比如某些业务处理流程很长,要求不能并发执行,可以在流程执行之前根据某个标志(用户ID+后缀等)获取分布式锁,其他流程执行时获取锁就会失败,也就是同一时间该流程只能有一个能执行成功,执行完成后,释放分布式锁。 4 幂等的优缺点 优点: 业务需要 缺点: (1)客户端处理逻辑得以简化,但服务端控制幂等逻辑变得更加复杂; (2)把并发执行变成改为串行执行,降低了执行效率。 5 扩展 分布式自增ID可以借鉴Snowflake算法,优点是高性能、低延迟、按时间有序;缺点是需要独立的开发和部署。 其结构如下: 最高位是符号位,始终为0,不可用。 41位的时间序列,精确到毫秒级,41位的长度可以使用 (1L << 41) / (1000L * 60 * 60 * 24 * 365) = 69年。时间位还有一个很重要的作用是可以根据时间进行排序。注意,41位时间截不是存储当前时间的时间截,而是存储时间截的差值(当前时间截 - 开始时间截) 后得到的值,这里的的开始时间截,一般是我们的id生成器开始使用的时间,由我们程序来指定的。 10位的机器标识,10位的长度最多支持部署1024个节点。 12位的计数序列号,序列号即一系列的自增id,可以支持同一节点同一毫秒生成多个ID序号,12位的计数序列号支持每个节点每毫秒产生4096个ID序号。 加起来刚好64位,为一个Long型。这个算法很简洁,但依旧是一个很好的ID生成策略。 参考文献: [1] 分布式系统互斥性与幂等性问题的分析与解决 https://zhuanlan.zhihu.com/p/22820761 [2] 高并发下接口幂等性解决方案 https://blog.csdn.net/u011635492/article/details/81058153 [3] 幂等性问题和解决方法 https://blog.csdn.net/qq_32020035/article/details/105448889 [4] 雪花算法 https://www.cnblogs.com/grasp/p/12309726.html [5] 聊聊开发中幂等问题 https://segmentfault.com/a/1190000018808510 作者:京东零售 李泽阳 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅析Java - SPI机制 | 京东云技术团队

SPI是什么 SPI全称Service Provider Interface,是Java提供的一套用来被第三方实现或者扩展的API,它可以用来启用框架扩展和替换组件。 整体机制如下图 Java SPI 实际上是“基于接口的编程+策略模式+配置文件”组合实现的动态加载机制。 使用场景 适用于:调用者根据实际使用需要,启用、扩展、或者替换框架的实现策略 比较常见的例子: 数据库驱动加载接口实现类的加载,JDBC加载不同类型数据库的驱动 日志门面接口实现类加载,SLF4J加载不同提供商的日志实现类 Spring中大量使用了SPI,比如:对servlet3.0规范对ServletContainerInitializer的实现、自动类型转换Type Conversion SPI(Converter SPI、Formatter SPI)等 Dubbo中也大量使用SPI的方式实现框架的扩展, 不过它对Java提供的原生SPI做了封装,允许用户扩展实现Filter接口 使用介绍 要使用Java SPI,需要遵循如下约定: 当服务提供者提供了接口的一种具体实现后,在jar包的META-INF/services目录下创建一个以“接口全限定名”为命名的文件,内容为实现类的全限定名; 接口实现类所在的jar包放在主程序的classpath中; 主程序通过java.util.ServiceLoder动态装载实现模块,它通过扫描META-INF/services目录下的配置文件找到实现类的全限定名,把类加载到JVM; SPI的实现类必须携带一个不带参数的构造方法; 总结 优点:使用Java SPI机制的优势是实现解耦,使得第三方服务模块的装配控制的逻辑与调用者的业务代码分离,而不是耦合在一起。应用程序可以根据实际业务情况启用框架扩展或替换框架组件。 缺点: 虽然ServiceLoader也算是使用的延迟加载,但是基本只能通过遍历全部获取,也就是接口的实现类全部加载并实例化一遍。如果你并不想用某些实现类,它也被加载并实例化了,这就造成了浪费。获取某个实现类的方式不够灵活,只能通过Iterator形式获取,不能根据某个参数来获取对应的实现类。 多个并发多线程使用ServiceLoader类的实例是不安全的。 作者:京东零售 曹志飞 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Elasticsearch Mapping类型修改 | 京东云技术团队

背景 通常数据库进行分库分表后,目前比较常规的作法,是通过将数据异构到Elasticsearch来提供分页列表查询服务;在创建Elasticsearch索引时,基本都是会参考目前的业务需求、关系数据库中的类型以及对数据的相关规划来定义相关字段mapping的类型. 在Elasticsearch的mapping中的列(或则叫属性),有几个比较重要的参数(更多参数参考官方文档) 列类型:type 指定了该列的数据类型,常用的有text,keyword,date,long,double,boolean以及object和nested,不同的类型也有对应的不同查询方式,创建之后是不能修改的; 是否可索引:index 该index选项控制字段值是否被索引。它接受trueorfalse,并且默认为true. 未索引的字段不可查询,当然也不能做为排序字段。 但是在实际的开发过程中,又会有需求对现有的mapping的type进行修改(类似对MySQL数据表的字段进行DDL操作)的诉求。比如商品上的价格price字段,按原来的业务分析,只需要提供数据返回即可,在创建索引时类型定义了keyword了,并且index设置成了false,这时我们需要根据价格的范围查询或则进行排序操作,就希望对mapping进行调整,将类型修改成数字类型,索引也需要加上;今天针对Elasticsearch的Mapping类型进行修改,讨论几个可行的方案 方案1:运用reindex 遇到问题第一时间,我们应该是查询官方文档是否有相关的操作说明,在官方文档中,确实还能找到对已有mapping更新的相关apiput-mapping,通过这个文档,很快可以找到文档中对修改已有mapping的列的方式(参考官方文档),同时也提到的通过reindex的方式来修改已有类型的方式; 除了支持的mapping parameters外,您不能更改现有字段的映射或字段类型。更改现有字段可能会使已编制索引的数据无效。如果您需要更改字段的映射,请使用正确的映射创建一个新索引并将您的数据重新索引reindex到该索引中。 如原来索引的mapping如下 PUT /users { "mappings" : { "properties": { "user_id": { "type": "long" } } } } //加一了两条数据 POST /users/_doc?refresh=wait_for { "user_id" : 12345 } POST /users/_doc?refresh=wait_for { "user_id" : 12346 } 这时想修改user_id的类型为keyword,我们直接是修改不了的。 //尝试直接修改type,行不通,会报错 PUT /users/_mapping { "properties": { "user_id": { "type": "keyword" } } } //报错信息 { "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" } ], "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" }, "status": 400 } 按官方文档说的reindex重新索引可按以下步骤操作 操作步骤 第一步:创建新的索引new_users将user_id的类型定义成keyword PUT /new_users { "mappings" : { "properties": { "user_id": { "type": "keyword" } } } } 第二步:将原user索引标记为只读 控制我们的应用系统,数据停写不再向老索引中写数据,并且最好对老索引进行只读操作设置,保证在reindex的过程中,不要生产新数据,导致新老索数据不一致; //设置索引为读写的 PUT /users/_settings { "settings": { "index.blocks.write": true } } 第三步:将原user索引中的数据迁移到new_users中 POST /_reindex { "source": { "index": "users" }, "dest": { "index": "new_users" } } reindex还有很多的参数可以配置,包括从远程的一个集群迁移数据都是可以的,详细可参考:Reindex API 如果新的索引的mapping的定义与原索引的定义有差异的,会按新索引定义的dynamic规则进行数据的迁移,具体的,可以参考:dynamic 该dynamic设置控制是否可以动态添加新字段。它接受三种设置: 值 说明 true 新检测到的字段被添加到映射中。(默认); 新增的数据类型的规则,可以参考:dynamic-mapping false 忽略新检测到的字段。这些字段不会被编入索引,因此将无法搜索,但仍会出现在_source返回的命中字段中。这些字段不会添加到映射中,必须明确添加新字段。 strict 如果检测到新字段,则会抛出异常并拒绝文档。必须将新字段显式添加到映射中。 同时将原user索引标记为可读写 //设置索引为可读写 PUT /users/_settings { "settings": { "index.blocks.write": false } } 第四步:切换到使用新的mapping 可以将应用系统中的配置改成新索引 也可以通过索引的别名的方式为新索引增加原来老索引的别名来操作,为索引增加别名参考文档:Add index alias API,在增加别名前,需要删除原来的老索引; //为索引增加别名 基本格式 PUT /<index>/_alias/<alias> POST /<index>/_alias/<alias> //为new_users索引增加别名users PUT /new_users/_alias/users //没有删除老索引前,是增加不了别名的,需要先删除老别名 { "error": { "root_cause": [ { "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" } ], "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" }, "status": 400 } 方案优劣分析 【优点】操作简单,官方方案 该方案,不需要对原索引做操作,在线即可进行,并且操作步骤也简单;也是官方文档提供的方案。 【缺点】数据量大迁移耗时长 当数据最大时,这个数据迁移会比较耗时 结论 当数据量小时,并且希望mapping比较规整好看,该方案是比较推荐的。当数据量大时,可能该方案在数据迁移过程中会比较耗时,需要评估是否可行; 方案2:运用multi-fields 为不同的目的以不同的方式索引同一个字段通常很有用。这就是multi-fields的目的。例如,一个string字段可以映射为text用于全文搜索的字段,也可以映射keyword为用于排序或聚合的字段; 在这个方案中,应用的是mapping参数fields来对同一个列,定义多种数据类型;详细[【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) 操作步骤 第一步:为列增加fields属性 还是以上面的users这个索引为例,我们还是想将user_id的类型定义成keyword; PUT /users/_mapping { "properties":{ "user_id":{ "type":"long", "fields":{ "raw":{ "type":"keyword" } } } } } 操作完成后,在users的user_id列下,就会多出一个raw的子属性;在我们正常写数据user_id时,会自动生成这两个索引,一个是long类型的user_id,以及keyword类型的user_id.raw(注意这里有个点,跟子对象访问方式一样); 在put mapping时,type参数必需给,并且需要跟原来的类型一致,fields中新定义的子属性可以多个; 【可选】第二步:历史数据更新 针对历史数据需要处理,可以借助_update_by_query来更新数据,只需要将原来的索引再写一次,即可将新加的字段写入数据。 POST /users/_update_by_query { "query":{ "exists":{ "field":"user_id" } }, "script":{ "source":"ctx._source.user_id=ctx._source.user_id ", "lang":"painless" } } // query 部分为需要更新数据过滤条件,可根据业务规则写 // script 更数据的逻辑,这个基本可以不改 方案优劣分析 【优点】不影响原索引,同一列可以定义多种类型 通过这方式不会影响原来的索引数据,可以不用修改现在的应用程序的读写方式,对应用程序一切按原来逻辑执行,对应用方无感知,非常优化。只需要有使用新类型的场景使用即可,可以说影响是最小的; 同时只是做了一个定义,执行速度是非常快的,对Elasticsearch服务基本不会有太大影响;并且对于同一个列可以定义多个类型,比如商品名称,在多国多语言环境下可以根据不同语言定义多个列,对应使用不同的分词器; 【缺点】老数据不会自动创建子索引,多出额外的存储 老数据不会自动创建索引,因为需要多出新的索引来,会增加额外的存储; 结论 1、需要对多一列创建多个索引类型时,是一个非常推荐的方案; 2、对于新索引,只有新业务使用,对老数据没有诉求的,也非常推荐该方案; 方案3:运用copy_to copy_to是将多个字段的值,合并到一个字段中,便于搜索。但是也可以实现一个字段存在多个类型的需求。详细参考【官方文档】copy_to 操作步骤 还是用上面的users这个索引为例,为user_id创建一个copy列:user_id_raw类型定义成keyword PUT /users/_mapping { "properties":{ "user_id_raw":{ "type":"keyword", "copy_to":"user_id" } } } 这个方案与方案2:multi-fields基本是一样的,只是创建列的方式不同,优缺点都一样; 参考资料 [1]【官方文档】Mapping parameters [2]【官方文档】Mapping Field datatypes [3] [【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) [4]Elasticsearch Rename Index [5]elasticSearch7.x—mapping中的fields属性||copy_to配置(同一个字段两种类型) [6]《Elasticsearch:权威指南》Mapping -- Mapping parameters -- fields(multi-fields) 作者:京东零售 周德东 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

当小白遇到FullGC | 京东云技术团队

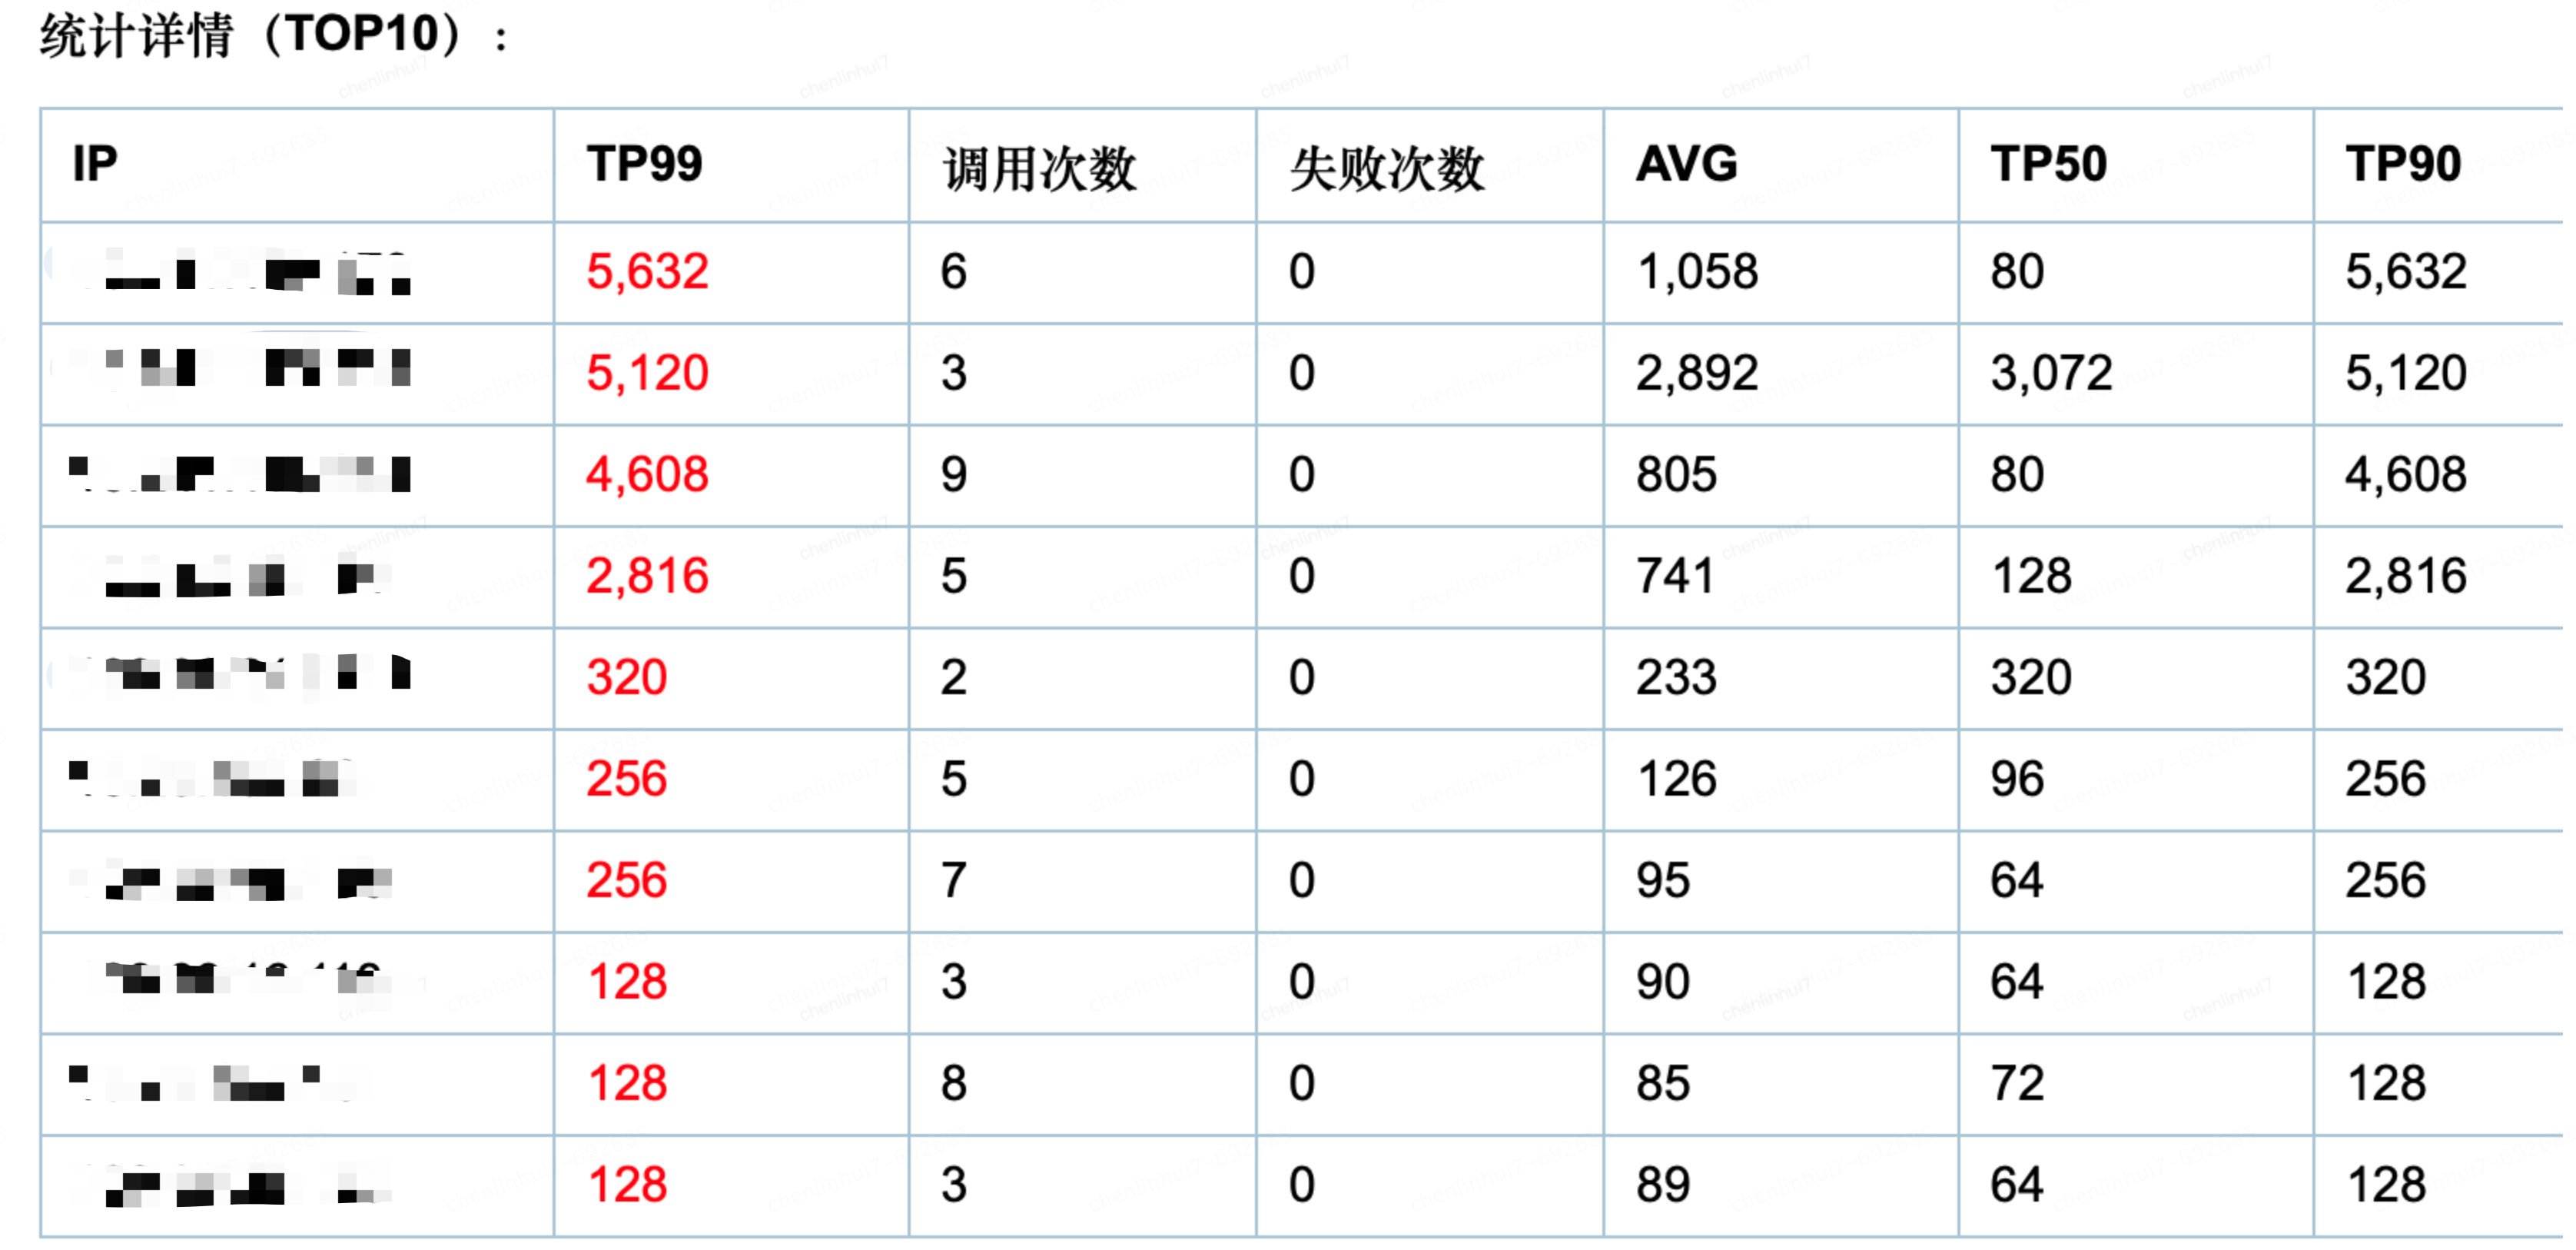
起初没有人在意这场GC,直到它影响到了每一天! 前言 本文记录了一次排查FullGC导致的TP99过高过程,介绍了一些排查时思路,线索以及工具的使用,希望能够帮助一些新手在排查问题没有很好的思路时,提供一些思路,让小白也能轻松解决FullGC问题,文中实际提到的参数配置不一定适合其他业务场景,在调优自己的项目时还是需要实际试验过才能得出最佳参数配置 我也是小白,如有不合理的地方,欢迎大佬们进行指正 因为线上服务器,我们大部分是没有SSH权限的,没有办法直接执行命令获取容器信息,所以排查过程中只能借助平台提供的工具,平台提供的工具还是挺全的,本文主要用到的工具有: JDOS容器智能监控,JDOS进程查询,SGM容器监控信息,SGM方法调用查询 以下几个工具简单介绍: http://sgm-server.jd.com/ http://jagile.jd.com/jdosCD/jdt/apps JDOS容器智能监控: 查看容器的CPU,内存,磁盘,IO等信息 JDOS进程查询: 查看Java进程编号,执行常用的Java内存进程查看命令 SGM容器监控信息: 查看JVM虚拟机内存变更历史记录 SGM方法调用查询: 查看某一次关键接口调用的上下依赖,时间分布 起因 - 偶尔出现接口超时 一开始偶尔会收到报警邮件,显示有些接口调用时间比较长,抽查了一些接口,发现大部分都是调用下游JSF时间比较长,导致响应比较慢,这时候就没太在意,接下来继续观察了几天,发现一个规律,大部分邮件都是每天10点  排查定位问题 1. 首先确认了10点这个时间点有没有定时任务之类的操作,经过询问确定这个时间点是仓库出库高峰期,导致业务量出现峰值(调用量变大可能是激发FullGC问题,成为问题暴漏的导火线) 2. 第二部就是确认是数据库原因,还是业务代码,还是JSF下游接口达到极限原因,到这一步还是未知的,在这用到了SGM的接口调用查询工具,下图中我们看到,这次调用JSF也是挺高的(这个没有太好办法,除非让下游优化,所以暂时忽略),但是还有一个是logic,这个就是逻辑处理,如果没有那个FullGC提示,就需要去分析代码的处理是否有问题,这通过那行红色字体的提示,很显然我们确定了是FullGC导致的问题 3. 我们去查看一下容器的FullGC情况,确实发现这个时间点的FullGC特别频繁,到此已经把问题范围定位到就是FullGC导致的     FullGC问题排查 Full GC 触发条件: 到这里我们需要确定一个问题 : “触发FullGC的条件是什么?”,新手可以去博客搜索,当然最好是能记住这个知识点。注意这不是确定“什么原因导致的FullGC?”,因为这个问题原因太多了,我们要一步一步排查。 下面是我查到的资料,粘到这里供参考. 1. Minor GC触发条件:当Eden区满时,触发Minor GC。 2. Full GC触发条件: (1)调用System.gc()时,系统建议执行Full GC,但是不必然执 (2)老年代空间不足 (3)方法区空间不足 (4)通过Minor GC后进入老年代的平均大小大于老年代的可用内存 (5)由Eden区、From Space区向To Space区复制时,对象大小大于To Space可用内存,则把该对象转存到老年代 这里在代码中并没有找到System.gc()的显示调用,一般我们也不会调用这个方法,所以我们直接看第二种情况,到SGM中查看老年代变化,结果发现老年代频繁达到90%,而这个时间正好可以跟上面GC时间对上.  对象进入老年代的几种情况 我们都知道,老年代的对象应该是存活时间很长的对象,但是我们发现这些对象都在FullGC时被释放掉了,他们为什么到了老年代呢? 这时候我们需要确定的第二个问题是:“什么情况下对象会进入老年代?” 查资料后有以下几种情况 1. 年龄够了: 躲过15次(默认配置是15次) minorGC 之后从新生代进入老年代; 2. 大对象: 大对象直接进入老年代。有一个 JVM 参数 '-XX:PretenureSizeThreshold' 设置值为字节数,创建超过该大小的对象直接进入老年代,如果没有配置这个参数,这个值好像默认是1M。 3. 动态年龄判断:当前放对象的 Survivor 区,相同年龄的一批对象(以及小于该年龄)的总内存大于该区的内存的50%,大于该年龄的其他老对象,就会进入老年代(例如1,2,3岁年龄的对象占了 S 区的50%以上,就会把大于3岁的对象移动到老年代去。所以尽量让 S 区中的对象,占比尽量少于 50%); 4. 剩的总量太多: Eden 区存活对象太多,超过了 Survivor 的大小,就直接把这些对象都转移到老年代去。(JDK1.8 空间担保机制) 首先分析第一种情况,如果出现大批量这样的对象,代码中出现了长时间引用(例如:静态Map只加不删),但是我们可以看到,这些对象在每次FullGC都被释放掉了,说明这批对象存活的时间并不长, 而且代码排查也没发现这种代码,暂时排除这种情况(这的代码因为是工具包的代码,所以没有太深纠,这为续集留个伏笔). 第二种情况,大对象,我们到JDOS下载下来JMap-dump内存快照和JMap-Histo对象统计信息,经过对FullGC钱dump分析,结合GC前GC后对象统计结果,并没有发现大量的大对象,这个基本也排除 通过JMAT(Eclipse Memory Analysis Tools)导入dump文件进行分析,内存泄漏问题一般我们直接选Leak Suspects即可,mat给出了内存泄漏的建议。另外也可以选择Top Consumers来查看最大对象报告。和线程相关的问题可以选择thread overview进行分析。除此之外就是选择Histogram类概览来自己慢慢分析,大家可以搜搜mat的相关教程。    接下来就是第三种和第四种情况,这时候我们需要取查看年轻代三块区域的变化,尤其是Survivor区域,下图是当时一个情况,S区大小一直在变化,而且基本一致保持在50%以上,这时候想到了一个JVM高版本特性,会自动打开UseAdaptiveSizePolicy(动态调整),查资料后发现,好多人反应这个参数会导致对象跨过S区,直接跑到老年代的情况,我们看到在调用量持续很高的情况,尽然调整到了17M,这肯定会导致容纳不下当时存活的对象 UseAdaptiveSizePolicy开关参数-XX:+UseAdaptiveSizePolicy是一个开关参数,当这个参数打开之后,虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或最大的吞吐量,这种调节方式称为GC自适应的调节策略(GC Ergonomics)。  定位到UseAdaptiveSizePolicy问题 既然这有问题,我们尝试关闭一下这个参数看下效果,下面是老年代,S区和FullGC,在关闭前和关闭后的效果,关闭之后S区大多数时间有充足的空间,而且,老年代和FullGC图也安稳了很多 关闭AdaptiveSizePolicy的方式 开启:-XX:+UseAdaptiveSizePolicy(JDK1.8 Parallel Scavenge收集器默认) 关闭:-XX:-UseAdaptiveSizePolicy    发现新的问题 上图中虽然已经安稳了很多,但是还是有一点小问题,频繁FullGC虽然没有了,但是一个小时还是会出现一次FullGC,而且这时候老年代还没有满,这种频率的FullGC,理论上也是不允许的. 我们回到第一个问题,FullGC触发条件,第三个,我们赶紧看了下永久代,也就是元空间,如下图,这一看不得了,元空间也在频繁变动,而且达到300M左右时会触发一次FullGC释放掉. tips: 这里是没有配置元空间的大小的,也没有配置元空间的理论上元空间无限大,不会满,查询资料后解释是,元空间也会根据当前已使用进行动态调整,当达到上次调整值90%后就会FullGC,所以每次FullGC元空间大小在200M到500M不等 元空间内存排查 这时猜测可能是代码中出现了大量的动态类的声明,想要定位哪些类需要jvm启动参数加上打印类加载和卸载的参数,顺带把GC日志开关也打开 -XX:+TraceClassUnloading -XX:+TraceClassLoading -XX:+PrintGCDetails  打开后查看日志发现一个频繁加载和卸载的类[com.googlecode.aviator.Expression], 经查询资料,这个是aviator 工具的一个规则引擎类,在加载规则时会动态加载一个类,默认不使用缓存,可以打开缓存防止频繁声明新类    修改代码后重新部署,一小时一次的FullGC也没了,如下图  总结 发现的问题: 问题一: AdaptiveSizePolicy导致对象提前进入老年代,老年代增长速度快,导致频繁FullGC 解决方式: 关闭:-XX:-UseAdaptiveSizePolicy 问题二: 元空间不断增长,导致一小时一次FullGC 解决方式: 修改逻辑代码防止频繁加载新类 在排查问题时尽可能先找直接原因,缩小排查跨度,不要一步就想知道根本原因,每个线索都要问个为什么,不正常的现象肯定是有原因的. 下面是FullGC排查思路参考脑图 作者:京东保险 陈林辉 来源:京东云开发者社区 转载请注明来源


优秀的个人博客,低调大师

商品推荐系统浅析 | 京东云技术团队

一、综述 本文主要做推荐系统浅析,主要介绍推荐系统的定义,推荐系统的基础框架,简单介绍设计推荐的相关方法以及架构。适用于部分对推荐系统感兴趣的同学以及有相关基础的同学,本人水平有限,欢迎大家指正。 二、商品推荐系统 2.1 推荐系统的定义 推荐系统本质上还是解决信息过载的问题,帮助用户找到他们感兴趣的物品,深度挖掘用户潜在的兴趣。 2.2 推荐架构 其实推荐系统的核心流程只有召回、排序、重排。 请求流程 当一个用户打开一个页面,这个时候前端会携带用户信息(pin或者uuid等)去请求后台接口(通过color间接调用),当后台收到请求后一般会先根据用户标识进行分流获取相关策略配置(ab策略),这些策略去决定接下来会调用召回模块、排序模块以及重排模块的哪个接口。一般召回模块分多路召回,每路召回负责召回多个商品,排序和重排负责调整这些商品的顺序。最后挑选出合适的商品并进行价格、图片等相关信息补充展现给用户。用户会根据自己是否感兴趣选择点击或者不点击,这些涉及用户的行为会通过日志上报到数据平台,为之后效果分析和利用用户行为推荐商品奠定基础。 其实有些问题想说一说: 为什么要采取召回、排序、重排这种漏斗分层架构? (1)从性能方面 终极:从百万级的商品库筛选出用户感兴趣的个位数级别的商品。 复杂的排序模型线上推断耗时严重,需要严格控制进入排序模型的商品数量。需要进行拆解 (2)从目标方面 召回模块:召回模块的任务是快速从大量的物品中筛选出一部分候选物品,目的是不要漏掉用户可能会喜欢的物品。召回模块通常采用多路召回,使用一些简化的特征或模型。 排序模块:排序模块的任务是精准排序,根据用户的历史行为、兴趣、偏好等信息,对召回模块筛选出的候选物品进行排序。排序模块通常使用一些复杂的模型。 重排模块:重排模块的任务是对排序模块的结果进行二次排序或调整,以进一步提高推荐的准确性和个性化程度。重排模块通常使用一些简单而有效的算法。 什么是ab实验? 参考论文:Overlapping Experiment Infrastructure: More, Better, Faster Experimentation(google2010) 只有在线实验才能真正评估模型优劣,ab实验可以快速验证实验的效果,快速迭代模型。减少上线新功能的风险。 ab算法:Hash(uuid+实验id+创建时间戳)%100 特性:分流+正交 2.3召回 召回层的存在仅仅是为用户从广阔的商品池子中初筛出一批还不错的商品。为了平衡计算速度与召回率(正样本占全部正样本的比例)指标之间的矛盾,采用多路召回策略,每路召回策略只考虑其中的单一特征或策略。 2.3.1多路召回的优劣 多路召回:采用不同的策略、特征或者简单模型分别召回一部分候选集,然后把候选集混合在一起供排序使用。召回率高,速度快,多路召回相互补充。 多路召回中每路召回的截断个数K是个超参数,需要人工调参,成本高;召回通路存在重合问题,冗余。 是否存在一种召回可以替代多路召回,向量召回应用而生,就目前而言,仍然是以向量召回为主,其他召回为辅的架构。 2.3.2召回分类 主要分为非个性化召回,个性化召回两大类。非个性化召回主要是进行热点推送,推荐领域马太效应严重,20%的商品贡献80%的点击。个性化召回主要是发掘用户感兴趣的商品,着重处理每个用户的差异点,提高商品的多样性,保持用户的粘性。 非个性化召回 (1) 热门召回 近7天高点击、高点赞、高销量商品召回 (2)新品召回 最新上架的商品召回 个性化召回 (1)标签召回、地域召回 标签召回:用户感兴趣的品类、品牌、店铺召回等 地域召回:根据用户的地域召回地域内的优质商品。 (2)cf召回 协同过滤算法是基于用户行为数据挖掘用户的行为偏好,从而根据用户的行为偏好为其推荐物品,其根据的是用户和物品的行为矩阵(共现矩阵)。用户行为一般包括浏览、点赞、加购、点击、关注、分享等等。 协同过滤分为三大类:基于用户的协同过滤(UCF)和基于物品的协同过滤(ICF)和基于模型的协同过滤(隐语义模型)。是否为用户推荐某个物品,首先要把用户和物品进行关联,而进行关联的点是另一个物品还是另一个用户,决定了这属于哪个类型的协同过滤。而基于隐语义模型是根据用户行为数据进行自动聚类挖掘用户的潜在兴趣特征。从而通过潜在兴趣特征对用户和物品进行关联。 基于物品的协同过滤(ICF):判断是否为用户推荐某个物品,首先根据用户历史行为记录的物品和这个物品的相似关系来推断用户对这个物品的兴趣度,从而判断我们是否推荐这个物品。整个协同过滤过程主要分为以下几步:计算物品之间的相似度,计算用户对物品的兴趣度,排序截取结果。 商品相似度计算: 衡量相似度主要有以下几种方式:夹角余弦距离,杰卡德公式。由于用户或物品的表示方式的多样性,使得这些相似度的计算非常灵活。我们可以利用用户和物品的行为矩阵来去计算相似度,也可以根据用户行为、物品属性和上下文关系构造用户和物品的向量表示去计算相似性。 夹角余弦距离公式: cos⁡θ=(x1*x2+y1*y2)/(√(x12+y12 )*√(x22+y22 )) 杰卡德公式J(A,B)=(|A⋂B|)/(|A⋃B|) 商品a 商品b 商品c 商品d 用户A 1 0 0 1 用户B 0 1 1 0 用户C 1 0 1 1 用户D 1 1 0 0 夹角余弦距离公式计算商品a和b的相似度: Wab=(1*0+0*1+1*0+1*1)/(√(1^2+0^2+1^2+1^2 )*√(0^2+1^2+0^2+1^2 ))=1/√6 spark实现ICF:https://zhuanlan.zhihu.com/p/413159725 问题:冷启动问题,长尾效应。 (3)向量召回 向量化召回:通过学习用户与物品低维向量化表征,将召回建模成向量空间内的近邻搜索问题,有效提升了召回的泛化能力与多样性,是推荐引擎的核心召回通道。 向量:万物皆可向量化,Embedding就是用一个低维稠密的向量表示一个对象(词语或者商品),主要作用是将稀疏向量转换成稠密向量(降维的效果),这里的表示蕴含着一定的深意,使其能够表达出对象的一部分特征,同时向量之间的距离反映对象之间的相似性。 向量召回步骤:离线训练生成向量,在线向量检索。 1.离线训练生成向量 word2vec:词向量的鼻祖,由三层神经网络:输入层,隐藏层,输出层,隐藏层没有激活函数,输出层用了softmax计算概率。 目标函数 网络结构: 总的来说:输入是词语的序列,经过模型训练可以得到每个词语对应的向量。应用在推荐领域就是输入是用户的点击序列,经过模型训练得到每个商品的向量。 优劣:简单高效,但是只考虑了行为序列,没有考虑其他特征。 双塔模型: 网络结构:分别称为User塔和物品塔;其中User塔接收用户侧特征作为输入比如用户id、性别、年龄、感兴趣的三级品类、用户点击序列、用户地址等;Item塔接受商品侧特征,比如商品id、类目id、价格、近三天订单量等。数据训练:(正样本数据,1)(负样本,0)正样本:点击的商品,负样本:全局随机商品样本(或者同批次其他用户点击样本) 优劣:高效,完美契合召回特性,在线请求得到用户向量,检索召回item向量,泛化性高;用户塔和item塔割裂,只在最后做了交互。 2.在线向量检索 向量检索:是一种基于向量空间模型(Vector Space Model)的信息检索方法,用于在大规模文本集合中快速查找与查询向量最相似的文档向量。在信息检索、推荐系统、文本分类中得到广泛应用。 向量检索的过程是计算向量之间的相似度,最后返回相似度较高的TopK向量返回,而向量相似度计算有多种方式。计算向量相似性得方式有欧式距离、内积、余弦距离。归一化后,内积与余弦相似度计算公式等价。 向量检索的本质是近似近邻搜索(ANNS),尽可能减小查询向量的搜索范围,从而提高查询速度。 目前在工业界被大规模用到的向量检索算法基本可以分为以下3类: 局部敏感性哈希(LSH) 基于图(HNSW) 基于乘积量化 简单介绍LSH LSH算法的核心思想是:将原始数据空间中的两个相邻数据点通过相同的映射或投影变换后,这两个数据点在新的数据空间中仍然相邻的概率很大,而不相邻的数据点被映射到同一个桶的概率很小。 相比于暴力搜索遍历数据集中的所有点,而使用哈希,我们首先找到查询样本落入在哪个桶中,如果空间的划分是在我们想要的相似性度量下进行分割的,则查询样本的最近邻将极有可能落在查询样本的桶中,如此我们只需要在当前的桶中遍历比较,而不用在所有的数据集中进行遍历。当哈希函数数目H取得太大,查询样本与其对应的最近邻落入同一个桶中的可能性会变得很微弱,针对这个问题,我们可以重复这个过程L次(每一次都是不同得哈希函数),从而增加最近邻的召回率。 案例:基于word2vec实现向量召回 2.4排序 推荐系统的掌上明珠 排序阶段分为粗排和精排,粗排一般出现在在召回结果的数据量级比较大的时候。 进化历程 简单介绍Wide&Deep 背景:手动特征组合实现记忆性效果不错但是特征工程太耗费人力,并且未曾出现的特征组合无法记忆,不能进行泛化。 目的:使模型同时兼顾泛化和记忆能力(有效的利用历史信息并具有强大的表达能力)​ (1)记忆能力 模型直接学习并利用历史数据中物品或者特征共现频率的能力,记忆历史数据的分布特点,简单模型容易发现数据中对结果影响较大的特征或者组合特征,调整其权重实现对强特征的记忆 (2)泛化能力 模型传递特征的相关性,以及发掘稀疏或者从未出现过的稀有特征和最终标签相关性的能力,即使是非常稀疏的特征向量输入也能得到稳定平滑的推荐概率。提高泛化性的例子:矩阵分解,神经网络 兼顾记忆和泛化能力 (结果的准确性和扩展性) wide部分专注模型记忆,快速处理大量历史行为特征,deep部分专注模型泛化,探索新世界,模型传递特征的相关性,发掘稀疏甚至从外出现过的稀有特征与最终标签的相关性的能力,具有强大的表达能力。最终将wide部分和deep部分结合起来,形成统一的模型。 wide部分就是基础的线性模型,表示为y=W^T X+b X特征部分包括基础特征和交叉特征。交叉特征在wide部分很重要,可以捕捉到特征间的交互,起到添加非线性的作用。 deep部分为embeding层+三层神经网络(relu),前馈公式 联合训练 优劣:为推荐/广告/搜索排序算法之后的发展奠定了重要基础,从传统算法跨越到深度学习算法,里程碑意义。兼顾记忆和泛化能力但是Wide侧仍需要手工组合特征。 参考论文:Wide & Deep Learning for Recommender Systems 2.5 重排 定义:对精排后的结果顺序进行微调,一方面实现全局最优、一方面满足业务诉求提升用户体验。比如打散策略,强插策略,提高曝光,敏感过滤 MMR算法 实现商品多样性问题​ 目的:在推荐结果准确性的同时保证推荐结果的多样性,为了平衡推荐结果的多样性和相关性​ 算法原理,如公式​ D:商品集合,Q:用户,S:已被选中的商品集合, R\S:R中未被选中的商品集合​ def MMR(itemScoreDict, similarityMatrix, lambdaConstant=0.5, topN=20): #s 排序后列表 r 候选项 s, r = [], list(itemScoreDict.keys()) while len(r) > 0: score = 0 selectOne = None # 遍历所有剩余项 for i in r: firstPart = itemScoreDict[i] # 计算候选项与"已选项目"集合的最大相似度 secondPart = 0 for j in s: sim2 = similarityMatrix[i][j] if sim2 > second_part: secondPart = sim2 equationScore = lambdaConstant * (firstPart - (1 - lambdaConstant) * secondPart) if equationScore > score: score = equationScore selectOne = i if selectOne == None: selectOne = i # 添加新的候选项到结果集r,同时从s中删除 r.remove(selectOne) s.append(selectOne) return (s, s[:topN])[topN > len(s)] 意义是选择一个与用户最相关的同时跟已选择物品最不相关的物品。时间复杂度O(n2) 可以通过限制选择的个数进行降低时间复杂度​ 工程实现:需要用户和物品的相关性和物品之间的相似性作为输入,用户和物品的相关性可以用排序模型的结果作为代替,物品之间的相似性可以通过协同过滤等算法得到商品向量,计算余弦距离。也可以简单得是否同一三级类目、同一店铺等表征​ 三、总结 就简单唠叨这么多啦,主要想让大家了解一下推荐系统,向大家介绍一下整个推荐架构,以及整个推荐都有哪些模块。由于本人水平有限,每个模块也没有讲的特别细,希望之后能在工作中继续学习这个领域,深挖细节,产出更好的东西呈现给大家。感谢!!! 作者:京东零售 闫先东 来源:京东云开发者社区

优秀的个人博客,低调大师

桌面应用打包:pyinstaller | 京东物流技术团队

1 背景 在使用python开发一些小工具时,如果其他人电脑中没有python环境或者没有安装相应的第三方库,是没办法运行的,而要求对方安装又不现实,尤其是对方不是技术人员,因此如何将一个独立的python程序,使它成为成为一个不用考虑环境,双击即可运行的桌面应用呢?使用pyinstaller打包是一个不错的选择。 2 什么是pyinstaller pyinstaller是一个支持跨平台使用的第三方库,它可以将脚本执行所需的模块和库,自动分析、收集并生成一个文件夹或者可执行文件。 以下示例使用windows环境,由于pyinstaller的跨平台性,与类unix环境命令一样,只是最终生成的可执行文件不一样。 3 如何安装 安装pyinstaller模块与安装其他python模块一样,使用pip命令安装即可。 pip install pyinstaller 安装输出结果: 其中的 altgraph、future等代表 PyInstaller 模块依赖环境。 4 如何使用 4.1 常用命令介绍 pyinstaller + 选项 + python入口源文件 主要选项包括: -F 打包成一个exe文件(如果是多个py文件,下面有解决办法) -D 自动创建一个包含桌面应用文件的目录,包括所有运行依赖文件(默认选项) -w 指定程序运行时,不显示命令行窗口(仅对windows有效) -i + ico路径 可以更换应用图标(如果是当前文件夹下,不用添加ico路径) -d 产生debug版本的exe文件 -o 指定.spec文件生成目录,如果没有指定,将会在当前根目录下输出 -n 指定.spec文件名字,如果省略,主文件名将作为.spec的文件名字 -p 设置导入路径,可以使用路径分隔符(windows是分号,类unix是冒号) 4.2 常用方式举例 4.2.1 打包成单个文件 使用以下命令将会使python脚本,打包成为一个exe文件。 pyinstaller -F -w -i “./dian_128.ico” start_dian.py 其中: -F 命令打包成单个文件 -w 无命令行窗口 -i 指定exe文件icon图标 执行成功后,将会在根目录生成两个文件夹,其中“build”文件中包含的是所有依赖文件,“dist”文件夹中存放着本次生成的exe文件。 4.2.2 打包成文件夹 使用以下命令将会使python脚本,打包成为一个文件夹。 pyinstaller -D -w -i “./dian_128.ico” start_dian.py 其中: -D 命令打包成一个文件夹 -w 无命令行窗口 -i 指定exe文件icon图标 命令行执行成功后,将会在dist目录下生成一个start_dian的子目录,该目录中包含了大量的.dll文件和.pyz文件,都是exe文件的支撑文件。 4.3 使用.spec文件配置编译 上面讲解的都是通用版本,不太灵活,如果想要加入新的资源,或每次编译不想输入很长的命令,可以使用.spec文件,进行定制化配置编译。 4.3.1 生成.spec文件 使用上面的方式进行编译后,如未指定.spec生成目录,会在当前根目录生成一个与编译py文件同名的.spec文件; 或使用命令pyi-makespec -F start_dian.py,将会直接生成.spec文件; 4.3.2 spec文件内容介绍 打开spec文件 这里仅对涉及到的几个关键变量进行解释: 1.Analysis: [‘start_dian.py’]:是主文件以及全部依赖文件,如果依赖文件都在同一目录下可以不写; oathex:项目的绝对路径; datas:添加资源文件,例如文件夹、图片、excel等等,以元组入参,第一个参数为原始路径,第二个参数为编译后的目标路径; 2.EXE: console:是否开启命令行,默认为True(开启); icon:编译出exe可执行文件产物的图标,必须使用绝对路径; name:EXE内和COLLECT内的name都是编译后的文件名,默认与编译主文件同名; 4.3.3 spec文件编译 配置好的spec文件,执行命令进行编译,不再需要其他参数: pyinstaller start_dian.spec 4.3.4 以下四种情况,修改spec文件比较好: 当您需要将资源文件与exe文件捆绑在一起时; 当您的依赖文件包括.dll或.so文件时; 当您运行exe需要运行参数时; 当您需要合并多程序包成为通用模块时; 5 常见问题 1.多文件如何打包 在.spec文件中Analysis参数hiddenimports中添加导入模块名称,修改后,可再次进行打包,将会解决exe文件依赖包找不到的问题; 在命令中使用-p 主文件 + -p 引入文件 …,可以直接生成exe文件。 2.exe文件过大 安装python虚拟环境; 导入包时,使用form + 包名 + import + 功能函数,不要直接import + 包名。 3.出现莫名其妙的错误 python文件所在的全路径,尽量不要有中文存在。 4.打包成一个文件夹后,发送给其他人无法使用 需要将dist下面的文件夹整体发送,保持exe文件与dist下面文件夹的路径不变。 5.运行exe文件后,没有达到预期效果 文件报错了,重新打包文件,使用控制台(去掉-w参数),将会在控制台显示程序运行过程与打印错误。 6.python脚本主要是命令行输出,但是程序执行完后就退出无法查看输出信息 在python脚本最后一行添加命令:os.system(“pause”)或者raw_input(“输出任意按键即可退出”)。 作者:京东物流 骆铜磊 来源:京东云开发者社区自猿其说Tech

优秀的个人博客,低调大师

并发编程-CompletableFuture解析 | 京东物流技术团队

1、CompletableFuture介绍 CompletableFuture对象是JDK1.8版本新引入的类,这个类实现了两个接口,一个是Future接口,一个是CompletionStage接口。 CompletionStage接口是JDK1.8版本提供的接口,用于异步执行中的阶段处理,CompletionStage定义了一组接口用于在一个阶段执行结束之后,要么继续执行下一个阶段,要么对结果进行转换产生新的结果等,一般来说要执行下一个阶段都需要上一个阶段正常完成,这个类也提供了对异常结果的处理接口 2、CompletableFuture的API 2.1 提交任务 在CompletableFuture中提交任务有以下几种方式: public static CompletableFuture<Void> runAsync(Runnable runnable) public static CompletableFuture<Void> runAsync(Runnable runnable, Executor executor) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier, Executor executor) 这四个方法都是用来提交任务的,不同的是supplyAsync提交的任务有返回值,runAsync提交的任务没有返回值。两个接口都有一个重载的方法,第二个入参为指定的线程池,如果不指定,则默认使用ForkJoinPool.commonPool()线程池。在使用的过程中尽量根据不同的业务来指定不同的线程池,方便对不同线程池进行监控,同时避免业务共用线程池相互影响。 2.2 结果转换 2.2.1 thenApply public <U> CompletableFuture<U> thenApply(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn, Executor executor) thenApply这一组函数入参是Function,意思是将上一个CompletableFuture执行结果作为入参,再次进行转换或者计算,重新返回一个新的值。 2.2.2 handle public <U> CompletableFuture<U> handle(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn, Executor executor) handle这一组函数入参是BiFunction,该函数式接口有两个入参一个返回值,意思是处理上一个CompletableFuture的处理结果,同时如果有异常,需要手动处理异常。 2.2.3 thenRun public CompletableFuture<Void> thenRun(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action, Executor executor) thenRun这一组函数入参是Runnable函数式接口,该接口无需入参和出参,这一组函数是在上一个CompletableFuture任务执行完成后,在执行另外一个接口,不需要上一个任务的结果,也不需要返回值,只需要在上一个任务执行完成后执行即可。 2.2.4 thenAccept public CompletableFuture<Void> thenAccept(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action, Executor executor) thenAccept这一组函数的入参是Consumer,该函数式接口有一个入参,没有返回值,所以这一组接口的意思是处理上一个CompletableFuture的处理结果,但是不返回结果。 2.2.5 thenAcceptBoth public <U> CompletableFuture<Void> thenAcceptBoth(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action, Executor executor) thenAcceptBoth这一组函数入参包括CompletionStage以及BiConsumer,CompletionStage是JDK1.8新增的接口,在JDK中只有一个实现类:CompletableFuture,所以第一个入参就是CompletableFuture,这一组函数是用来接受两个CompletableFuture的返回值,并将其组合到一起。BiConsumer这个函数式接口有两个入参,并且没有返回值,BiConsumer的第一个入参就是调用方CompletableFuture的执行结果,第二个入参就是thenAcceptBoth接口入参的CompletableFuture的执行结果。所以这一组函数意思是将两个CompletableFuture执行结果合并到一起。 2.2.6 thenCombine public <U,V> CompletableFuture<V> thenCombine(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn, Executor executor) thenCombine这一组函数和thenAcceptBoth类似,入参都包含一个CompletionStage,也就是CompletableFuture对象,意思也是组合两个CompletableFuture的执行结果,不同的是thenCombine的第二个入参为BiFunction,该函数式接口有两个入参,同时有一个返回值。所以与thenAcceptBoth不同的是,thenCombine将两个任务结果合并后会返回一个全新的值作为出参。 2.2.7 thenCompose public <U> CompletableFuture<U> thenCompose(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn, Executor executor) thenCompose这一组函数意思是将调用方的执行结果作为Function函数的入参,同时返回一个新的CompletableFuture对象。 2.3 回调方法 public CompletableFuture<T> whenComplete(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action, Executor executor) whenComplete方法意思是当上一个CompletableFuture对象任务执行完成后执行该方法。BiConsumer函数式接口有两个入参没有返回值,这两个入参第一个是CompletableFuture任务的执行结果,第二个是异常信息。表示处理上一个任务的结果,如果有异常,则需要手动处理异常,与handle方法的区别在于,handle方法的BiFunction是有返回值的,而BiConsumer是没有返回值的。 以上方法都有一个带有Async的方法,带有Async的方法表示是异步执行的,会将该任务放到线程池中执行,同时该方法会有一个重载的方法,最后一个参数为Executor,表示异步执行可以指定线程池执行。为了方便进行控制,最好在使用CompletableFuture时手动指定我们的线程池。 2.4 异常处理 public CompletableFuture<T> exceptionally(Function<Throwable, ? extends T> fn) exceptionally是用来处理异常的,当任务抛出异常后,可以通过exceptionally来进行处理,也可以选择使用handle来进行处理,不过两者有些不同,hand是用来处理上一个任务的结果,如果有异常情况,就处理异常。而exceptionally可以放在CompletableFuture处理的最后,作为兜底逻辑来处理未知异常。 2.5 获取结果 public static CompletableFuture<Void> allOf(CompletableFuture<?>... cfs) public static CompletableFuture<Object> anyOf(CompletableFuture<?>... cfs) allOf是需要入参中所有的CompletableFuture任务执行完成,才会进行下一步; anyOf是入参中任何一个CompletableFuture任务执行完成都可以执行下一步。 public T get() throws InterruptedException, ExecutionException public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException public T getNow(T valueIfAbsent) public T join() get方法一个是不带超时时间的,一个是带有超时时间的。 getNow方法则是立即返回结果,如果还没有结果,则返回默认值,也就是该方法的入参。 join方法是不带超时时间的等待任务完成。 3、CompletableFuture原理 join方法同样表示获取结果,但是join与get方法有什么区别呢。 public T join() { Object r; return reportJoin((r = result) == null ? waitingGet(false) : r); } public T get() throws InterruptedException, ExecutionException { Object r; return reportGet((r = result) == null ? waitingGet(true) : r); } public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { Object r; long nanos = unit.toNanos(timeout); return reportGet((r = result) == null ? timedGet(nanos) : r); } public T getNow(T valueIfAbsent) { Object r; return ((r = result) == null) ? valueIfAbsent : reportJoin(r); } 以上是CompletableFuture类中两个方法的代码,可以看到两个方法几乎一样。区别在于reportJoin/reportGet,waitingGet方法是一致的,只不过参数不一样,我们在看下reportGet与reportJoin方法。 private static <T> T reportGet(Object r) throws InterruptedException, ExecutionException { if (r == null) // by convention below, null means interrupted throw new InterruptedException(); if (r instanceof AltResult) { Throwable x, cause; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if ((x instanceof CompletionException) && (cause = x.getCause()) != null) x = cause; throw new ExecutionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } private static <T> T reportJoin(Object r) { if (r instanceof AltResult) { Throwable x; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if (x instanceof CompletionException) throw (CompletionException)x; throw new CompletionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } 可以看到这两个方法很相近,reportGet方法判断了r对象是否为空,并抛出了中断异常,而reportJoin方法没有判断,同时reportJoin抛出的都是运行时异常,所以join方法也是无需手动捕获异常的。 我们在看下waitingGet方法 private Object waitingGet(boolean interruptible) { Signaller q = null; boolean queued = false; int spins = -1; Object r; while ((r = result) == null) { if (spins < 0) spins = SPINS; else if (spins > 0) { if (ThreadLocalRandom.nextSecondarySeed() >= 0) --spins; } else if (q == null) q = new Signaller(interruptible, 0L, 0L); else if (!queued) queued = tryPushStack(q); else if (interruptible && q.interruptControl < 0) { q.thread = null; cleanStack(); return null; } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q != null) { q.thread = null; if (q.interruptControl < 0) { if (interruptible) r = null; // report interruption else Thread.currentThread().interrupt(); } } postComplete(); return r; } 该waitingGet方法是通过while的方式循环判断是否任务已经完成并产生结果,如果结果为空,则会一直在这里循环,这里需要注意的是在这里初始化了一下spins=-1,当第一次进入while循环的时候,spins是-1,这时会将spins赋值为一个常量,该常量为SPINS。 private static final int SPINS = (Runtime.getRuntime().availableProcessors() > 1 ? 1 << 8 : 0); 这里判断可用CPU数是否大于1,如果大于1,则该常量为 1<< 8,也就是256,否则该常量为0。 第二次进入while循环的时候,spins是256大于0,这里做了减一的操作,下次进入while循环,如果还没有结果,依然是大于0继续做减一的操作,此处用来做短时间的自旋等待结果,只有当spins等于0,后续会进入正常流程判断。 我们在看下timedGet方法的源码 private Object timedGet(long nanos) throws TimeoutException { if (Thread.interrupted()) return null; if (nanos <= 0L) throw new TimeoutException(); long d = System.nanoTime() + nanos; Signaller q = new Signaller(true, nanos, d == 0L ? 1L : d); // avoid 0 boolean queued = false; Object r; // We intentionally don't spin here (as waitingGet does) because // the call to nanoTime() above acts much like a spin. while ((r = result) == null) { if (!queued) queued = tryPushStack(q); else if (q.interruptControl < 0 || q.nanos <= 0L) { q.thread = null; cleanStack(); if (q.interruptControl < 0) return null; throw new TimeoutException(); } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q.interruptControl < 0) r = null; q.thread = null; postComplete(); return r; } timedGet方法依然是通过while循环的方式来判断是否已经完成,timedGet方法入参为一个纳秒值,并通过该值计算出一个deadline截止时间,当while循环还未获取到任务结果且已经达到截止时间,则抛出一个TimeoutException异常。 4、CompletableFuture实现多线程任务 这里我们通过CompletableFuture来实现一个多线程处理异步任务的例子。 这里我们创建10个任务提交到我们指定的线程池中执行,并等待这10个任务全部执行完毕。 每个任务的执行流程为第一次先执行加法,第二次执行乘法,如果发生异常则返回默认值,当10个任务执行完成后依次打印每个任务的结果。 public void demo() throws InterruptedException, ExecutionException, TimeoutException { // 1、自定义线程池 ExecutorService executorService = new ThreadPoolExecutor(5, 10, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(100)); // 2、集合保存future对象 List<CompletableFuture<Integer>> futures = new ArrayList<>(10); for (int i = 0; i < 10; i++) { int finalI = i; CompletableFuture<Integer> future = CompletableFuture // 提交任务到指定线程池 .supplyAsync(() -> this.addValue(finalI), executorService) // 第一个任务执行结果在此处进行处理 .thenApplyAsync(k -> this.plusValue(finalI, k), executorService) // 任务执行异常时处理异常并返回默认值 .exceptionally(e -> this.defaultValue(finalI, e)); // future对象添加到集合中 futures.add(future); } // 3、等待所有任务执行完成,此处最好加超时时间 CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).get(5, TimeUnit.MINUTES); for (CompletableFuture<Integer> future : futures) { Integer num = future.get(); System.out.println("任务执行结果为:" + num); } System.out.println("任务全部执行完成!"); } private Integer addValue(Integer index) { System.out.println("第" + index + "个任务第一次执行"); if (index == 3) { int value = index / 0; } return index + 3; } private Integer plusValue(Integer index, Integer num) { System.out.println("第" + index + "个任务第二次执行,上次执行结果:" + num); return num * 10; } private Integer defaultValue(Integer index, Throwable e) { System.out.println("第" + index + "个任务执行异常!" + e.getMessage()); e.printStackTrace(); return 10; } 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

并发编程-FutureTask解析 | 京东物流技术团队

1、FutureTask对象介绍 Future对象大家都不陌生,是JDK1.5提供的接口,是用来以阻塞的方式获取线程异步执行完的结果。 在Java中想要通过线程执行一个任务,离不开Runnable与Callable这两个接口。 Runnable与Callable的区别在于,Runnable接口只有一个run方法,该方法用来执行逻辑,但是并没有返回值;而Callable的call方法,同样用来执行业务逻辑,但是是有一个返回值的。 Callable执行任务过程中可以通过FutureTask获得任务的执行状态,并且可以在执行完成后通过Future.get()方式获取执行结果。 Future是一个接口,而FutureTask就是Future的实现类。并且FutureTask实现了 RunnableFuture(Runnable + Future),说明我们可以创建一个FutureTask并直接把它放到线程池执行,然后获取FutureTask的执行结果。 2、FutureTask源码解析 2.1 主要方法和属性 那么FutureTask是如何通过阻塞的方式来获取到异步线程执行的结果的呢?我们看下FutureTask中的属性。 // FutureTask的状态及其常量 private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; // callable对象,执行完后置空 private Callable<V> callable; // 要返回的结果或要引发的异常来自 get() 方法 private Object outcome; // non-volatile, protected by state reads/writes // 执行Callable的线程 private volatile Thread runner; // 等待线程的一个链表结构 private volatile WaitNode waiters; FutureTask中几个比较重要的方法。 // 取消任务的执行 boolean cancel(boolean mayInterruptIfRunning); // 返回任务是否已经被取消 boolean isCancelled(); // 返回任务是否已经完成,任务状态不为NEW即为完成 boolean isDone(); // 通过get方法获取任务的执行结果 V get() throws InterruptedException, ExecutionException; // 通过get方法获取任务的执行结果,带有超时,如果超过给定时间则抛出异常 V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException; 2.2 FutureTask执行 当我们在线程池中执行一个Callable方法时,其实是将Callable任务封装成一个RunnableFuture对象去执行,同时将这个RunnableFuture对象返回,这样我们就拿到了FutureTask的引用,可以随时获取到任务执行的状态,并且可以在任务执行完成后通过该对象获取执行结果。 以下为ThreadPoolExecutor线程池提交一个callable方法的源码。 public <T> Future<T> submit(Callable<T> task) { if (task == null) throw new NullPointerException(); RunnableFuture<T> ftask = newTaskFor(task); execute(ftask); return ftask; } protected <T> RunnableFuture<T> newTaskFor(Callable<T> callable) { return new FutureTask<T>(callable); } 2.3 run方法介绍 RunnableFuture其实也是一个可以执行的runnable,我们看下他的run方法。其主要流程就是执行call方法,正常执行完毕后将result结果赋值到outcome属性上。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { // 将callable赋值到本地变量 Callable<V> c = callable; // 判断callable不为空并且FutureTask的状态必须为新创建 if (c != null && state == NEW) { V result; boolean ran; try { // 执行call方法(用户自己实现的call逻辑),并获取到result结果 result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; // 如果执行过程出现异常,则将异常对象赋值到outcome上 setException(ex); } // 如果正常执行完毕,则将result赋值到outcome属性上 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } 以下逻辑为正常执行完成后赋值的逻辑。 // 如果任务没有被取消,将future执行完的返回值赋值给result结果 // FutureTask任务的执行状态是通过CAS的方式进行赋值的,并且由此可知,COMPLETING其实是一个瞬时状态 // 当将线程执行结果赋值给outcome后,状态会修改为对应的NORMAL,即正常结束 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state finishCompletion(); } } 以下为执行异常时赋值逻辑,直接将Throwable对象赋值到outcome属性上。 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = t; UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // final state finishCompletion(); } } 无论是正常执行还是异常执行,最终都会调用一个finishCompletion方法,用来做工作的收尾工作。 2.4 get方法介绍 Future的get方法有两个重载的方法,一个是get()获取结果,一个是get(long, TimeUnit)带有超时时间的获取结果,我们看下FutureTask中的这两个方法是如何实现的。 // 不带有超时时间,一直阻塞直到获取结果 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) // 等待结果完成,带有超时的get方法也是调用的awaitDone方法 s = awaitDone(false, 0L); // 返回结果 return report(s); } // 带有超时时间的获取结果,如果超过时间还没有获取到结果则抛出异常 public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; // 如果任务未中断,调用awaitDone方法等待任务结果 if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING) throw new TimeoutException(); // 返回结果 return report(s); } 我们主要看下awaitDone方法的执行逻辑。此方法会通过for循环的方式一直阻塞等待任务执行完成。如果带有超时时间,则超过截止时间后会直接返回。 // timed:是否需要超时获取 // nanos:超时时间单位纳秒 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; // 此方法会一直for循环判断任务状态是否已经完成,是Future.get阻塞的原因 for (;;) { if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } int s = state; // 任务状态大于COMPLETING,则表明任务结束,直接返回 if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet // Thread.yield() 方法,使当前线程由执行状态,变成为就绪状态,让出cpu时间,在下一个线程执行时候,此线程有可能被执行,也有可能没有被执行。 // COMPLETING状态为瞬时状态,任务执行完成,要么是正常结束,要么异常结束,后续会被置为NORMAL或者EXCEPTIONAL Thread.yield(); else if (q == null) // 每调用一次get方法,都会创建一个WaitNode等待节点 q = new WaitNode(); else if (!queued) // 将该等待节点添加到链表结构waiters中,q.next = waiters 即在waiters的头部插入 queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); // 如果方法带有超时判断,则判断当前时间是否已经超过了截止时间,如果超过了及截止日期,则退出循环直接返回当前状态,此时任务状态一定是NEW else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) { removeWaiter(q); return state; } LockSupport.parkNanos(this, nanos); } else LockSupport.park(this); } } 我们在看下report方法,在调用get方法时是如何返回结果的。 这里首先获取outcome的值,并判断任务是否已经执行完成,如果执行完成,则将outcome对象强转成泛型指定的类型;如果任务被取消了,则抛出一个CancellationException异常;如果都不是,则说明任务在执行过程中发生了异常,此时任务状态位EXCEPTIONAL,此时的outcome即为Throwable对象,所以将outcome强转为Throwable并抛出异常。 由此可以知道,我们将一个FutureTask任务submit到线程池中执行的时候,如果发生了异常,是会在调用get方法的时候抛出的。 private V report(int s) throws ExecutionException { Object x = outcome; if (s == NORMAL) return (V)x; if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 2.5 cancel方法介绍 cancel方法用于取消正在运行的任务,如果任务取消成功,则返回TRUE,如果取消失败则返回FALSE。 // mayInterruptIfRunning:允许中断正在运行的任务 public boolean cancel(boolean mayInterruptIfRunning) { // mayInterruptIfRunning如果为true则将状态置为INTERRUPTING,如果未false则将状态置为CANCELLED if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false; // 如果状态修改成功后,判断是否允许中断线程,如果允许,则调用Thread的interrupt方法中断 try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { // 取消后的收尾工作 finishCompletion(); } return true; } 2.6 isDone/isCancelled方法介绍 isDone方法用于判断FutureTask是否已经完成;isCancelled方法用来判断FutureTask是否已经取消,这两个方法都是通过状态位来判断的。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 2.7 finishCompletion方法介绍 我们看下finishCompletion方法都做了哪些工作。 // 删除所有等待线程并发出信号,最后执行done方法 private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t); } WaitNode next = q.next; if (next == null) break; q.next = null; // unlink to help gc q = next; } break; } } done(); callable = null; // to reduce footprint } 我们看到done方法是一个受保护的空方法,此处没有任何逻辑,由其子类去根据自己的业务去实现相应的逻辑。例如:java.util.concurrent.ExecutorCompletionService.QueueingFuture。 protected void done() { } 3、总结 通过源码解读可以了解到Future的原理: 第一步:主线程将任务封装成一个Callable对象,通过submit方法提交到线程池去执行。 第二步:线程池执行任务的run方法,主线程则可以继续执行其他逻辑。 第三步:线程池中方法执行完成后将结果赋值到outcome属性上,并修改任务状态。 第四步:主线程在需要拿到异步任务结果的时候,主动调用fugure.get()方法来获取结果。 第五步:如果异步线程在执行过程中发生异常,则会在调用future.get()方法的时候抛出来。 以上就是对于FutureTask的分析,我们可以了解FutureTask任务执行的方式以及Future.get已阻塞的方式获取线程执行的结果原理,并且从代码中可以了解FutureTask的任务执行状态以及状态的变化过程。 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

JVM GC配置指南 | 京东云技术团队

本文旨在简明扼要说明各回收器调优参数,如有疏漏欢迎指正。 1、JDK版本 以下所有优化全部基于JDK8版本,强烈建议低版本升级到JDK8,并尽可能使用update_191以后版本。 2、如何选择垃圾回收器 响应优先应用:面向C端对响应时间敏感的应用,堆内存8G以上建议选择G1,堆内存较小或低版本JDK选择CMS; 吞吐量优先应用:对响应时间不敏感,以高吞吐量为目标的应用(如MQ、Worker),建议选择ParallelGC; 3、各回收器优化参数 1)基本参数配置(所有应用、所有回收器都需要): -Xmx(一般为容器内存的50%) -Xms(与Xmx一致) -XX:MetaspaceSize(通常256M~512M) -XX:ParallelGCThreads=容器核数 -XX:CICompilerCount=容器核数(必须大于等于2) 2)ParallelGC 除以上参数外,一般不需要额外调优(JDK8默认回收器) 3)CMS -XX:+UseConcMarkSweepGC -Xmn (一般为堆内存的三分之一),尤其是配置了ParallelGCThreads后必须配置此参数 -XX:ConcGCThreads=n(默认为ParallelGCThreads/4,可视情况调整至ParallelGCThreads/2) -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=70(推荐值) 4)G1 -XX:+UseG1GC -XX:ConcGCThreads=n(默认为ParallelGCThreads/4,可视情况调整至ParallelGCThreads/2) -XX:G1HeapRegionSize=8m(若堆内存在8G以内且有较多大对象推荐设置此值) *注意不要设置-Xmn 和 XX:NewRatio 5)其他调优参数 -XX:+ParallelRefProcEnabled 如果GC时Reference处理时间较长,例如大量使用WeakReference对象,可以通过此参数开启并行处理 4、开启GC日志 -XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/export/Logs/gc.log 5、如何判断GC是否正常 1)GC是否频繁:YoungGC频率一般几十秒钟一次,FullGC一般每天几次,注意G1回收器不应该出现FullGC; 2)GC耗时:耗时主要取决于堆内存大小及垃圾对象数量。YoungGC时间通常应在几十毫秒,FullGC通常在几百毫秒; 3)每次GC内存是否下降:应用刚启动时,每次YoungGC内存应该回收到较低水位,随着时间推移老年代逐步增多,内存水位会逐步上涨,直到FullGC/MixedGC(G1),内存会再次回到较低水位,否则可能存在内存泄漏; 4)如果使用ParallelGC,堆内存耗尽才会触发FullGC,所以不用配置堆内存使用率告警,但需关注GC频率; 5)泰山上可以巡检部分JVM配置。 作者:京东零售王利辉 来源:京东云开发者社区

优秀的个人博客,低调大师

SpringIoc容器之Aware | 京东云技术团队

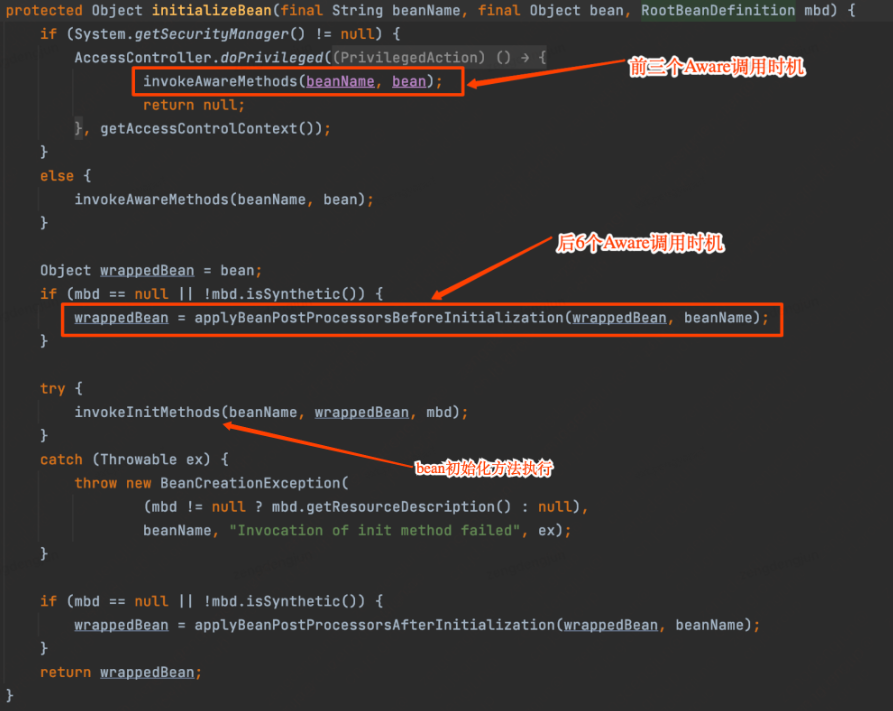
1 前言 Aware是Spring提供的一个标记超接口,指示bean有资格通过回调样式的方法由Spring容器通知特定的框架对象,以获取到容器中特有对象的实例的方法之一。实际的方法签名由各个子接口确定,但通常只包含一个接受单个参数的void返回方法。 2 Spring中9个Aware内置实现 |--Aware |--BeanNameAware |--BeanClassLoaderAware |--BeanFactoryAware |--EnvironmentAware |--EmbeddedValueResolverAware |--ResourceLoaderAware |--ApplicationEventPublisherAware |--MessageSourceAware |--ApplicationContextAware 9个内置实现又分两类,前三个为直接调用,后6个通过ApplicationContextAwareProcessor后置处理器,间接回调 2.1 BeanNameAware public interface BeanNameAware extends Aware { /** *设置创建此bean的bean工厂中的bean的名称。 *在普通bean属性填充之后但在 *初始化之前回调,如{@link InitializingBean#afterPropertiesSet()} *或自定义初始化方法。 * @param name工厂中bean的名称。 *注意,此名称是工厂中使用的实际bean名称,这可能 *与最初指定的名称不同:特别是对于内部bean * names,实际的bean名称可以通过添加 *“#…”后缀。使用{@link BeanFactoryUtils#originalBeanName(String)} *方法提取原始bean名称(不带后缀),如果需要的话。 * / void setBeanName(String name); } 实现BeanNameAware接口需要实现setBeanName()方法,这个方法只是简单的返回我们当前的beanName,这个接口表面上的作用就是让实现这个接口的bean知道自己在spring容器里的名字,而且官方的意思是这个接口更多的使用在spring的框架代码中,实际开发环境应该不建议使用,因为spring认为bean的名字与bean的联系并不是很深,(的确,抛开spring API而言,我们如果获取了该bean的名字,其实意义不是很大,我们没有获取该bean的class,只有该bean的名字,我们也无从下手,相反,因为bean的名称在spring容器中可能是该bean的唯一标识,也就是说再beanDefinitionMap中,key值就是这个name,spring可以根据这个key值获取该bean的所有特性)所以spring说这个不是非必要的依赖。 2.2 BeanClassLoaderAware public interface BeanClassLoaderAware extends Aware { /** *提供bean {@link ClassLoader}类加载器的回调 *一个bean实例在属性的填充之后但在初始化回调之前调用 * {@link InitializingBean * {@link InitializingBean#afterPropertiesSet()} *方法或自定义初始化方法。 * @param类加载器拥有的类加载器;可能是{@code null}在例如,必须使用默认的{@code ClassLoader} * 获取的{@code ClassLoader} * {@link org.springframework.util.ClassUtils#getDefaultClassLoader()} * / void setBeanClassLoader(ClassLoader classLoader); } 在bean属性填充之后初始化之前,提供类加制器的回调。让受管Bean本身知道它是由哪一类装载器负责装载的。 2.3 BeanFactoryAware public interface BeanFactoryAware extends Aware { /** * 为bean实例提供所属工厂的回调。 * 在普通bean属性填充之后调用但在初始化回调之前,如 * {@link InitializingBean#afterPropertiesSet()}或自定义初始化方法。 * @param beanFactory拥有beanFactory(非空)。bean可以立即调用工厂上的方法。 * @在初始化错误时抛出BeansException * @参见BeanInitializationException * / void setBeanFactory(BeanFactory beanFactory) throws BeansException; } 在bean属性填充之后初始化之前,提bean工厂的回调。实现 BeanFactoηAware 接口的 bean 可以直接访问 Spring 容器,被容器创建以后,它会拥有一个指向 Spring 容器的引用,可以利用该bean根据传入参数动态获取被spring工厂加载的bean 2.4 EnvironmentAware public interface EnvironmentAware extends Aware { /** * 设置该对象运行的{@code环境}。 */ void setEnvironment(Environment environment); } 设置该对象运行的。所有注册到 Spring容器内的 bean,只要该bean 实现了 EnvironmentAware接口,并且进行重写了setEnvironment方法的情况下,那么在工程启动时就可以获取得 application.properties 的配置文件配置的属性值,这样就不用我们将魔法值写到代码里面了。 2.5 EmbeddedValueResolverAware public interface EmbeddedValueResolverAware extends Aware { /** * 设置StringValueResolver用于解析嵌入的定义值。 */ void setEmbeddedValueResolver(StringValueResolver resolver); } 在基于Spring获取properties文件属性值的时候,一般使用@Value的方式注入配置文件属性值,但是@Value必须要在Spring的Bean生命周期管理下才能使用,比如类被@Controller、@Service、@Component等注解标注。如有的抽象类中,基于Spring解析@Value的方式,使用EmbeddedValueResolverAware解析配置文件来实现。 2.6 ResourceLoaderAware public interface ResourceLoaderAware extends Aware { /** *设置该对象运行的ResourceLoader。这可能是一个ResourcePatternResolver,它可以被检查 *通过{@code instanceof ResourcePatternResolver}。另请参阅 * {@code ResourcePatternUtils。getResourcePatternResolver}方法。 * <p>在填充普通bean属性之后但在init回调之前调用 *像InitializingBean的{@code afterPropertiesSet}或自定义初始化方法。 *在ApplicationContextAware的{@code setApplicationContext}之前调用。 * @param resourceLoader该对象使用的resourceLoader对象 * @ @ springframework.core. io.support.resourcepatternresolver * @ @ resourcepatternutils #获取resourcepatternresolver * / void setResourceLoader(ResourceLoader resourceLoader); } ResourceLoaderAware 是特殊的标记接口,它希望拥有一个 ResourceLoader 引用的对象。当实现了 ResourceLoaderAware接口的类部署到application context(比如受Spring管理的bean)中时,它会被application context识别为 ResourceLoaderAware。 接着application context会调用setResourceLoader(ResourceLoader)方法,并把自身作为参数传入该方法(记住,所有Spring里的application context都实现了ResourceLoader接口)。 既然 ApplicationContext 就是ResourceLoader,那么该bean就可以实现 ApplicationContextAware接口并直接使用所提供的application context来载入资源,但是通常更适合使用特定的满足所有需要的 ResourceLoader 实现。 这样一来,代码只需要依赖于可以看作辅助接口的资源载入接口,而不用依赖于整个Spring ApplicationContext 接口。 2.7 ApplicationEventPublisherAware public interface ApplicationEventPublisherAware extends Aware { /** *设置该对象运行的ApplicationEventPublisher。 * <p>在普通bean属性填充之后但在init之前调用像InitializingBean的afterPropertiesSet或自定义初始化方法。 *在ApplicationContextAware的setApplicationContext之前调用。 *该对象使用的事件发布者 * / void setApplicationEventPublisher(ApplicationEventPublisher applicationEventPublisher); } ApplicationEventPublisherAware 是由 Spring 提供的用于为 Service 注入 ApplicationEventPublisher 事件发布器的接口,使用这个接口,我们自己的 Service 就拥有了发布事件的能力。 2.8 MessageSourceAware public interface MessageSourceAware extends Aware { /** *设置该对象运行的MessageSource。 * <p>在普通bean属性填充之后但在init之前调用像InitializingBean的afterPropertiesSet或自定义初始化方法。 *在ApplicationContextAware的setApplicationContext之前调用。 * @param messageSource消息源 * / void setMessageSource(MessageSource messageSource); } 获得message source这样可以获得文本信息,使用场景如为了国际化。 2.9 ApplicationContextAware public interface ApplicationContextAware extends Aware { /** *设置该对象运行的ApplicationContext。通常这个调用将用于初始化对象。 * <p>在普通bean属性填充之后但在init回调之前调用 *作为{@link org.springframework.beans.factory.InitializingBean#afterPropertiesSet()} *或自定义初始化方法。在{@link ResourceLoaderAware#setResourceLoader}之后调用, * {@link ApplicationEventPublisherAware#setApplicationEventPublisher}和 * {@link MessageSourceAware},如果适用。 * @param applicationContext该对象将使用的applicationContext对象 * @在上下文初始化错误时抛出ApplicationContextException如果由应用程序上下文方法抛出,则抛出BeansException * @see org.springframework.beans.factory.BeanInitializationException * / void setApplicationContext(ApplicationContext applicationContext) throws BeansException; } ApplicationContextAware的作用是可以方便获取Spring容器ApplicationContext,从而可以获取容器内的Bean。ApplicationContextAware接口只有一个方法,如果实现了这个方法,那么Spring创建这个实现类的时候就会自动执行这个方法,把ApplicationContext注入到这个类中,也就是说,spring 在启动的时候就需要实例化这个 class(如果是懒加载就是你需要用到的时候实例化),在实例化这个 class 的时候,发现它包含这个 ApplicationContextAware 接口的话,sping 就会调用这个对象的 setApplicationContext 方法,把 applicationContext Set 进去了。 3 Spring中调用时机 Aware接口由Spring在AbstractAutowireCapableBeanFactory.initializeBean(beanName, bean,mbd)方法中通过调用invokeAwareMethods(beanName, bean)方法和applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName)触发Aware方法的调用 3.1 invokeAwareMethods private void invokeAwareMethods(final String beanName, final Object bean) { if (bean instanceof Aware) { if (bean instanceof BeanNameAware) { ((BeanNameAware) bean).setBeanName(beanName); } if (bean instanceof BeanClassLoaderAware) { ((BeanClassLoaderAware) bean).setBeanClassLoader(getBeanClassLoader()); } if (bean instanceof BeanFactoryAware) { ((BeanFactoryAware) bean).setBeanFactory(AbstractAutowireCapableBeanFactory.this); } } } 判断并直接回调 3.2 applyBeanPostProcessorsBeforeInitialization public Object applyBeanPostProcessorsBeforeInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; for (BeanPostProcessor beanProcessor : getBeanPostProcessors()) { result = beanProcessor.postProcessBeforeInitialization(result, beanName); if (result == null) { return result; } } return result; } 通过ApplicationContextAwareProcessor.postProcessBeforeInitialization(Object bean, String beanName)间接调用,并在方法invokeAwareInterfaces中进行回调。 public Object postProcessBeforeInitialization(final Object bean, String beanName) throws BeansException { AccessControlContext acc = null; if (System.getSecurityManager() != null && (bean instanceof EnvironmentAware || bean instanceof EmbeddedValueResolverAware || bean instanceof ResourceLoaderAware || bean instanceof ApplicationEventPublisherAware || bean instanceof MessageSourceAware || bean instanceof ApplicationContextAware)) { acc = this.applicationContext.getBeanFactory().getAccessControlContext(); } if (acc != null) { AccessController.doPrivileged(new PrivilegedAction<Object>() { @Override public Object run() { invokeAwareInterfaces(bean); return null; } }, acc); } else { invokeAwareInterfaces(bean); } return bean; } private void invokeAwareInterfaces(Object bean) { if (bean instanceof Aware) { if (bean instanceof EnvironmentAware) { ((EnvironmentAware) bean).setEnvironment(this.applicationContext.getEnvironment()); } if (bean instanceof EmbeddedValueResolverAware) { ((EmbeddedValueResolverAware) bean).setEmbeddedValueResolver( new EmbeddedValueResolver(this.applicationContext.getBeanFactory())); } if (bean instanceof ResourceLoaderAware) { ((ResourceLoaderAware) bean).setResourceLoader(this.applicationContext); } if (bean instanceof ApplicationEventPublisherAware) { ((ApplicationEventPublisherAware) bean).setApplicationEventPublisher(this.applicationContext); } if (bean instanceof MessageSourceAware) { ((MessageSourceAware) bean).setMessageSource(this.applicationContext); } if (bean instanceof ApplicationContextAware) { ((ApplicationContextAware) bean).setApplicationContext(this.applicationContext); } } } 4 总结 通过上面的分析,可以知道Spring生命周期中的初始化方法里,在真正执行初始化方法之前,分别通过invokeAwareMethods方法和后置处理器ApplicationContextAwareProcessor来触发Aware的调用,那么,Spring为什么要使用两种方式而不使用其中之一呢? 通过本章我们了解了9中内置接口的作用,以及它们能够获取到的不同上下文信息。 作者:京东零售 曾登均 来源:京东云开发者社区

优秀的个人博客,低调大师

Intellij IDEA 插件开发 | 京东云技术团队

写在前面 很多idea插件文档更多的是介绍如何创建一个简单的idea插件,本篇文章从开发环境、demo、生态组件、添加依赖包、源码解读、网络请求、渲染数据、页面交互等方面介绍,是一篇能够满足基本的插件开发工程要求的文章。 如有疏漏欢迎指正,如想深入了解欢迎探讨。 一、简介 IntelliJ IDEA 与 IntelliJ Platform IntelliJ IDEA 简称 IDEA,是 Jetbrains 公司旗下的一款 JAVA 开发工具,支持 Java、Scala、Groovy 等语言的开发,同时具备支持目前主流的技术和框架,擅长于企业应用、移动应用和 Web 应用的开发,提供了丰富的功能,智能代码助手、代码自动提示、重构、J2EE支持、各类版本工具(git、svn等)、JUnit、CVS整合、代码分析、 创新的GUI设计等。 IntelliJ Platform 是一个构建 IDE 的开源平台,基于它构建的 IDE 有 IntelliJ IDEA、WebStorm、DataGrip、以及 Android Studio 等等。IDEA 插件也是基于 IntelliJ Platform 开发的。 二、开发环境搭建 注意各软件版本要对应 1、开发工具 IDEA 2020.1 各版本下载地址:https://www.jetbrains.com/idea/download/other.html gradle 6.1 各版本下载地址:https://gradle.org/releases/ org.jetbrains.intellij 0.4.22 jdk 1.8 首先看一下目前idea版本的变动,找到自己当前idea对应的版本需要的jdk版本https://plugins.jetbrains.com/docs/intellij/build-number-ranges.html?from=jetbrains.org#intellij-platform-based-products-of-recent-ide-versions 接下来需要找idea对应版本的gradle版本https://www.jetbrains.com/legal/third-party-software/?product=iic&version=2020.1.1 最后就是找 gradle版本对应的 org.jetbrains.intellij 插件版本,在gradle-intellij-plugin插件的releases页面,这里会在描述中指出有各个插件版本对应最低的gradle版本。https://github.com/JetBrains/gradle-intellij-plugin/releases?page=1 添加依赖到gradel配置文件,获取相关依赖配置https://mvnrepository.com/artifact/org.springframework/spring-web 2、启用Plugin DevKit Plugin DevKit 是 IntelliJ 的一个插件,它使用 IntelliJ IDEA 自己的构建系统来为开发 IDEA 插件提供支持。开发 IDEA 插件之前需要安装并启用 Plugin DevKit 。 打开 IDEA,导航到 Settings | Plugins,若插件列表中没有 Plugin DevKit,点击 Install JetBrains plugin,搜索并安装。 3、配置IntelliJ Platform Plugin SDK IntelliJ Platform Plugin SDK 就是开发 IntelliJ 平台插件的SDK, 是基于 JDK 之上运行的,类似于开发 Android 应用需要 Android SDK。 3.1导航到 File | Project Structure,选择对话框左侧栏 Platform Settings 下的 SDKs 3.2点击 + 按钮,先选择 JDK,指定 JDK 的路径;再创建 IntelliJ Platform Plugin SDK,指定 home path 为 IDEA 的安装路径,如图 创建好 IntelliJ Platform Plugin SDK 后,选择左侧栏 Project Settings 下的 Projects,在 Project SDK 下选择刚创建的 IntelliJ Platform Plugin SDK。 4、设置源码路径(可选) 4.1查看 build 号:打开 IDEA,Help | About,查看版本号及 build 号 4.2IDEA Community 源码(https://github.com/JetBrains/intellij-community/):切换到与 build 号相同的分支,点击 Clone or download 按钮,选择 Download ZIP 4.3选择工程结构设置后选择SDKs->选中之前在第3步添加的sdk点击SourcePath后按如下1点击添加一个sourcePath,选择上面下载额源码后点击OK、点击Applay 4.4未安装源码时点击某一个action(NewModuleAction)会看到如下所示阅读起来会比较晦涩难懂。 5、Sandbox IntelliJ IDEA 插件以 Debug/Run 模式运行时是在 SandBox 中进行的,不会影响当前的 IntelliJ IDEA;但是同一台机器同时开发多个插件时默认使用的同一个 sandbox,即在创建 IntelliJ Platform SDK 时默认指定的 Sandbox Home 如果需要每个插件的开发环境是相互独立的,可以创建多个 IntelliJ Platform SDK,为 Sandbox Home 指定不同的目录 。 三、开发一个简单插件 插件的创建、配置、运行、打包流程,以及 action 1、创建一个插件工程 选择 File | New | Project,左侧栏中选择 IntelliJ Platform Plugin 工程类型 点击 Next,设置工程名称及位置,点击 Finish 完成创建。可以到 File | Project Structure 来自定义工程设置。 除了在idea创建插件项目外,我们还可以下载github模板代码进行修改:https://github.com/JetBrains/intellij-platform-plugin-template 2、插件工程结构 插件工程内容: PluginDemo/ resources/ META-INF/ plugin.xml src/ com/foo/... ... ... src 实现插件功能的classes resources/META-INF/plugin.xml 插件的配置文件,指定插件名称、描述、版本号、支持的 IntelliJ IDEA 版本、插件的 components 和 actions 以及软件商等信息。 3、plugin.xml 下面示例描述了可在 plugin.xml 文件配置的主要元素: <idea-plugin> <!-- 插件名称,别人在官方插件库搜索你的插件时使用的名称 --> <name>MyPlugin</name> <!-- 插件唯一id,不能和其他插件项目重复,所以推荐使用com.xxx.xxx的格式 插件不同版本之间不能更改,若没有指定,则与插件名称相同 --> <id>com.example.plugin.myplugin</id> <!-- 插件的描述 --> <description>my plugin description</description> <!-- 插件版本变更信息,支持HTML标签; 将展示在 settings | Plugins 对话框和插件仓库的Web页面 --> <change-notes>Initial release of the plugin.</change-notes> <!-- 插件版本 --> <version>1.0</version> <!-- 供应商主页和email--> <vendor url="http://www.jetbrains.com" email="support@jetbrains.com" /> <!-- 插件所依赖的其他插件的id --> <depends>MyFirstPlugin</depends> <!-- 插件兼容IDEA的最大和最小 build 号,两个属性可以任选一个或者同时使用 官网详细介绍:http://www.jetbrains.org/intellij/sdk/docs/basics/getting_started/build_number_ranges.html--> <idea-version since-build="3000" until-build="3999"/> <!-- application components --> <application-components> <component> <!-- 组件接口 --> <interface-class>com.plugin.demo.Component1Interface</interface-class> <!-- 组件的实现类 --> <implementation-class>com.plugin.demo.impl.Component1Impl</implementation-class> </component> </application-components> <!-- project components --> <project-components> <component> <!-- 接口和实现类相同 --> <interface-class>com.plugin.demo.impl.Component2</interface-class> </component> </project-components> <!-- module components --> <module-components> <component> <interface-class>com.plugin.demo.impl.Component3</interface-class> </component> </module-components> <!-- Actions --> <actions> ... </actions> <!-- 插件定义的扩展点,以供其他插件扩展该插件 --> <extensionPoints> ... </extensionPoints> <!-- 声明该插件对IDEA core或其他插件的扩展 --> <extensions xmlns="com.intellij"> ... </extensions> </idea-plugin> 4、创建 Action Action是实现插件功能的类, 一个Action类需要继承AnAction并且实现actionPerformed方法。当用户点击菜单或者工具栏按钮, 按快捷键,或者通过Help | Find Action点击时, IntelliJ Platform系统会回调对应Action的actionPerformed方法。 一个 Action 表示 IDEA 菜单里的一个 menu item 或工具栏上的一个按钮,通过继承 AnAction class 实现,当选择一个 menu item 或点击工具栏上的按钮时,就会调用 AnAction 类的 actionPerformed 方法。 实现自定义 Action 分两步: 定义一个或多个 action 注册 action,将 item 添加到菜单或工具栏上 4.1、定义 Action 定义一个 Java class,继承 AnAction 类,并重写 actionPerformed 方法, 如 public class ActionDemo extends AnAction { public void actionPerformed(AnActionEvent event) { Project project = event.getData(PlatformDataKeys.PROJECT); Messages.showInputDialog( project, "What is your name?", "Input your name", Messages.getQuestionIcon()); } } 4.2、注册 Action 在 plugin.xml 文件的<actions>元素内注册 <actions> <group id="MyPlugin.SampleMenu" text="Sample Menu" description="Sample menu"> <add-to-group group-id="MainMenu" anchor="last" /> <action id="Myplugin.ActionDemo" class="Mypackage.ActionDemo" text="Text Boxes" description="A test menu item" /> </group> </actions> <action>元素会定义一个 action,指定 action 的 id、实现类、显示文本、描述 <group>元素会定义一个 action group(多个action),设置 action group 的 id、文本、描述 <add-to-group>元素指定其外部 action 或 action group 被添加到的位置 上面示例会定义一个被添加到 IDEA 主菜单的最后面的 “SampleMenu” 的菜单,点击该菜单将弹出一个 “Text Boxes” item,如图 4.3、快速创建 Action IntelliJ Platform 提供了 New Action 向导,它会帮助我们创建 action class 并配置 plugin.xml 文件: 在目标 package 上右键,选择 New | Plugin DevKit | Action: Action ID: action 唯一 id,推荐 format: PluginName.ID Class Name: 要被创建的 action class 名称 Name: menu item 的文本 Description: action 描述,toolbar 上按钮的提示文本,可选 Add to Group:选择新 action 要被添加到的 action group(Groups, Actions)以及相对其他 actions 的位置(Anchor) Keyboard Shortcuts:指定 action 的第一和第二快捷键 注意:该向导只能向主菜单中已存在的 action group 或工具栏上添加 action,若要创建新的 action group,请参考前面的内容。 5、运行调试插件 运行/调试插件可直接在 IntelliJ IDEA 进行,选择 Run | Edit Configurations...,若左侧栏没有 Plugin 类型的 Configuration, 点击右上角 + 按钮,选择 Plugin 类型, 如图 Use classpath of module 选择要调试的 module,其余配置一般默认即可;切换到 Logs 选项卡,如果勾选了 idea.log,运行插件时 idea.log 文件的内容将输出到 idea.log console。 运行插件点击工具栏上运行按钮Run 6、打包安装插件 6.1、打包插件 选择 Build | Prepare Plugin Module ‘module name’ for Deployment 来打包插件: jar类型的插件包: PluginDemo.jar/ com/xxx/... ... ... META-INF/ plugin.xml zip类型的插件包: PluginDemo.zip/ lib/ libxxx.jar libbar.jar PluginDemo.jar/ com/xxx/... ... ... META-INF/ plugin.xml 6.2、安装插件 导航到 File | Settings | Plugins 页面,点击 Install plugin from disk... 选择插件包的位置,点击 OK 在插件列表中,勾选插件名字后面的 check-box 来启用插件,点击 OK 重启 IDEA Install JetBrains plugin... 从 JetBrains 仓库(https://plugins.jetbrains.com/)中安装插件 Browse repositories... 添加并管理自己的仓库 四、Action允许添加的位置 这个时候我们了解的都比较浅显还停留在demo层面,如何进行深入的了解呢? eg:我们怎么知道都有哪些 action 或 action group 可以被我们添加呢? 1.添加主菜单MainMenu 1、我们可以点击配置group-id="MainMenu"下的MainMenu <actions> <group id="MyPlugin.SampleMenu" text="Sample Menu" description="Sample menu"> <add-to-group group-id="MainMenu" anchor="last" /> <action id="Myplugin.Textboxes" class="Mypackage.TextBoxes" text="Text Boxes" description="A test menu item" /> </group> </actions> 2、进入PlatformActions.xml如下图,这个时候不难看出这里就是主菜单的第一列子菜单 3.这个时候如果我们想新建个类似与File-->New和Open的菜单该怎么做呢? 3.1我们应该先实现布局,添加主菜单MainMenu <!-- Actions --> <actions> <group id="MainMenuActionGroup" text="MainMenuActionGroup" description="MainMenuActionGroup" popup="true"> <add-to-group group-id="MainMenu" anchor="after" relative-to-action="HelpMenu"/> <action id="OpenFile" class="com.plugin.demo.action.MainMenuOpenFileAction" text="Open" description="主菜单File下的Open子菜单"/> <separator/> </group> <group id="JavaNewProjectOrModuleGroup" text="一级菜单" popup="true"> <add-to-group group-id="MainMenuActionGroup" anchor="before" relative-to-action="OpenFile"/> <action id="NewProject" class="com.intellij.ide.actions.NewProjectAction"/> <action id="ImportProject" class="com.intellij.ide.actions.ImportProjectAction"/> <action id="ProjectFromVersionControl" class="com.intellij.openapi.wm.impl.welcomeScreen.ProjectFromVersionControlAction"/> <separator/> <action id="NewModule" class="com.intellij.openapi.roots.ui.configuration.actions.NewModuleAction"/> <action id="ImportModule" class="com.intellij.ide.actions.ImportModuleAction"/> </group> </actions> 3.2实现自定义的打开文件 其实是通过下面的action配置的OpenFileAction找到源码 <action id="OpenFile" class="com.intellij.ide.actions.OpenFileAction" icon="AllIcons.Actions.Menu_open"/> 在将源码拷贝出来粘贴到自己的action内。这样就可以实现自己的主菜单File下的Open子菜单 3.3这个时候有人会有疑问我不知道去哪找New对应的action呀? 这个时候我们通过界面可以看到Project from Existing Sources...,这里我们就可以去搜这个文本呀。既然显示在页面上。必然有地方定义了它。 ActionBundle.properties 这个时候我们在根据对应的action定义的文本在去搜索对应的action,com.intellij.ide.actions.ImportProjectAction 3.4这个时候我们将对应的action拷贝到自己的插件定义的配置上也就形成了3.1的一级和二级菜单 2.添加主工具栏MainToolBar 添加主工具栏MainToolBar(如果不清楚哪里是主菜单、主工具栏、导航栏、上下文菜单、弹出菜单参考https://www.w3cschool.cn/intellij_idea_doc/intellij_idea_doc-34852d55.html) <group> <add-to-group group-id="MainToolBar" anchor="before" relative-to-action="SearchEverywhere"/> <reference ref="MainMenuActionGroup"></reference> </group> 3、添加上下文菜单ProjectViewPopupMenu <group> <add-to-group group-id="ProjectViewPopupMenu" anchor="before" relative-to-action="WeighingNewGroup"/> <reference ref="MainMenuActionGroup"></reference> </group> 4、添加弹出菜单EditorPopupMenu <!--添加到弹出框右键--> <group> <add-to-group group-id="EditorPopupMenu" anchor="before" relative-to-action="ShowIntentionsGroup"/> <reference ref="MainMenuActionGroup"></reference> </group> 5、添加打印ConsoleEditorPopupMenu <!--添加到控制台打印右键--> <group> <add-to-group group-id="ConsoleEditorPopupMenu" anchor="before" relative-to-action="CutCopyPasteGroup"/> <reference ref="MainMenuActionGroup"></reference> </group> 6、右键新建action时也可以直接选择添加的位置。 1.筛选后查找要添加的group 2.选择对应的action 3.选择要添加到这个action的某个位置 五、Components(已不建议使用) IntelliJ IDEA 的组件模型是基于 PicoContainer 的,组件都包含在这些容器中,但容器有三种级别:application container,project container 以及 module container。application container 可以包含多个 project container,而 project container 可以包含多个 module container。 1、Components 类型 Components 是插件开发的基础,Components 有三种类型: 2、注册 Components components 需要配置在 plugin.xml 中,并指定 interface 和 implementation,interface 类用于从其他组件中检索组件,implementation 类用于实例化组件。示例: //创建一个 application level component public interface Component1 extends ApplicationComponent { } public class Component1Impl implements Component1 { @Override public String getComponentName() { return "PluginDemo.Component1"; } } plugin.xml <application-components> <component> <interface-class>com.example.test.Component1</interface-class> <implementation-class>com.example.test.Component1Impl</implementation-class> </component> </application-components> 注意:一个 interface-class 不能有多个 implementation-class,如下图: 若组件没有创建 interface 类,而是直接实现了 ApplicationComponent 等接口,interface 和 implementation 可以指定为同一个类。 每一个组件都应该有一个唯一的名字,通过 getComponentName() 返回,推荐使用 <plugin_name>.<component_name> 格式。 3、Component 周期方法 ApplicationComponent 的生命周期方法: //构造方法 public constructor(){ } //初始化 public void initComponent() { } public void disposeComponent() { } ProjectComponent 的生命周期方法: //构造方法 public constructor(){ } //通知一个project已经完成加载 public void projectOpened() { } public void projectClosed() { } //执行初始化操作以及与其他 components 的通信 public void initComponent() { } //释放系统资源或执行其他清理 public void disposeComponent() { } ModuleComponent 的生命周期方法: ModuleComponent 的生命周期方法中比 ProjectComponent 多一个 moduleAdded(),用于通知 module 已经被添加到 project 中。 4、Component 加载 Application 级别的 components 在 IDEA 启动时加载,Project 和 Module 级别的 components 在项目启动时共同加载。 一个组件加载过程: 创建:调用构造方法 初始化:调用 initComponent() 方法 如果是 Project 组件,会调用 projectOpened() 方法; 如果是 Module 组件,会依次调用 moduleAdded() 和 projectOpened() 方法 如果 component 在加载时需要用到其他 component,我们只需在该 component 的构造方法的参数列表声明即可,在这种情况下,IntelliJ IDEA 会按正确的顺序实例化所依赖的 component。 示例: public class MyComponent implements ApplicationComponent { private final MyOtherComponent otherComponent; public MyComponent(MyOtherComponent otherComponent) { this.otherComponent = otherComponent; } ... } 5、Component 卸载 一个组件卸载过程: 如果是 Project 或 Module 组件,调用 projectClosed() 接下来 disposeComponent() 将被调用 6、Component 容器 前面我们提到有三种不同的容器,application container 实现 Application 接口; project container 实现 Project 接口; module container 实现 Module 接口。每一个容器都有自己的方法去获取容器内的 component。 获取 application 容器及其内部的组件: /获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 MyComponent myComponent = application.getComponent(MyComponent.class); 获取 project / module 容器及其内部的组件: 在 component 构造方法的参数列表中声明: public class MyComponent implements ProjectComponent { Project project; public MyComponent(Project project){ this.project = project; } public void initComponent() { OtherComponent otherComponent = project.getComponent(OtherComponent.class); } } 在这个例子中,组件在构造方法中获取了容器对象,将其保存,然后在 component 其他地方进行引用。 7、 各组件使用时机 7.1创建一个ApplicationComponent package com.plugin.demo.component; import com.intellij.openapi.components.ApplicationComponent; //创建一个 application level component public interface ApplicationComponentDemo extends ApplicationComponent { } package com.plugin.demo.component; import com.intellij.openapi.application.Application; import com.intellij.openapi.application.ApplicationManager; public class ApplicationComponentDemoImpl implements ApplicationComponentDemo { @Override public String getComponentName() { System.out.println("ApplicationComponentDemoImpl = " +this.getClass().getName()); return this.getClass().getName(); } //初始化 public void initComponent() { System.out.println("ApplicationComponentDemoImpl initComponent" ); } public void disposeComponent() { //获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 ApplicationComponentDemoImpl myComponent = application.getComponent(ApplicationComponentDemoImpl.class); System.out.println("disposeComponent = " + myComponent.getComponentName()); } } 7.2 创建一个ProjectComponent package com.plugin.demo.component; import com.intellij.openapi.application.Application; import com.intellij.openapi.application.ApplicationManager; import com.intellij.openapi.components.ProjectComponent; import org.jetbrains.annotations.NotNull; public class ProjectComponentDemo implements ProjectComponent { @NotNull @Override public String getComponentName() { //获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 ApplicationComponentDemoImpl myComponent = application.getComponent(ApplicationComponentDemoImpl.class); System.out.println("ProjectComponentDemo = " + myComponent.getComponentName()); return myComponent.getComponentName(); } @Override public void initComponent() { // 获取application容器 Application application = ApplicationManager.getApplication(); // 获取application容器中的组件 ApplicationComponentDemo component = application.getComponent(ApplicationComponentDemo.class); System.out.println("ApplicationComponentDemoImpl initComponent = " + component.getComponentName()); System.out.println("ProjectComponentDemo initComponent"); } @Override public void disposeComponent() { //获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 ApplicationComponentDemoImpl myComponent = application.getComponent(ApplicationComponentDemoImpl.class); System.out.println("disposeComponent = " + myComponent.getComponentName()); } } 7.3创建一个ModuleComponent package com.plugin.demo.component; import com.intellij.openapi.application.Application; import com.intellij.openapi.application.ApplicationManager; import com.intellij.openapi.components.ApplicationComponent; import com.intellij.openapi.module.ModuleComponent; import com.intellij.openapi.project.Project; import com.intellij.openapi.project.ProjectManager; import org.jetbrains.annotations.NotNull; public class ModuleComponentDemo implements ModuleComponent { @NotNull @Override public String getComponentName() { //获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 ApplicationComponentDemoImpl myComponent = application.getComponent(ApplicationComponentDemoImpl.class); System.out.println("ApplicationComponentDemoImpl initComponent = " + myComponent.getComponentName()); ProjectManager projectManager = ProjectManager.getInstance(); Project defaultProject = projectManager.getDefaultProject(); ProjectComponentDemo component = defaultProject.getComponent(ProjectComponentDemo.class); System.out.println("ProjectComponentDemo initComponent" + component.getComponentName()); return myComponent.getComponentName(); } @Override public void initComponent() { System.out.println("ModuleComponentDemo initComponent"); } @Override public void disposeComponent() { //获取application容器 Application application = ApplicationManager.getApplication(); //获取application容器中的组件 ApplicationComponentDemoImpl myComponent = application.getComponent(ApplicationComponentDemoImpl.class); System.out.println("disposeComponent = " + myComponent.getComponentName()); } } 7.4注册配置Component <application-components> <component> <interface-class>com.plugin.demo.component.ApplicationComponentDemo</interface-class> <implementation-class>com.plugin.demo.component.ApplicationComponentDemoImpl</implementation-class> </component> </application-components> <project-components> <component> <interface-class>com.plugin.demo.component.ProjectComponentDemo</interface-class> <implementation-class>com.plugin.demo.component.ProjectComponentDemo</implementation-class> </component> </project-components> <module-components> <component> <interface-class>com.plugin.demo.component.ModuleComponentDemo</interface-class> <implementation-class>com.plugin.demo.component.ModuleComponentDemo</implementation-class> </component> </module-components> 7.5运行后的预期是先执行应用层组件,在执行工程级组件,在执行模块级组件 六、Extensions and Extension Points 如果插件需要扩展 IDEA Platform 或 其他插件的功能,或为其他插件提供可以扩展自己的接口,那么就要用到 extensions 和 extension points,用于与 IDEA 和其他插件交互。 1、Extension points 扩展点 extension point 用于数据信息扩展,使其他插件可以扩展本插件的功能,可通过plugin.xml 的 元素声明,如下示例: <extensionPoints> <!--使用beanClass声明--> <extensionPoint name="MyExtensionPoint1" beanClass="MyPackage.MyBeanClass" area="IDEA_APPLICATION"> <with attribute="implementationClass" implements="MyPackage.MyAbstractClass"/> </extensionPoint> <!--使用interface声明--> <extensionPoint name="MyExtensionPoint2" interface="MyPlugin.MyInterface" area="IDEA_PROJECT" /> </extensionPoints> name 指定 extension point 的名字,当其他插件扩展该extensionPoint时,需要指定该name area 有三种值,IDEAAPPLICATION,IDEAPROJECT,IDEA_MODULE,指定extension point的级别 interface 指定需要扩展此 extension point 的插件必须要实现的接口 beanClass 指定一个类,该类有一个或多个被 @Attribute 注解的属性 声明 extension point 有两种方式,指定 beanClass 或 interface 如果某个属性需要是某个类的子类,或某个接口的实现类,需要通过 指明类名或接口名。 示例上述代码中的 MyExtensionPoint1 的 beanClass: public class MyBeanClass extends AbstractExtensionPointBean { @Attribute("key") public String key; @Attribute("implementationClass") public String implementationClass; ... } 2、Extension 扩展其他插件功能 如果插件需要扩展 IntelliJ Platform 或其他插件的功能,需要声明一个或多个 extension。 设置 的 defaultExtensionNs 属性若是扩展 IntelliJ Platform,设为 com.intellij若是扩展其他插件,则设为 pluginId 指定要扩展哪个 extension point内部的子标签的名字必须与 extension point 的 name 属性相同 如果 extension point 是通过 interface 声明的,那么使用 implementation 属性指明 interface 的实现类 是通过 beanClass 声明的,那么就要为 beanClass 中被 @Attribute 注解的属性指定属性值 示例: <!-- 扩展 interface 声明的 extensionPoint --> <extensions defaultExtensionNs="com.intellij"> <appStarter implementation="MyPackage.MyExtension1" /> <applicationConfigurable implementation="MyPackage.MyExtension2" /> </extensions> <!-- 扩展 beanClass 声明的 extensionPoint --> <extensions defaultExtensionNs="pluginId"> <MyExtensionPoint1 key="keyValue" implementationClass="MyPackage.MyClassImpl"></MyExtensionPoint1> </extensions> 插件的 service 的实现就是扩展 IDEA Platform 的 applicationService 或 projectService 两个 extension points 3、获取 extension points IntelliJ Platform 的部分 extension points <extensionPoints> <extensionPoint name="languageBundle" beanClass="com.intellij.DynamicBundle$LanguageBundleEP"/> <!--suppress PluginXmlValidity --> <extensionPoint name="applicationService" beanClass="com.intellij.openapi.components.ServiceDescriptor" dynamic="true"/> <!--suppress PluginXmlValidity --> <extensionPoint name="projectService" beanClass="com.intellij.openapi.components.ServiceDescriptor" dynamic="true"/> <!--suppress PluginXmlValidity --> <extensionPoint name="moduleService" beanClass="com.intellij.openapi.components.ServiceDescriptor" dynamic="true"/> <extensionPoint name="virtualFileManagerListener" interface="com.intellij.openapi.vfs.VirtualFileManagerListener" dynamic="true"/> <extensionPoint name="vfs.asyncListener" interface="com.intellij.openapi.vfs.AsyncFileListener" dynamic="true"/> <!-- only bundled plugin can define startupActivity --> <extensionPoint name="startupActivity" interface="com.intellij.openapi.startup.StartupActivity"/> <extensionPoint name="postStartupActivity" interface="com.intellij.openapi.startup.StartupActivity" dynamic="true"/> <extensionPoint name="backgroundPostStartupActivity" interface="com.intellij.openapi.startup.StartupActivity" dynamic="true"/> <extensionPoint name="fileTypeDetector" interface="com.intellij.openapi.fileTypes.FileTypeRegistry$FileTypeDetector" dynamic="true"/> <extensionPoint name="editorFactoryDocumentListener" interface="com.intellij.openapi.editor.event.DocumentListener" dynamic="true"/> <extensionPoint name="multiHostInjector" interface="com.intellij.lang.injection.MultiHostInjector" area="IDEA_PROJECT" dynamic="true"/> <extensionPoint name="writingAccessProvider" area="IDEA_PROJECT" interface="com.intellij.openapi.vfs.WritingAccessProvider" dynamic="true"/> <extensionPoint name="metaLanguage" interface="com.intellij.lang.MetaLanguage"/> <extensionPoint name="lang.parserDefinition" beanClass="com.intellij.lang.LanguageExtensionPoint" dynamic="true"> <with attribute="implementationClass" implements="com.intellij.lang.ParserDefinition"/> </extensionPoint> <extensionPoint name="lang.elementManipulator" beanClass="com.intellij.openapi.util.ClassExtensionPoint" dynamic="true"> <with attribute="implementationClass" implements="com.intellij.psi.ElementManipulator"/> </extensionPoint> <!--suppress PluginXmlValidity --> <extensionPoint name="stubElementTypeHolder" beanClass="com.intellij.psi.stubs.StubElementTypeHolderEP" dynamic="true"/> </extensionPoints> <extensions defaultExtensionNs="com.intellij"> <applicationService serviceInterface="com.intellij.util.messages.MessageBusFactory" serviceImplementation="com.intellij.util.messages.impl.MessageBusFactoryImpl"/> </extensions> 其他可以从被扩展插件的 plugin.xml 文件中获取https://plugins.jetbrains.com/intellij-platform-explorer/extensions 七、Service 参考:https://plugins.jetbrains.com/docs/intellij/plugin-services.html#examples Service 也是一种按需加载的 component,在调用 ServiceManager.getService(Class)时才会加载,且程序中只有一个实例。 Service是插件的一个组件, 是为了把公共的逻辑放到一起,Service的实例是单例的。 Serivce 在 IntelliJ IDEA 中是以 extension point 形式提供的,实现自己的 service 需要扩展相应 extension point。 applicationService: application level service projectService: project level service moduleService: module level service 声明 service 时必须包含 serviceImplementation 属性用于实例化 service, serviceInterface 属性是可选的,可用于获取 service 实例。 1、创建 Service 在需要放置 service 的 package 上右键, New | Plugin DevKit | xxxxService,如图 选择相应 service,弹出如下对话框,填写 interface 类和 implementation 类,若不勾选 Separate interface from implementation,只需填写 implementation 类。 IntelliJ IDEA 会自动创建相应类并配置 plugin.xml 文件。 示例:plugin.xml: <extensions defaultExtensionNs="com.intellij"> <applicationService serviceInterface="com.plugin.demo.service.ApplicationServiceDemo" serviceImplementation="com.plugin.demo.service.impl.ApplicationServiceDemoImpl"/> <projectService serviceInterface="com.plugin.demo.service.ProjectServiceDemo" serviceImplementation="com.plugin.demo.service.impl.ProjectServiceDemoImpl"/> <moduleService serviceInterface="com.plugin.demo.service.ModuleServiceDemo" serviceImplementation="com.plugin.demo.service.impl.ModuleServiceDemoImpl"/> </extensions> 生成的 service 类: public interface ApplicationServiceDemo { static ApplicationServiceDemo getInstance() { return ServiceManager.getService(ApplicationServiceDemo.class); } } public interface ProjectServiceDemo { static ProjectServiceDemo getInstance(@NotNull Project project) { return ServiceManager.getService(project, ProjectServiceDemo.class); } } public interface ModuleServiceDemo { static ModuleServiceDemo getInstance(@NotNull Module module) { return module.getService(ModuleServiceDemo.class); } } public class ApplicationServiceDemoImpl implements ApplicationServiceDemo { public ApplicationServiceDemoImpl() { System.out.println("ApplicationServiceDemoImpl = "); } } public class ProjectServiceDemoImpl implements ProjectServiceDemo { public ProjectServiceDemoImpl(Project project) { System.out.println("ProjectServiceDemoImpl = " + project); } } public class ModuleServiceDemoImpl implements ModuleServiceDemo { public ModuleServiceDemoImpl(Module project) { System.out.println("ModuleServiceDemoImpl = " + project); } } 2、获取 Service MyApplicationService applicationService = ServiceManager.getService(MyApplicationService.class); //获取 project 级别的 service,需要提供 project 对象 MyProjectService projectService = ServiceManager.getService(project, MyProjectService.class); //获取 module 级别的 service,需要提供 module 对象 MyModuleService moduleService = ModuleServiceManager.getService(module, MyModuleService.class); 八、持久化状态 我们在使用 IDE 开始开发工作之前,总是要先在 settings 页面进行一些设置,且每次重新打开 IDE 后这些设置仍然保留着,那么这些设置是如何保存下来的呢? IntelliJ Platform 提供了一些 API,可以使 components 或 services 在每次打开 IDE 时仍然使用之前的数据,即持久化其状态。 1、PropertiesComponent 对于一些简单少量的值,我们可以使用 PropertiesComponent,它可以保存 application 级别和 project 级别的值。 下面方法用于获取 PropertiesComponent 对象: //获取 application 级别的 PropertiesComponent PropertiesComponent.getInstance() //获取 project 级别的 PropertiesComponent,指定相应的 project PropertiesComponent.getInstance(Project) propertiesComponent.setValue(name, value) propertiesComponent.getValue(name) PropertiesComponent 保存的是键值对,由于所有插件使用的是同一个 namespace,强烈建议使用前缀来命名 name,比如使用 plugin id。 2、PersistentStateComponent PersistentStateComponent 用于持久化比较复杂的 components 或 services,可以指定需要持久化的值、值的格式以及存储位置。 要使用 PersistentStateComponent 持久化状态: 需要提供一个 PersistentStateComponent 接口的实现类(component 或 service),指定类型参数,重写 getState() 和 loadState() 方法 类型参数就是要被持久化的类,它可以是一个 bean class,也可以是 PersistentStateComponent实现类本身。 在 PersistentStateComponent 的实现类上,通过 @com.intellij.openapi.components.State 注解指定存储的位置 下面通过两个例子进行说明: class MyService implements PersistentStateComponent<MyService.State> { //这里 state 是一个 bean class static class State { public String value; ... } //用于保存当前的状态 State myState; // 从当前对象里获取状态 public State getState() { return myState; } // 从外部加载状态,设置给当前对象的相应字段 public void loadState(State state) { myState = state; } } // 这里的 state 就是实现类本身 class MyService implements PersistentStateComponent<MyService> { public String stateValue; ... public MyService getState() { return this; } public void loadState(MyService state) { XmlSerializerUtil.copyBean(state, this); } } 2.1、实现 State 类 a、字段要求 state 类中可能有多个字段,但不是所有字段都可以被持久化,可以被持久化的字段: public 字段 bean 属性:提供 getter 和 setter 方法 被注解的私有字段:使用 @Tag, @Attribute, @Property, @MapAnnotation, @AbstractCollection 等注解来自定义存储格式,一般在实现向后兼容时才考虑使用这些注解 这些字段也有类型要求: 数字(包括基础类型,如int,和封装类型,如Integer) 布尔值 字符串 集合 map 枚举 如果不希望某个字段被持久化,可以使用 @com.intellij.util.xmlb.annotations.Transient 注解。 b、构造器要求 state 类必须有一个默认构造器,这个构造器返回的 state 对象被认为是默认状态,只有当当前状态与默认状态不同时,状态才会被持久化。 2.2、定义存储位置 我们可以使用 @State 注解来定义存储位置 @State(name = "PersistentDemo", storages = {@Storage(value = "PluginDemo.xml")}) public class PersistentDemo implements PersistentStateComponent<PersistentDemo> { ... } name: 定义 xml 文件根标签的名称 storages: 一个或多个 @Storage,定义存储的位置 若是 application 级别的组件运行调试时 xml 文件的位置: ~/IdeaICxxxx/system/plugins-sandbox/config/options正式环境时 xml 文件的位置: ~/IdeaICxxxx/config/options 若是 project 级别的组件,默认为项目的 .idea/misc.xml,若指定为 StoragePathMacros.WORKSPACE_FILE,则会被保存在 .idea/worksapce.xml 2.3、生命周期 loadState() 当组件被创建或 xml 文件被外部改变(比如被版本控制系统更新)时被调用 getState() 当 settings 被保存(比如settings窗口失去焦点,关闭IDE)时,该方法会被调用并保存状态值。如果 getState() 返回的状态与默认状态相同,那么什么都不会被保存。 noStateLoaded() 该方法不是必须实现的,当初始化组件,但是没有状态被持久化时会被调用 2.4、组件声明 持久化组件可以声明为 component,也可以声明为 service 声明为 service,plugin.xml 文件如下配置: <extensions defaultExtensionNs="com.intellij"> <applicationService serviceImplementation="com.example.test.persisting.PersistentDemo"/> <projectService serviceImplementation="com.example.test.persisting.PersistentDemo2"/> </extensions> 代码中获取状态与获取 service 的方式一样: PersistentDemo persistDemo = ServiceManager.getService(PersistentDemo.class); PersistentDemo2 persistDemo2 = ServiceManager.getService(project,PersistentDemo.class); 声明为 component,plugin.xml 文件如下配置: <application-components> <!--将持久化组件声明为component--> <component> <implementation-class>com.example.persistentdemo.PersistentComponent</implementation-class> </component> </application-components> 获取状态与获取 component 的方式一样: public static PersistentComponent getInstance() { return ApplicationManager.getApplication().getComponent(PersistentComponent.class); } public static PersistentComponent getInstance(Project project) { return project.getComponent(PersistentComponent.class); } 九、插件依赖 开发插件时可能会用到其他插件,可能是 IDEA 绑定的,也可能是第三方的插件。 配置插件依赖需要将插件包添加到 SDK 的 classpath 中,并在 plugin.xml 配置。 确定插件包的位置如果插件是 IDEA 捆绑的插件,那么插件包在 IDEA 安装目录的 plugins/ 或 plugins//lib 下。如果插件是第三方或自己的,那么需要先运行一次 sandbox(其实我们在运行调试插件的时候就是在运行sandbox)并从本地或插件仓库安装依赖插件。安装好后,插件包会放在 sandbox 目录下的 config/plugins/ 或 config/plugins//lib,查看 sandbox 目录:打开 IntelliJ Platform SDK 配置页面,其中 Sandbox Home 就是其目录。 将插件包添加到 SDK 的 classpath 中导航到 File | Project Structure | SDKs,选择插件使用的 IntelliJ Platform SDK,点击右侧 + 号,在弹出的文件选择框中选择要依赖的插件包,点击 OK。 配置 plugin.xml在 plugin.xml 的 部分添加所依赖插件的id。 org.jetbrains.kotlin plugin id 可以从插件包的 plugin.xml 文件查看。 十、GUI 介绍 GUI 是 IntelliJ IDEA 提供的一个自动生成 java 布局代码的工具,它使用 JDK 中的 Swing 控件来实现 UI 界面。 使用步骤: 1.配置 配置 GUI首先打开 Settings 对话框,选择 Editor | GUI Designer,如图,在 Generate GUI into: 有两个选项,生成 class 文件或 java 代码,我们选择生成 java 代码,因为建好布局后可能需要修改代码。其他默认即可。 2.创建 form 创建 form 文件form 文件用于记录界面布局。在相应的 package 上右键,选择 New | GUI Form,如图,输入 form 文件名,一般与 java 文件名相同,点击 OK 创建 form 与 java 文件。 3.面板介绍 编辑界面打开 form 文件,如图,通过拖拽控件来搭建布局。每个form文件布局的 root 控件都是一个 JPanel,可将该 root 对象传给需要该布局的类。注意:左下角的属性面板,只有当填写了 field name 属性时该控件的对象才会被当成成员变量,否则为局部变量。 4.构建 生成 java 代码搭建好布局后,点击 build 编译按钮,即可生成 java 的源码文件。 GUI 生成的方法名前后都有三个 $ 标识,当再次修改布局时,GUI 只会修改 $ 标识的方法。 十一、源码分析SmartConverter SmartConverter -- POJO Object Converter 项目地址:https://github.com/zitiger/smartconverter 1、项目背景 在分层开发中,我们总是面临着各种POJO(DTO,DO,JO,VO)对象之间的相互转换。当对象比较复杂时,编写转换代码耗时较多,且非常容易出错。以至于可能会出现写一天代码,半天在写各种convert的囧境。 为了实现自动转换,出现了BeanUtil和ModelMapper等解决方案。这些方案,在少量对象转换时,性能损耗可以忽略,但是当转换数量达到一定量级时,这种损耗会对性能产生影响。 本插件可以自动生成POJO之间的转换代码,省去手工转换的麻烦,也不会损失性能。 2、安装 下载SmartConverter.zip,并在Intellij Idea中安装; 3、四个转换函数 把光标放到函数中,不能是函数内. 光标移动到函数体内,按下⌘+N,在弹出的Generate菜单中选择Smart Converter; 插件自动生成一下四个转换函数 A -> B B -> A List-> List List**-> List** 4、单个抓换函数 在编辑器中,确定返回值和参数,完成空转换函数; public static List<UserJO> toDTOList(List<UserDTO> userDTOList) { } 光标移动到函数体内,按下⌘+N,在弹出的Generate菜单中选择Smart Converter; 插件根据入参和出参推断出需要转换的POJO。 5、插件特色 插件自动从转换函数的参数和返回值推断出转换POJO; 支持List之间的转换。 如果存在单个转换的函数,则直接使用 如果不存在单个转换的函数,创建单个转换函数 支持嵌套转换 6、源码解读 6.1.如何将ConvertGeneratorAction 添加到菜单 因为使用SmartConvert是使用alt+insert弹出或者右键点击Generate显示SmartConvertAction,所以根据前文的添加位置不难推断添加在弹出菜单EditorPopupMenu下,这个时候我们可以从两个方向找他添加的位置。 首先从项目的配置文件进入找到plugin.xml下配置的action。由此不难看出它实际是添加在了GenerateGroup这个组上的 <actions> <group id="com.zitiger.plugin.converter.generate.group" popup="true"> <separator/> <!-- Add your actions here --> <action id="com.zitiger.plugin.converter.action.generator" class="com.zitiger.plugin.converter.action.ConvertGeneratorAction" text="Smart Converter" description="Smart Converter"> <keyboard-shortcut keymap="$default" first-keystroke="shift meta N"/> </action> <add-to-group group-id="GenerateGroup" anchor="last"/> </group> </actions> 这个时候我们不难看出并没有地方引用这个组,这个时候我们不防从使用的地方入手,我们是右键点击Generate或者alt+insert弹出的EditorLangPopupMenu下的Generate的组。这个时候我们去全局搜索EditorPopupMenu 发现这里有一个添加到右键菜单下的 <group id="EditorLangPopupMenu"> <separator/> <group id="EditorPopupMenu.GoTo" popup="true"> <reference ref="ShowNavBar"/> <reference ref="GotoDeclaration"/> <reference ref="GotoImplementation"/> <reference ref="GotoTypeDeclaration"/> <reference ref="GotoSuperMethod"/> <reference ref="GotoTest"/> </group> <reference ref="Generate"/> <separator/> <group id="EditorPopupMenu.Run"> <reference ref="RunContextPopupGroup"/> </group> <separator/> <reference ref="VersionControlsGroup"/> <separator/> <reference ref="ExternalToolsGroup"/> <add-to-group group-id="EditorPopupMenu" relative-to-action="CompareClipboardWithSelection" anchor="before"/> </group> 点击后跳转的是 <action id="Generate" class="com.intellij.codeInsight.generation.actions.GenerateAction"/> GenerateAction的点击方法actionPerformed内动态生成了ActionGroup JBPopupFactory.getInstance().createActionGroupPopup(CodeInsightBundle.message("generate.list.popup.title"), wrapGroup(getGroup(),dataContext,project),dataContext,JBPopupFactory.ActionSelectionAid.SPEEDSEARCH, false); 而getGroup() 通过指定groupid 获取到GenerateGroup的Action组 return (DefaultActionGroup)ActionManager.getInstance().getAction(IdeActions.GROUP_GENERATE); 6.2.如何实现实体~~~~转换 2.1Program Structure Interface (PSI) https://plugins.jetbrains.com/docs/intellij/psi-files.html 程序结构接口,通常简称为 PSI,负责解析文件并创建语法和语义代码模型,为平台的众多功能提供支持。 PSI文件是结构的根,将文件内容表示为特定编程语言中元素的层次结构 PsiFile是所有 PSI 文件的公共基类,而特定语言的文件通常由其子类表示。例如PsiJavaFile类代表一个Java文件,类XmlFile代表一个XML文件。 2.2查看某一个文件的PSI结构 参考文档:PSI Viewer https://www.jetbrains.com/help/idea/psi-viewer.html?_ga=2.203993552.1175576577.1685324427-1690948556.1684890471&_gl=1y6ns8zgaMTY5MDk0ODU1Ni4xNjg0ODkwNDcxga_9J976DJZ68*MTY4NTQxNDQzMS4xOS4xLjE2ODU0MTU2NTguMC4wLjA. 未配置开启查看PIS结构时如下图 开启查看PIS结构 找到idea安装路径下的bin目录下的idea.properties配置如下 idea.is.internal=true 开启后显示了View PSI Structure 和View PSI Structure of Current File 进入要查看结构的文件后点击View PSI Structure of Current File 查看某一个文件的psi结构 2.3查看插件源码 进入ConvertGeneratorAction的点击事件方法不难看到如下的根据PSI获取当前类和方法的代码 2.4继续跟踪生成方法转换代码 这里主要是根据返回类型获取到了一个MethodGenerator并执行对应的generateCode方法 2.5MethodGenerator下的generateCode MethodGenerator下的generateCode主要获取了当前方法的入参fromClass与toClass,并进行了字符串的组装和生成代码块。 PsiCodeBlock codeBlock = elementFactory. createCodeBlockFromText("{" + String.join("\n", statementList) + "}", psiClass); 源码分析就到这里,如果有兴趣的同学可以自行深入分析并欢迎补充。 十二、武魂融合 1.定位 想编写一个什么样的插件(功能) 插件要实现的能力是什么,eg:进行方法入参快速转为出参、获取选择的文本添加为笔记、idea激活弹出框、数据库Database...等。 2.拆解 实现插件需要具备哪些能力(功能拆解) 需要页面操作交互能力(java swing) 需要发送http请求能力(添加依赖的能力) 需要添加action的能力(插件需要放在哪里,插件的生命周期是什么等级的等。) 需要读写文件的能里(new BufferedWriter(new OutputStreamWriter(new FileOutputStream(file),"utf-8"));) 3.落地 3.1添加一个Action到右键EditorPopupMenu 创建一个action并继承AnAction package com.test.action; import com.intellij.openapi.actionSystem.AnAction; import com.intellij.openapi.actionSystem.AnActionEvent; public class testAction extends AnAction { @Override public void actionPerformed(AnActionEvent e) { // TODO: insert action logic here System.out.println("action点击触发方法 = " + e); } } <actions> <!-- Add your actions here --> <action id="testAction" class="com.test.action.testAction" text="testAction" description="testAction"> <add-to-group group-id="EditorPopupMenu" anchor="before" relative-to-action="ShowIntentionsGroup"/> </action> </actions> 3.2发起网络请求获取数据 添加spring相关依赖到gradle dependencies { testCompile group: 'junit', name: 'junit', version: '4.12' // https://mvnrepository.com/artifact/org.springframework/spring-web implementation 'org.springframework:spring-web:5.1.13.RELEASE' // https://mvnrepository.com/artifact/org.springframework/spring-core implementation 'org.springframework:spring-core:5.1.13.RELEASE' // https://mvnrepository.com/artifact/org.springframework/spring-beans implementation 'org.springframework:spring-beans:5.1.13.RELEASE' } 使用spring-web下的RestTemplate创建网络请求工具(也可以直接使用RestTemplate) package com.test.http; import org.springframework.http.HttpStatus; import org.springframework.http.ResponseEntity; import org.springframework.web.client.RestTemplate; public class HttpUtil { public static ResponseEntity<Map> get(String url){ RestTemplate restTemplate = new RestTemplate(); try { ResponseEntity<Map> forEntity = new RestTemplate().getForEntity(url, Map.class); return forEntity; } catch (Exception e) { e.printStackTrace(); return null; } } } 在需的地方触发网络请求获取数据 public class testAction extends AnAction { @Override public void actionPerformed(AnActionEvent e) { // TODO: insert action logic here System.out.println("action点击触发方法 = " + e); ResponseEntity<Map> mapResponseEntity = HttpUtil.get("http://localhost:22200/getPerson"); System.out.println("action点击触发网络请求 = " + mapResponseEntity.toString()); } } 触发验证 3.3回显到idea界面 首先创建一个回显显示的界面 package com.test.view; import com.intellij.openapi.ui.DialogWrapper; import org.jetbrains.annotations.Nullable; import javax.swing.*; import java.awt.*; public class testDialog extends DialogWrapper { JLabel label; public testDialog(boolean canBeParent) { super(canBeParent); init();//初始化dialog setTitle("标题"); } @Override protected @Nullable JComponent createCenterPanel() { /*创建一个面板,设置其布局为边界布局*/ JPanel centerPanel = new JPanel(new BorderLayout()); /*创建一个文字标签,来承载内容*/ String text = "aaa11111测试回显内容"; label = new JLabel(text); /* 设置首先大小*/ label.setPreferredSize(new Dimension(100, 100)); /*将文字标签添加的面板的正中间*/ centerPanel.add(label, BorderLayout.CENTER); return centerPanel; } public void setLabelText(String text) { label.setText(text); } } 在action内触发请求网络获取内容并设置到显示的面板上。 public class testAction extends AnAction { @Override public void actionPerformed(AnActionEvent e) { // TODO: insert action logic here System.out.println("action点击触发方法 = " + e); ResponseEntity<Map> mapResponseEntity = HttpUtil.get("http://localhost:22200/getPerson"); System.out.println("action点击触发网络请求 = " + mapResponseEntity.getBody()); testDialog testDialog=new testDialog(true); testDialog.setLabelText(mapResponseEntity.getBody().toString()); testDialog.show(); } } 3.4乱码处理 像上图的标题等直接赋值汉字时会有乱码,重新编码进行处理(这种方式简单的汉字和汉字较少时可以) String encodeTitle = new String("标题".getBytes("gbk"), "UTF-8"); title = new EditorTextField(encodeTitle); 3.5获取选中的内容并回显 我们从action中获取editor对象,在通过editor获取SelectionModel,在获取选中的文本。 弹窗提供一个重新设置选择文本的方法 testDialog.setContent(selectedText); @Override public void actionPerformed(AnActionEvent e) { // TODO: insert action logic here testDialog testDialog = new testDialog(true); //获取当前编辑器对象 Editor editor = e.getRequiredData(CommonDataKeys.EDITOR); //获取选择的数据模型 SelectionModel selectionModel = editor.getSelectionModel(); //获取当前选择的文本 String selectedText = selectionModel.getSelectedText(); System.out.println(selectedText); testDialog.setContent(selectedText); testDialog.show(); } 测试选中内容和回显内容如下图 3.6按钮响应 @Override protected JComponent createSouthPanel() { JPanel panel = new JPanel(new FlowLayout()); try { String encodeTitle = new String("标题".getBytes("gbk"), "UTF-8"); JLabel title = new JLabel(encodeTitle); String encodeBtnAdd = new String("按钮点击".getBytes("gbk"), "UTF-8"); JButton btnAdd = new JButton(encodeBtnAdd); //按钮点击事件处理 btnAdd.addActionListener(e -> { //获取标题 String titleStr = title.getText(); //获取内容 String contentStr = content.getText(); System.out.println("titleStr" + ":" + titleStr); System.out.println("contentStr" + ":" + contentStr); label.setText(getHttpText()); }); panel.add(title, BorderLayout.NORTH); /* 设置首先大小*/ btnAdd.setPreferredSize(new Dimension(200, 100)); panel.add(btnAdd, BorderLayout.CENTER); } catch (UnsupportedEncodingException e) { e.printStackTrace(); } return panel; } private String getHttpText() { ResponseEntity<Map> mapResponseEntity = HttpUtil.get("http://localhost:22200/getPerson"); return mapResponseEntity.toString(); } 如图所示点击按钮访问本地http服务获取数据后回显 3.7获取控件内数据 3.8保存数据到文件 可以使用java本身的流进行读写,也可以使用模板引擎进行,这里使用freemarker模版引擎 3.8.1获取按钮点击事件后弹出目录选择框选择要保存的文件夹,首先需要改造弹窗的构造器传入当前action的事件Event,从event获取当前的工程 3.8.2按钮点击事件创建文件选择器 有人会有疑问,为什么这样就弹出了文件选择器,其实最后是一个FileChooser->FileChooserDialog final FileChooserDialog chooser = FileChooserFactory.getInstance().createFileChooser(descriptor, project, parent); return chooser.choose(project, toSelect); 3.8.3引入freemarker模版引擎依赖并进行文件创建保存 组织数据、获取模版、创建文件、执行创建文件 模版代码创建并获取上图中的组织数据model下的内容 ​​​​​​​ 3.9通知(当有错误或成功是弹出通知事件--IDEA的Event Log) NotificationGroup notificationGroup = new NotificationGroup("testId", NotificationDisplayType.BALLOON, true); /** * content : 通知内容 * type :通知的类型,warning,info,error */ Notification notification = notificationGroup.createNotification("测试通知保存成功", MessageType.INFO); Notifications.Bus.notify(notification); 3.10扩展某一个扩展点 添加一个自定义ToolWindow 3.10.1创建一个toolwindow package com.test.view; import com.intellij.openapi.wm.ToolWindow; import javax.swing.*; import java.text.SimpleDateFormat; import java.util.Date; public class MyToolWindow { private JButton hideButton; private JLabel datetimeLabel; private JPanel myToolWindowContent; public MyToolWindow(ToolWindow toolWindow) { init(); hideButton.addActionListener(e -> toolWindow.hide(null)); } private void init() { datetimeLabel = new JLabel(); datetimeLabel.setText(new SimpleDateFormat("yyyy-MM-dd HH:mm:ss").format(new Date())); hideButton = new JButton("取消"); myToolWindowContent = new JPanel(); myToolWindowContent.add(datetimeLabel); myToolWindowContent.add(hideButton); } public JPanel getContent() { return myToolWindowContent; } } 3.10.2创建ToolWindowFactory的实现类 package com.test.view; import com.intellij.openapi.project.Project; import com.intellij.openapi.wm.ToolWindow; import com.intellij.openapi.wm.ToolWindowFactory; import com.intellij.ui.content.Content; import com.intellij.ui.content.ContentFactory; import org.jetbrains.annotations.NotNull; public class toolWindowExt implements ToolWindowFactory { @Override public void createToolWindowContent(@NotNull Project project, @NotNull ToolWindow toolWindow) { MyToolWindow myToolWindow = new MyToolWindow(toolWindow); //获取内容工厂的实例 ContentFactory contentFactory = ContentFactory.SERVICE.getInstance(); //获取用于toolWindow显示的内容 Content content = contentFactory.createContent(myToolWindow.getContent(), "自定义tool window", false); //给toolWindow设置内容 toolWindow.getContentManager().addContent(content); } } 3.10.3声明扩展点对应的扩展 <extensions defaultExtensionNs="com.intellij"> <!-- Add your extensions here --> <toolWindow id="添加toolWindow" secondary="false" anchor="right" factoryClass="com.test.view.toolWindowExt"> </toolWindow> </extensions> 十三、参考文档: idea插件官方文档:https://plugins.jetbrains.com/docs/intellij/welcome.html gradle官方文档:https://docs.gradle.org/current/userguide/userguide.html freemarker:https://freemarker.apache.org/docs/ 京东技术:https://cloud.tencent.com/developer/article/1348741 javaSwing:https://docs.oracle.com/javase/tutorial/uiswing/components/jcomponent.html sdk-code-samples:https://github.com/JetBrains/intellij-sdk-code-samples 十四、其他插件文档传送门 idea插件开发经验总结(一):环境搭建 IDEA插件开发简明教程 【IDEA插件开发】快速入门系列01 开发一个简单的Idea插件 IDEA Plugin 插件怎么开发? 作者:京东健康 马仁喜 来源:京东云开发者社区

优秀的个人博客,低调大师

Spring源码核心剖析 | 京东云技术团队

前言 SpringAOP作为Spring最核心的能力之一,其重要性不言而喻。然后需要知道的是AOP并不只是Spring特有的功能,而是一种思想,一种通用的功能。而SpringAOP只是在AOP的基础上将能力集成到SpringIOC中,使其作为bean的一种,从而我们能够很方便的进行使用。 一、SpringAOP的使用方式 1.1 使用场景 当我们在日常业务开发中,例如有些功能模块是通用的(日志、权限等),或者我们需要在某些功能前后去做一些增强,例如在某些方法执行后发送一条mq消息等。 如果我们将这些通用模块代码与业务代码放在一块,那么每个业务代码都要写这些通用模块,维护成本与耦合情况都十分严重。 因此,我们可以将此模块抽象出来,就有了”切面“的概念。 1.2 常用方式 AOP的使用方式相对比较简单,首先我们需要完成业务代码 @Service public class AopDemo implements AopInterface{ public Student start(String name) { System.out.println("执行业务逻辑代码....."); return new Student(name); } } 业务逻辑比较简单,接收一个name参数。 接下来我们需要创建其对应的切面 //将该切面加入spring容器 @Service //声明该类为一个切面 @Aspect class AopAspect { //声明要进行代理的方法 @Pointcut("execution(* com.example.demo.aop.AopInterface.start(..))") public void startAspect() { } //在方法执行之前的逻辑 @Before(value = "startAspect()") public void beforeAspect() { System.out.println("业务逻辑前代码....."); } //在方法执行之后的逻辑 @After(value = "startAspect()") public void afterAspect() { System.out.println("业务逻辑后代码....."); } //围绕方法前后的逻辑 @Around("startAspect()") public Object aroundAspect(ProceedingJoinPoint point) throws Throwable { Object[] requestParams = point.getArgs(); String name = requestParams[0].toString(); System.out.println("传入参数:" + name); requestParams[0] = "bob"; return point.proceed(requestParams); } } 可以看到,首先需要我们指明要代理的对象及方法,然后根据需要选择不同的注解即可实现代理对象。 传入参数:tom 业务逻辑前代码..... 执行业务逻辑代码..... 业务逻辑后代码..... 二、SpringAOP源码解析 2.1 被代理对象的开始initializeBean 根据上面的使用情况,我们知道只需要声明对应的注解即可,不需要其他额外的配置,然后我们获得的bean对象就已经是被代理的了,那么我们可以推断代理对象的过程一定是发生在bean创建的过程的。 我们回顾一下创建bean的流程 实例化bean 装配属性 初始化bean 只有第三步初始化bean的时候才会有机会进行代理。 找到对应的代码位置: protected Object initializeBean(String beanName, Object bean, @Nullable RootBeanDefinition mbd) { Object wrappedBean = bean; if (mbd == null || !mbd.isSynthetic()) { //前置处理器 wrappedBean = applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName); } //... try { //对象的初始化方法 invokeInitMethods(beanName, wrappedBean, mbd); } if (mbd == null || !mbd.isSynthetic()) { //后置处理器,AOP开始的地方 wrappedBean = applyBeanPostProcessorsAfterInitialization(wrappedBean, beanName); } return wrappedBean; } 2.2 后置处理器applyBeanPostProcessorsAfterInitialization 后置处理器会执行那些实现了后置处理器接口的代码: public Object applyBeanPostProcessorsAfterInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; //获取所有的后置处理器 for (BeanPostProcessor processor : getBeanPostProcessors()) { //实现其要执行的方法 Object current = processor.postProcessAfterInitialization(result, beanName); if (current == null) { return result; } result = current; } return result; } 而AOP的后置处理器就是其中的一个: AbstractAutoProxyCreator 其对应的方法为(以下代码不为同一个类,而是对应的执行顺序): public Object postProcessAfterInitialization(@Nullable Object bean, String beanName) { if (bean != null) { Object cacheKey = getCacheKey(bean.getClass(), beanName); if (this.earlyProxyReferences.remove(cacheKey) != bean) { //执行到下面方法 return wrapIfNecessary(bean, beanName, cacheKey); } } return bean; } protected Object wrapIfNecessary(Object bean, String beanName, Object cacheKey) { // Create proxy if we have advice. Object[] specificInterceptors = getAdvicesAndAdvisorsForBean(bean.getClass(), beanName, null); if (specificInterceptors != DO_NOT_PROXY) { this.advisedBeans.put(cacheKey, Boolean.TRUE); //创建代理对象 Object proxy = createProxy( bean.getClass(), beanName, specificInterceptors, new SingletonTargetSource(bean)); this.proxyTypes.put(cacheKey, proxy.getClass()); return proxy; } this.advisedBeans.put(cacheKey, Boolean.FALSE); return bean; } protected Object createProxy(Class beanClass, @Nullable String beanName, @Nullable Object[] specificInterceptors, TargetSource targetSource) { //获取advisors Advisor[] advisors = buildAdvisors(beanName, specificInterceptors); proxyFactory.addAdvisors(advisors); proxyFactory.setTargetSource(targetSource); customizeProxyFactory(proxyFactory); proxyFactory.setFrozen(this.freezeProxy); if (advisorsPreFiltered()) { proxyFactory.setPreFiltered(true); } // Use original ClassLoader if bean class not locally loaded in overriding class loader ClassLoader classLoader = getProxyClassLoader(); if (classLoader instanceof SmartClassLoader && classLoader != beanClass.getClassLoader()) { classLoader = ((SmartClassLoader) classLoader).getOriginalClassLoader(); } //通过代理工厂创建代理对象 return proxyFactory.getProxy(classLoader); } public Object getProxy(@Nullable ClassLoader classLoader) { //首先获取对应的代理 return createAopProxy().getProxy(classLoader); } //该方法根据要被代理的类选择使用jdk代理还是cglib代理 public AopProxy createAopProxy(AdvisedSupport config) throws AopConfigException { if (!NativeDetector.inNativeImage() && (config.isOptimize() || config.isProxyTargetClass() || hasNoUserSuppliedProxyInterfaces(config))) { Class targetClass = config.getTargetClass(); //如果被代理的类是一个接口则使用jdk代理 if (targetClass.isInterface() || Proxy.isProxyClass(targetClass) || ClassUtils.isLambdaClass(targetClass)) { return new JdkDynamicAopProxy(config); } //否则使用cglib代理 return new ObjenesisCglibAopProxy(config); } else { //根据配置选择强制使用jdk代理 return new JdkDynamicAopProxy(config); } } 我们知道,代理方式有jdk动态代理与cglib动态代理两种方式,而我们一个bean使用那种代理方式则由上述的方法决定。 至此,我们已经确定了使用那种代理方式获取代理对象。 2.3 获取代理对象 从上文中,我们已经确定了选用何种方式构建代理对象。接下来就是通过不同的方式是如何获取代理对象的。 看懂本章需要实现了解jdk动态代理或者cglib动态代理的方式。 2.3.1 JDK代理 首先在获取代理对象时选择 JdkDynamicAopProxy public Object getProxy(@Nullable ClassLoader classLoader) { if (logger.isTraceEnabled()) { logger.trace("Creating JDK dynamic proxy: " + this.advised.getTargetSource()); } //这里通过反射创建代理对象 return Proxy.newProxyInstance(classLoader, this.proxiedInterfaces, this); } 当被代理对象执行被代理的方法时,会进入到此方法。(jdk动态代理的概念) JDK通过反射创建对象,效率上来说相对低一些。 public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { try { // 获取被代理对象的所有切入点 List chain = this.advised.getInterceptorsAndDynamicInterceptionAdvice(method, targetClass); // 如果调用链路为空说明没有需要执行的切入点,直接执行对应的方法即可 if (chain.isEmpty()) { // We can skip creating a MethodInvocation: just invoke the target directly // Note that the final invoker must be an InvokerInterceptor so we know it does // nothing but a reflective operation on the target, and no hot swapping or fancy proxying. Object[] argsToUse = AopProxyUtils.adaptArgumentsIfNecessary(method, args); retVal = AopUtils.invokeJoinpointUsingReflection(target, method, argsToUse); } else { // 如果有切入点的话则按照切入点顺序开始执行 MethodInvocation invocation = new ReflectiveMethodInvocation(proxy, target, method, args, targetClass, chain); // Proceed to the joinpoint through the interceptor chain. retVal = invocation.proceed(); } return retVal; } } invocation.proceed();这个方法就是通过递归的方式执行所有的调用链路。 public Object proceed() throws Throwable { // We start with an index of -1 and increment early. if (this.currentInterceptorIndex == this.interceptorsAndDynamicMethodMatchers.size() - 1) { return invokeJoinpoint(); } Object interceptorOrInterceptionAdvice = this.interceptorsAndDynamicMethodMatchers.get(++this.currentInterceptorIndex); if (interceptorOrInterceptionAdvice instanceof InterceptorAndDynamicMethodMatcher) { InterceptorAndDynamicMethodMatcher dm = (InterceptorAndDynamicMethodMatcher) interceptorOrInterceptionAdvice; Class targetClass = (this.targetClass != null ? this.targetClass : this.method.getDeclaringClass()); if (dm.methodMatcher.matches(this.method, targetClass, this.arguments)) { return dm.interceptor.invoke(this); } else { // 继续执行 return proceed(); } } else { // 如果调用链路还持续的话,下一个方法仍会调用proceed() return ((MethodInterceptor) interceptorOrInterceptionAdvice).invoke(this); } } 2.3.2 cglib代理 public Object getProxy(@Nullable ClassLoader classLoader) { try { //配置CGLIB Enhancer... Enhancer enhancer = createEnhancer(); if (classLoader != null) { enhancer.setClassLoader(classLoader); if (classLoader instanceof SmartClassLoader && ((SmartClassLoader) classLoader).isClassReloadable(proxySuperClass)) { enhancer.setUseCache(false); } } enhancer.setSuperclass(proxySuperClass); enhancer.setInterfaces(AopProxyUtils.completeProxiedInterfaces(this.advised)); enhancer.setNamingPolicy(SpringNamingPolicy.INSTANCE); enhancer.setStrategy(new ClassLoaderAwareGeneratorStrategy(classLoader)); //1.获取回调函数,对于代理类上所有方法的调用,都会调用CallBack,而Callback则需要实现intercept()方法 Callback[] callbacks = getCallbacks(rootClass); Class[] types = new Class[callbacks.length]; for (int x = 0; x < types.length; x++) { types[x] = callbacks[x].getClass(); } // fixedInterceptorMap only populated at this point, after getCallbacks call above enhancer.setCallbackFilter(new ProxyCallbackFilter( this.advised.getConfigurationOnlyCopy(), this.fixedInterceptorMap, this.fixedInterceptorOffset)); enhancer.setCallbackTypes(types); //2.创建代理对象 return createProxyClassAndInstance(enhancer, callbacks); } catch (CodeGenerationException | IllegalArgumentException ex) { throw new AopConfigException("Could not generate CGLIB subclass of " + this.advised.getTargetClass() + ": Common causes of this problem include using a final class or a non-visible class", ex); } catch (Throwable ex) { // TargetSource.getTarget() failed throw new AopConfigException("Unexpected AOP exception", ex); } } 可以看到我们在创建代理对象前会先获取代理对象的所有回调函数: 首先可以看到我们一共有7个回调方法,其中第一个为AOP相关的方法,其他的为spring相关。 在第一个对调对象中持有的 advised 对象中有 advisors 属性,就是对应我们的代理类中四个切片,@Before等等。 然后我们看一下 createProxyClassAndInstance()都做了什么。 //CglibAopProxy类的创建代理对象方法 protected Object createProxyClassAndInstance(Enhancer enhancer, Callback[] callbacks) { enhancer.setInterceptDuringConstruction(false); enhancer.setCallbacks(callbacks); return (this.constructorArgs != null && this.constructorArgTypes != null ? enhancer.create(this.constructorArgTypes, this.constructorArgs) : enhancer.create()); } //ObjenesisCglibAopProxy继承了CglibAopProxy类,并覆写了其方法 protected Object createProxyClassAndInstance(Enhancer enhancer, Callback[] callbacks) { Class proxyClass = enhancer.createClass(); Object proxyInstance = null; //1.尝试使用objenesis创建对象 if (objenesis.isWorthTrying()) { try { proxyInstance = objenesis.newInstance(proxyClass, enhancer.getUseCache()); } catch (Throwable ex) { logger.debug("Unable to instantiate proxy using Objenesis, " + "falling back to regular proxy construction", ex); } } //2.根据commit的提交记录发现,objenesis有可能创建对象失败,如果失败的话则选用放射的方式创建对象 if (proxyInstance == null) { // Regular instantiation via default constructor... try { Constructor ctor = (this.constructorArgs != null ? proxyClass.getDeclaredConstructor(this.constructorArgTypes) : proxyClass.getDeclaredConstructor()); ReflectionUtils.makeAccessible(ctor); proxyInstance = (this.constructorArgs != null ? ctor.newInstance(this.constructorArgs) : ctor.newInstance()); } catch (Throwable ex) { throw new AopConfigException("Unable to instantiate proxy using Objenesis, " + "and regular proxy instantiation via default constructor fails as well", ex); } } // ((Factory) proxyInstance).setCallbacks(callbacks); return proxyInstance; } 2.3.3 cglib 此处有个遇到的问题,当我在debug的时候,发现怎么都进不去 createProxyClassAndInstance(),百思不得其解,然后看到IDEA旁边有一个向下的箭头,代表该方法可能其子类被覆写了。然后在其子类处打断点果然发现是其子类的实现。 此处在2.2中也可看到: 可以看到返回的是其子类的对象,而不是CglibAopProxy本身的对象。 作者:京东科技 韩国凯 来源:京东云开发者社区

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册