首页 文章 精选 留言 我的

精选列表

搜索[部署工具],共10000篇文章
优秀的个人博客,低调大师

Flask环境github部署(十三)

(1) github项目搭建 1 连接GitHub hostnamectl set-hostname flask-dev # 设置 hostname,一般是主机名可以不更改 ssh-keygen # 生成SSH公钥,一直enter代表不设置密码 cd .ssh/ #存放秘钥文件,id_rsa是私钥文件,id_rsa.pub是公钥文件 vim id_rsa.pub #编辑秘钥,全部复制公钥添加到 账户settings >> SSH-keys >> add SSHkeys 2 配置git git config --global user.email "邮箱" #设置用户名与邮箱,作为标识 git config --global user.name "账户名" vim ~/.gitconfig #添加配置信息 [core] repositoryformatversion = 0 filemode = true bare = false logallrefupdates = true editor = vim 3 配置虚拟环境 pip3 install virtualenv #安装virtualenv virtualenv flaskenv #创建flaskenv虚拟环境 source env/bin/activate #激活虚拟环境 4 安装flask pip3 install flask #安装flask pip freeze > requirements.txt #在requirements.txt生成当前环境下所需要安装的python软件包列表 pip install -r requirements.txt #生成 requirements.txt 文件,更方便我们去安装需要的包 deactivate #退出当前的虚拟环境 5 创建github项目 # 让 Git 忽略对整个 env 目录和所有 *.pyc 文件的处理,让 Git 仅处理自己的代码文件 vim .gitignore env/ *.pyc mkdir gitblog #创建项目名 cd gitblog # 创建 README 文件 echo "# welcome to why blog! " >> README.md # 初始化 git 仓库 git init # 将刚创建的文件都加入 git 缓冲区 git add . # 提交改动文件到 git 仓库 git commit -m "first commit" # 将项目发布到 github git remote add origin https://github.com/用户名/blog.git git push -u origin master (2) 项目简单流程 1 项目配置文件config.py/settings.py #配置所有环境的基类 class Config: SECRET_KEY = 'JAGAFAjjfdsfdasdas' SQLALCHEMY_TRACK_MODIFITIONS = False #测试 class TestingConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' pass #开发 class DevelopmentConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' DEBUG = True #生产 class ProductionConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' pass sqlalchemy通过特殊的URI字符串创建数据库的连接 # database_type+driver://user:password@sql_server_ip:port/database_name 2 创建主启动文件manage.py ​ 该文件是 Flask 应用的核心,也是程序的入口 from flask import Flask from config import DevelopmentConfig from flask_script import Manager app = Flask(__name__) manager = Manager(app) # 使用 config.from_object() 而不使用 app.config['DEBUG'] 是因为这样可以加载 class DevConfig 的配置变量集合,而不需要一项一项的添加和修改。 app.config.from_object(DevConfig) # 指定 URL='/' 的路由规则 @app.route('/') def index(): return '<h1>index</h1>' if __name__ == '__main__': manager.run() #注意 : 通过 manager.py 来执行命令行是十分有必要的,因为一些 Flask 的扩展只有在 Flask app object 被创建之后才会被初始化,所以非常依赖于应用上下 文的环境,在没有 Flask app object 时,直接运行默认的 Python CLI 会导致 这些 Flask 扩展返回错误。 3 运行开发服务器 python manage.py runserver -d -r python3 当前启动文件名.py runserver 可选参数 #可选参数如下: -h 主机名 -p 端口号 --threaded 开启多线程 -d 开启调试模式 -r 代码修改后重新加载 4 Models与SQLAlchemy 在 Web 应用程序开发中引入了 Models 为了 —— 将关系型数据转化为一个对象类型 SQLAlchemy 是一个 Python 包,其最底层包装了对数据库进入操作的统一接口,然后在最上层提供了对象关系映射(ORM)的实现。 SQLAlchemy-ORM 可以把大量的不同类型的数据库中的数据,转换成 Python 对象的集合。即SQLAlchemy-ORM 可以将对这些数据对象的操作转化为对数据库的操作。 Flask 为我们提供了 Flask SQLAlchemy,其实就是在 SQLAlchemy 上提供了一层包装,让 SQLAlchemy 可以结合 Flask 的一些特性来使用。

优秀的个人博客,低调大师

阿里云部署Hbase集群

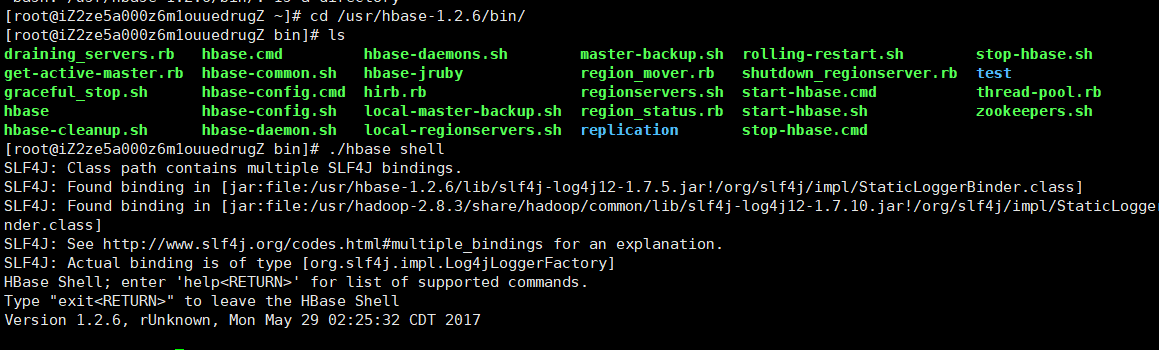
安装环境 主机 ip 操作系统 master 10.30.45.239 centos7.4 slave1 10.31.155.33 centos7.4 slave2 10.81.233.67 centos7.4 阿里云3台ecs搭建一个小型的hbase分布式数据存储(这里的ip都是内网)。一台作为主master两台作为从slave。 安装步骤 安装vim编辑器 安装ssh 配置ssh免密码登陆 安装jdk 安装hadoop 安装zookeeper 安装时间同步服务 NTP 安装hbase 准备工作 版本 centos7.4 内核为3.10 Hadoop 2.8.3 Hbase 1.2.6 Zookeeper 3.4.10 Sqoop 1.4.7 Phoenix 4.13.1 修改hostname # vim /etc/hostname 输入自定义主机名 ,三台都要改 修改hosts文件 分别登陆三台主机,修改hosts vim /etc/hosts --添加以下信息(三台都要改) 10.30.45.239 master 10.31.155.33 slave1 10.81.233.67 slave2 登陆master,下载所有安装包 --下载jdk8u31 wget --no-check-certificate --no-cookies --header "Cookie: oraclelicense=accept-securebackup-cookie" http://download.oracle.com/otn-pub/java/jdk/8u131-b11/d54c1d3a095b4ff2b6607d096fa80163/jdk-8u131-linux-x64.tar.gz -- 下载 hadoop-2.8.3 wget http://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/common/hadoop-2.8.3/hadoop-2.8.3.tar.gz --下载hbase 1.2.6 wget http://mirrors.hust.edu.cn/apache/hbase/1.2.6/hbase-1.2.6-bin.tar.gz --下载zookeeper 3.4.10 wget http://apache.claz.org/zookeeper/zookeeper-3.4.10/zookeeper-3.4.10.tar.gz --下载phoenix4.13.1 wget http://mirror.bit.edu.cn/apache/phoenix/apache-phoenix-4.13.1-HBase-1.2/bin/apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz --下载sqoop1.4.7 wget http://mirror.cogentco.com/pub/apache/sqoop/1.4.7/sqoop-1.4.7.bin__hadoop-2.6.0.tar.gz 写这篇文章的时候是2018年4月。适当选择稳定的版本安装。下载官网如下: jdk : http://www.oracle.com/technetwork/java/javase/downloads/index.html hadoop:http://hadoop.apache.org/releases.html hbase: http://www.apache.org/dyn/closer.lua/hbase/ zookeeper: http://zookeeper.apache.org/releases.html sqoop: http://sqoop.apache.org phoenix: https://phoenix.apache.org/ 设置3台ecs之间免密登陆 方便后期之间文件复制。 # # slave1 # ssh-keygen -t rsa -- 不用输入密码,一路回车就行 # cp ~/.ssh/id_rsa.pub ~/.ssh/slave1_id_rsa.pub # scp ~/.ssh/slave1_id_rsa.pub master:~/.ssh/ # # slave2 # ssh-keygen -t rsa # cp ~/.ssh/id_rsa.pub ~/.ssh/slave2_id_rsa.pub # scp ~/.ssh/slave2_id_rsa.pub master:~/.ssh/ # # master ssh-keygen -t rsa # cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys # cat ~/.ssh/slave1_id_rsa.pub >> ~/.ssh/authorized_keys # cat ~/.ssh/slave2_id_rsa.pub >> ~/.ssh/authorized_kyes -- 拷贝文件至slave1及slave2 # scp ~/.ssh/authorized_keys slave1:~/.ssh # scp ~/.ssh/authorized_keys slave2:~/.ssh 关闭防火墙及SELINUX(master、slave1、slave2均需修改) -- 关闭防火墙 # systemctl stop firewalld.service # systemctl disable firewalld.service -- 关闭SELINUX # vim /etc/selinux/config -- 注释掉 #SELINUX=enforcing #SELINUXTYPE=targeted -- 添加 SELINUX=disabled 设置时间同步 这里省略,第一我懒得配,第二阿里云有自动同步 安装jdk 登陆master -- 解压jdk安装包 # mkdir /usr/java # tar -zxvf jdk-8u131-linux-x64.tar.gz -C /usr/java -- 拷贝jdk至slave1及slave2中 # scp -r /usr/java slave1:/usr # scp -r /usr/java slave2:/usr -- 设置jdk环境变量(master、slave1、slave2均需修改) # vim /etc/environment JAVA_HOME=/usr/java/jdk1.8.0_131 JRE_HOME=/usr/java/jdk1.8.0_131/jre # vim /etc/profile export JAVA_HOME=/usr/java/jdk1.8.0_131 export JRE_HOME=${JAVA_HOME}/jre export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 搭建Hadoop环境 解压安装 登陆master # tar -zxvf hadoop-2.8.3-x64.tar.gz -C /usr # cd /usr/hadoop-2.8.3 # mkdir tmp logs hdf hdf/data hdf/name 修改Hadoop配置文件 -- 修改 slaves 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/slaves -- 删除 localhost,添加 slave1 slave2 -- 修改 core-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/core-site.xml -- 在 configuration 节点中添加以下内容 <property> <name>fs.default.name</name> <value>hdfs://master:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>file:/usr/hadoop-2.8.3/tmp</value> </property> -- 修改 hdfs-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/hdfs-site.xml -- 在 configuration 节点添加以下内容 <property> <name>dfs.datanode.data.dir</name> <value>/usr/hadoop-2.8.3/hdf/data</value> <final>true</final> </property> <property> <name>dfs.namenode.name.dir</name> <value>/usr/hadoop-2.8.3/hdf/name</value> <final>true</final> </property> -- 修改 mapred-site.xml 文件 # cp /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml.template /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml # vim /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml -- 在 configuration 节点添加以下内容 <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.jobhistory.address</name> <value>master:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>master:19888</value> </property> -- 修改 yarn-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/yarn-site.xml -- 在 configuration 节点添加以下内容 <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.mapred.ShuffleHandler</value> </property> <property> <name>yarn.resourcemanager.address</name> <value>master:8032</value> </property> <property> <name>yarn.resourcemanager.scheduler.address</name> <value>master:8030</value> </property> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>master:8031</value> </property> <property> <name>yarn.resourcemanager.admin.address</name> <value>master:8033</value> </property> <property> <name>yarn.resourcemanager.webapp.address</name> <value>master:8088</value> </property> 复制hadoop到slave节点 # scp -r /usr/hadoop-2.8.3 slave1:/usr # scp -r /usr/hadoop-2.8.3 slave2:/usr 配置 master 和 slave 的 hadoop 环境变量 # vim /etc/profile -- 添加如下内容 export HADOOP_HOME=/usr/hadoop-2.8.3 export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH export HADOOP_LOG_DIR=/usr/hadoop-2.8.3/logs export YARN_LOG_DIR=$HADOOP_LOG_DIR -- 保存后执行 # source /etc/profile # vim ~/.bashrc -- 添加如下内容 export HADOOP_PREFIX=/usr/hadoop-2.8.3/ -- 保存后执行 # source ~/.bashrc 格式化 namenode # /usr/hadoop-2.8.3/sbin/hdfs namenode -format 启动 hadoop(仅在master节点执行) # ssh master # /usr/hadoop-2.8.3/sbin/start-all.sh 到这一步已经成功完成了hadoop环境的搭建 Zookeeper环境搭建 解压缩 zookeeper 安装包到master,并建立基本目录 # tar -zxvf zookeeper-3.4.10.tar.gz -C /usr # mkdir /usr/zookeeper-3.4.10/data 修改master配置文件 -- 复制配置文件模板 # cp /usr/zookeeper-3.4.10/conf/zoo-sample.cfg /usr/zookeeper-3.4.10/conf/zoo.cfg -- 修改配置文件 # vim /usr/zookeeper-3.4.10/conf/zoo.cfg -- 添加如下内容 dataDir=/usr/zookeeper-3.4.10/data server.1=master:2888:3888 server.2=slave1:2888:3888 server.3=slave2:2888:3888 复制到各个子节点 # scp -r /usr/zookeeper-3.4.10 slave1:/usr # scp -r /usr/zookeeper-3.4.10 slave2:/usr 创建myid文件 -- master节点添加myid文件 # ssh master # touch /usr/zookeeper-3.4.10/data/myid # echo 1 > /usr/zookeeper-3.4.10/data/myid -- slave1节点添加myid文件 # ssh slave1 # touch /usr/zookeeper-3.4.10/data/myid # echo 2 > /usr/zookeeper-3.4.10/data/myid -- slave2节点添加myid文件 # ssh slave2 # touch /usr/zookeeper-3.4.10/data/myid # echo 3 > /usr/zookeeper-3.4.10/data/myid 启动zookeeper(master、slave1、slave2均需执行) -- 启动master # ssh master # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start -- 启动slave1 # ssh slave1 # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start -- 启动slave2 # ssh slave2 # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start 到这一步完成了zookeeper环境的搭建 HBase环境搭建 解压缩hbase安装包 # tar -zxvf hbase-1.2.6-bin.star.gz -C /usr # mkdir /usr/hbase-1.2.6-bin/logs 修改Hbase启动时要使用的环境变量(hbase-env.sh) -- 打开环境变量配置文件 # vim /usr/hbase-1.2.6/conf/hbase-env.sh -- 添加如下内容 -- 1、设置java安装路径 export JAVA_HOME=/usr/java/jdk1.8.0_131 -- 2、设置hbase的日志地址 export HBASE_LOG_DIR=${HBASE_HOME}/logs -- 3、设置是否使用hbase管理zookeeper(因使用zookeeper管理的方式,故此参数设置为false) export HBASE_MANAGES_ZK=false -- 4、设置hbase的pid文件存放路径 export HBASE_PID_DIR=/var/hadoop/pids 添加所有的region服务器到regionservers文件中 – 打开regionservers配置文件 # vim /usr/hbase-1.2.5/conf/regionservers -- 删除localhost,新增如下内容 master slave1 slave2 注:hbase在启动或关闭时会依次迭代访问每一行来启动或关闭所有的region服务器进程 修改Hbase集群的基本配置信息(hbase-site.xml),该配置将会覆盖Hbase的默认配置 -- 打开配置文件 # vim /usr/hbase-1.2.6/conf/hbase-site.xml -- 在configuration节点下添加如下内容 <property> <name>hbase.rootdir</name> <value>hdfs://master:9000/hbase</value> </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.zookeeper.quorum</name> <value>master,slave1,slave2</value> </property> <property> <name>hbase.zookeeper.property.dataDir</name> <value>/usr/zookeeper-3.4.10/data</value> </property> <property> <name>hbase.master</name> <value>hdfs://master:60000</value> </property> 复制hbase到slave中 # scp -r /usr/hbase-1.2.6 slave1:/usr # scp -r /usr/hbase-1.2.6 slave2:/usr 启动hbase(仅在master节点上执行即可) # ssh master # /usr/hbase-1.2.5/bin/start-hbase.sh 到这一步hbase环境搭建完成 本地测试 使用Habse shell连接Hbase cd /usr/hbase-1.2.6/bin/ ./hbase shell ./hbase shell 创建user1表 create 'user1','personalinfo' create 对user1简单CURD 插入 put 'user1','roow1','personalinfo:name','zhangsan' put 查询 get 'user1','row1','personalinfo:name' get 其他命令 help查询就好 hbase(main):001:0> help HBase Shell, version 1.2.6, rUnknown, Mon May 29 02:25:32 CDT 2017 Type 'help "COMMAND"', (e.g. 'help "get"' -- the quotes are necessary) for help on a specific command. Commands are grouped. Type 'help "COMMAND_GROUP"', (e.g. 'help "general"') for help on a command group. COMMAND GROUPS: Group name: general Commands: status, table_help, version, whoami Group name: ddl Commands: alter, alter_async, alter_status, create, describe, disable, disable_all, drop, drop_all, enable, enable_all, exists, get_table, is_disabled, is_enabled, list, locate_region, show_filters Group name: namespace Commands: alter_namespace, create_namespace, describe_namespace, drop_namespace, list_namespace, list_namespace_tables Group name: dml Commands: append, count, delete, deleteall, get, get_counter, get_splits, incr, put, scan, truncate, truncate_preserve Group name: tools Commands: assign, balance_switch, balancer, balancer_enabled, catalogjanitor_enabled, catalogjanitor_run, catalogjanitor_switch, close_region, compact, compact_rs, flush, major_compact, merge_region, move, normalize, normalizer_enabled, normalizer_switch, split, trace, unassign, wal_roll, zk_dump Group name: replication Commands: add_peer, append_peer_tableCFs, disable_peer, disable_table_replication, enable_peer, enable_table_replication, list_peers, list_replicated_tables, remove_peer, remove_peer_tableCFs, set_peer_tableCFs, show_peer_tableCFs Group name: snapshots Commands: clone_snapshot, delete_all_snapshot, delete_snapshot, list_snapshots, restore_snapshot, snapshot Group name: configuration Commands: update_all_config, update_config Group name: quotas Commands: list_quotas, set_quota Group name: security Commands: grant, list_security_capabilities, revoke, user_permission Group name: procedures Commands: abort_procedure, list_procedures Group name: visibility labels Commands: add_labels, clear_auths, get_auths, list_labels, set_auths, set_visibility SHELL USAGE: Quote all names in HBase Shell such as table and column names. Commas delimit command parameters. Type <RETURN> after entering a command to run it. Dictionaries of configuration used in the creation and alteration of tables are Ruby Hashes. They look like this: {'key1' => 'value1', 'key2' => 'value2', ...} and are opened and closed with curley-braces. Key/values are delimited by the '=>' character combination. Usually keys are predefined constants such as NAME, VERSIONS, COMPRESSION, etc. Constants do not need to be quoted. Type 'Object.constants' to see a (messy) list of all constants in the environment. If you are using binary keys or values and need to enter them in the shell, use double-quote'd hexadecimal representation. For example: hbase> get 't1', "key\x03\x3f\xcd" hbase> get 't1', "key\003\023\011" hbase> put 't1', "test\xef\xff", 'f1:', "\x01\x33\x40" The HBase shell is the (J)Ruby IRB with the above HBase-specific commands added. For more on the HBase Shell, see http://hbase.apache.org/book.html
优秀的个人博客,低调大师

YARN HA架构部署测试

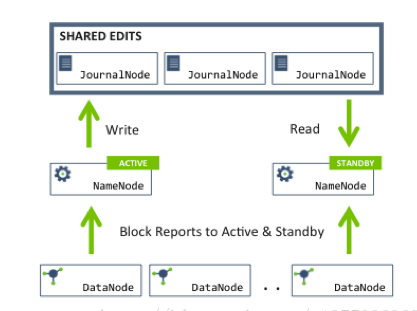
ResourceManager(RM)负责跟踪集群中的资源,并调度应用程序(例如MapReduce作业)。 在Hadoop 2.4之前,ResourceManager是纱线集群中的单一故障点。 高可用性特性以活动/备用资源管理器对的形式添加冗余,以删除此故障点。 原理图 配置过程 管理命令 ResourceManger Restart NodeManagers和客户端在RM关闭期间将保持对RM的轮询,直到RM启 动。当启动后,RM将通过心跳机制向正在与其会话的NodeManager和 ApplicationMasters发送同步指令。目前NodeManager和ApplicationMaster 处理该指令的方式为:NodeManager将杀死它管理的所有容器然后向RM 重新注册,对于RM来说,这些重新注册的NodeManager与新加入的 NodeManager相似。ApplicationMasters在接收到RM的同步指令后,将会 关闭。在RM重启后,从状态存储中加载应用元数据和认证信息并放入 内存后,RM将为每个还未完成的应用创建新的尝试。正如之前描述的 ,此种方式下之前正在运行的应用程序的工作将会丢失,因为它们已经 被RM在重启后使用同步指令杀死了 ResourceManager重启可以划分为两个阶段。 第一阶段, 增强的ResourceManager(RM)将应用程序的状态和其它认证信息保存到一个插入式的状态存储中。 RM重启时将从状态存储中重新加载这些信息,然后重新开始之前正在运行的应 用程序,用户不需要重新提交应用程序。 第二阶段, 重启时通过从NodeManagers读取容器的状态和从ApplicationMasters读取容器的请求,集中重构RM的运行状态。与第一阶段不同的是,在第二阶段中,之前正在运行的应用 程序将不会在RM重启后被杀死,所以应用程序不会因为RM中断而丢失工作。

优秀的个人博客,低调大师

elasticsearch5.6.3插件部署

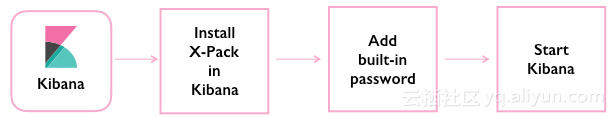
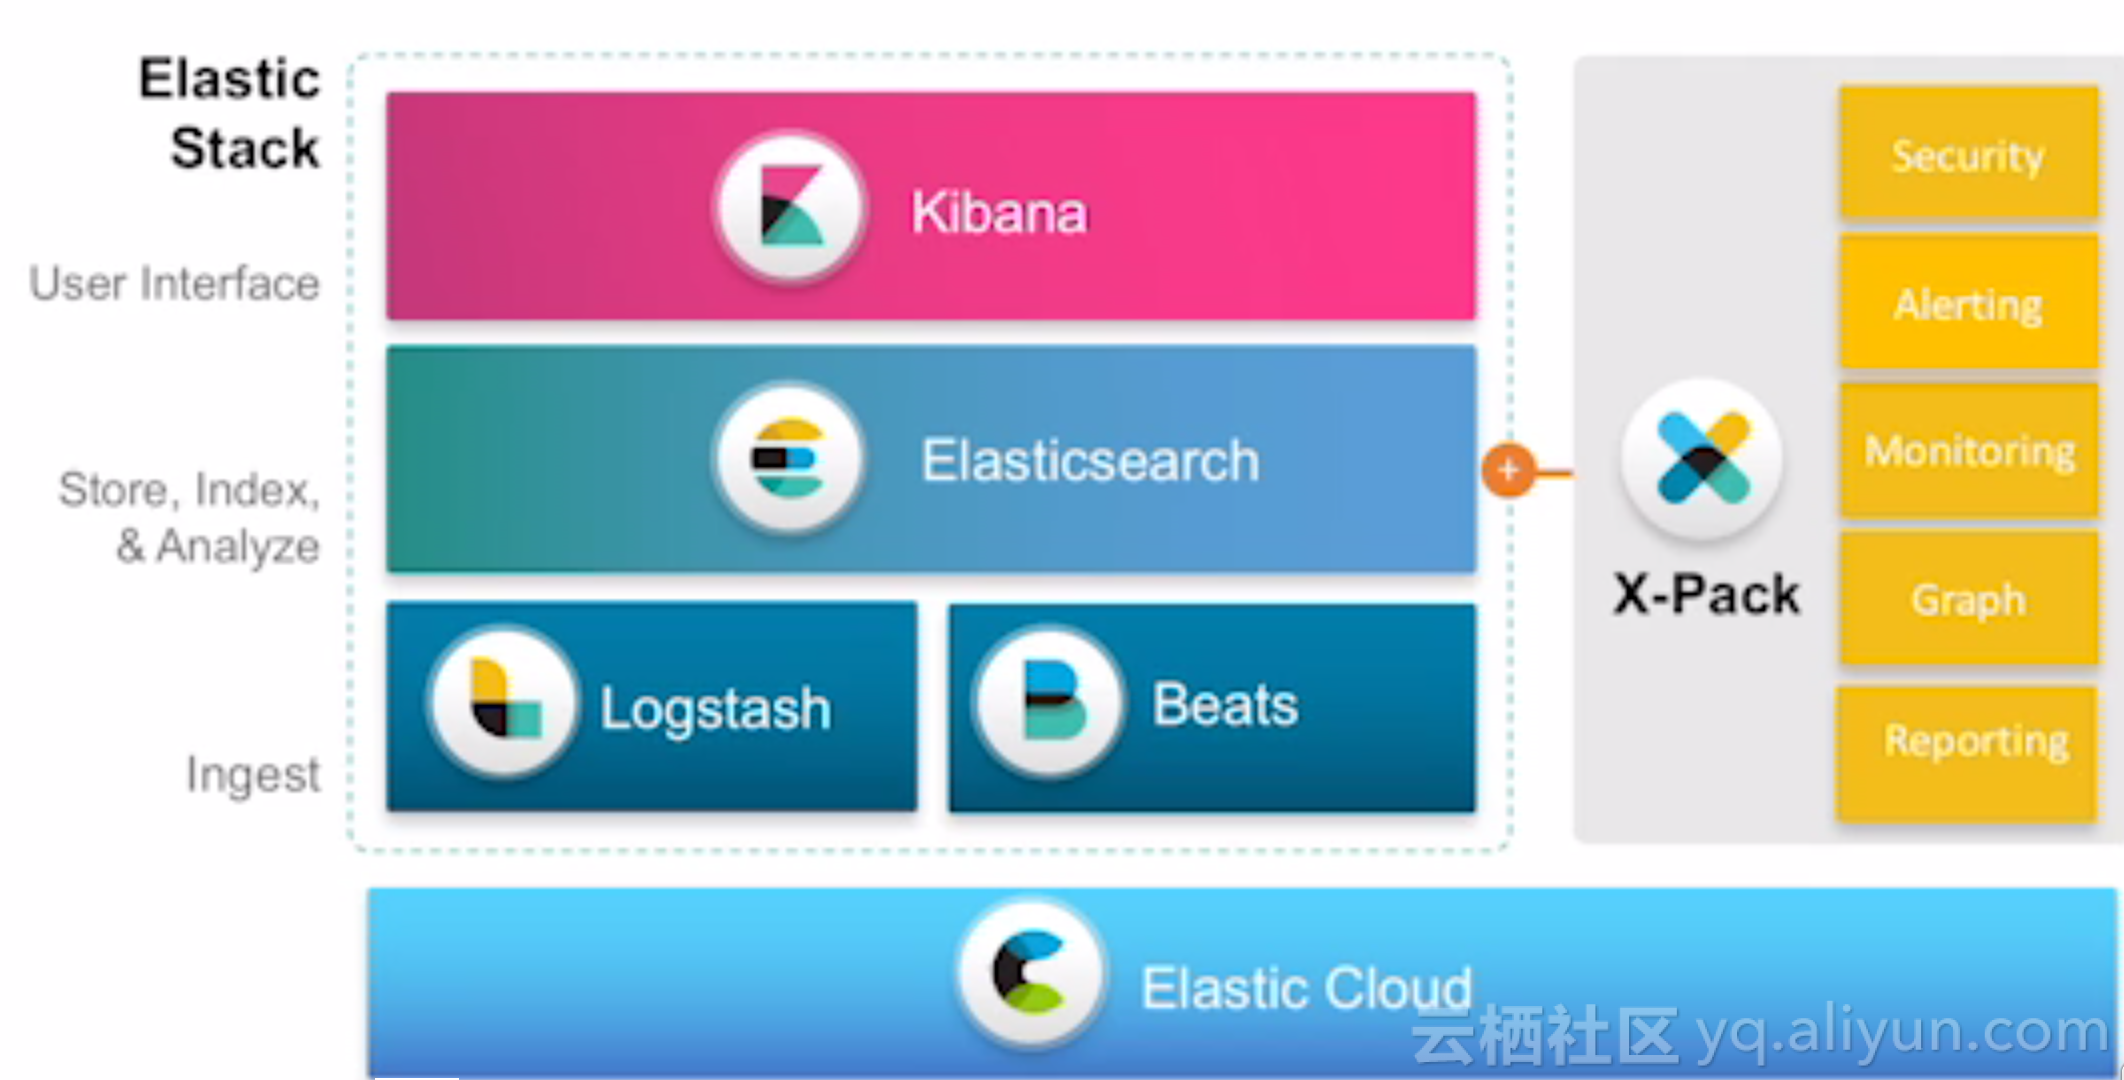
需要注意的是,5.x和2.x插件方面改动很大。参考:https://www.elastic.co/blog/running-site-plugins-with-elasticsearch-5-0。因为安全原因,原先的head、bigdesk、krof等插件不再支持直接在plugin目录下解压使用;新出个安全监控插件X-Pack,涵盖了marvel等功能。后面我会选择性地安装一些插件。 1.elasticsearch 安装和2.x一样,没什么可说的。安装后启动会遇到一系列问题,参考:http://www.cnblogs.com/jiu0821/p/7683322.html 2.kibana5.6.3 安装和2.x一样,只是界面大为改观,且内置了sense插件。 实际安装过程中遇到一个问题,kibana日志正常但不可用其他主机通过浏览器访问,端口是开放的。使用命令:netstat -an | grep LISTEN看到5601端口绑定的地址是127.0.0.1,由于本地hosts配置问题,无法通过本机实际ip访问。两个方案,一个就是配置本地hosts问题,另一个可以修改kibana的配置文件,把里面的host改为“host:0.0.0.0",解决。(0.0.0.0代表使用所有地址) 3.cerebro(krof) realease版本下载地址:https://github.com/lmenezes/cerebro/releases 解压安装包到一个自定义目录(非elasticsearch或kibana的plugin目录),Run bin/cerebro(or bin/cerebro.bat if on Windows)。界面会让你输入es域名,连接即可。 4.analysis-ik 下载地址:https://github.com/medcl/elasticsearch-analysis-ik/releases 解压,复制到插件目录:mv elasticsearch-analysis-ik-5.6.3elasticsearch安装目录/plugins/analysis-ik 这个时候需要重启 elasticsearch 插件才能生效(这个可以等设置好词库再重启也可以) 5.bigdesk 下载地址:https://github.com/hlstudio/bigdesk 修改es配置文件,添加参数: http.cors.enabled: true http.cors.allow-origin: "*" 解压安装包到一个自定义目录(非elasticsearch或kibana的plugin目录)。这个插件需要运行在一个web server上,es没有提供,我们需要自己搭建。 安装node,然后进入bigdesk目录下的_site目录,可以看到有个index.html。这里暂且使用Python提供的一个简易web server,执行: python -m SimpleHTTPServer [port] 注:这里的port可不填,也可以填自己指定的端口号 然后就可以用浏览器访问了,访问http://ip:port。 本文转自 jiu~ 博客园博客,原文链接:http://www.cnblogs.com/jiu0821/p/7695149.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop的部署以及应用

1.基础环境 1 2 3 4 5 6 7 8 9 10 [hadoop@master~]$ cat /etc/redhat-release CentOSLinuxrelease7.2.1511(Core) [hadoop@master~]$ [hadoop@master~]$getenforce Disabled [hadoop@master~]$systemctlstatusfirewalld ●firewalld.service-firewalld-dynamicfirewalldaemon Loaded:loaded( /usr/lib/systemd/system/firewalld .service;disabled;vendorpreset:enabled) Active:inactive(dead) [hadoop@master~]$ 2.IP以及对应节点 IP 主机名 hadoop node hadoop 进程名称 192.168.56.100 master master namenode,jobtracker 192.168.56.101 slave1 slave datanode,tasktracker 192.168.56.102 slave2 slave datanode,tasktracker 192.168.56.103 slave3 slave datanode,tasktracker 1 2 3 4 5 6 [hadoop@master~] #cat/etc/hosts 192.168.56.100Master 192.168.56.101slave1 192.168.56.102slave2 192.168.56.103slave3 [hadoop@master~] # 3.增加hadoop用户,所有节点 1 2 useradd hadoop echo hadoop| passwd --stdinhadoop 4.jdk 1 2 3 4 5 6 7 8 9 10 11 12 [hadoop@slave1application] #ll total4 lrwxrwxrwx1rootroot24Jul1001:35jdk-> /application/jdk1 .8.0_60 drwxr-xr-x8rootroot4096Aug52015jdk1.8.0_60 [hadoop@slave1application] #pwd /application [hadoop@slave1application] # [hadoop@master~] #java-version javaversion "1.8.0_60" Java(TM)SERuntimeEnvironment(build1.8.0_60-b27) JavaHotSpot(TM)64-BitServerVM(build25.60-b23,mixedmode) [hadoop@master~] # 5.master(192.168.56.100)上的hadoop用户可以ssh所有slave节点的hadoop用户下 6.设置hadoop安装路径 以及环境变量(所有节点) 1 2 3 4 5 6 7 su -hadoop tar xfhadoop-2.7.0tar.gz /home/hadoop/hadoop-2 .7.0 vi /etc/profile 添加hadoop环境变量 export HADOOP_HOME= /home/hadoop/hadoop-2 .7.0 export PATH=$PATH:$HADOOP_HOME /bin source /etc/profile 7.修改hadoop的环境的Java环境变量 1 2 3 4 /home/hadoop/hadoop-2 .7.0 /etc/hadoop vi hadoop- env .sh添加 ###JAVA_HOME export JAVA_HOME= /application/jdk/ 8.修改hadoop的配置文件 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 cd /home/hadoop/hadoop-2 .7.0 /etc/hadoop 1. ############################## [hadoop@masterhadoop]$ cat core-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>fs.default.name< /name > <value>hdfs: //master :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> /home/hadoop/tmp < /value > < /property > < /configuration > [hadoop@masterhadoop]$ 2. ###################################(默认不存在拷贝个模板即可) [hadoop@masterhadoop]$ cat mapred-site.xml <?xmlversion= "1.0" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>mapred.job.tracker< /name > <value>master:9001< /value > < /property > <property> <name>mapred. local . dir < /name > <value> /home/hadoop/tmp < /value > < /property > < /configuration > [hadoop@masterhadoop]$ 3. ######################################### [hadoop@masterhadoop]$ cat hdfs-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>dfs.name. dir < /name > <value> /home/hadoop/name1 , /home/hadoop/name2 , /home/hadoop/name3 < /value > <description>< /description > < /property > <property> <name>dfs.data. dir < /name > <value> /home/hadoop/data1 , /home/hadoop/data2 , /home/hadoop/data3 < /value > <description>< /description > < /property > <property> <name>dfs.replication< /name > <value>3< /value > < /property > < /configuration > [hadoop@masterhadoop]$ [hadoop@masterhadoop]$ cat masters master [hadoop@masterhadoop]$ cat slaves slave1 slave2 slave3 [hadoop@masterhadoop]$ 9.分发到slave节点 1 2 3 scp -r /home/hadoop/hadoop-2 .7.0slave1: /home/hadoop/ scp -r /home/hadoop/hadoop-2 .7.0slave2: /home/hadoop/ scp -r /home/hadoop/hadoop-2 .7.0slave3: /home/hadoop/ 10.master 节点测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 /home/hadoop/name1 /home/hadoop/name2 /home/hadoop/name3 这三个目录不要创建,如果创建会提示 重新reload cd /home/hadoop/hadoop-2 .7.0 [hadoop@masterhadoop-2.7.0]$. /bin/hadoop namenode- format DEPRECATED:Useofthisscripttoexecutehdfs command isdeprecated. Insteadusethehdfs command for it. 17 /07/10 02:57:34INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=Master /192 .168.56.100 STARTUP_MSG:args=[- format ] STARTUP_MSG:version=2.7.0 STARTUP_MSG:classpath= /home/hadoop/hadoop-2 .7.0 /etc/hadoop : /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hadoop-auth-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-recipes-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-collections-3 .2.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/xmlenc-0 .52.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/htrace-core-3 .1.0-incubating.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-beanutils-core-1 .8.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-digester-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsp-api-2 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/httpcore-4 .2.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/mockito-all-1 .8.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hadoop-annotations-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/junit-4 .11.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-configuration-1 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/api-util-1 .0.0-M20.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jaxb-impl-2 .2.3-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-json-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jettison-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-jaxrs-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hamcrest-core-1 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-net-3 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/api-asn1-api-1 .0.0-M20.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-math3-3 .1.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-xc-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/stax-api-1 .0-2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/slf4j-log4j12-1 .7.10.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/snappy-java-1 .0.4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/avro-1 .7.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/paranamer-2 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-beanutils-1 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsch-0 .1.42.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/apacheds-kerberos-codec-2 .0.0-M15.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jets3t-0 .9.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/activation-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/java-xmlbuilder-0 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/apacheds-i18n-2 .0.0-M15.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-httpclient-3 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/gson-2 .2.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jaxb-api-2 .2.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-framework-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/httpclient-4 .2.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-client-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/slf4j-api-1 .7.10.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/zookeeper-3 .4.6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-nfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-common-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs : /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xmlenc-0 .52.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/htrace-core-3 .1.0-incubating.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-daemon-1 .0.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xercesImpl-2 .9.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/netty-all-4 .0.23.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xml-apis-1 .3.04.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-nfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-collections-3 .2.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/javax .inject-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/aopalliance-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jaxb-impl-2 .2.3-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-json-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jettison-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-jaxrs-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-xc-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/stax-api-1 .0-2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-guice-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guice-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/activation-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jaxb-api-2 .2.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/zookeeper-3 .4.6-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guice-servlet-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-client-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/zookeeper-3 .4.6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-sharedcachemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-applicationhistoryservice-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-applications-distributedshell-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-applications-unmanaged-am-launcher-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-resourcemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-registry-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-tests-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-web-proxy-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-api-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-nodemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-client-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/javax .inject-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/aopalliance-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/hadoop-annotations-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/junit-4 .11.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/hamcrest-core-1 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/snappy-java-1 .0.4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-guice-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/guice-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/avro-1 .7.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/paranamer-2 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/guice-servlet-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-examples-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-hs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-core-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-hs-plugins-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-shuffle-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-app-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /contrib/capacity-scheduler/ *.jar: /home/hadoop/hadoop-2 .7.0 /contrib/capacity-scheduler/ *.jar STARTUP_MSG:build=Unknown-rUnknown;compiledby 'root' on2015-05-27T13:56Z STARTUP_MSG:java=1.8.0_60 ************************************************************/ 17 /07/10 02:57:34INFOnamenode.NameNode:registeredUNIXsignalhandlers for [TERM,HUP,INT] 17 /07/10 02:57:34INFOnamenode.NameNode:createNameNode[- format ] 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name1 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name2 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name3 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name1 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name2 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name3 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. Formattingusingclusterid:CID-77e0896d-bda2-49f1-8127-c5343f1c52c9 17 /07/10 02:57:35INFOnamenode.FSNamesystem:NoKeyProviderfound. 17 /07/10 02:57:35INFOnamenode.FSNamesystem:fsLockisfair: true 17 /07/10 02:57:35INFOblockmanagement.DatanodeManager:dfs.block.invalidate.limit=1000 17 /07/10 02:57:35INFOblockmanagement.DatanodeManager:dfs.namenode.datanode.registration.ip- hostname -check= true 17 /07/10 02:57:35INFOblockmanagement.BlockManager:dfs.namenode.startup.delay.block.deletion.secis set to000:00:00:00.000 17 /07/10 02:57:36INFOblockmanagement.BlockManager:Theblockdeletionwillstartaround2017Jul1002:57:36 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapBlocksMap 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:2.0%maxmemory966.7MB=19.3MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^21=2097152entries 17 /07/10 02:57:36INFOblockmanagement.BlockManager:dfs.block.access.token. enable = false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:defaultReplication=3 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxReplication=512 17 /07/10 02:57:36INFOblockmanagement.BlockManager:minReplication=1 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxReplicationStreams=2 17 /07/10 02:57:36INFOblockmanagement.BlockManager:shouldCheckForEnoughRacks= false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:replicationRecheckInterval=3000 17 /07/10 02:57:36INFOblockmanagement.BlockManager:encryptDataTransfer= false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxNumBlocksToLog=1000 17 /07/10 02:57:36INFOnamenode.FSNamesystem:fsOwner=hadoop(auth:SIMPLE) 17 /07/10 02:57:36INFOnamenode.FSNamesystem:supergroup=supergroup 17 /07/10 02:57:36INFOnamenode.FSNamesystem:isPermissionEnabled= true 17 /07/10 02:57:36INFOnamenode.FSNamesystem:HAEnabled: false 17 /07/10 02:57:36INFOnamenode.FSNamesystem:AppendEnabled: true 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapINodeMap 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:1.0%maxmemory966.7MB=9.7MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^20=1048576entries 17 /07/10 02:57:36INFOnamenode.FSDirectory:ACLsenabled? false 17 /07/10 02:57:36INFOnamenode.FSDirectory:XAttrsenabled? true 17 /07/10 02:57:36INFOnamenode.FSDirectory:Maximumsizeofanxattr:16384 17 /07/10 02:57:36INFOnamenode.NameNode:Caching file namesoccuring more than10 times 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapcachedBlocks 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:0.25%maxmemory966.7MB=2.4MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^18=262144entries 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.threshold-pct=0.9990000128746033 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.min.datanodes=0 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.extension=30000 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .window.num.buckets=10 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .num. users =10 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .windows.minutes=1,5,25 17 /07/10 02:57:36INFOnamenode.FSNamesystem:Retrycacheonnamenodeisenabled 17 /07/10 02:57:36INFOnamenode.FSNamesystem:Retrycachewilluse0.03oftotalheapandretrycacheentryexpiry time is600000millis 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapNameNodeRetryCache 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:0.029999999329447746%maxmemory966.7MB=297.0KB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^15=32768entries 17 /07/10 02:57:36INFOnamenode.FSImage:AllocatednewBlockPoolId:BP-467031090-192.168.56.100-1499626656612 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name1 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name2 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name3 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOnamenode.NNStorageRetentionManager:Goingtoretain1imageswithtxid>=0 17 /07/10 02:57:36INFOutil.ExitUtil:Exitingwithstatus0 17 /07/10 02:57:37INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatMaster /192 .168.56.100 ************************************************************/ [hadoop@masterhadoop-2.7.0]$ 11.启动服务 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 [hadoop@mastersbin]$ pwd /home/hadoop/hadoop-2 .7.0 /sbin [hadoop@mastersbin]$ [hadoop@mastersbin]$. /start-all .sh ThisscriptisDeprecated.Insteadusestart-dfs.shandstart-yarn.sh Startingnamenodeson[master] master:startingnamenode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-namenode-master .out slave3:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave3 .out slave2:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave2 .out slave1:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave1 .out Startingsecondarynamenodes[0.0.0.0] 0.0.0.0:startingsecondarynamenode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-secondarynamenode-master .out startingyarndaemons startingresourcemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-resourcemanager-master .out slave3:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave3 .out slave2:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave2 .out slave1:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave1 .out 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [hadoop@mastersbin]$ netstat -lntup (Notallprocessescouldbeidentified,non-ownedprocessinfo willnotbeshown,youwouldhavetoberoottoseeitall.) ActiveInternetconnections(onlyservers) ProtoRecv-QSend-QLocalAddressForeignAddressStatePID /Program name tcp00192.168.56.100:90000.0.0.0:*LISTEN4405 /java tcp000.0.0.0:500900.0.0.0:*LISTEN4606 /java tcp000.0.0.0:500700.0.0.0:*LISTEN4405 /java tcp000.0.0.0:220.0.0.0:*LISTEN- tcp00127.0.0.1:250.0.0.0:*LISTEN- tcp600:::22:::*LISTEN- tcp600:::8088:::*LISTEN4757 /java tcp600::1:25:::*LISTEN- tcp600:::8030:::*LISTEN4757 /java tcp600:::8031:::*LISTEN4757 /java tcp600:::8032:::*LISTEN4757 /java tcp600:::8033:::*LISTEN4757 /java [hadoop@mastersbin]$ http://192.168.56.100:50070/dfshealth.html#tab-overview http://192.168.56.103:8042/node/allApplications http://192.168.56.100:50090/status.html 本文转自 小小三郎1 51CTO博客,原文链接:http://blog.51cto.com/wsxxsl/1945709,如需转载请自行联系原作者

优秀的个人博客,低调大师

CentOS7 部署Kubernetes

一、Installing Docker yuminstall-ydocker systemctlenabledocker&&systemctlstartdocker 二、Installing kubeadm, kubelet and kubectl cat<<EOF>/etc/yum.repos.d/kubernetes.repo [kubernetes] name=Kubernetes baseurl=https://packages.cloud.google.com/yum/repos/kubernetes-el7-x86_64 enabled=1 gpgcheck=1 repo_gpgcheck=1 gpgkey=https://packages.cloud.google.com/yum/doc/yum-key.gpghttps://packages.cloud.google.com/yum/doc/rpm-package-key.gpg EOF setenforce0 yuminstall-ykubeletkubeadmkubectl systemctlenablekubelet&&systemctlstartkubelet 1.关闭selinux 2.Some users on RHEL/CentOS 7 have reported issues with traffic being routed incorrectly due to iptables being bypassed. You should ensurenet.bridge.bridge-nf-call-iptablesis set to 1 in yoursysctlconfig, e.g. cat<<EOF>/etc/sysctl.d/k8s.conf net.bridge.bridge-nf-call-ip6tables=1 net.bridge.bridge-nf-call-iptables=1 EOF sysctl--system 参考https://kubernetes.io/docs/setup/independent/install-kubeadm/ 本文转自不要超过24个字符博客51CTO博客,原文链接http://blog.51cto.com/cstsncv/2060277如需转载请自行联系原作者 cstsncv

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册