首页 文章 精选 留言 我的

精选列表

搜索[词元],共10000篇文章
优秀的个人博客,低调大师

开源跨平台划词翻译软件 Pot 1.1.0 版本发布,支持 OCR

Pot是一款基于Tauri开发的桌面应用程序,可以在Windows、macOS和Linux上运行。它提供了一种简单而实用的方式,让用户可以在任何地方快速翻译单词或短语。 在1.1.0版本中,Pot增加了大家所期待的OCR功能,这意味着用户可以直接截图来识别文本,然后进行翻译。这个功能对于需要翻译图片或者PDF文档的用户来说非常实用。 此外,Pot还支持多种翻译引擎,包括OpenAI、百度翻译、谷歌翻译和有道翻译等。用户可以根据自己的需求选择不同的翻译引擎。 Pot的界面简洁明了,用户可以通过设置快捷键来方便地调用它。 官网地址:https://pot.pylogmon.com Github地址:https://github.com/pot-app/pot-desktop

优秀的个人博客,低调大师

全自动、可视化开发,成为敏捷转型落地关键词

德勤( Deloitte)在《2020年技术趋势报告》中指出,创新仍是商业和技术领域中的颠覆性动力。新兴企业正在利用数字技术迅速进步,然而很多传统企业正在面临着IT系统越来越缓慢、僵化和昂贵等诸多问题,还在努力追赶发展的步伐。这在德勤此前一项面向全球首席信息官 (CIO)的调查中已经得到证实,仅有 54% 的CIO表示他们企业现有的技术能够满足当前和未来的业务需求。 那么,要如何解决这个问题呢?最快捷的方式,莫过于利用一套低门槛、可视化、全自动的服务和平台来提升自身的技术能力。 只需一个具有简单逻辑和拖拽组件的可视化界面,专业开发人员,或者没有编程基础、开发技能的普通人,就可以创建复杂程度不同的软件,以满足开发、自动化流程和加速数字化转型的业务需求。 由于它优化了软件开发过程的每一步,因此在需要快速构建、频繁更新、异步协作和高质量工作的软件市场中,全自动、可视化开发工具备受青睐,常被用于 DevOps 流程中,加速企业敏捷转型。 降本增效,便捷开发 全自动可视化开发最大的优势就是,能够为企业降低成本,提升效率。 在全自动可视化平台出现之前,传统的原生代码开发平台需要手动编码,开发完成之后还要进行测试以及 bug 修复等一系列繁琐工作。 而现在,使用全自动可视化工具构建软件非常容易,因为预建组件和服务,不必逐行编写代码,也无需从头开始为应用程序构建核心模块,缩短了软件开发和上市时间。 而且,由于平台套用封装代码,基本消除测试修复 bug 的环节。同时,全自动可视化开发平台是松耦合的并发开发模型,大大降低开发中对合作方的依赖性,从而降低沟通和时间成本。 此外,开发人员也能从最繁琐的日常任务如执行持续维护中解放出来,从而可以专注创新开发。 打破壁垒,促进协作 项目团队中,业务、产品、设计、开发、测试与运维人员各司其职,且各有一套领域内的工具和语言,难以就项目进行协作和交流,当个人负责复杂的、自定义编码的软件时尤其如此——尽管代码的作者了解它的工作原理,但其他团队成员通常不清楚。 全自动可视化工具则提供了一个直观的业务逻辑流程图,每个成员都可以轻松了解他们的任务是什么,以及他们如何适应更广泛的工作流程,而不需要任何编码知识。 而且由于全自动可视化开发上手容易,无需经过太多专业的训练,业务人员也可以快速上手,通过“拖拉拽”,基于模板或者可视化界面快速生成应用,从而打破业务壁垒。 缓解人才紧缺难题 全自动可视化开发就像拼积木一样,跟着业务逻辑拖拽组件,就能完成软件开发。低门槛带来的优势在于,即使没有编码经验也能开发软件。 也就是说,使用全自动可视化平台,不仅降低了研发人员的工作量,同时也降低了对编码人员开发技能的要求。 因此,企业不需要再像以前一样,招聘大量的开发人员。对于迟迟难以招聘到 IT 人才的企业来说,全自动可视化平台解决了燃眉之急。Korn Ferry最近的一项研究发现,到 2030 年,中国可能面临 1200 万人才的短缺,其中,对熟练的开发人员和 IT 专业人员的需求占到了很大一部分。 提高产品的灵活性 企业利用全自动可视化平台开发,可以轻松地更改应用和业务流程,而无需花费大量时间编写代码。应用和系统的灵活性、可操作性和可更改性大大提高。而且由于组件和服务可以重复使用,可以更加快速地开发不同的解决方案。 加快数字化转型 在经济新常态下,为了提高经营效率和经营表现,数字化转型是大多数传统企业的目标,而全自动可视化技术可以帮助企业更快更好地完成数字化转型。 相比于纯代码开发,使用全自动可视化技术开发企业应用能将项目的交付周期大幅缩短,从而更敏捷地完成项目交付,大幅提升企业数字化的速度。敏捷交付的背后是更多次数的迭代,以及软件系统与企业贴合度的大幅提升,而这点是企业数字化转型成败的关键。 近几年,已经有越来越多的企业开始抢占全自动、可视化开发的赛道。今年5月,飞算推出了全球首款面向微服务架构设计和最佳实践的软件机器人——SoFlu软件机器人。它包含后端全自动开发平台、前端全自动开发平台、全自动测试平台、全自动运维平台,特别之处就在于可视化、全自动。 很多人认为,可视化开发平台只能用于简单的场景开发,其实并非如此。SoFlu软件机器人就是一个覆盖前后端的全自动可视化开发平台。 其中, 后端全自动开发平台改变了传统编写代码的开发方法,通过拖拽方式以及参数配置,就能实现等同于编写复杂代码的业务逻辑,业务逻辑可视化展示,极大地降低开发门槛,在设计业务逻辑时就形成微服务应用。 前端全自动开发平台是一个前端开发客户端,提供可视化开发模式,能够快速开发前端界面交互;提供丰富的页面控件实现页面自定义开发,无业务场景限制。简化后端接口数据联调,生成前端部署包实现应用项目私有化部署。 事实上,它不仅仅是实现了可视化,还实现了自动化开发。比如,链接数据库后,SoFlu软件机器人会自动生成库中所有表的基本接口和SQL语句,从而极大地降低基本接口的开发难度。 除了开发之外,SoFlu软件机器人还可以助力企业提高项目管理水平,实现从“人治”到“法治”,软件工程通过工具化平台将管理制度落地,彻底提升效率降低成本;还能将所有的经验值沉淀到企业内部,形成良性循环复用,建立企业知识库。 现在,越来越多的企业在整个软件开发生命周期中采用敏捷和 DevOps 流程和实践,自动化是任何成功的 DevOps 流程不可或缺的一部分,可视化开发,又能进一步节省时间和资源,同时有机地提高 SDLC(软件开发生命周期) 的效率。

优秀的个人博客,低调大师

Chromium 与 Go 开发者提议替换“blacklist”与“slave”等词

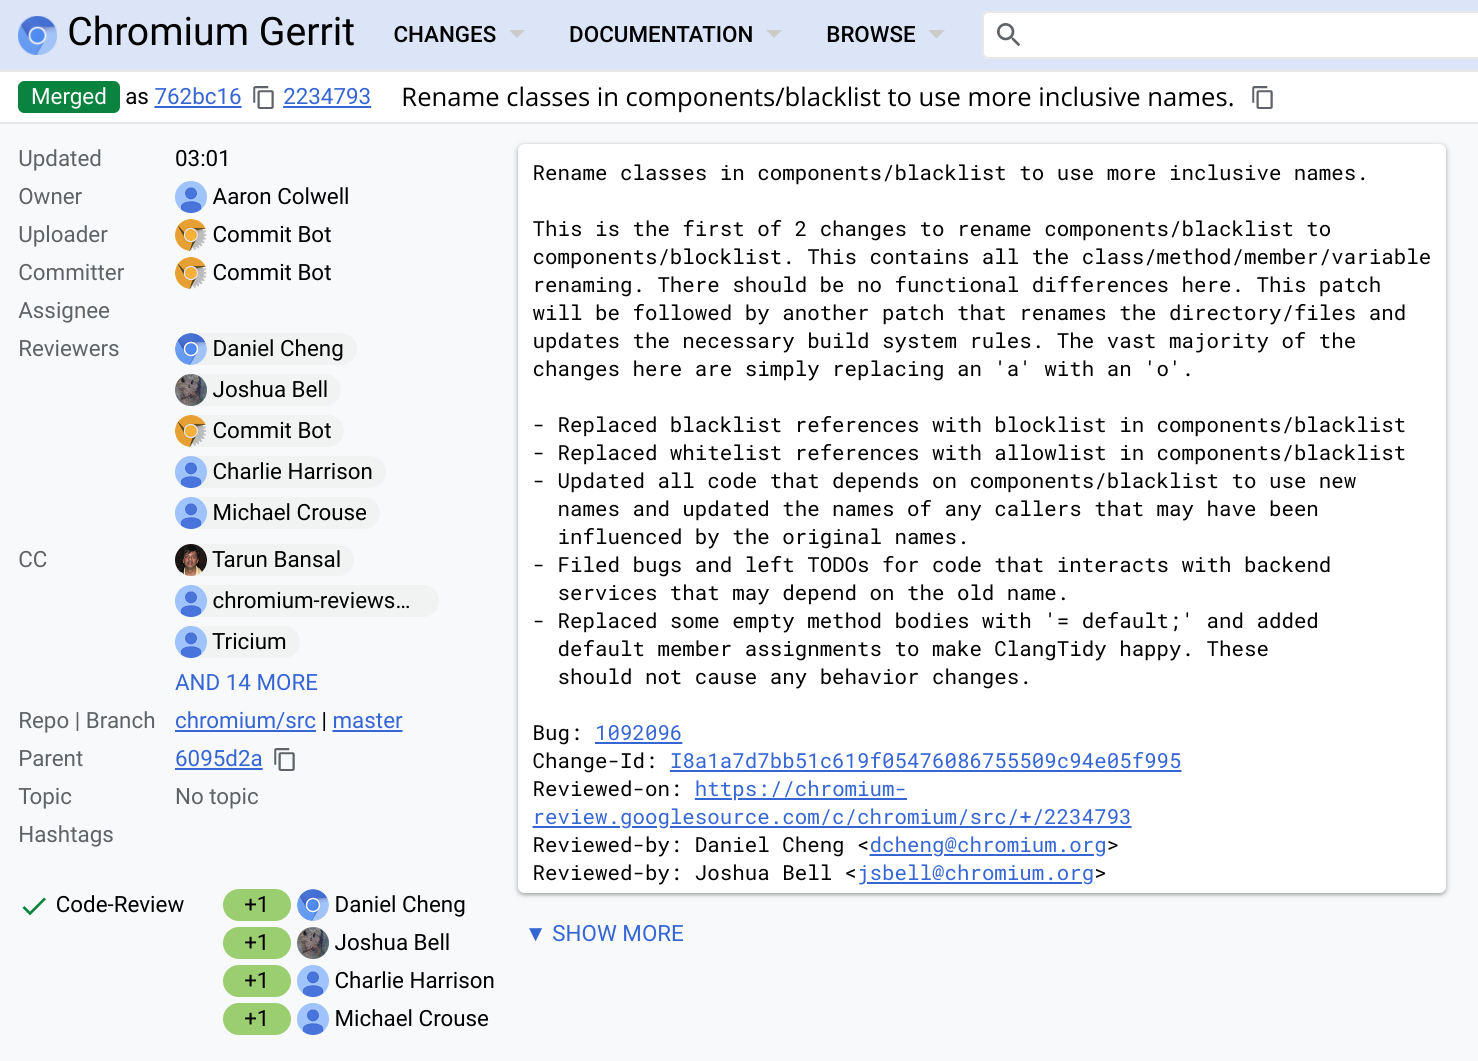
最近美国引发的“Black Lives Matter”运动使得各种抗议声音不断,技术圈也有支持这一运动的行动。 从源码中的一个新 commit 来看,Chromium 有开发者提议移除“blacklist(黑名单)”这样的字眼。 这一个 commit 试图安全地替换出现单词“blacklist”的每个可能的实例,而不破坏浏览器的任何部分,最终目的是将“components/blacklist”重命名为“components/blocklist”,也就是将 blacklist 中的“a”替换成“o”,大约有超过 2000 个单词需要修改。这将包含所有的类/方法/成员/变量重命名,需要更新必要的构建系统规则。 另一边,Golang 也有开发者提了类似 commit,其认为讨论为什么没什么意义,更重要的是实际上 whitelist/blacklist、master/slave 这些词汇真的给一些人带来了伤害。在这一 commit 中,没有更改供应商、绑定等文件,几乎所有变化是测试或注释方面的,并有一些cmd/link 和 cmd/oldlink 中几个重命名,这是非常安全的改变过程。 回想起 18 年 Redis 也因为类似种族歧视的原因,无奈放弃了master-slave 的表述方式。有人认为这些是所谓的“政治正确”,并没有什么意义,然而实际上或许这些本身就是真实伤害呢?你怎么看?

优秀的个人博客,低调大师

Splunk: 2018年物联网的四大关键词

随着越来越多的企业计划扩大现有数据规模,物联网必定是他们下一步的选择。一些成功整合了IT、运营和业务数据的企业,现在正在设法获取物联网数据并使之与现有的基础设施关联起来。只有这样做,物联网、数据、IT 才能充分发挥作用,为企业服务。 1.风险 物联网在快速发展的同时也带来了安全风险。越来越多的“联网物体”让日常生活更加美好,然而在推动创新的同时,也让自己进入了安全雷区。 我们日常生活和经济活动的方方面面,与其他人、流程和企业的联系越来越紧密,网络安全风险将呈指数级增长。每一个“联网的物体”都为个人信息、企业信息和公共安全打开了新大门。通过这些大门,个人和企业将自己的新弱点都暴露给了黑客。在未来,我们发现攻击可以来自公共网络,还可以来自智能手机和智能家居等私人设备。因此,虽然物联网变革振奋人心,但在2018年,消费者和企业将不得不开始权衡利弊。这对于那些泄露事件会导致消费者产生严重不信任的企业而言尤为重要。Gartner预测,到2020年,25%以上已识别的攻击事件将涉及物联网——尽管物联网预算在IT安全预算中不足10%。这将促使企业去重新思考。 2.行业 物联网带来的最大价值是能够解决复杂的物流、制造和公共部门问题。这意味着有些行业会比其他行业更快地得到切实的好处: 公共部门——随着人类、数据和事物之间的连结越来越紧密,智慧城市将会出现,传感器和自动化技术增强了服务的可靠性,特别是在安全和环境方面。物联网传感器数据的应用情形包括,改善空气质量、优化交通路线、减少安全事故、交通火灾事件预测,以及增强公民身份认证等。 制造业——将继续保持其领先的物联网行业地位,预测性维护应用促进了该行业的转型。企业将继续投资,以改善运营,提高对设备停机的预测能力。 运输行业——特别是航空公司和机场,将继续推广物联网数据的应用。这一行业将利用实时的机场、飞机、气象传感器和旅客信息进行创新,以改善运营,让旅客有更好的体验。 3.云 云计算支持实现灵活的业务新模式,使得中小企业更容易采用物联网。对于大企业,云投资有利于协调全局数据集成。例如,AWS物联网可以作为分散在各处的设备、资产和传感器的中心平台。将这些与安全和数据获取结合起来,云将有助于物联网的成功。 数字化转型举措,特别是围绕客户体验的举措,将加速物联网的扩展。建设技术基础设施相对容易,面临的挑战是实施影响业务健康的数据驱动型决策。传统上,企业在基础设施上投入大量资金,然后开展IT和安全数据驱动的应用。刚刚开始整合物联网数据的企业会提出这些问题——怎样创新;怎样利用现有的新信息来提高收益,实现更好的客户体验? 4.机器学习 机器学习和人工智能为物联网带来了巨大的发展机遇。传感器设备的日益商品化和规模化将推动智能产业的新浪潮,对现有产业产生重大影响。能够预测机器什么时候需要修理,自我优化生产和需求响应便是这方面的几个应用实例。 随着现有网络基础设施将被用于“连接物体”,当企业寻找新方法来挖掘智能设备生成的大量数据时,会进一步加大对分析技术的投资。工业资产管理、运输车队管理、库存管理和政府安全将是2018年物联网发展最热门的领域。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

实战Kibana的日志关键词搜索和日志可视化

准备工作 首先,先下载一个elastic网站上下载一个它提供的demo---莎翁的《亨利四世》,下载地址是https://download.elastic.co/demos/kibana/gettingstarted/shakespeare.json。 打开这个json字符串,里面就是《亨利四世》的话剧剧本,长得是这个样子: 可以看到里面有“play_name”、"speaker"、"speech_number"、"line_id"等等名称,每个名称后面都有一个对应的值。 然后启动elasticsearch,按照上面的文件格式生成索引。语句如下: curl-XPUThttp://localhost:9200/shakespeare-d' { "mappings":{ "_default_":{ "properties":{ "speaker":{"type":"string","index":"not_analyzed"},#确定type是字符 "play_name":{"type":"string","index":"not_analyzed"}, "line_id":{"type":"integer"},#确定type是数字 "speech_number":{"type":"integer"} } } } } '; 导入刚刚下载的那个json: 1 curl-XPOST 'localhost:9200/shakespeare/_bulk?pretty' --data-binary@shakespeare.json 具体elasticsearch的增删改查语法可以参看阮大师的http://www.ruanyifeng.com/blog/2017/08/elasticsearch.html,个人建议将elasticsearch和mysql对比一下,这样更方便理解。 然后后台启动kibana,确认5601端口已经stand by,如图: 然后在浏览器地址栏输入“服务器外网ip:5601”打开kibana。 导入数据结束之后,使用#curl 'localhost:9200/_cat/indices?v',去查看一下效果,如果看到index里有shakespeare那一栏就是导入成功了,如图: 在启动Kibana后,Kibana会自动在配置的es中创建一个名为.kibana的索引(上图第二个),这个索引用来存储数据,注意!不要删除了它。 Kibana的界面搜索 如果此时的kibana里是第一次配置的话,那么第一步就是配置新索引,我们之前在生成索引的时候写的是shakespeare,那么现在也写shakespeare,然后点击create,如图: 然后在菜单栏左侧的discover里选择刚刚建立的“shakespeare”,就会看到这样的东西: 在Search上就可以进行搜寻,比如说我搜寻"freedom",如图: 如果我搜寻“KING HENRY IV”,他不分大小写的把所有king、henry、iv都搜索出来。 如果我想搜寻line_id的第一行到第三行,那么语句就是line_id:[1 TO 3],如图: 如果想在上面的基础上进一步细化,比如说要在line_id是从第一行到第三行,同时_type是scene的语句:line_id:[1 TO 3] AND _type:scene: 假如不想要scene,那么就把AND改成NOT。 如果这个时候只想关注一些指定的字段,那么可以将鼠标移动到索引下面的字段上,然后选在add即可,同样的移动上面已经选择的字段选择remove进行移除,比如我们试一下这个speaker: add之后在点击右侧的具体的speaker,就会看到里面的细节,比如这位westmoreland(威斯摩兰伯爵): 这个时候就能看见这位伯爵大哥的台词细节,在第几场的第几节,说的是什么台词。再返回菜单左侧点击这个speaker,我们还会看到一个比重: 从这里就很清晰的看到,FALSTAFF(法斯塔夫)这个哥们的台词最多,也符合书里塑造的那个嗜酒话痨的艺术形象。而我们的KING HENRY IV(亨利四世)的台词只是第四位,占比重11%而已... 这样具体的搭配搜索之后,可以点击界面右上侧的save进行保存搜寻结果,再搭配share分享搜索结果的url网址,如图: Kibana的图像化展示 Kibana也能做到类似grafana那样的炫酷图象化展示,更加立体的表现日志情况,首先选择左侧菜单栏里的“Visualize”(可视化): 然后点击“Create a Visualization”,里面既有很多种图形供你选择,有饼型,有箭头的,有文字的,有仪表盘的,如图: 我们这里先建立一个饼型的,还是上面那个台词多少的例子,首先选择"shakespeare"作为数据源,然后点击“split slices”,如图: 然后在Aggergation里选择“Terms”,然后在Field里选择“Speaker”,size那里写8,最后点击上面的那个三角播放键,看看结果: 这就很清晰的看出,亨利四世一共说了1086句话,占比11.11%。 如果我们再加一个“Split Slices",这一次在原有的specker的基础上选择“play_name”,图象变成了一个同心圆,最外面的一层就是新增的“play_name”的情况,如图显示FALSTAFF的所有台词会在两个play_name里出现: 如果这个盘子里不想统计FALSTAFF这个话包,就添加一个过滤器,选择speaker is not,后面写上FALSTAFF即可,如图: 效仿刚才的方法也可以做一个仪表盘,如图: 可视化的数据也可以save和share,同样在web界面的右上角。保存的数据是可以在左侧菜单栏里的Dashboard里展示,做成一个类似zabbix那样的展示! 最后的最后,如果您觉得本文对您升职加薪有帮助,那么请不吝赞助之手,刷一下下面的二维码,赞助本人继续写更多的博文! 本文转自 苏幕遮618 51CTO博客,原文链接:http://blog.51cto.com/chenx1242/2049350
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册