首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6139篇文章
优秀的个人博客,低调大师

Android 的这 13 道 ContentProvider 面试题,你都会了吗?

前言 作为 Android 的四大组件之一,ContentProvider 可以说是无处不在了。 但是对于我而言,开发过程中看似 ContentProvider 用得很娴熟,却一直没能形成一个完整的体系。 也许大家也有着和我类似的烦恼,于是我特地花了几天的时间,总结了我所知道的知识点,以及面试中可能遇到的问题。将本文分享给大家,希望能帮助大家重新梳理下我们的这个老朋友 ContentProvider 。 希望大家阅读愉快! 文章目录 ContentProvider 应用程序间非常通用的共享数据的一种方式,也是 Android 官方推荐的方式。 Android 中许多系统应用都使用该方式实现数据共享,比如通讯录、短信等。 1.1 Android 为什么要设计 ContentProvider 这个组件? 很多做 Android 开发的人都不怎么使用它,觉得直接读取数据库会更简单方便。 那么 Android 搞一个内容提供者在数据和应用之间,只是为了装高大上,故弄玄虚?我认为其设计用意在于: 封装。对数据进行封装,提供统一的接口,使用者完全不必关心这些数据是在 DB ,XML 、Preferences 或者网络请求来的。当项目需求要改变数据来源时,使用我们的地方完全不需要修改。 提供一种跨进程数据共享的方式。 应用程序间的数据共享还有另外的一个重要话题,就是数据更新通知机制了。因为数据是在多个应用程序中共享的,当其中一个应用程序改变了这些共享数据的时候,它有责任通知其它应用程序,让它们知道共享数据被修改了,这样它们就可以作相应的处理。 1.2 如何访问自定义 ContentProvider ContentResolver 接口的 notifyChange 函数来通知那些注册了监控特定 URI的ContentObserver 对象,使得它们可以相应地执行一些处理。 ContentObserver 可以通过 registerContentObserver 进行注册。 通过 ContentProvider 的 Uri 访问开放的数据。 ContenResolver 对象通过 Context 提供的方法 getContenResolver() 来获得。 ContenResolver 提供了以下方法来操作:insert delete update query 这些方法分别会调用 ContenProvider 中与之对应的方法并得到返回的结果。 1.3 通过 ContentResolver 获取 ContentProvider 内容的基本步骤 得到 ContentResolver 类对象:ContentResolver cr = getContentResolver ( )。 定义要查询的字段 String 数组。 使用 cr.query() ; 返回一个 Cursor 对象。 使用 while 循环得到 Cursor 里面的内容。 1.4 ContentProvider 是如何实现数据共享的: 在 Android 中如果想将自己应用的数据 ( 一般多为数据库中的数据 ) 提供给第三发应用, 那么我们只能通过 ContentProvider 来实现了。 ContentProvider 是应用程序之间共享数据的接口。 使用的时候首先自定义 一个类继承 ContentProvider , 然后覆写 query 、insert 、update 、delete 等 方法。 因为其是四大组件之一因此必须在 AndroidManifest 文件中进行注册。 把自己的数据通过 uri 的形式共享出去 android 系统下 不同程序 数据默认是不能共享访问 需要去实现一个类去继承 ContentProvider。 public class PersonContentProvider extends ContentProvider{ public boolean onCreate(){ } query(Url, String[], String, String[], String); insert(Uri,ContentValues); update(Uri,ContentValues,String[]); delete(Uri,String,String[]); } 1.5 为什么要用 ContentProvider ?它和 sql 的实现上有什么差别? ContentProvider 屏蔽了数据存储的细节 , 内部实现对用户完全透明 , 用户只需要关心操作数据的 uri 就可以了, ContentProvider 可以实现不同 app之间 共享。 Sql 也有增删改查的方法, 但是 sql 只能查询本应用下的数据库。 而 ContentProvider 还可以去增删改查本地文件. xml 文件的读取等。 1.6 Uri 介绍 为系统的每一个资源给其一个名字,比方说通话记录。 每一个 ContentProvider 都拥有一个公共的 URI ,这个 URI 用于表示这个 ContentProvider 所提供的数据。 Android 所提供的 ContentProvider 都存放在 android.provider 包中。 将其分为 A,B,C,D 4个部分: A:标准前缀,用来说明一个 Content Provider 控制这些数据,无法改变的;"content://"; B:URI 的标识,用于唯一标识这个 ContentProvider ,外部调用者可以根据这个标识来找到它。它定义了是哪个 ContentProvider 提供这些数据。对于第三方应用程序,为了保证 URI 标识的唯一性,它必须是一个完整的、小写的类名。这个标识在元素的 authorities 属性中说明:一般是定义该 ContentProvider 的包类的名称; C:路径( path ),通俗的讲就是你要操作的数据库中表的名字,或者你也可以自己定义,记得在使用的时候保持一致就可以了;"content://com.bing.provider.myprovider/tablename"。 D:如果URI中包含表示需要获取的记录的 ID;则就返回该id对应的数据,如果没有 ID,就表示返回全部; "content://com.bing.provider.myprovider/tablename/#" # 表示数据 id 。 1.7 如何访问 asserts 资源目录下的数据库? 把数据库 db 复制到 /data/data/packagename/databases/ 目录下, 然后直接就能访问了。 1.8 多个进程同时调用一个 ContentProvider 的 query 获取数据,ContentPrvoider 是如何反应的呢? 一个 ContentProvider 可以接受来自另外一个进程的数据请求。 尽管 ContentResolver 与 ContentProvider 类隐藏了实现细节,但是 ContentProvider 所提供的 query(),insert(),delete(),update() 都是在 ContentProvider 进程的线程池中被调用执行的,而不是进程的主线程中。 这个线程池是有 Binder 创建和维护的,其实使用的就是每个应用进程中的 Binder 线程池。 1.9 Android 设计 ContentProvider 的目的是什么呢? 隐藏数据的实现方式,对外提供统一的数据访问接口; 更好的数据访问权限管理。ContentProvider 可以对开发的数据进行权限设置,不同的 URI 可以对应不同的权限,只有符合权限要求的组件才能访问到 ContentProvider 的具体操作。 ContentProvider 封装了跨进程共享的逻辑,我们只需要 Uri 即可访问数据。由系统来管理 ContentProvider 的创建、生命周期及访问的线程分配,简化我们在应用间共享数据( 进程间通信 )的方式。我们只管通过 ContentResolver 访问 ContentProvider 所提示的数据接口,而不需要担心它所在进程是启动还是未启动。 1.10 运行在主线程的 ContentProvider 为什么不会影响主线程的UI操作? ContentProvider 的 onCreate() 是运行在 UI 线程的,而 query() ,insert() ,delete() ,update() 是运行在线程池中的工作线程的 所以调用这向个方法并不会阻塞 ContentProvider 所在进程的主线程,但可能会阻塞调用者所在的进程的 UI 线程! 所以,调用 ContentProvider 的操作仍然要放在子线程中去做。 虽然直接的 CRUD 的操作是在工作线程的,但系统会让你的调用线程等待这个异步的操作完成,你才可以继续线程之前的工作。 1.11 外提供数据共享,那么如何限制对方的使用呢? android:exported 属性非常重要。这个属性用于指示该服务是否能够被其他应用程序组件调用或跟它交互。 如果设置为 true,则能够被调用或交互,否则不能。 设置为 false 时,只有同一个应用程序的组件或带有相同用户 ID 的应用程序才能启动或绑定该服务。 对于需要开放的组件应设置合理的权限,如果只需要对同一个签名的其它应用开放 ContentProvider ,则可以设置 signature 级别的权限。 大家可以参考一下系统自带应用的代码,自定义了 signature 级别的 permission : <permission android:name="com.android.gallery3d.filtershow.permission.READ" android:protectionLevel="signature" /> <permission android:name="com.android.gallery3d.filtershow.permission.WRITE" android:protectionLevel="signature" /> <provider android:name="com.android.gallery3d.filtershow.provider.SharedImageProvider" android:authorities="com.android.gallery3d.filtershow.provider.SharedImageProvider" android:grantUriPermissions="true" android:readPermission="com.android.gallery3d.filtershow.permission.READ" android:writePermission="com.android.gallery3d.filtershow.permission.WRITE" /> 1.11.1 如果我们只需要开放部份的 URI 给其他的应用访问呢? 可以参考 Provider 的 URI 权限设置,只允许访问部份 URI ,可以参考原生 ContactsProvider2 的相关代码( 注意 path-permission 这个选项 ): <provider android:name="ContactsProvider2" android:authorities="contacts;com.android.contacts" android:label="@string/provider_label" android:multiprocess="false" android:exported="true" android:grantUriPermissions="true" android:readPermission="android.permission.READ_CONTACTS" android:writePermission="android.permission.WRITE_CONTACTS"> <path-permission android:pathPrefix="/search_suggest_query" android:readPermission="android.permission.GLOBAL_SEARCH" /> <path-permission android:pathPrefix="/search_suggest_shortcut" android:readPermission="android.permission.GLOBAL_SEARCH" /> <path-permission android:pathPattern="/contacts/.*/photo" android:readPermission="android.permission.GLOBAL_SEARCH" /> <grant-uri-permission android:pathPattern=".*" /> </provider> 1.12 ContentProvider 接口方法运行在哪个线程中呢? ContentProvider 可以在 AndroidManifest.xml 中配置一个叫做 android:multiprocess 的属性,默认值是 false ,表示 ContentProvider 是单例的 无论哪个客户端应用的访问都将是同一个 ContentProvider 对象,如果设为 true ,系统会为每一个访问该 ContentProvider 的进程创建一个实例。 1.12.1 这点还是比较好理解的,那如果我要问每个 ContentProvider 的操作是在哪个线程中运行的呢?( 其实我们关心的是 UI 线程和工作线程 ) 比如我们在UI线程调用getContentResolver().query查询数据,而当数据量很大时(或者需要进行较长时间的计算)会不会阻塞UI线程呢? 要分两种情况回答这个问题: ContentProvider 和调用者在同一个进程,ContentProvider 的方法( query/insert/update/delete 等 )和调用者在同一线程中; ContentProvider 和调用者在不同的进程,ContentProvider 的方法会运行在它自身所在进程的一个 Binder 线程中。 但是,注意这两种方式在 `ContentProvider` 的方法没有执行完成前都会 `blocked` 调用者。所以你应该知道这个上面这个问题的答案了吧。 也可以看看 CursorLoader 这个类的源码,看 Google 自己是怎么使用 getContentResolver().query 的。 1.13 ContentProvider 是如何在不同应用程序之间传输数据的? 一个应用进程有 16 个 Binder 线程去和远程服务进行交互,而每个线程可占用的缓存空间是 128KB 这样,超过会报异常。 ContentResolver 虽然是通过 Binder 进程间通信机制打通了应用程序之间共享数据的通道,但 ContentProvider 组件在不同应用程序之间传输数据是基于匿名共享内存机制来实现的。 有兴趣的可以查看一下老罗的文章Android系统匿名共享内存Ashmem(Anonymous Shared Memory)简要介绍和学习计划。 总结 在这篇文章中,我对我所知道的 ContentProvider 知识总进行了详细的总结,希望大家通过本次阅读都能有所收获。 重点:学 Android 有一段时间了,我打算好好的梳理一下所学知识,到现在为止,我才总结完 Activity 、Service 、BroadcastRecevier 等,有关 事件分发、滑动冲突、新能优化等重要模块,后面也将详尽的总结,欢迎大家关注,方便及时接收更新 。 如果有可以补充的知识点,欢迎大家在评论区指出。 最后 今天分享的面试题就到这里,还是那句话,有些东西你不仅要懂,而且要能够很好地表达出来,能够让面试官认可你的理解,例如Handler机制,这个是面试必问之题。有些晦涩的点,或许它只活在面试当中,实际工作当中你压根不会用到它,但是你要知道它是什么东西。 不管怎么样,不论是什么样的大小面试,要想不被面试官虐的不要不要的,只有刷爆面试题题做好全面的准备,当然除了这个还需要在平时把自己的基础打扎实,这样不论面试官怎么样一个知识点里往死里凿,你也能应付如流啊~

优秀的个人博客,低调大师

消息中间件面试题31道RabbitMQ+ActiveMQ+Kafka

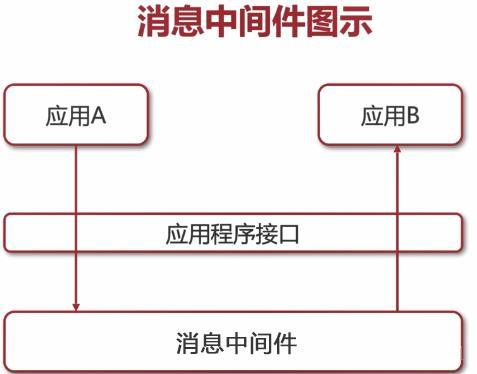
前言 文章开始前,我们先了解一下什么是消息中间件? 什么是中间件? 非底层操作系统软件,非业务应用软件,不是直接给最终用户使用的,不能直接给客户带来价值的软件统称为中间件。 什么是消息中间件? 是关注于数据的发送和接收,利用高效可靠的异步消息传递机制集成分布式系统 图示: 消息中间件RabbitMQ+ActiveMQ+Kafka的对比 接下来就是消息中间件面试题RabbitMQ+ActiveMQ+Kafka RabbitMQ消息中间件系列 1:RabbitMQ 中的 broker 是指什么?cluster 又是指什么? 答:broker 是指一个或多个 erlang node 的逻辑分组,且 node 上运行着 RabbitMQ 应用程序。cluster 是在 broker 的基础之上,增加了 node 之间共享元数据的约束。 2:什么是元数据?元数据分为哪些类型?包括哪些内容?与 cluster 相关的元数据有哪些?元数据是如何保存的?元数据在 cluster 中是如何分布的? 答:在非 cluster 模式下,元数据主要分为 Queue 元数据(queue 名字和属性等)、Exchange 元数据(exchange 名字、类型和属性等)、Binding 元数据(存放路由关系的查找表)、Vhost 元数据(vhost 范围内针对前三者的名字空间约束和安全属性设置)。在cluster 模式下,还包括 cluster 中 node 位置信息和 node 关系信息。元数据按照 erlang node 的类型确定是仅保存于 RAM 中,还是同时保存在 RAM 和 disk 上。元数据在cluster 中是全 node 分布的。 3:RAM node 和 disk node 的区别? 答:RAM node 仅将 fabric(即 queue、exchange 和 binding 等 RabbitMQ 基础构件)相关元数据保存到内存中,但 disk node 会在内存和磁盘中均进行存储。RAM node 上唯一会存储到磁盘上的元数据是 cluster 中使用的 disk node 的地址。要求在 RabbitMQ cluster 中至少存在一个 disk node 。 4:RabbitMQ 上的一个 queue 中存放的 message 是否有数量限制? 答:可以认为是无限制,因为限制取决于机器的内存,但是消息过多会导致处理效率的下降。 5:RabbitMQ 概念里的 channel、exchange 和 queue 这些东东是逻辑概念,还是对应着进程实体?这些东东分别起什么作用? 答:queue 具有自己的 erlang 进程;exchange 内部实现为保存 binding 关系的查找表; channel 是实际进行路由工作的实体,即负责按照 routing_key 将 message 投递给queue 。由 AMQP 协议描述可知,channel 是真实 TCP 连接之上的虚拟连接,所有AMQP 命令都是通过 channel 发送的,且每一个 channel 有唯一的 ID。一个 channel 只能被单独一个操作系统线程使用,故投递到特定 channel 上的 message 是有顺序的。但一个操作系统线程上允许使用多个 channel 。channel 号为 0 的 channel 用于处理所有对于当前 connection 全局有效的帧,而 1-65535 号 channel 用于处理和特定 channel 相关的帧。 其中每一个 channel 运行在一个独立的线程上,多线程共享同一个 socket。 6:vhost 是什么?起什么作用? 答:vhost 可以理解为虚拟 broker ,即 mini-RabbitMQ server。其内部均含有独立的 queue、exchange 和 binding 等,但最最重要的是,其拥有独立的权限系统,可以做到vhost 范围的用户控制。当然,从 RabbitMQ 的全局角度,vhost 可以作为不同权限隔离的手段(一个典型的例子就是不同的应用可以跑在不同的 vhost 中)。 7:为什么 heavy RPC 的使用场景下不建议采用 disk node ? 答:heavy RPC 是指在业务逻辑中高频调用 RabbitMQ 提供的 RPC 机制,导致不断创建、销毁 reply queue ,进而造成 disk node 的性能问题(因为会针对元数据不断写盘)。所以在使用 RPC 机制时需要考虑自身的业务场景。 8:向不存在的 exchange 发 publish 消息会发生什么?向不存在的 queue 执行consume 动作会发生什么? 答:都会收到 Channel.Close 信令告之不存在(内含原因 404 NOT_FOUND)。 9:RabbitMQ 允许发送的 message 最大可达多大? 答:根据 AMQP 协议规定,消息体的大小由 64-bit 的值来指定,所以你就可以知道到底能发多大的数据了。 10:什么情况下 producer 不主动创建 queue 是安全的? 答:1.message是允许丢失的;2.实现了针对未处理消息的republish功能(例如采用Publisher Confirm 机制)。 11:“dead letter”queue 的用途? 答:当消息被 RabbitMQ server 投递到 consumer 后,但 consumer 却通过 Basic.Reject 进行了拒绝时(同时设置 requeue=false),那么该消息会被放入“dead letter”queue 中。该 queue 可用于排查 message 被 reject 或 undeliver 的原因。 12:为什么说保证 message 被可靠持久化的条件是 queue 和 exchange 具有durable 属性,同时 message 具有 persistent 属性才行? 答:binding 关系可以表示为 exchange – binding – queue 。从文档中我们知道,若要求投递的 message 能够不丢失,要求 message 本身设置 persistent 属性,要求 exchange 和 queue 都设置 durable 属性。其实这问题可以这么想,若 exchange 或 queue 未设置durable 属性,则在其 crash 之后就会无法恢复,那么即使 message 设置了 persistent 属性,仍然存在 message 虽然能恢复但却无处容身的问题;同理,若 message 本身未设置persistent 属性,则 message 的持久化更无从谈起。 13:什么情况下会出现 blackholed 问题? 答:blackholed 问题是指,向 exchange 投递了 message ,而由于各种原因导致该message 丢失,但发送者却不知道。可导致 blackholed 的情况:1.向未绑定 queue 的exchange 发送 message;2.exchange 以 binding_key key_A 绑定了 queue queue_A,但向该 exchange 发送 message 使用的 routing_key 却是 key_B。 14:如何防止出现 blackholed 问题? 答:没有特别好的办法,只能在具体实践中通过各种方式保证相关 fabric 的存在。另外, 如果在执行 Basic.Publish 时设置 mandatory=true ,则在遇到可能出现 blackholed 情况时,服务器会通过返回 Basic.Return 告之当前 message 无法被正确投递(内含原因 312 NO_ROUTE)。 15:Consumer Cancellation Notification 机制用于什么场景? 答:用于保证当镜像 queue 中 master 挂掉时,连接到 slave 上的 consumer 可以收到自身 consume 被取消的通知,进而可以重新执行 consume 动作从新选出的 master 出获得消息。若不采用该机制,连接到 slave 上的 consumer 将不会感知 master 挂掉这个事情,导致后续无法再收到新 master 广播出来的 message 。另外,因为在镜像 queue 模式下,存在将 message 进行 requeue 的可能,所以实现 consumer 的逻辑时需要能够正确处理出现重复 message 的情况。 ActiveMQ消息中间件系列 1.什么是 ActiveMQ? activeMQ 是一种开源的,实现了 JMS1.1 规范的,面向消息(MOM)的中间件,为应用程序提供高效的、可扩展的、稳定的和安全的企业级消息通信 2.ActiveMQ 服务器宕机怎么办? 这得从 ActiveMQ 的储存机制说起。在通常的情况下,非持久化消息是存储在内存中的,持久化消息是存储在文件中的,它们的最大限制在配置文件的节点中配置。但是,在非持久化消息堆积到一定程度,内存告急的时候,ActiveMQ 会将内存中的非持久化消息写入临时文件中,以腾出内存。虽然都保存到了文件里,但它和持久化消息的区别是,重启后持久化消息会从文件中恢复,非持久化的临时文件会直接删除。 那如果文件增大到达了配置中的最大限制的时候会发生什么?我做了以下实验: 设置 2G 左右的持久化文件限制,大量生产持久化消息直到文件达到最大限制,此时生产者阻塞,但消费者可正常连接并消费消息,等消息消费掉一部分,文件删除又腾出空间之后,生产者又可继续发送消息, 服务自动恢复正常。 设置 2G 左右的临时文件限制,大量生产非持久化消息并写入临时文件,在达到最大限制时,生产者阻塞,消费者可正常连接但不能消费消息,或者原本慢速消费的消费者,消费突然停止。整个系统可连接, 但是无法提供服务,就这样挂了。 具体原因不详,解决方案:尽量不要用非持久化消息,非要用的话,将临时文件限制尽可能的调大。 3.丢消息怎么办? 这得从 java 的 java.net.SocketException 异常说起。简单点说就是当网络发送方发送一堆数据,然后调用 close 关闭连接之后。这些发送的数据都在接收者的缓存里,接收者如果调用 read 方法仍旧能从缓存中读取这些数据,尽管对方已经关闭了连接。但是当接收者尝试发送数据时,由于此时连接已关闭,所以会发生异常,这个很好理解。不过需要注意的是,当发生 SocketException 后,原本缓存区中数据也作废了,此时接收者再次调用 read 方法去读取缓存中的数据,就会报 Software caused connection abort: recv failed 错误。 通过抓包得知,ActiveMQ 会每隔 10 秒发送一个心跳包,这个心跳包是服务器发送给客户端的,用来判断客户端死没死。如果你看过上面第一条,就会知道非持久化消息堆积到一定程度会写到文件里,这个写的过程会阻塞所有动作,而且会持续 20 到 30 秒,并且随着内存的增大而增大。当客户端发完消息调用connection.close()时,会期待服务器对于关闭连接的回答,如果超过 15 秒没回答就直接调用 socket 层的 close 关闭 tcp 连接了。这时客户端发出的消息其实还在服务器的缓存里等待处理,不过由于服务器心跳包的设置,导致发生了 java.net.SocketException 异常,把缓存里的数据作废了,没处理的消息全部丢失。 解决方案:用持久化消息,或者非持久化消息及时处理不要堆积,或者启动事务,启动事务后, commit()方法会负责任的等待服务器的返回,也就不会关闭连接导致消息丢失了。 4.持久化消息非常慢。 默认的情况下,非持久化的消息是异步发送的,持久化的消息是同步发送的,遇到慢一点的硬盘,发送消息的速度是无法忍受的。但是在开启事务的情况下,消息都是异步发送的,效率会有 2 个数量级的提升。所以在发送持久化消息时,请务必开启事务模式。其实发送非持久化消息时也建议开启事务,因为根本不会影响性能。 5.消息的不均匀消费。 有时在发送一些消息之后,开启 2 个消费者去处理消息。会发现一个消费者处理了所有的消息,另一个消费者根本没收到消息。原因在于 ActiveMQ 的 prefetch 机制。当消费者去获取消息时,不会一条一条去获取,而是一次性获取一批,默认是 1000 条。这些预获取的消息,在还没确认消费之前,在管理控制台还是可以看见这些消息的,但是不会再分配给其他消费者,此时这些消息的状态应该算作“已分配未消 费”,如果消息最后被消费,则会在服务器端被删除,如果消费者崩溃,则这些消息会被重新分配给新的消费者。但是如果消费者既不消费确认,又不崩溃,那这些消息就永远躺在消费者的缓存区里无法处理。更通常的情况是,消费这些消息非常耗时,你开了 10 个消费者去处理,结果发现只有一台机器吭哧吭哧 处理,另外 9 台啥事不干。 解决方案:将 prefetch 设为 1,每次处理 1 条消息,处理完再去取,这样也慢不了多少。 6.死信队列。 如果你想在消息处理失败后,不被服务器删除,还能被其他消费者处理或重试,可以关闭AUTO_ACKNOWLEDGE,将 ack 交由程序自己处理。那如果使用了 AUTO_ACKNOWLEDGE,消息是什么时候被确认的,还有没有阻止消息确认的方法?有! 消费消息有 2 种方法,一种是调用 consumer.receive()方法,该方法将阻塞直到获得并返回一条消息。这种情况下,消息返回给方法调用者之后就自动被确认了。另一种方法是采用 listener 回调函数,在有消息到达时,会调用 listener 接口的 onMessage 方法。在这种情况下,在 onMessage 方法执行完毕后, 消息才会被确认,此时只要在方法中抛出异常,该消息就不会被确认。那么问题来了,如果一条消息不能被处理,会被退回服务器重新分配,如果只有一个消费者,该消息又会重新被获取,重新抛异常。就算有多个消费者,往往在一个服务器上不能处理的消息,在另外的服务器上依然不能被处理。难道就这么退回 –获取–报错死循环了吗? 在重试 6 次后,ActiveMQ 认为这条消息是“有毒”的,将会把消息丢到死信队列里。如果你的消息不见了,去 ActiveMQ.DLQ 里找找,说不定就躺在那里。 Kafka消息中间件系列 1.Kafka 的设计时什么样的呢? Kafka 将消息以 topic 为单位进行归纳 将向 Kafka topic 发布消息的程序成为 producers. 将预订 topics 并消费消息的程序成为 consumer. Kafka 以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个 broker. producers 通过网络将消息发送到 Kafka 集群,集群向消费者提供消息 2.数据传输的事物定义有哪三种? 数据传输的事务定义通常有以下三种级别: (1)最多一次: 消息不会被重复发送,最多被传输一次,但也有可能一次不传输 (2)最少一次: 消息不会被漏发送,最少被传输一次,但也有可能被重复传输. (3)精确的一次(Exactly once):不会漏传输也不会重复传输,每个消息都传输被一次而且仅仅被传输一次,这是大家所期望的 3.Kafka 判断一个节点是否还活着有那两个条件? (1)节点必须可以维护和 ZooKeeper 的连接,Zookeeper 通过心跳机制检查每个节点的连接 (2)如果节点是个 follower,他必须能及时的同步 leader 的写操作,延时不能太久 4.producer 是否直接将数据发送到 broker 的 leader(主节点)? producer 直接将数据发送到 broker 的 leader(主节点),不需要在多个节点进行分发,为了帮助 producer 做到这点,所有的 Kafka 节点都可以及时的告知:哪些节点是活动的,目标topic 目标分区的 leader 在哪。这样 producer 就可以直接将消息发送到目的地了 5、Kafa consumer 是否可以消费指定分区消息? Kafaconsumer 消费消息时,向 broker 发出"fetch"请求去消费特定分区的消息,consumer 指定消息在日志中的偏移量(offset),就可以消费从这个位置开始的消息,customer 拥有了 offset 的控制权,可以向后回滚去重新消费之前的消息,这是很有意义的 6、Kafka 消息是采用 Pull 模式,还是 Push 模式? Kafka 最初考虑的问题是,customer 应该从 brokes 拉取消息还是 brokers 将消息推送到consumer,也就是 pull 还 push。在这方面,Kafka 遵循了一种大部分消息系统共同的传统的设计:producer 将消息推送到 broker,consumer 从 broker 拉取消息 一些消息系统比如 Scribe 和 ApacheFlume 采用了 push 模式,将消息推送到下游的consumer。这样做有好处也有坏处:由 broker 决定消息推送的速率,对于不同消费速率的consumer 就不太好处理了。消息系统都致力于让 consumer 以最大的速率最快速的消费消息,但不幸的是,push 模式下,当 broker 推送的速率远大于 consumer 消费的速率时, consumer 恐怕就要崩溃了。最终 Kafka 还是选取了传统的 pull 模式 Pull 模式的另外一个好处是 consumer 可以自主决定是否批量的从 broker 拉取数据。Push 模式必须在不知道下游 consumer 消费能力和消费策略的情况下决定是立即推送每条消息还是缓存之后批量推送。如果为了避免 consumer 崩溃而采用较低的推送速率,将可能导致一次只推送较少的消息而造成浪费。Pull 模式下,consumer 就可以根据自己的消费能力去决 定这些策略 Pull 有个缺点是,如果 broker 没有可供消费的消息,将导致 consumer 不断在循环中轮询, 直到新消息到 t 达。为了避免这点,Kafka 有个参数可以让 consumer 阻塞知道新消息到达(当然也可以阻塞知道消息的数量达到某个特定的量这样就可以批量发 7.Kafka 的消费者如何消费数据 消费者每次消费数据的时候,消费者都会记录消费的物理偏移量(offset)的位置等到下次消费时,他会接着上次位置继续消费 8.消费者负载均衡策略 一个消费者组中的一个分片对应一个消费者成员,他能保证每个消费者成员都能访问,如果组中成员太多会有空闲的成员 9.数据有序 一个消费者组里它的内部是有序的消费者组与消费者组之间是无序的 10.kafaka 生产数据时数据的分组策略 生产者决定数据产生到集群的哪个 partition 中每一条消息都是以(key,value)格式 Key 是由生产者发送数据传入 所以生产者(key)决定了数据产生到集群的哪个 partition 喜欢文章记得点个赞,感谢支持!

优秀的个人博客,低调大师

刷完500道BAT面试题,我能去面试大厂了吗?

面试之前先刷几篇面经,或者做几道热门面试题,想必是大家很熟悉的一种复习方式了,就像我们当年经常做五年高考三年模拟一样。但是可不要把面试题和面经当成你的主要复习方式,它只是锦上添花,绝非雪中送炭! 壹面经的意义 面经是别人的面试经验,所谓前车之鉴,后事之师。我们可以通过面筋对自己的不足查缺补漏,却不能把这些面试题等同于我们所要掌握的知识点。原因很简单,两篇面经可能会有很多的重复知识点,100篇面经也无法包含所有知识点,所以在只刷面经的问题就是:重复多、不全面。 其实笔者以前也很喜欢刷面经,在面试前几天把该公司这个岗位的面经刷一遍,面试时还是可以遇到很多类似的问题的。这种做法短期内效果确实好,但是如果从长计议,只刷面经的复习方法实为下策。 作者在春招时才发现问题的严重性,吃了不少亏,简单来说就是:别人的面试题和面试总结看了又忘,忘了又看,本质性的东西没有掌握。 贰你还记得多少面试题 在春招刚刚结束的这段时间,我总结了一下春招面试过程中的一些问题,主要就是:之前学过的东西忘记了很多,特别是那些理解的不够深的知识点,总是特别容易忘记。另外我发现,虽然我在笔记中记录了很多的知识点和面试题,但是往往我只看过一次,不会再去看第二次。 这也意味着,虽然记录的内容很多,但是真正消化吸收的内容很少,脑子里充斥着总是那些零碎的知识点和面试问题,对于完整的知识体系知之甚少。这些问题在春招期间也不断地暴露出来,让我思考了很久。 面对如此窘境,我想做出改变,趁着现在时间充裕,我想要为这些内容做一次减法,并且借此机会,推翻自己原有的知识体系,重建新的知识框架。简单说来,就是重新开始学习Java后端,这次我要用一种更高效的方式,避免走之前走的弯路,要用最高效,最合理的方式去复习。由于我之前已经有基础,所以我对完成这一目标有信心,相应地我也为此做出了明确且详细的学习计划。 叁忘掉过去,重拾基础 忘记过去,才能更好地开始。当然,也不是真的要大家忘记以前学过的知识点,只是建议各位把之前学的不扎实的技术重新地学一遍,不要只凭着印象去记忆知识点。 前面提到我在秋招前完成了知识体系重建,那在这里我也想跟大家分享一下我当时大致的知识体系构成。就跟我前面说的一样,我选择重新再学一遍Java后端相关的技术内容,因为我知道大致的学习方向,并且有一定的基础,所以看很多文章变得更加得心应手,写文章和做总结也更加有底气了。 首先在Java基础方面,我写了20多篇原创博客,主要是对Java核心技术的解析,比如"Java反射"、"Java序列化和反序列化"、"Java异常体系"等等。 在Java集合类方面,我原创了部分文章,另外整合了一些比较好的技术文章,其中最主要的就是关于hashmap的文章,当时我整合的文章几乎没有遗漏任何一个知识点。 在Java并发编程方面,我主要参考了并发编程网以及一些优质博客的文章,先搞懂了Java并发原理,再一步步学习JUC并发包的组件,其中重点看了chm,并发工具类以及阻塞队列等JDK源码的解析文章,除此之外,我还会在IDE中跑JUC相关的emo,毕竟这方面的内容非常需要实践。 在Java网络编程方面,我先从最基础的socket入手,再讲到NIO,AIO,并且加入了几篇对Linux IO模型解析的文章,让整个知识体系更加完整(因为NIO是基于Linux Epoll实现的),接着我又加入了对Netty的探讨,以及Tomcat中对NIO的应用,可以说是把Java网络编程一些比较重要的部分都囊括进来了。为了更好理解这部分内容,我也在网上参考了很多客户端和服务端通信的demo,最后我分别用Socket,NIO,AIO以及Netty把C/S 通信的demo都写了一遍。 在JVM虚拟机方面,我则按照《深入理解JVM虚拟机》这本书的行文脉络进行文章的整理。在搞定JVM基本原理以后,我着重了解了JVM调优和实践中常遇到的问题,并且整理了常用的JVM调优工具,场景问题以及调优实践的案例,这也是因为面试中对JVM调优实践越来越重视了。 在JavaWeb方面,我从Java Web相关技术的发展入手,一步步了解了每种技术存在的意义,比如JSP,Servlet,JDBC,Spring等等,然后对每种技术进行了比较全面的了解,并且着重地看了Spring和SpringMVC的源码分析文章,另外一方面,我花了很多时间去研究Tomcat的工作原理。除此之外,JavaWeb项目中常用的maven,日志组件,甚至是单测试组件,也纳入了我的系列文章里。 在数据库和缓存方面,我主要学习了MySQL和Redis这两种最常用的数据库。对于Mysql,我从简单的sql开始了解,然后开始了解sql优化,MySQL的存储引擎和索引,事务及锁,还有更复杂的主从复制,分库分表等内容。对于Redis,我也是从简单的api入手,然后去了解每一种数据结构的底层实现原理,接着尝试去学习Redis的持久化方式,以及作为缓存常需要考虑的技术点,当然,也包括Redis的分布式锁实现,以及它的分布式集群方案。 最后一部分就是分布式相关的理论和技术了,这个也是困扰我很久的一块内容,我主要把这块内容分为两个部分,分别是分布式理论和分布式技术,理论方面,我先了解CAP,BASE等基本知识,然后开始学习一致性协议和算法,接着探讨分布式事务。 对于分布式技术,涉及的东西就更多了,例如分布式session,负载均衡,分布式锁等内容,这些知识点我都会用一到两篇文章去总结,对于分布式缓存,消息队列,以及分布式服务等内容,我会花比较多的时间去全面学习,然后总结出一个系列的文章出来。当然,对于这些技术的学习主要还是停留在理论方面,在自己的项目中能用到的比较少。 至此,我的知识体系基本构建完成,这也是我在秋招中能够成功闯过那么多面试的原因。 微信公众号【黄小斜】大厂程序员,互联网行业新知,终身学习践行者。关注后回复「Java」、「Python」、「C++」、「大数据」、「机器学习」、「算法」、「AI」、「Android」、「前端」、「iOS」、「考研」、「BAT」、「校招」、「笔试」、「面试」、「面经」、「计算机基础」、「LeetCode」 等关键字可以获取对应的免费学习资料。 ​

优秀的个人博客,低调大师

170道Java工程师面试题,你敢挑战吗?

1、面向对象的特征有哪些方面? 2、访问修饰符public,private,protected,以及不写(默认)时的区别? 3、String 是最基本的数据类型吗? 4、float f=3.4;是否正确? 5、short s1 = 1; s1 = s1 + 1;有错吗?short s1 = 1; s1 += 1;有错吗? 6、Java有没有goto? 7、int和Integer有什么区别? 8、&和&&的区别? 9、解释内存中的栈(stack)、堆(heap)和静态区(static area)的用法。 10、Math.round(11.5) 等于多少?Math.round(-11.5)等于多少? 11、switch 是否能作用在byte 上,是否能作用在long 上,是否能作用在String上? 12、用最

优秀的个人博客,低调大师

10秒构建阿里云产品的第一道监控屏障

前言 作为一个云上运维的新人,面对阿里云上复杂的生态系统,ECS、RDS、负载均衡、各种数据库等等,每一个服务下面都有无数的指标需要了解,那么如此高的学习成本,要花费多少时间才能完成准确建立起基本的云上监控报警体系,避免遗漏重要指标的报警呢? 业务快速迭代的过程中,购买的大量服务器如何快速被现有监控体系覆盖呢? 面对云监控应用分组、报警规则、各种云产品监控等等一系列高级功能,如何在学习过程中先对运维监控快速兜底呢? 如果你有以上烦恼,那么请继续阅读本文。10秒中让您的服务拥有最低成本的基础保护。在业务出问题时,让云监控通知你,而不是让你的老板或者客户通知你。 操作步骤 登录云监控,进入报警服务--一键报警功能,对需要设置报警的云产品开启一键报警按钮,完成设置! 点击服务右侧的下拉按钮,可能快速查看<一键告警>给您自动生成的规则,当然

优秀的个人博客,低调大师

WF4.0实战(十三):解微软一道面试题

题目:一个整数数列,元素取值可能是0—65535中的任意一个数,相同数值不会重复出现。0是例外,可以反复出现。 请设计一个算法,当你从该数列中随意选取5个数值,判断这5个数值是否连续相邻。 注意: 1、5个数值允许是乱序的。比如: 8 7 5 0 6; 2、0可以通配任意数值。比如:8 7 5 0 6 中的0可以通配成9或者4; 3、0可以多次出现; 4、复杂度如果是O(n2)则不得分。 分析:通过分析你可以发现,题目只要满足:除0之外的最大数减去除0之外的最小数小于等于4就行了。 故只要通过一个循环就5个数字中除0之外的最大数和最小数。求差之后与4做个比较就行了。伪代码如下: 1 public booleanisContiguous( int []array) 2 { 3 int min =- 1 ; 4 int max =- 1 ; 5 for ( int i = 0 ;i < array.length;i ++ ) 6 { 7 if (array[i] != 0 ) 8 { 9 if (min ==- 1 || min > array[i]) 10 { 11 min = array[i]; 12 } 13 if (max ==- 1 || max < array[i]) 14 { 15 max = array[i]; 16 } 17 } 18 } 19 return max - min <= array.length - 1 ; 20 } 下面让我用WF4.0来实现解这个题目,思路和上面代码思想是一致的。 流程: 实现: 1、产生随机数流程GenerateRandom流程,如下图: 2、验证产生的数字是否满足条件: 3、输出结果: 4、整个流程: 运行结果: 0~65535范围太大,很难产生出5位连续的数字,将范围缩小为1-6: 总结:这篇文章主要说明使用WF4.0和你写一般的C#代码一样,复杂的逻辑它也可以实现。一些复杂的算法可能会因为它的可视化编程而变得更简单。 本文转自麒麟博客园博客,原文链接:http://www.cnblogs.com/zhuqil/archive/2010/05/07/msInterview.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

追踪与合包,跨境物流系统的两道必答题

2026年夏天,红海航线的异常波动把跨境物流的脆弱性摊开了给人看。一艘叫Sea Majesty的油轮申报目的港为埃及艾因苏赫纳,实际却在沙特延布港装油,AIS信号关闭,靠吃水数据才被识破。这类绕过常规航道的操作,让原本经曼德海峡19天的航程,绕行好望角后拉长到48天。运费与时效双双失控,最终传导到终端消费者身上。跨境物流系统的选型,绕不开两个问题:货在哪,怎么合。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册