首页 文章 精选 留言 我的

精选列表

搜索[思考模型],共10000篇文章
优秀的个人博客,低调大师

应用系统瓶颈排查和分析的思考-Arthas 实战

作者 | 一啦米 【Arthas 官方社区正在举行征文活动,参加即有奖品拿~点击投稿】 背景 业务应用系统接入流程引擎来处理业务应用的流程执行,流程引擎提供多线程高性能异步化来执行流程元素的执行,但是如何设置流程引擎的线程池线程数执行,以及执行线程数和任务数,应用机器资源使用情况之间的关系如何,目前只能通过接入方的人工经验评估,比较粗泛评估,参数的合理性也很难直观的评估,现通过现有的应用系统默认的参数配置进行问题说明。 性能监控 查看 CPU 核数 应用机器的配置是 2 核 CPU 配置: 查看应用机器的负载情况 应用程序的近 15 分钟内的负载严重的超载(平均超出 CPU 执行的 10 倍之多),应用程序对应的 CPU 和 MEM 的利用率都很高,按照本次单机模拟线上的流量(QPS:10) 不至于出现如此的负载情况吧。 查看应用机器的综合统计 CPU 运行队列中也严重的堵筛(Procs列中指标),应用的 CPU 有效利用率其实并不算太高(US+SY),但是系统出现了严重的 CS(上下文切换),配合 BI,BO 执行,也间接反馈出一些端倪,具体反馈到应用程序中,还需要进一步分析。 查看应用服务(PID=512)的进程 CPU 执行情况 查看应用机器的磁盘 IO 使用情况 应用系统的线程统计概要 应用系统中居然有如此多的线程(1285),应用系统接入流程 SDK 中的线程池数据设置也不会超过80个线程,为何有如何大的偏差,考虑到应用系统中还存在 RPC,kafka 等相关的技术栈,对于应用系统的线程分布还需要进一步的分析。 应用系统执行 dashboard GC 回收线程监控统计 应用系统线程执行栈的统计 阻塞线程 ThreadDump 信息 org.apache.log4j.spi.RootLoggeris blocking 379 threads. Pigeon-Server-Request-Processor-46-thread-318Stack Trace is:java.lang.Thread.State: RUNNABLEat java.lang.Throwable.printStackTrace(Throwable.java:665) locked <0x000000075332fde8> (a java.io.PrintWriter) java.lang.Throwable.printStackTrace(Throwable.java:721) at org.apache.log4j.DefaultThrowableRenderer.render(DefaultThrowableRenderer.java:60)at org.apache.log4j.spi.ThrowableInformation.getThrowableStrRep(ThrowableInformation.java:87) locked <0x000000074ae96550> (a org.apache.log4j.spi.ThrowableInformation) org.apache.log4j.spi.LoggingEvent.getThrowableStrRep(LoggingEvent.java:413) at org.apache.log4j.WriterAppender.subAppend(WriterAppender.java:313)at org.apache.log4j.WriterAppender.append(WriterAppender.java:162)at com.dianping.combiz.misc.ExtendedConsoleAppender.append(ExtendedConsoleAppender.java:82)at org.apache.log4j.AppenderSkeleton.doAppend(AppenderSkeleton.java:251) eliminated <0x000000075f880030> (a com.dianping.combiz.misc.ExtendedConsoleAppender) com.dianping.combiz.misc.ExtendedConsoleAppender.doAppend(ExtendedConsoleAppender.java:75) locked <0x000000075f880030> (a com.dianping.combiz.misc.ExtendedConsoleAppender) org.apache.log4j.helpers.AppenderAttachableImpl.appendLoopOnAppenders(AppenderAttachableImpl.java:66) at org.apache.log4j.Category.callAppenders(Category.java:206)- locked <0x000000075ed2bd58> (a org.apache.log4j.spi.RootLogger)at org.apache.log4j.Category.forcedLog(Category.java:391)at org.apache.log4j.Category.log(Category.java:856)at org.slf4j.impl.Log4jLoggerAdapter.error(Log4jLoggerAdapter.java:576)at com.meituan.mafka.client.producer.DefaultProducerProcessor.doSend(DefaultProducerProcessor.java:832)at com.meituan.mafka.client.producer.DefaultProducerProcessor.sendMessage(DefaultProducerProcessor.java:603)at com.meituan.mafka.client.producer.DefaultProducerProcessor.sendMessage(DefaultProducerProcessor.java:584)at com.meituan.mafka.client.producer.DefaultProducerProcessor.sendMessage(DefaultProducerProcessor.java:567)at com.meituan.mafka.client.producer.DefaultProducerProcessor.sendMessage(DefaultProducerProcessor.java:562)at com.dianping.poi.flowcenter.mq.WorkflowEventMQProducer.sendSyncMessage(WorkflowEventMQProducer.java:98)at com.dianping.poi.flowcenter.WorkflowEngine.createFlowInstance(WorkflowEngine.java:642)at com.dianping.poi.flowcenter.WorkflowEngine.startWorkflow0(WorkflowEngine.java:560)at com.dianping.poi.flowcenter.WorkflowEngine.startWorkflow(WorkflowEngine.java:504)at com.dianping.poi.mainflow.clearengine.engine.create.impl.CreateWorkflowServiceImpl.createWorkflow(CreateWorkflowServiceImpl.java:66)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:277)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:183)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:176)at com.dianping.poi.mainflow.core.business.WorkflowBusiness$$FastClassBySpringCGLIB$$f3bb47a4.invoke()at org.springframework.cglib.proxy.MethodProxy.invoke(MethodProxy.java:204)at org.springframework.aop.framework.CglibAopProxy$CglibMethodInvocation.invokeJoinpoint(CglibAopProxy.java:736)at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:157)at org.springframework.aop.interceptor.ExposeInvocationInterceptor.invoke(ExposeInvocationInterceptor.java:92)at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:179)at org.springframework.aop.framework.CglibAopProxy$DynamicAdvisedInterceptor.intercept(CglibAopProxy.java:671)at com.dianping.poi.mainflow.core.business.WorkflowBusiness$$EnhancerBySpringCGLIB$$e721a2aa.createWorkflow()at com.dianping.poi.mainflow.update.biz.business.MainUpdateFlowBusiness.update(MainUpdateFlowBusiness.java:220)at com.dianping.poi.mainflow.update.biz.business.MainUpdateFlowBusiness.update(MainUpdateFlowBusiness.java:179)at com.dianping.poi.mainflow.feedback.biz.serviceImpl.FeedbackForPoiServiceImpl.dpFeedbackBase(FeedbackForPoiServiceImpl.java:1233)at com.dianping.poi.mainflow.feedback.biz.serviceImpl.FeedbackForPoiServiceImpl.dpTerminalFeedback(FeedbackForPoiServiceImpl.java:486)at sun.reflect.GeneratedMethodAccessor144.invoke(Unknown Source)at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)at java.lang.reflect.Method.invoke(Method.java:497)at com.dianping.pigeon.remoting.provider.service.method.ServiceMethod.invoke(ServiceMethod.java:193)at com.dianping.pigeon.remoting.provider.process.filter.BusinessProcessFilter.invoke(BusinessProcessFilter.java:79)at com.dianping.pigeon.remoting.provider.process.filter.BusinessProcessFilter.invoke(BusinessProcessFilter.java:34)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.GatewayProcessFilter.invoke(GatewayProcessFilter.java:242)at com.dianping.pigeon.remoting.provider.process.filter.GatewayProcessFilter.invoke(GatewayProcessFilter.java:51)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.SecurityFilter.invoke(SecurityFilter.java:31)at com.dianping.pigeon.remoting.provider.process.filter.SecurityFilter.invoke(SecurityFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.GenericProcessFilter.invoke(GenericProcessFilter.java:41)at com.dianping.pigeon.remoting.provider.process.filter.GenericProcessFilter.invoke(GenericProcessFilter.java:24)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ExceptionProcessFilter.invoke(ExceptionProcessFilter.java:44)at com.dianping.pigeon.remoting.provider.process.filter.ExceptionProcessFilter.invoke(ExceptionProcessFilter.java:27)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ContextTransferProcessFilter.invoke(ContextTransferProcessFilter.java:43)at com.dianping.pigeon.remoting.provider.process.filter.ContextTransferProcessFilter.invoke(ContextTransferProcessFilter.java:28)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.WriteResponseProcessFilter.invoke(WriteResponseProcessFilter.java:36)at com.dianping.pigeon.remoting.provider.process.filter.WriteResponseProcessFilter.invoke(WriteResponseProcessFilter.java:26)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.TrafficRecordFilter.invoke(TrafficRecordFilter.java:34)at com.dianping.pigeon.remoting.provider.process.filter.TrafficRecordFilter.invoke(TrafficRecordFilter.java:14)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.InnerTracerFilter.invoke(InnerTracerFilter.java:29)at com.dianping.pigeon.remoting.provider.process.filter.InnerTracerFilter.invoke(InnerTracerFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.MonitorProcessFilter.invoke(MonitorProcessFilter.java:101)at com.dianping.pigeon.remoting.provider.process.filter.MonitorProcessFilter.invoke(MonitorProcessFilter.java:35)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.TracerFilter.invoke(TracerFilter.java:37)at com.dianping.pigeon.remoting.provider.process.filter.TracerFilter.invoke(TracerFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ProviderContextFilter.invoke(ProviderContextFilter.java:28)at com.dianping.pigeon.remoting.provider.process.filter.ProviderContextFilter.invoke(ProviderContextFilter.java:18)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.threadpool.RequestThreadPoolProcessor$2.call(RequestThreadPoolProcessor.java:254)at com.dianping.pigeon.remoting.provider.process.threadpool.RequestThreadPoolProcessor$2.call(RequestThreadPoolProcessor.java:243)at java.util.concurrent.FutureTask.run(FutureTask.java:266)at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1142)at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:617)at java.lang.Thread.run(Thread.java:745)Locked ownable synchronizers: <0x00000007ab2b6228> (a java.util.concurrent.ThreadPoolExecutor$Worker) Pigeon 阻塞线程 ThreadDump 信息 priority:5 - threadId:0x00007fa599636000 - nativeId:0x2ec8 - nativeId (decimal):11976 - state:BLOCKEDstackTrace:java.lang.Thread.State: BLOCKED (on object monitor)at deps.redis.clients.util.RedisInputStream.ensureFill(RedisInputStream.java:207)at deps.redis.clients.util.RedisInputStream.readByte(RedisInputStream.java:47)at deps.redis.clients.jedis.Protocol.process(Protocol.java:204)at deps.redis.clients.jedis.Protocol.read(Protocol.java:271)at deps.redis.clients.jedis.Connection.readProtocolWithCheckingBroken(Connection.java:305)at deps.redis.clients.jedis.Connection.getBinaryBulkReply(Connection.java:236)at deps.redis.clients.jedis.BinaryJedis.hget(BinaryJedis.java:788)at deps.redis.clients.jedis.BinaryJedisCluster$13.execute(BinaryJedisCluster.java:202)at deps.redis.clients.jedis.BinaryJedisCluster$13.execute(BinaryJedisCluster.java:199)at deps.redis.clients.jedis.JedisClusterCommand.runWithRetries(JedisClusterCommand.java:64)at deps.redis.clients.jedis.JedisClusterCommand.runBinary(JedisClusterCommand.java:41)at deps.redis.clients.jedis.BinaryJedisCluster.hget(BinaryJedisCluster.java:199)at com.dianping.squirrel.client.impl.redis.RedisStoreClientImpl$41.excute(RedisStoreClientImpl.java:1022)at com.dianping.squirrel.client.impl.AbstractStoreClient$MonitorCommand.run(AbstractStoreClient.java:1066)at com.dianping.squirrel.client.impl.redis.RedisStoreClientImpl.hget(RedisStoreClientImpl.java:1018)at com.dianping.poi.mainflow.core.redisdao.TimestampRedisDao.getUpdateTime(TimestampRedisDao.java:18)at com.dianping.poi.mainflow.common.RefreshableCache.checkUpdate(RefreshableCache.java:99) locked<0x00000007623197a0>(a com.dianping.poi.mainflow.core.cache.FlowTemplateRuleCache) com.dianping.poi.mainflow.common.RefreshableCache.getValue(RefreshableCache.java:53) at com.dianping.poi.mainflow.common.RefreshableCache.getValue(RefreshableCache.java:43)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.getTemplateRule(WorkflowBusiness.java:160)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.setTemplateByWorkflow(WorkflowBusiness.java:134)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:253)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:183)at com.dianping.poi.mainflow.core.business.WorkflowBusiness.createWorkflow(WorkflowBusiness.java:176)at com.dianping.poi.mainflow.core.business.WorkflowBusiness$$FastClassBySpringCGLIB$$f3bb47a4.invoke()at org.springframework.cglib.proxy.MethodProxy.invoke(MethodProxy.java:204)at org.springframework.aop.framework.CglibAopProxy$CglibMethodInvocation.invokeJoinpoint(CglibAopProxy.java:736)at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:157)at org.springframework.aop.interceptor.ExposeInvocationInterceptor.invoke(ExposeInvocationInterceptor.java:92)at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:179)at org.springframework.aop.framework.CglibAopProxy$DynamicAdvisedInterceptor.intercept(CglibAopProxy.java:671)at com.dianping.poi.mainflow.core.business.WorkflowBusiness$$EnhancerBySpringCGLIB$$e721a2aa.createWorkflow()at com.dianping.poi.mainflow.update.biz.business.MainUpdateFlowBusiness.update(MainUpdateFlowBusiness.java:220)at com.dianping.poi.mainflow.update.biz.business.MainUpdateFlowBusiness.update(MainUpdateFlowBusiness.java:179)at com.dianping.poi.mainflow.feedback.biz.serviceImpl.FeedbackForPoiServiceImpl.dpFeedbackBase(FeedbackForPoiServiceImpl.java:1233)at com.dianping.poi.mainflow.feedback.biz.serviceImpl.FeedbackForPoiServiceImpl.dpTerminalFeedback(FeedbackForPoiServiceImpl.java:486)at sun.reflect.GeneratedMethodAccessor144.invoke(Unknown Source)at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)at java.lang.reflect.Method.invoke(Method.java:497)at com.dianping.pigeon.remoting.provider.service.method.ServiceMethod.invoke(ServiceMethod.java:193)at com.dianping.pigeon.remoting.provider.process.filter.BusinessProcessFilter.invoke(BusinessProcessFilter.java:79)at com.dianping.pigeon.remoting.provider.process.filter.BusinessProcessFilter.invoke(BusinessProcessFilter.java:34)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.GatewayProcessFilter.invoke(GatewayProcessFilter.java:242)at com.dianping.pigeon.remoting.provider.process.filter.GatewayProcessFilter.invoke(GatewayProcessFilter.java:51)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.SecurityFilter.invoke(SecurityFilter.java:31)at com.dianping.pigeon.remoting.provider.process.filter.SecurityFilter.invoke(SecurityFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.GenericProcessFilter.invoke(GenericProcessFilter.java:41)at com.dianping.pigeon.remoting.provider.process.filter.GenericProcessFilter.invoke(GenericProcessFilter.java:24)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ExceptionProcessFilter.invoke(ExceptionProcessFilter.java:44)at com.dianping.pigeon.remoting.provider.process.filter.ExceptionProcessFilter.invoke(ExceptionProcessFilter.java:27)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ContextTransferProcessFilter.invoke(ContextTransferProcessFilter.java:43)at com.dianping.pigeon.remoting.provider.process.filter.ContextTransferProcessFilter.invoke(ContextTransferProcessFilter.java:28)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.WriteResponseProcessFilter.invoke(WriteResponseProcessFilter.java:36)at com.dianping.pigeon.remoting.provider.process.filter.WriteResponseProcessFilter.invoke(WriteResponseProcessFilter.java:26)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.TrafficRecordFilter.invoke(TrafficRecordFilter.java:34)at com.dianping.pigeon.remoting.provider.process.filter.TrafficRecordFilter.invoke(TrafficRecordFilter.java:14)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.InnerTracerFilter.invoke(InnerTracerFilter.java:29)at com.dianping.pigeon.remoting.provider.process.filter.InnerTracerFilter.invoke(InnerTracerFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.MonitorProcessFilter.invoke(MonitorProcessFilter.java:101)at com.dianping.pigeon.remoting.provider.process.filter.MonitorProcessFilter.invoke(MonitorProcessFilter.java:35)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.TracerFilter.invoke(TracerFilter.java:37)at com.dianping.pigeon.remoting.provider.process.filter.TracerFilter.invoke(TracerFilter.java:15)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.filter.ProviderContextFilter.invoke(ProviderContextFilter.java:28)at com.dianping.pigeon.remoting.provider.process.filter.ProviderContextFilter.invoke(ProviderContextFilter.java:18)at com.dianping.pigeon.remoting.provider.process.ProviderProcessHandlerFactory$1.handle(ProviderProcessHandlerFactory.java:99)at com.dianping.pigeon.remoting.provider.process.threadpool.RequestThreadPoolProcessor$2.call(RequestThreadPoolProcessor.java:254)at com.dianping.pigeon.remoting.provider.process.threadpool.RequestThreadPoolProcessor$2.call(RequestThreadPoolProcessor.java:243)at java.util.concurrent.FutureTask.run(FutureTask.java:266)at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1142)at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:617)at java.lang.Thread.run(Thread.java:745)Locked ownable synchronizers:-<0x0000000735ab3bc0>(a java.util.concurrent.ThreadPoolExecutor$Worker) 问题说明 通过对应用系统的模拟上线应用运行状态分析,目标找出系统的瓶颈点,以及通过对应用系统的资源使用情况来评估应用系统的相关参数设置是否合理; 如何根据应用系统的运行时的性能监控,动态的评估应用系统潜在的瓶颈点,以及预测此瓶颈点对应用的影响,是否可以动态的调配相关应用参数,来自适用应用系统性能,充分利用应用系统资源(CPU,Memory,IO)等,结合应用系统的任务使用特性(CPU 密集型,IO 密集型,MiX 混合性)以及多个线程池任务执行特性,是否能够动态预测。 Arthas 征文活动火热进行中 Arthas 官方正在举行征文活动,如果你有: 使用 Arthas 排查过的问题 对 Arthas 进行源码解读 对 Arthas 提出建议 不限,其它与 Arthas 有关的内容 欢迎参加征文活动,还有奖品拿哦~点击投稿 “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的公众号。”

优秀的个人博客,低调大师

重新思考边缘存储时应考虑5个方面

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 现在企业边缘产生的数据比以往任何时候都多,这使得很多企业开始认真研究存储系统,以存储这些数据。例如,COVID-19大流行使各种医疗保健组织生成更多数据,并给边缘系统带来更大压力。同时,这些组织有更多的人员在家工作,他们将大量非结构化数据发送到边缘环境中或从边缘环境中发送出去。 基于当前不断变化的工作负载,IT必须评估数据流如何影响其边缘存储功能。下面让我们看看看边缘数据影响存储的五种方式,以及管理边缘存储时需要考虑的因素。 1. 数据量和类型 当前的大流行正在改变边缘工作负载,但是即使没有疫情,边缘的数据量和类型也会影响存储。边缘环境可以支持一切,包括从虚拟桌面基础设施到医疗保健到IoT设备。存储系统必须能够满足目标工作负载,同时满足数据保留要求,并且通常要结合分层和其他策略。 如果边缘环境仅支持一种类型的工作负载,存储会更加简单,只要正确配置并考虑预期的工作负载波动即可。而多种类型的工作负载则更加复杂。例如,在大流行之前,医疗机构可​​能已经部署边缘系统来支持患者监视设备。现在,它可能还需要支持在家工作的管理人员相关的各种工作负载。在此期间,存储系统可能会受到严重影响,特别是如果它们已经在极限范围内运行时。 2. 环境条件 边缘环境本身会影响存储架构。存储系统可能嵌入在汽车、飞机、火车、船甚至无人机中,也可能是在工业环境中,周围都是重型机械,例如在石油钻机或矿山中,其中需要考虑振动或灰尘因素。同时,根据地理位置的不同,它可能会遭受温度、压力、湿度和高度的极端影响。 无论环境多么恶劣,边缘系统都必须能够承受其环境的严酷考验。无论是在零下温度的极地冰帽,还是在撒哈拉沙漠–周围都吹着干热的干沙,存储设备必须针对其环境专门设计,并结合坚固耐用的组件–这些组件在极端条件下不会损坏。 3. 设施和空间限制 在某些边缘部署中,空间本身可能很小,例如边缘系统可能安装在飞机的货舱中、风车脚下或卫星办公室的储藏室中。此外,这些空间可能具有电源和散热限制,这会影响存储的部署方式。边缘存储必须适应这些限制,即使在工作负载波动和增长的情况下(例如现在的大流行)。 企业可使用较小的存储设备或密度要求来应对空间限制。例如,在某些情况下,SSD比HDD更有优势,因为它们只需要较少的空间、电源和散热。另外,当空间紧张时,计算存储也是一种选择,它可将部分处理移至存储系统本身,从而减轻计算资源的负担。 4. 基础设施限制 边缘环境之外的情况也会影响存储架构。例如,网络带宽限制和距离将决定在边缘系统和数据中心或云端的集中存储库之间可发送多少数据。或者说,集中存储库也可能没有办法处理来自多个边缘系统的所有数据,即使网络带宽不是问题。并且,边缘系统的位置也会影响IT部门日常物理访问边缘存储设备。 为了解决基础架构的局限性,很多企业在边缘处理数据,仅将已处理和汇总的数据发送到中央存储库。这种方法可以提高应用程序性能。但是,存储必须能够满足低延迟和高IOPS的应用程序需求,这可能意味着需要投资于性能更高的设备。边缘环境可能还需要高度可靠的存储–使用软件定义的或智能存储技术来支持远程管理,并减少管理开销。 5. 数据保护要求 管理边缘系统的IT团队必须确保数据安全性和隐私性,同时在发生灾难时保护数据完整性。不幸的是,边缘计算会增加潜在的攻击面,因此会增加风险,特别是s在支持大量IoT设备时。如果多个应用程序在同一硬件上运行,则风险可能更大。并且,如果更多人从家庭设备连接到边缘系统,例如当前的大流行的情况,可能会加剧安全风险,从而导致敏感数据从企业系统流出。 在这种情况下,IT必须对静态和动态数据进行加密,在应用程序之间隔离数据,并部署防火墙、VPN和反恶意软件等策略。此外,管理员应从集中管理仪表板或门户监视所有边缘系统以及存储设备本身的数据访问和移动。企业还应该考虑使用能够自动响应威胁的智能存储设备,而无需等待人工干预。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-05-03本文作者:佚名本文来自:“TechTarget中国”,了解相关信息可以关注“TechTarget中国”

优秀的个人博客,低调大师

从函数计算架构看 Serverless 的演进与思考

作者|杨皓然 阿里巴巴高级技术专家 导读:云计算之所以能够成为 DT 时代颠覆性力量,是因为其本质是打破传统架构模式、降低成本并简化体系结构,用全新的思维更好的满足了用户需求。而无服务器计算(Serverless Computing)作为这个巨大市场的下一个阶段的进化产物,将真正帮助企业实现只专注于业务和构建应用程序,而不必担心 IT 基础设施,这也将成为云服务商未来竞争的关键。 什么是无服务器计算 云原生计算基金会(Cloud Native Computing Foundation, CNCF)对无服务器计算作了如下定义: Serverless computing refers to the concept of building and running applications that do not require serve

优秀的个人博客,低调大师

有趣的Tensorflow游乐场以及有趣的思考

闲来无事不小心发现一个好玩有适合神经网络初学者的工具。google的神经网络Tensorflow游戏场,通过拖拽就可以选择特征,配置权重,配置隐藏层等,下图是通过左侧点集的点位置(x1,x2),算出点集的蓝色和橙色区域:地址有意思的反思:我从大二起就在公司实习一直到研究生、工作,先后接触了电子设计,嵌入式软件设计,嵌入式系统开发,linux系统开发和驱动开发,java后端设计,C#客户端开发,app及前端开发,数据仓库,大数据调研及数据分析,机器学习以及计算视觉等工作,可谓是一路追赶时代口号的发展,每一次技术的转行吧,都会有深深的迷茫,回过头来不禁发现,其实无论技术的怎样变迁,都是为了解决现有的商业问题,所有看似前端的技术,无论是20年前的嵌入式还是现在的人工智能,大数据什么的,都是解决问题的一个工具而已。不同于当时读博的是,商业

优秀的个人博客,低调大师

有关Android插件化的一些总结思考

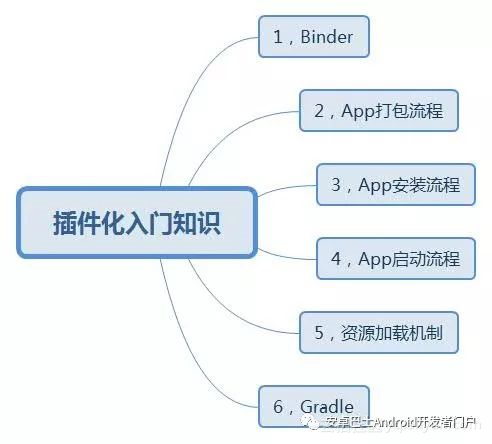
最近几年移动开发业界兴起了「 插件化技术 」的旋风,各个大厂都推出了自己的插件化框架,各种开源框架都评价自身功能优越性,令人目不暇接。随着公司业务快速发展,项目增多,开发资源却有限,如何能在有限资源内满足需求和项目的增长,同时又能快速响应问题和迭代新需求,这就是一个矛盾点。此时,插件化技术正好风生水起,去了解各个主流框架实现思路,看看能对目前工作是否有帮助,是很有必要的。 主要分为以下几个部分 插件化介绍入门知识实现原理主流框架实战小结插件化介绍 百度百科里是这么定义插件的:「 是一种遵循一定规范的应用程序接口编写出来的程序,只能运行在程序规定的系统平台下,而不能脱离指定的平台单独运行。」,也就是说,插件可以提供一种动态扩展能力,使得应用程序在运行时加载原本不属于该应用的功能,并且做到动态更新和替换。 那么在 Android 中,何为「 插件化 」,顾名思义,就是把一些核心复杂依赖度高的业务模块封装成独立的插件,然后根据不同业务需求进行不同组合,动态进行替换,可对插件进行管理、更新,后期对插件也可进行版本管理等操作。在插件化中有两个概念需要讲解下: 宿主所谓宿主,就是需要能提供运行环境,给资源调用提供上下文环境,一般也就是我们主 APK ,要运行的应用,它作为应用的主工程所在,实现了一套插件的加载和管理的框架,插件都是依托于宿主的APK而存在的。 插件插件可以想象成每个独立的功能模块封装为一个小的 APK ,可以通过在线配置和更新实现插件 APK 在宿主 APK 中的上线和下线,以及动态更新等功能。 那么为何要使用插件化技术,它有何优势,能给我们带来什么样好处,这里简单列举了以下几点: 让用户不用重新安装 APK 就能升级应用功能,减少发版本频率,增加用户体验。提供一种快速修复线上 BUG 和更新的能力。按需加载不同的模块,实现灵活的功能配置,减少服务器对旧版本接口兼容压力。模块化、解耦合、并行开发、 65535 问题。入门知识 首先我们要知道插件化技术是属于比较复杂一个领域,复杂点在于它涉及知识点广泛,不仅仅是上层做应用架构能力,还要求我们对 Android 系统底层知识需要有一定的认知,这里简单罗列了其中会涉及的知识点: 首先,要介绍的是 Binder ,我们都知道 Android 多进程通信核心就是 Binder ,如果没有它真的寸步难行。 Binder 涉及两层技术,你可以认为它是一个中介者模式,在客户端和服务器端之间, Binder 就起到中介的作用。如果要实现四大组件的插件化,就需要在 Binder 上做修改, Binder 服务端的内容没办法修改,只能改客户端的代码,而且四大组件的每个组件的客户端都不一样,这个就需要深入研究了。学习Binder的最好方式是 AIDL ,这方面在网上有很多资料,最简单的方式就是自己写个 aidl 文件自动生成一个 Java 类,然后去查看这个Java类的每个方法和变量,然后再去看四大组件,其实都是跟 AIDL 差不多的实现方式。 其次,是 App 打包的流程。代码写完了,执行一次打包操作,中途经历了资源打包、 Dex 生成、签名等过程。其中最重要的就是资源的打包,即 AAPT 这一步,如果宿主和插件的资源id冲突,一种解决办法就是在这里做修改。 第三, App 在手机上的安装流程也很重要。熟悉安装流程不仅对插件化有帮助,在遇到安装 Bug 的时候也非常重要。手机安装 App 的时候,经常会有下载异常,提示资源包不能解析,这时需要知道安装 App 的这段代码在什么地方,这只是第一步。第二步需要知道, App 下载到本地后,具体要做哪些事情。手机有些目录不能访问, App 下载到本地之后,放到哪个目录下,然后会生成哪些文件。插件化有个增量更新的概念,如何下载一个增量包,从本地具体哪个位置取出一个包,这个包的具体命名规则是什么,等等。这些细节都必须要清楚明白。 第四,是 App 的启动流程。 Activity 启动有几种方式?一种是写一个 startActivity ,第二种是点击手机 App ,通过手机系统里的 Launcher 机制,启动 App 里默认的 Activity 。通常, App 开发人员喜闻乐见的方式是第二种。那么第一种方式的启动原理是什么呢?另外,启动的时候,Main 函数在哪里?这个 Main 函数的位置很重要,我们可以对它所在的类做修改,从而实现插件化。 第五点更重要,做 Android 插件化需要控制两个地方。首先是插件 Dex 的加载,如何把插件 Dex 中的类加载到内存?另外是资源加载的问题。插件可能是 Apk 也可能是 so 格式,不管哪一种,都不会生成 R.id ,从而没办法使用。这个问题有好几种解决方案。一种是是重写 Context 的 getAsset 、 getResource 之类的方法,偷换概念,让插件读取插件里的资源,但缺点就是宿主和插件的资源 id 会冲突,需要重写 AAPT 。另一种是重写 AMS中保存的插件列表,从而让宿主和插件分别去加载各自的资源而不会冲突。第三种方法,就是打包后,执行一个脚本,修改生成包中资源id。 第六点,在实施插件化后,如何解决不同插件的开发人员的工作区问题。比如,插件1和插件2,需要分别下载哪些代码,如何独立运行?就像机票和火车票,如何只运行自己的插件,而不运行别人的插件?这是协同工作的问题。火车票和机票,这两个 Android 团队的各自工作区是不一样的,这时候就要用到 Gradle 脚本了,每个项目分别有各自的仓库,有各自不同的打包脚本,只需要把自己的插件跟宿主项目一起打包运行起来,而不用引入其他插件,还有更厉害的是,也可以把自己的插件当作一个 App 来打包并运行。 上面介绍了插件化的入门知识,一共六点,每一点都需要花大量时间去理解。否则,在面对插件化项目的时候,很多地方你会一头雾水。而只要理解了这六点核心,一切可迎刃而解。 实现原理 在Android中应用插件化技术,其实也就是动态加载的过程,分为以下几步: 把可执行文件( .so/dex/jar/apk 等)拷贝到应用 APP 内部。加载可执行文件,更换静态资源调用具体的方法执行业务逻辑Android 项目中,动态加载技术按照加载的可执行文件的不同大致可以分为两种: 动态加载 .so 库动态加载 dex/jar/apk文件(现在动态加载普遍说的是这种)第一点, Android 中 NDK 中其实就使用了动态加载,动态加载 .so 库并通过 JNI 调用其封装好的方法。后者一般是由 C/C++ 编译而成,运行在 Native 层,效率会比执行在虚拟机层的 Java 代码高很多,所以 Android 中经常通过动态加载 .so 库来完成一些对性能比较有需求的工作(比如 Bitmap 的解码、图片高斯模糊处理等)。此外,由于 .so 库是由 C/C++ 编译而来的,只能被反编译成汇编代码,相比中 dex 文件反编译得到的 Smali 代码更难被破解,因此 .so 库也可以被用于安全领域。 其二,“基于 ClassLoader 的动态加载 dex/jar/apk 文件”,就是我们指在 Android 中 动态加载由 Java 代码编译而来的 dex 包并执行其中的代码逻辑,这是常规 Android 开发比较少用到的一种技术,目前说的动态加载指的就是这种。 Android 项目中,所有 Java 代码都会被编译成 dex 文件,Android 应用运行时,就是通过执行 dex 文件里的业务代码逻辑来工作的。使用动态加载技术可以在 Android 应用运行时加载外部的 dex 文件,而通过网络下载新的 dex 文件并替换原有的 dex 文件就可以达到不安装新 APK 文件就升级应用(改变代码逻辑)的目的。 所以说,在 Android 中的 ClassLoader 机制主要用来加载 dex 文件,系统提供了两个 API 可供选择: PathClassLoader:只能加载已经安装到 Android 系统中的 APK 文件。因此不符合插件化的需求,不作考虑。DexClassLoader:支持加载外部的 APK、Jar 或者 dex 文件,正好符合文件化的需求,所有的插件化方案都是使用 DexClassloader 来加载插件 APK 中的 .class文件的。主流框架 在 Android 中实现插件化框架,需要解决的问题主要如下: 资源和代码的加载Android 生命周期的管理和组件的注册宿主 APK 和插件 APK 资源引用的冲突解决下面分析几个目前主流的开源框架,看看每个框架具体实现思路和优缺点。 DL 动态加载框架 ( 2014 年底) 是基于代理的方式实现插件框架,对 App 的表层做了处理,通过在 Manifest 中注册代理组件,当启动插件组件时,首先启动一个代理组件,然后通过这个代理组件来构建,启动插件组件。 需要按照一定的规则来开发插件 APK,插件中的组件需要实现经过改造后的 Activity、FragmentActivity、Service 等的子类。 优点如下: 插件需要遵循一定的规则,因此安全方面可控制。方案简单,适用于自身少量代码的插件化改造。缺点如下: 不支持通过 This 调用组件的方法,需要通过 that 去调用。由于 APK 中的 Activity 没有注册,不支持隐式调用 APK 内部的 Activity。插件编写和改造过程中,需要考虑兼容性问题比较多,联调起来会比较费时费力。DroidPlugin ( 2015 年 8 月) DroidPlugin 是 360 手机助手实现的一种插件化框架,它可以直接运行第三方的独立 APK 文件,完全不需要对 APK 进行修改或安装。一种新的插件机制,一种免安装的运行机制,是一个沙箱(但是不完全的沙箱。就是对于使用者来说,并不知道他会把 apk 怎么样), 是模块化的基础。 实现原理: 共享进程:为android提供一个进程运行多个 apk 的机制,通过 API 欺骗机制瞒过系统。占坑:通过预先占坑的方式实现不用在 manifest 注册,通过一带多的方式实现服务管理。Hook 机制:动态代理实现函数 hook ,Binder 代理绕过部分系统服务限制,IO 重定向(先获取原始 Object –> Read ,然后动态代理 Hook Object 后–> Write 回去,达到瞒天过海的目的)。插件 Host 的程序架构: 优点如下: 支持 Android 四大组件,而且插件中的组件不需要在宿主 APK 中注册。支持 Android 2.3 及以上系统,支持所有的系统 API。插件与插件之间,插件与宿主之间的代码和资源完全隔阂。实现了进程管理,插件的空进程会被及时回收,占用内存低。缺点如下: 插件 APK 中不支持自定义资源的 Notification,通知栏限制。插件 APK 中无法注册具有特殊的 IntentFilter 的四大组件。缺乏对 Native 层的 Hook 操作,对于某些带有 Native 代码的插件 APK 支持不友好,可能无法正常运行。由于插件与插件,插件与宿主之间的代码完全隔离,因此,插件与插件,插件与宿主之间的通信只能通过 Android 系统级别的通信方式。安全性担忧(可以修改,hook一些重要信息)。机型适配(不是所有机器上都能行,因为大量用反射相关,如果rom厂商深度定制了framework层,反射的方法或者类不在,容易插件运用失败)Small ( 2015 年底) Small 是一种实现轻巧的跨平台插件化框架,基于“轻量、透明、极小化、跨平台”的理念,实现原理有以下三点。 动态加载类:我们知道插件化很多都从 DexClassLoader 类有个 DexPathList 清单,支持 dex/jar/zip/apk 文件格式,却没有支持 .so 文件格式,因此 Small 框架则是把 .so 文件包装成 zip 文件格式,插入到 DexPathList 集合中,改写动态加载的代码。资源分段:由于 Android 资源的格式是 0xPPTTNNNN ,PP 是包 ID ,00-02 是属于系统,7f 属于应用程序,03-7e 则保留,可以在这个范围内做文章 , TT 则是 Type 比如,attr 、layout 、string 等等,NNNN 则是资源全局 ID。那么这个框架则是对资源包进行重新打包,每个插件重新分配资源 ID ,这样就保证了宿主和插件的资源不冲突。动态代理注册:在 Android 中要使用四大组件,都是需要在 manifest 清单中注册,这样才可以使用,那如何在不注册情况也能使用呢,这里就是用到动态代理机制进行 Hook ,在发送 AMS 之前用占坑的组件来欺骗系统,通过认证后,再把真正要调用的组件还原回来,达到瞒天过海目的。架构图: 优点如下: 所有插件支持内置宿主包中。插件的编码和资源文件的使用与普通开发应用没有差别。通过设定 URI ,宿主以及 Native 应用插件,Web 插件,在线网页等能够方便进行通信。支持 Android 、 iOS 、和 Html5 ,三者可以通过同一套 Javascript 接口实现通信。缺点如下: 暂不支持 Service 的动态注册,不过这个可以通过将 Service 预先注册在宿主的 AndroidManifest.xml 文件中进行规避,因为 Service 的更新频率通常非常低。与其他主流框架的区别: DyLA : Dynamic-load-apk @singwhatiwanna DiLA : Direct-Load-apk @FinalLody APF : Android-Plugin-Framework @limpoxe ACDD : ACDD @bunnyblue DyAPK : DynamicAPK @TediWang DPG : DroidPlugin @cmzy, 360 功能 透明度 VirtualAPK 是滴滴开源的一套插件化框架,支持几乎所有的 Android 特性,四大组件方面。 架构图: 实现思路: VirtualAPK 对插件没有额外的约束,原生的 apk 即可作为插件。插件工程编译生成 apk后,即可通过宿主 App 加载,每个插件 apk 被加载后,都会在宿主中创建一个单独的 LoadedPlugin 对象。如下图所示,通过这些 LoadedPlugin 对象,VirtualAPK 就可以管理插件并赋予插件新的意义,使其可以像手机中安装过的 App 一样运行。 合并宿主和插件的ClassLoader 需要注意的是,插件中的类不可以和宿主重复合并插件和宿主的资源 重设插件资源的 packageId,将插件资源和宿主资源合并去除插件包对宿主的引用 构建时通过 Gradle 插件去除插件对宿主的代码以及资源的引用 特性如下: 四大组件均不需要在宿主manifest中预注册,每个组件都有完整的生命周期。 Activity:支持显示和隐式调用,支持Activity的theme和LaunchMode,支持透明主题; Service:支持显示和隐式调用,支持Service的start、stop、bind和unbind,并支持跨进程bind插件中的Service; Receiver:支持静态注册和动态注册的Receiver; ContentProvider:支持provider的所有操作,包括CRUD和call方法等,支持跨进程访问插件中的Provider。 自定义View:支持自定义 View,支持自定义属性和style,支持动画; PendingIntent:支持PendingIntent以及和其相关的Alarm、Notification和AppWidget; 支持插件Application以及插件manifest中的meta-data; 支持插件中的so。 优秀的兼容性 兼容市面上几乎所有的Android手机,这一点已经在滴滴出行客户端中得到验证。资源方面适配小米、Vivo、Nubia 等,对未知机型采用自适应适配方案。极少的 Binder Hook,目前仅仅 hook了两个Binder:AMS和IContentProvider,hook 过程做了充分的兼容性适配。插件运行逻辑和宿主隔离,确保框架的任何问题都不会影响宿主的正常运行。入侵性极低 插件开发等同于原生开发,四大组件无需继承特定的基类;精简的插件包,插件可以依赖宿主中的代码和资源,也可以不依赖;插件的构建过程简单,通过 Gradle 插件来完成插件的构建,整个过程对开发者透明。如下是 VirtualAPK 和主流的插件化框架之间的对比。 ![image](https://yqfile.alicdn.com/6c28aa88cf2cd04d58c5b0534e2f98e53a79615e.png) RePlugin是一套完整的、稳定的、适合全面使用的,占坑类插件化方案,由360手机卫士的RePlugin Team研发,也是业内首个提出”全面插件化“(全面特性、全面兼容、全面使用)的方案。 框架图: 主要优势有:极其灵活:主程序无需升级(无需在Manifest中预埋组件),即可支持新增的四大组件,甚至全新的插件非常稳定:Hook 点仅有一处(ClassLoader),无任何 Binder Hook!如此可做到其崩溃率仅为“万分之一”,并完美兼容市面上近乎所有的 Android ROM。特性丰富:支持近乎所有在“单品”开发时的特性。包括静态 Receiver、 Task-Affinity 坑位、自定义 Theme、进程坑位、AppCompat、DataBinding等。易于集成:无论插件还是主程序,只需“数行”就能完成接入。管理成熟:拥有成熟稳定的“插件管理方案”,支持插件安装、升级、卸载、版本管理,甚至包括进程通讯、协议版本、安全校验等。数亿支撑:有 360 手机卫士庞大的数亿用户做支撑,三年多的残酷验证,确保App用到的方案是最稳定、最适合使用的。 实战 主要是测试各个框架之间上手的容易度如何,并做不同对比,这边写了两个 Demo 例子,一个是基于 Small 框架,一个基于 VirtualAPK 框架,从中能看出不同。 Small 实践 要引用官方最新的版本,不然在宿主和插件合并build.gradle 的时候会出现一个 BUG,这是个坑位,注意行走。其次在模块命名上要遵循一定的规则,比如业务模块用 app. ,公共库模块用 lib. ,相当于包名 .app.,.lib. 。每次在插件中添加一个 activity 组件,都需要在宿主中配置路由,然后在重新编译插件一遍,不然直接运行的话,在宿主中是找到新添加的 activity 组件,会报该组件没在系统 manifest 中,所以每次新增或修改建议插件都重新编译一遍。官方里说了,对于 Service 支持不太友好,就没去实践了。 VirtualAPK 实践有个坑需要注意的是构建环境,官方说明是要以下版本环境,Gradle 2.14.1 和 com.android.tools.build 2.1.3, 之前编译的是用最新的Gradle版本,导致一直有问题,至于是否有其他问题,可以看官方文档。 具体代码Small Demo :https://github.com/cr330326/MySmall VirtualAPK Demo :https://github.com/cr330326/MyVirtualAPKDemo 小结 正如开头所说,要实现插件化的框架,无非就是解决那典型的三个问题:插件代码如何加载、插件中的组件生命周期如何管理、插件资源和宿主资源冲突怎么办。每个框架针对这三个问题,都有不同的解决方案,同时呢,根据时间顺序,后出来的框架往往都会吸收已经出的框架精髓,进而修复那些比较有里程碑意义框架的不足。但这些框架的核心思想都是用到了代理模式,有的在表面层进行代理,有的则在系统应用层进行代理,通过代理达到替换和瞒天过海,最终让 Android 系统误以为调用插件功能和调用原生开发的功能是一样的,进而达到插件化和原生兼容编程的目的。 原文发布时间为:2018-07-19本文作者:斜杠Allen本文来自云栖社区合作伙伴“安卓巴士Android开发者门户”,了解相关信息可以关注“安卓巴士Android开发者门户”。

优秀的个人博客,低调大师

【Python初级】StringIO和BytesIO读写操作的小思考

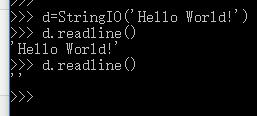
from io import StringIO; f = StringIO(); f.write('Hello World'); s = f.readline(); print s; 上面这种方法“无论如何”都读不出f的内容,使用readlines和循环也不行。 但是,用以下的方法,却可以“正常读取”: from io import StringIO; f = StringIO('Hello World'); s = f.readline(); print s; 这是为什么呢? 这是因为the stream position的原因,当你用: d = StringIO('Hello World') 其stream position为0(可以通过d.tell()获得),而后执行: d.readline() stream position移动到11.因此当我们再次执行d.readline()时,返回的是空字符串。演示见图: 类似的,使用: f = StringIO() stream position也为0,但执行了: f.write('Hello World') 之后,stream position就移动到11了,因此此时你再执行readline时返回的依旧是空字符串。 当然咯,既然这个读取是和stream position的位置有关系,那么要能够在当前情况下还能读取'Hello World!',我们可以调整这个指针的位置,执行: f.seek(0) 再进行读取操作,即可。 下面利用BytesIO进行演示,是一样的道理:

优秀的个人博客,低调大师

MongoDB分页的Java实现和分页需求的思考

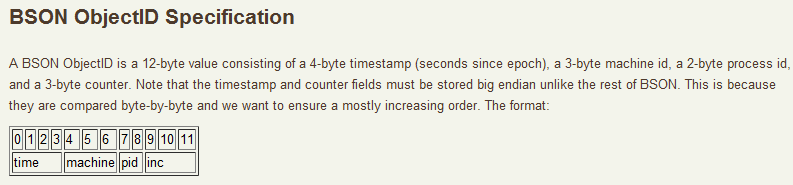
前言 传统关系数据库中都提供了基于row number的分页功能,切换MongoDB后,想要实现分页,则需要修改一下思路。 传统分页思路 假设一页大小为10条。则 //page 1 1-10 //page 2 11-20 //page 3 21-30 ... //page n 10*(n-1) +1 - 10*n MongoDB提供了skip()和limit()方法。 skip: 跳过指定数量的数据. 可以用来跳过当前页之前的数据,即跳过pageSize*(n-1)。limit: 指定从MongoDB中读取的记录条数,可以当做页面大小pageSize。 所以,分页可以这样做: //Page 1 db.users.find().limit (10) //Page 2 db.users.find().skip(10).limit(10) //Page 3 db.users.find().skip(20).limit(10) ........ 问题 看起来,分页已经实现了,但是官方文档并不推荐,说会扫描全部文档,然后再返回结果。 The cursor.skip() method requires the server to scan from the beginning of the input results set before beginning to return results. As the offset increases, cursor.skip() will become slower. 所以,需要一种更快的方式。其实和mysql数量大之后不推荐用limit m,n一样,解决方案是先查出当前页的第一条,然后顺序数pageSize条。MongoDB官方也是这样推荐的。 正确的分页办法 我们假设基于_id的条件进行查询比较。事实上,这个比较的基准字段可以是任何你想要的有序的字段,比如时间戳。 //Page 1 db.users.find().limit(pageSize); //Find the id of the last document in this page last_id = ... //Page 2 users = db.users.find({ '_id' :{ "$gt" :ObjectId("5b16c194666cd10add402c87")} }).limit(10) //Update the last id with the id of the last document in this page last_id = ... 显然,第一页和后面的不同。对于构建分页API, 我们可以要求用户必须传递pageSize, lastId。 pageSize 页面大小 lastId 上一页的最后一条记录的id,如果不传,则将强制为第一页 降序 _id降序,第一页是最大的,下一页的id比上一页的最后的id还小。 function printStudents(startValue, nPerPage) { let endValue = null; db.students.find( { _id: { $lt: startValue } } ) .sort( { _id: -1 } ) .limit( nPerPage ) .forEach( student => { print( student.name ); endValue = student._id; } ); return endValue; } 升序 _id升序, 下一页的id比上一页的最后一条记录id还大。 function printStudents(startValue, nPerPage) { let endValue = null; db.students.find( { _id: { $gt: startValue } } ) .sort( { _id: 1 } ) .limit( nPerPage ) .forEach( student => { print( student.name ); endValue = student._id; } ); return endValue; } 一共多少条 还有一共多少条和多少页的问题。所以,需要先查一共多少条count. db.users.find().count(); ObjectId的有序性问题 先看ObjectId生成规则: 比如"_id" : ObjectId("5b1886f8965c44c78540a4fc") 取id的前4个字节。由于id是16进制的string,4个字节就是32位,对应id前8个字符。即5b1886f8, 转换成10进制为1528334072. 加上1970,就是当前时间。 事实上,更简单的办法是查看org.mongodb:bson:3.4.3里的ObjectId对象。 public ObjectId(Date date) { this(dateToTimestampSeconds(date), MACHINE_IDENTIFIER, PROCESS_IDENTIFIER, NEXT_COUNTER.getAndIncrement(), false); } //org.bson.types.ObjectId#dateToTimestampSeconds private static int dateToTimestampSeconds(Date time) { return (int)(time.getTime() / 1000L); } //java.util.Date#getTime /** * Returns the number of milliseconds since January 1, 1970, 00:00:00 GMT * represented by this <tt>Date</tt> object. * * @return the number of milliseconds since January 1, 1970, 00:00:00 GMT * represented by this date. */ public long getTime() { return getTimeImpl(); } MongoDB的ObjectId应该是随着时间而增加的,即后插入的id会比之前的大。但考量id的生成规则,最小时间排序区分是秒,同一秒内的排序无法保证。当然,如果是同一台机器的同一个进程生成的对象,是有序的。 如果是分布式机器,不同机器时钟同步和偏移的问题。所以,如果你有个字段可以保证是有序的,那么用这个字段来排序是最好的。_id则是最后的备选方案。 如果我一定要跳页 上面的分页看起来看理想,虽然确实是,但有个刚需不曾指明---我怎么跳页。 我们的分页数据要和排序键关联,所以必须有一个排序基准来截断记录。而跳页,我只知道第几页,条件不足,无法分页了。 现实业务需求确实提出了跳页的需求,虽然几乎不会有人用,人们更关心的是开头和结尾,而结尾可以通过逆排序的方案转成开头。所以,真正分页的需求应当是不存在的。如果你是为了查找某个记录,那么查询条件搜索是最快的方案。如果你不知道查询条件,通过肉眼去一一查看,那么下一页足矣。 说了这么多,就是想扭转传统分页的概念,在互联网发展的今天,大部分数据的体量都是庞大的,跳页的需求将消耗更多的内存和cpu,对应的就是查询慢。 当然,如果数量不大,如果不介意慢一点,那么skip也不是啥问题,关键要看业务场景。 我今天接到的需求就是要跳页,而且数量很小,那么skip吧,不费事,还快。 来看看大厂们怎么做的 Google最常用了,看起来是有跳页选择的啊。再仔细看,只有10页,多的就必须下一页,并没有提供一共多少页,跳到任意页的选择。这不就是我们的find-condition-then-limit方案吗,只是他的一页数量比较多,前端或者后端把这一页给切成了10份。 同样,看Facebook,虽然提供了总count,但也只能下一页。 其他场景,比如Twitter,微博,朋友圈等,根本没有跳页的概念的。 排序和性能 前面关注于分页的实现原理,但忽略了排序。既然分页,肯定是按照某个顺序进行分页的,所以必须要有排序的。 MongoDB的sort和find组合 db.bios.find().sort( { name: 1 } ).limit( 5 ) db.bios.find().limit( 5 ).sort( { name: 1 } ) 这两个都是等价的,顺序不影响执行顺序。即,都是先find查询符合条件的结果,然后在结果集中排序。 我们条件查询有时候也会按照某字段排序的,比如按照时间排序。查询一组时间序列的数据,我们想要按照时间先后顺序来显示内容,则必须先按照时间字段排序,然后再按照id升序。 db.users.find({name: "Ryan"}).sort( { birth: 1, _id: 1 } ).limit( 5 ) 我们先按照birth升序,然后birth相同的record再按照_id升序,如此可以实现我们的分页功能了。 多字段排序 db.records.sort({ a:1, b:-1}) 表示先按照a升序,再按照b降序。即,按照字段a升序,对于a相同的记录,再用b降序,而不是按a排完之后再全部按b排。 示例: db.user.find(); 结果: { "_id" : ObjectId("5b1886ac965c44c78540a4fb"), "name" : "a", "age" : 1.0, "id" : "1" } { "_id" : ObjectId("5b1886f8965c44c78540a4fc"), "name" : "a", "age" : 2.0, "id" : "2" } { "_id" : ObjectId("5b1886fa965c44c78540a4fd"), "name" : "b", "age" : 1.0, "id" : "3" } { "_id" : ObjectId("5b1886fd965c44c78540a4fe"), "name" : "b", "age" : 2.0, "id" : "4" } { "_id" : ObjectId("5b1886ff965c44c78540a4ff"), "name" : "c", "age" : 10.0, "id" : "5" } 按照名称升序,然后按照age降序 db.user.find({}).sort({name: 1, age: -1}) 结果: { "_id" : ObjectId("5b1886f8965c44c78540a4fc"), "name" : "a", "age" : 2.0, "id" : "2" } { "_id" : ObjectId("5b1886ac965c44c78540a4fb"), "name" : "a", "age" : 1.0, "id" : "1" } { "_id" : ObjectId("5b1886fd965c44c78540a4fe"), "name" : "b", "age" : 2.0, "id" : "4" } { "_id" : ObjectId("5b1886fa965c44c78540a4fd"), "name" : "b", "age" : 1.0, "id" : "3" } { "_id" : ObjectId("5b1886ff965c44c78540a4ff"), "name" : "c", "age" : 10.0, "id" : "5" } 用索引优化排序 到这里必须考虑下性能。 $sort and Memory Restrictions The $sort stage has a limit of 100 megabytes of RAM. By default, if the stage exceeds this limit, $sort will produce an error. To allow for the handling of large datasets, set the allowDiskUse option to true to enable $sort operations to write to temporary files. See the allowDiskUse option in db.collection.aggregate() method and the aggregate command for details. Changed in version 2.6: The memory limit for $sort changed from 10 percent of RAM to 100 megabytes of RAM. 从2.6开始,sort只排序100M以内的数据,超过将会报错。可以通过设置allowDiskUse来允许排序大容量数据。 有索引的排序会比没有索引的排序快,所以官方推荐为需要排序的key建立索引。 索引 对于单key排序,建立单独索引 db.records.createIndex( { a: 1 } ) 索引可以支持同排序和逆序的sort 索引又分升序(1)和降序(-1),索引定义的排序方向以及逆转方向可以支持sort。对于上述单key索引a,可以支持sort({a:1})升序和sort({a:-1})降序。 对于多字段排序 如果想要使用索引。则可以建立复合(compound index)索引为 db.records.createIndex( { a: 1, b:-1 } ) 复合索引的字段顺序必须和sort一致 复合多字段索引的顺序要和sort的字段一致才可以走索引。比如索引{a:1, b:1}, 可以支持sort({a:1, b:1})和逆序sort({a:-1, b:-1}), 但是,不支持a,b颠倒。即,不支持sort({b:1, a:1}). 复合索引支持sort同排序和逆序 索引{a:1, b:-1} 可以支持sort({a:1, b:-1}), 也可以支持sort({a:-1, b:1}) 复合索引可以前缀子集支持sort 对于多字段复合索引,可以拆分成多个前缀子集。比如{a:1, b:1, c:1}相当于 { a: 1 } { a: 1, b: 1 } { a: 1, b: 1, c: 1 } 示例: Example Index Prefix db.data.find().sort( { a: 1 } ) { a: 1 } db.data.find().sort( { a: -1 } ) { a: 1 } db.data.find().sort( { a: 1, b: 1 } ) { a: 1, b: 1 } db.data.find().sort( { a: -1, b: -1 } ) { a: 1, b: 1 } db.data.find().sort( { a: 1, b: 1, c: 1 } ) { a: 1, b: 1, c: 1 } db.data.find( { a: { $gt: 4 } } ).sort( { a: 1, b: 1 } ) { a: 1, b: 1 } 复合索引的非前缀子集可以支持sort,前提是前缀子集的元素要在find的查询条件里是equals 这个条件比较绕口,复合索引的非前缀子集,只要find和sort的字段要组成索引前缀,并且find里的条件必须是相等。 示例 Example Index Prefix db.data.find( { a: 5 } ).sort( { b: 1, c: 1 } ) { a: 1 , b: 1, c: 1 } db.data.find( { b: 3, a: 4 } ).sort( { c: 1 } ) { a: 1, b: 1, c: 1 } db.data.find( { a: 5, b: { $lt: 3} } ).sort( { b: 1 } ) { a: 1, b: 1 } find和sort的字段加起来满足前缀子集,find条件中可以使用其他字段进行非equals比较。 对于既不是前缀子集,也不是find相等条件的。索引无效。比如,对于索引{a:1, b:1, c:1}。以下两种方式不走索引。 db.data.find( { a: { $gt: 2 } } ).sort( { c: 1 } ) db.data.find( { c: 5 } ).sort( { c: 1 } ) Java代码分页 由于确实有跳页的需求,目前还没有发现性能问题,仍旧采用skip做分页,当然也兼容条件分页 public PageResult<StatByClientRs> findByDurationPage(FindByDurationPageRq rq) { final Criteria criteriaDefinition = Criteria.where("duration").is(rq.getDuration()); final Query query = new Query(criteriaDefinition).with(new Sort(Lists.newArrayList(new Order(Direction.ASC, "_id")))); //分页逻辑 long total = mongoTemplate.count(query, StatByClient.class); Integer pageSize = rq.getPageSize(); Integer pageNum = rq.getPageNum(); String lastId = rq.getLastId(); final Integer pages = (int) Math.ceil(total / (double) pageSize); if (pageNum<=0 || pageNum> pages) { pageNum = 1; } if (StringUtils.isNotBlank(lastId)) { if (pageNum != 1) { criteriaDefinition.and("_id").gt(new ObjectId(lastId)); } query.limit(pageSize); } else { int skip = pageSize * (pageNum - 1); query.skip(skip).limit(pageSize); } List<StatByClient> statByClientList = mongoTemplate.find(query, StatByClient.class); PageResult<StatByClientRs> pageResult = new PageResult<>(); pageResult.setTotal(total); pageResult.setPages(pages); pageResult.setPageSize(pageSize); pageResult.setPageNum(pageNum); pageResult.setList(mapper.mapToListRs(statByClientList)); return pageResult; } 这个示例中,目标是根据duration查询list,结果集进行分页。当请求体中包含lastId,那就走下一页方案。如果想要跳页,就不传lastId,随便你跳吧。 抽取分页代码为公共工具类 考虑分页需求的旺盛,每个集合都这样写感觉比较麻烦,而且容易出错。我们来把这个封装成单独一个PageHelper import com.google.common.collect.Lists; import com.shuwei.d2.message.PageResult; import java.util.List; import java.util.function.Function; import java.util.stream.Collectors; import org.apache.commons.lang3.StringUtils; import org.bson.types.ObjectId; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.domain.Sort; import org.springframework.data.domain.Sort.Direction; import org.springframework.data.domain.Sort.Order; import org.springframework.data.mongodb.core.MongoTemplate; import org.springframework.data.mongodb.core.query.Criteria; import org.springframework.data.mongodb.core.query.Query; import org.springframework.stereotype.Component; /** * MongoDB分页查询工具类. * * @author Ryan Miao at 2018-06-07 14:46 **/ @Component public class MongoPageHelper { public static final int FIRST_PAGE_NUM = 1; public static final String ID = "_id"; private final MongoTemplate mongoTemplate; @Autowired public MongoPageHelper(MongoTemplate mongoTemplate) { this.mongoTemplate = mongoTemplate; } /** * 分页查询,直接返回集合类型的结果. * * @see MongoPageHelper#pageQuery(org.springframework.data.mongodb.core.query.Query, * java.lang.Class, java.util.function.Function, java.lang.Integer, java.lang.Integer, * java.lang.String) */ public <T> PageResult<T> pageQuery(Query query, Class<T> entityClass, Integer pageSize, Integer pageNum) { return pageQuery(query, entityClass, Function.identity(), pageSize, pageNum, null); } /** * 分页查询,不考虑条件分页,直接使用skip-limit来分页. * * @see MongoPageHelper#pageQuery(org.springframework.data.mongodb.core.query.Query, * java.lang.Class, java.util.function.Function, java.lang.Integer, java.lang.Integer, * java.lang.String) */ public <T, R> PageResult<R> pageQuery(Query query, Class<T> entityClass, Function<T, R> mapper, Integer pageSize, Integer pageNum) { return pageQuery(query, entityClass, mapper, pageSize, pageNum, null); } /** * 分页查询. * * @param query Mongo Query对象,构造你自己的查询条件. * @param entityClass Mongo collection定义的entity class,用来确定查询哪个集合. * @param mapper 映射器,你从db查出来的list的元素类型是entityClass, 如果你想要转换成另一个对象,比如去掉敏感字段等,可以使用mapper来决定如何转换. * @param pageSize 分页的大小. * @param pageNum 当前页. * @param lastId 条件分页参数, 区别于skip-limit,采用find(_id>lastId).limit分页. * 如果不跳页,像朋友圈,微博这样下拉刷新的分页需求,需要传递上一页的最后一条记录的ObjectId。 如果是null,则返回pageNum那一页. * @param <T> collection定义的class类型. * @param <R> 最终返回时,展现给页面时的一条记录的类型。 * @return PageResult,一个封装page信息的对象. */ public <T, R> PageResult<R> pageQuery(Query query, Class<T> entityClass, Function<T, R> mapper, Integer pageSize, Integer pageNum, String lastId) { //分页逻辑 long total = mongoTemplate.count(query, entityClass); final Integer pages = (int) Math.ceil(total / (double) pageSize); if (pageNum <= 0 || pageNum > pages) { pageNum = FIRST_PAGE_NUM; } final Criteria criteria = new Criteria(); if (StringUtils.isNotBlank(lastId)) { if (pageNum != FIRST_PAGE_NUM) { criteria.and(ID).gt(new ObjectId(lastId)); } query.limit(pageSize); } else { int skip = pageSize * (pageNum - 1); query.skip(skip).limit(pageSize); } final List<T> entityList = mongoTemplate .find(query.addCriteria(criteria) .with(new Sort(Lists.newArrayList(new Order(Direction.ASC, ID)))), entityClass); final PageResult<R> pageResult = new PageResult<>(); pageResult.setTotal(total); pageResult.setPages(pages); pageResult.setPageSize(pageSize); pageResult.setPageNum(pageNum); pageResult.setList(entityList.stream().map(mapper).collect(Collectors.toList())); return pageResult; } } 对了,还有PageResult对象 import com.fasterxml.jackson.annotation.JsonInclude; import com.fasterxml.jackson.annotation.JsonInclude.Include; import io.swagger.annotations.ApiModelProperty; import java.util.List; import lombok.AllArgsConstructor; import lombok.Data; import lombok.NoArgsConstructor; /** * 分页结果. * @author Ryan */ @Data @AllArgsConstructor @NoArgsConstructor @JsonInclude(Include.NON_NULL) public class PageResult<T> { @ApiModelProperty("页码,从1开始") private Integer pageNum; @ApiModelProperty("页面大小") private Integer pageSize; @ApiModelProperty("总数") private Long total; @ApiModelProperty("总页数") private Integer pages; @ApiModelProperty("数据") private List<T> list; } 使用工具类 最初的查询语句,业务逻辑和分页逻辑分开。 public PageResult<StatByClientRs> findByDurationPage(FindByDurationPageRq rq) { final Query query = new Query(Criteria.where("duration").is(rq.getDuration())); return mongoPageHelper.pageQuery(query, StatByClient.class, mapper::mapToRs, rq.getPageSize(), rq.getPageNum(), rq.getLastId()); } 把工具类共享到maven仓库 新建一个maven项目,https://github.com/Ryan-Miao/mongo-page-helper 修改并提取刚才的工具类。 如何使用 必须结合spring-boot-starter-data-mongodb来使用. 在pom里添加repository <repositories> <repository> <id>jitpack.io</id> <url>https://jitpack.io</url> </repository> </repositories> 再引入依赖 <dependency> <groupId>com.github.Ryan-Miao</groupId> <artifactId>mongo-page-helper</artifactId> <version>1.0</version> </dependency> 配置Configuration @Configuration public class MongoConfiguration{ @Autowired private MongoTemplate mongoTemplate; @Bean public MongoPageHelper mongoPageHelper() { return new MongoPageHelper(mongoTemplate); } } 然后就可以使用MongoPageHelper来注入了。 参考 官方分页推荐 官方sort文档 官方使用索引优化sort文档 官方复合索引 如何正确看待分页的需求 http://ian.wang/35.htm https://cnodejs.org/topic/559a0bf493cb46f578f0a601 关注我的公众号 唯有不断学习方能改变! -- Ryan Miao

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册