首页 文章 精选 留言 我的

精选列表

搜索[star],共5482篇文章
优秀的个人博客,低调大师

18.8k Star! 告别百度网盘,一个公私兼备的网盘系统-Cloudreve

应用简览 Cloudreve 是一个开源的网盘系统,支持不同的云存储平台,用户在实际使用时无须关心物理存储方式。你可以使用 Cloudreve 搭建个人用网盘、文件分享系统,亦或是针对大小团体的公有云系统。 主要特性 ☁️ 支持本机、从机、七牛、阿里云 OSS、腾讯云 COS、又拍云、OneDrive (包括世纪互联版) 、S3兼容协议 作为存储端 📤 上传/下载 支持客户端直传,支持下载限速 💾 可对接 Aria2 离线下载,可使用多个从机节点分担下载任务 📚 在线 压缩/解压缩、多文件打包下载 💻 覆盖全部存储策略的 WebDAV 协议支持 ⚡ 拖拽上传、目录上传、流式上传处理 🗃️ 文件拖拽管理 👩‍👧‍👦 多用户、用户组、多存储策略 🔗 创建文件、目录的分享链接,可设定自动过期 👁️‍🗨️ 视频、图像、音频、 ePub 在线预览,文本、Office 文档在线编辑 🎨 自定义配色、黑暗模式、PWA 应用、全站单页应用、国际化支持 🚀 All-In-One 打包,开箱即用 🌈 ... ... 应用特色 一、多样化的外部存储、流畅的文件上传、管理体验 Cloudreve 支持对接多种外部存储,如本机、从机、七牛、阿里云 OSS、腾讯云 COS、又拍云、OneDrive (包括世纪互联版) 、S3兼容协议等,文件的上传和下载全部为客户端直传,无需经过服务器中转。 同时,在 Web 端,Cloudreve 提供了强大的文件管理及上传组件:通过拖拽管理文件;多选、范围选择批量操作文件,对文件进行分享、移动、复制、压缩等操作。功能丰富的上传任务管理器,支持目录上传、断点续传、并行上传、拖拽文件上传。 二、离线下载,构建私人离线资源库 将磁力链、种子文件、下载链接交给 Cloudreve 处理,Cloudreve 会在服务端下载您指定的文件, 并自动上传到对应的存储端中.您还可以通过从机 Cloudreve 节点,将不同的离线下载和转存任务分配到不同服务器处理,减轻主节点的负载压力。 三、快速分享你的文件、目录 对 Cloudreve 中的文件创建分享链接,别人可以通过此链接访问、下载或预览文件。分享链接完全由你控制,提供了丰富的配置选项。支持密码保护、自动过期等选项。 四、多端同步,从多种设备、应用中访问文件 通过 Cloudreve iOS 客户端,你可以在移动设备上便捷地管理文件; 通过 WebDAV 协议,还可以在所有支持 WebDAV 协议的应用中访问并操作文件,包括 系统文件管理器、 各种文件管理器客户端、视频播放器、笔记软件等,比如:Cloudreve for iOS、nPlayer、Solid Explorer File Manager、Joplin等。 安装指南 进入云原生应用商店 搜索 Cloudreve 进入详情,选择包类型(本应用支持,docker安装,ram安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档 或加入社区 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。 官网:https://hub.grapps.cn/ 微信群:关注 云原生应用市场 公众号加入技术交流群
优秀的个人博客,低调大师

17.8k Star!开源且支持私有化部署的碎片化知识卡片管理工具-Memos

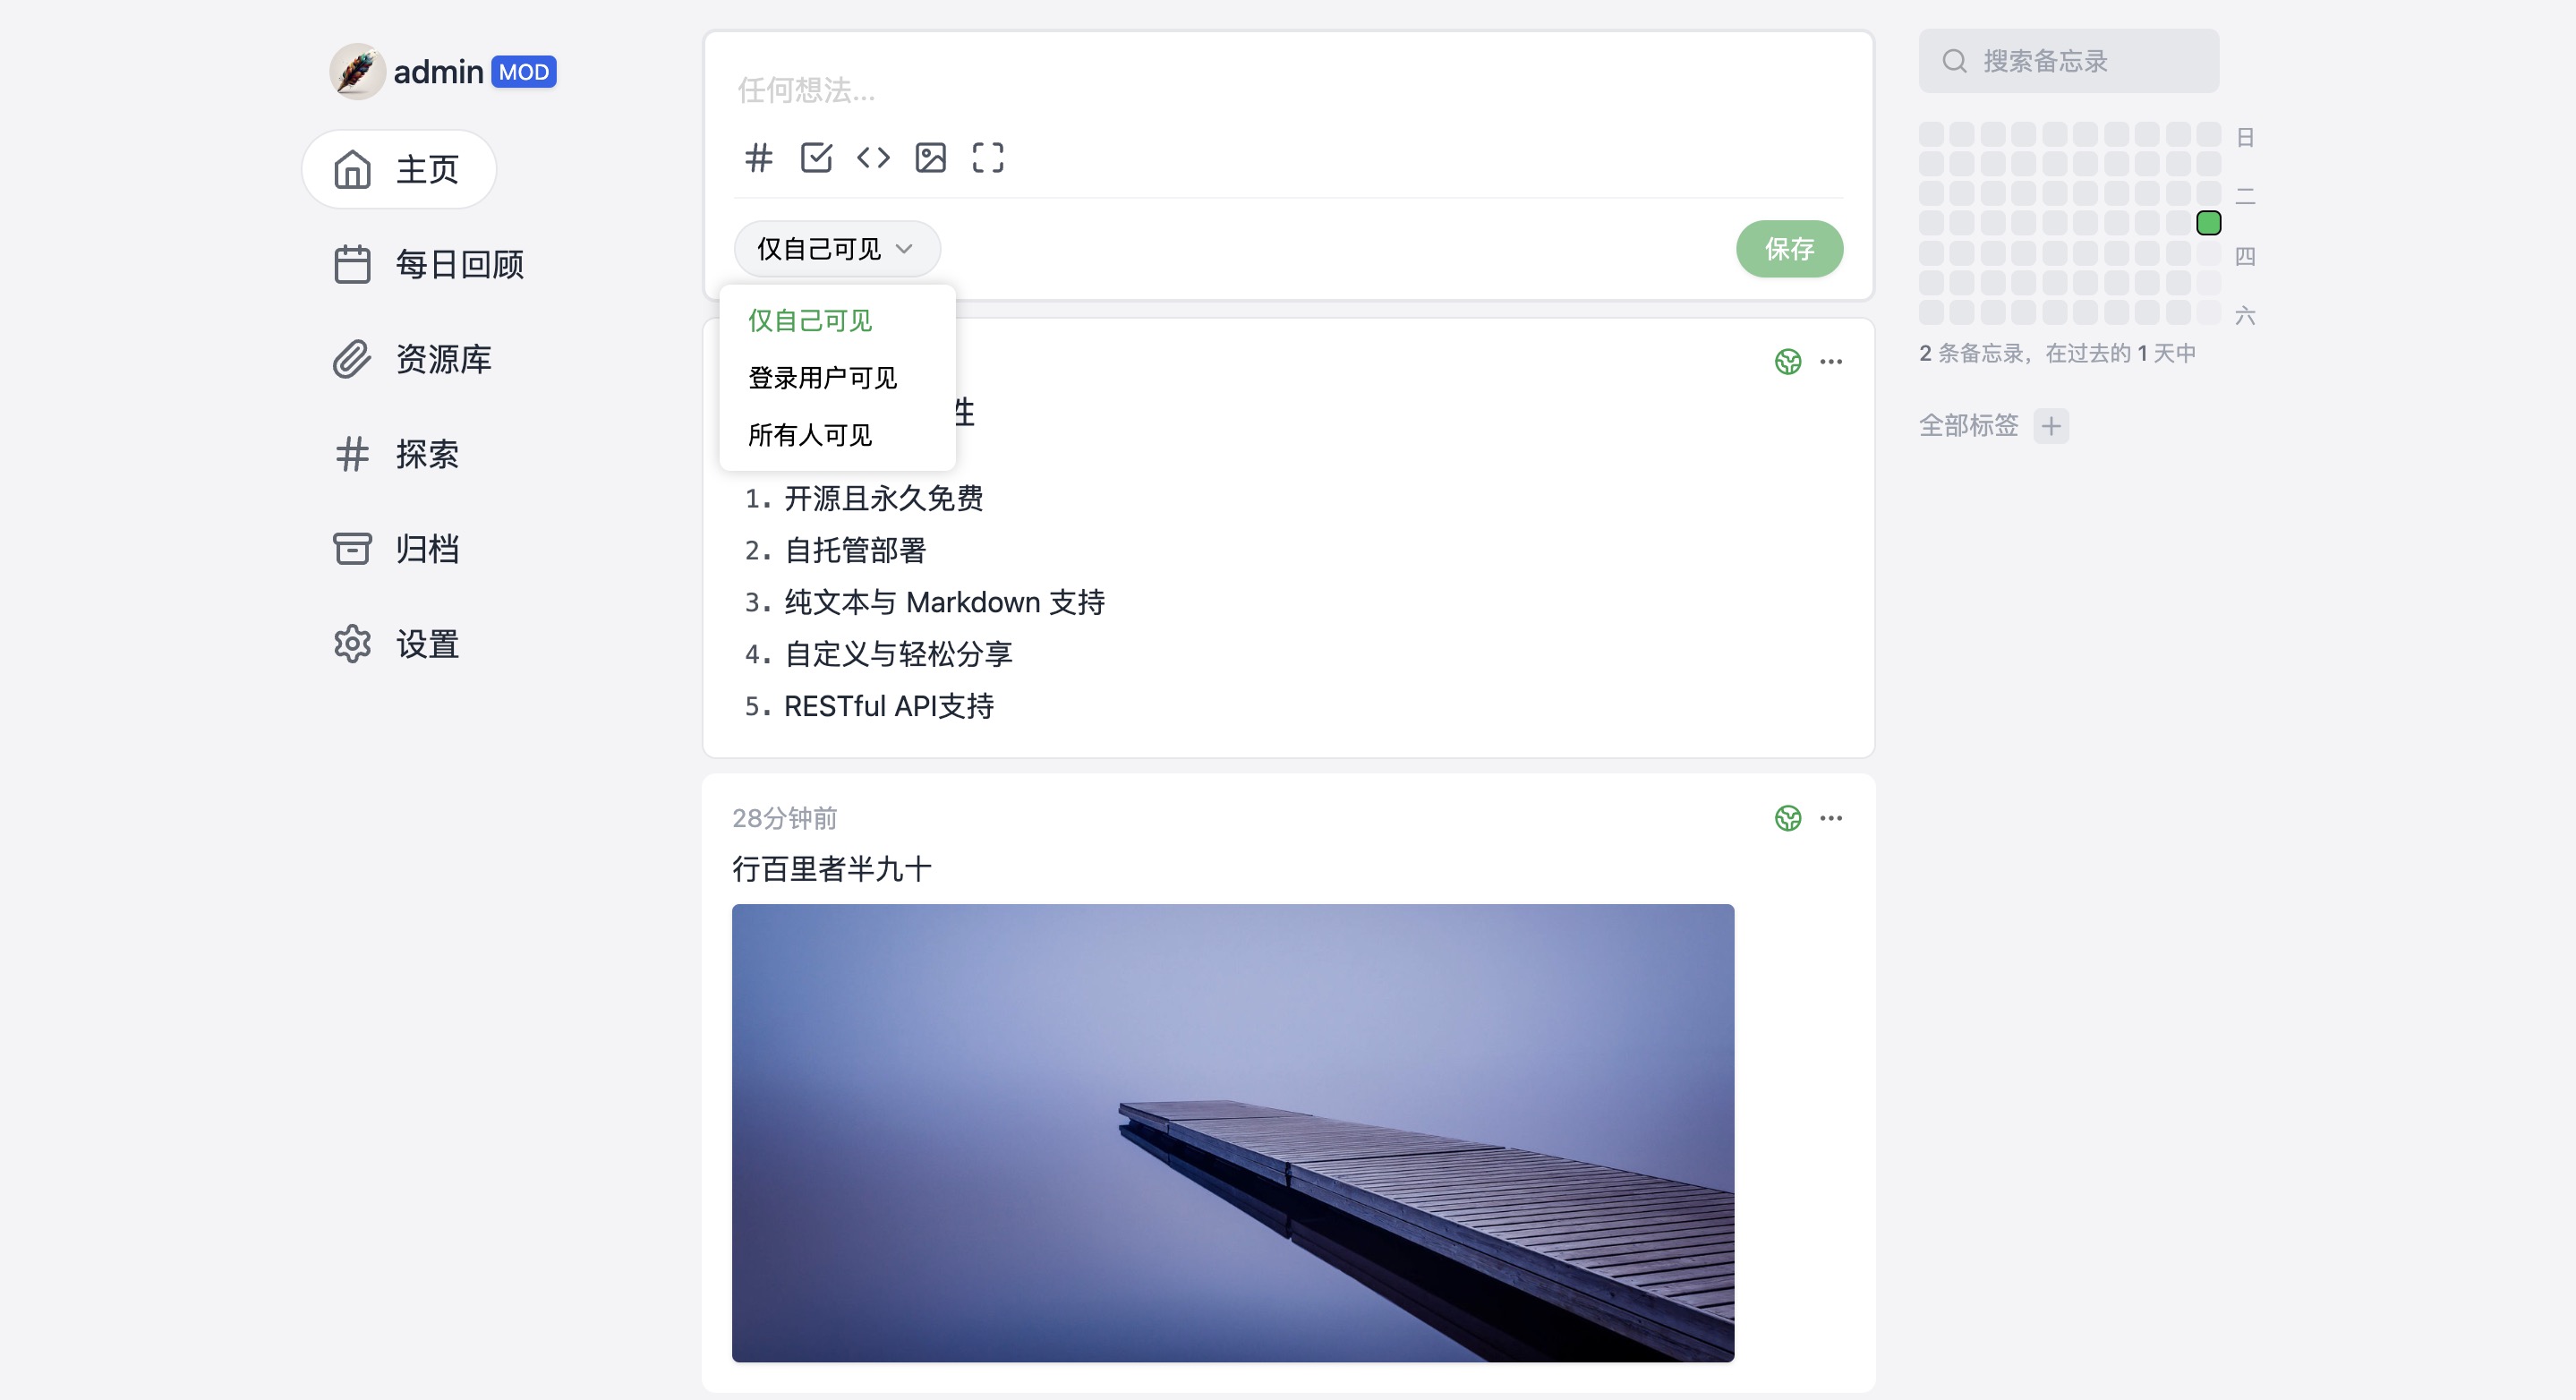
应用简览 Memos 是一个开源的轻量级笔记服务应用,它为用户提供了一个随时记录思绪和想法的私密空间,同时它支持私有化部署,这意味你可以完全掌控你的数据和隐私,同时它还提供了直观的分享功能,让你可以轻松地与他人协作和分享笔记。 主要特性 开源且永久免费:Memos 是一款开源的应用,永久免费使用。它鼓励创造力,让您的想法得以充分发挥,不受任何限制。 自托管部署:使用 Docker,可以在几秒钟内设置好 Memos,获得数据和隐私的完全控制权,提供了极大的灵活性和可扩展性。 纯文本与 Markdown 支持:Memos 坚持采用纯文本格式,摒弃了繁琐的富文本编辑,同时支持 Markdown,让您以极简主义的方式记录和分享笔记。 自定义与轻松分享:Memos 提供直观的自定义和分享功能,使你能够轻松地与他人合作和分享笔记,促进信息交流。 RESTful API支持:Memos 还提供了强大的 RESTful API,让您能够与第三方服务进行集成,开启全新的应用可能性。 应用特色 一、支持多用户,且允许设置可见范围 Memos 提供了多用户支持,这意味着可以与团队成员或朋友共享笔记,并轻松地管理多个用户帐户。而且,Memos 允许设置笔记可见范围,确保您的笔记只对登录用户、自己或全部可见。这一功能极大地增强了协作和隐私保护的灵活性。 二、支持资源库的形式存储各类文件 除了纯文本笔记,Memos 还支持资源库的形式存储各类文件。这意味着您不仅可以记录文字内容,还可以轻松地上传、存储和共享图片、音频、文档等多种文件类型。无论是项目资料、创意灵感还是照片集,Memos 都能满足你的多样化需求。 三、支持多种存储,以及多种类型的单点登录 Memos 提供多样化的后端存储选项,包括数据库、S3 和本地存储,确保您能够根据需求选择最适合的存储方式,为您的数据提供灵活性和可扩展性。此外,Memos 还支持多种类型的单点登录,如 Github、Gitlab、Google 等,同时还允许您自定义其他认证方式,为用户提供了便捷的登录和身份验证方式,从而平衡了安全性和便利性的需求。 四、支持图片、链接、嵌入式代码等方式分享笔记 Memos 提供了多种富有创意的笔记分享方式,包括图片、链接以及嵌入式代码等。这意味着您可以以更生动和多样的方式分享您的笔记内容。无论是展示精美图片、分享有用链接,还是嵌入代码示例以便他人参考,Memos 都为分享增添了更多的生动性和趣味性。 安装指南 进入云原生应用商店 搜索 Memos 进入详情,选择包类型(本应用支持,docker安装,ram安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档或加入社区 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。 官网:https://hub.grapps.cn/ 微信群:关注 云原生应用市场 公众号加入技术交流群

优秀的个人博客,低调大师

6K star

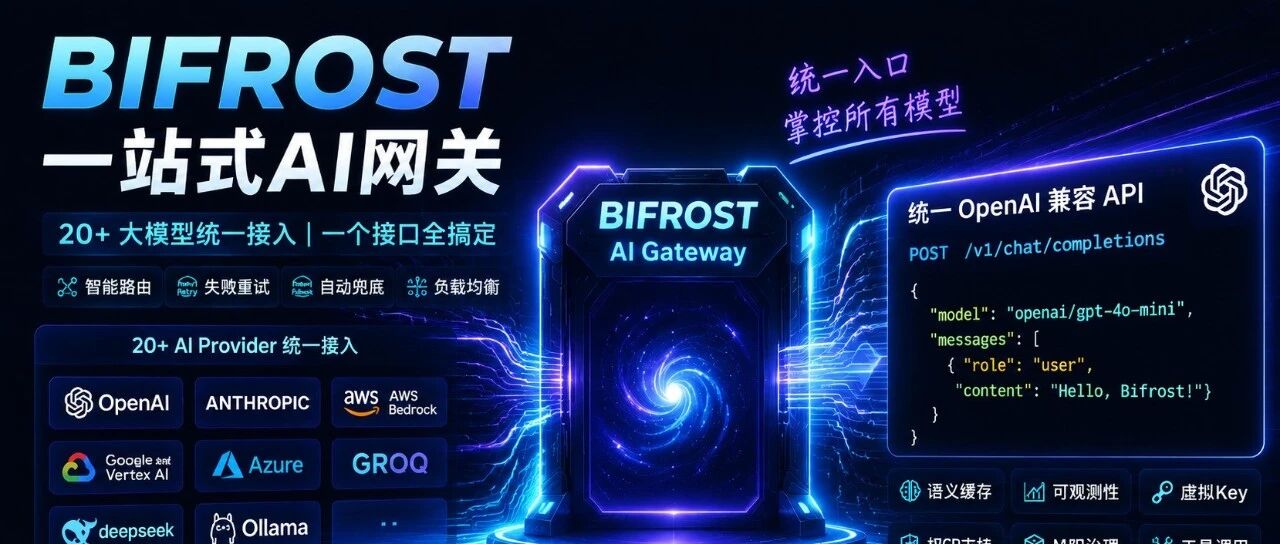
今儿刷 Github,撞见个这年头最磨人的活儿——把各家大模型入口收成一个口子——给干利索了的项目:bifrost。 ![Bifrost 快速启动](https://developer.qcloudimg.com/http-save/yehe-5359587/19ea3489e850ec52671edb1033f3df33.png) |Stars:6,379 | Forks:865 | License:Apache-2.0 | 主要语言:Go| | --- | ## 01 这玩意儿到底是啥 bifrost 是个开源的 AI 网关(AI Gateway)。 先说清楚,它本身不做模型。 它就夹在你的应用和那些模型厂商中间,给你当个"统一收口"的二传手。 你把 OpenAI、Anthropic、AWS Bedrock、Google Vertex、Azure、Groq、DeepSeek,还有本地跑的 Ollama,一股脑全接进来,然后统一用 OpenAI 那套接口去调——再也不用给每个厂商单独写一套对接代码了。 官方文档说得很直白:20 多个 AI provider 都吃这一套,一个统一 API 就把路由、fallback、负载均衡、缓存、治理全包了。从你发请求到厂商响应中间那堆破事,基本都给你平了。 ![Bifrost 架构图](https://developer.qcloudimg.com/http-save/yehe-5359587/fba4aa44782e337e4d17c6d8a87f93cb.png) 要是你手上已经有一套 OpenAI SDK 的调用代码,那接 bifrost 简单到离谱——本质上就是在中间把 base URL 换掉。 应用里再也不用把各家 provider 的 key 撒得到处都是。 模型切换、失败重试、限流、预算、日志这些原本要在每个业务里各自折腾的活儿,全塞进网关一层统一管。 ## 02 它到底在治什么毛病 AI 应用接模型,一开始都觉得特简单。 一个 key。一个 SDK。一个接口。齐活。 等接的厂商一多,麻烦就排着队来了。 同一个业务,可能 OpenAI、Claude、Bedrock、Gemini、本地模型得同时用着。 哪家 provider 抽风了,得切备用模型。 哪把 key 被限流了,得换另一把。 不同团队、不同客户、不同环境,还得各自有预算、速率限制和权限边界。 Bifrost 就是想把这些乱七八糟的破事,收进一个控制面里。 ![Bifrost 功能范围](https://developer.qcloudimg.com/http-save/yehe-5359587/526a8b16114b650a366cf6af501dbff0.png) 它文档里有个细节我挺服的,值得单拎出来说。 retry(重试)和 fallback(兜底)是**分开的**。 retry 管的是同一个 provider 内部的临时抽风——比如网络抖了、来了个 5xx、429,或者 key 坏了。 fallback 是主 provider 重试都耗尽了,才切到下一个 provider。 这个分层其实很工程化。因为线上真出问题的时候,往往不是"模型挂了"这么干脆,而是某一把 key、某一个 provider、某一种错误码在悄悄作妖。 ## 03 几个硬核看点 **第一,统一模型入口。** Bifrost 的请求走的是 `/v1/chat/completions` 这种 OpenAI 风格接口。模型名你可以直接写成 `openai/gpt-4o-mini` 这种 `provider/model` 的写法,也可以甩手让它自己去做 provider resolution。 **第二,自带 Web UI。** 一条 npx 或者一个 Docker 就能把 HTTP Gateway 起起来。 起来之后打开 `localhost:8080`,provider、API key、日志、缓存、治理规则,全在页面里点着配。 ![Bifrost UI 配置](https://developer.qcloudimg.com/http-save/yehe-5359587/7369847b2c157a6d9277ba52bd231cda.png) **第三,Virtual Keys(虚拟钥匙)。** 它把"谁能用哪些模型、花多少钱、每分钟打多少请求"这摊权限账,抽成了虚拟 key。 Virtual Key 既认 OpenAI 那套 `Authorization: Bearer`,也认 Anthropic、Gemini 常用的 key header。 多个团队共用一套模型网关的,这玩意儿简直救命。 ![Bifrost Virtual Key](https://developer.qcloudimg.com/http-save/yehe-5359587/d91f84ecc3c1b91826fe417c61f9f735.png) **第四,可观测。** 文档里写得很实:每次 AI 请求的**输入、输出、token、费用、延迟、provider、model、错误,连 retry 轨迹**都给你记下来。 而且日志插件是异步写,不堵在请求主路径上——这点对性能很友好。 ![Bifrost 请求追踪](https://developer.qcloudimg.com/http-save/yehe-5359587/5eb18988091ad28ba15a9b729d6e824c.png) ## 04 凭啥值得单独看一眼 说实在的,光是"又做了个统一模型调用",我本来不会单独拎它出来。这类轮子已经够多了。 Bifrost 值得看,是因为它把几个**正经工程问题**攒到一起一并解决了。 **一个是高可用。** 文档里说,在 5000 requests per second 的持续压测下,每次请求只多花约 11 微秒开销。 这数字你当然得结合自己环境看,但至少说明它不是按"跑个 demo 得了"的思路写出来的。 **一个是缓存。** 它支持直接 hash 命中,也支持基于 embedding 的语义缓存。 一样的问题直接复用回答,近似问题走相似度检索。 不过文档也把代价写明白了:语义缓存 miss 的时候,得先花一次 embedding 调用,完了还得再调一次 LLM——所以别无脑开。 ![Bifrost 缓存配置](https://developer.qcloudimg.com/http-save/yehe-5359587/603b04cea77b7fa296383fde22459791.png) **还有一个是 MCP。** Bifrost 没把 MCP 只当个工具调用入口糊弄。 它既能当 MCP client 去连外部工具服务器,也能当 MCP server,把已经接好的工具甩给 Claude Desktop、Cursor 这些 MCP client 用。 默认模式下,模型返回的 tool call 只是个**建议**。真要执行工具,得应用再调一个单独的接口。 这个默认值挺克制的,要审计的场景反而更省心。 ## 05 怎么把它跑起来 最小启动,简单到没脾气。 本机有 Node 就行: ``` npx -y @maximhq/bifrost ``` 用 Docker 也成: ``` docker pull maximhq/bifrost docker run -p 8080:8080 maximhq/bifrost ``` 然后浏览器打开: ``` http://localhost:8080 ``` 页面里先加一个 provider key。 再用最普通的 OpenAI 风格请求,打到本机这个网关上: ``` curl -X POST http://localhost:8080/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "openai/gpt-4o-mini", "messages": [{"role": "user", "content": "Hello, Bifrost!"}] }' ``` 想试稳定性?建议从 **retries 和 fallbacks** 入手。 先配一个主 provider,再配一个备用的。 看它失败的时候,是不是真按你预期去切。 ![Bifrost 重试配置](https://developer.qcloudimg.com/http-save/yehe-5359587/4671be92380ccbef7d1280460d413522.png) 想试治理?那就从 **Virtual Key** 开始。 给不同应用发不同的 key,把模型、预算、请求频率都限死。 想试 MCP?先用默认的**显式执行**流程。 别一上来就把自动执行打开。 ## 06 适合谁,以及先泼几盆冷水 这项目主要对三类人胃口: **第一类**,已经接了好几个模型供应商的团队。你们最缺的不是再封一层 SDK,而是统一路由、fallback、key 管理和日志。 **第二类**,做企业内部 AI 平台的人。预算、审计、虚拟 key、请求追踪、缓存……这些东西塞在应用里只会越来越散,挪到 gateway 这层才好管。 **第三类**,在研究 MCP 工具调用的人。Bifrost 那个默认显式执行、工具过滤、Agent Mode、Code Mode,都值得拆开扒一扒。 不过有几件事得先泼盆冷水: 它是网关,**天然就在关键路径上**。真要上生产,先按你自己的流量模型压一轮。 缓存也别乱开。直接缓存适合稳稳的重复请求;语义缓存你得算清楚命中率、embedding 成本,还有误命中的风险。 MCP 更要慎之又慎。既然能让模型调工具了,权限、审批、日志、回滚,一个都不能马虎。 说到底,这项目值得看,原因也正在这儿。 它不是只帮你"调到模型"。 它是在收拾 AI 应用**真跑起来之后**才会撞上的那一堆工程细节。 今天就先唠到这儿。我们下期再见!

优秀的个人博客,低调大师

Github 开源一周1.2k star,Go主打的第一款Agent IDE官宣开源了

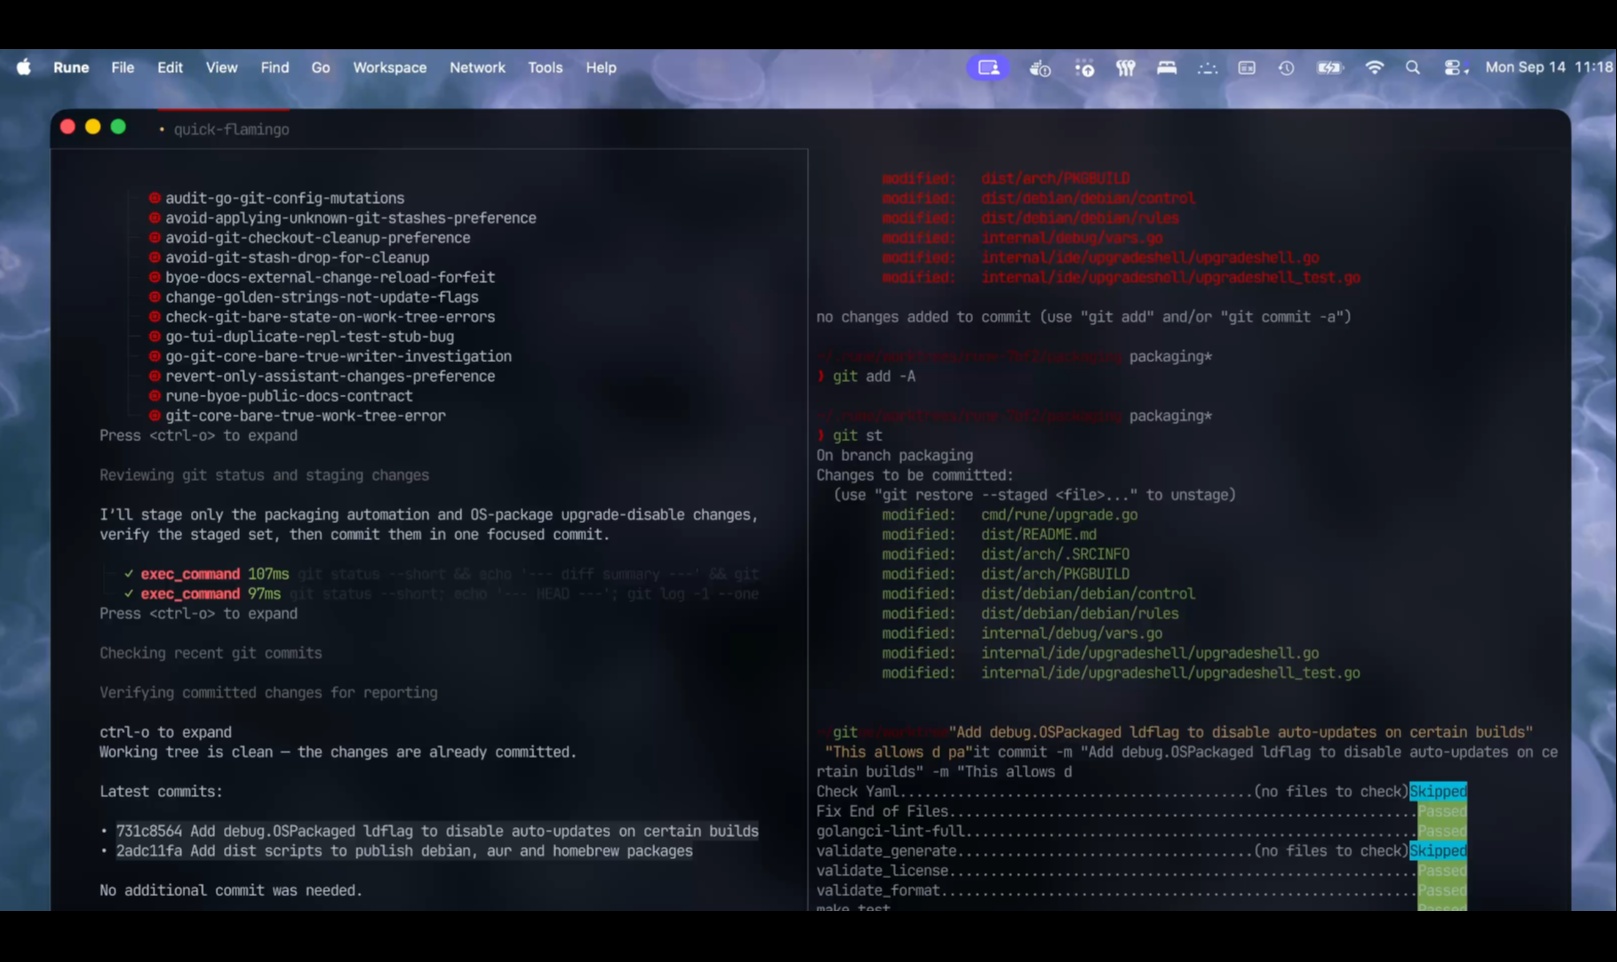
编辑器圈子又来新卷王了。刚开源的Rune IDE,Go语言写就,GPU加速渲染,把GUI编辑器和tmux终端体验揉到一块。它有几个脑洞大开的设计,和我们熟悉的VS Code完全不是一个思路,倒是多多少少有点Zed的影子。 这个IDE据作者介绍最早是因为再2017年的时候,因为使用vim写go,遇到跳转到定义失败,所以激发他开发一款新的IDE。 中间又经过了几年知道2022年的时候,作者被uber裁员,作者决定开公司专门使用Go来开发一款IDE。 直到2026年7月的时候,Rune官宣1.1版本正式发布,9月份的时候官宣开源。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/1303f9436321eb66a791122bd6de5892.png) 下面就通过Rune的介个主要新特性来认识下这款全新IDE。 ## 1、 键盘驱动 代码编辑、终端、命令行工具、语言智能分析、调试以及 AI 智能代理,全部整合进一套可自由组合、支持多工作区的开发环境。 rune内置3种编辑器,一种是标准的,就类似vscode,另外2种是vim,emacs。 选好一套键位(VS‑Code标准/Vim/Emacs三选一),**编辑器、终端、文件树、输入框全部统一这套按键**。不用在不同组件之间来回切换输入模式。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/ba30e5314d54e9d8102dbfac1881732c.png) 对重度模态编辑爱好者来说,这点简直是救星。再也不会出现“我明明按了Vim快捷键,结果往终端敲了一堆乱字符”的社死现场。 ## 2、 命令提示符 这个可以说是rune提出的一个新概念了,由于rune是键盘驱动的IDE,除了你再编辑器力输入代码,你输入的内容就是一条命令:打开文件、切分窗口、执行构建、跳转到定义。每一项操作都可以直接敲入命令执行,可以绑定快捷键,还可以串起来做成别名。 这个很类似于vscode,zed里面的命令面板,而且都是使用快捷键ctrl shift p打开 ## 3、 调试 rune已经内置了一些语言的调试器,比如你开发go,rune已经内置了go的调试器dlv,开箱即用,但是目前调试也是基于命令提示符来完成,比如打断点使用 命令debugger set-breakpoint,就会再当前光标所在行打赏断点,但是个人感觉可能有一个gui来调试会更方便。 ## 4、 文件浏览器 这里的文件浏览器并不是供你点击操作的树形控件。 它是一份对应整个工作区的实时可编辑缓冲区;**直接编辑这份文本缓冲区,就是你管理文件的方式**。 修改一行上的名称,对应的文件就完成重命名;删除一行,文件随即被删除; 调整一整块内容的缩进,这一批文件就会移动到另一个目录下面。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/4f52ee58091780f4397ca6b476aa0278.png) 你可以像普通编辑文本一样,一次性做完所有改动,最后保存一次并确认即可。 这是在 Rune 里面批量处理文件的最快方式。一旦你体会到这套用法的妙处,你可能就再也不想用别的方式管理文件方式,比如vscode 当然Rune目前还有短板,只支持macOS和Linux,Windows暂时缺席,生态也还很幼小。 不过这套设计思路很值得玩味:不去无脑复刻VS Code,而是重新思考编辑器到底该长什么样。 有人也认为这可能是下一代Agent IDE的最佳形式。

优秀的个人博客,低调大师

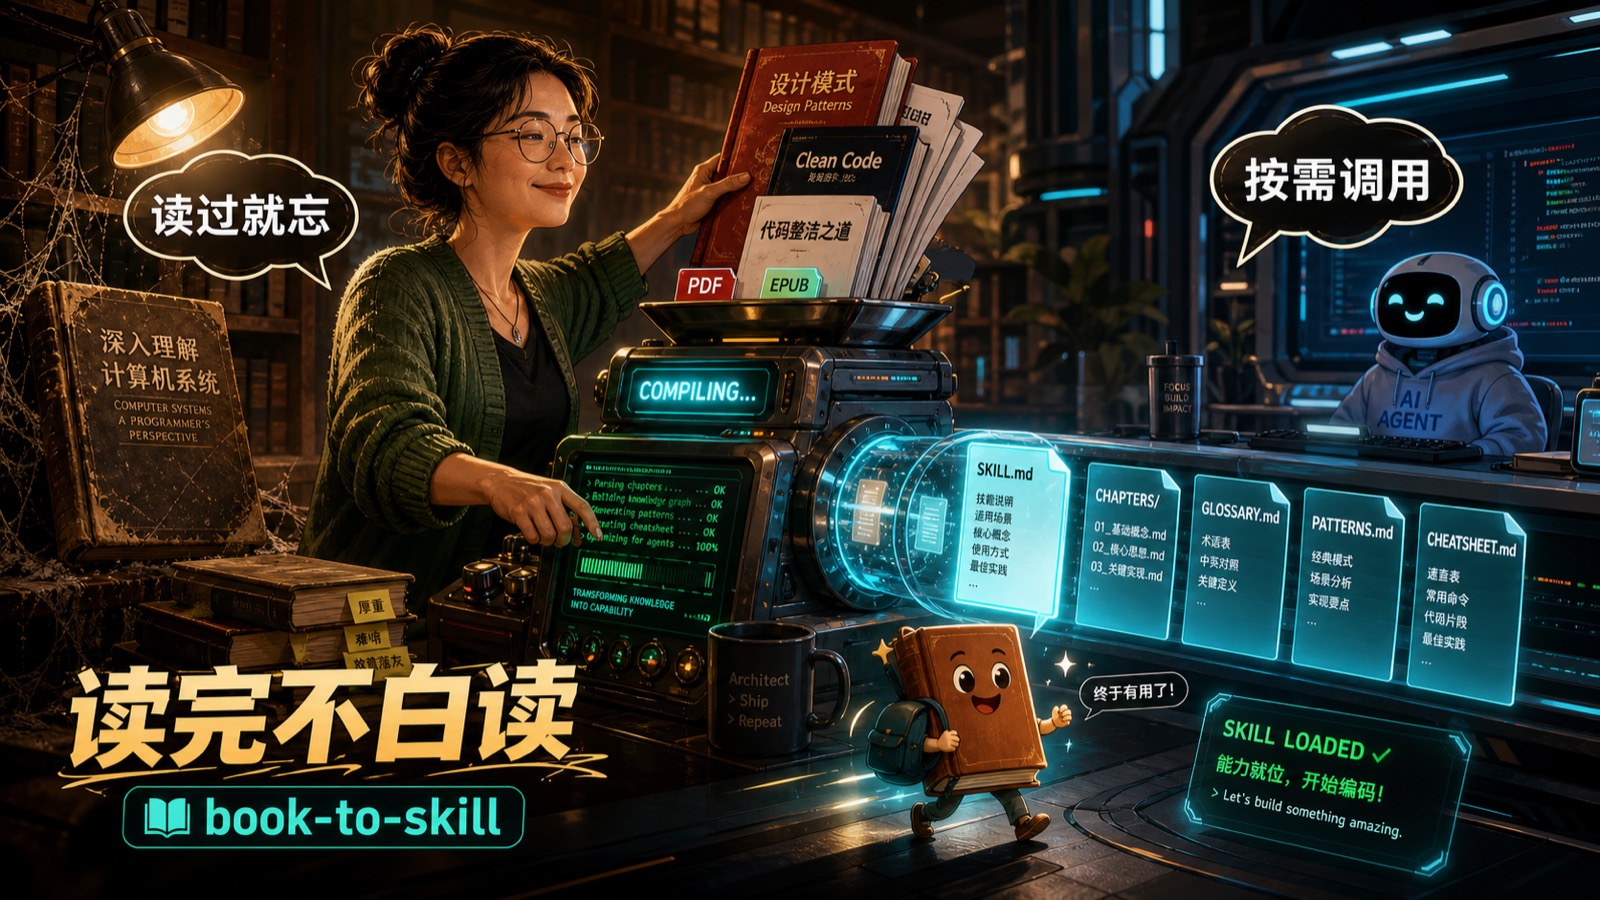
PDF 读完就忘,15k Star book-to-skill 把技术书编译成 Agent 的随身 Skill

嗨,我是小华同学,专注解锁高效工作与前沿AI工具!每日精选开源技术、实战技巧,助你省时50%、领先他人一步。👉免费订阅,与10万+技术人共享升级秘籍! > 很多人买技术书时信心满满,读完几章后也觉得“懂了”,但三个月后遇到问题,还是得重新翻 PDF、搜目录、找关键词。 > **book-to-skill 的反差在于:它不把书再总结成一篇更短的文章,而是把书“编译”成 Agent 可以按需调用的 Skill。** > 你以后问 Agent `/your-book replication`,它不是凭印象聊天,而是加载对应章节、术语和方法,直接从整理后的知识结构里回答。 ![](https://developer.qcloudimg.com/http-save/yehe-3875637/0c3dab76c3680c8943739462c5724ef1.jpg) ## 先说痛点:读过,不等于用得上 技术资料最容易出现三种浪费: - PDF 在硬盘里,但 Agent 不知道它存在; - 你做过笔记,但笔记变成一篇永远不会再打开的长文; - 每次提问都让 Agent 重新翻目录、找章节、回忆上下文,既慢又费 Token。 传统的“把整本书塞进上下文”看起来直接,实际上会让模型面对过量内容;“只做摘要”又容易丢掉决策规则、反模式、代码示例和章节关联。 book-to-skill 选择了第三条路:**先付一次整理成本,把资料拆成结构化、可发现、可按需加载的知识资产。** ## 一句话理解 book-to-skill **它是一个把书籍、文档目录或多份资料转换成 Agent Skill 的命令行工具。** 输入可以是一个文件、一个目录、一个 glob,甚至是一组不同格式的资料;输出不是一篇普通总结,而是一套有层次的 Skill: |输出文件|主要作用|Agent 什么时候读| | --- | --- | --- | |SKILL.md|核心心智模型、章节索引、使用入口|每次加载 Skill 时先读| |chapters/|每章的按需知识文件|问到具体章节或主题时| |glossary.md|术语、定义和章节引用|遇到陌生概念时| |patterns.md|技术、算法、设计模式和实践方法|需要解决类似问题时| |cheatsheet.md|决策表和快速规则|需要快速查判断时| 这套结构的关键不是文件多,而是把“核心知识”和“细节知识”分开,让 Agent 不必每次都把整本书重新搬进对话。 ## 它最值得关注的 4 个点 ### 1. 不是总结,而是提炼“可执行知识” 普通摘要常常告诉你“这一章讲了什么”,但真正工作时更想知道: - 什么场景应该用这个方法? - 哪些情况不应该用? - 决策顺序是什么? - 常见反模式有哪些? - 代码或表格示例在哪里? book-to-skill 的设计原则是 practitioner voice,也就是把内容提炼成“什么时候用 X、为什么、要避开什么”的工作规则,而不是把原文换一种说法再抄一遍。 ### 2. 章节按需加载,避免每次重新发现 一个 Agent 直接读 PDF,往往会经历一段隐形的“发现循环”:找目录、遇到术语、回头翻页、加载更多内容,再把读到的东西压缩回主对话。 book-to-skill 把这笔导航成本前置到生成阶段。运行时先加载体积较小的 `SKILL.md`,根据问题再定位到具体章节、术语表或 patterns 文件。 ![](https://developer.qcloudimg.com/http-save/yehe-3875637/4d51ec7bdac07cc07ff73e9b0dacd4d8.jpg) ### 3. 技术书和普通书,走不同的提取路线 项目不会对所有 PDF 一刀切: - 技术型资料优先考虑 Docling,以尽量保留 Markdown 表格和代码块; - 文字型资料优先使用 `pdftotext`,再按需回退到 `pypdf`、`pdfminer`; - EPUB、DOCX、HTML、RTF、MOBI 等格式也有对应提取器或回退方案。 这点很工程化:**提取不是越快越好,而是要看原始资料里有没有代码、表格和结构信息。** 如果把一本技术书当纯文本处理,最后得到的 Skill 可能“读起来完整,拿来用却缺关键结构”。 ### 4. 支持把新资料折叠回已有 Skill 它不只支持从零生成新 Skill,也支持把新论文、新章节、新笔记合并进已有 Skill 目录。 这让知识库更像一个会持续更新的工程产物:先把一本书编译成 Skill,之后再把实践记录、补充文章和新版本文档 fold in,而不是每次重新从零生成一套孤立笔记。 ## 3 步看懂它怎么工作 ``` 资料文件 / 文档目录 / glob │ ▼ 选择提取路线:技术型 or 文字型 │ ▼ 合并文本 + 元数据 + 来源标记 │ ▼ 分析标题、作者、章节、目录和知识结构 │ ▼ 生成 SKILL.md、章节、术语表、patterns、cheatsheet │ ▼ Agent 按需加载并用于工作 ```bash ``` 最简单的使用方式是: ``` /book-to-skill ./my-book.pdf ```bash ``` 也可以一次处理多个资料,或者把新资料合并进已有 Skill: ``` /book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research /book-to-skill ~/articles/new-paper.pdf ~/.claude/skills/project-knowledge ```bash ``` 官方仓库的原始页面显示,它不是一个只有 README 的概念项目,而是包含 `book_to_skill`、`scripts`、`docs`、`tests` 和 `tools` 等目录,并配有命令行入口和测试结构。 ![](https://developer.qcloudimg.com/http-save/yehe-3875637/c3d2076045243210212e41e5827a147e.jpg) ## 它和“让 Agent 直接读 PDF”有什么不同? |方式|处理方式|每次提问的代价|知识能否复用| | --- | --- | --- | --- | |直接把 PDF 塞进上下文|运行时临时发现和读取|上下文长,导航成本高|弱| |只做一篇摘要|一次压缩成短文|细节、规则和章节关系容易丢|中| |手写长笔记|人工整理和维护|维护成本高,结构不统一|取决于个人| |book-to-skill|编译成分层 Skill,按需加载|先整理,运行时按主题读取|强| README 提到,在真实书籍测试中,它测得的 Token 消耗比直接把书倒进上下文少 24 到 51 倍。这个数字属于项目自己的基准,不代表每一本书都能达到同样结果,但它说明了一个方向:**把“阅读和导航”从每次对话里拿出来,提前编译一次。** ## 程序员可以怎么用? - 把《Designing Data-Intensive Applications》编译成可查的架构 Skill; - 把团队内部架构文档、运行手册和 onboarding 文档合成一套知识 Skill; - 把 RFC、API 合约和合规标准变成可在写代码时查询的规则库; - 把品牌规范、设计系统和代码规范转成 Agent 的工作上下文; - 把论文、实验记录和自己的补充笔记持续 fold in,形成研究 Skill。 它真正适合的是“会反复用到,但不想每次重新翻”的知识,而不是只看一次、没有后续行动的资料。 ## 项目边界与限制:它不是知识库万能替代品 book-to-skill 解决的是资料提取、结构化和 Agent 按需加载,不是所有知识管理问题: - 生成质量依赖原始文档结构和提取器能力; - OCR 质量差、扫描版 PDF 或复杂排版,仍可能需要人工校验; - Skill 生成之后仍需要版本管理和更新策略; - “No hallucination”是项目目标,不能替代对关键技术结论的验证; - 生成的 `SKILL.md` 能否被某个 Agent 客户端直接发现,取决于该客户端是否支持对应的 Agent Skills 目录和加载约定。 项目采用 MIT License,适合拿来研究,也适合根据自己的团队知识流改造成内部工具。 ## 我的判断 book-to-skill 最有价值的地方,不是帮你少看几页 PDF,而是把“读过的知识”从静态文件变成了 Agent 可以调用的工作能力。 **书不再只是被问一次的资料,而可以变成一套会在真实任务里被反复调用的 Skill。** 如果你正在积累技术书、内部文档、论文或规范,建议先拿一份 20 到 50 页的资料试跑:看它生成的 `SKILL.md` 是否抓住了核心心智模型,再检查章节索引、术语表、patterns 和 cheatsheet 能不能真正辅助下一次工作。 后续我会继续拆解:如何为自己的知识库设计 Skill 目录、如何让不同 Agent 共用一套 Skill,以及怎样对生成结果做质量回归。 ## 项目地址 [https://github.com/virgiliojr94/book-to-skill](https://github.com/virgiliojr94/book-to-skill)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册