首页 文章 精选 留言 我的

精选列表

搜索[流程管理],共10000篇文章
优秀的个人博客,低调大师

Elasticsearch + php + msyql+nginx安装流程

sudo yum -y install gcc gcc-c++ autoconf libjpeg libjpeg-devel libpng libpng-devel freetype freetype-devel libxml2 libxml2-devel zlib zlib-devel glibc glibc-develglib2 glib2-devel bzip2 bzip2-devel ncurses ncurses-devel curl curl-devele krb5 krb5-devel libidn libidn-devel openssl openssl-devel openldap openldap-devel nss_ldap openldap-clients openldap-servers #nginx所需要的库文件件 sudo yum -y install pcre-deve l zlib-deve l gd gd-deve l freetype net-tools yum -y install pcre* #PHP依赖的库文件 sudo yum -y install gd-devel libjpeg-devel libpng-devel freetype-devel libxml2-devel curl-devel yum -y install mysql mysql-devel //尽可能用源码编译安装 yum -y install mysql-server //尽可能用源码编译安装 mysql -uroot -p #登陆方式 3.登录MySQL修改密码 mysql -uroot -S /opt/mysql/3306/mysql.sock mysql> flush privileges; mysql> set password for root@'localhost'= password('miaohr1qaz'); 4.登录数据库给multi用户添加权限 mysql -uroot -S /opt/mysql/3306/mysql.sock -pmiaohr1qaz mysql> GRANT SHUTDOWN ON *.* TO 'multi'@'localhost' IDENTIFIED BY 'multi'; 5.设置root远程访问 mysql> UPDATE mysql.user SET Host='%' WHERE Host='localhost'; mysql> GRANT ALL PRIVILEGES ON *.* TO 'root'@'%'; mysql> FLUSH PRIVILEGES; nginx 安装 ./configure --prefix=/usr/nginx make make install 匹配nginx.conf开启 location ~ \.php$ { root html; fastcgi_pass 127.0.0.1:9000 fastcgi_index index.php fastcgi_param SCRIPT_FILENAME /usr/nginx/html$fastcgi_script_name; include fastcgi_params; } 启动nginx /usr/nginx/sbin/nginx 重启 /usr/nginx/sbin/nginx -s reload php安装方法 mysql_config 没有的话是因为没有安装mysql-devel (mysql_config 是一个绿色的可执行文件) ./configure --prefix=/data/local/php \ --enable-fpm \ --with-zlib \ --enable-mbstring \ --with-openssl \ --with-mysqli \ --enable-mysqlnd \ --with-mysql-sock \ --with-gd \ --enable-gd-native-ttf \ --enable-pdo \ --with-pdo-mysql \ --with-gettext \ --with-curl \ --enable-sockets \ --enable-bcmath \ --enable-xml \ --with-bz2 \ --enable-zip \ -enable-pcntl make make install 从php的解压包里 cp php.ini-development /usr/php/lib/php.ini 在/usr/php/etc/里 cp /usr/php/etc/php-fpm.conf.default /usr/php/etc/php-fpm.conf date.timezone = “Asia/Shanghai” default_charset = "utf-8" 然后启动nginx,mysql 和/usr/php/sbin/php-fpm ps aux | grep -c php-fpm 查看状态 服务器1 cluster.name: ejiqun node.name: node1 node.rack: r1 #机架号 最好不同 path.data: /elastic_data/data path.logs: /elastic_data/logs network.host: 192.168.1.210 http.port: 9200 transport.tcp.port: 9300 #设置节点之间交互的端口号 discovery.zen.ping.timeout: 120s #设置集群中自动发现其他节点时ping连接的超时时间 discovery.zen.ping.multicast.enabled: true #设置是否打开多播发现节点 discovery.zen.ping.unicast.hosts: ["192.168.1.210:9300", "192.168.1.211:9300"] 服务器2 cluster.name: ejiqun node.name: node2 node.rack: r2 #机架号 最好不同 path.data: /elastic_data/data path.logs: /elastic_data/logs network.host: 192.168.1.211 http.port: 9200 transport.tcp.port: 9300 #设置节点之间交互的端口号 discovery.zen.ping.timeout: 120s #设置集群中自动发现其他节点时ping连接的超时时间 discovery.zen.ping.multicast.enabled: true #设置是否打开多播发现节点 discovery.zen.ping.unicast.hosts: ["192.168.1.210:9300", "192.168.1.211:9300"] 安装jdk 去http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html中下载jdk的安装文件。由于我的Linux是32位的,因此我下载jdk-8u25-linux-i586.tar.gz文件。 新建/usr/java文件夹,将jdk-8u25-linux-i586.tar.gz放到该文件夹中,并将工作目录切换到/usr/java目录下。 执行命令tar -zxvf jdk-8u25-linux-i586.gz 进行解压,解压后发现/usr/java多了一个jdk1.8.0_25文件夹。 通过以上步骤,jdk就已经全部安装完成了。下面,就是环境变量的配置。 配置环境变量 使用vim /etc/profile编辑profile文件 在/etc/profile底部加入如下内容 JAVA_HOME=/usr/java/jdk1.8.0_25 PATH=$JAVA_HOME/bin:$PATH CLASSPATH=$JAVA_HOME/jre/lib/ext:$JAVA_HOME/lib/tools.jar export PATH JAVA_HOME CLASSPATH 以上,环境变量配置完成。需要注意的是,PATH在配置的时候,一定要把$JAVA_HOME/bin放在前面,不然使用java命令时,系统会找到以前的java,再不往下找了。这样java这个可执行文件运行的目录其实不在$JAVA_HOME/bin下,而在其它目录下,会造成很大的问题。 还要注意,以前其它教程写的CLASSPATH=$JAVA_HOME/lib.tools.jar,不知道以前的版本是怎么样的,现在的版本是没有这样的jar包的。 最后使用source /etc/profile让profile文件立即生效。 命令测试 使用javac命令,不会出现command not found错误 使用java -version,出现版本为java version "1.8.0_25" echo $JAVA_HOME, echo $CLASSPATH, echo $PATH,看看自己的配置是否都正确。 elasticsearch-jdbc使用 第一步:环境匹配 1)elasticsearch 2.3.3 成功安装部署 2)mysql安装成功,增删改查无误~~。 3)要保证elasticsearch-jdbc的版本要与elasticsearch的版本是一致的(下面的内容会提示下载)。否则会报错,无法进行之后的步骤。 (例如elasticsearch-jdbc-2.3.3.0-dist.zip(对应的你的elaseticsearh-2.3.3) 第二步:下载JDBC工具 选择你需要的版本进行下载。(例如elasticsearch-jdbc-2.3.3.0-dist.zip(对应的你的elaseticsearh-2.3.3) ,下载后缀为dist.zip的即可) 地址: http://xbib.org/repository/org/xbib/elasticsearch/importer/elasticsearch-jdbc/ 解压下载的文件unzip elasticsearch-jdbc-2.3.3.0-dist.zip 解压下载的文件unzip elasticsearch-jdbc-2.3.3.0-dist.zip 创建mysql脚本计划任务 cd /elasticsearch-jdbc-2.3.3.0/bin/ (在bin目录下建立我们的新脚本) vi import_es.sh #!/bin/sh bin=/elasticsearch-jdbc-2.3.3.1/bin lib=/elasticsearch-jdbc-2.3.3.1/lib echo '{ "type" : "jdbc", "jdbc": { "elasticsearch.autodiscover":true, "elasticsearch.cluster":"ejiqun", "url":"jdbc:mysql://10.0.8.7:3306/bo", "user":"caiyun", "password":"bo2016.", "sql":"select email from members", "elasticsearch" : { "host" : "192.168.48.129", "port" : 9300 }, "index" : "test", "type" : "ffcs" } }' | java \ -cp "${lib}/*" \ -Dlog4j.configurationFile=${bin}/log4j2.xml \ org.xbib.tools.Runner \ org.xbib.tools.JDBCImporter 为 import_es.sh 添加可执行权限。 chmod a+x import_es.sh //(a+x 是给所有人加上可执行权限,包括所有者,所属组,和其他人 o+x 只是给其他人加上可执行权限) 执行脚本:./import_es.sh 第五步:检测数据是否新增成功 curl 'localhost:9200/_cat/indices?pretty' //索引是否有新增呢?? curl -XGET 'http://localhost:9200/test/ffcs/_search?pretty' //抓取显示数据 通过各种条件查询 curl 'localhost:9200/test/ffcs/_search?pretty' -d ' { "filter":{"term":{"name":"john"}} }'
优秀的个人博客,低调大师

Hadoop YARN 的工作流程简述

1、Client 向 YARN 提交应用程序,其中包括 ApplicationMaster 程序及启动 ApplicationMaster 命令2、ResourceManager 为该 ApplicationMaster 分配第一个 Container,并与对应的 NodeManager 通信,要求它在这个 Container 中启动应用程序的 ApplicationMaster3、ApplicationMaster 向ResourceManager 注册4、ApplicationMaster 为 Application 的任务申请并领取资源5、获取到资源后,要求对应的 NodeManager 在 Container 中启动任务6、NodeManager 收到 ApplicationMaster 的请求后,为任务设置好运行环境(包括环境变量、JAR 包等),将任务启动脚本写到一个脚本中,并通过运行该脚本启动任务7、各个任务通过 RPC 协议向 ApplicationMaster 汇报自己的状态和进度,以让 ApplicationMaster 随时掌握各个任务的运行状态,从而可以在失败时重启任务8、应用程序完成后,ApplicationMaster 向 ResourceManager 注销并关闭自己实际中,集群可能并没有那么多资源来满足 ApplicationMaster 的资源请求,这是 ApplicationMaster 会采用轮循的方式不断申请资源,直到申请到资源或 Application 结束

优秀的个人博客,低调大师

iOS打包ipa给客户测试流程

IOS项目开发的过程中经常会用到一个测试的问题,特别是外包的项目,客户拿了那么多钱,看不到产品时时的进度说不过去,而且UI和功能是否和符合用户需求这个很重要,需要客户的认同。 所以就需要时时给开发中的产品打包,让客户去检查是否符合需求。 接入正题: 先讲一下大概的思路,具体的步骤往下看。 1.往开发者账号里面添加测试设备 2.创建证书和配置文件(配置文件选设备和证书的时候建议都选) 3.打包 4.安装到客户的手机 具体细节: 有些外包是用外包的开发者账号,有的是用人家公司的开发者账号,其实都无所谓了。只要打包时候的开发者账号和你添加设备的开发者账号一样就行了。 1.进入开发者中心,找到证书配置文件那一页 2.创见证书(并下载到电脑上,双击添加到登录里面) 3.创建APPID 4.添加设备(主要就是UDID,要把所有测试设备的UDID都添加进来,不然将来打包安装不上,获取UDID参见:http://www.cnblogs.com/BK-12345/p/5996372.html) 5.创建配置文件(选择证书的时候建议有多少选多少,设备也一样全部选中) 6.接着就是将创建好的配置文件下载到电脑上,双击配置文件,在Xcode中选择刚才创建的配置文件即可。 7.在选择模拟器的地方调成Generic iOS Device。 8.Produc->Archive 9.Export(和正常的一样)->会有四个选项,选最后一个Save for Development Deloyment,然后next,选择刚才导入的证书,next,next ,next,Export选个地方保存一下就可以了。 10.就是将打好包安装到手机上,参考一下链接:http://www.cnblogs.com/BK-12345/p/6000124.html

优秀的个人博客,低调大师

Ganglia+Hadoop+Hbase监控搭建流程

Hadoop集群基本部署完成,接下来就需要有一个监控系统,能及时发现性能瓶颈,给故障排除提供有力依据。监控hadoop集群系统好用的比较少,自身感觉ambari比较好用,但不能监控已有的集群环境,挺悲催的。ganglia在网上看到原生支持Hadoop、Hbase性能监控,试用一段时间感觉还不错,监控项比较全面,配置简单,软件包在epel网络源中,使用yum安装方便快捷。Ganglia是一个开源集群监控系统,主要用来监控系统性能,如:cpu、mem、硬盘利用率、I/O负载、网络流量等。Ganglia涉及到三个组件:gmond:被监控端代理程序,用于收集监控信息,并发送给gmetad。gmetad:定期从gmond获取数据,并将数据存储到RRD存储引擎中。ganglia-web:WEB前端,RRD绘图后通过PHP展示。 1.CentOS6 YUM源自带epel网络源,直接安装[root@sht-sgmhadoopnn-01 ~]# yum install epel-release[root@sht-sgmhadoopnn-01 ~]# yum install ganglia-web ganglia-gmetad ganglia-gmond 2.配置监控程序[root@sht-sgmhadoopnn-01 ~]# vi /etc/ganglia/gmetad.confdata_source "hadoop_hbase_cluster" 172.16.101.55:8649 172.16.101.56:8649 172.16.101.58:8649 172.16.101.59:8649 172.16.101.60:8649case_sensitive_hostnames 1setuid_username "root"gridname "MyGrid" 3.关联Apache,因为Ganglia自创建的配置ganglia.conf有问题,所以先删除,再创建个软连接到Apache根目录下[root@sht-sgmhadoopnn-01 ~]# rm /etc/httpd/conf.d/ganglia.conf rm: remove regular file `/etc/httpd/conf.d/ganglia.conf'? y[root@sht-sgmhadoopnn-01 ~]# ln -s /usr/share/ganglia /var/www/html/ganglia[root@sht-sgmhadoopnn-01 ~]# 4.启动Apache和Ganglia,并设置开机启动 [root@sht-sgmhadoopnn-01 ~]# chown -R root:root /var/lib/ganglia [root@sht-sgmhadoopnn-01 ~]# service httpd startStarting httpd: [ OK ][root@sht-sgmhadoopnn-01 ~]# service gmetad startStarting GANGLIA gmetad: [ OK ][root@sht-sgmhadoopnn-01 ~]# 5.安装与配置被监控端(每台同样配置)# yum install ganglia-gmond# vi /etc/ganglia/gmond.conf globals { daemonize = yes setuid = yes user = root ##root debug_level = 0 max_udp_msg_len = 1472 mute = no deaf = no allow_extra_data = yes host_dmax = 86400 /*secs. Expires (removes from web interface) hosts in 1 day */ host_tmax = 20 /*secs */ cleanup_threshold = 300 /*secs */ gexec = no # By default gmond will use reverse DNS resolution when displaying your hostname # Uncommeting following value will override that value. # override_hostname = "mywebserver.domain.com" # If you are not using multicast this value should be set to something other than 0. # Otherwise if you restart aggregator gmond you will get empty graphs. 60 seconds is reasonable send_metadata_interval = 0 /*secs */ } cluster{ name = "hadoop_hbase_cluster" #集群名,和上面那个一样 owner = "root" ##root latlong = "unspecified" url = "unspecified"} /* Thehost section describes attributes of the host, like the location */host { location = "unspecified"} /*Feel free to specify as many udp_send_channels as you like. Gmond used to only support having a single channel*/udp_send_channel{ #bind_hostname = yes # Highly recommended,soon to be default. # This option tells gmond to use asource address # that resolves to themachine's hostname. Without # this, the metrics mayappear to come from any # interface and the DNSnames associated with # those IPs will be usedto create the RRDs. #mcast_join = 239.2.11.71 #关闭多播 host = 172.16.101.55 #添加发送IP/主机名 port = 8649 #默认端口 ttl = 1} /* Youcan specify as many udp_recv_channels as you like as well. */udp_recv_channel{ #mcast_join = 239.2.11.71 port = 8649 bind = 172.16.101.55 #------------ 本机的ip/hostname 接收地址 retry_bind = true # Size of the UDP buffer. If you are handlinglots of metrics you really # should bump it up to e.g. 10MB or evenhigher. # buffer = 10485760}…… 6.同步[root@sht-sgmhadoopnn-01 ~]# scp /etc/ganglia/gmond.conf root@sht-sgmhadoopnn-02:/etc/ganglia/gmond.confgmond.conf 100% 8769 8.6KB/s 00:00 You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 ~]# scp /etc/ganglia/gmond.conf root@sht-sgmhadoopdn-02:/etc/ganglia/gmond.confgmond.conf 100% 8769 8.6KB/s 00:00 [root@sht-sgmhadoopnn-01 ~]# scp /etc/ganglia/gmond.conf root@sht-sgmhadoopdn-01:/etc/ganglia/gmond.confgmond.conf 100% 8769 8.6KB/s 00:00 [root@sht-sgmhadoopnn-01 ~]# scp /etc/ganglia/gmond.conf root@sht-sgmhadoopdn-03:/etc/ganglia/gmond.confgmond.conf 100% 8769 8.6KB/s 00:00 #### 修改各个节点的gmond.conf的bind 为本节点ip 7.运行gmond (每台节点)[root@sht-sgmhadoopnn-01 ~]# service gmond start[root@sht-sgmhadoopnn-02 ~]# service gmond start[root@sht-sgmhadoopdn-01 ~]# service gmond start[root@sht-sgmhadoopdn-02 ~]# service gmond start[root@sht-sgmhadoopdn-03 ~]# service gmond start 8.添加Hadoop被Ganglia监控,去掉文件中以***释并修改(每台同样配置)[root@sht-sgmhadoopnn-01 ~]# vi $HADOOP_HOME/etc/hadoop/hadoop-metrics2.properties*.sink.ganglia.class=org.apache.hadoop.metrics2.sink.ganglia.GangliaSink31*.sink.ganglia.period=10*.sink.ganglia.supportsparse=true*.sink.ganglia.slope=jvm.metrics.gcCount=zero,jvm.metrics.memHeapUsedM=both*.sink.ganglia.dmax=jvm.metrics.threadsBlocked=70,jvm.metrics.memHeapUsedM=40namenode.sink.ganglia.servers=172.16.101.55:8649 #当有多个ganglia监控系统时,以逗号分隔datanode.sink.ganglia.servers=172.16.101.55:8649 #都指定ganglia服务器resourcemanager.sink.ganglia.servers=172.16.101.55:8649nodemanager.sink.ganglia.servers=172.16.101.55:8649 [root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.properties sht-sgmhadoopnn-02:/hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.propertieshadoop-metrics2.properties 100% 3183 3.1KB/s 00:00 You have new mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.properties sht-sgmhadoopdn-03:/hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.propertieshadoop-metrics2.properties 100% 3183 3.1KB/s 00:00 [root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.properties sht-sgmhadoopdn-02:/hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.propertieshadoop-metrics2.properties 100% 3183 3.1KB/s 00:00 [root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.properties sht-sgmhadoopdn-01:/hadoop/hadoop-2.7.2/etc/hadoop/hadoop-metrics2.propertieshadoop-metrics2.properties 100% 3183 3.1KB/s 00:00 [root@sht-sgmhadoopnn-01 ~]# 9.添加HBase被Ganglia监控,添加如下(每台同样配置)[root@sht-sgmhadoopnn-01 ~]# vi /hadoop/hbase/conf/hadoop-metrics2-hbase.properties *.sink.ganglia.class=org.apache.hadoop.metrics2.sink.ganglia.GangliaSink31 *.sink.ganglia.period=10 hbase.sink.ganglia.period=10 hbase.sink.ganglia.servers=172.16.101.55:8649 [root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hbase/conf/hadoop-metrics2-hbase.properties sht-sgmhadoopnn-02:/hadoop/hbase/conf/hadoop-metrics2-hbase.properties[root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hbase/conf/hadoop-metrics2-hbase.properties sht-sgmhadoopdn-01:/hadoop/hbase/conf/hadoop-metrics2-hbase.properties[root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hbase/conf/hadoop-metrics2-hbase.properties sht-sgmhadoopdn-02:/hadoop/hbase/conf/hadoop-metrics2-hbase.properties[root@sht-sgmhadoopnn-01 ~]# scp /hadoop/hbase/conf/hadoop-metrics2-hbase.properties sht-sgmhadoopdn-03:/hadoop/hbase/conf/hadoop-metrics2-hbase.properties 10.查看http://172.16.101.55/ganglia

优秀的个人博客,低调大师

实时交互平台流程与技术分析

最近几个月一直在做基于storm的流式处理,索性整理下所有的知识点与技术知识。 一、数据准备 1、首先,我们需要用户的所有数据,使用MapReduce进行数据处理,生成业务宽表导入hbase与Redis,用于后续实时处理直接从Redis中获取相应数据,减少读写磁盘IO的消耗。 二、消息的接入 1、传入的数据是经过二进制处理的,所以使用jetty轻量级服务对传入的报文进行接入解析,同时部署多个服务,使用nginx进行负载均衡。 2、每个服务同时启动多个线程进行消息的接入,通过blockingQueue进行存储,随后进行报文解析,序列化后发送对应主题的kafka. 三、storm处理 1、使用集成的kafkaspout进行消息的接入代替storm的spout,降低工程复杂度,可直接编写bolt进行业务逻辑处理,随后进行数据的一次性过滤bolt,验证消息的正确性并并封装入对象中。 2、通过消息中的相应主键,从Redis中加载该用户的全量数据,以便后续业务处理(存入hbase是以防redis出现问题进而再查询hbase,同时hbase中的rowkey做了散列,数据均匀分布在每个region中)。 3、加载配置活动规则,这些规则通过前台web系统配置保存,存储于redis中。对多个规则进行遍历匹配,封装成一个大的对象,传入下游推送拓扑。 4、推送拓扑在接收到消息后,从对象中获取封装的消息对象的渠道对象,对其进行遍历发送至不同的渠道。

优秀的个人博客,低调大师

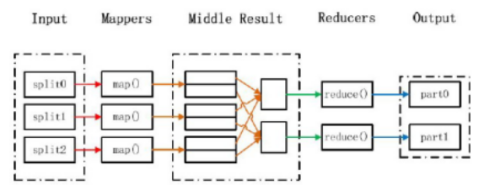
map-reduce任务的执行流程

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/44657537 (1).客户端提交一个mr的jar包给JobClient(提交方式:hadoop jar ...) (2).JobClient通过RPC和JobTracker进行通信,返回一个存放jar包的地址(HDFS)和jobId (3).client将jar包写入到HDFS当中(path = hdfs上的地址 + jobId) (4).开始提交任务(任务的描述信息,不是jar, 包括jobid,jar存放的位置,配置信息等等) (5).JobTracker进行初始化任务 (6).读取HDFS上的要处理的文件,开始计算输入分片,每一个分片对应一个MapperTask (7).TaskTracker通过心跳机制领取任务(任务的描述信息) (8).下载所需的jar,配置文件等 (9).TaskTracker启动一个java child子进程,用来执行具体的任务(MapperTask或ReducerTask ) (10).将结果写入到HDFS当中

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册