首页 文章 精选 留言 我的

精选列表

搜索[整理],共10000篇文章
优秀的个人博客,低调大师

玩遍博客网站,我整理了 Hexo 及其流行的风格主题

搭建博客网站是个人进入互联网世界的最常见方式之一。伴随着网站技术的发展,如何搭建博客网站已经变得非常容易了。当然,你可以选择诸如 新浪博客、CSDN、博客园 之类的大型网站,快速创建依赖于大平台的个人博客,不过这种方式的不足是言论受限太多、无法触及网站底层技术。所以,对于想要自由发挥创意、又期望对网站拥有更多主动权的话,最好还是选择自己去亲手搭建一个网站。 本文来源:魚立说。本文链接:https://www.yulisay.com/d/nkpvy.html,支持微信浏览器打开。 更多精彩文章,请移步 魚立说个人网站 翻看。欢迎欣赏,吐槽不足之处。 本主题将围绕博客网站的搭建流程、不同的博客搭建技术及其流行的风格主题展开,整个系列由以下三个文章部分组成: 当下流行的博客技术栈 Hexo 及其流行的风格主题 Hugo 及其流行的风格主题 <div class="bordor-separation"></div> Hugo 是使用 Go 编写的快速而现代的静态站点生成器,旨在使网站创建变得有趣。特点是简单、易用、高效、扩展性好、快速部署。其官网是:https://gohugo.io。 安装 Hugo 安装 Hugo 相当简单,但是需要先安装 Go 运行环境。以 Mac 操作系统为例,安装 Hugo 的命令:brew install hugo。 初始化一个名字为 hugo-blog 的项目:hugo new site hugo-blog,此时将生成如下 Hugo 项目目录: . ├── config.toml # 网站的配置信息 ├── archetypes # 存放 .md 文件的模板 ├── content # 存放 .md 文件 ├── data # 存放 Hugo 数据 ├── layouts # 存放布局文件 ├── public # 公共文件夹,用于存放生成的站点文件 ├── static # 存放静态文件,比如图片、CSS、JS └── themes # 存放主题 快速操作 Hugo 查看版本:hugo version 新建一篇文章: hugo new post/my-first-blog.md 生成静态文件: hugo -t even 启动服务器: hugo server 正常启动服务后,在浏览器打开 http://localhost:1313/ 看到我们的网站。 流行的 Hugo 主题 使用 Hugo 博客时,我们最希望的是找到适合自己的一款主题,下面将图文结合介绍一些流行的 Hugo 主题。此外,关于写作的方法和 Hugo 主题修改,可以查阅本文参考中的 Hugo 官方文档,这里不再赘述。 找到、安装和配置 Hugo 主题 最好的搜索方式是在 https://github.com/ 中,搜索关键词:hugo theme。或者使用搜索引擎,搜索:hugo theme site:github.com。 然后进入到项目目录中,下载安装我们需要的主题(theme-demo 只是一个示例资源,请注意替代为实际的资源): git clone https://github.com/theme-demo.git themes/theme-demo cp -r themes/theme-demo/_source/* source 希望使用下载的主题,添加 themes/theme-demo/exampleSite/config.toml 中的配置,还需要在 config.toml 中配置主题: theme = "theme-demo" 此外,在有些 theme-demo 文件夹中会有 demo 或 example 目录,文件结构与新建的 Hugo 项目的文件结构几乎是一样的,这样设置是为了用户的配置可以覆盖掉主题的配置。 Hugo 流行主题之 1:MemE MemE 是一个强大且可高度定制的 GoHugo 博客主题,专为个人博客设计。MemE 主题专注于优雅、简约、现代,以及代码的正确性。Github 地址:https://github.com/reuixiy/hugo-theme-meme。 Hugo 流行主题之 2:Clarity 基于 VMware 的开源 Clarity 设计系统,具有丰富的代码支持、暗/光模式、移动支持等特点,为 Hugo 设计了一个具有技术意识的主题。Github 地址:https://github.com/chipzoller/hugo-clarity。 Hugo 流行主题之 3:Even 一个很简洁的主题,移植自 hexo-theme-even。Github 地址:https://github.com/olOwOlo/hugo-theme-even。 Hugo 流行主题之 4:Octopress 从 Octopress 博客移植过来的经典主题。Github 地址:https://github.com/parsiya/Hugo-Octopress。 Hugo 流行主题之 5:Tokiwa 一个极简的博客主题,对汉字进行了显示优化。Github 地址:https://github.com/heyeshuang/hugo-theme-tokiwa。 除了以上几种,还有更多不错的 Hugo 风格主题供你选用,可以前往 Hugo 主题网站 找到。如果你有好的想法和设计,也可以创建并发布自己制作的 Hugo 主题,到时候欢迎给我的网站 魚立说 留言。 参考链接 ① Hugo 官方文档 ② Hugo Themes

优秀的个人博客,低调大师

Java基础篇(01):基本数据类型,核心点整理

本文源码:GitHub·点这里 || GitEE·点这里 一、基本类型 1、基本类型 不使用New创建,声明一个非引用传递的变量,且变量的值直接置于堆栈中,大小不随运行环境变化,效率更高。使用new创建的引用对象存储在堆中。 2、基本信息 基本类型包括如下几种:byte、short、int、long、float、double、boolean、char,可以通过相关方法查看范围大小。 public class IntType01 { public static void main(String[] args) { System.out.println("进制位数:"+Integer.SIZE); System.out.println("最小值:"+Integer.MIN_VALUE); System.out.println("最大值:"+Integer.MAX_VALUE); System.out.println("进制位数:"+Double.SIZE); System.out.println("最小值:"+Double.MIN_VALUE); System.out.println("最大值:"+Double.MAX_VALUE); } } 二、案例用法 1、类型转换 自动转换:范围小的数据类型可以自动转换成范围大的数据类型。 强制转换:把一种数据类型转换为另外一种数据类型。 类型提升:表达式运算中有不同的数据类型,类型会自动向范围大的提升。 public class IntType02 { public static void main(String[] args) { // 自动转换 int i = 112 ; long j = i ; System.out.println(j); // 强制转换 double d = 13.14 ; int f = (int)d; System.out.println(f); // 类型提升 long r = i * j ; System.out.println(r); } } 注意:类型转换中最需要关注的问题就是范围大小问题。 2、包装器类型 基本数据类型不符合面向对象思想,从而出现了包装器类型, 并且包装器添加了更多的属性和方法,自动包装功能可以将基本类型转换为包装器类型。Java为每个原始类型都提供了一个封装类,Integer、Double、Long、Boolean、Byte等等。 public class IntType03 { public static void main(String[] args) { Integer int1 = null ; Double dou1 = 13.14 ; Long lon1 = 123L ; } } Integer变量的默认值为null,说明Integer可以区分出未赋值和值为0的区别,好比考试得0分和没参加考试的区别。 3、字符类型 char类型变量是用来储存Unicode编码的字符的,unicode字符集包含汉字。 public class IntType04 { public static void main(String[] args) { char cha1 = '知'; System.out.println(cha1); } } 注意:可能存在特殊生僻字没有包含在unicode编码字符集中。 4、赋值和运算 += 和 = 的区分:short s1=1;s1=s1+1与short s1=1;s1+=1;问题。 public class IntType05 { public static void main(String[] args) { short s1 = 1 ; // s1 = s1 + 1 ; // 变异错误:s1自动向int类型转换 s1 += 1 ; System.out.println(s1); } } +=运算符是java语言规定的,编译器会对它进行识别处理,因此可以正确编译。 5、布尔类型 两个逻辑值: true和false,通常用来表示关系运算的结果。 public class IntType06 { public static void main(String[] args) { // 存在精度损失问题:0.30000000000000004 System.out.println(3*0.1); // true System.out.println(0.3 == 0.3); // false System.out.println(3*0.1 == 0.3); } } 三、Float和Dubble 1、基础概念 这两个类型可能大部分情况下都说不明白关系和区分,首先要理解几个基础概念。 浮点数:在计算机中用以近似表示任意某个实数。具体的说,这个实数由一个整数或定点数乘以某个基数(计算机中通常是2)的整数次幂得到 单精度浮点数:单精度浮点数是用来表示带有小数部分的实数,一般用于科学计算。占用4个字节(32位)存储空间 双精度浮点数:双精度浮点数(double)是计算机使用的一种数据类型,使用64位(8字节)来存储一个浮点数。 2、对比分析 Float基本描述 位数:32 最小值:1.4E-45 最大值:3.4028235E38 Double基本描述 位数:64 最小值:4.9E-324 最大值:1.7976931348623157E308 案例描述 float和double声明和转换相关演示案例。 public class IntType07 { public static void main(String[] args) { // float 声明 float f1 = 12.3f ; // double 声明 double d1 = 13.4 ; // 向下转型,需要强制转换 float f2 = (float) d1 ; System.out.println("f1="+f1+";d1="+d1+";f2="+f2); } } 四、高精度类型 1、BigInteger 支持任意大小的整数运算,且不会再运算过程有任何丢失情况,没有对应的基本类型,运算也会变得相对复杂,运算速度自然也就会下降。 2、BigDecimal 支持任意精度的定点数,通常用来进行精确的货币计算,在公司的日常开发中,这里通常是硬性要求。 public class IntType08 { public static void main(String[] args) { BigDecimal dec1 = new BigDecimal(3.0) ; BigDecimal dec2 = new BigDecimal(2.11) ; // 精确加法运算 BigDecimal res1 = dec1.add(dec2) ; System.out.println(res1); // 精确减法运算,并截取结果 // HALF_UP:四舍五入 BigDecimal res2 = dec1.subtract(dec2); System.out.println(res2.setScale(1, RoundingMode.HALF_UP)); // 精确乘法运算 BigDecimal res3 = dec1.multiply(dec2) ; System.out.println(res3.doubleValue()); // 精确除法运算,并截取结果 // ROUND_DOWN:直接按保留位数截取 BigDecimal res4 = dec1.divide(dec2,2,BigDecimal.ROUND_DOWN); System.out.println(res4); } } 五、源代码地址 GitHub·地址 https://github.com/cicadasmile/java-base-parent GitEE·地址 https://gitee.com/cicadasmile/java-base-parent

优秀的个人博客,低调大师

整理了8个Python中既冷门又实用的技巧

1.print 打印带有颜色的信息 大家知道 Python 中的信息打印函数 print,一般我们会使用它打印一些东西,作为一个简单调试。 但是你知道么,这个 Print 打印出来的字体颜色是可以设置的。 一个小例子 def esc(code=0): return f'\033[{code}m' print(esc('31;1;0') + 'Error:'+esc()+'important') 在控制台或者 Pycharm 运行这段代码之后你会得到结果。 Error:important 其中 Error 是红色加下划线的,important 为默认色 其设置格式为:033[显示方式;前景色;背景色 m 下面可以设置的参数: 说明:前景色 背景色 颜色 --------------------------------------- 30 40 黑色 31 41 红色 32 42 绿色 33 43 黃色 34 44 蓝色 35 45 紫红色 36 46 青蓝色 37 47 白色 显示方式 意义 ------------------------- 0 终端默认设置 1 高亮显示 4 使用下划线 5 闪烁 7 反白显示 8 不可见 例子: \033[1;31;40m <!--1-高亮显示 31-前景色红色 40-背景色黑色--> 2.在 Python 中使用定时器 今天看到一个比较人性化的定时模块 schedule,目前 star 数为 6432,还是非常的受欢迎,这个模块也是秉承这 For Humans 的原则,这里推荐给大家。地址 https://github.com/dbader/schedule 1.通过 pip 即可安装。 pip install schedule 2.使用案例 import schedule import time def job(): print("I'm working...") schedule.every(10).minutes.do(job) schedule.every().hour.do(job) schedule.every().day.at("10:30").do(job) schedule.every().monday.do(job) schedule.every().wednesday.at("13:15").do(job) schedule.every().minute.at(":17").do(job) while True: schedule.run_pending() time.sleep(1) 从单词的字面意思,你就知道这是做什么的。 举个例子: schedule.every().monday.do(job) 这句代码作用就是就是单词意思,定时器会每个周一运行函数 job,怎么样是不是很简单。 3.实现一个进度条 # Python学习交流QQ群:857662006 from time import sleep def progress(percent=0, width=30): left = width * percent // 100 right = width - left print('\r[', '#' * left, ' ' * right, ']', f' {percent:.0f}%', sep='', end='', flush=True) for i in range(101): progress(i) sleep(0.1) 展示效果上面的代码中的 print 有几个有用的参数,sep 的作用是已什么为分隔符,默认是空格,这里设置为空串是为了让每个字符之间更紧凑,end 参数作用是已什么结尾,默认是回车换行符,这里为了实现进度条的效果,同样设置为空串。 还有最后一个参数 flush,该参数的作用主要是刷新, 默认 flush = False,不刷新,print 到 f 中的内容先存到内存中;而当 flush = True 时它会立即把内容刷新并输出。 之前在Python 下载夏目友人帐中提到了的 tqdm 模块,更好的实现一个进度条. 4.优雅的打印嵌套类型的数据 大家应该都有印象,在打印 json 字符串或者字典的时候,打印出的一坨东西根本就没有一个层次关系,这里主要说的就是输出格式的问题。 import json my_mapping = {'a': 23, 'b': 42, 'c': 0xc0ffee} print(json.dumps(my_mapping, indent=4, sort_keys=True)) 大家可以自己试试只用 print 打印 my_mapping,和例子的这种打印方法。 如果我们打印字典组成的列表呢,这个时候使用 json 的 dumps 方法肯定不行的,不过没关系 用标准库的 pprint 方法同样可以实现上面的方法 # Python学习交流QQ群:857662006 import pprint my_mapping = [{'a': 23, 'b': 42, 'c': 0xc0ffee},{'a': 231, 'b': 42, 'c': 0xc0ffee}] pprint.pprint(my_mapping,width=4) 5.功能简单的类使用 namedtuple 和 dataclass 的方式定义 有时候我们想实现一个类似类的功能,但是没有那么复杂的方法需要操作的时候,这个时候就可以考虑下下面两种方法了。 第一个,namedtuple 又称具名元组,带有名字的元组。它作为 Python 标准库 collections 里的一个模块,可以实现一个类似类的一个功能。 from collections import namedtuple # Python学习交流QQ群:857662006 # 以前简单的类可以使用 namedtuple 实现。 Car = namedtuple('Car', 'color mileage') my_car = Car('red', 3812.4) print(my_car.color) print(my_car) 但是呢,所有属性需要提前定义好才能使用,比如想使用my_car.name,你就得把代码改成下面的样子。 from collections import namedtuple # Python学习交流QQ群:857662006 # 以前简单的类可以使用 namedtuple 实现。 Car = namedtuple('Car', 'color mileage name') my_car = Car('red', 3812.4,"Auto") print(my_car.color) print(my_car.name) 使用 namedtuple 的缺点很明显了。 所以现在更优的方案,那就是 Python3.7 加入到标准库的 dataclass。 其实在 3.6 也可以使用不过需要它被作为第三方的库使用了,使用 pip 安装即可。 使用示例如下: from dataclasses import dataclass @dataclass class Car: color: str mileage: float my_car = Car('red', 3812.4) print(my_car.color) print(my_car) 6.f-string 的 !r,!a,!s f-string出现在Python3.6,作为当前最佳的拼接字符串的形式,看下 f-string 的结构 f ' <text> { <expression> <optional !s, !r, or !a> <optional : format specifier> } <text> ... ' 其中'!s' 在表达式上调用str(),'!r' 调用表达式上的repr(),'!a' 调用表达式上的ascii() (1) 默认情况下,f-string将使用str(),但如果包含转换标志,则可以确保它们使用repr () ! class Comedian: def __init__(self, first_name, last_name, age): self.first_name = first_name self.last_name = last_name self.age = age def __str__(self): return f"{self.first_name} {self.last_name} is {self.age}." def __repr__(self): return f"{self.first_name} {self.last_name} is {self.age}. Surprise!" 调用 >>> new_comedian = Comedian("Eric", "Idle", "74") >>> f"{new_comedian}" 'Eric Idle is 74.' >>> f"{new_comedian}" 'Eric Idle is 74.' >>> f"{new_comedian!r}" 'Eric Idle is 74. Surprise!' (2) !a的例子 >>> a = 'some string' >>> f'{a!r}' "'some string'" 等价于 >>> f'{repr(a)}' "'some string'" (3) !d的例子 类似2 pycon2019有人提出的一个展望!d的功能实现:在 Python3.8 中已经实现上述功能,不过不再使用 !d 了改为了 f"{a=}" 的形式,看过这个视频的发现没有 !d 应该很懵逼 7.f-string 里"="的应用 在 Python3.8 里有这样一个功能 a = 5 print(f"{a=}") 打印之后的结果为 a=5 是不是很方便,不用你再使用 f"a={a}" 了。 8.海象运算符:=的使用 a =6 if (b:=a+1)>6: print(b) 赋值的时候同时可以进行运算,和 Go 语言的赋值类似了。 代码的运行顺序,首先计算 a+1 得到值为 7,然后把 7 赋值给 b,到这里代码相当于下面这样了 b =7 if b>6: print(b) 怎么样?是不是简单了不少,不过这个功能 3.8 开始才能用哦。

优秀的个人博客,低调大师

HP EVA8400删除VDISK后数据恢复过程分步整理

【故障描述】 某地法院一台HP EVA8400存储,2组扩展柜,物理磁盘由12个1T FATA磁盘(AG691A 454414-001)和10个300G 15K FC磁盘(AG690A 454411-001)组成,LUN数量不确定,主机环境为WINDOWS,存储法院历史案例审理材料。 因本案多方转手,所以我们也无法直接得知故障原因。 【初检及分析】 1、电话初检,确定得知,数据出现故障后再未重用。通常按HP-EVA的故障可能推断,数据恢复的可靠性较高。 2、EVA主机及扩展柜正常关机,之后将所有硬盘标好位置序号,拿出。在数据成功恢复之前,不再开启EVA 8400控制器。 3、接手磁盘后,按如下链路对磁盘进行连接。 4、进入WINDOWS环境,用WINHEX查看磁盘情况,发现所有磁盘均可正常识别。 5、查看每个磁盘信息,发现300G FC磁盘存在PV HEAD,而1T FATA磁盘上均无PV HEAD。查看300G磁盘中存储的Metadata,发现仅描述了一个RSS组组成的LUN,大小不足2T,成员为所有300G磁盘。而1T FATA磁盘中残留的LUN信息则至少包括5组信息。上述信息表明,极有可能地,某种原因导致删除了1T 磁盘组成的DISK GROUP内所划分的所有VDISK,并UNGROUP了所有1T FATA磁盘。 6、分析1T FATA磁盘上保留的Metadata,大致判断可恢复率较高。 【恢复过程】 1、对所有磁盘做完整镜像,参见《如何对磁盘做完整备份》或本人博客中的其他文章。 2、使用Frombyte recovery for HP-EVA对300G 磁盘所属的LUN进行恢复。 3、因1T磁盘已全部UNGROUP,关于RSS的分配,以及本身的磁盘ID均无法得知。故需进行人工方式分析RSS配置表。通过META信息的对照,以及通过xor信息区的校验验证,得到如下rss组配置表: 3-0 hd6 3-1 hd8 3-2 hd2 3-3 hd9 3-4 hd10 3-5 hd5 2-0 hd0 2-1 hd7 2-2 hd1 2-3 hd11 2-4 hd3 2-5 hd4 4、重组及整合所有LUN的存储分配表。 5、根据存储分配表,及RSS磁盘分配表,对所有LUN进行提取。提取过程中,对不通过的XOR条带进行人工分析,确定离线情况(本例没有掉线磁盘),确定得到最佳重组结论,再通过Frombyte recovery for HP-EVA进行恢复。 【数据恢复结论】 数据100%恢复成功。

优秀的个人博客,低调大师

【监控体系】最全面系统的Zabbix讲解 | 含源码&监控类型整理

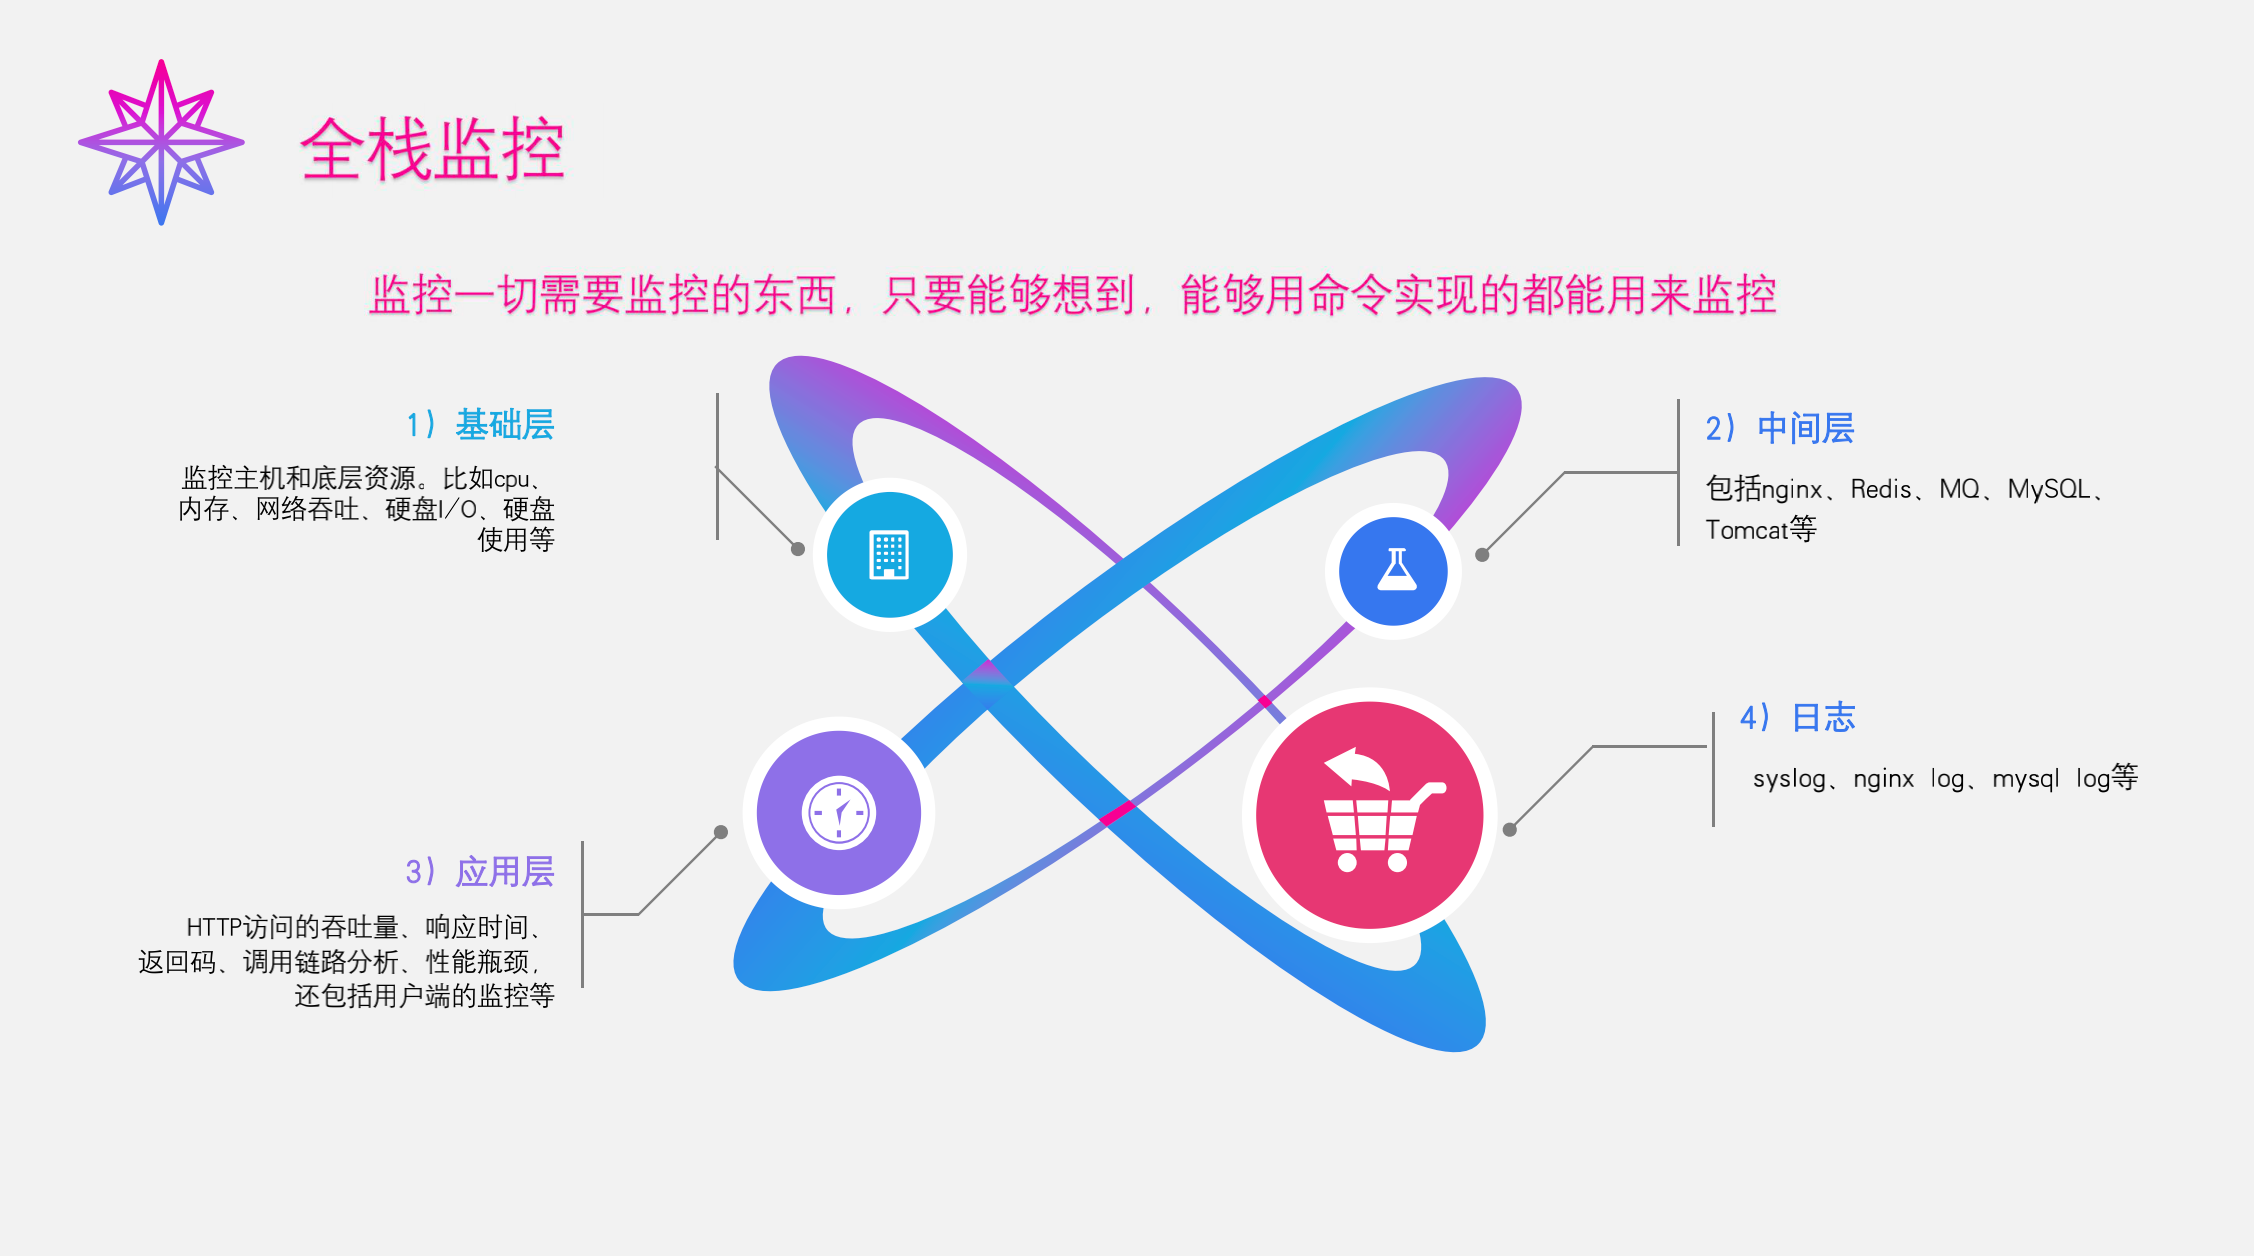
主讲人:王鸿杰,云智慧/企业效能部/架构师 讲师简介:云智慧架构师,PHP/PECL 开发组成员,PECL/SeasClick、PECL/SeasLog Maintainer。6 年研发经验,2018 年加入透视宝团队,致力于 APM 产品的架构与研发,专注于服务的性能分析与优化。2021 年加入效能工程团队,为高效而生,立足于使用最少的资源来解决最大的问题,研究各种不同的 bot 技术,让整个团队更高效运转。 公司简介:云智慧集团成立于2009年,是国内领先的全栈智能业务运维解决方案服务商。经过多年自主研发,公司形成了从IT运维、电力运维到IoT运维的产业布局,覆盖ITOM、ITOA、ITSM、DevOps以及IoT几大领域,为金融、政府、运营商、能源、交通、制造等上百家行业的客户,提供了数字化运维体系建设及全生命周期运维管理解决方案。云智慧秉承Make Digital Online的使命,致力于通过先进的产品技术,为企业数字化转型和提升IT运营效率持续赋能。 从本篇内容你能得到: 1. Zabbix是什么、能做到什么 2. Zabbix组件详解、架构和处理工作流程 3. Zabbix各监控项类型的采集实现(SNMP、ICMP、Ping、简单检查等) 4. Zabbix 模板组成结构与实现 5. Zabbix Agent源码结构与实现分析 6. Zabbix 自动发现逻辑的源码结构与实现详解 全栈监控是什么? 监控一切需要监控的东西,只要能够想到,能够用命令实现的都能用来监控。 基础层:主要偏硬件,监控主机和底层资源。比如cpu、 内存、网络吞吐、硬盘I/O、硬盘使用等 中间层:包括nginx、Redis、MQ、MySQL、 Tomcat等 应用层: HTTP访问的吞吐量、响应时间、 返回码、调用链路分析、性能瓶颈, 还包括用户端的监控等 日志:syslog、nginx log、mysql log等 为什么使用Zabbix? 目前开源的解决方案中,Zabbix和Prometheus是使用较多的两个方案,这两个方案的区别和优势是什么? 对于偏传统的行业,云环境较少的场景下,是比较适合于Zabbix的使用,当然Prometheus是未来发展的方向。 Zabbix是什么? Zabbix源码主要组成: frontends:php,主要负责前端的业务操作 Zabbix agent:采集数据 Zabbx server:同步配置,处理数据,分析告警等。 Zabbix处理流程: 主要由四部分组成: Portal-DB-Server-Agent 详细的工作流程如下: 详细流程可查看下图: Zabbix是怎么做的? Zabbix Process 当添加(自动发现)一个 host,并且为 host 添加对应的模板的时候,Portal 会解析出来对应的 item, preprocess,trigger 然后放在对应的 Db 表里面。 Server 的 dbconfig_thread 会从 Db 拿到对应的数据放在共享内存中,然后poller_thread 进程读取到对应的 items,开启与 Agent 建立连接,遍历 items 从 Agent(snmp,简单检查 等) 获取到对应的指标数据 然后将 指标数据给 preprocessing_manager_thread 进程,preprocessing_manager_thread 进程会安排对应的preprocessing_worker 进程对数据进行 preprocess 最后由 dbsyncer_thread 进程将数据放入 Db 中,Portal 界面从 Db 拿到对应的数据信息绘制和显示 dbsyncer_thread 同步数据到DB,遍历数据 并计算 expression 表达式计算指标,最后触发 escalator_thread 和 alerter_thread 做出相应的动作。 对于可监控指标,Agent 自带多种可监控指标 cmd,Agent 只能监控内置的监控指标,可以通过插件拓展 可监控指标。 Zabbix Server dbconfig_thread: 配置同步到共享内存,保证所有进程都可读 poller_thread: 主动监控,解析 items 调用 Agent *trapper_thread: 收集 Agent 上报上来的数据 pinger_thread: 定期 ping 所有监控主机,简单检查 ICMP *alerter_thread: 告警消息处理进程从 IPC 读出需要发动的消息,发出告警 housekeeper_thread: 管家进程,过期数据清理 discoverer_thread: 主机、服务的自动发现 escalator_thread: 根据触发器的值判断是否告警,具体执行什么动作 dbsyncer_thread:同步数据到 db,并计算触发器值也同步到db selfmon_thread: 自监控 preprocessing_worker_thread: 数据预处理进程,数据从 poller 和 trapper 进程过来 Zabbix Agent collector_thread 周期采集基础信息,主要是内存和 CPU,储存于共享内存中 listener_thread 用于接收 server 或者 proxy 分配的的采集任务,被动采采集 active_checks_thread 主动采集上报 指标类型 按进程(处理方式)划分指标类型 Poller 进程(被动) 1. snmp|SNMP代理检查 simple_checks|简单检查(应用层状态检查) calculated|计算监控项 internal|Zabbix内部检查 ssh_checks|SSH检查 telnet_checks|Telnet检查 external|外部检查 aggregate|汇总检查 odbc_checks|ODBC监控 httppoller 进程(被动) http|HTTP 检查 ipmi_poller_thread 进程(被动) ipmi|IPMI检查 icmp pinger 进程(被动) simple_checks|简单检查(icmp 检查) trapper 进程(主动) trapper|捕捉器监控项 log_items|日志文件监控 snmptrap|SNMP traps preprocess 进程(Follow me) dependent_items|相关项目(从属监控项) 按客户端依赖划分指标类型 无依赖 snmp|SNMP代理检查 ipmi|IPMI检查 simple_checks|简单检查 external|外部检查 odbc_checks|ODBC监控 依赖其他监控项 calculated|计算监控项 aggregate|汇总检查 依赖第三方 zabbix_agent|Zabbix代理检查 (Agent) snmptrap|SNMP traps (snmptrap) log_items|日志文件监控 (Agent) ssh_checks|SSH检查 (ssh 秘钥或密码) telnet_checks|Telnet检查 (Telnet Server和 Telnet 密码) trapper|捕捉器监控项 (Zabbix Sender) http|HTTP 检查 (http 接口) IDEA 被动监控对 Zabbix Server 来说会有大的压力 从监控类型来看,Zabbix 更多的是被动监控,主动监控只有 Agent Active、SnmpTrap,Sender,但是由于 Zabbix Agent 的强大,很多场景下主动监控的指标覆盖度完全能跟被动监控硬怼。 所以要根据具体监控场景,主动和被动互相搭配,耗时的指标更加倾向于主动监控。 Zabbix监控项类型梳理 附件: 请您添加:xiaoyuerwise,备注“附件”获取,或从本文底部扫码获取。 Zabbix的自动发现 自动发现是伴随着指标监控来的,当发现能有采集到预设的指标时,这台主机就会被标记为可用,然后触发预设的Action,通知或者自动添加监控模板等。 自动发现分类 简单检查类 Agent 类型 snmp 类型 ICMP (ping) 类型 自动发现流程 配置 IP 段 配置自动发现指标 配置发现动作 Action 发现主机后添加 event escalator_thread 进程处理对应的 event Zabbix的模板结构 模板结构 从属指标 计算指标 Agent源码 附件: 请您添加:xiaoyuerwise,备注“附件”获取,或从本文底部扫码获取。 写在最后 近年来,在AIOps领域极速发展的背景下,IT工具、平台能力、解决方案、AI场景及可用数据集的迫切需求在各行业迸发。基于此,云智慧在2021年8月发布了AIOps社区,旨在树起一面开源旗帜,为各行业客户、用户、研究者和开发者们构建活跃的用户及开发者社区,共同贡献及解决行业难题、促进该领域技术发展。 成立近半年,社区先后开源了数据可视化编排平台-FlyFish、运维管理平台OMP、云服务管理平台-摩尔平台、Hours算法等产品。其中FlyFish斩获中国开源云联盟2021优秀开源项目奖。OMP运维管理平台入选2021 年度 OSC 中国开源项目「最受欢迎项目」榜单。并在业内首次开源了智能运维开源数据集-GAIA数据集,填补了AIOps开源集数据领域的空白。 2021年11月,云智慧正式成为中国开源云联盟成员单位,2022年1月,云智慧入选SegmentFault 思否「2021 中国技术品牌影响力企业榜单」,这一切都代表着开发者和社区对我们的认可,这也更加坚定了云智慧开源战略的决心。 如果您对云智慧AIOps感兴趣,可以通过下方链接了解我们,也可以添加小助手微信,申请加入开发者交流群,可与大咖进行1V1交流! 云智慧AIOps社区:https://www.cloudwise.ai/ Github地址: https://github.com/CloudWise-OpenSource/FlyFish Gitee地址: https://gitee.com/CloudWise/fly-fish

优秀的个人博客,低调大师

熬夜整理的c/c++万字总结(三),值得收藏!

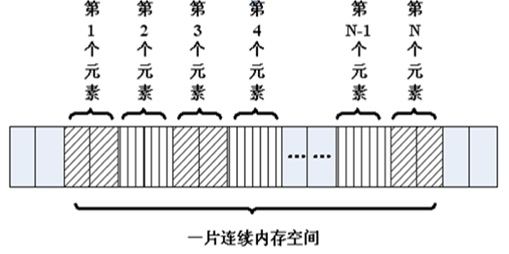
1、位运算 可以使用 C 对变量中的个别位进行操作。您可能对人们想这样做的原因感到奇怪。这种能力有时确实是必须的,或者至少是有用的。C 提供位的逻辑运算符和移位运算符。在以下例子中,我们将使用二进制计数法写出值,以便您可以了解对位发生的操作。在一个实际程序中,您可以使用一般的形式的整数变量或常量。例如不适用 00011001 的形式,而写为 25 或者 031 或者 0x19.在我们的例子中,我们将使用8位数字,从左到右,每位的编号是 7 到 0。 这一定是你需要的电子书资源,全!点击查看! 程序员书籍资源,点击查看! 1.1 位逻辑运算符 4 个位运算符用于整型数据,包括 char。将这些位运算符成为位运算的原因是它们对每位进行操作,而不影响左右两侧的位。请不要将这些运算符与常规的逻辑运算符(&& 、||和!)相混淆,常规的位的逻辑运算符对整个值进行操作。 1.1.1 按位取反~ 一元运算符~将每个 1 变为 0,将每个 0 变为 1,如下面的例子: ~(10011010) 01100101 假设 a 是一个unsigned char,已赋值为 2。在二进制中,2 是00000010.于是 -a 的值为11111101或者 253。请注意该运算符不会改变 a 的值,a 仍为 2。 unsignedchara=2;//00000010 unsignedcharb=~a;//11111101 printf("ret=%d\n",a);//ret=2 printf("ret=%d\n",b);//ret=253 1.1.2 位与(AND): & 二进制运算符 & 通过对两个操作数逐位进行比较产生一个新值。对于每个位,只有两个操作数的对应位都是 1 时结果才 为 1。 (10010011) & (00111101) = (00010001) C 也有一个组合的位与-赋值运算符:&=。下面两个将产生相同的结果: val&=0377 val=val&0377 1.1.3 位或(OR): | 二进制运算符 | 通过对两个操作数逐位进行比较产生一个新值。对于每个位,如果其中任意操作数中对应的位为 1,那么结果位就为 1。 (10010011)| (00111101) = (10111111) C 也有组合位或-赋值运算符: |= val|=0377 val=val|0377 **1.1.4 位异或: ** 二进制运算符^对两个操作数逐位进行比较。对于每个位,如果操作数中的对应位有一个是 1(但不是都是1),那么结果是 1.如果都是 0 或者都是 1,则结果位 0。 (10010011)^ (00111101) = (10101110) C 也有一个组合的位异或 - 赋值运算符: ^= val^=0377 val=val^0377 1.1.5 用法 1.1.5.1 打开位 已知:10011010: 1.将位 2 打开 flag | 10011010 (10011010)|(00000100)=(10011110) 2.将所有位打开 flag | ~flag (10011010)|(01100101)=(11111111) 1.1.5.2 关闭位 flag & ~flag (10011010)&(01100101)=(00000000) 1.1.5.3 转置位 转置(toggling)一个位表示如果该位打开,则关闭该位;如果该位关闭,则打开。您可以使用位异或运算符来转置。其思想是如果 b 是一个位(1或0),那么如果 b 为 1 则 b^1 为 0,如果 b 为 0,则 1^b 为 1。无论 b 的值是 0 还是 1,0^b 为 b。 flag ^ 0xff (10010011)^(11111111)=(01101100) 1.1.5.4 交换两个数不需要临时变量 //a^b=temp; //a^temp=b; //b^temp=a (10010011)^(00100110)=(10110101) (10110101)^(00100110)=10010011 inta=10; intb=30; 1.2 移位运算符 现在让我们了解一下 C 的移位运算符。移位运算符将位向左或向右移动。同样,我们仍将明确地使用二进制形式来说明该机制的工作原理。 1.2.1 左移 << 左移运算符<<将其左侧操作数的值的每位向左移动,移动的位数由其右侧操作数指定。空出来的位用 0 填充,并且丢弃移出左侧操作数末端的位。在下面例子中,每位向左移动两个位置。 (10001010) << 2 = (00101000) 该操作将产生一个新位置,但是不改变其操作数。 1<<1=2; 2<<1=4; 4<<1=8; 8<<2=32 左移一位相当于原值 *2。 1.2.2 右移 >> 右移运算符>>将其左侧的操作数的值每位向右移动,移动的位数由其右侧的操作数指定。丢弃移出左侧操作数有段的位。对于unsigned类型,使用 0 填充左端空出的位。对于有符号类型,结果依赖于机器。空出的位可能用 0 填充,或者使用符号(最左端)位的副本填充。 //有符号值 (10001010)>>2 (00100010)//在某些系统上的结果值 (10001010)>>2 (11100010)//在另一些系统上的结果 //无符号值 (10001010)>>2 (00100010)//所有系统上的结果值 1.2.3 用法:移位运算符 移位运算符能够提供快捷、高效(依赖于硬件)对 2 的幂的乘法和除法。 number << n: number乘以2的n次幂 number >> n: 如果number非负,则用number除以2的n次幂 2、数组 2.1 一维数组 元素类型角度:数组是相同类型的变量的有序集合 内存角度:连续的一大片内存空间 在讨论多维数组之前,我们还需要学习很多关于一维数组的知识。首先让我们学习一个概念。 2.1.1 数组名 考虑下面这些声明: inta; intb[10]; 我们把 a 称作标量,因为它是个单一的值,这个变量是的类型是一个整数。我们把 b 称作数组,因为它是一些值的集合。下标和数名一起使用,用于标识该集合中某个特定的值。例如,b[0] 表示数组 b 的第 1 个值,b[4] 表示第 5 个值。每个值都是一个特定的标量。 那么问题是 b 的类型是什么?它所表示的又是什么?一个合乎逻辑的答案是它表示整个数组,但事实并非如此。在 C中,在几乎所有数组名的表达式中,数组名的值是一个指针常量,也就是数组第一个元素的地址。它的类型取决于数组元素的类型:如果他们是int类型,那么数组名的类型就是“指向 int 的常量指针”;如果它们是其他类型,那么数组名的类型也就是“指向其他类型的常量指针”。 请问:指针和数组是等价的吗? 答案是否定的。数组名在表达式中使用的时候,编译器才会产生一个指针常量。那么数组在什么情况下不能作为指针常量呢?在以下两种场景下: 当数组名作为sizeof操作符的操作数的时候,此时sizeof返回的是整个数组的长度,而不是指针数组指针的长度。 当数组名作为&操作符的操作数的时候,此时返回的是一个指向数组的指针,而不是指向某个数组元素的指针常量。 intarr[10]; //arr=NULL;//arr作为指针常量,不可修改 int*p=arr;//此时arr作为指针常量来使用 printf("sizeof(arr):%d\n",sizeof(arr));//此时sizeof结果为整个数组的长度 printf("&arrtypeis%s\n",typeid(&arr).name());//int(*)[10]而不是int* 2.1.2 下标引用 intarr[]={1,2,3,4,5,6}; *(arr + 3) ,这个表达式是什么意思呢? 首先,我们说数组在表达式中是一个指向整型的指针,所以此表达式表示 arr 指针向后移动了 3 个元素的长度。然后通过间接访问操作符从这个新地址开始获取这个位置的值。这个和下标的引用的执行过程完全相同。所以如下表达式是等同的: *(arr+3) arr[3] 问题1:数组下标可否为负值? 问题2:请阅读如下代码,说出结果: intarr[]={5,3,6,8,2,9}; int*p=arr+2; printf("*p=%d\n",*p); printf("*p=%d\n",p[-1]); 那么是用下标还是指针来操作数组呢?对于大部分人而言,下标的可读性会强一些。 2.1.3 数组和指针 指针和数组并不是相等的。为了说明这个概念,请考虑下面两个声明: inta[10]; int*b; 声明一个数组时,编译器根据声明所指定的元素数量为数组分配内存空间,然后再创建数组名,指向这段空间的起始位置。声明一个指针变量的时候,编译器只为指针本身分配内存空间,并不为任何整型值分配内存空间,指针并未初始化指向任何现有的内存空间。 因此,表达式 *a 是完全合法的,但是表达式 *b 却是非法的。*b 将访问内存中一个不确定的位置,将会导致程序终止。另一方面b++可以通过编译,a++ 却不行,因为a是一个常量值。 2.1.4 作为函数参数的数组名 当一个数组名作为一个参数传递给一个函数的时候发生什么情况呢? 我们现在知道数组名其实就是一个指向数组第 1 个元素的指针,所以很明白此时传递给函数的是一份指针的拷贝。所以函数的形参实际上是一个指针。但是为了使程序员新手容易上手一些,编译器也接受数组形式的函数形参。因此下面两种函数原型是相等的: intprint_array(int*arr); intprint_array(intarr[]); 我们可以使用任何一种声明,但哪一个更准确一些呢?答案是指针。因为实参实际上是个指针,而不是数组。同样 sizeof arr 值是指针的长度,而不是数组的长度。 现在我们清楚了,为什么一维数组中无须写明它的元素数目了,因为形参只是一个指针,并不需要为数组参数分配内存。另一方面,这种方式使得函数无法知道数组的长度。如果函数需要知道数组的长度,它必须显式传递一个长度参数给函数。 2.2 多维数组 如果某个数组的维数不止1个,它就被称为多维数组。接下来的案例讲解以二维数组举例。 voidtest01(){ //二维数组初始化 intarr1[3][3]={ {1,2,3}, {4,5,6}, {7,8,9} }; intarr2[3][3]={1,2,3,4,5,6,7,8,9}; intarr3[][3]={1,2,3,4,5,6,7,8,9}; //打印二维数组 for(inti=0;i<3;i++){ for(intj=0;j<3;j++){ printf("%d",arr1[i][j]); } printf("\n"); } } 2.2.1 数组名 一维数组名的值是一个指针常量,它的类型是“指向元素类型的指针”,它指向数组的第 1 个元素。多维数组也是同理,多维数组的数组名也是指向第一个元素,只不过第一个元素是一个数组。例如: intarr[3][10] 可以理解为这是一个一维数组,包含了 3 个元素,只是每个元素恰好是包含了 10 个元素的数组。arr 就表示指向它的第1个元素的指针,所以 arr 是一个指向了包含了 10 个整型元素的数组的指针。 2.2.2 指向数组的指针(数组指针) 数组指针,它是指针,指向数组的指针。 数组的类型由元素类型和数组大小共同决定:int array[5] 的类型为 int[5]; C 语言可通过 typedef 定义一个数组类型: 定义数组指针有一下三种方式: //方式一 voidtest01(){ //先定义数组类型,再用数组类型定义数组指针 intarr[10]={1,2,3,4,5,6,7,8,9,10}; //有typedef是定义类型,没有则是定义变量,下面代码定义了一个数组类型ArrayType typedefint(ArrayType)[10]; //intArrayType[10];//定义一个数组,数组名为ArrayType ArrayTypemyarr;//等价于intmyarr[10]; ArrayType*pArr=&arr;//定义了一个数组指针pArr,并且指针指向数组arr for(inti=0;i<10;i++){ printf("%d",(*pArr)[i]); } printf("\n"); } //方式二 voidtest02(){ intarr[10]; //定义数组指针类型 typedefint(*ArrayType)[10]; ArrayTypepArr=&arr;//定义了一个数组指针pArr,并且指针指向数组arr for(inti=0;i<10;i++){ (*pArr)[i]=i+1; } for(inti=0;i<10;i++){ printf("%d",(*pArr)[i]); } printf("\n"); } //方式三 voidtest03(){ intarr[10]; int(*pArr)[10]=&arr; for(inti=0;i<10;i++){ (*pArr)[i]=i+1; } for(inti=0;i<10;i++){ printf("%d",(*pArr)[i]); } printf("\n"); } 2.2.3 指针数组(元素为指针) 2.2.3.1 栈区指针数组 //数组做函数函数,退化为指针 voidarray_sort(char**arr,intlen){ for(inti=0;i<len;i++){ for(intj=len-1;j>i;j--){ //比较两个字符串 if(strcmp(arr[j-1],arr[j])>0){ char*temp=arr[j-1]; arr[j-1]=arr[j]; arr[j]=temp; } } } } //打印数组 voidarray_print(char**arr,intlen){ for(inti=0;i<len;i++){ printf("%s\n",arr[i]); } printf("----------------------\n"); } voidtest(){ //主调函数分配内存 //指针数组 char*p[]={"bbb","aaa","ccc","eee","ddd"}; //char**p={"aaa","bbb","ccc","ddd","eee"};//错误 intlen=sizeof(p)/sizeof(char*); //打印数组 array_print(p,len); //对字符串进行排序 array_sort(p,len); //打印数组 array_print(p,len); } 2.2.3.2 堆区指针数组 //分配内存 char**allocate_memory(intn){ if(n<0){ returnNULL; } char**temp=(char**)malloc(sizeof(char*)*n); if(temp==NULL){ returnNULL; } //分别给每一个指针malloc分配内存 for(inti=0;i<n;i++){ temp[i]=malloc(sizeof(char)*30); sprintf(temp[i],"%2d_helloworld!",i+1); } returntemp; } //打印数组 voidarray_print(char**arr,intlen){ for(inti=0;i<len;i++){ printf("%s\n",arr[i]); } printf("----------------------\n"); } //释放内存 voidfree_memory(char**buf,intlen){ if(buf==NULL){ return; } for(inti=0;i<len;i++){ free(buf[i]); buf[i]=NULL; } free(buf); } voidtest(){ intn=10; char**p=allocate_memory(n); //打印数组 array_print(p,n); //释放内存 free_memory(p,n); } 2.2.4二维数组三种参数形式 2.2.4.1 二维数组的线性存储特性 voidPrintArray(int*arr,intlen){ for(inti=0;i<len;i++){ printf("%d",arr[i]); } printf("\n"); } //二维数组的线性存储 voidtest(){ intarr[][3]={ {1,2,3}, {4,5,6}, {7,8,9} }; intarr2[][3]={1,2,3,4,5,6,7,8,9}; intlen=sizeof(arr2)/sizeof(int); //如何证明二维数组是线性的? //通过将数组首地址指针转成Int*类型,那么步长就变成了4,就可以遍历整个数组 int*p=(int*)arr; for(inti=0;i<len;i++){ printf("%d",p[i]); } printf("\n"); PrintArray((int*)arr,len); PrintArray((int*)arr2,len); } 2.2.4.2 二维数组的3种形式参数 //二维数组的第一种形式 voidPrintArray01(intarr[3][3]){ for(inti=0;i<3;i++){ for(intj=0;j<3;j++){ printf("arr[%d][%d]:%d\n",i,j,arr[i][j]); } } } //二维数组的第二种形式 voidPrintArray02(intarr[][3]){ for(inti=0;i<3;i++){ for(intj=0;j<3;j++){ printf("arr[%d][%d]:%d\n",i,j,arr[i][j]); } } } //二维数组的第二种形式 voidPrintArray03(int(*arr)[3]){ for(inti=0;i<3;i++){ for(intj=0;j<3;j++){ printf("arr[%d][%d]:%d\n",i,j,arr[i][j]); } } } voidtest(){ intarr[][3]={ {1,2,3}, {4,5,6}, {7,8,9} }; PrintArray01(arr); PrintArray02(arr); PrintArray03(arr); } 2.3总结 2.3.1 编程提示 源代码的可读性几乎总是比程序的运行时效率更为重要 只要有可能,函数的指针形参都应该声明为 const。 在多维数组的初始值列表中使用完整的多层花括号提高可读性 2.3.2 内容总结 在绝大多数表达式中,数组名的值是指向数组第 1 个元素的指针。这个规则只有两个例外,sizeof 和对数组名&。 指针和数组并不相等。当我们声明一个数组的时候,同时也分配了内存。但是声明指针的时候,只分配容纳指针本身的空间。 当数组名作为函数参数时,实际传递给函数的是一个指向数组第 1 个元素的指针。 我们不单可以创建指向普通变量的指针,也可创建指向数组的指针。

优秀的个人博客,低调大师

熬夜整理的c/c++万字总结(二),值得收藏!

0.为什么使用指针 假如我们定义了 char a=’A’ ,当需要使用 ‘A’ 时,除了直接调用变量 a ,还可以定义 char *p=&a ,调用 a 的地址,即指向 a 的指针 p ,变量 a( char 类型)只占了一个字节,指针本身的大小由可寻址的字长来决定,指针 p 占用 4 个字节。 这一定是你需要的电子书资源,全!点击查看! 程序员书籍资源,点击查看! 但如果要引用的是占用内存空间比较大东西,用指针也还是 4 个字节即可。 使用指针型变量在很多时候占用更小的内存空间。 变量为了表示数据,指针可以更好的传递数据,举个例子: 第一节课是 1 班语文, 2 班数学,第二节课颠倒过来, 1 班要上数学, 2 班要上语文,那么第一节课下课后需要怎样作调整呢?方案一:课间 1 班学生全都去 2 班, 2 班学生全都来 1 班,当然,走的时候要携带上书本、笔纸、零食……场面一片狼藉;方案二:两位老师课间互换教室。 显然,方案二更好一些,方案二类似使用指针传递地址,方案一将内存中的内容重新“复制”了一份,效率比较低。 在数据传递时,如果数据块较大,可以使用指针传递地址而不是实际数据,即提高传输速度,又节省大量内存。 一个数据缓冲区 char buf[100] ,如果其中 buf[0,1] 为命令号, buf[2,3] 为数据类型, buf[4~7] 为该类型的数值,类型为 int ,使用如下语句进行赋值: *(short*)&buf[0]=DataId; *(short*)&buf[2]=DataType; *(int*)&buf[4]=DataValue; 数据转换,利用指针的灵活的类型转换,可以用来做数据类型转换,比较常用于通讯缓冲区的填充。 指针的机制比较简单,其功能可以被集中重新实现成更抽象化的引用数据形式 函数指针,形如: #define PMYFUN (void*)(int,int) ,可以用在大量分支处理的实例当中,如某通讯根据不同的命令号执行不同类型的命令,则可以建立一个函数指针数组,进行散转。 在数据结构中,链表、树、图等大量的应用都离不开指针。 1. 指针强化 1.1 指针是一种数据类型 操作系统将硬件和软件结合起来,给程序员提供的一种对内存使用的抽象,这种抽象机制使得程序使用的是虚拟存储器,而不是直接操作和使用真实存在的物理存储器。所有的虚拟地址形成的集合就是虚拟地址空间。 内存是一个很大的线性的字节数组,每个字节固定由 8 个二进制位组成,每个字节都有唯一的编号,如下图,这是一个 4G 的内存,他一共有 4x1024x1024x1024 = 4294967296 个字节,那么它的地址范围就是 0 ~ 4294967296 ,十六进制表示就是 0x00000000~0xffffffff ,当程序使用的数据载入内存时,都有自己唯一的一个编号,这个编号就是这个数据的地址。指针就是这样形成的。 1.1.1 指针变量 指针是一种数据类型,占用内存空间,用来保存内存地址。 voidtest01(){ int*p1=0x1234; int***p2=0x1111; printf("p1size:%d\n",sizeof(p1)); printf("p2size:%d\n",sizeof(p2)); //指针是变量,指针本身也占内存空间,指针也可以被赋值 inta=10; p1=&a; printf("p1address:%p\n",&p1); printf("p1address:%p\n",p1); printf("aaddress:%p\n",&a); } 1.1.2 野指针和空指针 1.1.2.1 空指针 标准定义了NULL指针,它作为一个特殊的指针变量,表示不指向任何东西。要使一个指针为NULL,可以给它赋值一个零值。为了测试一个指针百年来那个是否为NULL,你可以将它与零值进行比较。 对指针解引用操作可以获得它所指向的值。但从定义上看,NULL指针并未指向任何东西,因为对一个NULL指针因引用是一个非法的操作,在解引用之前,必须确保它不是一个NULL指针。 如果对一个NULL指针间接访问会发生什么呢?结果因编译器而异。 不允许向NULL和非法地址拷贝内存: voidtest(){ char*p=NULL; //给p指向的内存区域拷贝内容 strcpy(p,"1111");//err char*q=0x1122; //给q指向的内存区域拷贝内容 strcpy(q,"2222");//err } 1.1.2.2 野指针 在使用指针时,要避免野指针的出现: 野指针指向一个已删除的对象或未申请访问受限内存区域的指针。与空指针不同,野指针无法通过简单地判断是否为 NULL避免,而只能通过养成良好的编程习惯来尽力减少。对野指针进行操作很容易造成程序错误。 什么情况下会导致野指针? 指针变量未初始化 任何指针变量刚被创建时不会自动成为NULL指针,它的缺省值是随机的,它会乱指一气。所以,指针变量在创建的同时应当被初始化,要么将指针设置为NULL,要么让它指向合法的内存。 指针释放后未置空 有时指针在free或delete后未赋值 NULL,便会使人以为是合法的。别看free和delete的名字(尤其是delete),它们只是把指针所指的内存给释放掉,但并没有把指针本身干掉。此时指针指向的就是“垃圾”内存。释放后的指针应立即将指针置为NULL,防止产生“野指针”。 指针操作超越变量作用域 不要返回指向栈内存的指针或引用,因为栈内存在函数结束时会被释放。 voidtest(){ int*p=0x001;//未初始化 printf("%p\n",p); *p=100; } 操作野指针是非常危险的操作,应该规避野指针的出现: 初始化时置 NULL 指针变量一定要初始化为NULL,因为任何指针变量刚被创建时不会自动成为NULL指针,它的缺省值是随机的。 释放时置 NULL 当指针p指向的内存空间释放时,没有设置指针p的值为NULL。delete和free只是把内存空间释放了,但是并没有将指针p的值赋为NULL。通常判断一个指针是否合法,都是使用if语句测试该指针是否为NULL。 1.1.2.3 void*类型指针 void是一种特殊的指针类型,可以用来存放任意对象的地址。一个void指针存放着一个地址,这一点和其他指针类似。不同的是,我们对它到底储存的是什么对象的地址并不了解。 doublea=2.3; intb=5; void*p=&a; cout<<p<<endl;//输出了a的地址 p=&b; cout<<p<<endl;//输出了b的地址 //cout<<*p<<endl;这一行不可以执行,void*指针只可以储存变量地址,不可以直接操作它指向的对象 由于void是空类型,只保存了指针的值,而丢失了类型信息,我们不知道他指向的数据是什么类型的,只指定这个数据在内存中的起始地址,如果想要完整的提取指向的数据,程序员就必须对这个指针做出正确的类型转换,然后再解指针。 1.1.2.4 void*数组和指针 同类型指针变量可以相互赋值,数组不行,只能一个一个元素的赋值或拷贝 数组在内存中是连续存放的,开辟一块连续的内存空间。数组是根据数组的下进行访问的。指针很灵活,它可以指向任意类型的数据。指针的类型说明了它所指向地址空间的内存。 数组所占存储空间的内存:sizeof(数组名) 数组的大小:sizeof(数组名)/sizeof(数据类型),在32位平台下,无论指针的类型是什么,sizeof(指针名)都是 4 ,在 64 位平台下,无论指针的类型是什么,sizeof(指针名)都是 8 。 数组名作为右值的时候,就是第一个元素的地址 intmain(void) { intarr[5]={1,2,3,4,5}; int*p_first=arr; printf("%d",*p_first);//1 return0; } 指向数组元素的指针 支持 递增 递减 运算。p= p+1意思是,让p指向原来指向的内存块的下一个相邻的相同类型的内存块。在数组中相邻内存就是相邻下标元素。 1.1.3 间接访问操作符 通过一个指针访问它所指向的地址的过程叫做间接访问,或者叫解引用指针,这个用于执行间接访问的操作符是*。 注意:对一个int类型指针解引用会产生一个整型值,类似地,对一个float指针解引用会产生了一个float类型的值。 intarr[5]; int*p=*(&arr); intarr1[5][3]arr1=int(*)[3]&arr1 1)在指针声明时,* 号表示所声明的变量为指针 2)在指针使用时,* 号表示操作指针所指向的内存空间 *相当通过地址(指针变量的值)找到指针指向的内存,再操作内存 *放在等号的左边赋值(给内存赋值,写内存) *放在等号的右边取值(从内存中取值,读内存) //解引用 voidtest01(){ //定义指针 int*p=NULL; //指针指向谁,就把谁的地址赋给指针 inta=10; p=&a; *p=20;//*在左边当左值,必须确保内存可写 //*号放右面,从内存中读值 intb=*p; //必须确保内存可写 char*str="helloworld!"; *str='m'; printf("a:%d\n",a); printf("*p:%d\n",*p); printf("b:%d\n",b); } 1.1.4 指针的步长 指针是一种数据类型,是指它指向的内存空间的数据类型。指针所指向的内存空间决定了指针的步长。指针的步长指的是,当指针+1时候,移动多少字节单位。 思考如下问题: inta=0xaabbccdd; unsignedint*p1=&a; unsignedchar*p2=&a; //为什么*p1打印出来正确结果? printf("%x\n",*p1); //为什么*p2没有打印出来正确结果? printf("%x\n",*p2); //为什么p1指针+1加了4字节? printf("p1=%d\n",p1); printf("p1+1=%d\n",p1+1); //为什么p2指针+1加了1字节? printf("p2=%d\n",p2); printf("p2+1=%d\n",p2+1); 1.1.5 函数与指针 1.1.5.1 函数的参数和指针 C语言中,实参传递给形参,是按值传递的,也就是说,函数中的形参是实参的拷贝份,形参和实参只是在值上面一样,而不是同一个内存数据对象。这就意味着:这种数据传递是单向的,即从调用者传递给被调函数,而被调函数无法修改传递的参数达到回传的效果。 voidchange(inta) { a++;//在函数中改变的只是这个函数的局部变量a,而随着函数执行结束,a被销毁。age还是原来的age,纹丝不动。 } intmain(void) { intage=60; change(age); printf("age=%d",age);//age=60 return0; } 有时候我们可以使用函数的返回值来回传数据,在简单的情况下是可以的,但是如果返回值有其它用途(例如返回函数的执行状态量),或者要回传的数据不止一个,返回值就解决不了了。 传递变量的指针可以轻松解决上述问题。 voidchange(int*pa) { (*pa)++;//因为传递的是age的地址,因此pa指向内存数据age。当在函数中对指针pa解地址时, //会直接去内存中找到age这个数据,然后把它增1。 } intmain(void) { intage=160; change(&age); printf("age=%d",age);//age=61 return0; } 比如指针的一个常见的使用例子: #include<stdio.h> #include<stdlib.h> #include<string.h> voidswap(int*,int*); intmain() { inta=5,b=10; printf("a=%d,b=%d\n",a,b); swap(&a,&b); printf("a=%d,b=%d\n",a,b); return0; } voidswap(int*pa,int*pb) { intt=*pa;*pa=*pb;*pb=t; } 在以上的例子中,swap函数的两个形参pa和pb可以接收两个整型变量的地址,并通过间接访问的方式修改了它指向变量的值。在main函数中调用swap时,提供的实参分别为&a,&b,这样就实现了pa=&a,pb=&b的赋值过程,这样在swap函数中就通过pa修改了 a 的值,通过pb修改了 b 的值。因此,如果需要在被调函数中修改主调函数中变量的值,就需要经过以下几个步骤: 定义函数的形参必须为指针类型,以接收主调函数中传来的变量的地址; 调用函数时实参为变量的地址; 在被调函数中使用*间接访问形参指向的内存空间,实现修改主调函数中变量值的功能。 指针作为函数的形参的另一个典型应用是当函数有多个返回值的情形。比如,需要在一个函数中统计一个数组的最大值、最小值和平均值。当然你可以编写三个函数分别完成统计三个值的功能。但比较啰嗦,如: intGetMax(inta[],intn) { intmax=a[0],i; for(i=1;i<n;i++) { if(max<a[i])max=a[i]; } returnmax; } intGetMin(inta[],intn) { intmin=a[0],i; for(i=1;i<n;i++) { if(min>a[i])min=a[i]; } returnmin; } doubleGetAvg(inta[],intn) { doubleavg=0; inti; for(i=0;i<n;i++) { avg+=a[i]; } returnavg/n; } 其实我们完全可以在一个函数中完成这个功能,由于函数只能有一个返回值,可以返回平均值,最大值和最小值可以通过指针类型的形参来进行实现: doubleStat(inta[],intn,int*pmax,int*pmin) { doubleavg=a[0]; inti; *pmax=*pmin=a[0]; for(i=1;i<n;i++) { avg+=a[i]; if(*pmax<a[i])*pmax=a[i]; if(*pmin>a[i])*pmin=a[i]; } returnavg/n; } 1.1.5.2 函数的指针 一个函数总是占用一段连续的内存区域,函数名在表达式中有时也会被转换为该函数所在内存区域的首地址。我们可以把函数的这个首地址赋予一个指针变量,使指针变量指向函数所在的内存区域,然后通过指针变量就可以找到并调用该函数。这种指针就是函数指针。 函数指针的定义形式为: returnType(*pointerName)(paramlist); returnType 为函数返回值类型,pointerNmae 为指针名称,param list 为函数参数列表。参数列表中可以同时给出参数的类型和名称,也可以只给出参数的类型,省略参数的名称,这一点和函数原型非常类似。 用指针来实现对函数的调用: #include<stdio.h> //返回两个数中较大的一个 intmax(inta,intb) { returna>b?a:b; } intmain() { intx,y,maxval; //定义函数指针 int(*pmax)(int,int)=max;//也可以写作int(*pmax)(inta,intb) printf("Inputtwonumbers:"); scanf("%d%d",&x,&y); maxval=(*pmax)(x,y); printf("Maxvalue:%d\n",maxval); return0; } 1.1.5.3 结构体和指针 结构体指针有特殊的语法: -> 符号 如果p是一个结构体指针,则可以使用 p ->【成员】 的方法访问结构体的成员 typedefstruct { charname[31]; intage; floatscore; }Student; intmain(void) { Studentstu={"Bob",19,98.0}; Student*ps=&stu; ps->age=20; ps->score=99.0; printf("name:%sage:%d ",ps->name,ps->age); return0; } 1.2 指针的意义_间接赋值 1.2.1 间接赋值的三大条件 通过指针间接赋值成立的三大条件: 2个变量(一个普通变量一个指针变量、或者一个实参一个形参) 建立关系 通过 * 操作指针指向的内存 voidtest(){ inta=100;//两个变量 int*p=NULL; //建立关系 //指针指向谁,就把谁的地址赋值给指针 p=&a; //通过*操作内存 *p=22; } 1.2.2 如何定义合适的指针变量 voidtest(){ intb; int*q=&b;//0级指针 int**t=&q; int***m=&t; } 1.2.3 间接赋值:从0级指针到1级指针 intfunc1(){return10;} voidfunc2(inta){ a=100; } //指针的意义_间接赋值 voidtest02(){ inta=0; a=func1(); printf("a=%d\n",a); //为什么没有修改? func2(a); printf("a=%d\n",a); } //指针的间接赋值 voidfunc3(int*a){ *a=100; } voidtest03(){ inta=0; a=func1(); printf("a=%d\n",a); //修改 func3(&a); printf("a=%d\n",a); } 1.2.4 间接赋值:从1级指针到2级指针 voidAllocateSpace(char**p){ *p=(char*)malloc(100); strcpy(*p,"helloworld!"); } voidFreeSpace(char**p){ if(p==NULL){ return; } if(*p!=NULL){ free(*p); *p=NULL; } } voidtest(){ char*p=NULL; AllocateSpace(&p); printf("%s\n",p); FreeSpace(&p); if(p==NULL){ printf("p内存释放!\n"); } } 1.2.4 间接赋值的推论 用1级指针形参,去间接修改了0级指针(实参)的值。 用2级指针形参,去间接修改了1级指针(实参)的值。 用3级指针形参,去间接修改了2级指针(实参)的值。 用n级指针形参,去间接修改了n-1级指针(实参)的值。 1.3 指针做函数参数 指针做函数参数,具备输入和输出特性: 输入:主调函数分配内存 输出:被调用函数分配内存 1.3.1 输入特性 voidfun(char*p/*in*/) { //给p指向的内存区域拷贝内容 strcpy(p,"abcddsgsd"); } voidtest(void) { //输入,主调函数分配内存 charbuf[100]={0}; fun(buf); printf("buf=%s\n",buf); } 1.3.2 输出特性 voidfun(char**p/*out*/,int*len) { char*tmp=(char*)malloc(100); if(tmp==NULL) { return; } strcpy(tmp,"adlsgjldsk"); //间接赋值 *p=tmp; *len=strlen(tmp); } voidtest(void) { //输出,被调用函数分配内存,地址传递 char*p=NULL; intlen=0; fun(&p,&len); if(p!=NULL) { printf("p=%s,len=%d\n",p,len); } } 1.4 字符串指针强化 1.4.1 字符串指针做函数参数 1.4.1.1 字符串基本操作 //字符串基本操作 //字符串是以0或者'\0'结尾的字符数组,(数字0和字符'\0'等价) voidtest01(){ //字符数组只能初始化5个字符,当输出的时候,从开始位置直到找到0结束 charstr1[]={'h','e','l','l','o'}; printf("%s\n",str1); //字符数组部分初始化,剩余填0 charstr2[100]={'h','e','l','l','o'}; printf("%s\n",str2); //如果以字符串初始化,那么编译器默认会在字符串尾部添加'\0' charstr3[]="hello"; printf("%s\n",str3); printf("sizeofstr:%d\n",sizeof(str3)); printf("strlenstr:%d\n",strlen(str3)); //sizeof计算数组大小,数组包含'\0'字符 //strlen计算字符串的长度,到'\0'结束 //那么如果我这么写,结果是多少呢? charstr4[100]="hello"; printf("sizeofstr:%d\n",sizeof(str4)); printf("strlenstr:%d\n",strlen(str4)); //请问下面输入结果是多少?sizeof结果是多少?strlen结果是多少? charstr5[]="hello\0world"; printf("%s\n",str5); printf("sizeofstr5:%d\n",sizeof(str5)); printf("strlenstr5:%d\n",strlen(str5)); //再请问下面输入结果是多少?sizeof结果是多少?strlen结果是多少? charstr6[]="hello\012world"; printf("%s\n",str6); printf("sizeofstr6:%d\n",sizeof(str6)); printf("strlenstr6:%d\n",strlen(str6)); } 八进制和十六进制转义字符: 在C中有两种特殊的字符,八进制转义字符和十六进制转义字符,八进制字符的一般形式是'\ddd',d是0-7的数字。十六进制字符的一般形式是'\xhh',h是0-9或A-F内的一个。八进制字符和十六进制字符表示的是字符的ASCII码对应的数值。 比如 : '\063'表示的是字符'3',因为'3'的ASCII码是30(十六进制),48(十进制),63(八进制)。 '\x41'表示的是字符'A',因为'A'的ASCII码是41(十六进制),65(十进制),101(八进制)。 1.4.1.2 字符串拷贝功能实现 //拷贝方法1 voidcopy_string01(char*dest,char*source){ for(inti=0;source[i]!='\0';i++){ dest[i]=source[i]; } } //拷贝方法2 voidcopy_string02(char*dest,char*source){ while(*source!='\0'/**source!=0*/){ *dest=*source; source++; dest++; } } //拷贝方法3 voidcopy_string03(char*dest,char*source){ //判断*dest是否为0,0则退出循环 while(*dest++=*source++){} } 1.4.1.3 字符串反转模型 voidreverse_string(char*str){ if(str==NULL){ return; } intbegin=0; intend=strlen(str)-1; while(begin<end){ //交换两个字符元素 chartemp=str[begin]; str[begin]=str[end]; str[end]=temp; begin++; end--; } } voidtest(){ charstr[]="abcdefghijklmn"; printf("str:%s\n",str); reverse_string(str); printf("str:%s\n",str); } 1.4.2 字符串的格式化 1.4.2.1 sprintf #include<stdio.h> intsprintf(char*str,constchar*format,...); 功能:根据参数format字符串来转换并格式化数据,然后将结果输出到str指定的空间中,直到 出现字符串结束符 '\0' 为止。 参数: str:字符串首地址 format:字符串格式,用法和printf()一样 返回值: 成功:实际格式化的字符个数 失败: - 1 voidtest(){ //1.格式化字符串 charbuf[1024]={0}; sprintf(buf,"你好,%s,欢迎加入我们!","John"); printf("buf:%s\n",buf); memset(buf,0,1024); sprintf(buf,"我今年%d岁了!",20); printf("buf:%s\n",buf); //2.拼接字符串 memset(buf,0,1024); charstr1[]="hello"; charstr2[]="world"; intlen=sprintf(buf,"%s%s",str1,str2); printf("buf:%slen:%d\n",buf,len); //3.数字转字符串 memset(buf,0,1024); intnum=100; sprintf(buf,"%d",num); printf("buf:%s\n",buf); //设置宽度右对齐 memset(buf,0,1024); sprintf(buf,"%8d",num); printf("buf:%s\n",buf); //设置宽度左对齐 memset(buf,0,1024); sprintf(buf,"%-8d",num); printf("buf:%s\n",buf); //转成16进制字符串小写 memset(buf,0,1024); sprintf(buf,"0x%x",num); printf("buf:%s\n",buf); //转成8进制字符串 memset(buf,0,1024); sprintf(buf,"0%o",num); printf("buf:%s\n",buf); } 1.4.2.2 sscanf #include<stdio.h> intsscanf(constchar*str,constchar*format,...); 功能:从str指定的字符串读取数据,并根据参数format字符串来转换并格式化数据。 参数: str:指定的字符串首地址 format:字符串格式,用法和scanf()一样 返回值: 成功:成功则返回参数数目,失败则返回-1 失败: - 1 //1.跳过数据 voidtest01(){ charbuf[1024]={0}; //跳过前面的数字 //匹配第一个字符是否是数字,如果是,则跳过 //如果不是则停止匹配 sscanf("123456aaaa","%*d%s",buf); printf("buf:%s\n",buf); } //2.读取指定宽度数据 voidtest02(){ charbuf[1024]={0}; //跳过前面的数字 sscanf("123456aaaa","%7s",buf); printf("buf:%s\n",buf); } //3.匹配a-z中任意字符 voidtest03(){ charbuf[1024]={0}; //跳过前面的数字 //先匹配第一个字符,判断字符是否是a-z中的字符,如果是匹配 //如果不是停止匹配 sscanf("abcdefg123456","%[a-z]",buf); printf("buf:%s\n",buf); } //4.匹配aBc中的任何一个 voidtest04(){ charbuf[1024]={0}; //跳过前面的数字 //先匹配第一个字符是否是aBc中的一个,如果是,则匹配,如果不是则停止匹配 sscanf("abcdefg123456","%[aBc]",buf); printf("buf:%s\n",buf); } //5.匹配非a的任意字符 voidtest05(){ charbuf[1024]={0}; //跳过前面的数字 //先匹配第一个字符是否是aBc中的一个,如果是,则匹配,如果不是则停止匹配 sscanf("bcdefag123456","%[^a]",buf); printf("buf:%s\n",buf); } //6.匹配非a-z中的任意字符 voidtest06(){ charbuf[1024]={0}; //跳过前面的数字 //先匹配第一个字符是否是aBc中的一个,如果是,则匹配,如果不是则停止匹配 sscanf("123456ABCDbcdefag","%[^a-z]",buf); printf("buf:%s\n",buf); } 1.5 一级指针易错点 1.5.1 越界 voidtest(){ charbuf[3]="abc"; printf("buf:%s\n",buf); } 1.5.2 指针叠加会不断改变指针指向 voidtest(){ char*p=(char*)malloc(50); charbuf[]="abcdef"; intn=strlen(buf); inti=0; for(i=0;i<n;i++) { *p=buf[i]; p++;//修改原指针指向 } free(p); } 1.5.3 返回局部变量地址 char*get_str() { charstr[]="abcdedsgads";//栈区, printf("[get_str]str=%s\n",str); returnstr; } 1.5.4 同一块内存释放多次(不可以释放野指针) voidtest(){ char*p=NULL; p=(char*)malloc(50); strcpy(p,"abcdef"); if(p!=NULL) { //free()函数的功能只是告诉系统p指向的内存可以回收了 //就是说,p指向的内存使用权交还给系统 //但是,p的值还是原来的值(野指针),p还是指向原来的内存 free(p); } if(p!=NULL) { free(p); } } 1.6 const使用 //const修饰变量 voidtest01(){ //1.const基本概念 constinti=0; //i=100;//错误,只读变量初始化之后不能修改 //2.定义const变量最好初始化 constintj; //j=100;//错误,不能再次赋值 //3.c语言的const是一个只读变量,并不是一个常量,可通过指针间接修改 constintk=10; //k=100;//错误,不可直接修改,我们可通过指针间接修改 printf("k:%d\n",k); int*p=&k; *p=100; printf("k:%d\n",k); } //const修饰指针 voidtest02(){ inta=10; intb=20; //const放在*号左侧修饰p_a指针指向的内存空间不能修改,但可修改指针的指向 constint*p_a=&a; //*p_a=100;//不可修改指针指向的内存空间 p_a=&b;//可修改指针的指向 //const放在*号的右侧,修饰指针的指向不能修改,但是可修改指针指向的内存空间 int*constp_b=&a; //p_b=&b;//不可修改指针的指向 *p_b=100;//可修改指针指向的内存空间 //指针的指向和指针指向的内存空间都不能修改 constint*constp_c=&a; } //const指针用法 structPerson{ charname[64]; intid; intage; intscore; }; //每次都对对象进行拷贝,效率低,应该用指针 voidprintPersonByValue(structPersonperson){ printf("Name:%s\n",person.name); printf("Name:%d\n",person.id); printf("Name:%d\n",person.age); printf("Name:%d\n",person.score); } //但是用指针会有副作用,可能会不小心修改原数据 voidprintPersonByPointer(conststructPerson*person){ printf("Name:%s\n",person->name); printf("Name:%d\n",person->id); printf("Name:%d\n",person->age); printf("Name:%d\n",person->score); } voidtest03(){ structPersonp={"Obama",1101,23,87}; //printPersonByValue(p); printPersonByPointer(&p); } 2. 指针的指针(二级指针) 2.1 二级指针基本概念 这里让我们花点时间来看一个例子,揭开这个即将开始的序幕。考虑下面这些声明: inta=12; int*b=&a; 它们如下图进行内存分配: 假定我们又有了第3个变量,名叫c,并用下面这条语句对它进行初始化: c=&b; 它在内存中的大概模样大致如下: c的类型是什么?显然它是一个指针,但它所指向的是什么? 变量b是一个“指向整型的指针”,所以任何指向b的类型必须是指向“指向整型的指针”的指针,更通俗地说,是一个指针的指针。 它合法吗? 是的!指针变量和其他变量一样,占据内存中某个特定的位置,所以用&操作符取得它的地址是合法的。 那么这个变量的声明是怎样的声明的呢? int**c=&b; 那么这个**c如何理解呢?操作符具有从右想做的结合性,所以这个表达式相当于(*c),我们从里向外逐层求职。*c访问c所指向的位置,我们知道这是变量b.第二个间接访问操作符访问这个位置所指向的地址,也就是变量a.指针的指针并不难懂,只需要留心所有的箭头,如果表达式中出现了间接访问操作符,你就要随箭头访问它所指向的位置。 2.2 二级指针做形参输出特性 二级指针做参数的输出特性是指由被调函数分配内存。 //被调函数,由参数n确定分配多少个元素内存 voidallocate_space(int**arr,intn){ //堆上分配n个int类型元素内存 int*temp=(int*)malloc(sizeof(int)*n); if(NULL==temp){ return; } //给内存初始化值 int*pTemp=temp; for(inti=0;i<n;i++){ //temp[i]=i+100; *pTemp=i+100; pTemp++; } //指针间接赋值 *arr=temp; } //打印数组 voidprint_array(int*arr,intn){ for(inti=0;i<n;i++){ printf("%d",arr[i]); } printf("\n"); } //二级指针输出特性(由被调函数分配内存) voidtest(){ int*arr=NULL; intn=10; //给arr指针间接赋值 allocate_space(&arr,n); //输出arr指向数组的内存 print_array(arr,n); //释放arr所指向内存空间的值 if(arr!=NULL){ free(arr); arr=NULL; } } 2.3 二级指针做形参输入特性 二级指针做形参输入特性是指由主调函数分配内存。 //打印数组 voidprint_array(int**arr,intn){ for(inti=0;i<n;i++){ printf("%d",*(arr[i])); } printf("\n"); } //二级指针输入特性(由主调函数分配内存) voidtest(){ inta1=10; inta2=20; inta3=30; inta4=40; inta5=50; intn=5; int**arr=(int**)malloc(sizeof(int*)*n); arr[0]=&a1; arr[1]=&a2; arr[2]=&a3; arr[3]=&a4; arr[4]=&a5; print_array(arr,n); free(arr); arr=NULL; } 2.4 强化训练_画出内存模型图 voidmian() { //栈区指针数组 char*p1[]={"aaaaa","bbbbb","ccccc"}; //堆区指针数组 char**p3=(char**)malloc(3*sizeof(char*));//char*array[3]; inti=0; for(i=0;i<3;i++) { p3[i]=(char*)malloc(10*sizeof(char));//charbuf[10] sprintf(p3[i],"%d%d%d",i,i,i); } } 2.4 多级指针 将堆区数组指针案例改为三级指针案例: //分配内存 voidallocate_memory(char***p,intn){ if(n<0){ return; } char**temp=(char**)malloc(sizeof(char*)*n); if(temp==NULL){ return; } //分别给每一个指针malloc分配内存 for(inti=0;i<n;i++){ temp[i]=malloc(sizeof(char)*30); sprintf(temp[i],"%2d_helloworld!",i+1); } *p=temp; } //打印数组 voidarray_print(char**arr,intlen){ for(inti=0;i<len;i++){ printf("%s\n",arr[i]); } printf("----------------------\n"); } //释放内存 voidfree_memory(char***buf,intlen){ if(buf==NULL){ return; } char**temp=*buf; for(inti=0;i<len;i++){ free(temp[i]); temp[i]=NULL; } free(temp); } voidtest(){ intn=10; char**p=NULL; allocate_memory(&p,n); //打印数组 array_print(p,n); //释放内存 free_memory(&p,n); } 2.5 深拷贝和浅拷贝 如果2个程序单元(例如2个函数)是通过拷贝 他们所共享的数据的 指针来工作的,这就是浅拷贝,因为真正要访问的数据并没有被拷贝。如果被访问的数据被拷贝了,在每个单元中都有自己的一份,对目标数据的操作相互 不受影响,则叫做深拷贝。 #include<iostream> usingnamespacestd; classCopyDemo { public: CopyDemo(intpa,char*cstr)//构造函数,两个参数 { this->a=pa; this->str=newchar[1024];//指针数组,动态的用new在堆上分配存储空间 strcpy(this->str,cstr);//拷贝过来 } //没写,C++会自动帮忙写一个复制构造函数,浅拷贝只复制指针,如下注释部分 //CopyDemo(CopyDemo&obj) //{ //this->a=obj.a; //this->str=obj.str;//这里是浅复制会出问题,要深复制 //} CopyDemo(CopyDemo&obj)//一般数据成员有指针要自己写复制构造函数,如下 { this->a=obj.a; //this->str=obj.str;//这里是浅复制会出问题,要深复制 this->str=newchar[1024];//应该这样写 if(str!=0) strcpy(this->str,obj.str);//如果成功,把内容复制过来 } ~CopyDemo()//析构函数 { deletestr; } public: inta;//定义一个整型的数据成员 char*str;//字符串指针 }; intmain() { CopyDemoA(100,"hello!!!"); CopyDemoB=A;//复制构造函数,把A的10和hello!!!复制给B cout<<"A:"<<A.a<<","<<A.str<<endl; //输出A:100,hello!!! cout<<"B:"<<B.a<<","<<B.str<<endl; //输出B:100,hello!!! //修改后,发现A,B都被改变,原因就是浅复制,A,B指针指向同一地方,修改后都改变 B.a=80; B.str[0]='k'; cout<<"A:"<<A.a<<","<<A.str<<endl; //输出A:100,kello!!! cout<<"B:"<<B.a<<","<<B.str<<endl; //输出B:80,kello!!! return0; } 根据上面实例可以看到,浅复制仅复制对象本身(其中包括是指针的成员),这样不同被复制对象的成员中的对应非空指针会指向同一对象,被成员指针引用的对象成为共享的,无法直接通过指针成员安全地删除(因为若直接删除,另外对象中的指针就会无效,形成所谓的野指针,而访问无效指针是危险的; 除非这些指针有引用计数或者其它手段确保被指对象的所有权);而深复制在浅复制的基础上,连同指针指向的对象也一起复制,代价比较高,但是相对容易管理。 参考资料 C Primer Plus(第五版)中文版 https://www.cnblogs.com/lulipro/p/7460206.html
优秀的个人博客,低调大师

熬夜整理的c/c++万字总结(一),值得收藏!

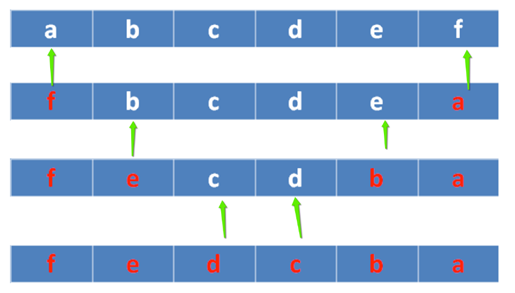
一. C语言概述 欢迎大家来到c语言的世界,c语言是一种强大的专业化的编程语言。 这一定是你需要的电子书资源,全!点击查看! 程序员书籍资源,点击查看! 1.1 C语言的起源 贝尔实验室的Dennis Ritchie在1972年开发了C,当时他正与ken Thompson一起设计UNIX操作系统,然而,C并不是完全由Ritchie构想出来的。它来自Thompson的B语言。 1.2 使用C语言的理由 在过去的几十年中,c语言已成为最流行和最重要的编程语言之一。它之所以得到发展,是因为人们尝试使用它后都喜欢它。过去很多年中,许多人从c语言转而使用更强大的c++语言,但c有其自身的优势,仍然是一种重要的语言,而且它还是学习c++的必经之路。 高效性。c语言是一种高效的语言。c表现出通常只有汇编语言才具有的精细的控制能力(汇编语言是特定cpu设计所采用的一组内部制定的助记符。不同的cpu类型使用不同的汇编语言)。如果愿意,您可以细调程序以获得最大的速度或最大的内存使用率。 可移植性。c语言是一种可移植的语言。意味着,在一个系统上编写的c程序经过很少改动或不经过修改就可以在其他的系统上运行。 强大的功能和灵活性。c强大而又灵活。比如强大灵活的UNIX操作系统便是用c编写的。其他的语言(Perl、Python、BASIC、Pascal)的许多编译器和解释器也都是用c编写的。结果是当你在一台Unix机器上使用Python时,最终由一个c程序负责生成最后的可执行程序。 1.3 C语言标准 1.3.1 K&R C 起初,C语言没有官方标准。1978年由美国电话电报公司(AT&T)贝尔实验室正式发表了C语言。布莱恩•柯林汉(Brian Kernighan) 和 丹尼斯•里奇(Dennis Ritchie) 出版了一本书,名叫《The C Programming Language》。这本书被 C语言开发者们称为K&R,很多年来被当作 C语言的非正式的标准说明。人们称这个版本的 C语言为K&R C。 K&R C主要介绍了以下特色:结构体(struct)类型;长整数(long int)类型;无符号整数(unsigned int)类型;把运算符=+和=-改为+=和-=。因为=+和=-会使得编译器不知道使用者要处理i = -10还是i =- 10,使得处理上产生混淆。 即使在后来ANSI C标准被提出的许多年后,K&R C仍然是许多编译器的最准要求,许多老旧的编译器仍然运行K&R C的标准。 1.3.2 ANSI C/C89标准 1970到80年代,C语言被广泛应用,从大型主机到小型微机,也衍生了C语言的很多不同版本。1983年,美国国家标准协会(ANSI)成立了一个委员会X3J11,来制定 C语言标准。 1989年,美国国家标准协会(ANSI)通过了C语言标准,被称为ANSI X3.159-1989 "Programming Language C"。因为这个标准是1989年通过的,所以一般简称C89标准。有些人也简称ANSI C,因为这个标准是美国国家标准协会(ANSI)发布的。 1990年,国际标准化组织(ISO)和国际电工委员会(IEC)把C89标准定为C语言的国际标准,命名为ISO/IEC 9899:1990 - Programming languages -- C[5] 。因为此标准是在1990年发布的,所以有些人把简称作C90标准。不过大多数人依然称之为C89标准,因为此标准与ANSI C89标准完全等同。 1994年,国际标准化组织(ISO)和国际电工委员会(IEC)发布了C89标准修订版,名叫ISO/IEC 9899:1990/Cor 1:1994[6] ,有些人简称为C94标准。 1995年,国际标准化组织(ISO)和国际电工委员会(IEC)再次发布了C89标准修订版,名叫ISO/IEC 9899:1990/Amd 1:1995 - C Integrity[7] ,有些人简称为C95标准。 1.3.3 C99标准 1999年1月,国际标准化组织(ISO)和国际电工委员会(IEC)发布了C语言的新标准,名叫ISO/IEC 9899:1999 - Programming languages -- C ,简称C99标准。这是C语言的第二个官方标准。 例如: 增加了新关键字 restrict,inline,_Complex,_Imaginary,_Bool 支持 long long,long double _Complex,float _Complex 这样的类型 支持了不定长的数组。数组的长度就可以用变量了。声明类型的时候呢,就用 int a[*] 这样的写法。不过考虑到效率和实现,这玩意并不是一个新类型。 二、内存分区 2.1 数据类型 2.1.1 数据类型概念 什么是数据类型?为什么需要数据类型? 数据类型是为了更好进行内存的管理,让编译器能确定分配多少内存。 我们现实生活中,狗是狗,鸟是鸟等等,每一种事物都有自己的类型,那么程序中使用数据类型也是来源于生活。 当我们给狗分配内存的时候,也就相当于给狗建造狗窝,给鸟分配内存的时候,也就是给鸟建造一个鸟窝,我们可以给他们各自建造一个别墅,但是会造成内存的浪费,不能很好的利用内存空间。 我们在想,如果给鸟分配内存,只需要鸟窝大小的空间就够了,如果给狗分配内存,那么也只需要狗窝大小的内存,而不是给鸟和狗都分配一座别墅,造成内存的浪费。 当我们定义一个变量,a = 10,编译器如何分配内存?计算机只是一个机器,它怎么知道用多少内存可以放得下10? 所以说,数据类型非常重要,它可以告诉编译器分配多少内存可以放得下我们的数据。 狗窝里面是狗,鸟窝里面是鸟,如果没有数据类型,你怎么知道冰箱里放得是一头大象! 数据类型基本概念: 类型是对数据的抽象; 类型相同的数据具有相同的表示形式、存储格式以及相关操作; 程序中所有的数据都必定属于某种数据类型; 数据类型可以理解为创建变量的模具: 固定大小内存的别名; 2.1.2 数据类型别名 typedefunsignedintu32; typedefstruct_PERSON{ charname[64]; intage; }Person; voidtest(){ u32val;//相当于unsignedintval; Personperson;//相当于structPERSONperson; } 2.1.3 void数据类型 void字面意思是”无类型”,void* 无类型指针,无类型指针可以指向任何类型的数据。 void定义变量是没有任何意义的,当你定义void a,编译器会报错。 void真正用在以下两个方面: 对函数返回的限定; 对函数参数的限定; //1.void修饰函数参数和函数返回 voidtest01(void){ printf("helloworld"); } //2.不能定义void类型变量 voidtest02(){ voidval;//报错 } //3.void*可以指向任何类型的数据,被称为万能指针 voidtest03(){ inta=10; void*p=NULL; p=&a; printf("a:%d\n",*(int*)p); charc='a'; p=&c; printf("c:%c\n",*(char*)p); } //4.void*常用于数据类型的封装 voidtest04(){ //void*memcpy(void*_Dst,constvoid*_Src,size_t_Size); } 2.1.4 sizeof 操作符 sizeof 是 c语言中的一个操作符,类似于++、--等等。sizeof 能够告诉我们编译器为某一特定数据或者某一个类型的数据在内存中分配空间时分配的大小,大小以字节为单位。 基本语法: sizeof(变量); sizeof变量; sizeof(类型); sizeof 注意点: sizeof返回的占用空间大小是为这个变量开辟的大小,而不只是它用到的空间。和现今住房的建筑面积和实用面积的概念差不多。所以对结构体用的时候,大多情况下就得考虑字节对齐的问题了; sizeof返回的数据结果类型是unsigned int; 要注意数组名和指针变量的区别。通常情况下,我们总觉得数组名和指针变量差不多,但是在用sizeof的时候差别很大,对数组名用sizeof返回的是整个数组的大小,而对指针变量进行操作的时候返回的则是指针变量本身所占得空间,在32位机的条件下一般都是4。而且当数组名作为函数参数时,在函数内部,形参也就是个指针,所以不再返回数组的大小; //1.sizeof基本用法 voidtest01(){ inta=10; printf("len:%d\n",sizeof(a)); printf("len:%d\n",sizeof(int)); printf("len:%d\n",sizeofa); } //2.sizeof结果类型 voidtest02(){ unsignedinta=10; if(a-11<0){ printf("结果小于0\n"); } else{ printf("结果大于0\n"); } intb=5; if(sizeof(b)-10<0){ printf("结果小于0\n"); } else{ printf("结果大于0\n"); } } //3.sizeof碰到数组 voidTestArray(intarr[]){ printf("TestArrayarrsize:%d\n",sizeof(arr)); } voidtest03(){ intarr[]={10,20,30,40,50}; printf("arraysize:%d\n",sizeof(arr)); //数组名在某些情况下等价于指针 int*pArr=arr; printf("arr[2]:%d\n",pArr[2]); printf("arraysize:%d\n",sizeof(pArr)); //数组做函数函数参数,将退化为指针,在函数内部不再返回数组大小 TestArray(arr); } 2.1.5 数据类型总结 数据类型本质是固定内存大小的别名,是个模具,C语言规定:通过数据类型定义变量; 数据类型大小计算(sizeof); 可以给已存在的数据类型起别名typedef; 数据类型的封装(void 万能类型); 2.2 变量 2.1.1 变量的概念 既能读又能写的内存对象,称为变量; 若一旦初始化后不能修改的对象则称为常量。 变量定义形式:类型标识符,标识符,…,标识符 2.1.2 变量名的本质 变量名的本质:一段连续内存空间的别名; 程序通过变量来申请和命名内存空间 int a = 0; 通过变量名访问内存空间; 不是向变量名读写数据,而是向变量所代表的内存空间中读写数据; 修改变量的两种方式: voidtest(){ inta=10; //1.直接修改 a=20; printf("直接修改,a:%d\n",a); //2.间接修改 int*p=&a; *p=30; printf("间接修改,a:%d\n",a); } 2.3 程序的内存分区模型 2.3.1 内存分区 2.3.1.1 运行之前 我们要想执行我们编写的c程序,那么第一步需要对这个程序进行编译。 1)预处理:宏定义展开、头文件展开、条件编译,这里并不会检查语法 2)编译:检查语法,将预处理后文件编译生成汇编文件 3)汇编:将汇编文件生成目标文件(二进制文件) 4)链接:将目标文件链接为可执行程序  代码区 存放 CPU 执行的机器指令。通常代码区是可共享的(即另外的执行程序可以调用它),使其可共享的目的是对于频繁被执行的程序,只需要在内存中有一份代码即可。代码区通常是只读的,使其只读的原因是防止程序意外地修改了它的指t令。另外,代码区还规划了局部变量的相关信息。  全局初始化数据区/静态数据区(data段) 该区包含了在程序中明确被初始化的全局变量、已经初始化的静态变量(包括全局静态变量和t)和常量数据(如字符串常量)。  未初始化数据区(又叫 bss 区) 存入的是全局未初始化变量和未初始化静态变量。未初始化数据区的数据在程序开始执行之前被内核初始化为 0 或者空(NULL)。 总体来讲说,程序源代码被编译之后主要分成两种段:程序指令(代码区)和程序数据(数据区)。代码段属于程序指令,而数据域段和.bss段属于程序数据。 那为什么把程序的指令和程序数据分开呢? 程序被load到内存中之后,可以将数据和代码分别映射到两个内存区域。由于数据区域对进程来说是可读可写的,而指令区域对程序来讲说是只读的,所以分区之后呢,可以将程序指令区域和数据区域分别设置成可读可写或只读。这样可以防止程序的指令有意或者无意被修改; 当系统中运行着多个同样的程序的时候,这些程序执行的指令都是一样的,所以只需要内存中保存一份程序的指令就可以了,只是每一个程序运行中数据不一样而已,这样可以节省大量的内存。比如说之前的Windows Internet Explorer 7.0运行起来之后, 它需要占用112 844KB的内存,它的私有部分数据有大概15 944KB,也就是说有96 900KB空间是共享的,如果程序中运行了几百个这样的进程,可以想象共享的方法可以节省大量的内存。 2.3.1.1 运行之后 程序在加载到内存前,代码区和全局区(data和bss)的大小就是固定的,程序运行期间不能改变。然后,运行可执行程序,操作系统把物理硬盘程序load(加载)到内存,除了根据可执行程序的信息分出代码区(text)、数据区(data)和未初始化数据区(bss)之外,还额外增加了栈区、堆区。  代码区(text segment) 加载的是可执行文件代码段,所有的可执行代码都加载到代码区,这块内存是不可以在运行期间修改的。  未初始化数据区(BSS) 加载的是可执行文件BSS段,位置可以分开亦可以紧靠数据段,存储于数据段的数据(全局未初始化,静态未初始化数据)的生存周期为整个程序运行过程。  全局初始化数据区/静态数据区(data segment) 加载的是可执行文件数据段,存储于数据段(全局初始化,静态初始化数据,文字常量(只读))的数据的生存周期为整个程序运行过程。  栈区(stack) 栈是一种先进后出的内存结构,由编译器自动分配释放,存放函数的参数值、返回值、局部变量等。在程序运行过程中实时加载和释放,因此,局部变量的生存周期为申请到释放该段栈空间。  堆区(heap) 堆是一个大容器,它的容量要远远大于栈,但没有栈那样先进后出的顺序。用于动态内存分配。堆在内存中位于BSS区和栈区之间。一般由程序员分配和释放,若程序员不释放,程序结束时由操作系统回收。 2.3.2 分区模型 2.3.2.1 栈区 由系统进行内存的管理。主要存放函数的参数以及局部变量。在函数完成执行,系统自行释放栈区内存,不需要用户管理。 #char*func(){ charp[]="helloworld!";//在栈区存储乱码 printf("%s\n",p); returnp; } voidtest(){ char*p=NULL; p=func(); printf("%s\n",p); } 2.3.2.2 堆区 由编程人员手动申请,手动释放,若不手动释放,程序结束后由系统回收,生命周期是整个程序运行期间。使用malloc或者new进行堆的申请。 char*func(){ char*str=malloc(100); strcpy(str,"helloworld!"); printf("%s\n",str); returnstr; } voidtest01(){ char*p=NULL; p=func(); printf("%s\n",p); } voidallocateSpace(char*p){ p=malloc(100); strcpy(p,"helloworld!"); printf("%s\n",p); } voidtest02(){ char*p=NULL; allocateSpace(p); printf("%s\n",p); } 堆分配内存API: #include<stdlib.h> void*calloc(size_tnmemb,size_tsize); 功能: 在内存动态存储区中分配nmemb块长度为size字节的连续区域。calloc自动将分配的内存 置0。 参数: nmemb:所需内存单元数量 size:每个内存单元的大小(单位:字节) 返回值: 成功:分配空间的起始地址 失败:NULL #include<stdlib.h> void*realloc(void*ptr,size_tsize); 功能: 重新分配用malloc或者calloc函数在堆中分配内存空间的大小。 realloc不会自动清理增加的内存,需要手动清理,如果指定的地址后面有连续的空间,那么就会在已有地址基础上增加内存,如果指定的地址后面没有空间,那么realloc会重新分配新的连续内存,把旧内存的值拷贝到新内存,同时释放旧内存。 参数: ptr:为之前用malloc或者calloc分配的内存地址,如果此参数等于NULL,那么和realloc与malloc功能一致 size:为重新分配内存的大小, 单位:字节 返回值: 成功:新分配的堆内存地址 失败:NULL voidtest01(){ int*p1=calloc(10,sizeof(int)); if(p1==NULL){ return; } for(inti=0;i<10;i++){ p1[i]=i+1; } for(inti=0;i<10;i++){ printf("%d",p1[i]); } printf("\n"); free(p1); } voidtest02(){ int*p1=calloc(10,sizeof(int)); if(p1==NULL){ return; } for(inti=0;i<10;i++){ p1[i]=i+1; } int*p2=realloc(p1,15*sizeof(int)); if(p2==NULL){ return; } printf("%d\n",p1); printf("%d\n",p2); //打印 for(inti=0;i<15;i++){ printf("%d",p2[i]); } printf("\n"); //重新赋值 for(inti=0;i<15;i++){ p2[i]=i+1; } //再次打印 for(inti=0;i<15;i++){ printf("%d",p2[i]); } printf("\n"); free(p2); } 2.3.2.3 全局/静态区 全局静态区内的变量在编译阶段已经分配好内存空间并初始化。这块内存在程序运行期间一直存在,它主要存储全局变量、静态变量和常量。 注意: (1)这里不区分初始化和未初始化的数据区,是因为静态存储区内的变量若不显示初始化,则编译器会自动以默认的方式进行初始化,即静态存储区内不存在未初始化的变量。 (2)全局静态存储区内的常量分为常变量和字符串常量,一经初始化,不可修改。静态存储内的常变量是全局变量,与局部常变量不同,区别在于局部常变量存放于栈,实际可间接通过指针或者引用进行修改,而全局常变量存放于静态常量区则不可以间接修改。 (3)字符串常量存储在全局/静态存储区的常量区。 intv1=10;//全局/静态区 constintv2=20;//常量,一旦初始化,不可修改 staticintv3=20;//全局/静态区 char*p1;//全局/静态区,编译器默认初始化为NULL //那么全局staticint和全局int变量有什么区别? voidtest(){ staticintv4=20;//全局/静态区 } char*func(){ staticchararr[]="helloworld!";//在静态区存储可读可写 arr[2]='c'; char*p="helloworld!";//全局/静态区-字符串常量区 //p[2]='c';//只读,不可修改 printf("%d\n",arr); printf("%d\n",p); printf("%s\n",arr); returnarr; } voidtest(){ char*p=func(); printf("%s\n",p); } 2.3.2.4 总结 在理解C/C++内存分区时,常会碰到如下术语:数据区,堆,栈,静态区,常量区,全局区,字符串常量区,文字常量区,代码区等等,初学者被搞得云里雾里。在这里,尝试捋清楚以上分区的关系。 数据区包括:堆,栈,全局/静态存储区。 全局/静态存储区包括:常量区,全局区、静态区。 常量区包括:字符串常量区、常变量区。 代码区:存放程序编译后的二进制代码,不可寻址区。 可以说,C/C++内存分区其实只有两个,即代码区和数据区。 2.3.3 函数调用模型 2.3.3.1 函数调用流程 栈(stack)是现代计算机程序里最为重要的概念之一,几乎每一个程序都使用了栈,没有栈就没有函数,没有局部变量,也就没有我们如今能见到的所有计算机的语言。在解释为什么栈如此重要之前,我们先了解一下传统的栈的定义: 在经典的计算机科学中,栈被定义为一个特殊的容器,用户可以将数据压入栈中(入栈,push),也可以将压入栈中的数据弹出(出栈,pop),但是栈容器必须遵循一条规则:先入栈的数据最后出栈(First In Last Out,FILO). 在经典的操作系统中,栈总是向下增长的。压栈的操作使得栈顶的地址减小,弹出操作使得栈顶地址增大。 栈在程序运行中具有极其重要的地位。最重要的,栈保存一个函数调用所需要维护的信息,这通常被称为堆栈帧(Stack Frame)或者活动记录(Activate Record).一个函数调用过程所需要的信息一般包括以下几个方面: 函数的返回地址; 函数的参数; 临时变量; 保存的上下文:包括在函数调用前后需要保持不变的寄存器。 我们从下面的代码,分析以下函数的调用过程: intfunc(inta,intb){ intt_a=a; intt_b=b; returnt_a+t_b; } intmain(){ intret=0; ret=func(10,20); returnEXIT_SUCCESS; } 2.3.3.2 调用惯例 现在,我们大致了解了函数调用的过程,这期间有一个现象,那就是函数的调用者和被调用者对函数调用有着一致的理解,例如,它们双方都一致的认为函数的参数是按照某个固定的方式压入栈中。如果不这样的话,函数将无法正确运行。 如果函数调用方在传递参数的时候先压入a参数,再压入b参数,而被调用函数则认为先压入的是b,后压入的是a,那么被调用函数在使用a,b值时候,就会颠倒。 因此,函数的调用方和被调用方对于函数是如何调用的必须有一个明确的约定,只有双方都遵循同样的约定,函数才能够被正确的调用,这样的约定被称为”调用惯例(Calling Convention)”.一个调用惯例一般包含以下几个方面: 函数参数的传递顺序和方式 函数的传递有很多种方式,最常见的是通过栈传递。函数的调用方将参数压入栈中,函数自己再从栈中将参数取出。对于有多个参数的函数,调用惯例要规定函数调用方将参数压栈的顺序:从左向右,还是从右向左。有些调用惯例还允许使用寄存器传递参数,以提高性能。 栈的维护方式 在函数将参数压入栈中之后,函数体会被调用,此后需要将被压入栈中的参数全部弹出,以使得栈在函数调用前后保持一致。这个弹出的工作可以由函数的调用方来完成,也可以由函数本身来完成。 为了在链接的时候对调用惯例进行区分,调用惯例要对函数本身的名字进行修饰。不同的调用惯例有不同的名字修饰策略。 事实上,在c语言里,存在着多个调用惯例,而默认的是cdecl.任何一个没有显示指定调用惯例的函数都是默认是cdecl惯例。比如我们上面对于func函数的声明,它的完整写法应该是: int_cdeclfunc(inta,intb); 注意: cdecl不是标准的关键字,在不同的编译器里可能有不同的写法,例如gcc里就不存在_cdecl这样的关键字,而是使用__attribute_((cdecl)). 2.3.3.2 函数变量传递分析 2.3.4 栈的生长方向和内存存放方向 //1.栈的生长方向 voidtest01(){ inta=10; intb=20; intc=30; intd=40; printf("a=%d\n",&a); printf("b=%d\n",&b); printf("c=%d\n",&c); printf("d=%d\n",&d); //a的地址大于b的地址,故而生长方向向下 } //2.内存生长方向(小端模式) voidtest02(){ //高位字节->地位字节 intnum=0xaabbccdd; unsignedchar*p=&num; //从首地址开始的第一个字节 printf("%x\n",*p); printf("%x\n",*(p+1)); printf("%x\n",*(p+2)); printf("%x\n",*(p+3)); }

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册